Коротко (TL;DR)
Context engineering для Claude 5 — це збирання всього, що модель отримує разом із вашим запитом: системного промпту, CLAUDE.md, скілів, пам’яті, файлів-референсів. 24 липня 2026 року Anthropic повідомила, що прибрала із системного промпту Claude Code понад 80% тексту для моделей на кшталт Opus 5 і Fable 5 і не побачила вимірних втрат на своїх оцінках коду. Нижче — що з цього випливає для ваших промптів і як перевірити це на власних завданнях, а не на вірі.
- Коротко (TL;DR)
- Що Anthropic сказала про Claude 5 — і чого немає в її пості
- Як це працює: чому зайві правила заважають Claude 5
- Шість старих звичок і чим їх замінити для Claude 5
- Приклади, роль, CAPS і «думай крок за кроком»: що шкодить, а що ні
- Аудит промпту під Claude 5: покроковий чек-лист
- Промпт «було → стало»: чистка системного промпту на прикладі
- Як перевірити, що чистка не погіршила якість: міні-eval
- CLAUDE.md, скіли й автопам’ять у Claude Code: що куди класти
- Чи працює це на GPT і Gemini: що радять OpenAI та Google
- Коли чистити промпт не треба і чим це ризикує
- Кейси: як чистили Claude Code, AGENTS.md і опис скіла
- FAQ
- Що застаріло: жорсткі правила «на всі випадки», приклади виклику інструментів, повтори однієї інструкції у двох місцях, CLAUDE.md як звалище всіх практик.
- Що лишилося: мета й причина запиту, формат виводу, межі завдання, заборона незворотних дій. Приклади для формату й тону довідка Anthropic і далі радить — 3–5 штук.
- Що робити: пройти кожен рядок промпту п’ятьма запитаннями, прибрати милиці під старі моделі, винести рідкісні інструкції у скіли.
- Як не зламати: прогнати старий і новий варіант на 15–20 реальних завданнях і відкочувати рядок, якщо просіла метрика.
- Чим собі допомогти: у Claude Code 2.1.283+ є
/doctor prompt-audit— він знаходить застарілі й суперечливі інструкції, але нічого не змінює без вашої команди.
Що Anthropic сказала про Claude 5 — і чого немає в її пості
Першоджерело — пост Таріка Шихіпара (Thariq Shihipar, технічний співробітник Anthropic) The new rules of context engineering for Claude 5 generation models, опублікований 24 липня 2026 року. Головна фраза поста: «We removed over 80% of Claude Code’s system prompt for models like Claude Opus 5 and Claude Fable 5 with no measurable loss on our coding evaluations». Тобто понад 80% системного промпту прибрано, а вимірних втрат на внутрішніх оцінках коду немає.
Важливо, що саме сказано, а чого немає. У пості немає диффа старого й нового промпту, немає назв оцінок і жодної цифри якості. «Без втрат» — це заява самої Anthropic, незалежно її ніхто не відтворив. Перекази поста, зокрема випуск DOU «AI шумлять», подекуди його посилюють — звірка нижче.Що кажуть у переказах Що в першоджерелі «Якість не впала ані на пункт» «No measurable loss on our coding evaluations» — без цифр і методики Чотири правила «було → стало» Шість пар Then/Now: правила, приклади, усе одразу, повтори, пам’ять, специфікації «Приклади тепер псують результат» Ідеться про приклади виклику інструментів; довідка з промптів радить 3–5 прикладів для формату Скорочували для Opus 4.5 і Sonnet 4.5 (MindStudio) У пості — «моделі на кшталт Opus 5 і Fable 5» 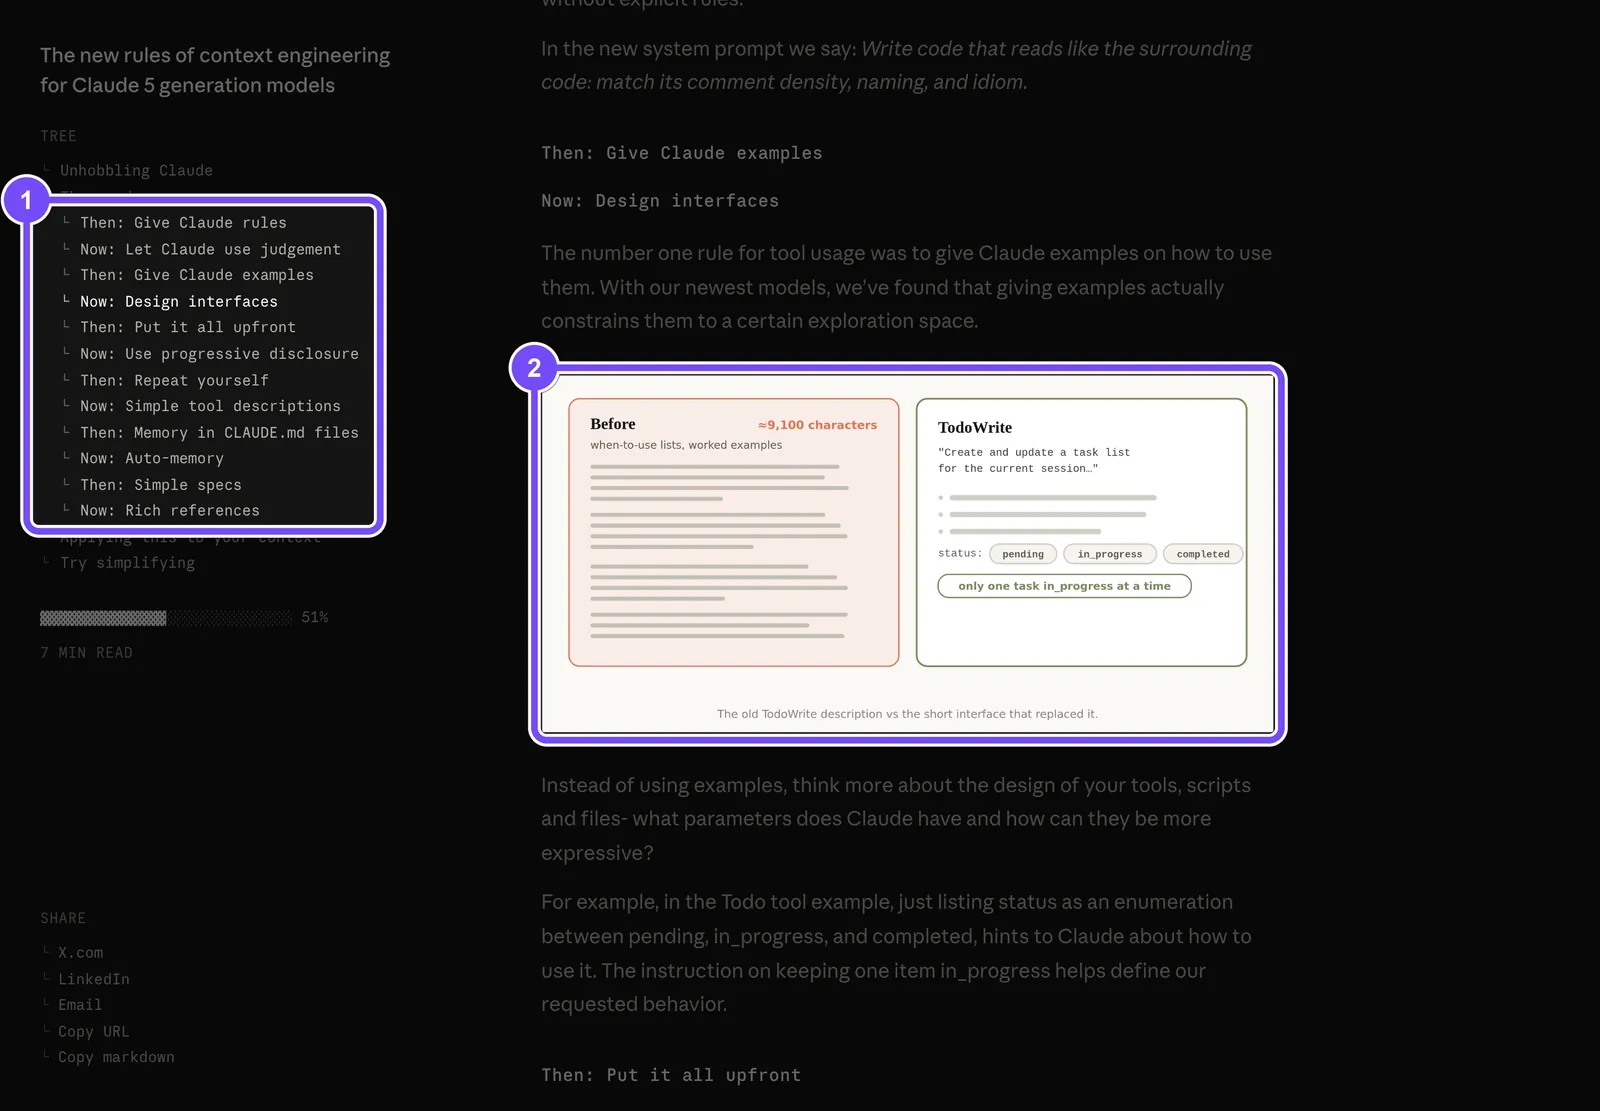
На кадрі зі сторінки поста (знято 24 жовтня 2026 року) рамка 1 виділяє зміст: усі шість пар «Then / Now» видно поспіль. Рамка 2 — ілюстрація з розділу про приклади: старий опис інструмента TodoWrite зі списками «коли використовувати» й розібраними прикладами проти короткого інтерфейсу зі статусами pending, in_progress, completed.
Пост писали про дві моделі, а лінійка відтоді оновилася. На 24 жовтня 2026 року в довідці Anthropic актуальні Claude Fable 5.1, Claude Opus 5.5, Sonnet 5.5 і Haiku 5.5 (ID claude-fable-5-1, claude-opus-5-5, claude-sonnet-5-5, claude-haiku-5-5), і для кожної є власна сторінка з порадами щодо промптів. Висновки поста до них застосовні із застереженням: довідка прямо пише, що техніку, перевірену на одній моделі, треба перевірити на своїх оцінках, перш ніж переносити на іншу.
Як це працює: чому зайві правила заважають Claude 5
Context engineering — це робота не з одним запитом, а з усім контекстом, який модель бачить під час кожної відповіді. Докладно про саме поняття і про те, чому довгий контекст «псується», — у розборі контекстної інженерії для ШІ-агентів. Тут важлива одна відмінність: промпт пишуть під конкретне завдання, а контекст працює одразу на сотні різних запитів, тому він не може бути таким самим конкретним.
Звідси головна проблема, яку Anthropic знайшла в себе. Читаючи логи власної роботи в Claude Code, команда бачила в одному запиті суперечливі вказівки: системний промпт, скіл і користувач одночасно казали «leave documentation as appropriate» і «DO NOT add comments». Claude зазвичай вгадує, чого хоче людина, але на розбір конфлікту витрачає зайве міркування. Документація Claude Code додає: якщо дві інструкції суперечать одна одній, модель може обрати одну довільно.
Друга причина — правила, потрібні слабким моделям. Раніше системний промпт Claude Code вимагав: «In code: default to writing no comments. Never write multi-paragraph docstrings…». Для частини завдань це було хибно: користувач має свої вподобання, а складному коду інколи потрібен довгий коментар. Старим моделям правило однаково було вигідніше, ніж свобода. У новому промпті його замінила одна фраза: «Write code that reads like the surrounding code: match its comment density, naming, and idiom» — пиши так, як написано навколишній код.
Третє — баланс між конкретикою і свободою. Автор польового гайду з Fable 5 формулює його так: надто конкретна інструкція змусить Claude виконувати її, навіть коли розумніше змінити курс; надто розмита — і модель ухвалить рішення за «галузевими практиками», які вам можуть не підійти. Ще у вересні 2025 року Anthropic називала це «правильною висотою» промпту й окремо застерігала, що мінімальний набір інструкцій не означає короткий.
Тому нові правила context engineering for Claude 5 models зводяться не до «пиши менше», а до «пиши про мету й причини». Довідка з Fable 5 це прямо підтверджує: модель працює краще, коли в промпті названо задум запиту, і більшістю поведінки можна керувати короткою інструкцією замість переліку випадків. Як побудувати добрий промпт з нуля — в окремому посібнику зі структури промпту; ця стаття про чистку того, що вже накопичилося.
Шість старих звичок і чим їх замінити для Claude 5
Пост Anthropic побудовано як шість пар «було → стало». У таблиці — кожна пара і те, що вона означає для вашого власного промпту чи CLAUDE.md.
| Було (Then) | Стало (Now) | Що зробити в себе |
|---|---|---|
| Давати Claude правила | Довіритися судженню | Замінити жорсткі заборони описом мети й критерію: «як у навколишньому коді» замість «ніколи не пиши коментарі» |
| Давати приклади використання інструментів | Проєктувати інтерфейси | Замість прикладів виклику — виразні параметри: перелік статусів, зрозумілі назви полів |
| Класти все одразу | Прогресивне розкриття | Рідкісні інструкції (код-рев’ю, перевірку) винести у скіли й окремі файли, що вантажаться на вимогу |
| Повторювати одне й те саме | Прості описи інструментів | Інструкцію щодо інструмента тримати в його описі, а не дублювати в системному промпті |
| Пам’ять у CLAUDE.md | Автопам’ять | Не записувати в CLAUDE.md кожну поправку вручну: вподобання Claude зберігає сам |
| Прості специфікації в markdown | Багаті референси | Давати еталон у коді, набір тестів, HTML-макет або рубрику замість словесного опису |
Дві пари із шести в переказах зазвичай губляться. «Повтори»: ранні моделі краще слухалися інструкцій наприкінці контексту, тому згадки інструментів дублювалися в системному промпті й в описі самого інструмента — тепер дублі видалено. «Референси»: специфікацією може бути докладний набір тестів або функція в іншій кодовій базі, яку треба портувати, а HTML-макет дизайну, за спостереженням Anthropic, зазвичай дає кращий результат, ніж словесний опис чи скриншот.
Якщо звести таблицю до одного правила, context engineering для Claude 5 зводиться до запитання «навіщо тут цей рядок?». Рядок, що страхує від помилки старої моделі, тепер коштує токенів у кожному запиті й може сперечатися з рештою. Рядок, що повідомляє моделі те, чого вона не дізнається сама, лишається.
Приклади, роль, CAPS і «думай крок за кроком»: що шкодить, а що ні
Найчастіше спотворення поста — «приклади тепер шкодять». У пості сказано конкретніше: «The number one rule for tool usage was to give Claude examples», а з новими моделями такі приклади «constrains them to a certain exploration space» — звужують простір пошуку. Ідеться про приклади виклику інструментів. Довідка з промптів тієї ж Anthropic на 24 жовтня 2026 року радить протилежне для формату й тону: «Include 3–5 examples for best results».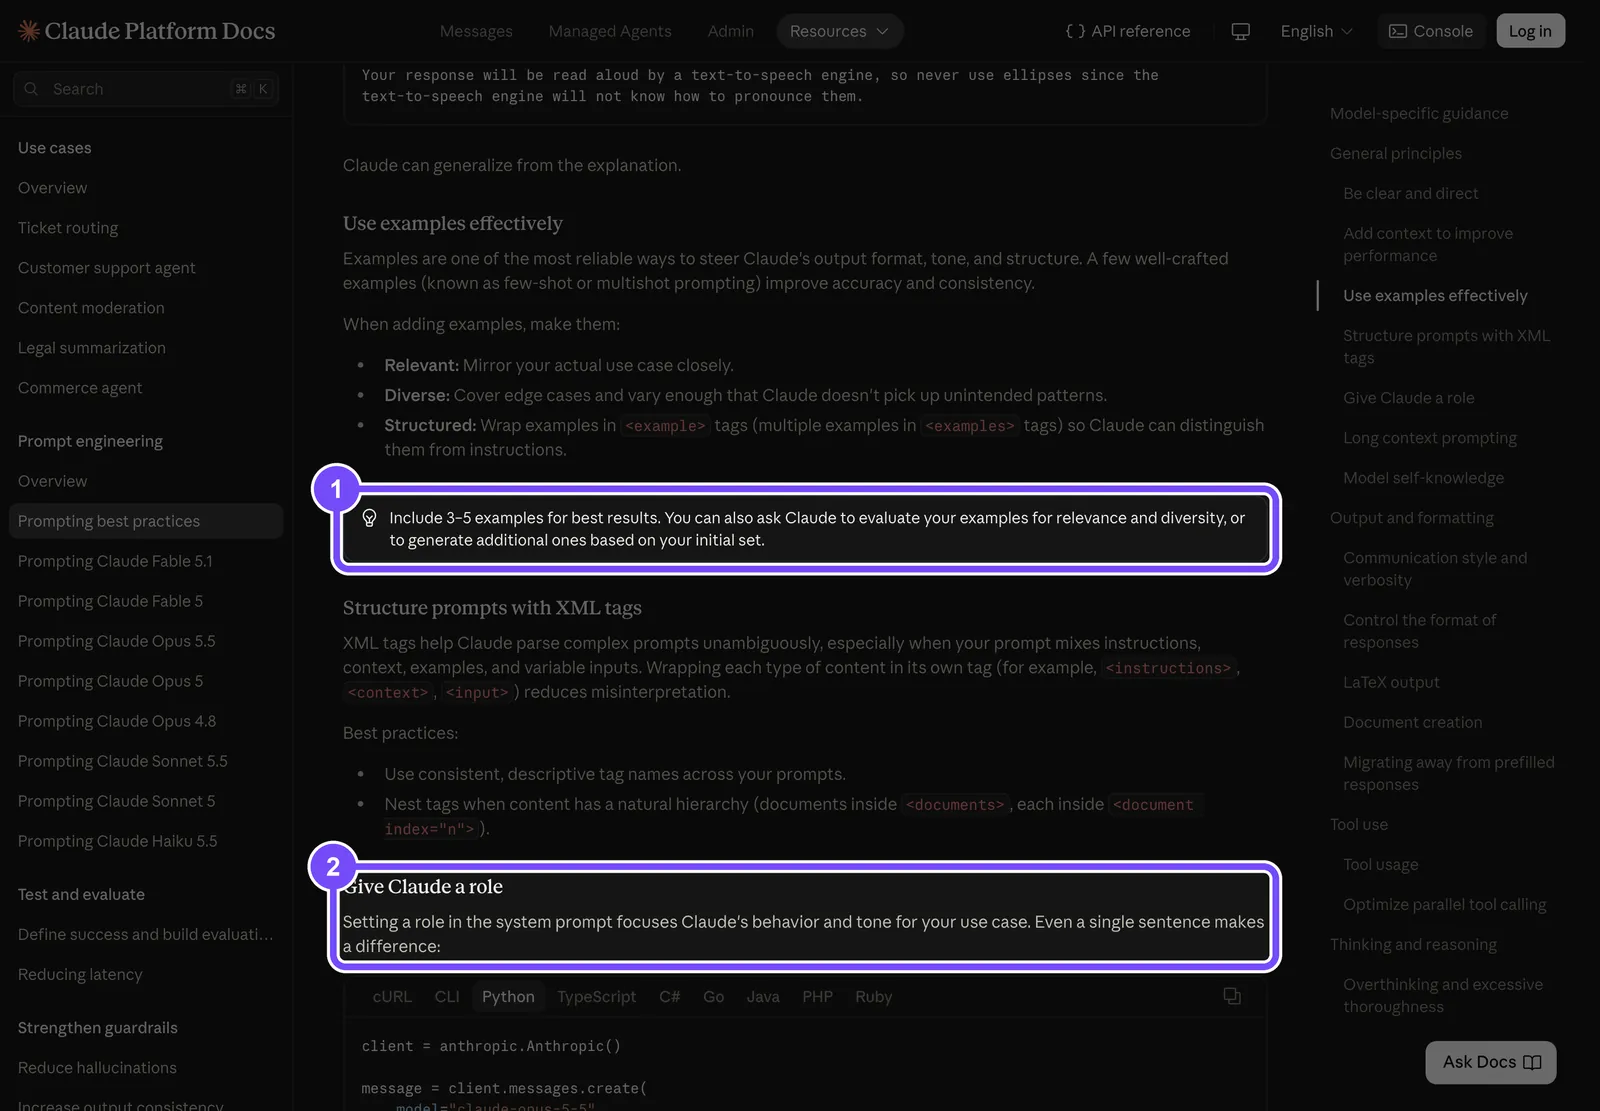
На кадрі з довідки Prompting best practices (знято 24 жовтня 2026 року) рамка 1 — підказка «Include 3–5 examples for best results» у розділі про приклади, рамка 2 — розділ «Give Claude a role»: роль у системному промпті й досі рекомендована, і навіть одне речення змінює поведінку й тон.Прийом Що каже Anthropic на 24.10.2026 Вердикт для Claude 5 Приклади формату й тону (few-shot) 3–5 різноманітних прикладів у тегах <example>Лишити, але без звалища всіх крайових випадків Приклади виклику інструментів Звужують пошук у нових моделей Прибрати, поліпшити параметри й опис інструмента Роль у системному промпті Фокусує поведінку й тон Лишити: навіть одне речення помітно впливає CAPS і «CRITICAL: You MUST…» Пом’якшити до «Use this tool when…» (сказано про Opus 4.5–4.6; окремого правила для 5.x немає) Пом’якшити: гучна інструкція в уважної моделі веде до перегину «Думай крок за кроком, випиши міркування» На Fable 5.1, Opus 5.5 і Sonnet 5.5 таке прохання можуть відхилити Прибрати, спиратися на вбудоване мислення «Перевір двічі», «фінальна перевірка» Opus 5 перевіряє себе сам, зайва перевірка витрачає токени Прибрати «Не використовуй списки й жирний» Fable 5.1: прибрати або замінити правилом, коли формат доречний Замінити умовою з причиною
Щодо CAPS потрібне застереження: у довідці пораду пом’якшити агресивну мову написано як ліки від «перепрацювання» в моделей 4.5–4.6, окремої заборони для лінійки 5.x там немає. Логіка при цьому та сама — гучна інструкція для уважної моделі стає нав’язливою.
Окрема сторінка довідки з prompt engineering для Claude Opus 5.5 додає ще один рядок на видалення: інструкції «думай уважно перед відповіддю» в системному промпті чату. У тестах Anthropic після видалення такого рядка відповіді починалися раніше без явного падіння якості. Застереження те саме: це перевірено в чат-сценарії, на ваших завданнях результат треба міряти.
Аудит промпту під Claude 5: покроковий чек-лист
Аудит — це прохід кожним рядком контексту з одним запитанням: що зламається, якщо його видалити? Порядок такий.
- Зберіть усі шари в одне місце. Системний промпт, усі CLAUDE.md (корінь, підпапки, користувацький), правила в
.claude/rules/, описи скілів, AGENTS.md. Конфлікти майже завжди живуть на стику шарів, тому дивитися файли поодинці марно. - Знайдіть суперечності. Шукайте пари на кшталт «лишай документацію за ситуацією» і «не додавай коментарі». Кожну пару зведіть до одного формулювання з причиною.
- Поставте кожному рядку п’ять запитань (список нижче) і позначте: лишити, прибрати, перенести.
- Перепишіть решту через мету й причину. «Відповідай без markdown» → «Відповідай звичайним текстом: віджет не показує розмітку».
- Винесіть рідкісне у скіли. Інструкції, потрібні в одному завданні з двадцяти, не мають вантажитися в кожне.
- Звіртеся з довідкою під свою модель. Для Claude Opus 5.5 в Anthropic є окремий prompt guide — сторінка «Prompting Claude Opus 5.5»; у Fable 5.1, Sonnet 5.5 і Haiku 5.5 — свої. Там перелічено рядки, які для конкретної моделі варто видалити.
- Проженіть міні-eval (розділ нижче) і тільки потім викочуйте нову версію.
П’ять запитань до кожного рядка:
- Чи страхує він від помилки, якої нова модель уже не робить? «Перевір відповідь», «мінімізуй виклики інструментів», «тримай усі знахідки до фінальної відповіді» — довідки з Opus 5, Fable 5.1 і Sonnet 5.5 прямо радять видалити такі рядки.
- Чи може модель дізнатися це сама з коду або файлів? Структура папок, список залежностей, огляд архітектури — виводяться з репозиторію.
- Чи не дублює він іншу інструкцію? Дубль у системному промпті й в описі інструмента — кандидат на видалення.
- Чи має він причину? Правило без «тому що» модель виконає буквально, навіть там, де воно недоречне.
- Чи охороняє він незворотну дію, формат або безпеку? Якщо так — лишити, переписати спокійним тоном і з причиною.
Останнє запитання — головне гальмо чистки. Видалення файлів, гроші, надсилання листів, доступ до продакшену, формат, який парсить інший сервіс, — такі межі не є милицею для слабкої моделі, і під Claude 5 вони лишаються.
Промпт «було → стало»: чистка системного промпту на прикладі
Навчальний приклад: системний промпт чат-бота підтримки інтернет-магазину, який роками доповнювали після кожного інциденту. Це шаблон для розбору, а не замір — перевіряти результат треба на своїх завданнях.
Було:
Ти — найкращий у світі асистент підтримки.
CRITICAL: You MUST ALWAYS use the search_orders tool when the user mentions an order.
ЗАВЖДИ викликай search_orders. НІКОЛИ не відповідай без перевірки замовлення.
Приклад: «Де моє замовлення 123?» → search_orders(order_id="123")
Приклад: «Замовлення 456 не прийшло» → search_orders(order_id="456")
Думай крок за кроком і випиши міркування в тегах <thinking> перед відповіддю.
Перед фінальною відповіддю перевір кожен факт двічі.
Мінімізуй виклики інструментів.
Не використовуй списки й жирний шрифт.
Не роби повернень.
Стало:
Ти відповідаєш клієнтам інтернет-магазину в чаті підтримки. Мета — розв'язати
питання за одну-дві відповіді: знайти замовлення, пояснити статус, запропонувати
наступний крок. Клієнти найчастіше пишуть із телефона, тому відповідай коротко.

Дані про замовлення — в інструменті search_orders; використовуй його, коли
питання стосується конкретного замовлення.

Повернення коштів і зміну адреси доставки ти не оформлюєш: це незворотні дії,
їх виконує оператор. Передай запит через handoff_to_human і скажи клієнтові,
коли йому дадуть відповідь.

Пиши звичайним текстом без markdown: чат-віджет не показує розмітку.
| Правка | Чому |
|---|---|
| «Найкращий у світі» → опис ролі й мети | Роль корисна, найвищий ступінь — ні; моделі потрібні мета й причина |
| CAPS і подвійне «ЗАВЖДИ/НІКОЛИ» → одна спокійна фраза | Довідка радить пом’якшувати агресивну мову; дубль однієї інструкції прибрано |
| Приклади виклику search_orders видалено | Приклади використання інструмента звужують пошук; параметр order_id говорить сам за себе |
| «Випиши міркування в | На Fable 5.1, Opus 5.5 і Sonnet 5.5 (а також Fable 5 і Opus 5) таке прохання можуть відхилити |
| «Перевір двічі», «мінімізуй виклики» видалено | Довідки з Opus 5 і Sonnet 5.5 прямо радять прибирати такі рядки |
| «Без списків і жирного» → правило з причиною | Fable 5.1: замінити заборону умовою, коли формат доречний |
| «Не роби повернень» → межа з причиною й маршрутом | Незворотна дія лишається під забороною, але модель знає, що робити натомість |
Чого бракує в новій версії, видно одразу: немає прикладів відповідей у фірмовому тоні. Якщо тон для бізнесу важливий, їх варто повернути — 3–5 коротких зразків у тегах <example>. Видаляли ми приклади виклику інструмента, а не приклади формату.
Як перевірити, що чистка не погіршила якість: міні-eval
Міні-eval — це невеликий набір реальних завдань, на якому старий і новий промпт проганяють однаково й порівнюють за заздалегідь записаними критеріями. Довідка Anthropic прямо радить перевіряти прийоми «against your own evals», а дослідження ETH Zurich про файли AGENTS.md у висновках пише те саме: будь-яку спробу поліпшити роботу агента треба суворо оцінити до викочування.
- Наберіть 15–20 завдань із реальних логів, а не вигаданих. Додайте типові запити й 3–4 неприємні: конфлікт інструкцій, прохання зробити заборонене, завдання на формат.
- Запишіть критерії до прогону. Для кожного завдання: розв’язано чи ні, чи дотримано формату, чи не було забороненої дії.
- Проженіть обидва варіанти на одній моделі з однаковими налаштуваннями. Різні моделі, рівень effort або режим мислення роблять порівняння безглуздим.
- Порівняйте частку розв’язаних завдань і витрату токенів.
- Відкочуйте конкретний рядок, а не всю чистку, якщо просіла метрика. Відчуття «стало гірше» без цифр — не привід.
Як читати результат на малій вибірці. На 20 завданнях одне завдання — це 5 процентних пунктів, тому різниця в одне завдання не відрізняється від випадковості. Наш обережний поріг відкату — евристика, а не статистичний тест: мінус два завдання й більше або хоча б одна заборонена дія в новому варіанті, і друге важливіше за будь-яке середнє. Спірний результат перевірте повторним прогоном: відповіді моделі від запуску до запуску трохи різняться.
Умовний розрахунок економії, щоб було зрозуміло, заради чого все це. Якщо системний промпт скоротився з 6 000 до 2 000 токенів, кожен запит несе на 4 000 вхідних токенів менше. На 1 000 запитів на день це 4 млн токенів на добу, які більше не треба обробляти. Цифри умовні — підставте свої обсяги й ціну вашої моделі. Якщо ввімкнено кешування промпту, повторюваний системний промпт і так оплачується за зниженою ставкою, тож у грошах виграш менший, але місце у вікні й увага моделі звільняються повністю.
Опубліковані цифри щодо такої чистки поки є тільки в OpenAI, і це її внутрішні прогони, а не незалежний тест. У довідці з GPT-5.6 (на 24 жовтня 2026 року) сказано: на вибірці прогонів кодового агента коротші системні промпти підняли оцінки приблизно на 10–15%, скоротивши токени на 41–66% і вартість на 33–67%. Сама OpenAI називає діапазони орієнтовними й радить ту саму методику, що й вище: прибирати по одній групі інструкцій, прикладів чи інструментів і перезапускати ті самі оцінки.
CLAUDE.md, скіли й автопам’ять у Claude Code: що куди класти
Context engineering у Claude Code — це розкладання інструкцій по шарах, кожен з яких має свою ціну. Щось вантажиться в кожен запит, щось — лише коли потрібно. Як написати сам файл інструкцій з нуля, розібрано в статті про CLAUDE.md у Claude Code; тут — що з нього прибрати й куди перенести.Шар Що туди класти Орієнтир із документації на 24.10.2026 Системний промпт Що це за продукт і що робить агент У Claude Code його майже не чіпають; у власному агенті тут основна робота CLAUDE.md Навіщо репозиторій + неочевидні «граблі» кодової бази Цілитися в менше ніж 200 рядків; очевидне з файлів не повторювати Скіли Рідкісні процедури: рев’ю, перевірка, деплой SKILL.md до 500 рядків, деталі — в окремі файли Опис скіла Коротко, коли він потрібен Лежить у контексті на кожному ході; бюджет списку — 1% вікна моделі Автопам’ять Ваші вподобання й поправки Увімкнена за замовчуванням у локальних сесіях; Claude пише її сам Референси Код-еталон, тести, HTML-макет, рубрика Підключаються через @-згадку файлу під час роботи (пост Anthropic)
Найдорожче місце — опис скіла. Тіло скіла читається лише під час виклику, а список назв і описів усіх скілів лежить у контексті на кожному ході, навіть якщо скіл ніколи не використовують. Довге «коли використовувати» в описі оплачується в кожному запиті. Як влаштовані скіли й прогресивне завантаження — у розборі Agent Skills у Claude Code.
Автопам’ять змінює роль CLAUDE.md. Раніше Claude Code пропонував хоткей #, щоб дописувати нотатки в CLAUDE.md, тепер модель сама зберігає те, що стосується роботи й вас. За документацією автопам’ять пропускає все, що виводиться з коду (архітектуру, шляхи до файлів, виправлення багів), і те, що вже є в CLAUDE.md. Отже, у CLAUDE.md лишається те, чого не дізнатися ні з репозиторію, ні з минулих сесій: приклад із поста — домовленість тримати всі типи в одному монолітному файлі.
Перевіряти шари вручну довго, тому в Claude Code є вбудований аудит. Команда /doctor prompt-audit (потрібна версія 2.1.283 або новіша; за даними Tproger, вона вийшла 25 вересня 2026 року) перевіряє CLAUDE.md, CLAUDE.local.md, AGENTS.md, а також правила, скіли, команди й субагентів у .claude/. Вона шукає інструкції, написані під старі моделі, посилання на файли й команди, яких немає, суперечності між файлами.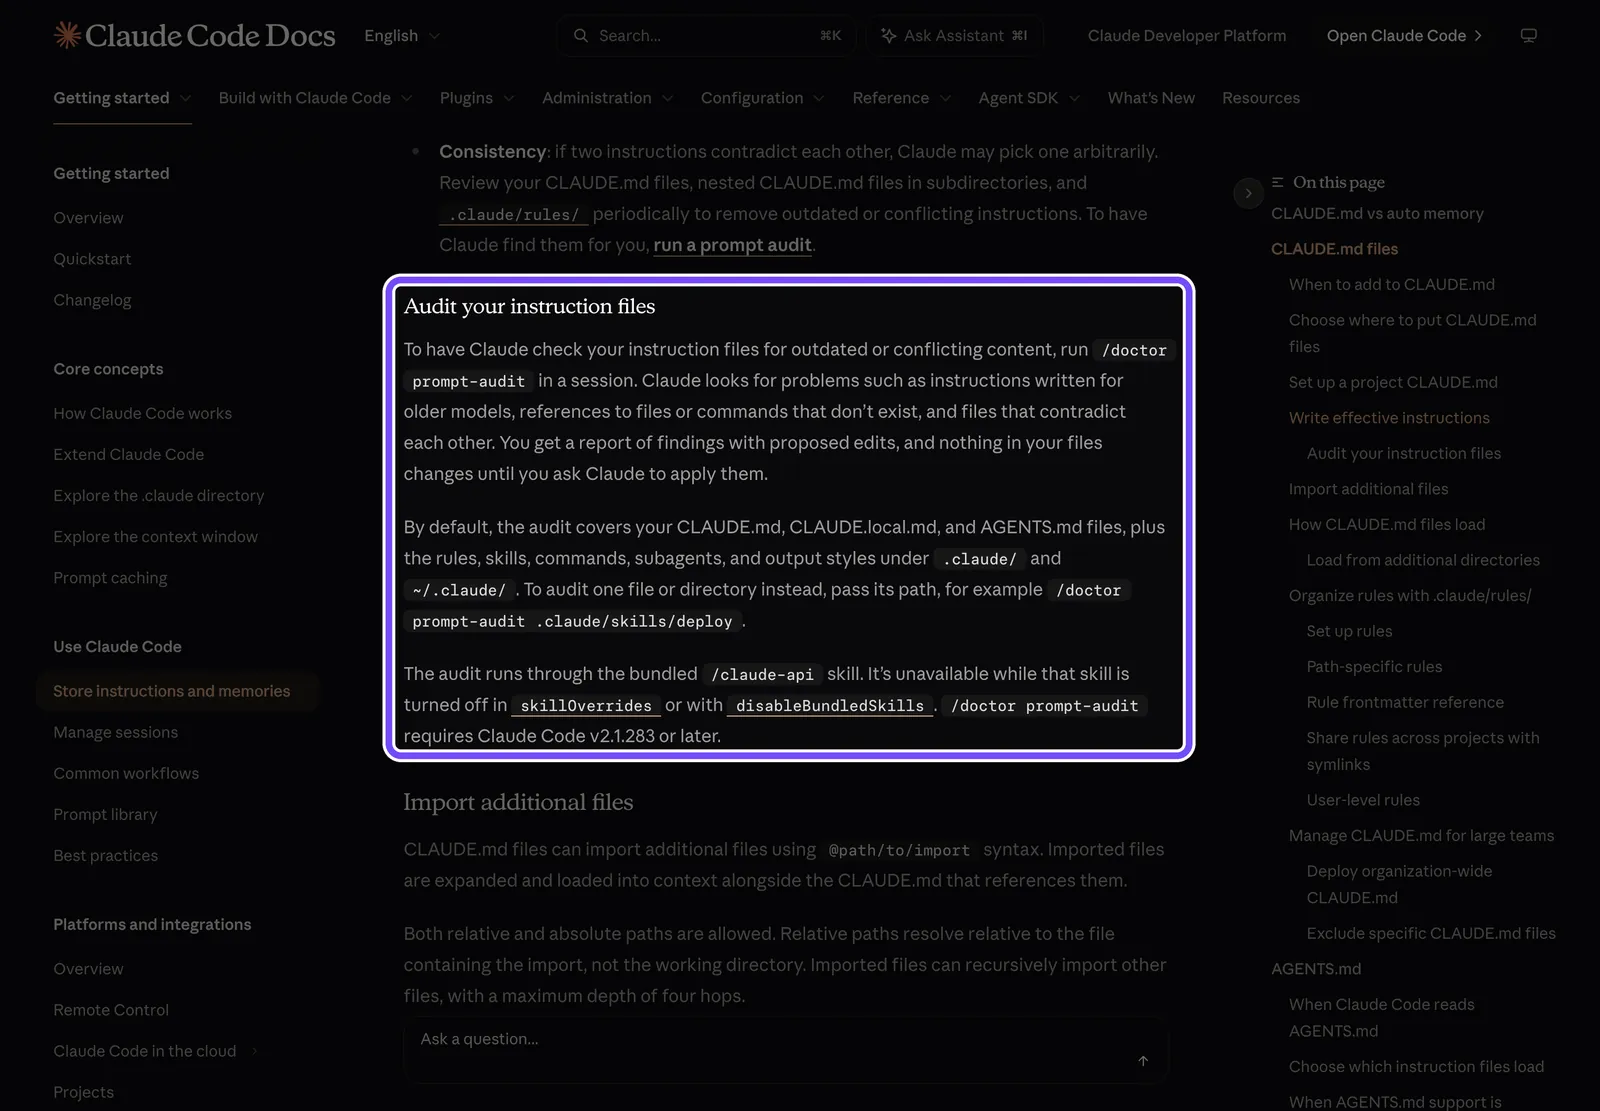
На кадрі з документації Claude Code (знято 24 жовтня 2026 року) рамкою виділено розділ «Audit your instruction files». У ньому видно три речі: аудит видає звіт із запропонованими правками й нічого не змінює, доки ви не попросите; одну папку можна перевірити окремо — /doctor prompt-audit .claude/skills/deploy; працює він через вбудований скіл /claude-api і потребує Claude Code v2.1.283.
Простий /doctor без аргументу — загальний чекап налаштувань: серед іншого він знаходить невикористовувані скіли й вміст CLAUDE.md, який виводиться з коду, і пропонує перенести інструкції, що вантажаться постійно, у скіли. Для ціни кожного скіла є окрема команда /skill-doctor, її розберемо в окремому матеріалі.
Чи працює це на GPT і Gemini: що радять OpenAI та Google
Частково. OpenAI з вересня 2026 року радить той самий напрям: менше приписів, короткі й несуперечливі описи скілів, без вимоги читати все перед кожною правкою. Google у довідці Gemini API, навпаки, і далі рекомендує завжди додавати few-shot приклади. Спільний знаменник у всіх трьох — суперечності й зайві інструкції шкодять, а мету й межі треба задавати явно.Питання Anthropic (Claude 5.x) OpenAI (GPT-5.6, GPT-6 Astra) Google (Gemini API) Скільки приписувати Мета й причина замість правил «Часто не треба приписувати кожен крок»; надто конкретні інструкції в скілах «можуть заважати там, де раніше допомагали» Чітко й прямо сформулювати мету Приклади Формат — 3–5 прикладів; інструменти — без прикладів Повторювані приклади прибирати; лишати ті, що задають вимогу продукту або виправляють заміряний провал (довідка GPT-5.6) «Рекомендуємо завжди додавати few-shot», але забагато прикладів веде до перенавчання Суперечності Модель може обрати одну інструкцію довільно Суперечливий файл скіла може зупинити роботу — Межі Для вузьких завдань в Opus 5 задавати явно Жорсткі обмеження й критерії успіху — лишити — Опис скіла Коротко, оплачується на кожному ході Якомога коротше, але зрозуміло, коли застосовувати —
В OpenAI є й зворотний ефект, якого в пості Anthropic немає. У блозі від 11 вересня 2026 року компанія попереджає: якщо попередній моделі ви писали жорсткі заборони, щоб вона не заходила задалеко, GPT-6 Astra може сприйняти їх надто серйозно й зупинитися там, де ви були б раді продовженню. Тобто застаріла межа шкодить не лише витратою токенів, а й тим, що роботу не доведено до кінця.
Загальний висновок для змішаного стеку: той самий AGENTS.md чи скіл може читати модель іншого вендора. OpenAI прямо пише, що інструкції, які допомагали її попереднім моделям, можуть сковувати нову, — і радить думати, які моделі читатимуть ваші файли.
Коли чистити промпт не треба і чим це ризикує
Чистка під Claude 5 — не універсальна порада. Є сценарії, де старі інструкції виправдані, і є ризики, про які перекази поста мовчать.
- Старі моделі в продакшені. Висновки поста стосуються «моделей на кшталт Opus 5 і Fable 5». Для Sonnet 4.6 і Haiku 4.5 у довідці лишаються старі рекомендації, а довідка прямо вимагає перевіряти техніку під час перенесення на іншу модель.
- Незворотні дії та безпека. Видалення даних, платежі, надсилання листів, доступ до продакшену лишаються під явною забороною з причиною.
- Формат, який читає машина. Якщо відповідь парсить інший сервіс, суворий формат — не милиця, а контракт.
- Opus 5 потрібні межі, а не свобода. Довідка з Opus 5: модель сама перевіряє свою роботу й може розширювати завдання, додаючи кроки, про які не просили. Для вузьких завдань рамку треба задавати явно.
| Ризик | Що відомо | На яку дату |
|---|---|---|
| «80% без втрат» не перевірено | Заява Anthropic без диффа й цифр оцінок | 24.07.2026 |
| Промпт для Opus 5 знову виріс | Сторонній замір: 7694 символи в Opus 5 проти 4467 в Opus 4.8 (+72%) і 15225 в Opus 4.7 | 27.07.2026 |
| Контекстні файли не завжди допомагають | ETH: частка розв’язаних завдань у середньому не зростає, вартість +20% і більше | 29.09.2026 |
| Аудит моделі — теж думка моделі | /doctor prompt-audit пропонує правки, а не гарантує їхню користь | 24.10.2026 |
Цифра «+72%» схожа на спростування поста, але ним не є. Її навів китайський портал QbitAI з посиланням на розробника Chen Cheng (переказ — 36Kr), і порівнюються в ній різні пари: «80%» Anthropic — це шлях від старого промпту до нового, а «+72%» — Opus 5 проти Opus 4.8. За тим самим переказом основне скорочення припало на перехід від Opus 4.7 до 4.8.
Що саме додалося, розробник теж подивився: за переказом 36Kr, майже всю різницю, близько 3 755 символів, дають два розділи, які є тільки в промпті для Opus 5, — «Delivering work» (рамки завдання, звіти про хід роботи, здача результату) і «Corrections» (обмеження на повторні розбори власних помилок). Це збігається з довідкою з Opus 5: модель сама перевіряє роботу, розширює завдання й охоче делегує його субагентам Claude Code, тому для вузьких завдань довідка радить ставити рамки явно, а про сам Claude Code пише, що на Opus 5 він додає власну інструкцію щодо делегування. Офіційно Anthropic склад приросту не коментувала, а сам замір одиничний — ми його не відтворювали.
З того самого розбору випливає ще одна деталь: Claude Code тримає два набори системних промптів і обирає їх залежно від моделі. Докладний старий отримують Sonnet, Haiku і старі Opus, скорочений новий — Opus 5 і Fable 5. Тобто сама Anthropic не переносить чистку на моделі, для яких її не перевірено.
Дослідження ETH Zurich (arXiv 2602.11988, версія від 29 вересня 2026 року) додає незалежний сигнал: контекстні файли на кшталт AGENTS.md у середньому не підвищують частку розв’язаних завдань і піднімають вартість запуску більш ніж на 20%. Огляди репозиторію, які радять вендори, виявилися марними, а от інструкції агенти виконують. Це працює в обидва боки: вдалий рядок спрацює, невдалий — теж, буквально. Застереження: моделі в дослідженні — не лінійка Claude 5.
Кейси: як чистили Claude Code, AGENTS.md і опис скіла
Три публічні приклади, де видно і «було», і «стало». Усі три — з першоджерел вендорів, а не з переказів.
Коментарі в коді в Claude Code
Було: правило «за замовчуванням не писати коментарів, жодних багаторядкових docstring, щонайбільше один короткий рядок», плюс заборона створювати документи з планами без прохання користувача. Стало: «пиши код так, як навколишній: та сама щільність коментарів, назви й ідіоми». Одна фраза закриває всі випадки — і проєкт без коментарів, і складний модуль, де багаторядковий коментар доречний, — бо спирається на контекст, а не на заборону.
Опис скіла для міграцій Postgres в OpenAI
Поганий опис: «Create and validate Postgres schema migrations. Use when working with databases, queries, models, or persistence». Добрий: «…Use when adding or changing a migration, or reviewing its rollout». За поясненням OpenAI, перша версія штовхає модель вмикати скіл за будь-якого дотику до бази даних, хоча він потрібен лише для міграцій. Опис став точнішим, а не довшим.
AGENTS.md «прочитай усе перед кожною правкою»
Погано: «Before every edit, read architecture.md, database.md, and deployment.md». Добре: architecture.md — для меж сервісів, database.md — для змін схеми, deployment.md — під час підготовки деплою. OpenAI називає вимогу читати стос документів перед кожною правкою зайвою для виправлення одруківки: це спалює контекст і сповільнює роботу. Посилання на документи лишаються корисними, якщо вони прив’язані до ситуації.
FAQ
Чи треба прибирати приклади з промптів для Claude 5?
Не всі. Пост Anthropic говорить про приклади виклику інструментів: у нових моделей вони звужують простір пошуку, і замість них краще поліпшити параметри й опис інструмента. Приклади формату, тону й структури довідка Anthropic на 24 жовтня 2026 року і далі радить — 3–5 різноманітних зразків у тегах <example>, без спроби перелічити всі крайові випадки.
Чим context engineering відрізняється від prompt engineering?
Prompt engineering — це формулювання одного запиту під конкретне завдання. Context engineering — робота з усім, що модель бачить разом із запитом: системним промптом, CLAUDE.md, скілами, пам’яттю, файлами й описами інструментів. Контекст обслуговує сотні різних запитів, тому в ньому не можна бути таким самим конкретним, як у промпті, і ціна кожного зайвого рядка вища.
Чи варто прибирати CAPS і MUST зі старих промптів?
Так, здебільшого. Довідка Anthropic радить пом’якшувати формулювання на кшталт «CRITICAL: You MUST use this tool» до звичайного «Use this tool when…»: пораду написано для Opus 4.5 і 4.6, які уважніші за попередні моделі до системного промпту, і гучна інструкція в них веде до перегину. Для лінійки 5.x окремого правила немає, але логіка та сама. Виняток — незворотні дії: заборона лишається, але спокійним тоном і з причиною.
Як зрозуміти, що правило в CLAUDE.md застаріло?
Поставте йому запитання: що зламається, якщо рядок видалити? Застаріле правило зазвичай страхує від помилки, якої нова модель уже не робить, повторює те, що видно з коду, дублює іншу інструкцію або не має причини. Документація Claude Code радить тримати CLAUDE.md коротшим за 200 рядків і витрачати його на неочевидні «граблі» проєкту.
Що робить /doctor prompt-audit і з якої версії він доступний?
Команда перевіряє CLAUDE.md, AGENTS.md, правила, скіли, команди й субагентів на інструкції під старі моделі, посилання на відсутні файли й суперечності між файлами. Вона видає звіт із запропонованими правками й нічого не змінює без вашої команди. Потрібен Claude Code версії 2.1.283 або новішої; перевірити один файл чи папку можна, передавши шлях.
Чи зламаються старі промпти на Claude 5, якщо нічого не змінювати?
Як правило, ні: моделі й далі виконують інструкції. Проблема в іншому — зайві рядки коштують токенів у кожному запиті, суперечності змушують модель обирати між ними, а застарілі заборони сковують її там, де вона впоралася б краще. Opus 5 зі старою інструкцією «перевір усе» просто перевіряє двічі й витрачає більше.
Чи підходять нові правила для GPT і Gemini?
Частково. OpenAI у 2026 році радить той самий напрям: менше покрокових приписів, короткі описи скілів, жодних суперечностей. Google у довідці Gemini API і далі рекомендує завжди додавати few-shot приклади, попереджаючи лише про перенавчання на завеликій їх кількості. Спільне в усіх трьох вендорів — явні цілі й межі за меншої кількості зайвих правил.