Коротко (TL;DR)
Context engineering для Claude 5 — это сборка всего, что модель получает вместе с вашим запросом: системного промпта, CLAUDE.md, скиллов, памяти, файлов-референсов. 24 июля 2026 года Anthropic сообщила, что убрала из системного промпта Claude Code больше 80% текста для моделей вроде Opus 5 и Fable 5 и не увидела измеримых потерь на своих оценках по коду. Ниже — что из этого следует для ваших промптов и как проверить это на своих задачах, а не на вере.
- Коротко (TL;DR)
- Что Anthropic сказала про Claude 5 — и чего нет в её посте
- Как это работает: почему лишние правила мешают Claude 5
- Шесть старых привычек и чем их заменить для Claude 5
- Примеры, роль, CAPS и «думай шаг за шагом»: что вредит, а что нет
- Аудит промпта под Claude 5: пошаговый чек-лист
- Промпт «было → стало»: чистка системного промпта на примере
- Как проверить, что чистка не уронила качество: мини-eval
- CLAUDE.md, скиллы и автопамять в Claude Code: что куда класть
- Работает ли это на GPT и Gemini: что советуют OpenAI и Google
- Когда чистить промпт не нужно и чем это рискует
- Кейсы: как чистили Claude Code, AGENTS.md и описание скилла
- FAQ
- Что устарело: жёсткие правила «на все случаи», примеры вызова инструментов, повторы одной инструкции в двух местах, CLAUDE.md как свалка всех практик.
- Что осталось: цель и причина запроса, формат вывода, границы задачи, запрет необратимых действий. Примеры для формата и тона справка Anthropic по-прежнему советует — 3–5 штук.
- Что делать: пройти каждую строку промпта пятью вопросами, убрать костыли под старые модели, вынести редкие инструкции в скиллы.
- Как не сломать: прогнать старый и новый вариант на 15–20 реальных задачах и откатывать строку, если просела метрика.
- Чем помочь себе: в Claude Code 2.1.283+ есть
/doctor prompt-audit— он находит устаревшие и противоречивые инструкции, но ничего не меняет без вашей команды.
Что Anthropic сказала про Claude 5 — и чего нет в её посте
Первоисточник — пост Тарика Шихипара (Thariq Shihipar, технический сотрудник Anthropic) The new rules of context engineering for Claude 5 generation models, опубликованный 24 июля 2026 года. Главная фраза поста: «We removed over 80% of Claude Code’s system prompt for models like Claude Opus 5 and Claude Fable 5 with no measurable loss on our coding evaluations». То есть больше 80% системного промпта убрано, а измеримых потерь на внутренних оценках по коду нет.
Важно, что именно сказано, а чего нет. В посте нет диффа старого и нового промпта, нет названий оценок и нет ни одной цифры качества. «Без потерь» — это заявление самой Anthropic, независимо его никто не воспроизвёл. Пересказы поста, включая выпуск DOU «AI шумлять», местами усиливают его — сверка ниже.Что говорят в пересказах Что в первоисточнике «Качество не упало ни на пункт» «No measurable loss on our coding evaluations» — без цифр и методики Четыре правила «было → стало» Шесть пар Then/Now: правила, примеры, всё сразу, повторы, память, спеки «Примеры теперь портят результат» Речь о примерах вызова инструментов; справка по промптам советует 3–5 примеров для формата Сокращали для Opus 4.5 и Sonnet 4.5 (MindStudio) В посте — «модели вроде Opus 5 и Fable 5» 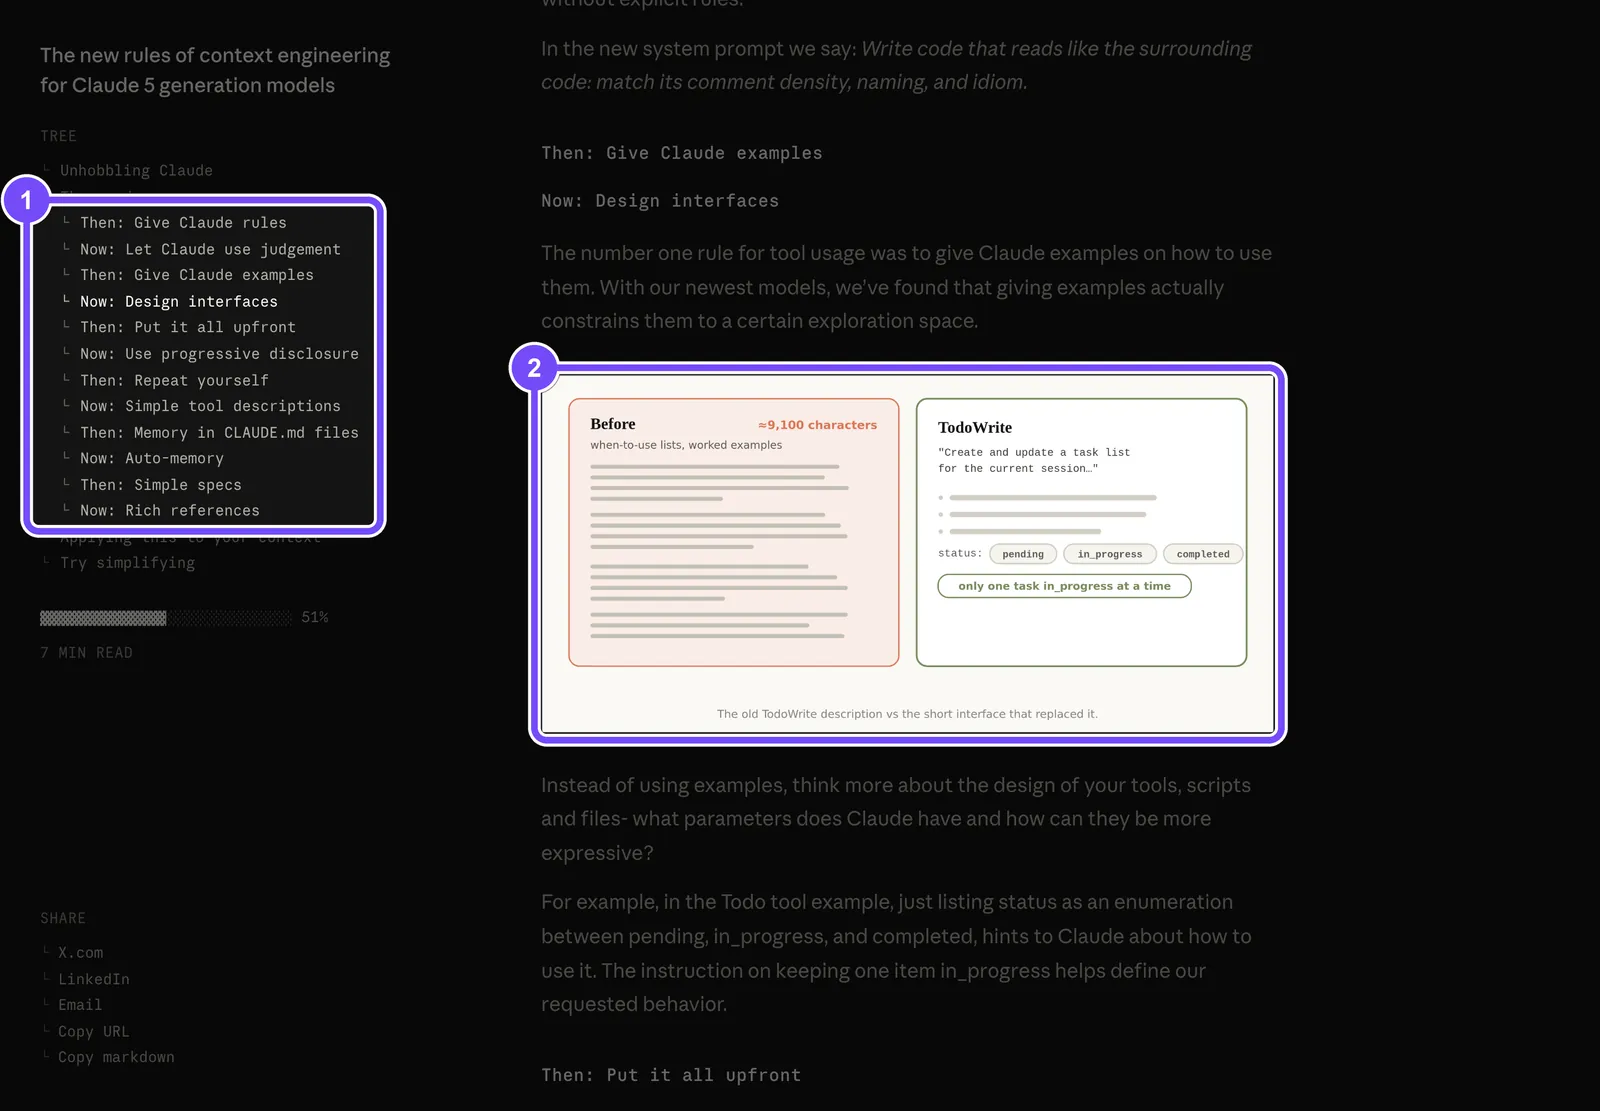
На кадре со страницы поста (снят 24 октября 2026 года) рамка 1 выделяет оглавление: все шесть пар «Then / Now» видны подряд. Рамка 2 — иллюстрация из раздела про примеры: старое описание инструмента TodoWrite со списками «когда использовать» и разобранными примерами против короткого интерфейса со статусами pending, in_progress, completed.
Пост писался о двух моделях, а линейка с тех пор обновилась. На 24 октября 2026 года в справке Anthropic актуальны Claude Fable 5.1, Claude Opus 5.5, Sonnet 5.5 и Haiku 5.5 (ID claude-fable-5-1, claude-opus-5-5, claude-sonnet-5-5, claude-haiku-5-5), и для каждой есть своя страница с советами по промптам. Выводы поста к ним применимы с оговоркой: справка прямо пишет, что технику, проверенную на одной модели, нужно перепроверять на своих оценках, прежде чем переносить на другую.
Как это работает: почему лишние правила мешают Claude 5
Context engineering — это работа не с одним запросом, а со всем контекстом, который модель видит при каждом ответе. Подробно о самом понятии и о том, почему длинный контекст «портится», — в разборе контекст-инжиниринга для ИИ-агентов. Здесь важно одно отличие: промпт пишется под конкретную задачу, а контекст работает сразу на сотни разных запросов, поэтому он не может быть таким же конкретным.
Отсюда главная проблема, которую Anthropic нашла у себя. Читая логи собственной работы в Claude Code, команда видела в одном запросе противоречащие указания: системный промпт, скилл и пользователь одновременно говорили «leave documentation as appropriate» и «DO NOT add comments». Claude обычно угадывает, чего хочет человек, но на разбор конфликта тратит лишнее рассуждение. Документация Claude Code добавляет: если две инструкции противоречат друг другу, модель может выбрать одну произвольно.
Вторая причина — правила, которые были нужны слабым моделям. Раньше системный промпт Claude Code требовал: «In code: default to writing no comments. Never write multi-paragraph docstrings…». Для части задач это было неверно: у пользователя свои предпочтения, а сложному коду иногда нужен длинный комментарий. Старым моделям правило всё равно было выгоднее, чем свобода. В новом промпте его заменила одна фраза: «Write code that reads like the surrounding code: match its comment density, naming, and idiom» — пиши так, как написан окружающий код.
Третье — баланс между конкретикой и свободой. Автор полевого гайда по Fable 5 формулирует его так: слишком конкретная инструкция заставит Claude следовать ей, даже когда разумнее свернуть; слишком расплывчатая — и модель примет решения по «отраслевым практикам», которые вам могут не подойти. Ещё в сентябре 2025 года Anthropic называла это «правильной высотой» промпта и отдельно оговаривала, что минимальный набор инструкций не означает короткий.
Поэтому новые правила context engineering for Claude 5 models сводятся не к «пиши меньше», а к «пиши о цели и причинах». Справка по Fable 5 подтверждает это прямо: модель лучше работает, когда в промпте назван замысел запроса, и большинством поведения можно управлять короткой инструкцией вместо перечисления случаев. Как устроен хороший промпт с нуля — в отдельном руководстве по структуре промпта; эта статья про чистку того, что уже накопилось.
Шесть старых привычек и чем их заменить для Claude 5
Пост Anthropic построен как шесть пар «было → стало». В таблице — каждая пара и то, что она означает для вашего собственного промпта или CLAUDE.md.



| Было (Then) | Стало (Now) | Что сделать у себя |
|---|---|---|
| Давать Claude правила | Доверить суждение | Заменить жёсткие запреты на описание цели и критерия: «как в окружающем коде» вместо «никогда не пиши комментарии» |
| Давать примеры использования инструментов | Проектировать интерфейсы | Вместо примеров вызова — выразительные параметры: перечисление статусов, понятные имена полей |
| Класть всё сразу | Прогрессивное раскрытие | Редкие инструкции (код-ревью, проверка) вынести в скиллы и отдельные файлы, которые грузятся по требованию |
| Повторять одно и то же | Простые описания инструментов | Инструкцию по инструменту держать в его описании, а не дублировать в системном промпте |
| Память в CLAUDE.md | Автопамять | Не записывать в CLAUDE.md каждую поправку руками: предпочтения Claude сохраняет сам |
| Простые спеки в markdown | Богатые референсы | Давать эталон в коде, набор тестов, HTML-макет или рубрику вместо словесного описания |
Две пары из шести в пересказах обычно теряются. «Повторы»: ранние модели лучше слушались инструкций в конце контекста, поэтому упоминания инструментов дублировались в системном промпте и в описании самого инструмента — теперь дубли удалены. «Референсы»: спецификацией может быть подробный набор тестов или функция в другой кодовой базе, которую нужно портировать, а HTML-макет дизайна, по наблюдению Anthropic, обычно даёт результат лучше, чем словесное описание или скриншот.
Если свести таблицу к одному правилу, context engineering для Claude 5 сводится к вопросу «зачем эта строка здесь?». Строка, которая страхует от ошибки старой модели, теперь стоит токенов на каждом запросе и может спорить с остальными. Строка, которая сообщает модели то, чего она не может узнать сама, остаётся.
Примеры, роль, CAPS и «думай шаг за шагом»: что вредит, а что нет
Самое частое искажение поста — «примеры теперь вредят». В посте сказано конкретнее: «The number one rule for tool usage was to give Claude examples», а с новыми моделями такие примеры «constrains them to a certain exploration space» — сужают пространство поиска. Речь о примерах вызова инструментов. Справка по промптам в той же Anthropic на 24 октября 2026 года советует обратное для формата и тона: «Include 3–5 examples for best results».
На кадре из справки Prompting best practices (снят 24 октября 2026 года) рамка 1 — подсказка «Include 3–5 examples for best results» в разделе о примерах, рамка 2 — раздел «Give Claude a role»: роль в системном промпте по-прежнему рекомендована, и даже одно предложение меняет поведение и тон.Приём Что говорит Anthropic на 24.10.2026 Вердикт для Claude 5 Примеры формата и тона (few-shot) 3–5 разнообразных примеров в тегах <example>Оставить, но без свалки всех краевых случаев Примеры вызова инструментов Сужают поиск у новых моделей Убрать, улучшить параметры и описание инструмента Роль в системном промпте Фокусирует поведение и тон Оставить: даже одно предложение заметно влияет CAPS и «CRITICAL: You MUST…» Смягчить до «Use this tool when…» (сказано про Opus 4.5–4.6; отдельного правила для 5.x нет) Смягчить: громкая инструкция у внимательной модели ведёт к перегибу «Думай шаг за шагом, выпиши рассуждение» На Fable 5.1, Opus 5.5 и Sonnet 5.5 такая просьба может быть отклонена Убрать, опираться на встроенное мышление «Перепроверь дважды», «финальная проверка» Opus 5 проверяет себя сам, лишняя проверка тратит токены Убрать «Не используй списки и жирный» Fable 5.1: убрать или заменить правилом, когда формат уместен Заменить условием с причиной
Про CAPS нужна оговорка: в справке совет смягчить агрессивный язык написан как лекарство от «перерабатывания» у моделей 4.5–4.6, отдельного запрета для линейки 5.x там нет. Логика при этом та же — громкая инструкция для внимательной модели превращается в навязчивую.
Отдельная страница справки про prompt engineering для Claude Opus 5.5 добавляет ещё одну строку на удаление: инструкции «думай внимательно перед ответом» в системном промпте чата. В тестах Anthropic после удаления такой строки ответы начинались раньше без явного падения качества. Оговорка та же: это проверено в чат-сценарии, на ваших задачах результат нужно мерить.
Аудит промпта под Claude 5: пошаговый чек-лист
Аудит — это проход по каждой строке контекста с одним вопросом: что сломается, если её удалить? Порядок такой.
- Соберите все слои в одно место. Системный промпт, все CLAUDE.md (корень, подпапки, пользовательский), правила в
.claude/rules/, описания скиллов, AGENTS.md. Конфликты почти всегда живут на стыке слоёв, поэтому смотреть файлы по одному бесполезно. - Найдите противоречия. Ищите пары вроде «оставляй документацию по ситуации» и «не добавляй комментарии». Каждую пару сведите к одной формулировке с причиной.
- Задайте каждой строке пять вопросов (список ниже) и пометьте: оставить, убрать, перенести.
- Перепишите оставшееся через цель и причину. «Отвечай без markdown» → «Отвечай обычным текстом: виджет не показывает разметку».
- Вынесите редкое в скиллы. Инструкции, нужные в одной задаче из двадцати, не должны грузиться в каждую.
- Сверьтесь со справкой под свою модель. Для Claude Opus 5.5 у Anthropic есть отдельный prompt guide — страница «Prompting Claude Opus 5.5»; у Fable 5.1, Sonnet 5.5 и Haiku 5.5 — свои. Там перечислены строки, которые для конкретной модели стоит удалить.
- Прогоните мини-eval (раздел ниже) и только потом выкатывайте новую версию.
Пять вопросов к каждой строке:
- Страхует ли она от ошибки, которую новая модель уже не делает? «Перепроверь ответ», «минимизируй вызовы инструментов», «держи все находки до финального ответа» — справки по Opus 5, Fable 5.1 и Sonnet 5.5 прямо советуют удалить такие строки.
- Может ли модель узнать это сама из кода или файлов? Структура папок, список зависимостей, обзор архитектуры — выводятся из репозитория.
- Не дублирует ли она другую инструкцию? Дубль в системном промпте и в описании инструмента — кандидат на удаление.
- Есть ли у неё причина? Правило без «потому что» модель выполнит буквально, даже там, где оно неуместно.
- Охраняет ли она необратимое действие, формат или безопасность? Если да — оставить, переписать спокойным тоном и с причиной.
Последний вопрос — главный тормоз чистки. Удаление файлов, деньги, отправка писем, доступ к продакшену, формат, который парсит другой сервис, — такие границы не являются костылём для слабой модели, и под Claude 5 они остаются.
Промпт «было → стало»: чистка системного промпта на примере
Учебный пример: системный промпт чат-бота поддержки интернет-магазина, который годами дополняли после каждого инцидента. Это шаблон для разбора, а не замер — проверять результат нужно на своих задачах.
Было:
Ты — лучший в мире ассистент поддержки.
CRITICAL: You MUST ALWAYS use the search_orders tool when the user mentions an order.
ВСЕГДА вызывай search_orders. НИКОГДА не отвечай без проверки заказа.
Пример: «Где мой заказ 123?» → search_orders(order_id="123")
Пример: «Заказ 456 не пришёл» → search_orders(order_id="456")
Думай шаг за шагом и выпиши рассуждение в тегах <thinking> перед ответом.
Перед финальным ответом перепроверь каждый факт дважды.
Минимизируй вызовы инструментов.
Не используй списки и жирный шрифт.
Не делай возвратов.
Стало:
Ты отвечаешь клиентам интернет-магазина в чате поддержки. Цель — решить вопрос
за один-два ответа: найти заказ, объяснить статус, предложить следующий шаг.
Клиенты чаще пишут с телефона, поэтому отвечай коротко и по делу.

Данные о заказах — в инструменте search_orders; используй его, когда вопрос
касается конкретного заказа.

Возврат денег и смену адреса доставки ты не оформляешь: это необратимые
действия, их делает оператор. Передай запрос через handoff_to_human и скажи
клиенту, когда ему ответят.

Пиши обычным текстом без markdown: чат-виджет не отображает разметку.
| Правка | Почему |
|---|---|
| «Лучший в мире» → описание роли и цели | Роль полезна, превосходная степень — нет; модели нужна цель и причина |
| CAPS и двойное «ВСЕГДА/НИКОГДА» → одна спокойная фраза | Справка советует смягчать агрессивный язык; дубль одной инструкции убран |
| Примеры вызова search_orders удалены | Примеры использования инструмента сужают поиск; параметр order_id говорит сам за себя |
| «Выпиши рассуждение в | На Fable 5.1, Opus 5.5 и Sonnet 5.5 (а также Fable 5 и Opus 5) такая просьба может быть отклонена |
| «Перепроверь дважды», «минимизируй вызовы» удалены | Справки Opus 5 и Sonnet 5.5 прямо советуют убирать такие строки |
| «Без списков и жирного» → правило с причиной | Fable 5.1: заменить запрет условием, когда формат уместен |
| «Не делай возвратов» → граница с причиной и маршрутом | Необратимое действие остаётся под запретом, но модель знает, что делать вместо |
Чего в новой версии не хватает, видно сразу: нет примеров ответов в фирменном тоне. Если тон для бизнеса важен, их стоит вернуть — 3–5 коротких образцов в тегах <example>. Удаляли мы примеры вызова инструмента, а не примеры формата.
Как проверить, что чистка не уронила качество: мини-eval
Мини-eval — это небольшой набор реальных задач, на котором старый и новый промпт прогоняют одинаково и сравнивают по заранее записанным критериям. Справка Anthropic прямо советует перепроверять приёмы «against your own evals», а исследование ETH Zurich о файлах AGENTS.md в выводах пишет то же: любую попытку улучшить работу агента нужно строго оценивать до выката.
- Наберите 15–20 задач из реальных логов, а не придуманных. Включите типичные запросы и 3–4 неприятных: конфликт инструкций, просьбу сделать запрещённое, задачу на формат.
- Запишите критерии до прогона. По каждой задаче: решена или нет, соблюдён ли формат, не было ли запрещённого действия.
- Прогоните оба варианта на одной модели с одинаковыми настройками. Разные модели, уровень effort или режим мышления делают сравнение бессмысленным.
- Сравните долю решённых задач и расход токенов.
- Откатывайте конкретную строку, а не всю чистку, если просела метрика. Ощущение «стало хуже» без цифр — не повод.
Как читать результат на маленькой выборке. На 20 задачах одна задача — это 5 процентных пунктов, поэтому разница в одну задачу не отличима от случайности. Наш осторожный порог отката — эвристика, а не статистический тест: минус две задачи и больше либо хотя бы одно запрещённое действие в новом варианте, и второе важнее любой средней. Спорный результат перепроверьте повторным прогоном: ответы модели от запуска к запуску немного различаются.
Условный расчёт экономии, чтобы было понятно, ради чего всё это. Если системный промпт сократился с 6 000 до 2 000 токенов, каждый запрос несёт на 4 000 входных токенов меньше. На 1 000 запросов в день это 4 млн токенов в сутки, которые больше не нужно обрабатывать. Цифры условные — подставьте свои объёмы и цену вашей модели. Если включено кэширование промпта, повторяющийся системный промпт и так оплачивается по сниженной ставке, поэтому в деньгах выигрыш меньше, но место в окне и внимание модели освобождаются полностью.
Опубликованные цифры по такой чистке пока есть только у OpenAI, и это её внутренние прогоны, а не независимый тест. В справке по GPT-5.6 (на 24 октября 2026 года) сказано: на выборке прогонов кодового агента более короткие системные промпты подняли оценки примерно на 10–15%, сократив токены на 41–66% и стоимость на 33–67%. Сама OpenAI называет диапазоны ориентировочными и советует ту же методику, что выше: убирать по одной группе инструкций, примеров или инструментов и перезапускать те же оценки.
CLAUDE.md, скиллы и автопамять в Claude Code: что куда класть
Context engineering в Claude Code — это раскладка инструкций по слоям, у каждого из которых своя цена. Что-то загружается в каждый запрос, что-то — только когда нужно. Как написать сам файл инструкций с нуля, разобрано в статье про CLAUDE.md в Claude Code; здесь — что из него убрать и куда перенести.Слой Что туда класть Ориентир из документации на 24.10.2026 Системный промпт Что за продукт и что делает агент В Claude Code его почти не трогают; в своём агенте здесь основная работа CLAUDE.md Зачем репозиторий + неочевидные «грабли» кодовой базы Целиться в менее 200 строк; очевидное из файлов не повторять Скиллы Редкие процедуры: ревью, проверка, деплой SKILL.md до 500 строк, детали — в отдельные файлы Описание скилла Коротко, когда он нужен Лежит в контексте на каждом ходу; бюджет списка — 1% окна модели Автопамять Ваши предпочтения и поправки Включена по умолчанию в локальных сессиях; Claude пишет её сам Референсы Код-эталон, тесты, HTML-макет, рубрика Подключаются через @-упоминание файла по ходу задачи (пост Anthropic)
Самое дорогое место — описание скилла. Тело скилла читается только при вызове, а список имён и описаний всех скиллов лежит в контексте на каждом ходу, даже если скилл никогда не используется. Длинное «когда использовать» в описании оплачивается в каждом запросе. Как устроены скиллы и прогрессивная загрузка — в разборе Agent Skills в Claude Code.
Автопамять меняет роль CLAUDE.md. Раньше Claude Code предлагал хоткей #, чтобы дописывать заметки в CLAUDE.md, теперь модель сама сохраняет то, что относится к работе и к вам. По документации автопамять пропускает всё, что выводится из кода (архитектуру, пути к файлам, исправления багов), и то, что уже есть в CLAUDE.md. Значит, в CLAUDE.md остаётся то, чего не узнать ни из репозитория, ни из прошлых сессий: пример из поста — договорённость держать все типы в одном монолитном файле.
Проверять слои руками долго, поэтому в Claude Code есть встроенный аудит. Команда /doctor prompt-audit (нужна версия 2.1.283 или новее; по данным Tproger, она вышла 25 сентября 2026 года) проверяет CLAUDE.md, CLAUDE.local.md, AGENTS.md, а также правила, скиллы, команды и субагентов в .claude/. Она ищет инструкции, написанные под старые модели, ссылки на несуществующие файлы и команды, противоречия между файлами.
На кадре из документации Claude Code (снят 24 октября 2026 года) рамкой выделен раздел «Audit your instruction files». В нём видно три вещи: аудит выдаёт отчёт с предложенными правками и ничего не меняет, пока вы не попросите; одну папку можно проверить отдельно — /doctor prompt-audit .claude/skills/deploy; работает он через встроенный скилл /claude-api и требует Claude Code v2.1.283.
Простой /doctor без аргумента — общий чекап настройки: среди прочего он находит неиспользуемые скиллы и содержимое CLAUDE.md, которое выводится из кода, и предлагает перенести постоянно загружаемые инструкции в скиллы. Для цены каждого скилла есть отдельная команда /skill-doctor, её разберём в отдельном материале.
Работает ли это на GPT и Gemini: что советуют OpenAI и Google
Частично. OpenAI с сентября 2026 года советует то же направление: меньше предписаний, короткие и непротиворечивые описания скиллов, без требования читать всё перед каждой правкой. Google в справке Gemini API, наоборот, по-прежнему рекомендует всегда добавлять few-shot примеры. Общий знаменатель у всех трёх — противоречия и лишние инструкции вредят, а цель и границы нужно задавать явно.Вопрос Anthropic (Claude 5.x) OpenAI (GPT-5.6, GPT-6 Astra) Google (Gemini API) Сколько предписывать Цель и причина вместо правил «Часто не нужно предписывать каждый шаг»; слишком конкретные инструкции в скиллах «могут мешать там, где раньше помогали» Чётко и прямо сформулировать цель Примеры Формат — 3–5 примеров; инструменты — без примеров Повторяющиеся примеры убирать; оставлять те, что задают требование продукта или чинят замеренный провал (справка GPT-5.6) «Рекомендуем всегда включать few-shot», но много примеров ведёт к переобучению Противоречия Модель может выбрать одну инструкцию произвольно Противоречивый файл скилла может остановить работу — Границы Для узких задач у Opus 5 задавать явно Жёсткие ограничения и критерии успеха — оставить — Описание скилла Коротко, оплачивается на каждом ходу Как можно короче, но понятно, когда применять —
У OpenAI есть и обратный эффект, которого в посте Anthropic нет. В блоге от 11 сентября 2026 года компания предупреждает: если прежней модели вы писали жёсткие запреты, чтобы она не заходила слишком далеко, GPT-6 Astra может воспринять их слишком серьёзно и остановиться там, где вы были бы рады продолжению. То есть устаревшая граница вредит не только расходом токенов, но и тем, что работа не доделана.
Общий вывод для смешанного стека: один и тот же AGENTS.md или скилл может читать модель другого вендора. OpenAI прямо пишет, что инструкции, которые помогали её прошлым моделям, могут сковывать новую, — и советует думать, какие модели будут читать ваши файлы.
Когда чистить промпт не нужно и чем это рискует
Чистка под Claude 5 — не универсальный совет. Есть сценарии, где старые инструкции оправданы, и есть риски, о которых пересказы поста молчат.
- Старые модели в проде. Выводы поста относятся к «моделям вроде Opus 5 и Fable 5». Для Sonnet 4.6 и Haiku 4.5 в справке остаются старые рекомендации, а справка прямо требует перепроверять технику при переносе на другую модель.
- Необратимые действия и безопасность. Удаление данных, платежи, отправка писем, доступ к продакшену остаются под явным запретом с причиной.
- Формат, который читает машина. Если ответ парсит другой сервис, строгий формат — не костыль, а контракт.
- Opus 5 нужны границы, а не свобода. Справка по Opus 5: модель сама проверяет свою работу и может расширять задачу, добавляя шаги, о которых не просили. Для узких задач рамку нужно задавать явно.
| Риск | Что известно | На какую дату |
|---|---|---|
| «80% без потерь» не проверено | Заявка Anthropic без диффа и цифр оценок | 24.07.2026 |
| Промпт для Opus 5 снова вырос | Сторонний замер: 7694 символа у Opus 5 против 4467 у Opus 4.8 (+72%) и 15225 у Opus 4.7 | 27.07.2026 |
| Контекстные файлы не всегда помогают | ETH: доля решённых задач в среднем не растёт, стоимость +20% и больше | 29.09.2026 |
| Аудит модели — тоже мнение модели | /doctor prompt-audit предлагает правки, а не гарантирует их пользу | 24.10.2026 |
Цифра «+72%» выглядит как опровержение поста, но им не является. Её привёл китайский портал QbitAI со ссылкой на разработчика Chen Cheng (пересказ — 36Kr), и сравниваются в ней разные пары: «80%» Anthropic — это путь от старого промпта к новому, а «+72%» — Opus 5 против Opus 4.8. По тому же пересказу основное сокращение пришлось на переход от Opus 4.7 к 4.8. Что именно добавилось, разработчик тоже посмотрел: по пересказу 36Kr, почти всю разницу, около 3 755 символов, дают два раздела, которые есть только в промпте для Opus 5, — «Delivering work» (рамки задачи, отчёты о ходе работы, сдача результата) и «Corrections» (ограничение на повторные разборы собственных ошибок). Это сходится со справкой по Opus 5: модель сама проверяет работу, расширяет задачу и охотно делегирует её субагентам Claude Code, поэтому для узких задач справка советует ставить рамки явно, а про сам Claude Code пишет, что на Opus 5 он добавляет собственную инструкцию о делегировании. Официально Anthropic состав прибавки не комментировала, а сам замер единичный — мы его не воспроизводили.
Из того же разбора следует ещё одна деталь: Claude Code держит два набора системных промптов и выбирает их по модели. Подробный старый получают Sonnet, Haiku и старые Opus, сокращённый новый — Opus 5 и Fable 5. То есть сама Anthropic не переносит чистку на модели, для которых она не проверена.
Исследование ETH Zurich (arXiv 2602.11988, версия от 29 сентября 2026 года) добавляет независимый сигнал: контекстные файлы вроде AGENTS.md в среднем не повышают долю решённых задач и поднимают стоимость запуска больше чем на 20%. Обзоры репозитория, которые советуют вендоры, оказались бесполезны, а вот инструкции агенты выполняют. Это работает в обе стороны: удачная строка сработает, неудачная — тоже, буквально. Оговорка: модели в исследовании — не линейка Claude 5.
Кейсы: как чистили Claude Code, AGENTS.md и описание скилла
Три публичных примера, где видно и «было», и «стало». Все три — из первоисточников вендоров, а не из пересказов.
Комментарии в коде у Claude Code
Было: правило «по умолчанию не писать комментарии, никаких многострочных docstring, одна короткая строка максимум», плюс запрет создавать документы с планами без просьбы пользователя. Стало: «пиши код так, как окружающий: та же плотность комментариев, имена и идиомы». Одна фраза закрывает все случаи — и проект без комментариев, и сложный модуль, где многострочный комментарий уместен, — потому что опирается на контекст, а не на запрет.
Описание скилла для миграций Postgres у OpenAI
Плохое описание: «Create and validate Postgres schema migrations. Use when working with databases, queries, models, or persistence». Хорошее: «…Use when adding or changing a migration, or reviewing its rollout». По объяснению OpenAI, первая версия толкает модель включать скилл при любом касании базы данных, хотя он нужен только для миграций. Описание стало точнее, а не длиннее.
AGENTS.md «прочитай всё перед каждой правкой»
Плохо: «Before every edit, read architecture.md, database.md, and deployment.md». Хорошо: architecture.md — для границ сервисов, database.md — для изменений схемы, deployment.md — при подготовке деплоя. OpenAI называет требование читать стопку документов перед каждой правкой лишним для исправления опечатки: это сжигает контекст и замедляет работу. Ссылки на документы остаются полезны, если они привязаны к ситуации.
FAQ
Нужно ли убирать примеры из промптов для Claude 5?
Не все. Пост Anthropic говорит о примерах вызова инструментов: у новых моделей они сужают пространство поиска, и вместо них лучше улучшить параметры и описание инструмента. Примеры формата, тона и структуры справка Anthropic на 24 октября 2026 года по-прежнему советует — 3–5 разнообразных образцов в тегах <example>, без попытки перечислить все краевые случаи.
Чем context engineering отличается от prompt engineering?
Prompt engineering — это формулировка одного запроса под конкретную задачу. Context engineering — работа со всем, что модель видит вместе с запросом: системным промптом, CLAUDE.md, скиллами, памятью, файлами и описаниями инструментов. Контекст обслуживает сотни разных запросов, поэтому в нём нельзя быть таким же конкретным, как в промпте, и цена каждой лишней строки выше.
Стоит ли убирать CAPS и MUST из старых промптов?
Да, в большинстве случаев. Справка Anthropic советует смягчать формулировки вроде «CRITICAL: You MUST use this tool» до обычного «Use this tool when…»: совет написан для Opus 4.5 и 4.6, которые внимательнее прежних моделей к системному промпту, и громкая инструкция у них ведёт к перегибу. Для линейки 5.x отдельного правила нет, но логика та же. Исключение — необратимые действия: запрет остаётся, но спокойным тоном и с причиной.
Как понять, что правило в CLAUDE.md устарело?
Задайте ему вопрос: что сломается, если строку удалить? Устаревшее правило обычно страхует от ошибки, которую новая модель уже не делает, повторяет то, что видно из кода, дублирует другую инструкцию или не имеет причины. Документация Claude Code советует держать CLAUDE.md короче 200 строк и тратить его на неочевидные «грабли» проекта.
Что делает /doctor prompt-audit и с какой версии он доступен?
Команда проверяет CLAUDE.md, AGENTS.md, правила, скиллы, команды и субагентов на инструкции под старые модели, ссылки на несуществующие файлы и противоречия между файлами. Она выдаёт отчёт с предложенными правками и ничего не меняет без вашей команды. Нужен Claude Code версии 2.1.283 или новее; проверить один файл или папку можно, передав путь.
Сломаются ли старые промпты на Claude 5, если ничего не менять?
Как правило, нет: модели по-прежнему следуют инструкциям. Проблема в другом — лишние строки стоят токенов на каждом запросе, противоречия заставляют модель выбирать между ними, а устаревшие запреты сковывают её там, где она справилась бы лучше. Opus 5 со старой инструкцией «перепроверь всё» просто проверяет дважды и тратит больше.
Подходят ли новые правила для GPT и Gemini?
Частично. OpenAI в 2026 году советует то же направление: меньше пошаговых предписаний, короткие описания скиллов, никаких противоречий. Google в справке Gemini API по-прежнему рекомендует всегда добавлять few-shot примеры, предупреждая только о переобучении на слишком большом их числе. Общее у всех трёх вендоров — явные цели и границы при меньшем числе лишних правил.