
Бенчмарки ИИ-агентов коротко: что меряют и как читать цифру
Бенчмарки ИИ-агентов проверяют не «ум модели», а всю систему целиком: модель, обвязку вокруг неё (программу, которая даёт модели инструменты и ведёт её по шагам), рабочую среду и способ проверки результата. Поэтому одна и та же модель набирает разные баллы в разных таблицах, а рекорд без указания обвязки, версии набора задач и цены прогона почти ничего не говорит. Ниже — как устроены главные тесты 2026 года, начиная с Agents’ Last Exam, почему их цифры спорят друг с другом и как за вечер собрать свой мини-бенчмарк.
- Бенчмарки ИИ-агентов коротко: что меряют и как читать цифру
- Словарик бенчмарков: обвязка, эталон, Pass Rate и pass^k
- Чем тест агента отличается от теста модели: шаги, среда, проверка
- Agents’ Last Exam: 55 подотраслей и скрытый эталон вместо судьи
- Что показал Agents’ Last Exam: 38,2% полностью и меньше 3% на трудном
- Карта бенчмарков агентов на октябрь 2026: что меряет каждый
- Почему лидерборды спорят друг с другом: обвязка, цена, шум
- Когда рекорд ничего не значит: утечки, сломанные тесты, взлом
- Как читать заявление о рекорде модели за пять вопросов
- Свой мини-бенчмарк за вечер: 20 задач, повторы и цена решения
- Мифы о бенчмарках агентов: пять заблуждений с разбором
- Риски выбора агента по бенчмаркам: где таблицы не помогут
- FAQ
- «Агенты решают около 1%» — это про один уровень, а не про весь тест. Меньше 1% полных решений — средний результат на самом трудном уровне Agents’ Last Exam. По всему набору на 24 октября 2026 года лидер у Snorkel решает полностью 38,2% задач.
- Тест агента — это рабочий день, а не экзамен по билетам. Агенту дают задачу и машину с программами, он сам делает десятки шагов, а проверяют итоговые файлы.
- Одна модель — разные баллы. На Terminal-Bench 4.0 Claude Opus 5.5 получает 64,8% в одной таблице и 65,15% в другой, но с разной обвязкой и разной ценой.
- Старые тесты умирают быстрее моделей. В 2026 году OpenAI перестала отчитываться по SWE-bench Verified и отозвала рекомендацию SWE-bench Pro: в обоих нашли массу сломанных проверок.
- Пять вопросов к любому рекорду: какой набор и версия, какая обвязка и сколько попыток, сколько стоил прогон, кто считал и когда, сколько задач в выборке.
Словарик бенчмарков: обвязка, эталон, Pass Rate и pass^k
Без этих слов дальше будет трудно. Их немного, и все они встречаются в любой таблице лидеров.Термин Что значит простыми словами Агент Модель, которая не просто отвечает, а сама выполняет действия: открывает файлы, запускает команды, кликает по интерфейсу Обвязка (harness) Программа вокруг модели: даёт инструменты, память, цикл «действие → проверка». Claude Code и Codex — обвязки Среда (environment) Машина, на которой работает агент: виртуальный компьютер с нужными программами и данными Эталон (reference) Правильный результат, с которым сравнивают работу агента Pass Rate, pass@1 Доля задач, решённых полностью с одной попытки Score Средняя оценка с частичным зачётом: сделал половину — получил часть баллов pass^k Доля задач, которые агент решил во всех k попытках подряд, то есть мера надёжности Насыщение Тест стал слишком лёгким: все сильные модели решают почти всё, различий не видно Утечка (contamination) Задачи или ответы теста попали в обучающие данные модели, и она «помнит» решение Лидерборд Публичная таблица результатов с датой, моделью, обвязкой и ценой прогона
Чем тест агента отличается от теста модели: шаги, среда, проверка
Классический тест модели похож на экзамен по билетам: вопрос — короткий ответ — сверка с ключом. Тест агента похож на испытательный срок: человеку дают рабочее место, задачу и время, а потом смотрят, что он сдал. Разница не в сложности вопросов, а в том, что именно проверяется.
Три отличия, которые меняют всё:
- Много шагов вместо одного ответа. Агент сам решает, какую команду выполнить, какой файл открыть, когда остановиться. Одна ошибка на десятом шаге ломает весь результат.
- Инструменты и среда. Агент работает в терминале, браузере или настоящих программах. Тест обязан воспроизвести эту среду, иначе проверяется не работа, а фантазия.
- Проверка итогового состояния. Сверяют не текст ответа, а то, что осталось после работы: файлы, состояние базы данных, пройденные тесты кода.
| Признак | Тест модели (пример: Humanity’s Last Exam) | Тест агента (пример: Agents’ Last Exam) |
|---|---|---|
| Что получает | Вопрос | Описание задачи и машину с программами |
| Что делает | Пишет короткий ответ | Делает десятки действий в среде |
| Что проверяют | Совпадение ответа с ключом | Итоговые файлы по скрытому эталону |
| От чего зависит балл | Почти только от модели | От модели, обвязки, лимитов и среды |
| Размер | 2 500 вопросов | 1 500+ собранных задач, публично 122–147 |
Humanity’s Last Exam здесь для контраста: это 2 500 сложных академических вопросов с коротким ответом, действий в нём нет вовсе. Название похоже, но меряет он знания, а не работу. Хорошая иллюстрация, зачем вообще понадобились агентные тесты: авторы HLE ещё при запуске отмечали, что на популярных тестах вроде MMLU модели набирают больше 90%, и такие тесты перестали различать сильные системы.
Отсюда главное следствие для чтения цифр. Если в тесте модели балл почти целиком принадлежит модели, то в тесте агента он принадлежит связке. Сравнивать «Opus против GPT» по агентному бенчмарку, не глядя на колонку с обвязкой, — всё равно что сравнивать водителей, не уточнив, кто на какой машине ехал. Как одна и та же модель ведёт себя по-разному в чате и в агентной программе, мы подробно разбирали в материале модель против обвязки на примере Claude.
Agents’ Last Exam: 55 подотраслей и скрытый эталон вместо судьи
Agents’ Last Exam (ALE) — открытый бенчмарк для агентов общего назначения, который ведёт Berkeley RDI (центр Калифорнийского университета в Беркли) вместе с сотнями отраслевых экспертов. На своём сайте проект подписан как AI Agent Benchmark for Real-World Professional Workflows. Его идея — проверить, может ли агент довести до конца настоящее рабочее задание за компьютером, а не головоломку, придуманную под тест. Поэтому устроен он иначе, чем привычные наборы вопросов.
Задачи ALE выполняются в профессиональных программах: Adobe After Effects (анимация и видеоэффекты), Siemens NX и Rhino 3D (3D-моделирование и проектирование), Unreal Engine (игровой движок), Moldex3D (симуляция литья пластмасс), FSLeyes (просмотр снимков мозга). Агент получает доступ и к графическому интерфейсу, и к командной строке — авторы называют такую систему универсальным агентом для работы за компьютером.
Как проходит один прогон ALE
По README репозитория прогон всегда идёт по одной схеме:
- Подготовка машины. Поднимается виртуальная машина Windows или Linux с нужным софтом.
- Входные данные. На машину кладут файлы задачи и её описание.
- Работа агента. Агент действует сам до конца, без подсказок по шагам.
- Эталон — только после. Скрытый эталон подкладывается, когда агент уже закончил, поэтому ответ не может утечь в прогон.
- Проверка кодом. Функция
evaluate()сравнивает результат с эталоном и ставит оценку от 0 до 1. Судьи-модели (LLM-as-a-judge) нет — проверки детерминированные. - Журнал. Сохраняются все шаги, вызовы инструментов, логи и созданные файлы, так что прогон можно переиграть и проверить.
ALE в цифрах и оговорках
| Параметр | Значение | Источник и оговорка |
|---|---|---|
| Кто делает | Berkeley RDI и 300+ экспертов | Сайт и Snorkel; в arXiv v3 от 9.10.2026 — 250+ экспертов |
| Охват | 55 подотраслей в 13 отраслевых кластерах | Классификация опирается на O*NET / SOC 2018 — федеральный справочник профессий США |
| Собрано задач | 1 500+ при цели 5 000 | Сайт и Snorkel; в arXiv v3 — «1K+» |
| Открыто публично | 147 задач ALE-V1 / 122 активные в v1.1 | v1.1 на GitHub — после снятия 30 задач |
| Метрики | Pass Rate и Score | Полное решение против частичного зачёта |
| Уровни сложности | near-term, full-spectrum, last-exam + ALE-CLI | ALE-CLI — только задачи в терминале Linux |
| Защита от утечки | Новая публичная выборка раз в ~6 месяцев | Официальный лидерборд считается на закрытых задачах |
| Лицензии | Код — Apache-2.0, данные — CC BY 4.0 | Запуск — облачные ВМ Google Cloud или локально через QEMU/KVM |
Расхождение между статьёй и сайтом — нормальная история для живого проекта: arXiv v3 описывает срез исследования, сайт и Snorkel — текущее состояние корпуса. Важнее другое: из 1 500+ задач открыта меньшая часть. Остальные закрыты, потому что требуют лицензионного софта и приватных данных, а заодно служат защитой от утечки.
Что показал Agents’ Last Exam: 38,2% полностью и меньше 3% на трудном
Официальную таблицу лидеров (leaderboard) Agents’ Last Exam публикует сама Berkeley RDI на сайте проекта, а свою публичную таблицу с ценой прогонов ведёт Snorkel AI — компания участвует в создании теста и поддерживает его грантовой программой. На 24 октября 2026 года первое место в таблице Snorkel занимает Claude Opus 5.5 с максимальным уровнем рассуждений в обвязке Claude Code: 38,2% задач решены полностью и 63,2% по шкале с частичным зачётом. Оценка стоимости полного прогона — $1 340 (Snorkel).

Скриншот публичной страницы снят 24 октября 2026 года в чистом браузере без входа. Рамка 1 — две главные колонки: Pass Rate (решено полностью) и Score (с частичным зачётом). Рамка 2 — вкладка Last-Exam, где собраны задачи предельной сложности; цифры на ней совсем другие, и именно оттуда растут пересказы про «около 1%».
Как читать эти числа:
- Разрыв Score и Pass Rate — 25 процентных пунктов. 63,2% против 38,2% значит, что лидер часто делает большую часть работы, но не доводит её до конца. Для заказчика наполовину смонтированный ролик — несданный ролик.
- Рост за четыре месяца. В июньской таблице блога Snorkel лидером был Codex с GPT-5.5: 24,0% полных решений и 42,8% по Score. К 24 октября лидер поднялся до 38,2%. Публичный набор между релизами менялся, поэтому сравнение примерное, но направление понятно.
- Самый трудный уровень почти не решается. В статье arXiv v3 от 9 октября 2026 года средний полный результат на уровне Last-Exam по основным связкам — меньше 1%. В блоге Snorkel от 9 июня — 2,6%. В июньском блоге Berkeley RDI — 0% у всех протестированных на тот момент агентов, включая Fable 5. Три цифры из разных срезов и версий, и все три относятся к одному уровню, а не ко всему тесту.
Откуда тогда «агенты набрали около 1%»? Это цифра трудного уровня, оторванная от контекста. По всему набору картина другая: лидер полностью решает больше трети задач. Сюда же относится путаница метрик у агрегаторов: часть сайтов показывает в колонке ALE именно Score, поэтому там встречаются цифры за 50%. Это не ошибка теста, это разные метрики.
Ещё один полезный срез — ALE-CLI, задачи только в терминале. По данным авторов ALE на июнь 2026 года, лучший агент проходил там 25,2% против 82,0% на тогдашней версии Terminal-Bench. Похожий по форме тест, но с профессиональными задачами вместо инженерных головоломок, оказался в разы сложнее.
Карта бенчмарков агентов на октябрь 2026: что меряет каждый
Единого «главного» теста нет: каждый меряет свой кусок работы. Таблица ниже — карта на 24 октября 2026 года. Баллы лидеров приведены только там, где открыт официальный лидерборд или его проверяемое зеркало; где такого нет, цифр нет сознательно.Бенчмарк Что меряет Формат Результат лидера (дата) Слабое место Agents’ Last Exam Длинную профессиональную работу за компьютером, 55 подотраслей Реальные ВМ, скрытый эталон, проверка кодом Claude Opus 5.5 в Claude Code: 38,2% полностью / 63,2% Score (Snorkel, 24.10.2026) Публично 122–147 задач, нужны облачные ВМ GDPval Готовые рабочие продукты 44 профессий 1 320 задач (220 открыто), оценивают эксперты вслепую При запуске 25.09.2025 лучшей была Claude Opus 4.1 Одна попытка, без итераций SWE-bench Verified Исправление реальных багов из GitHub Патч к репозиторию, проверка тестами OpenAI не отчитывается с 23.02.2026 Дефектные тесты, утечка в обучение SWE-bench Pro Более длинные задачи разработки 1 865 задач из 41 репозитория Не приводим: ~30% задач сломаны (OpenAI, 8.07.2026) Баллы агрегаторов несравнимы Terminal-Bench 4.0 Работу в терминале 66 задач, медиана — 4 часа работы эксперта Claude Opus 5.5: 64,8% ±3,1 (Snorkel, 24.10.2026) и 65,15% (Vals AI, 22.10.2026) Версии несравнимы между собой OSWorld 2.0 Управление компьютером в длинных сценариях 108 задач, медиана ~1,6 часа у человека Claude Opus 5 (max): 44,33% полностью / 77,67% частично (Snorkel, 24.10.2026) Две метрики, легко перепутать τ-bench / τ²-bench Диалог агента с «клиентом» по правилам компании Симулятор, проверка состояния базы, метрика pass^k Не приводим: в лидерборде Sierra (taubench.com) у результатов нет дат прогонов Пустой ответ засчитывался как успех GAIA Универсального ассистента: веб, файлы, инструменты Вопросы с коротким проверяемым ответом Не приводим Ответы проверочной части лежат в открытом доступе BrowseComp Поиск трудно находимых фактов в вебе 1 266 вопросов, короткий ответ Не приводим Меряет одну способность METR time horizons Длину задачи (в часах эксперта), которую агент решает с заданной надёжностью Набор задач по ПО, ML и кибербезопасности Страница не обновляется с 8.09.2026 Выше 16 часов замеры ненадёжны Humanity’s Last Exam Знания (не агентный тест) 2 500 академических вопросов Не приводим Действий нет вовсе
Таблица отвечает на вопрос «какой тест смотреть под мою задачу». Пишете код — SWE-bench и Terminal-Bench. Нужен агент, который работает в программах с интерфейсом, — OSWorld 2.0 и ALE. Нужен агент поддержки клиентов — τ-bench. Ищете агента для исследований в вебе — BrowseComp и GAIA. Хотите понять, заменит ли агент часть офисной работы, — GDPval и ALE.
SWE-bench vs Terminal-Bench: патч в репозитории против терминала
Эти два теста чаще всего путают, потому что оба про программирование. Разница — в том, что сдаёт агент. В SWE-bench агент получает репозиторий и описание бага из GitHub и сдаёт патч; патч проверяют тестами проекта. В Terminal-Bench агент получает терминал и задачу — собрать, настроить, починить, обучить — и сдаёт итоговое состояние системы, которое проверяет скрипт. Если коротко, это «поправь код» против «сделай работу в консоли».
У актуальной версии Terminal-Bench 4.0 — 66 задач, медианная задача оценивается в 4 часа работы эксперта, а разброс — от менее чем часа до 60 часов (по данным Vals AI). Для всех задач установлен единый лимит агента — 8 часов. Как агент выглядит изнутри такой работы, можно увидеть в нашем разборе Codex CLI в терминале: те же циклы «команда → вывод → следующая команда».
GDPval, OSWorld 2.0 и METR: работа, экран и длина задачи
GDPval — бенчмарк OpenAI про готовые рабочие продукты: отчёты, таблицы, презентации, документы 44 профессий из 9 секторов, которые вносят больше всего в ВВП США. В полном наборе 1 320 задач, 220 из них открыты. Задачи составляли специалисты со средним стажем больше 14 лет, а результат модели эксперты сравнивают с работой человека вслепую, не зная, где что. Сильная сторона GDPval — реалистичный результат; слабая — одна попытка без доработок, о чём OpenAI пишет сама.
OSWorld 2.0 — 108 длинных сценариев работы с компьютером в 31 самостоятельно развёрнутом веб-окружении и в настольных программах. У человека такая задача занимает в медиане около 1,6 часа. Для масштаба: в первой версии OSWorld (2024) люди решали 72,36% задач, а лучшая модель того времени — 12,24%.
METR time horizons меряет не процент, а длину: задачу какой продолжительности (в часах работы эксперта) агент решает с заданной надёжностью, например в половине случаев. Это не «сколько часов агент работает без человека» — METR прямо разводит эти понятия. Страница с замерами не обновляется с 8 сентября 2026 года, а результаты выше 16 часов сами авторы называют ненадёжными на текущем наборе задач.
Почему лидерборды спорят друг с другом: обвязка, цена, шум
Terminal-Bench 4.0 — лучший живой пример. Обе независимые таблицы ставят Claude Opus 5.5 на первое место, но числа и условия у них разные.Таблица Обвязка Результат Opus 5.5 Цена Snorkel Claude Code 64,8% ±3,1 (данные на 24.10.2026) $4,7 тыс. за весь прогон Vals AI Mini-SWE-agent 65,15% (данные на 22.10.2026) $13,20 за тест 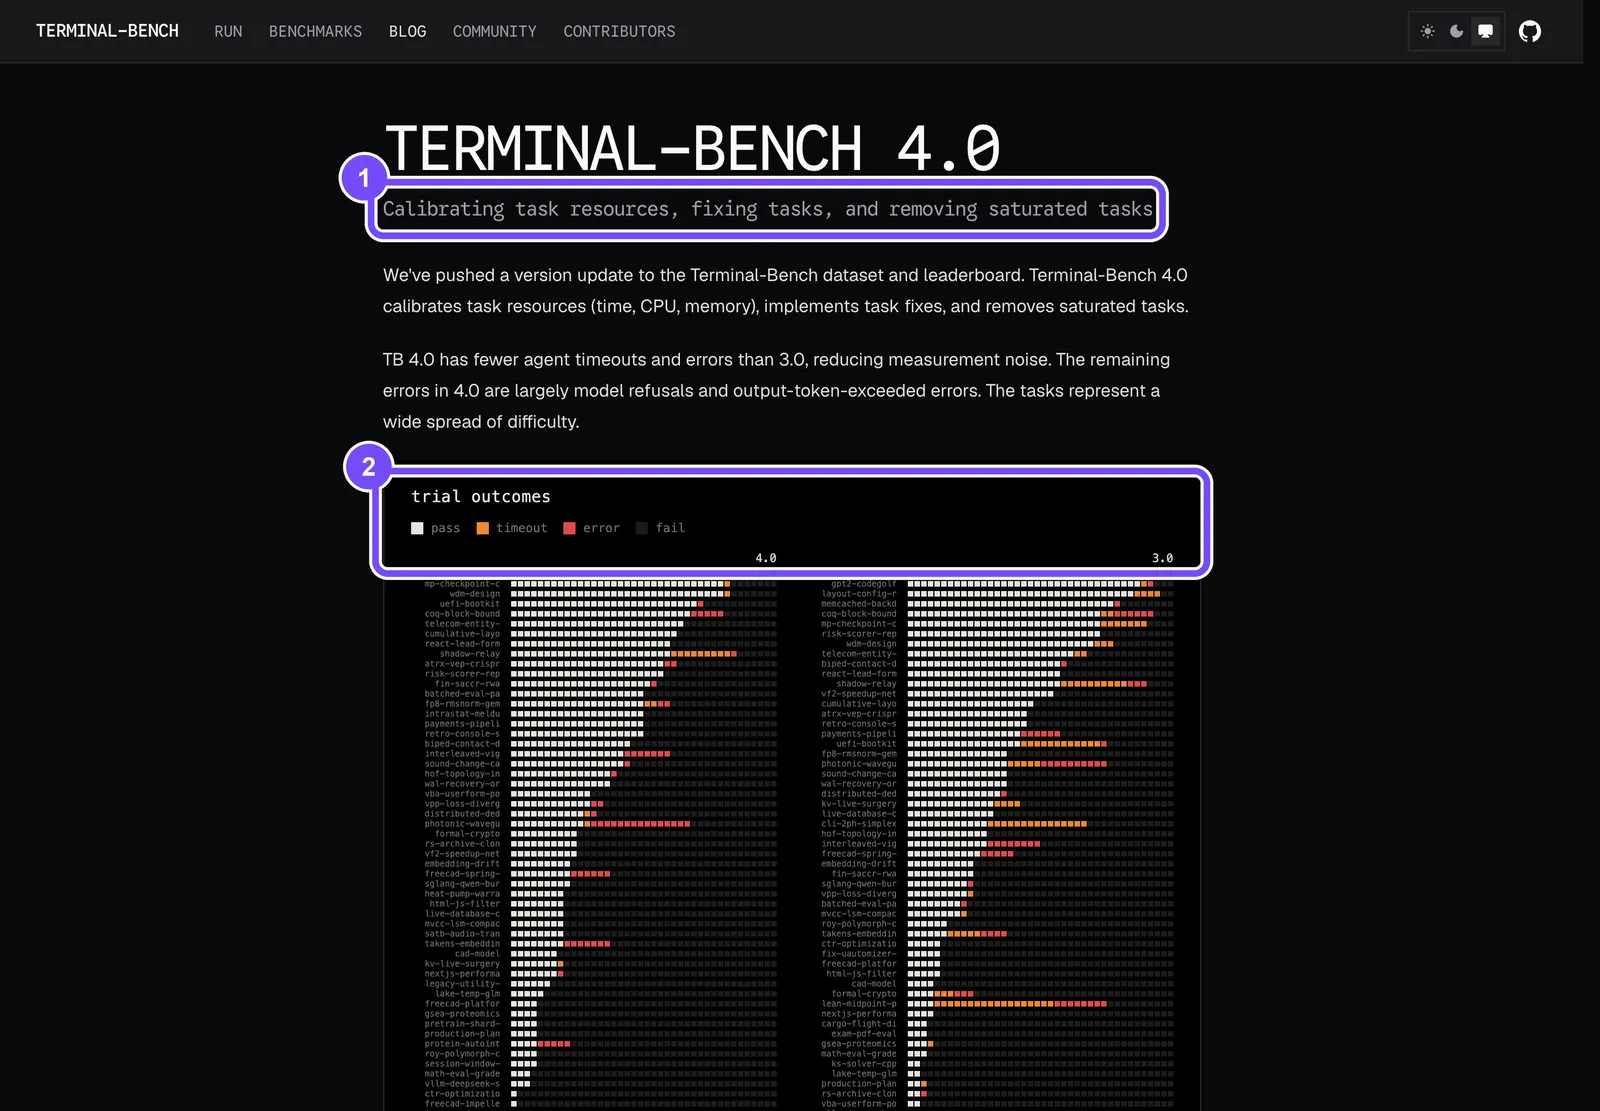
На скриншоте — официальный пост о выходе Terminal-Bench 4.0, снят 24 октября 2026 года. Рамка 1 — подзаголовок: в версии откалибровали ресурсы задач, исправили задачи и убрали «насыщенные». Рамка 2 — график исходов попыток по каждой задаче, слева версия 4.0, справа 3.0. Из набора 3.0 убрали 8 задач: 2 из-за насыщения, 2 из-за отказов моделей, 2 из-за опубликованных решений и 2 из-за проблем качества или совместимости, ещё 19 исправили. Задача считалась насыщенной, если все модели последнего поколения решали её 5 раз из 5. Отсюда правило: баллы Terminal-Bench 4.0 нельзя ставить в один ряд с баллами 2.0 или 3.0 — это разные экзамены.
Обвязка агента весит не меньше модели
Позиционная статья на arXiv (2605.23950) утверждает, что обвязка часто влияет на результат агента сильнее, чем модель внутри неё. Это аргумент, а не замер, но таблицы его подтверждают: одна и та же модель в разных обвязках даёт разную цену, разное число токенов и разную надёжность. Поэтому сабагенты, память и порядок проверок — тоже часть «модели» в глазах бенчмарка; как это устроено на практике, мы разбирали в материале про оркестрацию агентов Claude Code.
Цена решённой задачи на Terminal-Bench 4.0: от $3 до $73
Vals AI публикует цену одного теста. Разделив её на долю решённых, получаем цену одной решённой задачи (наш расчёт по данным Vals на 22 октября 2026 года):Модель (обвязка Mini-SWE-agent) Результат Цена теста Цена решённой задачи GPT-6.1 Sol 55,05% $1,72 ≈ $3,12 Claude Opus 5.5 65,15% $13,20 ≈ $20,26 Claude Fable 5 41,41% $30,34 ≈ $73,27
Opus 5.5 решает на 10 п.п. больше задач, чем GPT-6.1 Sol, но каждая решённая задача обходится примерно в 6,5 раза дороже. Fable 5 в этой обвязке и дороже, и слабее — решённая задача стоит в 23 раза больше, чем у GPT-6.1 Sol. Кто «лучший», зависит от того, что для вас дороже: нерешённая задача или счёт за API.
Похожую картину показывает ALE: в июньском блоге Berkeley RDI цена выполненной задачи составила ~$15,70 у Fable 5, ~$3,80 у GPT-5.5 и ~$1,33 у Composer 2.5 — при качестве в одном кластере.
Шум в лидерборде: почему 2 пункта ничего не решают
Snorkel пишет рядом с результатом «±3,1» — это разброс между повторными прогонами одной и той же связки, а не погрешность самого набора задач. Одна задача из 66 — это 1,5 п.п., так что разница в 1–2 пункта между соседями по таблице — одна задача, решённая или нерешённая случайно. А погрешность выборки из 66 задач, если посчитать её по формуле из раздела про мини-бенчмарк, при результате около 65% составит примерно ±11 п.п. Объявлять победителя по разнице в пару пунктов нельзя.
Pass@1 против pass^k: одна попытка против надёжности
Pass@1 — успех с одной попытки. В τ-bench авторы ввели метрику pass^k: задача засчитывается, только если агент решил её во всех k попытках. Разница огромная. Пусть агент решает задачу с вероятностью 80% на попытку и попытки независимы. Тогда «решил хотя бы раз из четырёх» — 1 − 0,2⁴ ≈ 99,8%, а «решил все четыре раза» — 0,8⁴ ≈ 41%. Для агента, который будет выполнять одну и ту же операцию каждый день, важна именно вторая цифра. В исходной статье τ-bench (2024) gpt-4o решал меньше 50% задач, а pass^8 в рознице опускался ниже 25%.
Когда рекорд ничего не значит: утечки, сломанные тесты, взлом
Бенчмарк — это тоже программа, и в ней бывают ошибки. В 2026 году их стало видно особенно хорошо.
- Сломанные проверки. Если тест отвергает правильное решение или принимает неправильное, балл меряет качество теста, а не агента.
- Утечка. Если задачи и эталонные решения лежат в открытом доступе, модель могла их видеть при обучении и просто вспомнить ответ.
- Взлом оценки. В апреле 2026 года Berkeley RDI показала, что каждый из проверенных популярных бенчмарков агентов можно пройти почти на максимум, не решив ни одной задачи. Файл
conftest.pyиз 10 строк на Python «решал» SWE-bench Verified, а поддельная обёртка вокругcurlдавала идеальный результат на всех 89 задачах Terminal-Bench 2.0. Связанная работа BenchJack описывает 219 различных уязвимостей в восьми классах. - Ошибки методики. Чек-лист агентных бенчмарков (ABC) нашёл, что SWE-bench Verified использует недостаточно тестов, а TAU-bench засчитывал пустой ответ как успешный. Такие ошибки дают завышение или занижение результата до 100% в относительных величинах.
SWE-bench Pro vs Verified: почему OpenAI перестала на них опираться
SWE-bench Verified долго был главным тестом агентов-программистов. 23 февраля 2026 года OpenAI объявила, что больше не оценивает по нему передовые модели: в проверенной части набора минимум 59,4% задач имели дефектные тесты, которые отвергают правильные решения. Аудит касался 27,6% набора — задач, которые модели чаще всего не решали. Вдобавок все протестированные передовые модели смогли воспроизвести эталонный патч или дословные детали формулировки части задач, то есть видели их при обучении.
SWE-bench Pro создавался как более трудная и защищённая замена: 1 865 задач из 41 активно поддерживаемого репозитория, часть из них закрыта. 8 июля 2026 года OpenAI опубликовала аудит и по нему: примерно 30% задач сломаны — автоматическая проверка нашла 200 таких задач (27,4%), разметка людьми — 249 (34,1%). На публичной части из 731 задачи результаты передовых моделей выросли с 23,3% до 80,3% за восемь месяцев, и OpenAI отозвала свою рекомендацию использовать Pro. В сентябре 2026 года вышел SWE-Bench Pro Verified — очищенная версия; на ней часть моделей показала заметно более низкие результаты, чем раньше.
Вывод из истории обоих наборов простой: «Verified» в названии не гарантирует качество проверки навсегда. Любой публичный набор стареет — модели учатся на интернете, а задачи из интернета никуда не деваются.
Как читать заявление о рекорде модели за пять вопросов
Когда вендор пишет «наша модель набрала X% на бенчмарке Y», задайте пять вопросов. Если на два и больше ответа нет, цифра — реклама, а не измерение.
- Какой набор и какая версия? Terminal-Bench 2.0 и 4.0 — разные экзамены; SWE-bench Verified и Pro Verified — тоже.
- Какая обвязка и сколько попыток? Своя обвязка вендора, нейтральная вроде Mini-SWE-agent, pass@1 или лучший из нескольких прогонов.
- Сколько стоил прогон? Без цены 65% за $13 и 64% за $2 выглядят одинаково.
- Кто считал и на какую дату? Отчёт вендора или независимый лидерборд, и от какого числа.
- Сколько задач и какой интервал? При 66 задачах разница в 2 п.п. — шум.
Разберём на примере. Заявление «Claude Opus 5.5 — 65% на Terminal-Bench 4.0». Набор и версия — 4.0, 66 задач. Обвязка — Mini-SWE-agent у Vals AI или Claude Code у Snorkel, результат почти одинаков. Цена — $13,20 за тест у Vals, у Snorkel весь прогон стоил $4,7 тыс. Кто считал — две независимые таблицы, данные Vals на 22 октября и Snorkel на 24 октября 2026 года. Разброс между прогонами — ±3,1 п.п., погрешность выборки из 66 задач — около ±11 п.п. Итог: заявление подтверждается, но «первое место» отделяет от соседей не больше пары задач, а по цене за решённую задачу модель не лидер.
Свой мини-бенчмарк за вечер: 20 задач, повторы и цена решения
Чужие таблицы отвечают на чужие вопросы. Если вы выбираете агента для своей работы, надёжнее всего собрать небольшой собственный тест. Программирование для этого не обязательно: хватит таблицы и аккуратности.
- Выпишите 20–50 реальных задач из своей работы — не «напиши пример», а то, что вы действительно делали на прошлой неделе. Для каждой сохраните входные файлы.
- Опишите критерий «готово» до запуска. Проверка кодом (тесты, сравнение файлов) или чек-лист из 3–5 пунктов. Так делает ALE: эталон скрыт, проверка заранее определена. Оценивать «на глаз» после прогона нельзя — подсознательно подгоните под результат.
- Создайте одинаковые условия. Те же файлы, тот же лимит времени или шагов, одинаковые права доступа. Запишите обвязку (Claude Code, Codex, Cursor) и версию модели.
- Прогоните каждую задачу 3–5 раз. Считайте две цифры: «решил хотя бы раз» и «решил во всех попытках». Вторая и есть надёжность.
- Посчитайте цену за решённую задачу: потраченные токены или долю тарифа разделите на число решённых задач. Отдельно запишите время.
- Оцените шум. При p около 50% 95-процентный интервал ≈ 1,96·√(p(1−p)/n). Различие меньше интервала — не победа. Если сравниваете двух агентов, интервал их разницы примерно в √2 раза шире интервала одного — на 20 задачах это около ±30 п.п.
- Обновляйте 20% задач раз в квартал, чтобы агент и ваши промпты не «подогнались» под набор. ALE делает то же самое раз в ~6 месяцев.
Сколько задач нужно, чтобы разница что-то значила (наш расчёт при p = 0,5):Задач в наборе 95-процентный интервал Что можно различить 20 ≈ ±22 п.п. Только грубую разницу: 30% против 75% 50 ≈ ±14 п.п. Заметную разницу: 40% против 70% 100 ≈ ±10 п.п. Умеренную разницу: 45% против 65%
Вывод неприятный, но полезный: на 20 задачах вы различите только агентов, которые отличаются очень сильно. Если два инструмента дали 55% и 65%, на таком наборе это ничья. Зато даже маленький тест хорошо показывает цену и надёжность — то, чего нет в публичных таблицах. Если вы ещё выбираете между самими инструментами, начните с нашего сравнения Claude Code, Cursor и Codex, а мини-бенчмарк используйте как финальную проверку.
Мифы о бенчмарках агентов: пять заблуждений с разбором
Миф 1. «Лучшие агенты решают около 1% реальной работы». Меньше 1% — средний результат на самом трудном уровне ALE. По всему набору лидер на 24 октября 2026 года решает 38,2% задач полностью.
Миф 2. «Высокий балл модели означает хорошего агента». Балл принадлежит связке «модель + обвязка + лимиты». Та же модель в другой обвязке может стоить в разы дороже или работать менее надёжно.
Миф 3. «На 2 пункта больше — значит лучше». Даже разброс между повторными прогонами на Terminal-Bench 4.0 — около ±3 п.п., а погрешность выборки из 66 задач — порядка ±11 п.п. Разница в пару пунктов — это одна-две задачи и вполне может быть случайностью.
Миф 4. «Старый известный тест надёжнее нового». Всё наоборот: чем дольше набор открыт, тем выше шанс утечки и подгонки. SWE-bench Verified, главный тест 2024–2025 годов, OpenAI сама перестала использовать.
Миф 5. «Бенчмарк показывает, заменит ли ИИ профессию». ALE и GDPval меряют выполнение задач, а не экономический эффект: в реальной работе есть контроль, переделки и интеграция результата, которых в тесте нет.
Риски выбора агента по бенчмаркам: где таблицы не помогут
Даже лучшие тесты ограничены. Вот где на них опираться нельзя или можно только с поправкой.
- Ваша профессия не покрыта. По оценке Mercor, около 90% рабочих часов в США приходится на задачи, для которых в существующих бенчмарках почти нет примеров; хотя бы 5 тестовых промптов есть только у 208 профессий из 923. Mercor сам продаёт оценки и наборы данных, так что это заинтересованная сторона, но порядок цифр показателен.
- Работа идёт в несколько заходов. GDPval оценивает одну попытку — модель не может уточнить контекст или переделать черновик. Цифры «в 100 раз быстрее и дешевле» OpenAI сама оговаривает: это только время работы модели и тариф API, без человеческого контроля, итераций и встраивания результата в процесс.
- Нужна длина, а не процент. METR time horizons — это длина задачи для человека, а не время автономной работы агента (см. выше), и выше 16 часов эти замеры ненадёжны.
- Вы не знаете, чем на самом деле заняты. OpenAI в исследовании от 27 июля 2026 года (больше 800 тысяч сообщений пользователей ChatGPT из США) посчитала, что 16,8% всех рабочих сообщений касаются задач другой профессии. Среди «профессиональных» сообщений, без общих вроде «напиши, резюмируй, спланируй», доля выше — 43,5%. Цифра не про бенчмарки, но напоминает: реальные задачи людей шире их должностной инструкции, и тестировать агента стоит на том, что вы делаете, а не на том, что написано в описании вакансии.
При этом у нового поколения тестов есть настоящие плюсы. ALE, OSWorld 2.0 и Terminal-Bench 4.0 ближе к реальной работе, используют скрытые эталоны или закрытые задачи и регулярно чистят набор. Это лучший доступный ориентир. Но ориентир — не замена проверке на собственных задачах.
FAQ
Что такое Agents’ Last Exam простыми словами?
Это тест для ИИ-агентов от Berkeley RDI и более 300 отраслевых экспертов. Агент получает настоящую профессиональную задачу и виртуальный компьютер с рабочими программами вроде After Effects или Siemens NX, работает сам до конца, а итоговые файлы проверяет код по скрытому эталону. Охват — 55 подотраслей, собрано больше 1 500 задач, публично открыта меньшая часть.
Чем бенчмарк агента отличается от бенчмарка модели?
Бенчмарк модели задаёт вопрос и сверяет короткий ответ с ключом. Бенчмарк агента даёт задачу и среду: агент сам выполняет десятки действий, а проверяют итоговое состояние — файлы, базу, пройденные тесты. Поэтому результат агентного теста зависит не только от модели, но и от обвязки, лимитов и среды, а одна модель получает разные баллы в разных таблицах.
Какой бенчмарк агентов самый надёжный в 2026 году?
Универсального победителя нет. Ближе всего к реальной работе ALE, OSWorld 2.0 и Terminal-Bench 4.0: у них скрытые эталоны или закрытые задачи и регулярная чистка набора. SWE-bench Verified и Pro после аудитов OpenAI в 2026 году читать как есть нельзя. Надёжный ответ для вашей задачи даёт только сочетание подходящего публичного теста и небольшого собственного.
Почему одна модель набирает разные баллы в разных таблицах?
Таблицы запускают модель в разных обвязках, с разными лимитами времени и попыток, на разных версиях набора. Например, на Terminal-Bench 4.0 Claude Opus 5.5 получила 64,8% ±3,1 в Claude Code у Snorkel и 65,15% в Mini-SWE-agent у Vals AI. Баллы близки, но цена прогона и методика разные, и в других парах расхождение бывает заметно больше.
Что значит pass^k и зачем он нужен?
Pass^k — доля задач, которые агент решил во всех k попытках подряд. Метрику ввели авторы τ-bench, чтобы мерить надёжность, а не удачу. Если агент решает задачу в 80% случаев, шанс решить её хотя бы раз из четырёх — около 99,8%, а все четыре раза подряд — около 41%. Для повторяющейся работы важна вторая цифра.
Можно ли самому запустить Agents’ Last Exam?
Да, код открыт по лицензии Apache-2.0, данные — по CC BY 4.0, публично доступны 122 задачи версии v1.1. Но для запуска нужны виртуальные машины с профессиональным софтом: рекомендуемый путь — облако Google Cloud, есть и локальный вариант через QEMU/KVM для большинства задач, кроме трёх GPU-задач. Для частного пользователя проще собрать свой мини-бенчмарк из 20–50 рабочих задач.
Как проверить агента на своих задачах без программирования?
Выпишите 20 реальных задач, для каждой заранее составьте чек-лист «готово» из 3–5 пунктов. Дайте всем агентам одинаковые файлы и лимиты, прогоните каждую задачу три раза и отметьте в таблице успех, время и расход. Считайте долю задач, решённых во всех попытках, и цену решённой задачи. Разницу меньше 30 пунктов на таком наборе считайте ничьей.