
Бенчмарки ШІ-агентів коротко: що вимірюють і як читати цифру
Бенчмарки ШІ-агентів перевіряють не «розум моделі», а всю систему разом: модель, обв’язку навколо неї (програму, яка дає моделі інструменти й веде її крок за кроком), робоче середовище та спосіб перевірки результату. Тому одна й та сама модель набирає різні бали в різних таблицях, а рекорд без обв’язки, версії набору завдань і ціни прогону майже нічого не каже. Нижче — як улаштовані головні тести 2026 року, починаючи з Agents’ Last Exam, чому їхні цифри не збігаються і як за вечір зібрати власний мінібенчмарк.
- Бенчмарки ШІ-агентів коротко: що вимірюють і як читати цифру
- Словничок бенчмарків: обв’язка, еталон, Pass Rate і pass^k
- Тест агента проти тесту моделі: кроки, середовище, перевірка
- Agents’ Last Exam: 55 підгалузей і прихований еталон замість судді
- Що показав Agents’ Last Exam: 38,2% повністю і менше 3% на важкому
- Карта бенчмарків агентів на жовтень 2026: що вимірює кожен
- Чому лідерборди не збігаються: обв’язка, ціна, шум
- Коли рекорд нічого не означає: витоки, зламані тести, злам
- Як читати заяву про рекорд моделі за п’ять запитань
- Власний мінібенчмарк за вечір: 20 завдань, повтори й ціна розв’язку
- Міфи про бенчмарки агентів: п’ять хибних уявлень
- Ризики вибору агента за бенчмарками: де таблиці не допоможуть
- FAQ
- «Агенти розв’язують близько 1%» — це про один рівень, а не про весь тест. Менше 1% повних розв’язків — середній результат на найважчому рівні Agents’ Last Exam. За всім набором на 24 жовтня 2026 року лідер у Snorkel повністю розв’язує 38,2% завдань.
- Тест агента — це робочий день, а не іспит за білетами. Агентові дають завдання й машину з програмами, він сам робить десятки кроків, а перевіряють підсумкові файли.
- Одна модель — різні бали. На Terminal-Bench 4.0 Claude Opus 5.5 отримує 64,8% в одній таблиці й 65,15% в іншій, але з різною обв’язкою та різною ціною.
- Старі тести вмирають швидше за моделі. У 2026 році OpenAI перестала звітувати за SWE-bench Verified і відкликала рекомендацію SWE-bench Pro: в обох знайшли безліч зламаних перевірок.
- П’ять запитань до будь-якого рекорду: який набір і версія, яка обв’язка і скільки спроб, скільки коштував прогін, хто рахував і коли, скільки завдань у вибірці.
Словничок бенчмарків: обв’язка, еталон, Pass Rate і pass^k
Без цих слів далі буде важко. Їх небагато, і всі вони трапляються в будь-якій таблиці лідерів.Термін Що означає простими словами Агент Модель, яка не просто відповідає, а сама виконує дії: відкриває файли, запускає команди, клікає інтерфейсом Обв’язка (harness) Програма навколо моделі: дає інструменти, пам’ять, цикл «дія → перевірка». Claude Code і Codex — обв’язки Середовище (environment) Машина, на якій працює агент: віртуальний комп’ютер із потрібними програмами й даними Еталон (reference) Правильний результат, із яким порівнюють роботу агента Pass Rate, pass@1 Частка завдань, розв’язаних повністю з однієї спроби Score Середня оцінка з частковим зарахуванням: зробив половину — отримав частину балів pass^k Частка завдань, які агент розв’язав в усіх k спробах поспіль, тобто міра надійності Насичення Тест став надто легким: усі сильні моделі розв’язують майже все, відмінностей не видно Витік (contamination) Завдання чи відповіді тесту потрапили в навчальні дані моделі, і вона «пам’ятає» розв’язок Лідерборд Публічна таблиця результатів із датою, моделлю, обв’язкою та ціною прогону
Тест агента проти тесту моделі: кроки, середовище, перевірка
Класичний тест моделі схожий на іспит за білетами: запитання — коротка відповідь — звірка з ключем. Тест агента схожий на випробувальний термін: людині дають робоче місце, завдання й час, а потім дивляться, що вона здала. Різниця не в складності запитань, а в тому, що саме перевіряють.
Три відмінності, які змінюють усе:

- Багато кроків замість однієї відповіді. Агент сам вирішує, яку команду виконати, який файл відкрити, коли зупинитися. Одна помилка на десятому кроці ламає весь результат.
- Інструменти та середовище. Агент працює в терміналі, браузері або справжніх програмах. Тест мусить відтворити це середовище, інакше перевіряють не роботу, а фантазію.
- Перевірка підсумкового стану. Звіряють не текст відповіді, а те, що лишилося після роботи: файли, стан бази даних, пройдені тести коду.
| Ознака | Тест моделі (приклад: Humanity’s Last Exam) | Тест агента (приклад: Agents’ Last Exam) |
|---|---|---|
| Що отримує | Запитання | Опис завдання й машину з програмами |
| Що робить | Пише коротку відповідь | Робить десятки дій у середовищі |
| Що перевіряють | Збіг відповіді з ключем | Підсумкові файли за прихованим еталоном |
| Від чого залежить бал | Майже лише від моделі | Від моделі, обв’язки, лімітів і середовища |
| Розмір | 2 500 запитань | 1 500+ зібраних завдань, публічно 122–147 |
Humanity’s Last Exam тут для контрасту: це 2 500 складних академічних запитань із короткою відповіддю, дій у ньому немає взагалі. Назва схожа, але вимірює він знання, а не роботу. Добра ілюстрація, навіщо взагалі знадобилися агентні тести: автори HLE ще на старті зазначали, що на популярних тестах на кшталт MMLU моделі набирають понад 90%, і такі тести перестали розрізняти сильні системи.
Звідси головний висновок для читання цифр. Якщо в тесті моделі бал майже повністю належить моделі, то в тесті агента він належить зв’язці. Порівнювати «Opus проти GPT» за агентним бенчмарком, ігноруючи колонку з обв’язкою, — те саме, що порівнювати водіїв, не уточнивши, хто якою машиною їхав. Як одна й та сама модель поводиться по-різному в чаті та в агентній програмі, ми докладно розбирали в матеріалі модель проти обв’язки на прикладі Claude.
Agents’ Last Exam: 55 підгалузей і прихований еталон замість судді
Agents’ Last Exam (ALE) — відкритий бенчмарк для агентів загального призначення, який веде Berkeley RDI (центр Каліфорнійського університету в Берклі) разом із сотнями галузевих експертів. На своєму сайті проєкт підписаний як AI Agent Benchmark for Real-World Professional Workflows. Його ідея — перевірити, чи може агент довести до кінця справжнє робоче завдання за комп’ютером, а не головоломку, вигадану під тест. Тому влаштований він інакше, ніж звичні набори запитань.
Завдання ALE виконують у професійних програмах: Adobe After Effects (анімація та відеоефекти), Siemens NX і Rhino 3D (3D-моделювання та проєктування), Unreal Engine (ігровий рушій), Moldex3D (симуляція лиття пластмас), FSLeyes (перегляд знімків мозку). Агент має доступ і до графічного інтерфейсу, і до командного рядка — автори називають таку систему універсальним агентом для роботи за комп’ютером.
Як відбувається один прогін ALE
За README репозиторію прогін завжди йде за однією схемою:
- Підготовка машини. Піднімається віртуальна машина Windows або Linux із потрібним софтом.
- Вхідні дані. На машину кладуть файли завдання та його опис.
- Робота агента. Агент діє сам до кінця, без підказок за кроками.
- Еталон — лише після. Прихований еталон підкладають, коли агент уже закінчив, тому відповідь не може потрапити в прогін.
- Перевірка кодом. Функція
evaluate()порівнює результат з еталоном і ставить оцінку від 0 до 1. Судді-моделі (LLM-as-a-judge) немає — перевірки детерміновані. - Журнал. Зберігаються всі кроки, виклики інструментів, логи та створені файли, тож прогін можна відтворити й перевірити.
ALE у цифрах і застереженнях
| Параметр | Значення | Джерело та застереження |
|---|---|---|
| Хто робить | Berkeley RDI і 300+ експертів | Сайт і Snorkel; в arXiv v3 від 9.10.2026 — 250+ експертів |
| Охоплення | 55 підгалузей у 13 галузевих кластерах | Класифікація спирається на O*NET / SOC 2018 — федеральний довідник професій США |
| Зібрано завдань | 1 500+ за мети 5 000 | Сайт і Snorkel; в arXiv v3 — «1K+» |
| Відкрито публічно | 147 завдань ALE-V1 / 122 активні у v1.1 | v1.1 на GitHub — після зняття 30 завдань |
| Метрики | Pass Rate і Score | Повний розв’язок проти часткового зарахування |
| Рівні складності | near-term, full-spectrum, last-exam + ALE-CLI | ALE-CLI — лише завдання в терміналі Linux |
| Захист від витоку | Нова публічна вибірка раз на ~6 місяців | Офіційний лідерборд рахують на закритих завданнях |
| Ліцензії | Код — Apache-2.0, дані — CC BY 4.0 | Запуск — хмарні ВМ Google Cloud або локально через QEMU/KVM |
Розбіжність між статтею та сайтом — нормальна історія для живого проєкту: arXiv v3 описує зріз дослідження, сайт і Snorkel — поточний стан корпусу. Важливіше інше: з 1 500+ завдань відкрито меншу частину. Решта закриті, бо потребують ліцензійного софту й приватних даних, а заразом слугують захистом від витоку.
Що показав Agents’ Last Exam: 38,2% повністю і менше 3% на важкому
Офіційну таблицю лідерів (leaderboard) Agents’ Last Exam публікує сама Berkeley RDI на сайті проєкту, а власну публічну таблицю з ціною прогонів веде Snorkel AI — компанія бере участь у створенні тесту й підтримує його грантовою програмою. На 24 жовтня 2026 року перше місце в таблиці Snorkel посідає Claude Opus 5.5 з максимальним рівнем міркувань в обв’язці Claude Code: 38,2% завдань розв’язано повністю і 63,2% за шкалою з частковим зарахуванням. Оцінка вартості повного прогону — $1 340 (Snorkel).
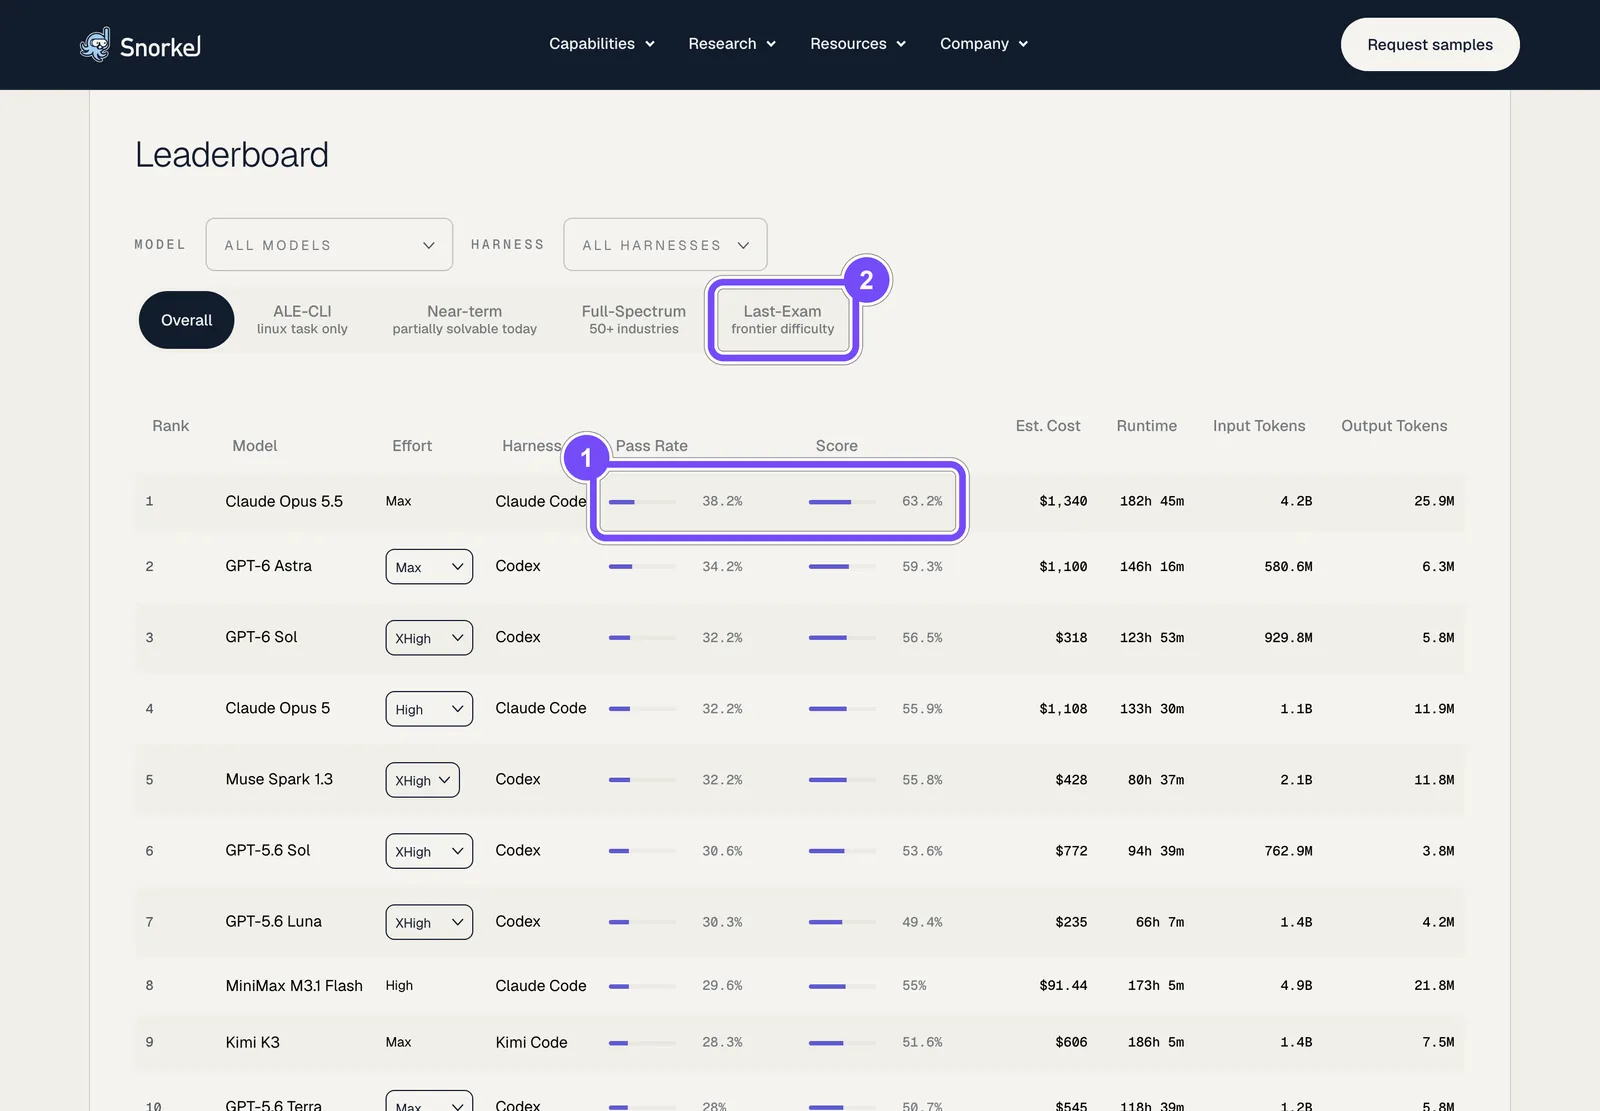
Скриншот публічної сторінки знято 24 жовтня 2026 року в чистому браузері без входу. Рамка 1 — дві головні колонки: Pass Rate (розв’язано повністю) і Score (із частковим зарахуванням). Рамка 2 — вкладка Last-Exam, де зібрано завдання граничної складності; цифри на ній зовсім інші, і саме звідти ростуть переказування про «близько 1%».
Як читати ці числа:
- Розрив Score і Pass Rate — 25 відсоткових пунктів. 63,2% проти 38,2% означає, що лідер часто робить більшу частину роботи, але не доводить її до кінця. Для замовника наполовину змонтований ролик — нездане замовлення.
- Зростання за чотири місяці. У червневій таблиці блогу Snorkel лідером був Codex із GPT-5.5: 24,0% повних розв’язків і 42,8% за Score. До 24 жовтня лідер піднявся до 38,2%. Публічний набір між релізами змінювався, тому порівняння приблизне, але напрям зрозумілий.
- Найважчий рівень майже не розв’язується. У статті arXiv v3 від 9 жовтня 2026 року середній повний результат на рівні Last-Exam за основними зв’язками — менше 1%. У блозі Snorkel від 9 червня — 2,6%. У червневому блозі Berkeley RDI — 0% в усіх протестованих на той момент агентів, зокрема Fable 5. Три цифри з різних зрізів і версій, і всі три стосуються одного рівня, а не всього тесту.
Звідки тоді «агенти набрали близько 1%»? Це цифра важкого рівня, відірвана від контексту. За всім набором картина інша: лідер повністю розв’язує понад третину завдань. Сюди ж належить плутанина метрик в агрегаторів: частина сайтів показує в колонці ALE саме Score, тому там трапляються цифри понад 50%. Це не помилка тесту, це різні метрики.
Ще один корисний зріз — ALE-CLI, завдання лише в терміналі. За даними авторів ALE на червень 2026 року, найкращий агент проходив там 25,2% проти 82,0% на тодішній версії Terminal-Bench. Схожий за формою тест, але з професійними завданнями замість інженерних головоломок, виявився в рази складнішим.
Карта бенчмарків агентів на жовтень 2026: що вимірює кожен
Єдиного «головного» тесту немає: кожен вимірює свій шматок роботи. Таблиця нижче — карта на 24 жовтня 2026 року. Бали лідерів наведено лише там, де відкрито офіційний лідерборд або його перевірюване дзеркало; де такого немає, цифр немає свідомо.Бенчмарк Що вимірює Формат Результат лідера (дата) Слабке місце Agents’ Last Exam Довгу професійну роботу за комп’ютером, 55 підгалузей Реальні ВМ, прихований еталон, перевірка кодом Claude Opus 5.5 у Claude Code: 38,2% повністю / 63,2% Score (Snorkel, 24.10.2026) Публічно 122–147 завдань, потрібні хмарні ВМ GDPval Готові робочі продукти 44 професій 1 320 завдань (220 відкрито), оцінюють експерти наосліп На старті 25.09.2025 найкращою була Claude Opus 4.1 Одна спроба, без ітерацій SWE-bench Verified Виправлення реальних багів із GitHub Патч до репозиторію, перевірка тестами OpenAI не звітує з 23.02.2026 Дефектні тести, витік у навчання SWE-bench Pro Довші завдання розробки 1 865 завдань із 41 репозиторію Не наводимо: ~30% завдань зламані (OpenAI, 8.07.2026) Бали агрегаторів непорівнянні Terminal-Bench 4.0 Роботу в терміналі 66 завдань, медіана — 4 години роботи експерта Claude Opus 5.5: 64,8% ±3,1 (Snorkel, 24.10.2026) і 65,15% (Vals AI, 22.10.2026) Версії непорівнянні між собою OSWorld 2.0 Керування комп’ютером у довгих сценаріях 108 завдань, медіана ~1,6 години в людини Claude Opus 5 (max): 44,33% повністю / 77,67% частково (Snorkel, 24.10.2026) Дві метрики, легко сплутати τ-bench / τ²-bench Діалог агента з «клієнтом» за правилами компанії Симулятор, перевірка стану бази, метрика pass^k Не наводимо: у лідерборді Sierra (taubench.com) результати без дат прогонів Порожню відповідь зараховували як успіх GAIA Універсального асистента: веб, файли, інструменти Запитання з короткою перевірюваною відповіддю Не наводимо Відповіді перевірної частини лежать у відкритому доступі BrowseComp Пошук фактів, які важко знайти у вебі 1 266 запитань, коротка відповідь Не наводимо Вимірює одну здатність METR time horizons Довжину завдання (у годинах експерта), яке агент розв’язує із заданою надійністю Набір завдань із ПЗ, ML і кібербезпеки Сторінка не оновлюється з 8.09.2026 Понад 16 годин виміри ненадійні Humanity’s Last Exam Знання (не агентний тест) 2 500 академічних запитань Не наводимо Дій немає взагалі
Таблиця відповідає на запитання «який тест дивитися під моє завдання». Пишете код — SWE-bench і Terminal-Bench. Потрібен агент, що працює в програмах з інтерфейсом, — OSWorld 2.0 і ALE. Потрібен агент підтримки клієнтів — τ-bench. Шукаєте агента для досліджень у вебі — BrowseComp і GAIA. Хочете зрозуміти, чи замінить агент частину офісної роботи, — GDPval і ALE.
SWE-bench vs Terminal-Bench: патч у репозиторії проти термінала
Ці два тести найчастіше плутають, бо обидва про програмування. Різниця — в тому, що здає агент. У SWE-bench агент отримує репозиторій та опис бага з GitHub і здає патч; патч перевіряють тестами проєкту. У Terminal-Bench агент отримує термінал і завдання — зібрати, налаштувати, полагодити, навчити — та здає підсумковий стан системи, який перевіряє скрипт. Якщо коротко, це «виправ код» проти «зроби роботу в консолі».
В актуальній версії Terminal-Bench 4.0 — 66 завдань, медіанне завдання оцінюють у 4 години роботи експерта, а розкид — від менш ніж години до 60 годин (за даними Vals AI). Для всіх завдань встановлено єдиний ліміт агента — 8 годин. Як агент виглядає зсередини такої роботи, можна побачити в нашому розборі Codex CLI у терміналі: ті самі цикли «команда → вивід → наступна команда».
GDPval, OSWorld 2.0 і METR: робота, екран і довжина завдання
GDPval — бенчмарк OpenAI про готові робочі продукти: звіти, таблиці, презентації, документи 44 професій із 9 секторів, які дають найбільше у ВВП США. У повному наборі 1 320 завдань, 220 з них відкриті. Завдання готували фахівці із середнім стажем понад 14 років, а результат моделі експерти порівнюють з роботою людини наосліп, не знаючи, де що. Сильна сторона GDPval — реалістичний результат; слабка — одна спроба без доопрацювань, про що OpenAI пише сама.
OSWorld 2.0 — 108 довгих сценаріїв роботи з комп’ютером у 31 самостійно розгорнутому вебсередовищі та в настільних програмах. У людини таке завдання займає в медіані близько 1,6 години. Для масштабу: у першій версії OSWorld (2024) люди розв’язували 72,36% завдань, а найкраща модель того часу — 12,24%.
METR time horizons вимірює не відсоток, а довжину: завдання якої тривалості (у годинах роботи експерта) агент розв’язує із заданою надійністю, наприклад у половині випадків. Це не «скільки годин агент працює без людини» — METR прямо розводить ці поняття. Сторінка з вимірами не оновлюється з 8 вересня 2026 року, а результати понад 16 годин самі автори називають ненадійними на поточному наборі завдань.
Чому лідерборди не збігаються: обв’язка, ціна, шум
Terminal-Bench 4.0 — найкращий живий приклад. Обидві незалежні таблиці ставлять Claude Opus 5.5 на перше місце, але числа й умови в них різні.Таблиця Обв’язка Результат Opus 5.5 Ціна Snorkel Claude Code 64,8% ±3,1 (дані на 24.10.2026) $4,7 тис. за весь прогін Vals AI Mini-SWE-agent 65,15% (дані на 22.10.2026) $13,20 за тест 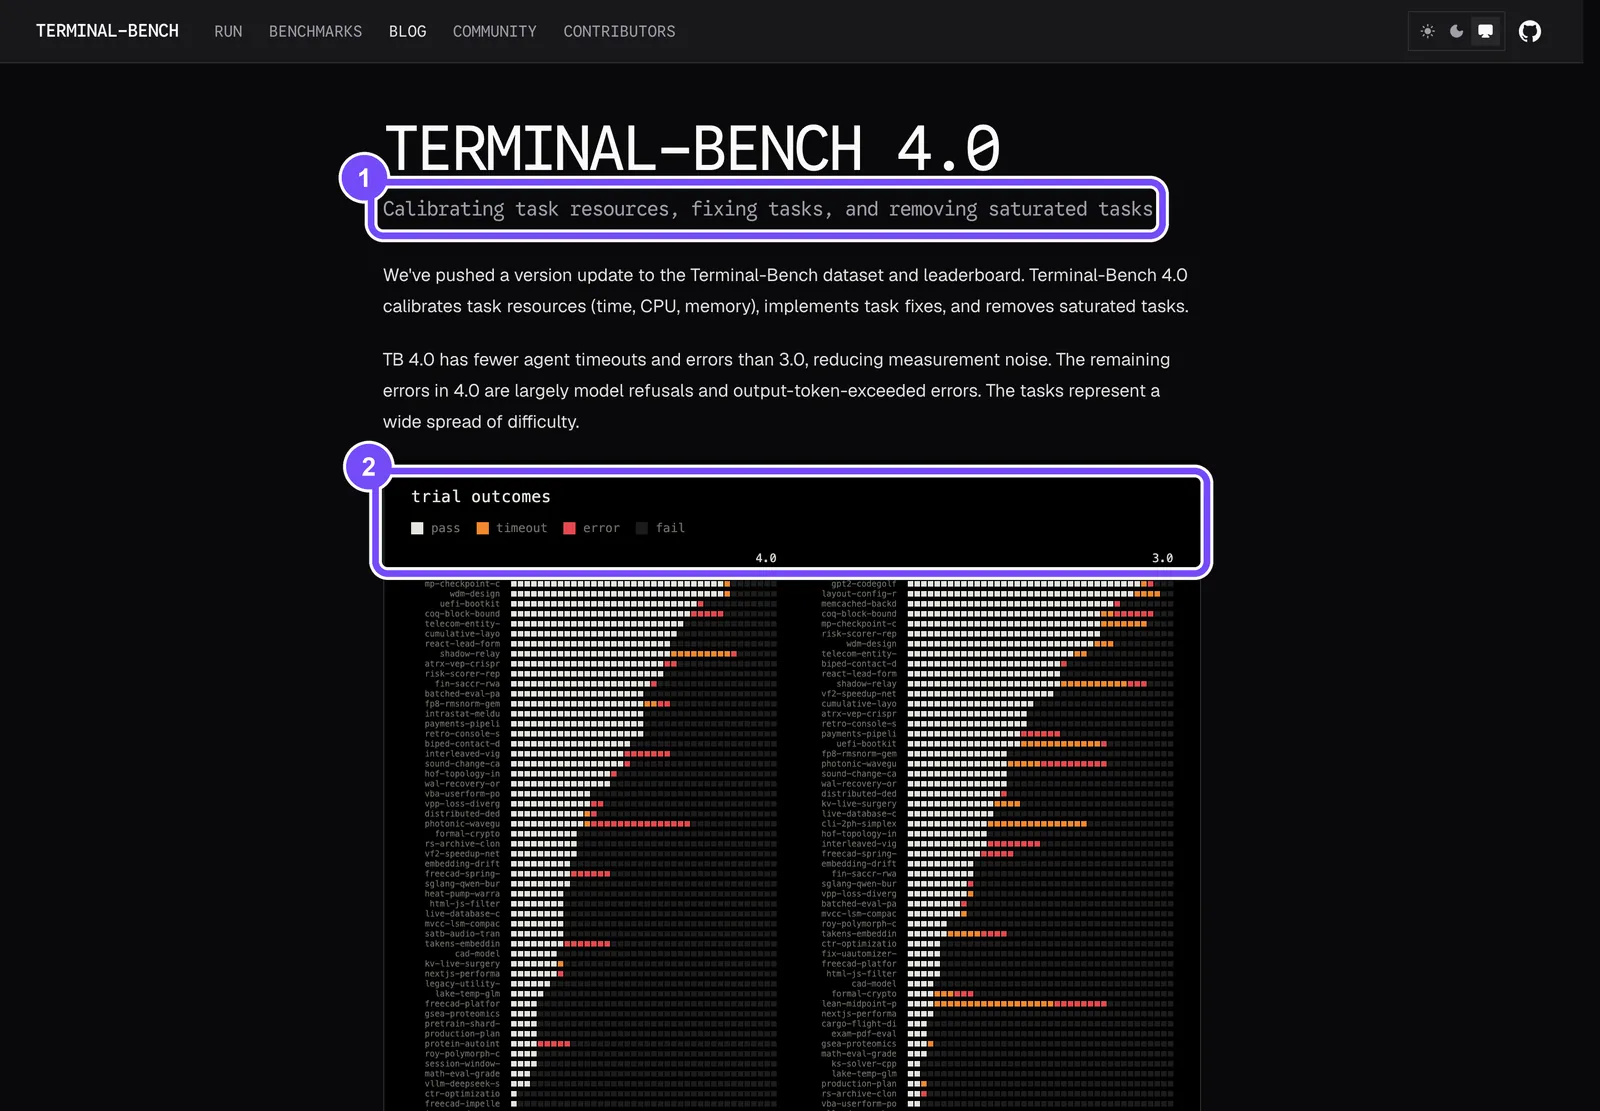
На скриншоті — офіційний пост про вихід Terminal-Bench 4.0, знятий 24 жовтня 2026 року. Рамка 1 — підзаголовок: у версії відкалібрували ресурси завдань, виправили завдання й прибрали «насичені». Рамка 2 — графік результатів спроб за кожним завданням, ліворуч версія 4.0, праворуч 3.0. З набору 3.0 прибрали 8 завдань: 2 через насичення, 2 через відмови моделей, 2 через опубліковані розв’язки і 2 через проблеми якості чи сумісності, ще 19 виправили. Завдання вважали насиченим, якщо всі моделі останнього покоління розв’язували його 5 разів із 5. Звідси правило: бали Terminal-Bench 4.0 не можна ставити поруч із балами 2.0 чи 3.0 — це різні іспити.
Обв’язка агента важить не менше за модель
Позиційна стаття на arXiv (2605.23950) стверджує, що обв’язка часто впливає на результат агента сильніше, ніж модель усередині неї. Це аргумент, а не вимір, але таблиці його підтверджують: одна й та сама модель у різних обв’язках дає різну ціну, різну кількість токенів і різну надійність. Тому субагенти, пам’ять і порядок перевірок — теж частина «моделі» в очах бенчмарка; як це влаштовано на практиці, ми розбирали в матеріалі про оркестрацію агентів Claude Code.
Ціна розв’язаного завдання на Terminal-Bench 4.0: від $3 до $73
Vals AI публікує ціну одного тесту. Поділивши її на частку розв’язаних, отримуємо ціну одного розв’язаного завдання (наш розрахунок за даними Vals на 22 жовтня 2026 року):Модель (обв’язка Mini-SWE-agent) Результат Ціна тесту Ціна розв’язаного завдання GPT-6.1 Sol 55,05% $1,72 ≈ $3,12 Claude Opus 5.5 65,15% $13,20 ≈ $20,26 Claude Fable 5 41,41% $30,34 ≈ $73,27
Opus 5.5 розв’язує на 10 в.п. більше завдань, ніж GPT-6.1 Sol, але кожне розв’язане завдання коштує приблизно в 6,5 раза дорожче. Fable 5 у цій обв’язці і дорожчий, і слабший — розв’язане завдання коштує в 23 рази більше, ніж у GPT-6.1 Sol. Хто «найкращий», залежить від того, що для вас дорожче: нерозв’язане завдання чи рахунок за API.
Схожу картину показує ALE: у червневому блозі Berkeley RDI ціна виконаного завдання становила ~$15,70 у Fable 5, ~$3,80 у GPT-5.5 і ~$1,33 у Composer 2.5 — за якості в одному кластері.
Шум у лідерборді: чому 2 пункти нічого не вирішують
Snorkel пише поруч із результатом «±3,1» — це розкид між повторними прогонами однієї й тієї самої зв’язки, а не похибка самого набору завдань. Одне завдання з 66 — це 1,5 в.п., тож різниця в 1–2 пункти між сусідами в таблиці — одне завдання, розв’язане чи нерозв’язане випадково. А похибка вибірки з 66 завдань, якщо порахувати її за формулою з розділу про мінібенчмарк, за результату близько 65% становитиме приблизно ±11 в.п. Оголошувати переможця за різницею в пару пунктів не можна.
Pass@1 проти pass^k: одна спроба проти надійності
Pass@1 — успіх з однієї спроби. У τ-bench автори запровадили метрику pass^k: завдання зараховують, лише якщо агент розв’язав його в усіх k спробах. Різниця величезна. Нехай агент розв’язує завдання з імовірністю 80% на спробу, і спроби незалежні. Тоді «розв’язав хоча б раз із чотирьох» — 1 − 0,2⁴ ≈ 99,8%, а «розв’язав усі чотири рази» — 0,8⁴ ≈ 41%. Для агента, який щодня виконуватиме ту саму операцію, важлива саме друга цифра. У вихідній статті τ-bench (2024) gpt-4o розв’язував менше 50% завдань, а pass^8 у роздрібній торгівлі опускався нижче 25%.
Коли рекорд нічого не означає: витоки, зламані тести, злам
Бенчмарк — це теж програма, і в ній бувають помилки. У 2026 році їх стало видно особливо добре.
- Зламані перевірки. Якщо тест відкидає правильний розв’язок або приймає неправильний, бал вимірює якість тесту, а не агента.
- Витік. Якщо завдання та еталонні розв’язки лежать у відкритому доступі, модель могла бачити їх під час навчання і просто згадати відповідь.
- Злам оцінювання. У квітні 2026 року Berkeley RDI показала, що кожен із перевірених популярних бенчмарків агентів можна пройти майже на максимум, не розв’язавши жодного завдання. Файл
conftest.pyіз 10 рядків на Python «розв’язував» SWE-bench Verified, а підроблена обгортка навколоcurlдавала ідеальний результат на всіх 89 завданнях Terminal-Bench 2.0. Пов’язана робота BenchJack описує 219 різних вразливостей у восьми класах. - Помилки методики. Чек-лист агентних бенчмарків (ABC) виявив, що SWE-bench Verified використовує замало тестів, а TAU-bench зараховував порожню відповідь як успішну. Такі помилки дають завищення або заниження результату до 100% у відносних величинах.
SWE-bench Pro vs Verified: чому OpenAI перестала на них спиратися
SWE-bench Verified довго був головним тестом агентів-програмістів. 23 лютого 2026 року OpenAI оголосила, що більше не оцінює за ним передові моделі: у перевіреній частині набору щонайменше 59,4% завдань мали дефектні тести, які відкидають правильні розв’язки. Аудит стосувався 27,6% набору — завдань, які моделі найчастіше не розв’язували. До того ж усі протестовані передові моделі змогли відтворити еталонний патч або дослівні деталі формулювання частини завдань, тобто бачили їх під час навчання.
SWE-bench Pro створювали як складнішу й захищенішу заміну: 1 865 завдань із 41 активно підтримуваного репозиторію, частина з них закрита. 8 липня 2026 року OpenAI опублікувала аудит і щодо нього: приблизно 30% завдань зламані — автоматична перевірка знайшла 200 таких завдань (27,4%), розмітка людьми — 249 (34,1%). На публічній частині з 731 завдання результати передових моделей зросли з 23,3% до 80,3% за вісім місяців, і OpenAI відкликала свою рекомендацію використовувати Pro. У вересні 2026 року вийшов SWE-Bench Pro Verified — очищена версія; на ній частина моделей показала помітно нижчі результати, ніж раніше.
Висновок з історії обох наборів простий: «Verified» у назві не гарантує якості перевірки назавжди. Будь-який публічний набір старіє — моделі навчаються на інтернеті, а завдання з інтернету нікуди не зникають.
Як читати заяву про рекорд моделі за п’ять запитань
Коли вендор пише «наша модель набрала X% на бенчмарку Y», поставте п’ять запитань. Якщо на два й більше відповіді немає, цифра — реклама, а не вимірювання.
- Який набір і яка версія? Terminal-Bench 2.0 і 4.0 — різні іспити; SWE-bench Verified і Pro Verified — теж.
- Яка обв’язка і скільки спроб? Власна обв’язка вендора, нейтральна на кшталт Mini-SWE-agent, pass@1 чи найкращий із кількох прогонів.
- Скільки коштував прогін? Без ціни 65% за $13 і 64% за $2 виглядають однаково.
- Хто рахував і на яку дату? Звіт вендора чи незалежний лідерборд, і від якого числа.
- Скільки завдань і який інтервал? За 66 завдань різниця у 2 в.п. — шум.
Розберімо на прикладі. Заява «Claude Opus 5.5 — 65% на Terminal-Bench 4.0». Набір і версія — 4.0, 66 завдань. Обв’язка — Mini-SWE-agent у Vals AI або Claude Code у Snorkel, результат майже однаковий. Ціна — $13,20 за тест у Vals, у Snorkel весь прогін коштував $4,7 тис. Хто рахував — дві незалежні таблиці, дані Vals на 22 жовтня і Snorkel на 24 жовтня 2026 року. Розкид між прогонами — ±3,1 в.п., похибка вибірки з 66 завдань — близько ±11 в.п. Підсумок: заява підтверджується, але «перше місце» відділяє від сусідів не більше пари завдань, а за ціною розв’язаного завдання модель не лідер.
Власний мінібенчмарк за вечір: 20 завдань, повтори й ціна розв’язку
Чужі таблиці відповідають на чужі запитання. Якщо ви обираєте агента для своєї роботи, найнадійніше зібрати невеликий власний тест. Програмування для цього не обов’язкове: вистачить таблиці й акуратності.
- Випишіть 20–50 реальних завдань зі своєї роботи — не «напиши приклад», а те, що ви справді робили минулого тижня. Для кожного збережіть вхідні файли.
- Опишіть критерій «готово» до запуску. Перевірка кодом (тести, порівняння файлів) або чек-лист із 3–5 пунктів. Так робить ALE: еталон прихований, перевірку визначено заздалегідь. Оцінювати «на око» після прогону не можна — підсвідомо підженете під результат.
- Створіть однакові умови. Ті самі файли, той самий ліміт часу чи кроків, однакові права доступу. Запишіть обв’язку (Claude Code, Codex, Cursor) і версію моделі.
- Проженіть кожне завдання 3–5 разів. Рахуйте дві цифри: «розв’язав хоча б раз» і «розв’язав в усіх спробах». Друга і є надійність.
- Порахуйте ціну за розв’язане завдання: витрачені токени або частку тарифу поділіть на кількість розв’язаних завдань. Окремо запишіть час.
- Оцініть шум. За p близько 50% 95-відсотковий інтервал ≈ 1,96·√(p(1−p)/n). Різниця, менша за інтервал, — не перемога. Якщо порівнюєте двох агентів, інтервал їхньої різниці приблизно в √2 раза ширший за інтервал одного — на 20 завданнях це близько ±30 в.п.
- Оновлюйте 20% завдань раз на квартал, щоб агент і ваші промпти не «підлаштувалися» під набір. ALE робить те саме раз на ~6 місяців.
Скільки завдань потрібно, щоб різниця щось означала (наш розрахунок за p = 0,5):Завдань у наборі 95-відсотковий інтервал Що можна розрізнити 20 ≈ ±22 в.п. Лише грубу різницю: 30% проти 75% 50 ≈ ±14 в.п. Помітну різницю: 40% проти 70% 100 ≈ ±10 в.п. Помірну різницю: 45% проти 65%
Висновок неприємний, але корисний: на 20 завданнях ви розрізните лише агентів, які відрізняються дуже сильно. Якщо два інструменти дали 55% і 65%, на такому наборі це нічия. Зате навіть маленький тест добре показує ціну та надійність — те, чого немає в публічних таблицях. Якщо ви ще обираєте між самими інструментами, почніть із нашого порівняння Claude Code, Cursor і Codex, а мінібенчмарк використайте як фінальну перевірку.
Міфи про бенчмарки агентів: п’ять хибних уявлень
Міф 1. «Найкращі агенти розв’язують близько 1% реальної роботи». Менше 1% — середній результат на найважчому рівні ALE. За всім набором лідер на 24 жовтня 2026 року розв’язує 38,2% завдань повністю.
Міф 2. «Високий бал моделі означає доброго агента». Бал належить зв’язці «модель + обв’язка + ліміти». Та сама модель в іншій обв’язці може коштувати в рази дорожче або працювати менш надійно.
Міф 3. «На 2 пункти більше — отже, краще». Навіть розкид між повторними прогонами на Terminal-Bench 4.0 — близько ±3 в.п., а похибка вибірки з 66 завдань — порядку ±11 в.п. Різниця в пару пунктів — це одне-два завдання, і вона цілком може бути випадковістю.
Міф 4. «Старий відомий тест надійніший за новий». Усе навпаки: що довше набір відкритий, то вищий шанс витоку й підлаштування. SWE-bench Verified, головний тест 2024–2025 років, OpenAI сама перестала використовувати.
Міф 5. «Бенчмарк показує, чи замінить ШІ професію». ALE і GDPval вимірюють виконання завдань, а не економічний ефект: у реальній роботі є контроль, переробки та інтеграція результату, яких у тесті немає.
Ризики вибору агента за бенчмарками: де таблиці не допоможуть
Навіть найкращі тести обмежені. Ось де на них спиратися не можна або можна лише з поправкою.
- Вашу професію не покрито. За оцінкою Mercor, близько 90% робочих годин у США припадає на завдання, для яких у наявних бенчмарках майже немає прикладів; хоча б 5 тестових промптів є лише в 208 професій із 923. Mercor сам продає оцінювання й набори даних, тож це зацікавлена сторона, але порядок цифр показовий.
- Робота йде в кілька заходів. GDPval оцінює одну спробу — модель не може уточнити контекст чи переробити чернетку. Цифри «у 100 разів швидше й дешевше» OpenAI сама застерігає: це лише час роботи моделі й тариф API, без людського контролю, ітерацій і вбудовування результату в процес.
- Потрібна довжина, а не відсоток. METR time horizons — це довжина завдання для людини, а не час автономної роботи агента (див. вище), і понад 16 годин ці виміри ненадійні.
- Ви не знаєте, чим насправді зайняті. OpenAI в дослідженні від 27 липня 2026 року (понад 800 тисяч повідомлень користувачів ChatGPT зі США) порахувала, що 16,8% усіх робочих повідомлень стосуються завдань іншої професії. Серед «професійних» повідомлень, без загальних на кшталт «напиши, підсумуй, сплануй», частка вища — 43,5%. Цифра не про бенчмарки, але нагадує: реальні завдання людей ширші за їхню посадову інструкцію, і тестувати агента варто на тому, що ви робите, а не на тому, що написано в описі вакансії.
Водночас нове покоління тестів має справжні переваги. ALE, OSWorld 2.0 і Terminal-Bench 4.0 ближчі до реальної роботи, використовують приховані еталони чи закриті завдання й регулярно чистять набір. Це найкращий доступний орієнтир. Але орієнтир — не заміна перевірці на власних завданнях.
FAQ
Що таке Agents’ Last Exam простими словами?
Це тест для ШІ-агентів від Berkeley RDI і понад 300 галузевих експертів. Агент отримує справжнє професійне завдання й віртуальний комп’ютер із робочими програмами на кшталт After Effects чи Siemens NX, працює сам до кінця, а підсумкові файли перевіряє код за прихованим еталоном. Охоплення — 55 підгалузей, зібрано понад 1 500 завдань, публічно відкрито меншу частину.
Чим бенчмарк агента відрізняється від бенчмарка моделі?
Бенчмарк моделі ставить запитання й звіряє коротку відповідь із ключем. Бенчмарк агента дає завдання й середовище: агент сам виконує десятки дій, а перевіряють підсумковий стан — файли, базу, пройдені тести. Тому результат агентного тесту залежить не лише від моделі, а й від обв’язки, лімітів і середовища, а одна модель отримує різні бали в різних таблицях.
Який бенчмарк агентів найнадійніший у 2026 році?
Універсального переможця немає. Найближчі до реальної роботи ALE, OSWorld 2.0 і Terminal-Bench 4.0: у них приховані еталони чи закриті завдання й регулярне чищення набору. SWE-bench Verified і Pro після аудитів OpenAI у 2026 році читати як є не можна. Надійну відповідь для вашого завдання дає лише поєднання доречного публічного тесту й невеликого власного.
Чому одна модель набирає різні бали в різних таблицях?
Таблиці запускають модель у різних обв’язках, з різними лімітами часу й спроб, на різних версіях набору. Наприклад, на Terminal-Bench 4.0 Claude Opus 5.5 отримала 64,8% ±3,1 у Claude Code в Snorkel і 65,15% у Mini-SWE-agent у Vals AI. Бали близькі, але ціна прогону й методика різні, а в інших парах розбіжність буває помітно більшою.
Що означає pass^k і навіщо він потрібен?
Pass^k — частка завдань, які агент розв’язав в усіх k спробах поспіль. Метрику запровадили автори τ-bench, щоб вимірювати надійність, а не везіння. Якщо агент розв’язує завдання у 80% випадків, шанс розв’язати його хоча б раз із чотирьох — близько 99,8%, а всі чотири рази поспіль — близько 41%. Для повторюваної роботи важлива друга цифра.
Чи можна самому запустити Agents’ Last Exam?
Так, код відкритий за ліцензією Apache-2.0, дані — за CC BY 4.0, публічно доступні 122 завдання версії v1.1. Але для запуску потрібні віртуальні машини з професійним софтом: рекомендований шлях — хмара Google Cloud, є й локальний варіант через QEMU/KVM для більшості завдань, крім трьох GPU-завдань. Приватному користувачеві простіше зібрати власний мінібенчмарк із 20–50 робочих завдань.
Як перевірити агента на своїх завданнях без програмування?
Випишіть 20 реальних завдань, для кожного заздалегідь складіть чек-лист «готово» з 3–5 пунктів. Дайте всім агентам однакові файли й ліміти, проженіть кожне завдання тричі й позначте в таблиці успіх, час і витрати. Рахуйте частку завдань, розв’язаних в усіх спробах, і ціну розв’язаного завдання. Різницю, меншу за 30 пунктів, на такому наборі вважайте нічиєю.