Коротко (TL;DR)
Станом на 15 листопада 2026 року власні ШІ-чипи Amazon і Google наздогнали Nvidia Blackwell Ultra (B300/GB300) за паспортною потужністю у форматі FP8, але не Rubin: у парі AWS Trainium vs Nvidia це видно на рівні систем, у парі Google TPU проти Nvidia — вже на рівні одного чипа. У окремих завданнях TPU дає більше токенів на долар. Проте ці чипи не витісняють відеокарти Nvidia, а стають поруч із ними — навіть у хмарах самих Amazon і Google.
- Коротко (TL;DR)
- ASIC проти GPU: чим Trainium і TPU відрізняються від відеокарт Nvidia
- Які чипи актуальні на 15.11.2026: Trainium 3, TPU 8 і Rubin
- Trainium3, Ironwood і Nvidia B300 на чип: HBM, ТБ/с і FP8/FP4
- Ironwood проти GB300 у тестах: що показав незалежний InferenceX
- Скільки коштує PFLOPS-година: розрахунок за прайсами Google і AWS
- Хто працює на Trainium і TPU: Anthropic, OpenAI, Meta
- Чому Nvidia лишається лідером: CUDA, NVLink і постачання
- Частка ринку ASIC: 27,8% серверів і близько 80% виторгу в Nvidia
- Що гонка чипів означає для цін на ШІ: оренда, API і вибір
- Де розходяться джерела: ціна Ironwood, S-1 Anthropic і FP8 Trainium
- Ризики для Trainium, TPU і Nvidia: вендорські цифри, CoWoS і 2027
- Часті запитання про Trainium, TPU і Nvidia
Головний перекіс у тому, що в Nvidia лишаються формат FP4, нове покоління Rubin, програмна екосистема CUDA і, за оцінками галузі, близько 75–80% виторгу ринку ШІ-прискорювачів. Найгучніші відповіді конкурентів — Trainium4 і TPU 8i Max — вийдуть лише 2027 року.
- Система на систему. Trn3 UltraServer (144 чипи Trainium3) видає 362 PFLOPS у FP8 за даними AWS — майже стільки ж, скільки стійка Nvidia GB300 NVL72 (360 PFLOPS dense). Нова стійка Vera Rubin NVL72 — вже 1 260 PFLOPS, у 3,5 раза більше.
- Чип на чип. Google TPU v7 Ironwood — 4,61 PFLOPS FP8 проти 5 PFLOPS у Nvidia B300, але под Google збирає до 9 216 чипів, а стійка Nvidia — 72 GPU.
- Незалежний тест. У InferenceX від 19 жовтня 2026 року на моделі Qwen3.5-397B за швидкості 200 токенів на секунду на користувача Ironwood у FP8 дав у 1,85 раза більше токенів на долар, ніж GB300 у FP8. Проти GB300 у FP4 картина зворотна: у TPU лише 0,54 від результату Nvidia.
- Наш розрахунок ціни. PFLOPS-година FP8 в Ironwood за прайсом Google коштує $2,60 без зобов’язань і $1,17 за контракту на 3 роки; у B300 в AWS Capacity Blocks — $3,23. Натомість у FP4 той самий B300 обходиться в $1,08.
- Хто на них працює. Anthropic за S-1/A-2 від 10 листопада 2026 року одночасно використовує Trainium, TPU, GPU Nvidia та AMD; OpenAI зобов’язалася споживати близько 2 ГВт потужностей Trainium; Meta вже обслуговує моделі на TPU.
ASIC проти GPU: чим Trainium і TPU відрізняються від відеокарт Nvidia
ASIC (application-specific integrated circuit) — це мікросхема, спроєктована під вузький клас завдань. Trainium від AWS і TPU від Google — ASIC для нейромереж: майже весь кристал віддано блокам матричного множення, на якому тримаються і навчання моделі, і інференс (генерація відповіді). GPU Nvidia — універсальний паралельний процесор: його програмують через CUDA під будь-які обчислення, і ШІ — лише найприбутковіше з них.
Спеціалізація дає виграш у ціні та енергоспоживанні на «своїх» завданнях і програш у гнучкості. Свіжий приклад: Ironwood не має нативної підтримки формату FP4, на який робить ставку Nvidia, — і в тестах це вирішує результат порівняння (докладно нижче). Зробити власний ASIC до снаги лише гіперскейлерам: за даними CNBC на листопад 2025 року, розробка кастомного чипа коштує десятки мільйонів доларів ще до першої партії, а Nvidia продає стійку GB200 NVL72 приблизно за $3 млн.
Друга відмінність — як чипи об’єднуються в один великий комп’ютер (scale-up). Nvidia з’єднує 72 GPU через комутатори NVLink: будь-який GPU стійки обмінюється даними з будь-яким на повній швидкості. Google збирає TPU в тривимірний тор, де кожен чип з’єднаний із сусідами безпосередньо, а оптичні комутатори перебудовують топологію поду. Масштаб у тора більший, але сигнал до далекого чипа йде через проміжні. Google робить TPU понад десять років і навіть випробовує TPU Google на орбіті, а 2026 року вперше почала ставити TPU-системи в дата-центри клієнтів.Параметр Google TPU v7 Ironwood AWS Trainium3 Nvidia B300 (GB300 NVL72) Тип чипа ASIC ASIC GPU Де взяти Google Cloud; з 2026 року — ЦОДи клієнтів лише AWS; поза AWS — план «кінець 2027» будь-які хмари й купівля серверів Об’єднання в scale-up 3D-тор, до 9 216 чипів у поді Trn3 UltraServer, до 144 чипів NVLink 5 з комутаторами, 72 GPU Канал між чипами 600 ГБ/с в один бік (1 200 ГБ/с в обидва) н/д 900 ГБ/с в один бік Нативний FP4 немає MXFP4 з тією самою піковою цифрою, що й FP8 так, 15 PFLOPS dense Софт для PyTorch TorchTPU (відкрито в жовтні 2026), бекенди vLLM і SGLang Neuron, TorchNeuron (відкрито 20.10.2026) CUDA, TensorRT-LLM, Dynamo
Канали між чипами — за документацією Google і зведенням SemiAnalysis InferenceX; дані Trainium3 — зі сторінки AWS (перевірено 15.11.2026).
Які чипи актуальні на 15.11.2026: Trainium 3, TPU 8 і Rubin
Найбільше плутанини в темі створюють анонси, які видають за доступне залізо. У конкурентних оглядах Trainium4 і TPU 8 порівнюють із Blackwell так, ніби їх уже можна орендувати. На середину листопада 2026 року картина така.Вендор Чип або система Статус на 15.11.2026 Ключова дата AWS Trainium3 / Trn3 UltraServer, перший 3-нм чип AWS загальний доступ в EC2 GA 02.12.2025 AWS Trainium4 у розробці, постачання очікуються з 2027 року анонс 02.12.2025 AWS Trainium для клієнтів поза AWS план «late in 2027» заява 29.10.2026 Google TPU v7 Ironwood загальний доступ, є публічний прайс анонс 04.2025, GA — 2026 Google TPU 8t (навчання) і TPU 8i (інференс) анонсовано, незалежних тестів немає 22.04.2026 Google TPU 8tx (конфіденційні обчислення) і TPU 8i Max анонсовано, доступність — 2027 09.11.2026 Nvidia B300 / GB300 NVL72 (Blackwell Ultra) масово в хмарах, в AWS — інстанси P6-B300 у продажу Nvidia Vera Rubin NVL72 виробничі постачання з серпня 2026; GA в Oracle Cloud 27.10.2026 Microsoft Maia 300 анонсовано, у продакшн — 2027 12.10.2026
Звідси перше правило читання новин: у порівнянні AWS Trainium 3 vs Nvidia чесна пара — Trainium3 проти B300 і Rubin, а Trainium4 змагається з тим, що Nvidia випустить 2027 року. Для Google чесна пара — Ironwood проти Blackwell Ultra: саме так її і тестує SemiAnalysis. TPU 8t і 8i — наступний крок, який Google описує в технічному розборі TPU 8t і TPU 8i від 22 квітня 2026 року, але замірів на них поки немає.
Nvidia тим часом уже відвантажує Rubin — його порівняння з іншим претендентом, AMD, ми розбирали в матеріалі AMD Instinct MI400 проти Nvidia Vera Rubin. За блогом Nvidia, загальний доступ до інстансів Vera Rubin у Google Cloud очікується в листопаді 2026 року — тобто Google здаватиме в оренду і свої TPU, і найновіший GPU конкурента.
Trainium3, Ironwood і Nvidia B300 на чип: HBM, ТБ/с і FP8/FP4
Три цифри вирішують, скільки ШІ-завдань чип опрацює за годину. Перша — обсяг пам’яті HBM: це стеки DRAM прямо на підкладці поруч із кристалом, у них живуть ваги моделі й кеш контексту. Друга — пропускна здатність цієї пам’яті: під час генерації відповіді чип більшість часу чекає на дані, тому ТБ/с часто важливіші за PFLOPS.
Третя — обчислювальна потужність у форматі чисел. FP8 і FP4 — восьми- та чотирибітні числа з рухомою комою: що менше біт, то більше операцій за такт, але й вищий ризик втратити точність моделі. Ще одна пастка — dense і sparse: Nvidia часто друкує «розріджені» (sparse) цифри, удвічі вищі за «щільні» (dense). Нижче — лише dense, якщо не зазначено інше.
| На один чип | Trainium3 | TPU v7 Ironwood | TPU 8t | TPU 8i | Nvidia B300 | Nvidia Rubin |
|---|---|---|---|---|---|---|
| Пам’ять | 144 ГБ HBM3e | 192 ГіБ (≈206 ГБ) HBM3e | 216 ГБ | 288 ГБ | 288 ГБ HBM3e | 288 ГБ HBM4 |
| Пропускна здатність | 4,9 ТБ/с | 7,37 ТБ/с | 6,53 ТБ/с | 8,6 ТБ/с | 8 ТБ/с | 19,2 ТБ/с |
| FP8, PFLOPS | 2,52* | 4,61 | н/д | н/д | 5 | 17,5 |
| FP4, PFLOPS | 2,52* (MXFP4) | немає нативного | 12,6 (пік) | 10,1 (пік) | 15 | 50 (інференс, sparse) |
| Scale-up | 144 чипи | 9 216 чипів | 9 600 чипів | до 1 152 чипів | 72 GPU | 72 GPU |
| Статус | доступний | доступний | анонс | анонс | доступний | постачання з 08.2026 |
*AWS публікує 362 PFLOPS FP8 на систему зі 144 чипів, тобто ≈2,52 на чип, і не уточнює, dense це чи sparse. Цифри Google щодо TPU 8t і 8i — пікові FP4; FP8 для них Google не публікує, тому пряме порівняння з Ironwood і Blackwell у FP8 неможливе.
Що видно з таблиці, якщо поділити одне на інше:
- Ironwood майже дорівнює B300: 0,92 від нього за FP8 і за пропускною здатністю пам’яті, 0,72 за обсягом HBM. Відставання — в межах одного покоління.
- Trainium3 на чип удвічі слабший за B300: 0,5 за FP8 і за пам’яттю, 0,61 за пропускною здатністю. AWS надолужує кількістю чипів у системі.
- Rubin відривається: у 3,5 раза більше FP8 і в 2,4 раза більша пропускна здатність, ніж у B300. З ним 2026 року не може зрівнятися жоден ASIC — відповіді конкурентів (TPU 8i Max із 384 ГБ і 17,2 ТБ/с, Trainium4) датовані 2027 роком.
Системи Trn3 UltraServer, под Ironwood і NVL72: що з чим порівнювати
На рівні систем картина рівніша. Trn3 UltraServer — 144 чипи і 362 PFLOPS FP8, GB300 NVL72 — 72 GPU і 360 PFLOPS FP8 dense (Nvidia пише 720 PFLOPS із розрідженістю). Цікавий збіг: в обох систем і в стійки Vera Rubin NVL72 по 20,7 ТБ пам’яті — 144 × 144 ГБ і 72 × 288 ГБ дають те саме число. Різниця в тому, що Rubin NVL72 видає 1 260 PFLOPS FP8 (72 × 17,5) за тієї самої пам’яті, тільки вже HBM4 з пропускною здатністю 1 400 ТБ/с на стійку проти 706 ТБ/с у Trn3 UltraServer.
Под Ironwood на 9 216 чипів за нашим множенням дає близько 42 500 PFLOPS FP8. Це не означає, що под «у 118 разів потужніший за стійку Nvidia»: завдання, яким потрібен цілий под, є в одиниць лабораторій, а в тора й комутованого NVLink різна ціна передавання даних між далекими чипами.
Енергоефективність Ironwood і GB300: PFLOPS FP8 на кіловат
SemiAnalysis закладає в планування дата-центрів 1,207 кВт на чип Ironwood і 2,12 кВт на GPU GB300 — це потужність з урахуванням охолодження й мережі. Звідси наш розрахунок: 4,614 / 1,207 ≈ 3,82 PFLOPS FP8 на кВт в Ironwood проти 5 / 2,12 ≈ 2,36 у GB300, тобто перевага TPU приблизно в 1,6 раза. Для ЦОДу, який упирається в ліміт підведеної потужності, це аргумент сильніший за паспортні PFLOPS.
Ironwood проти GB300 у тестах: що показав незалежний InferenceX
InferenceX — відкрита панель замірів SemiAnalysis, де прискорювачі ганяють на однакових агентних сценаріях (AgentX) і підраховують токени на долар вартості володіння. Це єдиний знайдений нами незалежний замір у парі «TPU Ironwood vs Nvidia». Для Trainium3 незалежних тестів на 15.11.2026 немає зовсім — є лише заява AWS про зростання «до 4,4 раза» відносно систем Trn2.
Методика важить не менше за результат. Вартість обчислюється за моделлю SemiAnalysis: $2,31 за GPU-годину для GB300 NVL72, $1,21 за чип-годину Ironwood для зовнішнього покупця і $1,03 — для самої Google. Швидкість — p90 інтерактивності, тобто токенів на секунду на одного користувача.Порівняння (InferenceX, 19.10.2026) Модель Швидкість на користувача TPU до GB300, токени на $ (зовн. / внутр. вартість) TPU до GB300 на МВт Ironwood FP8 проти GB300 FP8 (Dynamo SGLang) Qwen3.5-397B 200 ток/с 1,85x / 2,17x 1,70x Ironwood FP8 проти GB300 FP4 (Dynamo TensorRT-LLM) Qwen3.5-397B 200 ток/с 0,54x / 0,64x 0,50x Ironwood проти GB300 (Dynamo vLLM), Kimi K3: ваги MXFP4, активації MXFP8 в обох систем Kimi K3 100 ток/с 0,97x / 1,15x 0,90x
Перший рядок — джерело заголовків «TPU в півтора-два рази вигідніший за Nvidia». Він правильний, але лише за однакової точності FP8. Другий рядок — той самий тест, але Nvidia вмикає FP4, якого в Ironwood немає, і виграє майже вдвічі: за підсумковою таблицею InferenceX GB300 у FP4 попереду в усіх зіставних точках за обох оцінок вартості. На моделі Kimi K3 GB300 веде за зовнішньою вартістю, а TPU — лише за внутрішньою вартістю Google. FP4 у цьому рядку — формат ваг самої моделі; апаратних FP4-обчислень в Ironwood немає.
Застереження авторів, без яких цифри читаються неправильно:
- AgentX не оцінює якість відповідей, тому різниця в точності між FP4 і FP8 лишається поза межами тесту.
- Ironwood у тесті на Qwen працював на одному хості з 4 чипів, GB300 — на конфігураціях до 32 GPU.
- У кривих GB300 є прогалини, і частину значень між замірами інтерпольовано.
Видання NeoTeo в розборі від 8 листопада 2026 року дійшло того самого висновку: результати залежать від моделі, точності й софту та описують конкретні конфігурації, а не загальний рейтинг прискорювачів. Сама SemiAnalysis у тій самій публікації InferenceX від 19 жовтня 2026 року нагадує, що її раніші «до 50% краще за ціною» для Ironwood стосувалися іншого сценарію (запити 8k/1k) і порівняння FP8 з FP8 проти B200 і B300.
Скільки коштує PFLOPS-година: розрахунок за прайсами Google і AWS
Паспортні PFLOPS нічого не кажуть про гроші, тому ми поділили публічну ціну чип-години на потужність чипа у FP8 dense. Вийшла ціна однієї PFLOPS-години — скільки коштує година роботи умовного «петафлопса» в хмарі. Метод грубий: він не враховує завантаження, мережу й софт. Зате він обчислюється за першоджерелами й показує порядок цін.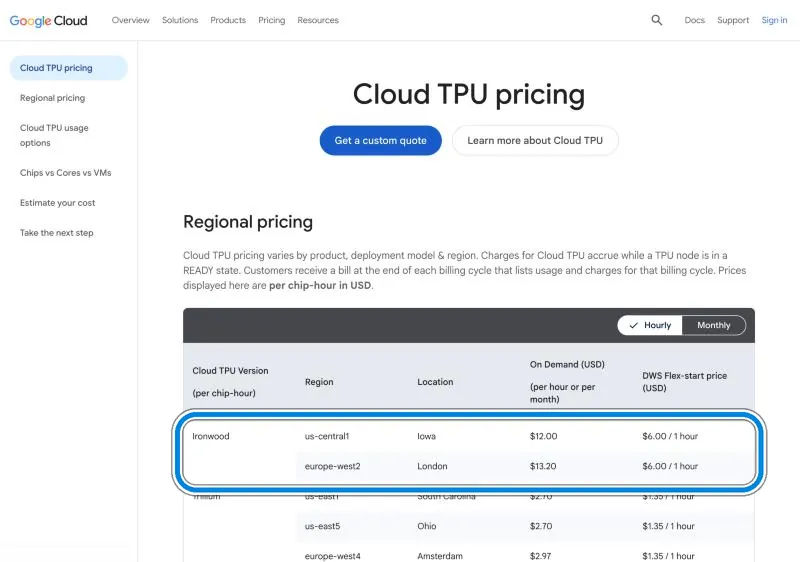
Скриншот: cloud.google.com/tpu/pricing, 15.11.2026. Рамкою виділено рядок Ironwood: за прайсом Google Cloud TPU чип-година коштує $12,00 без зобов’язань у регіоні us-central1 (Айова), $13,20 в europe-west2 (Лондон) і $6,00 у режимі DWS Flex-start, де завдання чекає на вивільнені потужності. Ціни вказано за один чип на годину.Чип і умови (15.11.2026) Ціна за чип-годину FP8 dense, PFLOPS $ за PFLOPS-годину FP8 Ironwood, on-demand, us-central1 $12,00 4,614 $2,60 Ironwood, on-demand, europe-west2 $13,20 4,614 $2,86 Ironwood, DWS Flex-start $6,00 4,614 $1,30 Ironwood, зобов’язання на 1 рік $8,40 4,614 $1,82 Ironwood, зобов’язання на 3 роки $5,40 4,614 $1,17 Nvidia B300, AWS Capacity Blocks (p6-b300, $129,168 за 8 GPU) $16,146 5,0 $3,23 Nvidia B300 у FP4, ті самі умови $16,146 15 (FP4) $1,08 за PFLOPS FP4 Nvidia B200, AWS Capacity Blocks (p6-b200) $14,208 — — Nvidia H100, AWS on-demand (p5, us-east-1) $6,88 — — AWS Trainium2, Capacity Blocks (trn2.48xlarge, 16 чипів) $2,235 — — AWS Trainium3 н/д: AWS не публікує ціну 2,52 н/д
Висновки з таблиці:
- За прайс-листом Ironwood дешевший за B300 у FP8 приблизно на 20% навіть без знижок ($2,60 проти $3,23), а з трирічним контрактом — майже в 2,8 раза.
- FP4 перевертає розрахунок. Якщо модель тримає якість у FP4, PFLOPS-година B300 коштує $1,08 — дешевше за будь-який варіант Ironwood у FP8. Це та сама історія, що й у тесті InferenceX.
- Порівняти AWS Trainium vs Google TPU за ціною зараз неможливо. Trainium3 не має публічної ціни: AWS продає його через інстанси й вимірює вигоду ціною токена, а не чипа. Відома лише блокова ставка Trainium2 — $2,235 за чип-годину.
Прайс-лист проти вартості володіння: Ironwood і GB300
Прайс-лист — це ціна для всіх. Великі клієнти платять за договорами, а самі гіперскейлери — собівартість. За моделлю SemiAnalysis, володіння чипом Ironwood обходиться зовнішньому покупцеві в $1,21 на годину, тобто близько $0,26 за PFLOPS-годину FP8; у GB300 — $2,31, або близько $0,46. Оренду Ironwood у Google на 3 роки SemiAnalysis оцінює в $2,00 за чип-годину, тоді як публічний прайс за ті самі 3 роки — $5,40. Це не помилка однієї зі сторін, а різні бази: відкритий прайс проти договірної оцінки.
Ціни на GPU Nvidia в AWS зростають
З 1 липня 2026 року AWS підняла ставки Capacity Blocks на GPU Nvidia — у H200 в p5e, наприклад, на 20%, з $39,80 до $47,76 за інстанс-годину, — а ставок Trainium підвищення не торкнулося (за розбором otontechnology). Водночас попит на Trainium теж високий: Енді Джассі 30 жовтня 2026 року сказав, що короткострокові потужності попередніх поколінь Trainium продаються з націнкою до першого півріччя. У липневій сітці B300 коштував $14,04 за GPU-годину, на 15 листопада 2026 року — $16,146, ще на 15% вище. Так само на 15% зросли ставки B200 і H100 у блоках: p6-b200 подорожчав з $12,355 до $14,208 за GPU-годину, p5 — з $5,191 до $5,970.
Хто працює на Trainium і TPU: Anthropic, OpenAI, Meta
Anthropic працює на обох чипах одночасно й підписала договори на гігавати потужностей; OpenAI законтрактувала близько 2 ГВт Trainium (Trn3 і Trn4, причому Trn4 — з 2027 року); Meta обслуговує моделі на TPU в продакшні. Найкращий тест для чипа — не бенчмарк, а готовність лабораторії довірити йому моделі на мільярди доларів, і тут Amazon і Google мають сильні аргументи.Клієнт і чип Що підписано Дата Чим підтверджено Anthropic — AWS Trainium понад $100 млрд на технології AWS за 10 років, до 5 ГВт потужностей, Trainium2/3/4 20.04.2026 Amazon, DCD Anthropic — Project Rainier близько 500 тис. чипів Trainium2 в одному кластері, запуск у жовтні 2025 10.2025 лише дані Amazon Anthropic — Google TPU до 1 млн TPU і понад 1 ГВт у 2026 році, «десятки мільярдів доларів» 23.10.2025 Anthropic, DCD Anthropic — Google і Broadcom 3,5 ГВт потужностей TPU з 2027 року, умови не розкрито 07.04.2026 DCD, Tom’s Hardware OpenAI — AWS Trainium близько 2 ГВт потужностей Trainium (Trn3 і Trn4), розширення договору на $100 млрд за 8 років до попередніх $38 млрд 27.02.2026 OpenAI, Amazon Meta — Google TPU SGLang на TorchTPU працює в продакшні Meta 22.10.2026 Tom’s Hardware з посиланням на Google Apple, Meta, Oracle — TPU клієнти TPU; в Oracle Cloud TPU з’являться з 2027 року 09.11.2026 Bloomberg через Straits Times
За даними Amazon, Project Rainier налічує близько 500 тис. чипів Trainium2; в S-1 Anthropic кількості чипів немає, тому незалежного підтвердження ця цифра не має. Сама Google 9 листопада 2026 року повідомила, що TPU вже мають майже 100 клієнтів — від лабораторій передових моделей до трейдингових фірм і університетів.
Найпоказовіший рядок — не в таблиці, а в проспекті Anthropic. У S-1/A-2 від 10 листопада 2026 року компанія описує свою архітектуру як мультичипову: AWS Trainium, Google TPU, GPU Nvidia і GPU AMD. Сукупні зобов’язання Anthropic щодо обчислень у цій редакції — близько $900,9 млрд. Для великої лабораторії вибір «Amazon Trainium vs Google TPU vs Nvidia GPU» звучить як «і те, і інше, і третє»:
- страховка від дефіциту: якщо один постачальник не встигає, навантаження переносять на іншого;
- торг за ціною: три платформи дають аргумент у переговорах із кожною;
- різні завдання: навчання, інференс і експерименти зручніше ставити на різне залізо.
Amazon 30 жовтня 2026 року, у звіті за третій квартал, повідомила, що зобов’язання клієнтів щодо виторгу зросли більш ніж у 20 разів рік до року — окремо в Trainium і окремо в Graviton. Попит на ASIC реальний — але він додається до попиту на Nvidia, а не замінює його.
Чому Nvidia лишається лідером: CUDA, NVLink і постачання
Якщо ASIC такі добрі на папері, чому Nvidia досі забирає більшість грошей? Причин п’ять, і на кожну є відповідь конкурентів — поки часткова.Сильна сторона Nvidia Цифра або факт Як відповідають AWS і Google Нове покоління вже в постачаннях Rubin: 17,5 PFLOPS FP8 на GPU, постачання з серпня 2026 TPU 8i Max і Trainium4 — 2027 Формат FP4 B300: 15 PFLOPS FP4 dense, лідер тесту InferenceX у FP4 нативний FP4 з’явиться в TPU 8t і 8i; в Ironwood його немає Софт CUDA стандарт для дослідників і open-source TorchNeuron і TorchTPU переносять PyTorch-код Доступність GPU є в усіх хмарах і в продажу ASIC лише в хмарі власника Гроші й постачання AWS розгорне ще 2 млн GPU Nvidia у 2027–2028 власних чипів бракує, Google орендує потужності в третіх сторін
Софт. Бар’єр CUDA звужується помітніше, ніж рік тому. Amazon 20 жовтня 2026 року відкрила TorchNeuron: щоб запустити PyTorch-модель на Trainium, досить замінити .to('cuda') на .to('neuron'), а сумісність перевірено на 100 тис. популярних моделей. Google у жовтні відкрила TorchTPU і бекенди vLLM та SGLang для TPU. Скептики в InfoQ слушно зауважують, що справжній іспит — не запуск, а швидкість і ціна токена на конкретному завданні.
Мережа і партнерство. Найнесподіваніша деталь: Trainium4 отримає технології самої Nvidia. Підтримку інтерфейсу NVLink Fusion AWS оголосила разом з анонсом Trainium4 2 грудня 2025 року, а пам’ять NVHBM — 26 серпня 2026 року. Конкурент Nvidia з’єднуватиме свої чипи її ж інтерфейсом. 26 серпня AWS і Nvidia оголосили про розгортання ще 2 млн GPU Nvidia у 2027–2028 роках. Amazon водночас змагається з Nvidia і лишається одним з її найбільших покупців.
Постачання. Nvidia відвантажує Rubin із серпня 2026 року і, за переказом Tom’s Hardware, очікує, що в третьому кварталі він дасть близько 20% виторгу сегмента дата-центрів. Alphabet на звіті 22 липня 2026 року визнала, що працює в умовах дефіциту потужностей і тимчасово закриває його орендою в третіх сторін. Окреме обмеження для Nvidia — експортний контроль США на постачання до Китаю; як його обходять, ми розбирали в матеріалі про санкції на чипи Nvidia і Китай.
Частка ринку ASIC: 27,8% серверів і близько 80% виторгу в Nvidia
Дві цифри, які в новинах часто протиставляють, насправді одна одній не суперечать. Одна враховує штуки, інша — гроші.Метрика ASIC (Trainium, TPU та інші) Nvidia і GPU Джерело й дата Частка в постачаннях ШІ-серверів, штуки (прогноз на 2026) 27,8% — максимум з 2023 року GPU-сервери 69,7% TrendForce, прогноз від 20.01.2026 Частка у виторгу ринку ШІ-прискорювачів близько 16% у кастомних чипів (розрахунок zhiyenotes) Nvidia близько 75% (Silicon Analysts) — близько 80% (оцінки галузі) оцінки на листопад 2026 Гроші в абсолюті чипи Amazon (Trainium + Graviton): понад $25 млрд на рік (річний темп на кінець липня 2026) Data Center Nvidia: $89,0 млрд за один квартал 31.07.2026 / 26.08.2026
Чому так виходить: чип ASIC дешевший, а внутрішні чипи гіперскейлерів враховуються за собівартістю, без маржі Nvidia. За моделлю SemiAnalysis година володіння Ironwood коштує 52% від години GB300. Тому кожен сервер на TPU у штуках важить стільки ж, скільки сервер на GPU, а у виторгу ринку — помітно менше.
Наш розрахунок масштабу: у другому кварталі 2027 фінансового року (травень — липень 2026) сегмент Data Center Nvidia приніс $89,0 млрд, у річному темпі це близько $356 млрд. Увесь чиповий бізнес Amazon — понад $25 млрд на рік (річний темп на кінець липня 2026 року), причому сюди входить і Graviton (серверний процесор, не ШІ-прискорювач). Різниця — близько 14 разів, не більше: в Amazon цифра «понад», а чиповий бізнес зростає тризначними темпами. Загальний виторг Nvidia за той самий квартал — $96,2 млрд (+106% рік до року), прогноз на третій квартал 2027 фінансового року (серпень — жовтень 2026) — $108 млрд ±2% (прогноз від 26 серпня).
Постачання ШІ-серверів загалом, за прогнозом TrendForce від січня 2026 року, зростуть у 2026 році на 28%. Ринок росте так швидко, що ASIC набирають частку без падіння продажів Nvidia.
Що гонка чипів означає для цін на ШІ: оренда, API і вибір
Конкуренція ASIC і GPU поки не зробила обчислення дешевшими. Ставки AWS на GPU Nvidia в блоках з липня по листопад 2026 року зросли двічі, Alphabet скаржиться на дефіцит, а найсильніші відповіді конкурентів перенесено на 2027 рік. Для читача це означає три речі.
- Купити Trainium або TPU не можна. Обидва чипи доступні лише в хмарах власників; Trainium поза AWS Amazon обіцяє «наприкінці 2027 року», а TPU-системи в дата-центри клієнтів Google почала ставити лише 2026 року.
- Ціна API не дорівнює ціні чипа. Постачальник моделі сам вирішує, скільки брати за токен, і поєднує різне залізо — як Anthropic із чотирма архітектурами. Здешевлення TPU не перетворюється на знижку на API автоматично.
- Для невеликих завдань ринок GPU, як і раніше, найгнучкіший. H100 в AWS коштує $6,88 за GPU-годину без зобов’язань (us-east-1, на 15.11.2026), його можна взяти на годину, у будь-якій хмарі й без переписування коду.
Як обирати залізо під завдання, якщо ви плануєте хмарний бюджет команди:Ваше завдання На що дивитися Чому Експерименти, донавчання відкритих моделей, невеликий інференс GPU Nvidia (H100, B200) CUDA, переносність між хмарами, погодинна оренда Великий стабільний інференс у FP8 усередині Google Cloud TPU Ironwood $2,60 за PFLOPS-годину без зобов’язань і $1,17 на 3 роки; виграш у FP8 за InferenceX Навантаження вже в AWS, код на PyTorch Trainium2 через Capacity Blocks, Trainium3 — за договором блокова ставка Trainium2 з липня не змінювалася, але короткострокові потужності дорожчають; TorchNeuron знижує ціну переїзду Модель тримає якість у FP4 B300, Rubin $1,08 за PFLOPS-годину FP4 у B300; лідер InferenceX у FP4
Ключове слово — «перевірити». Будь-який рядок таблиці ламається на конкретній моделі: перш ніж підписувати річний контракт, варто прогнати своє навантаження на пробній оренді й порахувати ціну токена, а не PFLOPS.
Де розходяться джерела: ціна Ironwood, S-1 Anthropic і FP8 Trainium
Тема свіжа, і цифри в ній змінюються від редакції до редакції. Ось розбіжності, які ми знайшли, і як ми їх читаємо.
- Ціна Ironwood на 3 роки: $5,40 за чип-годину в прайсі Google проти $2,00 в оцінці SemiAnalysis. Публічний список проти договірної оцінки — показуємо обидві.
- Зобов’язання Anthropic: $417 млрд в S-1 від 26 жовтня (за Fortune), $895,4 млрд у поправці від 2 листопада (за DCD) і близько $900,9 млрд в S-1/A-2 від 10 листопада 2026 року на sec.gov. Fortune окремо називав $542–567 млрд — це інше групування. Беремо останню редакцію з датою.
- Дата GA Ironwood: блог Google 6 листопада 2025 року обіцяв загальний доступ «найближчими тижнями», а в release notes запис про GA стоїть у блоці 2026 року. Звідси наше формулювання «анонс у квітні 2025, GA і публічний прайс — 2026».
- Частка ринку: 27,8% ASIC у штуках, близько 16% у грошах і 75–80% у Nvidia за виторгом — різні метрики, а не суперечність.
- FP8 у Trainium3: AWS не уточнює, dense чи sparse її 362 PFLOPS на систему. Порівнюємо з dense-цифрами Nvidia й подаємо як дані AWS.
- «Жоден ASIC не можна орендувати»: так пише огляд Spheron від 19 жовтня 2026 року, хоча його ж таблиця вказує «лише AWS» для Trainium3 і «лише GCP» для Ironwood. Орендувати можна, але тільки у власника.
- Project Rainier: «близько 500 тис. чипів» — заява Amazon, незалежного підтвердження немає.
Ризики для Trainium, TPU і Nvidia: вендорські цифри, CoWoS і 2027
Слабкі місця мають обидві сторони суперечки, і частина з них проявиться вже найближчими тижнями.
- Вендорські цифри без перевірки. Зростання Trn3 «до 4,4 раза» відносно Trn2, приріст TPU 8t «до 2,7 раза» в ціні навчання і TPU 8i «на 80%» у ціні інференсу — заяви самих AWS і Google. За даними DailySynapse на 14 листопада 2026 року, незалежних тестів найновіших систем Google немає.
- 2027 рік як обіцянка. Trainium4, TPU 8tx і 8i Max, Maia 300 і продаж Trainium поза AWS — плани, а не продукти. Терміни таких планів у галузі зсуваються регулярно.
- Дефіцит пакування CoWoS. CoWoS — технологія TSMC, яка з’єднує обчислювальний кристал зі стеками HBM; через неї проходять і GPU Nvidia, і TPU. За зведенням Data Gravity від 2 червня 2026 року, оцінки постачань TPU на 2026 рік розходяться від 3,3 млн (DigiTimes Research, з поправкою на ліміти CoWoS) до 4,6 млн штук (Bank of America).
- Ризики покупців. У S-1/A-2 Anthropic прямо називає серед ризиків брак обчислень і обмеження критичних ресурсів для них. Навіть найбільший клієнт не певен, що отримає все законтрактоване.
- Зміна керівництва Nvidia. 12 листопада 2026 року Nvidia розкрила у формі 8-K, що Дженсен Хуанг пішов із посад президента і CEO та з ради директорів; тимчасовий CEO — фінансова директорка Колетт Кресс. Компанія заявила, що дорожня карта триватиме без перерв.
- Прив’язка до хмари. Модель, оптимізована під TPU або Trainium, живе в одного постачальника: переїзд назад на GPU коштує інженерного часу, навіть із TorchTPU і TorchNeuron.
Є й плюси для конкурентів: Ironwood за незалежним тестом виграє в Blackwell Ultra у FP8 за ціною токена, PyTorch-мости знижують бар’єр входу, а Trainium4 з NVLink Fusion уможливить гібридні системи з ASIC і GPU.
Що застаріє першим. Nvidia відзвітує за третій квартал 2027 фінансового року (серпень — жовтень 2026) 17 листопада 2026 року — цифри виторгу й частки Rubin оновляться. Далі — загальний доступ до Rubin у Google Cloud, наступна сітка цін AWS Capacity Blocks і перші незалежні тести TPU 8t і 8i. Свіжі ціни дивіться на сторінках прайсів Google Cloud TPU і AWS Capacity Blocks.
Часті запитання про Trainium, TPU і Nvidia
Чи можна купити або орендувати Trainium 3 і TPU поза AWS і Google?
Купити для власного сервера не можна, орендувати — лише у власника. Trainium3 доступний у хмарі AWS, а продавати Trainium поза AWS Amazon планує «наприкінці 2027 року». TPU Google здає в Google Cloud і з 2026 року ставить у дата-центри окремих клієнтів. В Oracle Cloud TPU з’являться з 2027 року, за даними Bloomberg.
Чим TPU відрізняється від GPU Nvidia простими словами?
GPU — універсальний паралельний процесор, який через CUDA програмують під будь-які обчислення. TPU — спеціалізована мікросхема (ASIC), де майже весь кристал зайнятий матричним множенням для нейромереж. Тому TPU дешевший і ощадливіший на типових завданнях ШІ, але менш гнучкий: наприклад, Ironwood не має нативного формату FP4, який є в Nvidia B300.
На чому тренують Claude: на Trainium, на TPU чи на GPU Nvidia?
На всьому одразу. У проспекті S-1/A-2 від 10 листопада 2026 року Anthropic описує мультичипову архітектуру: AWS Trainium, Google TPU, GPU Nvidia і GPU AMD. Найбільші договори — з AWS (до 5 ГВт, Trainium2/3/4) і з Google (до 1 млн TPU, плюс 3,5 ГВт з 2027 року). Яку модель на якому чипі навчали, компанія не розкриває.
Чому Anthropic використовує одразу Trainium, TPU і GPU Nvidia?
Це страховка й важіль. Потужностей бракує всім, і Anthropic в S-1/A-2 прямо називає брак обчислень ризиком — кілька постачальників зменшують залежність від одного. Три-чотири платформи дають аргумент у переговорах про ціну. Нарешті, навчання, інференс і експерименти зручніше розподіляти між різним залізом під конкретне завдання.
Коли вийде Trainium 4 і що відомо про його характеристики?
Постачання Trainium4 очікуються з 2027 року — так пише OpenAI, яка замовила потужності на Trn3 і Trn4. Amazon обіцяє щонайменше в 6 разів більшу продуктивність у FP4, у 3 рази більшу у FP8 і в 4 рази більшу пропускну здатність пам’яті, ніж у Trainium3. Чип отримає NVLink Fusion і пам’ять NVHBM від Nvidia. Незалежних даних немає.
Чи дешевші TPU і Trainium, ніж GPU Nvidia B300 і H100?
Залежить від формату чисел. За нашим розрахунком на 15.11.2026, PFLOPS-година FP8 в Ironwood коштує $2,60 за прайсом Google проти $3,23 у B300 в AWS Capacity Blocks. Але у FP4 B300 обходиться в $1,08. H100 в AWS — $6,88 за GPU-годину без зобов’язань. Ціну Trainium3 AWS не публікує, Trainium2 у блоках — $2,235 за чип-годину.
Чи замінять чипи Google і Amazon відеокарти Nvidia?
Найближчими роками — ні, вони вбудовуються поруч. ASIC займуть близько 27,8% постачань ШІ-серверів у 2026 році за прогнозом TrendForce, але Nvidia зберігає близько 75–80% виторгу ринку. Самі конкуренти закуповують Nvidia: AWS розгорне ще 2 млн її GPU у 2027–2028 роках, а Trainium4 використовує інтерфейс NVLink Fusion.