

Коротко (TL;DR)
- MacBook Pro M5 Max с 40-ядерным GPU — единственный ноутбук Apple со 128 ГБ единой памяти (614 ГБ/с). Единственным Mac с таким объёмом он был до 25 августа 2026: теперь те же 128 ГБ даёт Mac Studio на M5 Max, а Mac Studio на M5 Ultra — до 512 ГБ.
- Плотные 70B-модели в 4-битном кванте реально идут со скоростью около 9–11 токенов в секунду. Физический потолок для 70B весом 42,5 ГБ на 614 ГБ/с — около 14,4 ток/с (наш расчёт), а замеры на GGUF-движках дают 9,95 (ручной замер AI-Stat) и 11 ток/с (Ollama в лидерборде llmcheck.net). Цифры лидербордов 15–18 ток/с упираются в потолок или выходят за него.
- 128 ГБ по-настоящему окупаются на MoE-моделях: Qwen 4.1 32B-A3B — 78–82 ток/с, 35B-A3B — около 100 ток/с, а Qwen3-235B-A22B в ~3 битах — 18 ток/с, как плотная 70B при втрое большем размере.
- Главный прирост поколения — обработка промпта (prefill): заявка Apple «до 4 раз быстрее M4 Max» подтверждена независимо (3,5–4,5 раза). Генерация текста выросла всего на ~20%.
- Цена: 14-дюймовый M5 Max после повышения цен Apple 26 июня 2026 стартует с $4 099 (было $3 599), но это 36 ГБ. Конфигурация с 40-ядерным GPU, 128 ГБ и 2 ТБ стоит $6 699 по рекомендованной цене (на 27 августа 2026). В Украине 16-дюймовая версия со 128 ГБ на 25 октября 2026 стоит 369 199 грн.
- RTX 5090 генерирует в 2–3 раза быстрее, но только то, что помещается в её 32 ГБ. 70B-модель в 4 битах весит около 42,5 ГБ и в одну такую карту не влезает.
Все цифры ниже — чужие замеры: у каждой указано, кто мерил, на какой модели и каким движком. Собственного прогона на этой машине у нас не было. Замеры собраны на 26 сентября 2026, цены и наличие обновлены 25 октября 2026.
- Коротко (TL;DR)
- Линейка MacBook Pro M5: для ИИ важна память, а не ядра
- Конфигурация M5 Max под LLM: что выбрать и сколько стоит
- MacBook Pro M5 Max против Mac Studio: кто теперь на вершине по памяти
- Сколько токенов в секунду реально выдаёт M5 Max на 70B и MoE-моделях
- M5 Max против M4 Max: prefill до 4 раз быстрее, генерация +20%
- RTX 5090 против M5 Max: GPU-башня или ноутбук со 128 ГБ
- Троттлинг 14-дюймового MacBook Pro: что показывают независимые тесты
- Риски ноутбука Apple для локального ИИ: CUDA, память, цена
- Кому стоит переплачивать за M5 Max и 128 ГБ, а кому хватит Pro
- FAQ
Линейка MacBook Pro M5: для ИИ важна память, а не ядра
MacBook Pro M5 Max — ноутбук Apple на старшем чипе поколения M5. Apple анонсировала его 3 марта 2026, продажи начались 11 марта. Для локального ИИ (в англоязычных обзорах — local AI, то есть нейросеть, которая работает на вашем компьютере без облака) в нём важны не ядра CPU, а два параметра памяти: сколько её и как быстро она читается. Лестница конфигураций ниже — по техническим характеристикам Apple и анонсам компании. Если вы ещё выбираете между MacBook, Mac mini и Mac Studio, начните с нашего гида какой Mac выбрать: там вся линейка с ценами в Украине.
Несколько терминов, без которых дальше будет сложно:
- Единая память — общая оперативная память для CPU и GPU. Модель не нужно копировать в отдельную видеопамять, поэтому большая часть из 128 ГБ доступна нейросети.
- Пропускная способность — сколько гигабайт в секунду память отдаёт чипу. Для генерации текста это главный параметр.
- Prefill — обработка вашего запроса до первого слова ответа. Упирается в вычислительную мощность.
- Decode, или генерация — выдача ответа токен за токеном. Упирается в пропускную способность памяти.
- Токен — кусочек слова; скорость меряют в токенах в секунду (ток/с).
- Квант — сжатие весов модели: «4 бита» означает, что каждый параметр хранится в 4 битах вместо 16. Модель легче, качество немного ниже.
| Чип | CPU | GPU | Пропускная способность | Память | Старт 14″ (анонс → после 26.06.2026) | Старт 16″ (анонс → после 26.06.2026) |
|---|---|---|---|---|---|---|
| M5 | 10 ядер | 10 ядер | 153 ГБ/с | до 32 ГБ | $1 599 → $1 899 (16 ГБ/512 ГБ) | — |
| M5 Pro | 15 или 18 ядер | 16 или 20 ядер | 307 ГБ/с | 24 / 48 / 64 ГБ (64 — только с 20-ядерным GPU) | $2 199 → $2 499 (24 ГБ) | $2 699 → $2 999 |
| M5 Max, 32 ядра GPU | 18 ядер | 32 ядра | 460 ГБ/с | только 36 ГБ | $3 599 → $4 099 | $3 899 → $4 899 |
| M5 Max, 40 ядер GPU | 18 ядер | 40 ядер | 614 ГБ/с | 48 / 64 / 128 ГБ | от $4 699 (48 ГБ) | от $5 599 (48 ГБ) |
Цены — рекомендованные в США. 26 июня 2026 Apple подняла цены на всю линейку Mac на фоне дефицита памяти; цифры «до» и «после» — по сводке Basic Apple Guy, цены 14-дюймовых M5 Pro и M5 Max мы перепроверили на apple.com 25 октября 2026. Базовый 14-дюймовый M5 в магазине Apple на эту дату стоит от $1 999 — это версия с 16 ГБ и 1 ТБ.
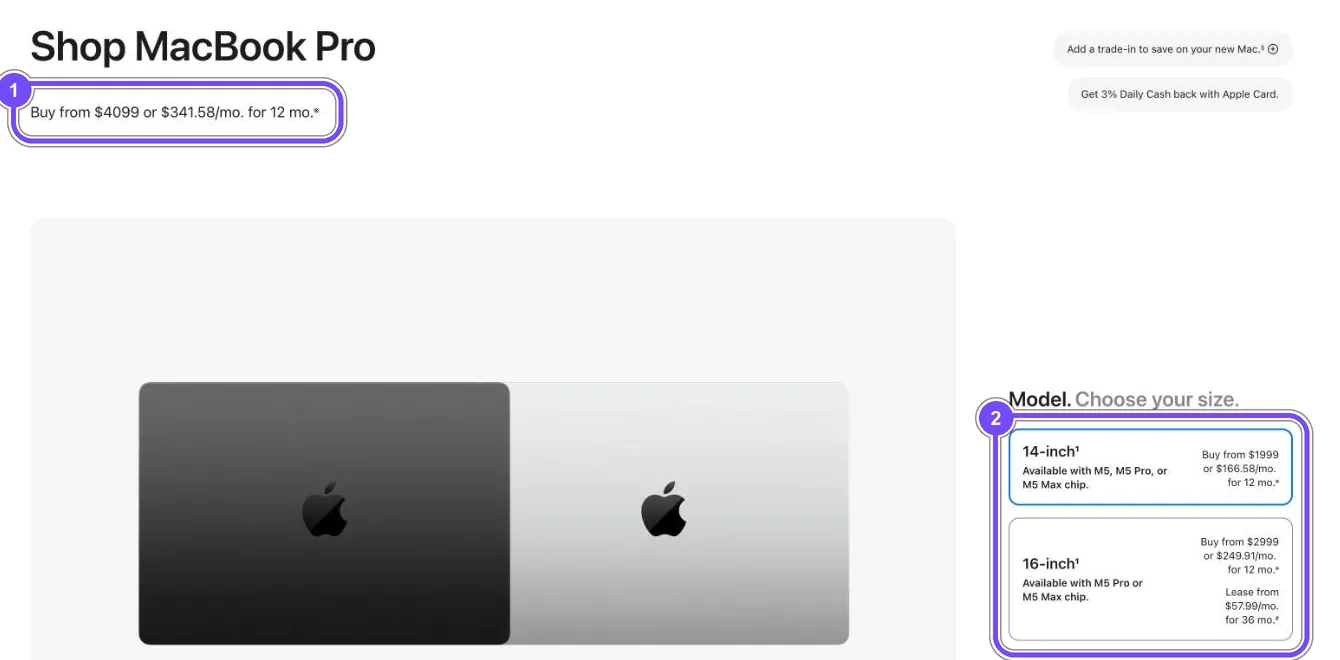
Страница M5 Max в магазине Apple, снято 25 октября 2026: цифра 1 — стартовая цена 14-дюймового M5 Max после повышения, цифра 2 — минимальные цены 14- и 16-дюймового корпуса с самым доступным чипом.
Из таблицы следуют три вывода, которые определяют всю покупку.
Первый: 128 ГБ есть только у M5 Max с 40-ядерным GPU. Стартовая версия M5 Max за $4 099 (до 26 июня 2026 — $3 599) — это 32 ядра GPU, 460 ГБ/с и фиксированные 36 ГБ. На ней 70B-модель не запустится вовсе.
Второй: скорость генерации растёт вместе с пропускной способностью, а не с числом ядер. Чтобы выдать очередной токен, плотная модель читает из памяти все свои веса. Поэтому 614 ГБ/с против 307 ГБ/с у M5 Pro — это примерно вдвое больше токенов в секунду на одной и той же модели.
Третий: 128 ГБ не означают 128 ГБ под модель. macOS по умолчанию отдаёт видеоядру около 75% единой памяти, то есть примерно 96 ГБ из 128. Сообщество поднимает этот лимит командой из раздела про софт ниже, до ~110 ГБ, и он сбрасывается при перезагрузке (данные Local AI Master).
В украинской рознице M5 Max на 25 октября 2026 уже есть. В каталоге Foxtrot 14-дюймовый M5 Max с 36 ГБ и 2 ТБ стоит 256 999 грн, 16-дюймовый с теми же 36 ГБ — 271 999 грн, 16-дюймовый с 40-ядерным GPU и 48 ГБ — 312 999 грн. Версию под локальный ИИ, 16 дюймов со 128 ГБ и 2 ТБ, Jabko продаёт за 369 199 грн с пометкой «осталось мало»; 14-дюймовую со 128 ГБ в официальной рознице мы не нашли. Базовый MacBook Pro M5 с 16 ГБ и 1 ТБ в Foxtrot — 120 999 грн (в апреле 2026 было 99 499 грн). Для локального ИИ это машина класса моделей на 4–8 млрд параметров.
Конфигурация M5 Max под LLM: что выбрать и сколько стоит
Под локальные модели имеет смысл собирать одну конкретную конфигурацию, а не «максимум всего». Раскладка по конфигуратору:
| Параметр | Что выбрать | Цена на 27 августа 2026 | Почему |
|---|---|---|---|
| Чип | M5 Max, 18 ядер CPU, 40 ядер GPU | входит в итог ниже | только с ним доступны 128 ГБ и 614 ГБ/с |
| Память | 128 ГБ | входит в итог ниже | 70B с запасом под контекст, MoE-модели на 100+ млрд параметров |
| Накопитель | стандартные 2 ТБ | входит в итог ниже | 70B-модель в 4 битах весит около 42,5 ГБ; SSD читает до 14,5 ГБ/с |
| Корпус | 16″, если модель работает часами | после 26 июня 2026 16″ с 40 ядрами GPU дороже 14″ на $900 ($5 599 против $4 699 за 48 ГБ) | больше запаса по охлаждению, см. раздел о троттлинге |
| Итого, 14″, 40 GPU / 128 ГБ / 2 ТБ | $6 699 рекомендованная цена |
Цену $6 699 за такую конфигурацию приводит AppleInsider на 27 августа 2026: партнёр Apple Expercom тогда продавал её за $5 299 со скидкой $1 400 при ограниченном запасе. Цифра сходится с расчётом: в магазине Apple на 25 октября 2026 14-дюймовый M5 Max с 40-ядерным GPU и 48 ГБ стоит от $4 699, переход с 48 на 128 ГБ после июньского повышения — ещё $2 000 (по скриншотам конфигуратора в пересказе Digital Trends), итого $6 699. Basic Apple Guy для той же конфигурации называет $6 999, а для 16-дюймовой со 128 ГБ и 2 ТБ — $7 199; финальную цену показывает только конфигуратор.
Наш расчёт: сколько стоит переход к 128 ГБ. Разница между стартовым 14-дюймовым M5 Max ($4 099 после 26 июня 2026, 36 ГБ, 32 ядра GPU) и конфигурацией под локальный ИИ ($6 699) — $2 600. За эти деньги вы получаете +92 ГБ памяти, +33% пропускной способности (614 против 460 ГБ/с) и +8 ядер GPU. Если отнести всю доплату на память, выходит около $28 за каждый дополнительный гигабайт. Чистая доплата за память у Apple — $2 000 за 80 ГБ, то есть $25 за гигабайт; до повышения та же ступень стоила $1 000.
Цена этой конфигурации может снова вырасти. В 2026 году Apple посреди цикла убирала опции большой памяти у Mac Studio на фоне дефицита DRAM (по данным MacRumors в пересказе Local AI Master), а 26 июня подняла цены на всю линейку Mac: стартовый 14-дюймовый M5 Max подорожал на $500, доплата за 128 ГБ удвоилась, стартовая цена Mac Studio выросла с $1 999 до $2 499 (Basic Apple Guy, Digital Trends, Macworld).
MacBook Pro M5 Max против Mac Studio: кто теперь на вершине по памяти
Короткий ответ на 26 сентября 2026: по объёму памяти на вершине Mac Studio на M5 Ultra (до 512 ГБ), MacBook Pro M5 Max и Mac Studio на M5 Max делят второе место со 128 ГБ. У ноутбука остаётся одно уникальное свойство — это единственные 128 ГБ, которые можно закрыть и унести.
Хронология: как «единственный Mac со 128 ГБ» устарел за 9 дней
Гайд Local AI Master от 16 августа 2026 назвал ноутбук на M5 Max самым ёмким по памяти Mac, который продаёт Apple («the highest-memory Mac Apple sells»). На дату публикации это было правдой. Вот как менялась картина:Дата Что произошло Максимум памяти у Mac 11 марта 2026 старт продаж ноутбука на M5 Max со 128 ГБ ноутбук — 128 ГБ март 2026 Apple убирает опцию 512 ГБ у Mac Studio M3 Ultra Mac Studio — 256 ГБ к маю 2026 у Mac Studio пропадают 256 и 128 ГБ, M3 Ultra остаётся с фиксированными 96 ГБ ноутбук на M5 Max — 128 ГБ 16 августа 2026 Local AI Master: M5 Max MacBook Pro — «the highest-memory Mac Apple sells» верно на эту дату 25 августа 2026 Apple анонсирует Mac Studio на M5 Max (до 128 ГБ) и M5 Ultra (до 512 ГБ, 1,2 ТБ/с) 512 ГБ (анонс) 22 сентября 2026 начало поставок нового Mac Studio; версия на 512 ГБ — в конце октября 2026 128 ГБ у двух Mac, больше — у M5 Ultra
Источники хронологии — Local AI Master (со ссылкой на MacRumors) и официальный анонс Mac Studio от 25 августа 2026. Mac Studio прошлого поколения на M3 Ultra с его цифрами мы разбирали отдельно.
Сравнение MacBook Pro vs Mac Studio на 26 сентября 2026
| Параметр | MacBook Pro 14″ M5 Max | Mac Studio M5 Max | Mac Studio M5 Ultra |
|---|---|---|---|
| Максимум памяти | 128 ГБ | 128 ГБ | 512 ГБ (с конца октября 2026) |
| Пропускная способность | 614 ГБ/с (40 ядер GPU) | 614 ГБ/с (40 ядер GPU) | 1,2 ТБ/с |
| Стартовая цена в США | $4 099 (36 ГБ, после 26 июня 2026); 128 ГБ — $6 699 | $2 499 за базовую конфигурацию | $5 499 |
| Экран, клавиатура, батарея | есть | нет | нет |
| Охлаждение под долгой нагрузкой | ограничено корпусом | настольное | настольное |
| Можно взять с собой | да | нет | нет |
Между MacBook Pro и Mac Studio на M5 Max при одинаковых 128 ГБ и одинаковых 614 ГБ/с разница сводится к корпусу: за ноутбук вы доплачиваете за экран, батарею и мобильность, а теряете запас охлаждения. Цену Mac Studio M5 Max именно со 128 ГБ Apple в пресс-релизе не называет, поэтому в таблице стоит стартовая. Если нужно больше 128 ГБ или быстрее 614 ГБ/с — это уже Mac Studio M5 Ultra; его память, реальные замеры и цены по конфигурациям мы подробно разобрали в обзоре Mac Studio M5 Ultra для LLM.
Часть сообщества выбирает не «или», а «и». Пользователь X 23 сентября 2026 написал, что 96 ГБ — это «едва достаточно», и он собирается держать свой MacBook Pro на M3 Max (36 ГБ) рядом с Mac Studio M5 Ultra на 256 или 512 ГБ. Схема рабочая: ноутбук для дороги и небольших моделей, настольная машина для тяжёлых.
Сколько токенов в секунду реально выдаёт M5 Max на 70B и MoE-моделях
На плотных 70B-моделях в 4-битном кванте M5 Max со 128 ГБ реально выдаёт около 9–11 токенов в секунду. Опубликованные цифры лежат в диапазоне от 9,95 до 18 ток/с, но верхние значения лидерборда упираются в физический потолок около 14,4 ток/с или выходят за него (расчёт ниже). На MoE-моделях с ~3 млрд активных параметров — 78–100 ток/с. Иначе говоря, 70B отвечает со скоростью чтения, а быстрые ответы на этой машине дают MoE-модели.
Плотные 70B: замеры на GGUF 9,95–11 ток/с, на MLX до 18
| Источник | Модель и квант | Движок | ток/с | Тип данных |
|---|---|---|---|---|
| AI-Stat, март 2026 | Llama 3.3 70B Q4_K_M | н/д | 9,95 | «точный замер» по тексту источника |
| llmcheck.net | DeepSeek R1 70B | Ollama | 11 | лидерборд |
| llmcheck.net | Llama 3.3 70B Q4_K_M | MLX | 15 | лидерборд |
| llmcheck.net | Llama 5 70B Q4_K_M | MLX | 18 | лидерборд |
Лидерборд llmcheck.net усредняет три прогона на свежезагруженной системе и собрал 227 замеров на Apple Silicon (данные в пересказе Local AI Master, август 2026). Показательно, что сам AI-Stat в сводной таблице пишет «70B Q4_K_M — 18–25 т/с», а строкой ниже приводит точный замер той же модели — 9,95 т/с. Две цифры одного издания расходятся вдвое.
Почему так бывает: разные версии модели (Llama 3.3 и Llama 5 — разные сети), разный движок (MLX быстрее Ollama, об этом ниже), разная длина контекста и ответа. Короткий ответ на свежей системе всегда быстрее, чем долгий диалог с заполненным контекстом.
Расчёт: потолок 70B на 614 ГБ/с — около 14,4 ток/с
Раз плотная модель на каждом токене читает все веса, скорость генерации не может превысить пропускную способность, делённую на вес модели. Файл Llama 3.3 70B в кванте Q4_K_M (формат GGUF для llama.cpp, Ollama и LM Studio) весит 42,5 ГБ, 4-битная MLX-версия той же модели — 39,7 ГБ (размеры файлов на Hugging Face на 25 октября 2026).
614 ГБ/с ÷ 42,5 ГБ ≈ 14,4 ток/с — теоретический потолок M5 Max на такой модели; для MLX-версии он чуть выше, 614 ÷ 39,7 ≈ 15,5 ток/с. Сверим с ним замеры:Замер ток/с Доля от потолка (14,4 ток/с для GGUF, 15,5 для MLX) AI-Stat, Llama 3.3 70B Q4_K_M 9,95 69% llmcheck.net, DeepSeek R1 70B, Ollama 11 76% llmcheck.net, Llama 3.3 70B, MLX 15 97% llmcheck.net, Llama 5 70B, MLX 18 116%
На практике генерация до потолка не доходит: часть пропускной способности уходит на чтение кэша контекста и накладные расходы движка. Ориентир — замер llama.cpp на чипе двумя поколениями старше: M3 Max с 40 ядрами GPU (400 ГБ/с) выдал на 70B Q4_K_M 7,53 ток/с при потолке около 9,4, то есть 80% (бенчмарк XiongjieDai на GitHub, май 2024). Оба замера на GGUF-движках (AI-Stat и Ollama) легли в коридор 69–76%. 97% у MLX-замера — почти идеальный случай (источник при этом указывает одновременно квант Q4_K_M и движок MLX, хотя Q4_K_M — формат GGUF), а результат выше 100% для плотной 4-битной 70B на этой памяти невозможен без оговорок. Значит, в этом замере модель была сжата сильнее, использовалось спекулятивное декодирование (маленькая модель-черновик предлагает токены, большая их проверяет пачкой) или отличалась методика. Это наша интерпретация: построчную методику лидерборд не раскрывает.
Тот же расчёт для соседей: у M4 Max (546 ГБ/с) потолок на 70B Q4_K_M — около 12,8 ток/с, у M5 Pro (307 ГБ/с) — около 7,2 ток/с. В 64 ГБ M5 Pro модель на 42,5 ГБ формально помещается, но работает медленно. Планируйте покупку под 9–11 ток/с на плотной 70B (наша оценка: 69–76% от потолка 14,4, как в замерах на GGUF). Если придёт больше — это бонус, а не норма.
MoE-модели и что влезает в 128 ГБ
MoE (Mixture of Experts, «смесь экспертов») — архитектура, в которой на каждый токен работает только часть параметров. Модель целиком лежит в памяти, но читается за шаг лишь её небольшая доля. Поэтому MoE-модель на 32 млрд параметров с 3 млрд активных генерирует со скоростью маленькой модели, а знает как большая.Модель Тип и квант Вес Влезает в 128 ГБ ток/с на M5 Max Источник Llama 3.1 8B плотная, Q4_K_M н/д да, с большим запасом 138 llmcheck.net Qwen 4.1 32B-A3B MoE, ~3 млрд активных, Q4_K_M н/д да 78–82 llmcheck.net 35B-A3B MoE, ~3 млрд активных н/д да ~100 участник Hacker News, июль 2026 Llama 3.3 70B плотная, Q4_K_M ~42,5 ГБ да, остаётся место под контекст 9,95–15 AI-Stat, llmcheck.net Qwen3-235B-A22B MoE, 22 млрд активных, ~3 бита ~100 ГБ да, с поднятым лимитом памяти GPU 18 llmcheck.net модели от 220 млрд параметров (MiniMax M2.5, DeepSeek V4) — — по оценке AI-Stat, начинают выходить за пределы разумного; исключение — сильно сжатые MoE вроде Qwen3-235B-A22B — —
Самая показательная строка — последняя с цифрами. Qwen3-235B-A22B втрое больше плотной 70B, а генерирует с той же скоростью, 18 ток/с. Около 100 ГБ её весов не помещаются в 96 ГБ, которые macOS отдаёт GPU по умолчанию, но помещаются в 128 ГБ, если поднять лимит. Именно ради таких моделей и стоит брать 128 ГБ, а не 64.
Для сравнения: на M5 Pro с 64 ГБ Qwen 4.1 32B-A3B даёт 56 ток/с (llmcheck.net). Если ваш основной инструмент — MoE-модель такого класса для кода, M5 Pro закрывает задачу дешевле.
Софт разгоняет то же железо: MLX, LM Studio и Ollama
Скорость на Mac определяет не только чип, но и движок, которым вы запускаете модель. Пример из сентября 2026: разработчик в X (21 сентября) показал Qwen3.8-27B на ноутбуке с M5 Max в LM Studio Bionic с движком Splash — около 120 ток/с в агентной задаче с субагентом. По его словам, на старте модели чуть больше месяца назад та же модель на том же ноутбуке выдавала около 20 ток/с. Эту цифру 22 сентября пересказал другой пользователь X — это не независимый замер. Направление всё равно понятно: цифры на день покупки — не финальные.
Разница между движками измерена и в более спокойных условиях, хотя источники расходятся в процентах:
- MLX — фреймворк Apple для машинного обучения. По AI-Stat (март 2026), он на 20–30% быстрее llama.cpp и до 50% быстрее Ollama на генерации, а на prefill разрыв доходит до 3–5 раз.
- Лидерборд llmcheck.net даёт более скромный отрыв MLX от Ollama — 5–15% на одной и той же модели.
- Причина разрыва на prefill: нейроускорители в ядрах GPU M5 доступны через Metal 4 TensorOps, которые поддерживает MLX. llama.cpp на март 2026 их не задействовал.
Как расходятся Ollama, LM Studio и llama.cpp на одной модели, мы отдельно разбирали в замере Ollama, LM Studio и llama.cpp. Минимальный старт на MLX и снятие лимита памяти GPU выглядят так (команды из гайда Local AI Master):
pip install mlx-lm
mlx_lm.chat --model mlx-community/Llama-3.3-70B-Instruct-4bit

# отдать GPU ~110 ГБ из 128; сбрасывается при перезагрузке
sudo sysctl iogpu.wired_limit_mb=110000
После снятия лимита следите за графиком «Нагрузка на память» в Мониторе системы: пока он зелёный, всё в порядке. Жёлтый цвет означает подкачку на диск, и скорость генерации резко падает.
M5 Max против M4 Max: prefill до 4 раз быстрее, генерация +20%
Neural Accelerators — блоки для матричных вычислений, которые Apple встроила в каждое ядро GPU поколения M5. Они ускоряют prefill, то есть чтение вашего запроса, а не выдачу ответа. Apple заявляет для M5 Max обработку промпта LLM до 4 раз быстрее, чем у M4 Max, и до 6,7 раза быстрее, чем у M1 Max. Как пять поколений чипа Max отличаются в генерации, prefill и цене, мы разобрали в сравнении M1 Max и M5 Max. Независимые тесты заявку Apple подтверждают:Источник Что мерили M4 Max M5 Max Ускорение Apple, анонс 3 марта 2026 обработка промпта LLM — — до 4x Hardware Corner (в пересказе AI-Stat) один и тот же промпт 81 с 18 с 4,5x jakkuh, YouTube, 22 марта 2026 сценарий фильма целиком, Qwen 3.5 27B в 4 битах более 80 с менее 23 с ~3,5–4x jakkuh, та же модель генерация ответа 19 ток/с 22,5 ток/с +18% llmcheck.net генерация, Llama 5 70B, MLX, 128 ГБ 15 ток/с 18 ток/с +20%
Генерация выросла скромно, потому что пропускная способность памяти выросла всего с 546 до 614 ГБ/с. Отсюда и первые разочарованные впечатления: на коротком вопросе prefill занимает доли секунды, и пользователь видит только скорость генерации. У jakkuh обе машины были с 36 ГБ памяти, то есть M5 Max в тесте — версия с 32 ядрами GPU и 460 ГБ/с.
Где ускорение prefill заметно: RAG (ответы по вашим документам), загрузка PDF и веб-страниц, работа с кодовой базой, ИИ-агенты, которые снова и снова перечитывают накопленный контекст. Где почти незаметно: обычный чат с короткими вопросами.
Наш пример расчёта. Возьмём промпт из теста Hardware Corner. Если агент за одну задачу 20 раз обрабатывает контекст такого размера, на M4 Max ожидание до первого токена в сумме составит около 27 минут (81 с × 20), на M5 Max — около 6 минут (18 с × 20). Генерация в обоих случаях займёт примерно одинаковое время. Поэтому владельцу M4 Max со 128 ГБ апгрейд имеет смысл только при работе с длинным контекстом и агентами.
RTX 5090 против M5 Max: GPU-башня или ноутбук со 128 ГБ
RTX 5090 выигрывает по скорости всё, что помещается в её 32 ГБ видеопамяти. Ноутбук на M5 Max выигрывает всё, что туда не помещается. Это главное, что нужно знать о сравнении.Параметр MacBook Pro, M5 Max, 128 ГБ RTX 5090 RTX PRO 6000 Blackwell Память под модель 128 ГБ единой памяти 32 ГБ GDDR7 96 ГБ GDDR7 Пропускная способность 614 ГБ/с 1 792 ГБ/с 1 792 ГБ/с Генерация на моделях, которые влезают база в 2–3 раза быстрее на 50–65% быстрее Prefill база примерно в 4 раза быстрее быстрее 70B в 4 битах (~42,5 ГБ) помещается в одну карту не помещается помещается Цена $6 699 за весь ноутбук $1 999 рекомендованная, только карта $8 800 только за карту (март 2026) Потребление около 100 Вт на всю систему 575 Вт только карта (TDP) 600 Вт только карта (TDP) CUDA нет есть есть
Сравнение скорости и цена RTX PRO 6000 — по AI-Stat (март 2026), пропускная способность RTX 5090 и потребление ноутбука — по BuildMVPFast, рекомендованная цена RTX 5090 и TDP обеих карт — по данным NVIDIA. Цены на карты указаны без остального компьютера.
Пропускная способность RTX 5090 почти втрое выше, отсюда и кратный отрыв в генерации. Но модель на 42,5 ГБ в 32 ГБ не влезет, и дальше есть два пути: две карты или выгрузка части слоёв в обычную оперативную память, которая резко роняет скорость. У M5 Max этой проблемы на моделях до ~100 ГБ нет.
Где что выбирать:
- Модели до 32 ГБ и максимальная скорость — ПК с RTX 5090. Сводку чужих замеров по 5090, 4090 и 3090 мы собрали в обзоре RTX 5090, 4090 и 3090 в локальных LLM.
- 70B без компромиссов по скорости и с CUDA — рабочая станция на 96 ГБ видеопамяти, как в нашем разборе рабочей станции на RTX PRO 6000.
- Модели на 40–100 ГБ и мобильность — ноутбук на M5 Max со 128 ГБ.
Если выбираете между платформами с единой памятью вообще, посмотрите наше сравнение DGX Spark, Mac Studio и Strix Halo: там те же вопросы решаются на трёх разных архитектурах.
Троттлинг 14-дюймового MacBook Pro: что показывают независимые тесты
Троттлинг — снижение частот и мощности чипа, когда корпус не успевает отводить тепло. Оба найденных источника согласны в главном: 14-дюймовый MacBook Pro с M5 Max троттлит, а с M5 Pro — практически нет. Расходятся они в степени, потому что меряли разное.Источник Дата Методика Результат HackerNoon, колонка Andrew Schwabe 27 марта 2026 «устойчивая нагрузка», стенд и тип нагрузки не описаны 14″ M5 Max опускается примерно до 42 Вт; 16″ с тем же чипом держит 62+ Вт и обгоняет 14″ на 15–18% в реальных задачах jakkuh, YouTube 22 марта 2026 20-минутный стресс-тест 3DMark (графика) потеря производительности 3–5%; с вентиляторами на 100% — 2–3%; у M5 Pro троттлинга автор не заметил
Почему источники расходятся: ватты против баллов 3DMark
HackerNoon говорит о мощности чипа под долгой нагрузкой и о разнице с 16-дюймовой версией, но не описывает, чем нагружал. jakkuh приводит потерю баллов в 20-минутном графическом тесте. Это две разные величины: падение мощности вдвое не обязано давать падение баллов вдвое, а 20 минут 3DMark — не то же самое, что многочасовой прогон модели.
Для локального ИИ из этого следует наш вывод, а не замер. Генерация на плотной модели упирается в пропускную способность памяти, поэтому урезанная мощность должна задевать её меньше. Prefill и MoE-модели больше нагружают вычислительные блоки, поэтому здесь ограничение мощности ощутимее. Косвенно это подтверждает участник Hacker News: на MoE 35B-A3B он получает 80 ток/с в режиме высокой мощности и 38 ток/с в режиме энергосбережения (модель его чипа в сообщении не указана). Ограничение мощности режимом энергосбережения срезало скорость на MoE больше чем вдвое.
Если модель будет работать часами, выбирайте 16-дюймовую версию — это позиция и HackerNoon, и Local AI Master. Если нужен именно компактный ноутбук и хватает 64 ГБ, HackerNoon советует 14-дюймовый M5 Pro: этот чип укладывается в тепловой пакет корпуса.
Жар, шум и батарея при работе агентов
14-дюймовый M5 Max комплектуется адаптером на 96 Вт, а батарея у него — 72,4 Вт·ч. По HackerNoon, чип может кратковременно брать до 96 Вт, и под тяжёлой нагрузкой батарея разряжается даже на зарядке. jakkuh намерил под длительной нагрузкой 80–90 Вт из розетки. Наша грубая оценка: 72,4 Вт·ч при 80–90 Вт — это меньше часа работы от полной батареи, поэтому «ноутбук для ИИ в дороге» на практике означает «рядом с розеткой».
Владелец MacBook Pro M5 со 128 ГБ в той же ветке Hacker News (июль 2026) пишет прямо: при серьёзной работе с локальными моделями ноутбук обжигает пальцы и шумит так, что работать за ним некомфортно. Его совет — держать модель на отдельном Mac mini подальше от стола и подключаться по сети. Такую бюджетную точку входа мы разбирали в обзоре Mac Mini M4 Pro для нейросетей.
Безвентиляторный MacBook Air M5 — отдельная история
MacBook Air M5 не имеет вентилятора вообще и под длительной нагрузкой троттлит сильнее любого MacBook Pro M5 — в этом сходятся HackerNoon и сравнительный видеообзор Air против Pro. Для разговоров с небольшой моделью он годится, для долгих сессий инференса — нет. Путать его с троттлингом 14-дюймового Pro не стоит: у Pro вентиляторы есть, но чип Max мощнее, чем корпус может охладить под постоянной нагрузкой.
Риски ноутбука Apple для локального ИИ: CUDA, память, цена
- Нет CUDA. Дообучение моделей на Mac возможно (MLX-LM умеет QLoRA), но по оценке Local AI Master это рабочий вариант для моделей на 7–14 млрд параметров и далеко от экосистемы NVIDIA. Серьёзное обучение — это аренда GPU NVIDIA.
- Память конечна даже на 128 ГБ. Владелец MacBook Pro со 128 ГБ написал в X 19 сентября 2026, что уже упирается в лимит памяти, когда параллельно работают локальная модель и несколько сессий с ИИ-кодингом.
- Ожидания по 70B. Лидерборды на MLX показывают 15–18 ток/с, замеры на GGUF-движках — 9,95–11, а физический потолок Q4-модели на этой памяти — около 14,4. Если покупаете ради плотных 70B, закладывайтесь на 9–11 ток/с.
- Жар и цена. Про троттлинг и батарею — раздел выше. Конфигурация со 128 ГБ может подорожать или стать дефицитной: Apple в 2026 году уже убирала конфигурации с большой памятью посреди цикла.
- Избыточность. Колумнист vc.ru называет 16-дюймовый M5 Max «стрельбой из ядерной пушки по воробьям» для скриптов, интеграций и аналитики: такая машина оправдана только для тяжёлого локального ИИ и дата-инженерии.
Что устареет в этой статье первым: цены (память дорожает, Apple меняет конфигурации посреди цикла), скорость в токенах в секунду (движки MLX и LM Studio ускоряются от месяца к месяцу) и картина у Mac Studio, где версия на 512 ГБ появится в конце октября 2026. Свежие цены смотрите в конфигураторе Apple, свежие замеры — на лидерборде llmcheck.net и в r/LocalLLaMA.
Кому стоит переплачивать за M5 Max и 128 ГБ, а кому хватит Pro
Решение принимается по модели, которую вы собираетесь запускать, а не по чипу. Пройдите по шагам сверху вниз и остановитесь на первом подходящем:
- Модели до 8 млрд параметров и знакомство с локальным ИИ. Хватит базового MacBook Pro M5: до 32 ГБ и 153 ГБ/с. По оценке Local AI Master, 8B-модель в 4 битах даст на нём около 30–35 ток/с. В Украине версия с 16 ГБ и 1 ТБ на 25 октября 2026 стоит 120 999 грн (Foxtrot).
- Каждый день работаете с моделью класса 32B, например MoE-кодером. Выбор между MacBook Pro M5 и M5 Pro здесь решается в пользу M5 Pro с 64 ГБ: вдвое выше пропускная способность, чем у базового M5, 56 ток/с на Qwen 4.1 32B-A3B и отсутствие троттлинга в 14-дюймовом корпусе. Учтите: стартовые $2 499 (с 26 июня 2026, до этого $2 199) — цена M5 Pro с 24 ГБ, а 64 ГБ доступны только с 20-ядерным GPU и стоят дороже.
- Нужны плотные 70B и MoE-модели на 100+ млрд параметров, причём в дороге. Это и есть сценарий старшего ноутбука: M5 Max, 40 ядер GPU, 128 ГБ, стандартные 2 ТБ. Для многочасовой работы — 16 дюймов.
- Машина будет стоять на столе. Mac Studio на M5 Max даёт те же 128 ГБ и 614 ГБ/с; стартовая цена $2 499 — за базовую конфигурацию, со 128 ГБ дороже. Mac Studio на M5 Ultra — до 512 ГБ и 1,2 ТБ/с.
- Уже есть M4 Max со 128 ГБ. Генерация вырастет примерно на 20%. Апгрейд оправдан, только если вы много работаете с длинным контекстом, RAG или агентами, где prefill стал в 3,5–4,5 раза быстрее.
- Нужна максимальная скорость на моделях до 32 ГБ или дообучение. Это ПК с видеокартой NVIDIA и CUDA, а не Mac.
Отдельно о том, для кого 128 ГБ избыточны. Если локальная модель нужна для чата, небольших правок кода и перевода, 70B на 9–11 ток/с будет медленнее и дороже, чем MoE-модель на M5 Pro. 128 ГБ имеют смысл, когда вы точно знаете, какую модель на 70–235 млрд параметров будете запускать, и вам нужно делать это без облака и не только за столом.
FAQ
Сколько стоит MacBook Pro M5 Max с 128 ГБ памяти?
14-дюймовый MacBook Pro с M5 Max (40 ядер GPU), 128 ГБ и 2 ТБ стоит $6 699 по рекомендованной цене в США на 27 августа 2026, по данным AppleInsider. Партнёр Apple тогда продавал его со скидкой за $5 299. Стартовая цена M5 Max — $4 099 после повышения 26 июня 2026 — относится к версии с 36 ГБ и 32 ядрами GPU, на которой 70B-модели не запускаются. В Украине 16-дюймовая версия со 128 ГБ на 25 октября 2026 стоит 369 199 грн (Jabko).
MacBook Pro M5 Max — единственный Mac с 128 ГБ памяти?
Нет, с 25 августа 2026. В этот день Apple анонсировала Mac Studio на M5 Max (до 128 ГБ) и на M5 Ultra (до 512 ГБ), поставки начались 22 сентября. До этого ноутбук на M5 Max действительно был единственным Mac со 128 ГБ. Сейчас он единственный ноутбук Apple с таким объёмом памяти.
Какие модели ИИ реально помещаются в 128 ГБ памяти MacBook Pro?
Плотные модели до 70 млрд параметров в 4 битах (около 42,5 ГБ) с запасом под контекст, MoE-модели на 100+ млрд параметров и Qwen3-235B-A22B в ~3 битах (около 100 ГБ) — последняя только с поднятым лимитом памяти GPU. По умолчанию macOS отдаёт видеоядру около 96 ГБ из 128. Более крупные модели от 220 млрд параметров, по оценке AI-Stat, начинают выходить за пределы разумного: Qwen3-235B-A22B помещается только благодаря сжатию до ~3 бит.
Троттлится ли MacBook Pro M5 Max при долгой работе с нейросетями?
14-дюймовая версия троттлит, источники расходятся в степени. HackerNoon пишет о падении мощности примерно до 42 Вт и отставании от 16-дюймовой версии на 15–18%, 20-минутный тест 3DMark у jakkuh показал потерю 3–5%. Для многочасовой работы моделей лучше 16-дюймовый корпус, у M5 Pro троттлинга практически нет.
Что быстрее для локального ИИ — MacBook Pro M5 Max или RTX 5090?
RTX 5090 быстрее в 2–3 раза в генерации и примерно в 4 раза в prefill, но только на моделях, которые помещаются в её 32 ГБ. 70B-модель в 4 битах весит около 42,5 ГБ и в одну карту не влезает, а M5 Max держит модели до ~100 ГБ. Скорость на небольших моделях — за NVIDIA, объём и мобильность — за Mac.
Стоит ли переплачивать за M5 Max, если хватает M5 Pro?
Нет, если ваши модели помещаются в 64 ГБ. M5 Pro с 64 ГБ выдаёт 56 ток/с на Qwen 4.1 32B-A3B и не троттлит в 14-дюймовом корпусе. Стартовые $2 499 (после повышения 26 июня 2026) — это версия с 24 ГБ; 64 ГБ требуют 20-ядерного GPU и стоят дороже. Доплата за M5 Max со 128 ГБ оправдана под плотные 70B и MoE-модели на 100+ млрд параметров.