Коротко (TL;DR)
- Конвертировать PDF в Markdown для ИИ стоит, когда документов много: RAG-поиск, база знаний, пакетная обработка. Для одного файла хватит онлайн-конвертера или загрузки PDF прямо в чат-ассистента.
- Главные открытые парсеры на 2 ноября 2026 года — MinerU (4.1.4), Docling (2.145.0) и Marker (2.1.0); рядом olmOCR от AllenAI и MarkItDown от Microsoft.
- Многие обзоры устарели: MinerU с апреля 2026 года не AGPL, а Apache-2.0 с порогами для крупного бизнеса; у Marker код под Apache-2.0, но веса модели платные для компаний с выручкой или инвестициями больше $5 млн.
- Кириллицу включают руками: у Docling без указания языка OCR читает скан английской или китайской моделью. Независимого теста парсеров на украинском мы не нашли.
- Рейтинги противоречат друг другу: Docling лидирует среди трёх парсеров в одном бенчмарке и отстаёт от обоих конкурентов в другом. Решает проверка на 10 своих страницах — методика в конце.
PDF описывает не структуру документа, а его внешний вид: какой символ поставить в какую точку страницы. Человеку этого достаточно, языковой модели — нет. Парсер документов переводит эту «раскладку» обратно в структуру: заголовки, абзацы в правильном порядке, таблицы с ячейками. Ниже разбираем, как он это делает, какой взять, во что обойдётся лицензия и где он может подвести.
- Коротко (TL;DR)
- Зачем ИИ Markdown вместо PDF: порядок колонок, таблицы, токены
- Как парсер превращает PDF в Markdown: текстовый слой, OCR и VLM
- Конвертировать PDF в Markdown по шагам: MinerU и Docling
- MinerU, Docling, Marker, olmOCR, MarkItDown: сравнение по 9 критериям
- Лицензии парсеров: что разрешено бизнесу и где ловушки
- Кириллица и украинский: какой OCR-язык указать и как проверить
- Какому бенчмарку верить: рейтинги парсеров переворачиваются
- Облачный парсер или свой сервер: цена 1000 страниц PDF
- Когда парсер не подходит и чем рискуете: CVE, скрытый текст, ошибки
- Проверьте парсер на своих PDF за час: мини-бенчмарк на 10 страниц
- FAQ
Зачем ИИ Markdown вместо PDF: порядок колонок, таблицы, токены
Markdown — это текст с минимальной разметкой: # перед заголовком, | между ячейками таблицы, - перед пунктом списка. Модель видит структуру документа и не тратит внимание на координаты символов. PDF же описывает внешний вид страницы, и при «наивном» извлечении текста ломаются три вещи.
- Порядок чтения. В статье на две колонки извлекатель часто читает строку слева направо через обе колонки — предложения перемешиваются.
- Таблицы. Ячейки превращаются в поток чисел без границ: модель уже не знает, какая цифра к какому столбцу относится.
- Служебный мусор. Колонтитулы, номера страниц и сноски врезаются в середину абзаца и попадают в ответы.
Спор «PDF vs Markdown for LLM» обычно сводится к стоимости и точности. Markdown разбивается на смысловые куски по заголовкам, и каждый кусок (чанк) потом превращается в вектор для поиска. Это основа RAG — схемы, где модель сначала находит нужные фрагменты в вашей базе, а потом отвечает по ним; как выбрать модель для векторов, мы разбирали в материале про эмбеддинг-модели для RAG. Тот же Markdown удобен как постоянная база знаний агента — подход, описанный в разборе LLM Wiki по идее Карпаты.
Когда парсер не нужен: PDF можно отдать модели напрямую
Иногда проще отправить PDF модели как есть. По документации Anthropic на 2 ноября 2026 года Claude обрабатывает каждую страницу PDF дважды — как текст и как картинку, и текст одной страницы обычно стоит 1 500–3 000 токенов плюс цена изображения. Лимит — 600 страниц на запрос (100, если контекстное окно запроса меньше 1 млн токенов).
Посчитаем. Отчёт на 300 страниц — это 450 000–900 000 токенов одного только текста, и вы платите их при каждом вопросе к документу. Почему длинный контекст ещё и «забывает» детали, мы объясняли в статье про контекстное окно LLM. Готовый .md та же модель принимает как обычный текст (text/plain) без картинок страниц.
Отсюда простое правило:
- Разовый вопрос к нескольким файлам — загружайте PDF в чат-ассистента. Если хочется задавать вопросы сразу пачке документов и слушать пересказы, подойдёт сервис из нашего гайда по NotebookLM.
- Один простой файл без секретов, нужен Markdown — любой онлайн-конвертер или локальный MarkItDown от Microsoft (подойдёт для цифрового PDF без сложных таблиц и сканов, подробнее ниже). Помните: онлайн-конвертер отправляет файл на чужой сервер, MarkItDown работает на вашем компьютере.
- Сотни и тысячи страниц, повторные запросы, RAG — нужен парсер: вы один раз платите за разбор и дальше работаете с дешёвым текстом.
Почему MarkItDown хватает для Word, но не для сложных PDF
MarkItDown (лицензия MIT, версия 0.1.9 от 21 октября 2026 года) хорошо переводит в Markdown .docx. С PDF другое дело: по умолчанию он использует pdfminer.six, который только вытаскивает поток текста, без анализа вёрстки, без OCR и без распознавания таблиц. В бенчмарке OpenDataLoader у MarkItDown 0,273 балла за таблицы и 0,000 за иерархию заголовков. OCR добавляет отдельный плагин markitdown-ocr, который отправляет картинки в LLM с компьютерным зрением. Для отчётов с таблицами нужен инструмент тяжелее.
Как парсер превращает PDF в Markdown: текстовый слой, OCR и VLM
Современный парсер документов — это конвейер из четырёх ступеней. Разные инструменты включают разные ступени, и от этого зависят скорость, требования к железу и качество.
- Текстовый слой. В «цифровом» PDF (выгруженном из Word или LaTeX) текст уже есть — его нужно только прочитать. Быстро, работает на любом процессоре, но со сканами бесполезно.
- Модели разметки страницы (layout). Небольшие нейросети находят на странице блоки: заголовок, абзац, таблицу, формулу, подпись к рисунку — и определяют порядок чтения.
- OCR (оптическое распознавание символов). Для сканов и картинок: модель «читает» буквы с изображения. Здесь важен язык — модель, обученная на латинице, кириллицу распознаёт плохо.
- VLM (vision-language model). Модель, которая видит изображение страницы целиком и сразу пишет Markdown. Лучше справляется со сложной вёрсткой, но медленнее, требует видеокарту и иногда выдумывает текст.
Docling: что это и как он устроен
Docling — открытая библиотека для разбора документов из IBM Research, которую в апреле 2025 года IBM передала фонду LF AI & Data при Linux Foundation. Лицензия — MIT, свежая версия на 2 ноября 2026 года — 2.145.0 от 29 октября. В основе лежат специализированные модели: DocLayNet для разметки страницы и TableFormer для структуры таблиц. Для сложных страниц есть VLM-режим с моделью GraniteDocling. Red Hat описывает Docling как дополнение к своей платформе Red Hat AI.
MinerU 4: четыре уровня качества от flash до advanced
MinerU делает лаборатория OpenDataLab. На 2 ноября 2026 года на PyPI лежит версия 4.1.4 (вышла в тот же день, 4.1.3 — 30 октября). Главная идея четвёртой ветки — уровни разбора (tiers): вы выбираете не модель, а нужное качество.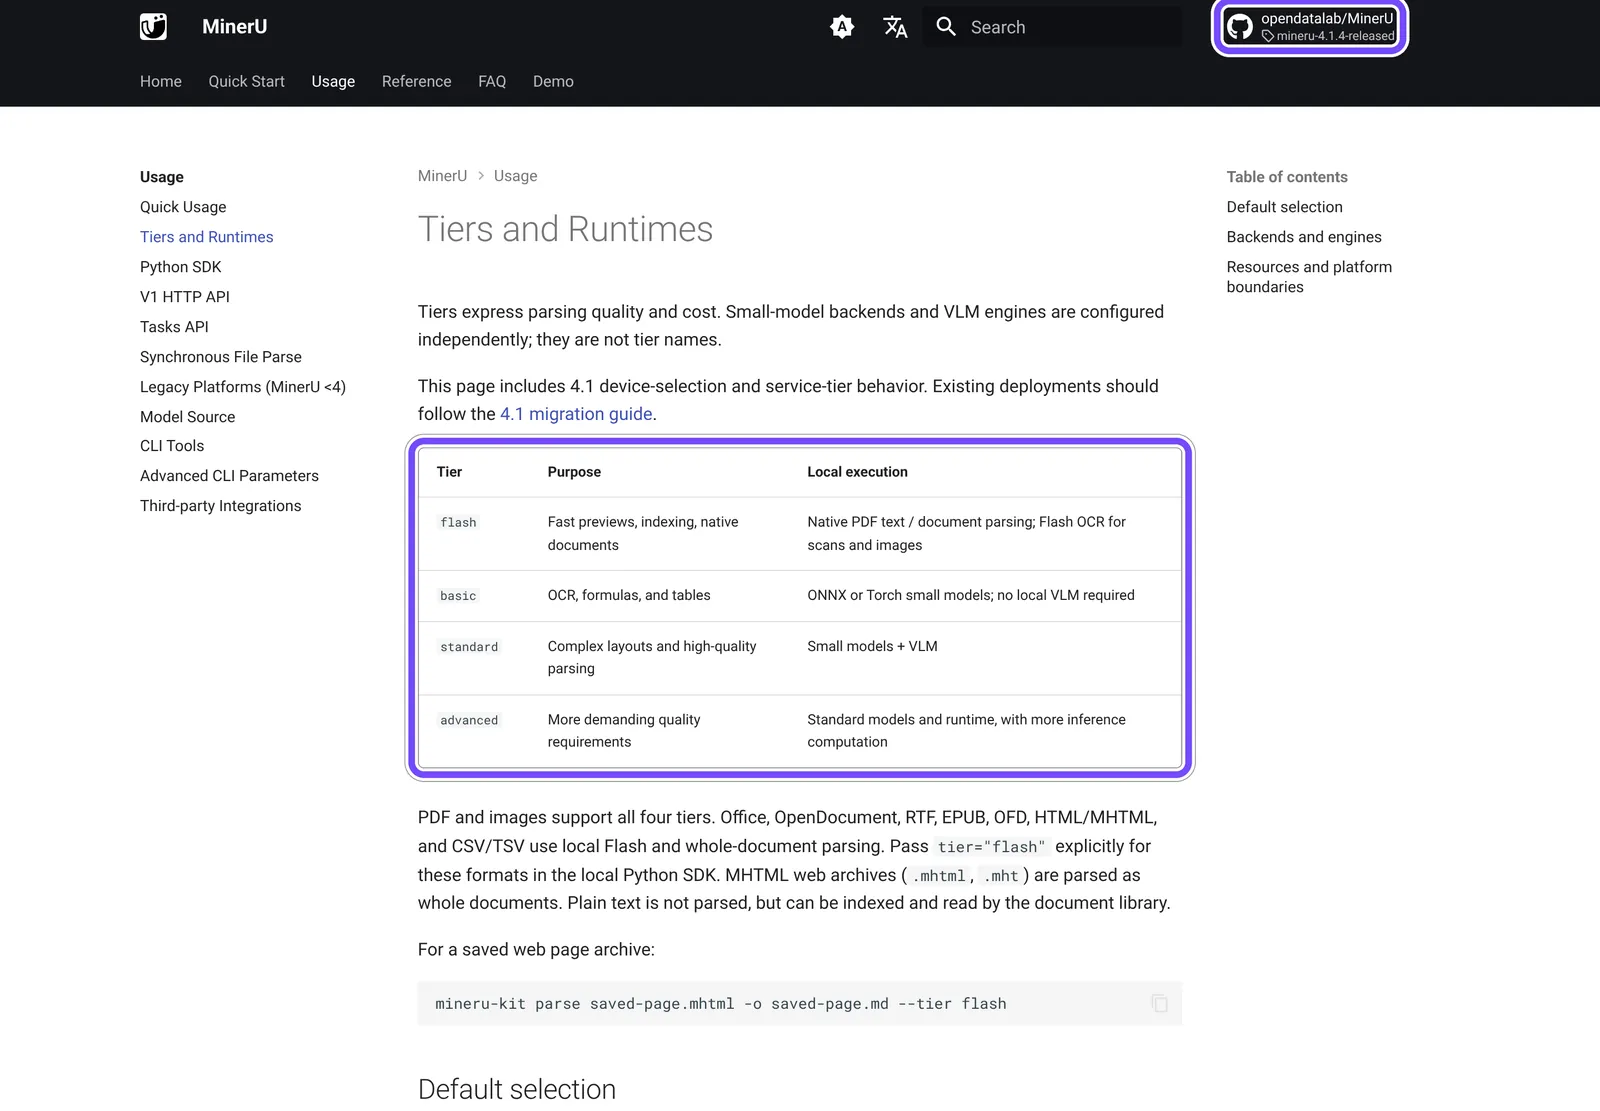
На странице документации, снятой 2 ноября 2026 года, рамкой выделена таблица уровней, а в шапке — бейдж последнего релиза:
- flash — быстрый просмотр и индексация: текстовый слой цифровых документов, для сканов и картинок — облегчённый Flash OCR;
- basic — OCR, формулы и таблицы небольшими моделями (ONNX или Torch), без VLM;
- standard — сложная вёрстка: небольшие модели плюс VLM; этот уровень включается по умолчанию для PDF;
- advanced — те же модели, но больше вычислений на страницу.
Кроме PDF, MinerU принимает картинки, DOCX, PPTX, XLSX, EPUB, HTML и ещё десяток форматов. На Mac с Apple Silicon он сам выбирает Torch/MPS и llama.cpp/Metal.
Конвертировать PDF в Markdown по шагам: MinerU и Docling
Команды ниже взяты из официальной документации обоих проектов на 2 ноября 2026 года. Синтаксис меняется между версиями: у MinerU старая команда mineru -p input.pdf -o output в ветке 4.x заменена на mineru-kit parse input.pdf -o output.md, а многие инструкции в интернете до сих пор показывают старую.
MinerU: установка и первая конвертация за пять шагов
- Создайте виртуальное окружение. MinerU требует Python от 3.11 до 3.14 (
>=3.11,<3.15), документация советует начинать с 3.12:uv venv --python 3.12 .venv, затемsource .venv/bin/activate(на Windows —.venv\Scripts\Activate.ps1). - Установите пакет:
uv pip install -U "mineru>=4.0,<5". Базовая сборка уже включает ONNX-модели и llama.cpp; веб-интерфейс запускается командойmineru-kit webui. - Проверьте железо:
mineru-kit hardware detectподскажет, какой уровень потянет ваш компьютер. Для производительного локального запуска документация советует закладывать от 16 ГБ оперативной памяти, а 8 ГБ видеопамяти называет лишь отправной точкой для планирования, а не гарантией. - Разберите файл:
mineru-kit parse document.pdf -o document.md --tier standard. При первом запуске скачаются веса моделей. - Пакетная обработка:
mineru-kit parse ./documents -o ./output --format zip— для папки-oдолжен указывать на каталог.
Две оговорки. Для цифрового PDF без нейросетей есть --tier flash --ocr-mode txt, но такой режим читает только текстовый слой и не подстрахует OCR-ом сканированные страницы — для них нужен --ocr-mode ocr. И не путайте mineru-kit parse с командой mineru parse: вторая работает через библиотеку документов, по умолчанию берёт только первые 10 страниц и собирает телеметрию использования. Отключается она командой mineru telemetry disable; содержимое файлов, по документации, в телеметрию не попадает.
Docling: как пользоваться из командной строки и Python
Docling запускается одной командой в терминале или пятью строками в Python-скрипте.
- Установка:
pip install docling. Нужен Python 3.10 или новее; поддерживаются macOS, Linux и Windows. - Конвертация из терминала:
docling document.pdf— рядом появится.mdс содержимым документа. - Конвертация из Python:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()
result = converter.convert("document.pdf")
print(result.document.export_to_markdown())
- Сканы на кириллице: добавьте язык OCR, например
docling scan.pdf --ocr-lang iso:uk(подробнее — в разделе про кириллицу ниже). - Сложная вёрстка: VLM-режим включается флагом
docling --pipeline vlm --vlm-model granite_docling document.pdf.
Полезная и малоизвестная опция — --replace-broken-text-layer. Бывают PDF, которые на экране выглядят нормально, а при копировании дают мусор: шрифт не связывает глифы с настоящими буквами. Docling находит такие страницы (в документации есть пример с русским текстом, превратившимся в Îò÷¸ò) и перечитывает их через OCR. По умолчанию опция выключена.
Как проверить результат за пять минут
Откройте .md рядом с PDF и пройдитесь по короткому списку:
- Таблицы: число строк и столбцов совпадает, объединённые ячейки не съехали.
- Заголовки: уровни
#,##,###соответствуют структуре документа, а не размеру шрифта. - Цифры: суммы, даты и дозировки совпадают с оригиналом символ в символ.
- Мусор: поиск по символу
�и по колонтитулам, которые повторяются на каждой странице.
MinerU, Docling, Marker, olmOCR, MarkItDown: сравнение по 9 критериям
Сведения в таблице — из PyPI, лицензий и документации проектов на 2 ноября 2026 года. «н/д» означает, что первоисточник этого не указывает.Критерий MinerU Docling Marker olmOCR 2 MarkItDown Версия 4.1.4 (02.11.2026) 2.145.0 (29.10.2026) 2.1.0 olmOCR 2 (22.10.2025) 0.1.9 Лицензия кода Apache-2.0 + доп. условия MIT Apache-2.0 Apache-2.0 MIT Ограничения для бизнеса больше 100 млн MAU или больше $20 млн выручки в месяц — отдельная лицензия; онлайн-сервис обязан указать MinerU нет веса модели платные при выручке или инвестициях >$5 млн нет нет Python 3.11–3.14 3.10+ 3.10+ и PyTorch н/д н/д Железо 16 ГБ RAM — ориентир для производительного запуска; basic работает на CPU; Apple Silicon обычный ПК, PyTorch balanced на GPU, fast на CPU/MPS NVIDIA от 12 ГБ видеопамяти любой ПК Сканы и OCR да, с уровня basic да, на выбор EasyOCR, RapidOCR, Tesseract и другие да, через мультиязычную VLM surya да, VLM по изображению страницы только плагином через LLM Таблицы и формулы да таблицы — TableFormer да, по тестам olmOCR-bench да, по тестам olmOCR-bench таблицы 0,273 в ODL-бенчмарке Кириллица модели PP-OCRv5 для кириллицы язык нужно задать: cyrillic, eslav, iso:ukмультиязычный OCR surya заточен под английский только текстовый слой Сильная сторона качество на сканах и формулах скорость на CPU, лицензия, интеграции баланс скорости и качества на GPU дешёвый массовый прогон на своём GPU Word и Excel за секунды
Docling vs MinerU vs Marker: кому что подходит
Разницу между Docling и MinerU лучше всего показывает единственный найденный нами независимый замер с железом. Автор корейского практикума на WikiDocs (5 октября 2026 года) прогнал пятистраничный скан на MinerU 4.0.10 и Docling 2.132.0 — на видеокарте RTX 3090 и на процессоре с 4 ядрами и 16 ГБ памяти:Настройка Ошибка символов (CER) RTX 3090 CPU, 4 ядра MinerU standard 0,005 67,3 с 1 696 с Docling + EasyOCR 0,070 12,5 с 162,8 с
CER — доля неверно распознанных символов: 0,005 значит одна ошибка на 200 знаков, 0,070 — семь на сотню. Время включает загрузку моделей. Вывод практикума: MinerU точнее, Docling примерно в 10 раз быстрее на процессоре, а без видеокарты MinerU тратит около 5 минут 40 секунд на страницу. Текст корейский, но класс задачи — не-латиница на сканах — тот же, что у нас.
Отсюда практическая развилка:
- Нет видеокарты, документов много, PDF в основном цифровые — Docling. Лицензия MIT снимает юридические вопросы.
- Есть GPU, много сканов, формул и сложных таблиц — MinerU на уровне standard. Проверьте условия лицензии, если у вас крупный онлайн-сервис.
- Нужен баланс скорости и качества на GPU — Marker. Для стартапа с выручкой и инвестициями до $5 млн веса бесплатны; крупной компании нужна лицензия или облачный API Datalab.
- Огромный англоязычный архив и своя NVIDIA — olmOCR 2.
Общего победителя среди трёх нет: у каждого своя полоса, и ниже видно, как по-разному их оценивают бенчмарки.
Лицензии парсеров: что разрешено бизнесу и где ловушки
Лицензия — то, на чём чаще всего ошибаются чужие обзоры. Вот что написано в первоисточниках на 2 ноября 2026 года.Инструмент Лицензия Что требует отдельного договора MinerU Apache-2.0 + дополнительные условия MAU больше 100 млн или выручка больше $20 млн в месяц; онлайн-сервис для третьих лиц обязан заметно указать, что использует MinerU Docling MIT ничего Marker код Apache-2.0, веса — модифицированная OpenRAIL-M коммерческое использование весов, если выручка за прошлый год или привлечённое финансирование (инвестиции или долг) больше $5 млн; личное и исследовательское использование свободно PyMuPDF и pymupdf4llm AGPL-3.0 или коммерческая лицензия Artifex закрытый продукт или сервис, если вы не готовы открыть свой код по AGPL olmOCR Apache-2.0 ничего MarkItDown MIT ничего Unstructured (open source) Apache-2.0 ничего; облачная платформа — отдельно LlamaParse коммерческий сервис, не open source всё — это платный API
Ловушки, на которые стоит смотреть до внедрения:
- Устаревшее «MinerU — это AGPL». Смену лицензии внесли коммитом 14 апреля 2026 года, релиз 3.1.0 вышел 17–18 апреля. Обзор yage.ai от 12 апреля ещё писал, что AGPL ограничивает коммерческое использование, а MinerU не работает на macOS. Сегодня неверно и то и другое: лицензию сменили через несколько дней после публикации, а документация 4.1 описывает запуск на Apple Silicon. Сами пороги прописаны в LICENSE.md репозитория MinerU.
- AGPL распространяется на сеть. Если изменённую версию AGPL-кода вы запускаете как сервис, исходники изменённой версии нужно открыть пользователям. Это касается PyMuPDF и, соответственно, pymupdf4llm: его код переехал в пакет
pymupdf2.x. - Код и веса — разные лицензии. У Marker открыт код, но без весов модели он не работает, а у весов свой порог в $5 млн.
- «Бесплатно» не значит «без обязательств». Даже при MIT проверьте лицензии зависимостей и моделей, которые инструмент скачивает при первом запуске.
Это пересказ условий, а не юридическая консультация: для коммерческого продукта текст лицензии стоит показать юристу.
Кириллица и украинский: какой OCR-язык указать и как проверить
По умолчанию открытые парсеры читают сканы не той моделью. В документации Docling это записано прямо: если язык не задан (lang=[]), EasyOCR берёт английский, а RapidOCR — упрощённый китайский. Без флага --ocr-lang движок использует свои языки по умолчанию (таблица в документации Docling). Для цифровых PDF с текстовым слоем это не важно, для сканов — критично.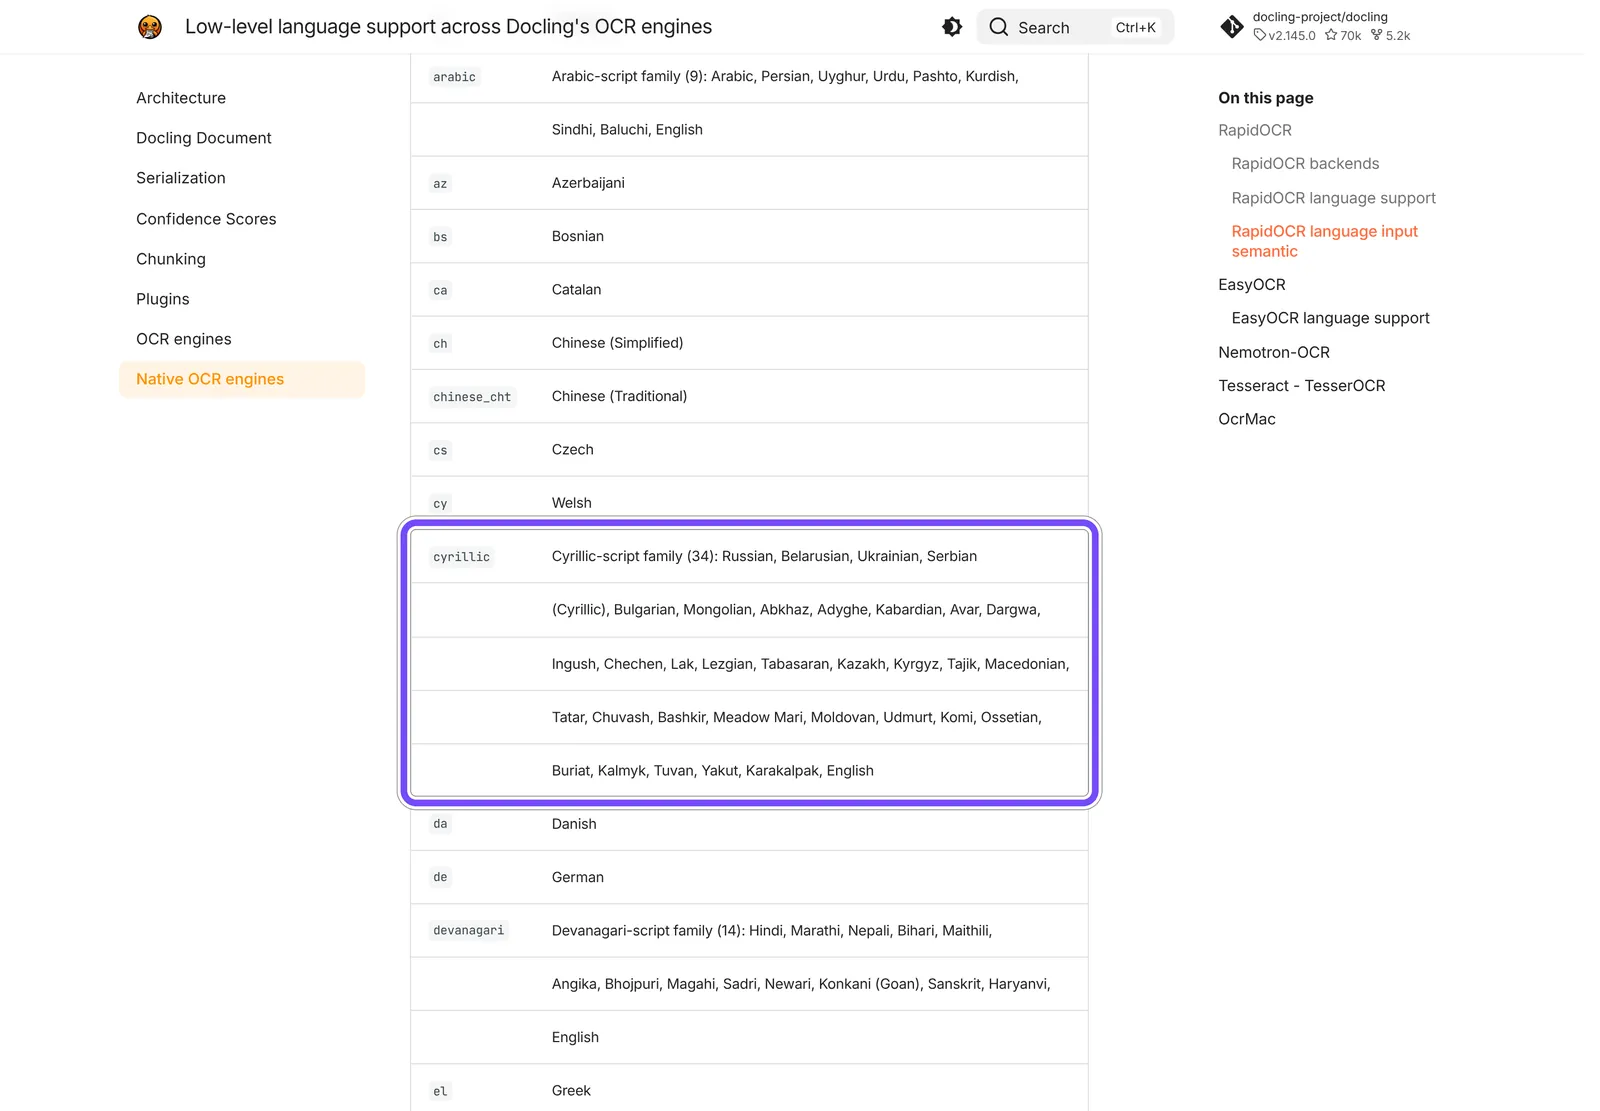
На странице Native OCR engines (снято 2 ноября 2026 года) рамкой выделена строка cyrillic: это семейство из 34 языков на кириллице, где есть русский, белорусский и украинский. Что из этого следует для команды:
- Docling + RapidOCR. Коды
iso:uk,iso:ruиiso:beсводятся к восточнославянской моделиeslav(PP-OCR v5). RapidOCR читает один язык за прогон: при нескольких берёт первый, остальные отбрасывает с предупреждением. - Запасной вариант. Сторонний справочник docling.org (не официальная документация) сообщает, что на PyTorch-бэкенде RapidOCR код
iso:ruвыдал ошибкуOcrLanguageNotSupportedErrorи сработал толькоcyrillic. Если увидите такую ошибку, пробуйте--ocr-lang cyrillic. - MinerU. В ноябре 2025 года модели для кириллицы обновили до PP-OCRv5. В разделе известных проблем README (редакция ветки 3.0) предупреждает, что на менее распространённых языках OCR может путать символы; в примерах — латиница с диакритикой и арабское письмо, кириллица прямо не названа.
- Marker распознаёт через мультиязычную VLM surya, olmOCR 2 AllenAI позиционирует под английские документы, Mistral OCR по заявлению вендора поддерживает 170 языков.
Что известно о качестве на кириллице
Независимого теста парсеров PDF на украинском или русском языке мы не нашли. Единственные «кириллические» цифры — из статьи авторов PaddleOCR-VL (Baidu): на их внутреннем наборе ошибка редактирования у MinerU2.5 — 0,832, у PaddleOCR-VL — 0,109 (меньше — лучше). Это распознавание отдельных строк, а не разбор страниц PDF; MinerU2.5 здесь — VLM-модель сентября 2025 года, а не нынешняя ветка 4.x; и тест провела заинтересованная сторона.
Корейский практикум даёт ещё одну подсказку: по умолчанию MinerU basic и Docling использовали PP-OCRv6, в котором корейского нет, и оба провалили скан. Для кириллицы вывод тот же: убедитесь, что выбранная модель вообще знает ваш алфавит.
Третья проблема — гомоглифы, то есть похожие буквы из разных алфавитов. Украинский разбор webscraft.org приводит пример «ЗО» вместо «30»: OCR подставил кириллическую «З» и букву «О» вместо цифр. На глаз это незаметно, а поиск по числу 30 такой фрагмент не найдёт. Поэтому суммы, даты и номера после OCR проверяйте отдельным проходом.
Если ваш архив рукописный, обратите внимание на Rukopys-OCR-4B — украинскую модель для рукописного текста на базе Qwen3.5-4B под лицензией Apache 2.0 (опубликована 25 августа 2026 года). Для печатных PDF она не предназначена.
Какому бенчмарку верить: рейтинги парсеров переворачиваются
Почти каждая англоязычная подборка «best PDF parser for LLMs» опирается на чей-то бенчмарк. Проблема в том, что три главных бенчмарка расставляют парсеры по-разному, и каждый ведёт заинтересованная сторона.Бенчмарк Кто ведёт Что меряет MinerU Docling Marker Другие OmniDocBench v1.6 (лидерборд на 11.09.2026) OpenDataLab — авторы MinerU 1 651 страница в базовом наборе, в v1.6 добавлено ещё 296: текст, таблицы, формулы 86,47 (Pipeline); 95,75 у VLM MinerU2.5-Pro н/д 78,44 (старая версия 1.8.2) olmOCR 85,74; Mistral OCR 85,66 (версия 2503) olmOCR-bench в прогоне Datalab Datalab — авторы Marker 1 403 PDF, около 8 400 тестов «прошёл/не прошёл», 8 категорий 72,7 (pipeline) 50,3 76,0 (balanced) у AllenAI: Marker 76,1, MinerU 75,8, olmOCR 2 — 82,4 OpenDataLoader bench OpenDataLoader — авторы своего парсера 200 PDF: порядок чтения, таблицы, заголовки 0,831 0,882 0,861 MarkItDown 0,589; гибридный OpenDataLoader 0,907
Шкалы разные: в первых двух — баллы из 100, в третьем — доля от 1. Сравнивать числа между строками нельзя, только порядок внутри строки. А порядок переворачивается: Docling лучший из тройки в OpenDataLoader, а у Datalab отстаёт от MinerU и Marker больше чем на 20 баллов. В бенчмарке своих же авторов MinerU-Pipeline опережает Marker 1.8.2 на 8 баллов, а VLM-модель MinerU2.5-Pro набирает 95,75.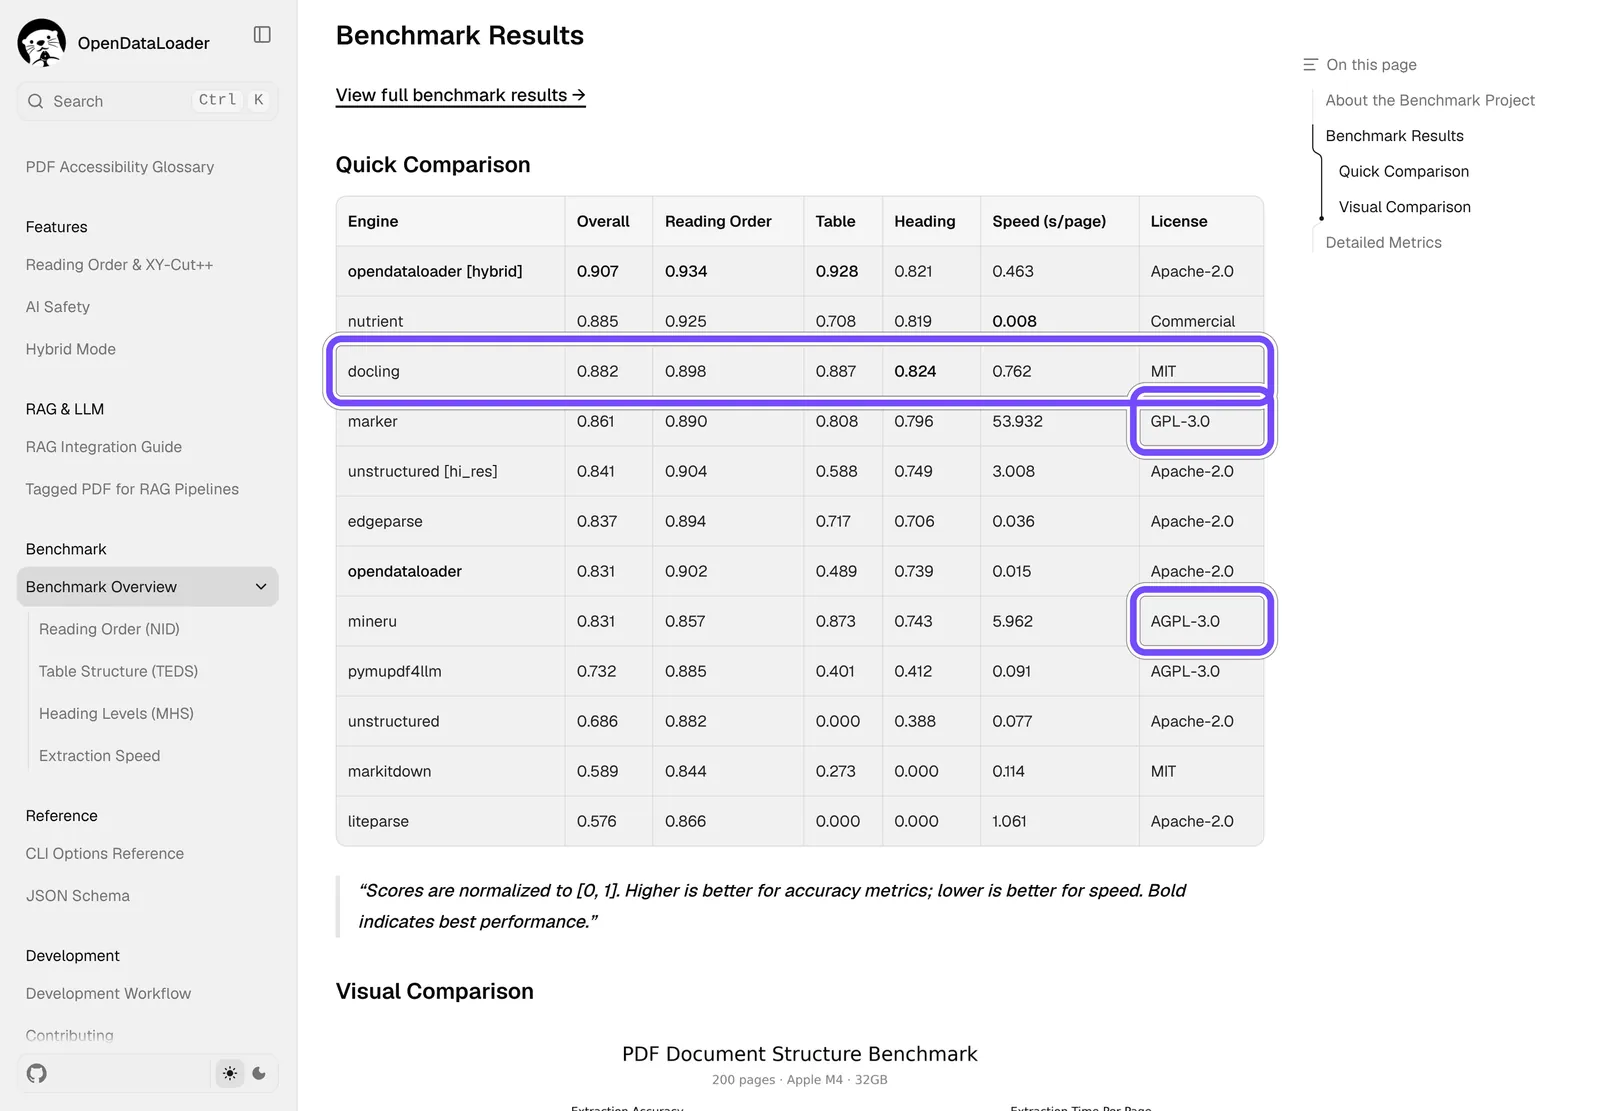
На скриншоте страницы OpenDataLoader от 2 ноября 2026 года рамкой выделены строка Docling и две ячейки с лицензиями: Marker там помечен GPL-3.0, MinerU — AGPL-3.0. Обе пометки устарели, и это хороший тест: если бенчмарк не обновил лицензии, вероятно, он не перепроверял и версии инструментов.
Почему результаты расходятся:
- Разные документы. OmniDocBench в основном китайский и английский, olmOCR-bench — англоязычные PDF со сложной математикой и старыми сканами.
- Разные метрики. Расстояние редактирования текста, совпадение структуры таблиц (TEDS), юнит-тесты на порядок строк — каждая метрика поощряет своё.
- Разные версии и режимы. В OmniDocBench оценены Marker 1.8.2 и Mistral OCR 2503, а не нынешние версии; Datalab запускал Docling с настройками по умолчанию.
- Разное железо. Datalab мерил скорость на сервере с одной B200, OpenDataLoader — на Apple M4.
Сами вендоры это признают. Mistral в анонсе OCR 4 пишет, что их бенчмарки «ориентировочные», цифры конкурентов — внутренние воспроизведения, и советует проверять на своих документах. CodeSOTA отозвала собственное сравнение скорости Docling и MinerU: к нему не было ни тестовых файлов, ни результатов, ни описания прогона. Поэтому любой «лучший парсер» без даты, версии и методики — это мнение, а не замер.
Облачный парсер или свой сервер: цена 1000 страниц PDF
Облачные парсеры избавляют от установки и видеокарты, но берут деньги за страницу и получают ваши файлы. Цены — по страницам вендоров на 2 ноября 2026 года (у Mistral — с момента анонса OCR 4 23 июня 2026 года); других источников, кроме самих вендоров, у этих цифр нет.Сервис Цена за 1000 страниц Бесплатно Архив 5 000 страниц (наш расчёт) Mistral OCR 4 $4; через Batch API — $2 н/д $20 или $10 пакетом LlamaParse от $1,25 (Fast) до $56,25 (Agentic Plus) 10 000 кредитов в месяц новым пользователям от $6,25 до $281,25 Datalab (облачный Marker) lite $0,50; fast/balanced $4; accurate $10 $20 в месяц на рабочую почту, около 5 000 страниц $2,50 / $20 / $50 olmOCR на своём GPU меньше $0,20 по оценке AllenAI — меньше $1 плюс ваше железо MinerU или Docling локально $0 за лицензию — электричество и время
Как считали. У LlamaParse 1000 кредитов стоят $1,25, а страница в режиме Fast — 1 кредит, Cost-effective — 3, Agentic — 10, Agentic Plus — 45. Значит, 5 000 страниц в Cost-effective — это 15 000 кредитов, или $18,75; в Agentic Plus — 225 000 кредитов, или $281,25. В режиме Fast те же 5 000 страниц укладываются в бесплатные 10 000 кредитов. Оценка AllenAI для olmOCR — меньше $200 за миллион страниц, то есть меньше $1 за наш архив без учёта стоимости видеокарты.
Время локальной обработки прикинем по известным замерам. По корейскому практикуму Docling с EasyOCR на 4-ядерном CPU тратил около 33 секунд на страницу скана — 5 000 страниц займут примерно 45 часов. MinerU standard на том же процессоре (около 5 минут 40 секунд на страницу) потратил бы на архив почти три недели непрерывной работы. Оба замера включают загрузку моделей, так что это верхняя оценка. На серверной B200 по данным Datalab Marker в режиме balanced выдаёт 2,9 страницы в секунду (архив — около 29 минут), Docling — 2,1, MinerU — 0,54 страницы в секунду.
Что происходит с вашими файлами
- LlamaParse по FAQ хранит файлы 48 часов в кэше, чтобы не брать деньги дважды за один документ, и не использует их для обучения моделей.
- Mistral OCR 4 помещается в один контейнер, и самостоятельное развёртывание предлагается корпоративным клиентам — документы остаются у вас.
- MinerU по документации не загружает документы в официальный облачный сервис автоматически: удалённый разбор нужно явно настроить.
- Docling работает полностью локально, включая изолированные сети без интернета. По описанию Red Hat, модели для этого нужно заранее скачать на машине с доступом в сеть, перенести во внутреннюю сеть и включить офлайн-режим.
Для договоров, медицинских и финансовых документов это часто важнее цены: локальный парсер бесплатен не только по деньгам, но и по рискам утечки.
Когда парсер не подходит и чем рискуете: CVE, скрытый текст, ошибки
Парсер — это код, который открывает чужие файлы, и модель, которая иногда ошибается молча. Вот риски, которые стоит учесть до запуска в работу.
- Скрытый текст становится инструкцией для модели. Текст в невидимом режиме отрисовки PDF человек не видит, а парсер извлекает его как обычный текст, и тот попадает в чанки RAG. Такой случай описан в issue #4377 библиотеки Unstructured (25 июня 2026 года). Исследование на конференции ACM AISec нашло, что атаки через документы срабатывают в 74,4% из 357 сценариев на пяти популярных загрузчиках данных. Механика та же, что у других атак на агентов, которые мы разбирали в материале про атаки через MCP-серверы.
- Уязвимости в самом парсере. 23 октября 2026 года Docling опубликовал пачку предупреждений безопасности. Одно из них: определение формата читает файл внутри ZIP-архива без ограничения размера, и маленький архив может исчерпать память. Ещё раньше, 5 октября, вышла CVE-2026-105751: специально собранный
.odtзаставлял Docling открыть файл по пути, заданному атакующим. Обновляйтесь и разбирайте чужие документы в изолированном окружении. - Тихая порча данных. Статья на воркшопе DocInsights 2026 (один автор, 6 парсеров) показала: если число в документе исказилось при разборе, а текст всё равно вернулся, в 96,5% случаев модель отвечает уверенно неверным значением, а не «не знаю».
- VLM может выдумать таблицу. В issue #90 проекта socr (обёртка над Qwen3-VL, 22 июня 2026 года) описано, как модель на трудных сканах генерирует правдоподобные несуществующие таблицы при статусе «успешно». Это не MinerU и не Docling, но тот же класс инструментов.
- Телеметрия и кэш. Библиотека документов MinerU по умолчанию собирает данные об использовании, облачные сервисы держат файлы в кэше — проверьте настройки до загрузки конфиденциального архива.
Когда парсер вообще не нужен, разобрано в начале статьи; добавим только рукописи — для них нужна специализированная модель.
Что устареет первым: версии и команды (MinerU сменил синтаксис между 3.x и 4.x, свежий релиз вышел в день написания статьи), цены облачных сервисов и лидерборды бенчмарков. Актуальное смотрите на PyPI, в файлах LICENSE репозиториев и на страницах тарифов.
Проверьте парсер на своих PDF за час: мини-бенчмарк на 10 страниц
Лидерборд отвечает на вопрос «какой парсер лучше на чужих документах». Вам нужен ответ на ваших. Вот методика на час работы.
- Соберите 10 страниц из своего архива: две обычные текстовые, две в две колонки, две с таблицами (одна — с объединёнными ячейками), одну с формулами или схемами, две сканированные (хотя бы одну — на украинском или русском) и одну с колонтитулами и сносками.
- Прогоните их через два-три парсера с одинаковыми настройками языка: например, Docling на CPU и MinerU на уровне standard. Можно добавить облачный сервис в рамках бесплатного лимита.
- Оцените четыре вещи по шкале 0–2: порядок чтения, таблицы, заголовки и цифры. Цифры сверяйте символ в символ.
- Запишите время на страницу и железо, на котором запускали.
- Посчитайте сумму баллов и умножьте время на объём архива. Победитель — тот, кто набрал приемлемое качество за приемлемое время, а не тот, кто первый в чужом рейтинге.
Сводную таблицу удобно вести прямо в Markdown: страница × парсер × четыре оценки × секунды. Через месяц, когда выйдут новые версии, тот же набор страниц покажет, стоит ли обновляться.
Где эти парсеры уже работают
- RAGFlow — открытый движок для RAG — в версии 0.22.0 добавил MinerU 2.6.3 как ещё один вариант разбора PDF, а рядом — Docling. RAGFlow запускает парсер, читает его результат и складывает в базу знаний.
- Red Hat описывает Docling как дополнение к платформе Red Hat AI и приводит пример госструктур, которым нельзя отправлять документы в публичные облачные сервисы.
- Сам Docling развивается под крылом LF AI & Data — это снижает риск, что проект закроют или сменят лицензию одним решением компании.
FAQ
Чем MinerU отличается от Docling и Marker?
MinerU делает ставку на качество сложных страниц и сканов: четыре уровня разбора, VLM на уровне standard, сильные результаты на формулах. Docling легче, быстрее на процессоре и распространяется под MIT. Marker держит баланс скорости и качества на видеокарте, но веса его модели платные для компаний с выручкой или инвестициями больше $5 млн.
Можно ли использовать MinerU в коммерческом проекте после смены лицензии?
Да, с апреля 2026 года MinerU распространяется под Apache-2.0 с дополнительными условиями. Отдельная лицензия нужна, если у продукта больше 100 млн активных пользователей в месяц или выручка больше $20 млн в месяц. Онлайн-сервис для третьих лиц обязан заметно указать, что использует MinerU, в интерфейсе или публичной документации.
Какой парсер лучше читает украинские сканы?
Независимого сравнения на украинском и русском мы не нашли, поэтому ответ даст только тест на ваших файлах. Обязательное условие — явно задать язык OCR: у Docling это iso:uk, eslav или cyrillic, иначе скан прочитает английская или китайская модель. После OCR отдельно проверяйте цифры: кириллическая «З» легко заменяет тройку.
Нужна ли видеокарта, чтобы запустить MinerU или Docling?
Нет, оба работают на процессоре. Docling рассчитан на обычный компьютер, а MinerU на уровне basic обходится без VLM. Но со сканами разница большая: в независимом замере MinerU standard на 4-ядерном CPU тратил около 5 минут 40 секунд на страницу, а Docling с EasyOCR — около 33 секунд. Для производительного запуска MinerU документация советует закладывать от 16 ГБ RAM.
Зачем конвертировать PDF в Markdown, если Claude читает PDF сам?
Для разовых вопросов конвертировать не нужно. Но Claude при каждом запросе обрабатывает страницу как текст и картинку — обычно 1 500–3 000 токенов текста плюс изображение, и платите вы каждый раз. Markdown получается один раз, дальше он дешёвый, режется на чанки для RAG и не упирается в лимит 600 страниц на запрос.
Безопасно ли загружать конфиденциальные PDF в облачные парсеры?
Только если вас устраивают условия сервиса: документ в любом случае покидает вашу инфраструктуру. LlamaParse, например, держит файлы в кэше 48 часов и обещает не обучать на них модели. Для договоров, медицинских и финансовых данных надёжнее локальный MinerU или Docling либо Mistral OCR, развёрнутый внутри своей сети: такое развёртывание Mistral предлагает корпоративным клиентам.