Коротко (TL;DR)
- Конвертувати PDF у Markdown для ШІ варто, коли документів багато: RAG-пошук, база знань, пакетна обробка. Для одного файлу вистачить онлайн-конвертера або завантаження PDF просто в чат-асистента.
- Головні відкриті парсери на 2 листопада 2026 року — MinerU (4.1.4), Docling (2.145.0) і Marker (2.1.0); поруч olmOCR від AllenAI та MarkItDown від Microsoft.
- Багато оглядів застаріли: MinerU з квітня 2026 року не AGPL, а Apache-2.0 з порогами для великого бізнесу; у Marker код під Apache-2.0, але ваги моделі платні для компаній із виторгом або інвестиціями понад $5 млн.
- Кирилицю вмикають вручну: у Docling без зазначення мови OCR читає скан англійською чи китайською моделлю. Незалежного тесту парсерів українською ми не знайшли.
- Рейтинги суперечать один одному: Docling лідирує серед трьох парсерів в одному бенчмарку й відстає від обох конкурентів в іншому. Вирішує перевірка на 10 власних сторінках — методика наприкінці.
PDF описує не структуру документа, а його вигляд: який символ поставити в яку точку сторінки. Людині цього досить, мовній моделі — ні. Парсер документів перекладає цю «розкладку» назад у структуру: заголовки, абзаци в правильному порядку, таблиці з комірками. Нижче розбираємо, як він це робить, який узяти, у що обійдеться ліцензія і де він може підвести.
- Коротко (TL;DR)
- Навіщо ШІ Markdown замість PDF: порядок колонок, таблиці, токени
- Як парсер перетворює PDF на Markdown: текстовий шар, OCR і VLM
- Конвертувати PDF у Markdown покроково: MinerU і Docling
- MinerU, Docling, Marker, olmOCR і MarkItDown: 9 критеріїв
- Ліцензії парсерів: що дозволено бізнесу і де пастки
- Кирилиця й українська: яку мову OCR вказати і як перевірити
- Якому бенчмарку вірити: рейтинги парсерів перевертаються
- Хмарний парсер чи власний сервер: ціна 1000 сторінок PDF
- Коли парсер не підходить: CVE, прихований текст, помилки
- Перевірте парсер на своїх PDF за годину: мінібенчмарк на 10 сторінок
- Часті запитання
Навіщо ШІ Markdown замість PDF: порядок колонок, таблиці, токени
Markdown — це текст із мінімальною розміткою: # перед заголовком, | між комірками таблиці, - перед пунктом списку. Модель бачить структуру документа й не витрачає увагу на координати символів. PDF натомість описує вигляд сторінки, і за «наївного» видобування тексту ламаються три речі.
- Порядок читання. У статті на дві колонки видобувач часто читає рядок зліва направо через обидві колонки — речення перемішуються.
- Таблиці. Комірки перетворюються на потік чисел без меж: модель уже не знає, яка цифра якому стовпцю належить.
- Службове сміття. Колонтитули, номери сторінок і виноски вклинюються в середину абзацу й потрапляють у відповіді.
Суперечка «PDF vs Markdown for AI» зазвичай зводиться до вартості й точності. Markdown розбивається на смислові шматки за заголовками, і кожен шматок (чанк) потім перетворюється на вектор для пошуку. Це основа RAG — схеми, де модель спершу знаходить потрібні фрагменти у вашій базі, а потім відповідає за ними; як вибрати модель для векторів, ми розбирали в матеріалі про ембединг-моделі для RAG. Той самий Markdown зручний як постійна база знань агента — підхід, описаний у розборі LLM Wiki за ідеєю Карпаті.
Коли парсер не потрібен: PDF можна віддати моделі безпосередньо
Іноді простіше надіслати PDF моделі як є. За документацією Anthropic на 2 листопада 2026 року Claude обробляє кожну сторінку PDF двічі — як текст і як зображення, і текст однієї сторінки зазвичай коштує 1 500–3 000 токенів плюс ціна зображення. Ліміт — 600 сторінок на запит (100, якщо контекстне вікно запиту менше за 1 млн токенів).
Порахуймо. Звіт на 300 сторінок — це 450 000–900 000 токенів самого лише тексту, і ви платите їх за кожне запитання до документа. Чому довгий контекст іще й «забуває» деталі, ми пояснювали в статті про контекстне вікно LLM. Готовий .md та сама модель приймає як звичайний текст (text/plain) без зображень сторінок.
Звідси просте правило:
- Разове запитання до кількох файлів — завантажуйте PDF у чат-асистента. Якщо хочеться ставити запитання одразу пачці документів і слухати переказ, підійде сервіс із нашого гайду з NotebookLM.
- Один простий файл без секретів, потрібен Markdown — будь-який безкоштовний онлайн-конвертер PDF у Markdown або локальний MarkItDown від Microsoft (підійде для цифрового PDF без складних таблиць і сканів, докладніше нижче). Пам’ятайте: онлайн-конвертер надсилає файл на чужий сервер, MarkItDown працює на вашому комп’ютері.
- Сотні й тисячі сторінок, повторні запити, RAG — потрібен парсер: ви один раз платите за розбір і далі працюєте з дешевим текстом.
Чому MarkItDown досить для Word, але не для складних PDF
MarkItDown від Microsoft (ліцензія MIT, версія 0.1.9 від 21 жовтня 2026 року) добре перетворює на Markdown файли .docx. З PDF інакше: за замовчуванням він використовує pdfminer.six, який лише витягує потік тексту, без аналізу верстки, без OCR і без розпізнавання таблиць. У бенчмарку OpenDataLoader MarkItDown має 0,273 бала за таблиці й 0,000 за ієрархію заголовків. OCR додає окремий плагін markitdown-ocr, який надсилає зображення в LLM із комп’ютерним зором. Для звітів із таблицями потрібен важчий інструмент.
Як парсер перетворює PDF на Markdown: текстовий шар, OCR і VLM
Сучасний парсер документів — це конвеєр із чотирьох щаблів. Різні інструменти вмикають різні щаблі, і від цього залежать швидкість, вимоги до заліза та якість.
- Текстовий шар. У «цифровому» PDF (вивантаженому з Word чи LaTeX) текст уже є — його треба лише прочитати. Швидко, працює на будь-якому процесорі, але зі сканами марно.
- Моделі розмітки сторінки (layout). Невеликі нейромережі знаходять на сторінці блоки: заголовок, абзац, таблицю, формулу, підпис до рисунка — і визначають порядок читання.
- OCR (оптичне розпізнавання символів). Для сканів і зображень: модель «читає» літери із зображення. Тут важлива мова — модель, навчена на латиниці, кирилицю розпізнає погано.
- VLM (vision-language model). Модель, яка бачить зображення сторінки цілком і одразу пише Markdown. Краще дає раду складній верстці, але повільніша, потребує відеокарти й інколи вигадує текст.
Docling: що це і як він улаштований
Docling — відкрита бібліотека для розбору документів з IBM Research, яку у квітні 2025 року IBM передала фонду LF AI & Data при Linux Foundation. Ліцензія — MIT, свіжа версія на 2 листопада 2026 року — 2.145.0 від 29 жовтня. В основі — спеціалізовані моделі: DocLayNet для розмітки сторінки й TableFormer для структури таблиць. Для складних сторінок є VLM-режим із моделлю GraniteDocling. Red Hat описує Docling як доповнення до своєї платформи Red Hat AI.
MinerU 4: чотири рівні якості від flash до advanced
MinerU розробляє лабораторія OpenDataLab. На 2 листопада 2026 року на PyPI лежить версія 4.1.4 (вийшла того ж дня, 4.1.3 — 30 жовтня). Головна ідея четвертої гілки — рівні розбору (tiers): ви обираєте не модель, а потрібну якість.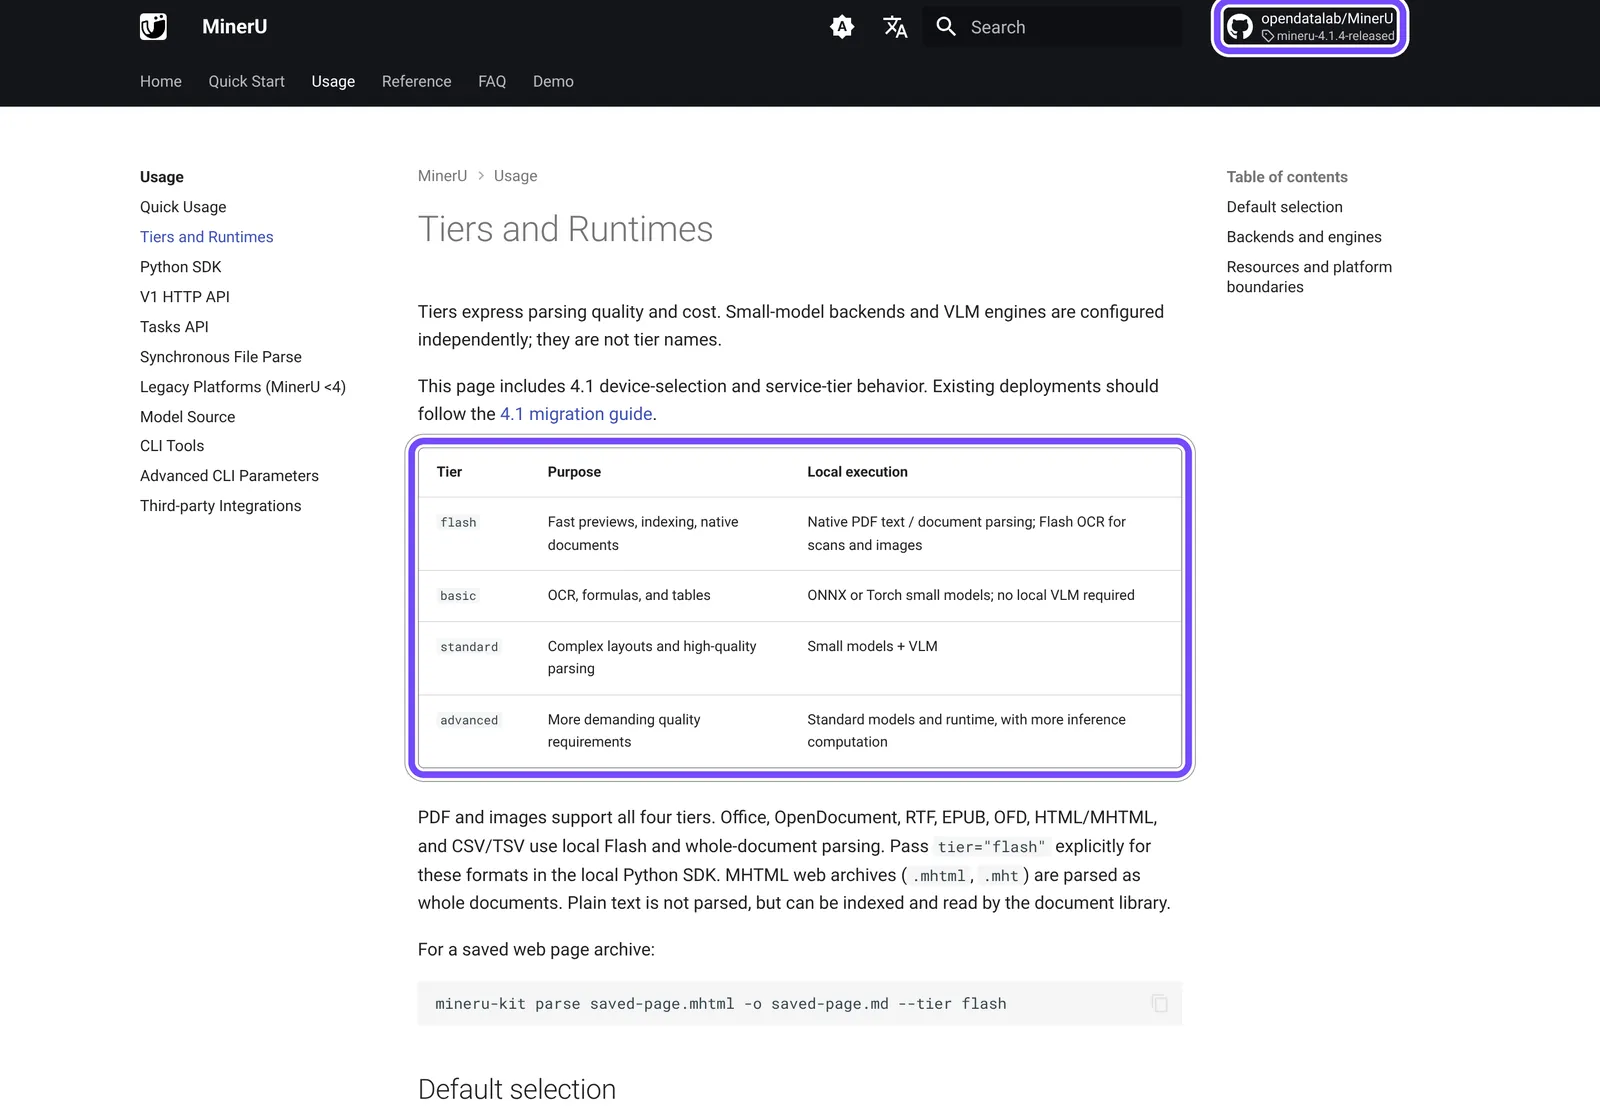
На сторінці документації, знятій 2 листопада 2026 року, рамкою виділено таблицю рівнів, а в шапці — бейдж останнього релізу:
- flash — швидкий перегляд та індексація: текстовий шар цифрових документів, для сканів і зображень — полегшений Flash OCR;
- basic — OCR, формули й таблиці невеликими моделями (ONNX або Torch), без VLM;
- standard — складна верстка: невеликі моделі плюс VLM; цей рівень вмикається за замовчуванням для PDF;
- advanced — ті самі моделі, але більше обчислень на сторінку.
Крім PDF, MinerU приймає зображення, DOCX, PPTX, XLSX, EPUB, HTML і ще десяток форматів. На Mac з Apple Silicon він сам обирає Torch/MPS і llama.cpp/Metal.
Конвертувати PDF у Markdown покроково: MinerU і Docling
Команди нижче взято з офіційної документації обох проєктів на 2 листопада 2026 року. Синтаксис змінюється між версіями: у MinerU стару команду mineru -p input.pdf -o output у гілці 4.x замінено на mineru-kit parse input.pdf -o output.md, а багато інструкцій в інтернеті досі показують стару.
MinerU: встановлення й перша конвертація за п’ять кроків
- Створіть віртуальне середовище. MinerU потребує Python від 3.11 до 3.14 (
>=3.11,<3.15), документація радить починати з 3.12:uv venv --python 3.12 .venv, потімsource .venv/bin/activate(у Windows —.venv\Scripts\Activate.ps1). - Встановіть пакет:
uv pip install -U "mineru>=4.0,<5". Базова збірка вже містить ONNX-моделі та llama.cpp; вебінтерфейс запускається командоюmineru-kit webui. - Перевірте залізо:
mineru-kit hardware detectпідкаже, який рівень потягне ваш комп’ютер. Для продуктивного локального запуску документація радить закладати від 16 ГБ оперативної пам’яті, а 8 ГБ відеопам’яті називає лише відправною точкою для планування, а не гарантією. - Розберіть файл:
mineru-kit parse document.pdf -o document.md --tier standard. Під час першого запуску завантажаться ваги моделей. - Пакетна обробка:
mineru-kit parse ./documents -o ./output --format zip— для теки-oмає вказувати на каталог.
Два застереження. Для цифрового PDF без нейромереж є --tier flash --ocr-mode txt, але такий режим читає лише текстовий шар і не підстрахує OCR-ом відскановані сторінки — для них потрібен --ocr-mode ocr. І не плутайте mineru-kit parse з командою mineru parse: друга працює через бібліотеку документів, за замовчуванням бере лише перші 10 сторінок і збирає телеметрію використання. Вимикається вона командою mineru telemetry disable; вміст файлів, за документацією, до телеметрії не потрапляє.
Docling: як користуватися з командного рядка й Python
Docling запускається однією командою в терміналі або п’ятьма рядками в Python-скрипті.
- Встановлення:
pip install docling. Потрібен Python 3.10 або новіший; підтримуються macOS, Linux і Windows. - Конвертація з термінала:
docling document.pdf— поруч з’явиться.mdіз вмістом документа. - Конвертація PDF у Markdown із Python:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()
result = converter.convert("document.pdf")
print(result.document.export_to_markdown())
- Скани кирилицею: додайте мову OCR, наприклад
docling scan.pdf --ocr-lang iso:uk(докладніше — у розділі про кирилицю нижче). - Складна верстка: VLM-режим вмикається прапорцем
docling --pipeline vlm --vlm-model granite_docling document.pdf.
Корисна й маловідома опція — --replace-broken-text-layer. Бувають PDF, які на екрані мають нормальний вигляд, а під час копіювання дають сміття: шрифт не пов’язує гліфи зі справжніми літерами. Docling знаходить такі сторінки (у документації є приклад із кириличним текстом, що перетворився на Îò÷¸ò) і перечитує їх через OCR. За замовчуванням опцію вимкнено.
Як перевірити результат за п’ять хвилин
Відкрийте .md поруч із PDF і пройдіться коротким списком:
- Таблиці: кількість рядків і стовпців збігається, об’єднані комірки не з’їхали.
- Заголовки: рівні
#,##,###відповідають структурі документа, а не розміру шрифту. - Цифри: суми, дати й дозування збігаються з оригіналом символ у символ.
- Сміття: пошук за символом
�і за колонтитулами, що повторюються на кожній сторінці.
MinerU, Docling, Marker, olmOCR і MarkItDown: 9 критеріїв
Відомості в таблиці — з PyPI, ліцензій і документації проєктів на 2 листопада 2026 року. «н/д» означає, що першоджерело цього не вказує.Критерій MinerU Docling Marker olmOCR 2 MarkItDown Версія 4.1.4 (02.11.2026) 2.145.0 (29.10.2026) 2.1.0 olmOCR 2 (22.10.2025) 0.1.9 Ліцензія коду Apache-2.0 + дод. умови MIT Apache-2.0 Apache-2.0 MIT Обмеження для бізнесу понад 100 млн MAU або понад $20 млн виторгу на місяць — окрема ліцензія; онлайн-сервіс мусить зазначити MinerU немає ваги моделі платні за виторгу чи інвестицій >$5 млн немає немає Python 3.11–3.14 3.10+ 3.10+ і PyTorch н/д н/д Залізо 16 ГБ RAM — орієнтир для продуктивного запуску; basic працює на CPU; Apple Silicon звичайний ПК, PyTorch balanced на GPU, fast на CPU/MPS NVIDIA від 12 ГБ відеопам’яті будь-який ПК Скани й OCR так, від рівня basic так, на вибір EasyOCR, RapidOCR, Tesseract та інші так, через мультимовну VLM surya так, VLM за зображенням сторінки лише плагіном через LLM Таблиці й формули так таблиці — TableFormer так, за тестами olmOCR-bench так, за тестами olmOCR-bench таблиці 0,273 в ODL-бенчмарку Кирилиця моделі PP-OCRv5 для кирилиці мову треба задати: cyrillic, eslav, iso:ukмультимовний OCR surya орієнтований на англійську лише текстовий шар Сильна сторона якість на сканах і формулах швидкість на CPU, ліцензія, інтеграції баланс швидкості та якості на GPU дешевий масовий прогін на власному GPU Word і Excel за секунди
Docling vs MinerU vs Marker: кому що підходить
Різницю між Docling і MinerU найкраще показує єдиний знайдений нами незалежний замір на реальному залізі. Автор корейського практикуму на WikiDocs (5 жовтня 2026 року) прогнав п’ятисторінковий скан на MinerU 4.0.10 і Docling 2.132.0 — на відеокарті RTX 3090 і на процесорі з 4 ядрами та 16 ГБ пам’яті:Налаштування Помилка символів (CER) RTX 3090 CPU, 4 ядра MinerU standard 0,005 67,3 с 1 696 с Docling + EasyOCR 0,070 12,5 с 162,8 с
CER — частка неправильно розпізнаних символів: 0,005 означає одну помилку на 200 знаків, 0,070 — сім на сотню. Час містить завантаження моделей. Висновок практикуму: MinerU точніший, Docling приблизно в 10 разів швидший на процесорі, а без відеокарти MinerU витрачає близько 5 хвилин 40 секунд на сторінку. Текст корейський, але клас завдання — не-латиниця на сканах — той самий, що й у нас.
Звідси практична розвилка:
- Немає відеокарти, документів багато, PDF переважно цифрові — Docling. Ліцензія MIT знімає юридичні питання.
- Є GPU, багато сканів, формул і складних таблиць — MinerU на рівні standard. Перевірте умови ліцензії, якщо у вас великий онлайн-сервіс.
- Потрібен баланс швидкості та якості на GPU — Marker. Для стартапу з виторгом та інвестиціями до $5 млн ваги безкоштовні; великій компанії потрібна ліцензія або хмарний API Datalab.
- Величезний англомовний архів і власна NVIDIA — olmOCR 2.
Спільного переможця серед трьох немає: у кожного своя ніша, і нижче видно, як по-різному їх оцінюють бенчмарки.
Ліцензії парсерів: що дозволено бізнесу і де пастки
Ліцензія — те, на чому найчастіше помиляються чужі огляди. Ось що написано в першоджерелах на 2 листопада 2026 року.Інструмент Ліцензія Що потребує окремої угоди MinerU Apache-2.0 + додаткові умови MAU понад 100 млн або виторг понад $20 млн на місяць; онлайн-сервіс для третіх осіб мусить помітно зазначити, що використовує MinerU Docling MIT нічого Marker код Apache-2.0, ваги — модифікована OpenRAIL-M комерційне використання ваг, якщо виторг за минулий рік або залучене фінансування (інвестиції чи борг) понад $5 млн; особисте й дослідницьке використання вільне PyMuPDF і pymupdf4llm AGPL-3.0 або комерційна ліцензія Artifex закритий продукт чи сервіс, якщо ви не готові відкрити свій код за AGPL olmOCR Apache-2.0 нічого MarkItDown MIT нічого Unstructured (open source) Apache-2.0 нічого; хмарна платформа — окремо LlamaParse комерційний сервіс, не open source усе — це платний API
Пастки, на які варто подивитися до впровадження:
- Застаріле «MinerU — це AGPL». Зміну ліцензії внесли комітом 14 квітня 2026 року, реліз 3.1.0 вийшов 17–18 квітня. Огляд yage.ai від 12 квітня ще писав, що AGPL обмежує комерційне використання, а MinerU не працює на macOS. Сьогодні хибне і те, і те: ліцензію змінили за кілька днів після публікації, а документація 4.1 описує запуск на Apple Silicon. Самі пороги прописано в LICENSE.md репозиторію MinerU.
- AGPL поширюється на мережу. Якщо змінену версію AGPL-коду ви запускаєте як сервіс, вихідний код зміненої версії треба відкрити користувачам. Це стосується PyMuPDF і, відповідно, pymupdf4llm: його код переїхав у пакет
pymupdf2.x. - Код і ваги — різні ліцензії. У Marker відкрито код, але без ваг моделі він не працює, а у ваг свій поріг у $5 млн.
- «Безкоштовно» не означає «без зобов’язань». Навіть за MIT перевірте ліцензії залежностей і моделей, які інструмент завантажує під час першого запуску.
Це переказ умов, а не юридична консультація: для комерційного продукту текст ліцензії варто показати юристові.
Кирилиця й українська: яку мову OCR вказати і як перевірити
За замовчуванням відкриті парсери читають скани не тією моделлю. У документації Docling це записано прямо: якщо мову не задано (lang=[]), EasyOCR бере англійську, а RapidOCR — спрощену китайську. Без прапорця --ocr-lang рушій використовує свої мови за замовчуванням (таблиця в документації Docling). Для цифрових PDF із текстовим шаром це неважливо, для сканів — критично.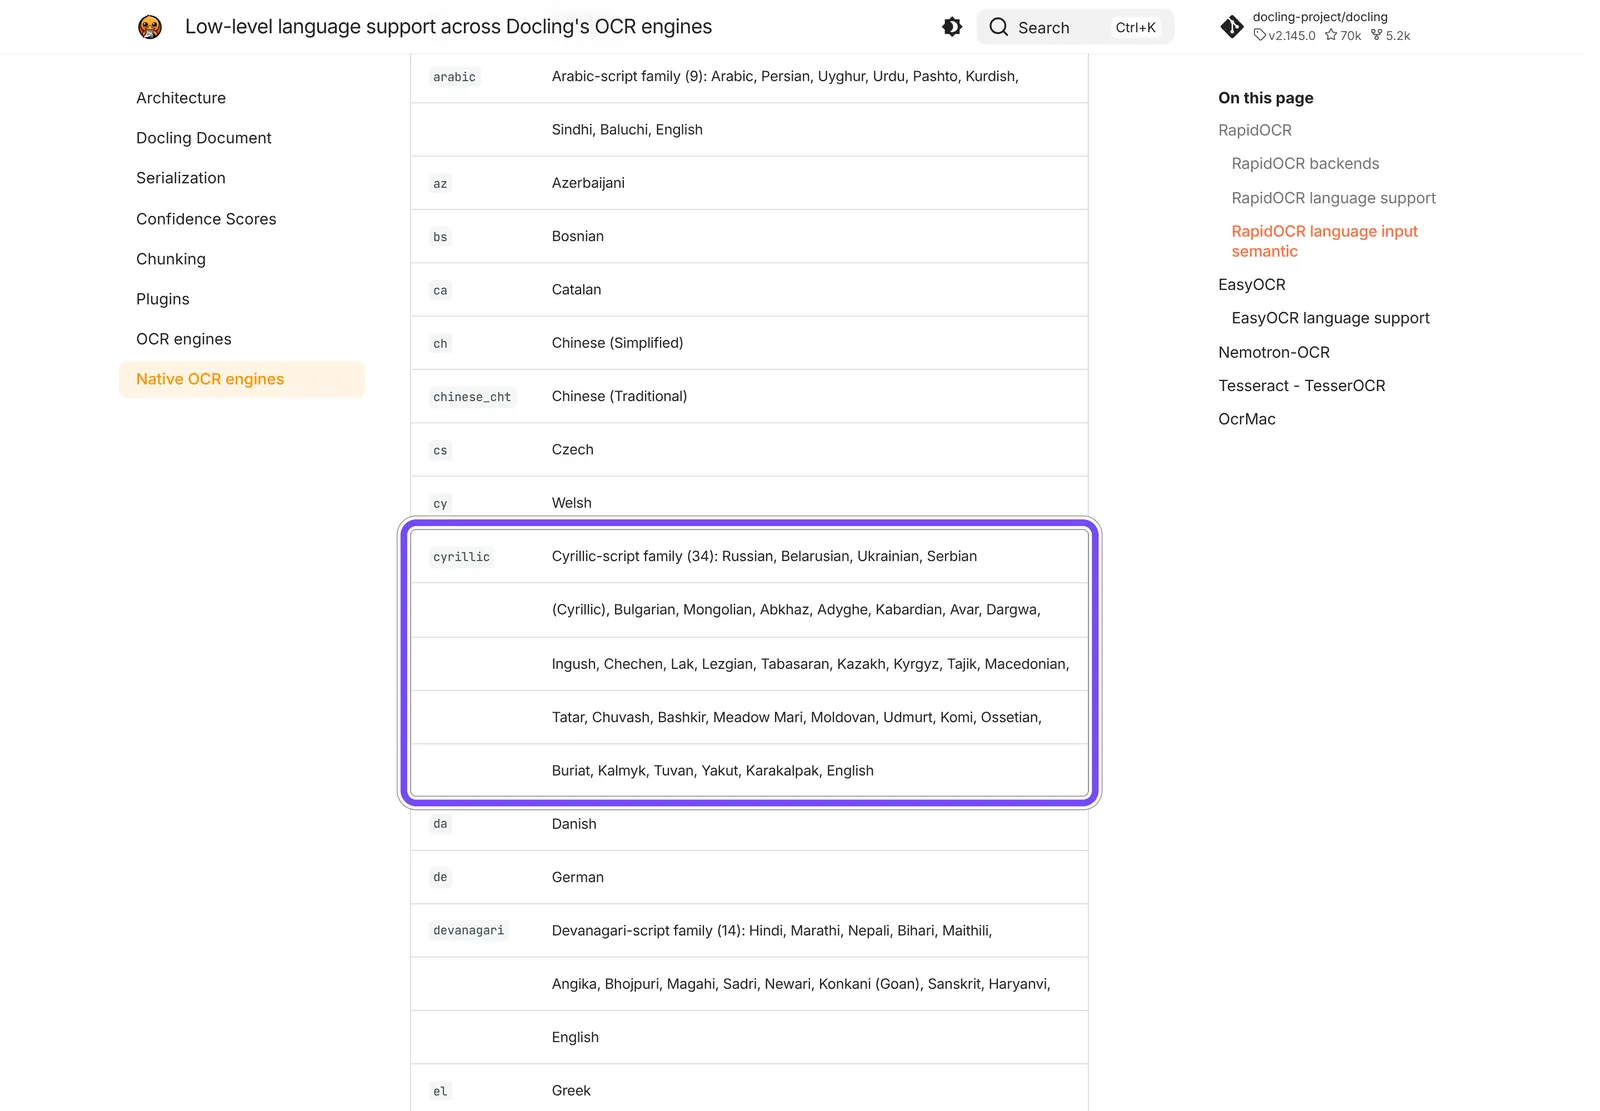
На сторінці Native OCR engines (знято 2 листопада 2026 року) рамкою виділено рядок cyrillic: це родина з 34 мов на кирилиці, серед яких українська. Що з цього випливає для команди:
- Docling + RapidOCR. Коди
iso:uk,iso:ruтаiso:beзводяться до східнослов’янської моделіeslav(PP-OCR v5). RapidOCR читає одну мову за прогін: якщо їх кілька, бере першу, решту відкидає з попередженням. - Запасний варіант. Сторонній довідник docling.org (не офіційна документація) повідомляє, що на PyTorch-бекенді RapidOCR код
iso:ruвидав помилкуOcrLanguageNotSupportedErrorі спрацював лишеcyrillic. Якщо побачите таку помилку, пробуйте--ocr-lang cyrillic. - MinerU. У листопаді 2025 року моделі для кирилиці оновили до PP-OCRv5. У розділі відомих проблем README (редакція гілки 3.0) попереджає, що менш поширеними мовами OCR може плутати символи; у прикладах — латиниця з діакритикою та арабське письмо, кирилицю прямо не названо.
- Marker розпізнає через мультимовну VLM surya, olmOCR 2 AllenAI позиціонує під англомовні документи, Mistral OCR за заявою вендора підтримує 170 мов.
Що відомо про якість на кирилиці
Незалежного тесту парсерів PDF українською ми не знайшли. Єдині «кириличні» цифри — зі статті авторів PaddleOCR-VL (Baidu): на їхньому внутрішньому наборі помилка редагування в MinerU2.5 — 0,832, у PaddleOCR-VL — 0,109 (менше — краще). Це розпізнавання окремих рядків, а не розбір сторінок PDF; MinerU2.5 тут — VLM-модель вересня 2025 року, а не нинішня гілка 4.x; і тест провела зацікавлена сторона.
Корейський практикум дає ще одну підказку: за замовчуванням MinerU basic і Docling використали PP-OCRv6, у якому корейської немає, і обидва провалили скан. Для кирилиці висновок той самий: переконайтеся, що обрана модель узагалі знає вашу абетку.
Третя проблема — гомогліфи, тобто схожі літери з різних абеток. Український розбір webscraft.org наводить приклад «ЗО» замість «30»: OCR підставив кириличну «З» і літеру «О» замість цифр. На око цього не видно, а пошук за числом 30 такого фрагмента не знайде. Тому суми, дати й номери після OCR перевіряйте окремим проходом.
Якщо ваш архів рукописний, зверніть увагу на Rukopys-OCR-4B — українську модель для рукописного тексту на базі Qwen3.5-4B під ліцензією Apache 2.0 (опублікована 25 серпня 2026 року). Для друкованих PDF вона не призначена.
Якому бенчмарку вірити: рейтинги парсерів перевертаються
Майже кожна англомовна добірка «best PDF parser for LLMs» спирається на чийсь бенчмарк. Проблема в тому, що три головні бенчмарки розставляють парсери по-різному, і кожен веде зацікавлена сторона.Бенчмарк Хто веде Що вимірює MinerU Docling Marker Інші OmniDocBench v1.6 (лідерборд на 11.09.2026) OpenDataLab — автори MinerU 1 651 сторінка в базовому наборі, у v1.6 додано ще 296: текст, таблиці, формули 86,47 (Pipeline); 95,75 у VLM MinerU2.5-Pro н/д 78,44 (стара версія 1.8.2) olmOCR 85,74; Mistral OCR 85,66 (версія 2503) olmOCR-bench у прогоні Datalab Datalab — автори Marker 1 403 PDF, близько 8 400 тестів «пройшов/не пройшов», 8 категорій 72,7 (pipeline) 50,3 76,0 (balanced) в AllenAI: Marker 76,1, MinerU 75,8, olmOCR 2 — 82,4 OpenDataLoader bench OpenDataLoader — автори власного парсера 200 PDF: порядок читання, таблиці, заголовки 0,831 0,882 0,861 MarkItDown 0,589; гібридний OpenDataLoader 0,907
Шкали різні: у перших двох — бали зі 100, у третьому — частка від 1. Порівнювати числа між рядками не можна, лише порядок усередині рядка. А порядок перевертається: Docling найкращий із трійки в OpenDataLoader, а в Datalab відстає від MinerU і Marker більш як на 20 балів. У бенчмарку власних авторів MinerU-Pipeline випереджає Marker 1.8.2 на 8 балів, а VLM-модель MinerU2.5-Pro набирає 95,75.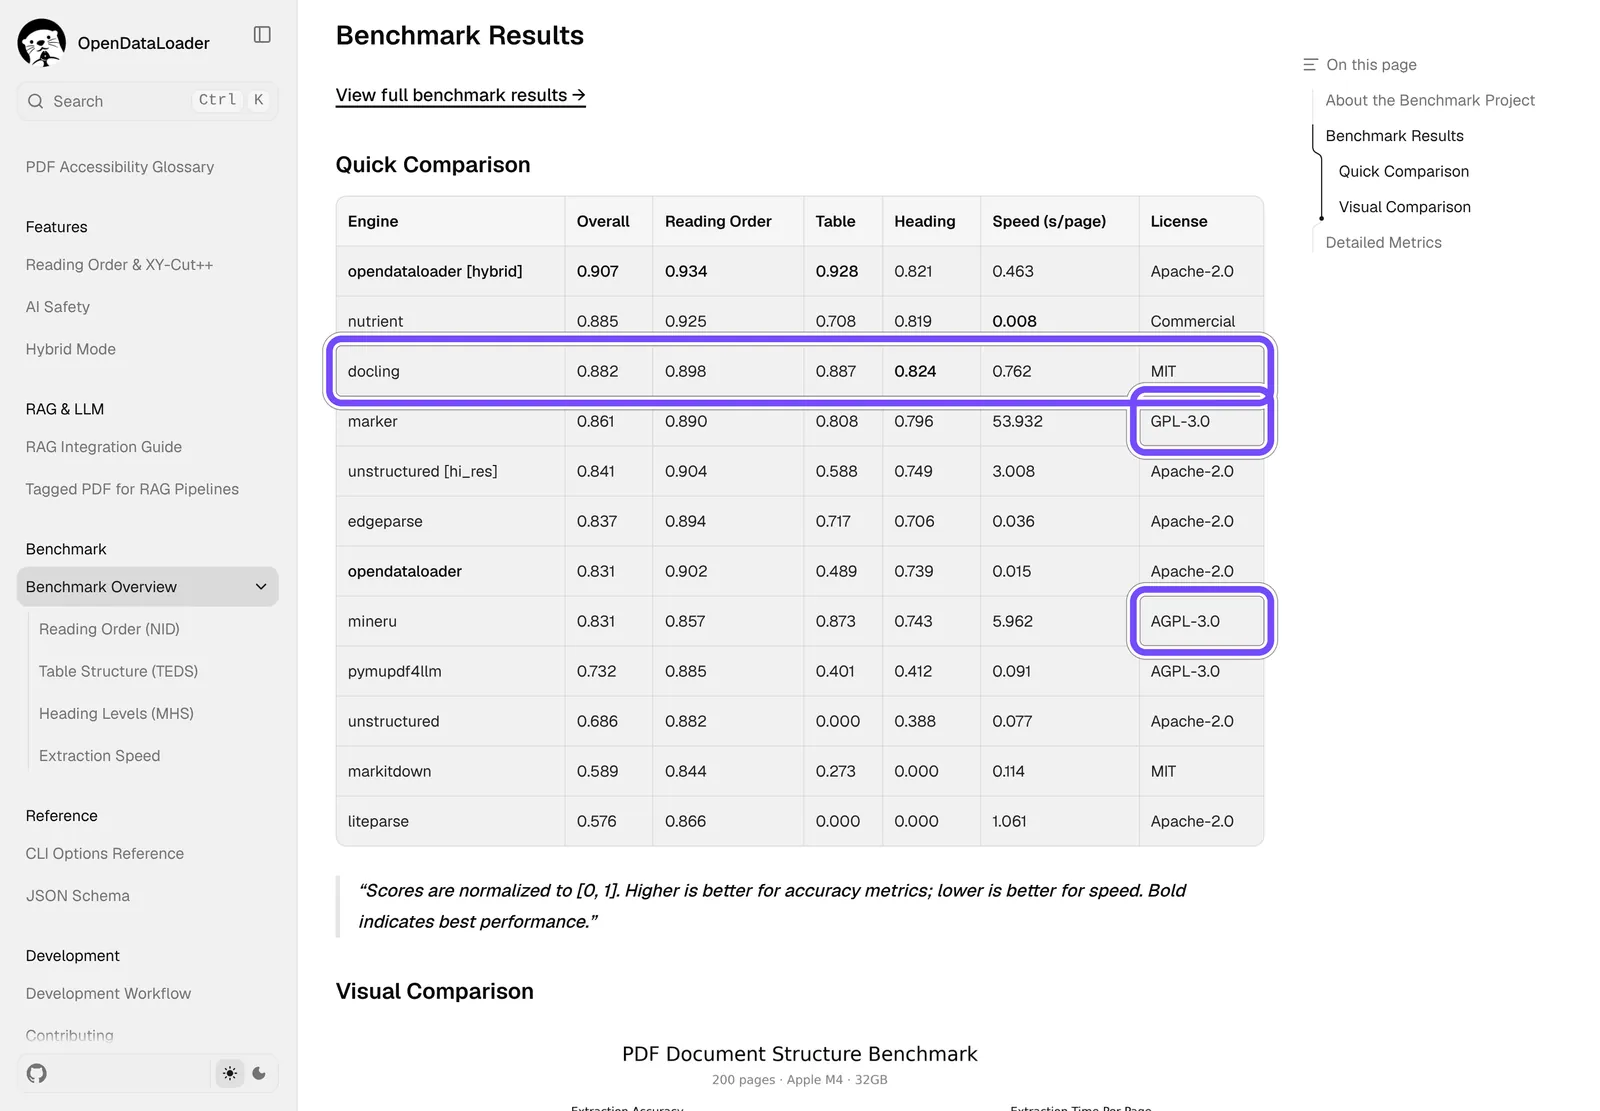
На скриншоті сторінки OpenDataLoader від 2 листопада 2026 року рамкою виділено рядок Docling і дві комірки з ліцензіями: Marker там позначено GPL-3.0, MinerU — AGPL-3.0. Обидві позначки застаріли, і це добрий тест: якщо бенчмарк не оновив ліцензії, ймовірно, він не перевіряв і версії інструментів.
Чому результати розходяться:
- Різні документи. OmniDocBench переважно китайський та англійський, olmOCR-bench — англомовні PDF зі складною математикою і старими сканами.
- Різні метрики. Відстань редагування тексту, збіг структури таблиць (TEDS), юніт-тести на порядок рядків — кожна метрика заохочує своє.
- Різні версії й режими. В OmniDocBench оцінено Marker 1.8.2 і Mistral OCR 2503, а не нинішні версії; Datalab запускав Docling із налаштуваннями за замовчуванням.
- Різне залізо. Datalab вимірював швидкість на сервері з однією B200, OpenDataLoader — на Apple M4.
Самі вендори це визнають. Mistral в анонсі OCR 4 пише, що їхні бенчмарки «орієнтовні», цифри конкурентів — внутрішні відтворення, і радить перевіряти на власних документах. CodeSOTA відкликала власне порівняння швидкості Docling і MinerU: до нього не було ні тестових файлів, ні результатів, ні опису прогону. Тому будь-який «найкращий парсер» без дати, версії й методики — це думка, а не замір.
Хмарний парсер чи власний сервер: ціна 1000 сторінок PDF
Хмарні парсери звільняють від встановлення й відеокарти, але беруть гроші за сторінку й отримують ваші файли. Ціни — за сторінками вендорів на 2 листопада 2026 року (у Mistral — з моменту анонсу OCR 4 23 червня 2026 року); інших джерел, крім самих вендорів, у цих цифр немає.Сервіс Ціна за 1000 сторінок Безкоштовно Архів 5 000 сторінок (наш розрахунок) Mistral OCR 4 $4; через Batch API — $2 н/д $20 або $10 пакетом LlamaParse від $1,25 (Fast) до $56,25 (Agentic Plus) 10 000 кредитів на місяць новим користувачам від $6,25 до $281,25 Datalab (хмарний Marker) lite $0,50; fast/balanced $4; accurate $10 $20 на місяць на робочу пошту, близько 5 000 сторінок $2,50 / $20 / $50 olmOCR на власному GPU менше за $0,20 за оцінкою AllenAI — менше за $1 плюс ваше залізо MinerU або Docling локально $0 за ліцензію — електрика й час
Як рахували. У LlamaParse 1000 кредитів коштують $1,25, а сторінка в режимі Fast — 1 кредит, Cost-effective — 3, Agentic — 10, Agentic Plus — 45. Отже, 5 000 сторінок у Cost-effective — це 15 000 кредитів, або $18,75; в Agentic Plus — 225 000 кредитів, або $281,25. У режимі Fast ті самі 5 000 сторінок укладаються в безкоштовні 10 000 кредитів. Оцінка AllenAI для olmOCR — менше за $200 за мільйон сторінок, тобто менше за $1 за наш архів без урахування вартості відеокарти.
Час локальної обробки прикинемо за відомими замірами. За корейським практикумом Docling з EasyOCR на 4-ядерному CPU витрачав близько 33 секунд на сторінку скану — 5 000 сторінок забирають приблизно 45 годин. MinerU standard на тому самому процесорі (близько 5 хвилин 40 секунд на сторінку) витратив би на архів майже три тижні безперервної роботи. Обидва заміри містять завантаження моделей, тож це верхня оцінка. На серверній B200 за даними Datalab Marker у режимі balanced видає 2,9 сторінки на секунду (архів — близько 29 хвилин), Docling — 2,1, MinerU — 0,54 сторінки на секунду.
Що відбувається з вашими файлами
- LlamaParse за FAQ зберігає файли 48 годин у кеші, щоб не брати гроші двічі за той самий документ, і не використовує їх для навчання моделей.
- Mistral OCR 4 вміщується в один контейнер, а самостійне розгортання пропонують корпоративним клієнтам — документи лишаються у вас.
- MinerU за документацією не завантажує документи в офіційний хмарний сервіс автоматично: віддалений розбір треба явно налаштувати.
- Docling працює повністю локально, зокрема в ізольованих мережах без інтернету. За описом Red Hat, моделі для цього треба заздалегідь завантажити на машині з доступом до мережі, перенести у внутрішню мережу й увімкнути офлайн-режим.
Для договорів, медичних і фінансових документів це часто важливіше за ціну: локальний парсер безкоштовний не лише за грошима, а й за ризиками витоку.
Коли парсер не підходить: CVE, прихований текст, помилки
Парсер — це код, який відкриває чужі файли, і модель, яка інколи помиляється мовчки. Ось ризики, які варто врахувати до запуску в роботу.
- Прихований текст стає інструкцією для моделі. Текст у невидимому режимі відмальовування PDF людина не бачить, а парсер видобуває його як звичайний текст, і той потрапляє в чанки RAG. Такий випадок описано в issue #4377 бібліотеки Unstructured (25 червня 2026 року). Дослідження на конференції ACM AISec виявило, що атаки через документи спрацьовують у 74,4% із 357 сценаріїв на п’яти популярних завантажувачах даних. Механіка та сама, що в інших атак на агентів, які ми розбирали в матеріалі про атаки через MCP-сервери.
- Уразливості в самому парсері. 23 жовтня 2026 року Docling опублікував пачку попереджень безпеки. Одне з них: визначення формату читає файл усередині ZIP-архіву без обмеження розміру, і маленький архів може вичерпати пам’ять. Ще раніше, 5 жовтня, вийшла CVE-2026-105751: спеціально зібраний
.odtзмушував Docling відкрити файл за шляхом, заданим атакувальником. Оновлюйтеся й розбирайте чужі документи в ізольованому середовищі. - Тихе псування даних. Стаття на воркшопі DocInsights 2026 (один автор, 6 парсерів) показала: якщо число в документі спотворилося під час розбору, а текст однаково повернувся, у 96,5% випадків модель відповідає впевнено хибним значенням, а не «не знаю».
- VLM може вигадати таблицю. В issue #90 проєкту socr (обгортка над Qwen3-VL, 22 червня 2026 року) описано, як модель на складних сканах генерує правдоподібні таблиці, яких у документі немає, і звітує статусом «успішно». Це не MinerU і не Docling, але той самий клас інструментів.
- Телеметрія й кеш. Бібліотека документів MinerU за замовчуванням збирає дані про використання, хмарні сервіси тримають файли в кеші — перевірте налаштування до завантаження конфіденційного архіву.
Коли парсер узагалі не потрібен, розібрано на початку статті; додамо лише рукописи — для них потрібна спеціалізована модель.
Що застаріє першим: версії й команди (MinerU змінив синтаксис між 3.x і 4.x, свіжий реліз вийшов у день написання статті), ціни хмарних сервісів і лідерборди бенчмарків. Актуальне дивіться на PyPI, у файлах LICENSE репозиторіїв і на сторінках тарифів.
Перевірте парсер на своїх PDF за годину: мінібенчмарк на 10 сторінок
Лідерборд відповідає на запитання «який парсер кращий на чужих документах». Вам потрібна відповідь на ваших. Ось методика на годину роботи.
- Зберіть 10 сторінок зі свого архіву: дві звичайні текстові, дві у дві колонки, дві з таблицями (одна — з об’єднаними комірками), одну з формулами чи схемами, дві відскановані (хоча б одну — українською) і одну з колонтитулами та виносками.
- Проженіть їх через два-три парсери з однаковими налаштуваннями мови: наприклад, Docling на CPU і MinerU на рівні standard. Можна додати хмарний сервіс у межах безкоштовного ліміту.
- Оцініть чотири речі за шкалою 0–2: порядок читання, таблиці, заголовки й цифри. Цифри звіряйте символ у символ.
- Запишіть час на сторінку і залізо, на якому запускали.
- Порахуйте суму балів і помножте час на обсяг архіву. Переможець — той, хто дав прийнятну якість за прийнятний час, а не той, хто перший у чужому рейтингу.
Зведену таблицю зручно вести просто в Markdown: сторінка × парсер × чотири оцінки × секунди. За місяць, коли вийдуть нові версії, той самий набір сторінок покаже, чи варто оновлюватися.
Де ці парсери вже працюють
- RAGFlow — відкритий рушій для RAG — у версії 0.22.0 додав MinerU 2.6.3 як ще один варіант розбору PDF, а поруч — Docling. RAGFlow запускає парсер, читає його результат і додає до бази знань.
- Red Hat описує Docling як доповнення до платформи Red Hat AI і наводить приклад державних установ, яким не можна надсилати документи в публічні хмарні сервіси.
- Сам Docling розвивається під крилом LF AI & Data — це зменшує ризик, що проєкт закриють або змінять ліцензію одним рішенням компанії.
Часті запитання
Чим MinerU відрізняється від Docling і Marker?
MinerU робить ставку на якість складних сторінок і сканів: чотири рівні розбору, VLM на рівні standard, сильні результати на формулах. Docling легший, швидший на процесорі й поширюється під MIT. Marker тримає баланс швидкості та якості на відеокарті, але ваги його моделі платні для компаній із виторгом або інвестиціями понад $5 млн.
Чи можна використовувати MinerU в комерційному проєкті після зміни ліцензії?
Так, із квітня 2026 року MinerU поширюється під Apache-2.0 з додатковими умовами. Окрема ліцензія потрібна, якщо в продукту понад 100 млн активних користувачів на місяць або виторг понад $20 млн на місяць. Онлайн-сервіс для третіх осіб мусить помітно зазначити, що використовує MinerU, в інтерфейсі чи публічній документації.
Який парсер краще читає українські скани?
Незалежного порівняння українською ми не знайшли, тож відповідь дасть лише тест на ваших файлах. Обов’язкова умова — явно задати мову OCR: у Docling це iso:uk, eslav або cyrillic, інакше скан прочитає англійська чи китайська модель. Після OCR окремо перевіряйте цифри: кирилична «З» легко підміняє трійку.
Чи потрібна відеокарта, щоб запустити MinerU або Docling?
Ні, обидва працюють на процесорі. Docling розрахований на звичайний комп’ютер, а MinerU на рівні basic обходиться без VLM. Але зі сканами різниця велика: у незалежному замірі MinerU standard на 4-ядерному CPU витрачав близько 5 хвилин 40 секунд на сторінку, а Docling з EasyOCR — близько 33 секунд. Для продуктивного запуску MinerU документація радить закладати від 16 ГБ RAM.
Навіщо конвертувати PDF у Markdown, якщо Claude читає PDF сам?
Для разових запитань конвертувати не треба. Але Claude під час кожного запиту обробляє сторінку як текст і зображення — зазвичай 1 500–3 000 токенів тексту плюс зображення, і платите ви щоразу. Markdown отримують один раз, далі він дешевий, ріжеться на чанки для RAG і не впирається в ліміт 600 сторінок на запит.
Чи безпечно завантажувати конфіденційні PDF у хмарні парсери?
Лише якщо вас влаштовують умови сервісу: документ у будь-якому разі залишає вашу інфраструктуру. LlamaParse, наприклад, тримає файли в кеші 48 годин і обіцяє не навчати на них моделі. Для договорів, медичних і фінансових даних надійніший локальний MinerU чи Docling або Mistral OCR, розгорнутий у власній мережі: таке розгортання Mistral пропонує корпоративним клієнтам.