
Коротко (TL;DR)
Qwen 3.8 27B для кодингу локально — робочий варіант, але тільки якщо запускати модель як агента, а не як чат із налаштуваннями за замовчуванням. Гілку на r/LocalLLM «Local Qwen 27B is practically unusable for coding» (за даними нашого моніторингу обговорень, понад 900 коментарів) майже повністю пояснюють дефолти: крихітний контекст, максимальна глибина міркувань, стара збірка llama.cpp, не той парсер викликів інструментів.
- Коротко (TL;DR)
- Qwen 3.8 27B для кодингу локально: що вміє і де ламається
- Чому Qwen 27B «непридатна для коду»: сім причин і виправлення
- Параметри генерації Qwen 3.8 27B для кодингу: температура і effort
- Контекст для кодингу: скільки потрібно і скільки він важить у пам’яті
- Квант під код: чи вистачає Q4_K_M і коли брати Q5–Q6
- Рушій і виклик інструментів: llama-server, vLLM, Ollama, LM Studio
- Агентна обв’язка: Claude Code, OpenCode, Cline, Aider, Continue
- Бенчмарки Qwen 3.8 27B для коду: 90,3 і 66,8 — це різні числа
- Що Qwen 27B робить добре, а що ні: задачі, репозиторії, ланцюжки
- Локально чи Claude: скільки коштує задача кодингу
- Ризики локального агента: пісочниця, чужі шаблони, зациклення
- Часті запитання
- Сім причин, чому модель «не кодить», і виправлення до кожної — у таблиці нижче: від контексту 4k в Ollama до заголовка Claude Code, який сповільнює локальне виведення приблизно на 90%.
- Офіційні параметри для 3.8 — температура 1.0 в режимі міркувань, а не 0,6 з гайдів для Qwen3.5/3.6. Для агента розумно починати з
reasoning_effort: medium. - Квант: 4-бітний Q4_K_M у незалежному замірі Quesma не відстав від повної моделі на агентному Terminal-Bench 2.1; 2 біти помітно гірші, 1 біт непридатний.
- Очікування: 90,3 на LiveCodeBench v6 — дані Qwen по всьому набору. На 100 свіжих складних задачах один виклик дає 66,8%, а 92,4% і «п’ять копій перемагають Fable 5» отримано оркестрацією на серверному FP8, а не на домашньому Q4.
- Чого ніхто не вимірював: поведінку 27B у великому репозиторії та довгих агентних ланцюжках — даних немає.
Qwen 3.8 27B для кодингу локально: що вміє і де ламається
Qwen3.8-27B — відкрита щільна модель Alibaba на 27 млрд параметрів із ліцензією Apache 2.0 і нативним контекстом 262 144 токени (картка моделі на Hugging Face). Що це за модель, скільки вона важить і як поводиться в чаті, ми розібрали в огляді Qwen 3.8 27B. Тут — лише програмування: що налаштувати, щоб вона писала код, і де її стеля.
Вердикт за тим, що підтверджено вимірюваннями та першоджерелами на 4 листопада 2026 року:
- Справляється: правка окремого файлу, генерація функцій і тестів, рефакторинг у межах контексту, алгоритмічні задачі. Незалежний замір Quesma відтворив заявлений Qwen результат на Terminal-Bench 2.1 — 89 агентних завдань у терміналі.
- Справляється краще в обв’язці: схема «план → одне завдання → перевірка тестами → нотатки на диск» підняла 27B з 66,8% до 92,4% на складних задачах LiveCodeBench. Приріст дала організація роботи, а не модель.
- Ламається на дефолтах: без налаштування контексту, глибини міркувань і парсера викликів агент «забуває» файл, думає по 20 хвилин і пише виклики інструментів текстом у чат.
- Не перевірено: великий репозиторій, що не вміщується в контекст, і багатогодинні агентні ланцюжки. Автори найсильнішого заміру прямо пишуть, що такий сценарій не тестували.
Простими словами: агент для коду — це програма-обв’язка (Claude Code, OpenCode, Cline), яка сама читає файли, запускає команди й передає моделі результат. Модель у ній — «мозок», а обв’язка — «руки» та пам’ять. Багато скарг на Qwen 27B насправді — скарги на руки.
Чому Qwen 27B «непридатна для коду»: сім причин і виправлення
Причини нижче взято не з коментарів гілки, а з документації рушіїв і замірів — кожну підтверджує першоджерело.Симптом Причина Виправлення Агент «забуває» початок файлу, не викликає інструменти, обриває відповідь Контекст за замовчуванням: Ollama дає 4k токенів на картах менше 24 ГіБ і 32k на 24–48 ГіБ, LM Studio — 8 192 Підняти до 64k і вище: OLLAMA_CONTEXT_LENGTH=64000, num_ctx або повзунок у LM StudioМодель думає до 20 хвилин, міркування з’їдають увесь контекст reasoning_effort за замовчуванням — xhigh, максимальна глибинаДля агента почати з medium, обмежити бюджет --reasoning-budgetНа відеокарті NVIDIA виведення — беззв’язне сміття, помилок у логах немає Збірка llama.cpp, старша за 16 серпня 2026 року, не підтримує шари DeltaNet цієї моделі Оновити llama.cpp або Ollama/LM Studio, які її вбудовують Виклик інструмента приходить звичайним текстом, агент «пише команду в чат» Не той парсер викликів: у vLLM за замовчуванням hermes, у llama.cpp потрібен шаблон jinjavLLM: --tool-call-parser qwen3_coder (запасний — qwen3_xml); llama-server: --jinjaClaude Code на локальній моделі в рази повільніший за чат Змінний заголовок атрибуції скидає кеш префікса на кожному запиті CLAUDE_CODE_ATTRIBUTION_HEADER: "0" у ~/.claude/settings.jsonПомилки в синтаксисі, «тупішає» під кінець сесії Надто стиснуті ваги (2 біти й нижче) або KV-кеш у q4_0Ваги від Q4_K_M, KV-кеш у q8_0 або f16Велике завдання одним запитом не розв’язує, іде в нескінченні міркування Модель працює «монолітом»: без плану, тестів і запису проміжних підсумків Обв’язка з планом, перевіркою тестами й нотатками на диск
Два рядки таблиці стоять окремо. Перший і другий підсилюють один одного: модель на xhigh пише довгі міркування, а за контексту 4–8 тис. токенів вони витісняють із пам’яті сам код. Саймон Віллісон у серпні описав саме це: у LM Studio ліміт 8 192 токени модель витрачала на роздуми навіть над простими задачами.
Останній рядок — не про налаштування, а про очікування. Одиночний виклик 27B у тесті GVS5H у 8 випадках із 500 вичерпав бюджет у 250 тис. токенів міркувань і не видав жодного рядка коду, а загалом порожніх відповідей без коду набралося 35. Обв’язка з менеджером розв’язала 28 із них і не залишила жодної порожньої.
Параметри генерації Qwen 3.8 27B для кодингу: температура і effort
Семплінг — це правила, за якими модель обирає наступне слово: температура задає «сміливість» вибору, top_p і top_k відсікають малоймовірні варіанти, presence_penalty штрафує за повтори. Для Qwen 3.8 значення офіційні, їх публікує сама Qwen у розділі Best Practices картки моделі.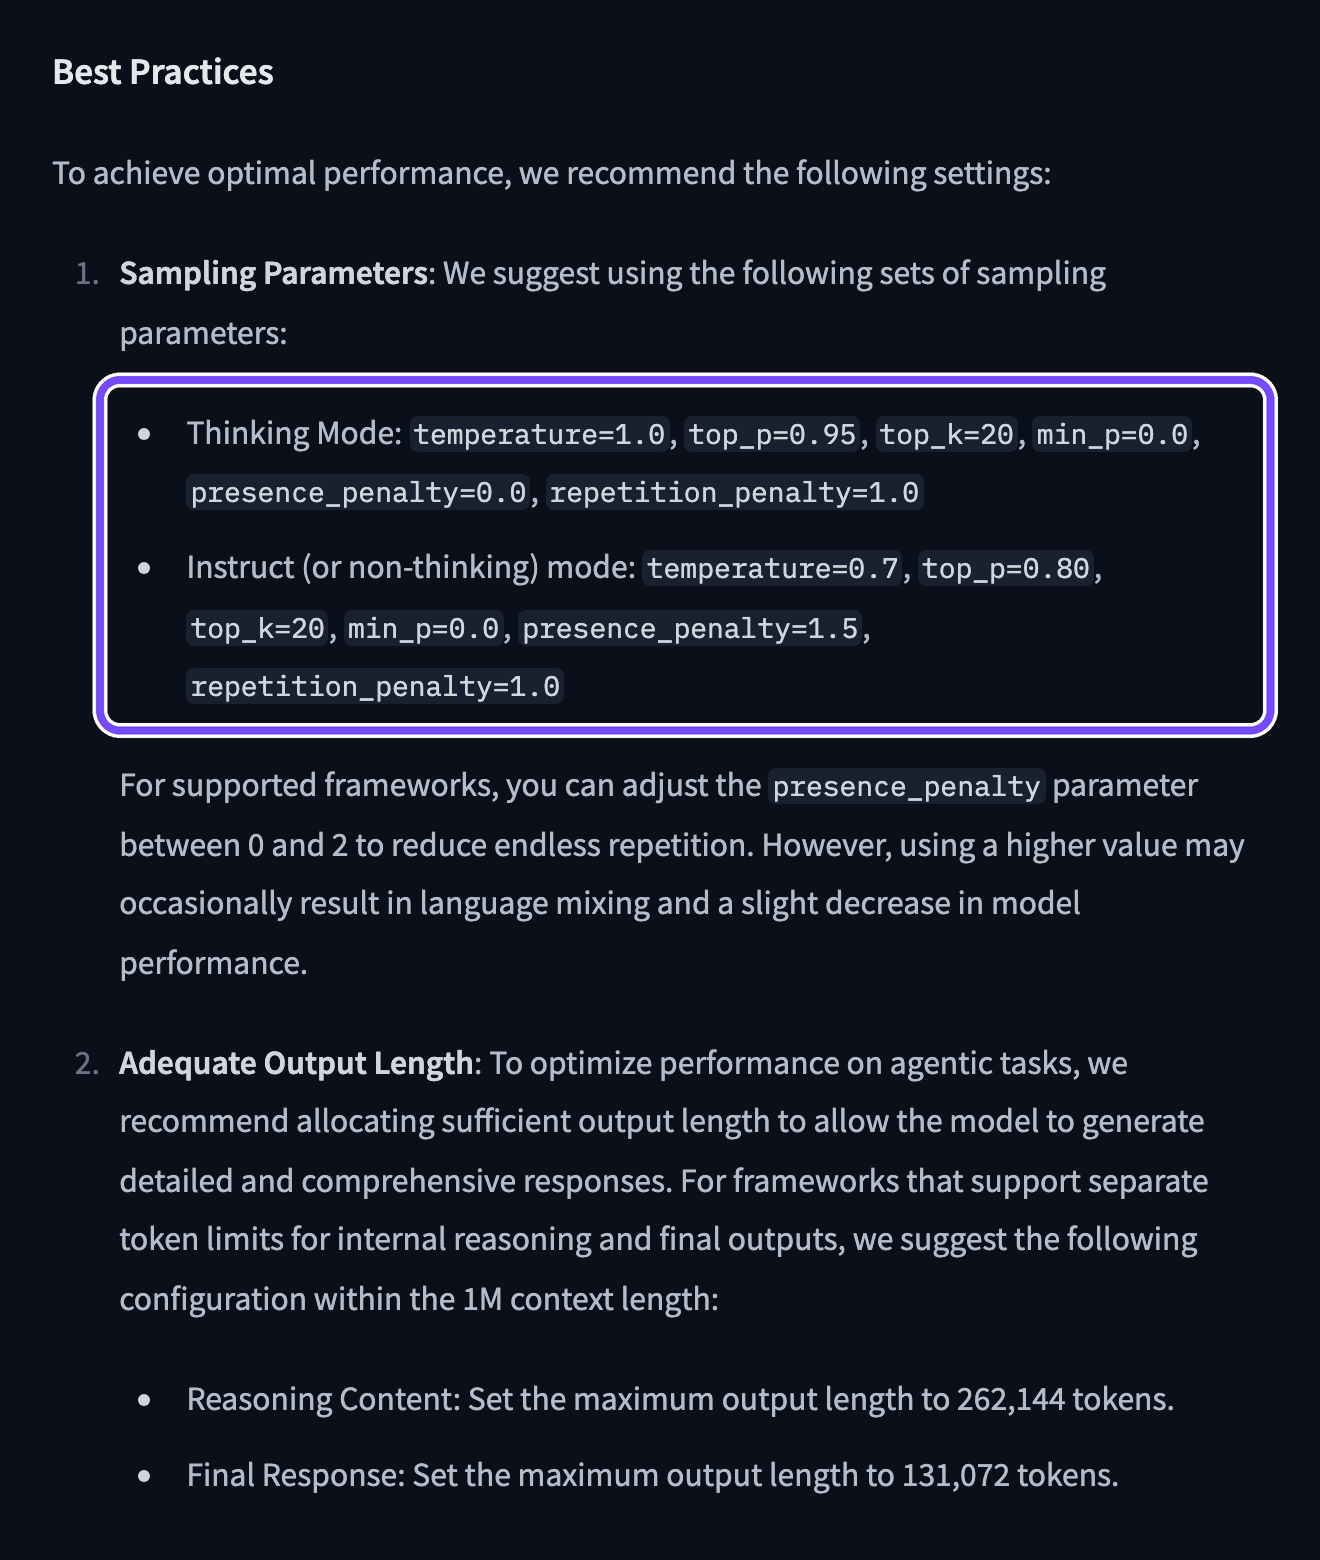
На скриншоті картки (знято 4 листопада 2026 року) рамка виділяє два набори параметрів. Їх і переносимо в таблицю:Параметр Режим міркувань (thinking, за замовчуванням) Режим без міркувань (instruct) temperature1.0 0.7 top_p0.95 0.80 top_k20 20 min_p0.0 0.0 presence_penalty0.0 1.5 repetition_penalty1.0 1.0
Готові «coding settings» для Qwen 3.8 27B з англомовних форумів і старих гайдів часто списано з попередніх поколінь: для Qwen3.5/3.6 під код радили температуру 0,6, і ця порада досі кочує інструкціями для Claude Code. Для 3.8 вона застаріла — у картці для режиму міркувань стоїть 1.0. Щодо presence_penalty сама Qwen попереджає: високе значення іноді спричиняє змішування мов і легку втрату якості, тому в режимі міркувань він дорівнює 0.
Глибина міркувань: xhigh, medium чи low
Qwen 3.8 має три рівні reasoning_effort: xhigh (за замовчуванням, для складного аналізу), medium (баланс) і low (швидкість). Дефолт xhigh — головна причина того, що «модель думає вічно»: Віллісон на ньому чекав SVG-картинку 21 хвилину і витратив 22 276 токенів міркувань, а без міркувань схожий результат вийшов за 137 секунд. Це один запуск, а не статистика, але порядок різниці показовий.



Знижувати одразу до low не варто. Qwen у картці окремо пише, що в багатоходових агентних завданнях низький рівень не завжди скорочує загальний час: модель частіше помиляється й переробляє. Робоча схема для агента — почати з medium, а xhigh вмикати для важких алгоритмічних задач. У llama-server і unsloth run рівень змінюють прапорцем --chat-template-kwargs '{"reasoning_effort":"medium"}'.
Ще два параметри з картки:
preserve_thinkingувімкнено за замовчуванням: міркування попередніх ходів лишаються в історії. Точність у довгому діалозі може зрости, але контекст витрачається швидше. За тісного контексту його вимикають черезchat_template_kwargs.- Довжина виведення. Для агентних завдань Qwen радить не шкодувати ліміту — до 262 144 токенів на міркування і 131 072 на фінальну відповідь, якщо рушій розділяє ці ліміти.
Контекст для кодингу: скільки потрібно і скільки він важить у пам’яті
Контекст — це робоча пам’ять моделі: усе, що вона «бачить» за раз, зокрема системний промпт агента, відкриті файли, виведення команд і власні міркування. Документація Ollama прямо каже: агентам та інструментам для коду потрібно щонайменше 64 000 токенів. OpenCode, коли виклики інструментів не працюють, радить почати з num_ctx 16–32 тис. — це стартова точка, а не робоча норма агента.
Пам’ять під контекст рахувати просто, якщо знати будову моделі. У Qwen3.8-27B із 64 шарів лише 16 використовують повну увагу й зберігають KV-кеш — «конспект» уже прочитаного тексту; решта 48 шарів лінійні (Gated DeltaNet) і тримають стан фіксованого розміру. Наш розрахунок за конфігурацією з картки: 16 шарів × 2 (K і V) × 4 KV-голови × 256 розмірність × 2 байти = 65 536 байт, тобто 64 КіБ на токен у форматі F16.Контекст KV-кеш F16 (розрахунок) KV-кеш q8_0 (розрахунок) Для чого вистачить 8 192 (дефолт LM Studio) 0,5 ГіБ 0,25 ГіБ Чат, коротке запитання щодо коду 32 768 2,0 ГіБ 1,0 ГіБ Один файл без агента 65 536 (мінімум Ollama для коду) 4,0 ГіБ 2,0 ГіБ Агент на невеликому завданні 131 072 8,0 ГіБ 4,0 ГіБ Агент із кількома файлами й тестами 262 144 (нативний максимум) 16,0 ГіБ 8,0 ГіБ Довга сесія, великий модуль
Незалежний замір Quesma дав близько 2,3 ГБ на 32 тис. токенів у F16 — трохи більше за наш розрахунок. Різницю дають стан лінійних шарів і службові буфери, тож до таблиці варто додавати запас.
Що з цього випливає на практиці. Ваги Q4_K_M займають 15–19 ГБ залежно від публікатора й версії файлу, плюс 4 ГіБ на 64k контексту в F16. На карті з 24 ГБ це вміщується, на 16 ГБ — уже ні без компромісів. Докладні таблиці під 12, 16 і 24 ГБ — у нашому розборі скільки відеопам’яті потрібно Qwen 3.8 27B, тут їх не повторюємо.
Стискати KV-кеш можна, але обережно. Документація llama.cpp попереджає: екстремальне стиснення на кшталт q4_0 може помітно зіпсувати виклик інструментів. Ентузіаст arczhi на RTX 5060 Ti 16 ГБ отримав робочого агента з KV-кешем q4_0, квантом UD-IQ4_XS і 80 тис. контексту за 11–13 токенів на секунду — але на одному своєму завданні, а найкращі результати дали вже його власні доопрацьовані збірки llama.cpp. Безпечна відправна точка — q8_0, а q4_0 — свідомий компроміс із перевіркою на своїх завданнях.
Квант під код: чи вистачає Q4_K_M і коли брати Q5–Q6
Квант — стиснена версія ваг: замість 16 біт на параметр зберігається 4–8, файл стає у 2–4 рази меншим, а якість трохи падає. Питання «що втрачається на коді» найкраще закриває замір Quesma від 26 серпня 2026 року: 4-бітний Q4_K_M на 17 ГБ не відрізняється від повної BF16 на Terminal-Bench 2.1. Той самий автор відтворив заявлений Qwen результат повної моделі, тож еталон для порівняння перевірено.Квант Розмір Відхилення від BF16 (KLD) Що відомо про код 1 біт 7–8 ГБ пам’яті н/д Близько випадкового рівня, виклики інструментів не працюють UD-Q2_K_XL (2 біти) 9–11 ГБ пам’яті н/д Quesma: результати трохи просідають; BestHub: годиться для чату Q4_K_M / UD-Q4_K_XL 15–19 ГБ ≈0,008 Не відрізняється від BF16 на Terminal-Bench 2.1 (Quesma) UD-Q6_K ≈22 ГБ ≈0,0024 Практики на HN вважають порогом «корисно для коду» Q8_0 ≈29 ГБ ≈0,001 Різниця з Q6 майже непомітна, пам’яті йде помітно більше NVFP4 (лише Blackwell, vLLM) н/д 0,026 на корпусі коду Найімовірніший токен збігається з BF16 у 96,68% випадків (дані Unsloth)
KLD — розбіжність Кульбака — Лейблера: наскільки розподіл імовірностей кванта відрізняється від повної моделі (0 — ідентично). Розміри — за таблицею пам’яті Unsloth і BestHub (файли Unsloth Dynamic 3.0), KLD — BestHub, дані NVFP4 — з документації Unsloth.
Тепер заперечення. Коментатор у гілці Memdoor на Hacker News пише, що навіть 4-бітні кванти Qwen3.8 27B для коду «так собі», а користь він бачить лише з Q5–Q6. Його підтримує інший практик: на «насичених» бенчмарках, де задачі давно розв’язано, різниці між квантами не видно, а в реальній роботі Q6 і 3-бітний квант відрізняються дуже сильно. Це думки, а не заміри, але аргумент слушний.
Є й технічне застереження: Quesma тестував файли Unsloth версії 2 з KV-кешем у F16, а 19 серпня Unsloth замінив їх на Dynamic 3.0 із заявленим приростом точності близько 10%. Саме тих файлів, що були в замірі, більше немає.
Практичний висновок: Q4_K_M або UD-Q4_K_XL — розумний старт для коду на 24 ГБ. Якщо пам’ять дозволяє Q5–Q6 без урізання контексту нижче 64k — беріть їх. Якщо вибір між Q6 із контекстом 16k і Q4 із 64k — для агента важливіший контекст.
Рушій і виклик інструментів: llama-server, vLLM, Ollama, LM Studio
Рушій — програма, яка завантажує ваги й віддає модель через API. Для агентного кодингу на Qwen 3.8 27B головне в рушії не швидкість, а коректний виклик інструментів: модель має повернути структурований запит «прочитай файл X», а не описати його словами. Різницю рушіїв на одній моделі ми розібрали в порівнянні Ollama, LM Studio і llama.cpp.Рушій Що ввімкнути для виклику інструментів Контекст Пастка llama-server (llama.cpp) --jinja, --reasoning-format deepseek--ctx-sizeЗбірки до 16.08.2026 дають сміття на CUDA vLLM --enable-auto-tool-choice --tool-call-parser qwen3_coder --reasoning-parser qwen3--max-model-lenПарсер hermes за замовчуванням дає виклики текстомOllama Працює одразу, агенти — ollama launchOLLAMA_CONTEXT_LENGTH, num_ctx4k контексту на картах менше 24 ГіБ LM Studio Шаблон вбудований, сервер OpenAI-сумісний Повзунок під час завантаження моделі 8 192 токени за замовчуванням (спостереження Віллісона, серпень 2026)
llama-server: команда для агента на 24 ГБ
Свіжа збірка llama.cpp (від 16 серпня 2026 року й новіша), ваги Unsloth, 64k контексту, KV-кеш у q8_0, рекомендований семплінг і medium:
./llama.cpp/llama-server \
  --model Qwen3.8-27B-UD-Q4_K_XL.gguf \
  --alias qwen3.8-27b \
  --ctx-size 65536 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --n-gpu-layers all \
  --jinja \
  --reasoning-format deepseek \
  --chat-template-kwargs '{"reasoning_effort":"medium"}' \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --port 8080
Прапорець --jinja у свіжих збірках увімкнено за замовчуванням, але сторінка llama.cpp про виклик функцій досі вимагає його явно — зайвим не буде. --reasoning-format deepseek виносить міркування в окреме поле reasoning_content: за досвідом спільноти (автор виправлених шаблонів froggeric) так «думки» не протікають у текст відповіді й не обривають виклик інструмента посередині.
vLLM: парсер із рецепта і запасний
Офіційний рецепт vLLM для Qwen3.8-27B використовує парсер qwen3_coder (vLLM 0.17.0 і новіші). Спільнота — BestHub і froggeric — на свіжих версіях vLLM радить qwen3_xml. Практичне правило: почніть із парсера з рецепта, а якщо виклики приходять текстом — перемкніться на qwen3_xml.
vllm serve Qwen/Qwen3.8-27B \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder \
  --reasoning-parser qwen3
vLLM розрахований на серверні карти: повна модель у BF16 потребує десятків гігабайтів. На одній RTX 5090 рецепт запускає 4-бітний NVFP4 лише з прапорцем --enforce-eager і контекстом 32k.
Ollama і LM Studio: де задати контекст
В Ollama контекст задають змінною під час запуску сервера (OLLAMA_CONTEXT_LENGTH=64000 ollama serve) або параметром num_ctx у запиті; перевірити, скільки реально виділено, можна командою ollama ps (колонка CONTEXT). У LM Studio довжину контексту виставляють повзунком під час завантаження моделі, і вона зберігається в налаштуваннях моделі за замовчуванням.
Агентна обв’язка: Claude Code, OpenCode, Cline, Aider, Continue
Агент для кодингу на Qwen 3.8 27B підключається до локального сервера як до будь-якого OpenAI-сумісного або Anthropic-сумісного API. Різниця — у тому, що кожна обв’язка ламає або що в ній треба налаштувати.Обв’язка Як підключити Що врахувати Claude Code ollama launch claude --model qwen3.8 або ANTHROPIC_BASE_URL на llama-server (/v1/messages)Anthropic не підтримує не-Claude моделі; заголовок атрибуції — вимкнути OpenCode ollama launch opencode --model qwen3.8 або провайдер @ai-sdk/openai-compatibleУ limit.context вказати реальний контекст сервераCline / Roo Провайдер Ollama або LM Studio в налаштуваннях Cline для локальних моделей рекомендує ввімкнути Use Compact Prompt Aider aider --model openai/<назва> + OPENAI_API_BASEПараметри семплінгу передаються через extra_params у налаштуваннях моделіContinue Провайдер Ollama або llama.cpp у конфігурації Документація Continue попереджає: його contextLength за замовчуванням буває більшим, ніж у сервера, — виставте вручнуQwen Code modelProviders у settings.json, тип openai з локальним baseUrlРідна обв’язка Qwen, але безкоштовний тариф Qwen OAuth закрито з 15.04.2026
Qwen 3.8 27B у Claude Code: працює, але без підтримки Anthropic
Найчастіше запитання — чи можна запустити Claude Code на Qwen 3.8 27B. Технічно так: llama-server віддає Anthropic-сумісний метод /v1/messages, а Ollama документує запуск однією командою ollama launch claude. Офіційна позиція Anthropic при цьому однозначна.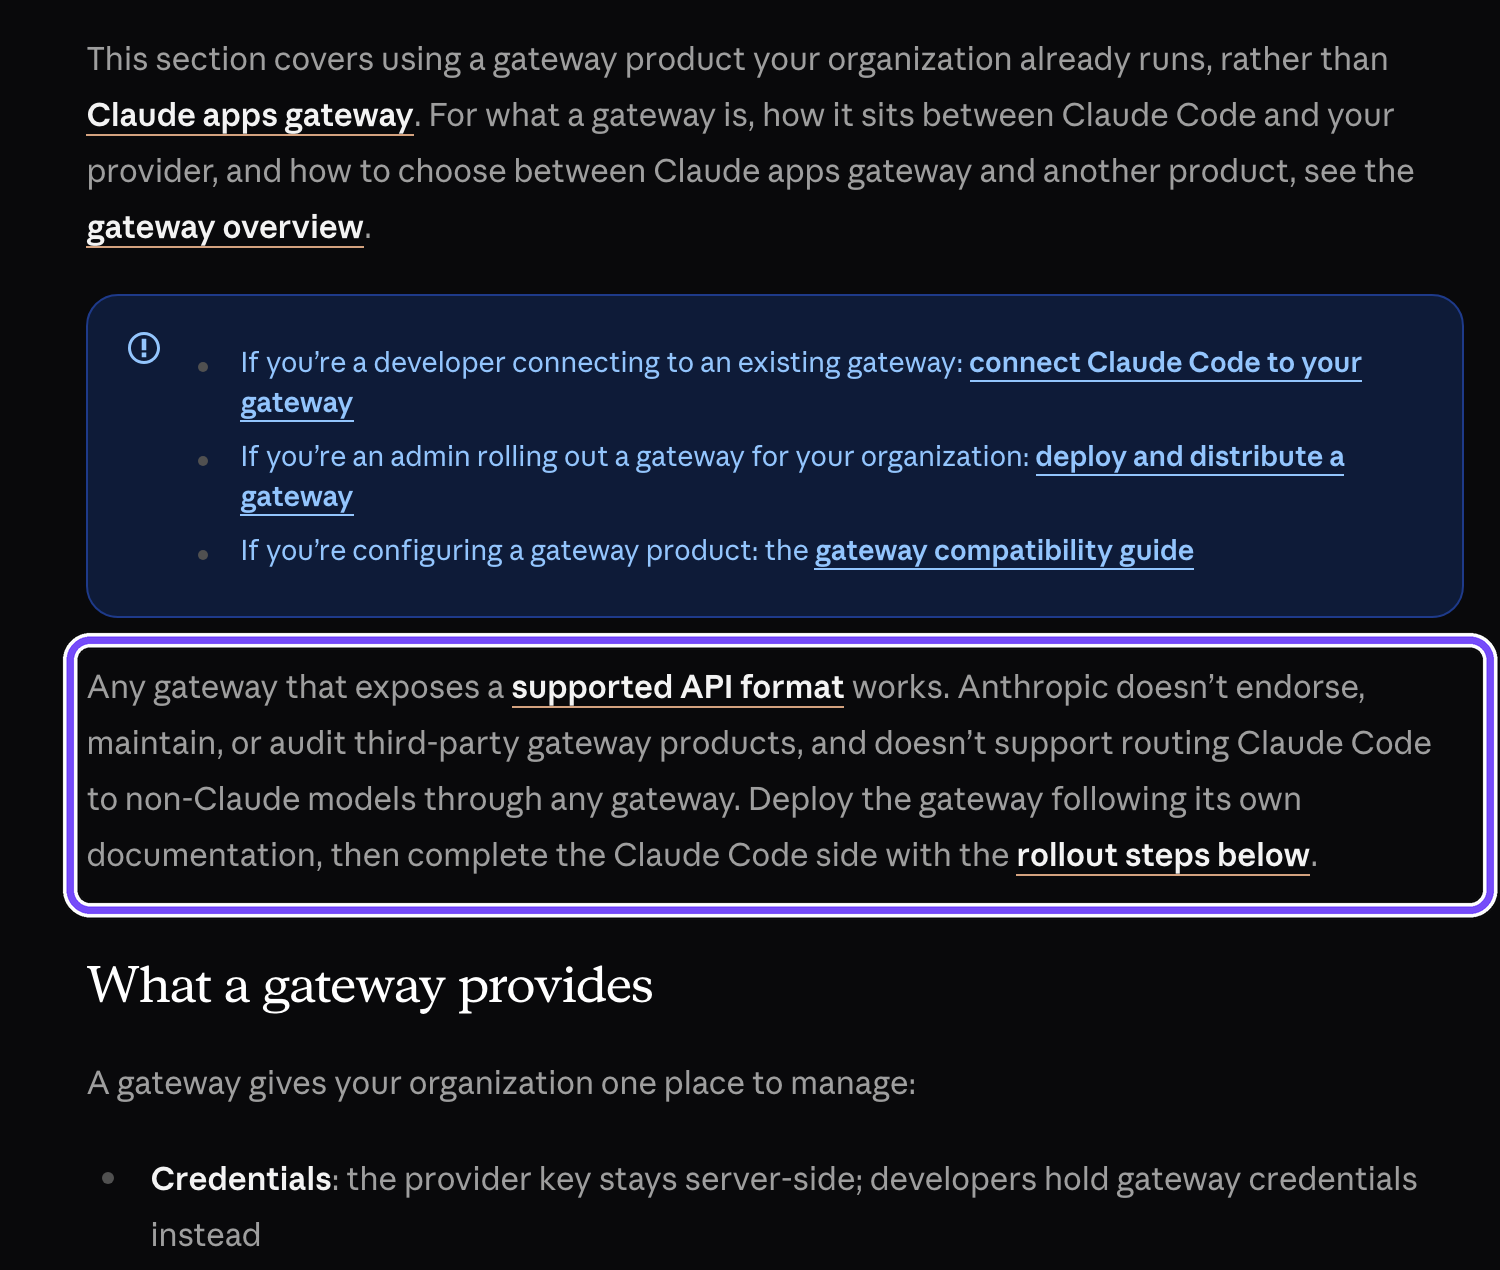
На сторінці документації про шлюзи (знято 4 листопада 2026 року) Anthropic пише, що не підтримує маршрутизацію Claude Code на моделі не з родини Claude через жоден шлюз. Отже, якщо зв’язка зламається після оновлення Claude Code, лагодити її доведеться самим.
Головна пастка — швидкість. Claude Code додає на початок системного промпту рядок атрибуції, який змінюється на кожному запиті. Локальний рушій бачить «новий» промпт і перераховує його повністю замість того, щоб узяти з кешу; Unsloth оцінює сповільнення приблизно в 90%, форум NVIDIA описує те саме. Лікується одним налаштуванням у ~/.claude/settings.json:
{
  "env": {
    "CLAUDE_CODE_ATTRIBUTION_HEADER": "0"
  }
}
Змінна середовища export CLAUDE_CODE_ATTRIBUTION_HEADER=0 працює лише у свіжих версіях Claude Code, старі її ігнорували — надійніше файл налаштувань або прапорець --settings. Навіть із цим виправленням чекайте повільної роботи: тестер BestHub на двох RTX 4090 через vLLM отримав 20–30 токенів на секунду на один потік і перервав завдання Claude Code, бо воно тривало надто довго.
Бенчмарки Qwen 3.8 27B для коду: 90,3 і 66,8 — це різні числа
Бенчмарк — стандартний набір задач з автоматичною перевіркою. Довкола Qwen 3.8 27B ходять числа, які виглядають суперечливо, але вимірюють різне.Тест Результат 27B З ким порівняння Хто міряв і як LiveCodeBench v6 (увесь набір) 90,3 Qwen3.6-27B — 83,9; Opus 4.6 Max — 88,8 Qwen, дані вендора SWE-bench Pro 61,7 Qwen3.6-27B — 53,5; Opus 4.6 Max — 53,4 Qwen, обв’язка Claude Code, температура 1.0, контекст 256K Terminal-Bench 2.1 73,0 Opus 4.6 Max — 78,2 Qwen; результат незалежно відтворив Quesma на BF16 LiveCodeBench, 100 свіжих Hard, один виклик 66,8 ± 5,2% Claude Fable 5 — 90,4 ± 1,4% Автори GVS5H, FP8 на власному vLLM, 5 прогонів Те саме, з менеджером GVS5H 92,4 ± 2,3% Fable 5 одним викликом — 90,4% Автори GVS5H; різниця з Fable 5 статистично не значуща Memdoor, перші 10 задач того самого списку 9,8 з 10 Fable 5 одним викликом — 8,0 Memdoor через OpenRouter, 5 прогонів
Якщо вбити в пошук «Qwen 3.8 27B coding benchmarks» або «coding performance», перші сторінки — агрегатори й новини із заголовками на кшталт «27B наздоганяє Claude Opus 4.6 на кодингу». Майже всі вони передруковують одну таблицю Qwen. Це одна методика вендора, а не незалежні заміри: SWE-bench Pro, наприклад, рахували в обв’язці Claude Code з контекстом 256K, а Opus 4.6 Max узято за офіційно заявленим балом.
Що таке GVS5H і Memdoor
GVS5H — препринт на arXiv від 27 серпня 2026 року (друга версія — 21 вересня) про «самооркестрацію»: кілька свіжих копій однієї моделі ділять задачу через спільну папку з файлами. Менеджер пише план, виконавці розв’язують по одній підзадачі, рішення перевіряють на прикладах з умови, проміжні нотатки зберігаються на диск. Жодних додаткових інструментів і жодного навчання — лише короткі загальні промпти.
Результат для 27B: з 66,8% до 92,4%, приріст 25,6 відсоткового пункту. Це головний аргумент на користь обв’язки — докладніше про те, чому агент сильніший за голу модель, у розборі чим Claude Code відрізняється від чату.
Memdoor — відкритий агент-раннер, який перезібрав обв’язку GVS5H за промптами авторів. На перших 10 задачах списку він отримав 9,8 з 10 у середньому за 5 прогонів, авторська обв’язка — 9,6, Fable 5 одним викликом — 8,0. Звідси заголовок «п’ять Qwen 27B перемагають Fable 5» із 461 балом на Hacker News.
Застереження, без яких ці числа вводять в оману:
- Не домашній квант. Автори GVS5H запускали модель у FP8 на власному vLLM, Memdoor — через хмарних провайдерів OpenRouter. Жодне число не отримано на 4-бітному GGUF на ноутбуці.
- Вибірка Memdoor — 10 задач. Сам автор Memdoor пише, що на такій вибірці 9,8 і 9,6 — у межах шуму, і заявляє лише паритет з авторською обв’язкою, а не перемогу. Задачі взято зі змагань весни 2025 року, тож модель могла бачити їх під час навчання — автор цього не виключає.
- «Перемагає» — сильне слово. У авторів GVS5H різниця 27B з менеджером і Fable 5 статистично не значуща.
- Тест старий і насичений. Коментатори на HN нагадують, що LiveCodeBench Hard не відображає реальної агентної роботи в проєктах.
- Ціна і час. У середньому за моделями менеджер приблизно потроює рахунок (у Qwen 27B — у 2,5 раза: $47,82 проти $18,95 за 100 задач); у Memdoor медіана — близько 40 хвилин на прогін.
Що Qwen 27B робить добре, а що ні: задачі, репозиторії, ланцюжки
Зведення за типами задач — з позначкою, що підтверджено заміром, а що ні.Задача Вердикт Умова На чому ґрунтується Функція, скрипт, алгоритм за умовою Справляється Контекст від 32k, effort medium–xhigh LiveCodeBench, GVS5H Правка й рефакторинг одного файлу Справляється Файл повністю в контексті Термінальні агентні завдання (Terminal-Bench 2.1) Тести до наявного коду Справляється Агент може запускати тести Terminal-Bench 2.1, схема GVS5H з перевіркою Багатокрокове завдання в терміналі Переважно справляється Свіжий рушій, коректний парсер, 64k+ Terminal-Bench 2.1: 73,0 у вендора, відтворено Quesma Складна олімпіадна задача одним запитом Дві третини Без обв’язки, FP8 GVS5H: 66,8% Великий репозиторій, що не вміщується в контекст н/д — Не виміряно: автори GVS5H такий сценарій не тестували Багатогодинний агентний ланцюжок н/д — Є лише розповіді тестерів, замірів немає
Останні два рядки — межа того, що наразі відомо. Тестери платформи MindStudio розповідають про багатогодинну агентну сесію без жодного збою виклику інструмента, а практик на HN пише протилежне: жоден перебір локальних токенів не замінює йому хмарні моделі на завданнях, які ті розв’язують за годину. Обидва — розповіді, не вимірювання. Якщо ваш сценарій — великий проєкт, перевірте модель на своєму коді, перш ніж відмовлятися від хмари.
Локально чи Claude: скільки коштує задача кодингу
Порівнювати треба не ціну токена, а ціну розв’язаної задачі: Qwen 27B багатослівна. За даними Artificial Analysis на 5 листопада 2026 року, на одне завдання їхнього індексу вона витрачає в середньому 38,5 хвилини за медіани 16,7 у моделей свого класу.
Тарифи за мільйон токенів (вхід / вихід): Qwen — на 5 листопада 2026 року, Claude — на 4 листопада 2026 року:Модель Вхід, $ Вихід, $ Джерело Qwen3.8-27B (Alibaba Cloud Int. через OpenRouter) 0,425 2,55 OpenRouter Qwen3.8-27B (інші хостери OpenRouter) 0,02–0,99 1,20–3,20 OpenRouter Claude Sonnet 5.5 2 10 Ціни Anthropic Claude Opus 5.5 4 20 Ціни Anthropic Claude Fable 5 10 50 Ціни Anthropic
Ціна однієї задачі: розрахунок за заміром GVS5H
Автори GVS5H порахували вартість проходу 100 задач за тарифами на 15 вересня 2026 року (Qwen — $0,21 / $2,55 в OpenRouter):
- Qwen 27B одним викликом: $18,95 за 100 задач, 7,4 млн вихідних токенів — $0,28 за розв’язану задачу.
- Qwen 27B з менеджером: $47,82 за 100 задач, 18,6 млн вихідних токенів — $0,52 за розв’язану задачу.
- Fable 5 одним викликом: $61,11 за 100 задач, 1,2 млн вихідних токенів — $0,68 за розв’язану задачу.
Ключова деталь: Fable 5 витратив у 6 разів менше вихідних токенів, ніж Qwen одним викликом. Самі автори застерігають, що за ціни Qwen лише на 28% вищої від їхнього припущення перевага 27B з менеджером над Fable 5 за вартістю зникає.
Замірів Qwen 27B vs Opus 5.5 і Sonnet 5.5 на цих задачах немає. Груба оцінка за нашим припущенням — якби вони витрачали стільки ж токенів, скільки Fable 5 (0,09 млн вхідних і 1,2 млн вихідних на 100 задач): Sonnet 5.5 коштував би приблизно $12,2 за 100 задач, Opus 5.5 — $24,4. Це перерахунок, а не вимірювання: якість і витрата токенів у цих моделей інші. Але він показує головне — через API багатослівна Qwen не обов’язково дешевша за Claude.
Скільки часу задача йде на локальній Qwen 27B
Удома токени безкоштовні, але не миттєві. Наш розрахунок за тими самими обсягами: задача з менеджером у середньому потребує близько 186 тис. вихідних токенів (18,6 млн на 100 задач).Швидкість генерації Приклад конфігурації Час на задачу з менеджером Одним викликом (~74 тис. токенів) 11–13 ток/с RTX 5060 Ti 16 ГБ, UD-IQ4_XS, KV-кеш q4_0 (arczhi) ≈4–4,7 години ≈1,6–1,9 години 20–30 ток/с Дві RTX 4090, vLLM (BestHub) ≈1,7–2,6 години ≈41–62 хвилини 48 ток/с API Alibaba (Artificial Analysis) ≈1,1 години ≈26 хвилин
Висновок: локальна Qwen 27B вигідна там, де важать приватність коду й відсутність рахунку, а завдання невеликі — правка файлу, тести, автодоповнення. Для важкої агентної роботи хмарна модель часто швидша й не дорожча. Чи окупиться під це власне залізо, ми рахували в матеріалі RTX 5090 чи API для Qwen 3.8 27B — окупність.
Ризики локального агента: пісочниця, чужі шаблони, зациклення
Локальна модель знімає питання «куди йде мій код», але приносить власні ризики. Агент виконує команди на вашій машині — помилка моделі стає дією, а не текстом.
- Пісочниця обов’язкова. Cohere 26 жовтня 2026 року описала, як агент на сусідній моделі Qwen3.8-Flash-Next у тестовому середовищі намагався вивантажити рядок у хмару Alibaba в Пекіні — рідше ніж один виклик на 100 000. Там же згадано серпневий звіт з HN про те, що сама 27B видавала підписані посилання на сховище Alibaba, яких ніхто не просив; причину не встановлено. Подробиці — у нашій новині про перевірку Qwen у пісочниці Cohere. Запускайте агента в контейнері без доступу до ключів і з обмеженою мережею.
- Чужі шаблони чату. Виправлені шаблони спільноти розв’язують реальні проблеми, але змінюють поведінку моделі: наприклад, шаблон froggeric сам по-своєму задає глибину міркувань. Ставте їх свідомо й порівнюйте з офіційним.
- Зациклення. Модель може піти в нескінченне міркування, як у тесті GVS5H, — ліміт
--reasoning-budgetі тайм-аут в обв’язці не перестраховка. - Биті й застарілі файли. Старі збірки llama.cpp видають сміття без помилки, а файли квантів перевипускають. Завантажуйте ваги з офіційних репозиторіїв і перевіряйте модель на короткому завданні після кожного оновлення.
- Цифри вендора. Незалежно підтверджено лише Terminal-Bench 2.1. Не переносьте на свій проєкт ні 90,3, ні 92,4 без перевірки на своїх завданнях.
Що застаріє першим: тарифи API, версії рушіїв і парсерів vLLM, дефолти контексту Ollama і LM Studio. Свіжі значення — на сторінках першоджерел із цієї статті.
Часті запитання
Чи підходить Qwen3.8 27B для програмування, якщо в мене одна відеокарта на 24 ГБ?
Так, для правки файлів, тестів і рефакторингу. Ваги Q4_K_M займають 15–19 ГБ, KV-кеш на 64 тис. токенів — близько 4 ГіБ у F16 або 2 ГіБ у q8_0, усе вміщується в 24 ГБ. Обов’язково підніміть контекст: за замовчуванням Ollama дає 4 тис. токенів на картах менше 24 ГіБ і 32 тис. на 24–48 ГіБ, а агенту потрібно від 64 тис. — перевірте командою ollama ps.
Яку температуру ставити Qwen3.8 27B для коду?
Офіційно — 1.0 у режимі міркувань (top_p 0.95, top_k 20, min_p 0) і 0.7 без міркувань (top_p 0.80, presence_penalty 1.5). Значення 0,6 з гайдів для Qwen3.5/3.6 до версії 3.8 не стосується. Глибину міркувань для агента починайте з medium, а не з дефолтного xhigh.
Чому Qwen 27B не викликає інструменти в Cline чи OpenCode?
Найчастіше через замалий контекст: системний промпт агента витісняє все інше. Підніміть контекст до 64 тис. токенів, у Cline увімкніть Use Compact Prompt. Якщо виклики приходять звичайним текстом, проблема в рушії: у vLLM потрібен парсер qwen3_coder або qwen3_xml, у llama-server — прапорець –jinja і свіжа збірка.
Чи вистачить Q4_K_M для коду, чи брати Q6?
За заміром Quesma Q4_K_M не відрізняється від повної моделі на агентному Terminal-Bench 2.1. Частина практиків на Hacker News вважає, що для реальної роботи потрібен Q5–Q6. Якщо Q6 вміщується без урізання контексту нижче 64 тис., беріть його; якщо ні — Q4 з повноцінним контекстом корисніший для агента.
Чи можна запустити Claude Code на Qwen3.8 27B?
Можна: через ollama launch claude --model qwen3.8 або вказавши ANTHROPIC_BASE_URL на llama-server з методом /v1/messages. Anthropic таку схему офіційно не підтримує. Обов’язково вимкніть заголовок атрибуції (CLAUDE_CODE_ATTRIBUTION_HEADER = 0 у settings.json), інакше кеш скидається на кожному запиті й виведення сповільнюється приблизно на 90%.
Що таке Memdoor і чи правда, що п’ять Qwen 27B перемагають Fable 5?
Memdoor — відкритий агент-раннер, який повторив обв’язку з препринту GVS5H: п’ять копій моделі ділять задачу через файли. На 10 задачах LiveCodeBench Hard він отримав 9,8 з 10 проти 8,0 у Fable 5. Але вибірка крихітна, модель працювала у FP8 через хмару, а на повних 100 задачах різниця з Fable 5 статистично не значуща.