Коротко (TL;DR)
Це огляд Qwen 3.8 27B — відкритої моделі Alibaba, яку можна поставити на одну відеокарту на 24 ГБ або на Mac із 24–32 ГБ пам’яті. Qwen 3.8 27B вийшла 14 серпня 2026 року під ліцензією Apache 2.0 і розуміє текст, зображення та відео. Власного запуску моделі в цьому матеріалі немає: усі виміри швидкості чужі, з автором і умовами, а там, де виміру немає, ми даємо оцінку за відкритою формулою й так її і підписуємо.
- Коротко (TL;DR)
- Словник: кванти, VRAM, MTP та інші терміни локального запуску
- Що таке Qwen 3.8 27B і чим вона відрізняється від Qwen 3.6 27B
- Версії, розміри та ліцензія Qwen 3.8 27B: що завантажити
- Бенчмарки Qwen 3.8 27B: цифри Alibaba і незалежний індекс
- Qwen 3.8 27B проти Gemma 4 31B, Qwen 3.6 27B і Flash-Next
- Скільки пам’яті потрібно Qwen 3.8 27B: кванти GGUF і MLX у гігабайтах
- Як запустити Qwen 3.8 27B: Ollama, LM Studio, llama.cpp і MLX
- Швидкість на RTX 3060, 4090, 5090 і Mac з M4 та M5: виміри й оцінки
- Режим xhigh у Qwen за замовчуванням: як не чекати 21 хвилину відповіді
- Ризики локальної 27B-моделі Alibaba: коли вона не підходить
- Який квант брати під код, агентів, документи й чат
- FAQ
- Якість. Незалежний індекс Artificial Analysis — 34 бали (33,70) на 25 жовтня 2026 року. Це рівень DeepSeek V4 Flash, у якої параметрів удесятеро більше. У попередниці Qwen 3.6 27B — 21,43.
- Пам’ять. Найпоширеніший 4-бітний файл UD-Q4_K_XL важить 17,56 ГБ. На 16 ГБ модель стає лише в 3–4 бітах із коротким контекстом.
- Швидкість. RTX 4090 — 47 токенів за секунду без прискорення і близько 109 з MTP; M5 Max — 36,6 в MLX на короткій відповіді, M4 Max — 24,6. Виміри різних авторів, умови нижче.
- Головна пастка. За замовчуванням модель міркує на максимумі (
xhigh) і може думати 21 хвилину над простим завданням. Перше, що варто зробити після встановлення, — зменшити глибину міркування або вимкнути його. - Кому підходить: код, агенти, довгі документи на власному залізі без хмари. Кому ні: власникам ноутбуків без потужної відеокарти та Mac із 16 ГБ — їм швидше підійде MoE-модель.
- Підсумок на 25 жовтня 2026 року: якість на рівні моделі вдесятеро більшої, відкрита ліцензія і реальний запуск на 24 ГБ; мінуси — багатослівність і швидкість щільної моделі, особливо на Mac.
Словник: кванти, VRAM, MTP та інші терміни локального запуску
Без цих термінів далі буде складно — кожен пояснюємо одним рядком.
- Параметри (27B) — числа всередині нейромережі, 27 мільярдів. Що їх більше, то модель зазвичай розумніша і то більше пам’яті їй потрібно.
- Щільна модель (dense) — на кожне слово працюють усі 27 млрд параметрів одразу. Протилежність — MoE (mixture of experts, «суміш експертів»): мережа розбита на частини, і на кожне слово вмикається лише невелика частка.
- Квантування — стиснення моделі: замість 16 біт на параметр зберігаємо 4–8. Файл стає в рази легшим, якість падає трохи.
- GGUF і MLX — формати стиснутих файлів. GGUF читають llama.cpp, Ollama і LM Studio на будь-якому комп’ютері, MLX — рідний формат Apple для Mac.
- VRAM — пам’ять відеокарти. Модель має поміститися в неї повністю, інакше частина поїде у звичайну пам’ять і швидкість упаде в рази.
- Єдина пам’ять Mac — в Apple процесор і графіка ділять одну пам’ять, тому Mac на 32 ГБ може віддати моделі більше, ніж відеокарта на 12 ГБ.
- Контекст і KV-кеш — контекст це обсяг тексту, який модель тримає в голові за раз; KV-кеш — пам’ять, куди вона кладе вже прочитане.
- Токен за секунду (ток/с) — швидкість відповіді. Токен — шматок слова; 20 ток/с читаються комфортно, 5 ток/с — уже повільно.
Що таке Qwen 3.8 27B і чим вона відрізняється від Qwen 3.6 27B
Що це за модель? Qwen 3.8 27B — щільна мовна модель команди Qwen з Alibaba на 27 млрд параметрів із вбудованим модулем зору: вона читає текст, зображення й відео, а відповідає текстом. Ваги відкриті під Apache 2.0, модель розрахована на локальний запуск і на сервери. За замовчуванням вона спершу міркує, а потім відповідає.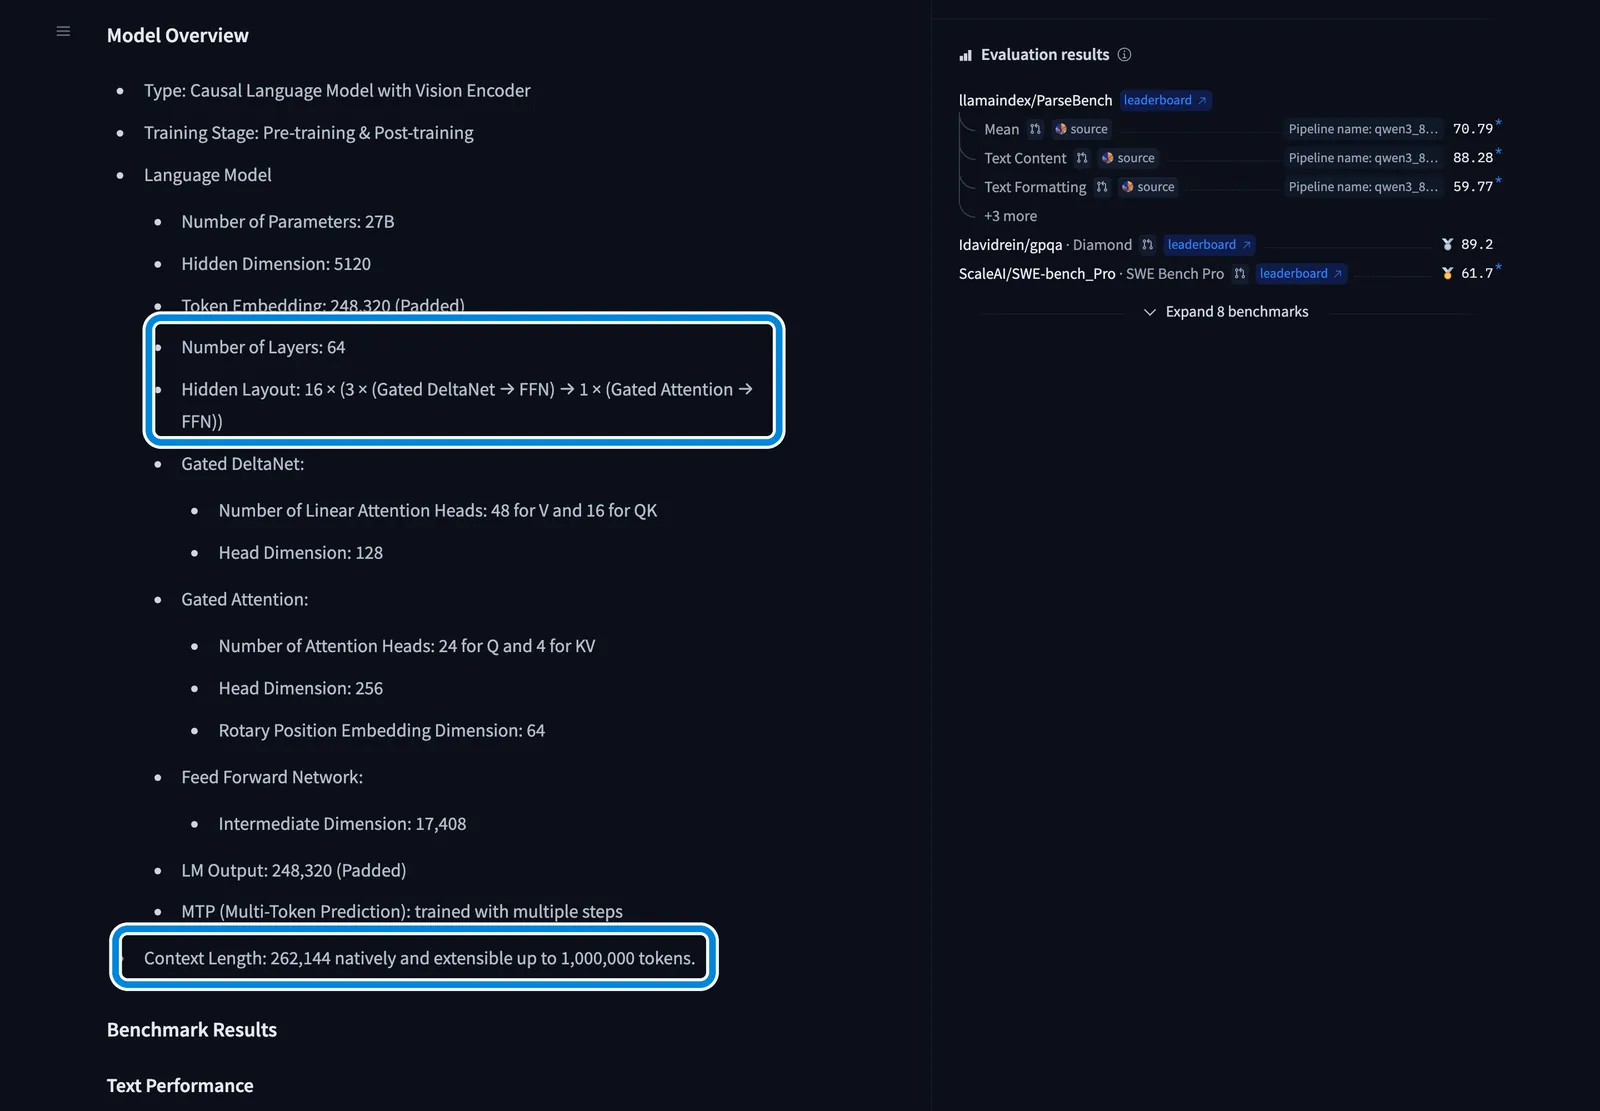
На кадрі — офіційна картка моделі на Hugging Face, знята 25 жовтня 2026 року. Рамки показують два рядки, які пояснюють майже все про її апетит до пам’яті.

- 64 шари, але повна увага лише в 16. Схема
16 × (3 × Gated DeltaNet → 1 × Gated Attention)означає: на кожні чотири шари три «лінійні» (Gated DeltaNet) і один звичайний. Лінійний шар зберігає стисле зведення прочитаного фіксованого розміру, а звичайний пам’ятає кожен токен. Тому KV-кеш росте лише в 16 шарах із 64 — він учетверо менший, ніж у звичайної моделі такого розміру. - Контекст 262 144 токени нативно. Цифру «до 1 млн» картка дає через розтягування YaRN у серверних рушіях vLLM, SGLang і TokenSpeed; удома орієнтуйтеся на 262 тис.
- Вбудоване MTP (multi-token prediction, багатотокенне передбачення) — додаткова «голова», яка вгадує кілька наступних токенів. Через неї на тій самій карті модель буває вдвічі швидшою, подробиці — в розділі про швидкість.
Приріст від дотренування: ті самі 64 шари, інші цифри
Порівняння Qwen 3.8 27B vs Qwen 3.6 27B починається з того, що архітектура не змінилася: ті самі 64 шари, той самий гібрид, той самий контекст, та сама ліцензія і той самий модуль зору. Codersera звірила конфігураційні файли двох моделей і дійшла висновку, що весь приріст дало дотренування, а не нова конструкція. Якщо ви вже розбиралися з Qwen3 на своєму ПК, Qwen 3.8 27B запуститься тими самими інструментами, потрібні лише свіжі версії.
Що дав апгрейд, видно з цифр:
- індекс Artificial Analysis v4.3.2 зріс із 21,43 до 33,70 (+12,3 бала) на 25 жовтня 2026 року;
- агентний тест DeepSWE 1.1 за даними Alibaba — з 13,3 до 42,2;
- керування комп’ютером OSWorld-Verified — з 63,9 до 84,3 (теж дані Alibaba).
Платить модель за це багатослівністю. На прогін того самого індексу Qwen 3.8 27B витратила 200 млн вихідних токенів проти 160 млн у Qwen 3.6 27B, а прогін одного завдання індексу через API коштував $1,01 проти $0,62. Удома ви платите не грошима, а часом: кожен зайвий токен міркування треба згенерувати.
Версії, розміри та ліцензія Qwen 3.8 27B: що завантажити
Alibaba виклала ваги Qwen 3.8 27B 14 серпня 2026 року, і цю дату підтверджують Artificial Analysis, DataNorth та OpenRouter. Модель називають «27B», хоча в офіційному файлі 27 781 427 952 параметри: понад мовну частину туди входять візуальний кодувальник і вбудована голова MTP.
Офіційний репозиторій — huggingface.co/Qwen/Qwen3.8-27B: там лежать ваги Qwen, картка з бенчмарками й рекомендовані налаштування, а поруч — кванти від Unsloth, ggml-org і lmstudio-community.Варіант Хто публікує Вага Для чого BF16 (без стиснення) Qwen 54,66 ГБ у GGUF сервери з 64 ГБ+ пам’яті, дотренування FP8 Qwen ( Qwen/Qwen3.8-27B-FP8)28,5 ГіБ ваг у vLLM (29,0 з MTP) сервер на одній великій карті NVFP4 NVIDIA, Unsloth 19,9 ГіБ ваг у vLLM (20,8 з MTP) відеокарти RTX 50 і Blackwell: найшвидший формат GGUF 2–8 біт Unsloth, ggml-org 7,27–29,05 ГБ llama.cpp, Ollama, LM Studio на будь-якому ПК і Mac MLX 4/5/6/8 біт lmstudio-community, mlx-community 16,05–29,50 ГБ Mac на чипах Apple M Ollama qwen3.8:27bOllama 17 ГБ у пам’яті (Q4_K_M) запуск однією командою, потрібна Ollama 0.32.12+
Ліцензія Apache 2.0 дозволяє комерційне використання, зміну й поширення. Умова одна: зберегти текст ліцензії та позначити змінені файли. Оригінальні ваги, GGUF від Unsloth і ggml-org та MLX-збірки lmstudio-community заявляють ту саму ліцензію. Сторонні «розцензуровані» версії (abliterated) і суміші з чужими моделями — окремі роботи: їхню ліцензію й походження перевіряйте на сторінці кожного репозиторію.
Не плутайте із сусідами по лінійці. Qwen3.8-Max — хмарний флагман на 2,4 трлн параметрів (MoE, близько 95 млрд активних), удома його не поставити. Qwen3.8-Flash-Next — MoE на 125 млрд параметрів із 6 млрд активних і окремою ліцензією qwen-community-1.0. Обидві моделі — не той файл, про який цей огляд.

Скільки коштує. Ваги безкоштовні. Якщо запускати не в себе, а через API, ціна залежить від провайдера: Artificial Analysis розраховує за ціною $0,50 за 1 млн вхідних і $3,00 за 1 млн вихідних токенів, на OpenRouter у найдешевшого провайдера на 25 жовтня 2026 року — від $0,02 і $0,50. Сама Alibaba модель теж віддає: на OpenRouter серед провайдерів є Alibaba Cloud International — $0,425 за 1 млн вхідних і $2,55 за 1 млн вихідних токенів на 25 жовтня 2026 року.
Бенчмарки Qwen 3.8 27B: цифри Alibaba і незалежний індекс
Бенчмарк — стандартний іспит для моделей. Важливо, хто його проводив: розробник підбирає умови сам, незалежна лабораторія ганяє всіх однаково. Тому нижче — дві окремі картини.
Що заявляє Alibaba
За таблицею розробника Qwen 3.8 27B обходить попередницю всюди, а подекуди — і закриту Claude Opus 4.6 Max. Але в цих цифр три застереження, які варто знати до висновків.Тест Qwen 3.8 27B Qwen 3.6 27B Claude Opus 4.6 Max Gemma 4 31B LiveCodeBench v6 (олімпіадний код) 90,3 83,9 88,8 80,0 GPQA Diamond (наука) 89,2 87,8 91,3 84,3 SWE-bench Pro (виправлення репозиторіїв) 61,7 53,5 53,4 н/д Terminal Bench 2.1 (робота в терміналі) 73,0 63,4 78,2 н/д HLE (складні питання) 30,8 24,0 40,0 н/д IFBench (виконання інструкцій) 79,5 69,1 62,5 н/д
Дані вендорів: картка Qwen/Qwen3.8-27B (14.08.2026) і картка google/gemma-4-31B-it.
- SWE-bench Pro — різні версії тесту в одному рядку. Alibaba виправила проблемні завдання й перепрогнала свої моделі на новій версії, а в Opus стоїть офіційний результат на початковій. Перемога 61,7 проти 53,4 — не порівняння один до одного.
- Частина тестів — внутрішні. QwenSWEBench і CoWorkBench Alibaba придумала й проводить сама.
- Gemma 4 — з іншої картки. Її цифри публікує Google зі своїми налаштуваннями прогону, тож різниця з Qwen — орієнтир, а не точний рахунок.
Що показує незалежний індекс
Artificial Analysis — лабораторія, яка сама проганяє моделі через десять тестів (агентні завдання, код, наука, довгий контекст) і зводить їх в один бал. На 25 жовтня 2026 року в Qwen 3.8 27B у режимі xhigh 34 бали індексу v4.3.2.
Щільна модель на 27 млрд параметрів стоїть урівень із GLM-5.2 і DeepSeek V4 Flash та вище за закриту Claude Opus 4.6. Ціна завдання при цьому в неї одна з найвищих у групі.Модель Індекс AA v4.3.2 Ціна одного завдання індексу DeepSeek V4 Flash 0731 (Max), MoE 284B 34,33 $0,22 GLM-5.2 (Max) 33,71 $1,47 Qwen 3.8 27B (xhigh) 33,70 $1,01 Claude Opus 4.6 (Max) 31,95 $0,06 Qwen 3.6 27B (reasoning) 21,43 $0,62
Artificial Analysis, сторінка моделі та зведення Codersera з посиланням на AA; на 25.10.2026.
Кадр знято 25 жовтня 2026 року. У рамці — зведення лабораторії: індекс 34, 200 млн вихідних токенів на прогін за медіани 82 млн і швидкість 44 токени за секунду через API. Сама лабораторія називає модель «дуже багатослівною» і «помітно повільною».
Звідки в оглядах «52 бали». У серпні модель отримала 52 бали за минулою версією індексу v4.1.1. Потім Artificial Analysis перерахувала індекс на новому наборі тестів, і всі моделі отримали нові бали. Порівнювати 52 і 34 не можна: це різні шкали, а не падіння якості. У тексті вище — лише чинна версія.
Qwen 3.8 27B проти Gemma 4 31B, Qwen 3.6 27B і Flash-Next
Головний вибір під час локального запуску — щільна модель чи MoE. Щільна читає з пам’яті всі свої параметри на кожен токен, тому вона повільніша, але стабільніша у довгих завданнях. MoE зберігає багато параметрів, а працює малою їх частиною: відповідає швидше, але пам’яті потребує як велика модель.Qwen 3.8 27B Gemma 4 31B Qwen 3.6 27B Qwen3.8-Flash-Next Тип щільна щільна щільна MoE Параметри 27 млрд 30,7 млрд 27 млрд 125 млрд, 6 млрд активних Ліцензія Apache 2.0 Apache 2.0 Apache 2.0 qwen-community-1.0 Контекст 262 тис. 256 тис. 262 тис. 262 тис. 4 біти в Ollama 18 ГБ 19 ГБ н/д не вміщується в 24 ГБ GPQA Diamond 89,2 84,3 87,8 91,7 LiveCodeBench v6 90,3 80,0 83,9 91,9 Індекс AA v4.3.2 33,70 н/д 21,43 н/д
Бенчмарки — з карток вендорів (Flash-Next і Gemma — за зведенням BetterClaw), на 25.10.2026. У Flash-Next 125 млрд параметрів: навіть у 4 бітах це щонайменше 63 ГБ ваг (125 млрд × 0,5 байта), в одну відеокарту на 24 ГБ модель не вміщується.
Qwen 3.8 27B проти Gemma 4 31B: що обрати для коду й агентів
На двох тестах, які є в обох картках, попереду Qwen 3.8 27B: 89,2 проти 84,3 на GPQA Diamond і 90,3 проти 80,0 на LiveCodeBench v6. Різниця в коді — близько десяти пунктів, це найбільший відрив. Обидві моделі вміщуються у відеокарту на 24 ГБ у 4 бітах: в Ollama Qwen важить 18 ГБ, Gemma — 19 ГБ.
У Gemma свій козир: Google публікує для 31B результат 76,9% на Tau2 — тесті на роботу з інструментами в діалозі, — а Qwen цього тесту не наводить. Порівняти їх безпосередньо в агентних сценаріях за відкритими даними не можна. Докладніше про другу модель — у розборі Gemma 3 і Gemma 4 на своєму ПК.
Висновок: для коду й багатокрокових завдань на 24 ГБ — Qwen 3.8 27B. Якщо потрібна менша модель для карти на 16 ГБ, у родині Gemma 4 є MoE 26B A4B із 3,8 млрд активних параметрів — на слабкому залізі вона відповідає помітно швидше.
Проти Qwen3.8-Flash-Next: швидкість чи надійність
У парі Qwen 3.8 27B vs Qwen 3.8 Flash-Next друга модель швидша завдяки 6 млрд активних параметрів, але їй потрібна пам’ять як у моделі на 125 млрд. У тесті MindStudio на збірці з чотирьох RTX 3090 щільна Qwen 3.8 27B у FP16 довела до кінця дводенну сесію агентного програмування, а Flash-Next в INT4 — ні. Це одна демонстрація, а не бенчмарк, але вона збігається з логікою архітектур: щільна модель рідше збивається на довгій дистанції. Для живого чату, де важливі швидкість і різноманітність відповідей, автор того самого тесту віддає перевагу Flash-Next.
Що не беремо до порівняння. Qwen3 32B — минуле покоління, пряма попередниця цієї моделі — Qwen 3.6 27B.
Скільки пам’яті потрібно Qwen 3.8 27B: кванти GGUF і MLX у гігабайтах
Скільки важить Qwen 3.8 27B? Без стиснення — 54,66 ГБ, у поширеному 4-бітному кванті UD-Q4_K_XL — 17,56 ГБ, у 4-бітній збірці MLX для Mac — 16,05 ГБ. До ваги файлу додайте KV-кеш під контекст і запас близько 1 ГБ: стільки llama.cpp за замовчуванням залишає вільним, щоб не впасти під час завантаження.
Однакова назва кванта в різних авторів не гарантує однакового файлу: Q4_K_M від ggml-org на 2,5 ГБ важчий за UD-Q4_K_M від Unsloth. Порівнюйте файли за розміром, а не за назвою.Квант Qwen 3.8 27B GGUF / MLX Файл, ГБ Мінімум пам’яті Для чого UD-IQ2_XXS 7,27 12 ГБ експеримент: якість помітно падає UD-IQ3_XXS 10,93 12 ГБ RTX 3060 12 ГБ, Mac 16 ГБ із контекстом 8K UD-Q3_K_XL 13,15 16 ГБ карти на 16 ГБ: контекст до 32K UD-IQ4_XS 14,25 16 ГБ єдиний 4-бітний для 16 ГБ, контекст близько 28K MLX 4-біт 16,05 Mac 24 ГБ основний вибір для Mac UD-Q4_K_XL 17,56 24 ГБ основний вибір для RTX 4090 і 3090 UD-Q5_K_M 19,77 24 ГБ трохи точніший, контекст 32–64K UD-Q6_K 21,98 32 ГБ RTX 5090, Mac 32–36 ГБ Q8_0 29,05 32 ГБ+ майже без втрат; RTX 5090 із контекстом 32K BF16 54,66 64 ГБ+ без стиснення
Розміри — байти Hugging Face API за зведенням TechPlained; мінімуми — розрахунок «файл + KV-кеш + 1 ГБ», на 25.10.2026.
Скільки пам’яті з’їдає контекст
Оскільки повна увага є лише в 16 шарах із 64, кеш у Qwen 3.8 27B маленький: 64 КіБ на токен у форматі f16. Довгий контекст на одній відеокарті стає реальним.Контекст KV-кеш f16 q8_0 q4_0 Якби всі 64 шари були повними 8 тис. токенів 0,50 ГіБ 0,27 ГіБ 0,14 ГіБ 2 ГіБ 32 тис. 2,00 ГіБ 1,06 ГіБ 0,56 ГіБ 8 ГіБ 64 тис. 4,00 ГіБ 2,13 ГіБ 1,13 ГіБ 16 ГіБ 131 тис. 8,00 ГіБ 4,25 ГіБ 2,25 ГіБ 32 ГіБ 262 тис. 16,00 ГіБ 8,50 ГіБ 4,50 ГіБ 64 ГіБ
Розрахунок за config.json моделі (TechPlained): 2 × 16 шарів × 4 голови × 256 × 2 байти = 64 КіБ на токен. q8_0 і q4_0 — стиснення самого кешу.
Що вміщується в 12, 16, 24, 32 і 48 ГБ пам’яті
Вимоги Qwen 3.8 27B до заліза зручніше читати сходинками — від того, скільки пам’яті у вас уже є:
- 12 ГБ (RTX 3060). Повністю у відеокарту вміщується лише 3-бітний UD-IQ3_XXS: 10,18 ГіБ ваг + 0,5 ГіБ кешу на 8K + 1 ГіБ запасу = 11,7 ГіБ із 12. Це впритул і з коротким контекстом. 4-бітний файл доведеться частково тримати у звичайній пам’яті, а там швидкість падає в рази.
- 16 ГБ (RTX 5080, RTX 5060 Ti 16 ГБ). UD-Q3_K_XL із контекстом 32K або UD-IQ4_XS із контекстом близько 28K. Працює, але 3 біти — компроміс щодо якості.
- 24 ГБ (RTX 4090, RTX 3090). UD-Q4_K_XL із контекстом до 128K за стиснутого кешу або UD-Q5_K_M із контекстом 32–64K. Це та сходинка, під яку модель задумана: Unsloth прямо пише, що 4-бітні кванти працюють на 16–19 ГБ відеопам’яті.
- 32 ГБ (RTX 5090). Q8_0 із контекстом 32K або UD-Q6_K_XL із контекстом 64K. Майже без втрат якості.
- 48 ГБ і більше. Q8_0 з повним контекстом 262 тис. у f16. Такий обсяг дають і дві RTX 3090 в одній збірці.
На Mac моделі доступна не вся пам’ять: macOS віддає графіці лише частину, решту тримає за системою й програмами. Тому Mac на 16 ГБ — це 3 біти й контекст 8K, на 24 ГБ — MLX 4-біт із контекстом 32K, на 32–36 ГБ — MLX 5-біт, на 48 ГБ — MLX 6-біт або 8-біт із коротким контекстом, на 64 ГБ і більше — 8 біт із повним контекстом. Як macOS ділить пам’ять між системою та графікою, розібрано в матеріалі про єдину пам’ять Mac для ШІ.
Модуль зору зберігається окремим файлом (mmproj) і додає близько 0,86 ГіБ. Якщо зображення не потрібні, його можна не завантажувати й повернути цю пам’ять під контекст.
Як запустити Qwen 3.8 27B: Ollama, LM Studio, llama.cpp і MLX
Щоб запустити Qwen 3.8 локально, є чотири популярні способи — від однієї команди до повного контролю над пам’яттю. Чим вони відрізняються між собою загалом, ми розбирали в порівнянні Ollama, LM Studio і llama.cpp. Нижче — що важливо саме для Qwen 3.8 27B.
Ollama: запуск однією командою
- Оновіть Ollama до версії 0.32.12 або новішої — на старих модель не завантажиться.
- Завантажте модель:
ollama pull qwen3.8:27b. Це квант Q4_K_M, у пам’яті він займає близько 17 ГБ. MTP у цьому тегу вже ввімкнено: Ollama заздалегідь угадує чотири токени. - Перевірте, що все працює, із вимкненим міркуванням:
ollama run qwen3.8:27b --verbose --think=false "Одним реченням: що робить OOM killer у Linux?"
- Задайте контекст. За замовчуванням Ollama обирає його за обсягом відеопам’яті: 4K на картах менших за 24 ГіБ, 32K — від 24 до 48 ГіБ. Для коду й агентів радять від 64K:
OLLAMA_CONTEXT_LENGTH=65536 ollama serve. - Потрібен контекст 131K на 24 ГБ — стисніть кеш. У налаштуваннях служби додайте
OLLAMA_FLASH_ATTENTION=1іOLLAMA_KV_CACHE_TYPE=q4_0. У вимірі ComputingForGeeks на RTX 4090 без цього модель за 131K частково переїжджала у звичайну пам’ять і видавала 16,4 ток/с, зі стиснутим кешем — 101,8 ток/с повністю на відеокарті.
Перевірити, чи не переїхала модель на процесор, можна командою ollama ps: у колонці розміщення має стояти 100% GPU.
LM Studio: з інтерфейсом або з термінала
- Завантажте модель:
lms get qwen/qwen3.8-27b. На Mac додайте прапорець--mlx, щоб отримати збірку в рідному форматі Apple. - Завантажте її з потрібним контекстом:
lms load qwen/qwen3.8-27b --gpu=max --context-length=32768. - Запустіть локальний сервер, сумісний з API OpenAI:
lms server start.
LM Studio вказує 16 ГБ як мінімальний обсяг пам’яті для цієї моделі. На практиці це 3–4 біти й короткий контекст.
llama.cpp: максимальна швидкість із MTP
llama.cpp дає повний контроль: який квант, як стиснути кеш і чи підключати MTP. Готові збірки під CUDA лежать на нумерованих релізах (b11200 і новіші) — тег «latest» на момент перевірки ComputingForGeeks вказував на версію без бінарників.
- Завантажте 4-бітний квант і окремий файл MTP:
hf download unsloth/Qwen3.8-27B-GGUF Qwen3.8-27B-UD-Q4_K_XL.gguf --local-dir ~/lcpp/gguf
hf download unsloth/Qwen3.8-27B-GGUF --include "MTP/*" --local-dir ~/lcpp/gguf
- Для коротких діалогів і коду — запуск із MTP (файл прискорювача важить 1,4 ГБ):
llama-server -ngl 99 -fa on -c 8192 --jinja \
  -m gguf/Qwen3.8-27B-UD-Q4_K_XL.gguf \
  --spec-type draft-mtp -md gguf/MTP/mtp-Qwen3.8-27B-Q4_0.gguf -ngld 99
- Для довгих документів — без MTP і зі стиснутим кешем. На RTX 4090 лише так відкрився повний контекст 262 144:
llama-server -ngl 99 -fa on -c 262144 -ctk q4_0 -ctv q4_0 --jinja \
  -m gguf/Qwen3.8-27B-UD-Q4_K_XL.gguf
Якщо сервер пише failed to create MTP context, значить MTP і контекст не вміщуються разом: зменште -c або приберіть параметри --spec-type і -md.
MLX на Mac
Модель розуміє зображення, тому MLX-збірки зроблено через mlx-vlm:
pip install -U mlx-vlm
mlx_vlm.server --model lmstudio-community/Qwen3.8-27B-MLX-5bit --enable-thinking
У прикладі — 5-бітна збірка для Mac на 32–36 ГБ; на 24 ГБ беріть 4-бітну з того самого набору lmstudio-community. Зверніть увагу: у сервері mlx-vlm міркування за замовчуванням вимкнене, прапорець --enable-thinking його вмикає. Це протилежно іншим інструментам.
Швидкість на RTX 3060, 4090, 5090 і Mac з M4 та M5: виміри й оцінки
Чому швидкість щільної моделі передбачувана? Щоб видати один токен, чип читає з пам’яті весь файл ваг. Отже, стеля швидкості — це пропускна здатність пам’яті (скільки гігабайтів за секунду вона віддає), поділена на розмір файлу. Реальна швидкість нижча за стелю на втрати рушія.
Перевірмо формулу на трьох вимірах:
- RTX 4090: 1008 ГБ/с ÷ 17,56 ГБ = 57,4 ток/с стеля. ComputingForGeeks наміряла 47,0 ток/с в llama.cpp b11200 на відповіді в 512 токенів — це 82% стелі.
- M4 Max із 40 ядрами графіки: 546 ГБ/с ÷ 16,05 ГБ = 34,0 ток/с стеля. Weschera наміряв 24,6 ток/с без MTP в oMLX: 4-бітний квант, відповідь на 320 токенів, три прогони. Це 72% стелі.
- M5 Max із 40 ядрами графіки: 614 ГБ/с ÷ 16,05 ГБ = 38,3 ток/с стеля. PocketAI наміряла 36,6 ток/с в MLX, це 96% стелі. Але це найкращий випадок: один прогін і відповідь лише в 9 токенів. Simon Willison у LM Studio отримував 15–30 ток/с.
Для відеокарт NVIDIA ми застосували частку 0,82, для Mac — обережну 0,72 за виміром M4 Max. Верхню межу в таблиці пораховано за 0,96. Вийшли оцінки, а не виміри, — на графіку вони заштриховані.
Відеокарти NVIDIA швидші за будь-який Mac завдяки пропускній здатності пам’яті: у RTX 5090 це 1792 ГБ/с, у найшвидшого M5 Max — 614 ГБ/с. Зате Mac бере обсягом: на 64–128 ГБ єдиної пам’яті модель стає у 8 бітах із повним контекстом.Залізо Квант і рушій Без MTP, ток/с З MTP, ток/с Що це за цифра RTX 3060 12 ГБ (360 ГБ/с) UD-IQ3_XXS, llama.cpp ≈ 22–27 — оцінка (стеля 33) н/д оцінка за формулою RTX 4090 24 ГБ UD-Q4_K_XL, llama.cpp b11200, 8K 47,0 109,4 вимір ComputingForGeeks, 27.09.2026 RTX 4090 24 ГБ Ollama qwen3.8:27b47,7 95,5 вимір ComputingForGeeks, 27.09.2026 RTX 5090 32 ГБ UD-Q4_K_XL ≈ 84 — оцінка (стеля 102) н/д оцінка за формулою RTX 5090 32 ГБ UD-Q5_K_XL, контекст 125K н/д 120 вимір автора Хабра, 14.08.2026 RTX 5090 32 ГБ UD-Q6_K_XL, контекст 48K н/д 100 вимір автора Хабра, 14.08.2026 RTX 5090 32 ГБ NVFP4, llama.cpp 10479 н/д 142 у середньому вимір DataCamp, 25.08.2026 M5, 24–32 ГБ (153 ГБ/с) MLX 4-біт ≈ 7–9 — оцінка (стеля 9,5) н/д оцінка за формулою M4 Pro (273 ГБ/с) MLX 4-біт ≈ 12–16 — оцінка (стеля 17) н/д оцінка за формулою M5 Pro (307 ГБ/с) MLX 4-біт ≈ 14–18 — оцінка (стеля 19) н/д оцінка за формулою M5 Max, 32 GPU, 36 ГБ (460 ГБ/с) MLX 4-біт ≈ 21–27 — оцінка (стеля 29) н/д оцінка за формулою M4 Max, 40 GPU, 128 ГБ (546 ГБ/с) oMLX 0.6.3rc2, квант oQ4e; MTP k=3 + Neural Engine 24,6 53,3 текст / 72,1 код вимір Weschera, 21.08.2026, 3 прогони M5 Max, 40 GPU, 128 ГБ (614 ГБ/с) MLX 4-біт, mlx-vlm 0.6.8 36,6 н/д вимір PocketAI, один прогін, відповідь 9 токенів
Пропускна здатність: Apple (характеристики MacBook Pro), NVIDIA через зведення TechPlained. У RTX 3060 на сторінці NVIDIA вказано лише 12 ГБ GDDR6 і шину 192 біти, тому 360 ГБ/с — розрахунок: 192 біти × 15 Гбіт/с ÷ 8. Для неї оцінку подано діапазоном: 3-бітні i-кванти складніше розпаковувати, і частка 0,82 від 4-бітного файлу на 4090 переноситься з натяжкою. Виміри M5 Max і M4 Max — з одного джерела кожен. 53–72 ток/с на M4 Max — заслуга MTP і Neural Engine в oMLX; звичайний llama.cpp так не розганяється.
Звідки береться «вдвічі швидше» з MTP
Звичайний рушій видає один токен за один прохід вагами. MTP працює як чернетка з перевіркою: вбудована «голова» швидко пропонує кілька наступних токенів, а основна модель перевіряє їх усі за один прохід. Угадала — отримали кілька токенів за ціною одного. Не вгадала — викидаємо чернетку й ідемо далі звичайним кроком.
Тому прискорення залежить від того, наскільки текст передбачуваний:
- у вимірі ComputingForGeeks на RTX 4090 модель прийняла 1034 токени чернетки з 1493 (69%) — швидкість зросла з 47,0 до 109,4 ток/с;
- у Weschera на M4 Max чернетку на коді приймали в 99,6% випадків, на звичайному тексті — у 78%, звідси 72,1 проти 53,3 ток/с;
- загалом ComputingForGeeks бачить прискорення в 1,6–2,3 раза на всіх рушіях — але лише для одного користувача. Коли сервер обслуговує 16 запитів одночасно, приріст падає до 0–28%.
Підступ на 24 ГБ: MTP і довгий контекст разом не вміщуються. На RTX 4090 доводиться обирати: близько 110 ток/с за контексту до 8K або близько 47 ток/с із контекстом до 262 тис. Усі спроби поєднати MTP і контекст від 64K закінчувалися помилкою під час запуску або на першому запиті.
Вірусні «168 ток/с на M5 Max» — це не вимір
В обговореннях ходить цифра 168 токенів за секунду на M5 Max. Її джерело — README проєкту lithos-metal, і там вона прямо названа проєкцією: розрахунок на контексті в 128 токенів за умови, що за кожен прохід приймаються шість токенів чернетки, без урахування часу на саму чернетку. Реальні виміри на M5 Max скромніші: 36,6 ток/с без MTP у PocketAI на короткій відповіді та 15–30 ток/с у Simon Willison у LM Studio.
Чому відповідь починається з паузи: швидкість читання запиту
Перед генерацією модель читає ваш запит — це окремий етап, і він упирається не в пам’ять, а в обчислювальну потужність. RTX 4090 читає 2600–3000 токенів запиту за секунду, M5 Max в MLX — 733, M4 Max зі стеком Weschera — 273,7. Для довгого документа на 100 тис. токенів на Mac це вже хвилини очікування до першого слова відповіді (оцінка за цими швидкостями).
Якщо ви ще обираєте комп’ютер під такі моделі, порівняння чипів, пам’яті й цін зібрано в хабі Який Mac обрати.
Режим xhigh у Qwen за замовчуванням: як не чекати 21 хвилину відповіді
Qwen 3.8 27B міркує перед відповіддю, і за карткою моделі глибина міркування за замовчуванням — максимальна, xhigh. Simon Willison, розробник і автор популярного блогу про ШІ, 16 серпня 2026 року опублікував перші тести: він ганяв модель на MacBook Pro з M5 Max на 128 ГБ і на NVIDIA DGX Spark, у LM Studio з квантом Q4_K_M на 17 ГБ. Його фірмовий тест — намалювати в SVG пелікана на велосипеді — тривав 21 хвилину: 22 276 токенів міркування заради 3223 токенів результату. Без міркування схожа відповідь на 3715 токенів прийшла за 137 секунд.
Це один промпт, а не бенчмарк, але з нього видно арифметику. На базовому M5 з оціночною швидкістю 7–9 ток/с ті самі 22 276 токенів міркування зайняли б від 40 до 55 хвилин (22 276 ÷ 9,2…6,9 ≈ 2420–3230 секунд — оцінка).Режим Що робить Коли вмикати Як увімкнути xhighмаксимальна глибина міркування, багато токенів складний код, багатокрокові завдання за замовчуванням у vLLM і за карткою моделі mediumбаланс точності й швидкості щоденна робота на повільному залізі за замовчуванням в Ollama; --reasoning-effort medium у llama-serverlowкоротке міркування швидкі відповіді з логікою та рахунком "chat_template_kwargs": {"reasoning_effort": "low"}без міркування відповідає одразу чат, переказ, витягання даних --think=false в Ollama, "enable_thinking": false в API
Приклад запиту до локального сервера з низькою глибиною міркування:
curl -s localhost:8000/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "model": "qwen3.8-27b",
  "messages": [{"role": "user", "content": "Скільки простих чисел між 100 і 130?"}],
  "max_tokens": 8192,
  "chat_template_kwargs": {"reasoning_effort": "low"}
}'
Вимикати міркування зовсім варто не всюди. ComputingForGeeks поставила моделі саме це питання (правильна відповідь — шість: 101, 103, 107, 109, 113, 127). Без міркування модель за 0,1 секунди відповіла «13» — неправильно. На low вона міркувала 516 токенів і відповіла правильно за 3 секунди, на xhigh — 345 токенів і теж правильно за 2,5 секунди. Правило просте: для чату й витягання даних міркування вимикаємо, для всього, де є рахунок чи логіка, залишаємо принаймні low.
Ще одне налаштування — preserve_thinking. За замовчуванням модель зберігає в контексті міркування з усіх минулих повідомлень: агентам це допомагає не втрачати нитку, але контекст заповнюється швидше. Для звичайного чату цю поведінку можна вимкнути. Рекомендовані карткою параметри генерації: для режиму міркування temperature=1.0, top_p=0.95, top_k=20; без міркування — temperature=0.7, top_p=0.80, presence_penalty=1.5.
Ризики локальної 27B-моделі Alibaba: коли вона не підходить
- Слабке залізо — повільно. Щільна модель читає всі параметри на кожен токен. На ноутбуці з пам’яттю близько 100 ГБ/с Codersera бачить близько 4 ток/с, на одному процесорі — близько 1 ток/с. Для такого заліза швидша MoE: Qwen 3.6 35B-A3B із 3 млрд активних параметрів на процесорі працює приблизно вп’ятеро швидше.
- Багатослівність коштує часу й грошей. 200 млн вихідних токенів на прогін індексу за медіани 82 млн. Через API одне завдання коштує $1,01 — DeepSeek V4 Flash із тим самим балом бере $0,22 (на 25 жовтня 2026 року).
- 12 і 16 ГБ — компроміс щодо якості. 3 біти вміщуються, але відповідають гірше за 4-бітну версію. Unsloth публікує графіки втрат для кожного кванта; якщо 3-бітний результат не влаштовує, це лікується пам’яттю, а не іншим 3-бітним файлом.
- Бенчмарки здебільшого від вендора. Незалежних вимірів небагато: індекс Artificial Analysis та окремі прогони ентузіастів. Якість російською й українською ніхто незалежно не вимірював — перевіряйте на своїх завданнях.
- «Мільйон токенів» — не для дому. Розтягування YaRN підтримують серверні рушії, і, за попередженням картки, воно може погіршувати роботу на коротких текстах. Локально тримайтеся в межах 262 тис.
- Неофіційні збірки. На Hugging Face багато «розцензурованих» (abliterated) і змішаних з іншими моделями версій. Це не Alibaba: ліцензія, якість і безпека в кожної свої.
- Приватність залежить від способу запуску. Локально дані не залишають комп’ютер. Через API запити йдуть провайдеру, і правила зберігання в кожного свої — їх варто прочитати до надсилання робочих документів.
Який квант брати під код, агентів, документи й чат
| Завдання | Що ставити | Режим міркування | Мінімум заліза |
|---|---|---|---|
| Код у редакторі, короткі завдання | UD-Q4_K_XL + файл MTP у llama.cpp або Ollama | medium або xhigh | 24 ГБ відеопам’яті або Mac 24 ГБ |
| Агенти й багатокрокові завдання | UD-Q4_K_XL або Q8_0, контекст від 64K | xhigh | 24 ГБ, краще 32 ГБ |
| Довгі документи до 262 тис. токенів | UD-Q4_K_XL, кеш q4_0, без MTP | low або без міркування | 24 ГБ (близько 47 ток/с) |
| Звичайний чат і переказ | Ollama qwen3.8:27b або MLX 4-біт | без міркування | 24 ГБ або Mac 24 ГБ |
| Скриншоти, схеми, документи із зображеннями | будь-який квант + файл mmproj | залежно від завдання | +0,86 ГіБ до обраного варіанта |
| Сервер для команди | vLLM з NVFP4 або FP8, MTP увімкнено | залежно від завдання | карта на 80 ГБ і більше: 540–710 ток/с на 16 користувачів |
Вердикт щодо заліза (який квант куди вміщується, розібрано вище в розділі про пам’ять):
- RTX 3060 12 ГБ і карти на 16 ГБ — запустити можна, але лише в 3–4 бітах; для щоденної роботи практичніша MoE-модель.
- RTX 4090 / 3090 на 24 ГБ і RTX 5090 на 32 ГБ — цільова сходинка: близько 100 ток/с з MTP на 4090 і 100–142 ток/с на 5090 за вимірами.
- Mac із 24–36 ГБ — MLX 4–5 біт, приблизно від 7 до 21 ток/с за обережною оцінкою залежно від чипа (у найкращому разі до 27).
- Mac Max із 48–128 ГБ — 6–8 біт і повний контекст. За вимірами в 4 бітах — 24,6 ток/с на M4 Max і до 36,6 на M5 Max; у 6 і 8 бітах M5 Max дає 26,2 і 20,1 ток/с.
Підсумок на 25 жовтня 2026 року. Самі ми модель не запускали, тому висновок зібрано з чотирьох критеріїв, за якими є відкриті дані. Якість — сильна сторона: 34 бали індексу Artificial Analysis, урівень із моделлю вдесятеро більшою. Ліцензія — без застережень, Apache 2.0. Пам’ять — добре: 4-бітний файл на 17,56 ГБ вміщується у відеокарту на 24 ГБ. Швидкість — головний мінус: за чужими вимірами 47 ток/с на RTX 4090 без MTP і 25–37 ток/с на M4 Max та M5 Max, а на базових і Pro-чипах Mac, за нашою оцінкою, 7–18 ток/с. Якість відповідей російською й українською ніхто не вимірював, тому до висновку вона не входить.
Плюси: 34 бали індексу Artificial Analysis — рівень DeepSeek V4 Flash, яка вдесятеро більша; Apache 2.0 без обмежень на комерцію; повноцінна робота на одній відеокарті на 24 ГБ; маленький KV-кеш і контекст 262 тис. удома; вбудоване MTP прискорює відповідь до двох разів; розуміє зображення й відео.
Мінуси: за замовчуванням занадто довго міркує; багатослівна й дорога через API в розрахунку на одне завдання; на Mac і слабких картах повільна, як будь-яка щільна модель; на 24 ГБ не можна поєднати MTP і довгий контекст; більшість бенчмарків — від самої Alibaba.
FAQ
Скільки відеопам’яті потрібно для Qwen 3.8 27B?
Для нормальної роботи — 24 ГБ: у них уміщується 4-бітний квант UD-Q4_K_XL (17,56 ГБ) із контекстом до 128 тис. за стиснутого кешу. На 16 ГБ модель запускається в 3 бітах або в UD-IQ4_XS із контекстом близько 28 тис. токенів. Без стиснення потрібно понад 54 ГБ, це вже рівень двох відеокарт або Mac із 64 ГБ.
Чи запуститься Qwen 3.8 27B на Mac із 16 ГБ пам’яті?
Запуститься, але з великими компромісами. macOS віддає графіці не всю пам’ять, тому вміщується лише 3-бітний файл UD-IQ3_XXS (10,93 ГБ) із контекстом близько 8 тис. токенів. Базовий M5 до того ж повільний: за нашою оцінкою, 7–9 токенів за секунду з 4-бітною збіркою, а для неї вже потрібен Mac на 24 ГБ. Тому розумний мінімум для цієї моделі — Mac із 24 ГБ і чипом рівня Pro або Max.
Чи можна використовувати Qwen 3.8 27B у комерційних проєктах безкоштовно?
Так. Офіційні ваги випущено під Apache 2.0: модель можна безкоштовно використовувати в комерційних продуктах, змінювати й поширювати. Потрібно зберегти текст ліцензії та позначити змінені файли. Сторонні збірки й «розцензуровані» версії з Hugging Face — окремі роботи, їхню ліцензію перевіряйте на сторінці репозиторію. Платити доведеться лише за залізо або за API провайдера.
Що краще для коду: Qwen 3.8 27B чи Gemma 4 31B?
За відкритими даними для коду сильніша Qwen 3.8 27B: 90,3 проти 80,0 на LiveCodeBench v6 і 89,2 проти 84,3 на GPQA Diamond. Обидві моделі вміщуються у відеокарту на 24 ГБ у 4 бітах. Застереження: це цифри з карток різних вендорів із різними умовами прогону, а для роботи з інструментами Google публікує в Gemma тест Tau2, якого немає в Qwen.
Чому Qwen 3.8 27B так довго думає і як це вимкнути?
За замовчуванням модель міркує на максимальній глибині xhigh і може витратити понад 20 тисяч токенів на просте завдання. Вимкнути міркування можна прапорцем --think=false в Ollama або параметром "enable_thinking": false в API. Для завдань із рахунком і логікою краще не вимикати його зовсім, а поставити reasoning_effort на low або medium.
Чи потягне Qwen 3.8 27B відеокарта RTX 3060 на 12 ГБ?
Повністю у відеопам’ять уміщується лише 3-бітний квант UD-IQ3_XXS, і то з контекстом близько 8 тисяч токенів. За оцінкою, це близько 22–27 токенів за секунду — вимірів на цій карті ми не знайшли. 4-бітний файл частково поїде у звичайну пам’ять, і швидкість упаде в рази. Для RTX 3060 практичніша менша модель або MoE.