
Коротко (TL;DR)
Это обзор Qwen 3.8 27B — открытой модели Alibaba, которую можно поставить на одну видеокарту на 24 ГБ или на Mac с 24–32 ГБ памяти. Qwen 3.8 27B вышла 14 августа 2026 года под лицензией Apache 2.0, понимает текст, картинки и видео. Своего запуска модели в этом материале нет: все замеры скорости чужие, с указанием автора и условий, а там, где замера нет, мы даём оценку по открытой формуле и так её и подписываем.
- Коротко (TL;DR)
- Словарь: кванты, VRAM, MTP и другие термины локального запуска
- Что такое Qwen 3.8 27B и чем она отличается от Qwen 3.6 27B
- Версии, размеры и лицензия Qwen 3.8 27B: что скачать
- Бенчмарки Qwen 3.8 27B: цифры Alibaba и независимый индекс
- Qwen 3.8 27B против Gemma 4 31B, Qwen 3.6 27B и Flash-Next
- Сколько памяти нужно Qwen 3.8 27B: кванты GGUF и MLX в гигабайтах
- Как запустить Qwen 3.8 27B: Ollama, LM Studio, llama.cpp и MLX
- Скорость на RTX 3060, 4090, 5090 и Mac с M4 и M5: замеры и оценки
- Режим xhigh у Qwen по умолчанию: как не ждать 21 минуту ответа
- Риски локальной 27B-модели Alibaba: когда она не подходит
- Какой квант брать под код, агентов, документы и чат
- FAQ
- Качество. Независимый индекс Artificial Analysis — 34 балла (33,70) на 25 октября 2026 года. Это уровень DeepSeek V4 Flash, у которой параметров в десять раз больше. У предшественницы Qwen 3.6 27B — 21,43.
- Память. Самый ходовой 4-битный файл UD-Q4_K_XL весит 17,56 ГБ. На 16 ГБ модель встаёт только в 3–4 битах с коротким контекстом.
- Скорость. RTX 4090 — 47 токенов в секунду без ускорения и около 109 с MTP; M5 Max — 36,6 в MLX на коротком ответе, M4 Max — 24,6. Замеры разных авторов, условия ниже.
- Главная ловушка. По умолчанию модель рассуждает на максимуме (
xhigh) и может думать 21 минуту над простой задачей. Первое, что стоит сделать после установки, — снизить глубину рассуждения или выключить его. - Кому подходит: код, агенты, длинные документы на своём железе без облака. Кому нет: владельцам ноутбуков без мощной видеокарты и Mac с 16 ГБ — им быстрее подойдёт MoE-модель.
- Итог на 25 октября 2026 года: качество на уровне модели в десять раз крупнее, открытая лицензия и реальный запуск на 24 ГБ; минусы — многословие и скорость плотной модели, особенно на Mac.
Словарь: кванты, VRAM, MTP и другие термины локального запуска
Без этих терминов дальше будет сложно — каждый объясняем одной строкой.
- Параметры (27B) — числа внутри нейросети, 27 миллиардов. Чем их больше, тем модель обычно умнее и тем больше памяти ей нужно.
- Плотная модель (dense) — на каждое слово работают все 27 млрд параметров сразу. Противоположность — MoE (mixture of experts, «смесь экспертов»): сеть разбита на части, и на каждое слово включается только небольшая доля.
- Квантование — сжатие модели: вместо 16 бит на параметр храним 4–8. Файл становится в разы легче, качество падает немного.
- GGUF и MLX — форматы сжатых файлов. GGUF читают llama.cpp, Ollama и LM Studio на любом компьютере, MLX — родной формат Apple для Mac.
- VRAM — память видеокарты. Модель должна поместиться в неё целиком, иначе часть уедет в обычную память и скорость упадёт в разы.
- Единая память Mac — у Apple процессор и графика делят одну память, поэтому Mac на 32 ГБ может отдать модели больше, чем видеокарта на 12 ГБ.
- Контекст и KV-кэш — контекст это объём текста, который модель держит в голове за раз; KV-кэш — память, куда она складывает уже прочитанное.
- Токен в секунду (ток/с) — скорость ответа. Токен — кусок слова; 20 ток/с читаются комфортно, 5 ток/с — уже медленно.
Что такое Qwen 3.8 27B и чем она отличается от Qwen 3.6 27B
Что это за модель? Qwen 3.8 27B — это плотная языковая модель команды Qwen из Alibaba на 27 млрд параметров со встроенным модулем зрения: она читает текст, изображения и видео, а отвечает текстом. Веса открыты под Apache 2.0, модель рассчитана на локальный запуск и на серверы. По умолчанию она сначала рассуждает, а потом отвечает.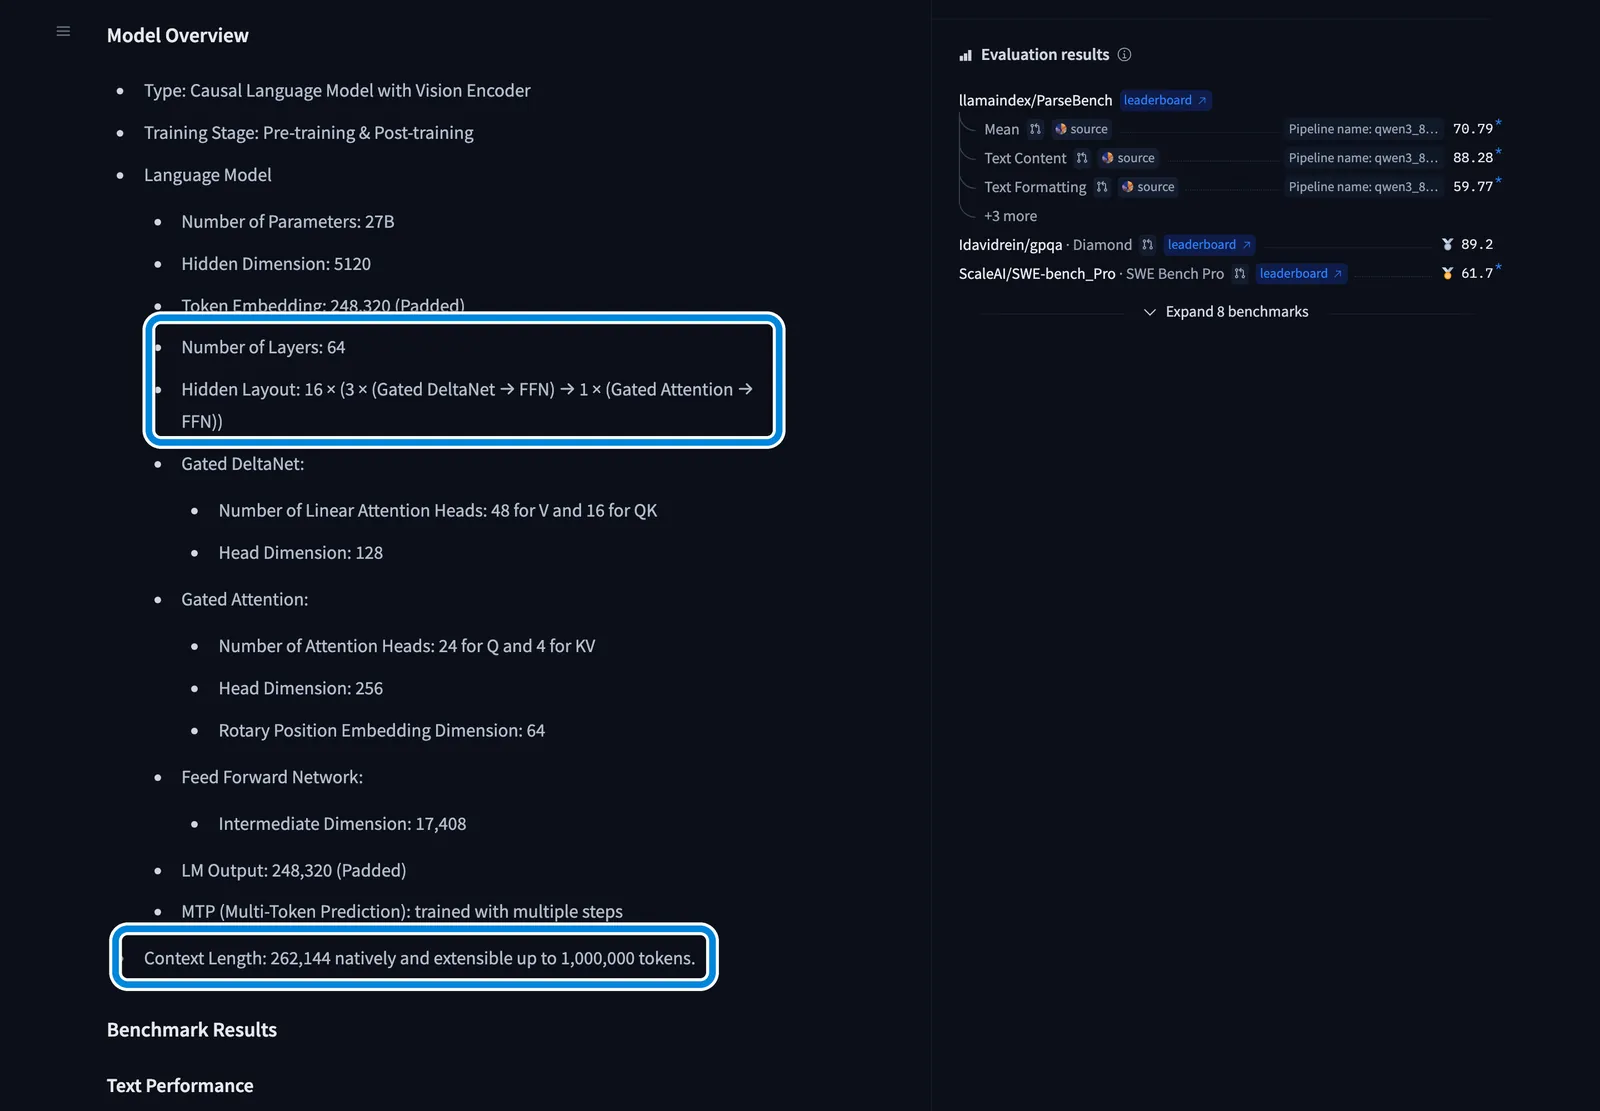
На кадре — официальная карточка модели на Hugging Face, снята 25 октября 2026 года. Рамки показывают две строки, которые объясняют почти всё про её аппетит к памяти.
- 64 слоя, но полное внимание только у 16. Схема
16 × (3 × Gated DeltaNet → 1 × Gated Attention)значит: на каждые четыре слоя три «линейных» (Gated DeltaNet) и один обычный. Линейный слой хранит сжатую сводку прочитанного фиксированного размера, а обычный помнит каждый токен. Поэтому KV-кэш растёт только в 16 слоях из 64 — он вчетверо меньше, чем у обычной модели такого размера. - Контекст 262 144 токена нативно. Цифру «до 1 млн» карточка даёт через растяжение YaRN в серверных движках vLLM, SGLang и TokenSpeed; дома ориентируйтесь на 262 тыс.
- Встроенное MTP (multi-token prediction, многотокенное предсказание) — дополнительная «голова», которая угадывает несколько следующих токенов. Из-за неё на одной и той же карте модель бывает вдвое быстрее, подробности — в разделе про скорость.
Прирост из дообучения: те же 64 слоя, другие цифры
Архитектура не изменилась: те же 64 слоя, тот же гибрид, тот же контекст, та же лицензия и тот же модуль зрения. Codersera сверила конфигурационные файлы двух моделей и пришла к выводу, что весь прирост дало дообучение, а не новая конструкция. Если вы уже разбирались с Qwen3 на своём ПК, Qwen 3.8 27B запустится теми же инструментами, нужны только свежие версии.
Что дал апгрейд, видно по цифрам:
- индекс Artificial Analysis v4.3.2 вырос с 21,43 до 33,70 (+12,3 балла) на 25 октября 2026 года;
- агентный тест DeepSWE 1.1 по данным Alibaba — с 13,3 до 42,2;
- компьютерное управление OSWorld-Verified — с 63,9 до 84,3 (тоже данные Alibaba).
Платит модель за это многословием. На прогон того же индекса Qwen 3.8 27B потратила 200 млн выходных токенов против 160 млн у Qwen 3.6 27B, а прогон одной задачи индекса через API обошёлся в $1,01 против $0,62. Дома вы платите не деньгами, а временем: каждый лишний токен рассуждения нужно сгенерировать.
Версии, размеры и лицензия Qwen 3.8 27B: что скачать
Alibaba выложила веса 14 августа 2026 года — эту дату подтверждают Artificial Analysis, DataNorth и OpenRouter. Модель называют «27B», хотя в официальном файле 27 781 427 952 параметра: сверх языковой части туда входят визуальный кодировщик и встроенная голова MTP.Вариант Кто публикует Вес Для чего BF16 (без сжатия) Qwen 54,66 ГБ в GGUF серверы с 64 ГБ+ памяти, дообучение FP8 Qwen ( Qwen/Qwen3.8-27B-FP8)28,5 ГиБ весов в vLLM (29,0 с MTP) сервер на одной большой карте NVFP4 NVIDIA, Unsloth 19,9 ГиБ весов в vLLM (20,8 с MTP) видеокарты RTX 50 и Blackwell: самый быстрый формат GGUF 2–8 бит Unsloth, ggml-org 7,27–29,05 ГБ llama.cpp, Ollama, LM Studio на любом ПК и Mac MLX 4/5/6/8 бит lmstudio-community, mlx-community 16,05–29,50 ГБ Mac на Apple M-чипах Ollama qwen3.8:27bOllama 17 ГБ в памяти (Q4_K_M) запуск одной командой, нужен Ollama 0.32.12+
Лицензия Apache 2.0 разрешает коммерческое использование, изменение и распространение. Условие одно: сохранить текст лицензии и пометить изменённые файлы. Апстрим-веса, GGUF от Unsloth и ggml-org и MLX-сборки lmstudio-community заявляют ту же лицензию. Сторонние «расцензуренные» версии (abliterated) и смеси с чужими моделями — отдельные работы: их лицензию и происхождение проверяйте на странице каждого репозитория.
Не путайте с соседями по линейке. Qwen3.8-Max — облачный флагман на 2,4 трлн параметров (MoE, около 95 млрд активных), домой его не поставить. Qwen3.8-Flash-Next — MoE на 125 млрд параметров с 6 млрд активных и отдельной лицензией qwen-community-1.0. Обе модели — не тот файл, о котором этот обзор.
Сколько стоит. Веса бесплатны. Если запускать не у себя, а через API, цена зависит от провайдера: Artificial Analysis считает по $0,50 за 1 млн входных и $3,00 за 1 млн выходных токенов, на OpenRouter у самого дешёвого провайдера на 25 октября 2026 года — от $0,02 и $0,50. Сама Alibaba модель тоже отдаёт: на OpenRouter среди провайдеров есть Alibaba Cloud International — $0,425 за 1 млн входных и $2,55 за 1 млн выходных токенов на 25 октября 2026 года.



Бенчмарки Qwen 3.8 27B: цифры Alibaba и независимый индекс
Бенчмарк — стандартный экзамен для моделей. Важно, кто его проводил: разработчик подбирает условия сам, независимая лаборатория гоняет всех одинаково. Поэтому ниже две отдельные картины.
Что заявляет Alibaba
По таблице разработчика Qwen 3.8 27B обходит предшественницу везде и местами — закрытую Claude Opus 4.6 Max. Но у этих цифр три оговорки, которые стоит знать до выводов.Тест Qwen 3.8 27B Qwen 3.6 27B Claude Opus 4.6 Max Gemma 4 31B LiveCodeBench v6 (олимпиадный код) 90,3 83,9 88,8 80,0 GPQA Diamond (наука) 89,2 87,8 91,3 84,3 SWE-bench Pro (правка репозиториев) 61,7 53,5 53,4 н/д Terminal Bench 2.1 (работа в терминале) 73,0 63,4 78,2 н/д HLE (трудные вопросы) 30,8 24,0 40,0 н/д IFBench (выполнение инструкций) 79,5 69,1 62,5 н/д
Данные вендоров: карточка Qwen/Qwen3.8-27B (14.08.2026) и карточка google/gemma-4-31B-it.
- SWE-bench Pro — разные версии теста в одной строке. Alibaba исправила проблемные задачи и перепрогнала свои модели на новой версии, а у Opus стоит официальный счёт на исходной. Победа 61,7 против 53,4 — не сравнение один к одному.
- Часть тестов — внутренние. QwenSWEBench и CoWorkBench Alibaba придумала и проводит сама.
- Gemma 4 — из другой карточки. Её цифры публикует Google со своими настройками прогона, поэтому разница с Qwen — ориентир, а не точный счёт.
Что показывает независимый индекс
Artificial Analysis — лаборатория, которая сама прогоняет модели через десять тестов (агентные задачи, код, наука, длинный контекст) и сводит их в один балл. На 25 октября 2026 года у Qwen 3.8 27B в режиме xhigh 34 балла индекса v4.3.2.
Плотная модель на 27 млрд параметров стоит вровень с GLM-5.2 и DeepSeek V4 Flash и выше закрытой Claude Opus 4.6. Цена задачи при этом у неё одна из самых высоких в группе.Модель Индекс AA v4.3.2 Цена одной задачи индекса DeepSeek V4 Flash 0731 (Max), MoE 284B 34,33 $0,22 GLM-5.2 (Max) 33,71 $1,47 Qwen 3.8 27B (xhigh) 33,70 $1,01 Claude Opus 4.6 (Max) 31,95 $0,06 Qwen 3.6 27B (reasoning) 21,43 $0,62
Artificial Analysis, страница модели и сводка Codersera со ссылкой на AA; на 25.10.2026.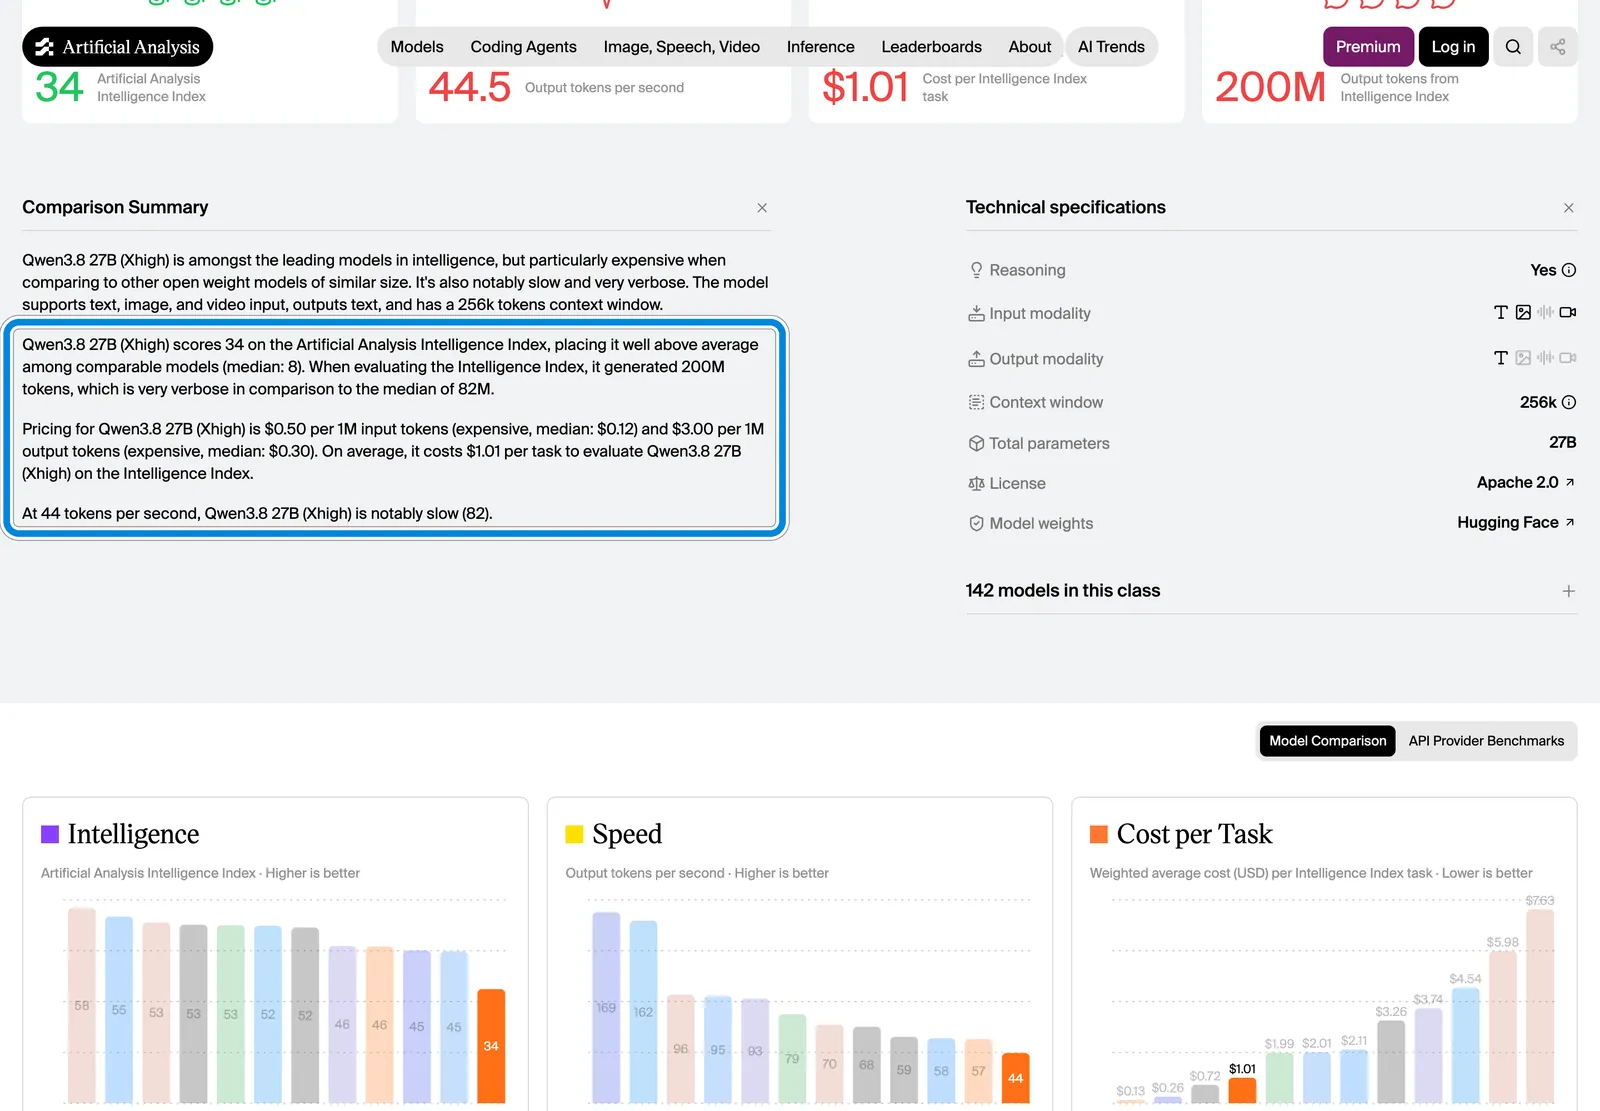
Кадр снят 25 октября 2026 года. В рамке — сводка лаборатории: индекс 34, 200 млн выходных токенов на прогон при медиане 82 млн и скорость 44 токена в секунду через API. Сама лаборатория называет модель «очень многословной» и «заметно медленной».
Откуда в обзорах «52 балла». В августе модель получила 52 балла по прошлой версии индекса v4.1.1. Потом Artificial Analysis пересчитала индекс на новом наборе тестов, и все модели получили новые баллы. Сравнивать 52 и 34 нельзя: это разные шкалы, а не падение качества. В тексте выше — только текущая версия.
Qwen 3.8 27B против Gemma 4 31B, Qwen 3.6 27B и Flash-Next
Главный выбор при локальном запуске — плотная модель или MoE. Плотная читает из памяти все свои параметры на каждый токен, поэтому она медленнее, но стабильнее в длинных задачах. MoE хранит много параметров, а работает малой их частью: отвечает быстрее, но памяти требует как большая модель.Qwen 3.8 27B Gemma 4 31B Qwen 3.6 27B Qwen3.8-Flash-Next Тип плотная плотная плотная MoE Параметры 27 млрд 30,7 млрд 27 млрд 125 млрд, 6 млрд активных Лицензия Apache 2.0 Apache 2.0 Apache 2.0 qwen-community-1.0 Контекст 262 тыс. 256 тыс. 262 тыс. 262 тыс. 4-бит в Ollama 18 ГБ 19 ГБ н/д не помещается в 24 ГБ GPQA Diamond 89,2 84,3 87,8 91,7 LiveCodeBench v6 90,3 80,0 83,9 91,9 Индекс AA v4.3.2 33,70 н/д 21,43 н/д
Бенчмарки — из карточек вендоров (Flash-Next и Gemma — по сводке BetterClaw), на 25.10.2026. У Flash-Next 125 млрд параметров: даже в 4 битах это не меньше 63 ГБ весов (125 млрд × 0,5 байта), в одну видеокарту на 24 ГБ модель не помещается.
Qwen 3.8 27B vs Gemma 4 31B: что выбрать для кода и агентов
На двух тестах, которые есть в обеих карточках, впереди Qwen 3.8 27B: 89,2 против 84,3 на GPQA Diamond и 90,3 против 80,0 на LiveCodeBench v6. Разница в коде — около десяти пунктов, это самый большой отрыв. Обе модели помещаются в видеокарту на 24 ГБ в 4 битах: в Ollama Qwen весит 18 ГБ, Gemma — 19 ГБ.
У Gemma свой козырь: Google публикует для 31B результат 76,9% на Tau2 — тесте на работу с инструментами в диалоге, — а Qwen этот тест не приводит. Сравнить их напрямую в агентных сценариях по открытым данным нельзя. Подробнее о второй модели — в разборе Gemma 3 и Gemma 4 на своём ПК.
Вывод: для кода и многошаговых задач на 24 ГБ — Qwen 3.8 27B. Если нужна модель поменьше для карты на 16 ГБ, в семействе Gemma 4 есть MoE 26B A4B с 3,8 млрд активных параметров — на слабом железе она отвечает заметно быстрее.
Против Qwen3.8-Flash-Next: скорость или надёжность
Flash-Next быстрее за счёт 6 млрд активных параметров, но ей нужна память как у модели на 125 млрд. В тесте MindStudio на сборке из четырёх RTX 3090 плотная Qwen 3.8 27B в FP16 довела до конца двухдневную сессию агентного программирования, а Flash-Next в INT4 — нет. Это одна демонстрация, а не бенчмарк, но она совпадает с логикой архитектур: плотная модель реже сбивается на длинной дистанции. Для живого чата, где важна скорость и разнообразие ответов, автор того же теста предпочитает Flash-Next.
Что не берём в сравнение. Qwen3 32B — прошлое поколение, прямая предшественница этой модели — Qwen 3.6 27B.
Сколько памяти нужно Qwen 3.8 27B: кванты GGUF и MLX в гигабайтах
Сколько весит Qwen 3.8 27B? Без сжатия — 54,66 ГБ, в ходовом 4-битном кванте UD-Q4_K_XL — 17,56 ГБ, в 4-битной сборке MLX для Mac — 16,05 ГБ. К весу файла добавьте KV-кэш под контекст и запас около 1 ГБ: столько llama.cpp по умолчанию оставляет свободным, чтобы не упасть при загрузке.
Одинаковое имя кванта у разных авторов не гарантирует одинаковый файл: Q4_K_M от ggml-org на 2,5 ГБ тяжелее UD-Q4_K_M от Unsloth. Сравнивайте файлы по размеру, а не по названию.Квант Qwen 3.8 27B GGUF / MLX Файл, ГБ Минимум памяти Для чего UD-IQ2_XXS 7,27 12 ГБ эксперимент: качество заметно падает UD-IQ3_XXS 10,93 12 ГБ RTX 3060 12 ГБ, Mac 16 ГБ с контекстом 8K UD-Q3_K_XL 13,15 16 ГБ карты на 16 ГБ: контекст до 32K UD-IQ4_XS 14,25 16 ГБ единственный 4-бит для 16 ГБ, контекст около 28K MLX 4-бит 16,05 Mac 24 ГБ основной выбор для Mac UD-Q4_K_XL 17,56 24 ГБ основной выбор для RTX 4090 и 3090 UD-Q5_K_M 19,77 24 ГБ чуть точнее, контекст 32–64K UD-Q6_K 21,98 32 ГБ RTX 5090, Mac 32–36 ГБ Q8_0 29,05 32 ГБ+ почти без потерь; RTX 5090 с контекстом 32K BF16 54,66 64 ГБ+ без сжатия
Размеры — байты Hugging Face API по сводке TechPlained; минимумы — расчёт «файл + KV-кэш + 1 ГБ», на 25.10.2026.
Сколько памяти съедает контекст
Благодаря тому, что полное внимание есть только в 16 слоях из 64, кэш у Qwen 3.8 27B маленький: 64 КиБ на токен в формате f16. Длинный контекст на одной видеокарте становится реальным.Контекст KV-кэш f16 q8_0 q4_0 Если бы все 64 слоя были полными 8 тыс. токенов 0,50 ГиБ 0,27 ГиБ 0,14 ГиБ 2 ГиБ 32 тыс. 2,00 ГиБ 1,06 ГиБ 0,56 ГиБ 8 ГиБ 64 тыс. 4,00 ГиБ 2,13 ГиБ 1,13 ГиБ 16 ГиБ 131 тыс. 8,00 ГиБ 4,25 ГиБ 2,25 ГиБ 32 ГиБ 262 тыс. 16,00 ГиБ 8,50 ГиБ 4,50 ГиБ 64 ГиБ
Расчёт по config.json модели (TechPlained): 2 × 16 слоёв × 4 головы × 256 × 2 байта = 64 КиБ на токен. q8_0 и q4_0 — сжатие самого кэша.
Что помещается в 12, 16, 24, 32 и 48 ГБ памяти
Требования Qwen 3.8 27B к железу удобнее читать ступенями — от того, сколько памяти у вас уже есть:
- 12 ГБ (RTX 3060). Целиком в видеокарту влезает только 3-битный UD-IQ3_XXS: 10,18 ГиБ весов + 0,5 ГиБ кэша на 8K + 1 ГиБ запаса = 11,7 ГиБ из 12. Это впритык и с коротким контекстом. 4-битный файл придётся частично держать в обычной памяти, а там скорость падает в разы.
- 16 ГБ (RTX 5080, RTX 5060 Ti 16 ГБ). UD-Q3_K_XL с контекстом 32K или UD-IQ4_XS с контекстом около 28K. Работает, но 3 бита — компромисс по качеству.
- 24 ГБ (RTX 4090, RTX 3090). UD-Q4_K_XL с контекстом до 128K при сжатом кэше или UD-Q5_K_M с контекстом 32–64K. Это та ступень, под которую модель задумана: Unsloth прямо пишет, что 4-битные кванты работают на 16–19 ГБ видеопамяти.
- 32 ГБ (RTX 5090). Q8_0 с контекстом 32K или UD-Q6_K_XL с контекстом 64K. Почти без потерь качества.
- 48 ГБ и больше. Q8_0 с полным контекстом 262 тыс. в f16. Такой объём дают и две RTX 3090 в одной сборке.
На Mac модели доступна не вся память: macOS отдаёт графике только часть, остальное держит за системой и программами. Поэтому Mac на 16 ГБ — это 3 бита и контекст 8K, на 24 ГБ — MLX 4-бит с контекстом 32K, на 32–36 ГБ — MLX 5-бит, на 48 ГБ — MLX 6-бит или 8-бит с коротким контекстом, на 64 ГБ и больше — 8 бит с полным контекстом. Как macOS делит память между системой и графикой, разобрано в материале про единую память Mac для ИИ.
Модуль зрения хранится отдельным файлом (mmproj) и добавляет около 0,86 ГиБ. Если картинки не нужны, его можно не загружать и вернуть эту память под контекст.
Как запустить Qwen 3.8 27B: Ollama, LM Studio, llama.cpp и MLX
Четыре популярных способа — от одной команды до полного контроля над памятью. Чем они отличаются между собой в целом, мы разбирали в сравнении Ollama, LM Studio и llama.cpp. Ниже — что важно именно для Qwen 3.8 27B.
Ollama: запуск одной командой
- Обновите Ollama до версии 0.32.12 или новее — на старых модель не загрузится.
- Скачайте модель:
ollama pull qwen3.8:27b. Это квант Q4_K_M, в памяти он занимает около 17 ГБ. MTP в этом теге уже включён: Ollama заранее угадывает четыре токена. - Проверьте, что всё работает, с выключенным рассуждением:
ollama run qwen3.8:27b --verbose --think=false "В одном предложении: что делает OOM killer в Linux?"
- Задайте контекст. По умолчанию Ollama выбирает его по объёму видеопамяти: 4K на картах меньше 24 ГиБ, 32K — от 24 до 48 ГиБ. Для кода и агентов рекомендуют от 64K:
OLLAMA_CONTEXT_LENGTH=65536 ollama serve. - Нужен контекст 131K на 24 ГБ — сожмите кэш. В настройках службы добавьте
OLLAMA_FLASH_ATTENTION=1иOLLAMA_KV_CACHE_TYPE=q4_0. В замере ComputingForGeeks на RTX 4090 без этого модель при 131K частично уезжала в обычную память и выдавала 16,4 ток/с, со сжатым кэшем — 101,8 ток/с целиком на видеокарте.
Проверить, не уехала ли модель на процессор, можно командой ollama ps: в колонке размещения должно стоять 100% GPU.
LM Studio: с интерфейсом или из терминала
- Скачайте модель:
lms get qwen/qwen3.8-27b. На Mac добавьте флаг--mlx, чтобы получить сборку в родном формате Apple. - Загрузите её с нужным контекстом:
lms load qwen/qwen3.8-27b --gpu=max --context-length=32768. - Запустите локальный сервер, совместимый с API OpenAI:
lms server start.
LM Studio указывает 16 ГБ как минимальный объём памяти для этой модели. На практике это 3–4 бита и короткий контекст.
llama.cpp: максимальная скорость с MTP
llama.cpp даёт полный контроль: какой квант, как сжать кэш и подключать ли MTP. Готовые сборки под CUDA лежат на нумерованных релизах (b11200 и новее) — тег «latest» на момент проверки ComputingForGeeks указывал на версию без бинарников.
- Скачайте 4-битный квант и отдельный файл MTP:
hf download unsloth/Qwen3.8-27B-GGUF Qwen3.8-27B-UD-Q4_K_XL.gguf --local-dir ~/lcpp/gguf
hf download unsloth/Qwen3.8-27B-GGUF --include "MTP/*" --local-dir ~/lcpp/gguf
- Для коротких диалогов и кода — запуск с MTP (файл ускорителя весит 1,4 ГБ):
llama-server -ngl 99 -fa on -c 8192 --jinja \
  -m gguf/Qwen3.8-27B-UD-Q4_K_XL.gguf \
  --spec-type draft-mtp -md gguf/MTP/mtp-Qwen3.8-27B-Q4_0.gguf -ngld 99
- Для длинных документов — без MTP и со сжатым кэшем. На RTX 4090 только так открылся полный контекст 262 144:
llama-server -ngl 99 -fa on -c 262144 -ctk q4_0 -ctv q4_0 --jinja \
  -m gguf/Qwen3.8-27B-UD-Q4_K_XL.gguf
Если сервер пишет failed to create MTP context, значит MTP и контекст не помещаются вместе: уменьшите -c или уберите параметры --spec-type и -md.
MLX на Mac
Модель понимает картинки, поэтому MLX-сборки сделаны через mlx-vlm:
pip install -U mlx-vlm
mlx_vlm.server --model lmstudio-community/Qwen3.8-27B-MLX-5bit --enable-thinking
В примере — 5-битная сборка для Mac на 32–36 ГБ; на 24 ГБ берите 4-битную из того же набора lmstudio-community. Обратите внимание: в сервере mlx-vlm рассуждение по умолчанию выключено, флаг --enable-thinking его включает. Это противоположно остальным инструментам.
Скорость на RTX 3060, 4090, 5090 и Mac с M4 и M5: замеры и оценки
Почему скорость плотной модели предсказуема? Чтобы выдать один токен, чип читает из памяти весь файл весов. Значит, потолок скорости — это пропускная способность памяти (сколько гигабайт в секунду она отдаёт), делённая на размер файла. Реальная скорость ниже потолка на потери движка.
Проверим формулу на трёх замерах:
- RTX 4090: 1008 ГБ/с ÷ 17,56 ГБ = 57,4 ток/с потолок. ComputingForGeeks намерила 47,0 ток/с в llama.cpp b11200 на ответе в 512 токенов — это 82% потолка.
- M4 Max с 40 ядрами графики: 546 ГБ/с ÷ 16,05 ГБ = 34,0 ток/с потолок. Weschera намерила 24,6 ток/с без MTP в oMLX: 4-битный квант, ответ на 320 токенов, три прогона. Это 72% потолка.
- M5 Max с 40 ядрами графики: 614 ГБ/с ÷ 16,05 ГБ = 38,3 ток/с потолок. PocketAI намерила 36,6 ток/с в MLX, это 96% потолка. Но это лучший случай: один прогон и ответ всего в 9 токенов. Simon Willison в LM Studio получал 15–30 ток/с.
Для видеокарт NVIDIA мы применили долю 0,82, для Mac — осторожную 0,72 по замеру M4 Max. Верхняя граница в таблице посчитана по 0,96. Получились оценки, а не замеры, — на графике они заштрихованы.
Видеокарты NVIDIA быстрее любого Mac за счёт пропускной способности памяти: у RTX 5090 это 1792 ГБ/с, у самого быстрого M5 Max — 614 ГБ/с. Зато Mac берёт объёмом: на 64–128 ГБ единой памяти модель встаёт в 8 битах с полным контекстом.Железо Квант и движок Без MTP, ток/с С MTP, ток/с Что это за цифра RTX 3060 12 ГБ (360 ГБ/с) UD-IQ3_XXS, llama.cpp ≈ 22–27 — оценка (потолок 33) н/д оценка по формуле RTX 4090 24 ГБ UD-Q4_K_XL, llama.cpp b11200, 8K 47,0 109,4 замер ComputingForGeeks, 27.09.2026 RTX 4090 24 ГБ Ollama qwen3.8:27b47,7 95,5 замер ComputingForGeeks, 27.09.2026 RTX 5090 32 ГБ UD-Q4_K_XL ≈ 84 — оценка (потолок 102) н/д оценка по формуле RTX 5090 32 ГБ UD-Q5_K_XL, контекст 125K н/д 120 замер автора Хабра, 14.08.2026 RTX 5090 32 ГБ UD-Q6_K_XL, контекст 48K н/д 100 замер автора Хабра, 14.08.2026 RTX 5090 32 ГБ NVFP4, llama.cpp 10479 н/д 142 в среднем замер DataCamp, 25.08.2026 M5, 24–32 ГБ (153 ГБ/с) MLX 4-бит ≈ 7–9 — оценка (потолок 9,5) н/д оценка по формуле M4 Pro (273 ГБ/с) MLX 4-бит ≈ 12–16 — оценка (потолок 17) н/д оценка по формуле M5 Pro (307 ГБ/с) MLX 4-бит ≈ 14–18 — оценка (потолок 19) н/д оценка по формуле M5 Max, 32 GPU, 36 ГБ (460 ГБ/с) MLX 4-бит ≈ 21–27 — оценка (потолок 29) н/д оценка по формуле M4 Max, 40 GPU, 128 ГБ (546 ГБ/с) oMLX 0.6.3rc2, квант oQ4e; MTP k=3 + Neural Engine 24,6 53,3 текст / 72,1 код замер Weschera, 21.08.2026, 3 прогона M5 Max, 40 GPU, 128 ГБ (614 ГБ/с) MLX 4-бит, mlx-vlm 0.6.8 36,6 н/д замер PocketAI, один прогон, ответ 9 токенов
Пропускная способность: Apple (спецификации MacBook Pro), NVIDIA через сводку TechPlained. У RTX 3060 на странице NVIDIA указаны только 12 ГБ GDDR6 и шина 192 бита, поэтому 360 ГБ/с — расчёт: 192 бита × 15 Гбит/с ÷ 8. Для неё оценка дана диапазоном: 3-битные i-кванты сложнее распаковывать, и доля 0,82 от 4-битного файла на 4090 переносится с натяжкой. Замеры M5 Max и M4 Max — по одному источнику каждый. 53–72 ток/с на M4 Max — заслуга MTP и Neural Engine в oMLX; обычный llama.cpp так не разгоняется.
Откуда берётся «вдвое быстрее» с MTP
Обычный движок выдаёт один токен за один проход по весам. MTP работает как черновик с проверкой: встроенная «голова» быстро предлагает несколько следующих токенов, а основная модель проверяет их все за один проход. Угадала — получили несколько токенов по цене одного. Не угадала — выбрасываем черновик и идём дальше обычным шагом.
Поэтому ускорение зависит от того, насколько текст предсказуем:
- в замере ComputingForGeeks на RTX 4090 модель приняла 1034 токена черновика из 1493 (69%) — скорость выросла с 47,0 до 109,4 ток/с;
- у Weschera на M4 Max черновик на коде принимался в 99,6% случаев, на обычном тексте — в 78%, отсюда 72,1 против 53,3 ток/с;
- в целом ComputingForGeeks видит ускорение в 1,6–2,3 раза на всех движках — но только для одного пользователя. Когда сервер обслуживает 16 запросов сразу, прирост падает до 0–28%.
Подвох на 24 ГБ: MTP и длинный контекст вместе не помещаются. На RTX 4090 приходится выбирать: около 110 ток/с при контексте до 8K или около 47 ток/с с контекстом до 262 тыс. Все попытки совместить MTP и контекст от 64K заканчивались ошибкой при запуске или на первом запросе.
Вирусные «168 ток/с на M5 Max» — это не замер
В обсуждениях гуляет цифра 168 токенов в секунду на M5 Max. Её источник — README проекта lithos-metal, и там она прямо названа проекцией: расчёт на контексте в 128 токенов при условии, что за каждый проход принимаются шесть токенов черновика, без учёта времени на сам черновик. Реальные замеры на M5 Max скромнее: 36,6 ток/с без MTP у PocketAI на коротком ответе и 15–30 ток/с у Simon Willison в LM Studio.
Почему ответ начинается с паузы: скорость чтения запроса
Перед генерацией модель читает ваш запрос — это отдельный этап, и он упирается не в память, а в вычислительную мощность. RTX 4090 читает 2600–3000 токенов запроса в секунду, M5 Max в MLX — 733, M4 Max со стеком Weschera — 273,7. Для длинного документа на 100 тыс. токенов на Mac это уже минуты ожидания до первого слова ответа (оценка по этим скоростям).
Если вы ещё выбираете компьютер под такие модели, сравнение чипов, памяти и цен собрано в хабе Какой Mac выбрать.
Режим xhigh у Qwen по умолчанию: как не ждать 21 минуту ответа
Qwen 3.8 27B рассуждает перед ответом, и по карточке модели глубина рассуждения по умолчанию — максимальная, xhigh. Simon Willison, разработчик и автор популярного блога об ИИ, 16 августа 2026 года опубликовал первые тесты: он гонял модель на MacBook Pro с M5 Max на 128 ГБ и на NVIDIA DGX Spark, в LM Studio с квантом Q4_K_M на 17 ГБ. Его фирменный тест — нарисовать в SVG пеликана на велосипеде — занял 21 минуту: 22 276 токенов рассуждения ради 3223 токенов результата. Без рассуждения похожий ответ на 3715 токенов пришёл за 137 секунд.
Это один промпт, а не бенчмарк, но по нему видна арифметика. На базовом M5 с оценочной скоростью 7–9 ток/с те же 22 276 токенов рассуждения заняли бы от 40 до 55 минут (22 276 ÷ 9,2…6,9 ≈ 2420–3230 секунд — оценка).Режим Что делает Когда включать Как включить xhighмаксимальная глубина рассуждения, много токенов сложный код, многошаговые задачи по умолчанию в vLLM и по карточке модели mediumбаланс точности и скорости повседневная работа на медленном железе по умолчанию в Ollama; --reasoning-effort medium в llama-serverlowкороткое рассуждение быстрые ответы с логикой и счётом "chat_template_kwargs": {"reasoning_effort": "low"}без рассуждения отвечает сразу чат, пересказ, извлечение данных --think=false в Ollama, "enable_thinking": false в API
Пример запроса к локальному серверу с низкой глубиной рассуждения:
curl -s localhost:8000/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "model": "qwen3.8-27b",
  "messages": [{"role": "user", "content": "Сколько простых чисел между 100 и 130?"}],
  "max_tokens": 8192,
  "chat_template_kwargs": {"reasoning_effort": "low"}
}'
Выключать рассуждение совсем стоит не везде. ComputingForGeeks задала модели именно этот вопрос (правильный ответ — шесть: 101, 103, 107, 109, 113, 127). Без рассуждения модель за 0,1 секунды ответила «13» — неверно. На low она рассуждала 516 токенов и ответила верно за 3 секунды, на xhigh — 345 токенов и тоже верно за 2,5 секунды. Правило простое: для чата и извлечения данных рассуждение выключаем, для всего, где есть счёт или логика, оставляем хотя бы low.
Ещё одна настройка — preserve_thinking. По умолчанию модель хранит в контексте рассуждения из всех прошлых сообщений: агентам это помогает не терять нить, но контекст заполняется быстрее. Для обычного чата это поведение можно выключить. Рекомендованные карточкой параметры генерации: для режима рассуждения temperature=1.0, top_p=0.95, top_k=20; без рассуждения — temperature=0.7, top_p=0.80, presence_penalty=1.5.
Риски локальной 27B-модели Alibaba: когда она не подходит
- Слабое железо — медленно. Плотная модель читает все параметры на каждый токен. На ноутбуке с памятью около 100 ГБ/с Codersera видит около 4 ток/с, на одном процессоре — около 1 ток/с. Для такого железа быстрее MoE: Qwen 3.6 35B-A3B с 3 млрд активных параметров на процессоре работает примерно в пять раз быстрее.
- Многословие стоит времени и денег. 200 млн выходных токенов на прогон индекса при медиане 82 млн. Через API задача обходится в $1,01 — DeepSeek V4 Flash с тем же баллом берёт $0,22 (на 25 октября 2026 года).
- 12 и 16 ГБ — компромисс по качеству. 3 бита помещаются, но отвечают хуже 4-битной версии. Unsloth публикует графики потерь по каждому кванту; если 3-битный результат не устраивает, лечится это памятью, а не другим 3-битным файлом.
- Бенчмарки в основном от вендора. Независимых замеров немного: индекс Artificial Analysis и отдельные прогоны энтузиастов. Качество на русском и украинском никто независимо не измерял — проверяйте на своих задачах.
- «Миллион токенов» — не для дома. Растяжение YaRN поддерживают серверные движки, и, по предупреждению карточки, оно может ухудшать работу на коротких текстах. Локально держитесь в пределах 262 тыс.
- Неофициальные сборки. На Hugging Face много «расцензуренных» (abliterated) и смешанных с другими моделями версий. Это не Alibaba: лицензия, качество и безопасность у каждой свои.
- Приватность зависит от способа запуска. Локально данные не покидают компьютер. Через API запросы уходят провайдеру, и правила хранения у каждого свои — их стоит прочитать до отправки рабочих документов.
Какой квант брать под код, агентов, документы и чат
| Задача | Что ставить | Режим рассуждения | Минимум железа |
|---|---|---|---|
| Код в редакторе, короткие задачи | UD-Q4_K_XL + файл MTP в llama.cpp или Ollama | medium или xhigh | 24 ГБ видеопамяти или Mac 24 ГБ |
| Агенты и многошаговые задачи | UD-Q4_K_XL или Q8_0, контекст от 64K | xhigh | 24 ГБ, лучше 32 ГБ |
| Длинные документы до 262 тыс. токенов | UD-Q4_K_XL, кэш q4_0, без MTP | low или без рассуждения | 24 ГБ (около 47 ток/с) |
| Обычный чат и пересказ | Ollama qwen3.8:27b или MLX 4-бит | без рассуждения | 24 ГБ или Mac 24 ГБ |
| Скриншоты, схемы, документы с картинками | любой квант + файл mmproj | по задаче | +0,86 ГиБ к выбранному варианту |
| Сервер для команды | vLLM с NVFP4 или FP8, MTP включён | по задаче | карта на 80 ГБ и больше: 540–710 ток/с на 16 пользователей |
Вердикт по железу (какой квант куда помещается, разобрано выше в разделе про память):
- RTX 3060 12 ГБ и карты на 16 ГБ — запустить можно, но только в 3–4 битах; для ежедневной работы практичнее MoE-модель.
- RTX 4090 / 3090 на 24 ГБ и RTX 5090 на 32 ГБ — целевая ступень: около 100 ток/с с MTP на 4090 и 100–142 ток/с на 5090 по замерам.
- Mac с 24–36 ГБ — MLX 4–5 бит, примерно от 7 до 21 ток/с по осторожной оценке в зависимости от чипа (в лучшем случае до 27).
- Mac Max с 48–128 ГБ — 6–8 бит и полный контекст. По замерам в 4 битах — 24,6 ток/с на M4 Max и до 36,6 на M5 Max; в 6 и 8 битах M5 Max даёт 26,2 и 20,1 ток/с.
Итог на 25 октября 2026 года. Сами мы модель не запускали, поэтому вывод собран из четырёх критериев, по которым есть открытые данные. Качество — сильная сторона: 34 балла индекса Artificial Analysis, вровень с моделью в десять раз крупнее. Лицензия — без оговорок, Apache 2.0. Память — хорошо: 4-битный файл на 17,56 ГБ помещается в видеокарту на 24 ГБ. Скорость — главный минус: по чужим замерам 47 ток/с на RTX 4090 без MTP и 25–37 ток/с на M4 Max и M5 Max, а на базовых и Pro-чипах Mac, по нашей оценке, 7–18 ток/с. Качество ответов на русском и украинском никто не измерял, поэтому в вывод оно не входит.
Плюсы: 34 балла индекса Artificial Analysis — уровень DeepSeek V4 Flash, которая в десять раз крупнее; Apache 2.0 без ограничений на коммерцию; полноценная работа на одной видеокарте на 24 ГБ; маленький KV-кэш и контекст 262 тыс. дома; встроенное MTP ускоряет ответ до двух раз; понимает картинки и видео.
Минусы: по умолчанию слишком долго рассуждает; многословна и дорога через API за задачу; на Mac и слабых картах медленная, как любая плотная модель; на 24 ГБ нельзя совместить MTP и длинный контекст; большая часть бенчмарков — от самой Alibaba.
FAQ
Сколько видеопамяти нужно для Qwen 3.8 27B?
Для нормальной работы — 24 ГБ: в них помещается 4-битный квант UD-Q4_K_XL (17,56 ГБ) с контекстом до 128 тыс. при сжатом кэше. На 16 ГБ модель запускается в 3 битах или в UD-IQ4_XS с контекстом около 28 тыс. токенов. Без сжатия нужно больше 54 ГБ, это уже уровень двух видеокарт или Mac с 64 ГБ.
Запустится ли Qwen 3.8 27B на Mac с 16 ГБ памяти?
Запустится, но с большими компромиссами. macOS отдаёт графике не всю память, поэтому влезает только 3-битный файл UD-IQ3_XXS (10,93 ГБ) с контекстом около 8 тыс. токенов. Базовый M5 к тому же медленный: по нашей оценке, 7–9 токенов в секунду с 4-битной сборкой, а для неё уже нужен Mac на 24 ГБ. Поэтому разумный минимум для этой модели — Mac с 24 ГБ и чипом уровня Pro или Max.
Можно ли использовать Qwen 3.8 27B в коммерческих проектах бесплатно?
Да. Официальные веса выпущены под Apache 2.0: модель можно бесплатно использовать в коммерческих продуктах, изменять и распространять. Нужно сохранить текст лицензии и пометить изменённые файлы. Сторонние сборки и «расцензуренные» версии с Hugging Face — отдельные работы, их лицензию проверяйте на странице репозитория. Платить придётся только за железо или за API провайдера.
Что лучше для кода: Qwen 3.8 27B или Gemma 4 31B?
По открытым данным для кода сильнее Qwen 3.8 27B: 90,3 против 80,0 на LiveCodeBench v6 и 89,2 против 84,3 на GPQA Diamond. Обе модели помещаются в видеокарту на 24 ГБ в 4 битах. Оговорка: это цифры из карточек разных вендоров с разными условиями прогона, а для работы с инструментами Google публикует у Gemma тест Tau2, которого нет у Qwen.
Почему Qwen 3.8 27B так долго думает и как это отключить?
По умолчанию модель рассуждает на максимальной глубине xhigh и может потратить больше 20 тысяч токенов на простую задачу. Отключить рассуждение можно флагом --think=false в Ollama или параметром "enable_thinking": false в API. Для задач со счётом и логикой лучше не выключать его совсем, а поставить reasoning_effort на low или medium.
Потянет ли Qwen 3.8 27B видеокарта RTX 3060 на 12 ГБ?
Целиком в видеопамять помещается только 3-битный квант UD-IQ3_XXS, и то с контекстом около 8 тысяч токенов. По оценке, это около 22–27 токенов в секунду — замеров на этой карте мы не нашли. 4-битный файл частично уедет в обычную память, и скорость упадёт в разы. Для RTX 3060 практичнее модель поменьше или MoE.