Qwen 3.6 35B-A3B коротко: вердикт, память и скорость
Qwen 3.6 35B-A3B — открытая MoE-модель Alibaba, выложенная в апреле 2026 года под лицензией Apache 2.0. Главное, что о ней нужно знать до скачивания: считает она как маленькая модель на 3 млрд параметров, а хранит в памяти все 35 млрд. Поэтому вопрос «потянет ли моё железо» здесь сводится не к мощности, а к объёму памяти.
- Qwen 3.6 35B-A3B коротко: вердикт, память и скорость
- Что такое Qwen 3.6 35B-A3B и чем MoE отличается от обычной модели
- Версии, размеры и лицензия Qwen 3.6: что скачивать
- Бенчмарки Qwen 3.6 35B-A3B: цифры Alibaba и независимые проверки
- Сколько памяти нужно MoE-модели на 35B: вес файла по квантам
- Как запустить Qwen 3.6 дома: Ollama, LM Studio, llama.cpp и MLX
- Скорость генерации на RTX и Apple M: замеры и оценки
- Почему MoE быстрая на Mac и слабой карте: расчёт по памяти
- Qwen 3.6 35B-A3B против Qwen 3.8 27B, gpt-oss-20b и Gemma 4
- Когда Qwen 3.6 35B-A3B не подойдёт: петли, инструменты, язык
- Какую сборку Qwen 3.6 выбрать: код, агент, ноутбук, слабая карта
- FAQ
Сами мы модель не запускали. Цифры скорости ниже — замеры других людей, у каждого указаны источник, метод и дата. Где замера нет, стоит оценка по открытой формуле, и она так и подписана.
- Что это. Модель со «смесью экспертов» (MoE): 35 млрд параметров всего, из них на каждый токен работают около 3 млрд. Понимает текст, картинки и видео, контекст — 262 144 токена.
- Память. 4-битный файл весит 21,2–24 ГБ в зависимости от сборки. Видеокарте на 24 ГБ хватает впритык, Mac нужен от 32 ГБ. Mac на 24 ГБ 4-битную версию по умолчанию не тянет: видеоядру macOS отдаёт около 3/4 памяти, это примерно 19,3 ГБ, а модель на пике занимает 18,3–19,3 ГБ уже на коротком запросе — места под контекст не остаётся.
- Скорость по чужим замерам. RTX 5090 — 183 токена в секунду (Zenn, UD-Q4_K_M, llama.cpp b8870, 22.04.2026), RTX 3090 — 158, Mac на M4 Max — 109–121, на M4 Pro — 86. RTX 3060 на 12 ГБ выдаёт 38–47 токенов в секунду, если часть модели держать в оперативной памяти.
- Качество. В независимом индексе Artificial Analysis у неё 18 баллов, у плотной Qwen3.8-27B — 34. По данным самой Alibaba плотная Qwen3.6-27B сильнее во всех основных тестах. Зато MoE-версия в 3–5 раз быстрее.
- Кому брать. Тем, кому нужна быстрая локальная модель для чата, кода и простых агентов на видеокарте 24–32 ГБ, на Mac от 32 ГБ или даже на 12-гигабайтной карте. Кому важнее качество ответа, чем скорость, — плотная Qwen 3.8 27B.
| Qwen 3.6 35B-A3B | Qwen 3.8 27B | gpt-oss-20b | |
|---|---|---|---|
| Устройство | MoE, активных 3B из 35B | плотная, 27B | MoE, активных 3,6B из 21B |
| Индекс Artificial Analysis v4.3.2 | 18 | 34 | н/д |
| Скорость через API (Artificial Analysis) | 131 ток/с | 44 ток/с | н/д |
| RTX 3090, llama-bench | 157,7 ток/с | н/д | 161,8 ток/с |
| Лицензия | Apache 2.0 | Apache 2.0 | Apache 2.0 |
Что такое Qwen 3.6 35B-A3B и чем MoE отличается от обычной модели
Qwen 3.6 35B-A3B — первая модель поколения Qwen 3.6 с открытыми весами: файлы модели можно скачать и запустить у себя, а не только обращаться к ней через чужой сервер. Так её называет сама Alibaba в карточке модели на Hugging Face. Предыдущее поколение Qwen 3.5 вышло в феврале 2026-го, а как развивалась линейка Qwen для локального запуска до этого, мы разбирали отдельно.
Название читается так: 35B — 35 млрд параметров (точнее, 35 951 822 704 по данным Hugging Face API), A3B — около 3 млрд активных параметров на каждый токен. Токен — кусочек слова, из которых модель собирает ответ.
MoE (Mixture of Experts, «смесь экспертов») — устройство, при котором модель состоит из множества небольших блоков-«экспертов», и на каждый токен включается только несколько из них. Удобная аналогия — клиника с 256 узкими специалистами. На каждый токен диспетчер (роутер) зовёт 8 профильных врачей и одного терапевта общего профиля, остальные 247 в этот момент не работают. В обычной, плотной модели на каждый токен работают все параметры сразу.
Что ещё указано в карточке:
- 40 слоёв, в каждом — блок из 256 экспертов, из которых активны 8 маршрутизируемых и 1 общий.
- Гибридное внимание. Три слоя из четырёх используют Gated DeltaNet — упрощённое «линейное» внимание, которое дешевле на длинном тексте. Каждый четвёртый слой — обычное внимание (Gated Attention). Схема: 10 × (3 × Gated DeltaNet → 1 × Gated Attention).
- Зрение. Это языковая модель с энкодером изображений: она читает картинки, сканы документов и видео. По данным Alibaba, в VideoMMMU у неё 83,7.
- Режим размышления включён по умолчанию: перед ответом модель пишет черновые рассуждения. Его отключают параметром
enable_thinking: False.
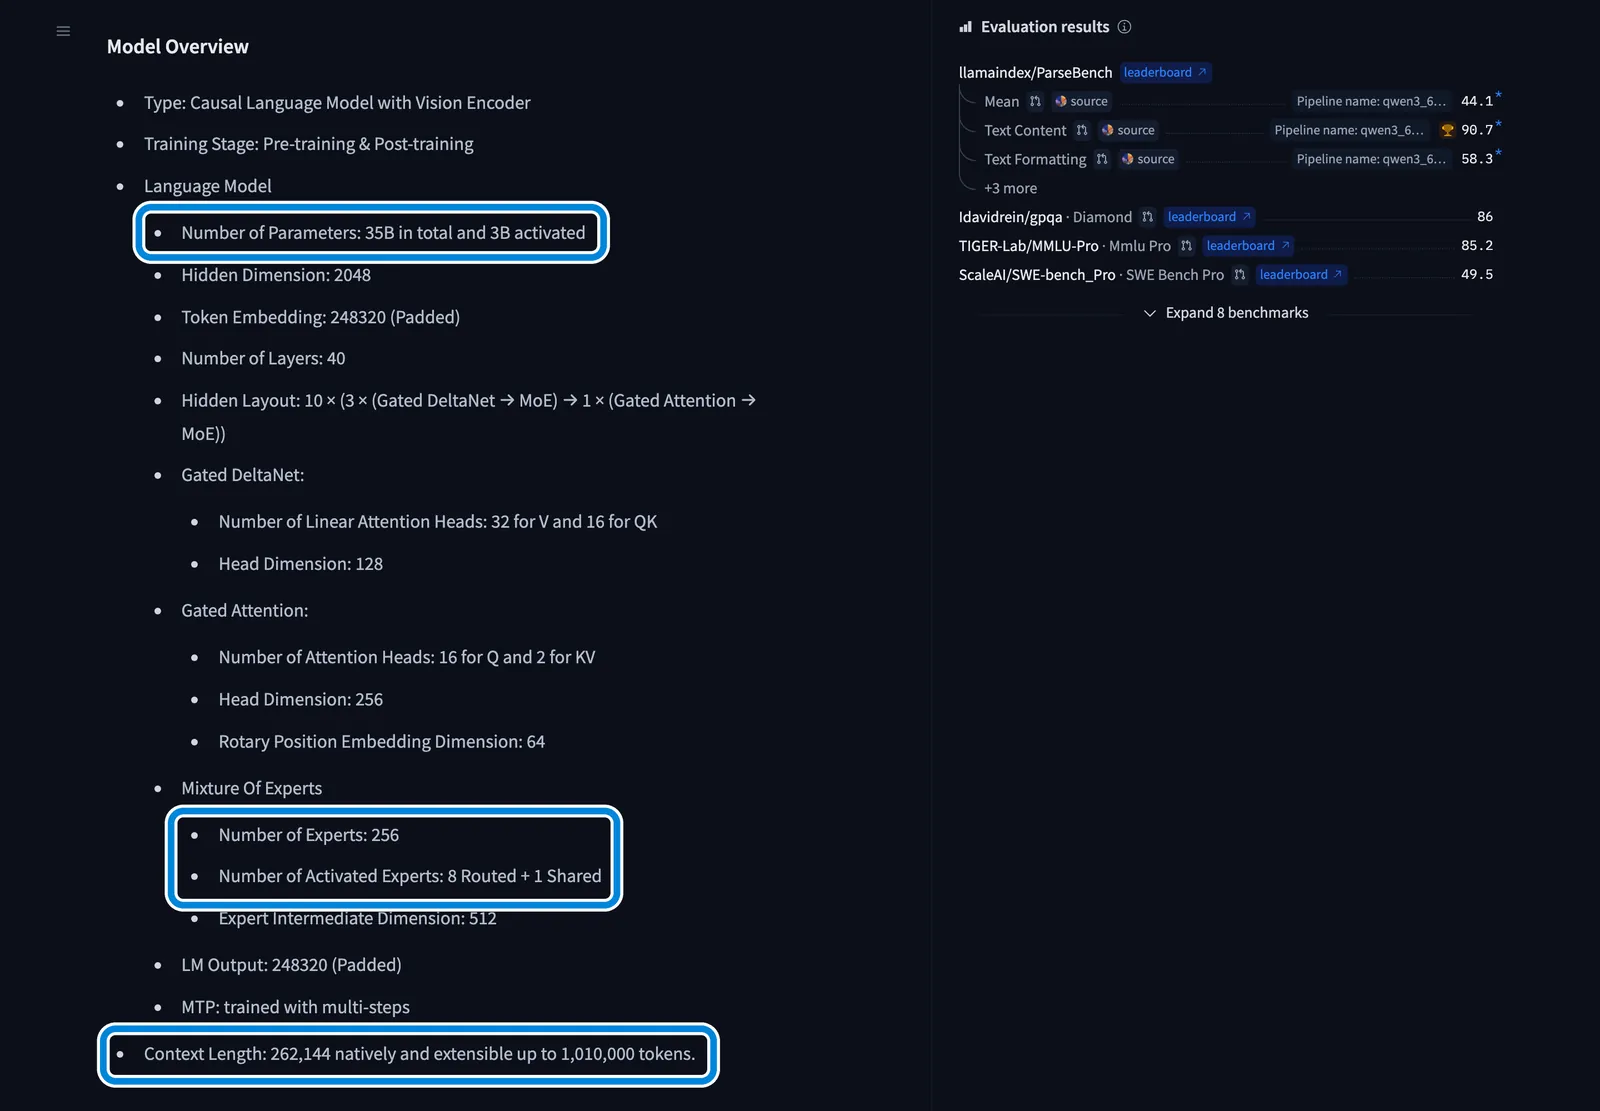
Скриншот карточки модели снят 25.10.2026. Рамки показывают три строки, на которых держится весь этот разбор: 35B параметров всего и 3B активных, 256 экспертов (8 + 1 активны) и нативный контекст 262 144 токена с растяжением до 1 010 000.
Из этого устройства следуют два вывода, которые объясняют почти всё дальше. Вычислений на токен столько же, сколько у модели на 3B, поэтому она быстрая. А памяти нужно столько же, сколько модели на 35B: следующий токен может позвать любых экспертов, и все они должны лежать в памяти заранее.
Большинство страниц, которые поиск выдаёт по запросу «Qwen 3.6 35B A3B review», — агрегаторы со спецификациями и ценами API. Замеров на домашнем железе и ответа на вопрос «кому её брать» там нет. Именно на эти два вопроса отвечают разделы ниже.
Версии, размеры и лицензия Qwen 3.6: что скачивать
Сама Alibaba выкладывает веса в исходном формате BF16 — 16 бит на число, около 70 ГБ. Для дома их почти никто не качает: сообщество сразу выпускает сжатые сборки. Формат GGUF — файл для llama.cpp и программ на его основе (Ollama, LM Studio), в котором модель уже квантована, то есть ужата до 2–8 бит на число. Готовые GGUF-сборки Qwen 3.6 35B A3B есть у Unsloth, у LM Studio Community и в библиотеке Ollama.Вариант Что это Где взять Вес Qwen3.6-35B-A3B, BF16 исходные веса от Alibaba Hugging Face, Qwen ≈70 ГБ GGUF Unsloth (UD-Q3…UD-Q6) сжатые сборки для llama.cpp и LM Studio Hugging Face, unsloth 16,6–29,3 ГБ GGUF LM Studio Community Q4_K_M, Q6_K, Q8_0 Hugging Face, lmstudio-community 21,2 / 28,5 / 36,9 ГБ Ollama qwen3.6:35bготовый тег, он же latestollama.com 23–24 ГБ MLX 4-бит формат для Mac (Apple MLX) Hugging Face, Unsloth UD-MLX-4bit ≈20 ГБ NVFP4 (Unsloth, с 10.07.2026) 4-битный формат для RTX 50-й серии Hugging Face, unsloth н/д Qwen3.6-27B плотная модель того же поколения Ollama qwen3.6:27b18–19 ГБ
Лицензия — Apache 2.0. Модель можно использовать в коммерческих продуктах, менять и дообучать, без ограничений по числу пользователей и географии. Это видно и на карточке Hugging Face, и в прогоне MERA.
Контекст — сколько текста модель держит в голове за раз — 262 144 токена нативно и до 1 010 000 с растяжением YaRN. Тег Ollama подписан как 256K.
Дата выхода. По Epoch AI модель вышла 14 апреля 2026 года, репозиторий на Hugging Face создан 15 апреля. Агрегаторы в выдаче называют 2, 16, 17 и 27 апреля и даже 30 июля — это даты их собственных страниц, а не релиза. Не путайте с Qwen 3.6 Plus: это закрытая облачная модель того же поколения, вышла в марте, и её веса не публиковались.
Бенчмарки Qwen 3.6 35B-A3B: цифры Alibaba и независимые проверки
Бенчмарк — стандартный набор задач, на котором модели сравнивают по доле правильных ответов. Почти все цифры ниже взяты из карточек Alibaba, то есть их измерял сам разработчик. Независимо перепроверена только одна: GPQA Diamond.
На графике видно, что MoE-версия заметно обогнала прошлое поколение (Terminal-Bench: 51,5 против 40,5), но уступает плотной Qwen3.6-27B во всех четырёх тестах. Сильнее всего разрыв в агентных задачах в терминале — 51,5 против 59,3.Тест (данные Alibaba) Qwen3.6-35B-A3B Qwen3.6-27B Qwen3.5-35B-A3B Gemma 4 31B Gemma 4 26B-A4B SWE-bench Verified 73,4 77,2 70,0 52,0 17,4 (вероятно, другая обвязка) Terminal-Bench 2.0 51,5 59,3 40,5 42,9 34,2 GPQA Diamond 86,0 (Epoch AI: 85) 87,8 84,2 84,3 82,3 LiveCodeBench v6 80,4 83,9 74,6 80,0 77,1 SWE-bench Pro 49,5 н/д 44,6 35,7 13,8
Что подтверждено независимо, на 25.10.2026:
- GPQA Diamond — Epoch AI намерила 85% против 86,0 у Alibaba. Расхождение в 1 пункт: здесь вендору можно верить.
- Сводный рейтинг Epoch (ECI) — 144 балла, 99-е место из 253 моделей. На момент выхода было 42-е из 193: за полгода модель заметно сдвинулась вниз, потому что вышли новые.
- Индекс Artificial Analysis v4.3.2 — 18 баллов. У Qwen3.8-27B в режиме максимального размышления — 34 (сравнение на Artificial Analysis), у Gemma 4 26B-A4B — 17, причём это оценка самой Artificial Analysis, полный прогон ещё не сделан. В выдаче встречаются и другие цифры индекса, 32 и 52, — по всей видимости, это старые версии шкалы, и сравнивать их с текущей нельзя.
- Русский язык — в бенчмарке MERA общий балл 0,792 и 11-е место, ruMMLU 0,872 (прогон от 3 мая 2026 года). Важная оговорка: MERA гоняла полную BF16-версию на восьми серверных A100, а не 4-битный файл на домашней карте.
- Украинский язык — независимых тестов для этой модели нет.
У SWE-bench Verified, главного теста на программирование, независимого прогона мы не нашли: 73,4 — это цифра Alibaba. Отдельно про Gemma 4 26B-A4B: 17,4 в SWE-bench выглядит аномально низко рядом с 77,1 в LiveCodeBench, скорее всего, Alibaba гоняла её в неподходящей обвязке.
Ещё одно ограничение: все бенчмарки сняты на полной версии модели. Квантование до 4 бит качество немного снижает, хотя у аккуратных сборок потери малы: по замеру Unsloth, их 4-битная NVFP4 даёт 85,85 в MMLU-Pro против 85,75 у исходной BF16.
Сколько памяти нужно MoE-модели на 35B: вес файла по квантам
Квантование — сжатие весов модели: вместо 16 бит на каждое число хранят 2–8. Чем меньше бит, тем меньше файл и тем ниже качество, но до 4 бит потери обычно невелики. Сколько весит Qwen 3.6 35B-A3B в 4 битах, зависит от сборки: 21,2 ГБ у Q4_K_M от LM Studio, 22,1–22,4 ГБ у Unsloth и 23–24 ГБ у тега Ollama. Разница — в том, какие слои сжаты сильнее, и в том, считают ли авторы гигабайты десятичными или двоичными.
График показывает главную особенность MoE: даже в 4 битах модель весит 21–24 ГБ, столько же, сколько плотная модель такого же размера. MoE экономит вычисления, но не память.Квант Вес, ГБ Видеокарта (вся модель в VRAM) Mac (видеоядру ≈3/4 памяти) Q2_K ≈13 (с кэшем 8k, по bestllmfor) 16 ГБ 24 ГБ (≈ оценка) UD-Q3_K_M 16,6 24 ГБ; на 16 ГБ — только с выгрузкой 24 ГБ — впритык (≈ оценка) Q4_K_M / UD-Q4_K_XL 21,2–22,4 24 ГБ, короткий контекст от 32 ГБ Ollama qwen3.6:35b23–24 24 ГБ — впритык от 32 ГБ UD-Q5_K_S 24,9 32 ГБ (RTX 5090) от 36 ГБ (≈ оценка) Q6_K 28,5–29,3 32 ГБ от 48 ГБ Q8_0 36,9 одна карта не вмещает 48 ГБ — впритык, комфортно 64 ГБ BF16 ≈70 одна карта не вмещает 128 ГБ (пик 65,6 ГБ)
VRAM — собственная память видеокарты; модель работает быстро, только когда целиком лежит в ней. Единая память Mac — общая для процессора и видеоядра, но видеоядру macOS по умолчанию отдаёт только часть: на 16 ГБ — 12,7 ГБ, на 48 ГБ — 40,2 ГБ, на 128 ГБ — около 96 ГиБ. Почему так и как этот лимит поднять, подробно разобрано в материале о том, сколько памяти нужно Mac для ИИ.
Отсюда история с Mac на 24 ГБ. По правилу 3/4 видеоядру достаётся около 18 ГиБ, это примерно 19,3 десятичного гигабайта. 4-битная MLX-версия на пике занимает 18,3–19,3 ГБ уже при запросе в 1 000 токенов, а поднять лимит видеоядра можно только за счёт памяти системы и браузера. На практике это означает, что 4 бита на 24 ГБ по умолчанию не поместятся, и остаются только 2–3-битные сборки.
Сверху весов растёт кэш контекста. На M3 Max пик памяти увеличивается с 19,0 ГБ при 1k токенов до 26,4 ГБ при 128k и 29,4 ГБ при 195k. На видеокартах та же проблема: у Giles Thomas на RTX 3090 файл UD-Q4_K_XL на 22,4 ГиБ не оставил места под рабочий контекст, а чуть более сжатый UD-IQ4_NL_XL на 19,5 ГиБ дал 89 600 токенов. Если важен длинный контекст, разумно взять квант на ступень меньше. Как при этом меняется качество, видно в замерах квантования Q4 против Q8.
Как запустить Qwen 3.6 дома: Ollama, LM Studio, llama.cpp и MLX
Три популярные программы работают с одними и теми же GGUF-файлами, но дают разную скорость и разный уровень контроля. Чем они различаются на одной модели, разобрано в сравнении Ollama, LM Studio и llama.cpp. Ниже — порядок действий для Qwen 3.6 35B-A3B.
Шаг 1. Ollama: одна команда в терминале
Qwen 3.6 в Ollama ставится одной командой: ollama run qwen3.6:35b. Ollama сама скачает тег на 23–24 ГБ и откроет чат. Тег qwen3.6 без уточнения тоже ведёт на 35B-версию — это latest.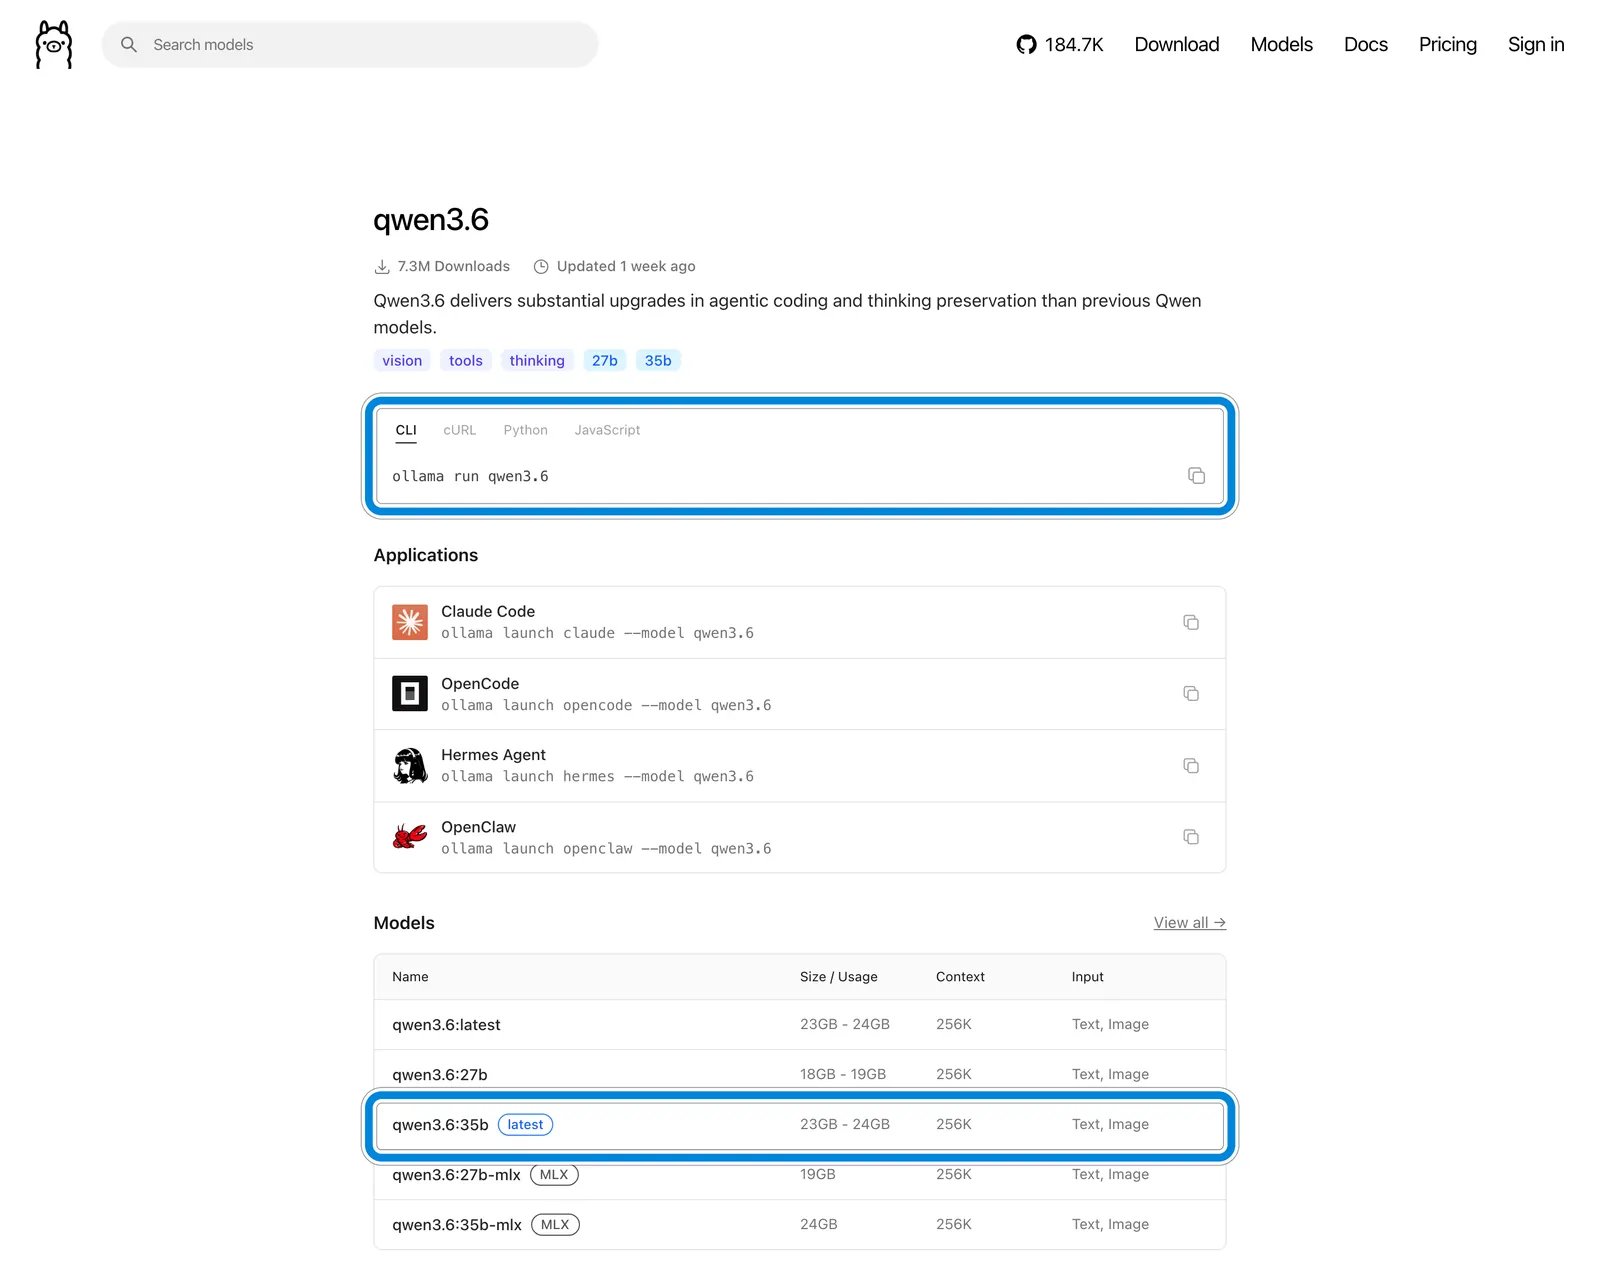
На скриншоте библиотеки Ollama от 25.10.2026 выделены команда запуска и строка нужного тега: 23–24 ГБ, контекст 256K, вход — текст и изображения.
Две вещи стоит проверить сразу. Первая — размер контекста: он задаётся параметром num_ctx, и лучше выставить его явно под свою задачу. Alibaba рекомендует держать не меньше 128K токенов, чтобы модель не теряла нить рассуждений, но на 24-гигабайтной карте такой контекст вместе с весами не поместится, и придётся искать компромисс. Вторая — картинки. Библиотека Ollama помечает тег как «текст и изображения», а InsiderLLM в обновлении от 16.10.2026 пишет, что ввод картинок в Ollama не работает: она не подключает отдельный файл энкодера изображений (mmproj). Если анализ изображений важен, надёжнее llama.cpp с файлом mmproj, а на Mac — mlx-vlm.
Шаг 2. LM Studio: модель мышкой, без терминала
В поиске LM Studio наберите Qwen3.6-35B-A3B и выберите сборку под свою память: Q4_K_M на 21,2 ГБ для карты на 24 ГБ, 3-битную для 16 ГБ, MLX-версию для Mac. Если подключаете модель к агенту или редактору кода через сервер LM Studio, проверьте, что клиент передаёт preserve_thinking: true в параметрах шаблона чата (chat_template_kwargs). Без него шаблон Qwen 3.6 выбрасывает прошлые рассуждения, и уже на втором-третьем ходе модель начинает вызывать инструменты с пустыми аргументами. Так случилось у агента pi (GitHub, issue #3325 от 17.04.2026), там это исправили в тот же день.
Шаг 3. llama.cpp: максимум скорости и выгрузка экспертов
llama.cpp — движок, на котором построены Ollama и LM Studio; напрямую он даёт и наибольшую скорость, и все ручки настройки. Базовая команда из документации Unsloth:
./llama.cpp/llama-cli -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.00
Для карты на 12 ГБ добавляют -ngl 999 -ncmoe 18 -fa on. Флаг -ncmoe N оставляет экспертов из N слоёв в оперативной памяти компьютера, а всё остальное — на видеокарте. Именно этот флаг позволяет запускать 4-битную модель на карте с 12 ГБ; подробнее о том, почему это работает, — в разделе с расчётом.
Важная грабля: на CUDA 13.2 низкобитные кванты выдают бессмыслицу, об этом предупреждают и Unsloth, и InsiderLLM. Берите 13.1 или 13.3.
Шаг 4. Mac: MLX вместо Metal в llama.cpp
На Mac лучше работать через MLX — фреймворк Apple для машинного обучения. Его поддерживают LM Studio, oMLX и mlx-lm. На M1 Max с 64 ГБ одна и та же модель в MLX выдала 54,4 токена в секунду, а в Ollama — 26,6, то есть вдвое меньше (lilting.ch, 23.04.2026). InsiderLLM объясняет это тем, что ядра Metal в llama.cpp для слоёв Gated DeltaNet ещё догоняют.
Шаг 5. Настройки генерации из карточки
| Режим | temperature | top_p | top_k | presence_penalty |
|---|---|---|---|---|
| С размышлением, общие задачи | 1.0 | 0.95 | 20 | 1.5 |
| С размышлением, точный код | 0.6 | 0.95 | 20 | 0.0 |
| Без размышления | 0.7 | 0.80 | 20 | 1.5 |
Переключатели /think и /nothink из Qwen 3 здесь официально не поддерживаются — режим меняется только параметром enable_thinking.
Скорость генерации на RTX и Apple M: замеры и оценки
Скорость генерации измеряют в токенах в секунду (ток/с): сколько кусочков слов модель выдаёт в ответе. Для комфортного чата хватает 20–30 ток/с, для агентов, которые пишут длинные ответы и много размышляют, чем больше, тем лучше.
На графике видно три уровня. Карты на 24–32 ГБ держат всю модель и выдают 140–183 ток/с. На 12 ГБ и меньше часть экспертов уезжает в оперативную память, скорость падает в 3–9 раз, но остаётся рабочей. RTX 4090 на графике нет: прямого замера для неё не нашлось, а оценка слишком широкая, чтобы рисовать её полосой, — она в таблице. Последняя строка — та же RTX 5090, когда её видеопамять занимала другая программа.Видеокарта Квант и условия ток/с Замер или оценка Источник, дата RTX 5090 32 ГБ UD-Q4_K_M (Unsloth), llama-bench tg128, сборка b8870 183 замер Zenn, 22.04.2026 RTX 4090 24 ГБ прямого замера нет ≈144–216 ≈ оценка, низкая точность insidepc: пересчёт замеров 5090 и 3090 по соотношению карт на gpt-oss-20b RTX 3090 24 ГБ UD-Q4_K_M, tg128, до 8K контекста 157,7 замер InsiderLLM, июль 2026 (сборка b10088) RTX 3090 24 ГБ UD-IQ4_NL_XL, CUDA, контекст 89 600 139,6 замер Giles Thomas, 24.07.2026 RTX 3090 24 ГБ ncmoe 10, полный контекст 262 144 89,1 замер Giles Thomas, 24.07.2026 RTX 3060 12 ГБ + 32 ГБ RAM IQ4_XS, ncmoe 18, tg128 46,8 замер r/LocalLLaMA, 15.05.2026 RTX 3060 12 ГБ + 32 ГБ RAM ncmoe 24 ≈38 замер InsiderLLM, страница от 16.10.2026 GTX 1650 4 ГБ ncmoe 40 ≈20,2 замер InsiderLLM, 11.09.2026 RTX 5090, видеопамять занята Q5_K_S, откат на процессор 18 замер Zenn, 22.04.2026
Прямого замера для RTX 4090 в открытых источниках нет, поэтому в таблице стоит диапазон-оценка. Считали так: у gpt-oss-20b в одном и том же тесте llama.cpp 4090 даёт 222 ток/с, 5090 — 282,5, а 3090 — 161,8. Переносим эти соотношения на замеры Qwen: 183 × 222 / 282,5 ≈ 144 и 157,7 × 222 / 161,8 ≈ 216. Границы так далеко друг от друга, потому что исходные замеры сняты на разных сборках llama.cpp: 183 на 5090 — апрельская b8870, через неделю после выхода модели, а 157,7 на 3090 — июльская b10088. Свежий замер 3090 почти совпадает с gpt-oss-20b на той же карте (157,7 против 161,8), поэтому верхняя граница, скорее всего, ближе к правде — но тогда и апрельские 183 на 5090 уже не потолок. Пока прямого замера нет, точная цифра для 4090 неизвестна; ясно только, что медленнее 3090 она не будет. Сводку замеров всех трёх карт на других моделях смотрите в материале RTX 5090, 4090 и 3090 в локальных LLM.
Почему цифры в выдаче так расходятся. Сайт bestllmfor пишет для этой модели 110–125 ток/с на RTX 5090 и 55–70 на RTX 3090, но в эти цифры входит и обработка запроса, а программу и сборку сайт не называет. InsiderLLM оценивает 4090 в 120–140 ток/с — ниже собственного замера на более старой 3090: по её же словам, оценку пересчитывали из старого замера 3090 на ~101 ток/с. Чистые прогоны llama-bench от Zenn и InsiderLLM дают в 1,5–2,5 раза больше. Есть и обратный эффект: на той же RTX 5090 прошлая Qwen3.5-35B-A3B выдавала 214 ток/с против 183 у новой. Сборки llama.cpp у этих прогонов разные, но вывод простой: новее не значит быстрее, и скорость Qwen 3.6 ещё будет расти с обновлениями движка.
Отдельная ловушка — тихий откат на процессор. Автор теста на Zenn получил 18 ток/с вместо 180 на кванте Q5_K_S, потому что в фоне Ollama держала в видеопамяти ту же модель на 22,7 ГБ, а ещё 7 ГБ занимала вторая модель. llama.cpp не сообщил об ошибке, а просто перешёл на процессор. Перед запуском одной программы закрывайте другую.
Скорость на Mac растёт вместе с пропускной способностью памяти, но не пропорционально: M4 Max с 546 ГБ/с выдаёт 108,8–121,3 ток/с, а версия с 410 ГБ/с — 109,9: прибавка от нуля до 10%. Заштрихованные полосы — наша оценка для чипов, на которых замеров этой модели нет.Mac Полоса памяти ток/с (1k) Замер или оценка Источник, дата M4 Max 40c, 64 ГБ 546 ГБ/с 121,3 замер oMLX, 26.04.2026 M4 Max 32c, 36 ГБ 410 ГБ/с 109,9 замер oMLX, 25.04.2026 M4 Max 40c, 48 ГБ 546 ГБ/с 108,8 замер oMLX, 20.04.2026 M3 Max 40c, 64 ГБ 400 ГБ/с 102,8 замер oMLX, 24.04.2026 M5 Max 40c, 128 ГБ, 8 бит 614 ГБ/с 96,0 замер, другой квант oMLX, 24.04.2026 M4 Pro 20c, 48 ГБ 273 ГБ/с 85,9 замер oMLX, 18.05.2026 M4 Max 40c, 128 ГБ, BF16 546 ГБ/с 62,2 замер, без сжатия oMLX, 19.05.2026 M1 Max, 64 ГБ 400 ГБ/с 54,4 замер, другая методика lilting.ch, 23.04.2026 M5 Max 40c, 4 бита 614 ГБ/с ≈116–137 ≈ оценка insidepc, формула ниже M5 Pro 20c, 48 ГБ 307 ГБ/с ≈81–96 ≈ оценка insidepc, формула ниже M5, 32 ГБ 153 ГБ/с ≈41–48 ≈ оценка insidepc, формула ниже M4, 32 ГБ 120 ГБ/с ≈32–37 ≈ оценка insidepc, формула ниже
Все замеры oMLX сделаны участниками сообщества на oMLX 0.3.6–0.3.9 с 4-битной моделью и запросом в 1 000 токенов, если не указано иное. Строка M1 Max снята другим способом — как общее время ответа вместе с чтением запроса, поэтому она ниже, чем дал бы тот же чип в oMLX.
С длинным контекстом скорость падает ступенькой. Замер на M3 Max 40c с 64 ГБ (oMLX, 24.04.2026):Контекст 1k 8k 32k 64k 128k 195k ток/с 102,8 90,5 90,0 81,1 40,6 43,9 Пик памяти, ГБ 19,0 20,1 21,9 23,8 26,4 29,4
До 64k токенов модель теряет около 20% скорости, а после — вдвое. Если вы планируете скармливать ей большие кодовые базы или длинные документы, ориентируйтесь на правый край таблицы, а не на рекламные цифры при коротком запросе.
Почему MoE быстрая на Mac и слабой карте: расчёт по памяти
При генерации каждого токена модель должна прочитать из памяти все задействованные веса. Поэтому потолок скорости задаёт не мощность чипа, а пропускная способность памяти — сколько гигабайт в секунду она успевает отдать. Отсюда простая формула:
скорость ≈ полоса памяти ÷ объём весов на один токен × КПД
У Qwen 3.6 35B-A3B на токен работают около 3 млрд параметров. В 4 битах с учётом служебных данных это примерно 4,5 бита на параметр, то есть 3 млрд × 4,5 / 8 ≈ 1,7 ГБ на токен. У плотной модели на 27B в тех же 4 битах — около 15 ГБ на токен, почти в 9 раз больше. Это и есть ответ на вопрос, почему MoE быстрая.
КПД — какую долю теоретического потолка чип реально выдаёт. Его можно посчитать из замеров:Чип Полоса, ГБ/с Потолок, ток/с (полоса ÷ 1,7) Замер, ток/с КПД M4 Pro 20c 273 ≈161 85,9 ≈0,53 M4 Max 32c 410 ≈241 109,9 ≈0,46 M3 Max 40c 400 ≈235 102,8 ≈0,44 M4 Max 40c, 64 ГБ 546 ≈321 121,3 ≈0,38 M4 Max 40c, 48 ГБ 546 ≈321 108,8 ≈0,34
Чем шире память, тем ниже КПД. По нашему расчёту, причина — постоянные накладные расходы на каждый токен, которые от полосы не зависят. Их можно прикинуть по двум замерам одного чипа, снятым на разных компьютерах и версиях oMLX: на M4 Max 40c 4 бита (≈1,7 ГБ на токен) дают 121,3 ток/с, то есть 8,2 мс на токен, а BF16 (≈6 ГБ на токен) — 62,2 ток/с, 16,1 мс. Лишние 4,3 ГБ добавили 7,8 мс — это чтение на полной полосе около 550 ГБ/с, а остальные ≈5 мс на токен уходят на накладные. Когда весов на токен мало, как у MoE, эти 5 мс и съедают КПД.
Поэтому для чипов без замера мы берём КПД из наблюдаемого диапазона соседей: 0,45–0,53 для M4, M5 и M5 Pro (как у M4 Pro и M3 Max) и 0,32–0,38 для M5 Max (как у M4 Max 40c). Самые ненадёжные строки — базовые M4 и M5 с 10-ядерным видеоядром: замеров в этом классе нет ни одного. Оценку M5 Max подтверждает и его собственный замер в 8 битах: 96 ток/с при ≈3,2 ГБ на токен дают те же ≈5 мс накладных, и для 4 бит из этого выходит около 125 ток/с — внутри диапазона. Так получились заштрихованные строки в таблице скорости на Mac. Это оценка, а не замер.
Та же логика объясняет, как модель работает на слабых картах. На RTX 3090 вся модель в видеопамяти даёт 157,7 ток/с, то есть около 6,3 мс на токен. По замеру InsiderLLM, каждый слой экспертов, вынесенный в оперативную память, добавляет примерно 0,53 мс. Все 40 слоёв в оперативке: 6,3 + 40 × 0,53 ≈ 27,5 мс, или около 36 ток/с, и это сходится с замером InsiderLLM при полной выгрузке.
У выгрузки есть обрыв. На RTX 3060 с 12 ГБ при -ncmoe 17 скорость 46,6 ток/с, а при -ncmoe 16 — уже 25,8 (r/LocalLLaMA, 15.05.2026). Скорее всего, на этом шаге в видеопамять перестаёт помещаться всё остальное, и драйвер начинает гонять данные туда-обратно. Подбирайте N сверху вниз и останавливайтесь на шаг раньше обрыва.
А вот «ускорители» почти не помогают. Спекулятивная генерация MTP, когда модель угадывает несколько токенов вперёд, у MoE даёт 15–25% по данным Unsloth и всего 2% у автора теста на RTX 3060. Скорость берётся из правильного кванта, флага -ncmoe и свежей сборки движка.
Qwen 3.6 35B-A3B против Qwen 3.8 27B, gpt-oss-20b и Gemma 4
Главный выбор здесь — между скоростью и качеством. MoE-модели (Qwen 3.6 35B-A3B, gpt-oss-20b, Gemma 4 26B-A4B) быстрые, плотные (Qwen 3.8 27B, Qwen3.6-27B) умнее, но медленнее.Qwen 3.6 35B-A3B Qwen 3.8 27B Qwen 3.6 27B gpt-oss-20b Gemma 4 26B-A4B Устройство MoE, 35B / 3B активных плотная, 27B плотная, 27B MoE, 21B / 3,6B активных MoE, 26B / ≈4B активных Выход апрель 2026 август 2026 апрель 2026 август 2025 н/д Память, 4 бита 21,2–24 ГБ н/д 18–19 ГБ (Ollama) до 16 ГБ (OpenAI) н/д RTX 3090, llama-bench 157,7 ток/с н/д н/д 161,8 ток/с н/д RTX 5090, llama-bench 183 ток/с н/д н/д 282,5 ток/с н/д M4 Max 32c, 36 ГБ 109,9 ток/с (MLX) н/д н/д 92,4 ток/с (llama.cpp) н/д Индекс Artificial Analysis v4.3.2 18 34 н/д н/д 17 (оценка AA) GPQA Diamond (карточки разработчиков; Gemma — по таблице Alibaba) 86,0 89,2 87,8 66 82,3 Скорость API, Artificial Analysis 131 ток/с 44 ток/с н/д н/д 91 ток/с Цена API за 1М токенов, вход / выход $0,375 / $2,25 $0,50 / $3,00 н/д н/д $0,10 / $0,34 Лицензия Apache 2.0 Apache 2.0 Apache 2.0 Apache 2.0 н/д Контекст 262 144 262 144 262 144 н/д 256K
Цены и индексы — на 25.10.2026, по данным Artificial Analysis; у отдельных провайдеров цена бывает и ниже, и выше медианы.
Qwen 3.6 35B vs Qwen 3.8 27B: скорость против качества
Qwen 3.8 27B — плотная модель следующего поколения, вышла в августе 2026 года, тоже под Apache 2.0 и с тем же контекстом 262 144. В независимом индексе Artificial Analysis она набирает 34 балла против 18 у Qwen 3.6 35B-A3B, то есть почти вдвое больше. Цена — скорость: через API 44 ток/с против 131. На домашнем железе разрыв похожий: на M1 Max плотная Qwen3.6-27B выдавала 11,5 ток/с против 54,4 у MoE-версии (lilting.ch), это в 4,7 раза. Если модель пишет код в агенте и ошибка стоит дороже ожидания, берите Qwen 3.8 27B. Если важна отзывчивость в чате или нужно запустить модель на 12-гигабайтной карте, остаётся Qwen 3.6 35B-A3B.
Против gpt-oss-20b: кто быстрее на той же карте
gpt-oss-20b — открытая модель OpenAI, тоже MoE и тоже под Apache 2.0. Она легче: OpenAI заявляет, что она работает в 16 ГБ памяти, а значит, помещается туда, куда Qwen 3.6 35B-A3B не влезает. На мощных картах gpt-oss-20b быстрее: 282,5 против 183 ток/с на RTX 5090. На RTX 3090 они почти равны — 161,8 против 157,7. Оговорка: замеры gpt-oss сделаны в августе 2025 года на ранней сборке llama.cpp, у Qwen — в 2026-м на других, так что сравнение ориентировочное. По вендорскому GPQA Diamond Qwen заметно сильнее: 86,0 против 66.
Qwen 3.6 35B-A3B vs Gemma 4 26B-A4B: два MoE одного класса
Gemma 4 26B-A4B от Google — ближайший по устройству соперник: тоже MoE, около 4 млрд активных параметров. В индексе Artificial Analysis они почти равны — 18 против 17, но у Gemma это пока оценка, а не полный прогон. По данным Alibaba Qwen впереди в Terminal-Bench (51,5 против 34,2) и в LiveCodeBench (80,4 против 77,1). Через API Gemma дешевле в несколько раз: $0,10 / $0,34 против $0,375 / $2,25 за миллион токенов, но медленнее — 91 ток/с против 131. У Gemma 4 26B-A4B меньше параметров всего — 26 млрд против 35, поэтому и файл у неё легче: для карты на 16 ГБ это довод в её пользу.
Когда Qwen 3.6 35B-A3B не подойдёт: петли, инструменты, язык
Слабые места модели, о которых известно на 25.10.2026, собраны ниже вместе с тем, что их уравновешивает.
Риски в агентах, Ollama и на CUDA 13.2
- Петли в агентах. InsiderLLM в обновлении от 16.10.2026 пишет о повторных неудачных вызовах инструментов и о том, что плотная 27B «стабильнее». На r/LocalLLaMA жалуются, что после длинного контекста модель зацикливается и забывает инструкции. Для серьёзной агентной работы это главный минус.
- Пустые аргументы инструментов. Без
preserve_thinking=trueшаблон чата отбрасывает прошлые рассуждения, и вызовы инструментов приходят пустыми (GitHub pi #3325, 17.04.2026). Это не дефект весов, а настройка, но новички на неё натыкаются. - Тихий откат на процессор. Если видеопамять занята другой моделью, скорость падает со 180 до 18 ток/с без всякого предупреждения (Zenn, 22.04.2026).
- CUDA 13.2. На низкобитных квантах выдаёт бессмыслицу (Unsloth, InsiderLLM).
- Картинки в Ollama. Источники расходятся: библиотека Ollama помечает тег как «текст и изображения», а InsiderLLM (16.10.2026) пишет, что ввод картинок там не работает, потому что Ollama не подключает файл mmproj.
- Память при длинном контексте. На 128k скорость на Mac падает вдвое, а пик памяти растёт на 7 ГБ.
- Языки. Русский проверен в MERA на полной версии модели, украинский не проверял никто. Качество на 4-битной версии на обоих языках неизвестно.
- Возраст. Модель апрельская. В рейтинге Epoch AI она опустилась с 42-го места на 99-е, следующее поколение Qwen 3.8 уже вышло.
Плюсы для баланса: GPQA Diamond подтверждён независимо, лицензия Apache 2.0 без географических ограничений, на RTX 3090 модель выдаёт 140–158 ток/с, а 12-гигабайтные карты тянут её на 38–47 ток/с. Ещё один плюс локального запуска — приватность: запросы и файлы не уходят на чужой сервер. При работе через API данные получает провайдер, и условия хранения у каждого свои.
Чего мы не знаем: реальной скорости на RTX 4090, независимого результата в SWE-bench и качества на украинском. Первым устареет блок про скорость — с каждой сборкой llama.cpp и MLX цифры меняются, свежие замеры стоит смотреть в таблицах oMLX и обсуждениях llama.cpp.
Какую сборку Qwen 3.6 выбрать: код, агент, ноутбук, слабая карта
- RTX 3090 или 4090, 24 ГБ. Q4_K_M или UD-IQ4_NL_XL в llama.cpp — на 3090 140–158 ток/с по замерам; на 4090 замера нет, по нашей оценке не меньше. Если нужен весь контекст 262 144, вынесите экспертов из 10 слоёв (
-ncmoe 10): у Giles Thomas это дало 89 ток/с на полном окне. - RTX 5090, 32 ГБ. Можно взять квант покрупнее, Q5 или Q6 на 25–29 ГБ, или формат NVFP4: по данным Unsloth, на 32 ГБ он ускоряет эту модель в 1,7 раза.
- 12 ГБ, например RTX 3060. IQ4_XS и
-ncmoe 17–20при 32 ГБ оперативной памяти — 38–47 ток/с. - 4–8 ГБ. Работает и на GTX 1650 с 4 ГБ, около 20 ток/с при почти полной выгрузке. Но тут уже стоит смотреть на gpt-oss-20b, которой хватает 16 ГБ общей памяти.
- Mac на 16–24 ГБ. Не та модель: 4 бита не помещаются, на 24 ГБ остаются только 2–3-битные сборки впритык. Если выбираете компьютер под локальный ИИ, начните с гида какой Mac выбрать.
- Mac на 32–48 ГБ. 4-битная MLX-версия: около 86 ток/с на M4 Pro и 109–121 на M4 Max.
- Mac на 64–128 ГБ. 8 бит (96 ток/с на M5 Max) или даже исходная BF16 (62 ток/с на M4 Max со 128 ГБ): в 8 битах потери от сжатия минимальны, в BF16 их нет вовсе.
- Агент и серьёзный код. Плотная Qwen 3.8 27B или Qwen3.6-27B: медленнее в 3–5 раз, но ошибаются реже.
- Без своего железа. Через API по данным Artificial Analysis на 25.10.2026 — $0,375 за миллион входных токенов и $2,25 за миллион выходных (медиана провайдеров).
FAQ
Сколько памяти нужно, чтобы запустить Qwen 3.6 35B-A3B?
В 4 битах сам файл весит 21,2–24 ГБ в зависимости от сборки, плюс 1–7 ГБ на контекст. Минимальный комфортный вариант — видеокарта на 24 ГБ с коротким контекстом или Mac с 32 ГБ единой памяти. Полная версия BF16 весит около 70 ГБ и требует Mac на 128 ГБ. На картах поменьше модель работает, если часть экспертов вынести в оперативную память.
Запустится ли модель на RTX 3060 12 ГБ или Mac с 16 ГБ?
На RTX 3060 — да: с выгрузкой экспертов в оперативную память (флаг -ncmoe в llama.cpp) и 32 ГБ RAM она выдаёт 38–47 токенов в секунду по замерам InsiderLLM и r/LocalLLaMA. На Mac с 16 ГБ — нет: видеоядру достаётся около 12,7 ГБ, а даже 2-битной сборке нужно около 13 ГБ вместе с контекстом.
Чем Qwen 3.6 35B-A3B лучше Qwen 3.8 27B и чем хуже?
Лучше — скоростью: через API 131 токен в секунду против 44, на домашнем железе разрыв в 3–5 раз. Хуже — качеством: в независимом индексе Artificial Analysis v4.3.2 у неё 18 баллов против 34. Для чата и быстрых задач подходит Qwen 3.6 35B-A3B, для сложного кода и агентов — плотная Qwen 3.8 27B.
Можно ли использовать Qwen 3.6 в коммерческих проектах?
Да. Веса выложены под лицензией Apache 2.0: модель можно встраивать в платные продукты, изменять и дообучать без ограничений по числу пользователей и стране. Лицензия указана в карточке модели на Hugging Face и подтверждается в прогоне MERA. Отвечать за то, что модель сгенерирует в вашем продукте, придётся вам самим.
Почему модель на 35B генерирует так быстро?
Потому что это MoE: на каждый токен работают только около 3 млрд параметров из 35 — восемь экспертов из 256 и один общий. Из памяти на токен читается около 1,7 ГБ весов, а не 20 с лишним. Но хранить в памяти приходится все 35 млрд, поэтому памяти она требует как большая модель.
Умеет ли модель работать с картинками и видео локально?
Да, у модели есть энкодер изображений: она читает фото, сканы и видео, по данным Alibaba — на уровне 83,7 в VideoMMMU. Но локально это работает не везде: Ollama помечает тег как поддерживающий изображения, а InsiderLLM пишет, что у неё ввод картинок не работает. Для изображений надёжнее llama.cpp с файлом mmproj или mlx-vlm на Mac.