

Коротко (TL;DR)
- У Mac unified memory для LLM важны два разных числа: объём единой памяти решает, какая модель вообще запустится, а пропускная способность памяти — как быстро она будет отвечать. Оба зависят от конкретного чипа.
- 16 ГБ — модели до 8B с полноценным контекстом и 14B с коротким; 32 ГБ — 32B с коротким контекстом; 64 ГБ — 70B в 4 битах впритык; 96–128 ГБ — 70B с длинным контекстом и gpt-oss-120b; 256 ГБ — Qwen3 235B; 512 ГБ — DeepSeek-R1 671B в 4 битах, почти без запаса.
- Видеоядру macOS по умолчанию отдаёт не всю память: по логам llama.cpp на свежих macOS — около 3/4 (74% на 16 ГБ, 78% на 48 ГБ, 75% на 512 ГБ), на старой macOS 13 было 2/3. Лимит можно поднять командой
sysctl, но до перезагрузки. - Скорость генерации упирается в формулу «пропускная способность ÷ размер модели», но это потолок: по замерам llama.cpp чипы выдают от 40% (Ultra на маленькой модели) до 84% (базовый M2) этого потолка.
- На 25.10.2026 в Украине Mac mini M6 с 16 ГБ стоит от 55 799 ₴, Mac Studio M5 Ultra с 96 ГБ — 343 999 ₴. Mac Studio на 512 ГБ Apple обещала «в конце октября», подтверждения продаж на эту дату мы не нашли.
Сколько единой памяти нужно Mac для ИИ: ступени от 16 до 512 ГБ
Главный вопрос «сколько брать» решается одной таблицей: модели в двух видах сжатия против объёмов, которые продаёт Apple. На пересечении — поместится ли модель в часть памяти, которую macOS отдаёт видеоядру. Сначала четыре термина:
- Коротко (TL;DR)
- Сколько единой памяти нужно Mac для ИИ: ступени от 16 до 512 ГБ
- Единая память Mac против видеопамяти видеокарты: что решает объём
- Пропускная способность и максимум памяти по чипам M1–M6 и бинам
- Сколько памяти занимает модель: веса, KV-кэш и запас под macOS
- Лимит видеоядра Mac: сколько единой памяти macOS отдаёт GPU
- Какой Mac брать под каждую ступень: от MacBook Neo до Mac Studio
- Скорость генерации: измеренные токены в секунду и оценка по формуле
- Prefill против генерации: «в 4,3 раза быстрее» — не про токены
- Картинки, видео, Whisper и эмбеддинги: память сверх LLM
- Если памяти не хватило: своп, давление памяти и урезанный контекст
- Сколько стоит память: доплаты Apple и цены в Украине на 25.10.2026
- Как выбрать объём под задачу: от первой модели до агента с 128K
- Слабые места единой памяти Mac: цены, апгрейд и дефицит 512 ГБ
- Частые вопросы про память Mac для ИИ
Эта статья — часть гида «Какой Mac выбрать»: там карта всех чипов M1–M6 с тестами, подбор конфигурации под вашу задачу и калькулятор «какая нейросеть влезет».
- Единая память (unified memory) — одна общая оперативная память, из которой читают и процессор, и видеоядро Mac. Отдельной видеопамяти, как у видеокарты, у Mac нет.
- Квантование — сжатие весов модели: Q4 хранит каждый параметр примерно в 4 битах, Q8 — в 8 битах. Q4 вдвое легче, качество теряет немного; подробно разбирали в материале про квантование локальных LLM.
- Контекст — сколько текста модель держит в голове за раз, в токенах. Токен — кусок слова: слог, слово или знак препинания. Контекст хранится в KV-кэше — служебной памяти, которая растёт с длиной разговора.
- MoE (mixture of experts, «смесь экспертов») — модель, у которой на каждый токен работает лишь часть параметров. Памяти она требует на все параметры, а скорость определяют только активные.
Какая модель влезает в какой объём памяти Mac (оценка по формуле, лимит видеоядра — по логам для 16, 48 и 512 ГБ, остальное по правилу 3/4)Модель и сжатие Нужно, ГБ (8K / 32K) 16 ГБ 24 ГБ 32 ГБ 48 ГБ 64 ГБ 96 ГБ 128 ГБ 256 ГБ 512 ГБ Llama 3.1 8B Q4 6,0 / 9,2 да да да да да да да да да Llama 3.1 8B Q8 9,6 / 12,8 8K да да да да да да да да Qwen3 14B Q4 10,3 / 14,4 8K да да да да да да да да Qwen3 14B Q8 17,0 / 21,1 нет 8K да да да да да да да Qwen3 32B Q4 21,9 / 28,4 нет нет 8K да да да да да да Qwen3 32B Q8 37,0 / 43,4 нет нет нет 8K да да да да да Llama 3.3 70B Q4 45,2 / 53,3 нет нет нет нет 8K да да да да Llama 3.3 70B Q8 77,7 / 85,7 нет нет нет нет нет sysctl да да да gpt-oss-120b (MoE, MXFP4) 63,7 / 64,6 нет нет нет нет нет да да да да Qwen3 235B-A22B Q4 (MoE) 143,7 / 148,5 нет нет нет нет нет нет нет да да Qwen3 235B-A22B Q8 (MoE) 251,5 / 256,2 нет нет нет нет нет нет нет sysctl да DeepSeek-R1 671B Q4 (MoE) от 404,4 нет нет нет нет нет нет нет нет впритык DeepSeek-R1 671B Q8 (MoE) от 713,3 нет нет нет нет нет нет нет нет нет
Как читать ячейки:
- да — веса и контекст 32 768 токенов помещаются в лимит видеоядра по умолчанию;
- 8K — помещается только с коротким контекстом, около 8 тысяч токенов: хватает на чат, но не на длинный документ или агента;
- sysctl — модель влезет, только если поднять лимит видеоядра вручную и оставить системе около 8 ГБ (на 256 ГБ — 16 ГБ);
- нет — не помещается даже так; на Mac она пойдёт через своп и станет непригодной по скорости.
«Нужно» — это файл весов с Hugging Face плюс KV-кэш на 8 и 32 тысячи токенов, посчитанный по config.json модели. Буферы движка сюда не входят, поэтому на границе ступени реальная нагрузка может не поместиться. У DeepSeek-R1 своя схема внимания (MLA), её KV-кэш мы не считали — поэтому «от».
Главный вывод таблицы: ступени 48 и 64 ГБ покупают не под веса, а под контекст. Веса 70B в Q4 — 42,52 ГБ, на 64 ГБ они помещаются, но на длинный разговор места почти не остаётся. MoE-модели живут на Mac свободнее плотных (почему — в разделе про скорость MoE), а 512 ГБ — единственная ступень под 671B на одной машине, с запасом около 8 ГБ.
На графике видно, где у модели проходит граница ступени: Llama 3.3 70B с контекстом 32K (≈ 53,3 ГБ) уже не помещается в 64-гигабайтный Mac без правки лимита, а Qwen3 235B (≈ 148,5 ГБ) перешагивает через 128 ГБ.Модель Тип Веса Q4, ГБ Веса Q8, ГБ KV-кэш 32K, ГБ Q4 + 32K, ГБ (≈ оценка) Q8 + 32K, ГБ (≈ оценка) Llama 3.1 8B плотная 4,92 8,54 4,3 ≈ 9,2 ≈ 12,8 Qwen3 14B плотная 9,00 15,70 5,4 ≈ 14,4 ≈ 21,1 Qwen3 32B плотная 19,76 34,82 8,6 ≈ 28,4 ≈ 43,4 Llama 3.3 70B плотная 42,52 74,98 10,7 ≈ 53,3 ≈ 85,7 gpt-oss-120b MoE 63,39 (MXFP4) н/д 1,2 ≈ 64,6 н/д Qwen3 235B-A22B MoE 142,15 249,94 6,3 ≈ 148,5 ≈ 256,2 DeepSeek-R1 671B MoE 404,43 713,29 н/д н/д н/д
Единая память Mac против видеопамяти видеокарты: что решает объём
Сравнение unified memory vs VRAM для LLM сводится к двум числам: сколько гигабайт модели помещается и с какой скоростью их можно прочитать. Видеокарта выигрывает скорость, Mac выигрывает объём. У RTX 5090 32 ГБ видеопамяти с пропускной способностью 1,79 ТБ/с, у Mac Studio M5 Ultra — до 512 ГБ общей памяти и 1,2 ТБ/с.
Пропускная способность — сколько гигабайт данных память отдаёт чипу за секунду. Чтобы написать один токен ответа, модель читает из памяти все свои активные веса. Поэтому, когда модель целиком помещается в память, генерацией правит именно этот параметр.
Что из этого следует на практике:
- Модель влезает в 32 ГБ — видеокарта быстрее. MacStories на одной модели Qwen 3.8 27B (на Mac — MLX, на ПК — GGUF в LM Studio) получил у RTX 5090 около +25% в генерации и ~3000 токенов в секунду на чтении промпта из 6000 токенов против ~1700 у M5 Ultra (30.09.2026).
- Модель не влезает в 32 ГБ — tbreak загрузил gpt-oss-120b на Mac Studio со 128 ГБ, а система с RTX 5090 не смогла уместить её в видеопамять.
- Длинный контекст — тоже вопрос объёма: на 256 тысячах токенов RTX 5090 справилась у MacStories только с 8-битным KV-кэшем.
Единая память — не единственный способ получить много памяти под модель. Мини-ПК на NVIDIA GB10 и AMD Strix Halo устроены похоже, и мы сравнивали их с Mac Studio в разборе DGX Spark, Mac Studio и Strix Halo. Сколько видеопамяти просят разные модели в мире видеокарт, разобрано в статье видеопамять под LLM — там же подробная формула KV-кэша.
| Что сравниваем | Единая память Mac | Видеопамять видеокарты |
|---|---|---|
| Максимальный объём | до 512 ГБ (M5 Ultra) | 32 ГБ у RTX 5090 |
| Пропускная способность | 60 ГБ/с (MacBook Neo) — 1,2 ТБ/с (M5 Ultra) | 1,79 ТБ/с у RTX 5090 |
| Кто пользуется памятью | процессор, видеоядро, macOS, приложения — делят одну | только видеоядро |
| Можно добавить позже | нет, память распаяна вместе с чипом | нет, но можно поставить вторую карту |
| Сильная сторона | большие модели и длинный контекст на одной тихой машине | скорость на моделях, которые помещаются |
Пропускная способность и максимум памяти по чипам M1–M6 и бинам
Пропускная способность зависит не только от поколения и класса чипа (базовый, Pro, Max, Ultra), но и от бина — урезанной или полной версии одного и того же кристалла. Apple продаёт один чип в двух вариантах с разным числом ядер GPU, и у младшего часто меньше ширина шины памяти. Официальные цифры — на странице Mac Studio Tech Specs и в спецификациях остальных моделей.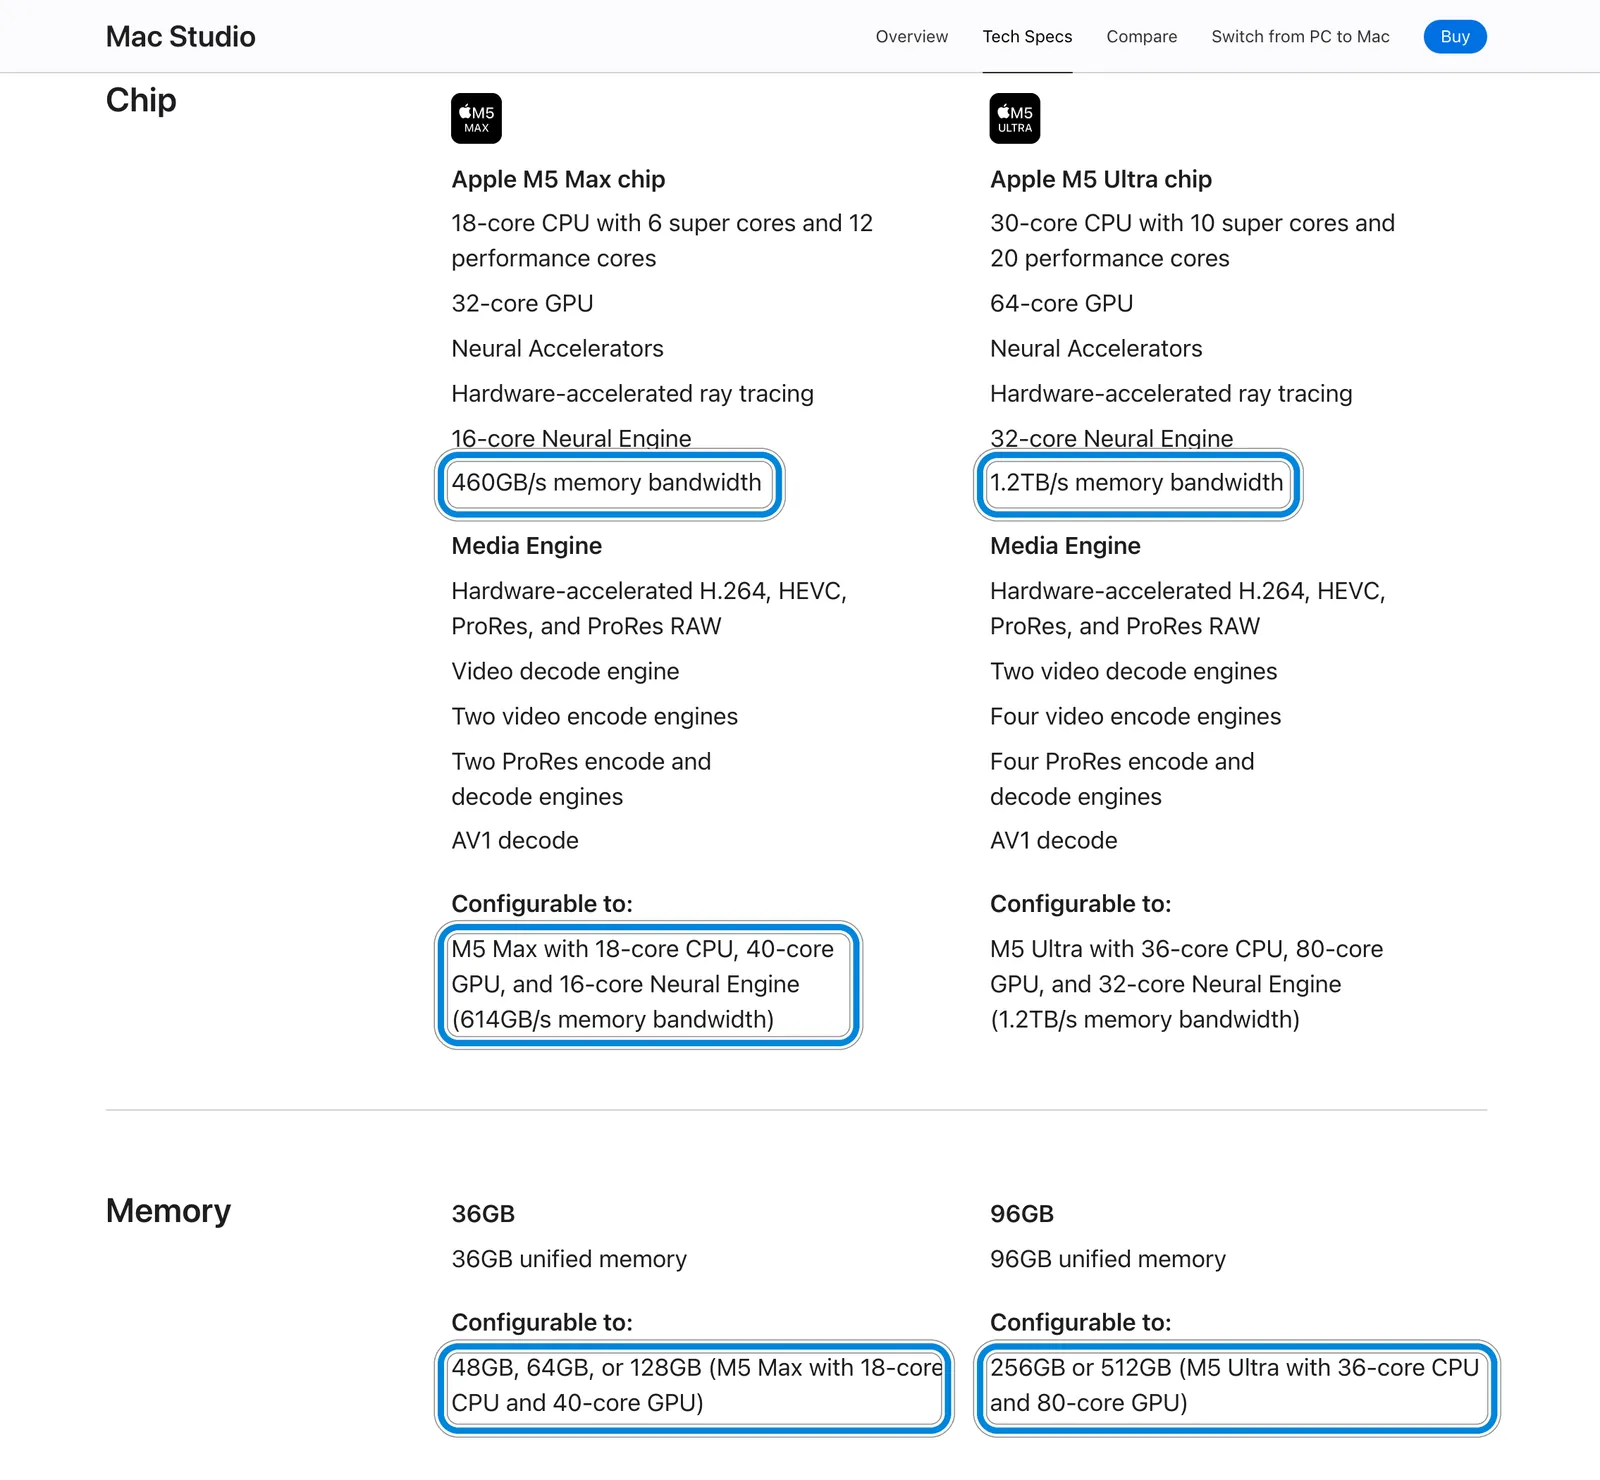
На скриншоте страницы Apple, снятом 25.10.2026, рамками выделено главное: младший M5 Max с 32-ядерным GPU даёт 460 ГБ/с и продаётся только с 36 ГБ, а 48, 64 и 128 ГБ доступны лишь со старшим 40-ядерным, у которого 614 ГБ/с. У Mac Studio M5 Ultra стартовая конфигурация — 96 ГБ, а 256 и 512 ГБ Apple ставит только в версию с 80-ядерным GPU.
График показывает, что объём иногда покупает и скорость: Mac mini M6 на 16 ГБ работает с памятью на 153 ГБ/с, а на 24 и 32 ГБ — на 170 ГБ/с. Та же история у M4 Max: 410 ГБ/с у версии с 36 ГБ и 546 ГБ/с у версии на 48–128 ГБ.Чип Ядра CPU · GPU Пропускная способность, ГБ/с Максимум памяти, ГБ A18 Pro (MacBook Neo) 6 · 5 60 8 M1 8 · 8 68 (таблица llama.cpp, Apple не публикует) 16 M1 Pro 10 · 16 200 32 M1 Max 10 · 32 400 64 M1 Ultra 20 · 64 800 128 M2 8 · 10 100 24 M2 Pro 12 · 19 200 32 M2 Max 12 · 38 400 96 M2 Ultra 24 · 76 800 192 M3 8 · 10 100 24 M3 Pro 12 · 18 150 36 M3 Max (30 GPU / 40 GPU) 14 · 30 / 16 · 40 300 / 400 96 / 128 M3 Ultra 32 · 80 819 512 (у Apple 512 снят 5.03.2026, 256 — 5.05.2026) M4 10 · 10 120 32 M4 Pro 14 · 20 273 64 M4 Max (32 GPU / 40 GPU) 14 · 32 / 16 · 40 410 / 546 36 / 128 M5 10 · 10 153 32 M5 Pro (16 GPU / 20 GPU) 15 · 16 / 18 · 20 307 / 307 64 M5 Max (32 GPU / 40 GPU) 18 · 32 / 18 · 40 460 / 614 36 / 128 M5 Ultra (64 GPU / 80 GPU) 30 · 64 / 36 · 80 1200 / 1200 96 / 512 M6 (16 ГБ / 24–32 ГБ) 12 · 12 153 / 170 32
Для M5 Ultra Apple пишет «1,2 ТБ/с»; в таблице llama.cpp и в наших расчётах доли потолка стоит точнее — 1228 ГБ/с.
Что сейчас реально продаётся с каждым объёмом (по страницам Apple на 25.10.2026): MacBook Neo — только 8 ГБ; MacBook Air M5 — 16, 24 и 32 ГБ; Mac mini M6 — 16, 24 и 32 ГБ; Mac mini и MacBook Pro на M5 Pro — 24, 48 и 64 ГБ; M5 Max — 36 (младший бин), 48, 64 и 128 ГБ; Mac Studio M5 Ultra — 96, 256 и 512 ГБ. «Дешёвого Mac mini на 64 ГБ» на старом M4 Pro в линейке больше нет: 64 ГБ в mini теперь только на M5 Pro, а он стартует в США от $1699 (25.08.2026).
Сколько памяти занимает модель: веса, KV-кэш и запас под macOS
Память под локальную модель — это файл весов, KV-кэш под контекст и то, что macOS оставляет системе. Первое видно по размеру файла, второе приходится считать:
Нужно ≈ файл весов + KV-кэш
KV-кэш на токен = 2 × слои × KV-головы × размер головы × 2 байта (fp16)
Двойка в начале — это ключи (K) и значения (V), которые модель запоминает для каждого токена. Все параметры берутся из config.json модели на Hugging Face.
Разберём на примере Llama 3.3 70B. У неё 80 слоёв, 8 KV-голов и размер головы 128. Получаем 2 × 80 × 8 × 128 × 2 = 327 680 байт, или 320 КиБ на каждый токен. Контекст 32 768 токенов — это около 10,7 ГБ сверху к 42,52 ГБ весов Q4, итого около 53,3 ГБ. На 128 тысячах токенов один только KV-кэш дорастает до ~43 ГБ — столько же, сколько веса.Модель Слои · KV-головы · размер головы KV на токен KV на 8K, ГБ KV на 32K, ГБ KV на 128K, ГБ Llama 3.1 8B 32 · 8 · 128 128 КиБ 1,1 4,3 17,2 Qwen3 14B 40 · 8 · 128 160 КиБ 1,3 5,4 21,5 Qwen3 32B 64 · 8 · 128 256 КиБ 2,1 8,6 34,4 Llama 3.3 70B 80 · 8 · 128 320 КиБ 2,7 10,7 43,0 Qwen3 235B-A22B 94 · 4 · 128 188 КиБ 1,6 6,3 25,2 gpt-oss-120b 18 полных слоёв · 8 · 64 36 КиБ 0,3 1,2 4,8
Нюанс про единицы. Hugging Face и Ollama показывают размер файлов в десятичных гигабайтах, а Apple считает объём памяти в двоичных (1 ГиБ = 1,074 ГБ). Чтобы цифры сравнивались напрямую, все лимиты в статье пересчитаны в десятичные ГБ: например, 3/4 от 512-гигабайтного Mac — это 384 ГиБ, или 412,3 ГБ.
У Qwen3 родной контекст — 40 960 токенов, 128 тысяч включаются растяжением YaRN. У gpt-oss-120b половина слоёв смотрит только на последние 128 токенов, поэтому её кэш крошечный.
Насколько формула близка к реальности, показывают два замера:
- tbreak, Qwen3 30B-A3B в 4 битах на Mac Studio M5 Max (23.09.2026): 18,11 ГБ памяти при промпте в 2 тысячи токенов и 24,26 ГБ при 64 тысячах. Рост на 6 ГБ — это KV-кэш и буферы.
- Apple Machine Learning Research, M5 Ultra 512 ГБ (15.10.2026): Qwen 3.8 27B в BF16 занимает до 68 ГБ, а Mistral Medium 3.5 128B в FP8 — до 158 ГБ при контексте 65 536 токенов.
Лимит видеоядра Mac: сколько единой памяти macOS отдаёт GPU
macOS по умолчанию разрешает видеоядру занять только часть единой памяти. Apple не публикует формулу этого лимита, поэтому опираемся на логи, где llama.cpp печатает значение recommendedMaxWorkingSetSize. В открытых логах нашлось четыре точки:
- M1 Max, 32 ГБ, macOS 13 — 22 906,50 МБ, ровно 2/3 памяти;
- M3 Ultra, 512 ГБ, macOS 15 — 412 316,86 МБ, ровно 3/4;
- M4 Pro, 48 ГБ, macOS 26.3 — 40 200,90 МБ, около 78%;
- MacBook Air M5, 16 ГБ, macOS 26.6.1 — 12,7 ГБ со слов участника таблицы llama.cpp, около 74%.
Доля зависит не только от объёма, но, судя по этим логам, и от версии macOS: на свежей системе видеоядру достаётся около 3/4, больше, чем по старому правилу 2/3. Для 128 ГБ участник обсуждения llama.cpp пишет «около 3/4, то есть 96 ГиБ», но сам лог в обсуждении не опубликован. Единой формулы от Apple нет, поэтому там, где лога нет, в таблицах стоит оценка по правилу 3/4, а свой лимит проверяется одной строкой лога (инструкция ниже).
Сплошные полосы на графике — значения из логов, заштрихованные — оценка. Вторая вкладка показывает, сколько видеоядро получит, если поднять лимит вручную и оставить системе 8 ГБ.Объём памяти Лимит видеоядра по умолчанию, ГБ Откуда После sysctl (системе 8 ГБ), ГБ 8 ГБ (MacBook Neo) ≈ 6,4 ≈ оценка, правило 3/4 — 16 ГБ 12,7 со слов участника llama.cpp #4167, M5, macOS 26.6.1 ≈ 8,6 (выигрыша нет) 24 ГБ ≈ 19,3 ≈ оценка, правило 3/4 ≈ 17,2 (выигрыша нет) 32 ГБ ≈ 25,8 (на macOS 13 — 22,9) ≈ оценка 3/4; 22,9 — лог llama.cpp #22800 ≈ 25,8 (выигрыша нет) 36 ГБ ≈ 29,0 ≈ оценка, правило 3/4 ≈ 30,1 48 ГБ 40,2 лог llama.cpp #20141, M4 Pro, macOS 26.3 ≈ 42,9 64 ГБ ≈ 51,5 ≈ оценка, правило 3/4 ≈ 60,1 96 ГБ ≈ 77,3 ≈ оценка, правило 3/4 ≈ 94,5 128 ГБ ≈ 103,1 со слов участника llama.cpp #29465, лог не опубликован ≈ 128,8 256 ГБ ≈ 206,2 ≈ оценка, правило 3/4 ≈ 257,7 (системе 16 ГБ) 512 ГБ 412,3 лог llama.cpp #15055, M3 Ultra, macOS 15 ≈ 532,6 (системе 16 ГБ)
Как проверить и поднять лимит видеоядра на своём Mac
- Посмотрите текущее значение. Запустите любую модель через llama.cpp и найдите в логе строку
recommendedMaxWorkingSetSize. Это и есть ваш лимит; лог печатает его в десятичных мегабайтах. - Поднимите лимит одной командой. Команда описана в документации MLX:
sudo sysctl iogpu.wired_limit_mb=<значение>. Параметр принимает двоичные мегабайты (МиБ): для Mac на 64 ГБ с запасом 8 ГБ этоsudo sysctl iogpu.wired_limit_mb=57344, то есть 56 ГиБ. Число из лога сюда не подставляйте — ошибётесь примерно на 7%. - Оставьте системе 8–16 ГБ. Значение обязано быть строго меньше всей памяти, иначе macOS начнёт активно сбрасывать данные в своп, и машина затормозит целиком.
- Помните про перезагрузку. Правка живёт до перезапуска Mac, после него лимит возвращается к значению по умолчанию. Значение
0тоже возвращает лимит по умолчанию.
Риск у правки один: если модели и приложениям вместе станет тесно, система уйдёт в своп. Данные это не испортит, но скорость упадёт в разы. Поэтому sysctl — инструмент «впустить модель, которая не влезает на пару гигабайт», а не способ превратить 64 ГБ в 96.
Какой Mac брать под каждую ступень: от MacBook Neo до Mac Studio
8 и 16 ГБ: MacBook Neo, MacBook Air M5 и Mac mini M6
У MacBook Neo на 8 ГБ видеоядру достаётся около 6,4 ГБ (оценка): 8B в Q4 (4,92 ГБ) помещается только с контекстом до 8 тысяч токенов, а при 60 ГБ/с это машина для знакомства с инструментами. На 16 ГБ (12,7 ГБ видеоядру на macOS 26) свободно живут модели до 8B, Qwen3 14B в Q4 — только с коротким контекстом. tbreak советует воспринимать 16 ГБ как ступень для освоения инструментов, а не для рабочей станции.
24 и 32 ГБ: первая рабочая ступень
На 24 ГБ помещается 14B в Q4 с длинным контекстом, на 32 ГБ впервые запускается Qwen3 32B в Q4 — с контекстом около 8 тысяч токенов. tbreak намерил у Qwen3 30B-A3B на 64 тысячах токенов 24,26 ГБ: 24-гигабайтный Mac это уже не тянет, а 32-гигабайтный тянет впритык — по правилу 3/4 у него около 25,8 ГБ для видеоядра, а на старой macOS 13 было 22,9 ГБ и понадобился бы sysctl. Эти объёмы есть у MacBook Air M5 и Mac mini M6.
48 и 64 ГБ: ступень под 70B
48 ГБ — это Qwen3 32B в Q4 с полным контекстом и 32B в Q8 с коротким (по логу на macOS 26; с контекстом 32K Q8 не влезает даже после sysctl — ≈ 43,4 ГБ при 42,9). 64 ГБ — первая ступень для Llama 3.3 70B в Q4 с контекстом около 8 тысяч токенов. tbreak называет 48 ГБ точкой, где 70B «становится возможной», а 64 ГБ — комфортной целью; по нашему расчёту 70B в Q4 даже с коротким контекстом (≈ 45,2 ГБ) в 48 ГБ не помещается, так что реальная ступень под неё — 64 ГБ. Обе ступени есть у M5 Pro и M5 Max; предыдущее поколение этого класса мы разбирали на примере Mac mini M4 Pro.
96 и 128 ГБ: длинный контекст и модели на 100B+
128GB unified memory — максимальная ступень для LLM в MacBook Pro и в Mac Studio на M5 Max, и Apple даёт её только с 40-ядерным GPU. На ней помещаются Llama 3.3 70B в Q8, 70B в Q4 с контекстом на 128 тысяч токенов (≈ 85,5 ГБ по нашей оценке) и gpt-oss-120b: tbreak запускал её через Ollama на Mac Studio со 128 ГБ на скорости около 75 токенов в секунду и подключал к агенту с окном контекста 64K. 96 ГБ — стартовый объём Mac Studio M5 Ultra, gpt-oss-120b помещается и туда. Ноутбучный вариант разобран в обзоре MacBook Pro M5 Max для нейросетей.
256 и 512 ГБ: Qwen3 235B и DeepSeek-R1 671B
На 256 ГБ свободно работает Qwen3 235B-A22B в Q4 (≈ 148,5 ГБ по нашей оценке с контекстом 32K). 512 ГБ — единственная ступень для DeepSeek-R1 671B в Q4 на одной машине: файл весит 404,43 ГБ при лимите 412,3 ГБ. MacStories запускал R1-0528 в 4 битах на Mac Studio M3 Ultra с 512 ГБ, модели понадобилось «чуть меньше 400 ГБ»; 8-битная версия на ~700 ГБ не загрузилась. Опыт жизни с такой моделью — в материале про Mac Studio M3 Ultra.
Цены на графике (25.10.2026) показывают, как ступень памяти тянет за собой цену: от MacBook Neo на 8 ГБ за 36 999 ₴ до MacBook Pro 14 M5 Max со 128 ГБ за 353 699 ₴.
Скорость генерации: измеренные токены в секунду и оценка по формуле
Скорость генерации — сколько токенов в секунду модель пишет в ответ. Лучший открытый источник замеров на Mac — таблица в обсуждении llama.cpp #4167: участники гоняют одну и ту же Llama 2 7B (3,56 ГиБ в Q4_0) на всех чипах M1–M6 одним тестом.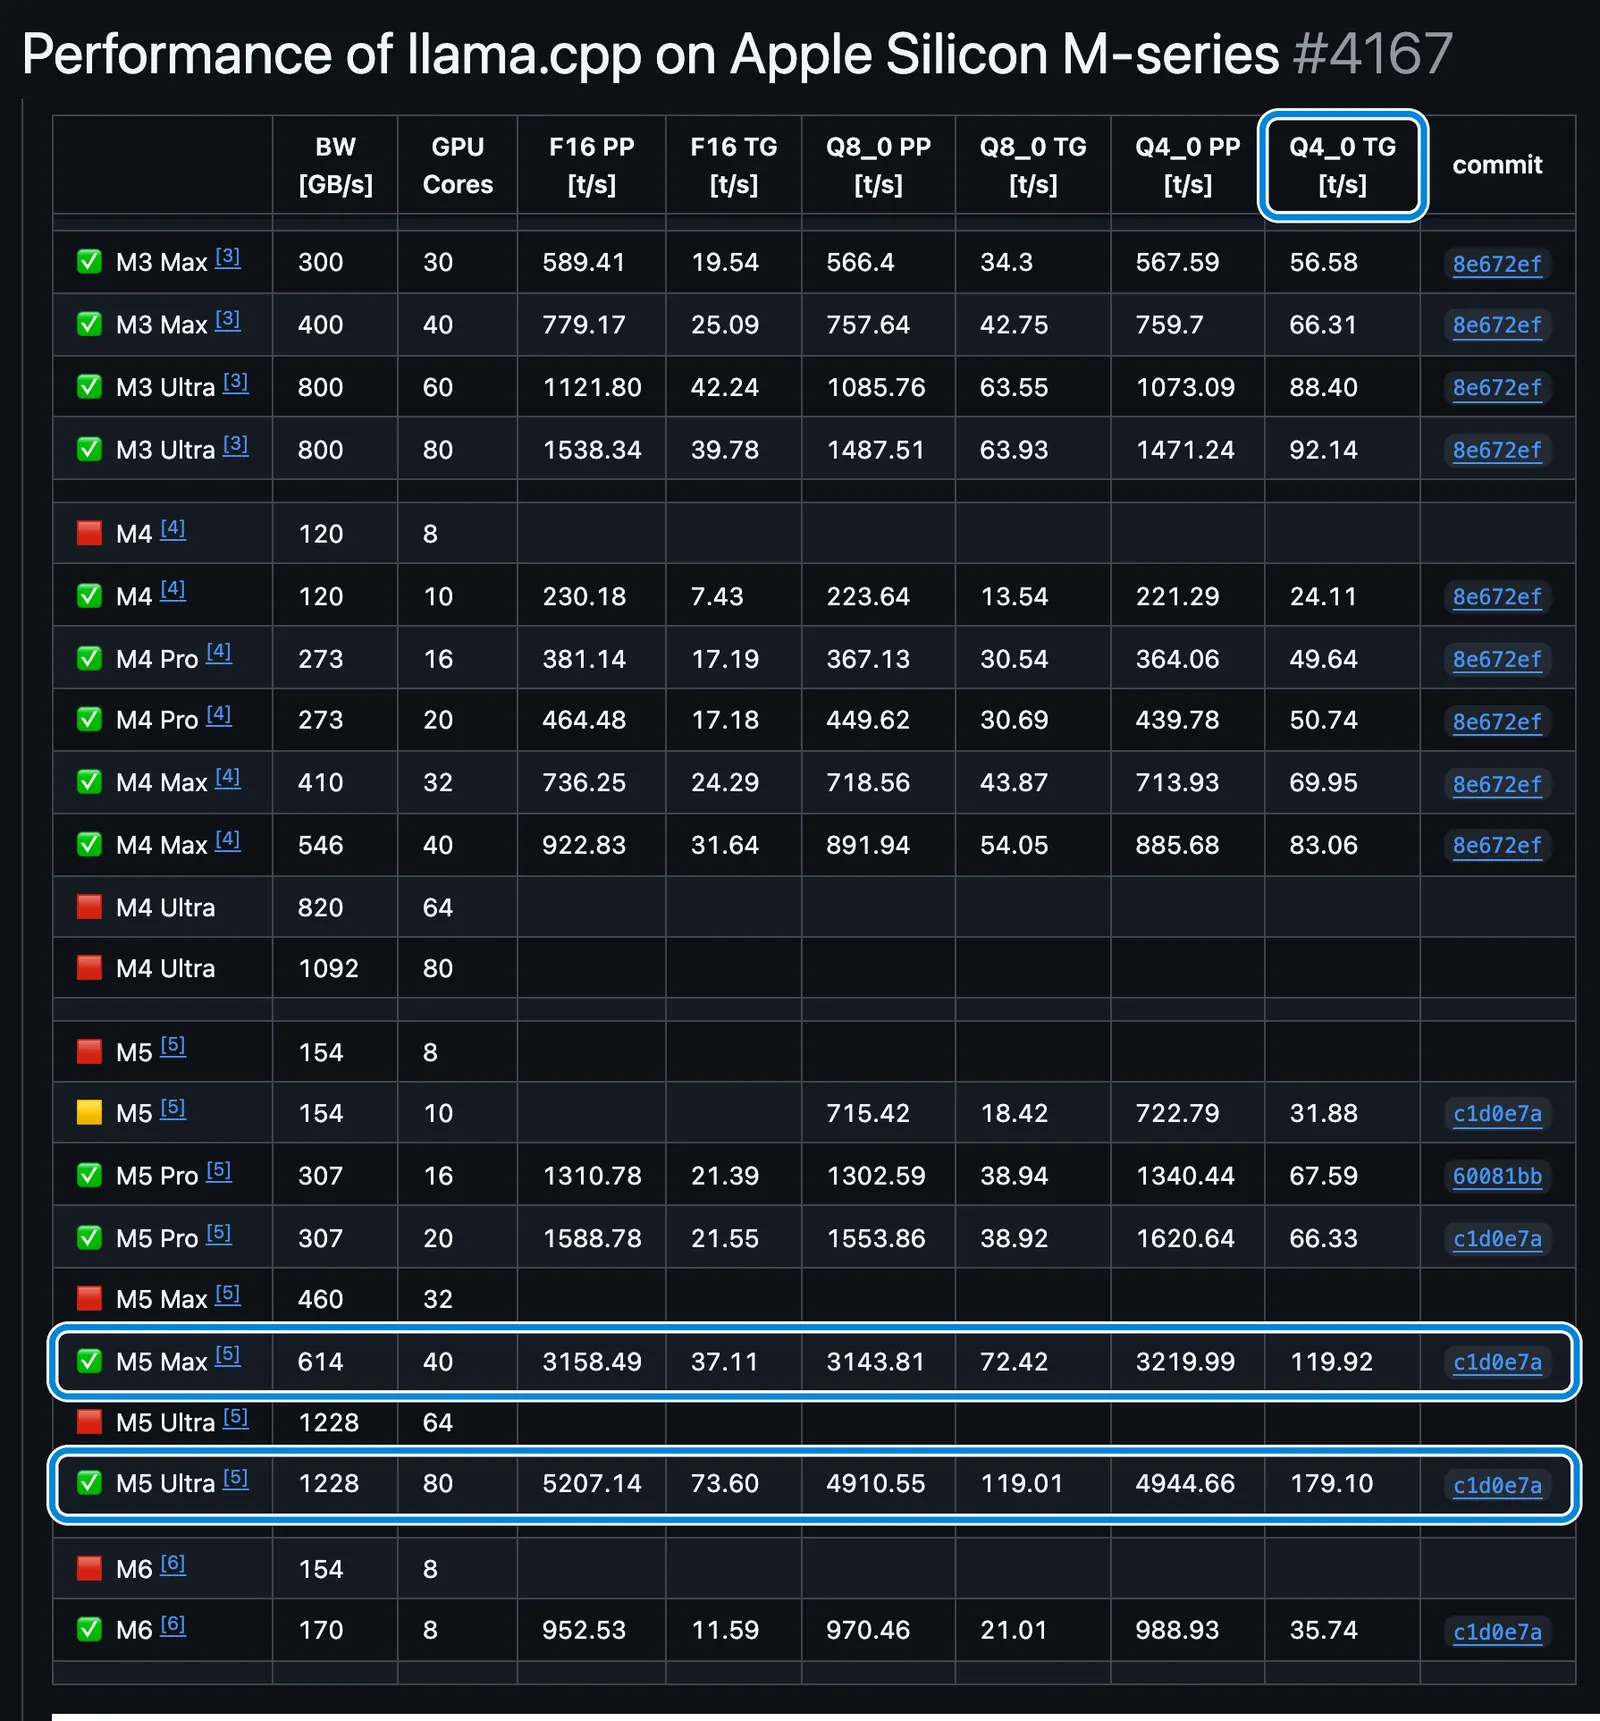
На скриншоте таблицы, снятом 25.10.2026, выделен столбец генерации для Q4_0 и две строки: M5 Max на 40 ядер GPU пишет 119,92 токена в секунду, M5 Ultra на 80 ядер — 179,10. Пустые строки (младший M5 Max, M5 Ultra на 64 ядра) означают, что замера пока нет.
Генерация растёт вместе с пропускной способностью, но не пропорционально: у M5 Ultra шина вдвое шире, чем у M5 Max, а пишет он лишь в полтора раза быстрее. Вторая вкладка показывает чтение промпта: здесь поколение M5 ушло вперёд в 3,3–3,7 раза к M4 и M3 Ultra.Чип Пропускная способность, ГБ/с Генерация, ток/с Чтение промпта, ток/с M1 (8 GPU) 68 14,15 117,96 M1 Pro (16 GPU) 200 36,41 266,25 M1 Max (32 GPU) 400 61,19 530,06 M1 Ultra (64 GPU) 800 83,73 1030,04 M2 (10 GPU) 100 21,91 179,57 M2 Pro (19 GPU) 200 38,86 341,19 M2 Max (38 GPU) 400 65,95 671,31 M2 Ultra (76 GPU) 800 94,27 1238,48 M3 (10 GPU) 100 21,34 186,75 M3 Pro (18 GPU) 150 30,74 341,67 M3 Max (30 GPU) 300 56,58 567,59 M3 Max (40 GPU) 400 66,31 759,70 M3 Ultra (80 GPU) 800 92,14 1471,24 M4 (10 GPU) 120 24,11 221,29 M4 Pro (20 GPU) 273 50,74 439,78 M4 Max (32 GPU) 410 69,95 713,93 M4 Max (40 GPU) 546 83,06 885,68 M5 (10 GPU) 153 31,88 722,79 M5 Pro (20 GPU) 307 66,33 1620,64 M5 Max (40 GPU) 614 119,92 3219,99 M5 Ultra (80 GPU) 1228 179,10 4944,66 M6 (24/32 ГБ) 170 35,74 988,93
Формула скорости: потолок и реальная доля
Популярная прикидка «скорость ≈ пропускная способность ÷ размер модели» описывает потолок, а не прогноз: на один токен нужно один раз прочитать все активные веса. Мы посчитали, какую долю потолка каждый чип реально выдал в таблице llama.cpp:
Доля потолка = измеренная генерация ÷ (пропускная способность ÷ размер файла)
Оценка скорости ≈ пропускная способность ÷ размер модели × доля потолка
Пример для M5 Max на 40 ядер GPU: 614 ГБ/с ÷ 3,823 ГБ = 160,6 токена в секунду в теории, а в замере — 119,92. Доля потолка — 0,75.
Доля не константа: широкая шина Ultra на маленькой модели в 3,8 ГБ просто не загружается работой. Универсальные «65% от потолка» из гайдов (например, у Bizon) — середина диапазона, а не правило.Класс чипа Доля потолка на Llama 2 7B Q4_0 Чипы в выборке Базовые (M1–M6) 0,77–0,84 M1, M2, M3, M4, M5, M6 Pro 0,70–0,83 M1 Pro, M2 Pro, M3 Pro, M4 Pro, M5 Pro Max 0,58–0,75 M1–M5 Max, оба бина M3 и M4 Ultra 0,40–0,56 M1, M2, M3, M5 Ultra
Оценка скорости 8B, 32B и 70B на актуальных Mac
Замеров этих трёх моделей на всех актуальных чипах в одном тесте нет, поэтому ниже — оценка по формуле выше с размером файла Q4_K_M. Для M5 Max с 32-ядерным GPU и для M6 на 16 ГБ своих замеров нет — берём долю ближайшего родственника (M5 Max на 40 ядер и M5). У M5 на 16 ГБ замер есть (доля 0,79), оценка для него та же — около 25 токенов в секунду.
Все полосы заштрихованы — это расчёт; пустая строка — модель с контекстом не помещается в память чипа.Чип Llama 3.1 8B (4,92 ГБ), ток/с Qwen3 32B (19,76 ГБ), ток/с Llama 3.3 70B (42,52 ГБ), ток/с M5 / M6, 16 ГБ (153 ГБ/с) ≈ 25 (потолок 31) не помещается не помещается M6, 24/32 ГБ (170 ГБ/с) ≈ 28 (потолок 35) ≈ 7 на 32 ГБ (потолок 9) не помещается M5 Pro (307 ГБ/с) ≈ 52 (потолок 62) ≈ 13 (потолок 16) ≈ 6 на 64 ГБ (потолок 7) M5 Max, 32 GPU (460 ГБ/с) ≈ 70 (потолок 94) ≈ 17 (потолок 23) не помещается в 36 ГБ M5 Max, 40 GPU (614 ГБ/с) ≈ 93 (потолок 125) ≈ 23 (потолок 31) ≈ 11 (потолок 14) M5 Ultra (1228 ГБ/с) ≈ 139 (потолок 250) ≈ 35 (потолок 62) ≈ 16 (потолок 29)
Сверка с реальностью: та же формула для M4 Max на 40 ядер (546 ГБ/с, доля 0,58) даёт для 70B около 7,5 токена в секунду (оценка), а Bizon приводит реальные результаты на похожих конфигурациях — 8–11 при потолке 12,8. Значит, на больших моделях наша оценка для Max скорее занижена, как и для Ultra: их долю потолка мерили на маленькой модели, которая шину не загружает.
Почему у MoE-моделей скорость другая
Формулу «пропускная способность ÷ весь размер файла» к MoE-моделям применять нельзя: на каждый токен читаются только активные эксперты. gpt-oss-120b весит 63,39 ГБ, но на токен включает 4 эксперта из 128, а её KV-кэш на 32K весит около 1,2 ГБ — у половины слоёв окно всего 128 токенов. Поэтому в замерах она быстрая: 79,68 токена в секунду на M2 Ultra в llama.cpp и около 75 на Mac Studio со 128 ГБ у tbreak. Плотная 70B на M5 Max по нашей оценке даёт около 11. Объём памяти покупается под «сколько параметров всего», а скорость — под «сколько активно».
Prefill против генерации: «в 4,3 раза быстрее» — не про токены
Prefill, или обработка промпта, — это этап, когда модель читает ваш запрос перед первым словом ответа. Он упирается в вычисления видеоядра, а не в память. Генерация после этого упирается в пропускную способность. Поэтому маркетинговые «в N раз быстрее» почти всегда относятся к prefill, и путать их со скоростью ответа нельзя.
В пресс-релизе от 25.08.2026 Apple пишет про «до 4,3 раза больше пиковой вычислительной мощности для ИИ» у M5 Ultra против M3 Ultra. Это про prefill: в ядрах GPU поколения M5 появились нейроускорители для перемножения матриц. По генерации разница скромнее — Apple Machine Learning Research намерила 1,6 раза (15.10.2026), MacStories в своих тестах — около +70% в среднем. Это близко к росту пропускной способности: 1,2 ТБ/с против 819 ГБ/с.Что ускоряется От чего зависит M5 Ultra против M3 Ultra Где заметно Prefill (чтение промпта, время до первого токена) вычисления GPU, нейроускорители до 4,6 раза по времени до первого токена (Apple ML Research) длинные документы, агенты, код Генерация (токены ответа) пропускная способность памяти 1,6 раза (Apple ML Research), ~+70% (MacStories) чат, любые ответы
Для выбора памяти это значит три вещи. Агент с длинным контекстом каждый раз заново читает десятки тысяч токенов, и здесь поколение M5 выигрывает сильнее, чем видно по скорости ответа. Длинный контекст дорог и по времени: у tbreak на M5 Max чтение промпта Qwen3 30B-A3B упало с 5451,9 до 1560,4 токена в секунду при росте промпта с 2 до 64 тысяч. А старый Mac с большой памятью (M1 Max, M2 Ultra) влезает по объёму, но читает промпт в 2,6–6 раз медленнее M5 Max — 530 и 1238 токенов в секунду против 3220.
Подробный разбор M5 Ultra с замерами prefill и генерации — в статье Mac Studio M5 Ultra для LLM.
Картинки, видео, Whisper и эмбеддинги: память сверх LLM
Генераторы картинок и видео, распознавание речи и эмбеддинги (модели, которые превращают текст в числа для поиска по документам) тоже живут в единой памяти, и у некоторых пик гораздо выше размера файла.Нагрузка Размер весов, ГБ Минимальная разумная ступень Комментарий Stable Diffusion XL base 1.0 6,94 16 ГБ по гайдам modelfit и insiderllm — комфортно на 16 ГБ FLUX.1 dev, GGUF Q4_K_S 6,81 16 ГБ впритык, оба гайда отмечают своп FLUX.1 dev, GGUF Q8_0 12,71 32 ГБ рекомендация modelfit FLUX.1 dev, bf16 23,80 64 ГБ рекомендация modelfit LTX-Video 13B, fp8 / bf16 15,69 / 28,58 32 / 64 ГБ ≈ оценка по размеру весов LTX-2.3 22B, видео 241 кадр н/д 128 ГБ замер tbreak: пик 115,16 ГБ, своп 7,59 ГБ Qwen-Image-2.1 н/д 128 ГБ замер MacStories на M5 Ultra: пик 78 ГБ, 180 секунд на картинку Whisper large-v3 3,09 8–16 ГБ ≈ оценка, хватает любой ступени Эмбеддинги BAAI/bge-m3 2,27 8–16 ГБ ≈ оценка, работает рядом с LLM
Самый показательный замер — у видео. tbreak генерировал на Mac Studio со 128 ГБ ролик из 241 кадра 1024×768 моделью LTX-2.3 22B. На основной генерации система занимала около 57 ГБ, а на финальном декодировании кадров — 115,16 ГБ, и macOS выделила 7,59 ГБ свопа. Модель на 22 миллиарда параметров потребовала больше памяти, чем языковая на 120 миллиардов, потому что в конце ей нужно собрать все готовые кадры сразу.
Если в планах видео, ступень выбирают по пику пайплайна, а не по размеру модели; Whisper и эмбеддинги почти ничего не добавляют к бюджету LLM.
Если памяти не хватило: своп, давление памяти и урезанный контекст
Своп — это запись части оперативной памяти на SSD, когда её не хватает. Для локальной модели это катастрофа: каждый токен требует прочитать все веса, и чтение с диска обрушивает скорость. Строгого замера «память против свопа» мы не нашли, поэтому цифру падения не называем. Признаки: генерация в разы медленнее, чем у владельцев того же чипа, а в «Мониторинге системы» на вкладке «Память» график «Давление памяти» жёлтый или красный и растёт «Использовано свопа».
Что делать, если модели не хватает памяти: шесть шагов
- Проверьте, куда загружена модель. В Ollama команда
ollama psпоказывает в колонке PROCESSOR, какая доля модели работает на GPU; всё, что не «100% GPU», уже медленнее. - Урежьте контекст. Контекст 32K у Llama 3.3 70B стоит около 10,7 ГБ, 8K — около 2,7 ГБ. Это самый дешёвый способ освободить память.
- Возьмите квантование сильнее. Переход с Q8 на Q4 почти вдвое снижает вес: у Qwen3 32B — с 34,82 до 19,76 ГБ.
- Закройте тяжёлые приложения. Браузер с десятками вкладок и редактор видео делят ту же единую память.
- Поднимите лимит видеоядра через sysctl, если не хватает пары гигабайт, — см. раздел про лимит.
- Возьмите MoE-модель вместо плотной — см. раздел про скорость MoE.
Сколько стоит память: доплаты Apple и цены в Украине на 25.10.2026
26 июня 2026 года Apple подняла цены на Mac, и в части линеек доплата за память удвоилась.Конфигурация (США) До 26.06.2026 После 26.06.2026 MacBook Air 13 M5, 16 ГБ / 512 ГБ $1099 $1299 MacBook Air M5: доплата за 24 / 32 ГБ +$200 / +$400 +$200 / +$400 (не изменилась) MacBook Pro 14 M5, 16 ГБ / 512 ГБ $1599 $1899 MacBook Pro M5 Max: 48 → 64 ГБ +$200 +$400 MacBook Pro M5 Max: 48 → 128 ГБ +$1000 +$2000 Mac mini, 16 ГБ / 256 ГБ $599 (M4) $799 (M4), $899 (M6, с 25.08.2026) Mac mini M5 Pro — от $1699 (25.08.2026) Mac Studio M5 Max / M5 Ultra 64 GPU / 80 GPU — от $2499 / $5499 / $6799 (25.08.2026)
Расхождение источников здесь кажущееся: BasicAppleGuy и GeekChamp пишут, что доплата за память не выросла, Digital Trends — что удвоилась. Правы обе стороны, просто про разные линейки: у MacBook Air шаги остались $200 и $400, у MacBook Pro с M5 Max — подорожали вдвое.
Цены в Украине на 25.10.2026 — по магазинам и объявлениям, со скидками на эту дату. Бин влияет на скорость: MacBook Air 13 M5 16/512 в таблице — версия с 10 ядрами CPU и 8 GPU, Mac mini M5 Pro 24/512 — младший бин с 15 ядрами CPU и 16 GPU.Mac и конфигурация Память, ГБ Цена, ₴ ₴ за 1 ГБ памяти Где MacBook Neo 8/256 8 36 999 ≈ 4625 Jabko Mac mini M6 16/256 16 55 799 ≈ 3487 ti.ua (Hotline: 48 400–56 663) Mac mini M6 16/512 16 68 599 ≈ 4287 ti.ua MacBook Air 13 M5 16/512 16 72 899 ≈ 4556 Jabko Mac mini M6 24/512 24 81 499 ≈ 3396 ti.ua MacBook Air 13 M5 24/1TB 24 92 999 ≈ 3875 Jabko Mac mini M5 Pro 24/512 24 105 499 ≈ 4396 ti.ua Mac Studio M5 Max 36/512 36 151 599 ≈ 4211 ti.ua (Hotline: 127 529–161 849) Mac Studio M5 Max 64/1TB 64 от 246 780 ≈ 3856 Hotline Mac Studio M5 Ultra 96/1TB 96 343 999 ≈ 3583 ti.ua (Hotline: от 273 289) MacBook Pro 14 M5 Max 128/2TB 128 353 699 ≈ 2763 Jabko б/у Mac mini M4 16/256 16 40 999 ≈ 2562 Jabko, «хороший стан» б/у MacBook Pro 16 M1 Max 32/1TB 32 от 56 500 ≈ 1766 OLX б/у MacBook Pro 16 M2 Max 64/1TB 64 118 999 ≈ 1859 OLX б/у Mac Studio M2 Ultra 64/1TB 64 130 000 ≈ 2031 OLX
Столбец «₴ за 1 ГБ» — наш расчёт: цена делится на объём памяти без учёта диска и чипа, это ориентир, а не реальная цена гигабайта.
Сколько стоит шаг памяти в Украине на одной модели и том же диске:
- Mac mini M6, 16 → 24 ГБ при 512 ГБ SSD: 68 599 → 81 499 ₴, доплата 12 900 ₴ (ti.ua, 25.10.2026).
- MacBook Air 13 M5, 16 → 24 ГБ при 1 ТБ: 80 499 → 92 999 ₴, доплата 12 500 ₴ (Jabko, 25.10.2026).
Вторичка — самый дешёвый способ получить объём: MacBook Pro 16 на M1 Max с 32 ГБ на OLX стоит от 56 500 ₴ (25.10.2026), почти как новый Mac mini M6 с 16 ГБ. Платите за это скоростью: генерация у M1 Max вдвое медленнее, чем у M5 Max, а промпт он читает в 6 раз медленнее.
Как выбрать объём под задачу: от первой модели до агента с 128K
Выбирая Mac для нейросетей, начинайте с вопроса «какую самую большую модель я хочу запускать каждый день и с каким контекстом». Отвечать на него приходится до покупки: память не добавить, а цена шага у Apple с лета 2026 выросла. Саму модель под задачу удобнее выбирать после этого: сначала бюджет памяти, потом список того, что в него помещается.Задача Минимум Разумный выбор Почему Попробовать локальные модели, чат на 8B 16 ГБ 24 ГБ 8B с контекстом 32K займёт ≈ 9,2 ГБ при лимите видеоядра 12,7 ГБ Перевод, суммаризация, помощник по коду на 14B 24 ГБ 32 ГБ 14B в Q8 с длинным контекстом — ≈ 21,1 ГБ Модели класса 30B, документы на десятки страниц 32 ГБ 48 ГБ 32B в Q4 с контекстом 32K — ≈ 28,4 ГБ Llama 3.3 70B и аналоги каждый день 64 ГБ 96–128 ГБ на 64 ГБ контекст только короткий gpt-oss-120b, агент с контекстом 64K 96 ГБ 128 ГБ замер tbreak: около 75 ток/с на 128 ГБ Генерация видео 64 ГБ 128 ГБ пик LTX-2.3 — 115,16 ГБ Qwen3 235B, исследовательские задачи 256 ГБ 256 ГБ ≈ 148,5 ГБ с контекстом 32K DeepSeek-R1 671B на одной машине 512 ГБ 512 ГБ или кластер запас всего около 8 ГБ
Если нужен MacBook для LLM, а не настольный Mac, выбор уже: MacBook Air M5 заканчивается на 32 ГБ при 153 ГБ/с, MacBook Pro на M5 Pro — 64 ГБ при 307 ГБ/с, на M5 Max — 128 ГБ при 614 ГБ/с. Под 70B каждый день в ноутбуке разумна только последняя конфигурация.
Несколько правил, которые экономят деньги:
- Не путайте «запускается» и «работает». Если модель проходит только с контекстом 8K, для агентов и длинных документов ступень мала.
- Смотрите на бин, а не только на объём. Младший M5 Max с 36 ГБ работает на 460 ГБ/с, старший с 48 ГБ — на 614 ГБ/с. За шаг в 12 ГБ вы получаете ещё и +33% к шине.
- Больше 512 ГБ — это кластер, а не покупка. Apple ML Research запускала модель на 816 миллиардов параметров (около 493 ГБ в 4 битах) на четырёх Mac Studio M5 Ultra через Thunderbolt 5 и получила свыше 36 токенов в секунду (15.10.2026). Это способ обойтись без самой дорогой ступени или выйти за её предел.
Слабые места единой памяти Mac: цены, апгрейд и дефицит 512 ГБ
У единой памяти Mac есть ограничения, о которых стоит знать до покупки:
- Память нельзя добавить. Она распаяна вместе с чипом, и ошибка с объёмом исправляется только покупкой новой машины (Digital Trends, июль 2026). Цена шага при этом выросла — см. раздел про стоимость памяти.
- Самые большие ступени исчезают. Apple сняла Mac Studio M3 Ultra с 512 ГБ 5 марта 2026 года (Cult of Mac), а 256 ГБ — 5 мая 2026 года (по данным BasicAppleGuy, единственный открытый источник). Mac Studio M5 Ultra с 512 ГБ Apple в пресс-релизе от 25.08.2026 обещала «в конце октября», но подтверждения продаж на 25.10.2026 мы не нашли — перед покупкой проверьте конфигуратор Apple.
- Лимит видеоядра не прозрачен. Apple не публикует, сколько памяти отдаёт GPU; в открытых логах есть лишь единичные точки, и доля, судя по ним, меняется с версией macOS. Правка sysctl живёт до перезагрузки.
- Скорость уступает видеокарте и новым чипам. На моделях до 32 ГБ RTX 5090 быстрее, а старые Max и Ultra со вторичного рынка в разы медленнее читают промпт — цифры в разделах про видеопамять и prefill.
Первыми в этой статье устареют цены и наличие ступеней: свежие данные — в конфигураторе на apple.com и на страницах магазинов. Таблица скорости llama.cpp пополняется участниками, туда же со временем попадут замеры младшего M5 Max и M5 Ultra на 64 ядра.
Частые вопросы про память Mac для ИИ
Хватит ли 16 ГБ единой памяти Mac для локального ИИ?
Хватит, чтобы освоить инструменты и запускать модели до 8B: Llama 3.1 8B в 4 битах с контекстом 32K займёт около 9,2 ГБ при лимите видеоядра 12,7 ГБ на macOS 26. Qwen3 14B пойдёт только с коротким контекстом, модели 30B и больше — нет. Для регулярной работы с локальными моделями разумная стартовая ступень — 32 ГБ.
Чем единая память Mac отличается от видеопамяти видеокарты?
Единая память — одна общая ОЗУ для процессора, видеоядра и системы, видеопамять — отдельная память только для видеокарты. У Mac её больше (до 512 ГБ против 32 ГБ у RTX 5090), но она медленнее (1,2 ТБ/с против 1,79 ТБ/с) и делится с macOS. Поэтому Mac запускает модели, которые не влезают в видеокарту, а видеокарта быстрее на тех, что влезают.
Можно ли добавить память в Mac после покупки?
Нет. Во всех Mac на Apple Silicon память распаяна вместе с чипом, слотов под модули нет. Объём выбирают один раз при покупке, поэтому лучше взять ступень с запасом под контекст. Если памяти не хватило, остаются урезанный контекст, более сильное квантование, правка лимита sysctl или продажа Mac и покупка новой конфигурации.
Сколько памяти нужно Mac для модели на 70B?
Для Llama 3.3 70B в 4 битах нужно минимум 64 ГБ: веса весят 42,52 ГБ, и на такой ступени без правок помещается контекст около 8 тысяч токенов. Для контекста 32K нужно около 53 ГБ под видеоядро — это 96–128 ГБ или 64 ГБ после правки sysctl (около 60 ГБ видеоядру). Для 8-битной версии (74,98 ГБ весов) — 128 ГБ, на 96 ГБ только после sysctl.
Что такое iogpu.wired_limit_mb и безопасно ли менять лимит?
Это системная настройка macOS, которая задаёт, сколько мегабайт памяти может занять видеоядро. Меняется командой sudo sysctl iogpu.wired_limit_mb=<МиБ>, описанной в документации MLX, и сбрасывается при перезагрузке. Для данных это безопасно, если оставить системе 8–16 ГБ: при нехватке памяти macOS уйдёт в своп, и всё замедлится, но ничего не сломается.
Сколько стоит доплата за память у Apple и в Украине?
В США после 26.06.2026 у MacBook Air шаги остались по $200 за 24 ГБ и $400 за 32 ГБ, а в MacBook Pro с M5 Max переход с 48 на 128 ГБ подорожал с $1000 до $2000. В Украине на 25.10.2026 Mac mini M6 с 24 ГБ дороже версии на 16 ГБ на 12 900 ₴, MacBook Air 13 M5 — на 12 500 ₴.