



Коротко (TL;DR)
- У Mac unified memory для LLM важать два різні числа: обсяг єдиної пам’яті вирішує, яка модель узагалі запуститься, а пропускна здатність пам’яті — наскільки швидко вона відповідатиме. Обидва залежать від конкретного чипа.
- 16 ГБ — моделі до 8B із повноцінним контекстом і 14B із коротким; 32 ГБ — 32B із коротким контекстом; 64 ГБ — 70B у 4 бітах упритул; 96–128 ГБ — 70B із довгим контекстом і gpt-oss-120b; 256 ГБ — Qwen3 235B; 512 ГБ — DeepSeek-R1 671B у 4 бітах, майже без запасу.
- Відеоядру macOS за замовчуванням віддає не всю пам’ять: за логами llama.cpp на свіжих macOS — близько 3/4 (74% на 16 ГБ, 78% на 48 ГБ, 75% на 512 ГБ), на старій macOS 13 було 2/3. Ліміт можна підняти командою
sysctl, але до перезавантаження. - Швидкість генерації впирається у формулу «пропускна здатність ÷ розмір моделі», але це стеля: за вимірами llama.cpp чипи видають від 40% (Ultra на малій моделі) до 84% (базовий M2) цієї стелі.
- Станом на 25.10.2026 в Україні Mac mini M6 із 16 ГБ коштує від 55 799 ₴, Mac Studio M5 Ultra з 96 ГБ — 343 999 ₴. Mac Studio на 512 ГБ Apple обіцяла «наприкінці жовтня», підтвердження продажів на цю дату ми не знайшли.
Скільки єдиної пам’яті потрібно Mac для ШІ: ступені від 16 до 512 ГБ
Головне питання «скільки брати» розв’язує одна таблиця: моделі у двох варіантах стиснення проти обсягів, які продає Apple. На перетині — чи поміститься модель у ту частину пам’яті, яку macOS віддає відеоядру. Спершу чотири терміни:
- Коротко (TL;DR)
- Скільки єдиної пам’яті потрібно Mac для ШІ: ступені від 16 до 512 ГБ
- Єдина пам’ять Mac проти відеопам’яті відеокарти: що вирішує обсяг
- Пропускна здатність і максимум пам’яті за чипами M1–M6 і бінами
- Скільки пам’яті займає модель: ваги, KV-кеш і запас під macOS
- Ліміт відеоядра Mac: скільки єдиної пам’яті macOS віддає GPU
- Який Mac брати під кожен ступінь: від MacBook Neo до Mac Studio
- Швидкість генерації: виміряні токени за секунду й оцінка за формулою
- Prefill проти генерації: «у 4,3 раза швидше» — не про токени
- Зображення, відео, Whisper та ембединги: пам’ять понад LLM
- Якщо пам’яті забракло: своп, тиск пам’яті й урізаний контекст
- Скільки коштує пам’ять: доплати Apple і ціни в Україні на 25.10.2026
- Як обрати обсяг під завдання: від першої моделі до агента з 128K
- Слабкі місця єдиної пам’яті Mac: ціни, апгрейд і дефіцит 512 ГБ
- Часті запитання про пам’ять Mac для ШІ
Ця стаття — частина гіда «Який Mac обрати»: там карта всіх чипів M1–M6 з тестами, підбір конфігурації під вашу задачу і калькулятор «яка нейромережа вміститься».
- Єдина пам’ять (unified memory) — одна спільна оперативна пам’ять, з якої читають і процесор, і відеоядро Mac. Окремої відеопам’яті, як у відеокарти, у Mac немає.
- Квантування — стиснення ваг моделі: Q4 зберігає кожен параметр приблизно в 4 бітах, Q8 — у 8 бітах. Q4 удвічі легша, а якість майже не страждає; докладно розбирали в матеріалі про квантування локальних LLM.
- Контекст — скільки тексту модель тримає в голові за раз, у токенах. Токен — шматок слова: склад, слово або розділовий знак. Контекст зберігається в KV-кеші — службовій пам’яті, яка росте з довжиною розмови.
- MoE (mixture of experts, «суміш експертів») — модель, у якої на кожен токен працює лише частина параметрів. Пам’ять вона займає під усі параметри, а швидкість визначають тільки активні.
Яка модель вміщується в який обсяг пам’яті Mac (оцінка за формулою, ліміт відеоядра — за логами для 16, 48 і 512 ГБ, решта за правилом 3/4)Модель і стиснення Потрібно, ГБ (8K / 32K) 16 ГБ 24 ГБ 32 ГБ 48 ГБ 64 ГБ 96 ГБ 128 ГБ 256 ГБ 512 ГБ Llama 3.1 8B Q4 6,0 / 9,2 так так так так так так так так так Llama 3.1 8B Q8 9,6 / 12,8 8K так так так так так так так так Qwen3 14B Q4 10,3 / 14,4 8K так так так так так так так так Qwen3 14B Q8 17,0 / 21,1 ні 8K так так так так так так так Qwen3 32B Q4 21,9 / 28,4 ні ні 8K так так так так так так Qwen3 32B Q8 37,0 / 43,4 ні ні ні 8K так так так так так Llama 3.3 70B Q4 45,2 / 53,3 ні ні ні ні 8K так так так так Llama 3.3 70B Q8 77,7 / 85,7 ні ні ні ні ні sysctl так так так gpt-oss-120b (MoE, MXFP4) 63,7 / 64,6 ні ні ні ні ні так так так так Qwen3 235B-A22B Q4 (MoE) 143,7 / 148,5 ні ні ні ні ні ні ні так так Qwen3 235B-A22B Q8 (MoE) 251,5 / 256,2 ні ні ні ні ні ні ні sysctl так DeepSeek-R1 671B Q4 (MoE) від 404,4 ні ні ні ні ні ні ні ні упритул DeepSeek-R1 671B Q8 (MoE) від 713,3 ні ні ні ні ні ні ні ні ні
Як читати клітинки:
- так — ваги й контекст на 32 768 токенів вміщуються в ліміт відеоядра за замовчуванням;
- 8K — вміщується лише з коротким контекстом, близько 8 тисяч токенів: досить для чату, але не для довгого документа чи агента;
- sysctl — модель увійде, тільки якщо підняти ліміт відеоядра вручну й залишити системі близько 8 ГБ (на 256 ГБ — 16 ГБ);
- ні — не вміщується навіть так; на Mac вона піде через своп і стане непридатною за швидкістю.
«Потрібно» — це файл ваг із Hugging Face плюс KV-кеш на 8 і 32 тисячі токенів, порахований за config.json моделі. Буфери рушія сюди не входять, тож на межі ступеня реальне навантаження може не поміститися. У DeepSeek-R1 власна схема уваги (MLA), її KV-кеш ми не рахували — тому «від».
Головний висновок таблиці: ступені 48 і 64 ГБ купують не під ваги, а під контекст. Ваги 70B у Q4 — 42,52 ГБ, на 64 ГБ вони вміщуються, але на довгу розмову місця майже не лишається. MoE-моделі почуваються на Mac вільніше за щільні (чому — у розділі про швидкість MoE), а 512 ГБ — єдиний ступінь під 671B на одній машині, із запасом близько 8 ГБ.
На графіку видно, де в моделі проходить межа ступеня: Llama 3.3 70B із контекстом 32K (≈ 53,3 ГБ) уже не вміщується в 64-гігабайтний Mac без зміни ліміту, а Qwen3 235B (≈ 148,5 ГБ) переступає через 128 ГБ.Модель Тип Ваги Q4, ГБ Ваги Q8, ГБ KV-кеш 32K, ГБ Q4 + 32K, ГБ (≈ оцінка) Q8 + 32K, ГБ (≈ оцінка) Llama 3.1 8B щільна 4,92 8,54 4,3 ≈ 9,2 ≈ 12,8 Qwen3 14B щільна 9,00 15,70 5,4 ≈ 14,4 ≈ 21,1 Qwen3 32B щільна 19,76 34,82 8,6 ≈ 28,4 ≈ 43,4 Llama 3.3 70B щільна 42,52 74,98 10,7 ≈ 53,3 ≈ 85,7 gpt-oss-120b MoE 63,39 (MXFP4) н/д 1,2 ≈ 64,6 н/д Qwen3 235B-A22B MoE 142,15 249,94 6,3 ≈ 148,5 ≈ 256,2 DeepSeek-R1 671B MoE 404,43 713,29 н/д н/д н/д
Єдина пам’ять Mac проти відеопам’яті відеокарти: що вирішує обсяг
Порівняння unified memory vs VRAM для LLM зводиться до двох чисел: скільки гігабайтів моделі вміщується і з якою швидкістю їх можна прочитати. Відеокарта виграє швидкість, Mac виграє обсяг. У RTX 5090 32 ГБ відеопам’яті з пропускною здатністю 1,79 ТБ/с, у Mac Studio M5 Ultra — до 512 ГБ спільної пам’яті та 1,2 ТБ/с.
Пропускна здатність — скільки гігабайтів даних пам’ять віддає чипу за секунду. Щоб написати один токен відповіді, модель читає з пам’яті всі свої активні ваги. Тому, коли модель цілком вміщується в пам’ять, генерацією керує саме цей параметр.
Що з цього випливає на практиці:
- Модель вміщується в 32 ГБ — відеокарта швидша. MacStories на одній моделі Qwen 3.8 27B (на Mac — MLX, на ПК — GGUF у LM Studio) отримав у RTX 5090 близько +25% у генерації та ~3000 токенів за секунду на читанні промпту з 6000 токенів проти ~1700 у M5 Ultra (30.09.2026).
- Модель не вміщується в 32 ГБ — tbreak завантажив gpt-oss-120b на Mac Studio зі 128 ГБ, а система з RTX 5090 не змогла вмістити її у відеопам’ять.
- Довгий контекст — теж питання обсягу: на 256 тисячах токенів RTX 5090 упоралася в MacStories лише з 8-бітним KV-кешем.
Єдина пам’ять — не єдиний спосіб отримати багато пам’яті під модель. Міні-ПК на NVIDIA GB10 і AMD Strix Halo влаштовані схоже, і ми порівнювали їх із Mac Studio в розборі DGX Spark, Mac Studio і Strix Halo. Скільки відеопам’яті просять різні моделі у світі відеокарт, розібрано в статті відеопам’ять під LLM — там і докладна формула KV-кешу.
| Що порівнюємо | Єдина пам’ять Mac | Відеопам’ять відеокарти |
|---|---|---|
| Максимальний обсяг | до 512 ГБ (M5 Ultra) | 32 ГБ у RTX 5090 |
| Пропускна здатність | 60 ГБ/с (MacBook Neo) — 1,2 ТБ/с (M5 Ultra) | 1,79 ТБ/с у RTX 5090 |
| Хто користується пам’яттю | процесор, відеоядро, macOS, застосунки — ділять одну | лише відеоядро |
| Чи можна додати пізніше | ні, пам’ять розпаяна разом із чипом | ні, але можна поставити другу карту |
| Сильна сторона | великі моделі й довгий контекст на одній тихій машині | швидкість на моделях, які вміщуються |
Пропускна здатність і максимум пам’яті за чипами M1–M6 і бінами
Пропускна здатність залежить не лише від покоління й класу чипа (базовий, Pro, Max, Ultra), а й від біна — урізаної чи повної версії того самого кристала. Apple продає один чип у двох варіантах із різною кількістю ядер GPU, і в молодшого часто вужча шина пам’яті. Офіційні цифри — на сторінці технічних характеристик Mac Studio і в специфікаціях інших моделей.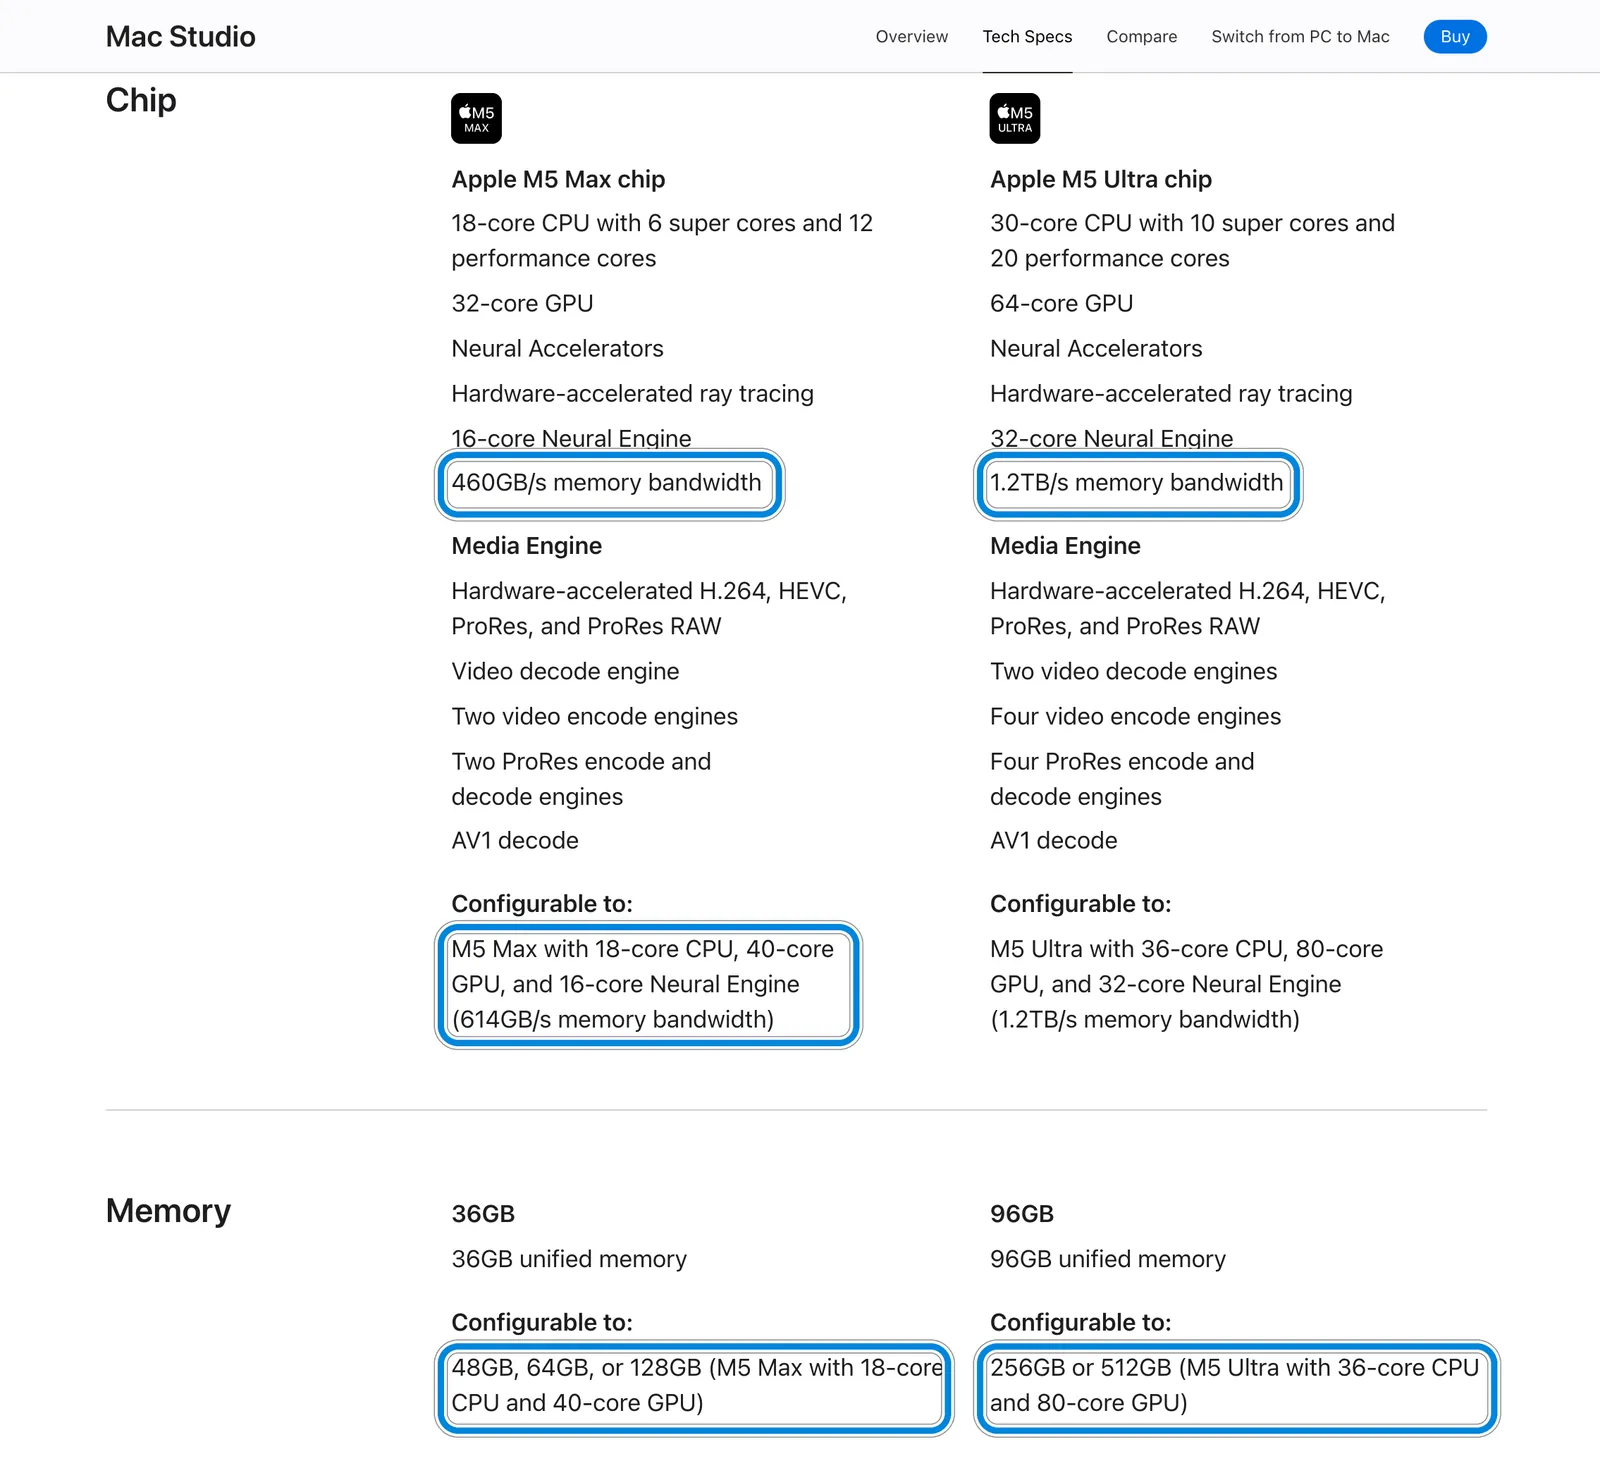
На знімку сторінки Apple від 25.10.2026 рамками виділено головне: молодший M5 Max із 32-ядерним GPU дає 460 ГБ/с і продається лише з 36 ГБ, а 48, 64 і 128 ГБ доступні тільки зі старшим 40-ядерним, у якого 614 ГБ/с. У Mac Studio M5 Ultra стартова конфігурація — 96 ГБ, а 256 і 512 ГБ Apple ставить лише у версію з 80-ядерним GPU.
Графік показує, що обсяг інколи купує і швидкість: Mac mini M6 на 16 ГБ працює з пам’яттю на 153 ГБ/с, а на 24 і 32 ГБ — на 170 ГБ/с. Та сама історія в M4 Max: 410 ГБ/с у версії з 36 ГБ і 546 ГБ/с у версії на 48–128 ГБ.Чип Ядра CPU · GPU Пропускна здатність, ГБ/с Максимум пам’яті, ГБ A18 Pro (MacBook Neo) 6 · 5 60 8 M1 8 · 8 68 (таблиця llama.cpp, Apple не публікує) 16 M1 Pro 10 · 16 200 32 M1 Max 10 · 32 400 64 M1 Ultra 20 · 64 800 128 M2 8 · 10 100 24 M2 Pro 12 · 19 200 32 M2 Max 12 · 38 400 96 M2 Ultra 24 · 76 800 192 M3 8 · 10 100 24 M3 Pro 12 · 18 150 36 M3 Max (30 GPU / 40 GPU) 14 · 30 / 16 · 40 300 / 400 96 / 128 M3 Ultra 32 · 80 819 512 (в Apple 512 прибрано 5.03.2026, 256 — 5.05.2026) M4 10 · 10 120 32 M4 Pro 14 · 20 273 64 M4 Max (32 GPU / 40 GPU) 14 · 32 / 16 · 40 410 / 546 36 / 128 M5 10 · 10 153 32 M5 Pro (16 GPU / 20 GPU) 15 · 16 / 18 · 20 307 / 307 64 M5 Max (32 GPU / 40 GPU) 18 · 32 / 18 · 40 460 / 614 36 / 128 M5 Ultra (64 GPU / 80 GPU) 30 · 64 / 36 · 80 1200 / 1200 96 / 512 M6 (16 ГБ / 24–32 ГБ) 12 · 12 153 / 170 32
Для M5 Ultra Apple пише «1,2 ТБ/с»; у таблиці llama.cpp і в наших розрахунках частки стелі стоїть точніше — 1228 ГБ/с.
Що зараз реально продається з кожним обсягом (за сторінками Apple станом на 25.10.2026): MacBook Neo — лише 8 ГБ; MacBook Air M5 — 16, 24 і 32 ГБ; Mac mini M6 — 16, 24 і 32 ГБ; Mac mini та MacBook Pro на M5 Pro — 24, 48 і 64 ГБ; M5 Max — 36 (молодший бін), 48, 64 і 128 ГБ; Mac Studio M5 Ultra — 96, 256 і 512 ГБ. «Дешевого Mac mini на 64 ГБ» на старому M4 Pro в лінійці більше немає: 64 ГБ у mini тепер лише на M5 Pro, а він стартує у США від $1699 (25.08.2026).
Скільки пам’яті займає модель: ваги, KV-кеш і запас під macOS
Пам’ять під локальну модель — це файл ваг, KV-кеш під контекст і те, що macOS лишає системі. Перше видно з розміру файлу, друге доводиться рахувати:
Потрібно ≈ файл ваг + KV-кеш
KV-кеш на токен = 2 × шари × KV-голови × розмір голови × 2 байти (fp16)
Двійка на початку — це ключі (K) і значення (V), які модель запам’ятовує для кожного токена. Усі параметри беруться з config.json моделі на Hugging Face.
Розберімо на прикладі Llama 3.3 70B. У неї 80 шарів, 8 KV-голів і розмір голови 128. Виходить 2 × 80 × 8 × 128 × 2 = 327 680 байтів, або 320 КіБ на кожен токен. Контекст на 32 768 токенів — це близько 10,7 ГБ понад 42,52 ГБ ваг Q4, разом близько 53,3 ГБ. На 128 тисячах токенів сам лише KV-кеш доростає до ~43 ГБ — стільки ж, скільки ваги.Модель Шари · KV-голови · розмір голови KV на токен KV на 8K, ГБ KV на 32K, ГБ KV на 128K, ГБ Llama 3.1 8B 32 · 8 · 128 128 КіБ 1,1 4,3 17,2 Qwen3 14B 40 · 8 · 128 160 КіБ 1,3 5,4 21,5 Qwen3 32B 64 · 8 · 128 256 КіБ 2,1 8,6 34,4 Llama 3.3 70B 80 · 8 · 128 320 КіБ 2,7 10,7 43,0 Qwen3 235B-A22B 94 · 4 · 128 188 КіБ 1,6 6,3 25,2 gpt-oss-120b 18 повних шарів · 8 · 64 36 КіБ 0,3 1,2 4,8
Нюанс щодо одиниць. Hugging Face та Ollama показують розмір файлів у десяткових гігабайтах, а Apple зазначає обсяг пам’яті у двійкових (1 ГіБ = 1,074 ГБ). Щоб цифри порівнювалися безпосередньо, усі ліміти в статті переведено в десяткові ГБ: наприклад, 3/4 від 512-гігабайтного Mac — це 384 ГіБ, або 412,3 ГБ.
У Qwen3 рідний контекст — 40 960 токенів, 128 тисяч вмикаються розтягуванням YaRN. У gpt-oss-120b половина шарів дивиться лише на останні 128 токенів, тому її кеш крихітний.
Наскільки формула близька до реальності, показують два виміри:
- tbreak, Qwen3 30B-A3B у 4 бітах на Mac Studio M5 Max (23.09.2026): 18,11 ГБ пам’яті з промптом на 2 тисячі токенів і 24,26 ГБ на 64 тисячах. Приріст на 6 ГБ — це KV-кеш і буфери.
- Apple Machine Learning Research, M5 Ultra 512 ГБ (15.10.2026): Qwen 3.8 27B у BF16 займає до 68 ГБ, а Mistral Medium 3.5 128B у FP8 — до 158 ГБ з контекстом 65 536 токенів.
Ліміт відеоядра Mac: скільки єдиної пам’яті macOS віддає GPU
macOS за замовчуванням дозволяє відеоядру зайняти лише частину єдиної пам’яті. Apple не публікує формулу цього ліміту, тому спираємося на логи, де llama.cpp друкує значення recommendedMaxWorkingSetSize. У відкритих логах знайшлося чотири точки:
- M1 Max, 32 ГБ, macOS 13 — 22 906,50 МБ, рівно 2/3 пам’яті;
- M3 Ultra, 512 ГБ, macOS 15 — 412 316,86 МБ, рівно 3/4;
- M4 Pro, 48 ГБ, macOS 26.3 — 40 200,90 МБ, близько 78%;
- MacBook Air M5, 16 ГБ, macOS 26.6.1 — 12,7 ГБ зі слів учасника таблиці llama.cpp, близько 74%.
Частка залежить не лише від обсягу, а, судячи з цих логів, і від версії macOS: на свіжій системі відеоядру дістається близько 3/4, більше, ніж за старим правилом 2/3. Для 128 ГБ учасник обговорення llama.cpp пише «близько 3/4, тобто 96 ГіБ», але сам лог в обговоренні не опубліковано. Єдиної формули від Apple немає, тож там, де логу немає, у таблицях стоїть оцінка за правилом 3/4, а свій ліміт перевіряється одним рядком логу (інструкція нижче).
Суцільні смуги на графіку — значення з логів, заштриховані — оцінка. Друга вкладка показує, скільки отримає відеоядро, якщо підняти ліміт вручну й залишити системі 8 ГБ.Обсяг пам’яті Ліміт відеоядра за замовчуванням, ГБ Звідки Після sysctl (системі 8 ГБ), ГБ 8 ГБ (MacBook Neo) ≈ 6,4 ≈ оцінка, правило 3/4 — 16 ГБ 12,7 зі слів учасника llama.cpp #4167, M5, macOS 26.6.1 ≈ 8,6 (виграшу немає) 24 ГБ ≈ 19,3 ≈ оцінка, правило 3/4 ≈ 17,2 (виграшу немає) 32 ГБ ≈ 25,8 (на macOS 13 — 22,9) ≈ оцінка 3/4; 22,9 — лог llama.cpp #22800 ≈ 25,8 (виграшу немає) 36 ГБ ≈ 29,0 ≈ оцінка, правило 3/4 ≈ 30,1 48 ГБ 40,2 лог llama.cpp #20141, M4 Pro, macOS 26.3 ≈ 42,9 64 ГБ ≈ 51,5 ≈ оцінка, правило 3/4 ≈ 60,1 96 ГБ ≈ 77,3 ≈ оцінка, правило 3/4 ≈ 94,5 128 ГБ ≈ 103,1 зі слів учасника llama.cpp #29465, лог не опубліковано ≈ 128,8 256 ГБ ≈ 206,2 ≈ оцінка, правило 3/4 ≈ 257,7 (системі 16 ГБ) 512 ГБ 412,3 лог llama.cpp #15055, M3 Ultra, macOS 15 ≈ 532,6 (системі 16 ГБ)
Як перевірити й підняти ліміт відеоядра на своєму Mac
- Подивіться поточне значення. Запустіть будь-яку модель через llama.cpp і знайдіть у лозі рядок
recommendedMaxWorkingSetSize. Це і є ваш ліміт; лог друкує його в десяткових мегабайтах. - Підніміть ліміт однією командою. Команду описано в документації MLX:
sudo sysctl iogpu.wired_limit_mb=<значення>. Параметр приймає двійкові мегабайти (МіБ): для Mac на 64 ГБ із запасом 8 ГБ цеsudo sysctl iogpu.wired_limit_mb=57344, тобто 56 ГіБ. Число з логу сюди не підставляйте — помилитеся приблизно на 7%. - Залиште системі 8–16 ГБ. Значення має бути строго меншим за всю пам’ять, інакше macOS почне активно скидати дані у своп, і машина гальмуватиме цілком.
- Пам’ятайте про перезавантаження. Зміна живе до перезапуску Mac, після нього ліміт повертається до значення за замовчуванням. Значення
0теж повертає ліміт за замовчуванням.
Ризик у такої зміни один: якщо моделі й застосункам разом стане тісно, система піде у своп. Дані це не зіпсує, але швидкість упаде в рази. Тому sysctl — інструмент «впустити модель, якій бракує пари гігабайтів», а не спосіб перетворити 64 ГБ на 96.
Який Mac брати під кожен ступінь: від MacBook Neo до Mac Studio
8 і 16 ГБ: MacBook Neo, MacBook Air M5 і Mac mini M6
У MacBook Neo на 8 ГБ відеоядру дістається близько 6,4 ГБ (оцінка): 8B у Q4 (4,92 ГБ) вміщується лише з контекстом до 8 тисяч токенів, а за 60 ГБ/с це машина для знайомства з інструментами. На 16 ГБ (12,7 ГБ відеоядру на macOS 26) вільно живуть моделі до 8B, Qwen3 14B у Q4 — тільки з коротким контекстом. tbreak радить сприймати 16 ГБ як ступінь для освоєння інструментів, а не для робочої станції.
24 і 32 ГБ: перший робочий ступінь
На 24 ГБ вміщується 14B у Q4 із довгим контекстом, на 32 ГБ уперше запускається Qwen3 32B у Q4 — із контекстом близько 8 тисяч токенів. tbreak виміряв у Qwen3 30B-A3B на 64 тисячах токенів 24,26 ГБ: 24-гігабайтний Mac це вже не тягне, а 32-гігабайтний тягне впритул — за правилом 3/4 у нього близько 25,8 ГБ для відеоядра, а на старій macOS 13 було 22,9 ГБ і знадобився б sysctl. Ці обсяги є в MacBook Air M5 і Mac mini M6.
48 і 64 ГБ: ступінь під 70B
48 ГБ — це Qwen3 32B у Q4 із повним контекстом і 32B у Q8 із коротким (за логом на macOS 26; із контекстом 32K Q8 не вміщується навіть після sysctl — ≈ 43,4 ГБ за ліміту 42,9). 64 ГБ — перший ступінь для Llama 3.3 70B у Q4 з контекстом близько 8 тисяч токенів. tbreak називає 48 ГБ точкою, де 70B «стає можливою», а 64 ГБ — комфортною ціллю; за нашим розрахунком 70B у Q4 навіть із коротким контекстом (≈ 45,2 ГБ) у 48 ГБ не вміщується, тож реальний ступінь під неї — 64 ГБ. Обидва ступені є в M5 Pro і M5 Max; попереднє покоління цього класу ми розбирали на прикладі Mac mini M4 Pro.
96 і 128 ГБ: довгий контекст і моделі на 100B+
128GB unified memory — максимальний ступінь для LLM у MacBook Pro і в Mac Studio на M5 Max, і Apple дає його тільки з 40-ядерним GPU. На ньому вміщуються Llama 3.3 70B у Q8, 70B у Q4 з контекстом на 128 тисяч токенів (≈ 85,5 ГБ за нашою оцінкою) і gpt-oss-120b: tbreak запускав її через Ollama на Mac Studio зі 128 ГБ зі швидкістю близько 75 токенів за секунду й підключав до агента з вікном контексту 64K. 96 ГБ — стартовий обсяг Mac Studio M5 Ultra, gpt-oss-120b вміщується й туди. Ноутбучний варіант розібрано в огляді MacBook Pro M5 Max для нейромереж.
256 і 512 ГБ: Qwen3 235B і DeepSeek-R1 671B
На 256 ГБ вільно працює Qwen3 235B-A22B у Q4 (≈ 148,5 ГБ за нашою оцінкою з контекстом 32K). 512 ГБ — єдиний ступінь для DeepSeek-R1 671B у Q4 на одній машині: файл важить 404,43 ГБ за ліміту 412,3 ГБ. MacStories запускав R1-0528 у 4 бітах на Mac Studio M3 Ultra з 512 ГБ, моделі знадобилося «трохи менше ніж 400 ГБ»; 8-бітна версія на ~700 ГБ не завантажилася. Досвід життя з такою моделлю — у матеріалі про Mac Studio M3 Ultra.
Ціни на графіку (25.10.2026) показують, як ступінь пам’яті тягне за собою ціну: від MacBook Neo на 8 ГБ за 36 999 ₴ до MacBook Pro 14 M5 Max зі 128 ГБ за 353 699 ₴.
Швидкість генерації: виміряні токени за секунду й оцінка за формулою
Швидкість генерації — скільки токенів за секунду модель пише у відповідь. Найкраще відкрите джерело вимірів на Mac — таблиця в обговоренні llama.cpp #4167: учасники запускають ту саму Llama 2 7B (3,56 ГіБ у Q4_0) на всіх чипах M1–M6 одним тестом.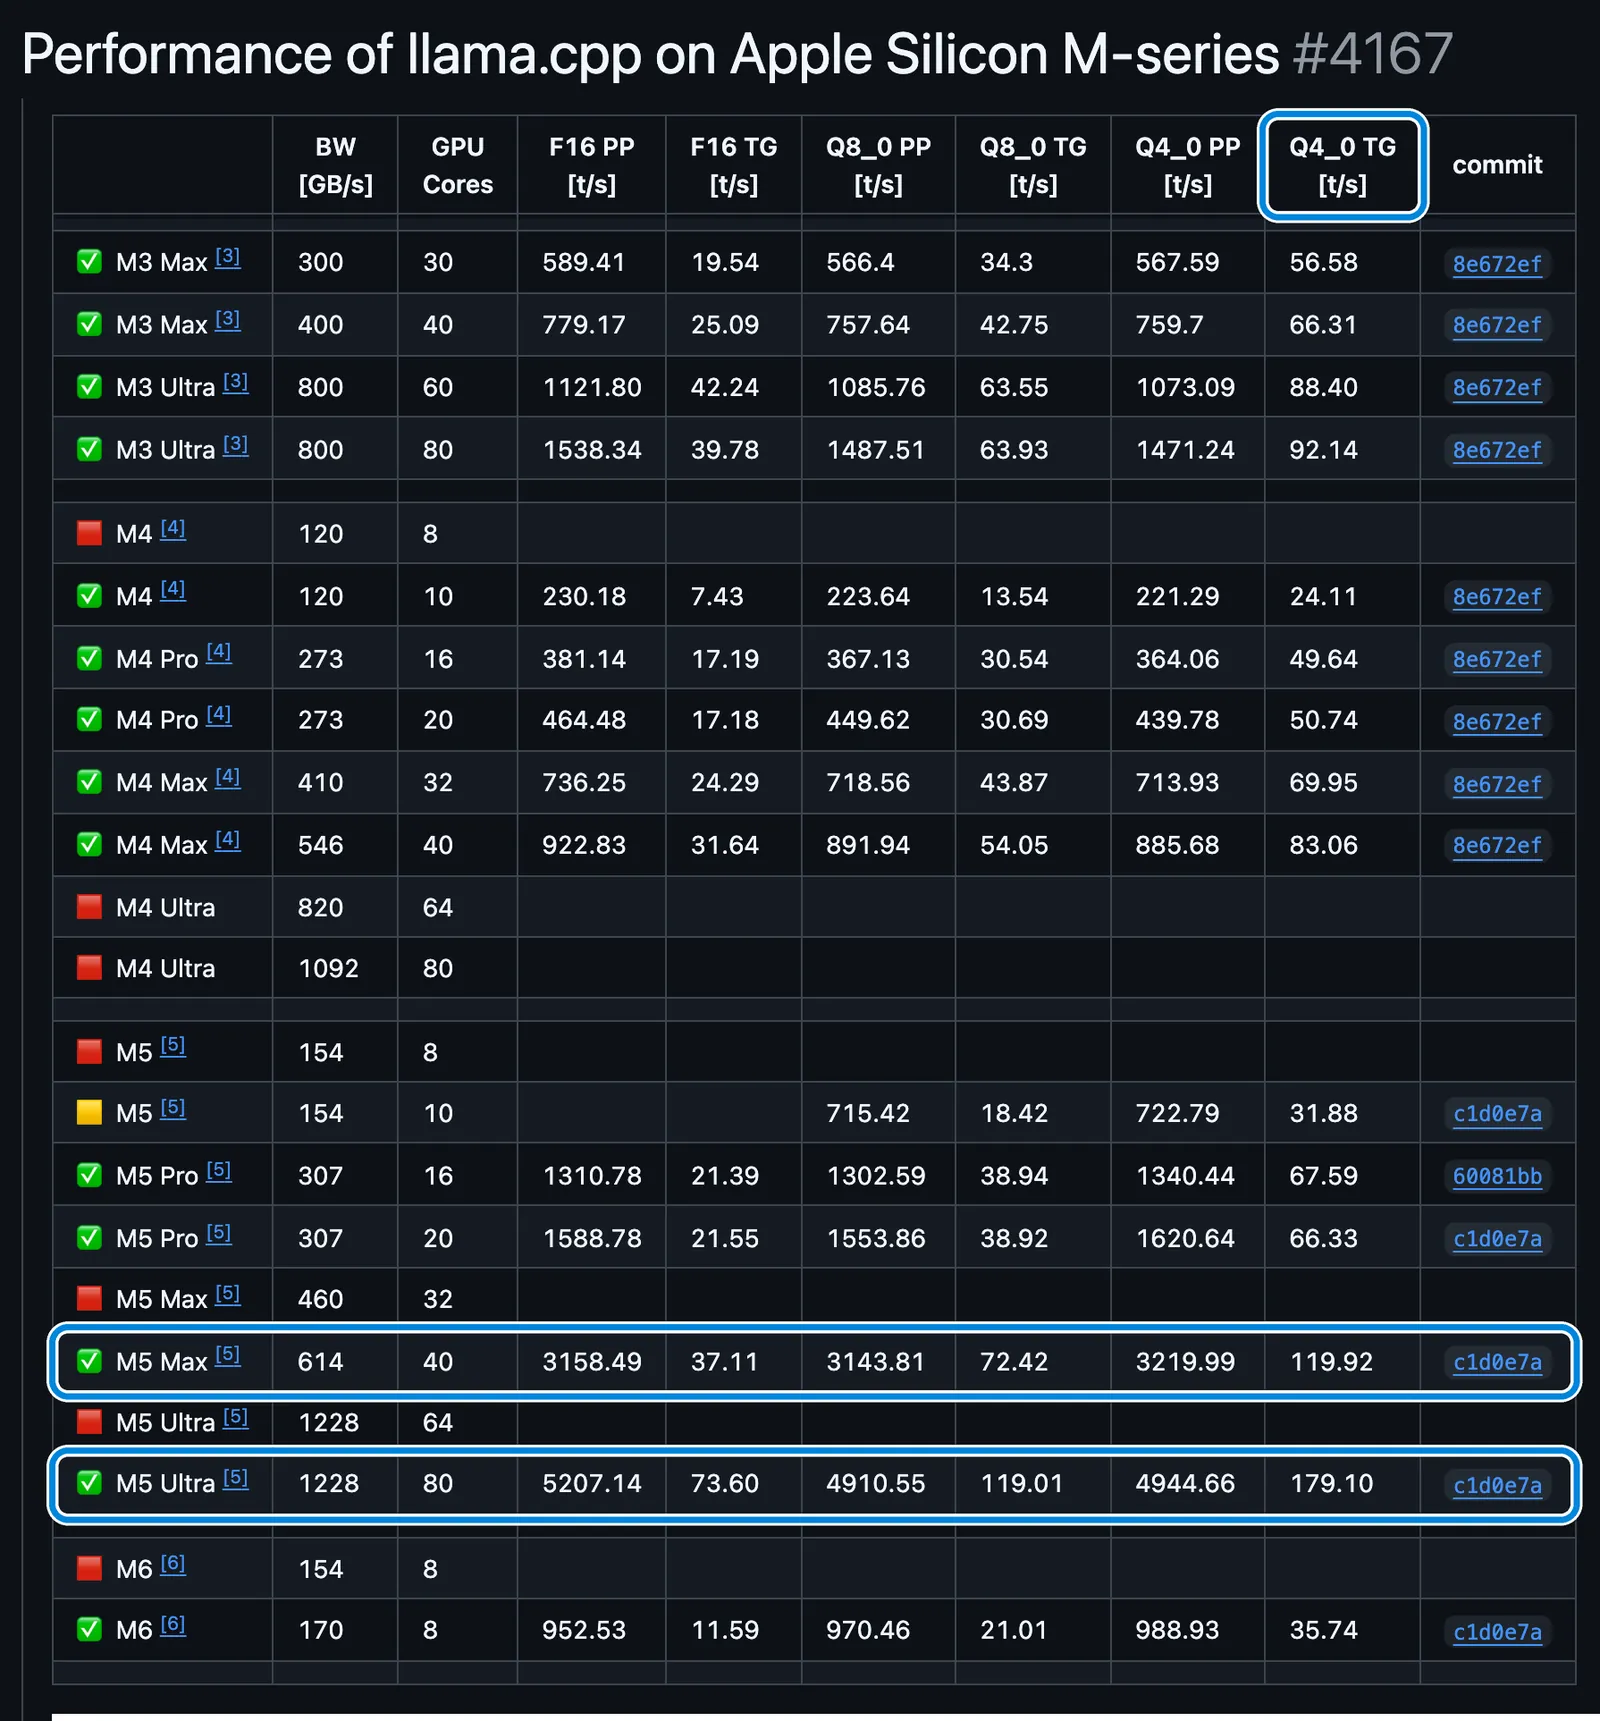
На знімку таблиці від 25.10.2026 виділено стовпець генерації для Q4_0 і два рядки: M5 Max на 40 ядер GPU пише 119,92 токена за секунду, M5 Ultra на 80 ядер — 179,10. Порожні рядки (молодший M5 Max, M5 Ultra на 64 ядра) означають, що виміру поки немає.
Генерація зростає разом із пропускною здатністю, але не пропорційно: у M5 Ultra шина вдвічі ширша, ніж у M5 Max, а пише він лише в півтора раза швидше. Друга вкладка показує читання промпту: тут покоління M5 пішло вперед у 3,3–3,7 раза порівняно з M4 і M3 Ultra.Чип Пропускна здатність, ГБ/с Генерація, ток/с Читання промпту, ток/с M1 (8 GPU) 68 14,15 117,96 M1 Pro (16 GPU) 200 36,41 266,25 M1 Max (32 GPU) 400 61,19 530,06 M1 Ultra (64 GPU) 800 83,73 1030,04 M2 (10 GPU) 100 21,91 179,57 M2 Pro (19 GPU) 200 38,86 341,19 M2 Max (38 GPU) 400 65,95 671,31 M2 Ultra (76 GPU) 800 94,27 1238,48 M3 (10 GPU) 100 21,34 186,75 M3 Pro (18 GPU) 150 30,74 341,67 M3 Max (30 GPU) 300 56,58 567,59 M3 Max (40 GPU) 400 66,31 759,70 M3 Ultra (80 GPU) 800 92,14 1471,24 M4 (10 GPU) 120 24,11 221,29 M4 Pro (20 GPU) 273 50,74 439,78 M4 Max (32 GPU) 410 69,95 713,93 M4 Max (40 GPU) 546 83,06 885,68 M5 (10 GPU) 153 31,88 722,79 M5 Pro (20 GPU) 307 66,33 1620,64 M5 Max (40 GPU) 614 119,92 3219,99 M5 Ultra (80 GPU) 1228 179,10 4944,66 M6 (24/32 ГБ) 170 35,74 988,93
Формула швидкості: стеля і реальна частка
Популярна прикидка «швидкість ≈ пропускна здатність ÷ розмір моделі» описує стелю, а не прогноз: на один токен треба один раз прочитати всі активні ваги. Ми порахували, яку частку стелі кожен чип справді видав у таблиці llama.cpp:
Частка стелі = виміряна генерація ÷ (пропускна здатність ÷ розмір файлу)
Оцінка швидкості ≈ пропускна здатність ÷ розмір моделі × частка стелі
Приклад для M5 Max на 40 ядер GPU: 614 ГБ/с ÷ 3,823 ГБ = 160,6 токена за секунду в теорії, а у вимірі — 119,92. Частка стелі — 0,75.
Частка не стала: широка шина Ultra на малій моделі в 3,8 ГБ просто не завантажується роботою. Універсальні «65% від стелі» з гайдів (наприклад, у Bizon) — середина діапазону, а не правило.Клас чипа Частка стелі на Llama 2 7B Q4_0 Чипи у вибірці Базові (M1–M6) 0,77–0,84 M1, M2, M3, M4, M5, M6 Pro 0,70–0,83 M1 Pro, M2 Pro, M3 Pro, M4 Pro, M5 Pro Max 0,58–0,75 M1–M5 Max, обидва біни M3 і M4 Ultra 0,40–0,56 M1, M2, M3, M5 Ultra
Оцінка швидкості 8B, 32B і 70B на актуальних Mac
Вимірів цих трьох моделей на всіх актуальних чипах в одному тесті немає, тому нижче — оцінка за формулою вище з розміром файлу Q4_K_M. Для M5 Max із 32-ядерним GPU і для M6 на 16 ГБ власних вимірів немає — беремо частку найближчого родича (M5 Max на 40 ядер і M5). У M5 на 16 ГБ вимір є (частка 0,79), оцінка для нього та сама — близько 25 токенів за секунду.
Усі смуги заштриховані — це розрахунок; порожній рядок — модель із контекстом не вміщується в пам’ять чипа.Чип Llama 3.1 8B (4,92 ГБ), ток/с Qwen3 32B (19,76 ГБ), ток/с Llama 3.3 70B (42,52 ГБ), ток/с M5 / M6, 16 ГБ (153 ГБ/с) ≈ 25 (стеля 31) не вміщується не вміщується M6, 24/32 ГБ (170 ГБ/с) ≈ 28 (стеля 35) ≈ 7 на 32 ГБ (стеля 9) не вміщується M5 Pro (307 ГБ/с) ≈ 52 (стеля 62) ≈ 13 (стеля 16) ≈ 6 на 64 ГБ (стеля 7) M5 Max, 32 GPU (460 ГБ/с) ≈ 70 (стеля 94) ≈ 17 (стеля 23) не вміщується в 36 ГБ M5 Max, 40 GPU (614 ГБ/с) ≈ 93 (стеля 125) ≈ 23 (стеля 31) ≈ 11 (стеля 14) M5 Ultra (1228 ГБ/с) ≈ 139 (стеля 250) ≈ 35 (стеля 62) ≈ 16 (стеля 29)
Перевірка реальністю: та сама формула для M4 Max на 40 ядер (546 ГБ/с, частка 0,58) дає для 70B близько 7,5 токена за секунду (оцінка), а Bizon наводить реальні результати на схожих конфігураціях — 8–11 за стелі 12,8. Отже, на великих моделях наша оцінка для Max радше занижена, як і для Ultra: їхню частку стелі міряли на малій моделі, яка шину не завантажує.
Чому в MoE-моделей швидкість інша
Формулу «пропускна здатність ÷ увесь розмір файлу» до MoE-моделей застосовувати не можна: на кожен токен читаються лише активні експерти. gpt-oss-120b важить 63,39 ГБ, але на токен вмикає 4 експерти зі 128, а її KV-кеш на 32K важить близько 1,2 ГБ — у половини шарів вікно лише 128 токенів. Тому у вимірах вона швидка: 79,68 токена за секунду на M2 Ultra в llama.cpp і близько 75 на Mac Studio зі 128 ГБ у tbreak. Щільна 70B на M5 Max за нашою оцінкою дає близько 11. Обсяг пам’яті купують під «скільки параметрів загалом», а швидкість — під «скільки активно».
Prefill проти генерації: «у 4,3 раза швидше» — не про токени
Prefill, або обробка промпту, — це етап, коли модель читає ваш запит перед першим словом відповіді. Він упирається в обчислення відеоядра, а не в пам’ять. Генерація після цього впирається в пропускну здатність. Тому маркетингові «в N разів швидше» майже завжди стосуються prefill, і плутати їх зі швидкістю відповіді не можна.
У пресрелізі від 25.08.2026 Apple пише про «до 4,3 раза більшу пікову обчислювальну потужність для ШІ» в M5 Ultra проти M3 Ultra. Це про prefill: у ядрах GPU покоління M5 з’явилися нейроприскорювачі для множення матриць. Щодо генерації різниця скромніша — Apple Machine Learning Research виміряла 1,6 раза (15.10.2026), MacStories у своїх тестах — близько +70% у середньому. Це близько до зростання пропускної здатності: 1,2 ТБ/с проти 819 ГБ/с.Що прискорюється Від чого залежить M5 Ultra проти M3 Ultra Де помітно Prefill (читання промпту, час до першого токена) обчислення GPU, нейроприскорювачі до 4,6 раза за часом до першого токена (Apple ML Research) довгі документи, агенти, код Генерація (токени відповіді) пропускна здатність пам’яті 1,6 раза (Apple ML Research), ~+70% (MacStories) чат, будь-які відповіді
Для вибору пам’яті це означає три речі. Агент із довгим контекстом щоразу заново читає десятки тисяч токенів, і тут покоління M5 виграє сильніше, ніж видно зі швидкості відповіді. Довгий контекст дорогий і за часом: у tbreak на M5 Max читання промпту Qwen3 30B-A3B впало з 5451,9 до 1560,4 токена за секунду, коли промпт виріс із 2 до 64 тисяч. А старий Mac із великою пам’яттю (M1 Max, M2 Ultra) вміщує модель, але читає промпт у 2,6–6 раза повільніше за M5 Max — 530 і 1238 токенів за секунду проти 3220.
Докладний розбір M5 Ultra з вимірами prefill і генерації — у статті Mac Studio M5 Ultra для LLM.
Зображення, відео, Whisper та ембединги: пам’ять понад LLM
Генератори зображень і відео, розпізнавання мовлення та ембединги (моделі, що перетворюють текст на числа для пошуку документами) теж живуть у єдиній пам’яті, і в деяких пік значно вищий за розмір файлу.Навантаження Розмір ваг, ГБ Мінімальний розумний ступінь Коментар Stable Diffusion XL base 1.0 6,94 16 ГБ за гайдами modelfit і insiderllm — комфортно на 16 ГБ FLUX.1 dev, GGUF Q4_K_S 6,81 16 ГБ упритул, обидва гайди фіксують своп FLUX.1 dev, GGUF Q8_0 12,71 32 ГБ рекомендація modelfit FLUX.1 dev, bf16 23,80 64 ГБ рекомендація modelfit LTX-Video 13B, fp8 / bf16 15,69 / 28,58 32 / 64 ГБ ≈ оцінка за розміром ваг LTX-2.3 22B, відео 241 кадр н/д 128 ГБ вимір tbreak: пік 115,16 ГБ, своп 7,59 ГБ Qwen-Image-2.1 н/д 128 ГБ вимір MacStories на M5 Ultra: пік 78 ГБ, 180 секунд на зображення Whisper large-v3 3,09 8–16 ГБ ≈ оцінка, вистачає будь-якого ступеня Ембединги BAAI/bge-m3 2,27 8–16 ГБ ≈ оцінка, працює поруч із LLM
Найпоказовіший вимір — у відео. tbreak генерував на Mac Studio зі 128 ГБ ролик із 241 кадру 1024×768 моделлю LTX-2.3 22B. На основній генерації система займала близько 57 ГБ, а на фінальному декодуванні кадрів — 115,16 ГБ, і macOS виділила 7,59 ГБ свопу. Модель на 22 мільярди параметрів потребувала більше пам’яті, ніж мовна на 120 мільярдів, бо наприкінці їй треба зібрати всі готові кадри одночасно.
Якщо в планах відео, ступінь обирають за піком пайплайна, а не за розміром моделі; Whisper та ембединги майже нічого не додають до бюджету LLM.
Якщо пам’яті забракло: своп, тиск пам’яті й урізаний контекст
Своп — це запис частини оперативної пам’яті на SSD, коли її бракує. Для локальної моделі це катастрофа: кожен токен вимагає прочитати всі ваги, і читання з диска обвалює швидкість. Строгого виміру «пам’ять проти свопу» ми не знайшли, тому цифру падіння не називаємо. Ознаки: генерація в рази повільніша, ніж у власників того самого чипа, а в «Моніторингу системи» на вкладці «Пам’ять» графік «Тиск пам’яті» жовтий або червоний і зростає «Використано свопу».
Що робити, якщо моделі бракує пам’яті: шість кроків
- Перевірте, куди завантажено модель. В Ollama команда
ollama psпоказує в колонці PROCESSOR, яка частка моделі працює на GPU; усе, що не «100% GPU», уже повільніше. - Уріжте контекст. Контекст 32K у Llama 3.3 70B коштує близько 10,7 ГБ, 8K — близько 2,7 ГБ. Це найдешевший спосіб звільнити пам’ять.
- Візьміть сильніше квантування. Перехід із Q8 на Q4 майже вдвічі зменшує вагу: у Qwen3 32B — із 34,82 до 19,76 ГБ.
- Закрийте важкі застосунки. Браузер із десятками вкладок і відеоредактор ділять ту саму єдину пам’ять.
- Підніміть ліміт відеоядра через sysctl, якщо бракує пари гігабайтів, — див. розділ про ліміт.
- Візьміть MoE-модель замість щільної — див. розділ про швидкість MoE.
Скільки коштує пам’ять: доплати Apple і ціни в Україні на 25.10.2026
26 червня 2026 року Apple підняла ціни на Mac, і в частині лінійок доплата за пам’ять подвоїлася.Конфігурація (США) До 26.06.2026 Після 26.06.2026 MacBook Air 13 M5, 16 ГБ / 512 ГБ $1099 $1299 MacBook Air M5: доплата за 24 / 32 ГБ +$200 / +$400 +$200 / +$400 (не змінилася) MacBook Pro 14 M5, 16 ГБ / 512 ГБ $1599 $1899 MacBook Pro M5 Max: 48 → 64 ГБ +$200 +$400 MacBook Pro M5 Max: 48 → 128 ГБ +$1000 +$2000 Mac mini, 16 ГБ / 256 ГБ $599 (M4) $799 (M4), $899 (M6, з 25.08.2026) Mac mini M5 Pro — від $1699 (25.08.2026) Mac Studio M5 Max / M5 Ultra 64 GPU / 80 GPU — від $2499 / $5499 / $6799 (25.08.2026)
Розбіжність джерел тут позірна: BasicAppleGuy і GeekChamp пишуть, що доплата за пам’ять не зросла, Digital Trends — що подвоїлася. Мають рацію обидві сторони, просто йдеться про різні лінійки: у MacBook Air кроки лишилися $200 і $400, у MacBook Pro з M5 Max — подорожчали вдвічі.
Ціни в Україні станом на 25.10.2026 — за магазинами й оголошеннями, зі знижками на цю дату. Бін впливає на швидкість: MacBook Air 13 M5 16/512 у таблиці — версія з 10 ядрами CPU і 8 GPU, Mac mini M5 Pro 24/512 — молодший бін із 15 ядрами CPU і 16 GPU.Mac і конфігурація Пам’ять, ГБ Ціна, ₴ ₴ за 1 ГБ пам’яті Де MacBook Neo 8/256 8 36 999 ≈ 4625 Jabko Mac mini M6 16/256 16 55 799 ≈ 3487 ti.ua (Hotline: 48 400–56 663) Mac mini M6 16/512 16 68 599 ≈ 4287 ti.ua MacBook Air 13 M5 16/512 16 72 899 ≈ 4556 Jabko Mac mini M6 24/512 24 81 499 ≈ 3396 ti.ua MacBook Air 13 M5 24/1TB 24 92 999 ≈ 3875 Jabko Mac mini M5 Pro 24/512 24 105 499 ≈ 4396 ti.ua Mac Studio M5 Max 36/512 36 151 599 ≈ 4211 ti.ua (Hotline: 127 529–161 849) Mac Studio M5 Max 64/1TB 64 від 246 780 ≈ 3856 Hotline Mac Studio M5 Ultra 96/1TB 96 343 999 ≈ 3583 ti.ua (Hotline: від 273 289) MacBook Pro 14 M5 Max 128/2TB 128 353 699 ≈ 2763 Jabko вживаний Mac mini M4 16/256 16 40 999 ≈ 2562 Jabko, «хороший стан» вживаний MacBook Pro 16 M1 Max 32/1TB 32 від 56 500 ≈ 1766 OLX вживаний MacBook Pro 16 M2 Max 64/1TB 64 118 999 ≈ 1859 OLX вживаний Mac Studio M2 Ultra 64/1TB 64 130 000 ≈ 2031 OLX
Стовпець «₴ за 1 ГБ» — наш розрахунок: ціну поділено на обсяг пам’яті без урахування диска й чипа, це орієнтир, а не реальна ціна гігабайта.
Скільки коштує крок пам’яті в Україні для однієї моделі з тим самим диском:
- Mac mini M6, 16 → 24 ГБ з 512 ГБ SSD: 68 599 → 81 499 ₴, доплата 12 900 ₴ (ti.ua, 25.10.2026).
- MacBook Air 13 M5, 16 → 24 ГБ з 1 ТБ: 80 499 → 92 999 ₴, доплата 12 500 ₴ (Jabko, 25.10.2026).
Вживаний Mac — найдешевший спосіб отримати обсяг: MacBook Pro 16 на M1 Max із 32 ГБ на OLX коштує від 56 500 ₴ (25.10.2026), майже як новий Mac mini M6 із 16 ГБ. Платите за це швидкістю: генерація в M1 Max удвічі повільніша, ніж у M5 Max, а промпт він читає в 6 разів повільніше.
Як обрати обсяг під завдання: від першої моделі до агента з 128K
Mac із unified memory для AI-завдань обирають, починаючи з питання «яку найбільшу модель я хочу запускати щодня і з яким контекстом». Відповісти на нього треба до купівлі: пам’ять не додаси, а ціна кроку в Apple з літа 2026 зросла. Саму модель під завдання зручніше обирати після цього: спершу бюджет пам’яті, потім перелік того, що в нього вміщується.Завдання Мінімум Розумний вибір Чому Спробувати локальні моделі, чат на 8B 16 ГБ 24 ГБ 8B з контекстом 32K займе ≈ 9,2 ГБ за ліміту відеоядра 12,7 ГБ Переклад, підсумовування, помічник із коду на 14B 24 ГБ 32 ГБ 14B у Q8 з довгим контекстом — ≈ 21,1 ГБ Моделі класу 30B, документи на десятки сторінок 32 ГБ 48 ГБ 32B у Q4 з контекстом 32K — ≈ 28,4 ГБ Llama 3.3 70B та аналоги щодня 64 ГБ 96–128 ГБ на 64 ГБ контекст лише короткий gpt-oss-120b, агент із контекстом 64K 96 ГБ 128 ГБ вимір tbreak: близько 75 ток/с на 128 ГБ Генерація відео 64 ГБ 128 ГБ пік LTX-2.3 — 115,16 ГБ Qwen3 235B, дослідницькі завдання 256 ГБ 256 ГБ ≈ 148,5 ГБ з контекстом 32K DeepSeek-R1 671B на одній машині 512 ГБ 512 ГБ або кластер запас лише близько 8 ГБ
Якщо потрібен MacBook для LLM, а не настільний Mac, вибір вужчий: MacBook Air M5 закінчується на 32 ГБ за 153 ГБ/с, MacBook Pro на M5 Pro — 64 ГБ за 307 ГБ/с, на M5 Max — 128 ГБ за 614 ГБ/с. Під 70B щодня в ноутбуці розумна лише остання конфігурація.
Кілька правил, які заощаджують гроші:
- Не плутайте «запускається» і «працює». Якщо модель проходить лише з контекстом 8K, для агентів і довгих документів ступінь замалий.
- Дивіться на бін, а не лише на обсяг. Молодший M5 Max із 36 ГБ працює на 460 ГБ/с, старший із 48 ГБ — на 614 ГБ/с. За крок у 12 ГБ ви отримуєте ще й +33% до шини.
- Понад 512 ГБ — це кластер, а не покупка. Apple ML Research запускала модель на 816 мільярдів параметрів (близько 493 ГБ у 4 бітах) на чотирьох Mac Studio M5 Ultra через Thunderbolt 5 і отримала понад 36 токенів за секунду (15.10.2026). Це спосіб обійтися без найдорожчого ступеня або вийти за його межу.
Слабкі місця єдиної пам’яті Mac: ціни, апгрейд і дефіцит 512 ГБ
В єдиної пам’яті Mac є обмеження, про які варто знати до купівлі:
- Пам’ять не можна додати. Вона розпаяна разом із чипом, і помилку з обсягом виправляє лише купівля нової машини (Digital Trends, липень 2026). Ціна кроку при цьому зросла — див. розділ про вартість пам’яті.
- Найбільші ступені зникають. Apple прибрала Mac Studio M3 Ultra з 512 ГБ 5 березня 2026 року (Cult of Mac), а 256 ГБ — 5 травня 2026 року (за даними BasicAppleGuy, єдине відкрите джерело). Mac Studio M5 Ultra з 512 ГБ Apple у пресрелізі від 25.08.2026 обіцяла «наприкінці жовтня», але підтвердження продажів станом на 25.10.2026 ми не знайшли — перед купівлею перевірте конфігуратор Apple.
- Ліміт відеоядра непрозорий. Apple не публікує, скільки пам’яті віддає GPU; у відкритих логах є лише поодинокі точки, і частка, судячи з них, змінюється з версією macOS. Зміна sysctl живе до перезавантаження.
- Швидкість поступається відеокарті й новим чипам. На моделях до 32 ГБ RTX 5090 швидша, а старі Max і Ultra з вторинного ринку в рази повільніше читають промпт — цифри в розділах про відеопам’ять і prefill.
Першими в цій статті застаріють ціни й наявність ступенів: свіжі дані — у конфігураторі на apple.com і на сторінках магазинів. Таблицю швидкості llama.cpp поповнюють учасники, туди ж згодом потраплять виміри молодшого M5 Max і M5 Ultra на 64 ядра.
Часті запитання про пам’ять Mac для ШІ
Чи вистачить 16 ГБ єдиної пам’яті Mac для локального ШІ?
Вистачить, щоб освоїти інструменти й запускати моделі до 8B: Llama 3.1 8B у 4 бітах із контекстом 32K займе близько 9,2 ГБ за ліміту відеоядра 12,7 ГБ на macOS 26. Qwen3 14B піде лише з коротким контекстом, моделі 30B і більші — ні. Для регулярної роботи з локальними моделями розумний стартовий ступінь — 32 ГБ.
Чим єдина пам’ять Mac відрізняється від відеопам’яті відеокарти?
Єдина пам’ять — одна спільна ОЗП для процесора, відеоядра й системи, відеопам’ять — окрема пам’ять лише для відеокарти. У Mac її більше (до 512 ГБ проти 32 ГБ у RTX 5090), але вона повільніша (1,2 ТБ/с проти 1,79 ТБ/с) і ділиться з macOS. Тому Mac запускає моделі, які не вміщуються у відеокарту, а відеокарта швидша на тих, що вміщуються.
Чи можна додати пам’ять у Mac після купівлі?
Ні. У всіх Mac на Apple Silicon пам’ять розпаяна разом із чипом, слотів під модулі немає. Обсяг обирають один раз під час купівлі, тож краще взяти ступінь із запасом під контекст. Якщо пам’яті забракло, лишаються урізаний контекст, сильніше квантування, зміна ліміту sysctl або продаж Mac і купівля нової конфігурації.
Скільки пам’яті потрібно Mac для моделі на 70B?
Для Llama 3.3 70B у 4 бітах потрібно щонайменше 64 ГБ: ваги важать 42,52 ГБ, і на такому ступені без змін уміщується контекст близько 8 тисяч токенів. Для контексту 32K потрібно близько 53 ГБ під відеоядро — це 96–128 ГБ або 64 ГБ після зміни sysctl (близько 60 ГБ відеоядру). Для 8-бітної версії (74,98 ГБ ваг) — 128 ГБ, на 96 ГБ лише після sysctl.
Що таке iogpu.wired_limit_mb і чи безпечно змінювати ліміт?
Це системне налаштування macOS, яке задає, скільки мегабайтів пам’яті може зайняти відеоядро. Змінюється командою sudo sysctl iogpu.wired_limit_mb=<МіБ>, описаною в документації MLX, і скидається після перезавантаження. Для даних це безпечно, якщо залишити системі 8–16 ГБ: коли пам’яті забракне, macOS піде у своп і все сповільниться, але нічого не зламається.
Скільки коштує доплата за пам’ять в Apple і в Україні?
У США після 26.06.2026 у MacBook Air кроки лишилися по $200 за 24 ГБ і $400 за 32 ГБ, а в MacBook Pro з M5 Max перехід із 48 на 128 ГБ подорожчав із $1000 до $2000. В Україні станом на 25.10.2026 Mac mini M6 із 24 ГБ дорожчий за версію на 16 ГБ на 12 900 ₴, MacBook Air 13 M5 — на 12 500 ₴.