
Коротко (TL;DR)
- Max — це не п’ять чипів, а десять версій. Кожне покоління має молодшу й старшу версію з різною кількістю ядер, а починаючи з M3 — ще й з різною пропускною здатністю пам’яті та різною стелею обсягу; за всіма десятьма версіями смуга — від 300 до 614 ГБ/с.
- Для локальних нейромереж вирішують пам’ять і її смуга, а не покоління. Генерація тексту в M5 Max швидша, ніж у M4 Max, приблизно на ті самі 9–12%, на які зросла смуга пам’яті (546 → 614 ГБ/с).
- Справжній приріст M5 Max — читання промпту. В одному й тому самому тесті llama.cpp M5 Max обробляє запит приблизно втричі швидше за M4 Max навіть після поправки на нову версію програми.
- Модель 70B на будь-якому Max — 4–12 токенів за секунду. Стеля навіть у старшого M5 Max — 14,4 ток/с; обіцянки «20–30 ток/с» для щільної 70B поки не підтвердив жоден вимір.
- Найбільший стрибок в історії Max — M3, а не M5: апаратне трасування променів підняло рендер Blender на GPU в 2,5 раза.
- Бюджетний варіант для ШІ — вживаний M1 Max або M2 Max на 64 ГБ: у них та сама смуга 400 ГБ/с, що й у старшого M3 Max, а ціна в Україні станом на 25 жовтня 2026 року — від 95 550 грн із гарантією магазину.
Словник: п’ять термінів, без яких порівняння не читається
- Бін (версія чипа) — той самий чип із частиною вимкнених ядер. Apple продає M4 Max у двох бінах: 14 ядер CPU і 32 ядра GPU або 16 і 40. Починаючи з M3 Max, біни відрізняються не лише ядрами, а й шириною шини пам’яті; у M1 Max і M2 Max шина в обох бінах однакова.
- Пропускна здатність пам’яті (смуга, memory bandwidth) — скільки гігабайтів за секунду чип може прочитати з пам’яті. Для генерації тексту нейромережею це головний параметр.
- Токен — шматок слова, яким оперує модель. Швидкість міряють у токенах за секунду (ток/с).
- Генерація і prompt processing. Генерація — швидкість, з якою модель друкує відповідь. Prompt processing (prefill, читання промпту) — швидкість, з якою вона прочитує ваш запит, файли й історію діалогу до першого слова відповіді.
- Квантування — стиснення ваг моделі: Q4 зберігає кожен параметр приблизно в 4 бітах замість 16, і модель 70B вміщується в 42,5 ГБ замість 140. Що нижчий квант, то менший файл і то більші втрати якості — докладно в розборі квантування Q4 проти Q8.
Чипи Max M1–M5: біни ядер, тип пам’яті та смуга в одній таблиці
Якщо коротко порівняти M4 Max vs M5 Max і попередні M1 Max, M2 Max та M3 Max, то за п’ять років у Max зросли три речі: стеля пам’яті (з 64 до 128 ГБ), пропускна здатність (з 400 до 614 ГБ/с) і графіка. Але зростання було нерівним, і в кожному поколінні є «полегшена» версія, яка за частиною параметрів поступається старшій версії минулого року.
- Коротко (TL;DR)
- Словник: п’ять термінів, без яких порівняння не читається
- Чипи Max M1–M5: біни ядер, тип пам’яті та смуга в одній таблиці
- Що вміщується в пам’ять Max: моделі від 27B до 120B у 36–128 ГБ
- Швидкість LLM: генерацію визначає смуга пам’яті
- Читання промпту в Max: M5 Max утричі швидший за M4 Max
- Генерація картинок і транскрипція: що виміряно, а що оцінка
- CPU і GPU Max у тестах: Blender, Geekbench і Cinebench
- Монтаж, 3D та ігри: де M5 Max не обганяє M4 Max
- Слабкі місця Max: корпус 14 дюймів, шина M3 Max і ціна пам’яті
- Вживані M1 Max і M2 Max проти нових M4 і M5 Max для ШІ
- Ціни в Україні станом на 25 жовтня 2026: нові й вживані Mac з Max
- Який Max обрати: M1, M2, M3, M4 чи M5 під ваше завдання
- Часті запитання
Ця стаття — частина гіда «Який Mac обрати»: там карта всіх чипів M1–M6 з тестами, підбір конфігурації під вашу задачу і калькулятор «яка нейромережа вміститься».
Останнє покоління — M5 Max, який Apple представила 3 березня 2026 року, — отримало нову пам’ять LPDDR5X-9600 і нейроприскорювач у кожному ядрі GPU. Apple заявляє для ШІ «понад 4x пікових обчислень GPU» проти M4 Max — це заява виробника, а не незалежний вимір; що з неї підтверджують тести, розберемо нижче.Чип і бін Рік CPU GPU Пам’ять Тип пам’яті Смуга Де стоїть M1 Max 2021 10 (8P + 2E) 24 32 / 64 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio (2022) M1 Max 2021 10 (8P + 2E) 32 32 / 64 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio M2 Max 2023 12 (8P + 4E) 30 32 / 64 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio M2 Max 2023 12 (8P + 4E) 38 32 / 64 / 96 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio M3 Max 2023 14 (10P + 4E) 30 36 / 96 ГБ LPDDR5-6400 300 ГБ/с MacBook Pro 14/16 M3 Max 2023 16 (12P + 4E) 40 48 / 64 / 128 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16 M4 Max 2024 14 (10P + 4E) 32 36 ГБ LPDDR5X-8533 410 ГБ/с MacBook Pro 14/16, Mac Studio (2025) M4 Max 2024 16 (12P + 4E) 40 48 / 64 / 128 ГБ LPDDR5X-8533 546 ГБ/с MacBook Pro 14/16, Mac Studio (2025) M5 Max 2026 18 (6 супер + 12) 32 36 ГБ LPDDR5X-9600 460 ГБ/с MacBook Pro 14/16, Mac Studio (2026) M5 Max 2026 18 (6 супер + 12) 40 48 / 64 / 128 ГБ LPDDR5X-9600 614 ГБ/с MacBook Pro 14/16, Mac Studio (2026)
Звідки береться смуга, найпростіше показати на M1 Max: шина 512 біт × 6400 мільйонів передач за секунду ÷ 8 біт у байті ≈ 409,6 ГБ/с — це і є «400 ГБ/с» зі специфікації. Тому в M1 Max і M2 Max смуга однакова: тип пам’яті й ширина шини не змінювалися. У M4 Max і M5 Max її підняли швидшою пам’яттю LPDDR5X.
На графіку видно головне: старша версія M3 Max за смугою не обігнала M1 Max п’ятирічної давнини (ті самі 400 ГБ/с), а молодша й зовсім відстала — 300 ГБ/с. Відчутне зростання почалося лише з M4 Max. Таблиця вище дублює ці цифри.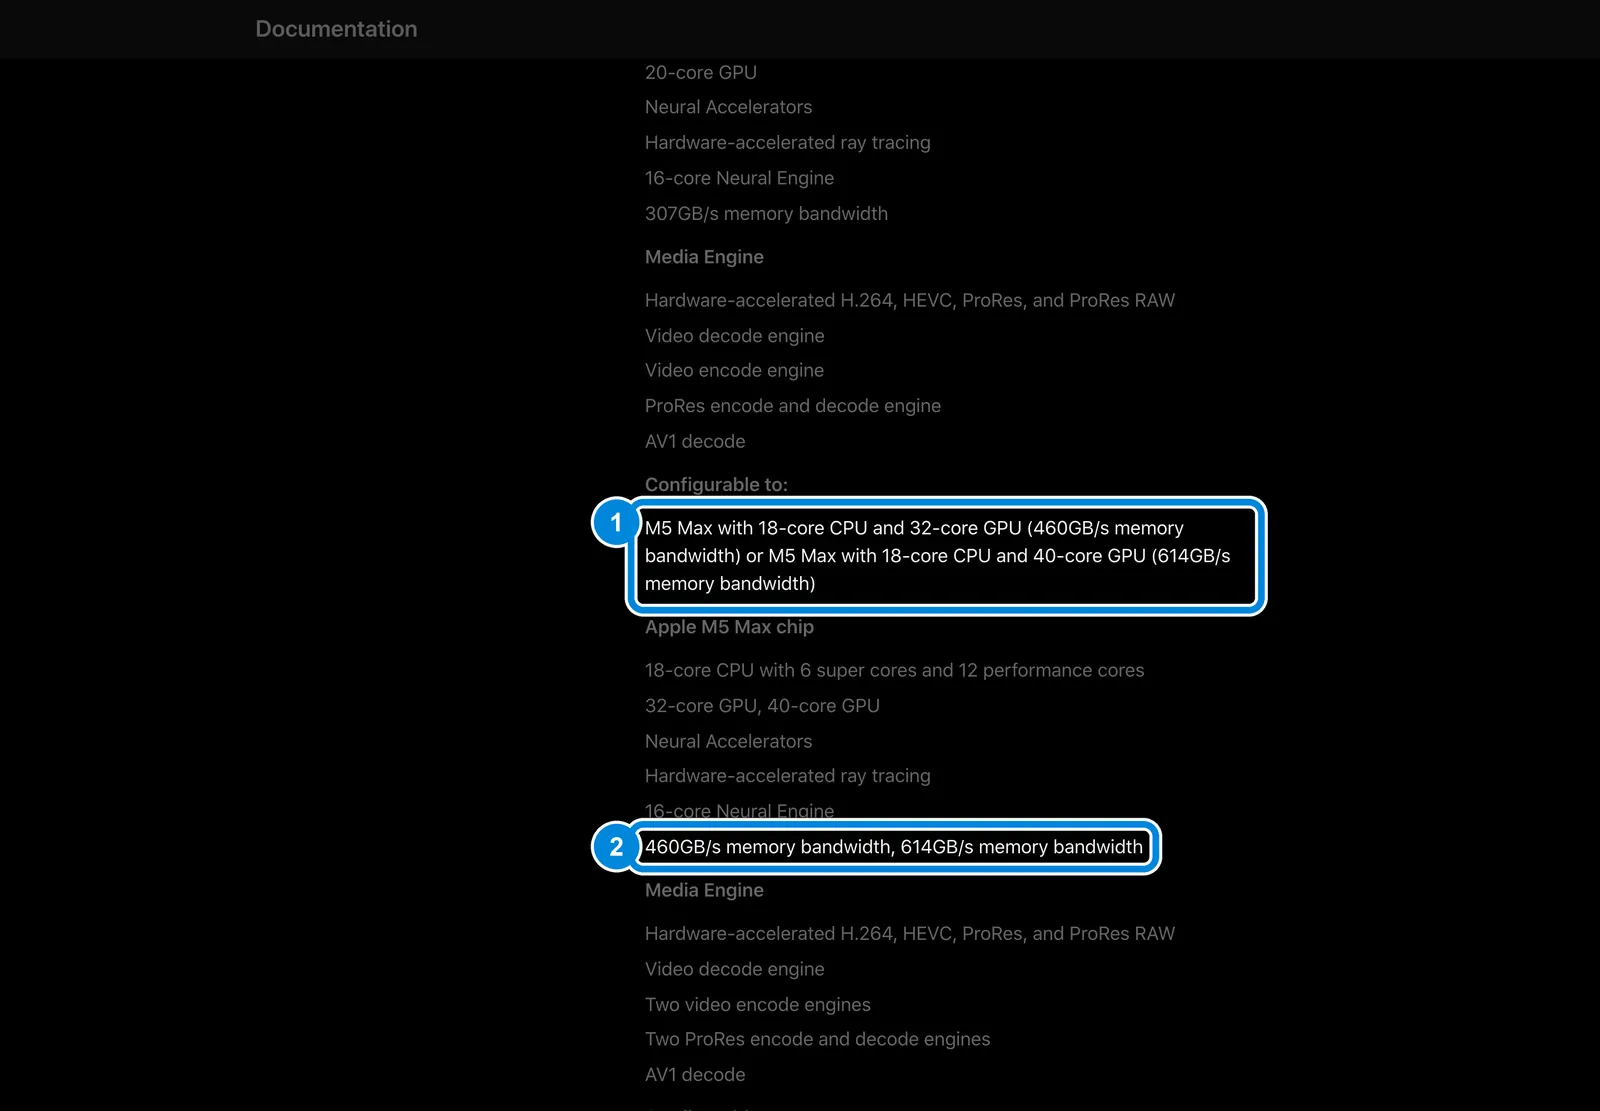
На знімку сторінки характеристик MacBook Pro 16 з M5 Max на сайті підтримки Apple (знято 25 жовтня 2026 року) рамка 1 показує дві конфігурації чипа — 32-ядерний GPU зі смугою 460 ГБ/с і 40-ядерний із 614 ГБ/с, а рамка 2 — ті самі дві цифри в описі самого чипа. Обидві версії отримали однаковий 18-ядерний процесор; різняться графіка, шина пам’яті й максимальний обсяг.
Ще дві речі, яких немає в таблиці, але які важливі далі. Апаратне трасування променів (прискорювач розрахунку світла в 3D-сценах) з’явилося лише в M3 — у M1 Max і M2 Max його немає. А 18-ядерний процесор M5 Max влаштований інакше, ніж у попередників: шість «супер-ядер» — так Apple тепер називає свої найшвидші ядра — і 12 нових продуктивних ядер, налаштованих на економну багатопотокову роботу. Енергоефективних ядер у колишньому вигляді в M5 Max немає.
Що вміщується в пам’ять Max: моделі від 27B до 120B у 36–128 ГБ
Пам’ять у Mac спільна для процесора й графіки, тому модель «бачить» не весь обсяг. За даними, які наводить незалежний набір тестів на GitHub із посиланням на Apple, GPU може зайняти близько 70% пам’яті на Mac із 32 ГБ і близько 78% на більших конфігураціях. Решту тримають система й програми.
Звідси простий розрахунок: доступно моделі ≈ обсяг пам’яті × 0,70–0,78. Це оцінка, а не гарантія: під довгий діалог моделі потрібен ще кеш контексту (KV-кеш), і він росте з довжиною розмови — як його порахувати, розібрано в матеріалі про те, скільки відеопам’яті потрібно моделі.Обсяг пам’яті Доступно GPU (≈ оцінка) Qwen 27B Q4, 17 ГБ MoE 35B-A3B, 23 ГБ 70B Q4_K_M, 42,5 ГБ gpt-oss 120B, 65 ГБ 70B Q8_0, 75 ГБ 32 ГБ ≈ 22 ГБ так на межі, ні ні ні ні 36 ГБ ≈ 27 ГБ так так ні ні ні 48 ГБ ≈ 37 ГБ так так ні ні ні 64 ГБ ≈ 50 ГБ так так так ні ні 96 ГБ ≈ 75 ГБ так так так так впритул, ні 128 ГБ ≈ 100 ГБ так так так так так
Вага моделей у таблиці — реальні файли: 70B Q4_K_M — 42,5 ГБ, 70B Q8_0 — близько 75 ГБ (за файлами на Hugging Face), gpt-oss 120B у форматі MXFP4 — 65 ГБ, Qwen 3.8 27B у 4 бітах — 17 ГБ.
З таблиці випливає важливе для покупки. Для локального ШІ (AI) у парі M4 Max vs M5 Max обсяг вирішує більше, ніж покоління: молодші версії обох чипів продаються лише з 36 ГБ, і модель 70B у них не вміщується взагалі. Для 70B у 4 бітах потрібно щонайменше 64 ГБ, для MoE-моделі на 120 мільярдів параметрів — 96 ГБ, для 70B у 8 бітах — 128 ГБ. Отже, M2 Max із 96 ГБ закриває більше сценаріїв, ніж новий M5 Max із 36 ГБ.
MoE (Mixture of Experts, «суміш експертів») — модель, у якій на кожен токен працює лише мала частина параметрів. У Qwen 3.6 35B-A3B активні близько 3 мільярдів із 35, тому вона швидка, як маленька модель, але в пам’яті займає місце великої.
Швидкість LLM: генерацію визначає смуга пам’яті
Щоб надрукувати кожен наступний токен, чип прочитує з пам’яті всі ваги щільної моделі цілком. Тому швидкість генерації впирається не в ядра, а в те, як швидко пам’ять віддає дані. У порівнянні M4 Max і M5 Max це видно за одним числом: memory bandwidth (пропускна здатність пам’яті) зросла з 546 до 614 ГБ/с, тобто на 12,5%, — і генерація зросла приблизно на стільки ж.
Де реального виміру немає, нижче ми рахуємо оцінку за однією відкритою формулою:
швидкість генерації ≈ смуга пам’яті ÷ вага моделі × η, де η (ета) — частка смуги, яка реально доходить до моделі. За вимірами η зазвичай 0,6–0,8; у старого M1 Max на збірці llama.cpp 2024 року вийшло близько 0,43.
Без множника η формула дає стелю — швидкість, вище за яку звичайна генерація фізично не підніметься. Усі числа з позначкою «оцінка» в цій статті пораховано так.
Реальні виміри llama.cpp на дев’яти версіях чипа
Найповніший відкритий вимір — таблиця розробників llama.cpp в обговоренні #4167 на GitHub: одна модель (Llama 2 7B), один квант Q4_0, однакові параметри тесту на всіх чипах. У ній є дев’ять із десяти версій Max; молодшого M5 Max із 32-ядерним GPU там немає.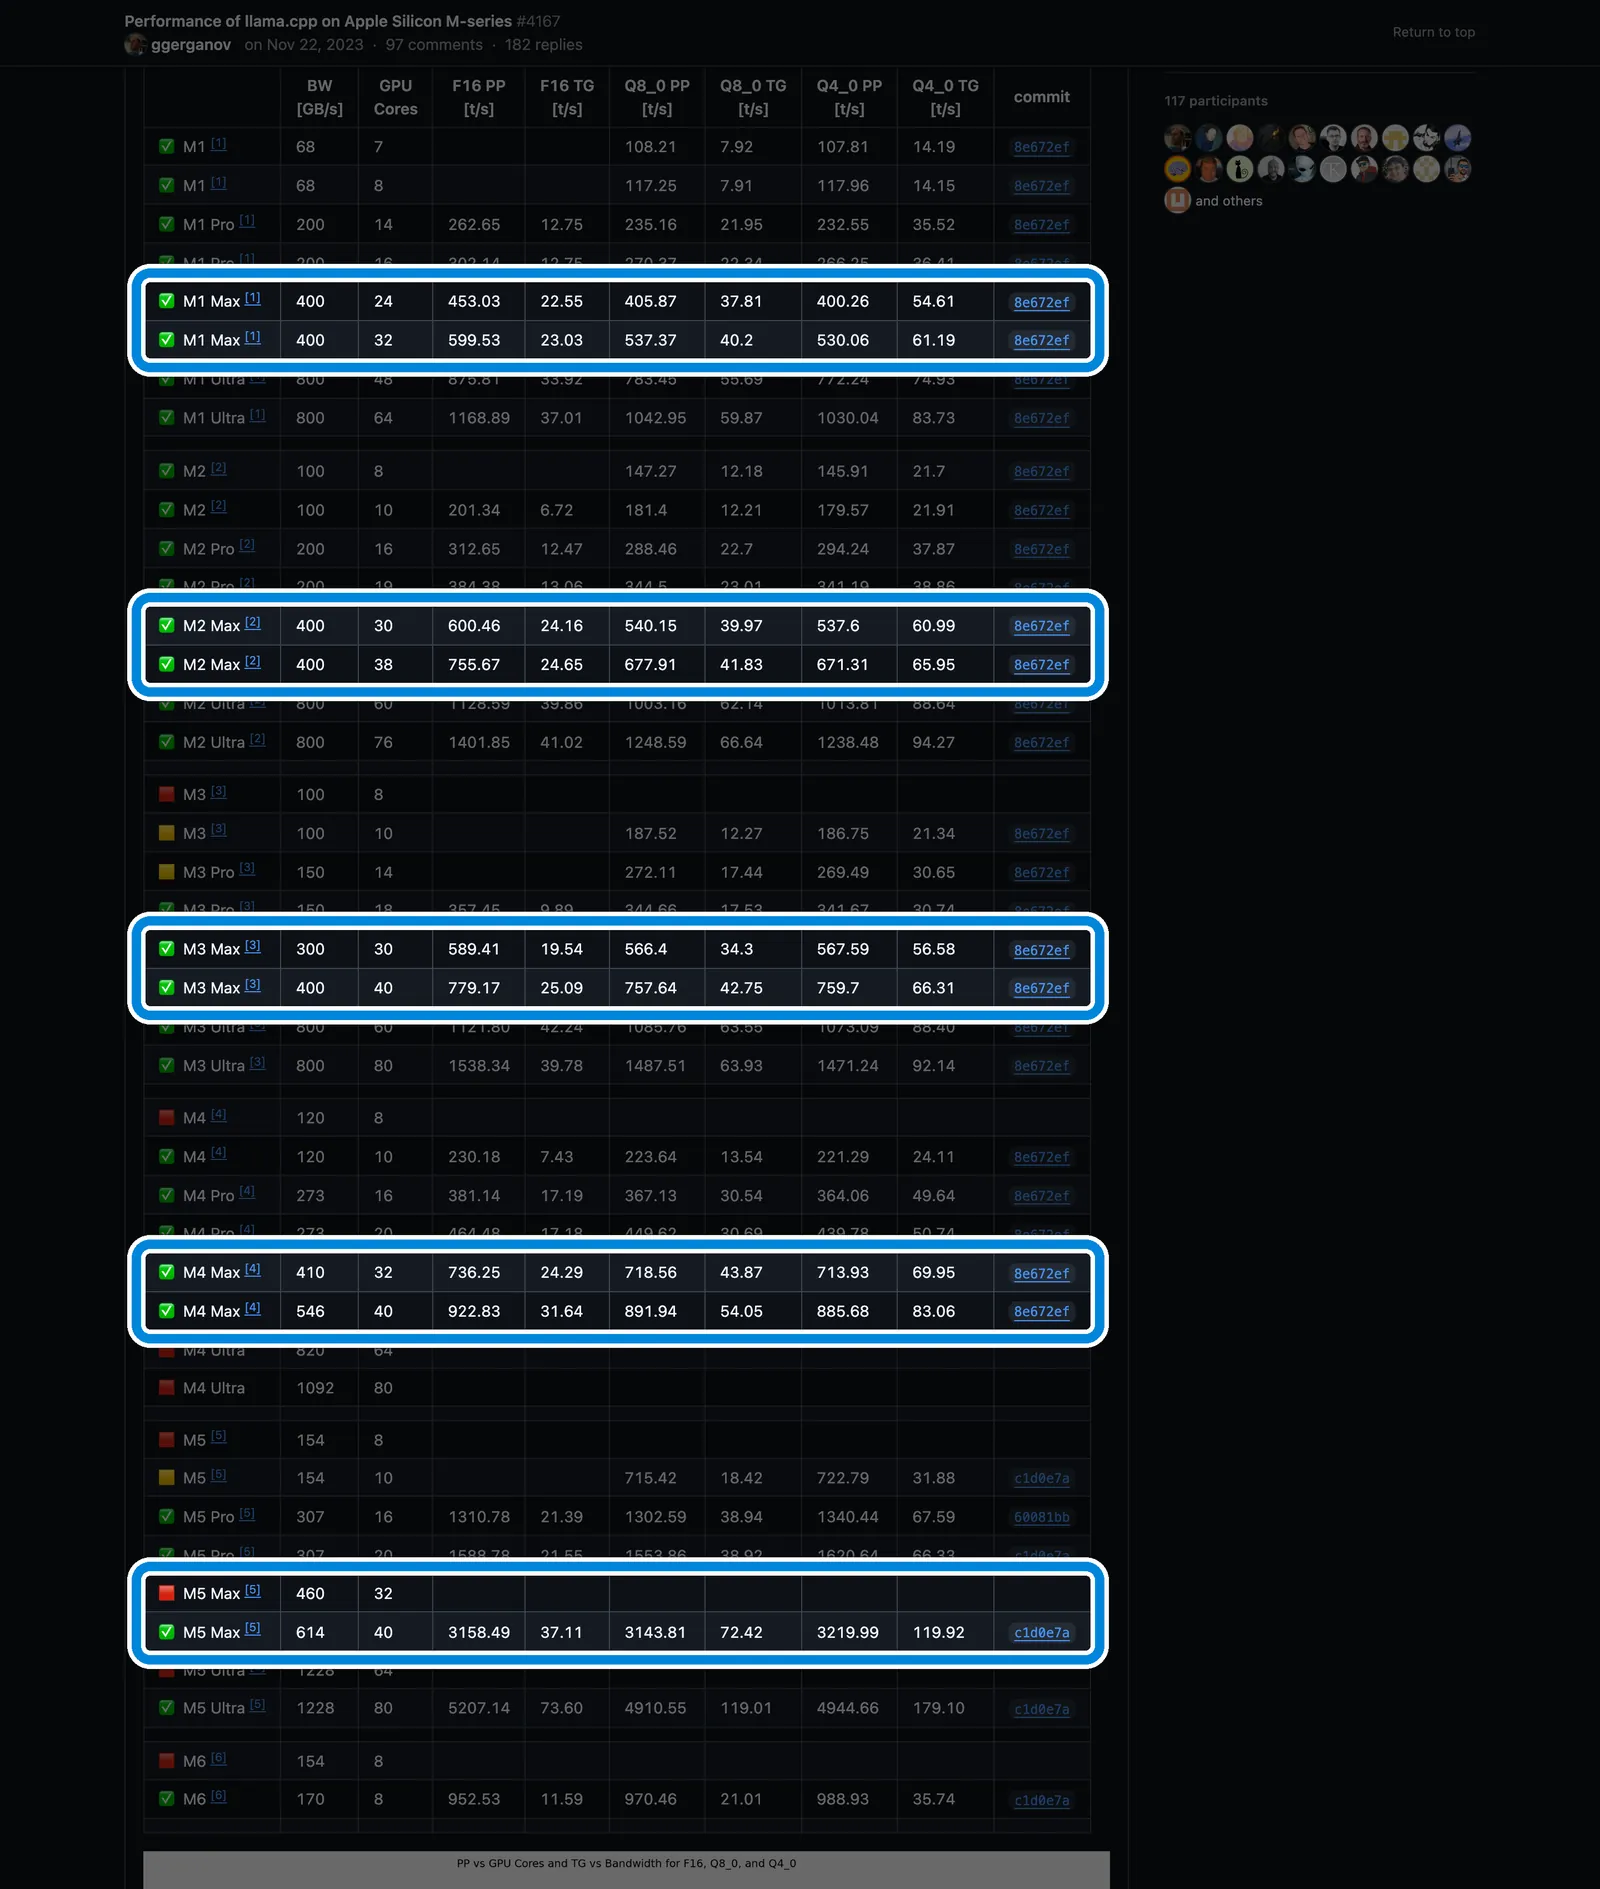
На знімку таблиці (знято 25 жовтня 2026 року) рамками виділено рядки Max. Зверніть увагу на останню колонку commit: у M1–M4 Max стоїть збірка 8e672ef 2023 року, а в M5 Max — c1d0e7a 2026 року. Порівнювати ці рядки безпосередньо не можна: нова програма сама по собі швидша.
Наскільки — видно з M2 Ultra, який виміряли на обох збірках: генерація на тому самому залізі зросла з 94,27 до 125,21 ток/с, тобто в 1,33 раза, читання промпту — в 1,20 раза. Якщо прибрати цей програмний приріст, сирі +44% у M5 Max над M4 Max перетворюються на +9%. Поправка груба: нову збірку на M2 Ultra запускали з прискоренням уваги Flash Attention, і невідомо, чи збігаються налаштування в рядку M5 Max.
Висновок із графіка: від M1 Max до M4 Max генерація на маленькій моделі зросла лише з 61 до 83 ток/с, а молодша версія M3 Max (300 ГБ/с) навіть повільніша за M1 Max із 32-ядерним GPU. Після поправки на версію програми M5 Max дає близько 90 ток/с — приріст до M4 Max відповідає зростанню смуги.Версія Max Смуга Генерація 7B Q4_0, ток/с (вимір) З поправкою на збірку, ток/с M1 Max 24 GPU 400 ГБ/с 54,61 54,61 M1 Max 32 GPU 400 ГБ/с 61,19 61,19 M2 Max 30 GPU 400 ГБ/с 60,99 60,99 M2 Max 38 GPU 400 ГБ/с 65,95 65,95 M3 Max 30 GPU 300 ГБ/с 56,58 56,58 M3 Max 40 GPU 400 ГБ/с 66,31 66,31 M4 Max 32 GPU 410 ГБ/с 69,95 69,95 M4 Max 40 GPU 546 ГБ/с 83,06 83,06 M5 Max 32 GPU 460 ГБ/с н/д ≈ 76 (оцінка) M5 Max 40 GPU 614 ГБ/с 119,92 (нова збірка) ≈ 90,3 (оцінка)
Модель 70B: виміри, оцінки й фізична стеля
На маленькій моделі всі Max швидкі. Різниця стає відчутною на великих моделях. Для Llama 70B у кванті Q4_K_M (42,5 ГБ) є два реальні виміри травня 2024 року: M1 Max із 32-ядерним GPU і 64 ГБ — 4,09 ток/с, M3 Max із 40-ядерним GPU — 7,53 ток/с. Для решти версій — оцінка за формулою.
| Версія Max | Пам’ять | Стеля, ток/с (оцінка) | Швидкість 70B Q4_K_M, ток/с |
|---|---|---|---|
| M1 Max 32 GPU | 64 ГБ | 9,4 | 4,09 (вимір) |
| M2 Max 38 GPU | 64 / 96 ГБ | 9,4 | ≈ 5,6–7,5 (оцінка) |
| M3 Max 30 GPU | 96 ГБ | 7,1 | ≈ 4,2–5,6 (оцінка) |
| M3 Max 40 GPU | 64 / 128 ГБ | 9,4 | 7,53 (вимір) |
| M4 Max 32 GPU | 36 ГБ | — | не вміщується |
| M4 Max 40 GPU | 64 / 128 ГБ | 12,8 | ≈ 7,7–10,3 (оцінка) |
| M5 Max 32 GPU | 36 ГБ | — | не вміщується |
| M5 Max 40 GPU | 64 / 128 ГБ | 14,4 | ≈ 8,7–11,6 (оцінка) |
В оглядах M5 Max трапляються цифри «22–32 ток/с» і «18–28 ток/с» для 70B у 4 бітах. Це не виміри, а розрахунки, і за звичайної генерації вони вищі за фізичну стелю: 614 ГБ/с ÷ 42,5 ГБ = 14,4 ток/с. Щоб вийти за цю межу, програма має видавати більше ніж один токен за один прохід по вагах — так працює, наприклад, спекулятивне декодування, коли маленька модель-помічник вгадує слова, а велика їх перевіряє.
У незалежному вимірі на MacBook Pro 16 з M5 Max і 128 ГБ (BestLLMfor, 16 вересня 2026 року) щільна Qwen 3.8 27B у форматі GGUF дала 36,6 ток/с — біля самої стелі 614 ÷ 17 ≈ 36 (частина файлу, наприклад таблиця словника, на кожному токені цілком не читається, тому вимір може впритул наблизитися до розрахунку). Та сама модель у MLX, бібліотеці Apple для своїх чипів, за даними джерела показала 68,0 ток/с — удвічі вище за стелю: щоб прочитувати 18 ГБ ваг на кожен токен із такою швидкістю, потрібна смуга близько 1,2 ТБ/с, а в чипа 614 ГБ/с. Так буває, лише якщо програма видає більше ніж один токен за прохід по вагах. Ймовірна причина — багатотокенне передбачення (MTP), для якого Qwen 3.8 має вбудовані голови, але автори виміру її не називають, і це поки не підтверджено. Тому цифру 68 ток/с вважаємо неперевіреною заявою одного джерела. Без таких прийомів планка для щільної 70B на M5 Max — 9–11 ток/с; усе понад це залежить від програми й моделі, а не від чипа. Як та сама модель поводиться в різних програмах, ми розбирали в порівнянні Ollama, LM Studio і llama.cpp.
Той самий вимір показує, що M5 Max зі 128 ГБ насправді добре тягне:Модель на M5 Max 40 GPU, 128 ГБ Формат Вага Генерація, ток/с (вимір) Gemma 4 12B GGUF Q4 7,6 ГБ 58,1 Qwen 3.8 27B GGUF Q4 17 ГБ 36,6 Qwen 3.8 27B MLX 18 ГБ 68,0 (вище за стелю смуги, причину не підтверджено — ймовірно, MTP) gpt-oss 20B (MoE) MXFP4 13 ГБ 113,4 gpt-oss 120B (MoE) MXFP4 65 ГБ 75,5–79,1 Qwen 3.6 35B-A3B (MoE) MLX 23 ГБ 167,2
Висновок із таблиці: на Max найвигідніше працюють MoE-моделі. Модель на 120 мільярдів параметрів друкує майже 80 ток/с, бо на кожен токен читає з пам’яті лише активну частину. Докладний розбір саме цього ноутбука — у матеріалі про MacBook Pro M5 Max для нейромереж.
Читання промпту в Max: M5 Max утричі швидший за M4 Max
Читання промпту (prompt processing, prefill) — це час, який модель витрачає на ваш запит до першого слова відповіді. На короткому питанні його не видно. Але коли ви віддаєте моделі договір на 40 сторінок, кодову базу чи довге листування агента, очікування вимірюється вже хвилинами. Тут працює не смуга пам’яті, а обчислювальна потужність GPU — і саме сюди Apple поставила нейроприскорювачі M5.
Найпоказовіший тест (benchmark) пари M4 Max і M5 Max — та сама таблиця llama.cpp: 885,68 ток/с у M4 Max проти 3219,99 ток/с у M5 Max. Сира різниця — у 3,6 раза. Після поправки на нову збірку програми (на M2 Ultra вона дала ×1,20) лишається приблизно в 3,0 раза. Це найбільший приріст покоління для ШІ.
На графіку видно, як рівно зростали M1–M4 Max: кожне покоління додавало 13–27%. M5 Max вибивається з ряду: до M4 Max — приблизно втричі, до M1 Max із 32-ядерним GPU — приблизно в 5 разів (оцінка після поправки на версію програми).Версія Max Читання промпту 7B Q4_0, ток/с (вимір) З поправкою на збірку, ток/с M1 Max 24 / 32 GPU 400,26 / 530,06 400,26 / 530,06 M2 Max 30 / 38 GPU 537,6 / 671,31 537,6 / 671,31 M3 Max 30 / 40 GPU 567,59 / 759,7 567,59 / 759,7 M4 Max 32 / 40 GPU 713,93 / 885,68 713,93 / 885,68 M5 Max 40 GPU 3219,99 (нова збірка) ≈ 2679 (оцінка)
Як це виглядає на великій моделі: у вимірі BestLLMfor gpt-oss 120B на M5 Max прочитала документ на 16 689 токенів (близько 45 сторінок) зі швидкістю 1 388 ток/с — 12 секунд до початку відповіді. Для порівняння, у M3 Max із 40-ядерним GPU у вимірі травня 2024 року модель 70B читала промпт зі швидкістю 62,88 ток/с — той самий обсяг тексту забрав би в неї близько 4,4 хвилини (оцінка; моделі різні, тому це порядок величин, а не точне порівняння).
В оглядах трапляється й цифра «у 4,5 раза швидше». У першоджерелі це проєкція, а не вимір. Apple для Mac Studio з M5 Max заявляє «до 3,9 раза» в LM Studio — це заява виробника на його власному сценарії; незалежний вимір дає близько 3,0.
Генерація картинок і транскрипція: що виміряно, а що оцінка
Для генерації зображень (Flux, Stable Diffusion XL) і розпізнавання мовлення (Whisper) незалежних вимірів на всіх версіях Max в однакових умовах знайти не вдалося. Тому цей розділ коротший, ніж про текст: чисел «секунд на картинку» за бінами ми не наводимо.Завдання Що відомо Статус Генерація картинок, M4 Max Nvidia GB10 (DGX Spark) зберігає велику перевагу над M4 Max (Tom’s Hardware) якісний висновок тесту Генерація картинок, M5 Max проти M4 Max Apple: до 3,5 раза швидше (Mac Studio) заява виробника Рендер на GPU без нейроприскорювачів Blender: M5 Max швидший за M4 Max в 1,39 раза вимір Секунди на зображення за бінами Max — н/д Whisper за бінами Max — н/д
Що з цього випливає на практиці:
- Генерація картинок навантажує обчислення GPU, а не лише пам’ять, тому різниця між поколіннями тут більша, ніж у генерації тексту. Грубий орієнтир знизу — +39% M5 Max до M4 Max на рендері (Blender нейроприскорювачі не використовує), орієнтир згори — заява Apple ×3,5.
- Якщо картинки й відеонейромережі — основна робота, Mac із Max поступається відеокартам Nvidia: більшість інструментів написано під CUDA. Як виглядає цей розрив на одному завданні, ми розбирали в порівнянні DGX Spark, Mac Studio і Strix Halo.
- Транскрипція мовлення моделями класу Whisper не потребує багато пам’яті, тому для неї вистачає будь-якого Max, зокрема M1 Max із 32 ГБ.
CPU і GPU Max у тестах: Blender, Geekbench і Cinebench
Для наскрізного порівняння всіх поколінь потрібен тест, у якому є всі п’ять чипів і одна методика. Найкраще на цю роль підходить база Blender Open Data: медіанний результат користувацьких прогонів в одній версії Blender (5.2) — і для процесора, і для графіки Metal. Цифри нижче — у розділі Benchmarks → Query з фільтром Metal (або CPU), версія 5.2.0, групування за пристроєм.
Графіка: Blender Metal і Geekbench 7
На графіку видно сходинкове зростання. З M1 Max на M2 Max графіка зросла в 1,6 раза, з M2 Max на M3 Max — у 2,5 раза (апаратне трасування променів), далі — в 1,33 раза до M4 Max і в 1,39 раза до M5 Max. Молодший M5 Max із 32-ядерним GPU в Blender на 10% швидший за старший M4 Max із 40 ядрами, але в Geekbench 7 Metal — на 6% повільніший.Версія Max Blender 5.2 Metal, балів (медіана) Кількість прогонів у базі Geekbench 7 Metal, балів (Geekbench Browser) M1 Max 24 / 32 GPU 834,6 / 1084,4 50 / 14 н/д (біни не розділено) M2 Max 30 / 38 GPU 1442,8 / 1743,1 4 / 10 н/д / 139 943 M3 Max 30 / 40 GPU 3613,5 / 4431,8 4 / 6 132 358 / 163 661 M4 Max 32 / 40 GPU 4876,1 / 5874,1 39 / 18 170 277 / 207 545 M5 Max 32 / 40 GPU 6461,9 / 8156,3 11 / 88 194 751 / 240 333
Частина версій має в базі Blender мало прогонів (30-ядерні M2 Max і M3 Max — по чотири), тому їхні цифри менш надійні. У порівнянні M4 Max vs M5 Max за GPU приріст залежить від тесту: Apple заявляє до +20%, Geekbench 7 за базою Geekbench Browser дає +16%, лабораторний вимір Notebookcheck у Geekbench 6.7 (інша версія тесту і своя шкала балів) — +24%, Cinebench 2024 GPU в огляді Macworld — +32%, Blender — +39%.
Процесор: Blender CPU, Cinebench 2026 і Geekbench 7
| Чип (старший CPU-бін) | Blender CPU, балів (біни M3/M4 Max не розділено) | Cinebench 2026, усі ядра | Geekbench 7, усі ядра | Geekbench 7, одне ядро |
|---|---|---|---|---|
| M1 Max, 10 ядер | 201,4 | 3300 | 14 226 | 2221 |
| M2 Max, 12 ядер | 244,4 | 4150 | 17 020 | 2491 |
| M3 Max, 16 ядер | 333,9 | 6140 | 24 512 | 2811 |
| M4 Max, 16 ядер | 403,8 | 7920 | 28 741 | 3349 |
| M5 Max, 18 ядер | 584,9 | 9194 | 34 585 | 3693 |
Багатоядерна потужність Max за п’ять поколінь зросла в 2,4–2,9 раза, одноядерна — в 1,7 раза. Загальна продуктивність (performance) у парі M4 Max vs M5 Max залежить від тесту: +10% в одному ядрі, +16% у Cinebench 2026, +20% у Geekbench 7 (усі ядра) і +45% у довгому рендері Blender. Остання цифра завищена: база Blender не ділить процесори M3 Max і M4 Max за кількістю ядер, і в їхню медіану потрапляють молодші 14-ядерні версії. Лабораторний вимір Notebookcheck обережніший: +10–14% у Geekbench 6.7, а Apple заявляє «до 15%». Бали Geekbench 6 і Geekbench 7 в одну шкалу не ставимо — це різні версії тесту.
Монтаж, 3D та ігри: де M5 Max не обганяє M4 Max
Для відеомонтажу в Max головне — не ядра, а медіарушії: апаратні блоки, які кодують і декодують відео без навантаження на процесор. Два відеокодери й два рушії ProRes мають усі Max, починаючи з M1. Тому різниця між поколіннями в експорті менша, ніж у рендері.
Що показали тести Macworld на MacBook Pro 16 (огляд від 9 березня 2026 року):
- Експорт у ProRes — M5 Max і M4 Max однакові.
- HandBrake, кодування в H.265 — без різниці.
- iMovie, експорт 4K у режимі High — M5 Max швидший на 14%.
- SSD — у M5 Max приблизно вдвічі швидший, до 14,5 ГБ/с за даними Apple. Для монтажу з великими вихідними файлами це найпомітніший виграш покоління: в огляді Mac Studio Macworld пише, що через SSD власникам Mac Studio з M4 Max, які працюють у продакшені, варто серйозно подумати про апгрейд.
Для 3D усе навпаки: рендер на GPU в Blender у M5 Max на 39% швидший, ніж у M4 Max, а під час трасування променів Apple заявляє до +30% до графіки. І варто пам’ятати, що для 3D найбільший крок зробив M3: старші M1 Max і M2 Max рендерять у Blender на GPU в 3,4–7,5 раза повільніше за старші M4 Max і M5 Max.
Ігри. За тестами Notebookcheck у Cyberpunk 2077, Baldur’s Gate 3 і Assassin’s Creed Shadows M5 Max швидший за M4 Max на 8–24% і зазвичай іде на рівні або трохи позаду ноутбучної GeForce RTX 5070. У синтетиці 3DMark Wild Life Extreme у M5 Max 43 222 бали в 16-дюймовому корпусі й 39 389 у 14-дюймовому проти 34 613 у M4 Max. Для ігор Max — приємний бонус до робочої машини: переходити з M4 Max на M5 Max заради 8–24% FPS сенсу мало.
Macworld в огляді Mac Studio формулює підсумок щодо робочих завдань так: у парі M4 Max vs M2 Max приріст був «значно більшим», ніж між M5 Max і M4 Max.
Слабкі місця Max: корпус 14 дюймів, шина M3 Max і ціна пам’яті
Порівняння Max за таблицями характеристик пропускає кілька пасток. Кожна з них коштує грошей.
- M5 Max у 14 дюймах — слабший, ніж у 16. Якщо порівнювати M4 Max vs M5 Max у MacBook Pro, важить і розмір корпусу. За вимірами Notebookcheck 14-дюймовий MacBook Pro ледве тримає 50 Вт на процесорі, а 16-дюймовий тримає 62 Вт. У багатоядерному Cinebench 2024 це 2073 бали проти 2437, а в творчих тестах PugetBench, за даними тієї самої лабораторії, 16-дюймовий швидший приблизно на 15%. До того ж базовий 14-дюймовий M5 Max за $3,599 іде з урізаним 32-ядерним GPU і смугою 460 ГБ/с; повна версія на 614 ГБ/с — у 16-дюймовому від $3,899 або за доплату.
- Молодша версія M3 Max — урізана шина. У 14-ядерному M3 Max увімкнено 24 з 32 контролерів пам’яті, звідси 300 ГБ/с — менше, ніж у будь-якої версії M1 Max і M2 Max. Для генерації тексту вживаний M3 Max 14/30 повільніший за вживаний M1 Max із 32-ядерним GPU.
- Молодші M4 Max і M5 Max — лише 36 ГБ. Пам’ять у Mac розпаяна в одному корпусі з чипом, докупити її потім не можна. Із 36 ГБ модель 70B не запуститься ніколи.
- Mac Studio з M4 Max: стеля пам’яті змінилася за час продажів. На старті у 2025 році старший M4 Max у Mac Studio пропонували з 48, 64 або 128 ГБ — так досі написано на сторінці характеристик Apple. За даними Tom’s Hardware станом на 30 липня 2026 року, новий Mac Studio зі старшим M4 Max продавався вже щонайбільше з 64 ГБ за $5,299. У Mac Studio з M5 Max, представленого 25 серпня 2026 року (у продажу з 22 вересня), стеля знову 128 ГБ. Перед покупкою перевіряйте конфігуратор на дату замовлення.
- Цифри виробника й оглядів треба ділити на тип тесту. «До 4x для ШІ» в Apple — пікові обчислення GPU, а не швидкість генерації. Генерація тексту росте зі смугою пам’яті, тобто на 12%, а не в рази.
Вживані M1 Max і M2 Max проти нових M4 і M5 Max для ШІ
Для тих, хто під локальний ШІ порівнює M4 Max vs M1 Max і новіший M5 Max, головне питання — скільки коштує кожна одиниця того, що реально впливає на швидкість і розмір моделі: гігабайт пам’яті й гігабайт за секунду смуги. Порахуймо це за цінами в Україні станом на 25 жовтня 2026 року.
Формула проста: ціна ÷ смуга (скільки гривень коштує 1 ГБ/с) і ціна ÷ обсяг пам’яті (скільки коштує 1 ГБ під модель). Це наш розрахунок за цінами нижче, а не тест.Конфігурація (25.10.2026) Ціна, грн Смуга Пам’ять грн за 1 ГБ/с грн за 1 ГБ MacBook Pro 16, M1 Max 32 ГБ, вживаний (OLX, медіана) 66 500 400 ГБ/с 32 ГБ 166 2078 MacBook Pro 16, M2 Max 38 GPU 32 ГБ, вживаний (OLX, медіана) 65 400 400 ГБ/с 32 ГБ 164 2044 MacBook Pro 16, M1 Max 64 ГБ, вживаний (Jabko, гарантія) 95 550 400 ГБ/с 64 ГБ 239 1493 MacBook Pro 16, M3 Max 40 GPU 48 ГБ, вживаний (OLX, медіана) 124 800 400 ГБ/с 48 ГБ 312 2600 MacBook Pro 16, M4 Max 48 ГБ, новий (hotline, медіана) 171 403 546 ГБ/с 48 ГБ 314 3571 MacBook Pro 16, M5 Max 48 ГБ, новий (hotline, медіана) 214 794 614 ГБ/с 48 ГБ 350 4475 MacBook Pro 16, M5 Max 128 ГБ, новий (Jabko) 369 199 614 ГБ/с 128 ГБ 601 2884
Що видно з розрахунку:
- Найдешевший гігабайт пам’яті — у вживаного M1 Max на 64 ГБ: близько 1 500 грн за ГБ, удвічі дешевше, ніж у нового M4 Max, і втричі дешевше, ніж у нового M5 Max на 48 ГБ. Модель 70B у 4 бітах на ньому працює (вимір — 4,09 ток/с), а моделі до 27B і MoE на кшталт gpt-oss 20B — комфортно.
- Найдешевша смуга — у вживаних M1 Max і M2 Max на 32 ГБ, але 32 ГБ — це стеля для моделей приблизно до 27B у 4 бітах.
- Вживаний M3 Max на 48 ГБ — невдала середина: та сама смуга 400 ГБ/с, що й у M1 Max, пам’яті менше, ніж у M1 Max на 64 ГБ, а ціна вища. Для ШІ його варто брати лише зі 128 ГБ.
- Новий M5 Max зі 128 ГБ дорогий в абсолюті, але за гігабайт пам’яті обходиться дешевше, ніж M4 Max і M5 Max на 48 ГБ. Це єдиний варіант зі списку, де вміщується 70B у 8 бітах.
Що ви втрачаєте, обираючи вживаний M1 Max замість нового M5 Max: читання промпту приблизно вп’ятеро повільніше, графіку без трасування променів, повільний SSD, гарантію виробника і, можливо, зношену батарею. Якщо потрібен найдешевший вхід у локальний ШІ без великої моделі, погляньте й на Mac Mini M4 Pro для нейромереж.
Ціни в Україні станом на 25 жовтня 2026: нові й вживані Mac з Max
Ціни на Mac в Україні сильно різняться між магазинами, тому нижче — медіана пропозицій: половина продавців дешевша, половина дорожча. Нові — за каталогом hotline.ua, вживані — за приватними оголошеннями OLX і магазином Jabko з гарантією. Усі ціни — станом на 25 жовтня 2026 року; це перше, що в статті застаріє.
| Конфігурація | Стан | Ціна на 25.10.2026, грн | Де |
|---|---|---|---|
| MacBook Pro 16, M2 Max 38 GPU, 32 ГБ / 1 ТБ | вживаний | 65 400 (медіана; від 56 250) | OLX |
| MacBook Pro 16, M1 Max 32 GPU, 32 ГБ / 1 ТБ | вживаний | 66 500 (медіана; від 56 500) | OLX |
| MacBook Pro 16, M1 Max 32 GPU, 32 ГБ / 1 ТБ | вживаний із гарантією | 79 625 | Jabko |
| MacBook Pro 16, M1 Max 32 GPU, 64 ГБ / 1 ТБ | вживаний із гарантією | 95 550–100 100 | Jabko |
| MacBook Pro 14/16, M3 Max 30 GPU, 36 ГБ / 1 ТБ | вживаний | 100 000 (медіана) | OLX |
| MacBook Pro 16, M3 Max 40 GPU, 48 ГБ / 1 ТБ | вживаний | 124 800 (медіана) | OLX |
| Mac Studio, M2 Max 30 GPU, 32 ГБ / 512 ГБ | новий, залишки | 80 399 | Jabko |
| Mac Studio, M5 Max 32 GPU, 36 ГБ / 512 ГБ | новий | 159 550 (медіана; від 127 529) | hotline |
| MacBook Pro 14, M5 Max 32 GPU, 36 ГБ / 2 ТБ | новий | 170 516 (медіана; від 156 176) | hotline |
| MacBook Pro 16, M4 Max 40 GPU, 48 ГБ / 1 ТБ | новий | 171 403 (медіана; від 151 135) | hotline |
| MacBook Pro 16, M5 Max 40 GPU, 48 ГБ / 2 ТБ | новий | 214 794 (медіана; від 201 363) | hotline |
| Mac Studio, M4 Max 40 GPU, 64 ГБ / 512 ГБ | новий | 223 997 (медіана) | hotline |
| Mac Studio, M5 Max 40 GPU, 64 ГБ / 1 ТБ | новий | 247 477 (медіана) | hotline |
| MacBook Pro 16, M5 Max 40 GPU, 128 ГБ / 2 ТБ | новий | 369 199 | Jabko |
Кілька застережень до таблиці. MacBook Pro 16 з M4 Max на 48 ГБ станом на 25 жовтня 2026 року в Jabko значиться «немає в наявності» (остання ціна 195 999 грн), у Foxtrot — теж немає в наявності за 249 999 грн, хоча в каталозі hotline.ua на ту саму дату 18 пропозицій від 151 135 грн. Новий MacBook Pro 16 з M2 Max на 96 ГБ у Jabko розпродано (остання ціна 187 999 грн). Щодо вживаних M4 Max і M5 Max порівнянних пропозицій на цю дату немає — н/д.
Для порівняння зі стартовими цінами Apple у США: MacBook Pro 14 з M5 Max — від $3,599, 16-дюймовий — від $3,899, Mac Studio з M5 Max — від $2,499. Mac Studio з M5 Max на 36 ГБ у Jabko 25 жовтня 2026 року коштував 151 599 грн, або 3 332 долари за курсом магазину, — приблизно на третину дорожче за американську ціну без податку.
Який Max обрати: M1, M2, M3, M4 чи M5 під ваше завдання
Вибір між M3 Max, M4 Max і M5 Max, а заразом ранішими M1 Max і M2 Max, зводиться до чотирьох питань. Ідіть за кроками — перша відповідь «так» і є вашим вибором.
- Потрібні моделі 70B і більші або MoE на 120B? Дивіться лише версії з 64 ГБ і більше. Найкраще співвідношення ціни й обсягу — вживаний M1 Max або M2 Max на 64–96 ГБ; найкраща швидкість і запас — M5 Max зі 128 ГБ. Якщо й 128 ГБ замало, це вже рівень Mac Studio M5 Ultra для LLM.
- Працюєте з довгими документами, кодом та агентами? Беріть M5 Max: читання промпту в нього приблизно втричі швидше, ніж у M4 Max, і це економить хвилини на кожному довгому запиті. Молодша версія на 36 ГБ підходить лише під моделі до ~27B.
- Основна робота — 3D, рендер, ігри? Мінімум — M3 Max (апаратне трасування променів); M4 Max і M5 Max швидші за нього в Blender в 1,3 і 1,8 раза відповідно. M1 Max і M2 Max для 3D сьогодні — компроміс.
- Основна робота — монтаж ProRes і H.265? Переплачувати за M5 Max заради експорту не потрібно: у ProRes і HandBrake він не швидший за M4 Max. Вирішують обсяг SSD і пам’ять під таймлайн; M5 Max виграє швидкістю диска.
Короткі правила для частих ситуацій:
- Маєте M1 Max або M2 Max на 64 ГБ — міняти варто, лише якщо впираєтеся в читання довгих промптів або в 3D. Для генерації тексту приріст M5 Max — близько півтора раза за смугою (400 → 614 ГБ/с).
- Маєте M4 Max — заради генерації тексту переходити на M5 Max немає сенсу (+9–12%); заради читання промпту, GPU-рендеру й SSD — є.
- Обираєте ноутбук M5 Max — беріть 16 дюймів: він довше тримає потужність і з заводу йде з повною 40-ядерною версією.
- Не беріть для ШІ молодші M4 Max і M5 Max на 36 ГБ і вживаний M3 Max 14/30 — перші впираються в обсяг, другий — в урізану шину.
Часті запитання
Чим M5 Max відрізняється від M4 Max для локальних нейромереж?
Генерація тексту в M5 Max швидша приблизно на 9–12% — стільки ж, на скільки зросла смуга пам’яті (546 → 614 ГБ/с). Головна різниця — у читанні промпту: у тесті llama.cpp M5 Max обробляє запит приблизно втричі швидше за M4 Max навіть після поправки на версію програми. Обсяг пам’яті у старших версій однаковий — до 128 ГБ.
Скільки пам’яті потрібно Mac із Max для моделі 70B?
Для 70B у кванті Q4_K_M файл важить 42,5 ГБ, а GPU може зайняти близько 75–78% пам’яті, тому мінімум — 64 ГБ. Для 70B у 8 бітах (близько 75 ГБ) потрібно 128 ГБ. Версії M4 Max і M5 Max на 36 ГБ модель 70B не запускають зовсім. Додайте запас під довгий контекст.
Чи варто купувати вживаний MacBook Pro з M1 Max у 2026 році?
Так, якщо мета — недорогий ноутбук для локальних моделей до 27B і MoE та потрібна пам’ять на 64 ГБ. У нього та сама смуга 400 ГБ/с, що й у старшого M3 Max, а ціна в Україні станом на 25 жовтня 2026 року — від 95 550 грн із гарантією магазину. Мінуси — повільне читання промпту, немає трасування променів, знос батареї.
Який Max швидший для відео — M4 Max чи M5 Max?
В експорті ProRes і кодуванні H.265 у HandBrake тести Macworld різниці між ними не знайшли, в експорті 4K з iMovie M5 Max швидший на 14%. Помітний виграш M5 Max — SSD приблизно вдвічі швидший, до 14,5 ГБ/с. Якщо ви монтуєте й не працюєте з 3D, добре налаштований M4 Max майже не поступається.
Чому в M3 Max дві різні пропускні здатності пам’яті?
У молодшій версії M3 Max із 14-ядерним CPU і 30-ядерним GPU Apple увімкнула 24 з 32 контролерів пам’яті, тому смуга — 300 ГБ/с. У старшій 16-ядерній версії працюють усі контролери — 400 ГБ/с. У підсумку молодший M3 Max генерує текст повільніше за M1 Max із 32-ядерним GPU (56,6 проти 61,2 ток/с у llama.cpp), хоча він на два роки новіший.
Чи вистачить M2 Max із 64 ГБ для локального ШІ?
Вистачить для більшості домашніх завдань: моделі до 27B, MoE на кшталт gpt-oss 20B і Qwen 35B-A3B, а також 70B у 4 бітах — за оцінкою, близько 5,6–7,5 ток/с. Не вмістяться gpt-oss 120B і 70B у 8 бітах — для них потрібна версія з 96 або 128 ГБ. Смуга в M2 Max — 400 ГБ/с, як і в M1 Max.