
Коротко (TL;DR)
Whisper large-v3 локально — это самая точная открытая модель распознавания речи от OpenAI, запущенная на вашем компьютере: аудио никуда не уходит, подписки нет, интернет нужен только для скачивания файла модели. Для русского она ошибается примерно в 5 словах из 100 (WER 4,96% на наборе FLEURS), для украинского — примерно в 6 (6,28%).
- Коротко (TL;DR)
- Whisper large-v3 локально: что это и чем отличается от v2 и turbo
- Версии Whisper large-v3: размеры, лицензия и вес файлов
- Точность large-v3 на русском и украинском: WER по FLEURS
- Large-v3 против turbo, Parakeet и Voxtral: какую модель выбрать
- Сколько памяти и времени займёт расшифровка на RTX и Apple M4
- Как запустить Whisper локально: faster-whisper, whisper.cpp и MLX
- Риски large-v3: галлюцинации, повторы и окна по 30 секунд
- Локальный Whisper или облачный API: сколько стоит час записи
- Какую модель Whisper взять под подкаст, совещание и субтитры
- Частые вопросы о локальной расшифровке речи
- Какая версия. Новейшие открытые чекпойнты — large-v3 (ноябрь 2023) и large-v3-turbo (октябрь 2024). Модели «large-v4» нет.
- Сколько весит. Полная large-v3 в формате whisper.cpp — 2,9 GiB, сжатая до 5 бит — 1,1 GiB; turbo — 1,5 GiB и 547 MiB.
- Сколько памяти. Ориентир OpenAI «~10 ГБ» относится к исходной реализации; в faster-whisper та же модель занимает 4,5 ГБ видеопамяти, в 8-битном режиме — 2,9 ГБ. Хватит видеокарты на 8 ГБ и любого Mac на Apple Silicon.
- Скорость. Час записи на RTX 3070 Ti — около 5 минут, с пакетной обработкой — 1,3 минуты (замер на large-v2, архитектура та же); на M4 Max — 2,5 минуты для large-v3 и 1,1 минуты для turbo; на базовом M4 turbo в WhisperKit — 4,2 минуты.
- turbo или large-v3. turbo на Mac быстрее примерно в 2,3 раза и ошибается чуть чаще: +1 процентный пункт на русском и украинском. «В 8 раз быстрее» — заявка OpenAI для видеокарты A100 и английской речи.
- Как запустить. NVIDIA — faster-whisper, Mac — mlx-whisper, любой компьютер — whisper.cpp. Команды с версиями — ниже.
Эта статья про расшифровку готовых файлов: подкасты, записи созвонов, интервью, субтитры. Диктовку в реальном времени, когда текст печатается по мере речи, мы разобрали отдельно — в материале Wispr Flow или свой Whisper. Все замеры скорости ниже чужие, с указанием стенда и методики; где замера нет, скорость не приводим.
Whisper large-v3 локально: что это и чем отличается от v2 и turbo
Whisper — модель автоматического распознавания речи (по-английски ASR, automatic speech recognition). На вход она получает звук, на выходе отдаёт текст с метками времени. Внутри два блока: энкодер «слушает» 30-секундный кусок записи целиком и превращает его в набор признаков, декодер по этим признакам пишет текст слово за словом. Линейка состоит из моделей разного размера — от tiny до large, и чем больше модель, тем точнее и медленнее.
Whisper large-v3 OpenAI анонсировала 6 ноября 2023 года. От предыдущей large-v2 её отличают три вещи:
- Вход стал подробнее. Звук перед обработкой превращается в спектрограмму — «картинку» частот. В v3 частотных полос 128 вместо 80, то есть модель различает больше оттенков звука.
- Данных стало больше. large-v3 обучали на 1 млн часов слабо размеченного аудио (по готовым субтитрам) и 4 млн часов, которые разметила сама large-v2.
- Добавился кантонский язык отдельным токеном.
По заявке OpenAI, large-v3 ошибается на 10–20% реже, чем v2, на широком наборе языков. Это слова самой компании; независимая проверка для русского и украинского — в разделе про точность ниже, и она заявку в целом подтверждает.
large-v3-turbo вышла 1 октября 2024 года. Это та же large-v3, у которой декодер урезали с 32 слоёв до 4, а энкодер оставили прежним. Параметров стало 809 млн вместо 1550 млн. Логика простая: «слушающая» часть сохранила качество, а «пишущая» стала в разы легче, поэтому модель работает быстрее. Цена — немного больше ошибок и слабый перевод: turbo дообучали без данных перевода, и OpenAI прямо пишет, что хорошего перевода на английский от неё не ждёт.
Модели «Whisper large-v4» не существует, хотя такой запрос встречается. Самые новые открытые модели распознавания речи OpenAI — large-v3 и large-v3-turbo. Новые ASR-модели компании (gpt-4o-transcribe и другие) доступны только через платный API и локально не запускаются.
Версии Whisper large-v3: размеры, лицензия и вес файлов
Одна и та же модель распространяется в нескольких форматах — под разные программы запуска. Формат определяет, сколько файл весит на диске и сколько памяти займёт в работе. Квантование — это сжатие весов модели: вместо 16 бит на каждое число хранится 8 или 5. Файл становится в 2–3 раза меньше, точность падает обычно незаметно.
Сколько весит Whisper large-v3 в формате ggml (его читает whisper.cpp) — по README проекта на 25.10.2026:Модель Параметров Файл ggml (полный) Файл ggml q5_0 Файл Q8_0 (Handy) Лицензия large-v3 1550 млн 2,9 GiB 1,1 GiB 1,55 ГБ MIT (README) / Apache-2.0 (карточка HF) large-v3-turbo 809 млн 1,5 GiB 547 MiB 0,83 ГБ MIT 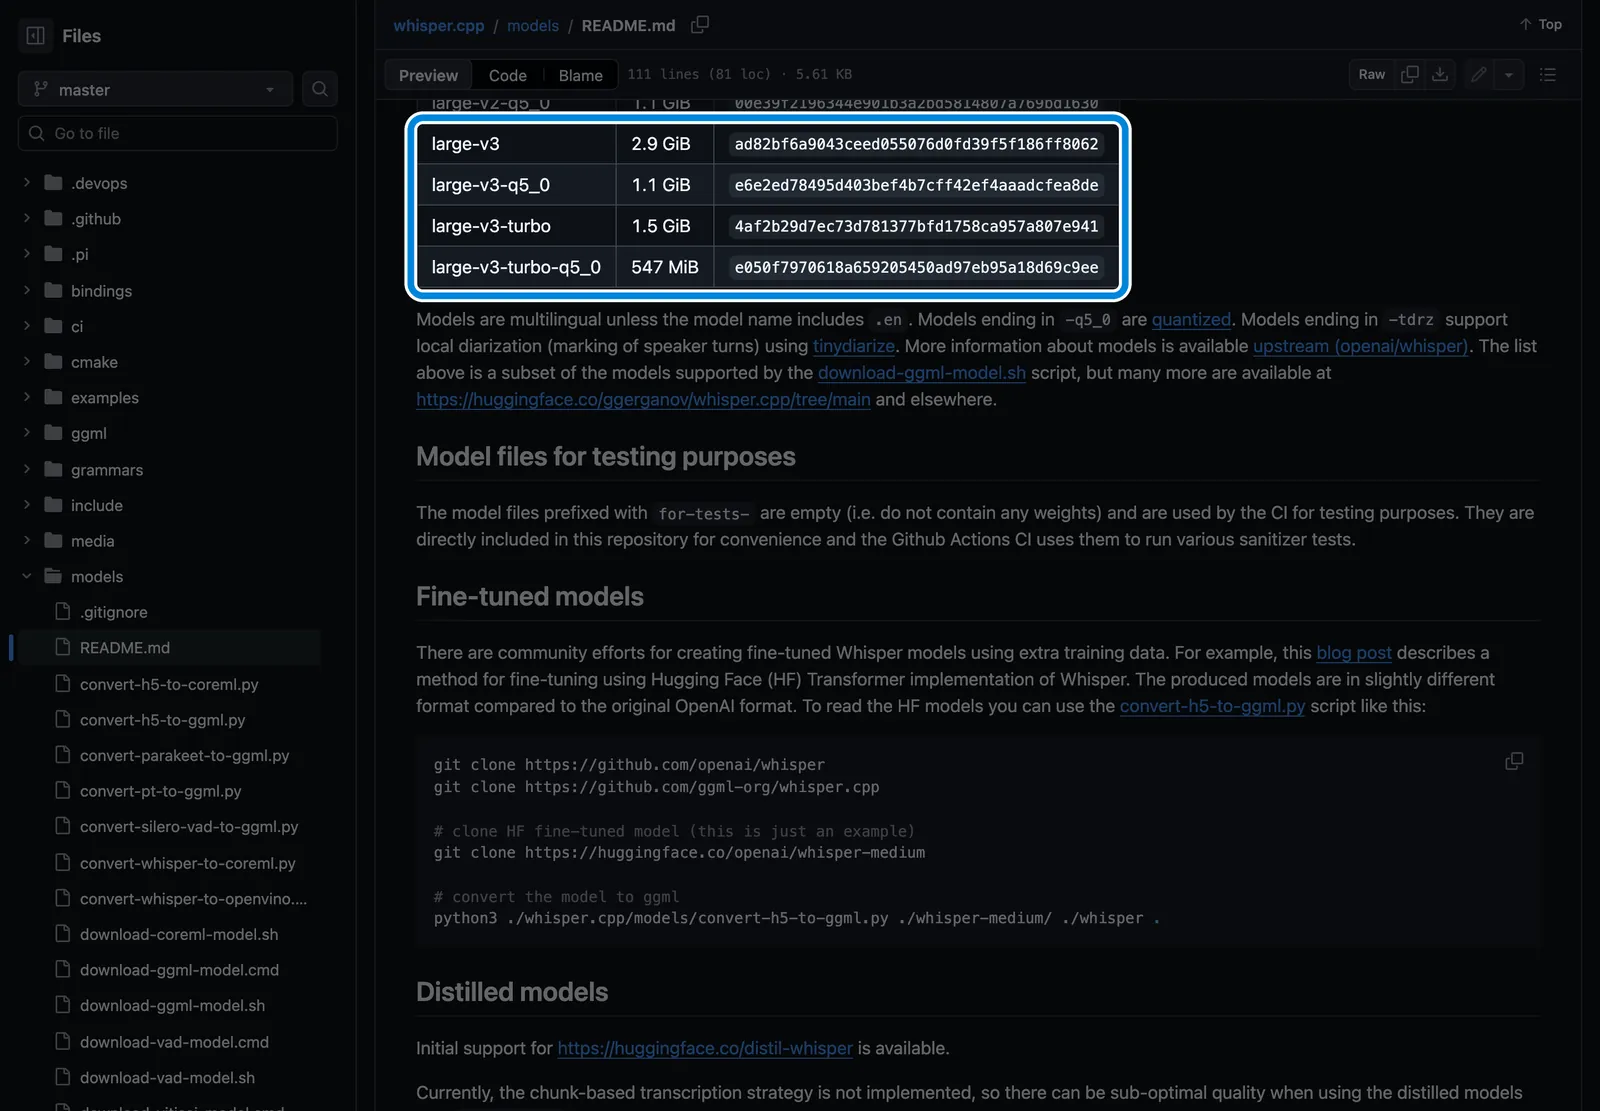
На скриншоте README whisper.cpp, снятом 25 октября 2026 года, рамкой выделены четыре строки семейства large-v3: полный файл и сжатый q5_0 для обычной модели и для turbo. Именно эти файлы скачивает скрипт whisper.cpp.
С лицензией есть расхождение, о котором стоит знать. README репозитория OpenAI говорит, что код и веса выпущены под MIT. Метаданные карточки large-v3 на Hugging Face указывают Apache-2.0, карточка turbo — снова MIT. Обе лицензии разрешают коммерческое использование, поэтому на практике это ничего не меняет: расшифровки можно использовать в работе и продавать. Для юридически строгого проекта сошлитесь на обе.
Скачать Whisper large-v3 проще всего не руками, а командой самой программы: она возьмёт файл нужного формата с Hugging Face.
- для faster-whisper — репозиторий
Systran/faster-whisper-large-v3(для turbo —mobiuslabsgmbh/faster-whisper-large-v3-turbo), скачивается сам при первом запуске; - для mlx-whisper на Mac —
mlx-community/whisper-large-v3-mlxиmlx-community/whisper-large-v3-turbo; - для whisper.cpp — файлы
ggml-large-v3.binиggml-large-v3-turbo-q5_0.binиз репозиторияggerganov/whisper.cppна Hugging Face или командаmake -j large-v3.
Исходные веса в формате PyTorch лежат на карточке модели — их берут openai/whisper и библиотека Transformers.
Точность large-v3 на русском и украинском: WER по FLEURS
Точность распознавания меряют WER (word error rate) — долей ошибочных слов: пропущенных, лишних и заменённых. WER 5% значит, что на 1000 слов придётся около 50 ошибок. Своей таблицы WER по языкам для large-v3 OpenAI не публикует: в README есть только график-картинка. Поэтому основной источник ниже — независимый бенчмарк Handy, который прогоняет модели на тестовой части набора FLEURS (чтение вслух, чистая запись) в кванте Q8_0.
На графике видно, что на русском large-v3 впереди всех Whisper, а на украинском плотная группа: Parakeet v3 отстаёт от неё на полпункта, turbo — примерно на пункт.Модель Русский, WER % Украинский, WER % Откуда Whisper large-v3 4,96 6,28 (ElevenLabs: 9,5) Handy; ElevenLabs — вендор Whisper large-v3-turbo 5,93 7,31 Handy Whisper large-v2 5,61 (OpenAI: 5,6) 8,17 (OpenAI: 8,6) Handy; статья OpenAI Whisper medium 7,30 11,59 Handy Parakeet TDT 0.6B v3 6,54 (NVIDIA: 5,51) 6,84 (NVIDIA: 6,79) Handy; карточка NVIDIA Voxtral Mini 4B Realtime 5,41 (Mistral: 6,02) языка нет Handy; карточка Mistral 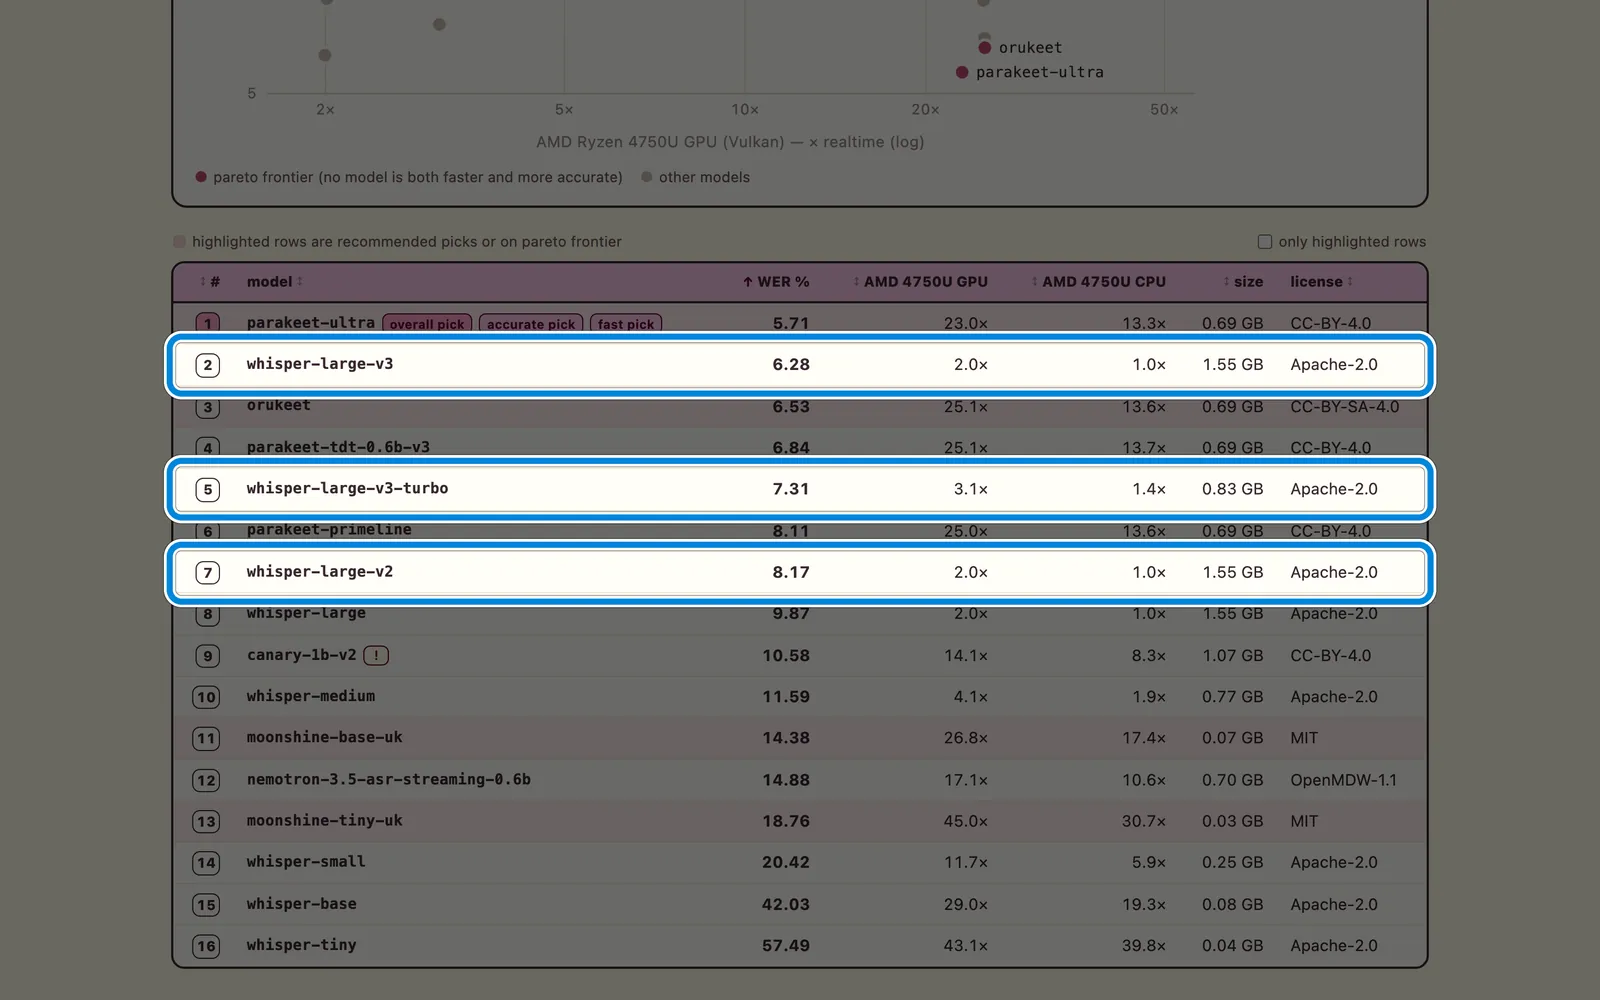
На скриншоте таблицы Handy для украинского, снятом 25 октября 2026 года, рамками выделены три строки Whisper: large-v3 с 6,28%, turbo с 7,31% и large-v2 с 8,17%. Строкой выше large-v3 стоит parakeet-ultra с 5,71% — это Parakeet TDT 0.6B v3, дообученная компанией Moondream (модель moondream/parakeet-ultra на Hugging Face, лицензия CC BY 4.0, сентябрь 2026). Handy рекомендует её для украинского.
Что из этого следует на практике. Переход с v2 на v3 снижает ошибки на русском на 12% (с 5,61 до 4,96), на украинском — на 23% (с 8,17 до 6,28). Заявка OpenAI «на 10–20% меньше ошибок» для русского подтверждается, для украинского выигрыш даже больше. turbo по сравнению с large-v3 добавляет около одной ошибки на каждые 100 слов: примерно 59 ошибок на 1000 слов вместо 50 на русском. Сравнение large-v3 с medium ещё нагляднее: на украинском меньшая medium ошибается в 11,59% слов против 6,28%, то есть почти вдвое чаще.
Почему одна модель даёт и 4,96%, и 16%, и 20,8%
Читая обзоры, легко запутаться: про ту же large-v3 пишут и 4,96%, и 16%, и 20,8%. Все три цифры могут быть верными, потому что меряют разное:
- 4,96% — русский, FLEURS, чистое чтение вслух (Handy).
- 16,0% — среднее по 45 языкам FLEURS в замере Mistral, куда входят и трудные для модели языки. Это вендорный замер: Mistral продаёт конкурента, свой Voxtral.
- 20,8% — среднее по семи русским наборам с шумной и телефонной речью; русскоязычный гайд toolfox пересказывает замер разработчика конкурирующей модели (вторичный источник).
Разрыв 20,8% против 4,96% — это разница условий измерения, а не моделей: чистое чтение вслух против звонков и шума. Поэтому сравнивать модели можно только по одному набору и одной методике, как в таблице выше.
Для украинского источники расходятся сильнее: 6,28% у Handy и 9,5% у ElevenLabs. ElevenLabs методику нормализации текста не раскрывает и продаёт собственную модель Scribe, поэтому её цифру стоит держать как верхнюю границу. Ещё один ориентир — проект BuzzASR: у large-v3 без дообучения на украинском FLEURS доля ошибочных символов (CER) 2,99%, на Common Voice — 3,7%. CER всегда ниже WER, сравнивать их напрямую нельзя.
Как проверить точность на своём аудио. Бенчмарк не знает ваших микрофонов, акцентов и терминов. Возьмите 30–60 минут своей типичной записи, расшифруйте 5–10 минут вручную как эталон и прогоните через две модели — например, large-v3 и turbo. Посчитать WER можно Python-библиотекой jiwer одной функцией wer(эталон, расшифровка). Разница больше 2–3 пунктов на вашем материале важнее любой таблицы.
Whisper large-v3 russian — это не отдельная модель OpenAI, а версии, которые сообщество дообучило на русской речи. На Hugging Face самая скачиваемая из них — antony66/whisper-large-v3-russian, дообученная на Common Voice 17 (около 2,8 тыс. загрузок за 30 дней на 25.10.2026), есть и сборки для faster-whisper и MLX. Независимого замера этих версий на FLEURS в наших источниках нет: дообучение на Common Voice может улучшить одни записи и ухудшить другие, поэтому сравнивайте их с базовой large-v3 по методике выше.
Large-v3 против turbo, Parakeet и Voxtral: какую модель выбрать
Сравнение Whisper large-v3 vs turbo почти всегда сводится к одному компромиссу: turbo быстрее примерно вдвое, large-v3 точнее примерно на пункт. Вопрос Whisper large-v3 vs Parakeet интереснее: модель NVIDIA в разы быстрее, на английском даже точнее, на украинском почти вровень, но знает только 25 европейских языков. Ниже — всё основное в одной таблице.Модель Параметры Языки WER ru / uk, % Скорость Лицензия Чем запускать Whisper large-v3 1550 млн многоязычная, ru и uk есть 4,96 / 6,28 база MIT / Apache-2.0 faster-whisper, whisper.cpp, MLX Whisper large-v3-turbo 809 млн те же, перевод слабый 5,93 / 7,31 ≈ в 2,3 раза быстрее на Mac MIT те же Parakeet TDT 0.6B v3 600 млн 25 европейских, ru и uk есть 6,54 / 6,84 в 12 раз быстрее large-v3 на Ryzen 4750U (Handy) CC BY 4.0 NVIDIA NeMo, сборки для transcribe.cpp Voxtral Mini 4B Realtime 4 млрд 13, ru есть, uk нет 5,41 / — потоковая, видеокарта от 16 ГБ Apache 2.0 только vLLM Voxtral Mini 3B 3 млрд 8, ru и uk нет — ~9,5 ГБ видеопамяти Apache 2.0 по карточке модели NVIDIA FastConformer UA ~115 млн только украинский uk 5,66 на Common Voice 12 лёгкая CC BY 4.0 NVIDIA NeMo
Parakeet TDT 0.6B v3. Сильнейший соперник Whisper среди открытых моделей. На английском (сводный лидерборд Open ASR) в среднем 6,34% WER против примерно 7,4% у large-v3. На украинском FLEURS отставание от large-v3 всего полпункта (6,84 против 6,28), на русском — полтора пункта (6,54 против 4,96) по замеру Handy; по карточке NVIDIA русский у Parakeet 5,51%. Модель принимает до 24 минут аудио за один проход (на A100 80 ГБ) и работает от 2 ГБ памяти. Минусы — меньше языков и не такая богатая экосистема программ, как у Whisper.
Voxtral от Mistral. Тут нужно разделить две вещи. Voxtral 3, анонсированный 20 октября 2026 года, — это API-модели: Mini Transcribe 3 стоит $0,0035 за минуту, открытых весов в анонсе нет: на своём сервере его можно развернуть только по договору с Mistral, скачать и запустить на домашнем компьютере нельзя. Открытые модели — прошлые: Voxtral Mini 3B (без русского и украинского) и Voxtral Mini 4B Realtime. Последняя по-русски распознаёт хорошо, но рассчитана на потоковую речь, требует видеокарту от 16 ГБ и запускается только через vLLM, а украинского не знает.
Украинская модель NVIDIA (stt_ua_fastconformer_hybrid_large_pc) — узкоспециализированная и лёгкая, 115 млн параметров, WER 5,66% на Common Voice 12 (8,06% с пунктуацией и регистром). Это другой набор данных, чем FLEURS, поэтому напрямую с Whisper её не сравнить, — но для чисто украинского архива на слабом железе её стоит проверить.
Apple SpeechAnalyzer — системный распознаватель macOS 26, без установки моделей. В тесте MacStories 34-минутное видео он расшифровал за 0:45 против 1:41 у MacWhisper с large-v3-turbo, то есть в 2,2 раза быстрее. Поддерживает ли он украинский, мы подтвердить не смогли: проверьте список SpeechTranscriber.supportedLocales на своём Mac.
Итог сравнения: для русского и смешанной речи — Whisper large-v3, для скорости на Mac — turbo, для английского и больших объёмов на видеокарте NVIDIA — Parakeet, для украинского — сравнить large-v3 и Parakeet на своём материале.
Сколько памяти и времени займёт расшифровка на RTX и Apple M4
Сначала про память. Видеопамять (VRAM) — память видеокарты, куда загружается модель; если модель не влезла, программа либо упадёт, либо перейдёт на медленный процессор. У Mac вместо неё единая память: один общий объём на процессор и графику.
График показывает, что пугающая цифра «~10 ГБ» из README OpenAI относится к исходной реализации на PyTorch, а оптимизированные программы обходятся вдвое-втрое меньшим объёмом.Режим Память, ГБ Что это Ориентир OpenAI, large ~10 исходная реализация openai/whisper Ориентир OpenAI, turbo ~6 то же faster-whisper fp16, пакет из 8 6,1 замер, RTX 3070 Ti, large-v2 openai/whisper fp16 4,7 замер, там же faster-whisper fp16 4,5 замер, там же whisper.cpp fp16 4,1 замер, там же faster-whisper int8 2,9 замер, там же
Замеры взяты из README faster-whisper: видеокарта RTX 3070 Ti 8 ГБ, CUDA 12.4, 13 минут аудио, модель large-v2. У large-v3 та же архитектура и то же число параметров, поэтому порядок цифр сохраняется. Отсюда простое правило: на видеокарте от 8 ГБ large-v3 работает в любом режиме оптимизированных программ, на 6 ГБ — в fp16 без пакетного режима или в int8, а самый лёгкий вариант семейства — turbo в формате q5_0, файл 547 MiB.Видеокарта Видеопамять large-v3 fp16 large-v3 int8 Прямой замер скорости large-v3 RTX 3060 12 ГБ (есть и версия на 8 ГБ) влезает влезает нет RTX 3070 Ti 8 ГБ влезает (4,5 ГБ) влезает (2,9 ГБ) есть, для large-v2 RTX 4090 24 ГБ влезает с большим запасом влезает нет RTX 5090 32 ГБ влезает с большим запасом влезает нет
Объём памяти карт — по спецификациям NVIDIA. Замеров large-v3 на RTX 3060, 4090 и 5090 с понятной методикой в открытых источниках мы не нашли, поэтому цифр скорости для них не приводим: по пропускной способности памяти их не пересчитать. Ясно одно: на любой из этих карт large-v3 упрётся не в память, а в программу запуска. Как эти же карты ведут себя с языковыми моделями, мы собирали в обзоре RTX 5090, 4090 и 3090 в локальных LLM.
Теперь скорость. Её удобно мерить во сколько раз быстрее реального времени (×RT): 12× значит, что час записи расшифруется за 5 минут.
Самое заметное на графике: пакетный режим faster-whisper на той же 8-гигабайтной карте ускоряет работу почти вчетверо, M4 Max с turbo расшифровывает час примерно за минуту, а строки WhisperKit почти не зависят от класса чипа.Железо и программа Модель ×RT Минут на 1 час Откуда RTX 3070 Ti 8 ГБ, openai/whisper fp16 large-v2 5,5 11 замер, faster-whisper README RTX 3070 Ti 8 ГБ, whisper.cpp fp16 large-v2 12,0 5,0 замер, там же RTX 3070 Ti 8 ГБ, faster-whisper fp16 large-v2 12,4 4,8 замер, там же RTX 3070 Ti 8 ГБ, faster-whisper fp16, пакет из 8 large-v2 45,9 1,3 замер, там же M4 Max (40 ядер GPU, 128 ГБ) large-v3 24 2,5 замер vllm-mlx, клип 46,7 с M4 Max (40 ядер GPU, 128 ГБ) large-v3-turbo 55 1,1 замер, там же M4 Pro, WhisperKit 0.13.1 (нейродвижок) large-v3-turbo 16,8 3,6 замер Argmax, 2 записи по 10 мин M4, WhisperKit 0.13.1 (нейродвижок) large-v3-turbo 14,4 4,2 замер, там же M2, WhisperKit 0.13.1 (нейродвижок) large-v3-turbo 12,4 4,9 замер, там же Mac (чип не указан), MacWhisper large-v2 8,7 6,9 замер MacStories, видео 34 мин Mac (чип не указан), MacWhisper large-v3-turbo 20,2 3,0 замер, там же Ryzen 4750U, встроенная графика (Vulkan), transcribe.cpp large-v3 2,0 30 замер Handy Ryzen 4750U, встроенная графика (Vulkan), transcribe.cpp large-v3-turbo 3,1 19 замер Handy
Пересчёт в минуты — наш: 60 ÷ ×RT. Исходные секунды: в бенчмарке faster-whisper 13 минут аудио обработаны за 2 мин 23 с (openai/whisper), 1 мин 05 с (whisper.cpp), 1 мин 03 с (faster-whisper) и 17 с (пакет из 8). Это единственный прямой замер на видеокарте RTX с полной методикой.
Откуда «в 8 раз быстрее» и почему у вас будет меньше. Таблица OpenAI сравнивает turbo с large на видеокарте A100 и английской речи. Два независимых замера на Mac дают одинаковое отношение — около 2,3 раза: у vllm-mlx 55× против 24× (M4 Max), у MacStories 1:41 против 3:55 (MacWhisper, правда, против large-v2). Блоги называют 4–5 раз. Ускорение turbo — это выигрыш на декодере, а энкодер у обеих моделей одинаковый, поэтому чем больше времени уходит на «слушание», тем скромнее разница.
Почему класс чипа почти не важен. WhisperKit — программа Argmax, которая гоняет Whisper на нейродвижке Mac (Neural Engine — отдельный блок чипа для нейросетей) через Core ML. В её открытом бенчмарке M4 Pro, у которого графических ядер вдвое больше, чем у M4, расшифровывает turbo всего на 16% быстрее (16,8× против 14,4×), а базовый M2 отстаёт от M4 Pro на четверть. MLX и whisper.cpp считают на графике, и там старший чип выигрывает сильнее: M4 Max с MLX — 55× на turbo. Сопоставимых замеров MLX на M4 и M4 Pro мы не нашли, а строки разных программ и записей напрямую не сравниваются. Вывод для покупки: Mac под одну только расшифровку можно брать базовый — час записи займёт 4–5 минут. Как устроена единая память Mac и сколько её нужно для языковых моделей — в отдельном разборе; там требования совсем другие.
Какая программа быстрее на Mac. В сравнении mac-whisper-speedtest на MacBook Pro M4 24 ГБ короткий клип моделью turbo обработан за 1,02 с в mlx-whisper, за 1,23 с в whisper.cpp с Core ML и за 6,96 с в faster-whisper на процессоре. Вывод: на Mac faster-whisper не берите — он не умеет работать с графикой Apple.
Сколько займёт ваш архив: расчёт
Формула одна: минуты работы = часы записи × 60 ÷ ×RT. Пример для архива подкастов на 40 часов:Где расшифровываем ×RT Время на 40 часов Расчёт RTX 3070 Ti, faster-whisper fp16 12,4 ≈ 3 ч 14 мин 40 × 60 ÷ 12,4 RTX 3070 Ti, faster-whisper, пакет из 8 45,9 ≈ 52 мин 40 × 60 ÷ 45,9 M4 Max, large-v3-turbo 55 ≈ 44 мин 40 × 60 ÷ 55 M4, WhisperKit, large-v3-turbo 14,4 ≈ 2 ч 47 мин 40 × 60 ÷ 14,4 Ноутбук на Ryzen 4750U (встроенная графика), large-v3 2,0 ≈ 20 ч 40 × 60 ÷ 2
Подставьте свой ×RT из таблицы выше. Если результат больше, чем вы готовы ждать, сначала переключитесь на turbo или пакетный режим — это бесплатно, — и только потом думайте о новом железе.
Как запустить Whisper локально: faster-whisper, whisper.cpp и MLX
Ниже три пути с версиями на 25 октября 2026 года: faster-whisper 1.2.1, mlx-whisper 0.4.3, whisper.cpp v1.9.5. Команды взяты из официальных README; мы приводим их как есть, без собственного прогона. Выберите путь по своему железу:Ваше железо Программа Почему Windows или Linux с видеокартой NVIDIA faster-whisper самый быстрый на CUDA, есть пакетный режим Mac на Apple Silicon (M1–M5) mlx-whisper работает на графике Apple, самый быстрый на Mac Любой компьютер, AMD, Intel, без Python whisper.cpp одна программа на C++, CUDA, Vulkan, Core ML или процессор
Windows или Linux с NVIDIA: faster-whisper за пять шагов
faster-whisper — переписанный Whisper на движке CTranslate2. Ему нужен Python 3.9 или новее, а для видеокарты — библиотеки NVIDIA cuBLAS и cuDNN 9 для CUDA 12. Отдельно ставить FFmpeg не нужно: звук декодирует встроенная библиотека.
- Установите Python 3.9+ и драйвер NVIDIA с поддержкой CUDA 12.
- Создайте окружение и поставьте пакет:
python -m venv whisper-env
source whisper-env/bin/activate        # Windows: whisper-env\Scripts\activate
pip install faster-whisper
- Создайте файл
transcribe.py:
from faster_whisper import WhisperModel

model = WhisperModel("large-v3", device="cuda", compute_type="float16")
# мало видеопамяти: compute_type="int8_float16"; без видеокарты: device="cpu", compute_type="int8"

segments, info = model.transcribe("zapis.mp3", beam_size=5, language="ru", vad_filter=True)
print("Язык:", info.language, info.language_probability)
for s in segments:
    print(f"[{s.start:.1f} → {s.end:.1f}] {s.text}")
- Запустите
python transcribe.py. При первом запуске скачается модельSystran/faster-whisper-large-v3. - Для ускорения в 3–4 раза включите пакетный режим:
BatchedInferencePipeline(model=model)иtranscribe("zapis.mp3", batch_size=8). Пакет из 8 в fp16 занимает 6,1 ГБ, поэтому на карте 8 ГБ не поднимайте его выше;batch_size=16— для карт от 12 ГБ. Для turbo замените"large-v3"на"turbo".
Параметр vad_filter=True включает VAD (voice activity detection) — фильтр, который вырезает тишину до распознавания. Это заметно снижает выдуманный текст на паузах.
Mac на Apple Silicon: mlx-whisper
MLX — фреймворк Apple для машинного обучения на чипах серии M. Установка занимает одну команду, но есть ловушка.
pip install mlx-whisper
mlx_whisper zapis.mp3 --model mlx-community/whisper-large-v3-turbo --language ru -f srt
Ловушка: без параметра --model программа берёт крошечную whisper-tiny (около 74 МБ), и расшифровка выходит плохой. Это частая причина отзывов «Whisper на Mac ошибается». Для полной модели укажите mlx-community/whisper-large-v3-mlx. Формат вывода задаёт -f: txt, srt, vtt или json.
Альтернатива без Python — WhisperKit от Argmax: brew install whisperkit-cli, работает на нейродвижке; именно его замеры на M2, M4 и M4 Pro приведены в таблице скорости.
Любой компьютер: whisper.cpp
whisper.cpp — реализация Whisper на C/C++ от автора llama.cpp, с тем же форматом файлов ggml; про её «старшего брата» для языковых моделей — в сравнении Ollama, LM Studio и llama.cpp. Работает на процессоре, видеокартах NVIDIA (CUDA) и AMD/Intel (Vulkan), а на Mac умеет отдавать энкодер нейродвижку через Core ML — это более чем втрое быстрее, чем только процессор.
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
cmake -B build -DGGML_CUDA=1          # NVIDIA; для AMD и Intel: -DGGML_VULKAN=1; Mac: без флага (Metal)
cmake --build build -j --config Release
make -j large-v3-turbo                # скачает модель; полная — make -j large-v3
ffmpeg -i zapis.mp3 -ar 16000 -ac 1 -c:a pcm_s16le zapis.wav
./build/bin/whisper-cli -m models/ggml-large-v3-turbo.bin -f zapis.wav -l ru -osrt
Две детали, на которых спотыкаются чаще всего: whisper-cli читает только 16-битный WAV (отсюда строка с ffmpeg), а язык по умолчанию у него английский. Без -l ru или -l auto русская речь превратится в английский текст. Флаги -otxt, -osrt и -ovtt сохраняют результат в текст или субтитры.
Типичные ошибки при запуске и как их исправить
- faster-whisper не находит библиотеки cuDNN. Обычно установлен cuDNN 8 или CUDA 11, а свежим версиям нужен cuDNN 9 для CUDA 12. Либо обновите библиотеки NVIDIA, либо откатите ctranslate2, как описано в README.
- Видеопамять закончилась. Переключитесь на
compute_type="int8_float16"или turbo; закройте игры и браузер с аппаратным ускорением. - На Mac всё медленно. Проверьте, что запускаете mlx-whisper или whisper.cpp, а не faster-whisper: последний работает только на процессоре.
- Первый запуск whisper.cpp с Core ML идёт минуты. Это компиляция модели под нейродвижок, она происходит один раз.
- Текст на английском вместо русского. Не указан язык:
-l ruв whisper.cpp,language="ru"в faster-whisper,--language ruв MLX.
Риски large-v3: галлюцинации, повторы и окна по 30 секунд
Когда large-v3 не подходит без доработки? Whisper — сильная модель, но у неё есть известные слабые места. Их полезно знать до того, как вы отдадите расшифровку клиенту или в суд.
- Галлюцинации — текст, которого не было в записи. Карточка large-v3 прямо предупреждает: модель может выдавать несказанные фразы и склонна к повторам, особенно на тишине, музыке и шуме. Исследование Careless Whisper нашло выдуманные фразы примерно в 1% записей, и 38% из них содержали явный вред — насилие, ложные связи, ложный авторитет. Важная оговорка: это проверка версий Whisper 2023 года, до large-v3, — ориентир для семейства, а не замер v3. Лечение — VAD-фильтр и выборочная проверка там, где ошибка стоит дорого: медицина, юриспруденция, цитаты.
- Регресс против v2 на отдельных записях. На форуме OpenAI пользователь сравнил модели на 20 записях звонков и получил лучший результат у large-v2 во всех случаях, кроме двух. Речь шла о переводе звонков на английский, и это частное наблюдение, а не бенчмарк, но вывод полезный: для своего типа записей сравните v2 и v3 на десятке файлов.
- Окна по 30 секунд. Whisper слушает запись кусками по 30 секунд, а длинный файл программа режет и склеивает. На стыках слова могут теряться или дублироваться: 24 октября 2026 года в одном из проектов на whisper.cpp описали потерю слов на каждой границе окна в режиме
--no-timestamps. Помогают VAD, режим с метками времени и проверка стыков на образце. - turbo плохо переводит. Если нужен перевод на английский прямо из речи (
task="translate"), берите large-v3, а не turbo. - Нет разделения по спикерам. Whisper не говорит, кто произнёс фразу. Для протоколов созвонов нужна надстройка с диаризацией — разметкой «кто говорит», например WhisperX: по заявке авторов — 70× реального времени для large-v2 в пакетном режиме и меньше 8 ГБ видеопамяти.
- Разные версии программ дают немного разный текст. Обновление MLX или whisper.cpp может поменять расшифровку отдельных фраз. Для воспроизводимого результата фиксируйте версии пакетов.
- Приватность — сильная сторона, но не автоматическая. Локальная модель не отправляет звук наружу, однако обёртки и GUI-приложения бывают с телеметрией или облачными функциями. Для конфиденциальных записей используйте программы из этого гайда и при необходимости отключайте сеть.
Локальный Whisper или облачный API: сколько стоит час записи
Локальная расшифровка бесплатна, если компьютер у вас уже есть: платите только за электричество. Облако берёт деньги за минуту, зато не требует железа. Цены OpenAI API на 25 октября 2026 года: gpt-4o-transcribe — $0,006 за минуту, gpt-4o-mini-transcribe — $0,003, gpt-transcribe — $0,0045. Классической модели whisper-1 на странице цен нет. У Mistral Mini Transcribe 3 — $0,0035 за минуту.Объём в месяц gpt-4o-transcribe gpt-4o-mini-transcribe Mistral Mini Transcribe 3 Локально 10 часов $3,60 $1,80 $2,10 только электричество 100 часов $36 $18 $21 только электричество 500 часов $180 $90 $105 только электричество
Расчёт: часы × 60 × цена за минуту. Вывод: при десятке часов в месяц облако стоит копейки, и покупать железо ради Whisper смысла нет. Локальный запуск выигрывает в трёх случаях: записи нельзя отдавать третьим лицам, объём исчисляется сотнями часов или видеокарта/Mac уже стоят на столе.
Какую модель Whisper взять под подкаст, совещание и субтитры
Сведём всё в одну таблицу решений. Цифры скорости — из раздела про память и скорость.Задача Железо Модель Программа Почему Архив подкастов, интервью NVIDIA от 8 ГБ large-v3 faster-whisper, пакетный режим максимум точности, час за 1–2 минуты Архив на Mac любой Apple Silicon large-v3-turbo mlx-whisper в 2,3 раза быстрее large-v3, +1 п.п. ошибок Протокол созвона с участниками NVIDIA от 8 ГБ large-v3 WhisperX диаризация «кто говорит» Субтитры к видео любое large-v3-turbo whisper.cpp -osrt или mlx-whisper -f srtготовый файл субтитров с таймкодами Украинский архив любое large-v3 и Parakeet v3 (или её дообученная версия parakeet-ultra) — сравнить faster-whisper или whisper.cpp разница на FLEURS всего 0,56 п.п. Слабый ноутбук без видеокарты встроенная графика (Vulkan) large-v3-turbo whisper.cpp или Handy около 19 минут на час записи на Ryzen 4750U (замер Handy в его движке transcribe.cpp) Голосовой ввод в редакторе любое turbo приложение-диктовка нужен отклик, а не точность архива
Для последней строки мы разбирали отдельный сценарий — голосовой ввод в Claude Code, там другая логика: важна задержка, а не точность часового архива.
Если вы ещё только выбираете компьютер, учтите, что Whisper — лёгкая задача по памяти: ему хватает базового Mac или видеокарты на 8 ГБ. Требования к памяти задают языковые модели, а не распознавание речи, поэтому подбирать Mac лучше по ним — в путеводителе какой Mac выбрать для локального ИИ. Для одного только Whisper разница между базовым и старшими чипами — минуты, а не «работает или нет»: turbo в WhisperKit расшифровывает час записи на M4 за 4,2 минуты, на M4 Pro — за 3,6.
Что устареет первым. Цены API, версии программ и рейтинги Handy меняются быстрее всего — сверяйте их на страницах источников. Сами модели large-v3 и turbo не менялись с 2024 года.
Частые вопросы о локальной расшифровке речи
Сколько видеопамяти нужно для Whisper large-v3 и turbo?
Для large-v3 в оптимизированных программах — от 3 до 6 ГБ: замер faster-whisper даёт 4,5 ГБ в fp16, 2,9 ГБ в int8 и 6,1 ГБ в пакетном режиме. Ориентир OpenAI «~10 ГБ» для large и «~6 ГБ» для turbo относится к исходной реализации на PyTorch. Видеокарта на 8 ГБ подходит для любого режима, на 6 ГБ — для int8 или turbo.
Whisper large-v3 понимает украинский и насколько точно?
Да. На наборе FLEURS независимый бенчмарк Handy даёт large-v3 6,28% WER, turbo — 7,31%, прошлой large-v2 — 8,17%. Вендор ElevenLabs называет 9,5%, но методику не раскрывает и продаёт конкурента. Parakeet v3 от NVIDIA на украинском почти не уступает — 6,84%, поэтому для украинского архива стоит сравнить обе модели на своих записях.
Чем отличается large-v3 от large-v3-turbo и что быстрее на Mac?
turbo — та же large-v3 с декодером из 4 слоёв вместо 32: 809 млн параметров вместо 1550 млн. На Mac она быстрее примерно в 2,3 раза — на M4 Max 55× реального времени против 24×. Плата — около одного процентного пункта WER на русском и украинском и слабый перевод на английский.
Можно ли запустить Whisper large-v3 на Mac без видеокарты?
Да, отдельная видеокарта Mac не нужна: графика встроена в чип M1–M5 и использует единую память. Запускайте через mlx-whisper или whisper.cpp с Core ML — оба работают на графике и нейродвижке Apple. Памяти хватит на любом Mac с Apple Silicon: полная модель в whisper.cpp занимает около 3,9 ГБ. Не берите faster-whisper — на Mac он считает только процессором.
Есть ли Whisper large-v4 и стоит ли переходить на Parakeet?
Модели large-v4 нет: самые новые открытые модели распознавания речи OpenAI — large-v3 (2023) и large-v3-turbo (2024). Parakeet TDT 0.6B v3 точнее Whisper на английском и в разы быстрее, но знает 25 европейских языков. Для русского large-v3 точнее (4,96% против 6,54%), для украинского модели почти вровень — переход имеет смысл после проверки на своём аудио.