



Коротко: 3090, 5070 Ti, 5080 или Radeon — что брать под ИИ
Видеокарта для ИИ выбирается по объёму видеопамяти (VRAM), а не по году выпуска: лучшая видеокарта для ИИ — та, в которую целиком помещается ваша модель. Если она не влезает, скорость падает в разы. Отсюда главный компромисс этой четвёрки: у б/у RTX 3090 — 24 ГБ, у RTX 5070 Ti, RTX 5080 и Radeon RX 9070 XT — по 16 ГБ. Решение по задачам и бюджету:
- Коротко: 3090, 5070 Ti, 5080 или Radeon — что брать под ИИ
- Почему в локальном ИИ решает объём VRAM, а не поколение карты
- Сравнение RTX 3090, 5070 Ti, 5080 и RX 9070 XT: таблица для ИИ
- Скорость в токенах в секунду: где 3090 и 5070 Ti равны
- Какие модели и кванты влезают в 16 и в 24 ГБ
- RTX 5070 Ti или RTX 5080: что даёт доплата в ИИ
- RX 9070 XT для ИИ: ROCm, Vulkan и где Radeon теряет время
- Цены в Украине: новые карты и б/у RTX 3090 на OLX
- Риски б/у RTX 3090: память, прокладки и объявления-ловушки
- Апгрейд с RTX 3080 или 3090 на 5070 Ti: когда он оправдан
- Диффузия: Stable Diffusion и FLUX на 16 и на 24 ГБ
- Бюджетнее и мощнее: RTX 5060 Ti 16 ГБ и RTX 5090 32 ГБ для ИИ
- Частые вопросы о выборе видеокарты для ИИ
- Модели до 14–20 млрд параметров и нужна гарантия — RTX 5070 Ti. В независимом замере Hardware Corner она выдаёт 87,54 токена в секунду на Qwen3 8B против 87,45 у RTX 3090, то есть скорость одинаковая. Новая карта на OLX стоит 59 000–60 000 грн (25 октября 2026 года).
- Модели 27–32B и длинный контекст — б/у RTX 3090 24 ГБ. Qwen3 32B идёт на ней со скоростью 30–33 ток/с при контексте 16 тыс. токенов, а на 16 ГБ-картах эта модель не запускается вовсе. Рабочие карты на OLX чаще всего стоят 28 000–44 000 грн, гарантии нет.
- RTX 5080 для ИИ не оправдана. Те же 16 ГБ, пропускная способность памяти выше всего на 7,1%, скорость генерации — на 5,6–10,5%, а новая карта на OLX дороже 5070 Ti на 19–29 тыс. грн.
- RX 9070 XT — выбор под Linux и для тех, кто готов настраивать. Это самая дешёвая новая 16 ГБ-карта из четырёх (от 38 500 грн), но на Windows Ollama работает с ней через Vulkan, а не через ROCm, и общий стек ИИ-программ у NVIDIA удобнее.
- Апгрейд: с RTX 3080 10 ГБ на 5070 Ti — да; с 3080 Ti — ради 4 ГБ памяти и гарантии, а не скорости; с 3090 — нет, если вы уже запускаете модели больше 16 ГБ.
Цены собраны по объявлениям OLX 25 октября 2026 года и меняются быстрее всего остального в статье. Скорость взята из открытых независимых замеров с указанием модели, кванта и контекста; своих тестов этих карт мы не проводили.
Почему в локальном ИИ решает объём VRAM, а не поколение карты
Локальная языковая модель (LLM) — это файл весов на несколько гигабайт, который программа вроде Ollama, LM Studio или llama.cpp загружает в видеопамять. Пока веса и KV-кеш (рабочая память диалога, где модель держит уже прочитанный текст) помещаются в VRAM, карта работает на полной скорости. Как только не помещаются, часть модели уходит в оперативную память компьютера, и генерация падает до однозначных чисел токенов в секунду — RunAIHome фиксирует именно это при частичной выгрузке 27B-модели на RTX 5070 Ti.
Второй по важности параметр — пропускная способность памяти, ГБ/с. Чтобы выдать каждый следующий токен, карта заново читает веса модели, поэтому скорость ответа упирается в то, как быстро память отдаёт данные, а не в число ядер:
- RTX 3090 — 936 ГБ/с (шина 384 бит, GDDR6X);
- RTX 5070 Ti — 896 ГБ/с (256 бит, GDDR7);
- RTX 5080 — 960 ГБ/с (256 бит, GDDR7);
- RX 9070 XT — до 640 ГБ/с (256 бит, GDDR6).
Расчёт. 936 / 896 = 1,045: карта 2020 года по пропускной способности даже на 4,5% впереди новой 5070 Ti. Поэтому на моделях, которые помещаются в обе карты, скорость у них почти одинаковая. А то, чего нет в 16 ГБ, новая архитектура не компенсирует.
Сколько памяти нужно модели, проще всего прикинуть по реальному файлу. Qwen3.8-27B в 4-битном кванте Q4_K_M весит 16,8 ГБ, то есть около 0,62 ГБ на миллиард параметров, и это ещё без KV-кеша. Квант — способ сжать веса, храня каждый параметр меньшим числом бит ценой небольшой потери точности; Q4 — около 4 бит на параметр. Подробная формула с поправкой на контекст — в разборе сколько видеопамяти нужно модели.
Поколение Blackwell (RTX 50) выигрывает в другом. Оно поддерживает 4-битный формат FP4 на уровне тензорных ядер, которого у 30-й серии нет, и, по оценке RunAIHome, быстрее обрабатывает длинный запрос до появления первого токена. Это реальные плюсы, но они не добавляют ни гигабайта памяти.
Сравнение RTX 3090, 5070 Ti, 5080 и RX 9070 XT: таблица для ИИ
Характеристики — с официальных страниц NVIDIA и AMD, скорость — из рейтинга Hardware Corner (контекст 16 тыс. токенов), цены — объявления OLX на 25.10.2026.Параметр RTX 3090 RTX 5070 Ti RTX 5080 RX 9070 XT Видеопамять 24 ГБ GDDR6X 16 ГБ GDDR7 16 ГБ GDDR7 16 ГБ GDDR6 Шина памяти 384 бит 256 бит 256 бит 256 бит Пропускная способность 936 ГБ/с 896 ГБ/с 960 ГБ/с до 640 ГБ/с Мощность карты 350 Вт 300 Вт 360 Вт 304 Вт Рекомендуемый блок питания 750 Вт 750 Вт 850 Вт 750 Вт Цена на старте (MSRP) $1 499 (2020) $749 $999 н/д OLX, 25.10.2026 б/у 28 000–44 000 грн новая 59 000–60 000 грн новая 78 000–89 000 грн новая 38 500–49 000 грн Qwen3 8B, ток/с 87,45 87,54 94,14 н/д в той же методике Qwen3 32B, ток/с 30,28 не запускается не запускается не помещается Гарантия нет (б/у) есть есть есть Программная база CUDA CUDA, FP4 CUDA, FP4 ROCm на Linux, Vulkan
Таблица читается сверху вниз. Три карты NVIDIA почти равны по скорости памяти, поэтому и по токенам в секунду на малых моделях они близки. Разница начинается в строке Qwen3 32B: там работает только карта с 24 ГБ.
Какая видеокарта для ИИ выгоднее по деньгам, видно из простого расчёта: делим цену на объём памяти и на скорость. Цены — ориентир по объявлениям OLX на 25 октября 2026 года: для новых карт взята нижняя цена объявления, для б/у 3090 — типичная рабочая карта за 40 000 грн.Карта Цена-ориентир Гривен за 1 ГБ VRAM Гривен за 1 ток/с на Qwen3 8B RTX 3090 (б/у) 40 000 грн 1 667 457 RTX 5060 Ti 16 ГБ (новая) 28 500 грн 1 781 554 RX 9070 XT (новая) 38 500 грн 2 406 н/д RTX 5070 Ti (новая) 59 000 грн 3 688 674 RTX 5080 (новая) 78 000 грн 4 875 829
Если нужна дешёвая видеокарта для ИИ, по гривне за гигабайт выигрывают б/у 3090 и новая 5060 Ti 16 ГБ. Но у первой нет гарантии, а вторая на 38–43% медленнее 5070 Ti. RTX 5080 проигрывает по обоим показателям.
Скорость в токенах в секунду: где 3090 и 5070 Ti равны
Hardware Corner — независимый ресурс, который гоняет видеокарты одним и тем же тестом llama-bench из пакета llama.cpp: Ubuntu 24.04, CUDA 12.8, квант Q4_K_XL для всех моделей, отдельные таблицы для контекста 16K, 32K, 65K и 131K токенов. Страница последний раз обновлялась 9 декабря 2025 года. Ниже — скорость генерации при контексте 16 тыс. токенов, по рейтингу Hardware Corner.Модель RTX 3090 RTX 5070 Ti RTX 5080 RTX 5060 Ti 16 ГБ RTX 5090 Qwen3 8B 87,45 87,54 94,14 51,41 145,34 Qwen3 14B 52,14 57,98 64,04 32,91 102,68 gpt-oss 20B 128,51 133,05 140,48 82,42 249,19 Qwen3 30B (MoE) 113,84 — — — 141,63 Qwen3 32B 30,28 — — — 50,92
Прочерк означает, что модель не поместилась в память карты и замера нет.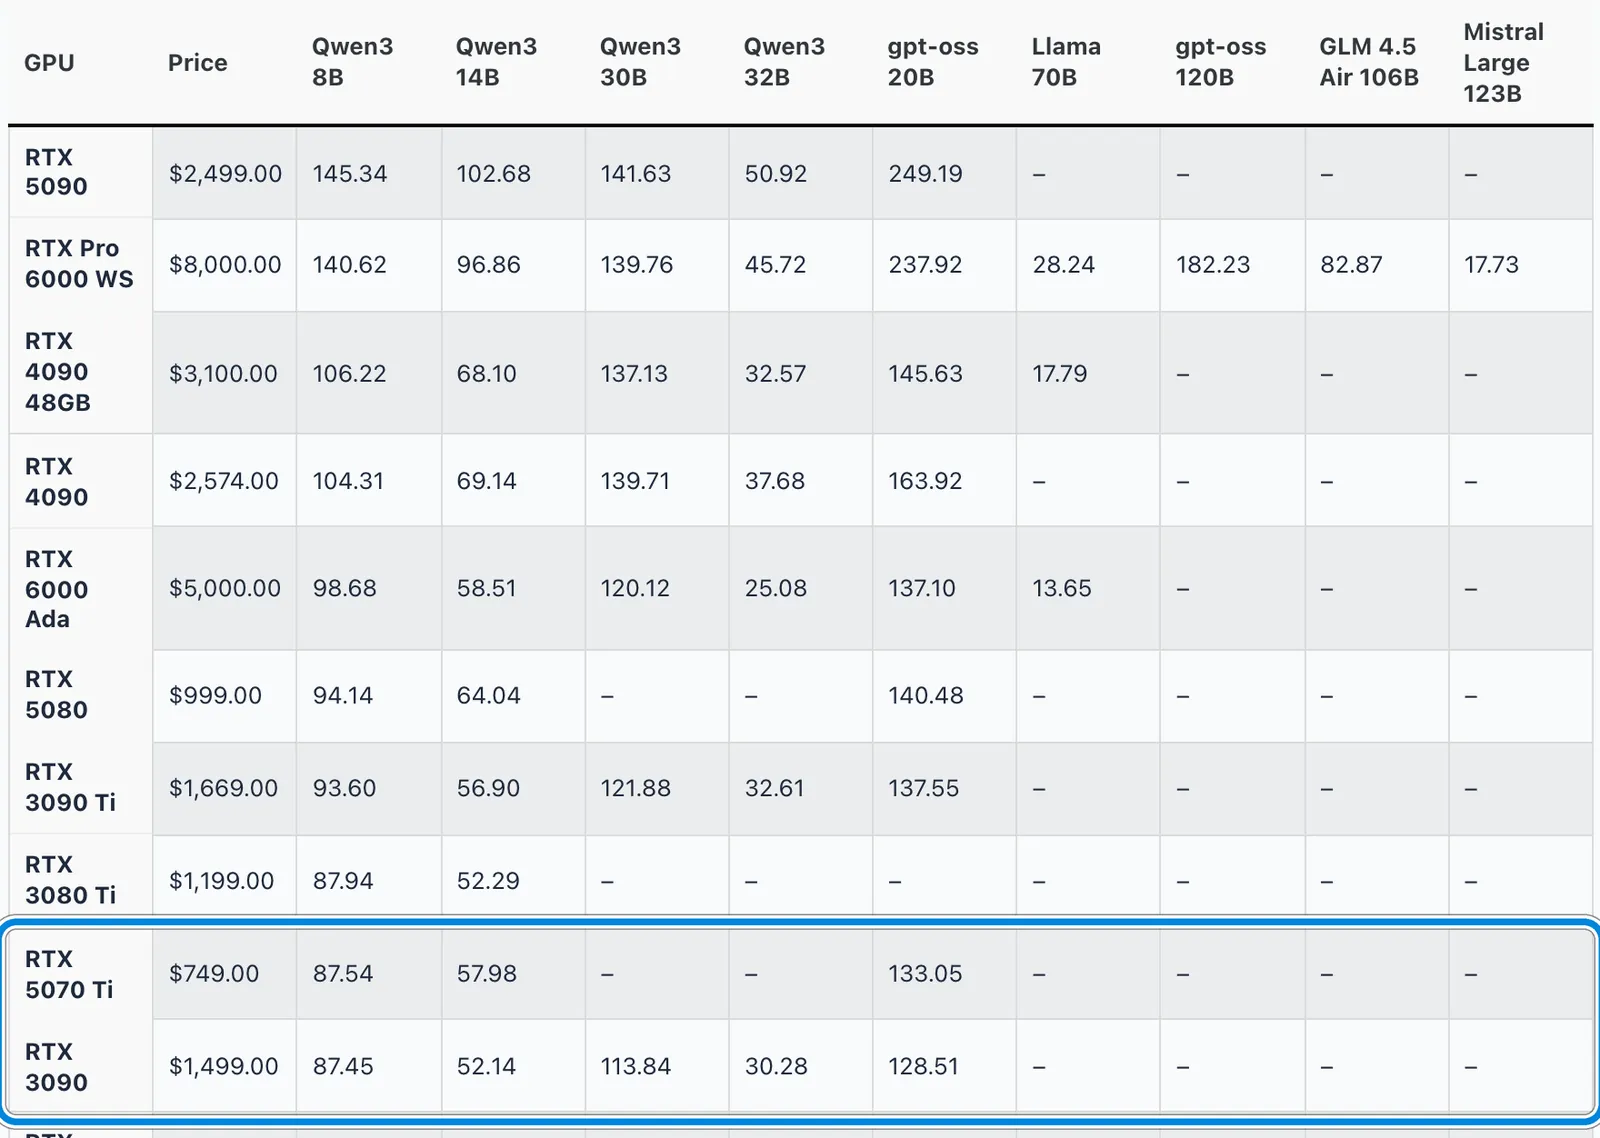
На кадре рейтинга Hardware Corner (снят 25 октября 2026 года) рамкой выделены строки RTX 5070 Ti и RTX 3090: одинаковая скорость на Qwen3 8B и прочерки у 5070 Ti в колонках 30B и 32B.
Что видно из таблицы:
- На 8B карты равны (0,1%), на gpt-oss 20B 5070 Ti впереди на 3,5%, на Qwen3 14B — на 11%.
- 5080 быстрее 5070 Ti на 5,6–10,5% — примерно на столько же, на сколько у неё больше пропускная способность памяти.
- Qwen3 30B (MoE) — модель «смесь экспертов»: на каждый токен работает только часть параметров, поэтому она быстрая (113,84 ток/с на 3090), но все веса всё равно должны лежать в памяти.
Второй независимый стенд, ComputingForGeeks (замер 20 октября 2026 года, CUDA 13.0, квант Q4_K_M), даёт на RTX 3090 для Qwen3 32B 38,9 ток/с с пустым контекстом, 35,6 — при 8K и 32,8 — при 16K. На одинаковом контексте 16K это 32,8 против 30,28 у Hardware Corner: расхождение около 8% объясняется другим квантом и версией llama.cpp. Для сравнения, человек читает заметно медленнее 30 токенов в секунду, так что 32B на 3090 работает комфортно.
Откуда цифра «5070 Ti на 10–30% быстрее 3090». Её приводит RunAIHome (27 сентября 2026 года), но она собрана из чужих замеров разных моделей, квантов и длины контекста. В одной методике Hardware Corner (контекст 16K) разница на 8B — 0,1%, на 14B — 11%. Поэтому числа разных источников мы сравниваем только внутри одного теста.
Какие модели и кванты влезают в 16 и в 24 ГБ
Граница для 16 ГБ-карт проходит примерно на 13–14 ГБ весов в 4-битном кванте: остаток нужен под контекст. Для 24 ГБ — на моделях около 32B.Модель и квант Вес файла 16 ГБ (5070 Ti, 5080, 9070 XT) 24 ГБ (RTX 3090) 8B, Q4 около 5 ГБ да, с большим запасом да 14B, Q4 около 9 ГБ да да gpt-oss 20B (MXFP4) 13,3 ГБ да, остаётся около 2,5 ГБ на контекст да Mistral Small 24B, Q4 в пределах 13–14 ГБ да, без выгрузки (по BestLLMfor) да Qwen3.8-27B, Q4_K_M 16,8 ГБ нет, ошибка нехватки памяти да Qwen3 30B (MoE), Q4 больше 16 ГБ нет, прочерк у Hardware Corner да, 113,84 ток/с Qwen3 32B, Q4 18,4 ГБ (файл); в работе с контекстом 16K — до 19 214 МиБ ≈ 18,8 ГБ нет да, с контекстом до ~16K Llama 3.3 70B, Q4_K_M 42,5 ГБ нет нет, нужна вторая карта
Цифры веса — из RunAIHome и ComputingForGeeks: на 3090 модель Qwen3 32B в работе заняла 19 214 МиБ из 24 576, и этого запаса хватает примерно на 16 тыс. токенов контекста. На 32K контекста с полноточным (FP16) кешем 3090 уже упирается в память — ComputingForGeeks получил ошибку нехватки памяти.
Когда и 24 ГБ мало, следующий шаг — не одна дорогая карта, а сборка на двух RTX 3090: 48 ГБ на двоих тянут 70B в 4-битном кванте.
Можно ли обойти стену 16 ГБ. Три пути, и у каждого цена:
- Взять модель, которая помещается. gpt-oss 20B и 14B-модели на 16 ГБ работают быстро — это правильный выбор, если вы покупаете 5070 Ti осознанно.
- Частичная выгрузка в оперативную память. Модель запустится, но генерация упадёт до однозначных ток/с.
- Формат NVFP4 на Blackwell. По данным RunAIHome, он ужимает другую версию, Qwen3.6-27B, примерно до 14 ГБ. Но опубликованных замеров 5070 Ti в этом формате пока нет, готовых NVFP4-моделей единицы, а контекста остаётся мало. Это частный обход, а не замена 24 ГБ.
Миф «27B в Q4 влезает в 5070 Ti». Такую строку выдаёт каталог BestLLMfor на странице сравнения 5070 Ti и 5080. Она противоречит и замеру RunAIHome (файл 16,8 ГБ не загружается), и собственной странице того же сайта про RX 9070 XT: «плотные модели на 27 млрд параметров недоступны». Каталожную строку мы считаем автоматической генерацией.
RTX 5070 Ti или RTX 5080: что даёт доплата в ИИ
Короткий ответ: около 7% скорости и игровую производительность, но не новые возможности в ИИ. Объём памяти тот же — 16 ГБ, поэтому список моделей, которые запускаются на 5080, ровно такой же, как у 5070 Ti.RTX 5070 Ti RTX 5080 Разница Видеопамять 16 ГБ 16 ГБ 0 Пропускная способность 896 ГБ/с 960 ГБ/с +7,1% Qwen3 8B / 14B / gpt-oss 20B, ток/с 87,54 / 57,98 / 133,05 94,14 / 64,04 / 140,48 +7,5% / +10,5% / +5,6% Мощность / блок питания 300 / 750 Вт 360 / 850 Вт +60 Вт MSRP $749 $999 +33% Новая на OLX, 25.10.2026 59 000–60 000 грн 78 000–89 000 грн +19–29 тыс. грн Б/у на OLX, 25.10.2026 49 999–55 500 грн 67 000–72 000 грн около +17 тыс. грн
Расчёт. Доплата 19–29 тыс. грн за прирост около 7,5% на Qwen3 8B — это 2 500–3 900 грн за каждый процент скорости. В США соотношение похожее (цены — в таблице раздела про Украину ниже). На Reddit этот спор так и звучит — «стоит ли 5080 разницы в $400».
Откуда «у 5080 на 15% больше пропускной способности». Так пишет RunAIHome, но по официальным цифрам NVIDIA 960 / 896 = 1,071, то есть +7,1%. Это либо арифметическая ошибка, либо цифра не про ГБ/с.
Когда 5080 всё-таки имеет смысл: карта нужна прежде всего для игр в высоком разрешении, а ИИ — второе применение. В генерации изображений разница тоже есть: по тесту StorageReview в Procyon SDXL, на который ссылается ComputingForGeeks, 5080 быстрее 5070 Ti в 1,27 раза. Но если вы покупаете карту ради нейросетей и 16 ГБ вам хватает, 5070 Ti даёт то же самое дешевле. Если не хватает, не поможет ни одна 16 ГБ-карта.
RX 9070 XT для ИИ: ROCm, Vulkan и где Radeon теряет время
RX 9070 XT — карта AMD с 16 ГБ GDDR6 и пропускной способностью до 640 ГБ/с. Для нейросетей у неё два программных пути, и от выбора пути зависит скорость:
- ROCm — аналог CUDA от AMD, основной путь на Linux. RX 9070 XT есть в матрице поддержки ROCm 7.2.1 для Ubuntu 22.04, 24.04 и 25.10, Ollama поддерживает её на Linux с драйвером ROCm 7, LM Studio — с версии 0.3.19 (июль 2025 года).
- Vulkan — универсальный графический интерфейс, через который llama.cpp тоже умеет считать. На Windows список ROCm-карт в документации Ollama заканчивается на RX 7000, поэтому RX 9070 XT там работает через Vulkan, который включён по умолчанию.
- PyTorch на Windows — для ComfyUI и других программ на PyTorch. AMD выпустила PyTorch on Windows 7.2 21 января 2026 года, и RX 9070 XT в списке совместимых карт.
Неочевидный момент: в тесте одного пользователя Vulkan оказался быстрее ROCm на генерации. Это замер в обсуждении llama.cpp #15021 от 15 июля 2026 года (Fedora 44, ROCm 7.1.1, сборка llama.cpp b10034):Модель Vulkan, ток/с ROCm, ток/с Vulkan быстрее на Llama 3.2 3B, Q4_K_M 220 179 23% Llama 2 7B, Q4_0 132 122 8%
На 7B разрыв меньше, чем на 3B, а на обработке запроса ROCm стабильнее: по словам автора теста, разброс между прогонами меньше 1%. Это один стенд, а не правило, поэтому практический вывод — проверить обе сборки llama.cpp на своей модели, прежде чем решать.
Чего в таблице нет: прямого сравнения 9070 XT с 5070 Ti в одной методике. По теории скорость генерации упирается в память, а у 9070 XT пропускная способность на 29% ниже (640 против 896 ГБ/с), но это оценка, а не замер. Стена 16 ГБ та же: по BestLLMfor, карта загружает модели с весами до 13–14 ГБ в Q4 (gpt-oss 20B, Mistral Small 24B), а плотные 27B ей недоступны.
Когда брать RX 9070 XT: вы работаете на Linux, готовы настраивать ROCm или Vulkan и хотите новую 16 ГБ-карту дешевле 5070 Ti — на OLX она стоит 38 500–49 000 грн против 59 000–60 000 (25.10.2026). Когда не брать: Windows, ComfyUI с кучей расширений и нет желания разбираться с драйверами — тогда 5070 Ti с CUDA сэкономит время. Где Radeon уже догнал GeForce, а где отстаёт, — в отдельном разборе ROCm против CUDA.
Цены в Украине: новые карты и б/у RTX 3090 на OLX
Сколько стоит видеокарта для ИИ в Украине, показываем по объявлениям OLX на 25 октября 2026 года. Это цены предложения, а не сделок, и источник один: страницы Hotline и Rozetka при сборе данных не открылись, их цифры мы не используем. Для ориентира добавлены цены в США.Карта Новая на OLX Б/у на OLX США RTX 3090 24 ГБ — 25 000–50 000 грн, чаще 28 000–43 999 б/у $1 343 (27.09) → $1 535 (20.10) RTX 5070 Ti 16 ГБ 59 000–60 000 грн 49 999–55 500 грн от $1 199,99 (23.09), MSRP $749 RTX 5080 16 ГБ 78 000–89 000 грн 67 000–72 000 грн $1 517–1 799 (сентябрь), MSRP $999 RX 9070 XT 16 ГБ 38 500–49 000 грн 38 000–46 000 грн н/д RTX 5060 Ti 16 ГБ 28 500–39 950 грн 34 500 грн н/д RTX 5090 32 ГБ — 273 000 грн (одно объявление магазина, 22.10) б/у в среднем $6 782 (20.10), MSRP $1 999
Что из этого следует:
- Новая 5070 Ti дороже типичной б/у 3090 примерно на 19 000 грн. Эта разница покупает гарантию, на 50 Вт меньшее потребление и +11% на 14B-моделях, но забирает 8 ГБ памяти.
- Б/у 9070 XT стоит почти как новая (38 000–46 000 против 38 500–49 000 грн), поэтому брать её с рук имеет мало смысла.
- Б/у 3090 дорожает. По трекеру ResalePrices, на который ссылаются RunAIHome и ComputingForGeeks, средняя цена в объявлениях в США между 27 сентября и 20 октября 2026 года выросла на 14% — за чуть больше трёх недель, а за 90 дней — на 23%.
Первым в статье устареют именно цены и наличие: рынок верхнего сегмента сейчас нестабилен. С 10 октября 2026 года ходят слухи о прекращении выпуска RTX 5090, NVIDIA убрала её из своего магазина, но сам слух опровергла. Перед покупкой проверьте свежие объявления и рейтинг Hardware Corner.
Риски б/у RTX 3090: память, прокладки и объявления-ловушки
Б/у 3090 — лучший вариант по цене за гигабайт, но это карта 2020–2022 годов без гарантии. ComputingForGeeks прямо пишет: таким картам 4–6 лет, часто это бывшие майнинговые, поэтому покупать стоит с возможностью возврата и сразу закладывать бюджет на новые термопрокладки.
Главная слабость 3090 — горячая память GDDR6X. Micron, производитель чипов, рассчитывает их на работу до 95 °C. По данным, которые приводит Tom’s Hardware в материале 2021 года, замена термопрокладок на 3090 снизила температуру памяти на величину до 25 °C. Материал старый, но предел в 95 °C актуален. Под нагрузкой LLM карта работает на пределе мощности: ComputingForGeeks на Qwen3 32B намерил в среднем 341 Вт при лимите 350 Вт и пиковую температуру 69–74 °C.
Ловушки в объявлениях OLX на 25 октября 2026 года:
- «ASUS ROG Strix RTX 3090 20GB» за 28 000 грн — у RTX 3090 по паспорту NVIDIA всегда 24 ГБ. Несоответствие объёма — красный флаг: ошибка продавца, другая карта или переделка.
- «Нерабочая» за 9 000 грн, «под ремонт» за 12 000 и 16 000 грн — это доноры. Дешевле 25 000 грн рабочей 3090 в выдаче не было.
Как проверить б/у RTX 3090 перед покупкой:
- Сверьте объём памяти. В
nvidia-smiили GPU-Z карта должна показывать 24 ГБ — 24 576 МиБ. - Нагрузите карту не меньше часа. Запустите модель через llama-bench или долгий диалог в Ollama и следите за температурой памяти в утилите мониторинга.
- Оцените температуру памяти. Если она подходит к 95 °C, закладывайте замену термопрокладок в цену.
- Проверьте блок питания. NVIDIA рекомендует для 3090 блок от 750 Вт; карта долго держит 340–350 Вт.
- Оставьте путь назад. Выбирайте сделку с проверкой при получении или с возвратом, а не перевод незнакомцу.
Апгрейд с RTX 3080 или 3090 на 5070 Ti: когда он оправдан
Обсуждения «менять ли 3090 на 5070 Ti» и «стоит ли апгрейд с 3080» на Reddit собирают до 200 комментариев. По замерам Hardware Corner (Qwen3, Q4_K_XL, контекст 16K) ответ зависит от того, какая у вас карта сейчас:Текущая карта Qwen3 8B, ток/с Qwen3 14B, ток/с Что даёт переход на 5070 Ti Вердикт RTX 3080 10 ГБ 74,24 не помещается +18% скорости, +6 ГБ, 14B начинает работать оправдан RTX 3080 Ti 12 ГБ 87,94 52,29 на 8B столько же, на 14B +11%, +4 ГБ только ради памяти и гарантии RTX 3090 24 ГБ 87,45 52,14 на 8B столько же, на 14B +11%, минус 8 ГБ не оправдан, если вы запускаете модели больше 16 ГБ
Расчёт для 3090. Продать карту за ~40 000 грн и купить новую 5070 Ti за 59 000 грн — доплата около 19 000 грн (OLX, 25.10.2026). За неё вы получите гарантию, +11% на 14B-моделях и меньше на 50 Вт по паспорту. При работе 4 часа в день это 50 × 4 × 365 = 73 кВт·ч в год, то есть экономия на электричестве небольшая. Взамен теряются 27B, 32B и MoE-модели на 30B. В США соотношение обратное: средняя цена б/у 3090 в объявлениях ($1 535 на 20.10.2026) выше минимальной цены новой 5070 Ti ($1 199,99 на 23.09.2026), и продажа 3090 покрывает новую карту с запасом. Оговорка: даты разные, а у 3090 это цена предложения, а не сделки.
Правило решения короткое:
- 3080 10 ГБ → 5070 Ti: да, это ощутимый рост и по скорости, и по памяти.
- 3080 Ti → 5070 Ti: скорость та же; апгрейд имеет смысл, только если вам нужны именно 16 ГБ и гарантия.
- 3090 → 5070 Ti: нет, если вы уже используете память больше 16 ГБ. Да, если работаете только с моделями до 14B, а старая карта перегревается или вы хотите гарантию.
Диффузия: Stable Diffusion и FLUX на 16 и на 24 ГБ
Для генерации изображений картина другая: там важнее вычислительная мощность, а нехватку памяти ComfyUI умеет частично обходить. Замер ComputingForGeeks от 20 октября 2026 года — время одного изображения 1024×1024, меньше — быстрее:Карта SDXL, 30 шагов FLUX.1-dev fp8, 20 шагов RTX 5090 32 ГБ 4,84 с 8,84 с RTX 3090 24 ГБ 8,28 с 23,23 с RTX 5060 Ti 16 ГБ 11,34 с 37,02 с
RTX 5070 Ti и 5080 ComputingForGeeks сам не мерил. Важные выводы из того же теста:
- FLUX в fp8 дорабатывает до конца и на 12–16 ГБ. Свежий ComfyUI сам включает DynamicVRAM и подгружает не поместившиеся веса по ходу работы. На 24 и 32 ГБ модель лежит в памяти целиком.
- На FLUX 3090 отстаёт сильнее, чем на SDXL. ComfyUI заявляет поддержку fp8 только для 40-й и 50-й серий — по оценке ComputingForGeeks, это вероятная причина.
- Нужна и оперативная память. Файл FLUX fp8 весит 17,2 ГБ, и ComfyUI сначала загружает его в ОЗУ. ComputingForGeeks советует не меньше 32 ГБ системной памяти, комфортно — 64 ГБ.
Вывод для выбора: если вы генерируете только картинки, 16 ГБ-карта нового поколения справится. Если нужны видеомодели или чекпоинты в bf16 больше 16 ГБ, ComputingForGeeks советует 3090 — она держит модель в памяти целиком.
Бюджетнее и мощнее: RTX 5060 Ti 16 ГБ и RTX 5090 32 ГБ для ИИ
Снизу — RTX 5060 Ti 16 ГБ. Те же 16 ГБ, что у 5070 Ti, но скорость ниже на 38–43%: 51,41 ток/с на Qwen3 8B, 32,91 на 14B и 82,42 на gpt-oss 20B (Hardware Corner, 16K). Новая на OLX — 28 500–39 950 грн (25.10.2026). Это вариант, если модели до 20B нужны, а 59 000 грн на 5070 Ti — нет. Подробные замеры и сценарии — в обзоре RTX 5060 Ti 16 ГБ.
Сверху — RTX 5090 32 ГБ. Пропускная способность 1 792 ГБ/с, мощность 575 Вт (под LLM-нагрузкой ComputingForGeeks видел около 490 Вт). На Qwen3 32B — 50,92 ток/с у Hardware Corner и 74,5 ток/с с пустым контекстом у ComputingForGeeks. Главное преимущество — длинный контекст: на 32K токенов 5090 выдаёт 53,3 ток/с там, где 3090 упирается в память. Цена — главный минус: MSRP $1 999, но на Amazon у сторонних продавцов новые карты стоили $7 979–10 999, а б/у в среднем $6 782 (20.10.2026); в Украине на OLX было одно б/у объявление за 273 000 грн (22.10.2026). Как собрать ПК вокруг неё — в разборе сборки на RTX 5090.
Если карта нужна в первую очередь для игр, а нейросети — эпизодически, выбор устроен иначе: см. общий гайд по выбору видеокарты. Отдельно о новых картах: часть RTX 5090, 5080 и 5070 Ti вышла без 8 блоков ROP (по данным NVIDIA — меньше 0,5% карт, проблему исправили). На ИИ-вычисления это не влияет, только на графику, но при покупке новой карты стоит проверить число ROP в GPU-Z.
Частые вопросы о выборе видеокарты для ИИ
Хватит ли 16 ГБ видеопамяти для локального ИИ?
Хватит для моделей с весами до 13–14 ГБ в 4-битном кванте: 8B, 14B, gpt-oss 20B, Mistral Small 24B. Плотные модели на 27–32B в Q4 в 16 ГБ не загружаются — Qwen3.8-27B весит 16,8 ГБ ещё до контекста. Частичная выгрузка в ОЗУ запустит модель, но скорость упадёт до однозначных токенов в секунду.
Что лучше для нейросетей: RTX 3090 или RTX 5070 Ti?
На моделях до 14–20B они почти равны: 87,45 и 87,54 ток/с на Qwen3 8B по Hardware Corner. 5070 Ti новая, с гарантией и экономичнее на 50 Вт. 3090 выигрывает памятью: 24 ГБ запускают Qwen3 32B со скоростью около 30 ток/с, а на 5070 Ti эта модель не стартует. Какая видеокарта лучше для ИИ, решает размер ваших моделей.
Стоит ли переплачивать за RTX 5080 ради ИИ?
Нет, если карта покупается ради нейросетей. У 5080 те же 16 ГБ, пропускная способность выше на 7,1%, а скорость генерации — на 5,6–10,5%. В Украине новая 5080 на OLX дороже 5070 Ti на 19–29 тыс. грн (25.10.2026). Переплата имеет смысл, если главная задача — игры в высоком разрешении.
Можно ли запускать Ollama и ComfyUI на Radeon RX 9070 XT?
Да. На Linux Ollama работает с ней через ROCm 7, LM Studio — с версии 0.3.19. На Windows Ollama использует Vulkan, который в тесте одного пользователя оказался быстрее ROCm на генерации. Для ComfyUI на Windows AMD выпустила PyTorch on Windows 7.2 с поддержкой RX 9070 XT. Настройка сложнее, чем у карт NVIDIA с CUDA.
Стоит ли менять RTX 3080 на RTX 5070 Ti ради нейросетей?
С RTX 3080 10 ГБ — да: скорость на Qwen3 8B вырастет с 74,24 до 87,54 ток/с, а памяти станет на 6 ГБ больше, и 14B-модели начнут помещаться. С 3080 Ti 12 ГБ скорость почти не изменится (87,94 против 87,54), выигрыш — 4 ГБ памяти и гарантия.