

Коротко (TL;DR)
DeepSeek V4.1 Flash в версии 1017 (вышла 17 октября 2026 года) — открытая модель на 763,2 млрд параметров под лицензией MIT. Оригинальные веса весят 510 ГБ, и всё же на ПК с 64 ГБ оперативной памяти и одной видеокартой на 12 ГБ её можно запустить. Путь пока один: движок Strata и сжатые DeepSeek V4.1 Flash GGUF от лаборатории ISTA-DASLab, а платить за это приходится диском, скоростью и частью качества.
- Коротко (TL;DR)
- Словарь
- DeepSeek V4.1 Flash на 64 ГБ RAM и RTX 3060: что запустится, а что нет
- Почему 763 млрд параметров идут на малой памяти: Engram на SSD
- Квантизации DeepSeek V4.1 Flash GGUF: IQ1_M, IQ2_XXS или IQ2_XS
- Установка DeepSeek V4.1 Flash через Strata: команды по шагам
- Скорость DeepSeek V4.1 Flash на RTX 3060 и 5070: 4–11 ток/с
- Почему не llama.cpp, Ollama и DeepInfer: что работает дома сегодня
- Качество 2-битных квантов V4.1 Flash: что потеряно по замерам
- Риски запуска DeepSeek V4.1 Flash: диск, чужой софт, uncensored-веса
- Когда проще API: DeepSeek V4.1 Flash за $0,15 вместо 265 ГБ диска
- FAQ
- Что работает на 25 октября 2026 года: Strata 0.2.5 и 2-битный набор IQ2_XXS. Нужны видеокарта NVIDIA RTX 30/40/50 с 12 ГБ, от 40 ГБ RAM и NVMe-диск, на котором свободно около 265 ГБ.
- Какая скорость: автор Strata намерил 4–6 токенов в секунду на RTX 5070 с 64 ГБ RAM и 9–11 ток/с на RTX 3060 с 46 ГБ RAM (таблица замеров в README Strata). Независимых замеров пока нет.
- Что не работает: основная ветка llama.cpp, Ollama и LM Studio эту модель локально не запускают. DeepInfer — движок самой DeepSeek для датацентровых ускорителей, домой он не ставится.
- Чем платите за компромисс: по трём бенчмаркам ISTA 2-битный квант равен оригиналу, но perplexity у него на 15,5% выше. На картах до 16 ГБ Strata по умолчанию считает 5 экспертов из 6.
- Что не подтверждено: пост о «510 ГБ оригинальных весов на 64 ГБ RAM и RTX 3060 при 7,4 ток/с» никто не воспроизвёл. В цифры статьи он не входит.
- Когда проще облако: API DeepSeek стоит $0,15 за миллион входных и $0,60 за миллион выходных токенов вне пиковых часов (тариф на 25 октября 2026 года).
Словарь
- MoE (смесь экспертов) — модель из множества небольших подсетей-«экспертов», из которых на каждое слово работают лишь несколько. Хранить приходится все, считать — малую часть.
- Квантизация и bpw — сжатие весов до меньшего числа бит. 2.00 bpw означает в среднем 2 бита на вес вместо 4–8 у оригинала DeepSeek V4.1 Flash (и 16 у типичных открытых моделей).
- GGUF — формат файла сжатой модели, который понимают llama.cpp и совместимые движки.
- Engram — таблицы n-грамм внутри DeepSeek V4.1: это не вычисления, а справочник, из которого на каждое слово читается несколько строк.
- Ток/с — токенов в секунду, скорость выдачи ответа. Токен — кусок слова.
- Perplexity и KL — меры того, насколько сжатая модель расходится с оригиналом. Чем больше число, тем дальше от исходника.
DeepSeek V4.1 Flash на 64 ГБ RAM и RTX 3060: что запустится, а что нет
Запустится 2-битная версия модели через Strata. Она займёт 12 ГБ видеопамяти, всю свободную оперативку и около 257 ГБ на диске, а то, что не влезло в память, движок будет читать с NVMe по ходу ответа. Скорость — однозначные числа токенов в секунду. Замеров оригинальных 510 ГБ на таком ПК не опубликовано, есть только непроверенный пост на Reddit (о нём ниже).
Модель свежая. Базовая V4.1 Flash вышла 10 сентября 2026 года с контекстом на 1 млн токенов, а 17 октября DeepSeek выложила обновление 1017, которое сама называет «minor update».
По бенчмаркам вендора версия 1017 подняла Terminal-Bench 4.0 с 31,2 до 42,3, а DeepSWE v1.1 — с 74,2 до 77,0. Это цифры DeepSeek на её собственных тестовых стендах, не независимый тест.
Если вы пользовались прошлой V4 Flash 0731, учтите: V4.1 — другая и заметно более тяжёлая модель, опыт запуска старой версии сюда не переносится.
Что вы получите на домашнем ПК с 64 ГБ RAM и одной картой на 12 ГБ:
- Текстовый чат и агентную работу через OpenAI- и Anthropic-совместимый API на localhost: Claude Code, Codex CLI, OpenCode и свои скрипты.
- Контекст 8192 токена по умолчанию. Strata проверяла модель именно на этом размере, больший задаётся флагом
--context. Миллион токенов из карточки модели — это возможность модели, а не домашнего ПК. - Один запрос за раз: параллельные запросы в версии Strata 0.2.5 не поддерживаются.
- Без картинок: модель умеет работать с изображениями, но Strata этот режим пока игнорирует.
Почему тогда в выдаче пишут, что на 64 ГБ модель не запускается? Источники разошлись по датам и методике. ModemGuides 20 октября прямо писал, что ПК с 64 ГБ памяти или 24 ГБ видеопамяти её «не запускает вообще». Unsloth для своего 1-битного кванта называет порог в 128 ГБ RAM и больше, а Kingy AI 22 октября оценил вариант «24 ГБ GPU + 64 ГБ RAM» как «нет» — по размерам файлов, без запуска. Поддержка ISTA-DASLab и Strata, в которой эксперты постоянно подкачиваются с SSD, появилась позже, 23–25 октября. Unsloth считает, что в RAM и видеопамять должны поместиться все веса, кроме Engram (её он тоже держит на SSD), — без подкачки экспертов с диска. Отсюда и разница в пороге.
Почему 763 млрд параметров идут на малой памяти: Engram на SSD
Модель, оригинал которой весит 510 ГБ, в 2-битной сборке (249 ГБ) работает на 76 ГБ памяти (12 ГБ видеокарты плюс 64 ГБ RAM), потому что целиком почти никогда не нужна. У неё два «лишних» для оперативной памяти слоя хранения: огромная таблица Engram, которую можно держать на диске, и сотни экспертов, из которых на каждое слово работают единицы.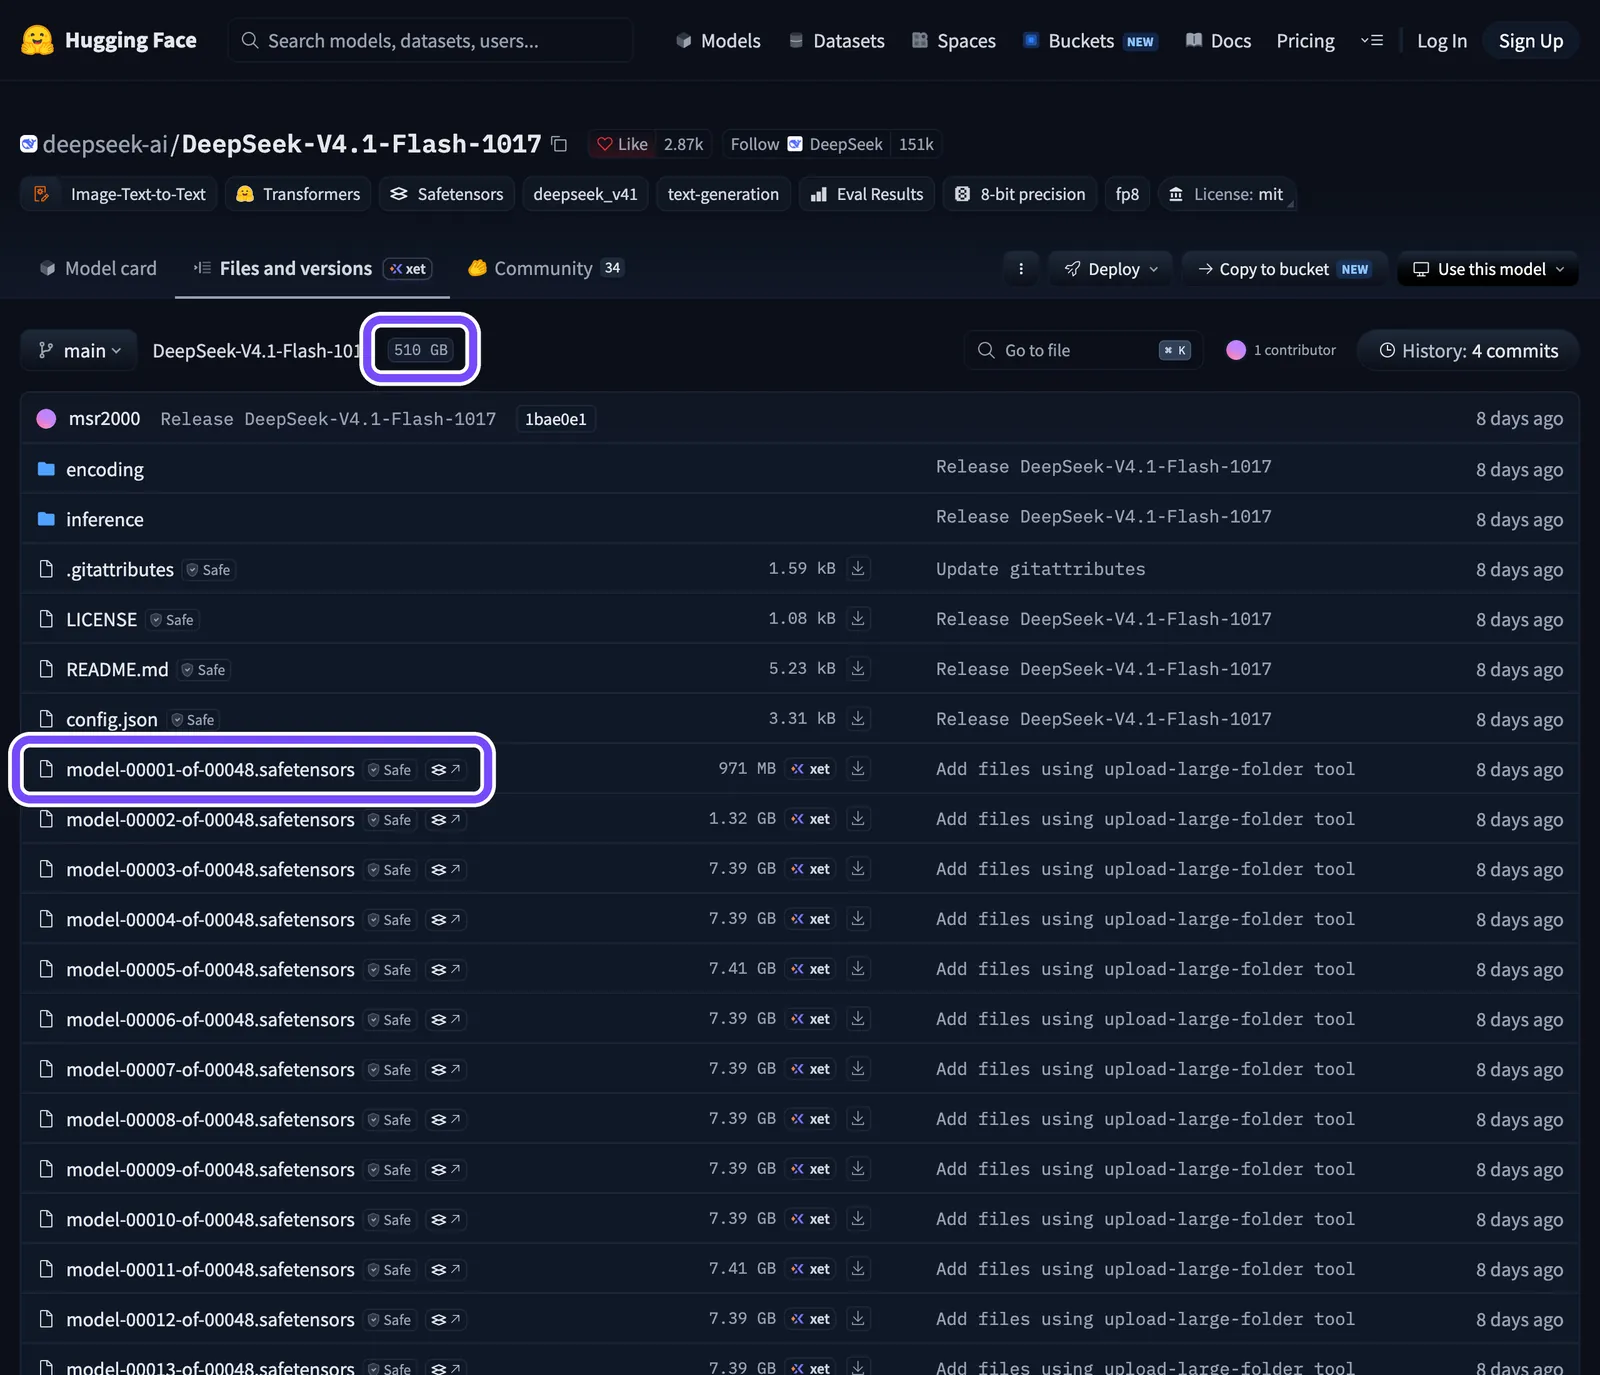
На кадре — репозиторий deepseek-ai/DeepSeek-V4.1-Flash-1017 на Hugging Face, снятый 25 октября 2026 года. Верхняя рамка выделяет общий размер (510 ГБ), нижняя — первый из 48 файлов весов safetensors. API Hugging Face даёт точное значение — 510,3 ГБ. В оригинале плотные слои хранятся в FP8, а эксперты — в FP4.
Из чего складываются параметры и где каждая часть живёт при запуске через Strata:Часть модели Параметры Размер в наборе 2.00 bpw Где лежит при работе Основа (внимание, общие слои, эксперты) 551,9 млрд 138 ГБ видеокарта и RAM, не влезшее читается с SSD Таблицы Engram 196,6 млрд 111 ГБ (общий файл IQ4_NL) SSD, по несколько строк на каждое слово Драфтер DSpark н/д 8 ГБ видеокарта, если включён Остальное, включая блок зрения около 15 млрд (разница, наш расчёт) н/д в Strata 0.2.5 не используется
Данные таблицы — из карточки ISTA-DASLab (23 октября 2026 года) и документации Strata. Всего карточка насчитывает 763,2 млрд параметров; строка «Остальное» — наш расчёт как разница от общего числа.
Первый механизм — Engram. Около четверти параметров (196,6 млрд из 763,2) — это не веса для умножения матриц, а таблица поиска. На каждое слово модель читает из неё несколько строк. Поэтому файл можно не загружать в RAM, а отобразить с диска (mmap), и он не займёт ни видеопамять, ни оперативку. Обратная сторона в том, что диск участвует в генерации каждого токена. Документация Strata предупреждает: медленный диск замедляет каждое слово, держите файлы на NVMe.
Второй механизм — разреженность экспертов. По config.json у модели 40 слоёв, в каждом 384 маршрутизируемых эксперта, и на одно слово работают 6 из них. Это около 1,6% экспертов слоя на токен. Strata держит в видеопамяти и RAM столько экспертов, сколько влезет, начиная с самых востребованных (в пакет кладётся готовый профиль «горячих» экспертов), а остальные читает прямо из файлов модели.
Наш грубый расчёт для набора 2.00 bpw: основа весит 138 ГБ, а памяти у вас 76 ГБ, и часть её занимают система и кэш контекста. Значит, не меньше 55–60 ГБ весов экспертов в любой момент остаётся на диске и подкачивается по мере нужды. Классическая формула «модель должна влезть в видеопамять» здесь не работает: ограничение смещается с VRAM на скорость SSD и объём RAM под кэш экспертов.
Квантизации DeepSeek V4.1 Flash GGUF: IQ1_M, IQ2_XXS или IQ2_XS
Для домашнего ПК берите IQ2_XXS (2.00 bpw): ISTA-DASLab называет его рекомендуемым и ближайшим к базовой модели, а Strata ставит по умолчанию. IQ1_M на 1.75 bpw нужен, только если не хватает диска или памяти. IQ2_XS на 2.25 bpw качественнее, но требует около 280 ГБ свободного места.
Все три набора сделаны методами GSQ и RCO: точность выделяется не одинаково на всю модель, а для каждого тензора отдельно, по его чувствительности. Подробнее о том, почему качество падает именно ниже 4 бит, — в нашем разборе квантизации локальных LLM.Набор bpw Основа Engram Всего у ISTA Загрузка в Strata Свободно на диске Кому подходит IQ1_M 1.75 120,7 ГБ 110,6 ГБ 231,3 ГБ 239 ГБ около 245 ГБ диск или RAM на пределе IQ2_XXS 2.00 138,2 ГБ 110,6 ГБ 248,8 ГБ 257 ГБ около 265 ГБ выбор по умолчанию IQ2_XS 2.25 155,2 ГБ 110,6 ГБ 265,8 ГБ 274 ГБ около 280 ГБ важнее качество, есть место
Размеры — из карточки GGUF ISTA-DASLab на 23 октября 2026 года и README Strata на 25 октября. Столбец «Загрузка в Strata» больше, чем «Всего у ISTA», потому что Strata докачивает драфтер DSpark на 8 ГБ. Файл Engram у всех трёх наборов общий: скачав его один раз, можно пробовать разные варианты основы.
Для сравнения: у Unsloth своя линейка. Её 1-битный UD-IQ1_M весит 250,4 ГБ и по тесту Unsloth в 88,2% позиций текста выбирает тот же наиболее вероятный токен, что и оригинал (top-1, тест long17k). Unsloth рассчитывает его на системы со 128 ГБ RAM и больше, а запускать предлагает через свой черновой PR #30817 к llama.cpp. Это другая линейка с другими типами тензоров, в том числе у Engram, поэтому файлы двух линеек не взаимозаменяемы.
В сообществе ходят и урезанные версии. Например, на r/LocalAIServers автор сжал uncensored-вариант 1017 до 256 ГБ методом REAP. Такие файлы — это уже отредактированные веса с непроверенным качеством, к официальным наборам они отношения не имеют.
Установка DeepSeek V4.1 Flash через Strata: команды по шагам
Strata — бесплатная программа с открытым кодом (лицензия MIT): она скачивает модель, ставит отдельный движок для DeepSeek и поднимает локальный сервер. Все команды ниже взяты из README Strata на 25 октября 2026 года, версия 0.2.5. Команды llama.cpp для этих файлов не приводим: ISTA-DASLab сама пометила их как «когда появится поддержка».
Шаг 1. Проверьте видеокарту, память и диск
- Видеокарта: NVIDIA RTX 30, 40 или 50 серии (Windows и Linux) либо AMD Radeon AI PRO R9700 (только Linux). ISTA-DASLab пишет, что все три набора работают на одной карте с 12 ГБ видеопамяти.
- Оперативная память: 64 ГБ — наша рекомендация как комфортный минимум. По документации Strata, ниже примерно 40 ГБ запуск не тестировался и идёт медленно; установщик об этом предупредит, но всё равно поставит.
- Диск: NVMe-SSD со свободными 265 ГБ под набор 2.00 bpw. Замер на 64 ГБ RAM сделан с диском на 3,6 ГБ/с.
- Интернет и время: 257 ГБ на канале 100 Мбит/с качаются около 5,7 часа, на гигабитном — около 34 минут. Загрузка докачивается после обрыва, а каждый файл сверяется по SHA-256.
Шаг 2. Установите Strata
Есть настольное приложение (установщики для Windows, Linux и Mac на странице релизов) и версия для терминала. Для терминала на Linux или Mac:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
На Windows в PowerShell:
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
На Windows после установки откройте новое окно терминала: иначе команда strata может не найтись. Перед запуском скрипта из интернета его стоит открыть и прочитать — об этом подробнее в разделе о рисках.
Шаг 3. Посмотрите план размещения до скачивания
strata launch --family deepseek41 --model ist-das-2.00bpw --plan
Флаг --plan ничего не скачивает и не меняет. Strata рассчитывает, сколько экспертов поместится в видеопамять и RAM именно вашего ПК, сколько уйдёт на диск и какой режим скорости вы получите. А если для вашей видеокарты нет пакета движка, об этом скажет установщик — до того, как начнёт качать 257 ГБ.
Шаг 4. Запустите загрузку и модель
strata launch
Мастер проведёт по шагам: выберите DeepSeek V4.1 Flash и набор 2.00 bpw. Strata скачает файлы и движок, упакует модель, проверит её коротким тестовым вопросом и запустит. Первая загрузка модели в память занимает несколько минут.
В мастере есть шаг Speed. «Faster» считает 5 экспертов из 6 и включается сам на ПК, где видеопамяти 16 ГиБ или меньше. «Full quality» считает все 6. Автор Strata описывает разницу в качестве как «небольшую, обычно незаметную», но это его оценка.
Шаг 5. Подключите чат, Claude Code или свой скрипт
strata connect
Команда покажет настройки для вашего инструмента: Claude Code, Codex CLI, OpenCode, Hermes Agent и других, работающих через OpenAI- и Anthropic-совместимый API. Рассуждения («thinking») у модели включены по умолчанию. Для быстрых коротких ответов их можно выключить параметром запроса reasoning_effort: "none". Температура и top_p по умолчанию — 1.0, как рекомендует DeepSeek.
Типичные проблемы:
- Движок не скачивается (нет доступа к ленте обновлений или ПК без интернета). Пакет
strata-dsv41можно скачать со страницы релизов вручную, сверить сSHA256SUMS.txtи передать Strata — так описано в документации. - Ответы идут очень медленно. Проверьте, что файлы модели лежат на NVMe, а не на SATA-SSD или HDD: Engram читается на каждом токене.
- Мало оперативки. Закройте браузер и тяжёлые программы: Strata сама решает, сколько RAM отдать под кэш экспертов, и чем больше RAM заняли другие программы, тем больше экспертов Strata будет читать с диска.
Скорость DeepSeek V4.1 Flash на RTX 3060 и 5070: 4–11 ток/с
На ПК с 64 ГБ RAM и картой на 12 ГБ ждите около 5 токенов в секунду: это единственный опубликованный замер именно на 64 ГБ (RTX 5070, NVMe 3,6 ГБ/с). Все замеры Strata сделал автор самого движка, и никто независимо их пока не повторил.Конфигурация Движок и набор Выдача Чтение промпта Кто мерил RTX 3060 12 ГБ, 46 ГБ RAM Strata 0.2.5, 2.00 bpw 9–11 ток/с (в docs — 8–10) около 155 ток/с (4K) автор Strata RTX 5070 12 ГБ, 64 ГБ RAM, NVMe 3,6 ГБ/с Strata 0.2.5, 2.00 bpw 4–6 ток/с (в docs — около 4,7) около 110 ток/с (4K) автор Strata 1× Radeon AI PRO R9700, 251 ГБ RAM Strata 0.2.5, 2.00 bpw 21–25 ток/с 320–360 ток/с (8K) автор Strata 4× Radeon AI PRO R9700 Strata 0.2.5, 2.00 bpw 74–77 ток/с (в docs — около 48 на коде) 400–450 ток/с (8K) автор Strata 2× RTX 3090, 128 ГБ RAM dsx (Rust + CUDA), свой квант T16 40+ ток/с н/д автор dsx
Данные — README и документация Strata на 25 октября 2026 года и репозиторий lxe/dsx на ту же дату. Для четырёх R9700 README и документация расходятся сильнее всего: 74–77 против примерно 48 ток/с.
Три оговорки, без которых таблицу легко прочитать неправильно:
- RTX 3060 быстрее RTX 5070, хотя у стенда с ней меньше оперативной памяти (46 против 64 ГБ). README причину не объясняет. Конфигурации различаются не только картой: диск у стенда с 3060 не указан, а цифры README и документации внутри одного репозитория расходятся (9–11 и 8–10 ток/с).
- Режим замера не назван. На картах до 16 ГиБ Strata по умолчанию включает «Faster» (5 экспертов из 6). Скорее всего, цифры для 3060 и 5070 сняты именно в нём, но источник этого не уточняет.
- Чтение промпта тоже стоит времени. При 110 ток/с промпт на 4000 токенов читается около 36 секунд, и только потом начинается ответ.
Что это значит на практике. Ответ на 1000 токенов при 4,7 ток/с пишется примерно 3,5 минуты. В режиме рассуждений модель сначала генерирует «мысли», и они тоже идут по 4–5 токенов в секунду. Для переписки в чате это терпимо, для агента, который делает десятки шагов, — очень медленно.
Пост про 510 ГБ и 7,4 ток/с: почему это пока не факт
На Reddit (r/LLMDevs) вышел пост с заголовком о полной модели 1017 на 510 ГБ с оригинальными весами на ПК с 64 ГБ RAM и RTX 3060: «до 7,4 ток/с, 98,3% совпадения с полной моделью», движок выложен. Открыть пост нам не удалось (Reddit блокировал запросы), а поиск по цифрам 25 октября не нашёл ни повторов, ни разборов. Поэтому это заявление автора поста, которое никто независимо не проверял.
Что в нём настораживает, если сопоставить с опубликованными данными:
- Скорость. Оригинал более чем вдвое тяжелее 2-битного набора (510 ГБ против 249 ГБ), значит, на каждый токен с диска придётся читать заметно больше, а заявленная скорость выше, чем у 2-битного набора на 64 ГБ RAM (4–6 ток/с). Для набора Unsloth UD-Q8_K_XL на 508 ГБ документация Strata пишет коротко: при нехватке памяти он «работает, медленно».
- Совпадение 98,3%. При тех же весах и том же режиме совпадение должно быть близким к 100%: расходиться результат может разве что из-за численных различий вычислительных ядер. Разрыв в 1,7% скорее говорит о том, что движок что-то упрощает — например, считает меньше экспертов на токен, как режим Faster у Strata. Это наша гипотеза, а не данные автора: на каком наборе текстов и в каком режиме считалось совпадение, из заголовка не понять.
Как проверять подобные заявления: точный конфиг (RAM, модель и скорость диска, контекст), режим экспертов, на каком наборе текстов считалось совпадение, есть ли команды и логи для повтора и повторил ли кто-нибудь результат. Пока на эти вопросы нет ответа, цифра остаётся рекламой, а не замером.
Почему не llama.cpp, Ollama и DeepInfer: что работает дома сегодня
Привычные домашние инструменты DeepSeek V4.1 Flash пока не умеют. На 23 октября 2026 года ISTA-DASLab прямо пишет, что llama.cpp не поддерживает DeepSeek-V4.1, а по данным ModemGuides на 20 октября ничего не влито ни в llama.cpp, ни в Ollama, ни в LM Studio. Ollama и LM Studio построены поверх llama.cpp, поэтому без поддержки в его основной ветке им нечего запускать.Движок Статус для V4.1 Flash Железо Для дома Strata 0.2.5 запускает наборы ISTA и UD-Q8_K_XL (25.10) RTX 30/40/50, R9700 да, единственный опубликованный путь llama.cpp, основная ветка не поддерживает (23.10) — ждать слияния llama.cpp, PR #30817 Unsloth черновик, свой формат Engram — для экспериментов Ollama только облачные теги (20.10) — локально нет LM Studio поддержки нет (20.10) — нет DeepInfer офлайн-инференс, только V4.1 Flash (20.10) NVIDIA SM100, Huawei Ascend 950 нет dsx (сообщество) свой движок на Rust и CUDA 2× RTX 3090, 128 ГБ RAM для энтузиастов
Статусы движков меняются быстрее всего остального в этой статье. Прежде чем ждать или ставить, проверьте карточку ISTA-DASLab и релизы llama.cpp: поддержка в основной ветке сразу откроет дорогу Ollama и LM Studio.
DeepInfer: движок для стоек, а не для домашнего ПК
DeepInfer — это высокопроизводительный движок, на котором работают продакшн-сервисы DeepSeek. Компания открыла его 20 октября 2026 года под лицензией Apache 2.0, и на Hacker News обсуждение собрало 2347 очков и 891 комментарий. Изначально он построен на vLLM и поддерживает ровно одну модель — DeepSeek-V4.1-Flash.
Домой он не подходит по трём причинам:
- Железо. Поддерживаются только датацентровые ускорители NVIDIA SM100 и Huawei Ascend 950. Игровых GeForce в списке нет.
- Масштаб. Опубликованные бенчмарки сняты на 4 GPU для обработки промпта и 64 GPU для генерации. Это стойка, а не рабочая станция.
- Комплектация. В открытой версии нет системы KV-кэша, разделения prefill и decode и балансировщика нагрузки — всего, что нужно для полноценного сервиса. Требования: Linux, CUDA 13, Python 3.12.
Пользу DeepInfer приносит другую: по коду видно, как DeepSeek устроила свой продакшн, и провайдеры смогут обслуживать модель так же, как сама DeepSeek. Его стоит читать, а не ставить. Тон обсуждения на HN такой же: в комментариях его называют инструментом для провайдеров, а не для домашнего железа.
Качество 2-битных квантов V4.1 Flash: что потеряно по замерам
Два источника дают две разные картины, и обе верны. ISTA-DASLab пишет, что IQ2_XXS сохраняет 100% качества базовой модели. Strata намерила у того же набора perplexity на 15,5% выше оригинала. Противоречия нет: они меряют разное.Набор Recovery у ISTA (3 бенчмарка) KL у Strata Perplexity у Strata Код Агентные задачи Прочее IQ1_M, 1.75 bpw 98,7% 0,217 +21% +8,9% +10,2% проза на английском +53%, мультиязычные тексты +14% IQ2_XXS, 2.00 bpw 100,0% 0,170 +15,5% +8,6% +5,3% н/д IQ2_XS, 2.25 bpw н/д (ISTA не публикует) 0,107 +7,3% +3,2% +2,2% н/д
Данные — карточка ISTA-DASLab (23 октября 2026 года) и документация Strata (25 октября, 4995 позиций текста).
Почему 100% и +15,5% совместимы. Recovery у ISTA — это среднее по трём задачам (AIME25, GPQA-Diamond и LiveCodeBench v6) при reasoning effort 50: олимпиадная математика, научные вопросы и код. Модель с 2-битными весами решает их так же, как оригинал. Perplexity и KL у Strata показывают, насколько распределение вероятностей слов отличается от оригинала на каждой позиции текста. Ответ на задачу может совпасть, даже если путь к нему и формулировки сместились.
Что из этого следует для практики:
- Для кода и агентов 2-битный набор теряет меньше всего: +8,6% и +5,3% по perplexity.
- Для текстов на русском и украинском ждите потерь больше: у IQ1_M мультиязычные тексты хуже на 14%, а английская проза — на 53%. Для IQ2_XXS отдельной цифры по языкам нет.
- Режим Faster (5 экспертов из 6) добавляет к этому ещё немного потерь. Замеров этой разницы Strata не публикует.
Обе оценки сделаны в одной экосистеме: ISTA-DASLab оптимизировала наборы вместе со Strata, и проекты ссылаются друг на друга. Это не значит, что цифрам нельзя верить, но независимой проверки пока нет.
Риски запуска DeepSeek V4.1 Flash: диск, чужой софт, uncensored-веса
- Молодой софт, по сути проект одного автора. Strata создана 24 сентября 2026 года, и почти все коммиты (3183 на 25 октября 2026 года) — от владельца репозитория, остальные участники внесли по несколько десятков правок. Движок для DeepSeek (
strata-dsv41, портирован из MIT-проекта Project Maya) ставится готовым бинарным пакетом из подписанной ленты обновлений. Strata проверяет подпись и хэши каждого файла, но доверяете вы в итоге автору. Скрипт установки перед запуском стоит прочитать. - Скорость и диск. Замеры из раздела о скорости закладывайте с запасом, особенно если диск медленнее 3,6 ГБ/с. Чтобы держать на диске все три набора сразу, нужно 533 ГБ.
- Потеря качества сильнее всего бьёт по длинным текстам на естественном языке, меньше — по коду (цифры — в разделе о качестве).
- Отредактированные веса. По данным ModemGuides на 20 октября, многие загрузки 1017 на Hugging Face — abliterated- и uncensored-версии, то есть веса изменены. Их авторы сообщают о малой потере качества, но независимо её никто не мерил. Вместе с моделями сообщество раздаёт Docker-образы и загрузчики с исполняемым кодом — запускайте только то, что прочитали.
- Ограничения DeepSeek в США. 21 октября 2026 года на HN обсуждали приказ DHS, исключающий DeepSeek из федеральных гражданских ведомств США. Для читателя из Украины это не запрет. Но если вы работаете на американского заказчика с такими требованиями, это стоит учесть, хотя локальный запуск никуда данные не отправляет.
- Быстрое устаревание. Поддержка в llama.cpp, новые версии Strata и обновления модели могут поменять картину за недели. Что устареет первым — статусы движков и замеры скорости.
Когда проще API: DeepSeek V4.1 Flash за $0,15 вместо 265 ГБ диска
Если вам не нужна приватность или работа без интернета, API почти всегда дешевле и быстрее. По тарифу DeepSeek на 25 октября 2026 года модель deepseek-flash (это и есть V4.1-Flash-1017) стоит $0,15 за 1 млн входных токенов без кэша и $0,60 за 1 млн выходных вне пиковых часов. В пик цены вдвое выше: $0,30 и $1,20. Пиковые часы — с 01:00 до 04:00 и с 06:00 до 10:00 UTC по будням.
Сравним на одном объёме работы. Локальная скорость взята из замера на RTX 5070 с 64 ГБ RAM: около 4,7 ток/с на выдаче и 110 ток/с на чтении промпта.Объём Локально (RTX 5070, 64 ГБ RAM) API вне пика 1 млн выходных токенов около 59 часов генерации $0,60 1 млн входных токенов около 2,5 часа чтения промпта $0,15 Подготовка 257 ГБ загрузки: 5,7 ч на 100 Мбит/с, 34 мин на 1 Гбит/с регистрация и ключ Контекст 8192 токена по умолчанию до 1 млн токенов Картинки и параллельные запросы нет есть
Расчёт наш: время = объём ÷ скорость. В локальную колонку не входит электричество за 59 часов работы ПК под нагрузкой — сумма зависит от тарифа и железа.
Когда локальный запуск оправдан:
- Приватность. Код или документы, которые нельзя отправлять на чужой сервер.
- Работа без интернета после того, как модель скачана.
- Эксперименты: изучить, как устроены MoE и Engram, проверить кванты, подключить свой агент без лимитов API.
Когда лучше облако: вам важна скорость, нужен длинный контекст или картинки, а железо придётся докупать. Если дома нужна именно модель DeepSeek, но 265 ГБ диска жалко, посмотрите на дистилляты DeepSeek-R1 — они идут на одной видеокарте без подкачки с диска. А можно ли дома запустить старшую DeepSeek V4 Pro, разобрано в том же обзоре, где мы описывали DSpark.
FAQ
Сколько оперативной памяти нужно для DeepSeek V4.1 Flash?
С движком Strata и 2-битным набором ISTA-DASLab — от 40 ГБ RAM: ниже этого порога запуск, по документации Strata, не тестировался и идёт медленно. 64 ГБ — разумный минимум, на нём автор движка намерил 4–6 ток/с. Unsloth для своего 1-битного кванта через llama.cpp называет 128 ГБ и больше: там другая методика, без постоянной подкачки экспертов с SSD.
Что такое DeepInfer и можно ли запустить его на домашнем ПК?
DeepInfer — движок, на котором работают продакшн-сервисы DeepSeek. Его открыли 20 октября 2026 года под лицензией Apache 2.0. На домашнем ПК он не запустится: поддерживает только датацентровые ускорители NVIDIA SM100 и Huawei Ascend 950, а бенчмарки сняты на 4 и 64 GPU. Для дома нужен Strata, DeepInfer полезен как открытый код продакшн-инференса.
Есть ли DeepSeek V4.1 Flash в Ollama и LM Studio?
На 25 октября 2026 года — нет. По данным ModemGuides на 20 октября, в Ollama есть только облачные теги этой модели, а в LM Studio поддержки нет вовсе. Оба инструмента построены на llama.cpp, а его основная ветка DeepSeek-V4.1 не поддерживает (ISTA-DASLab, 23 октября). Когда поддержку вольют в llama.cpp, Ollama и LM Studio, скорее всего, подтянутся следом.
Влезут ли 510 ГБ оригинальных весов DeepSeek V4.1 Flash в 64 ГБ RAM?
Нет, целиком 510 ГБ в 64 ГБ RAM не помещаются: запустить их можно только с постоянным чтением экспертов и таблиц Engram с SSD. Ближайший документированный случай — набор Unsloth UD-Q8_K_XL на 508 ГБ: для ПК с нехваткой памяти документация Strata пишет «работает, медленно», без цифр скорости. Пост на Reddit про 7,4 ток/с пока никто не воспроизвёл.
Можно ли запустить DeepSeek V4.1 Flash на RTX 3060 без SSD?
Практически нет. Таблица Engram на 111 ГБ читается с диска на каждом токене, а часть экспертов при 64 ГБ RAM тоже подкачивается с накопителя. На HDD каждое слово будет ждать диска. Strata прямо советует держать файлы модели на NVMe: опубликованный замер на 64 ГБ RAM сделан с диском на 3,6 ГБ/с, и даже на нём скорость — 4–6 ток/с.