
Коротко (TL;DR)
Это обзор GLM 5.3 — открытой модели китайской компании Z.ai (бывшая Zhipu AI). Главное, что нужно знать до покупки железа: под одним номером вышли две разные модели, и дома запускается только младшая.
- Коротко (TL;DR)
- GLM-5.3 и GLM-5.3-Flash: две разные модели под одним номером
- Откуда цифры в обзоре GLM-5.3: чужие замеры и наши оценки
- Размеры и лицензия GLM-5.3 и Flash: что можно скачать и продать
- Бенчмарки GLM-5.3: что подтвердили независимые замеры
- GLM-5.3 против Kimi K3 и DeepSeek V4: сравнение открытых моделей
- Чем GLM-5.3 отличается от GLM-5.2: эффект одного пост-обучения
- Сколько памяти нужно GLM-5.3 и Flash: кванты от 1 до 8 бит
- Скорость GLM-5.3-Flash на Mac и RTX: замеры и расчётные оценки
- Как запустить GLM-5.3-Flash локально: llama.cpp, MLX и ловушка Ollama
- Сильные и слабые стороны двух моделей Z.ai в одной таблице
- Риски GLM-5.3: киберспособности, слабая защита и юрисдикция
- Что выбрать под задачу: облачный API, Flash на Mac или флагман
- FAQ
- GLM-5.3 — флагман на 753 млрд параметров. Веса открыты с 28 августа 2026 года, но даже самый сжатый файл весит 217 ГБ: это Mac Studio на 256–512 ГБ или сервер, а не домашний ПК.
- GLM-5.3-Flash — отдельная модель на 320 млрд параметров под лицензией MIT. Она помещается в один Mac со 128 ГБ памяти (2–3 бита, после подъёма лимита видеоядра) или 256 ГБ (4 бита).
- Скорость Flash дома по замеру MacStories — 41 токен в секунду на Mac Studio M5 Ultra и 26 на M3 Ultra. Для остальных машин даём расчётную оценку и помечаем её.
- Независимый индекс Artificial Analysis на 25.10.2026 ставит GLM-5.3 в тройку лучших открытых моделей: 45 баллов. Выше только MiMo-V2.6-Pro от Xiaomi (46), столько же у DeepSeek V4.1 Flash 1017 (45), у Kimi K3 — 44.
- API дешевле железа для большинства: Flash стоит $0,15 за миллион входных токенов и $0,50 за миллион выходных (прайс Z.ai на 25.10.2026).
- Главный риск — сильные кибернавыки при слабой встроенной защите. Кибернавыки зафиксировал NIST, лёгкий обход защиты показала Anthropic, прямой конкурент Z.ai.
- Данные проверены на 25.10.2026. Собственного прогона модели у нас нет, поэтому балл не ставим: все цифры — документы Z.ai, независимые замеры и наши расчёты с открытой формулой.
GLM-5.3 и GLM-5.3-Flash: две разные модели под одним номером
Большинство страниц в выдаче смешивают две модели в одну. Из-за этого в одном месте пишут, что GLM-5.3 «требует серверную стойку», а в другом — что «работает на Mac». Правы оба утверждения, просто про разные модели.
Сначала словарик. Без него дальше будет сложно:
- Параметры — числа внутри нейросети, в которых записаны её знания. Чем их больше, тем модель обычно умнее и тем больше памяти ей нужно.
- MoE (Mixture of Experts, смесь экспертов) — устройство, при котором модель разбита на множество «экспертов», а на каждое слово работает лишь несколько из них. Поэтому у MoE-модели два числа: всего параметров и активных на один токен.
- Токен — кусочек слова, которым модель читает и пишет. Скорость измеряют в токенах в секунду (ток/с).
- Квантование — сжатие весов: вместо 16 бит на число хранят 2–4 бита. Файл становится в разы меньше, точность немного падает.
- Контекст — сколько текста модель держит в голове за раз: запрос, документы, история диалога.
- VRAM — память видеокарты. Единая память (unified memory) у Mac — общая для процессора и видеоядра, поэтому Mac со 128 ГБ может отдать модели большую часть: по умолчанию около 75%, больше — после настройки (см. ниже).
Теперь сами модели:



- GLM-5.3 (флагман). Вышла 14 августа 2026 года сначала только в API, веса Z.ai выложила через две недели — 28 августа. Всего 753 млрд параметров, активных 40 млрд. Карточка модели — GLM-5.3 на Hugging Face.
- GLM-5.3-Flash. Не урезанная копия флагмана, а новая модель, обученная с нуля на собственной базе (30 трлн токенов данных). Вышла 26 августа 2026 года сразу с открытыми весами. Всего 320 млрд параметров, активных 18 млрд, понимает текст и картинки.
GLM 5.3 Flash — что это для домашнего пользователя? Самостоятельная модель семейства GLM-5.3 и единственная из двух, которую реально запустить у себя. До раскрытия она несколько недель августа ходила по слепым сравнениям под кодовым именем Ox Alpha и обгоняла модели с известными именами (Gigazine, LLMCheck).
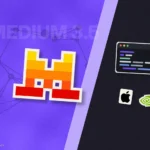
На снимке карточки GLM-5.3-Flash от 25.10.2026 рамка 1 показывает лицензию MIT, рамка 2 — строку «320B total parameters and just 18B active parameters». Счётчик справа — 6 352 272 скачивания за последний месяц: младшую модель качают втрое чаще флагмана (2 074 062 за тот же период).
Откуда цифры в обзоре GLM-5.3: чужие замеры и наши оценки
Собственного прогона GLM-5.3 на нашем железе в этом обзоре нет. Ниже три типа данных, и у каждой цифры сказано, к какому она относится:
- Заявления Z.ai — таблица бенчмарков из карточки модели. Это слова производителя, и мы так их и подписываем.
- Независимые замеры — индекс Artificial Analysis, оценка киберспособностей NIST, замеры скорости MacStories и сообщества llama.cpp. У каждого указаны условия теста.
- Наши оценки по открытой формуле — там, где замера нет (M5 Max, M4 Max, DGX Spark, RTX). Формулу и коэффициент показываем, чтобы любой мог пересчитать под свою машину.
В августе мы писали, почему Z.ai придержала веса GLM-5.3 — тогда модель была доступна только через API. Сейчас ситуация другая: репозиторий на Hugging Face открыт без заявок, и всё ниже относится к уже опубликованным весам.
Размеры и лицензия GLM-5.3 и Flash: что можно скачать и продать
Сколько параметров у GLM 5.3: у флагмана 753 млрд всего и 40 млрд активных на токен, у Flash — 320 млрд и 18 млрд. Unsloth и часть сайтов пишут «744B», Artificial Analysis и сумма тензоров чекпойнта на Hugging Face дают 753 млрд; дальше считаем по чекпойнту. Устройство флагмана — 78 слоёв и 256 экспертов, из которых на каждый токен работают 8.Параметр GLM-5.3 GLM-5.3-Flash GLM-5.2 (для сравнения) Параметров всего / активных 753B / 40B 320B / 18B 753B / 40B База та же, что у GLM-5.2 новая, обучена с нуля — Вход текст текст и изображения текст Контекст 1 048 576 токенов ≈1 млн (по Artificial Analysis) н/д Выход весов 28.08.2026 (API — с 14.08) 26.08.2026 раньше Лицензия своя лицензия GLM-5.3 MIT MIT Оригинальный чекпойнт FP8 ≈ 755 ГБ, BF16 ≈ 1,5 ТБ BF16 ≈ 642 ГБ н/д Минимальный квант 217 ГБ (1 бит) 93 ГБ (1 бит) н/д
Лицензия флагмана — главное отличие от GLM-5.2. У GLM-5.2 была MIT, у GLM-5.3 — собственная лицензия. Пользоваться, дообучать и продавать продукты на ней можно свободно. Условие одно: если компания продаёт доступ к модели как сервис (MaaS, model as a service) и вместе с аффилированными лицами зарабатывает больше $10 млрд за любые 12 месяцев подряд, перед коммерческим использованием ей нужно пройти проверку безопасности Z.ai.
Обычного пользователя, стартап или студию это не касается: под условие попадают облачные гиганты масштаба крупнейших провайдеров. У GLM-5.3-Flash такого пункта нет вовсе — MIT разрешает коммерцию, правку и распространение с указанием авторства.
Бенчмарки GLM-5.3: что подтвердили независимые замеры
Бенчмарк — стандартный набор задач, на котором сравнивают модели. Цифры GLM-5.3 надо читать из трёх источников, и они говорят разное.
Что заявляет Z.ai. Таблица из карточки модели — это замеры самого производителя:Тест (данные Z.ai) GLM-5.3 GLM-5.2 Kimi K3 Opus 4.8 GPT-5.6 Sol Terminal Bench 3.0 28,3 4,6 17,4 21,1 34,6 DeepSWE v1.1 66,9 46,2 67,5 58,0 72,7 CyberGym 84,5 77,2 80,0 78,1 83,6 HLE с инструментами 62,5 54,7 59,8 57,9 64,5
Даже по собственным данным Z.ai GLM-5.3 не лидер в программировании: в Terminal Bench 3.0 и DeepSWE впереди GPT-5.6 Sol и Fable 5 (33,7 и 69,7; этой колонки в нашей выборке нет), а в DeepSWE ещё и Kimi K3. Из 16 тестов своей таблицы Z.ai ставит GLM-5.3 первой в трёх: CyberGym (кибербезопасность), AutomationBench (48,2) и GDPval-AA v2 (1769) — офисные агентные задачи.
Что измерили независимые. Artificial Analysis (AA) прогоняет модели на своих десяти тестах и сводит их в индекс. На 25.10.2026 в версии индекса v4.3.2 у GLM-5.3 — 45 баллов, у Kimi K3 — 44, у GLM-5.3-Flash — 42 (сравнение на Artificial Analysis).
Вывод из графика: по сводному баллу GLM-5.3 третья среди открытых моделей (у DeepSeek V4.1 Flash 1017 столько же — 45), но в Terminal-Bench 4.0, тесте агента в терминале, она первая из восьми моделей графика — 42% против 34–35% у новых соперников и 13% у Kimi K3. Flash отстаёт от флагмана на три балла и при этом опережает GLM-5.2. Баллы AA сняты в режиме Max — с максимальной глубиной рассуждений; замеры скорости ниже сделаны в облегчённом режиме.Модель Индекс AA v4.3.2 (25.10.2026) Terminal-Bench 4.0 по AA MiMo-V2.6-Pro 46 35% GLM-5.3 45 42% DeepSeek V4.1 Flash 1017 45 34% Kimi K3 44 13% GLM-5.3-Flash 42 33% Qwen3.8-Flash-Next 40 25% DeepSeek V4 Flash 0731 34 12% GLM-5.2 34 1%
Почему в новостях было 60 баллов, а сейчас 45. На релизе, 19 августа 2026 года, AA давал GLM-5.3 60 баллов — вровень с Kimi K3 и на 7 выше GLM-5.2 (The Decoder, Gigazine). Тогдашняя версия индекса — v4.1.1 (метку версии называет сама Z.ai в материалах о Flash). С тех пор AA сменил набор тестов, и в версии v4.3.2 у всех моделей другие числа. Сравнивать 60 из августа с 45 из октября нельзя — это разные линейки. Пара GLM-5.3 и Kimi K3 по-прежнему идёт почти вровень (45 и 44), но с тех пор вышли две открытые модели с не меньшим баллом: MiMo-V2.6-Pro (46) и DeepSeek V4.1 Flash 1017 (45).
Что сказал NIST. Центр стандартов ИИ при NIST (CAISI) 17 сентября 2026 года назвал GLM-5.3 самой сильной в кибербезопасности открытой моделью на тот момент. По их сводке тестов она отстаёт от лучших американских моделей примерно на четыре месяца. Это госоценка на четырёх собственных тестах CAISI на поиск уязвимостей и написание эксплойтов (SEC-Bench Pro, ExploitBench, ExploitGym, CAISI OSS-Fuzz). CyberGym среди них нет, но общий вывод тот же, что у Z.ai: модель сильна именно в кибербезопасности.
GLM-5.3 против Kimi K3 и DeepSeek V4: сравнение открытых моделей
Сравнение GLM 5.3 vs Kimi K3 — пара, которую чаще всего ставят рядом: на релизе AA дал обеим одинаковые 60 баллов. Ниже к ним добавлены две новые открытые модели с тем же или большим баллом — MiMo-V2.6-Pro от Xiaomi (сентябрь 2026) и DeepSeek V4.1 Flash 1017 (октябрь 2026), а также «младшие» модели, которые реально запустить дома: DeepSeek V4 Flash и Qwen3.8-Flash-Next. Подробные разборы — в наших обзорах Kimi K3 и DeepSeek V4 Flash.Модель Всего / активных Лицензия Индекс AA API: вход / выход за 1M токенов Скорость API Дома MiMo-V2.6-Pro 1,0T / 42B MIT 46 $0,435 / $0,87 57 ток/с н/д GLM-5.3 753B / 40B своя (MaaS > $10 млрд) 45 $1,40 / $4,40 95 ток/с Mac Studio 256–512 ГБ DeepSeek V4.1 Flash 1017 552B / 16B MIT 45 $0,30 / $1,20 169 ток/с н/д Kimi K3 2,8T / 104B своя 44 $3,00 / $15,00 47 ток/с нет GLM-5.3-Flash 320B / 18B MIT 42 $0,15 / $0,50 70 ток/с Mac 128–256 ГБ Qwen3.8-Flash-Next 180B / 6B Qwen Community 40 $0,15 / $0,47 52 ток/с н/д (MacStories гонял на M5 Ultra 256 ГБ) DeepSeek V4 Flash 0731 284B / 13B MIT 34 $0,14 / $0,28 150 ток/с Mac 128 ГБ в 2 битах (замер сообщества)
Данные — Artificial Analysis и прайс Z.ai на 25.10.2026. Скорость API — это скорость в облаке провайдера, а не на вашем компьютере. Дома младшие соперники быстрее: Qwen3.8-Flash-Next в замере MacStories выдаёт 108 ток/с на M5 Ultra, DeepSeek V4 Flash по замеру сообщества — 39 ток/с на M5 Max в 2 битах.
На странице Pricing в документации Z.ai GLM-5.3 стоит $1,40 за миллион входных и $4,40 за миллион выходных токенов, Flash — $0,15 и $0,50 (на 25.10.2026).
Что видно на графике цен: по тарифу Kimi K3 в 2–3,5 раза дороже GLM-5.3, но средняя задача индекса AA обходится в них почти одинаково — $2,00 и $2,01. GLM-5.3 «думает» дольше и тратит больше токенов на рассуждения. Соперники с тем же или большим баллом решают задачу намного дешевле: DeepSeek V4.1 Flash 1017 — за $0,26 (в 8 раз дешевле), MiMo-V2.6-Pro — за $0,13. Flash за задачу — $0,28, примерно в семь раз дешевле флагмана.Модель Цена задачи AA (25.10.2026) GLM-5.3 $2,01 Kimi K3 $2,00 DeepSeek V4.1 Flash 1017 $0,26 MiMo-V2.6-Pro $0,13 Qwen3.8-Flash-Next $0,37 GLM-5.3-Flash $0,28 DeepSeek V4 Flash 0731 $0,15
Как читать сравнение. Kimi K3 при 2,8 трлн параметров дома не запустить вовсе — это выбор только для API. Главный довод за GLM-5.3 против более дешёвых MiMo-V2.6-Pro и DeepSeek V4.1 Flash 1017 — агентная работа: 42% в Terminal-Bench 4.0 против 35% и 34%. Если такие задачи не ваш случай, при равном балле дешевле взять соперника. GLM-5.3-Flash на восемь баллов впереди DeepSeek V4 Flash по индексу и почти втрое лучше в Terminal-Bench 4.0, но DeepSeek вдвое быстрее в облаке и дешевле на выходе. Для агента, который часами работает в терминале, Flash сильнее. Для дешёвого быстрого чата — DeepSeek.
Чем GLM-5.3 отличается от GLM-5.2: эффект одного пост-обучения
В паре GLM 5.3 vs 5.2 размер одинаковый: та же база на 753 млрд параметров. Z.ai прямо пишет в карточке, что весь прирост получен пост-обучением — дообучением готовой модели на задачах агента, кода и кибербезопасности. О предшественнике — в нашем обзоре GLM-5.2.
Что изменилось:
- Агентная работа. По независимому Terminal-Bench 4.0 от AA — 42% у GLM-5.3 против 1% у GLM-5.2. По собственному Terminal Bench 3.0 Z.ai — 28,3 против 4,6.
- Сводный индекс AA вырос с 34 до 45 баллов (версия v4.3.2, 25.10.2026).
- Кибернавыки. ExploitBench в таблице Z.ai — 54,4 против 24,4. Anthropic отдельно пишет, что скачок от GLM-5.2 к GLM-5.3 похож на скачок между её собственными Opus 4.6 и Mythos Preview.
- Цена API не изменилась: $1,40 и $4,40 за миллион токенов у обеих моделей. Скорость в API тоже та же — 94–95 ток/с.
- Задача стала дороже: $2,01 против $1,47 у GLM-5.2, потому что новая модель рассуждает дольше.
- Лицензия стала строже: MIT сменилась собственной лицензией с условием для MaaS-гигантов.
- Требования к железу не изменились: веса того же размера, тот же Mac Studio на 256–512 ГБ.
Практический вывод: если вы уже держали GLM-5.2 локально, GLM-5.3 встаёт на то же железо и в те же кванты.
Сколько памяти нужно GLM-5.3 и Flash: кванты от 1 до 8 бит
Сколько весит GLM 5.3 на диске? Оригинальный флагман в формате FP8 — около 755 ГБ, в BF16 — около 1,5 ТБ. Дома используют сжатые файлы GGUF от Unsloth: флагман от 217 ГБ, Flash от 93 ГБ.
Правило подбора простое: в памяти должен поместиться файл плюс 5–10% на контекст и систему. Unsloth даёт ориентиры: флагману в 1 бите нужно 223 ГБ суммарной памяти (оперативная плюс видеопамять, или единая у Mac), в 2 битах — 245 ГБ, в 4 битах — 372–475 ГБ, в 8 битах — 810 ГБ. Flash в 1 бите работает на 100 ГБ, в 3 битах — на устройствах со 128 ГБ.
Главное на графике: весь ряд Flash до 4 бит помещается в 128–256 ГБ, а флагман начинается там, где у Flash уже 4 бита. Колонки «точность» в таблице ниже — доля токенов, на которых сжатая модель выбирает тот же самый вероятный следующий токен, что и оригинал (метрика Unsloth top-1).Квант Flash, ГБ Flash, точность GLM-5.3, ГБ GLM-5.3, точность На чём (Flash / флагман) IQ1_S (1 бит) 93,1 70,9% 216,7 72,6% Mac 128 ГБ / Mac 256 ГБ, лимит поднять IQ2_XXS / IQ2_M (2 бита) 101,8 76,3% 238,6 78,5% Mac 128 ГБ, лимит поднять / Mac 256 ГБ, лимит поднять Q2_K_XL (2 бита) 108,7 78,3% 253,9 80,9% Mac 128 ГБ, лимит 112 ГиБ / Mac 512 ГБ IQ3_XXS (3 бита) 120,4 81,6% 281,7 84,2% Mac 128 ГБ, лимит ≈120 ГиБ / Mac 512 ГБ Q3_K_XL (3 бита) 147,5 86,3% 343,0 88,9% Mac 192 ГБ впритык или 256 ГБ / Mac 512 ГБ IQ4_XS (4 бита) 156,8 88,2% 365,3 90,6% Mac 192 ГБ, лимит поднять, или 256 ГБ / Mac 512 ГБ Q4_K_XL (4 бита) 199,7 92,2% 467,3 94,3% Mac 256 ГБ впритык / Mac 512 ГБ, лимит поднять Q5_K_XL (5 бит) 240,3 94,4% 562,5 95,8% Mac 256 ГБ, лимит поднять / сервер Q6_K_XL (6 бит) 291,8 95,2% 684,4 96,6% Mac 512 ГБ / сервер Q8_0 (8 бит) ≈341 н/д ≈801 н/д Mac 512 ГБ / сервер BF16 (оригинал) ≈642 100% ≈1508 100% сервер / сервер
Размеры — Unsloth (Q8_0 Flash — Toolhalla, Q8_0 и BF16 флагмана — ModelFit), десятичные гигабайты. Некоторые сайты пишут GiB (ГиБ, двоичные гигабайты): 112,1 ГиБ у IQ3_XXS — это те же 120 ГБ. Apple, наоборот, считает память в двоичных: «128 ГБ» у Mac — это 128 ГиБ, или 137 десятичных ГБ.
Лимит macOS — ловушка, о которой забывают. По умолчанию macOS отдаёт видеоядру около 75% единой памяти: на Mac со 128 ГБ это примерно 96 ГиБ, на 256 ГБ — 192 ГиБ, на 512 ГБ — 384 ГиБ. Файл Flash IQ3_XXS весит 112,1 ГиБ и в 96 ГиБ не влезает. Лимит поднимают командой sudo sysctl iogpu.wired_limit_mb=… (значение в мегабайтах). OrcaRouter приводит 114688 (112 ГиБ) для 2-битной сборки около 102 ГБ и называет 122880 (120 ГиБ) верхней границей того, что ставят на Mac со 128 ГБ. Файл IQ3_XXS в 112 ГиБ уже не помещается. Настройка сбрасывается после перезагрузки, а если оставить системе слишком мало памяти, Mac начнёт зависать.
Отсюда практические ступени. Mac на 96 ГБ не держит ни один квант Flash. Mac на 128 ГБ — 2 бита (Q2_K_XL, 101 ГиБ) при лимите 112 ГиБ или 3 бита IQ3_XXS только при лимите около 120 ГиБ: тогда macOS остаётся около 8 ГиБ, а контекст придётся держать коротким. Mac на 256 ГБ — полноценные 4 бита Q4_K_XL (186 ГиБ): при штатном лимите 192 ГиБ под контекст остаётся всего несколько гигабайт, поэтому лимит тоже стоит поднять. Флагман начинается с Mac Studio на 256 ГБ в 1–2 битах, и тут без подъёма лимита не обойтись: даже 1-битный файл (217 ГБ, 202 ГиБ) больше штатных 192 ГиБ. Точность при этом заметно падает; Unsloth советует целиться в Q4_K_XL и Q5_K_XL, а это уже 467–563 ГБ. Как выбирать объём памяти под разные модели, мы разбирали в статье «Единая память Mac для ИИ».
Скорость GLM-5.3-Flash на Mac и RTX: замеры и расчётные оценки
Скорость генерации у больших моделей почти целиком задаёт пропускная способность памяти — сколько гигабайт в секунду чип успевает прочитать. На каждый токен модель читает свои активные веса. У Flash при 4 битах это около 10 ГБ на токен против примерно 180 ГБ, если бы те же 320 млрд параметров работали все сразу (LLMCheck). Поэтому 320-миллиардная MoE-модель вообще оказалась темой для Mac.
Замеры. MacStories гонял GLM-5.3-Flash на двух Mac Studio: сборка MLX mixed 4/8 бит (эксперты в 4 битах, внимание в 8), движок oMLX 0.7.0.dev2, низкий уровень рассуждений, медиана трёх проходов, скорость считается вместе с токенами рассуждения. Результат — 41 ток/с на M5 Ultra 256 ГБ и 26 ток/с на M3 Ultra 512 ГБ. Отдельный замер сообщества в llama.cpp на том же M5 Ultra — 39,7 ток/с (квант не указан).
Формула для оценки. Где замера нет, считаем так:
скорость ≈ 0,36 × пропускная способность (ГБ/с) ÷ гигабайты активных весов на токен
Гигабайты на токен грубо равны размеру файла × 18/320 (доля активных параметров): у IQ3_XXS это 120,4 × 18/320 ≈ 6,8 ГБ, у Q4_K_XL — 199,7 × 18/320 ≈ 11,2 ГБ. Коэффициент 0,36 — доля теоретического потолка, которую чипы показали в замерах MacStories, посчитанная той же мерой, что и оценки (4-битный файл, 11,2 ГБ на токен): у M5 Ultra 1228 ÷ 11,2 ≈ 110 ток/с потолка, а измерено 41, то есть 0,37; у M3 Ultra 819 ÷ 11,2 ≈ 73 и 26, то есть 0,36. Сборка MacStories с вниманием в 8 битах читает на токен чуть больше, так что реальная доля скорее выше.
Пример расчёта для Mac Studio или MacBook Pro на M5 Max со 128 ГБ: 0,36 × 614 ÷ 6,8 ≈ 32 ток/с. LLMCheck по своей модели даёт для той же машины около 27: наша оценка выше примерно на 20%, и настоящего замера на M5 Max пока нет ни у кого.
Что видно на графике: замеры на Ultra и оценки по формуле лежат в одном коридоре 26–41 ток/с, а DGX Spark с полосой 273 ГБ/с вдвое медленнее любого Mac Max. Рост полосы на 50% (M3 Ultra → M5 Ultra) дал в замере MacStories +58% скорости — это согласуется с формулой, хотя двух точек для полной проверки мало.Машина и квант Генерация, ток/с Чтение 16K-промпта, ток/с Тип данных Mac Studio M5 Ultra 256 ГБ, MLX 4/8 бит 41 1107 замер MacStories Mac Studio M5 Ultra 256 ГБ, llama.cpp 39,7 (≈61 с MTP) н/д замер сообщества Mac Studio M5 Ultra 256 ГБ, Q4_K_XL ≈ 39 (оценка) н/д 0,36 × 1228 ÷ 11,2 Mac Studio M3 Ultra 512 ГБ, MLX 4/8 бит 26 428 замер MacStories Mac Studio M3 Ultra 256/512 ГБ, Q4_K_XL ≈ 26 (оценка) н/д 0,36 × 819 ÷ 11,2 M5 Max 128 ГБ, IQ3_XXS ≈ 32 (оценка) н/д 0,36 × 614 ÷ 6,8 M4 Max 128 ГБ, IQ3_XXS ≈ 29 (оценка) н/д 0,36 × 546 ÷ 6,8 DGX Spark 128 ГБ, IQ3_XXS ≈ 14 (оценка) н/д 0,36 × 273 ÷ 6,8 RTX 4090 24 ГБ + 128 ГБ DDR5 теоретический пик ≈ 16 (наш расчёт) н/д см. ниже RTX 5090 32 ГБ + 128 ГБ DDR5 теоретический пик ≈ 18 (наш расчёт) н/д см. ниже RTX 4090 + 64 ГБ ОЗУ, RTX 3060 не помещается — 88 ГБ < 100 ГБ минимума
Оговорки к оценкам. Коэффициент 0,36 выведен на Ultra в MLX: на Max в llama.cpp реальная доля может оказаться и выше, и ниже. MTP (multi-token prediction — модель угадывает сразу несколько следующих токенов) в llama.cpp 0.7.0 поднимает скорость на M5 Ultra примерно до 61 ток/с по замеру сообщества, но это другой режим работы, и в оценки мы его не закладываем.
Почему RTX здесь слабее. Ни одна игровая видеокарта Flash целиком не держит: у RTX 5090 32 ГБ видеопамяти, у RTX 4090 — 24 ГБ, а самый лёгкий файл — 93 ГБ. Остаётся схема «часть весов в видеокарте, остальное в оперативной памяти», и скорость тогда задаёт уже ОЗУ. Две планки DDR5-5600 в двух каналах теоретически дают 89,6 ГБ/с (5600 млн передач в секунду × 8 байт × 2 канала). Это наш расчёт по стандарту памяти, а не замер, и на практике выходит меньше. Даже теоретический пик в 6–14 раз ниже, чем у Mac Max и Ultra.
Оценка потолка для RTX 4090 со 128 ГБ DDR5 и квантом IQ3_XXS: из 120 ГБ около 100 ГБ лежат в ОЗУ, значит на токен оттуда читается примерно 6,8 × 100/120 ≈ 5,7 ГБ, и потолок — 89,6 ÷ 5,7 ≈ 16 ток/с. У RTX 5090 видеопамяти 32 ГБ, в ОЗУ остаётся около 90 ГБ: 6,8 × 90/120 ≈ 5,1 ГБ на токен, потолок 89,6 ÷ 5,1 ≈ 18 ток/с. Это теоретический пик по нашему расчёту, а не прогноз, и настоящего замера GLM-5.3-Flash на такой сборке нет. Если взять ту же долю 0,36 от потолка, что у Mac, выйдет около 6 ток/с — но это допущение ещё грубее. Цифры из пересказов для RTX 4090 с 64 ГБ ОЗУ мы не приводим: первоисточника у них нет, а 24 + 64 = 88 ГБ меньше 100 ГБ, которые Unsloth называет минимумом даже для 1 бита.
Если памяти не хватает совсем, llama.cpp может читать недостающие веса прямо с SSD. По замерам, собранным Pinggy, это превращает «не запускается» в «1–2 токена в секунду» — годится для ночной пакетной задачи, но не для чата.
Как запустить GLM-5.3-Flash локально: llama.cpp, MLX и ловушка Ollama
Запустить GLM 5.3 локально обычному пользователю реально только в версии Flash. Ниже путь для Mac через llama.cpp — бесплатную программу для запуска моделей. Общие принципы и прошлые версии GLM — в нашем гайде «GLM от Z.ai на своём ПК».
- Проверьте объём памяти. Нужен Mac со 128 ГБ единой памяти и больше. На 96 ГБ и меньше Flash не помещается ни в одном кванте.
- Посмотрите лимит видеоядра. Команда
sysctl iogpu.wired_limit_mb— ответ 0 означает системные ~75% памяти. - Поднимите лимит, если у вас 128 ГБ. Для 2-битного Q2_K_XL —
sudo sysctl iogpu.wired_limit_mb=114688(112 ГиБ). Для IQ3_XXS —sudo sysctl iogpu.wired_limit_mb=122880(120 ГиБ): это предел, системе останется мало памяти, следите за «Давлением памяти» в Мониторинге системы. После каждой перезагрузки команду нужно повторить. - Установите свежий llama.cpp. Поддержку архитектуры Flash (она называется glm5-next) влили 30 сентября 2026 года в PR #27773, сборка b11279. Проще всего —
brew install llama.cpp: Homebrew ставит версию 0.7.0, в ней уже есть и MTP. - Скачайте и запустите квант.
llama-cli -hf unsloth/GLM-5.3-Flash-GGUF:UD-IQ3_XXS -c 16384. Ключ-c 16384задаёт контекст в 16 тыс. токенов. Это осторожная стартовая точка, а не замер: если памяти не хватает, уменьшите контекст или возьмите Q2_K_XL. На Mac 256 ГБ заменитеUD-IQ3_XXSнаUD-Q4_K_XLи поднимите лимит (шаг 3) под объём своей памяти. - Если файлы скачаны до 5 октября — перекачайте первый шард. Ранние GGUF называли архитектуру
glm5nextи в штатном llama.cpp не открываются. Unsloth переписал первый файл каждого кванта (9 МБ) 5 октября, остальные 100+ ГБ качать заново не нужно. - Альтернатива — MLX. Штатный mlx-lm эту архитектуру не поддерживает. Работают oMLX (сборки от ~2 бит на 110 ГБ для Mac 128 ГБ) и mlx-vlm (сборка mlx-community в 4 битах, 204 ГБ, для Mac 256 ГБ). Перед загрузкой 200 ГБ сверьте размер сборки с объёмом памяти.
Ловушка Ollama. Многие ждут, что ollama run glm-5.3-flash скачает модель к ним на компьютер. Это не так: официальная запись в библиотеке Ollama на 25.10.2026 — только облачная.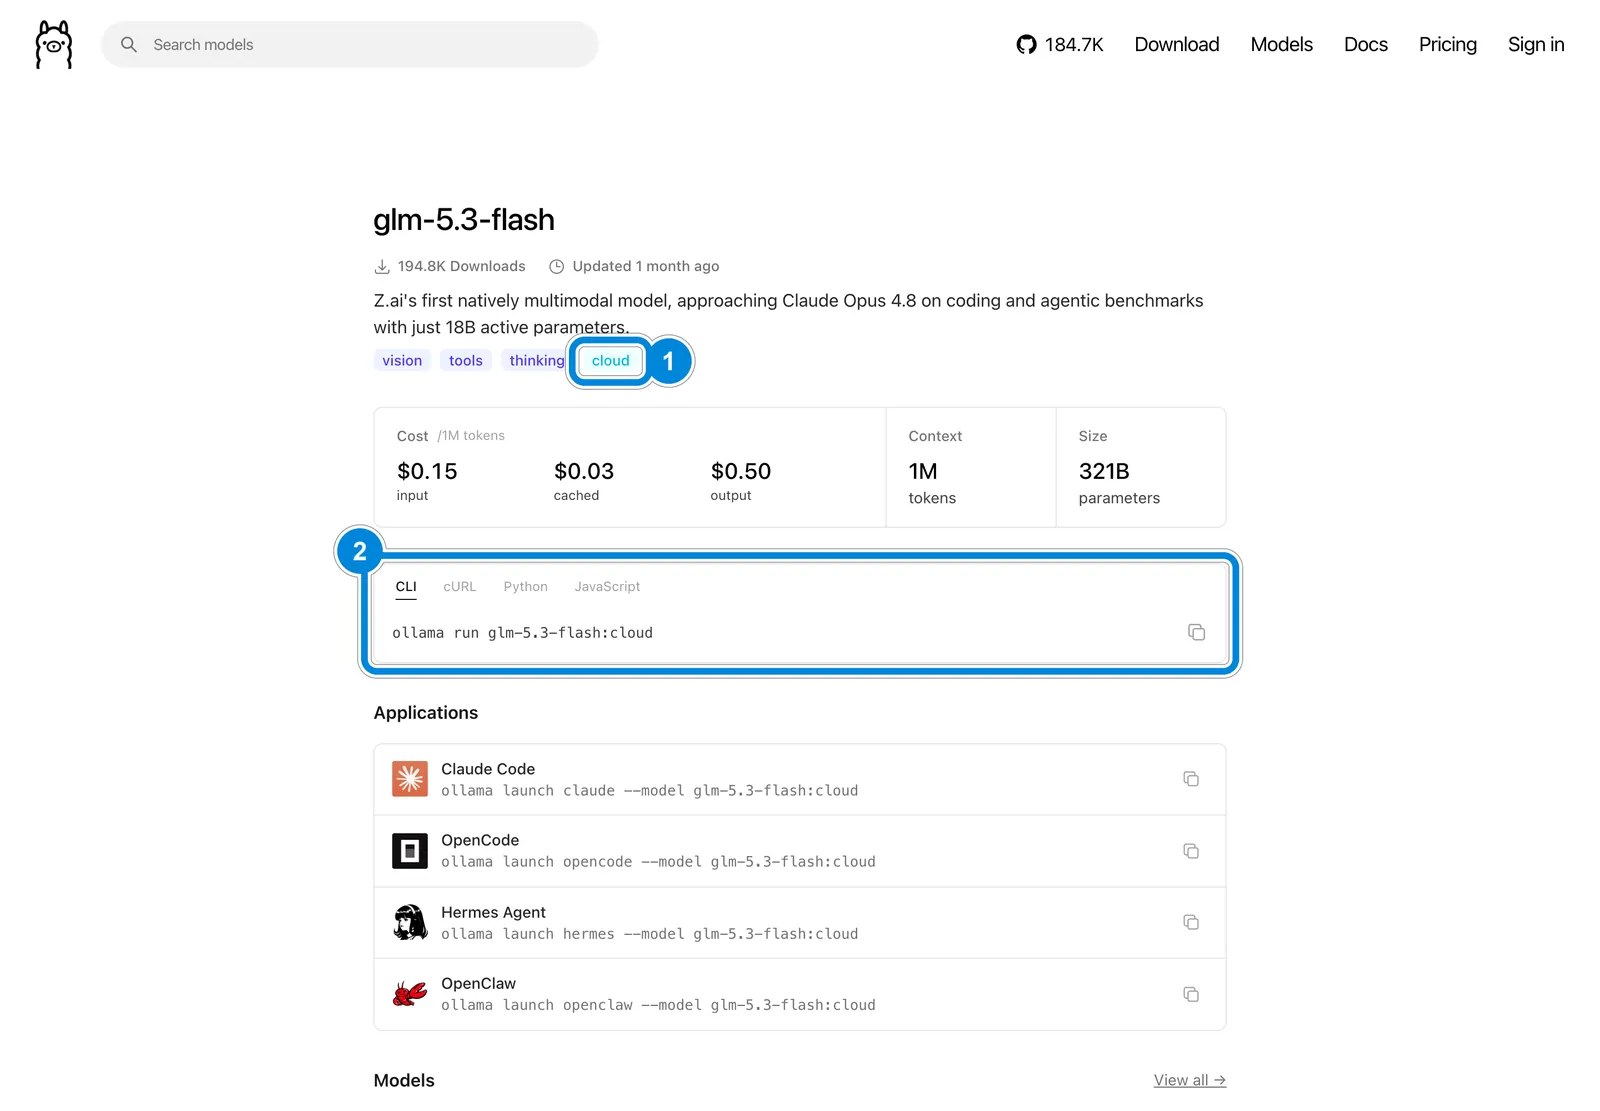
На снимке страницы от 25.10.2026 рамка 1 показывает метку cloud, рамка 2 — команду ollama run glm-5.3-flash:cloud. Такой запуск отправляет запросы на серверы Ollama, веса не скачиваются. Для локальной работы нужен llama.cpp или oMLX.
Для RTX и Windows. Путь тот же llama.cpp, но с выгрузкой экспертов в оперативную память. С 7 октября 2026 года в llama.cpp есть ключ --moe-cache-mib (PR 29887): эксперты живут в ОЗУ, а часто используемые кэшируются на видеокарте. На GLM-5.3-Flash этот режим официально не замеряли, поэтому скорость остаётся оценкой из раздела выше.
Сильные и слабые стороны двух моделей Z.ai в одной таблице
| Плюсы | Минусы |
|---|---|
| Открытые веса обеих моделей, у Flash — MIT без оговорок | У флагмана своя лицензия вместо MIT, как было у GLM-5.2 |
| 45 баллов в индексе AA — тройка лучших открытых моделей на 25.10.2026 | По сводному баллу не первая: MiMo-V2.6-Pro выше, DeepSeek V4.1 Flash 1017 вровень и дешевле |
| Первая по Terminal-Bench 4.0 среди сравниваемых — 42% | Задача индекса AA стоит $2,01 — в 8–15 раз дороже, чем у соперников того же уровня |
| Flash помещается в один Mac на 128–256 ГБ, 26–41 ток/с по замерам на Ultra | Флагман дома только на Mac Studio 256–512 ГБ, в 1–2 битах — с заметной потерей точности |
| Дешёвый API Flash: $0,15 / $0,50 за миллион токенов | Слабая встроенная защита: обход в 64–100% случаев по данным Anthropic |
| Поддержка в llama.cpp, oMLX и mlx-vlm | Поддержка молодая: ранние GGUF несовместимы, штатный mlx-lm не открывает, Ollama только в облаке |
Риски GLM-5.3: киберспособности, слабая защита и юрисдикция
Открытые веса — это свобода и для вас, и для злоумышленника. У GLM-5.3 этот вопрос острее, чем у большинства моделей.
- Сильные кибернавыки. NIST CAISI 17 сентября 2026 года назвал GLM-5.3 самой киберспособной открытой моделью на тот момент. Модель скачивает кто угодно, и отозвать её у вендора возможности нет.
- Слабая встроенная защита — по данным конкурента. Оценку обхода защиты опубликовала Anthropic 29 сентября 2026 года. Anthropic — прямой конкурент Z.ai. В той же статье она пишет, что эти приёмы не сработали против её моделей Claude, но условия не равны: веса Claude закрыты, их нельзя переделать, а API Anthropic не даёт подставить модели начало рассуждения. Оценку киберспособностей Anthropic даёт ту же, что и NIST. Цифры по обходу защиты есть только у неё. В симуляции на прямые вредные запросы GLM-5.3 отказывала во всех попытках. С ложной легендой («ты агент красной команды на учениях») она соглашалась в 64% случаев, с подставленным началом рассуждения — в 92%, после абляции — в 100%.
- Абляция — это недорого. Абляция — правка весов, которая убирает у модели привычку отказывать. По Anthropic, она снизила долю отказов GLM-5.3 с более чем 90% примерно до 3% в JailbreakBench и почти не задела способности модели. Команде, которая делала это впервые, понадобилось около 2200 GPU-часов, примерно $4400 вычислений; опытной команде, по оценке Anthropic, хватило бы около 600 GPU-часов (~$1200), а абляция Flash заняла около 600 GPU-часов. Готовые «расцензуренные» версии появились в открытом доступе через несколько дней после релиза.
- Заявления вендора ≠ независимый тест. Таблица бенчмарков в карточке — замеры Z.ai. Независимые цифры — AA и NIST, и они скромнее: например, индекс AA на 25.10.2026 ставит модель не первой, а в тройку открытых моделей, после MiMo-V2.6-Pro.
- Облачный API — чужая инфраструктура. NIST описывает Z.ai как компанию из КНР. Запросы к официальному API обрабатываются на её серверах по её правилам хранения данных. Для конфиденциального кода и документов надёжнее локальный запуск или провайдер с понятной политикой.
- Перегрузка провайдеров. Команда CMS Wagtail собиралась месяц писать код только на GLM-5.3 Flash через сторонних провайдеров. Это удалось на первую половину месяца, и Flash уложилась в бюджет: $68. Во второй половине большая часть токенов ушла на другие модели. Команда отметила, что именно у Flash падала производительность у провайдеров: модель популярна, а мощностей у провайдеров меньше, чем у крупных лабораторий.
- Молодая поддержка софта. Штатный llama.cpp запускает Flash только с 30 сентября 2026 года, ранние файлы GGUF несовместимы, штатный mlx-lm модель не открывает. Инструкции месячной давности уже устарели.
- Флагман дома — с потерей точности. На Mac Studio 256 ГБ GLM-5.3 работает только в 1–2 битах, где сжатая модель совпадает с оригиналом в выборе токена в 72–79% случаев (Unsloth).
Что выбрать под задачу: облачный API, Flash на Mac или флагман
Выбор упирается в три вопроса: нужна ли приватность, сколько токенов в месяц и есть ли уже Mac на 128 ГБ и больше.Ваш случай Что брать Почему Попробовать модель, пишете код время от времени API GLM-5.3-Flash $0,15 / $0,50 за миллион токенов на 25.10.2026, ничего покупать не нужно Агент, который часами работает в терминале API GLM-5.3 42% в Terminal-Bench 4.0 против 34–35% у соперников с тем же баллом Сильная модель для общих задач за меньшие деньги API DeepSeek V4.1 Flash 1017 или MiMo-V2.6-Pro тот же или больший балл AA, задача за $0,26 и $0,13 против $2,01 Код и документы нельзя отдавать в облако, есть Mac 128 ГБ Flash в 2–3 битах помещается после подъёма лимита, ≈29–32 ток/с по оценке, контекст короткий Нужна приватность и длинный контекст Flash Q4_K_XL на Mac Studio 256 ГБ 92% совпадения с оригиналом, ≈39–41 ток/с, после подъёма лимита — несколько десятков гигабайт под контекст Нужен именно флагман локально GLM-5.3 Q4_K_XL на Mac Studio 512 ГБ 467 ГБ файл, 384 ГиБ лимита по умолчанию — придётся поднимать Игровой ПК с RTX 4090/5090 API или DeepSeek V4 Flash локально Flash упрётся в оперативную память, теоретический пик ≈16–18 ток/с (наш расчёт)
Расчёт: когда API выгоднее. Допустим, вы отправляете 100 млн токенов запросов и получаете 10 млн токенов ответов в месяц — это плотная ежедневная работа агента. На Flash через API это 100 × $0,15 + 10 × $0,50 = $20 в месяц, на флагмане — 100 × $1,40 + 10 × $4,40 = $184. Учтите, что агент повторно отправляет одну и ту же историю, а кэшированный вход у Z.ai дешевле: $0,03 у Flash и $0,26 у флагмана за миллион.
Бесплатного доступа к GLM-5.3 и Flash у Z.ai нет. В прайсе на 25.10.2026 бесплатны только старые GLM-4.7-Flash, GLM-4.5-Flash и GLM-4.6V-Flash, а у GLM-5.3 бесплатно лишь хранение кэша, и то «на ограниченное время». Платить можно по факту с баланса аккаунта, пакетами токенов или подпиской GLM Coding Plan (личной или командной; с 16 октября 2026 года ключи для API и для подписки разделены). Какие способы оплаты принимаются из Украины, в документации Z.ai не сказано.
Теперь железо. На 25.10.2026 в украинских магазинах на Hotline Mac Studio M5 Ultra в минимальной конфигурации на 96 ГБ стоит от 273 289 грн (медиана 335 840 грн) — и Flash в такую память не помещается. Конфигураций на 128, 256 и 512 ГБ в базе Hotline на эту дату нет, поэтому их цену мы не приводим: 273 289 грн — только нижняя граница. Даже эта нижняя граница — годы работы Flash через API по $20 в месяц из примера выше. Покупка имеет смысл, когда приватность обязательна или Mac нужен и для других задач. Какую конфигурацию брать под локальные модели, разбираем в хабе «Какой Mac выбрать».
Короткие сценарии:
- Новичку — API Flash: дёшево, быстро, без настройки.
- Разработчику с Mac на 128 ГБ — Flash локально в 2–3 битах для простых задач, сложные отдавать облачной модели.
- Команде с чувствительными данными — Mac Studio на 256 ГБ и Flash в 4 битах: 92% совпадения с оригиналом по метрике Unsloth и 39–41 ток/с.
- Тем, кому нужен максимум качества — GLM-5.3, MiMo-V2.6-Pro или DeepSeek V4.1 Flash 1017 через API: дома флагман теряет слишком много точности.
Что устареет первым: цены API (у Z.ai бывают промо-скидки), индекс AA (версии меняются) и поддержка в программах. Свежие данные — на карточке модели на Hugging Face и в прайсе Z.ai.
FAQ
Выложены ли веса GLM-5.3 — можно ли скачать модель?
Да. Z.ai выпустила GLM-5.3 в API 14 августа 2026 года и выложила веса через две недели, 28 августа. Репозиторий zai-org/GLM-5.3 на Hugging Face открыт без заявки: за последний месяц на 25.10.2026 его скачали 2 074 062 раза. Младшую GLM-5.3-Flash опубликовали 26 августа под лицензией MIT, и её качают втрое чаще.
Чем GLM-5.3-Flash отличается от GLM-5.3 и какую запускать дома?
Flash — отдельная модель на новой базе: 320 млрд параметров против 753 млрд у флагмана, 18 млрд активных против 40 млрд, лицензия MIT вместо собственной и поддержка картинок. По индексу Artificial Analysis Flash отстаёт на три балла (42 против 45). Дома запускают именно Flash: ей хватает Mac со 128–256 ГБ, флагману нужно 256–512 ГБ.
Сколько памяти нужно, чтобы запустить GLM-5.3-Flash на Mac?
Минимум 128 ГБ единой памяти. На таком Mac помещаются кванты в 2 бита (102–109 ГБ) и 3-битный IQ3_XXS на 120 ГБ — последний только после того, как вы поднимете лимит видеоядра командой sysctl примерно до 120 ГиБ, и контекст придётся держать коротким. Комфортные 4 бита (200 ГБ) требуют Mac Studio на 256 ГБ. Mac на 96 ГБ не подходит.
Поддерживает ли Ollama GLM-5.3 локально?
Нет, на 25.10.2026 официальные записи glm-5.3-flash и glm-5.3 в Ollama — облачные, с суффиксом :cloud. Команда ollama run glm-5.3-flash:cloud отправляет запросы на серверы Ollama и ничего не скачивает. Чтобы работать без интернета, используйте llama.cpp версии b11279 или новее с файлами GGUF от Unsloth либо oMLX на Mac.
Можно ли использовать GLM-5.3 в коммерческих проектах?
Да. GLM-5.3-Flash выпущена под MIT — коммерция, правка и распространение разрешены с указанием авторства. Флагман GLM-5.3 под собственной лицензией тоже разрешает коммерцию. Единственное условие касается компаний, которые продают доступ к модели как сервис и зарабатывают больше $10 млрд за 12 месяцев: им нужна проверка безопасности Z.ai.
Запустится ли GLM-5.3-Flash на RTX 4090 или RTX 5090?
Целиком в видеокарту — нет: самый лёгкий файл весит 93 ГБ, а у RTX 5090 32 ГБ памяти. Работать будет связка видеокарты и 128 ГБ оперативной памяти, но скорость упрётся в ОЗУ: теоретический пик по нашему расчёту — около 16–18 ток/с, на практике заметно ниже. С 64 ГБ ОЗУ не хватит памяти даже на 1-битный квант.