
Коротко: Mistral Medium 3.5 — открытая 128B, но не для одной RTX
Mistral Medium 3.5 — языковая модель французской Mistral AI, вышедшая 29 апреля 2026 года. Её веса открыты на Hugging Face, и это главное отличие от Medium 3 и 3.1, которые работали только через API. Но слово Medium вводит в заблуждение: это не «средняя домашняя» модель, а плотная сеть на 128 миллиардов параметров.
- Коротко: Mistral Medium 3.5 — открытая 128B, но не для одной RTX
- Что такое Mistral Medium 3.5 и чем она отличается от Medium 3.1
- Версии, размеры и лицензия Modified MIT: что можно скачать
- Бенчмарки Mistral Medium 3.5: цифры Mistral и независимые замеры
- Как запустить Mistral Medium 3.5 локально: Ollama, llama.cpp, vLLM
- Сколько памяти нужно модели на 128B: кванты, Mac и RTX
- Скорость генерации на Mac и RTX: замер Apple и оценка
- Mistral Medium 3.5 против Qwen 3.6 27B, DeepSeek V4 Flash и gpt-oss
- Риски Mistral Medium 3.5: когда цена, скорость и лицензия мешают
- Кому брать Medium 3.5: API, Mac со 128 ГБ или модель поменьше
- Как мы оценивали Medium 3.5 без собственного прогона
- FAQ
- Что это: одна модель вместо трёх — обычный чат, режим рассуждений (reasoning) и агентный код. Контекст 256 тысяч токенов, понимает картинки, отвечает текстом.
- Лицензия: Modified MIT. Бесплатно для коммерции, пока месячная выручка компании не превышает $20 млн.
- Цена API на 25.10.2026: $1,5 за миллион входящих токенов и $7,5 за миллион исходящих — дороже всех открытых конкурентов из нашего сравнения.
- Железо: 4-битная версия весит 74,9 ГБ. Её тянет Mac со 128 ГБ единой памяти; одна видеокарта RTX не тянет — веса приходится держать в оперативной памяти, и скорость не выше 1,4–2 токенов в секунду (расчётный потолок).
- Скорость на Mac: Apple измерила 7,70 токена в секунду на Mac Studio M5 Ultra и 4,95 на M3 Ultra (исходные веса FP8, контекст 8K, 15.10.2026).
- Качество: у независимой Artificial Analysis индекс 14 при медиане 8 у открытых моделей того же размера, а у Qwen3.8 27B и DeepSeek V4 Flash — по 34.
Что такое Mistral Medium 3.5 и чем она отличается от Medium 3.1
Medium 3.5 — первая «объединённая» флагманская модель Mistral: в одном наборе весов собраны выполнение инструкций, рассуждения и программирование. По карточке модели она заменила Medium 3.1 и Magistral в чат-боте Le Chat и Devstral 2 в агенте для кода Vibe.
Модель называют плотной (dense). Это значит, что при генерации каждого токена работают все 128 миллиардов параметров. У моделей MoE (mixture of experts, «смесь экспертов») всё иначе: из сотен миллиардов параметров на токен включается небольшая часть. Для домашнего запуска эта разница решающая, к ней мы вернёмся в разделе про скорость.
Что изменилось по сравнению с Medium 3.1:
| Параметр | Medium 3 и 3.1 | Medium 3.5 |
|---|---|---|
| Веса | закрыты, только API | открыты, Hugging Face |
| Лицензия | коммерческая через API | Modified MIT с порогом выручки |
| Архитектура | не раскрывалась | плотная 128B |
| Контекст | н/д | 256K (262 144 токена) |
| Вход | н/д | текст и изображения, свой визуальный энкодер |
| Рассуждения | отдельная модель Magistral | встроены, включаются на запрос |
| Статус в Mistral | устаревшие (deprecated) | актуальная |
Рассуждения включаются параметром reasoning_effort. Значение none даёт быстрый ответ без размышлений, high — режим, в котором модель сначала «думает», а потом отвечает. Mistral советует high для сложных запросов и агентного кода, с температурой 0,7.
Языков в метаданных карточки 24, включая украинский и русский. Независимых тестов качества на этих языках мы не нашли, поэтому оценки здесь нет.
Место в линейке: сверху стоит Mistral Large 4 с индексом Artificial Analysis 38, снизу — Small 4 (индекс 11). Decrypt при выходе Medium 3.5 писал, что Mistral видит в ней ступень к будущему большому флагману. В октябре Large 4 вышла, но на 25.10.2026 это превью только через API, без открытых весов.
Версии, размеры и лицензия Modified MIT: что можно скачать
Официальный репозиторий называется Mistral Medium 3.5 128B. Mistral публикует веса сразу в формате FP8 (8 бит с плавающей точкой) с визуальным энкодером в BF16: 121,8 млрд параметров в FP8 и 5,9 млрд в BF16, вместе около 133,6 ГБ. Полную 16-битную версию и сжатые варианты собирает Unsloth.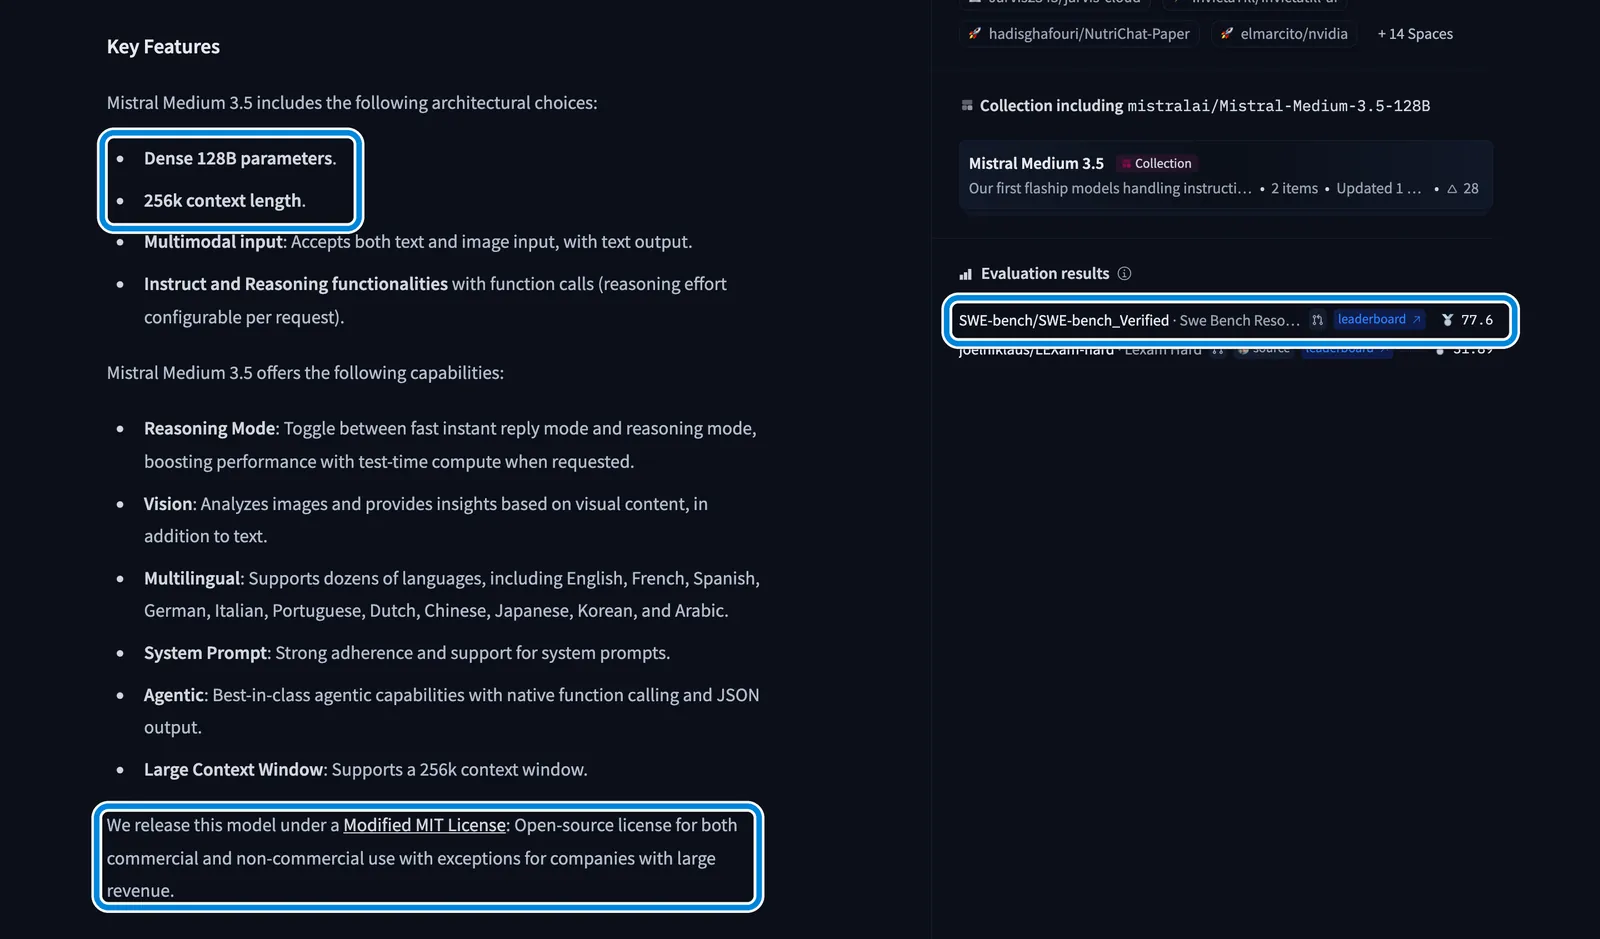
На скриншоте карточки, снятом 25.10.2026, выделены три вещи: «Dense 128B parameters» и «256k context length» в списке характеристик, результат SWE-bench Verified 77,6 в блоке оценок и строка о лицензии с исключением для компаний с большой выручкой.
Квантование — это сжатие весов: каждое число хранится меньшим количеством бит. Файл становится легче, точность немного падает. Обозначения вида Q4_K_M читаются так: Q4 — около 4 бит на параметр, K_M — средний вариант алгоритма. Подробно о том, где начинается заметная потеря качества, — в разборе квантования Q4 против Q8.Что скачать Размер, ГБ Где Для чего FP8, оригинал Mistral ≈133,6 mistralai/Mistral-Medium-3.5-128B vLLM, SGLang на серверных GPU EAGLE-голова н/д mistralai/Mistral-Medium-3.5-128B-EAGLE ускорение vLLM и SGLang BF16 GGUF 250,1 unsloth эталон, дома почти не нужен Q8_0 132,8 unsloth Mac на 192–256 ГБ Q4_K_M 74,9 unsloth стартовый выбор для Mac на 128 ГБ UD-Q4_K_XL 75,7 unsloth динамический 4-бит, его советует Unsloth Q3_K_M 60,6 unsloth Mac на 96 ГБ Q2_K 46,6 unsloth Mac на 64 ГБ, с потерей качества Тег Ollama mistral-medium-3.580 ollama.com запуск одной командой
EAGLE — маленькая вспомогательная модель, которая угадывает несколько следующих токенов наперёд, а большая только проверяет догадки. Так генерация на сервере идёт быстрее.

Лицензия Modified MIT — это обычная MIT с одним условием. Пользоваться моделью и производными от неё (дообученными версиями, квантами) нельзя, если глобальная консолидированная выручка вашей компании или вашего работодателя за предыдущий месяц превысила $20 млн. Порог считается помесячно, а не за год, как пишут в некоторых пересказах. Выше порога нужна отдельная коммерческая лицензия Mistral. Для фрилансера, студии или малого бизнеса ограничение не действует.
Бенчмарки Mistral Medium 3.5: цифры Mistral и независимые замеры
Бенчмарк — стандартный набор задач, на котором модели сравнивают по доле верных ответов. Цифры бывают двух видов: те, что публикует сам разработчик, и те, что получили сторонние лаборатории на своих прогонах. Их стоит держать в разных колонках.Тест Кто мерил Результат Что проверяет SWE-bench Verified Mistral, самоотчёт 77,6% исправление реальных ошибок в репозиториях на GitHub τ³-Telecom Mistral, самоотчёт 91,4% агент поддержки, который работает с инструментами Intelligence Index v4.3.2 Artificial Analysis 14 (медиана класса — 8) сводный балл по рассуждениям, знаниям, коду и агентам Vals Index Vals AI 32,69% средняя точность на наборах Vals ECI Epoch AI 141, место 115 сводный индекс возможностей Epoch
Карточка Artificial Analysis на 25.10.2026 даёт модели индекс 14 и восьмое место из 67 среди открытых моделей похожего размера (у AA это класс 40–150 млрд параметров). Отдельные тесты, из которых собран индекс, — в разделе Benchmarks на странице Mistral Medium 3.5. В части каталогов до сих пор висит «30» — это снимок прежней версии индекса, сравнивать его с нынешними цифрами нельзя.
График показывает расстановку на одной шкале: Medium 3.5 обходит gpt-oss-120b и Mistral Small 4, но отстаёт от Qwen3.6 27B, а Qwen3.8 27B и DeepSeek V4 Flash набирают в 2,4 раза больше.Модель Архитектура Индекс AA v4.3.2 (25.10.2026) GLM-5.3 Flash MoE 320B, 18B активных 42 Qwen3.8 27B плотная 27B 34 DeepSeek V4 Flash MoE 284B, 13B активных 34 Qwen3.6 27B плотная 27,8B 21 Mistral Medium 3.5 плотная 128B 14 gpt-oss-120b MoE 117B, 5,1B активных 12 Mistral Small 4 MoE 119B, 6,5B активных 11 Mistral Large 3 MoE 675B, 41B активных 9
Почему вендорские 77,6% на SWE-bench не превращаются в высокий сводный балл. Во-первых, это самоотчёт: независимого прогона SWE-bench Verified для Medium 3.5 в открытых источниках нет. Во-вторых, сводный индекс охватывает не только код, а рассуждения, знания и длинные агентные сценарии. Модель, заточенная под агентов для кода, может быть сильна в одной дисциплине и средней в остальных.
Как запустить Mistral Medium 3.5 локально: Ollama, llama.cpp, vLLM
Локальный запуск означает, что модель работает на вашем компьютере без интернета и без отправки данных в Mistral. Веса скачиваются с Hugging Face. Ниже — пять шагов от самого простого пути к серверному.
- Выберите квант под свою память. Ориентир — таблица в следующем разделе. Для Mac на 128 ГБ это Q4_K_M или UD-Q4_K_XL, для 96 ГБ — Q3_K_M.
- Самый простой путь — Ollama. Установите Ollama и выполните одну команду. Тег по умолчанию весит 80 ГБ и поддерживает контекст 256K.
ollama run mistral-medium-3.5
- Больше контроля — llama.cpp. Соберите свежую версию с GitHub. На Mac параметр
-DGGML_CUDA=OFF, поддержка Metal включена по умолчанию. Запуск прямо с Hugging Face в режиме рассуждений:
./llama.cpp/llama-cli \
    -hf unsloth/Mistral-Medium-3.5-128B-GGUF:UD-Q4_K_XL \
    --temp 0.7 \
    --chat-template-kwargs '{"reasoning_effort":"high"}'
- Свой API для приложений — llama-server. Он поднимает OpenAI-совместимый сервер, к которому подключаются чат-клиенты и агенты:
./llama.cpp/llama-server \
    -hf unsloth/Mistral-Medium-3.5-128B-GGUF:UD-Q4_K_XL \
    --alias "mistral-medium-3.5" --port 8001 --temp 0.7 \
    --chat-template-kwargs '{"reasoning_effort":"none"}'
- Сервер компании — vLLM или SGLang. Mistral рекомендует vLLM (ночную сборку) и пишет, что модель работает от четырёх GPU. Рецепт vLLM советует 8×H200, подходят и 4×B200. Один B200 вмещает веса FP8, но почти не оставляет места под контекст 256K.
Что работает, а что нет, на 25.10.2026:Инструмент Текст Картинки Что учесть Ollama да спорно страница Ollama помечает vision, Unsloth пишет, что vision-GGUF в Ollama не работают llama.cpp да да, с файлом mmproj GGUF, собранные до 01.05.2026, ломают длинный контекст LM Studio н/д н/д в карточке модели значится «WIP» vLLM, SGLang да да ночная сборка, серверные GPU Unsloth Studio да н/д веб-интерфейс Unsloth для запуска и дообучения
Три ловушки чаще всего портят первый запуск. Первая — в конфиге Transformers была ошибка, из-за которой падало качество на длинном контексте. Mistral исправила её коммитом c4be198, а Unsloth 1 мая 2026 года перевыпустила все GGUF. Скачанные раньше файлы стоит заменить. Вторая — CUDA 13.2: по предупреждению Unsloth, на ней модель выдаёт бессмыслицу. Третья — картинки в Ollama: если нужен анализ изображений, надёжнее llama.cpp с отдельным файлом mmproj-BF16.gguf (5,4 ГБ).
Кому 128B не по железу, но хочется модель того же разработчика дома, стоит посмотреть на Mistral Small на своём ПК: там тот же путь через Ollama и llama.cpp, но на обычной видеокарте.
Сколько памяти нужно модели на 128B: кванты, Mac и RTX
Правило простое: в память должны поместиться файл модели и кэш контекста. Кэш контекста (KV-кэш) — это рабочая память разговора, она растёт с длиной переписки. Unsloth рекомендует 64 ГБ суммарной памяти для 3-битной версии, 80 ГБ — для 4-битной и 128–170 ГБ — для 8-битной.
Сколько весит контекст, видно из замера Apple: при 65 536 токенах модель в FP8 заняла до 158 ГБ, то есть сверх 133,6 ГБ весов ушло около 24 ГБ. Эту прибавку мы переносим и на кванты — это оценка.
На графике видно, что 4-битный квант весит почти вдвое меньше оригинала FP8, а между Q4_K_M и Q8_0 лежит разница в 58 ГБ — это и есть цена перехода на ступень памяти выше.Квант Размер файла, ГБ Сколько бит на параметр UD-IQ2_XXS 34,9 около 2, сильная потеря качества Q2_K 46,6 около 2 Q3_K_M 60,6 около 3 IQ4_XS 67,1 около 4, компактный Q4_K_M 74,9 около 4 Q5_K_M 88,3 около 5 Q6_K 102,6 около 6 Q8_0 132,8 8 FP8 (оригинал) ≈133,6 8 BF16 250,1 16
Mac: единая память и лимит видеоядра
У Mac нет отдельной видеопамяти — процессор и видеоядро делят одну единую память. Но macOS по умолчанию отдаёт видеоядру не всю её, а около 3/4: по логам llama.cpp это 412,3 ГБ на Mac с 512 ГБ и 40,2 ГБ на 48-гигабайтном Mac с macOS 26.3. Как проверить и поднять лимит командой sysctl, подробно описано в статье о том, сколько единой памяти нужно Mac для ИИ.Память Mac Лимит видеоядра, ГБ Что помещается Где бывает 64 ГБ ≈51,5 Q2_K с коротким контекстом M4 Max, M5 Max, M2 Ultra 96 ГБ ≈77,3 Q3_K_M с контекстом около 16 ГБ; Q4_K_M без контекста, только после sysctl M3 Ultra, M5 Ultra 128 ГБ ≈103,1 Q4_K_M с контекстом до ≈64K (оценка); Q5_K_M с коротким M4 Max, M5 Max, M2 Ultra 192 ГБ ≈154,6 Q8_0 и FP8 с коротким контекстом M2 Ultra 256 ГБ ≈206,2 FP8 с контекстом 64K (158 ГБ по замеру Apple) M3 Ultra, M5 Ultra 512 ГБ 412,3 BF16 с запасом M3 Ultra, M5 Ultra
Лимиты в таблице переведены в десятичные гигабайты, чтобы сравнивать их с размерами файлов напрямую. Где лога нет, стоит оценка по правилу 3/4. Какой Mac под какие модели вообще имеет смысл покупать, сведено в хабе «Какой Mac выбрать».
ПК с RTX: видеопамяти не хватает ни одной карте
Ни одна потребительская видеокарта NVIDIA не вмещает даже самый сжатый квант: у RTX 5090 32 ГБ видеопамяти (VRAM), у RTX 4090 — 24 ГБ, у RTX 3060 — 12 ГБ, а UD-IQ2_XXS весит 34,9 ГБ. Остальное llama.cpp держит в обычной оперативной памяти и считает процессором — это называется выгрузкой (offload).Видеокарта VRAM, ГБ Сколько ОЗУ нужно под Q4_K_M Сколько весов уйдёт в ОЗУ, ГБ RTX 5090 32 от 64 ГБ ≈42,9 RTX 4090 24 от 64 ГБ ≈50,9 RTX 3060 12 от 96 ГБ, на 64 ГБ — Q3_K_M ≈62,9
Запустить так можно, но быстро не будет: решает скорость оперативной памяти, а не видеокарты. Подробнее — в следующем разделе.
Скорость генерации на Mac и RTX: замер Apple и оценка
Скорость генерации — сколько токенов в секунду модель выдаёт в ответ. Токен — кусочек слова, в русском тексте на слово уходит в среднем больше одного токена. У плотной модели генерация упирается в пропускную способность памяти: на каждый токен нужно один раз прочитать все веса. Отсюда формула потолка:
Потолок, ток/с ≈ пропускная способность памяти, ГБ/с ÷ размер весов, ГБ
Оценка, ток/с ≈ потолок × коэффициент 0,6–0,8
Замер Apple на Mac Studio
Единственный опубликованный замер этой модели на потребительском железе сделала сама Apple. 15 октября 2026 года команда Apple Machine Learning Research прогнала модель в исходной точности FP8 через mlx_lm.benchmark на Mac Studio с 512 ГБ и опубликовала таблицы скорости.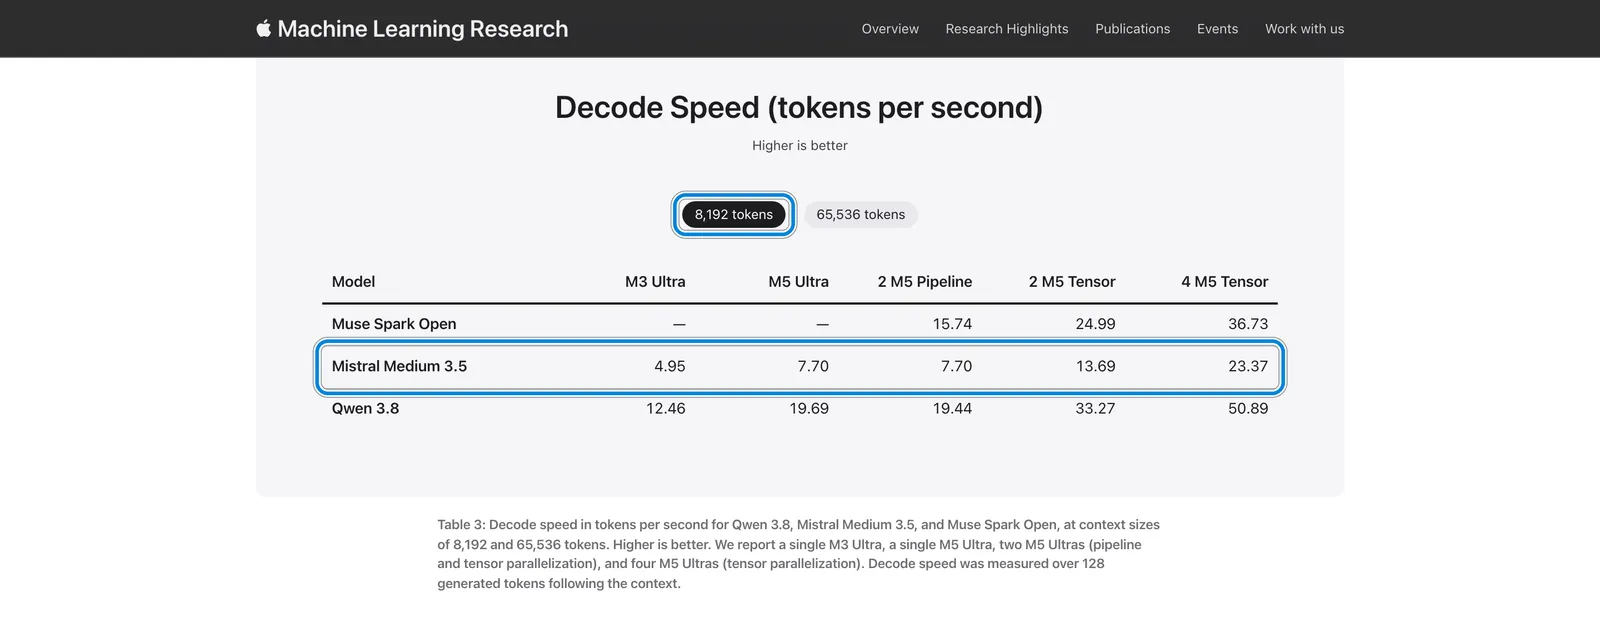
На скриншоте таблицы, снятом 25.10.2026, выделена вкладка «8,192 tokens» и строка модели: 4,95 токена в секунду на M3 Ultra, 7,70 на M5 Ultra и 23,37 на кластере из четырёх M5 Ultra.Конфигурация (FP8, MLX) Генерация, 8K, ток/с Генерация, 64K, ток/с До первого токена, 8K, с До первого токена, 64K, с Mac Studio M3 Ultra 4,95 3,88 95,9 1097,9 Mac Studio M5 Ultra 7,70 6,16 24,6 273,0 2× M5 Ultra, тензорный параллелизм 13,69 11,05 14,4 154,1 4× M5 Ultra, тензорный параллелизм 23,37 18,92 7,5 80,0
Вторая половина таблицы важнее для агентов. Время до первого токена — это сколько модель читает ваш запрос, прежде чем начать отвечать. На M3 Ultra запрос в 64 тысячи токенов (большой кусок кодовой базы) обрабатывается 1097,9 секунды, то есть больше 18 минут. M5 Ultra справляется за 273 секунды, около 4,5 минуты: у видеоядра нового поколения появились ускорители умножения матриц.
Замер Apple ещё и калибрует формулу. 819 ГБ/с ÷ 133,6 ГБ дают потолок 6,1 токена в секунду, реальные 4,95 — это 81% потолка. У M5 Ultra 1228,8 ГБ/с (пропускная способность шины LPDDR5X, Apple округляет её до 1,2 ТБ/с) ÷ 133,6 ГБ = 9,2, реальные 7,70 — 84%.
Оценка для 4-битного кванта на Mac и RTX
Для Q4_K_M (74,9 ГБ) замеров нет, поэтому ниже — оценка. Коэффициент берём в диапазоне 0,6–0,8: верх — то, что Apple получила на этой модели в MLX, низ — запас на llama.cpp и распаковку 4-битных весов, которая тоже стоит вычислений. Для ПК с видеокартой считаем потолок по оперативной памяти: двухканальная DDR5-5600 даёт 5600 × 8 байт × 2 канала = 89,6 ГБ/с. Это теоретический пик. В старых ПК с RTX 3060 часто стоит DDR4-3200 — это 51,2 ГБ/с, и потолок опускается примерно до 0,8 токена в секунду.
Главное, что видно на графике: даже лучший Mac со сжатой моделью выдаёт около 10–13 токенов в секунду, а ПК с одной видеокартой упирается в потолок около 2.Конфигурация Пропускная способность Квант Скорость, ток/с Тип цифры Mac Studio M5 Ultra 1,2 ТБ/с Q4_K_M ≈ 9,8–13,1 (потолок 16,4) ≈ оценка Mac Studio M3 Ultra 819 ГБ/с Q4_K_M ≈ 6,6–8,7 (потолок 10,9) ≈ оценка Mac Studio M2 Ultra 800 ГБ/с Q4_K_M ≈ 6,4–8,5 (потолок 10,7) ≈ оценка M5 Max, 40 ядер GPU 614 ГБ/с Q4_K_M ≈ 4,9–6,6 (потолок 8,2) ≈ оценка M4 Max, 40 ядер GPU 546 ГБ/с Q4_K_M ≈ 4,4–5,8 (потолок 7,3) ≈ оценка RTX 5090 + DDR5 89,6 ГБ/с на 42,9 ГБ в ОЗУ Q4_K_M ≤ ≈2,1 ≈ оценка, потолок RTX 4090 + DDR5 89,6 ГБ/с на 50,9 ГБ в ОЗУ Q4_K_M ≤ ≈1,8 ≈ оценка, потолок RTX 3060 12 ГБ + DDR5 89,6 ГБ/с на 62,9 ГБ в ОЗУ Q4_K_M ≤ ≈1,4 ≈ оценка, потолок API Mistral — — 162,5 замер Artificial Analysis, 25.10.2026
Откуда разница с замером: 4-битный файл легче оригинала FP8 в 1,8 раза (74,9 против 133,6 ГБ), но середина нашей оценки для M3 Ultra (≈7,7) выше замера Apple (4,95) лишь в 1,6 раза. Мы сознательно взяли коэффициент ниже, чем у Apple (0,7 против 0,81): llama.cpp и распаковка 4-битных весов съедают часть выигрыша. Это не проверка оценки, а её посылка — замера Q4 на этой модели пока нет. В MLX есть свои 4-битные кванты, и там коэффициент, скорее всего, ближе к верхней границе. У видеокарт потолок посчитан так, будто часть весов в VRAM читается мгновенно, поэтому реальная скорость будет ниже.
Почему MoE той же массы в разы быстрее
gpt-oss-120b весит в 4 битах 59 ГиБ, почти как Medium 3.5 в Q3, но это MoE: на каждый токен включается 5,1 млрд параметров из 117. В замере llama.cpp на M2 Ultra она пишет 79,68 токена в секунду, а наша оценка для Medium 3.5 в Q4 на том же чипе — около 7,5. Разница в 10 раз при похожем объёме памяти. Разработчик Сальваторе Санфилиппо (antirez) писал в обсуждении анонса на Hacker News, что DeepSeek V4 Flash в 2 битах (GGUF на 86 ГБ) выдаёт у него около 30 токенов в секунду на M3 Ultra — это пользовательский замер, а не методика лаборатории. Память покупается под «сколько параметров всего», а скорость определяется тем, сколько из них работает на токен.
Mistral Medium 3.5 против Qwen 3.6 27B, DeepSeek V4 Flash и gpt-oss
Сравнение собрано под вопрос «что запускать дома или дёшево брать по API». Индекс и цены — Artificial Analysis на 25.10.2026, архитектура и лицензии — карточки моделей.Модель Архитектура Лицензия Индекс AA Вес для запуска Цена API, $/1M вход / выход Medium 3.5 плотная 128B Modified MIT, порог $20 млн/мес 14 74,9 ГБ (Q4_K_M) 1,50 / 7,50 Qwen3.6 27B плотная 27,8B Apache 2.0 21 н/д 0,60 / 3,60 Qwen3.8 27B плотная 27B Apache 2.0 34 н/д 0,50 / 3,00 DeepSeek V4 Flash MoE 284B, 13B активных MIT 34 86 ГБ (2 бита, по antirez) 0,14 / 0,28 GLM-5.3 Flash MoE 320B, 18B активных MIT 42 н/д 0,15 / 0,50 gpt-oss-120b MoE 117B, 5,1B активных Apache 2.0 12 59 ГиБ (MXFP4) 0,15 / 0,60 Mistral Small 4 MoE 119B, 6,5B активных Apache 2.0 11 н/д 0,15 / 0,60
Mistral Medium 3.5 vs Qwen 3.6 27B: почти ничья в SWE-bench
Эта пара интересна тем, что обе плотные, но Qwen меньше почти в пять раз. По самоотчётам разработчиков в SWE-bench Verified у Mistral 77,6%, у Qwen3.6-27B — 77,2% (последний столбец таблицы в карточке Qwen). Decrypt в своём материале привёл для Qwen 72,4% — первоисточник эту цифру не подтверждает. На сводной шкале Artificial Analysis Qwen3.6 27B выше: 21 против 14. А по железу разрыв огромный: при одинаковом кванте 27 млрд параметров читаются на токен почти в пять раз быстрее, чем 128 млрд, и помещаются в память, где Medium 3.5 не поместится вовсе.
DeepSeek V4 Flash и gpt-oss: кто быстрее дома
Если у вас Mac на 128–192 ГБ, DeepSeek V4 Flash выигрывает по обоим параметрам — индекс 34 и, судя по отчёту antirez, кратно большая скорость. Подробный разбор — в обзоре DeepSeek V4 Flash. gpt-oss-120b слабее Medium по индексу (12 против 14), зато влезает в 80-гигабайтную видеокарту и в Mac на 96 ГБ, а работает в разы быстрее. Как поставить её на свой ПК — в гайде по GPT-OSS локально.
По цене API Medium 3.5 — самая дорогая модель сравнения: исходящий миллион токенов стоит $7,50, у Qwen3.8 27B — $3,00, у DeepSeek V4 Flash — $0,28.Модель Вход, $/1M Выход, $/1M Medium 3.5 1,50 7,50 Qwen3.6 27B 0,60 3,60 Qwen3.8 27B 0,50 3,00 Mistral Large 3 0,50 1,50 gpt-oss-120b 0,15 0,60 Mistral Small 4 0,15 0,60 GLM-5.3 Flash 0,15 0,50 DeepSeek V4 Flash 0,14 0,28
У Mistral есть и кэшированный вход за $0,15: повторяющийся кусок промпта, например системные инструкции агента, стоит в 10 раз дешевле.
Тарифы чата Mistral: попробовать Medium 3.5 без скачивания
Попробовать модель без 75 ГБ весов можно в чате Mistral Le Chat: по карточке модели Medium 3.5 заменила там Medium 3.1 и Magistral. На странице тарифов Mistral чат теперь идёт под именем Vibe. Что бесплатный план открывает именно Medium 3.5, там прямо не сказано — написано «наши последние модели».План (25.10.2026) Цена Что даёт Free бесплатно ограниченное число сообщений и поисков, «последние модели», веб и мобильное приложение Pro $14,99 в месяц без налогов больше сообщений, программирование в CLI и IDE, ежемесячные кредиты на API Pro для студентов $5,99 в месяц для подтверждённых студентов, до 12 месяцев Team $24,99 за пользователя в месяц общее рабочее пространство, выше лимиты API $1,5 / $7,5 за 1M токенов оплата по факту, без подписки
Лимиты бесплатного плана Mistral в цифрах не публикует, поэтому для регулярной работы с длинными документами ориентир — Pro или API.
Риски Mistral Medium 3.5: когда цена, скорость и лицензия мешают
- Обычный игровой ПК. С одной RTX потолок около 1,4–2 токенов в секунду (оценка). Ответ в 500 токенов будет печататься не меньше 4–6 минут.
- Mac на 64 ГБ и меньше. Поместится только 2-битный квант, а это заметная потеря качества при той же низкой скорости.
- Агенты с длинным контекстом на M3 Ultra. По замеру Apple запрос в 64 тысячи токенов обрабатывается больше 18 минут.
- Экономия на API. На 25.10.2026 тариф $1,5/$7,5. Прежняя Medium 3 при запуске в мае 2025 года стоила, по анонсу Mistral, $0,4 за миллион входящих и $2 за миллион исходящих токенов — новая версия дороже в 3,75 раза. Открытые конкуренты из сравнения дешевле в 2,5–27 раз по выходу.
- Крупная компания. Если месячная выручка выше $20 млн, свободная лицензия не действует — нужна коммерческая.
- Решение по одним вендорским цифрам. 77,6% на SWE-bench — самоотчёт Mistral. На независимых шкалах модель в середине таблицы: AA 14, Vals 32,69%, Epoch ECI 141.
- Работа с картинками через Ollama. Источники противоречат друг другу. Если зрение критично, используйте llama.cpp с файлом mmproj и проверьте на своих изображениях.
Пользовательских отзывов о модели мало: по запросу «Mistral Medium 3.5 review» поиск выдаёт в основном каталоги моделей и пересказы анонса, а в октябрьских обсуждениях на Reddit и в X разговор ушёл к Large 4 и Qwen3.8. На Hacker News в день выхода спорили две позиции: «конкурирует с моделями в пять раз крупнее» и «дороже Haiku и китайских аналогов».
Кому брать Medium 3.5: API, Mac со 128 ГБ или модель поменьше
| Ваша ситуация | Что выбрать | Почему |
|---|---|---|
| Нужен европейский поставщик и свой хостинг | Medium 3.5 через API Mistral или на своём сервере | французский разработчик, открытые веса, запуск от 4 GPU |
| Mac Studio на 256–512 ГБ, приватные документы | Medium 3.5 в FP8 или Q8_0 | помещается с длинным контекстом; 5–8 ток/с по замеру Apple |
| Mac на 128 ГБ | Medium 3.5 в Q4_K_M, если нужна именно она; иначе DeepSeek V4 Flash или gpt-oss-120b | Medium влезает, но даёт ≈4–8 ток/с в зависимости от чипа (оценка) |
| ПК с одной RTX | Qwen3.8 27B или Qwen3.6 27B | Medium 3.5 упрётся в оперативную память |
| Агентный код за минимальные деньги по API | DeepSeek V4 Flash или GLM-5.3 Flash | индекс выше, цена выхода в 15–27 раз ниже |
Сильные и слабые стороны модели одним списком:Плюсы Минусы открытые веса, коммерция до $20 млн выручки в месяц плотная 128B — медленная дома контекст 256K, картинки, рассуждения по запросу индекс AA 14 против 34 у Qwen3.8 27B 77,6% SWE-bench по данным Mistral цена API выше всех открытых аналогов в сравнении работает в Ollama, llama.cpp, vLLM, SGLang баги первых GGUF, CUDA 13.2, спор о зрении в Ollama европейский разработчик, свой хостинг от 4 GPU нет независимых тестов украинского и русского
Доступ из Украины: веса скачиваются с Hugging Face без аккаунта Mistral, у локального запуска нет региональных ограничений. Оплату API украинской картой мы не проверяли.
Как мы оценивали Medium 3.5 без собственного прогона
Своего запуска модели у нас не было. Вывод собран из открытых источников, и каждая цифра в статье помечена: замер, самоотчёт разработчика или наш расчёт.
- Характеристики и лицензия — карточка модели и полный текст LICENSE на Hugging Face, блог и прайс Mistral.
- Размеры файлов — сумма частей каждого кванта из API Hugging Face, 25.10.2026.
- Качество — три независимые шкалы с разными методиками: Artificial Analysis, Vals AI, Epoch AI. Усреднять их нельзя.
- Скорость — замер Apple Machine Learning Research (15.10.2026) и наша оценка по открытой формуле. Все оценки в таблицах и на графиках помечены и заштрихованы.
- Железо — пропускная способность Mac из спецификаций Apple, видеопамять — со страниц NVIDIA.
Первыми устареют цены API, индексы Artificial Analysis (лаборатория пересчитывает их при смене версии индекса) и статус LM Studio. Свежие значения — на страницах Mistral и Artificial Analysis из списка источников.
FAQ
Можно ли скачать Medium 3.5 бесплатно и использовать в бизнесе?
Да. Веса бесплатно скачиваются с Hugging Face, а лицензия Modified MIT разрешает коммерческое использование. Единственное условие: если глобальная выручка вашей компании или работодателя за предыдущий месяц превысила $20 млн, нужна отдельная коммерческая лицензия Mistral. Ограничение распространяется и на производные модели — дообученные версии и кванты.
Сколько оперативной памяти нужно, чтобы запустить модель дома?
Для 4-битного кванта Q4_K_M (74,9 ГБ) нужно около 80 ГБ памяти суммарно. На Mac это ступень 128 ГБ: видеоядру по умолчанию доступно около 103 ГБ. На ПК — видеокарта плюс 64–96 ГБ оперативной памяти. Mac на 64 ГБ вместит только 2-битную версию с заметной потерей качества.
Потянет ли Medium 3.5 видеокарта RTX 4090 или RTX 5090?
Запустить можно, но с выгрузкой: ни одна потребительская карта не вмещает модель целиком, даже 2-битный квант весит 34,9 ГБ. Большая часть весов остаётся в оперативной памяти, и скорость упирается в неё. По нашей оценке потолок — около 1,8 токена в секунду на RTX 4090 и 2,1 на RTX 5090 с двухканальной DDR5.
Mistral Medium 3.5 или Qwen 3.6 27B — что лучше для кода?
По самоотчётам разница минимальна: 77,6% у Mistral и 77,2% у Qwen3.6-27B в SWE-bench Verified. На независимой шкале Artificial Analysis Qwen выше — 21 против 14, а новая Qwen3.8 27B набирает 34. Qwen меньше почти в пять раз, поэтому дома работает заметно быстрее и требует гораздо меньше памяти.
Работает ли Medium 3.5 в Ollama и LM Studio с картинками?
С текстом Ollama работает: команда ollama run mistral-medium-3.5 скачивает тег на 80 ГБ. С изображениями источники расходятся: страница Ollama отмечает поддержку зрения, а Unsloth пишет, что vision-GGUF в Ollama не работают. В LM Studio, судя по карточке модели, поддержка ещё в разработке. Для картинок надёжнее llama.cpp с файлом mmproj.
Чем Mistral Medium 3.5 отличается от Medium 3.1 и Mistral Large 4?
Medium 3.1 была закрытой моделью только для API и стоила дешевле. Medium 3.5 получила открытые веса, встроенные рассуждения и заменила Magistral и Devstral 2. Large 4 — следующая ступень линейки: у Artificial Analysis её индекс 38 против 14 у Medium 3.5, но пока это превью только через API: открытых весов на 25.10.2026 нет, Mistral обещает их позже.