Коротко: Mistral Medium 3.5 — відкрита 128B, але не для однієї RTX
Mistral Medium 3.5 — мовна модель французької Mistral AI, яка вийшла 29 квітня 2026 року. Її ваги відкриті на Hugging Face, і це головна відмінність від Medium 3 і 3.1, що працювали тільки через API. Проте слово Medium вводить в оману: це не «середня домашня» модель, а щільна мережа на 128 мільярдів параметрів.
- Коротко: Mistral Medium 3.5 — відкрита 128B, але не для однієї RTX
- Що таке Mistral Medium 3.5 і чим вона відрізняється від Medium 3.1
- Версії, розміри й ліцензія Modified MIT: що можна завантажити
- Бенчмарки Mistral Medium 3.5: цифри Mistral і незалежні виміри
- Як запустити Mistral Medium 3.5 локально: Ollama, llama.cpp, vLLM
- Скільки пам’яті потрібно моделі на 128B: кванти, Mac і RTX
- Швидкість генерації на Mac і RTX: вимір Apple та оцінка
- Mistral Medium 3.5 проти Qwen 3.6 27B, DeepSeek V4 Flash і gpt-oss
- Ризики Mistral Medium 3.5: коли ціна, швидкість і ліцензія заважають
- Кому брати Medium 3.5: API, Mac зі 128 ГБ чи модель менша
- Як ми оцінювали Medium 3.5 без власного прогону
- Часті запитання
- Що це: одна модель замість трьох — звичайний чат, режим міркувань (reasoning) і агентний код. Контекст 256 тисяч токенів, розуміє зображення, відповідає текстом.
- Ліцензія: Modified MIT. Безкоштовно для комерції, доки місячний виторг компанії не перевищує $20 млн.
- Ціна API на 25.10.2026: $1,5 за мільйон вхідних токенів і $7,5 за мільйон вихідних — дорожче за всіх відкритих конкурентів із нашого порівняння.
- Залізо: 4-бітна версія важить 74,9 ГБ. Її тягне Mac зі 128 ГБ єдиної пам’яті; одна відеокарта RTX не тягне — ваги доводиться тримати в оперативній пам’яті, і швидкість не вища за 1,4–2 токени за секунду (розрахункова стеля).
- Швидкість на Mac: Apple виміряла 7,70 токена за секунду на Mac Studio M5 Ultra і 4,95 на M3 Ultra (вихідні ваги FP8, контекст 8K, 15.10.2026).
- Якість: у незалежної Artificial Analysis індекс 14 за медіани 8 у відкритих моделей того самого розміру, а в Qwen3.8 27B і DeepSeek V4 Flash — по 34.
Що таке Mistral Medium 3.5 і чим вона відрізняється від Medium 3.1
Medium 3.5 — перша «об’єднана» флагманська модель Mistral: в одному наборі ваг зібрано виконання інструкцій, міркування і програмування. За карткою моделі вона замінила Medium 3.1 і Magistral у чат-боті Le Chat, а Devstral 2 — в агенті для коду Vibe.
Модель називають щільною (dense). Це означає, що під час генерації кожного токена працюють усі 128 мільярдів параметрів. У моделей MoE (mixture of experts, «суміш експертів») усе інакше: із сотень мільярдів параметрів на токен вмикається невелика частина. Для домашнього запуску ця різниця вирішальна, до неї ми повернемося в розділі про швидкість.
Що змінилося порівняно з Medium 3.1:

| Параметр | Medium 3 і 3.1 | Medium 3.5 |
|---|---|---|
| Ваги | закриті, тільки API | відкриті, Hugging Face |
| Ліцензія | комерційна через API | Modified MIT з порогом виторгу |
| Архітектура | не розкривалася | щільна 128B |
| Контекст | н/д | 256K (262 144 токени) |
| Вхід | н/д | текст і зображення, власний візуальний енкодер |
| Міркування | окрема модель Magistral | вбудовані, вмикаються на запит |
| Статус у Mistral | застарілі (deprecated) | актуальна |
Міркування вмикаються параметром reasoning_effort. Значення none дає швидку відповідь без роздумів, high — режим, у якому модель спершу «думає», а потім відповідає. Mistral радить high для складних запитів і агентного коду, з температурою 0,7.
Мов у метаданих картки 24, серед них українська й російська. Незалежних тестів якості цими мовами ми не знайшли, тож оцінки тут немає.
Місце в лінійці: вгорі стоїть Mistral Large 4 з індексом Artificial Analysis 38, внизу — Small 4 (індекс 11). Decrypt під час виходу Medium 3.5 писав, що Mistral бачить у ній сходинку до майбутнього великого флагмана. У жовтні Large 4 вийшла, але на 25.10.2026 це прев’ю тільки через API, без відкритих ваг.
Версії, розміри й ліцензія Modified MIT: що можна завантажити
Офіційний репозиторій називається Mistral Medium 3.5 128B. Mistral публікує ваги одразу у форматі FP8 (8 біт із рухомою комою) з візуальним енкодером у BF16: 121,8 млрд параметрів у FP8 і 5,9 млрд у BF16, разом близько 133,6 ГБ. Повну 16-бітну версію і стиснені варіанти Mistral Medium 3.5 у форматі GGUF збирає Unsloth.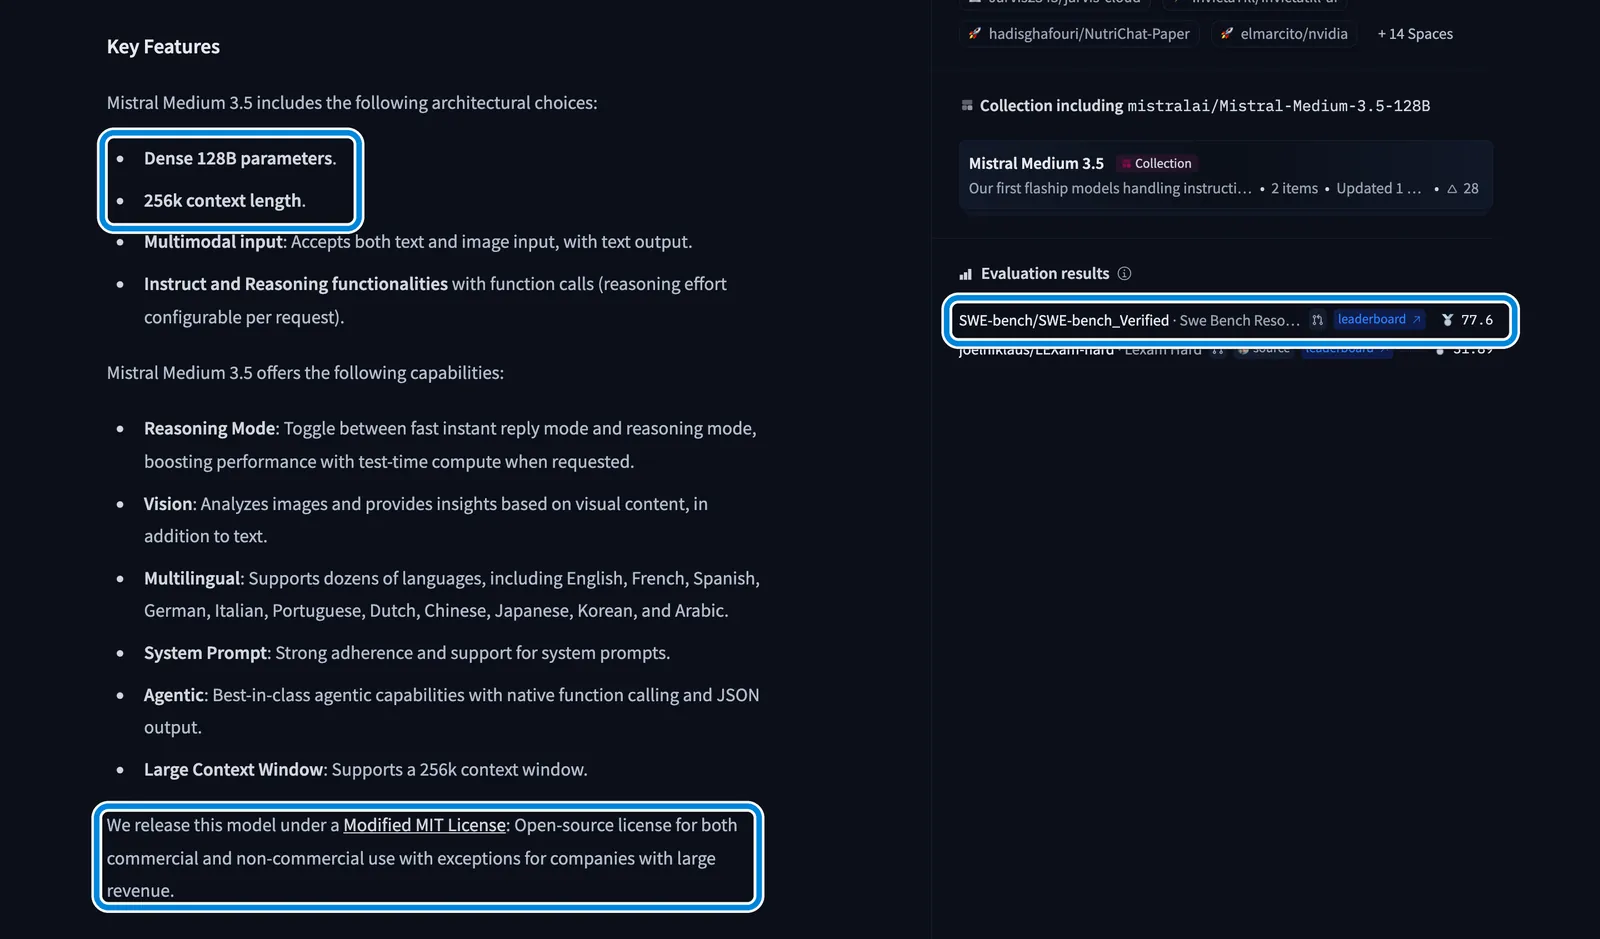
На скриншоті картки, знятому 25.10.2026, виділено три речі: «Dense 128B parameters» і «256k context length» у переліку характеристик, результат SWE-bench Verified 77,6 у блоці оцінок і рядок про ліцензію з винятком для компаній із великим виторгом.
Квантування — це стиснення ваг: кожне число зберігається меншою кількістю біт. Файл стає легшим, точність трохи падає. Позначення на кшталт Q4_K_M читаються так: Q4 — близько 4 біт на параметр, K_M — середній варіант алгоритму. Докладно про те, де починається помітна втрата якості, — у розборі квантування Q4 проти Q8.Що завантажити Розмір, ГБ Де Для чого FP8, оригінал Mistral ≈133,6 mistralai/Mistral-Medium-3.5-128B vLLM, SGLang на серверних GPU EAGLE-голова н/д mistralai/Mistral-Medium-3.5-128B-EAGLE прискорення vLLM і SGLang BF16 GGUF 250,1 unsloth еталон, удома майже не потрібен Q8_0 132,8 unsloth Mac на 192–256 ГБ Q4_K_M 74,9 unsloth стартовий вибір для Mac на 128 ГБ UD-Q4_K_XL 75,7 unsloth динамічний 4-біт, його радить Unsloth Q3_K_M 60,6 unsloth Mac на 96 ГБ Q2_K 46,6 unsloth Mac на 64 ГБ, із втратою якості Тег Ollama mistral-medium-3.580 ollama.com запуск однією командою
EAGLE — маленька допоміжна модель, яка вгадує кілька наступних токенів наперед, а велика лише перевіряє здогадки. Так генерація на сервері йде швидше.

Ліцензія Modified MIT — це звичайна MIT з однією умовою. Користуватися моделлю й похідними від неї (дотренованими версіями, квантами) не можна, якщо глобальний консолідований виторг вашої компанії або вашого роботодавця за попередній місяць перевищив $20 млн. Поріг обчислюють помісячно, а не за рік, як пишуть у деяких переказах. Понад поріг потрібна окрема комерційна ліцензія Mistral. Для фрилансера, студії чи малого бізнесу обмеження не діє.
Бенчмарки Mistral Medium 3.5: цифри Mistral і незалежні виміри
Бенчмарк — стандартний набір завдань, на якому моделі порівнюють за часткою правильних відповідей. Цифри бувають двох видів: ті, що публікує сам розробник, і ті, що отримали сторонні лабораторії на власних прогонах. Їх варто тримати в різних колонках.Тест Хто вимірював Результат Що перевіряє SWE-bench Verified Mistral, самозвіт 77,6% виправлення реальних помилок у репозиторіях на GitHub τ³-Telecom Mistral, самозвіт 91,4% агент підтримки, який працює з інструментами Intelligence Index v4.3.2 Artificial Analysis 14 (медіана класу — 8) зведений бал за міркуваннями, знаннями, кодом і агентами Vals Index Vals AI 32,69% середня точність на наборах Vals ECI Epoch AI 141, місце 115 зведений індекс можливостей Epoch
Картка Artificial Analysis на 25.10.2026 дає моделі індекс 14 і восьме місце з 67 серед відкритих моделей схожого розміру (в AA це клас 40–150 млрд параметрів). Окремі тести, з яких зібрано індекс, — у розділі Benchmarks на сторінці Mistral Medium 3.5. У частині каталогів досі висить «30» — це знімок попередньої версії індексу, порівнювати його з нинішніми цифрами не можна.
Графік показує розстановку на одній шкалі: Medium 3.5 випереджає gpt-oss-120b і Mistral Small 4, але поступається Qwen3.6 27B, а Qwen3.8 27B і DeepSeek V4 Flash набирають у 2,4 раза більше.Модель Архітектура Індекс AA v4.3.2 (25.10.2026) GLM-5.3 Flash MoE 320B, 18B активних 42 Qwen3.8 27B щільна 27B 34 DeepSeek V4 Flash MoE 284B, 13B активних 34 Qwen3.6 27B щільна 27,8B 21 Mistral Medium 3.5 щільна 128B 14 gpt-oss-120b MoE 117B, 5,1B активних 12 Mistral Small 4 MoE 119B, 6,5B активних 11 Mistral Large 3 MoE 675B, 41B активних 9
Чому вендорські 77,6% на SWE-bench не перетворюються на високий зведений бал. По-перше, це самозвіт: незалежного прогону SWE-bench Verified для Medium 3.5 у відкритих джерелах немає. По-друге, зведений індекс охоплює не лише код, а й міркування, знання та довгі агентні сценарії. Модель, заточена під агентів для коду, може бути сильною в одній дисципліні й середньою в решті.
Як запустити Mistral Medium 3.5 локально: Ollama, llama.cpp, vLLM
Локальний запуск означає, що модель працює на вашому комп’ютері без інтернету й без надсилання даних у Mistral. Ваги завантажуються з Hugging Face. Нижче — п’ять кроків від найпростішого шляху до серверного.
- Оберіть квант під свою пам’ять. Орієнтир — таблиця в наступному розділі. Для Mac на 128 ГБ це Q4_K_M або UD-Q4_K_XL, для 96 ГБ — Q3_K_M.
- Найпростіший шлях — Ollama. Встановіть Ollama і виконайте одну команду. Тег за замовчуванням важить 80 ГБ і підтримує контекст 256K.
ollama run mistral-medium-3.5
- Більше контролю — llama.cpp. Зберіть свіжу версію з GitHub. На Mac параметр
-DGGML_CUDA=OFF, підтримку Metal увімкнено за замовчуванням. Запуск просто з Hugging Face у режимі міркувань:
./llama.cpp/llama-cli \
    -hf unsloth/Mistral-Medium-3.5-128B-GGUF:UD-Q4_K_XL \
    --temp 0.7 \
    --chat-template-kwargs '{"reasoning_effort":"high"}'
- Власний API для застосунків — llama-server. Він піднімає OpenAI-сумісний сервер, до якого під’єднуються чат-клієнти й агенти:
./llama.cpp/llama-server \
    -hf unsloth/Mistral-Medium-3.5-128B-GGUF:UD-Q4_K_XL \
    --alias "mistral-medium-3.5" --port 8001 --temp 0.7 \
    --chat-template-kwargs '{"reasoning_effort":"none"}'
- Сервер компанії — vLLM або SGLang. Mistral рекомендує vLLM (нічну збірку) і пише, що модель працює від чотирьох GPU. Рецепт vLLM радить 8×H200, підходять і 4×B200. Один B200 вміщує ваги FP8, але майже не лишає місця під контекст 256K.
Що працює, а що ні, на 25.10.2026:Інструмент Текст Зображення Що врахувати Ollama так спірно сторінка Ollama позначає vision, Unsloth пише, що vision-GGUF в Ollama не працюють llama.cpp так так, із файлом mmproj GGUF, зібрані до 01.05.2026, ламають довгий контекст LM Studio н/д н/д у картці моделі значиться «WIP» vLLM, SGLang так так нічна збірка, серверні GPU Unsloth Studio так н/д вебінтерфейс Unsloth для запуску й дотренування
Три пастки найчастіше псують перший запуск. Перша — у конфігу Transformers була помилка, через яку падала якість на довгому контексті. Mistral виправила її комітом c4be198, а Unsloth 1 травня 2026 року перевипустила всі GGUF. Файли, завантажені раніше, варто замінити. Друга — CUDA 13.2: за попередженням Unsloth, на ній модель видає нісенітницю. Третя — зображення в Ollama: якщо потрібен аналіз картинок, надійніше llama.cpp з окремим файлом mmproj-BF16.gguf (5,4 ГБ).
Кому 128B не під силу, але хочеться модель того самого розробника вдома, варто подивитися на Mistral Small на своєму ПК: там той самий шлях через Ollama і llama.cpp, але на звичайній відеокарті.
Скільки пам’яті потрібно моделі на 128B: кванти, Mac і RTX
Правило просте: у пам’ять мають вміститися файл моделі й кеш контексту. Кеш контексту (KV-кеш) — це робоча пам’ять розмови, вона росте з довжиною листування. Unsloth рекомендує 64 ГБ сумарної пам’яті для 3-бітної версії, 80 ГБ — для 4-бітної і 128–170 ГБ — для 8-бітної.
Скільки важить контекст, видно з виміру Apple: на 65 536 токенах модель у FP8 зайняла до 158 ГБ, тобто понад 133,6 ГБ ваг пішло близько 24 ГБ. Цю надбавку ми переносимо й на кванти — це оцінка.
На графіку видно, що 4-бітний квант важить майже вдвічі менше за оригінал FP8, а між Q4_K_M і Q8_0 лежить різниця в 58 ГБ — це і є ціна переходу на сходинку пам’яті вище. Саме про це зазвичай питають запитом «Mistral Medium 3.5 size»: скільки важить файл і скільки пам’яті під нього брати.Квант Розмір файлу, ГБ Скільки біт на параметр UD-IQ2_XXS 34,9 близько 2, сильна втрата якості Q2_K 46,6 близько 2 Q3_K_M 60,6 близько 3 IQ4_XS 67,1 близько 4, компактний Q4_K_M 74,9 близько 4 Q5_K_M 88,3 близько 5 Q6_K 102,6 близько 6 Q8_0 132,8 8 FP8 (оригінал) ≈133,6 8 BF16 250,1 16
Mac: єдина пам’ять і ліміт відеоядра
У Mac немає окремої відеопам’яті — процесор і відеоядро ділять одну єдину пам’ять. Але macOS за замовчуванням віддає відеоядру не всю її, а близько 3/4: за логами llama.cpp це 412,3 ГБ на Mac із 512 ГБ і 40,2 ГБ на 48-гігабайтному Mac із macOS 26.3. Як перевірити й підняти ліміт командою sysctl, докладно описано в статті про те, скільки єдиної пам’яті потрібно Mac для ШІ.Пам’ять Mac Ліміт відеоядра, ГБ Що вміщується Де буває 64 ГБ ≈51,5 Q2_K з коротким контекстом M4 Max, M5 Max, M2 Ultra 96 ГБ ≈77,3 Q3_K_M з контекстом близько 16 ГБ; Q4_K_M без контексту, лише після sysctl M3 Ultra, M5 Ultra 128 ГБ ≈103,1 Q4_K_M з контекстом до ≈64K (оцінка); Q5_K_M з коротким M4 Max, M5 Max, M2 Ultra 192 ГБ ≈154,6 Q8_0 і FP8 з коротким контекстом M2 Ultra 256 ГБ ≈206,2 FP8 з контекстом 64K (158 ГБ за виміром Apple) M3 Ultra, M5 Ultra 512 ГБ 412,3 BF16 із запасом M3 Ultra, M5 Ultra
Ліміти в таблиці переведено в десяткові гігабайти, щоб порівнювати їх із розмірами файлів безпосередньо. Де логу немає, стоїть оцінка за правилом 3/4. Який Mac під які моделі взагалі має сенс купувати, зведено в хабі «Який Mac обрати».
ПК з RTX: відеопам’яті не вистачає жодній карті
Жодна споживча відеокарта NVIDIA не вміщує навіть найстисненіший квант: у RTX 5090 32 ГБ відеопам’яті (VRAM), у RTX 4090 — 24 ГБ, у RTX 3060 — 12 ГБ, а UD-IQ2_XXS важить 34,9 ГБ. Решту llama.cpp тримає у звичайній оперативній пам’яті й обробляє процесором — це називається вивантаженням (offload).Відеокарта VRAM, ГБ Скільки ОЗП потрібно під Q4_K_M Скільки ваг піде в ОЗП, ГБ RTX 5090 32 від 64 ГБ ≈42,9 RTX 4090 24 від 64 ГБ ≈50,9 RTX 3060 12 від 96 ГБ, на 64 ГБ — Q3_K_M ≈62,9
Запустити так можна, але швидко не буде: вирішує швидкість оперативної пам’яті, а не відеокарти. Докладніше — у наступному розділі.
Швидкість генерації на Mac і RTX: вимір Apple та оцінка
Швидкість генерації — скільки токенів за секунду модель видає у відповідь. Токен — шматочок слова, в українському тексті на слово в середньому припадає більше одного токена. У щільної моделі генерація впирається в пропускну здатність пам’яті: на кожен токен треба один раз прочитати всі ваги. Звідси формула стелі:
Стеля, ток/с ≈ пропускна здатність пам'яті, ГБ/с ÷ розмір ваг, ГБ
Оцінка, ток/с ≈ стеля × коефіцієнт 0,6–0,8
Вимір Apple на Mac Studio
Єдиний опублікований вимір цієї моделі на споживчому залізі зробила сама Apple. 15 жовтня 2026 року команда Apple Machine Learning Research прогнала модель у вихідній точності FP8 через mlx_lm.benchmark на Mac Studio з 512 ГБ і опублікувала таблиці швидкості.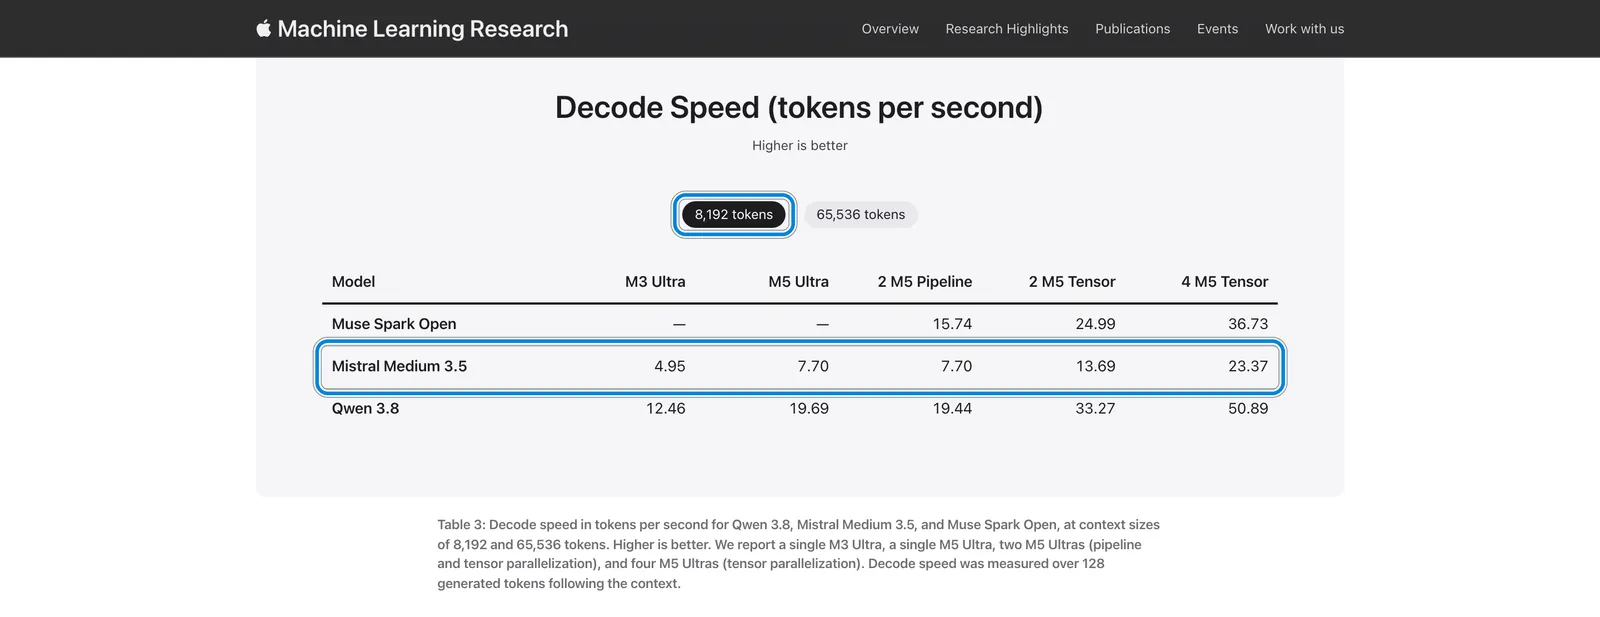
На скриншоті таблиці, знятому 25.10.2026, виділено вкладку «8,192 tokens» і рядок моделі: 4,95 токена за секунду на M3 Ultra, 7,70 на M5 Ultra і 23,37 на кластері з чотирьох M5 Ultra.Конфігурація (FP8, MLX) Генерація, 8K, ток/с Генерація, 64K, ток/с До першого токена, 8K, с До першого токена, 64K, с Mac Studio M3 Ultra 4,95 3,88 95,9 1097,9 Mac Studio M5 Ultra 7,70 6,16 24,6 273,0 2× M5 Ultra, тензорний паралелізм 13,69 11,05 14,4 154,1 4× M5 Ultra, тензорний паралелізм 23,37 18,92 7,5 80,0
Друга половина таблиці важливіша для агентів. Час до першого токена — це скільки модель читає ваш запит, перш ніж почати відповідати. На M3 Ultra запит на 64 тисячі токенів (великий шматок кодової бази) обробляється 1097,9 секунди, тобто понад 18 хвилин. M5 Ultra впорується за 273 секунди, близько 4,5 хвилини: у відеоядра нового покоління з’явилися прискорювачі множення матриць.
Вимір Apple ще й калібрує формулу. 819 ГБ/с ÷ 133,6 ГБ дають стелю 6,1 токена за секунду, реальні 4,95 — це 81% стелі. У M5 Ultra 1228,8 ГБ/с (пропускна здатність шини LPDDR5X, Apple округлює її до 1,2 ТБ/с) ÷ 133,6 ГБ = 9,2, реальні 7,70 — 84%.
Оцінка для 4-бітного кванта на Mac і RTX
Для Q4_K_M (74,9 ГБ) вимірів немає, тому нижче — оцінка. Коефіцієнт беремо в діапазоні 0,6–0,8: верх — те, що Apple отримала на цій моделі в MLX, низ — запас на llama.cpp і розпакування 4-бітних ваг, яке теж коштує обчислень. Для ПК з відеокартою рахуємо стелю за оперативною пам’яттю: двоканальна DDR5-5600 дає 5600 × 8 байтів × 2 канали = 89,6 ГБ/с. Це теоретичний пік. У старих ПК з RTX 3060 часто стоїть DDR4-3200 — це 51,2 ГБ/с, і стеля опускається приблизно до 0,8 токена за секунду.
Головне, що видно на графіку: навіть найкращий Mac зі стисненою моделлю видає близько 10–13 токенів за секунду, а ПК з однією відеокартою впирається в стелю близько 2.Конфігурація Пропускна здатність Квант Швидкість, ток/с Тип цифри Mac Studio M5 Ultra 1,2 ТБ/с Q4_K_M ≈ 9,8–13,1 (стеля 16,4) ≈ оцінка Mac Studio M3 Ultra 819 ГБ/с Q4_K_M ≈ 6,6–8,7 (стеля 10,9) ≈ оцінка Mac Studio M2 Ultra 800 ГБ/с Q4_K_M ≈ 6,4–8,5 (стеля 10,7) ≈ оцінка M5 Max, 40 ядер GPU 614 ГБ/с Q4_K_M ≈ 4,9–6,6 (стеля 8,2) ≈ оцінка M4 Max, 40 ядер GPU 546 ГБ/с Q4_K_M ≈ 4,4–5,8 (стеля 7,3) ≈ оцінка RTX 5090 + DDR5 89,6 ГБ/с на 42,9 ГБ в ОЗП Q4_K_M ≤ ≈2,1 ≈ оцінка, стеля RTX 4090 + DDR5 89,6 ГБ/с на 50,9 ГБ в ОЗП Q4_K_M ≤ ≈1,8 ≈ оцінка, стеля RTX 3060 12 ГБ + DDR5 89,6 ГБ/с на 62,9 ГБ в ОЗП Q4_K_M ≤ ≈1,4 ≈ оцінка, стеля API Mistral — — 162,5 вимір Artificial Analysis, 25.10.2026
Звідки різниця з виміром: 4-бітний файл легший за оригінал FP8 у 1,8 раза (74,9 проти 133,6 ГБ), але середина нашої оцінки для M3 Ultra (≈7,7) вища за вимір Apple (4,95) лише в 1,6 раза. Ми свідомо взяли коефіцієнт нижчий, ніж в Apple (0,7 проти 0,81): llama.cpp і розпакування 4-бітних ваг з’їдають частину виграшу. Це не перевірка оцінки, а її передумова — виміру Q4 на цій моделі поки немає. У MLX є власні 4-бітні кванти, і там коефіцієнт, найімовірніше, ближчий до верхньої межі. У відеокарт стелю пораховано так, наче частина ваг у VRAM читається миттєво, тому реальна швидкість буде нижчою.
Чому MoE тієї самої маси в рази швидша
gpt-oss-120b важить у 4 бітах 59 ГіБ, майже як Medium 3.5 у Q3, але це MoE: на кожен токен вмикається 5,1 млрд параметрів зі 117. У вимірі llama.cpp на M2 Ultra вона пише 79,68 токена за секунду, а наша оцінка для Medium 3.5 у Q4 на тому самому чипі — близько 7,5. Різниця в 10 разів за схожого обсягу пам’яті. Розробник Сальваторе Санфіліппо (antirez) писав в обговоренні анонсу на Hacker News, що DeepSeek V4 Flash у 2 бітах (GGUF на 86 ГБ) видає в нього близько 30 токенів за секунду на M3 Ultra — це користувацький вимір, а не методика лабораторії. Пам’ять купують під «скільки параметрів усього», а швидкість визначає те, скільки з них працює на токен.
Mistral Medium 3.5 проти Qwen 3.6 27B, DeepSeek V4 Flash і gpt-oss
Порівняння зібране під питання «що запускати вдома або дешево брати через API». Індекс і ціни — Artificial Analysis на 25.10.2026, архітектура й ліцензії — картки моделей.Модель Архітектура Ліцензія Індекс AA Вага для запуску Ціна API, $/1M вхід / вихід Medium 3.5 щільна 128B Modified MIT, поріг $20 млн/міс 14 74,9 ГБ (Q4_K_M) 1,50 / 7,50 Qwen3.6 27B щільна 27,8B Apache 2.0 21 н/д 0,60 / 3,60 Qwen3.8 27B щільна 27B Apache 2.0 34 н/д 0,50 / 3,00 DeepSeek V4 Flash MoE 284B, 13B активних MIT 34 86 ГБ (2 біти, за antirez) 0,14 / 0,28 GLM-5.3 Flash MoE 320B, 18B активних MIT 42 н/д 0,15 / 0,50 gpt-oss-120b MoE 117B, 5,1B активних Apache 2.0 12 59 ГіБ (MXFP4) 0,15 / 0,60 Mistral Small 4 MoE 119B, 6,5B активних Apache 2.0 11 н/д 0,15 / 0,60
Mistral Medium 3.5 vs Qwen 3.6 27B: майже нічия в SWE-bench
Ця пара цікава тим, що обидві моделі щільні, але Qwen менша майже вп’ятеро. За самозвітами розробників у SWE-bench Verified у Mistral 77,6%, у Qwen3.6-27B — 77,2% (останній стовпець таблиці в картці Qwen). Decrypt у своєму матеріалі навів для Qwen 72,4% — першоджерело цю цифру не підтверджує. На зведеній шкалі Artificial Analysis Qwen3.6 27B вища: 21 проти 14. А за залізом розрив величезний: за однакового кванта 27 млрд параметрів читаються на токен майже вп’ятеро швидше, ніж 128 млрд, і вміщуються в пам’ять, де Medium 3.5 не вміститься взагалі.
DeepSeek V4 Flash і gpt-oss: хто швидший удома
Якщо у вас Mac на 128–192 ГБ, DeepSeek V4 Flash виграє за обома параметрами — індекс 34 і, судячи зі звіту antirez, кратно більша швидкість. Докладний розбір — в огляді DeepSeek V4 Flash. gpt-oss-120b слабша за Medium за індексом (12 проти 14), зате вміщується у 80-гігабайтну відеокарту і в Mac на 96 ГБ, а працює в рази швидше. Як поставити її на свій ПК — у гайді з GPT-OSS локально.
За ціною API Medium 3.5 — найдорожча модель порівняння: вихідний мільйон токенів коштує $7,50, у Qwen3.8 27B — $3,00, у DeepSeek V4 Flash — $0,28.Модель Вхід, $/1M Вихід, $/1M Medium 3.5 1,50 7,50 Qwen3.6 27B 0,60 3,60 Qwen3.8 27B 0,50 3,00 Mistral Large 3 0,50 1,50 gpt-oss-120b 0,15 0,60 Mistral Small 4 0,15 0,60 GLM-5.3 Flash 0,15 0,50 DeepSeek V4 Flash 0,14 0,28
У Mistral є й кешований вхід за $0,15: повторюваний шматок промпту, наприклад системні інструкції агента, коштує в 10 разів дешевше.
Тарифи чату Mistral: спробувати Medium 3.5 без завантаження
Спробувати модель без 75 ГБ ваг можна в чаті Mistral Le Chat: за карткою моделі Medium 3.5 замінила там Medium 3.1 і Magistral. На сторінці тарифів Mistral чат тепер має назву Vibe. Що безкоштовний план відкриває саме Medium 3.5, там прямо не сказано — написано «наші найновіші моделі».План (25.10.2026) Ціна Що дає Free безкоштовно обмежену кількість повідомлень і пошуків, «найновіші моделі», веб і мобільний застосунок Pro $14,99 на місяць без податків більше повідомлень, програмування в CLI та IDE, щомісячні кредити на API Pro для студентів $5,99 на місяць для підтверджених студентів, до 12 місяців Team $24,99 за користувача на місяць спільний робочий простір, вищі ліміти API $1,5 / $7,5 за 1M токенів оплата за фактом, без підписки
Ліміти безкоштовного плану Mistral у цифрах не публікує, тож для регулярної роботи з довгими документами орієнтир — Pro або API.
Ризики Mistral Medium 3.5: коли ціна, швидкість і ліцензія заважають
- Звичайний ігровий ПК. З однією RTX стеля близько 1,4–2 токенів за секунду (оцінка). Відповідь на 500 токенів друкуватиметься щонайменше 4–6 хвилин.
- Mac на 64 ГБ і менше. Вміститься тільки 2-бітний квант, а це помітна втрата якості за тієї самої низької швидкості.
- Агенти з довгим контекстом на M3 Ultra. За виміром Apple запит на 64 тисячі токенів обробляється понад 18 хвилин.
- Економія на API. На 25.10.2026 тариф $1,5/$7,5. Попередня Medium 3 на старті в травні 2025 року коштувала, за анонсом Mistral, $0,4 за мільйон вхідних і $2 за мільйон вихідних токенів — нова версія дорожча в 3,75 раза. Відкриті конкуренти з порівняння дешевші у 2,5–27 разів за виходом.
- Велика компанія. Якщо місячний виторг понад $20 млн, вільна ліцензія не діє — потрібна комерційна.
- Рішення за самими вендорськими цифрами. 77,6% на SWE-bench — самозвіт Mistral. На незалежних шкалах модель посередині таблиці: AA 14, Vals 32,69%, Epoch ECI 141.
- Робота із зображеннями через Ollama. Джерела суперечать одне одному. Якщо зір моделі критичний, використовуйте llama.cpp із файлом mmproj і перевірте на своїх зображеннях.
Користувацьких відгуків про модель мало: за запитом «Mistral Medium 3.5 review» пошук видає здебільшого каталоги моделей і перекази анонсу, а в жовтневих обговореннях на Reddit і в X розмова перейшла до Large 4 і Qwen3.8. На Hacker News у день виходу сперечалися дві позиції: «конкурує з моделями вп’ятеро більшими» і «дорожча за Haiku та китайські аналоги».
Кому брати Medium 3.5: API, Mac зі 128 ГБ чи модель менша
| Ваша ситуація | Що обрати | Чому |
|---|---|---|
| Потрібен європейський постачальник і власний хостинг | Medium 3.5 через API Mistral або на своєму сервері | французький розробник, відкриті ваги, запуск від 4 GPU |
| Mac Studio на 256–512 ГБ, приватні документи | Medium 3.5 у FP8 або Q8_0 | вміщується з довгим контекстом; 5–8 ток/с за виміром Apple |
| Mac на 128 ГБ | Medium 3.5 у Q4_K_M, якщо потрібна саме вона; інакше DeepSeek V4 Flash або gpt-oss-120b | Medium вміщується, але дає ≈4–8 ток/с залежно від чипа (оцінка) |
| ПК з однією RTX | Qwen3.8 27B або Qwen3.6 27B | Medium 3.5 упреться в оперативну пам’ять |
| Агентний код за мінімальні гроші через API | DeepSeek V4 Flash або GLM-5.3 Flash | індекс вищий, ціна виходу в 15–27 разів нижча |
Сильні й слабкі сторони моделі одним списком:Плюси Мінуси відкриті ваги, комерція до $20 млн виторгу на місяць щільна 128B — повільна вдома контекст 256K, зображення, міркування на запит індекс AA 14 проти 34 у Qwen3.8 27B 77,6% SWE-bench за даними Mistral ціна API вища за всі відкриті аналоги в порівнянні працює в Ollama, llama.cpp, vLLM, SGLang баги перших GGUF, CUDA 13.2, суперечка про зір в Ollama європейський розробник, власний хостинг від 4 GPU немає незалежних тестів української та російської
Доступ з України: ваги завантажуються з Hugging Face без акаунта Mistral, у локального запуску немає регіональних обмежень. Оплату API українською карткою ми не перевіряли.
Як ми оцінювали Medium 3.5 без власного прогону
Власного запуску моделі в нас не було. Висновок зібрано з відкритих джерел, і кожна цифра в статті позначена: вимір, самозвіт розробника або наш розрахунок.
- Характеристики й ліцензія — картка моделі та повний текст LICENSE на Hugging Face, блог і прайс Mistral.
- Розміри файлів — сума частин кожного кванта з API Hugging Face, 25.10.2026.
- Якість — три незалежні шкали з різними методиками: Artificial Analysis, Vals AI, Epoch AI. Усереднювати їх не можна.
- Швидкість — вимір Apple Machine Learning Research (15.10.2026) і наша оцінка за відкритою формулою. Усі оцінки в таблицях і на графіках позначені й заштриховані.
- Залізо — пропускна здатність Mac зі специфікацій Apple, відеопам’ять — зі сторінок NVIDIA.
Першими застаріють ціни API, індекси Artificial Analysis (лабораторія перераховує їх у разі зміни версії індексу) і статус LM Studio. Свіжі значення — на сторінках Mistral і Artificial Analysis зі списку джерел.
Часті запитання
Чи можна завантажити Medium 3.5 безкоштовно й використовувати в бізнесі?
Так. Ваги безкоштовно завантажуються з Hugging Face, а ліцензія Modified MIT дозволяє комерційне використання. Єдина умова: якщо глобальний виторг вашої компанії або роботодавця за попередній місяць перевищив $20 млн, потрібна окрема комерційна ліцензія Mistral. Обмеження поширюється й на похідні моделі — дотреновані версії та кванти.
Скільки оперативної пам’яті потрібно, щоб запустити модель удома?
Для 4-бітного кванта Q4_K_M (74,9 ГБ) потрібно близько 80 ГБ пам’яті сумарно. На Mac це сходинка 128 ГБ: відеоядру за замовчуванням доступно близько 103 ГБ. На ПК — відеокарта плюс 64–96 ГБ оперативної пам’яті. Mac на 64 ГБ вмістить лише 2-бітну версію з помітною втратою якості.
Чи потягне Medium 3.5 відеокарта RTX 4090 або RTX 5090?
Запустити можна, але з вивантаженням: жодна споживча карта не вміщує модель повністю, навіть 2-бітний квант важить 34,9 ГБ. Більша частина ваг лишається в оперативній пам’яті, і швидкість упирається в неї. За нашою оцінкою стеля — близько 1,8 токена за секунду на RTX 4090 і 2,1 на RTX 5090 із двоканальною DDR5.
Mistral Medium 3.5 чи Qwen 3.6 27B — що краще для коду?
За самозвітами різниця мінімальна: 77,6% у Mistral і 77,2% у Qwen3.6-27B у SWE-bench Verified. На незалежній шкалі Artificial Analysis Qwen вища — 21 проти 14, а нова Qwen3.8 27B набирає 34. Qwen менша майже вп’ятеро, тому вдома працює помітно швидше й потребує значно менше пам’яті.
Чи працює Medium 3.5 в Ollama і LM Studio із зображеннями?
З текстом Ollama працює: команда ollama run mistral-medium-3.5 завантажує тег на 80 ГБ. Щодо зображень джерела розходяться: сторінка Ollama позначає підтримку зору, а Unsloth пише, що vision-GGUF в Ollama не працюють. У LM Studio, судячи з картки моделі, підтримка ще в розробці. Для зображень надійніше llama.cpp із файлом mmproj.
Чим Mistral Medium 3.5 відрізняється від Medium 3.1 і Mistral Large 4?
Medium 3.1 була закритою моделлю тільки для API і коштувала дешевше. Medium 3.5 отримала відкриті ваги, вбудовані міркування й замінила Magistral та Devstral 2. Large 4 — наступна сходинка лінійки: в Artificial Analysis її індекс 38 проти 14 у Medium 3.5, але поки це прев’ю тільки через API: відкритих ваг на 25.10.2026 немає, Mistral обіцяє їх пізніше.