
Коротко (TL;DR)
Whisper large-v3 локально — це найточніша відкрита модель розпізнавання мовлення від OpenAI, запущена на вашому комп’ютері: аудіо нікуди не йде, підписки немає, інтернет потрібен лише для завантаження файлу моделі. Для української вона помиляється приблизно в 6 словах зі 100 (WER 6,28% на наборі FLEURS), для російської — приблизно в 5 (4,96%).
- Коротко (TL;DR)
- Whisper large-v3 локально: що це і чим відрізняється від v2 і turbo
- Версії Whisper large-v3: розміри, ліцензія і вага файлів
- Точність large-v3 для української та російської: WER за FLEURS
- Large-v3 проти turbo, Parakeet і Voxtral: яку модель обрати
- Скільки пам’яті й часу займе розшифрування на RTX і Apple M4
- Як запустити Whisper локально: faster-whisper, whisper.cpp і MLX
- Ризики large-v3: галюцинації, повтори і вікна по 30 секунд
- Локальний Whisper чи хмарний API: скільки коштує година запису
- Яку модель Whisper узяти під подкаст, нараду і субтитри
- Часті запитання про локальне розшифрування мовлення
- Яка версія. Найновіші відкриті чекпойнти — large-v3 (листопад 2023) і large-v3-turbo (жовтень 2024). Моделі «large-v4» немає.
- Скільки важить. Повна large-v3 у форматі whisper.cpp — 2,9 GiB, стиснена до 5 біт — 1,1 GiB; turbo — 1,5 GiB і 547 MiB.
- Скільки пам’яті. Орієнтир OpenAI «~10 ГБ» стосується початкової реалізації; у faster-whisper та сама модель займає 4,5 ГБ відеопам’яті, у 8-бітному режимі — 2,9 ГБ. Вистачить відеокарти на 8 ГБ і будь-якого Mac на Apple Silicon.
- Швидкість. Година запису на RTX 3070 Ti — близько 5 хвилин, з пакетною обробкою — 1,3 хвилини (замір на large-v2, архітектура та сама); на M4 Max — 2,5 хвилини для large-v3 і 1,1 хвилини для turbo; на базовому M4 turbo у WhisperKit — 4,2 хвилини.
- turbo чи large-v3. turbo на Mac швидша приблизно в 2,3 раза і помиляється трохи частіше: +1 відсотковий пункт для української та російської. «У 8 разів швидше» — заява OpenAI для відеокарти A100 та англійського мовлення.
- Як запустити. NVIDIA — faster-whisper, Mac — mlx-whisper, будь-який комп’ютер — whisper.cpp. Команди з версіями — нижче.
Ця стаття про розшифрування готових файлів: подкасти, записи дзвінків, інтерв’ю, субтитри. Диктування в реальному часі, коли текст друкується під час мовлення, ми розібрали окремо — у матеріалі Wispr Flow чи свій Whisper. Усі заміри швидкості нижче чужі, із зазначенням стенда й методики; де заміру немає, швидкість не наводимо.
Whisper large-v3 локально: що це і чим відрізняється від v2 і turbo
Whisper — модель автоматичного розпізнавання мовлення (англійською ASR, automatic speech recognition). На вхід вона отримує звук, на виході віддає текст із мітками часу. Усередині два блоки: енкодер «слухає» 30-секундний фрагмент запису цілком і перетворює його на набір ознак, декодер за цими ознаками пише текст слово за словом. Лінійка складається з моделей різного розміру — від tiny до large, і що більша модель, то вона точніша й повільніша.
Дата виходу (release date) Whisper large-v3 — 6 листопада 2023 року, тоді OpenAI її анонсувала. Порівняння Whisper large-v3 vs v2 зводиться до трьох відмінностей:



- Вхід став детальнішим. Перед обробкою звук перетворюється на спектрограму — «картинку» частот. У v3 частотних смуг 128 замість 80, тобто модель розрізняє більше відтінків звуку.
- Даних стало більше. large-v3 навчали на 1 млн годин слабко розміченого аудіо (за готовими субтитрами) і 4 млн годин, які розмітила сама large-v2.
- Додалася кантонська мова окремим токеном.
За заявою OpenAI, large-v3 помиляється на 10–20% рідше, ніж v2, на широкому наборі мов. Це слова самої компанії; незалежна перевірка для української та російської — у розділі про точність нижче, і вона заяву загалом підтверджує.
Whisper large-v3-turbo вийшла 1 жовтня 2024 року. Це та сама large-v3, у якої декодер урізали з 32 шарів до 4, а енкодер залишили колишнім. Параметрів стало 809 млн замість 1550 млн. Логіка проста: частина, що «слухає», зберегла якість, а та, що «пише», стала в рази легшою, тому модель працює швидше. Ціна — трохи більше помилок і слабкий переклад: turbo донавчали без даних перекладу, і OpenAI прямо пише, що доброго перекладу англійською від неї не очікує.
Моделі «Whisper large-v4» не існує, хоча такий запит трапляється. Найновіші відкриті моделі розпізнавання мовлення OpenAI — large-v3 і large-v3-turbo. Нові ASR-моделі компанії (gpt-4o-transcribe та інші) доступні лише через платний API і локально не запускаються.
Версії Whisper large-v3: розміри, ліцензія і вага файлів
Та сама модель поширюється в кількох форматах — під різні програми запуску. Формат визначає, скільки файл важить на диску і скільки пам’яті займе під час роботи. Квантування — це стиснення ваг моделі: замість 16 біт на кожне число зберігається 8 або 5. Файл стає в 2–3 рази меншим, а точність зазвичай падає непомітно.
Скільки важить Whisper large-v3 у форматі ggml (його читає whisper.cpp) — за README проєкту на 25.10.2026:Модель Параметрів Файл ggml (повний) Файл ggml q5_0 Файл Q8_0 (Handy) Ліцензія large-v3 1550 млн 2,9 GiB 1,1 GiB 1,55 ГБ MIT (README) / Apache-2.0 (картка HF) large-v3-turbo 809 млн 1,5 GiB 547 MiB 0,83 ГБ MIT 
На скриншоті README whisper.cpp, знятому 25 жовтня 2026 року, рамкою виділено чотири рядки сімейства large-v3: повний файл і стиснений q5_0 для звичайної моделі та для turbo. Саме ці файли завантажує скрипт whisper.cpp.
З ліцензією є розбіжність, про яку варто знати. README репозиторію OpenAI каже, що код і ваги випущено під MIT. Метадані картки large-v3 на Hugging Face вказують Apache-2.0, картка turbo — знову MIT. Обидві ліцензії дозволяють комерційне використання, тому на практиці це нічого не змінює: розшифрування можна використовувати в роботі й продавати. Для юридично суворого проєкту пошліться на обидві.
Завантажити Whisper large-v3 найпростіше не вручну, а командою самої програми: вона візьме файл потрібного формату з Hugging Face.
- для faster-whisper — репозиторій
Systran/faster-whisper-large-v3(для turbo —mobiuslabsgmbh/faster-whisper-large-v3-turbo), завантажується сам під час першого запуску; - для mlx-whisper на Mac —
mlx-community/whisper-large-v3-mlxіmlx-community/whisper-large-v3-turbo; - для whisper.cpp — файли
ggml-large-v3.binіggml-large-v3-turbo-q5_0.binз репозиторіюggerganov/whisper.cppна Hugging Face або командаmake -j large-v3.
Початкові ваги у форматі PyTorch лежать на картці моделі — їх беруть openai/whisper і бібліотека Transformers.
Точність large-v3 для української та російської: WER за FLEURS
Точність розпізнавання вимірюють WER (word error rate) — часткою слів з помилкою: пропущених, зайвих і замінених. WER 5% означає, що на 1000 слів припаде близько 50 помилок. Власної таблиці WER за мовами для large-v3 OpenAI не публікує: у README є лише графік-картинка. Тому основне джерело нижче — незалежний бенчмарк Handy, який проганяє моделі на тестовій частині набору FLEURS (читання вголос, чистий запис) у кванті Q8_0.
На графіку видно, що для російської large-v3 попереду всіх Whisper, а для української щільна група: Parakeet v3 відстає від неї на пів пункту, turbo — приблизно на пункт.Модель Російська, WER % Українська, WER % Звідки Whisper large-v3 4,96 6,28 (ElevenLabs: 9,5) Handy; ElevenLabs — вендор Whisper large-v3-turbo 5,93 7,31 Handy Whisper large-v2 5,61 (OpenAI: 5,6) 8,17 (OpenAI: 8,6) Handy; стаття OpenAI Whisper medium 7,30 11,59 Handy Parakeet TDT 0.6B v3 6,54 (NVIDIA: 5,51) 6,84 (NVIDIA: 6,79) Handy; картка NVIDIA Voxtral Mini 4B Realtime 5,41 (Mistral: 6,02) мови немає Handy; картка Mistral 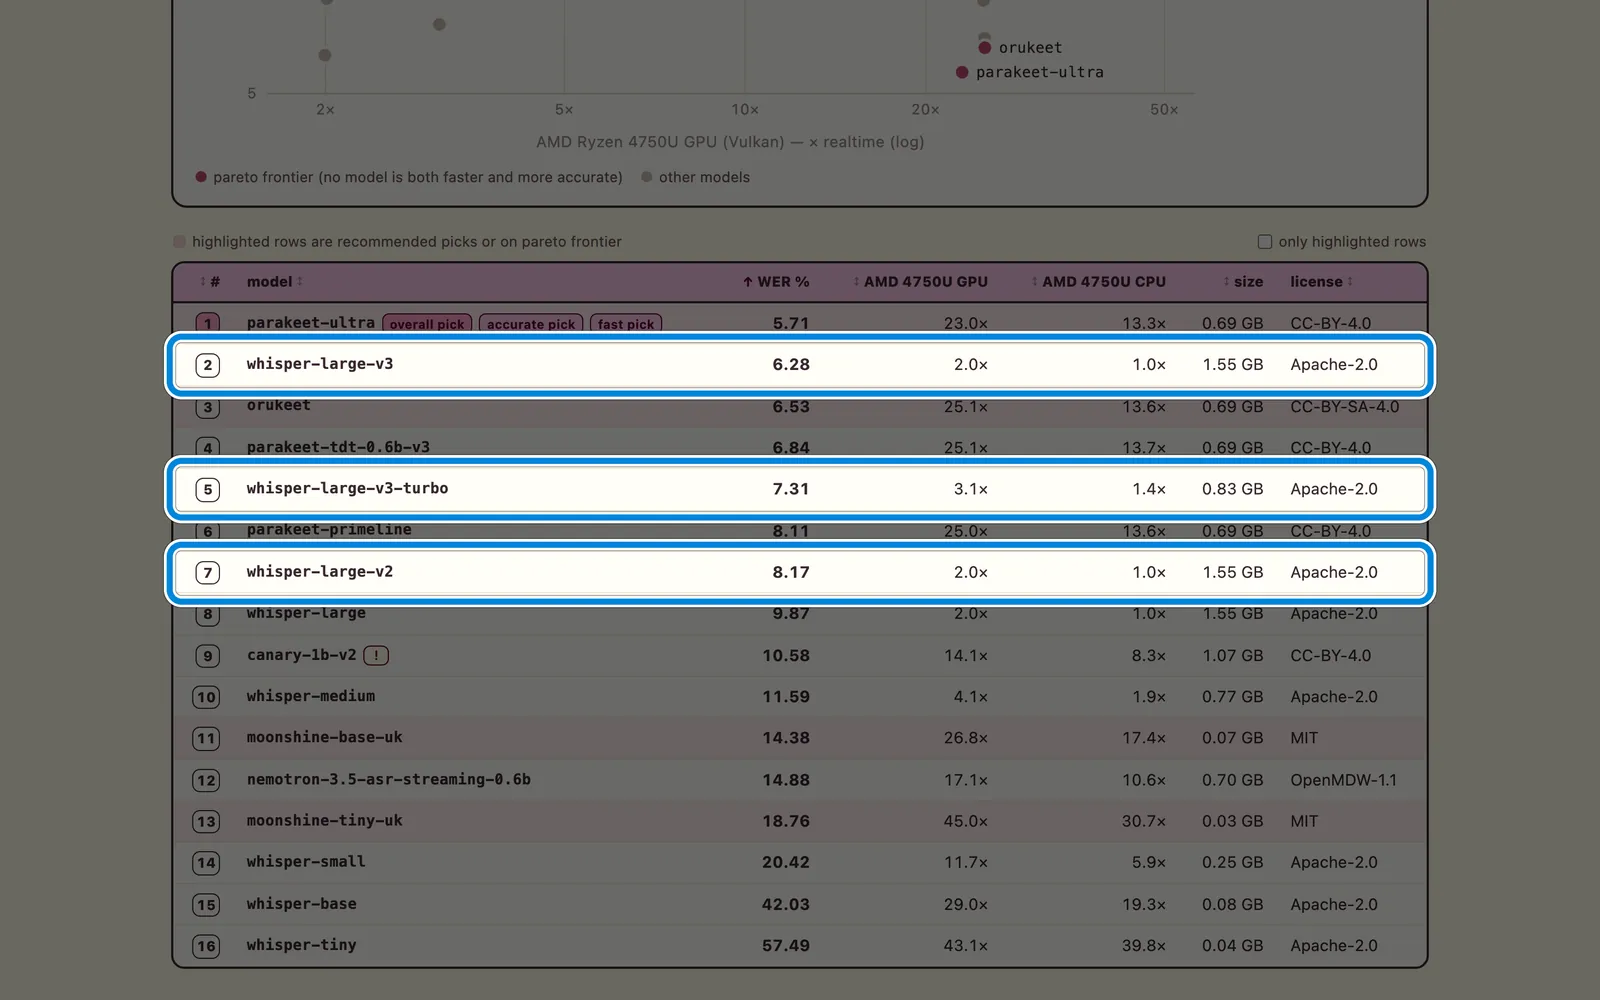
На скриншоті таблиці Handy для української, знятому 25 жовтня 2026 року, рамками виділено три рядки Whisper: large-v3 із 6,28%, turbo із 7,31% і large-v2 із 8,17%. Рядком вище large-v3 стоїть parakeet-ultra з 5,71% — це Parakeet TDT 0.6B v3, донавчена компанією Moondream (модель moondream/parakeet-ultra на Hugging Face, ліцензія CC BY 4.0, вересень 2026). Handy рекомендує її для української.
Що з цього випливає на практиці. Перехід з v2 на v3 зменшує помилки для російської на 12% (з 5,61 до 4,96), для української — на 23% (з 8,17 до 6,28). Заява OpenAI «на 10–20% менше помилок» для російської підтверджується, для української виграш навіть більший. turbo порівняно з large-v3 додає близько однієї помилки на кожні 100 слів: приблизно 59 помилок на 1000 слів замість 50 для російської. Порівняння Whisper large-v3 vs medium ще наочніше: для української менша medium помиляється в 11,59% слів проти 6,28%, тобто майже вдвічі частіше.
Чому одна модель дає і 4,96%, і 16%, і 20,8%
Читаючи огляди, легко заплутатися: про ту саму large-v3 пишуть і 4,96%, і 16%, і 20,8%. Усі три цифри можуть бути правильними, бо вимірюють різне:
- 4,96% — російська, FLEURS, чисте читання вголос (Handy).
- 16,0% — середнє за 45 мовами FLEURS у замірі Mistral, куди входять і складні для моделі мови. Це вендорний замір: Mistral продає конкурента, свій Voxtral.
- 20,8% — середнє за сімома російськими наборами з шумним і телефонним мовленням; російськомовний гайд toolfox переказує замір розробника конкурентної моделі (вторинне джерело).
Розрив 20,8% проти 4,96% — це різниця умов вимірювання, а не моделей: чисте читання вголос проти дзвінків і шуму. Тому порівнювати моделі можна лише за одним набором і однією методикою, як у таблиці вище.
Для української джерела розходяться сильніше: 6,28% у Handy і 9,5% в ElevenLabs. ElevenLabs методику нормалізації тексту не розкриває і продає власну модель Scribe, тому її цифру варто тримати як верхню межу. Ще один орієнтир — проєкт BuzzASR: у large-v3 без донавчання на українському FLEURS частка помилкових символів (CER) 2,99%, на Common Voice — 3,7%. CER завжди нижчий за WER, порівнювати їх безпосередньо не можна.
Як перевірити точність на своєму аудіо. Бенчмарк не знає ваших мікрофонів, акцентів і термінів. Візьміть 30–60 хвилин свого типового запису, розшифруйте 5–10 хвилин вручну як еталон і проженіть через дві моделі — наприклад, large-v3 і turbo. Порахувати WER можна Python-бібліотекою jiwer однією функцією wer(еталон, розшифрування). Різниця понад 2–3 пункти на вашому матеріалі важливіша за будь-яку таблицю.
Версії під російську — це не окремі моделі OpenAI, а донавчені спільнотою на російському мовленні варіанти Whisper large-v3. На Hugging Face найпопулярніша з них — antony66/whisper-large-v3-russian, донавчена на Common Voice 17 (близько 2,8 тис. завантажень за 30 днів на 25.10.2026), є й збірки для faster-whisper і MLX. Незалежного заміру цих версій на FLEURS у наших джерелах немає: донавчання на Common Voice може поліпшити одні записи й погіршити інші, тому порівнюйте їх із базовою large-v3 за методикою вище.
Large-v3 проти turbo, Parakeet і Voxtral: яку модель обрати
Порівняння Whisper large-v3 vs turbo майже завжди зводиться до одного компромісу: turbo швидша приблизно вдвічі, large-v3 точніша приблизно на пункт. Питання Whisper large-v3 vs Parakeet цікавіше: модель NVIDIA в рази швидша, для англійської навіть точніша, для української майже нарівні, але знає лише 25 європейських мов. Нижче — усе основне в одній таблиці.Модель Параметри Мови WER ru / uk, % Швидкість Ліцензія Чим запускати Whisper large-v3 1550 млн багатомовна, ru і uk є 4,96 / 6,28 база MIT / Apache-2.0 faster-whisper, whisper.cpp, MLX Whisper large-v3-turbo 809 млн ті самі, переклад слабкий 5,93 / 7,31 ≈ у 2,3 раза швидша на Mac MIT ті самі Parakeet TDT 0.6B v3 600 млн 25 європейських, ru і uk є 6,54 / 6,84 у 12 разів швидша за large-v3 на Ryzen 4750U (Handy) CC BY 4.0 NVIDIA NeMo, збірки для transcribe.cpp Voxtral Mini 4B Realtime 4 млрд 13, ru є, uk немає 5,41 / — потокова, відеокарта від 16 ГБ Apache 2.0 лише vLLM Voxtral Mini 3B 3 млрд 8, ru і uk немає — ~9,5 ГБ відеопам’яті Apache 2.0 за карткою моделі NVIDIA FastConformer UA ~115 млн лише українська uk 5,66 на Common Voice 12 легка CC BY 4.0 NVIDIA NeMo
Parakeet TDT 0.6B v3. Найсильніший суперник Whisper серед відкритих моделей. Для англійської (зведений лідерборд Open ASR) у середньому 6,34% WER проти приблизно 7,4% у large-v3. На українському FLEURS відставання від large-v3 лише пів пункту (6,84 проти 6,28), на російському — півтора пункту (6,54 проти 4,96) за заміром Handy; за карткою NVIDIA російська в Parakeet — 5,51%. Модель приймає до 24 хвилин аудіо за один прохід (на A100 80 ГБ) і працює від 2 ГБ пам’яті. Мінуси — менше мов і не така багата екосистема програм, як у Whisper.
Voxtral від Mistral. Тут треба розділити дві речі. Voxtral 3, анонсований 20 жовтня 2026 року, — це API-моделі: Mini Transcribe 3 коштує $0,0035 за хвилину, відкритих ваг в анонсі немає: на своєму сервері його можна розгорнути лише за договором із Mistral, завантажити й запустити на домашньому комп’ютері не можна. Відкриті моделі — попередні: Voxtral Mini 3B (без української та російської) і Voxtral Mini 4B Realtime. Остання російську розпізнає добре, але розрахована на потокове мовлення, потребує відеокарту від 16 ГБ і запускається лише через vLLM, а української не знає.
Українська модель NVIDIA (stt_ua_fastconformer_hybrid_large_pc) — вузькоспеціалізована й легка, 115 млн параметрів, WER 5,66% на Common Voice 12 (8,06% із пунктуацією та регістром). Це інший набір даних, ніж FLEURS, тому безпосередньо з Whisper її не порівняти, — але для суто українського архіву на слабкому залізі її варто перевірити.
Apple SpeechAnalyzer — системний розпізнавач macOS 26, без встановлення моделей. У тесті MacStories 34-хвилинне відео він розшифрував за 0:45 проти 1:41 у MacWhisper з large-v3-turbo, тобто у 2,2 раза швидше. Чи підтримує він українську, ми підтвердити не змогли: перевірте список SpeechTranscriber.supportedLocales на своєму Mac.
Підсумок порівняння: для російської та змішаного мовлення — Whisper large-v3, для швидкості на Mac — turbo, для англійської та великих обсягів на відеокарті NVIDIA — Parakeet, для української — порівняти large-v3 і Parakeet на своєму матеріалі.
Скільки пам’яті й часу займе розшифрування на RTX і Apple M4
Спочатку про пам’ять. Відеопам’ять (VRAM) — пам’ять відеокарти, куди завантажується модель; якщо модель не вмістилася, програма або впаде, або перейде на повільний процесор. У Mac замість неї єдина пам’ять: один спільний обсяг для процесора і графіки.
Графік показує, що страшна на вигляд цифра «~10 ГБ» з README OpenAI стосується початкової реалізації на PyTorch, а оптимізовані програми обходяться вдвічі-втричі меншим обсягом.Режим Пам’ять, ГБ Що це Орієнтир OpenAI, large ~10 початкова реалізація openai/whisper Орієнтир OpenAI, turbo ~6 те саме faster-whisper fp16, пакет із 8 6,1 замір, RTX 3070 Ti, large-v2 openai/whisper fp16 4,7 замір, там само faster-whisper fp16 4,5 замір, там само whisper.cpp fp16 4,1 замір, там само faster-whisper int8 2,9 замір, там само
Заміри взято з README faster-whisper: відеокарта RTX 3070 Ti 8 ГБ, CUDA 12.4, 13 хвилин аудіо, модель large-v2. У large-v3 та сама архітектура і та сама кількість параметрів, тому порядок цифр зберігається. Звідси просте правило: на відеокарті від 8 ГБ large-v3 працює в будь-якому режимі оптимізованих програм, на 6 ГБ — у fp16 без пакетного режиму або в int8, а найлегший варіант сімейства — turbo у форматі q5_0, файл 547 MiB.Відеокарта Відеопам’ять large-v3 fp16 large-v3 int8 Прямий замір швидкості large-v3 RTX 3060 12 ГБ (є і версія на 8 ГБ) вміщується вміщується немає RTX 3070 Ti 8 ГБ вміщується (4,5 ГБ) вміщується (2,9 ГБ) є, для large-v2 RTX 4090 24 ГБ вміщується з великим запасом вміщується немає RTX 5090 32 ГБ вміщується з великим запасом вміщується немає
Обсяг пам’яті карт — за специфікаціями NVIDIA. Замірів large-v3 на RTX 3060, 4090 і 5090 зі зрозумілою методикою у відкритих джерелах ми не знайшли, тому цифр швидкості для них не наводимо: за пропускною здатністю пам’яті їх не перерахувати. Зрозуміло одне: на будь-якій із цих карт large-v3 упреться не в пам’ять, а в програму запуску. Як ці самі карти поводяться з мовними моделями, ми зібрали в огляді RTX 5090, 4090 і 3090 у локальних LLM.
Тепер швидкість. Її зручно вимірювати у скільки разів швидше за реальний час (×RT): 12× означає, що година запису розшифрується за 5 хвилин.
Найпомітніше на графіку: пакетний режим faster-whisper на тій самій 8-гігабайтній карті прискорює роботу майже вчетверо, M4 Max із turbo розшифровує годину приблизно за хвилину, а рядки WhisperKit майже не залежать від класу чипа.Залізо і програма Модель ×RT Хвилин на 1 годину Звідки RTX 3070 Ti 8 ГБ, openai/whisper fp16 large-v2 5,5 11 замір, faster-whisper README RTX 3070 Ti 8 ГБ, whisper.cpp fp16 large-v2 12,0 5,0 замір, там само RTX 3070 Ti 8 ГБ, faster-whisper fp16 large-v2 12,4 4,8 замір, там само RTX 3070 Ti 8 ГБ, faster-whisper fp16, пакет із 8 large-v2 45,9 1,3 замір, там само M4 Max (40 ядер GPU, 128 ГБ) large-v3 24 2,5 замір vllm-mlx, кліп 46,7 с M4 Max (40 ядер GPU, 128 ГБ) large-v3-turbo 55 1,1 замір, там само M4 Pro, WhisperKit 0.13.1 (нейрорушій) large-v3-turbo 16,8 3,6 замір Argmax, 2 записи по 10 хв M4, WhisperKit 0.13.1 (нейрорушій) large-v3-turbo 14,4 4,2 замір, там само M2, WhisperKit 0.13.1 (нейрорушій) large-v3-turbo 12,4 4,9 замір, там само Mac (чип не вказано), MacWhisper large-v2 8,7 6,9 замір MacStories, відео 34 хв Mac (чип не вказано), MacWhisper large-v3-turbo 20,2 3,0 замір, там само Ryzen 4750U, вбудована графіка (Vulkan), transcribe.cpp large-v3 2,0 30 замір Handy Ryzen 4750U, вбудована графіка (Vulkan), transcribe.cpp large-v3-turbo 3,1 19 замір Handy
Перерахунок у хвилини — наш: 60 ÷ ×RT. Вихідні секунди: у бенчмарку faster-whisper 13 хвилин аудіо оброблено за 2 хв 23 с (openai/whisper), 1 хв 05 с (whisper.cpp), 1 хв 03 с (faster-whisper) і 17 с (пакет із 8). Це єдиний прямий замір на відеокарті RTX із повною методикою.
Звідки «у 8 разів швидше» і чому у вас буде менше. Таблиця OpenAI порівнює turbo з large на відеокарті A100 та англійському мовленні. Два незалежні заміри на Mac дають однакове співвідношення — близько 2,3 раза: у vllm-mlx 55× проти 24× (M4 Max), у MacStories 1:41 проти 3:55 (MacWhisper, щоправда, проти large-v2). Блоги називають 4–5 разів. Прискорення turbo — це виграш на декодері, а енкодер в обох моделей однаковий, тому що більше часу йде на «слухання», то скромніша різниця.
Чому клас чипа майже не важливий. WhisperKit — програма Argmax, яка запускає Whisper на нейрорушії Mac (Neural Engine — окремий блок чипа для нейромереж) через Core ML. У її відкритому бенчмарку M4 Pro, у якого графічних ядер удвічі більше, ніж у M4, розшифровує turbo лише на 16% швидше (16,8× проти 14,4×), а базовий M2 відстає від M4 Pro на чверть. MLX і whisper.cpp обчислюють на графіці, і там старший чип виграє сильніше: M4 Max з MLX — 55× на turbo. Порівнянних замірів MLX на M4 і M4 Pro ми не знайшли, а рядки різних програм і записів безпосередньо не порівнюються. Висновок для купівлі: Mac для самого лише розшифрування можна брати базовий — година запису займе 4–5 хвилин. Як улаштована єдина пам’ять Mac і скільки її потрібно для мовних моделей — в окремому розборі; там вимоги зовсім інші.
Яка програма швидша на Mac. У порівнянні mac-whisper-speedtest на MacBook Pro M4 24 ГБ короткий кліп моделлю turbo оброблено за 1,02 с у mlx-whisper, за 1,23 с у whisper.cpp з Core ML і за 6,96 с у faster-whisper на процесорі. Висновок: на Mac faster-whisper не беріть — він не вміє працювати з графікою Apple.
Скільки займе ваш архів: розрахунок
Формула одна: хвилини роботи = години запису × 60 ÷ ×RT. Приклад для архіву подкастів на 40 годин:Де розшифровуємо ×RT Час на 40 годин Розрахунок RTX 3070 Ti, faster-whisper fp16 12,4 ≈ 3 год 14 хв 40 × 60 ÷ 12,4 RTX 3070 Ti, faster-whisper, пакет із 8 45,9 ≈ 52 хв 40 × 60 ÷ 45,9 M4 Max, large-v3-turbo 55 ≈ 44 хв 40 × 60 ÷ 55 M4, WhisperKit, large-v3-turbo 14,4 ≈ 2 год 47 хв 40 × 60 ÷ 14,4 Ноутбук на Ryzen 4750U (вбудована графіка), large-v3 2,0 ≈ 20 год 40 × 60 ÷ 2
Підставте свій ×RT з таблиці вище. Якщо результат більший, ніж ви готові чекати, спершу перемкніться на turbo або пакетний режим — це безкоштовно, — і лише потім думайте про нове залізо.
Як запустити Whisper локально: faster-whisper, whisper.cpp і MLX
Нижче три шляхи з версіями на 25 жовтня 2026 року: faster-whisper 1.2.1, mlx-whisper 0.4.3, whisper.cpp v1.9.5. Команди взято з офіційних README; ми наводимо їх як є, без власного прогону. Оберіть шлях під своє залізо:Ваше залізо Програма Чому Windows або Linux із відеокартою NVIDIA faster-whisper найшвидша на CUDA, є пакетний режим Mac на Apple Silicon (M1–M5) mlx-whisper працює на графіці Apple, найшвидша на Mac Будь-який комп’ютер, AMD, Intel, без Python whisper.cpp одна програма на C++, CUDA, Vulkan, Core ML або процесор
Windows або Linux з NVIDIA: faster-whisper за п’ять кроків
faster-whisper — переписаний Whisper на рушії CTranslate2. Йому потрібен Python 3.9 або новіший, а для відеокарти — бібліотеки NVIDIA cuBLAS і cuDNN 9 для CUDA 12. Окремо встановлювати FFmpeg не потрібно: звук декодує вбудована бібліотека.
- Встановіть Python 3.9+ і драйвер NVIDIA з підтримкою CUDA 12.
- Створіть віртуальне середовище і встановіть пакет:
python -m venv whisper-env
source whisper-env/bin/activate        # Windows: whisper-env\Scripts\activate
pip install faster-whisper
- Створіть файл
transcribe.py:
from faster_whisper import WhisperModel

model = WhisperModel("large-v3", device="cuda", compute_type="float16")
# мало відеопам'яті: compute_type="int8_float16"; без відеокарти: device="cpu", compute_type="int8"

segments, info = model.transcribe("zapys.mp3", beam_size=5, language="uk", vad_filter=True)
print("Мова:", info.language, info.language_probability)
for s in segments:
    print(f"[{s.start:.1f} → {s.end:.1f}] {s.text}")
- Запустіть
python transcribe.py. Під час першого запуску завантажиться модельSystran/faster-whisper-large-v3. - Для прискорення в 3–4 рази увімкніть пакетний режим:
BatchedInferencePipeline(model=model)іtranscribe("zapys.mp3", batch_size=8). Пакет із 8 у fp16 займає 6,1 ГБ, тому на карті 8 ГБ не піднімайте його вище;batch_size=16— для карт від 12 ГБ. Для turbo замініть"large-v3"на"turbo".
Параметр vad_filter=True вмикає VAD (voice activity detection) — фільтр, який вирізає тишу до розпізнавання. Це помітно зменшує вигаданий текст на паузах.
Mac на Apple Silicon: mlx-whisper
MLX — фреймворк Apple для машинного навчання на чипах серії M. Встановлення займає одну команду, але є пастка.
pip install mlx-whisper
mlx_whisper zapys.mp3 --model mlx-community/whisper-large-v3-turbo --language uk -f srt
Пастка: без параметра --model програма бере крихітну whisper-tiny (близько 74 МБ), і розшифрування виходить поганим. Це часта причина відгуків «Whisper на Mac помиляється». Для повної моделі вкажіть mlx-community/whisper-large-v3-mlx. Формат виводу задає -f: txt, srt, vtt або json.
Альтернатива без Python — WhisperKit від Argmax: brew install whisperkit-cli, працює на нейрорушії; саме його заміри на M2, M4 і M4 Pro наведено в таблиці швидкості.
Будь-який комп’ютер: whisper.cpp
whisper.cpp — реалізація Whisper на C/C++ від автора llama.cpp, із тим самим форматом файлів ggml; про її «старшого брата» для мовних моделей — у порівнянні Ollama, LM Studio і llama.cpp. Працює на процесорі, відеокартах NVIDIA (CUDA) і AMD/Intel (Vulkan), а на Mac уміє віддавати енкодер нейрорушію через Core ML — це більш ніж утричі швидше, ніж лише процесор.
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
cmake -B build -DGGML_CUDA=1          # NVIDIA; для AMD та Intel: -DGGML_VULKAN=1; Mac: без прапорця (Metal)
cmake --build build -j --config Release
make -j large-v3-turbo                # завантажить модель; повна — make -j large-v3
ffmpeg -i zapys.mp3 -ar 16000 -ac 1 -c:a pcm_s16le zapys.wav
./build/bin/whisper-cli -m models/ggml-large-v3-turbo.bin -f zapys.wav -l uk -osrt
Дві деталі, на яких спотикаються найчастіше: whisper-cli читає лише 16-бітний WAV (звідси рядок з ffmpeg), а мова за замовчуванням у нього англійська. Без -l uk або -l auto українське мовлення перетвориться на англійський текст. Прапорці -otxt, -osrt і -ovtt зберігають результат у текст або субтитри.
Типові помилки під час запуску і як їх виправити
- faster-whisper не знаходить бібліотеки cuDNN. Зазвичай встановлено cuDNN 8 або CUDA 11, а свіжим версіям потрібен cuDNN 9 для CUDA 12. Або оновіть бібліотеки NVIDIA, або відкотіть ctranslate2, як описано в README.
- Відеопам’ять закінчилася. Перемкніться на
compute_type="int8_float16"або turbo; закрийте ігри та браузер з апаратним прискоренням. - На Mac усе повільно. Перевірте, що запускаєте mlx-whisper або whisper.cpp, а не faster-whisper: останній працює лише на процесорі.
- Перший запуск whisper.cpp з Core ML триває хвилини. Це компіляція моделі під нейрорушій, вона відбувається один раз.
- Текст англійською замість мови запису. Не вказано мову:
-l ukу whisper.cpp,language="uk"у faster-whisper,--language ukу MLX.
Ризики large-v3: галюцинації, повтори і вікна по 30 секунд
Коли large-v3 не підходить без доопрацювання? Whisper — сильна модель, але в неї є відомі слабкі місця. Їх корисно знати до того, як ви віддасте розшифрування клієнтові або до суду.
- Галюцинації — текст, якого не було в записі. Картка large-v3 прямо попереджає: модель може видавати несказані фрази і схильна до повторів, особливо на тиші, музиці та шумі. Дослідження Careless Whisper знайшло вигадані фрази приблизно в 1% записів, і 38% із них містили явну шкоду — насильство, хибні зв’язки, хибний авторитет. Важливе застереження: це перевірка версій Whisper 2023 року, до large-v3, — орієнтир для сімейства, а не замір v3. Лікування — VAD-фільтр і вибіркова перевірка там, де помилка коштує дорого: медицина, юриспруденція, цитати.
- Регрес проти v2 на окремих записах. На форумі OpenAI користувач порівняв моделі на 20 записах дзвінків і отримав кращий результат у large-v2 в усіх випадках, крім двох. Ішлося про переклад дзвінків англійською, і це окреме спостереження, а не бенчмарк, але висновок корисний: для свого типу записів порівняйте v2 і v3 на десятку файлів.
- Вікна по 30 секунд. Whisper слухає запис фрагментами по 30 секунд, а довгий файл програма ріже і склеює. На стиках слова можуть губитися або дублюватися: 24 жовтня 2026 року в одному з проєктів на whisper.cpp описали втрату слів на кожній межі вікна в режимі
--no-timestamps. Допомагають VAD, режим із мітками часу і перевірка стиків на зразку. - turbo погано перекладає. Якщо потрібен переклад англійською просто з мовлення (
task="translate"), беріть large-v3, а не turbo. - Немає розділення за мовцями. Whisper не каже, хто вимовив фразу. Для протоколів дзвінків потрібна надбудова з діаризацією — розміткою «хто говорить», наприклад WhisperX: за заявою авторів — 70× реального часу для large-v2 у пакетному режимі і менше 8 ГБ відеопам’яті.
- Різні версії програм дають трохи різний текст. Оновлення MLX або whisper.cpp може змінити розшифрування окремих фраз. Для відтворюваного результату фіксуйте версії пакетів.
- Приватність — сильна сторона, але не автоматична. Локальна модель не надсилає звук назовні, проте обгортки та GUI-застосунки бувають із телеметрією або хмарними функціями. Для конфіденційних записів використовуйте програми з цього гайду і за потреби вимикайте мережу.
Локальний Whisper чи хмарний API: скільки коштує година запису
Локальне розшифрування безкоштовне, якщо комп’ютер у вас уже є: платите лише за електрику. Хмара бере гроші за хвилину, зате не потребує заліза. Ціни OpenAI API на 25 жовтня 2026 року: gpt-4o-transcribe — $0,006 за хвилину, gpt-4o-mini-transcribe — $0,003, gpt-transcribe — $0,0045. Класичної моделі whisper-1 на сторінці цін немає. У Mistral Mini Transcribe 3 — $0,0035 за хвилину.Обсяг на місяць gpt-4o-transcribe gpt-4o-mini-transcribe Mistral Mini Transcribe 3 Локально 10 годин $3,60 $1,80 $2,10 лише електрика 100 годин $36 $18 $21 лише електрика 500 годин $180 $90 $105 лише електрика
Розрахунок: години × 60 × ціна за хвилину. Висновок: якщо на місяць набирається десяток годин, хмара коштує копійки, і купувати залізо заради Whisper сенсу немає. Локальний запуск виграє у трьох випадках: записи не можна віддавати третім особам, обсяг сягає сотень годин або відеокарта чи Mac уже стоять на столі.
Яку модель Whisper узяти під подкаст, нараду і субтитри
Зведемо все в одну таблицю рішень. Цифри швидкості — з розділу про пам’ять і швидкість.Завдання Залізо Модель Програма Чому Архів подкастів, інтерв’ю NVIDIA від 8 ГБ large-v3 faster-whisper, пакетний режим максимум точності, година за 1–2 хвилини Архів на Mac будь-який Apple Silicon large-v3-turbo mlx-whisper у 2,3 раза швидша за large-v3, +1 п.п. помилок Протокол дзвінка з учасниками NVIDIA від 8 ГБ large-v3 WhisperX діаризація «хто говорить» Субтитри до відео будь-яке large-v3-turbo whisper.cpp -osrt або mlx-whisper -f srtготовий файл субтитрів з таймкодами Український архів будь-яке large-v3 і Parakeet v3 (або її донавчена версія parakeet-ultra) — порівняти faster-whisper або whisper.cpp різниця на FLEURS лише 0,56 п.п. Слабкий ноутбук без відеокарти вбудована графіка (Vulkan) large-v3-turbo whisper.cpp або Handy близько 19 хвилин на годину запису на Ryzen 4750U (замір Handy в його рушії transcribe.cpp) Голосове введення в редакторі будь-яке turbo застосунок для диктування потрібен відгук, а не точність архіву
Для останнього рядка ми розбирали окремий сценарій — голосове введення в Claude Code, там інша логіка: важлива затримка, а не точність годинного архіву.
Якщо ви ще тільки обираєте комп’ютер, урахуйте, що Whisper — легке завдання щодо пам’яті: йому вистачає базового Mac або відеокарти на 8 ГБ. Вимоги до пам’яті задають мовні моделі, а не розпізнавання мовлення, тому підбирати Mac краще за ними — у путівнику який Mac обрати для локального ШІ. Для самого лише Whisper різниця між базовим і старшими чипами — хвилини, а не «працює чи ні»: turbo у WhisperKit розшифровує годину запису на M4 за 4,2 хвилини, на M4 Pro — за 3,6.
Що застаріє першим. Ціни API, версії програм і рейтинги Handy змінюються найшвидше — звіряйте їх на сторінках джерел. Самі моделі large-v3 і turbo не змінювалися з 2024 року.
Часті запитання про локальне розшифрування мовлення
Скільки відеопам’яті потрібно для Whisper large-v3 і turbo?
Для large-v3 в оптимізованих програмах — від 3 до 6 ГБ: замір faster-whisper дає 4,5 ГБ у fp16, 2,9 ГБ в int8 і 6,1 ГБ у пакетному режимі. Орієнтир OpenAI «~10 ГБ» для large і «~6 ГБ» для turbo стосується початкової реалізації на PyTorch. Відеокарта на 8 ГБ підходить для будь-якого режиму, на 6 ГБ — для int8 або turbo.
Whisper large-v3 розуміє українську і наскільки точно?
Так. На наборі FLEURS незалежний бенчмарк Handy дає large-v3 6,28% WER, turbo — 7,31%, попередній large-v2 — 8,17%. Вендор ElevenLabs називає 9,5%, але методику не розкриває і продає конкурента. Parakeet v3 від NVIDIA для української майже не поступається — 6,84%, тому для українського архіву варто порівняти обидві моделі на своїх записах.
Чим відрізняється large-v3 від large-v3-turbo і що швидше на Mac?
turbo — та сама large-v3 з декодером із 4 шарів замість 32: 809 млн параметрів замість 1550 млн. На Mac вона швидша приблизно в 2,3 раза — на M4 Max 55× реального часу проти 24×. Плата — близько одного відсоткового пункту WER для української та російської і слабкий переклад англійською.
Чи можна запустити Whisper large-v3 на Mac без відеокарти?
Так, окрема відеокарта Mac не потрібна: графіка вбудована в чип M1–M5 і використовує єдину пам’ять. Запускайте через mlx-whisper або whisper.cpp з Core ML — обидва працюють на графіці та нейрорушії Apple. Пам’яті вистачить на будь-якому Mac з Apple Silicon: повна модель у whisper.cpp займає близько 3,9 ГБ. Не беріть faster-whisper — на Mac він працює лише на процесорі.
Чи є Whisper large-v4 і чи варто переходити на Parakeet?
Моделі large-v4 немає: найновіші відкриті моделі розпізнавання мовлення OpenAI — large-v3 (2023) і large-v3-turbo (2024). Parakeet TDT 0.6B v3 точніша за Whisper для англійської і в рази швидша, але знає 25 європейських мов. Для російської large-v3 точніша (4,96% проти 6,54%), для української моделі майже нарівні — перехід має сенс після перевірки на своєму аудіо.