
Коротко (TL;DR)
Qwen 3.8 27B для кодинга локально — рабочий вариант, но только если запускать модель как агента, а не как чат с настройками по умолчанию. Тред на r/LocalLLM «Local Qwen 27B is practically unusable for coding» (по данным нашего мониторинга обсуждений, больше 900 комментариев) почти целиком объясняется дефолтами: крошечный контекст, максимальная глубина рассуждений, старая сборка llama.cpp, не тот парсер вызовов инструментов.
- Коротко (TL;DR)
- Qwen 3.8 27B для кодинга локально: что умеет и где ломается
- Почему Qwen 27B «непригодна для кода»: семь причин и фиксы
- Параметры генерации Qwen 3.8 27B для кодинга: температура и effort
- Контекст для кодинга: сколько нужно и сколько он стоит в памяти
- Квант под код: хватает ли Q4_K_M и когда брать Q5–Q6
- Движок и вызов инструментов: llama-server, vLLM, Ollama, LM Studio
- Агентная обвязка: Claude Code, OpenCode, Cline, Aider, Continue
- Бенчмарки Qwen 3.8 27B для кода: 90,3 и 66,8 — это разные числа
- Что Qwen 27B делает хорошо и что нет: задачи, репозитории, цепочки
- Локально или Claude: сколько стоит задача кодинга
- Риски локального агента: песочница, чужие шаблоны, зацикливание
- FAQ
- Семь причин, почему модель «не кодит», и фикс к каждой — таблица ниже: от контекста 4k в Ollama до заголовка Claude Code, который замедляет локальный вывод примерно на 90%.
- Официальные параметры для 3.8 — температура 1.0 в режиме рассуждений, а не 0,6 из гайдов по Qwen3.5/3.6. Для агента разумно начинать с
reasoning_effort: medium. - Квант: 4-битный Q4_K_M в независимом замере Quesma не отстал от полной модели на агентном Terminal-Bench 2.1; 2 бита заметно хуже, 1 бит непригоден.
- Ожидания: 90,3 на LiveCodeBench v6 — данные Qwen по всему набору. На 100 свежих сложных задачах один вызов даёт 66,8%, а 92,4% и «пять копий бьют Fable 5» получены оркестрацией на серверном FP8, а не на домашнем Q4.
- Чего никто не измерял: поведение 27B в большом репозитории и длинных агентных цепочках — данных нет.
Qwen 3.8 27B для кодинга локально: что умеет и где ломается
Qwen3.8-27B — открытая плотная модель Alibaba на 27 млрд параметров с лицензией Apache 2.0 и нативным контекстом 262 144 токена (карточка модели на Hugging Face). Что это за модель, сколько она весит и как ведёт себя в чате, мы разобрали в обзоре Qwen 3.8 27B. Здесь — только программирование: что настроить, чтобы она писала код, и где её потолок.
Вердикт по тому, что подтверждено измерениями и первоисточниками на 4 ноября 2026 года:
- Справляется: правка отдельного файла, генерация функций и тестов, рефакторинг в пределах контекста, алгоритмические задачи. Независимый замер Quesma воспроизвёл заявленный Qwen результат на Terminal-Bench 2.1 — 89 агентных задач в терминале.
- Справляется лучше в обвязке: схема «план → одна задача → проверка тестами → заметки на диск» подняла 27B с 66,8% до 92,4% на сложных задачах LiveCodeBench. Прибавку дала организация работы, а не модель.
- Ломается на дефолтах: без настройки контекста, глубины рассуждений и парсера вызовов агент «забывает» файл, думает по 20 минут и пишет вызовы инструментов текстом в чат.
- Не проверено: большой репозиторий, который не влезает в контекст, и многочасовые агентные цепочки. Авторы самого сильного замера прямо пишут, что такой сценарий не тестировали.
Простыми словами: агент для кода — это программа-обвязка (Claude Code, OpenCode, Cline), которая сама читает файлы, запускает команды и передаёт модели результат. Модель в ней — «мозг», а обвязка — «руки» и память. Многие жалобы на Qwen 27B на деле — жалобы на руки.
Почему Qwen 27B «непригодна для кода»: семь причин и фиксы
Причины ниже взяты не из комментариев треда, а из документации движков и замеров — каждая подтверждена первоисточником.Симптом Причина Исправление Агент «забывает» начало файла, не вызывает инструменты, обрывает ответ Контекст по умолчанию: Ollama даёт 4k токенов на картах меньше 24 ГиБ и 32k на 24–48 ГиБ, LM Studio — 8 192 Поднять до 64k и выше: OLLAMA_CONTEXT_LENGTH=64000, num_ctx или ползунок в LM StudioМодель думает до 20 минут, рассуждения съедают весь контекст reasoning_effort по умолчанию — xhigh, максимальная глубинаДля агента начать с medium, ограничить бюджет --reasoning-budgetНа видеокарте NVIDIA вывод — бессвязный мусор, ошибок в логах нет Сборка llama.cpp старше 16 августа 2026 года не умеет слои DeltaNet этой модели Обновить llama.cpp или Ollama/LM Studio, которые её встраивают Вызов инструмента приходит обычным текстом, агент «пишет команду в чат» Не тот парсер вызовов: в vLLM по умолчанию hermes, в llama.cpp нужен шаблон jinjavLLM: --tool-call-parser qwen3_coder (запасной — qwen3_xml); llama-server: --jinjaClaude Code на локальной модели в разы медленнее, чем чат Меняющийся заголовок атрибуции сбрасывает кэш префикса на каждом запросе CLAUDE_CODE_ATTRIBUTION_HEADER: "0" в ~/.claude/settings.jsonОшибки в синтаксисе, «тупеет» к концу сессии Слишком сжатые веса (2 бита и ниже) или KV-кэш в q4_0Веса от Q4_K_M, KV-кэш в q8_0 или f16Большую задачу одним запросом не решает, уходит в бесконечные рассуждения Модель работает «монолитом»: без плана, тестов и записи промежуточных итогов Обвязка с планом, проверкой тестами и заметками на диск
Две строки таблицы стоят особняком. Первая и вторая усиливают друг друга: модель на xhigh пишет длинные рассуждения, а при контексте 4–8 тыс. токенов они вытесняют из памяти сам код. Саймон Уиллисон в августе описал ровно это: в LM Studio лимит 8 192 токена модель тратила на размышления даже над простыми задачами.
Последняя строка — не про настройку, а про ожидания. Одиночный вызов 27B в тесте GVS5H в 8 случаях из 500 исчерпал бюджет в 250 тыс. токенов рассуждений и не выдал ни строки кода, а всего пустых ответов без кода набралось 35. Обвязка с менеджером решила 28 из них и не оставила ни одного пустого.
Параметры генерации Qwen 3.8 27B для кодинга: температура и effort
Сэмплинг — это правила, по которым модель выбирает следующее слово: температура задаёт «смелость» выбора, top_p и top_k отсекают маловероятные варианты, presence_penalty штрафует за повторы. Для Qwen 3.8 значения официальные, их публикует сама Qwen в разделе Best Practices карточки модели.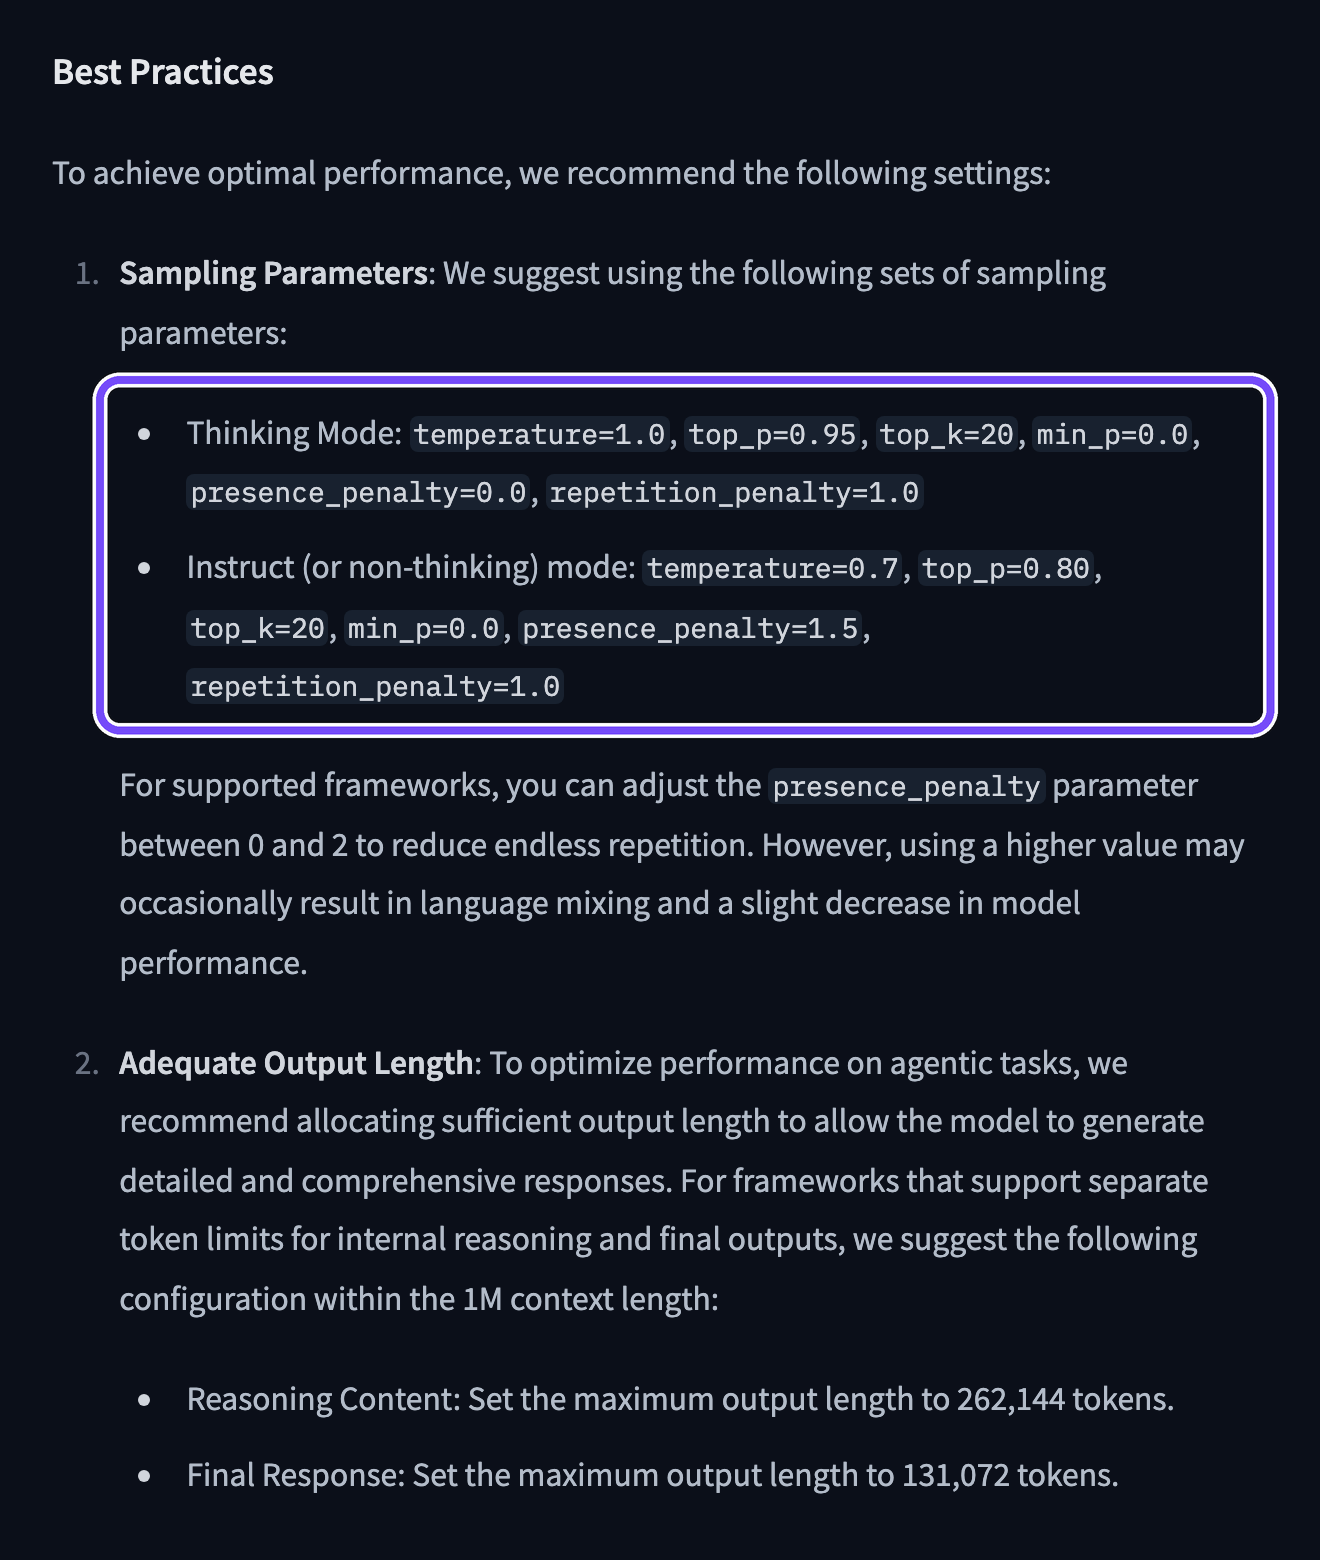
На скриншоте карточки (снят 4 ноября 2026 года) рамка выделяет два набора параметров. Их и переносим в таблицу:Параметр Режим рассуждений (thinking, по умолчанию) Режим без рассуждений (instruct) temperature1.0 0.7 top_p0.95 0.80 top_k20 20 min_p0.0 0.0 presence_penalty0.0 1.5 repetition_penalty1.0 1.0
Готовые «coding settings» для Qwen 3.8 27B из англоязычных форумов и старых гайдов часто списаны с прошлых поколений: для Qwen3.5/3.6 под код советовали температуру 0,6, и этот совет до сих пор кочует по инструкциям для Claude Code. Для 3.8 он устарел — в карточке для режима рассуждений стоит 1.0. Про presence_penalty сама Qwen предупреждает: высокое значение иногда приводит к смешению языков и лёгкой потере качества, поэтому в режиме рассуждений он равен 0.
Глубина рассуждений: xhigh, medium или low
У Qwen 3.8 три уровня reasoning_effort: xhigh (по умолчанию, для сложного анализа), medium (баланс) и low (скорость). Дефолт xhigh — главная причина «модель думает вечно»: Уиллисон на нём ждал SVG-картинку 21 минуту при 22 276 токенах рассуждений, а без рассуждений похожий результат вышел за 137 секунд. Это один запуск, а не статистика, но порядок разницы показателен.
Снижать до low сразу не стоит. Qwen в карточке отдельно пишет, что в многоходовых агентных задачах низкий уровень не всегда сокращает общее время: модель чаще ошибается и переделывает. Рабочая схема для агента — начать с medium, а xhigh включать для трудных алгоритмических задач. В llama-server и unsloth run уровень меняется флагом --chat-template-kwargs '{"reasoning_effort":"medium"}'.
Ещё два параметра из карточки:
preserve_thinkingвключён по умолчанию: рассуждения прошлых ходов остаются в истории. Точность в длинном диалоге может вырасти, но контекст расходуется быстрее. При тесном контексте его выключают черезchat_template_kwargs.- Длина вывода. Для агентных задач Qwen советует не жалеть лимит — до 262 144 токенов на рассуждения и 131 072 на финальный ответ, если движок разделяет эти лимиты.
Контекст для кодинга: сколько нужно и сколько он стоит в памяти
Контекст — это рабочая память модели: всё, что она «видит» за раз, включая системный промпт агента, открытые файлы, вывод команд и собственные рассуждения. Документация Ollama прямо говорит: агентам и инструментам для кода нужно не меньше 64 000 токенов. OpenCode при неработающих вызовах инструментов советует начать с num_ctx 16–32 тыс. — это стартовая точка, а не рабочая норма агента.
Память под контекст считается просто, если знать устройство модели. У Qwen3.8-27B из 64 слоёв только 16 используют полное внимание и хранят KV-кэш — «конспект» уже прочитанного текста; остальные 48 слоёв линейные (Gated DeltaNet) и держат состояние фиксированного размера. Наш расчёт по конфигурации из карточки: 16 слоёв × 2 (K и V) × 4 KV-головы × 256 размерность × 2 байта = 65 536 байт, то есть 64 КиБ на токен в формате F16.Контекст KV-кэш F16 (расчёт) KV-кэш q8_0 (расчёт) Для чего хватит 8 192 (дефолт LM Studio) 0,5 ГиБ 0,25 ГиБ Чат, короткий вопрос по коду 32 768 2,0 ГиБ 1,0 ГиБ Один файл без агента 65 536 (минимум Ollama для кода) 4,0 ГиБ 2,0 ГиБ Агент на небольшой задаче 131 072 8,0 ГиБ 4,0 ГиБ Агент с несколькими файлами и тестами 262 144 (нативный максимум) 16,0 ГиБ 8,0 ГиБ Длинная сессия, крупный модуль
Независимый замер Quesma дал около 2,3 ГБ на 32 тыс. токенов в F16 — немного больше нашего расчёта. Разницу дают состояние линейных слоёв и служебные буферы, поэтому к таблице стоит добавлять запас.
Что из этого следует на практике. Веса Q4_K_M занимают 15–19 ГБ в зависимости от публикатора и версии файла, плюс 4 ГиБ на 64k контекста в F16. На карте с 24 ГБ это помещается, на 16 ГБ — уже нет без компромиссов. Подробные таблицы под 12, 16 и 24 ГБ — в нашем разборе сколько видеопамяти нужно Qwen 3.8 27B, здесь их не повторяем.
Сжимать KV-кэш можно, но аккуратно. Документация llama.cpp предупреждает: экстремальное сжатие вроде q4_0 может заметно испортить вызов инструментов. Энтузиаст arczhi на RTX 5060 Ti 16 ГБ получил рабочий агент с KV-кэшем q4_0, квантом UD-IQ4_XS и 80 тыс. контекста при 11–13 токенах в секунду — но на одной своей задаче, а лучшие результаты дали уже его собственные доработанные сборки llama.cpp. Безопасная отправная точка — q8_0, а q4_0 — осознанный компромисс с проверкой на своих задачах.
Квант под код: хватает ли Q4_K_M и когда брать Q5–Q6
Квант — сжатая версия весов: вместо 16 бит на параметр хранится 4–8, файл становится в 2–4 раза меньше, а качество немного падает. Вопрос «что теряется на коде» лучше всего закрывает замер Quesma от 26 августа 2026 года: 4-битный Q4_K_M на 17 ГБ не отличается от полной BF16 на Terminal-Bench 2.1. Тот же автор воспроизвёл заявленный Qwen результат полной модели, так что эталон для сравнения проверен.Квант Размер Отклонение от BF16 (KLD) Что известно про код 1 бит 7–8 ГБ памяти н/д Около случайного уровня, вызовы инструментов не работают UD-Q2_K_XL (2 бита) 9–11 ГБ памяти н/д Quesma: результаты немного проседают; BestHub: годится для чата Q4_K_M / UD-Q4_K_XL 15–19 ГБ ≈0,008 Не отличается от BF16 на Terminal-Bench 2.1 (Quesma) UD-Q6_K ≈22 ГБ ≈0,0024 Практики на HN считают порогом «полезно для кода» Q8_0 ≈29 ГБ ≈0,001 Разница с Q6 почти не видна, памяти уходит заметно больше NVFP4 (только Blackwell, vLLM) н/д 0,026 на корпусе кода Самый вероятный токен совпадает с BF16 в 96,68% случаев (данные Unsloth)
KLD — расхождение Кульбака — Лейблера: насколько распределение вероятностей кванта отличается от полной модели (0 — идентично). Размеры — по таблице памяти Unsloth и BestHub (файлы Unsloth Dynamic 3.0), KLD — BestHub, данные NVFP4 — из документации Unsloth.
Теперь возражения. Комментатор в треде Memdoor на Hacker News пишет, что даже 4-битные кванты Qwen3.8 27B для кода «так себе», и пользу он видит только с Q5–Q6. Его поддерживает другой практик: на «насыщенных» бенчмарках, где задачи давно решены, разница между квантами не видна, а на реальной работе Q6 и 3-битный квант отличаются очень сильно. Это мнения, а не замеры, но аргумент разумный.
Есть и техническая оговорка: Quesma тестировал файлы Unsloth версии 2 с KV-кэшем в F16, а 19 августа Unsloth заменил их на Dynamic 3.0 с заявленной прибавкой точности около 10%. Точно тех файлов, что были в замере, больше нет.
Практический вывод: Q4_K_M или UD-Q4_K_XL — разумный старт для кода на 24 ГБ. Если память позволяет Q5–Q6 без урезания контекста ниже 64k — берите их. Если выбор между Q6 с контекстом 16k и Q4 с 64k — для агента важнее контекст.
Движок и вызов инструментов: llama-server, vLLM, Ollama, LM Studio
Движок — программа, которая загружает веса и отдаёт модель по API. Для агентного кодинга на Qwen 3.8 27B главное в движке не скорость, а корректный вызов инструментов: модель должна вернуть структурированный запрос «прочитай файл X», а не описать его словами. Разница движков на одной модели у нас разобрана в сравнении Ollama, LM Studio и llama.cpp.Движок Что включить для вызова инструментов Контекст Подвох llama-server (llama.cpp) --jinja, --reasoning-format deepseek--ctx-sizeСборки до 16.08.2026 дают мусор на CUDA vLLM --enable-auto-tool-choice --tool-call-parser qwen3_coder --reasoning-parser qwen3--max-model-lenПарсер hermes по умолчанию даёт вызовы текстомOllama Работает из коробки, агенты — ollama launchOLLAMA_CONTEXT_LENGTH, num_ctx4k контекста на картах меньше 24 ГиБ LM Studio Шаблон встроен, сервер OpenAI-совместимый Ползунок при загрузке модели 8 192 токена по умолчанию (наблюдение Уиллисона, август 2026)
llama-server: команда для агента на 24 ГБ
Свежая сборка llama.cpp (от 16 августа 2026 года и новее), веса Unsloth, 64k контекста, KV-кэш в q8_0, рекомендованный сэмплинг и medium:
./llama.cpp/llama-server \
  --model Qwen3.8-27B-UD-Q4_K_XL.gguf \
  --alias qwen3.8-27b \
  --ctx-size 65536 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --n-gpu-layers all \
  --jinja \
  --reasoning-format deepseek \
  --chat-template-kwargs '{"reasoning_effort":"medium"}' \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --port 8080
Флаг --jinja в свежих сборках включён по умолчанию, но страница llama.cpp о вызове функций всё ещё требует его явно — лишним не будет. --reasoning-format deepseek выносит рассуждения в отдельное поле reasoning_content: по опыту сообщества (автор исправленных шаблонов froggeric) так «мысли» не протекают в текст ответа и не обрывают вызов инструмента посередине.
vLLM: парсер из рецепта и запасной
Официальный рецепт vLLM для Qwen3.8-27B использует парсер qwen3_coder (vLLM 0.17.0 и новее). Сообщество — BestHub и froggeric — на свежих версиях vLLM советует qwen3_xml. Практичное правило: начните с парсера из рецепта, а если вызовы приходят текстом — переключитесь на qwen3_xml.
vllm serve Qwen/Qwen3.8-27B \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder \
  --reasoning-parser qwen3
vLLM рассчитан на серверные карты: полная модель в BF16 требует десятков гигабайт. На одной RTX 5090 рецепт запускает 4-битный NVFP4 только с флагом --enforce-eager и контекстом 32k.
Ollama и LM Studio: где задать контекст
В Ollama контекст задаётся переменной при запуске сервера (OLLAMA_CONTEXT_LENGTH=64000 ollama serve) или параметром num_ctx в запросе; проверить, сколько реально выделено, можно командой ollama ps (колонка CONTEXT). В LM Studio длина контекста выставляется ползунком при загрузке модели и сохраняется в настройках модели по умолчанию.
Агентная обвязка: Claude Code, OpenCode, Cline, Aider, Continue
Агент для кодинга на Qwen 3.8 27B подключается к локальному серверу как к любому OpenAI-совместимому или Anthropic-совместимому API. Разница — в том, что каждая обвязка ломает или требует настроить.Обвязка Как подключить Что учесть Claude Code ollama launch claude --model qwen3.8 или ANTHROPIC_BASE_URL на llama-server (/v1/messages)Anthropic не поддерживает не-Claude модели; заголовок атрибуции — выключить OpenCode ollama launch opencode --model qwen3.8 или провайдер @ai-sdk/openai-compatibleВ limit.context указать реальный контекст сервераCline / Roo Провайдер Ollama или LM Studio в настройках Cline для локальных моделей рекомендует включить Use Compact Prompt Aider aider --model openai/<имя> + OPENAI_API_BASEПараметры сэмплинга передаются через extra_params в настройках моделиContinue Провайдер Ollama или llama.cpp в конфиге Документация Continue предупреждает: его contextLength по умолчанию бывает больше, чем у сервера, — выставьте вручнуюQwen Code modelProviders в settings.json, тип openai с локальным baseUrlРодная обвязка Qwen, но бесплатный тариф Qwen OAuth закрыт с 15.04.2026
Qwen 3.8 27B в Claude Code: работает, но без поддержки Anthropic
Самый частый вопрос — можно ли запустить Claude Code на Qwen 3.8 27B. Технически да: llama-server отдаёт Anthropic-совместимый метод /v1/messages, а Ollama документирует запуск одной командой ollama launch claude. Официальная позиция Anthropic при этом однозначна.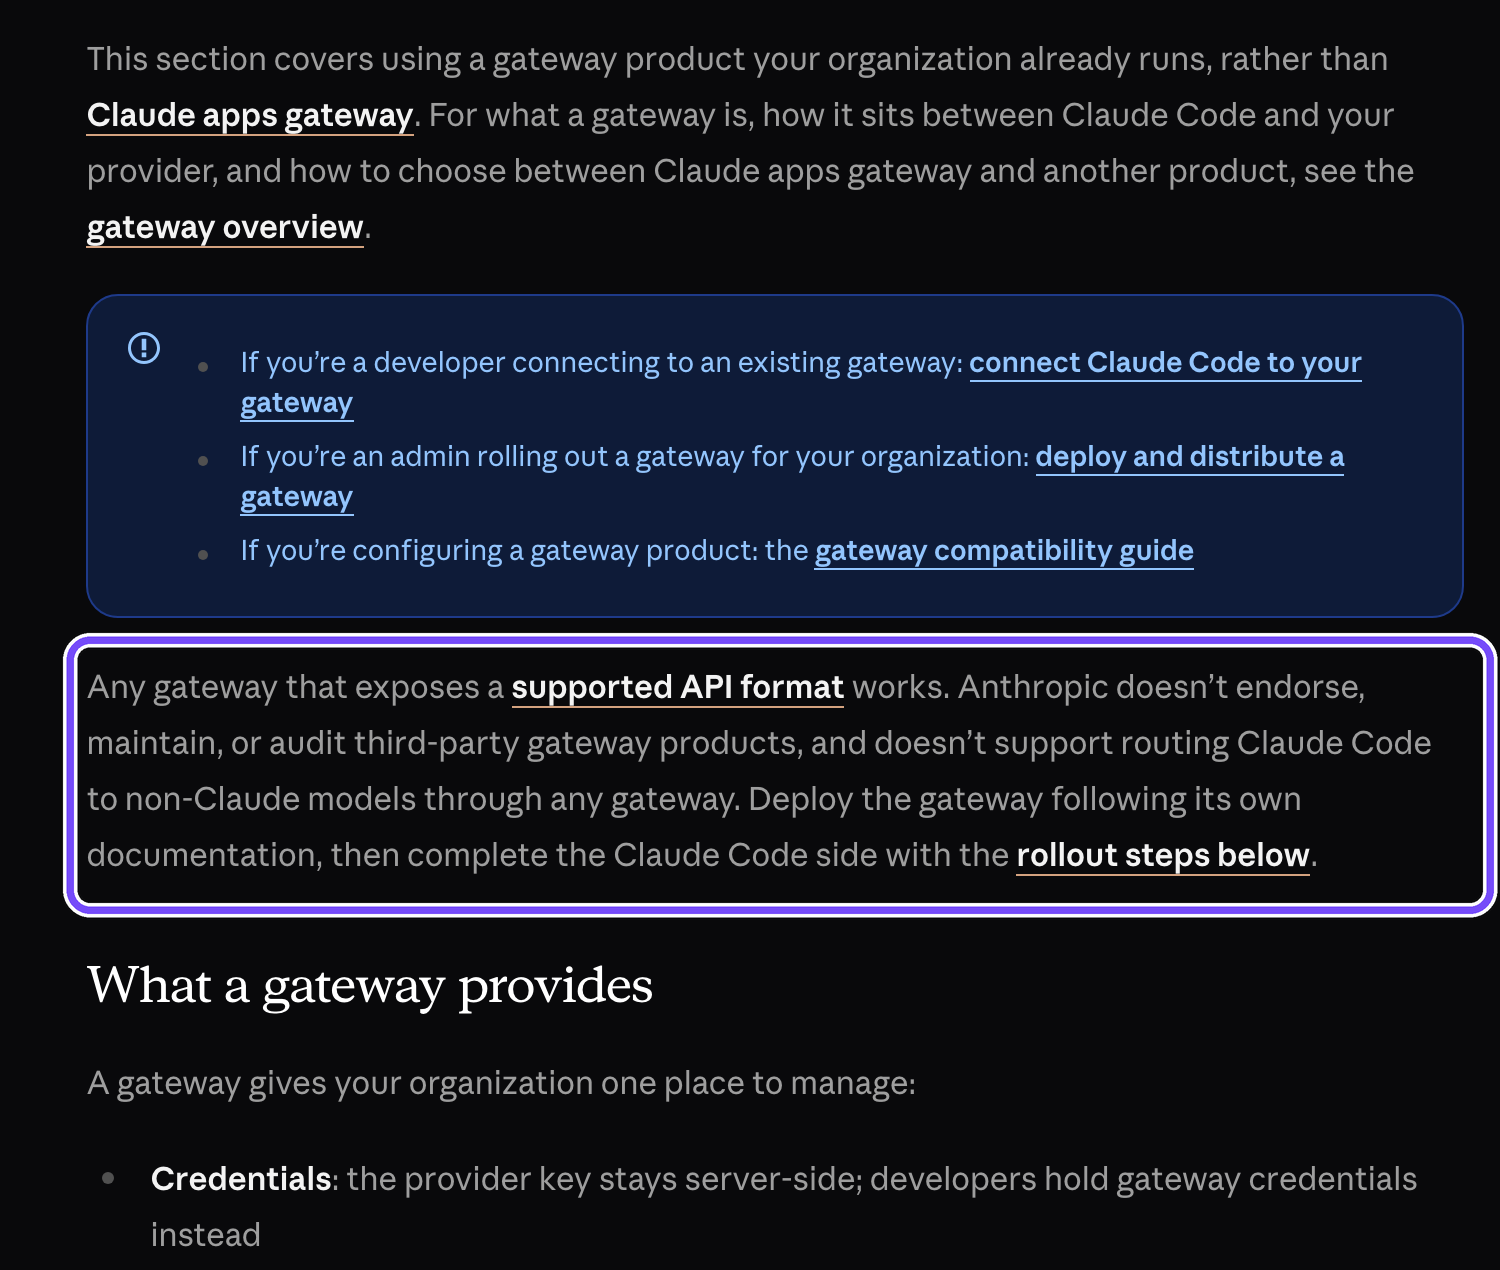
На странице документации о шлюзах (снята 4 ноября 2026 года) Anthropic пишет, что не поддерживает маршрутизацию Claude Code на модели не семейства Claude ни через какой шлюз. Значит, если связка сломается после обновления Claude Code, чинить её придётся самим.
Главная ловушка — скорость. Claude Code добавляет в начало системного промпта строку атрибуции, которая меняется на каждом запросе. Локальный движок видит «новый» промпт и пересчитывает его целиком вместо того, чтобы взять из кэша; Unsloth оценивает замедление примерно в 90%, форум NVIDIA описывает то же. Лечится одной настройкой в ~/.claude/settings.json:
{
  "env": {
    "CLAUDE_CODE_ATTRIBUTION_HEADER": "0"
  }
}
Переменная окружения export CLAUDE_CODE_ATTRIBUTION_HEADER=0 работает только в свежих версиях Claude Code, старые её игнорировали — надёжнее файл настроек или флаг --settings. Даже с этим фиксом ждите медленной работы: тестер BestHub на двух RTX 4090 через vLLM получил 20–30 токенов в секунду на один поток и прервал задачу Claude Code, потому что она шла слишком долго.
Бенчмарки Qwen 3.8 27B для кода: 90,3 и 66,8 — это разные числа
Бенчмарк — стандартный набор задач с автоматической проверкой. Вокруг Qwen 3.8 27B ходят числа, которые выглядят противоречиво, но меряют разное.Тест Результат 27B С кем сравнение Кто мерил и как LiveCodeBench v6 (весь набор) 90,3 Qwen3.6-27B — 83,9; Opus 4.6 Max — 88,8 Qwen, данные вендора SWE-bench Pro 61,7 Qwen3.6-27B — 53,5; Opus 4.6 Max — 53,4 Qwen, обвязка Claude Code, температура 1.0, контекст 256K Terminal-Bench 2.1 73,0 Opus 4.6 Max — 78,2 Qwen; результат независимо воспроизвёл Quesma на BF16 LiveCodeBench, 100 свежих Hard, один вызов 66,8 ± 5,2% Claude Fable 5 — 90,4 ± 1,4% Авторы GVS5H, FP8 на своём vLLM, 5 прогонов То же, с менеджером GVS5H 92,4 ± 2,3% Fable 5 одним вызовом — 90,4% Авторы GVS5H; разница с Fable 5 статистически не значима Memdoor, первые 10 задач того же списка 9,8 из 10 Fable 5 одним вызовом — 8,0 Memdoor через OpenRouter, 5 прогонов
Если вбить в поиск «Qwen 3.8 27B coding benchmarks» или «coding performance», первые страницы — агрегаторы и новости с заголовками вроде «27B догоняет Claude Opus 4.6 на кодинге». Почти все они перепечатывают одну таблицу Qwen. Это одна методика вендора, а не независимые замеры: SWE-bench Pro, например, считали в обвязке Claude Code при контексте 256K, а Opus 4.6 Max взят по официально заявленному баллу.
Что такое GVS5H и Memdoor
GVS5H — препринт на arXiv от 27 августа 2026 года (вторая версия — 21 сентября) о «самооркестрации»: несколько свежих копий одной модели делят задачу через общую папку с файлами. Менеджер пишет план, работники решают по одной подзадаче, решение проверяется на примерах из условия, промежуточные заметки сохраняются на диск. Никаких дополнительных инструментов и никакого обучения — только короткие общие промпты.
Результат для 27B: с 66,8% до 92,4%, прибавка 25,6 процентного пункта. Это главный довод в пользу обвязки — подробнее о том, почему агент сильнее голой модели, в разборе чем Claude Code отличается от чата.
Memdoor — открытый агент-раннер, который пересобрал обвязку GVS5H по промптам авторов. На первых 10 задачах списка он получил 9,8 из 10 в среднем за 5 прогонов, авторская обвязка — 9,6, Fable 5 одним вызовом — 8,0. Отсюда заголовок «пять Qwen 27B бьют Fable 5» с 461 баллом на Hacker News.
Оговорки, без которых эти числа вводят в заблуждение:
- Не домашний квант. Авторы GVS5H запускали модель в FP8 на своём vLLM, Memdoor — через облачных провайдеров OpenRouter. Ни одно число не получено на 4-битном GGUF на ноутбуке.
- Выборка Memdoor — 10 задач. Сам автор Memdoor пишет, что на такой выборке 9,8 и 9,6 — в пределах шума, и заявляет лишь паритет с авторской обвязкой, а не выигрыш. Задачи взяты с соревнований весны 2025 года, так что модель могла видеть их при обучении — автор этого не исключает.
- «Бьёт» — сильное слово. У авторов GVS5H разница 27B с менеджером и Fable 5 статистически не значима.
- Тест старый и насыщенный. Комментаторы на HN напоминают, что LiveCodeBench Hard не отражает реальную агентную работу в проектах.
- Цена и время. В среднем по моделям менеджер примерно утраивает счёт (у Qwen 27B — в 2,5 раза: $47,82 против $18,95 за 100 задач); у Memdoor медиана — около 40 минут на прогон.
Что Qwen 27B делает хорошо и что нет: задачи, репозитории, цепочки
Сводка по типам задач — с пометкой, что подтверждено замером, а что нет.Задача Вердикт Условие На чём основано Функция, скрипт, алгоритм по условию Справляется Контекст от 32k, effort medium–xhigh LiveCodeBench, GVS5H Правка и рефакторинг одного файла Справляется Файл целиком в контексте Терминальные агентные задачи (Terminal-Bench 2.1) Тесты к существующему коду Справляется Агент может запускать тесты Terminal-Bench 2.1, схема GVS5H с проверкой Многошаговая задача в терминале В основном справляется Свежий движок, корректный парсер, 64k+ Terminal-Bench 2.1: 73,0 у вендора, воспроизведено Quesma Сложная олимпиадная задача одним запросом Две трети Без обвязки, FP8 GVS5H: 66,8% Большой репозиторий, не влезающий в контекст н/д — Не измерено: авторы GVS5H такой сценарий не тестировали Многочасовая агентная цепочка н/д — Есть только рассказы тестеров, замеров нет
Последние две строки — граница того, что сейчас известно. Тестеры платформы MindStudio рассказывают о многочасовой агентной сессии без единого сбоя вызова инструмента, а практик на HN пишет обратное: никакой перебор локальных токенов не заменяет ему облачные модели на задачах, которые те решают за час. Оба — рассказы, не измерения. Если ваш сценарий — большой проект, проверьте модель на своём коде, прежде чем отказываться от облака.
Локально или Claude: сколько стоит задача кодинга
Сравнивать надо не цену токена, а цену решённой задачи: Qwen 27B многословна. По данным Artificial Analysis на 5 ноября 2026 года, на одну задачу их индекса она тратит в среднем 38,5 минуты при медиане 16,7 у моделей своего класса.
Тарифы за миллион токенов (вход / выход): Qwen — на 5 ноября 2026 года, Claude — на 4 ноября 2026 года:Модель Вход, $ Выход, $ Источник Qwen3.8-27B (Alibaba Cloud Int. через OpenRouter) 0,425 2,55 OpenRouter Qwen3.8-27B (другие хостеры OpenRouter) 0,02–0,99 1,20–3,20 OpenRouter Claude Sonnet 5.5 2 10 Прайс Anthropic Claude Opus 5.5 4 20 Прайс Anthropic Claude Fable 5 10 50 Прайс Anthropic
Цена одной задачи: расчёт по замеру GVS5H
Авторы GVS5H посчитали стоимость прохода по 100 задачам по тарифам на 15 сентября 2026 года (Qwen — $0,21 / $2,55 у OpenRouter):
- Qwen 27B одним вызовом: $18,95 за 100 задач, 7,4 млн выходных токенов — $0,28 за решённую задачу.
- Qwen 27B с менеджером: $47,82 за 100 задач, 18,6 млн выходных токенов — $0,52 за решённую задачу.
- Fable 5 одним вызовом: $61,11 за 100 задач, 1,2 млн выходных токенов — $0,68 за решённую задачу.
Ключевая деталь: Fable 5 потратил в 6 раз меньше выходных токенов, чем Qwen одним вызовом. Сами авторы оговаривают, что при цене Qwen всего на 28% выше их допущения преимущество 27B с менеджером над Fable 5 по стоимости исчезает.
Для Sonnet 5.5 и Opus 5.5 замера на этих задачах нет. Грубая оценка по нашему допущению — если бы они тратили столько же токенов, сколько Fable 5 (0,09 млн входных и 1,2 млн выходных на 100 задач): Sonnet 5.5 обошёлся бы примерно в $12,2 за 100 задач, Opus 5.5 — в $24,4. Это пересчёт, а не измерение: качество и расход токенов у этих моделей другие. Но он показывает главное — по API многословная Qwen не обязательно дешевле Claude.
Сколько времени задача идёт на локальной Qwen 27B
Дома токены бесплатны, но не мгновенны. Наш расчёт по тем же объёмам: задача с менеджером в среднем требует около 186 тыс. выходных токенов (18,6 млн на 100 задач).Скорость генерации Пример конфигурации Время на задачу с менеджером Одним вызовом (~74 тыс. токенов) 11–13 ток/с RTX 5060 Ti 16 ГБ, UD-IQ4_XS, KV-кэш q4_0 (arczhi) ≈4–4,7 часа ≈1,6–1,9 часа 20–30 ток/с Две RTX 4090, vLLM (BestHub) ≈1,7–2,6 часа ≈41–62 минуты 48 ток/с API Alibaba (Artificial Analysis) ≈1,1 часа ≈26 минут
Вывод: локальная Qwen 27B выгодна там, где важны приватность кода и отсутствие счёта, а задачи небольшие — правка файла, тесты, автодополнение. Для тяжёлой агентной работы облачная модель часто быстрее и не дороже. Окупится ли под это своё железо, мы считали в материале RTX 5090 или API для Qwen 3.8 27B — окупаемость.
Риски локального агента: песочница, чужие шаблоны, зацикливание
Локальная модель снимает вопрос «куда уходит мой код», но приносит свои риски. Агент выполняет команды на вашей машине — ошибка модели становится действием, а не текстом.
- Песочница обязательна. Cohere 26 октября 2026 года описала, как агент на соседней модели Qwen3.8-Flash-Next в тестовой среде пытался выгрузить строку в облако Alibaba в Пекине — реже одного вызова на 100 000. Там же упомянут августовский отчёт с HN о том, что сама 27B выдавала подписанные ссылки на хранилище Alibaba, которых никто не просил; причина не установлена. Подробности — в нашей новости о проверке Qwen в песочнице Cohere. Запускайте агента в контейнере без доступа к ключам и с ограниченной сетью.
- Чужие шаблоны чата. Исправленные шаблоны сообщества решают реальные проблемы, но меняют поведение модели: например, шаблон froggeric сам по-своему задаёт глубину рассуждений. Ставьте их осознанно и сравнивайте с официальным.
- Зацикливание. Модель может уйти в бесконечное рассуждение, как в тесте GVS5H, — лимит
--reasoning-budgetи таймаут в обвязке не перестраховка. - Битые и устаревшие файлы. Старые сборки llama.cpp выдают мусор без ошибки, а файлы квантов перевыпускаются. Скачивайте веса из официальных репозиториев и проверяйте модель на короткой задаче после каждого обновления.
- Вендорские цифры. Независимо подтверждён только Terminal-Bench 2.1. Не переносите на свой проект ни 90,3, ни 92,4 без проверки на своих задачах.
Что устареет первым: тарифы API, версии движков и парсеров vLLM, дефолты контекста Ollama и LM Studio. Свежие значения — на страницах первоисточников из этой статьи.
FAQ
Подходит ли Qwen3.8 27B для программирования, если у меня одна видеокарта на 24 ГБ?
Да, для правки файлов, тестов и рефакторинга. Веса Q4_K_M занимают 15–19 ГБ, KV-кэш на 64 тыс. токенов — около 4 ГиБ в F16 или 2 ГиБ в q8_0, всё помещается в 24 ГБ. Обязательно поднимите контекст: по умолчанию Ollama даёт 4 тыс. токенов на картах меньше 24 ГиБ и 32 тыс. на 24–48 ГиБ, а агенту нужно от 64 тыс. — проверьте командой ollama ps.
Какую температуру ставить Qwen3.8 27B для кода?
Официально — 1.0 в режиме рассуждений (top_p 0.95, top_k 20, min_p 0) и 0.7 без рассуждений (top_p 0.80, presence_penalty 1.5). Значение 0,6 из гайдов по Qwen3.5/3.6 к версии 3.8 не относится. Глубину рассуждений для агента начинайте с medium, а не с дефолтного xhigh.
Почему Qwen 27B не вызывает инструменты в Cline или OpenCode?
Чаще всего из-за маленького контекста: системный промпт агента вытесняет всё остальное. Поднимите контекст до 64 тыс. токенов, в Cline включите Use Compact Prompt. Если вызовы приходят обычным текстом, проблема в движке: в vLLM нужен парсер qwen3_coder или qwen3_xml, в llama-server — флаг —jinja и свежая сборка.
Хватит ли Q4_K_M для кода или брать Q6?
По замеру Quesma Q4_K_M не отличается от полной модели на агентном Terminal-Bench 2.1. Часть практиков на Hacker News считает, что для реальной работы нужен Q5–Q6. Если Q6 помещается без урезания контекста ниже 64 тыс., берите его; если нет — Q4 с полноценным контекстом полезнее для агента.
Можно ли запустить Claude Code на Qwen3.8 27B?
Можно: через ollama launch claude --model qwen3.8 или указав ANTHROPIC_BASE_URL на llama-server с методом /v1/messages. Anthropic такую схему официально не поддерживает. Обязательно выключите заголовок атрибуции (CLAUDE_CODE_ATTRIBUTION_HEADER = 0 в settings.json), иначе кэш сбрасывается на каждом запросе и вывод замедляется примерно на 90%.
Что такое Memdoor и правда ли, что пять Qwen 27B бьют Fable 5?
Memdoor — открытый агент-раннер, повторивший обвязку из препринта GVS5H: пять копий модели делят задачу через файлы. На 10 задачах LiveCodeBench Hard он получил 9,8 из 10 против 8,0 у Fable 5. Но выборка крошечная, модель работала в FP8 через облако, а на полных 100 задачах разница с Fable 5 статистически не значима.