
В Claude Code с сентября 2026 года есть встроенная команда /skill-doctor, и её легко спутать с одноимёнными сторонними скиллами Skill Doctor — от Warp и независимых авторов. Встроенный Skill Doctor отвечает на один вопрос: сколько контекста съедает каждый скилл и вызывался ли он вообще. Устаревшие и противоречивые правила в CLAUDE.md ищет другая команда — /doctor prompt-audit. Ниже — карта всех инструментов аудита, наши прогоны на Claude Code 2.1.316 от 2 ноября 2026 года и порядок чистки, после которого агент не становится глупее.
- Коротко (TL;DR)
- Skill Doctor, /doctor и prompt-audit: что каждый проверяет
- Почему неиспользуемый скилл всё равно стоит контекста
- Отчёт /skill-doctor: как читать колонки и что с ним делать
- Аудит CLAUDE.md командой prompt-audit: разбор реального отчёта
- Чистка CLAUDE.md и скиллов по шагам: что вырезать, что вынести в хук
- Проверка самих скиллов: plugin validate, eval и ручной тест
- Риски аудита: где он ошибается и чего нельзя вырезать
- Сторонние skill-doctor и claude-md-improver: когда они нужны
- Как часто аудитить скиллы и CLAUDE.md: ритм и чек-лист
- FAQ
Коротко (TL;DR)
/skill-doctor— отчёт «цена и вызовы»: сколько токенов каждый скилл занимает в списке на каждом ходу и сколько раз им пользовались. Пользу скилла и CLAUDE.md он не оценивает. Команда вышла в версии 2.1.261 (4 сентября 2026), документация называет порог 2.1.252./doctor prompt-audit— аудит текста инструкций: устаревшие формулировки, несуществующие пути и команды, противоречия. Появился в 2.1.283 (25 сентября 2026), файлы сам не правит.claude plugin validateловит битый frontmatter в SKILL.md,claude plugin evalсравнивает прогоны с плагином и без него.- Наши прогоны 02.11.2026: prompt-audit нашёл 8 проблем в песочнице за 66 секунд и $0.89; validate завершился с кодом 1 на битом YAML;
/skill-doctorв свежей среде показал у всех скиллов «0×, never» — это отсутствие истории, а не приговор. - Главное «зачем»: исследование Databricks показало, что большая библиотека скиллов вредит прежде всего тем, что агент выбирает не тот скилл. Поэтому описания на пересечение важнее экономии токенов.
- Ритм: беглый взгляд на
/skill-doctorи/contextраз в месяц, полный prompt-audit — после смены модели, крупного обновления или пачки новых скиллов.
Пять терминов, на которых держится текст. Контекст — всё, что модель видит на текущем ходу: системные инструкции, ваш CLAUDE.md, историю диалога. Токен — единица счёта текста для модели, примерно 3–4 символа английского текста. Скилл — папка с файлом SKILL.md: короткое описание «когда меня звать» плюс инструкция, которую Claude подгружает по требованию. Frontmatter — служебный блок в начале SKILL.md между линиями --- с полями name и description. CLAUDE.md — файл правил проекта, который Claude Code читает в начале каждой сессии.
Skill Doctor, /doctor и prompt-audit: что каждый проверяет
Встроенный Skill Doctor в Claude Code — это не «доктор для всего». Каждый из пяти инструментов закрывает свою узкую задачу, и ни один не отвечает на вопрос, полезен ли конкретный скилл. Путаницу усиливают два обстоятельства: сторонние скиллы на GitHub и в каталогах носят то же имя, а prompt-audit доступен через две разные команды.Инструмент Что проверяет Чего НЕ проверяет Версия Цена прогона по замерам /skill-doctorвес каждого скилла в списке, число вызовов, дату последнего вызова, давно не использованные плагины пользу скилла, пересечение описаний, CLAUDE.md, синтаксис SKILL.md 2.1.261 (вышла 04.09.2026); доки: от 2.1.252 н/д /doctor (чекап, алиас /checkup)установку, неиспользуемые скиллы, MCP-серверы и плагины против их веса, медленные хуки, дубли CLAUDE.md и то, что Claude выведет из кода сам противоречия и устаревшие формулировки н/д н/д /doctor prompt-auditустаревшие инструкции, битые пути и команды, противоречия в CLAUDE.md, скиллах, субагентах, командах частоту использования, вес скиллов 2.1.283 (25.09.2026) у нас $0.89 за 66 с; у bestagent.dev $0.41–0.75 claude plugin validateпарсится ли YAML во frontmatter, есть ли описание, корректен ли манифест плагина смысл описания и срабатывание 2.1.233+ н/д claude plugin evalкачество работы плагина: каждый кейс гоняется с плагином и без, результат оценивается CLAUDE.md; без набора кейсов в evals/ проверять нечего2.1.269 зависит от числа кейсов
Отдельно стоит /claude-api prompt-audit: он появился раньше, в 2.1.221 (4 августа 2026), и проверяет промпты вашего приложения, которое ходит в Claude API, а не настройку Claude Code. Методика у обеих команд общая — файл prompt-audit.md в репозитории anthropics/skills.
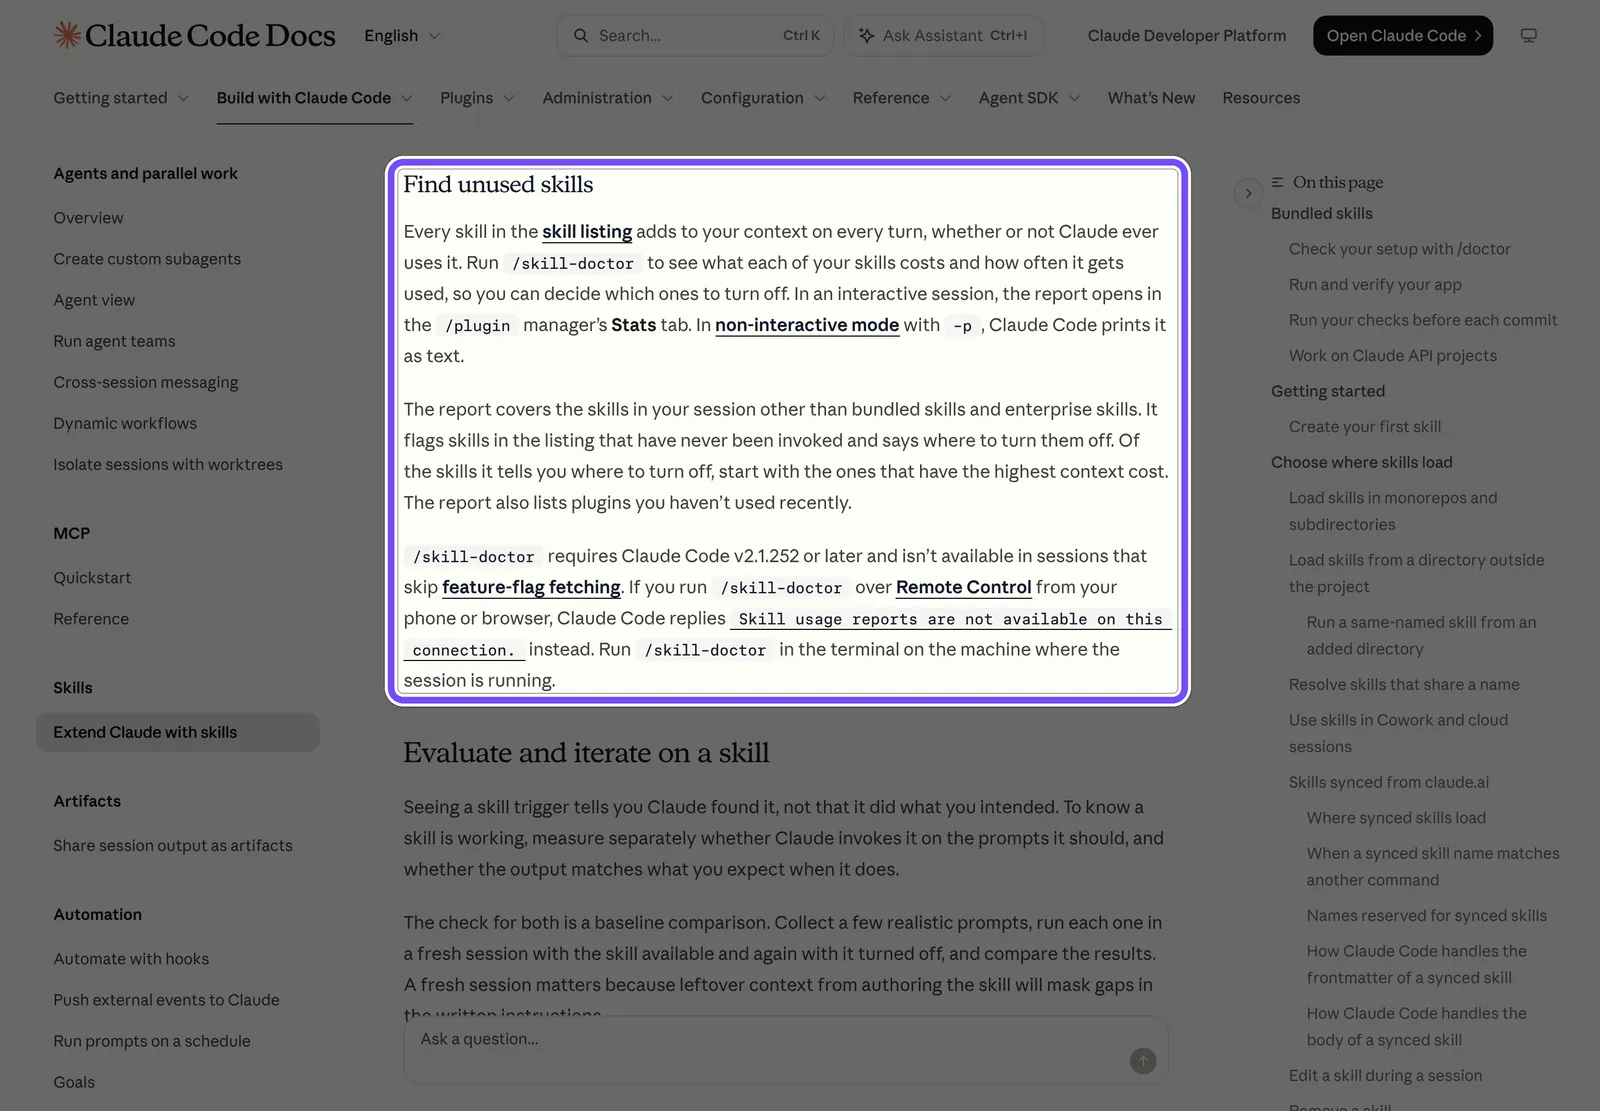
Кадр из документации Claude Code, снятый 2 ноября 2026 года: рамкой выделен раздел «Find unused skills». В нём три вещи, которые важно знать заранее. В интерактивной сессии отчёт открывается во вкладке Stats менеджера /plugin, с флагом -p печатается текстом. Встроенные (bundled) и корпоративные скиллы в отчёт не попадают. Через Remote Control с телефона или из браузера команда не работает и отвечает строкой «Skill usage reports are not available on this connection.» — запускать её нужно в терминале той машины, где идёт сессия.
Почему неиспользуемый скилл всё равно стоит контекста
Claude Code загружает скиллы в два слоя — это и есть прогрессивная загрузка, которую мы разбирали в материале про Agent Skills в Claude Code. Первый слой — список имён и описаний — уходит модели на каждом ходу, чтобы Claude знал, что у него есть. Второй слой — тело SKILL.md — подгружается только при вызове. Значит, скилл, который не вызывали ни разу, всё равно платит своим описанием за каждое ваше сообщение.Что Когда попадает в контекст Ограничение по докам (02.11.2026) Имя скилла на каждом ходу, всегда — Описание ( description + when_to_use)на каждом ходу, пока помещается в бюджет до 1 536 символов на скилл, настройка skillListingMaxDescCharsВесь список описаний на каждом ходу бюджет 1% окна контекста, настройка skillListingBudgetFractionТело SKILL.md только после вызова после компакции — первые 5 000 токенов скилла, на все скиллы вместе 25 000
Когда список не помещается в бюджет, Claude Code выбрасывает описания у скиллов, которые вы вызываете реже всего. Имя остаётся, а ключевые слова, по которым Claude подбирает скилл под запрос, пропадают. Компакция — это автоматическое сжатие длинного диалога, чтобы освободить окно. После неё Claude Code заново прикладывает вызванные скиллы, но только первые 5 000 токенов каждого и не больше 25 000 на все сразу, начиная с последних вызванных. Поэтому главное в SKILL.md стоит держать сверху.
Всё это — постоянный налог на каждый ход: тот же контекст, из которого складывается расход ваших лимитов Claude Code.
Сколько это в токенах, считали три автора на своих машинах. Методики разные, поэтому цифры ниже — иллюстрация, а не норма.Замер Скиллов Токенов в списке Токенов на скилл (наш расчёт) Как мерили Gekkode, 18.09.2026 117 (108 ни разу не вызывались) ≈8 800 ≈75 отчёт /skill-doctorMejba, 31.07.2026 226 ≈21 200 ≈94 символы ÷ 4, оценка kenimo49 (dev.to), 04.06.2026 5 (3 не сработали ни разу) ≈1 490 ≈298 замер за 7-часовую сессию 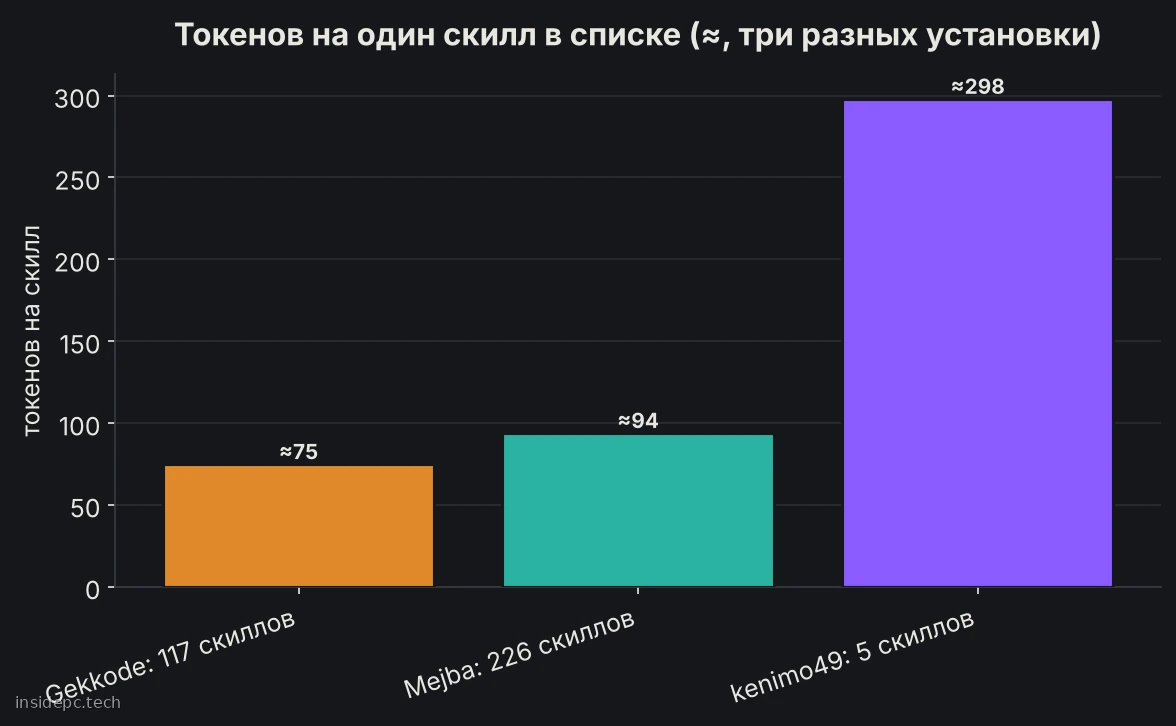
Вывод из графика: чем меньше скиллов, тем «жирнее» у автора описания — у kenimo49 одно описание весит в четыре раза больше, чем у Gekkode. Абсолютные числа зависят от того, как вы пишете description, поэтому смотреть надо на свой отчёт. Автор kenimo49 оценил, что три никогда не сработавших скилла дали около 11% токенов его рабочего дня, но кэширование промпта в расчёт не вошло — так что это верхняя оценка.
Почему токены — не главная беда, показывает работа исследователей Databricks «More Skills, Worse Agents?» (arXiv, май 2026). На бенчмарке SkillsBench (88 задач) доля решённых задач (pass rate) при переходе от небольшого набора заведомо полезных скиллов к библиотеке из 202 скиллов снижалась на величину до 21%. Авторы разложили падение на две части. «Затенение» (skill shadowing) — агент выбирает не тот скилл — росло с размером библиотеки. Вклад самого раздутого контекста оказался неотличим от нуля.


На кадре со страницы arXiv (снят 2 ноября 2026 года) рамкой выделена аннотация, где это сказано дословно: узкое место — ошибка выбора скилла, а не увеличенный контекст. Оговорка: это одна работа и две модели Anthropic (Haiku 4.5 и Sonnet 4.6), проверенные вне Claude Code. Но вывод для аудита прямой — проверять надо, не перекрывают ли описания друг друга, а не только сколько скиллов установлено. Похожую картину для инструкций дал тест IFScale (arXiv, июль 2025): при 500 одновременных инструкциях лучшие модели того времени выполняли около 68% из них. Задача там другая, переносить цифру на CLAUDE.md напрямую нельзя, но направление то же: чем больше правил, тем ниже доля исполненных.
Отчёт /skill-doctor: как читать колонки и что с ним делать
Мы запустили claude -p "/skill-doctor" 2 ноября 2026 года в облачной сессии на Claude Code 2.1.316, в рабочем проекте редакции. Отчёт перечислил 52 скилла: 28 личных и проектных (27 проектных и один личный), 10 из подключённого плагина data и 14 синхронизированных с claude.ai. Фрагмент вывода — по строке каждого происхождения и итоговые подсказки:
$ claude -p "/skill-doctor"
Skills loaded this session

  skill                                   source           context  7d tokens   uses  last used
  session-start-hook                      userSettings        ~100          -     0×  never
  system-check                            projectSettings     ~210          -     0×  never
  monthly-digest                          projectSettings     < 20          -     0×  never
  data:data-context-extractor             data                ~280          -     0×  never
  anthropic-skills:docs                   claude.ai sync      ~340          -     0×  never
  ...
28 skills loaded but never invoked. Each one adds to the system prompt every turn.
   Disable in /skills, or remove from .claude/skills.
14 skills synced from claude.ai loaded but never invoked. ... Disable in /skills, or turn them
   off on claude.ai — a deleted synced copy is re-downloaded on the next sync.
10 plugin skills loaded but never invoked, from data. ... Plugin skills can't be turned off
   individually — disable the plugin in /plugin.
| Колонка | Что значит | На что смотреть |
|---|---|---|
source | откуда скилл: userSettings — личный, projectSettings — проекта, имя плагина (у нас data) или claude.ai sync | от источника зависит, где его отключать |
context | вес строки скилла в списке, который уходит на каждом ходу | чистку начинайте с самых тяжёлых |
7d tokens | токены, отнесённые к скиллу за последние 7 дней сессий на этой машине; прочерк — за неделю к скиллу не отнесено ни одного токена | реальная работа скилла |
uses / last used | сколько раз вызывали и когда последний раз | «0× never» — кандидат, а не приговор |
У нас все 52 строки показали «0×, never». Причина не в том, что скиллы мёртвые: облачная среда создаётся с нуля, и истории вызовов на этой машине просто нет. Тот же эффект будет на новом ноутбуке или после переустановки. Вес строк — от «< 20» до примерно 340 токенов. У 28 личных и проектных скиллов в сумме выходит около 2,6–2,7 тыс. токенов, у всех 52 — около 7,3 тыс.
Итоговые строки отчёта полезнее таблицы: они говорят, где отключать каждую группу. Скиллы проекта — в /skills или удалением из .claude/skills. Синхронизированные — в /skills или на claude.ai, потому что удалённая копия скачается заново при следующей синхронизации. Скиллы плагина по одному не отключаются вовсе — только весь плагин через /plugin.
Почему /context показывает в строке Skills 9,6 тыс., а сумма по /skill-doctor меньше? Мы открыли полную таблицу /context того же дня. В строку Skills там входят все 68 скиллов списка, включая 16 встроенных (bundled) — вроде /claude-api и /code-review — на ≈2,4 тыс. токенов. /skill-doctor встроенные скиллы по документации не охватывает; отключают их отдельно — настройкой disableBundledSkills или по одному через skillOverrides. Сумма по группам из /context — ≈9,7 тыс., что сходится со строкой Skills с точностью до округления.
Как принимать решение по отчёту:
- Накопите историю. Запускайте отчёт там, где вы реально работаете, и не раньше чем через пару недель обычной работы — иначе все строки будут «never».
- Отсортируйте по
context. Документация советует начинать с самых дорогих по весу скиллов из тех, что отчёт предлагает отключить. - Проверьте каждого кандидата вопросом «он редкий или мёртвый?». Скилл для ежеквартального отчёта покажет «0× за неделю» и при этом нужен.
- Мёртвый — в
off, редкий — вname-onlyилиuser-invocable-only. Как это сделать, разобрано в разделе про чистку ниже. - Скиллы плагинов отключайте через
/plugin. НастройкаskillOverridesна них не действует.
Предел отчёта сформулировал Implicator.ai: инструмент фиксирует, запускался ли скилл и сколько места занял, но не то, улучшил ли он результат. Редкая, но ценная процедура в отчёте выглядит так же, как мёртвый груз.
Аудит CLAUDE.md командой prompt-audit: разбор реального отчёта
/doctor prompt-audit — встроенный аудит инструкций: Claude читает ваш CLAUDE.md, скиллы, субагентов и команды и ищет устаревшее и противоречивое. Правила, которые устарели именно с приходом нового поколения моделей, мы разбирали в материале про context engineering для Claude 5 — там же обещали отдельный разбор инструментов. Здесь — сам процесс на живом примере.
Для проверки мы собрали песочницу: CLAUDE.md из семи правил с подложенными ошибками, package.json с двумя скриптами (test и build) и скилл deploy. Вот файл целиком:
# Project notes
- Always use claude-3-opus for any model call. IMPORTANT: THINK STEP BY STEP before every answer or the output will be wrong!
- Run `npm run lintfix` before every commit.
- Follow the conventions in docs/STYLE_GUIDE.md.
- Indentation: use 4 spaces everywhere.
- Indentation: use 2 spaces everywhere.
- Never use semicolons in JS.
- Always end every JS statement with a semicolon.
Прогон claude -p "/doctor prompt-audit" 2 ноября 2026 года на Claude Code 2.1.316 с моделью claude-opus-5-5 занял 10 ходов, 66,5 секунды и $0.89 по счётчику total_cost_usd. Область аудита мы сузили настройкой claudeMdExcludes, иначе в проверку попал бы CLAUDE.md основного проекта. Отчёт нашёл 8 проблем и ничего не изменил — правки предложены в виде diff в конце.№ Где Что нашёл аудит Уверенность Предложенное действие 1 CLAUDE.md:2 имя модели claude-3-opus — модель снята с поддержкивысокая переписать на актуальную 2 CLAUDE.md:2 «THINK STEP BY STEP» капсом — у модели мышление и так всегда включено высокая удалить 3 CLAUDE.md:3 npm run lintfix — такого скрипта в package.json нетвысокая удалить или заменить реальной командой 4 CLAUDE.md:4 docs/STYLE_GUIDE.md не существуетвысокая удалить или вернуть файл 5 skills/deploy:5 ./scripts/deploy.sh и npm run publish-all не существуютвысокая удалить скилл или исправить шаги 6 CLAUDE.md:5–6 4 пробела против 2 пробелов высокая решаете вы 7 CLAUDE.md:7–8 «никогда точку с запятой» против «всегда точку с запятой» высокая решаете вы 8 skills/deploy:3 описание «Does deployment stuff» слишком размытое средняя переписать, если скилл остаётся
Сверх восьми пунктов аудит с низкой уверенностью предложил добавить скиллу disable-model-invocation: деплой — действие наружу, его лучше запускать только руками. Противоречия 6 и 7 в diff не попали: аудит прямо написал, что без истории git не может понять, какое правило новее, и выбор оставил человеку. Фрагмент предложенной правки:
- - Always use claude-3-opus for any model call. IMPORTANT: THINK STEP BY STEP before every answer or the output will be wrong!
+ - Use `claude-opus-5-5` for model calls.
Ещё одна полезная деталь — отчёт прямо перечисляет, чего он не проверил. В нашей песочнице доступ за пределы папки был закрыт, и аудит написал, что не смотрел личный ~/.claude, родительские папки и скиллы установленного плагина. По умолчанию prompt-audit охватывает CLAUDE.md, CLAUDE.local.md и AGENTS.md, а также правила, скиллы, команды, субагентов и стили вывода в .claude/ и ~/.claude/. Чтобы проверить только проект, передайте путь: /doctor prompt-audit ..
Насколько результат зависит от модели, проверил независимый тест bestagent.dev (4–7 октября 2026, Claude Code 2.1.289): в репозиторий подложили 9 проблем и 6 контрольных строк-«ловушек» и гоняли аудит по три раза на каждой модели.Модель Найдено из 9 Цена прогона по API Время Opus 5.5 9 во всех прогонах ≈$0.75 62 с Sonnet 5.5 9 во всех прогонах ≈$0.41 45 с Haiku 4.5 5, 7 и 6 (в среднем 6) ≈$0.20 69 с Haiku 5.5 (повтор 07.10.2026) 9 в трёх прогонах из трёх ≈$0.04 н/д 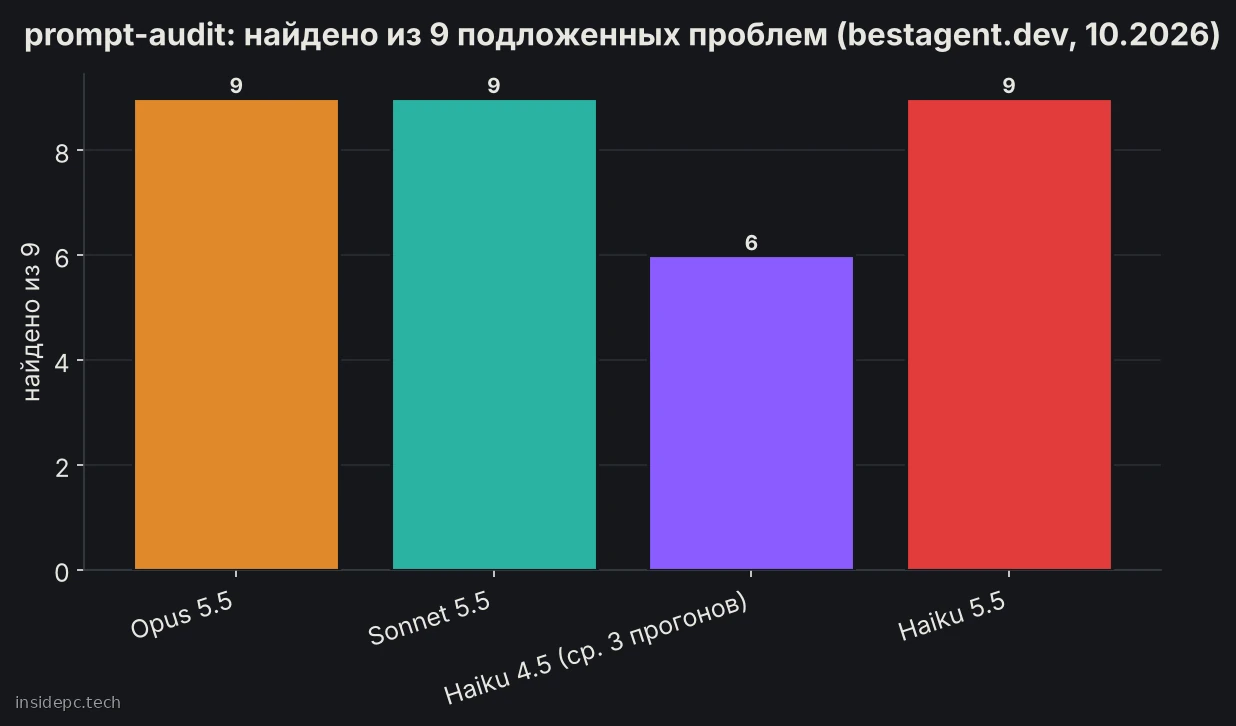
Вывод: Haiku 4.5 во всех трёх прогонах пропустил несуществующий npm-скрипт и отсутствующий скрипт деплоя — ровно тот класс ошибок, ради которого аудит и запускают. Повтор 7 октября на той же модели дал 3, 5 и 8 находок. Аудит работает на модели вашей сессии, поэтому перед запуском переключитесь на Opus или Sonnet командой /model.
Чистка CLAUDE.md и скиллов по шагам: что вырезать, что вынести в хук
Сначала — что вообще оставлять. Документация Claude Code называет CLAUDE.md контекстом, а не принудительной конфигурацией: правило в нём выполняется в большинстве случаев, но не в каждом. Каждая строка этого файла забирает немного внимания модели на каждой задаче, даже если к задаче не относится. Поэтому в нём живёт то, чего Claude не выведет из кода сам: подводные камни, причины решений и соглашения, которые расходятся с поведением инструментов по умолчанию.
На кадре из документации (2 ноября 2026 года) выделены два пункта. Первый — ориентир «меньше 200 строк на файл CLAUDE.md»; там же сказано, что импорты через @ помогают навести порядок, но стоимость в контексте не снижают — импортированный файл грузится вместе с основным. Второй — если две инструкции противоречат друг другу, Claude может выбрать любую из них произвольно.
Ориентир в строках обманчив. CLAUDE.md рабочего проекта нашей редакции занимает 99 строк — вдвое меньше ориентира, — но по /context весит 30,3 тыс. токенов: строки там длиной в абзац. Это 3% окна в 1 млн токенов на каждом ходу. Смотрите на токены в /context, а не на число строк.
Полный чекап /doctor (он же /checkup) сам предложит урезать CLAUDE.md: вырежет то, что выводится из кода — дерево папок, список зависимостей, обзор архитектуры, — и оставит грабли и соглашения. Дальше — порядок, в котором мы чистим сами:
- Снимите базу. Запишите цифры
/context(строки Memory files и Skills) и сохраните вывод/skill-doctor— без них не понять, что дала чистка. - Уберите выводимое из кода. Структура проекта, стек, версии библиотек — Claude прочитает их из репозитория.
- Разрешите противоречия. Аудит их находит, но выбрать правило должен человек. Помогает история git: обычно новее та строка, что добавлена позже.
- Жёсткие правила — в хуки. Хук — скрипт, который Claude Code запускает сам на событии, например перед завершением хода. Документация best practices прямо пишет: если вы всё сильнее выделяете строку в CLAUDE.md, а Claude её всё равно пропускает, этой строке место в хуке.
- Процедуры — в скиллы и правила по путям. Инструкция «как деплоить» нужна раз в неделю — ей место в скилле, который грузится по вызову. Правило для одной папки — в
.claude/rules/с привязкой к путям. Как собрать сам скилл, мы разбирали в материале SKILL.md без магии. - Скиллы — по состояниям
skillOverrides. Таблица ниже. - Один пункт за раз. После каждой правки — обычная задача в свежей сессии и сравнение с базой. Методика
prompt-audit.mdот Anthropic формулирует это так: аудит, который ничего не нашёл, ничего и не должен менять.
Состояние в skillOverrides | Модель видит | В меню / | Когда ставить |
|---|---|---|---|
on (по умолчанию) | имя и описание | да | рабочий скилл, который Claude должен подбирать сам |
name-only | только имя | да | нужный, но второстепенный — освобождает бюджет описаний |
user-invocable-only | не видит | да | редкий и ценный, запускаете только вы |
off | не видит | нет | мёртвый скилл или дубль |
Задать skillOverrides можно в любом файле настроек, но проще всего — через меню /skills: выделить скилл, пробелом переключить состояние, Esc для сохранения (меню пишет в .claude/settings.local.json). Если готовы править сам SKILL.md, вместо user-invocable-only можно поставить во frontmatter disable-model-invocation: true — так делают со скиллами, у которых есть побочные эффекты вроде деплоя или отправки сообщений.Что нашли Куда Почему описание структуры проекта, стек удалить Claude выведет из кода «всегда/никогда» про тесты, форматирование, секреты хук правило в CLAUDE.md не гарантировано пошаговая процедура на 20 строк скилл грузится только по вызову правило для одной папки .claude/rules/ с путямигрузится при работе с этими файлами грабли, причины решений, нестандартные соглашения оставить из кода не выводятся
Проверка самих скиллов: plugin validate, eval и ручной тест
Битый YAML во frontmatter — самая тихая поломка скилла. По документации, такой скилл загружается с пустыми метаданными: по имени /skill-name он запускается, но Claude не может подобрать его по описанию. Ошибки вы не увидите, скилл просто перестанет срабатывать сам. Ловит это claude plugin validate, несмотря на название — не только для плагинов: команда принимает и обычную папку со скиллами (с версии 2.1.233).
Мы прогнали её 2 ноября 2026 года на трёх тестовых скиллах: с битым YAML, без описания и корректном.
$ claude plugin validate skills
Validating skill: .../skills/bad-yaml/SKILL.md
× Found 1 error:
  > frontmatter: YAML frontmatter failed to parse: YAML Parse error: Unexpected token.
    At runtime this skill loads with empty metadata (all frontmatter fields silently dropped).

Validating skill: .../skills/vague/SKILL.md
‼ Found 1 warning:
  > description: No description in frontmatter.

× Validation failed
exit=1
Корректный скилл прошёл без замечаний, итог — код выхода 1. Флаг --json выдаёт тот же отчёт для скриптов с теми же кодами выхода, а --strict по справке превращает в ошибки и предупреждения — так удобно ставить проверку в CI (автоматическую проверку перед слиянием кода). Для проекта команда выглядит как claude plugin validate .claude/skills, для личных скиллов — claude plugin validate ~/.claude/skills.
Validate проверяет форму, но не смысл. Документация формулирует разницу точно: если скилл сработал, это значит, что Claude его нашёл, а не что он сделал нужное. Мерить надо две вещи по отдельности — вызывается ли скилл на тех запросах, где должен, и совпадает ли результат с ожиданием.
Для плагинов это автоматизирует claude plugin eval: каждый кейс из папки evals/ гоняется в изолированной сессии дважды — с плагином и без него, результат оценивают грейдеры (проверочные промпты), а при оценке ниже порога команда завершается с ненулевым кодом. Справка версии 2.1.316 предупреждает: прогон идёт на вашей машине от вашего имени, поэтому оценивать стоит только плагины, которым вы доверяете. Сами мы plugin eval на реальном плагине не запускали — подходящего плагина с набором кейсов под рукой не было.
Для одиночного скилла хватает ручного теста:
- Соберите 3–5 реальных запросов, на которых скилл должен сработать, и 2–3, на которых не должен.
- Прогоните каждый в свежей сессии со скиллом и без него (
offвskillOverrides). - Сравните, сработал ли скилл и чей результат лучше. Свежая сессия обязательна: остатки контекста от написания скилла маскируют дыры в инструкции.
Риски аудита: где он ошибается и чего нельзя вырезать
| Риск | Что происходит | Как подстраховаться | Источник, дата |
|---|---|---|---|
| Редкий скилл похож на мёртвый | /skill-doctor видит вызовы и вес, но не пользу | name-only или user-invocable-only вместо off | Implicator.ai, 07.09.2026 |
| Свежая среда — пустая история | у всех скиллов «0×, never» | судить только по машине с историей | наш прогон, 02.11.2026 |
| Аудит слабее на слабой модели | Haiku 4.5 нашёл 5–7 из 9 и пропустил битые команды | запускать на Opus или Sonnet | bestagent.dev, 04–07.10.2026 |
| Ложные «битые пути» | без контекста репозитория аудит путает пути | запускать из корня проекта, проверять каждую находку | Piekwerk (dev.to), 26.09.2026 |
| Личные файлы в области аудита | по умолчанию проверяется и ~/.claude — правка заденет все проекты | /doctor prompt-audit . | доки Claude Code, 02.11.2026 |
| Слепая чистка ради короткого файла | удаляются правила, которые держали поведение | правка по одной, проверка после каждой | anthropics/skills, prompt-audit.md |
Отдельно о громком аргументе «Anthropic сама срезала промпт». 24 июля 2026 года сотрудник Anthropic написал, что из системного промпта Claude Code для моделей уровня Opus 5 убрали больше 80% текста без измеримых потерь на внутренних тестах кода. Это заявление вендора: оценки не опубликованы, независимого замера нет. Повод перепроверить свой CLAUDE.md — да, повод вырезать вслепую — нет.
Методика prompt-audit.md называет ещё одну ловушку — «ловушку свежести»: одна неудачная сессия превращается в вечное правило. Агент однажды запустил не тот тест, в CLAUDE.md появилась строка капсом, через полгода причины никто не помнит, а строка висит в контексте каждого хода. Обратное тоже вредно: правило, которое предотвращает реальную поломку, аудит может счесть лишним, если не видит истории. Поэтому финальное слово по каждой находке — за человеком, который знает проект.
Сторонние skill-doctor и claude-md-improver: когда они нужны
Имя «Skill Doctor» носит не только встроенная команда: на 2 ноября 2026 года выдача по нему — это в основном сторонние проекты. Они делают другое, и путать их со встроенной командой не стоит.Инструмент Кто делает Откуда берёт данные Что выдаёт /skill-doctor (встроенный)Anthropic, Claude Code статистика сессий на машине вес и вызовы каждого скилла skill-doctor от Warp Warp, warpdotdev/common-skillsистория ваших диалогов с агентом, локально оценку скиллов и черновики правок, страницу-отчёт skill-doctor от независимых авторов (ssamba1, amaljithkuttamath и др.) сообщество, GitHub файлы скиллов и логи использования аудит пересечений, раздутости, устаревания — по-разному у каждого claude-md-improver + /revise-claude-mdAnthropic, официальный плагин claude-md-managementCLAUDE.md и текущий код; итоги сессии правки CLAUDE.md под изменения кода; новые правила по итогам сессии
Сторонние инструменты закрывают то, чего нет у встроенного: например, README проекта ssamba1 прямо говорит, что встроенные средства не ловят коллизии триггеров между скиллами. Именно эту дыру подсвечивает исследование про затенение. Но сторонний скилл — это код и инструкции, которые выполняются с правами вашего Claude Code: читает файлы, запускает команды, а вариант Warp ещё и разбирает историю диалогов. Перед установкой прочитайте его SKILL.md и скрипты целиком, ставьте из репозитория с понятным автором и историей коммитов.
Когда что брать. Чтобы понять, что тратит контекст, хватит встроенного /skill-doctor. Для проверки текста инструкций — /doctor prompt-audit. Если CLAUDE.md регулярно отстаёт от кода, пригодится официальный claude-md-improver. Сторонний skill-doctor имеет смысл, когда скиллов десятки и вы подозреваете, что они перебивают друг друга.
Как часто аудитить скиллы и CLAUDE.md: ритм и чек-лист
Единого стандарта частоты нет ни у Anthropic, ни у авторов тестов. Ниже — ритм, который мы предлагаем сами, исходя из того, что ломает инструкции.
Триггеры для полного аудита:
- смена модели — например, переход на новое поколение Opus или Sonnet: методика Anthropic прямо говорит, что обходной приём, нужный одному поколению, на следующем становится мёртвым грузом;
- обновление Claude Code с изменениями в скиллах или CLAUDE.md в changelog;
- пачка новых скиллов — условно, плюс 10 к библиотеке;
- рост строки Memory files или Skills в
/contextлибо CLAUDE.md за ориентиром в 200 строк; - агент начал «не замечать» правило — сигнал к его переносу в хук, а не к ещё одному «IMPORTANT».
Чек-лист одного прохода:
- Записать версию Claude Code, модель и цифры
/context. - Запустить
/skill-doctorна рабочей машине с историей. - Разделить кандидатов на «мёртвые» и «редкие», выставить
off/name-only/user-invocable-only. - Скиллы плагинов разобрать в
/plugin. - Запустить
/doctor prompt-audit .на Opus или Sonnet. - Проверить каждую находку руками: путь существует? команда есть в
package.json? - Противоречия решить самому, жёсткие правила перенести в хуки.
- Прогнать
claude plugin validate .claude/skills. - Вносить правки по одной и проверять на обычной задаче в свежей сессии.
- Записать итог и снова снять
/context.
Шаблон записи, чтобы через три месяца было с чем сравнить:
Аудит <дата> · Claude Code <версия> · модель: <модель>
/context до: Memory <N>k · Skills <N>k → после: Memory <N>k · Skills <N>k
prompt-audit: находок <N> · принято <N> · отложено <N> (противоречия — решение за человеком)
skill-doctor: off — <N> · name-only — <N> · user-invocable-only — <N>
Что устареет первым: номера версий, бюджеты списка скиллов и цены прогонов. Перед аудитом сверяйтесь с разделами «Find unused skills» и «Write effective instructions» документации Claude Code и с её changelog.
FAQ
Что делает /skill-doctor в Claude Code и с какой версии он есть? Команда показывает, сколько контекста занимает каждый загруженный скилл на каждом ходу, сколько раз его вызывали и когда последний раз, а также давно не использованные плагины. Она появилась в версии 2.1.261, вышедшей 4 сентября 2026 года, а документация называет минимальную версию 2.1.252. CLAUDE.md и пользу скиллов команда не оценивает.
Чем /doctor prompt-audit отличается от /skill-doctor?
/skill-doctor считает цену и вызовы скиллов и не читает их текст. /doctor prompt-audit читает текст CLAUDE.md, скиллов, субагентов и команд и ищет устаревшие формулировки, несуществующие пути и команды, противоречия. Первый отвечает на вопрос «что отключить», второй — «что переписать». Prompt-audit появился в версии 2.1.283 от 25 сентября 2026 года.
Сколько строк должно быть в CLAUDE.md?
Документация Claude Code советует держать каждый файл CLAUDE.md короче 200 строк: длинный файл занимает больше контекста и хуже соблюдается. Но строки — грубая мера: файл из 99 строк-абзацев может весить 30 тыс. токенов. Смотрите строку Memory files в /context и выносите процедуры в скиллы, а правила для отдельных папок — в .claude/rules/.
Как отключить неиспользуемый скилл, не удаляя его?
Через настройку skillOverrides или меню /skills: выделите скилл и пробелом переключите состояние. off скрывает его полностью, name-only оставляет в списке только имя, user-invocable-only прячет от модели, но оставляет запуск командой. Скиллы плагинов этой настройкой не управляются — их включают и выключают в /plugin.
Меняет ли prompt-audit мои файлы сам? Нет. Аудит выдаёт отчёт с находками и предложенным diff, а файлы меняются только после вашей команды применить правки. В нашем прогоне 2 ноября 2026 года в начале отчёта так и написано: «Nothing was edited». Противоречивые правила аудит в diff не включает вовсе и оставляет выбор человеку, потому что не знает, какое из них актуально.
Как часто запускать аудит скиллов и CLAUDE.md?
Мы рекомендуем раз в месяц смотреть /skill-doctor и /context, а полный /doctor prompt-audit запускать по событиям: смена модели, крупное обновление Claude Code, десяток новых скиллов, заметный рост CLAUDE.md. Частый аудит без изменений бесполезен: если находок нет, менять ничего не нужно.