
Коротко (TL;DR)
- MacBook Pro M5 Max із 40-ядерним GPU — єдиний ноутбук Apple зі 128 ГБ єдиної пам’яті (614 ГБ/с). Єдиним Mac із таким обсягом він був до 25 серпня 2026: тепер ті самі 128 ГБ дає Mac Studio на M5 Max, а Mac Studio на M5 Ultra — до 512 ГБ.
- Щільні 70B-моделі в 4-бітному кванті реально працюють зі швидкістю близько 9–11 токенів за секунду. Фізична стеля для 70B вагою 42,5 ГБ на 614 ГБ/с — близько 14,4 ток/с (наш розрахунок), а заміри на GGUF-рушіях дають 9,95 (ручний замір AI-Stat) і 11 ток/с (Ollama в лідерборді llmcheck.net). Цифри лідербордів 15–18 ток/с упираються в стелю або виходять за неї.
- 128 ГБ справді окупаються на MoE-моделях: Qwen 4.1 32B-A3B — 78–82 ток/с, 35B-A3B — близько 100 ток/с, а Qwen3-235B-A22B у ~3 бітах — 18 ток/с, як щільна 70B за втричі більшого розміру.
- Головний приріст покоління — обробка промпту (prefill): заяву Apple «до 4 разів швидше за M4 Max» підтверджено незалежно (3,5–4,5 раза). Генерація тексту зросла лише на ~20%.
- Ціна: 14-дюймовий M5 Max після підвищення цін Apple 26 червня 2026 стартує з $4 099 (було $3 599), але це 36 ГБ. Конфігурація з 40-ядерним GPU, 128 ГБ і 2 ТБ коштує $6 699 за рекомендованою ціною (на 27 серпня 2026). В Україні 16-дюймова версія зі 128 ГБ на 25 жовтня 2026 коштує 369 199 грн.
- RTX 5090 генерує у 2–3 рази швидше, але лише те, що вміщується в її 32 ГБ. 70B-модель у 4 бітах важить близько 42,5 ГБ і в одну таку карту не влазить.
Усі цифри нижче — чужі заміри: біля кожної вказано, хто міряв, на якій моделі та яким рушієм. Власного прогону на цій машині в нас не було. Заміри зібрано на 26 вересня 2026, ціни й наявність оновлено 25 жовтня 2026.
- Коротко (TL;DR)
- Лінійка MacBook Pro M5: для ШІ важлива пам’ять, а не ядра
- Конфігурація M5 Max під LLM: що обрати і скільки коштує
- MacBook Pro M5 Max проти Mac Studio: хто тепер на вершині за пам’яттю
- Скільки токенів за секунду реально видає M5 Max на 70B і MoE-моделях
- M5 Max проти M4 Max: prefill до 4 разів швидший, генерація +20%
- RTX 5090 проти M5 Max: GPU-башта чи ноутбук зі 128 ГБ
- Тротлінг 14-дюймового MacBook Pro: що показують незалежні тести
- Ризики ноутбука Apple для локального ШІ: CUDA, пам’ять, ціна
- Кому варто переплачувати за M5 Max і 128 ГБ, а кому вистачить Pro
- FAQ
Лінійка MacBook Pro M5: для ШІ важлива пам’ять, а не ядра
MacBook Pro M5 Max — ноутбук Apple на старшому чипі покоління M5. Apple анонсувала його 3 березня 2026, продажі стартували 11 березня. Для локального ШІ (в англомовних оглядах — local AI, тобто нейромережа, яка працює на вашому комп’ютері без хмари) у ньому важливі не ядра CPU, а два параметри пам’яті: скільки її і як швидко вона читається. Драбина конфігурацій нижче — за технічними характеристиками Apple та анонсами компанії. Якщо ви ще обираєте між MacBook, Mac mini і Mac Studio, почніть із нашого путівника який Mac обрати: там уся лінійка з цінами в Україні.
Кілька термінів, без яких далі буде складно:
- Єдина пам’ять — спільна оперативна пам’ять для CPU і GPU. Модель не треба копіювати в окрему відеопам’ять, тому більша частина зі 128 ГБ доступна нейромережі.
- Пропускна здатність — скільки гігабайтів за секунду пам’ять віддає чипу. Для генерації тексту це головний параметр.
- Prefill — обробка вашого запиту до першого слова відповіді. Упирається в обчислювальну потужність.
- Decode, або генерація — видача відповіді токен за токеном. Упирається в пропускну здатність пам’яті.
- Токен — шматочок слова; швидкість міряють у токенах за секунду (ток/с).
- Квант — стиснення ваг моделі: «4 біти» означає, що кожен параметр зберігається в 4 бітах замість 16. Модель легша, якість трохи нижча.
| Чип | CPU | GPU | Пропускна здатність | Пам’ять | Старт 14″ (анонс → після 26.06.2026) | Старт 16″ (анонс → після 26.06.2026) |
|---|---|---|---|---|---|---|
| M5 | 10 ядер | 10 ядер | 153 ГБ/с | до 32 ГБ | $1 599 → $1 899 (16 ГБ/512 ГБ) | — |
| M5 Pro | 15 або 18 ядер | 16 або 20 ядер | 307 ГБ/с | 24 / 48 / 64 ГБ (64 — лише з 20-ядерним GPU) | $2 199 → $2 499 (24 ГБ) | $2 699 → $2 999 |
| M5 Max, 32 ядра GPU | 18 ядер | 32 ядра | 460 ГБ/с | лише 36 ГБ | $3 599 → $4 099 | $3 899 → $4 899 |
| M5 Max, 40 ядер GPU | 18 ядер | 40 ядер | 614 ГБ/с | 48 / 64 / 128 ГБ | від $4 699 (48 ГБ) | від $5 599 (48 ГБ) |
Ціни — рекомендовані в США. 26 червня 2026 Apple підняла ціни на всю лінійку Mac на тлі дефіциту пам’яті; цифри «до» і «після» — за зведенням Basic Apple Guy, ціни 14-дюймових M5 Pro і M5 Max ми перевірили на apple.com 25 жовтня 2026. Базовий 14-дюймовий M5 у магазині Apple на цю дату коштує від $1 999 — це версія з 16 ГБ і 1 ТБ.
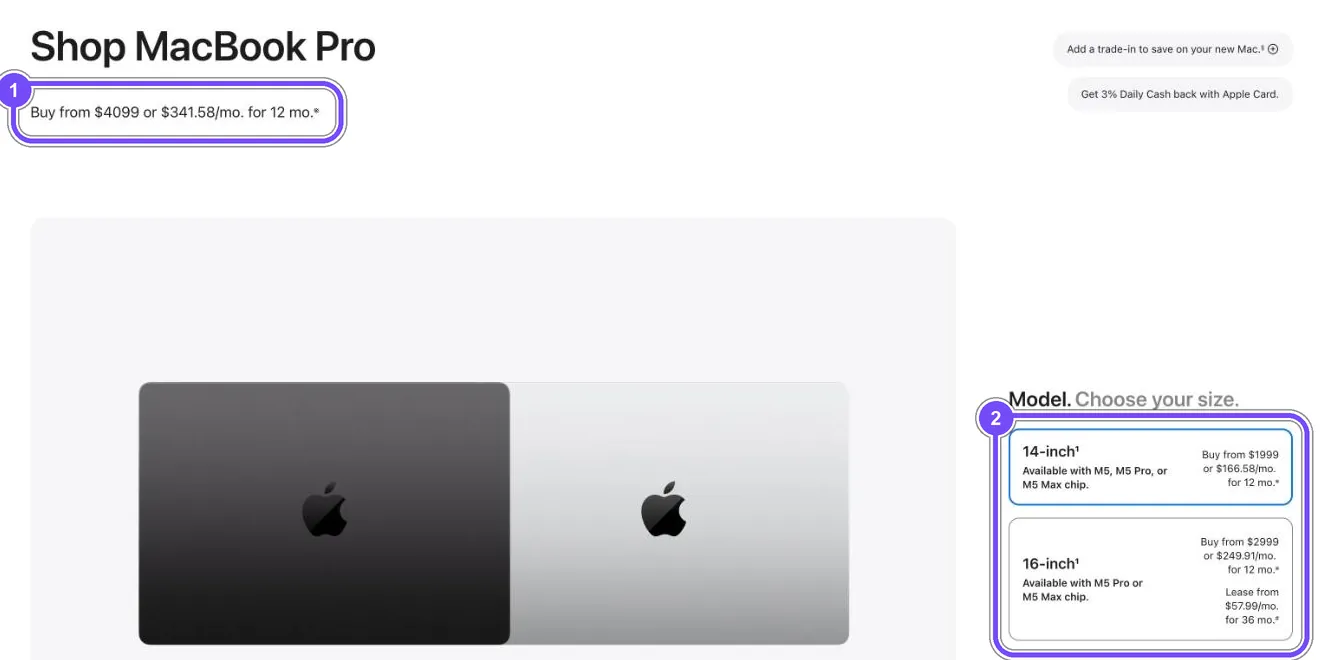
Сторінка M5 Max у магазині Apple, знято 25 жовтня 2026: цифра 1 — стартова ціна 14-дюймового M5 Max після підвищення, цифра 2 — мінімальні ціни 14- і 16-дюймового корпусу з найдоступнішим чипом.
З таблиці випливають три висновки, які визначають усю покупку.
Перший: 128 ГБ є лише в M5 Max із 40-ядерним GPU. Стартова версія M5 Max за $4 099 (до 26 червня 2026 — $3 599) — це 32 ядра GPU, 460 ГБ/с і фіксовані 36 ГБ. На ній 70B-модель не запуститься взагалі.
Другий: швидкість генерації зростає разом із пропускною здатністю, а не з кількістю ядер. Щоб видати черговий токен, щільна модель читає з пам’яті всі свої ваги. Тому 614 ГБ/с проти 307 ГБ/с у M5 Pro — це приблизно вдвічі більше токенів за секунду на одній і тій самій моделі.
Третій: 128 ГБ не означають 128 ГБ під модель. macOS за замовчуванням віддає відеоядру близько 75% єдиної пам’яті, тобто приблизно 96 ГБ зі 128. Спільнота піднімає цей ліміт командою з розділу про софт нижче, до ~110 ГБ, і він скидається після перезавантаження (дані Local AI Master).
В українському роздрібному продажу M5 Max на 25 жовтня 2026 вже є. У каталозі Foxtrot 14-дюймовий M5 Max із 36 ГБ і 2 ТБ коштує 256 999 грн, 16-дюймовий із тими самими 36 ГБ — 271 999 грн, 16-дюймовий із 40-ядерним GPU і 48 ГБ — 312 999 грн. Версію під локальний ШІ, 16 дюймів зі 128 ГБ і 2 ТБ, Jabko продає за 369 199 грн із позначкою «залишилось мало»; 14-дюймову зі 128 ГБ в офіційному роздрібному продажу ми не знайшли. Базовий MacBook Pro M5 із 16 ГБ і 1 ТБ у Foxtrot — 120 999 грн (у квітні 2026 було 99 499 грн). Для локального ШІ це машина класу моделей на 4–8 млрд параметрів.
Конфігурація M5 Max під LLM: що обрати і скільки коштує
Під локальні моделі має сенс збирати одну конкретну конфігурацію, а не «максимум усього». Розкладка за конфігуратором:
| Параметр | Що обрати | Ціна на 27 серпня 2026 | Чому |
|---|---|---|---|
| Чип | M5 Max, 18 ядер CPU, 40 ядер GPU | входить у підсумок нижче | лише з ним доступні 128 ГБ і 614 ГБ/с |
| Пам’ять | 128 ГБ | входить у підсумок нижче | 70B із запасом під контекст, MoE-моделі на 100+ млрд параметрів |
| Накопичувач | стандартні 2 ТБ | входить у підсумок нижче | 70B-модель у 4 бітах важить близько 42,5 ГБ; SSD читає до 14,5 ГБ/с |
| Корпус | 16″, якщо модель працює годинами | після 26 червня 2026 16″ із 40 ядрами GPU дорожчий за 14″ на $900 ($5 599 проти $4 699 за 48 ГБ) | більше запасу з охолодження, див. розділ про тротлінг |
| Разом, 14″, 40 GPU / 128 ГБ / 2 ТБ | $6 699 рекомендована ціна |
Ціну $6 699 за таку конфігурацію наводить AppleInsider на 27 серпня 2026: партнер Apple Expercom тоді продавав її за $5 299 зі знижкою $1 400 за обмеженого запасу. Цифра збігається з розрахунком: у магазині Apple на 25 жовтня 2026 14-дюймовий M5 Max із 40-ядерним GPU і 48 ГБ коштує від $4 699, перехід із 48 на 128 ГБ після червневого підвищення — ще $2 000 (за скриншотами конфігуратора в переказі Digital Trends), разом $6 699. Basic Apple Guy для тієї самої конфігурації називає $6 999, а для 16-дюймової зі 128 ГБ і 2 ТБ — $7 199; остаточну ціну показує лише конфігуратор.
Наш розрахунок: скільки коштує перехід до 128 ГБ. Різниця між стартовим 14-дюймовим M5 Max ($4 099 після 26 червня 2026, 36 ГБ, 32 ядра GPU) і конфігурацією під локальний ШІ ($6 699) — $2 600. За ці гроші ви отримуєте +92 ГБ пам’яті, +33% пропускної здатності (614 проти 460 ГБ/с) і +8 ядер GPU. Якщо віднести всю доплату на пам’ять, виходить близько $28 за кожен додатковий гігабайт. Чиста доплата за пам’ять у Apple — $2 000 за 80 ГБ, тобто $25 за гігабайт; до підвищення та сама опція коштувала $1 000.
Ціна цієї конфігурації може знову зрости. У 2026 році Apple посеред циклу прибирала опції великої пам’яті в Mac Studio на тлі дефіциту DRAM (за даними MacRumors у переказі Local AI Master), а 26 червня підняла ціни на всю лінійку Mac: стартовий 14-дюймовий M5 Max подорожчав на $500, доплата за 128 ГБ подвоїлася, стартова ціна Mac Studio зросла з $1 999 до $2 499 (Basic Apple Guy, Digital Trends, Macworld).
MacBook Pro M5 Max проти Mac Studio: хто тепер на вершині за пам’яттю
Коротка відповідь на 26 вересня 2026: за обсягом пам’яті на вершині Mac Studio на M5 Ultra (до 512 ГБ), а MacBook Pro M5 Max і Mac Studio на M5 Max ділять друге місце зі 128 ГБ. Ноутбук зберігає одну унікальну властивість — це єдині 128 ГБ, які можна закрити й забрати із собою.
Хронологія: як «єдиний Mac зі 128 ГБ» застарів за 9 днів
Гайд Local AI Master від 16 серпня 2026 назвав ноутбук на M5 Max найємнішим за пам’яттю Mac, який продає Apple («the highest-memory Mac Apple sells»). На дату публікації це було правдою. Ось як змінювалася картина:Дата Що сталося Максимум пам’яті в Mac 11 березня 2026 старт продажів ноутбука на M5 Max зі 128 ГБ ноутбук — 128 ГБ березень 2026 Apple прибирає опцію 512 ГБ у Mac Studio M3 Ultra Mac Studio — 256 ГБ до травня 2026 у Mac Studio зникають 256 і 128 ГБ, M3 Ultra лишається з фіксованими 96 ГБ ноутбук на M5 Max — 128 ГБ 16 серпня 2026 Local AI Master: M5 Max MacBook Pro — «the highest-memory Mac Apple sells» правда на цю дату 25 серпня 2026 Apple анонсує Mac Studio на M5 Max (до 128 ГБ) і M5 Ultra (до 512 ГБ, 1,2 ТБ/с) 512 ГБ (анонс) 22 вересня 2026 початок постачань нового Mac Studio; версія на 512 ГБ — наприкінці жовтня 2026 128 ГБ у двох Mac, більше — у M5 Ultra
Джерела хронології — Local AI Master (з посиланням на MacRumors) та офіційний анонс Mac Studio від 25 серпня 2026. Mac Studio попереднього покоління на M3 Ultra з його цифрами ми розбирали окремо.
Порівняння MacBook Pro vs Mac Studio на 26 вересня 2026
| Параметр | MacBook Pro 14″ M5 Max | Mac Studio M5 Max | Mac Studio M5 Ultra |
|---|---|---|---|
| Максимум пам’яті | 128 ГБ | 128 ГБ | 512 ГБ (з кінця жовтня 2026) |
| Пропускна здатність | 614 ГБ/с (40 ядер GPU) | 614 ГБ/с (40 ядер GPU) | 1,2 ТБ/с |
| Стартова ціна в США | $4 099 (36 ГБ, після 26 червня 2026); 128 ГБ — $6 699 | $2 499 за базову конфігурацію | $5 499 |
| Екран, клавіатура, батарея | є | немає | немає |
| Охолодження під тривалим навантаженням | обмежене корпусом | настільне | настільне |
| Можна взяти із собою | так | ні | ні |
Між MacBook Pro і Mac Studio на M5 Max за однакових 128 ГБ і однакових 614 ГБ/с різниця зводиться до корпусу: за ноутбук ви доплачуєте за екран, батарею й мобільність, а втрачаєте запас охолодження. Ціну Mac Studio M5 Max саме зі 128 ГБ Apple у пресрелізі не називає, тому в таблиці стоїть стартова. Якщо потрібно більше за 128 ГБ або швидше за 614 ГБ/с — це вже Mac Studio M5 Ultra; його пам’ять, реальні заміри й ціни за конфігураціями ми докладно розібрали в огляді Mac Studio M5 Ultra для LLM.
Частина спільноти обирає не «або», а «і». Користувач X 23 вересня 2026 написав, що 96 ГБ — це «ледь достатньо», і він збирається тримати свій MacBook Pro на M3 Max (36 ГБ) поруч із Mac Studio M5 Ultra на 256 або 512 ГБ. Схема робоча: ноутбук для дороги й невеликих моделей, настільна машина для важких.
Скільки токенів за секунду реально видає M5 Max на 70B і MoE-моделях
На щільних 70B-моделях у 4-бітному кванті M5 Max зі 128 ГБ реально видає близько 9–11 токенів за секунду. Опубліковані цифри лежать у діапазоні від 9,95 до 18 ток/с, але верхні значення лідерборду впираються у фізичну стелю близько 14,4 ток/с або виходять за неї (розрахунок нижче). На MoE-моделях із ~3 млрд активних параметрів — 78–100 ток/с. Інакше кажучи, 70B відповідає зі швидкістю читання, а швидкі відповіді на цій машині дають MoE-моделі.
Щільні 70B: заміри на GGUF 9,95–11 ток/с, на MLX до 18
| Джерело | Модель і квант | Рушій | ток/с | Тип даних |
|---|---|---|---|---|
| AI-Stat, березень 2026 | Llama 3.3 70B Q4_K_M | н/д | 9,95 | «точний замір» за текстом джерела |
| llmcheck.net | DeepSeek R1 70B | Ollama | 11 | лідерборд |
| llmcheck.net | Llama 3.3 70B Q4_K_M | MLX | 15 | лідерборд |
| llmcheck.net | Llama 5 70B Q4_K_M | MLX | 18 | лідерборд |
Лідерборд llmcheck.net усереднює три прогони на щойно завантаженій системі й зібрав 227 замірів на Apple Silicon (дані в переказі Local AI Master, серпень 2026). Показово, що сам AI-Stat у зведеній таблиці пише «70B Q4_K_M — 18–25 т/с», а рядком нижче наводить точний замір тієї самої моделі — 9,95 т/с. Дві цифри одного видання розходяться вдвічі.
Чому так буває: різні версії моделі (Llama 3.3 і Llama 5 — різні мережі), різний рушій (MLX швидший за Ollama, про це нижче), різна довжина контексту й відповіді. Коротка відповідь на свіжій системі завжди швидша, ніж довгий діалог із заповненим контекстом.
Розрахунок: стеля 70B на 614 ГБ/с — близько 14,4 ток/с
Якщо щільна модель на кожному токені читає всі ваги, швидкість генерації не може перевищити пропускну здатність, поділену на вагу моделі. Файл Llama 3.3 70B у кванті Q4_K_M (формат GGUF для llama.cpp, Ollama і LM Studio) важить 42,5 ГБ, 4-бітна MLX-версія тієї самої моделі — 39,7 ГБ (розміри файлів на Hugging Face на 25 жовтня 2026).
614 ГБ/с ÷ 42,5 ГБ ≈ 14,4 ток/с — теоретична стеля M5 Max на такій моделі; для MLX-версії вона трохи вища, 614 ÷ 39,7 ≈ 15,5 ток/с. Звірмо з нею заміри:Замір ток/с Частка від стелі (14,4 ток/с для GGUF, 15,5 для MLX) AI-Stat, Llama 3.3 70B Q4_K_M 9,95 69% llmcheck.net, DeepSeek R1 70B, Ollama 11 76% llmcheck.net, Llama 3.3 70B, MLX 15 97% llmcheck.net, Llama 5 70B, MLX 18 116%
На практиці генерація до стелі не доходить: частина пропускної здатності йде на читання кешу контексту й накладні витрати рушія. Орієнтир — замір llama.cpp на чипі на два покоління старшому: M3 Max із 40 ядрами GPU (400 ГБ/с) видав на 70B Q4_K_M 7,53 ток/с за стелі близько 9,4, тобто 80% (бенчмарк XiongjieDai на GitHub, травень 2024). Обидва заміри на GGUF-рушіях (AI-Stat і Ollama) лягли в коридор 69–76%. 97% у MLX-заміру — майже ідеальний випадок (джерело при цьому вказує одночасно квант Q4_K_M і рушій MLX, хоча Q4_K_M — формат GGUF), а результат понад 100% для щільної 4-бітної 70B на цій пам’яті неможливий без застережень. Отже, у цьому замірі модель була стиснута сильніше, використовувалося спекулятивне декодування (маленька модель-чернетка пропонує токени, велика перевіряє їх пачкою) або відрізнялася методика. Це наша інтерпретація: порядкової методики лідерборд не розкриває.
Той самий розрахунок для сусідів: у M4 Max (546 ГБ/с) стеля на 70B Q4_K_M — близько 12,8 ток/с, у M5 Pro (307 ГБ/с) — близько 7,2 ток/с. У 64 ГБ M5 Pro модель на 42,5 ГБ формально вміщується, але працює повільно. Плануйте покупку під 9–11 ток/с на щільній 70B (наша оцінка: 69–76% від стелі 14,4, як у замірах на GGUF). Якщо вийде більше — це бонус, а не норма.
MoE-моделі та що вміщується в 128 ГБ
MoE (Mixture of Experts, «суміш експертів») — архітектура, у якій на кожен токен працює лише частина параметрів. Модель цілком лежить у пам’яті, але за крок читається лише її невелика частка. Тому MoE-модель на 32 млрд параметрів із 3 млрд активних генерує зі швидкістю маленької моделі, а знає як велика.Модель Тип і квант Вага Вміщується в 128 ГБ ток/с на M5 Max Джерело Llama 3.1 8B щільна, Q4_K_M н/д так, із великим запасом 138 llmcheck.net Qwen 4.1 32B-A3B MoE, ~3 млрд активних, Q4_K_M н/д так 78–82 llmcheck.net 35B-A3B MoE, ~3 млрд активних н/д так ~100 учасник Hacker News, липень 2026 Llama 3.3 70B щільна, Q4_K_M ~42,5 ГБ так, лишається місце під контекст 9,95–15 AI-Stat, llmcheck.net Qwen3-235B-A22B MoE, 22 млрд активних, ~3 біти ~100 ГБ так, із піднятим лімітом пам’яті GPU 18 llmcheck.net моделі від 220 млрд параметрів (MiniMax M2.5, DeepSeek V4) — — за оцінкою AI-Stat, починають виходити за межі розумного; виняток — сильно стиснуті MoE на кшталт Qwen3-235B-A22B — —
Найпоказовіший рядок — останній із цифрами. Qwen3-235B-A22B утричі більша за щільну 70B, а генерує з тією самою швидкістю, 18 ток/с. Близько 100 ГБ її ваг не вміщуються в 96 ГБ, які macOS віддає GPU за замовчуванням, але вміщуються в 128 ГБ, якщо підняти ліміт. Саме заради таких моделей і варто брати 128 ГБ, а не 64.
Для порівняння: на M5 Pro з 64 ГБ Qwen 4.1 32B-A3B дає 56 ток/с (llmcheck.net). Якщо ваш основний інструмент — MoE-модель такого класу для коду, M5 Pro закриває завдання дешевше.
Софт розганяє те саме залізо: MLX, LM Studio та Ollama
Швидкість на Mac визначає не лише чип, а й рушій, яким ви запускаєте модель. Приклад із вересня 2026: розробник в X (21 вересня) показав Qwen3.8-27B на ноутбуці з M5 Max у LM Studio Bionic з рушієм Splash — близько 120 ток/с в агентному завданні із субагентом. За його словами, на старті моделі трохи більше місяця тому та сама модель на тому самому ноутбуці видавала близько 20 ток/с. Цю цифру 22 вересня переказав інший користувач X — це не незалежний замір. Напрям однаково зрозумілий: цифри на день покупки — не фінальні.
Різницю між рушіями виміряно й у спокійніших умовах, хоча джерела розходяться у відсотках:
- MLX — фреймворк Apple для машинного навчання. За AI-Stat (березень 2026), він на 20–30% швидший за llama.cpp і до 50% швидший за Ollama на генерації, а на prefill розрив сягає 3–5 разів.
- Лідерборд llmcheck.net дає скромніший відрив MLX від Ollama — 5–15% на одній і тій самій моделі.
- Причина розриву на prefill: нейроприскорювачі в ядрах GPU M5 доступні через Metal 4 TensorOps, які підтримує MLX. llama.cpp станом на березень 2026 їх не задіював.
Як розходяться Ollama, LM Studio і llama.cpp на одній моделі, ми окремо розбирали в замірі Ollama, LM Studio і llama.cpp. Мінімальний старт на MLX і зняття ліміту пам’яті GPU виглядають так (команди з гайду Local AI Master):
pip install mlx-lm
mlx_lm.chat --model mlx-community/Llama-3.3-70B-Instruct-4bit

# віддати GPU ~110 ГБ зі 128; скидається після перезавантаження
sudo sysctl iogpu.wired_limit_mb=110000
Після зняття ліміту стежте за графіком «Навантаження на пам’ять» у Моніторингу системи: поки він зелений, усе гаразд. Жовтий колір означає підкачку на диск, і швидкість генерації різко падає.
M5 Max проти M4 Max: prefill до 4 разів швидший, генерація +20%
Neural Accelerators — блоки для матричних обчислень, які Apple вбудувала в кожне ядро GPU покоління M5. Вони пришвидшують prefill, тобто читання вашого запиту, а не видачу відповіді. Apple заявляє для M5 Max обробку промпту LLM до 4 разів швидшу, ніж у M4 Max, і до 6,7 раза швидшу, ніж у M1 Max. Як п’ять поколінь чипа Max різняться швидкістю генерації, prefill і ціною, ми розібрали в порівнянні M1 Max і M5 Max. Незалежні тести заяву Apple підтверджують:Джерело Що міряли M4 Max M5 Max Прискорення Apple, анонс 3 березня 2026 обробка промпту LLM — — до 4x Hardware Corner (у переказі AI-Stat) той самий промпт 81 с 18 с 4,5x jakkuh, YouTube, 22 березня 2026 сценарій фільму цілком, Qwen 3.5 27B у 4 бітах понад 80 с менше 23 с ~3,5–4x jakkuh, та сама модель генерація відповіді 19 ток/с 22,5 ток/с +18% llmcheck.net генерація, Llama 5 70B, MLX, 128 ГБ 15 ток/с 18 ток/с +20%
Генерація зросла скромно, бо пропускна здатність пам’яті зросла лише з 546 до 614 ГБ/с. Звідси й перші розчаровані враження: на короткому запитанні prefill займає частки секунди, і користувач бачить тільки швидкість генерації. У jakkuh обидві машини були з 36 ГБ пам’яті, тобто M5 Max у тесті — версія з 32 ядрами GPU і 460 ГБ/с.
Де прискорення prefill помітне: RAG (відповіді за вашими документами), завантаження PDF і вебсторінок, робота з кодовою базою, ШІ-агенти, які знову й знову перечитують накопичений контекст. Де майже непомітне: звичайний чат із короткими запитаннями.
Наш приклад розрахунку. Візьмімо промпт із тесту Hardware Corner. Якщо агент за одне завдання 20 разів обробляє контекст такого розміру, на M4 Max очікування до першого токена сумарно становитиме близько 27 хвилин (81 с × 20), на M5 Max — близько 6 хвилин (18 с × 20). Генерація в обох випадках забере приблизно однаковий час. Тож якщо ви обираєте між MacBook Pro M5 Max і вже наявним M4 Max зі 128 ГБ, оновлення має сенс лише для роботи з довгим контекстом та агентами.
RTX 5090 проти M5 Max: GPU-башта чи ноутбук зі 128 ГБ
RTX 5090 виграє за швидкістю все, що вміщується в її 32 ГБ відеопам’яті. Ноутбук на M5 Max виграє все, що туди не вміщується. Це головне, що треба знати про порівняння.Параметр MacBook Pro, M5 Max, 128 ГБ RTX 5090 RTX PRO 6000 Blackwell Пам’ять під модель 128 ГБ єдиної пам’яті 32 ГБ GDDR7 96 ГБ GDDR7 Пропускна здатність 614 ГБ/с 1 792 ГБ/с 1 792 ГБ/с Генерація на моделях, які вміщуються база у 2–3 рази швидше на 50–65% швидше Prefill база приблизно в 4 рази швидше швидше 70B у 4 бітах (~42,5 ГБ) вміщується в одну карту не вміщується вміщується Ціна $6 699 за весь ноутбук $1 999 рекомендована, лише карта $8 800 лише за карту (березень 2026) Споживання близько 100 Вт на всю систему 575 Вт лише карта (TDP) 600 Вт лише карта (TDP) CUDA немає є є
Порівняння швидкості й ціна RTX PRO 6000 — за AI-Stat (березень 2026), пропускна здатність RTX 5090 і споживання ноутбука — за BuildMVPFast, рекомендована ціна RTX 5090 і TDP обох карт — за даними NVIDIA. Ціни на карти вказано без решти комп’ютера.
Пропускна здатність RTX 5090 майже втричі вища, звідси й кратний відрив у генерації. Але модель на 42,5 ГБ у 32 ГБ не влізе, і далі є два шляхи: дві карти або вивантаження частини шарів у звичайну оперативну пам’ять, яке різко знижує швидкість. У M5 Max такої проблеми на моделях до ~100 ГБ немає.
Що де обирати:
- Моделі до 32 ГБ і максимальна швидкість — ПК з RTX 5090. Зведення чужих замірів для 5090, 4090 і 3090 ми зібрали в огляді RTX 5090, 4090 і 3090 у локальних LLM.
- 70B без компромісів у швидкості та з CUDA — робоча станція на 96 ГБ відеопам’яті, як у нашому розборі робочої станції на RTX PRO 6000.
- Моделі на 40–100 ГБ і мобільність — ноутбук на M5 Max зі 128 ГБ.
Якщо обираєте між платформами з єдиною пам’яттю загалом, подивіться наше порівняння DGX Spark, Mac Studio і Strix Halo: там ті самі питання розв’язуються на трьох різних архітектурах.
Тротлінг 14-дюймового MacBook Pro: що показують незалежні тести
Тротлінг — зниження частот і потужності чипа, коли корпус не встигає відводити тепло. Обидва знайдені джерела згодні в головному: 14-дюймовий MacBook Pro з M5 Max тротлить, а з M5 Pro — практично ні. Розходяться вони в ступені, бо міряли різне.Джерело Дата Методика Результат HackerNoon, колонка Andrew Schwabe 27 березня 2026 «стале навантаження», стенд і тип навантаження не описано 14″ M5 Max опускається приблизно до 42 Вт; 16″ з тим самим чипом тримає 62+ Вт і випереджає 14″ на 15–18% у реальних завданнях jakkuh, YouTube 22 березня 2026 20-хвилинний стрес-тест 3DMark (графіка) втрата продуктивності 3–5%; із вентиляторами на 100% — 2–3%; у M5 Pro тротлінгу автор не помітив
Чому джерела розходяться: вати проти балів 3DMark
HackerNoon говорить про потужність чипа під тривалим навантаженням і про різницю з 16-дюймовою версією, але не описує, чим навантажував. jakkuh наводить втрату балів у 20-хвилинному графічному тесті. Це дві різні величини: падіння потужності вдвічі не зобов’язане давати падіння балів удвічі, а 20 хвилин 3DMark — не те саме, що багатогодинний прогін моделі.
Для локального ШІ з цього випливає наш висновок, а не замір. Генерація на щільній моделі впирається в пропускну здатність пам’яті, тому урізана потужність має зачіпати її менше. Prefill і MoE-моделі більше навантажують обчислювальні блоки, тому тут обмеження потужності відчутніше. Опосередковано це підтверджує учасник Hacker News: на MoE 35B-A3B він отримує 80 ток/с у режимі високої потужності й 38 ток/с у режимі енергозбереження (модель його чипа в повідомленні не вказано). Обмеження потужності режимом енергозбереження зрізало швидкість на MoE більш ніж удвічі.
Якщо модель працюватиме годинами, обирайте 16-дюймову версію — це позиція і HackerNoon, і Local AI Master. Якщо потрібен саме компактний ноутбук і вистачає 64 ГБ, HackerNoon радить 14-дюймовий M5 Pro: цей чип вкладається в тепловий пакет корпусу.
Жар, шум і батарея під час роботи агентів
14-дюймовий M5 Max комплектується адаптером на 96 Вт, а батарея в нього — 72,4 Вт·год. За HackerNoon, чип може короткочасно брати до 96 Вт, і під важким навантаженням батарея розряджається навіть на зарядці. jakkuh наміряв під тривалим навантаженням 80–90 Вт із розетки. Наша груба оцінка: 72,4 Вт·год за 80–90 Вт — це менше години роботи від повної батареї, тому «ноутбук для ШІ в дорозі» на практиці означає «поруч із розеткою».
Власник MacBook Pro M5 зі 128 ГБ у тій самій гілці Hacker News (липень 2026) пише прямо: під час серйозної роботи з локальними моделями ноутбук обпікає пальці й шумить так, що працювати за ним некомфортно. Його порада — тримати модель на окремому Mac mini подалі від столу й підключатися мережею. Таку бюджетну точку входу ми розбирали в огляді Mac Mini M4 Pro для нейромереж.
Безвентиляторний MacBook Air M5 — окрема історія
MacBook Air M5 не має вентилятора взагалі й під тривалим навантаженням тротлить сильніше за будь-який MacBook Pro M5 — у цьому сходяться HackerNoon і порівняльний відеоогляд Air проти Pro. Для розмов із невеликою моделлю він годиться, для довгих сесій інференсу — ні. Плутати його з тротлінгом 14-дюймового Pro не варто: у Pro вентилятори є, але чип Max потужніший, ніж корпус може охолодити під постійним навантаженням.
Ризики ноутбука Apple для локального ШІ: CUDA, пам’ять, ціна
- Немає CUDA. Дотренування моделей на Mac можливе (MLX-LM уміє QLoRA), але за оцінкою Local AI Master це робочий варіант для моделей на 7–14 млрд параметрів і далеко від екосистеми NVIDIA. Серйозне навчання — це оренда GPU NVIDIA.
- Пам’ять скінченна навіть на 128 ГБ. Власник MacBook Pro зі 128 ГБ написав в X 19 вересня 2026, що вже впирається в ліміт пам’яті, коли паралельно працюють локальна модель і кілька сесій ШІ-кодингу.
- Очікування щодо 70B. Лідерборди на MLX показують 15–18 ток/с, заміри на GGUF-рушіях — 9,95–11, а фізична стеля Q4-моделі на цій пам’яті — близько 14,4. Якщо купуєте заради щільних 70B, закладайтеся на 9–11 ток/с.
- Жар і ціна. Про тротлінг і батарею — розділ вище. Конфігурація зі 128 ГБ може подорожчати або стати дефіцитною: Apple у 2026 році вже прибирала конфігурації з великою пам’яттю посеред циклу.
- Надмірність. Колумніст vc.ru називає 16-дюймовий M5 Max «стріляниною з ядерної гармати по горобцях» для скриптів, інтеграцій та аналітики: така машина виправдана лише для важкого локального ШІ та дата-інженерії.
Що в цій статті застаріє першим: ціни (пам’ять дорожчає, Apple змінює конфігурації посеред циклу), швидкість у токенах за секунду (рушії MLX і LM Studio пришвидшуються з місяця в місяць) і картина з Mac Studio, де версія на 512 ГБ з’явиться наприкінці жовтня 2026. Свіжі ціни дивіться в конфігураторі Apple, свіжі заміри — на лідерборді llmcheck.net і в r/LocalLLaMA.
Кому варто переплачувати за M5 Max і 128 ГБ, а кому вистачить Pro
Рішення ухвалюється за моделлю, яку ви збираєтеся запускати, а не за чипом. Пройдіть кроками згори вниз і зупиніться на першому, що підходить:
- Моделі до 8 млрд параметрів і знайомство з локальним ШІ. Вистачить базового MacBook Pro M5: до 32 ГБ і 153 ГБ/с. За оцінкою Local AI Master, 8B-модель у 4 бітах дасть на ньому близько 30–35 ток/с. В Україні версія з 16 ГБ і 1 ТБ на 25 жовтня 2026 коштує 120 999 грн (Foxtrot).
- Щодня працюєте з моделлю класу 32B, наприклад MoE-кодером. Вибір між MacBook Pro M5 і M5 Pro тут на користь M5 Pro з 64 ГБ: удвічі вища пропускна здатність, ніж у базового M5, 56 ток/с на Qwen 4.1 32B-A3B і відсутність тротлінгу в 14-дюймовому корпусі. Врахуйте: стартові $2 499 (з 26 червня 2026, до того $2 199) — ціна M5 Pro з 24 ГБ, а 64 ГБ доступні лише з 20-ядерним GPU й коштують дорожче.
- Потрібні щільні 70B і MoE-моделі на 100+ млрд параметрів, причому в дорозі. Це і є сценарій старшого ноутбука: M5 Max, 40 ядер GPU, 128 ГБ, стандартні 2 ТБ. Для багатогодинної роботи — 16 дюймів.
- Машина стоятиме на столі. Mac Studio на M5 Max дає ті самі 128 ГБ і 614 ГБ/с; стартова ціна $2 499 — за базову конфігурацію, зі 128 ГБ дорожче. Mac Studio на M5 Ultra — до 512 ГБ і 1,2 ТБ/с.
- Уже маєте M4 Max зі 128 ГБ. Генерація зросте приблизно на 20%. Оновлення виправдане, лише якщо ви багато працюєте з довгим контекстом, RAG або агентами, де prefill став у 3,5–4,5 раза швидшим.
- Потрібна максимальна швидкість на моделях до 32 ГБ або дотренування. Це ПК з відеокартою NVIDIA і CUDA, а не Mac.
Окремо про те, для кого 128 ГБ надмірні. Якщо локальна модель потрібна для чату, невеликих правок коду й перекладу, 70B на 9–11 ток/с буде повільнішою й дорожчою, ніж MoE-модель на M5 Pro. 128 ГБ мають сенс, коли ви точно знаєте, яку модель на 70–235 млрд параметрів запускатимете, і вам треба робити це без хмари та не лише за столом.
FAQ
Скільки коштує MacBook Pro M5 Max зі 128 ГБ пам’яті?
14-дюймовий MacBook Pro з M5 Max (40 ядер GPU), 128 ГБ і 2 ТБ коштує $6 699 за рекомендованою ціною в США на 27 серпня 2026, за даними AppleInsider. Партнер Apple тоді продавав його зі знижкою за $5 299. Стартова ціна M5 Max — $4 099 після підвищення 26 червня 2026 — стосується версії з 36 ГБ і 32 ядрами GPU, на якій 70B-моделі не запускаються. В Україні 16-дюймова версія зі 128 ГБ на 25 жовтня 2026 коштує 369 199 грн (Jabko).
MacBook Pro M5 Max — єдиний Mac зі 128 ГБ пам’яті?
Ні, з 25 серпня 2026. Того дня Apple анонсувала Mac Studio на M5 Max (до 128 ГБ) і на M5 Ultra (до 512 ГБ), постачання почалися 22 вересня. До цього ноутбук на M5 Max справді був єдиним Mac зі 128 ГБ. Тепер він єдиний ноутбук Apple із таким обсягом пам’яті.
Які моделі ШІ реально вміщуються в 128 ГБ пам’яті MacBook Pro?
Щільні моделі до 70 млрд параметрів у 4 бітах (близько 42,5 ГБ) із запасом під контекст, MoE-моделі на 100+ млрд параметрів і Qwen3-235B-A22B у ~3 бітах (близько 100 ГБ) — остання лише з піднятим лімітом пам’яті GPU. За замовчуванням macOS віддає відеоядру близько 96 ГБ зі 128. Більші моделі від 220 млрд параметрів, за оцінкою AI-Stat, починають виходити за межі розумного: Qwen3-235B-A22B вміщується лише завдяки стисненню до ~3 бітів.
Чи тротлить MacBook Pro M5 Max під час тривалої роботи з нейромережами?
14-дюймова версія тротлить, джерела розходяться в ступені. HackerNoon пише про падіння потужності приблизно до 42 Вт і відставання від 16-дюймової версії на 15–18%, 20-хвилинний тест 3DMark у jakkuh показав втрату 3–5%. Для багатогодинної роботи моделей краще 16-дюймовий корпус, у M5 Pro тротлінгу практично немає.
Що швидше для локального ШІ — MacBook Pro M5 Max чи RTX 5090?
RTX 5090 швидша у 2–3 рази в генерації та приблизно в 4 рази в prefill, але лише на моделях, які вміщуються в її 32 ГБ. 70B-модель у 4 бітах важить близько 42,5 ГБ і в одну карту не влазить, а M5 Max тримає моделі до ~100 ГБ. Швидкість на невеликих моделях — за NVIDIA, обсяг і мобільність — за Mac.
Чи варто переплачувати за M5 Max, якщо вистачає M5 Pro?
Ні, якщо ваші моделі вміщуються в 64 ГБ. M5 Pro з 64 ГБ видає 56 ток/с на Qwen 4.1 32B-A3B і не тротлить у 14-дюймовому корпусі. Стартові $2 499 (після підвищення 26 червня 2026) — це версія з 24 ГБ; 64 ГБ потребують 20-ядерного GPU й коштують дорожче. Доплата за M5 Max зі 128 ГБ виправдана під щільні 70B і MoE-моделі на 100+ млрд параметрів.