
Коротко (TL;DR)
- Найменший файл Mistral Large 4 GGUF важить 233 ГБ (1-бітний квант Unsloth), нормальні 4 біти — 605 ГБ, офіційний FP8 — 1,06 ТБ (сума файлів за API Hugging Face станом на 1 листопада 2026). «52B активних параметрів» пам’ять не заощаджують: завантажувати доводиться всі ~1T.
- З готових комп’ютерів модель уміщається лише в Mac Studio M5 Ultra з 512 ГБ — від $22 299 в американському Apple Store (опцію відкрили 28 жовтня 2026), і то тільки у 2–3 бітах. Решта — саморобні станції та сервери: чотири RTX PRO 6000 коштують $53–68 тис. лише за карти.
- Єдині заміри швидкості зробили співавтори релізу (Hugging Face і llama.cpp): 15 ток/с на Mac Studio M3 Ultra, 30 ток/с на чотирьох RTX PRO 6000 на короткому контексті та 3 ток/с на довгому. Незалежних замірів станом на 2 листопада 2026 немає.
- Відеокарта на 24–32 ГБ плюс 64–128 ГБ RAM модель не потягне в жодному кванті — лишається читання ваг із SSD зі швидкістю 1–2 ток/с.
- API дешевший: $0,70 за мільйон вхідних і $2,10 за мільйон вихідних токенів. За нашим розрахунком, оренда ноди виходить приблизно в 12 разів дорожчою, а Mac за $22 299 окупився б лише за понад 15 років. Локальний запуск — заради даних і контролю, а не заради економії.
- Звичайному ПК підійде Qwen 3.8 або менші моделі Mistral, які компанія пообіцяла «протягом місяця».
Словничок: MoE, квант, GGUF, KV-кеш і prefill
Без цих п’яти слів далі буде важко — по рядку на кожне.
- Коротко (TL;DR)
- Словничок: MoE, квант, GGUF, KV-кеш і prefill
- Скільки пам’яті потрібно Mistral Large 4: від 233 ГБ до 1,06 ТБ
- Пам’ять Mistral Large 4: файл ваг, KV-кеш 35 КіБ на токен і запас
- Mac Studio для Mistral Large 4: 512 ГБ, ліміт 384 ГБ і ціна $22 299
- Зв’язка GPU і RAM-офлоад: що дають 4× RTX PRO 6000 і сервер на 768 ГБ
- Скільки ток/с у Mistral Large 4 вдома: заміри й стеля за пам’яттю
- Оренда замість купівлі: 4× B200 за $27 на годину проти API за $2,10
- Mistral Large 4 проти Qwen 3.8: 233–605 ГБ проти 17,6–397 ГБ
- Ліцензія Mistral Large 4 і якість низьких квантів: що перевірено
- Як запустити Mistral Large 4: llama.cpp, MLX, vLLM і Ollama
- Ризики локального запуску Mistral Large 4: що може піти не так
- Кому Mistral Large 4 потрібен локально — і коли краще почекати
- FAQ
- MoE (суміш експертів) — модель із безлічі «підмереж-експертів», з яких на кожному слові працюють лише кілька. Обчислює вона швидко, як маленька, а місця займає як велика: усі експерти мусять лежати в пам’яті.
- Квант — стиснута копія ваг: замість 8 або 16 біт на число — 1–4 біти. Файл менший у рази, якість трохи падає.
- GGUF — формат файлів для llama.cpp і програм на його основі (LM Studio, Llama App). Квант із позначкою UD — «динамічний» від Unsloth: важливі шари він лишає точнішими, решту стискає сильніше.
- KV-кеш — пам’ять моделі про поточну розмову. Зростає з довжиною контексту.
- Prefill — читання вашого запиту до першого слова відповіді. Генерація — сама відповідь. Це дві різні швидкості, і у великих моделей на слабкому залізі страждає саме prefill.
Скільки пам’яті потрібно Mistral Large 4: від 233 ГБ до 1,06 ТБ
Mistral Large 4 потрібно від 233 ГБ пам’яті в найстиснутішому 1-бітному кванті до 1,06 ТБ в офіційному FP8, плюс кілька гігабайтів на контекст і службові буфери. Практична середина — 2-бітний квант на 300–380 ГБ. Ідеться про обсяг пам’яті, яку бачить процесор або відеокарта: оперативну, відеопам’ять чи уніфіковану пам’ять Mac. Диск не враховується.
Сама модель — MoE на 1,05 трлн параметрів, із яких на кожному токені задіяні 49 млрд (52 млрд разом із шарами ембедингів і виходу). Mistral виклала ваги 29 жовтня 2026 року, оригінал лежить у картці Mistral-Large-4-1T-A52B на Hugging Face. У спільноті модель прозвали Le Chonk — так називався і PR з її підтримкою в llama.cpp. Бенчмарки і порівняння з Kimi K3 та GLM-5.3 — у нашому огляді Mistral Large 4 (його написано до виходу ваг: ціна й індекс там станом на 21 жовтня); тут лише залізо.
Розміри нижче — не формули зі статей до релізу, а сума реальних файлів у репозиторіях станом на 1 листопада 2026 (1 ГБ = 10⁹ байт).
| Формат / квант | Чий | Розмір, ГБ | Що це на практиці |
|---|---|---|---|
| FP8 (оригінал) | Mistral | 1060,6 | 54 файли; BF16 офіційно немає |
| NVFP4 | Mistral | 610,0 | лише відеокарти Blackwell (B200, B300, RTX PRO 6000) |
| UD-IQ1_S (1 біт) | Unsloth | 233,0 | найменший файл |
| UD-IQ1_M | Unsloth | 259,6 | 1 біт трохи точніший |
| IQ2_XXS | ggml-org | 297,7 | 2 біти від команди llama.cpp |
| UD-IQ2_XXS | Unsloth | 302,5 | 2 біти, влазить у Mac без налаштування |
| Q2_K | ggml-org | 380,7 | на ньому зроблено замір на Mac |
| UD-Q2_K_XL | Unsloth | 378,3 | приклад в інструкції Unsloth |
| UD-IQ3_XXS | Unsloth | 423,5 | 3 біти |
| UD-Q3_K_XL | Unsloth | 492,7 | 3 біти, на Mac — впритул із піднятим лімітом |
| UD-Q4_K_XL | Unsloth | 604,8 | 4 біти |
| Q4_K_M | ggml-org | 634,8 | інший 4-бітний рецепт |
| UD-Q5_K_XL / UD-Q6_K_XL / Q8_0 | Unsloth | 783,8 / 890,5 / 1115,2 | серверний клас |
| MLX Text 2 / 3 / 4 біти | mlx-community | 338,2 / 459,3 / 590,4 | для Mac, лише текст |
| mmproj (зір) | ggml-org | 3,4 | окремий файл, якщо потрібні зображення |
Дві пастки під час читання таких таблиць:
- Таблиця вимог Unsloth («1 біт — 256–270 ГБ, 4 біти — 630 ГБ, 8 біт — 1,2 ТБ») показує пам’ять із запасом під контекст, а не вагу файлу. Таблиці вище вона не суперечить.
- Q4_K_M і UD-Q4_K_XL — різні кванти з різницею в 30 ГБ. У статтях, написаних до виходу ваг, «Q4 ≈ 635 ГБ» — це оцінка, а не файл.
Пам’ять Mistral Large 4: файл ваг, KV-кеш 35 КіБ на токен і запас
Повна потреба в пам’яті обчислюється так: файл ваг + KV-кеш під обраний контекст + mmproj (3,4 ГБ, якщо потрібні зображення) + службові буфери рушія (зазвичай 5–10 ГБ). Якщо на цій самій машині працює ще й система, як на Mac, їй теж потрібен свій шматок.
KV-кеш у Mistral Large 4 маленький, і це не випадковість. Модель використовує MLA (стиснуту увагу): замість повного набору ключів і значень кожен шар зберігає латентний вектор на 512 чисел плюс 64 числа позиційної частини. До того ж частина шарів ділить кеш із сусідами: свій зберігають 63 з 72.
Наш розрахунок за config.json: 63 шари × (512 + 64) × 1 байт у FP8 = 36 288 байт на токен, близько 35 КіБ. Той самий порядок незалежно отримав японський розробник oflight (36 КБ на токен). У f16 — удвічі більше.Контекст KV у FP8 (як у vLLM) KV у f16 (ті самі 63 шари) 8 тис. токенів 0,28 ГіБ 0,55 ГіБ 32 тис. 1,11 ГіБ 2,21 ГіБ 128 тис. 4,43 ГіБ 8,86 ГіБ 256 тис. 8,86 ГіБ 17,7 ГіБ 1 млн 35,4 ГіБ 70,9 ГіБ
Як саме llama.cpp зберігає спільний для шарів кеш, у документації не сказано. Якщо спільний кеш не використовується зовсім, 128 тис. токенів у f16 займуть близько 10 ГіБ. Це найгірший варіант, і навіть він у 20 разів менший за найменший файл. Загальний принцип розрахунку ми розбирали в матеріалі скільки відеопам’яті потрібно моделі.
Висновок: у цієї моделі все вирішує файл ваг. Вікно в 1 млн токенів за пам’яттю доступне майже безкоштовно, але швидкість на довгому контексті падає в рази — про це нижче.
Який квант Mistral Large 4 влазить у Mac, GPU і сервер
Наш розрахунок, правило: файл + KV на 32 тис. токенів у f16 (2,4 ГБ) + 10 ГБ буфера не більше за доступну пам’ять. Усе зведено до десяткових ГБ, як у файлів.
| Конфігурація | Доступно, дес. ГБ | Найбільший квант, який влазить |
|---|---|---|
| Mac Studio M5 Ultra 512 ГБ, ліміт GPU за замовчуванням | ~412 | Q2_K (380,7) — впритул |
| Те саме, ліміт піднято командою sysctl | ~507 | UD-IQ3_XXS (423,5) із запасом, UD-Q3_K_XL (492,7) впритул |
| 4× DGX Spark | ~550 | UD-Q3_K_XL на папері; вузлам потрібна пам’ять під систему |
| 4× RTX PRO 6000 | ~412 VRAM | Q2_K впритул, IQ2_XXS із запасом |
| 1 відеокарта на 32 ГБ + 256 ГБ RAM | ~309 | лише 1 біт (233 / 260) |
| 1 відеокарта на 32 ГБ + 512 ГБ RAM | ~584 | UD-Q3_K_XL (492,7) |
| 1 відеокарта на 32 ГБ + 768 ГБ RAM | ~859 | UD-Q5_K_XL (783,8); 4 біти й NVFP4 із запасом |
| 4× B200 | від 720 | NVFP4 — конфігурація, яку називає Mistral |
| 8× H200 | від 1128 | FP8 із запасом |
| RTX 4090/5090 + 64–128 ГБ RAM | ~95–172 | нічого: лишається читання з SSD |
Пам’ять Mac і відеокарт двійкова: 384 ГБ у macOS ≈ 412 ГБ в одиницях таблиці.
Mac Studio для Mistral Large 4: 512 ГБ, ліміт 384 ГБ і ціна $22 299
Mac Studio з 512 ГБ — єдиний готовий комп’ютер із магазину, на якому Mistral Large 4 запускається без збирання станції чи сервера. Але він має три застереження, які в переказах губляться.
Перше: замір зроблено на машині, якої вже не продають. Команда Hugging Face і llama.cpp запустила Q2_K на Mac Studio M3 Ultra з 512 ГБ і отримала близько 90 ток/с на prefill і 15 ток/с на генерації (блог Hugging Face, 29 жовтня 2026). Опцію 512 ГБ для M3 Ultra Apple прибрала ще в березні 2026 року. Що ця машина вміла з іншими гігантами, ми розбирали у статті про Mac Studio M3 Ultra.
Друге: 512 ГБ повернулися на M5 Ultra і коштують дорого. З 28 жовтня 2026 року Mac Studio M5 Ultra можна зібрати з 512 ГБ уніфікованої пам’яті: $6 799 за базову конфігурацію з 36-ядерним CPU і 80-ядерним GPU плюс $15 500 за пам’ять, разом від $22 299 у США без податків (MacRumors). Пропускна здатність пам’яті — 1,2 ТБ/с. Терміни постачання станом на 2 листопада не підтверджені: одні видання пишуть про грудень, інші — що машини вже відвантажують.
Третє: macOS не віддає графічному ядру всю пам’ять. За замовчуванням GPU отримує лише частину ОЗП. Apple цю частку не публікує; за спостереженнями спільноти, це від двох третин до трьох чвертей. На 512 ГБ це близько 384 ГБ в одиницях macOS. Вони двійкові, тож у десяткових одиницях, у яких указано файли, це близько 412 ГБ. Q2_K (380,7 ГБ) з контекстом 32 тис. і буферами займає ~393 ГБ і вміщається впритул, а для 3 біт ліміт доведеться піднімати.
Ліміт піднімають командою. Порядок такий:
- Перевірити поточне значення:
sysctl iogpu.wired_limit_mb(0 означає «за замовчуванням»). - Підняти до 472 ГБ в одиницях macOS (~507 ГБ десяткових):
sudo sysctl iogpu.wired_limit_mb=483328. Це значення пропонує Pinggy в гайді з M5 Ultra; системі лишається близько 40 ГБ. - Закрити все зайве: браузер із десятком вкладок з’їсть запас, і машина почне підвисати.
- Повернути як було:
sudo sysctl iogpu.wired_limit_mb=0або просто перезавантаження — налаштування не зберігається.
| Mac Studio | Пам’ять | Ціна | Що запуститься | Швидкість генерації |
|---|---|---|---|---|
| M3 Ultra 512 ГБ | 819 ГБ/с | із березня 2026 нового не купити | Q2_K | 15 ток/с (замір HF) |
| M5 Ultra 512 ГБ | 1,2 ТБ/с | від $22 299 (28.10.2026) | до Q2_K одразу, до UD-Q3_K_XL із sysctl (впритул) | ~20–24 ток/с (наша оцінка) |
| M5 Ultra 256 ГБ і менше | — | дешевше | нічого, крім читання з SSD | 1–2 ток/с (за Pinggy) |
Оцінка для M5 Ultra — не замір: ми помножили 15 ток/с на 1,3–1,6. Нижня межа — приріст M5 Ultra над M3 Ultra в генерації за оцінкою BGR (30–40%). У нашому розборі Mac Studio M5 Ultra приріст на інших моделях становив 1,5–1,9 раза, тож реальна цифра може виявитися й вищою. Заміру Large 4 на M5 Ultra станом на 2 листопада немає ні в кого.
Зв’язка GPU і RAM-офлоад: що дають 4× RTX PRO 6000 і сервер на 768 ГБ
Без Mac лишаються два шляхи: зібрати багато відеопам’яті з кількох карт або тримати експертів в оперативній пам’яті сервера, а на відеокарті — лише увагу. Перший шлях швидший, другий дешевший за гігабайт і повільніший.
Чотири RTX PRO 6000 (по 96 ГБ, разом 384 ГБ — близько 412 ГБ у десяткових одиницях). Це конфігурація з того самого блогу Hugging Face. IQ2_XXS (297,7 ГБ) уміщається у відеопам’ять повністю: на короткому контексті вийшло 500 ток/с prefill і 30 ток/с генерації. Коли контекст довгий (сервер запускали з вікном 800 тис. токенів), швидкість падає до 129 і 3 ток/с. NVFP4 (610 ГБ) у цю відеопам’ять не вміщається — частину ваг довелося тримати поза відеопам’яттю, звідси близько 10 ток/с генерації за контексту 32 тис. Це наш висновок з арифметики: спосіб розміщення джерело не описує. Q2_K (380,7 ГБ) з контекстом 32 тис. за нашим розрахунком уміщається впритул; заміру на ньому для цієї зв’язки в HF немає.
Ціна зв’язки станом на 1 листопада 2026: RTX PRO 6000 в американській роздрібній торгівлі — від $17 063 (GPUPrix), на вітрині Nvidia — $13 250, але немає в наявності. Чотири карти — $53–68 тис. без сервера, блоків живлення й охолодження.
Сервер із великим обсягом RAM. llama.cpp уміє тримати рідко задіяні ваги експертів в оперативній пам’яті, а увагу — на відеокарті (прапорці --n-cpu-moe N або --override-tensor "\.ffn_.*_exps\.weight=CPU"). Обсяг тоді задає RAM, а швидкість — її пропускна здатність. На Mac цей трюк не потрібен: там процесор і графіка читають ту саму пам’ять.
Замірів Large 4 на CPU немає. Найближчий проксі — Kimi-K2.5, теж MoE на ~1T параметрів, але з 32 млрд активних проти 52 млрд у Mistral. На сервері з EPYC 9175F і 768 ГБ DDR5-6400 вона в Q4_K_S видала 11,7–12,9 ток/с генерації і 22–24 ток/с prefill (замір однієї приватної лабораторії, жовтень 2026). Наша оцінка для Large 4 у 4 бітах — 7–8 ток/с (12 × 32/52). Prefill тією самою пропорцією — близько 13–15 ток/с (у Kimi 22–24), тобто запит на 20 тис. токенів модель читатиме близько 25 хвилин.
Пам’ять для такого сервера дорожчає: за роздрібним індексом DatacenterDisk серверна DDR5 коштує близько $44 за ГБ, тобто 768 ГБ — близько $34 тис. Індекс зібрано з роздрібних оголошень, це орієнтир, а не прайс.
Чотири DGX Spark. Кожен має 128 ГБ і 273 ГБ/с, чотири у зв’язці — максимум, який підтримує Nvidia, — дають 512 ГБ, або близько 550 ГБ у десяткових одиницях. На папері це вміщає UD-Q3_K_XL, але кожному вузлу ще потрібна пам’ять під систему. Замірів Large 4 на такій зв’язці немає; наше порівняння DGX Spark, Mac Studio і Strix Halo показує, де Spark упирається в пам’ять на менших моделях.Варіант Пам’ять Ціна (дата) Квант Генерація Mac Studio M5 Ultra 512 ГБ 384–472 ГБ для GPU (~412–507 дес.) від $22 299 (28.10.2026) 2–3 біти ~20–24 ток/с (оцінка) 4× RTX PRO 6000 384 ГБ VRAM (~412 дес.) $53–68 тис. за карти (01.11.2026) IQ2_XXS, Q2_K впритул 30 → 3 ток/с (замір HF) EPYC + 768 ГБ DDR5 + 1 GPU ~859 ГБ дес. лише пам’ять ~$34 тис. (індекс) 4–5 біт ~7–8 ток/с (оцінка за проксі) 4× DGX Spark 512 ГБ (~550 дес.) н/д до 3 біт замірів немає ПК: RTX 5090 + 128 ГБ RAM ~172 ГБ дес. — не влазить 1–2 ток/с із SSD
Скільки ток/с у Mistral Large 4 вдома: заміри й стеля за пам’яттю
Удома Mistral Large 4 генерує від 3 до 30 ток/с, і єдині цифри станом на 2 листопада 2026 року — від співавторів релізу. На Mac Studio M3 Ultra це 15 ток/с, на чотирьох RTX PRO 6000 — 30 ток/с на короткому контексті та 3 на довгому. Незалежних замірів ні на Mac, ні на DGX Spark, ні на CPU поки немає.Конфігурація Квант Prefill, ток/с Генерація, ток/с Звідки цифра Mac Studio M3 Ultra 512 ГБ Q2_K ~90 15 замір HF і llama.cpp Mac Studio M5 Ultra 512 ГБ Q2_K н/д ~20–24 наша оцінка 4× RTX PRO 6000 IQ2_XXS, короткий контекст 500 30 замір HF 4× RTX PRO 6000 IQ2_XXS, довгий контекст 129 3 замір HF 4× RTX PRO 6000 NVFP4, 32 тис. 130–590 ~10 замір HF 8× H200, vLLM, FP8 один запит 1 тис. токенів за ~0,6 с ~65; 120–138 лише на чат-запитах із прийнятими чернетками DSpark замір HF 8× H200, vLLM, FP8 1000 діалогів разом — ~480 сумарно замір HF EPYC 9175F + 768 ГБ Q4 (проксі Kimi-K2.5) ~13–15 для Large 4 (у Kimi 22–24) ~7–8 для Large 4 (у Kimi 11,7–12,9) наша оцінка за проксі
DSpark — вбудована в модель «чорнова» голова: вона вгадує кілька наступних токенів, основна модель їх перевіряє, і за вдалого вгадування генерація пришвидшується. У vLLM її вмикають прапорцем --speculative-config у спеціальному образі vLLM — команда є в розділі про запуск.
Стелю швидкості можна порахувати. На кожному токені модель читає з пам’яті лише активні ваги — приблизно файл × 52/1050. Для UD-Q2_K_XL (378,3 ГБ) це близько 18,7 ГБ на токен, у Q2_K майже стільки ж. Ділимо пропускну здатність пам’яті на це число:
- M3 Ultra (819 ГБ/с) — не більше 44 ток/с; замір 15 ток/с — це близько 35% стелі;
- M5 Ultra (1,2 ТБ/с) — не більше 64 ток/с;
- EPYC із 12 каналами DDR5-6400 (~614 ГБ/с) — не більше 33;
- один DGX Spark (273 ГБ/с) — не більше 15;
- звичайний ПК із двоканальною DDR5 (~90 ГБ/с) — не більше 5.
Це груба верхня межа: кванти різних шарів важать по-різному, а реальні рушії втрачають частину швидкості на обчисленнях і синхронізації. Але порядок вона показує правильно: обсяг пам’яті вирішує, чи завантажиться модель, а пропускна здатність — наскільки швидко вона відповідатиме.
Міркування вимкнути не можна. Модель має три рівні reasoning_effort — low, medium і high (за замовчуванням). Значення none однаково працює як high. За 15 ток/с коротка відповідь із ланцюжком міркувань на тисячу-другу токенів займає хвилини, тож починати варто з low.
Цифра, якої в таблиці немає. У статті Context Studios, що вийшла до релізу ваг, стоїть «23 ток/с на кластері з чотирьох DGX Spark». Але сервер там запущено з моделлю qwen3.8-flash-next — це замір іншої моделі, Mistral Large 4 він не стосується.
Оренда замість купівлі: 4× B200 за $27 на годину проти API за $2,10
Орендувати ноду під Mistral Large 4 можна за $10–42 на годину, але з фінансового погляду це однаково дорожче за API — у рази. Оренда має сенс у двох випадках: перевірити своє завдання перед купівлею заліза або тримати дані на власному сервері, а не в Mistral.Нода Ціна GPU·год За годину Що тримає 4× RTX PRO 6000 (Runpod) $2,49 ~$9,96 IQ2_XXS, Q2_K впритул 4× B200 (Lambda) $6,79 ~$27,16 NVFP4 — офіційна конфігурація 4× B200 (Runpod) $7,99 ~$31,96 NVFP4 8× H200 (Runpod) $5,29 ~$42,32 FP8 повністю
Ціни Runpod — зі сторінки, оновленої 28 жовтня 2026 року, Lambda — станом на 1 листопада 2026 (дати на сторінці немає). API Mistral Large 4 після виходу ваг коштує $0,70 за мільйон вхідних токенів, $2,10 за мільйон вихідних і $0,07 за кешований вхід (Artificial Analysis, 1 листопада 2026). До відкриття ваг тариф був $1,36 / $4,18.
Наш розрахунок беззбитковості. Нода з чотирьох B200 за $27,16 на годину зрівняється з API за вихідними токенами, лише якщо видає 12,9 млн токенів на годину — близько 3 600 ток/с без перерви. На замірі Hugging Face вісім H200 під навантаженням у 1000 діалогів видали ~480 ток/с сумарно. За $42,32 на годину це близько $24,5 за мільйон вихідних токенів — приблизно в 12 разів дорожче за API. Вхідні токени, простій і електрика в розрахунок не входять, і всі вони роблять оренду ще дорожчою.
Купівля Mac теж не окупиться. $22 299 — це 10,6 млрд вихідних токенів за ціною API. За 20 ток/с без зупинки Mac видає 1,7 млн токенів на добу, і стільки токенів він нагенерує років за 17 (наш розрахунок; електрику і вхідні токени не враховано).
Висновок: Mistral Large 4 у себе запускають заради того, щоб запити не виходили за периметр компанії, заради роботи без інтернету і фіксованої версії моделі. Якщо нічого з цього не потрібно, API виграє. Порівняння майданчиків і прихованих платежів — у гайді з оренди GPU для нейромереж. Розумний порядок — спершу орендувати ноду на вихідні й прогнати своє завдання, потім вирішувати з купівлею.
Mistral Large 4 проти Qwen 3.8: 233–605 ГБ проти 17,6–397 ГБ
Головний суперник серед відкритих моделей — сімейство Qwen 3.8. Різниця за залізом — на порядок: у Qwen є моделі, що запускаються на одній відеокарті, а в Mistral у цьому поколінні поки є лише Large 4.Модель Параметрів усього / активних Файл в 1 біті Файл у 4 бітах Ліцензія Qwen 3.8 27B 27B, щільна 6,2 ГБ 17,6 ГБ Apache 2.0 Qwen 3.8 Flash-Next ~125–180B (обчислюють по-різному) / н/д 72,5 ГБ 111,3 ГБ власна Mistral Large 4 1,05T / 52B 233 ГБ 605 ГБ Mistral Ecosystem Open-Weight Qwen 3.8 2.4T-A95B 2,45T / 95B 397 ГБ 1,31 ТБ (IQ4_XS) власна
Файли — GGUF від Unsloth за API Hugging Face, 4 біти — UD-Q4_K_XL, якщо не зазначено інше.
За якістю Mistral Large 4 (режим high) набирає 26 балів в Intelligence Index v5 від Artificial Analysis, Qwen 3.8 27B (xhigh) — 20 (станом на 1 листопада 2026). У Flash-Next індексу на цій шкалі поки немає. Порівнювати можна лише числа однієї версії шкали: прев’ю Large 4 отримувало 38 за попередньою методикою, і це не означає, що модель «погіршилася».
Як це читати:
- Одна відеокарта на 24–32 ГБ — Qwen 3.8 27B, без варіантів.
- 128 ГБ уніфікованої пам’яті або ПК зі 128 ГБ RAM — Qwen 3.8 Flash-Next локально; її запускають у себе кілька учасників обговорення релізу на Hacker News.
- 512 ГБ і більше — Large 4 у 2–3 бітах або Qwen 3.8 2.4T в 1 біті. Другий варіант потребує в 1,7 раза більше пам’яті за тієї самої «бітності».
Шість балів різниці з 27B коштують 200–600 ГБ пам’яті проти 17,6 ГБ. Для чату й простого коду це переплата. Для складних агентних завдань і аналізу довгих документів усередині компанії — вже ні.
Ліцензія Mistral Large 4 і якість низьких квантів: що перевірено
Ліцензія. Large 4 вийшла під власною Mistral Ecosystem Open-Weight License, а не під Apache 2.0, як Large 3. Головне в ній:
- Комерційне використання дозволене.
- Пункт 2: якщо ви або афілійована компанія продаєте модель як сервіс (Model as a Service — даєте третім особам доступ до моделі через API чи хостинг із контролем над запитами, параметрами або навчанням), для комерційного використання потрібна окрема ліцензія від Mistral.
- Вбудований продукт — не MaaS: функція всередині власного застосунку або просте пересилання запитів до чужої моделі під це визначення не підпадають.
- Пункт 3: умови пункту 2 не стосуються внутрішнього використання (модель не відкрита третім особам) і доступу через офіційні продукти Mistral. Текст ліцензії лежить у репозиторії моделі.
На локальний запуск удома чи всередині компанії застереження про MaaS не поширюється. Хостинг-провайдерам і сервісам «модель через API» доведеться домовлятися з Mistral. Через це застереження на Hacker News сперечаються, чи можна називати реліз open source: формально це open weights, але не відкрита ліцензія в розумінні OSI.
Якість низьких квантів. Дані є лише в Unsloth — тобто в компанії, яка ці кванти робить. Це заяви вендора, а не незалежний тест.Квант Розмір Збіг top-1 з оригіналом KLD (менше — ближче до оригіналу) UD-IQ1_S 233,0 ГБ 90,6% 0,1263 UD-Q2_K_XL 378,3 ГБ 95,6% 0,0298 UD-IQ3_XXS 423,5 ГБ 96,2% 0,0217 UD-Q4_K_XL 604,8 ГБ 97,8% 0,0071
«Збіг top-1» — частка токенів, де стиснута модель обирає те саме слово, що й оригінал. Це не оцінка якості коду чи міркувань: 9% розбіжностей в 1-бітному кванті на довгій відповіді накопичуються. Незалежних тестів 1- і 2-бітних квантів на завданнях із програмування станом на 1 листопада 2026 немає. Тому 1 біт — це спосіб запустити модель, а не «майже без втрат».
Як запустити Mistral Large 4: llama.cpp, MLX, vLLM і Ollama
Підтримку Mistral Large 4 влили в llama.cpp у день релізу — PR #31376, 29 жовтня 2026 року. Збірки, старші за цю дату, модель не відкриють. Нижче — команди з інструкцій Unsloth і Hugging Face; адаптовані під Linux із відеокартою NVIDIA, на Mac відрізняється лише збірка.
Крок 1. Обрати квант Mistral Large 4 під свою пам’ять
Звіртеся з таблицею «що влазить». На Mac Studio 512 ГБ без налаштування — до Q2_K впритул (контекст краще тримати скромним), із піднятим лімітом — UD-IQ3_XXS із запасом або UD-Q3_K_XL впритул. На машині з однією відеокартою і 768 ГБ RAM — UD-Q4_K_XL із запасом, максимум UD-Q5_K_XL. Врахуйте диск: 300–600 ГБ на один квант.
Крок 2. Зібрати свіжий llama.cpp
sudo apt-get update
sudo apt-get install -y build-essential cmake curl libcurl4-openssl-dev
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --target llama-cli llama-server
Для Mac або запуску лише на процесорі — -DGGML_CUDA=OFF, Metal на macOS вмикається сам.
Крок 3. Завантажити квант і запустити сервер
./llama.cpp/build/bin/llama-server \
    -hf unsloth/Mistral-Large-4-1T-A52B-GGUF:UD-Q2_K_XL \
    --ctx-size 32768 \
    --temp 1.0 --top-p 0.95 --top-k 0 --min-p 0.0 \
    --chat-template-kwargs '{"reasoning_effort":"low"}' \
    --host 127.0.0.1 --port 8080
Чат відкриється за адресою 127.0.0.1:8080, OpenAI-сумісний API — там само, за шляхом /v1. Контекст 32 тис. обмежує KV-кеш. Unsloth у прикладі ставить reasoning_effort у high; ми ставимо low, бо на домашньому залізі high розтягує відповідь на хвилини. Бракує пам’яті — зменште --ctx-size або візьміть менший квант.
Завантажити квант заздалегідь (9 файлів, тримати в одній теці):
pip install -U huggingface_hub
hf download unsloth/Mistral-Large-4-1T-A52B-GGUF \
    --local-dir unsloth/Mistral-Large-4-1T-A52B-GGUF \
    --include "UD-Q2_K_XL/*"
Той самий запуск через Llama App із квантом команди llama.cpp — один рядок: llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K.
Крок 4. Mac: GGUF чи MLX
На Mac працюють обидва шляхи. GGUF через llama.cpp — той, на якому зроблено замір Hugging Face. MLX-конверсії від mlx-community (2, 3 і 4 біти: 338,2 / 459,3 / 590,4 ГБ) з’явилися в день релізу, але вони лише текстові, і їхню якість ніхто не міряв. Конверсії зроблено гілкою mlx-lm із PR #2018 і перевірено на dev-збірці 0.32.3; якщо реліз із pip модель не відкриває — ставте mlx-lm із GitHub.
Крок 5. Сервери на Blackwell: vLLM
vLLM обслуговує NVFP4 і FP8, а станом на 1 листопада 2026 року працює лише зі спеціального образу vllm/vllm-openai:mistral-large-4 — ні реліз, ні нічна збірка підтримки ще не містять. Базова конфігурація рецепта vLLM — чотири GB300:
export VLLM_ENGINE_READY_TIMEOUT_S=6000
vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --tokenizer-mode mistral --config-format mistral --load-format mistral \
  --max-model-len 262144 --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.85 \
  --reasoning-parser mistral --tool-call-parser mistral --enable-auto-tool-choice \
  --speculative-config '{"method":"dspark","num_speculative_tokens":3}'
Ollama і Mistral Large 4: поки що лише хмарний тег
На сторінці Mistral Large 4 у бібліотеці Ollama станом на 1 листопада 2026 видно лише тег mistral-large-4:cloud — це запуск у хмарі Ollama, а не на вашому залізі. Локально поки використовуйте llama.cpp або програми на його основі.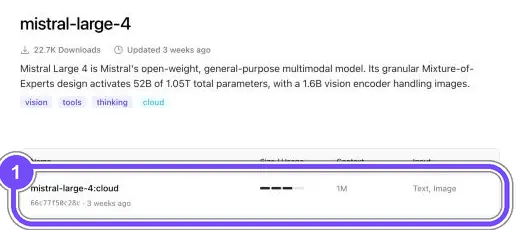
Ollama, сторінка тегів mistral-large-4, 2 листопада 2026: 1 — єдиний тег — хмарний :cloud, локальної версії поки немає.
Ризики локального запуску Mistral Large 4: що може піти не так
- Підвисання Mac після підняття ліміту. Якщо GPU забрав 472 з 512 ГБ, системі лишається ~40 ГБ. Важкий браузер чи IDE — і macOS починає вивантажувати пам’ять на диск.
- Обвал швидкості на довгому контексті. Замір HF: 30 ток/с на короткому запиті і 3 ток/с на довгому. Вікно в 1 млн токенів за пам’яттю доступне, але працювати з ним на домашньому залізі болісно.
- Prefill на CPU. За ~13–15 ток/с (наша оцінка) читання великого документа чи кодової бази займає десятки хвилин. Для агентів, які постійно надсилають довгий контекст, це неприйнятно.
- Якість 1–2 біт підтверджує лише вендор квантів. Порівняйте відповіді з API на своїх завданнях, перш ніж будувати на цьому процеси.
- Читання з SSD замість пам’яті. Якщо модель не вміщається, llama.cpp підвантажує ваги з диска через mmap. З досвіду Pinggy, це 1–2 ток/с — для чату марно, а SSD постійно навантажений читанням.
- Завантаження і диск. 300–600 ГБ на квант, плюс місце на експерименти з двома-трьома варіантами. Беріть файли лише з офіційних репозиторіїв (mistralai, unsloth, ggml-org, mlx-community).
- Цифри зі статей до релізу. Оцінки «Q4 ≈ 635 ГБ», «NVFP4 = 525 ГБ», «23 ток/с на DGX Spark» не збігаються з реальними файлами або стосуються іншої моделі.
Кому Mistral Large 4 потрібен локально — і коли краще почекати
Mistral Large 4 потрібен локально тим, кому не можна надсилати дані в зовнішній API і хто вже має або матиме сервер від 400 ГБ пам’яті. Ентузіастові найдешевше — через Mac Studio за $22 299, у 2–3 бітах. Звичайному ПК він не потрібен зовсім: там працює Qwen 3.8.Профіль Що робити Компанія з чутливими даними і бюджетом на сервер Орендувати 4× B200 на тест, потім власна нода на NVFP4 або FP8 через vLLM Ентузіаст із бюджетом від $22 тис. Mac Studio M5 Ultra 512 ГБ, Q2_K, із піднятим лімітом — 3 біти, ~20 ток/с (оцінка) Є сервер із 512–768 ГБ RAM Офлоад експертів у RAM, 3–5 біт, 7–8 ток/с (оцінка), короткі запити Звичайний ПК, одна відеокарта Qwen 3.8 27B або Flash-Next; Large 4 — через API
П’ять запитань перед купівлею заліза:
- Чи не можна даним виходити в хмару? Якщо можна — API за $0,70/$2,10 дешевший за будь-який варіант.
- Чи потрібен довгий контекст? На локальному залізі він повільний: 3 ток/с на замірі HF.
- Чи будуть агенти з довгими промптами? Тоді вирішує prefill, і CPU-сервер відпадає.
- Який бюджет? Поріг входу — $22 299 за Mac або $50 тис.+ за зв’язку відеокарт.
- Чи можна почекати місяць? На брифінгу 28 жовтня 2026 року віцепрезидент Mistral із науки П’єр Сток пообіцяв «протягом місяця» сімейство менших моделей, і одна з них, за його словами, точно запуститься на ноутбуці (Frandroid). Розміру, дати й ліцензії поки немає, в офіційному анонсі цієї обіцянки теж немає.
Найшвидше застаріють ціни Mac, відеокарт і пам’яті, тарифи оренди і самі файли квантів: Unsloth і ggml-org оновлюють репозиторії. Свіжі розміри дивіться в картці моделі на Hugging Face, свіжі ціни — на сторінках Apple і хмар.
FAQ
Чи можна запустити Mistral Large 4 на одній RTX 5090 або 4090?
Ні, у нормальному режимі — ні. Навіть найменший квант важить 233 ГБ, а RTX 5090 має 32 ГБ відеопам’яті. Разом із 64–128 ГБ оперативної пам’яті однаково не вистачає, і llama.cpp читатиме ваги з SSD — це 1–2 ток/с. Для однієї такої відеокарти краще підходить Qwen 3.8 27B: у 4 бітах вона важить 17,6 ГБ.
Чи вистачить Mac Studio на 512 ГБ для Mistral Large 4?
Вистачить, але лише в 1–3 бітах. За замовчуванням macOS віддає графічному ядру близько 384 ГБ (≈412 ГБ у десяткових одиницях файлів) — цього вистачає на Q2_K (380,7 ГБ) впритул. Якщо підняти ліміт командою sysctl до 472 ГБ, влізуть UD-IQ3_XXS і впритул UD-Q3_K_XL. Замір на M3 Ultra в Q2_K — 15 ток/с; нові M5 Ultra з 512 ГБ коштують від $22 299 у США.
Скільки оперативної пам’яті потрібно, щоб запустити Mistral Large 4 без відеокарти?
Для 1 біта — щонайменше 256 ГБ, для 2 біт — близько 384 ГБ, для 4 біт — 768 ГБ. Швидкість задає пропускна здатність пам’яті: на звичайному ПК із двоканальною DDR5 стеля близько 5 ток/с. На серверному EPYC із 12 каналами DDR5 наша оцінка — 7–8 ток/с у 4 бітах, а prefill — близько 13–15 ток/с.
Де завантажити Mistral Large 4 і який формат обрати — FP8, NVFP4 чи GGUF?
Усі офіційні файли лежать на Hugging Face в репозиторії mistralai/Mistral-Large-4-1T-A52B. FP8 (1,06 ТБ) — для серверів на 8 GPU, NVFP4 (610 ГБ) — для відеокарт Blackwell через vLLM. Для Mac і домашніх систем потрібен GGUF: від unsloth (233–1115 ГБ) або ggml-org (297,7–634,8 ГБ), він запускається в llama.cpp.
Чим Mistral Large 4 відрізняється від Qwen 3.8 за вимогами до заліза?
На порядок. Qwen 3.8 27B у 4 бітах важить 17,6 ГБ і працює на одній відеокарті, Flash-Next — 111 ГБ, це машина зі 128 ГБ пам’яті. Mistral Large 4 починається з 233 ГБ в 1 біті. В індексі Artificial Analysis v5 Large 4 набирає 26 балів, Qwen 3.8 27B — 20 (1 листопада 2026).
Чи можна використовувати Mistral Large 4 у комерційному проєкті?
Так, ліцензія Mistral Ecosystem Open-Weight це дозволяє, зокрема всередині компанії: застереження про MaaS на це не поширюється. Окрема ліцензія від Mistral потрібна, лише якщо ви продаєте доступ до самої моделі як сервіс — через API чи хостинг, де клієнти керують запитами й параметрами. Функція всередині власного застосунку сервісом не вважається.