
Коротко: R9700 беруть за 32 ГБ, а не за швидкість
AMD Radeon AI Pro R9700 — професійна відеокарта AMD на чипі RDNA 4 з 32 ГБ відеопам’яті. У магазинах її шукають як Radeon AI Pro R9700 32GB, і саме обсяг пам’яті — причина, через яку карту купують під локальні нейромережі: у неї повністю вміщуються мовні моделі на 27–35 млрд параметрів, які на 16- і 24-гігабайтних картах не влазять або влазять упритул. Далі — що ця пам’ять дає на практиці, у що впирається і кому карта підходить. Якщо ви тільки обираєте залізо, почніть із нашого загального розбору вибору відеокарти для локального ШІ, а сюди повертайтеся, коли в списку лишилася R9700.
- Коротко: R9700 беруть за 32 ГБ, а не за швидкість
- Характеристики R9700 для ШІ: що важливо, а що ні
- Ціна R9700 на 26 жовтня 2026: від $1300 за прайсом до $1900
- Які моделі влазять у 32 ГБ і з якою швидкістю
- ROCm чи Vulkan: який бекенд обрати під вашу модель
- R9700 проти RTX 5090: у скільки разів повільніша і дешевша
- Radeon R9700 проти RTX 3090, RX 7900 XTX і RX 9070 XT: що брати
- Дві й чотири R9700: 64 ГБ, vLLM і підводні камені
- Ризики купівлі R9700: Linux, баги ROCm, відео і ціна
- Сильні й слабкі сторони Radeon AI Pro R9700 за чужими тестами
- Кому брати R9700, а кому краще інша карта
- FAQ: часті запитання про Radeon AI Pro R9700
Цей огляд Radeon AI Pro R9700 зібрано за чужими замірами: власної карти на стенді в нас немає, тому кожна цифра швидкості підписана — хто міряв, на якій моделі та яким рушієм.
- Пам’ять: 32 ГБ GDDR6 і 640 ГБ/с пропускної здатності. Обсяг — рівень RTX 5090, швидкість читання пам’яті — майже втричі нижча.
- Ціна на 26 жовтня 2026 року: близько $1700 за оцінкою ServeTheHome. Стартова ціна AMD була $1299, на eBay у жовтні нижні лоти коштували в середньому $1921.
- Швидкість: щільна модель на 27 млрд параметрів у 4-бітній квантизації — близько 29 токенів на секунду (tok/s), модель-«суміш експертів» 35B-A3B — 127–148 tok/s. RTX 5090 швидша: у генерації приблизно в 1,5 раза, в обробці запиту — у 2,6–3,4 раза.
- Софт: найкраще працює на Linux. Через Vulkan карта запускається і на Windows, а стек ROCm на Windows обмежений одним PyTorch.
- Кому: одній людині під чат, код і агентів на моделях до ~35B, а також тим, хто збирає 64–128 ГБ із двох-чотирьох карт. Не підходить для генерації відео і сервісу на десятки користувачів.
Характеристики R9700 для ШІ: що важливо, а що ні
R9700 — це той самий чип Navi 48, що стоїть в ігровій RX 9070 XT, але з подвоєною пам’яттю, професійним драйвером і турбінним охолодженням. Для нейромереж із довгого списку специфікацій важливі три рядки: обсяг пам’яті, її пропускна здатність і живлення. Решта (терафлопси, кількість ядер) на швидкість домашньої генерації тексту впливає слабко.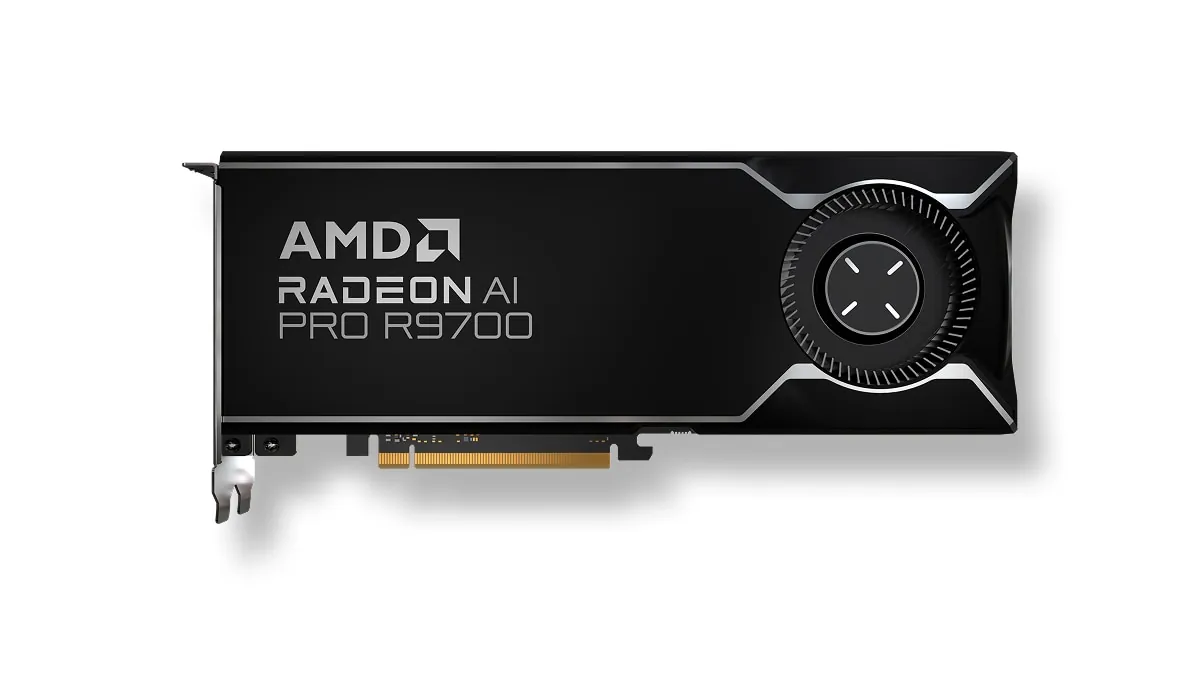
Фото: AMD. Ілюстрація зі сторінки продукту, а не наш стенд.
| Параметр | Radeon AI Pro R9700 | Що це означає для локального ШІ |
|---|---|---|
| Чип | Navi 48, RDNA 4, 64 обчислювальні блоки, 4096 потокових процесорів, 128 ШІ-прискорювачів | той самий кристал, що в RX 9070 XT |
| Відеопам’ять | 32 ГБ GDDR6, шина 256 біт | влазять моделі 27–35B у 4 бітах із запасом під контекст |
| Пропускна здатність | 640 ГБ/с | задає стелю швидкості генерації (формула нижче) |
| Infinity Cache | 64 МБ | малий на тлі моделі у 16–20 ГБ, стелю задає основна пам’ять |
| FP8 (матричні операції) | 383 TFLOPS, з розрідженістю 766 | теоретичний пік, прискорює обробку запиту, а не генерацію |
| ECC | є, лише під Linux | захист пам’яті від збоїв, важливий для довгих завдань |
| Живлення | TBP 300 Вт, роз’єм 12V-2×6, рекомендований БЖ від 750 Вт | влазить у звичайний ПК |
| Інтерфейс | PCIe 5.0 x16 | повнорозмірний слот, як в ігрових відеокарт |
| Охолодження | турбіна (blower), два слоти; в ASRock довжина 27,1 см | гаряче повітря виходить за межі корпусу, карти можна ставити впритул |
Джерело специфікацій — сторінка AMD, дані звірено з таблицею ServeTheHome. Puget Systems у реальній роботі наміряв в однієї карти пікові 298 Вт, тобто в заявлені 300 Вт вона вкладається.
Формула: скільки токенів на секунду дасть 32GB-карта
Мовна модель на кожен новий токен (шматок слова) перечитує з пам’яті всі свої ваги. Тому стеля швидкості генерації обчислюється просто: пропускна здатність ÷ розмір моделі в пам’яті.
- Щільна модель на 27 млрд параметрів у квантизації Q4_K_M важить 15,58 ГіБ, тобто близько 16,7 ГБ. 640 ÷ 16,7 ≈ 38 tok/s в теорії. Реальний замір у llama.cpp — близько 29 tok/s, тобто карта працює приблизно на 75% стелі.
- Модель на 8 млрд параметрів без квантизації (FP16) важить 16 ГБ: стеля близько 40 tok/s. Puget на DeepSeek-R1-Distill-Llama-8B наміряв 34,5 tok/s.
- У моделі-«суміші експертів» (MoE) 35B-A3B на кожен токен працюють лише близько 3 млрд параметрів. Читати доводиться в рази менше, звідси 127–148 tok/s.
Ця сама формула ловить помилки в чужих тестах. Puget Systems спершу опублікував 61,7 tok/s на 8B-моделі, а у вересні 2026 року сам виправив цифру: для такої швидкості знадобилося б близько 991 ГБ/с, а в карти 640. Правильне значення — 34,5 tok/s. Якщо в переказах ви бачите «61,7» — це стара версія.
Ціна R9700 на 26 жовтня 2026: від $1300 за прайсом до $1900
Ціна Radeon AI Pro R9700 залежить від дати й каналу продажу сильніше, ніж у більшості карт. AMD випустила її в робочих станціях 23 липня 2025 року, у роздріб карта надійшла 27 жовтня 2025-го за рекомендованою ціною $1299. Через рік та сама карта коштує на третину-половину дорожче.Дата Канал Ціна $ за 1 ГБ пам’яті 27.10.2025 рекомендована ціна AMD $1299 $40,6 липень 2026 Puget Systems, конфігуратор інтегратора ~$1880 $58,8 початок серпня 2026 Newegg, роздріб США (за даними localaimaster) $1350–1380 $42–43 жовтень 2026 eBay, середнє нижніх лотів (GPU Poet) $1921, розкид $1683–2586 $60 26.10.2026 оцінка ринкової ціни ServeTheHome ~$1700 $53
Чому подорожчала? Головна причина — пам’ять. За даними TrendForce з посиланням на галузеві канали, AMD повідомила партнерів (Sapphire, ASUS, XFX та інших) про зростання цін на набори «чип + пам’ять GDDR» приблизно на 10% з липня 2026 року. Спотова ціна споживчої GDDR6 з осені 2025 року до липня 2026-го зросла приблизно з $2,5 до $7,5 за гігабайт (TrendForce, 3 липня 2026 року), а підвищення AMD стало другим за пів року. ServeTheHome називає ту саму причину: ціни зросли через подорожчання комплектуючих і пам’яті. Для карти з 32 ГБ пам’яті це помітна частина собівартості, тому R9700 дорожчає швидше за ігрові моделі з 16 ГБ.
Партнерські версії (ASRock Creator, PowerColor, Sapphire, XFX) майже однакові: AMD тримає партнерів у жорстких рамках дизайну, щоб карти гарантовано ставали по кілька штук у робочу станцію. Переплачувати за бренд сенсу мало — порівнюйте ціну і гарантію. Перевірених цін R9700 в українському роздробі на 26 жовтня 2026 року в нас немає, тому орієнтуйтеся на доларові ціни США з поправкою на доставку та мито.
Що застаріє першим: ціни в цій таблиці. Перед купівлею звірте актуальну ціну в магазині — тренд осені 2026 року спрямований угору.
Які моделі влазять у 32 ГБ і з якою швидкістю
Для запуску мовних моделей на своєму комп’ютері головне питання — яка модель повністю поміститься в пам’ять R9700. Якщо модель не влазить і частина шарів іде в оперативну пам’ять, швидкість падає в рази. Розмір ваг обчислюється так: параметри × біти на вагу ÷ 8. Квантизація — це стиснення ваг: Q4 зберігає вагу приблизно в 4,8 біта замість 16, і модель стає більш ніж утричі легшою. Скільки якості при цьому втрачається — у нашому розборі квантування Q4 проти Q8.
Відкритих LLM-бенчмарків (benchmark — стандартизований тест швидкості) AMD Radeon AI Pro R9700 небагато, і найкорисніші з них — обговорення llama.cpp на GitHub, де власники карти публікують заміри з моделлю, квантом і бекендом. До ваг додайте 2–6 ГБ на кеш контексту (KV-кеш, пам’ять для вже прочитаного тексту) і службові буфери. Таблиця — наш розрахунок за цією формулою плюс опубліковані заміри на R9700.Модель (приклад) Q4 (~4,8 біта) Q8 (~8,5 біта) FP16 Влазить у 32 ГБ? Замір на одній R9700 8B (Llama 3.1 8B, Qwen3 8B) ~5 ГБ ~8,5 ГБ ~16 ГБ так, навіть без квантизації 27,7–34,5 tok/s у FP16, vLLM (Puget: Qwen3 8B — 27,7, Llama 3.1 8B — 29,1, DeepSeek-R1-Distill-Llama-8B — 34,5) 14B ~9 ГБ ~15 ГБ ~28 ГБ Q8 — вільно, FP16 — упритул н/д 27B щільна (Qwen3.5-27B) 15,58 ГіБ (~16,7 ГБ) ~29 ГБ ~54 ГБ Q4 — із запасом під довгий контекст, Q8 — на межі ~29 tok/s, Q4_K_M, Vulkan (llama.cpp #21043) 30B MoE (Qwen3-30B-A3B) 17,28 ГіБ (~18,5 ГБ) ~32 ГБ — Q4 — так, Q8 — ні 177 tok/s на контексті 2048, Vulkan (llama.cpp #19890) 35B MoE (Qwen3.5-35B-A3B) ~21 ГБ ~37 ГБ — Q4 — так 127,4–147,8 tok/s, Vulkan (#19890, #21043) 70B щільна ~42 ГБ ~75 ГБ ~140 ГБ ні; Q4 — лише на двох картах н/д
Що видно з таблиці:
- Щільні 27–32B — стеля комфорту. ServeTheHome на Qwen3.8-27B у 4 бітах отримав 20–30 tok/s на одного користувача — читати відповідь у реальному часі можна, але це не миттєво. Тест HOSTKEY на Habr в Ollama дав 26,3 tok/s на deepseek-r1:32b.
- MoE — природне середовище R9700. Модель із 35 млрд параметрів, з яких на токен працюють 3 млрд, іде в 4–5 разів швидше за щільну 27B за схожого розміру файлу. Вибір моделі тут важливіший за вибір рушія.
- Генерація картинок працює. Puget отримав на Z-Image Turbo 1024×1024 за 3,6 секунди в усталеному режимі, близько 18 ГБ відеопам’яті. У HOSTKEY на тій самій моделі вийшло 6–7 секунд — інша збірка ПЗ і методика, цифри не усереднюємо.
- 70B на одній карті — лише з агресивним стисненням нижче Q4, де якість помітно просідає. Реальний шлях — дві карти (розділ нижче).
ROCm чи Vulkan: який бекенд обрати під вашу модель
У карт AMD два шляхи запуску нейромереж. ROCm — програмна платформа AMD для обчислень на відеокарті, аналог CUDA в NVIDIA (докладно про різницю — у матеріалі ROCm проти CUDA). Vulkan — універсальний графічний інтерфейс, через який llama.cpp теж уміє рахувати нейромережі; йому не потрібні окремі драйвери ROCm.
Єдиної цифри «що швидше» немає: джерела міряли різні моделі на різних збірках. Правило, яке з них складається:Завдання Що брати На чому ґрунтується llama.cpp, LM Studio, MoE-моделі, одна карта Vulkan на Qwen3-30B-A3B ~183 tok/s через Vulkan проти ~150 через ROCm (llama.cpp #19890); 147,8 tok/s на 35B-A3B (#21043) Щільні моделі понад 20B у llama.cpp спробуйте ROCm учасники обговорення llama.cpp #21043 пишуть, що ROCm швидший на великих щільних моделях, а Vulkan — на MoE; замірів в однакових умовах немає vLLM, кілька користувачів, дві карти ROCm vLLM працює лише поверх ROCm; Puget міряв офіційний образ vllm-openai-rocm v0.20.2 PyTorch, ComfyUI, навчання LoRA ROCm Vulkan цих завдань не покриває Windows Vulkan або PyTorch на ROCm решта стека ROCm для Radeon підтримується лише на Linux 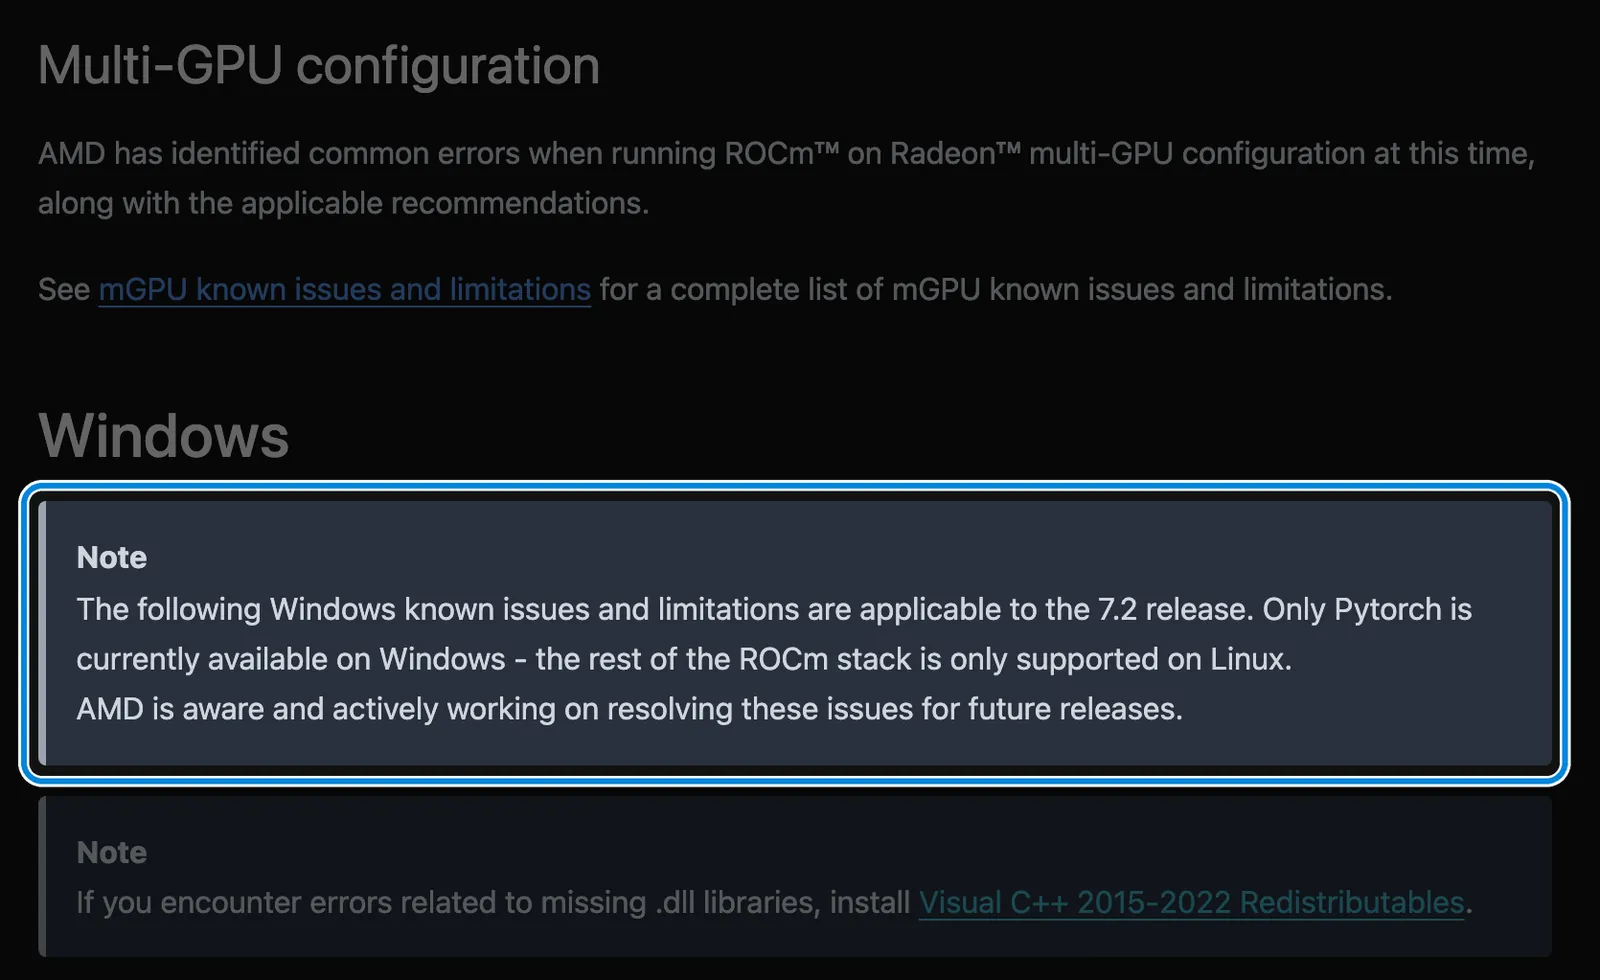
На скриншоті документації AMD ROCm 7.2 (знято 26 жовтня 2026 року) рамкою виділено обмеження: на Windows доступний лише PyTorch, решта стека ROCm підтримується лише на Linux.
Оновлювати ROCm заради швидкості в llama.cpp не обов’язково: Phoronix 14 травня 2026 року не побачив змін швидкості llama.cpp під час переходу з ROCm 7.0 на 7.2.3.
Запуск карти під llama.cpp: чотири кроки
- Поставте Linux зі списку підтримки ROCm — найпростіше Ubuntu 24.04 LTS. Для Vulkan-шляху вистачає свіжого драйвера Mesa (RADV), для ROCm-шляху встановіть ROCm 7.x за інструкцією AMD.
- Зберіть llama.cpp під потрібний бекенд:
cmake -B build -DGGML_VULKAN=ONдля Vulkan абоcmake -B build -DGGML_HIP=ON -DGPU_TARGETS=gfx1201для ROCm (gfx1201 — внутрішнє ім’я чипа R9700). - Явно вкажіть карту. Якщо в процесорі є вбудована графіка, llama.cpp може за замовчуванням обрати її. Автор тесту в обговоренні #19890 отримав ~120 tok/s замість ~180, доки не вказав пристрій прапорцем
-dev Vulkan1. - Перевірте, що всі шари на карті (
-ngl 99) і що модель із контекстом вкладається в 32 ГБ — інакше швидкість упаде в рази.
R9700 проти RTX 5090: у скільки разів повільніша і дешевша
Порівняння Radeon AI Pro R9700 і RTX 5090 напрошується: в обох по 32 ГБ відеопам’яті, тобто влазять ті самі моделі. Різниця — у швидкості й ціні, і вона тягне в різні боки.Radeon AI Pro R9700 GeForce RTX 5090 Відеопам’ять 32 ГБ GDDR6 32 ГБ GDDR7 Пропускна здатність 640 ГБ/с 1792 ГБ/с (у 2,8 раза вища) Потужність 300 Вт 575 Вт Рекомендована ціна $1299 $1999 Ціна восени 2026 року ~$1700 (ServeTheHome, 26.10) $4299 у Micro Center і $6500–9500 у сторонніх продавців (Tom’s Hardware, 14.09); ~$6450 — середнє нижніх лотів eBay за жовтень (GPU Poet) $ за 1 ГБ пам’яті ~$53 $134–297 Обробка запиту база у 2,6–3,4 раза швидша (llama.cpp #19890) Генерація, один потік база приблизно в 1,5 раза швидша (llama.cpp #19890) Сервер під навантаженням база майже в 4 рази швидша на піку, щільна 27B (ServeTheHome)
Головне спостереження з огляду ServeTheHome: на MoE-моделі Qwen3.6-35B-A3B за малої кількості користувачів розрив стискається до 2:1, за великої — близько 3:1, а на щільній Qwen3.8-27B на піку пропускної здатності RTX 5090 майже вчетверо швидша. Тест HOSTKEY на Habr (компанія здає GPU в оренду, це варто враховувати) показав схожу картину на deepseek-r1:32b в Ollama: 26,3 tok/s у R9700 проти 65,4 tok/s у RTX 5090.
Звідси висновок. Якщо ви одні й пишете в чат або запускаєте агента, R9700 повільніша в 1,5–2 раза, але коштує в 2,5–3,8 раза дешевше (на осінніх цінах $1700 проти $4299–6450). Якщо ви обслуговуєте команду або ганяєте довгі документи, де вирішує обробка промпту, RTX 5090 відпрацьовує свою ціну. Зведену таблицю замірів по NVIDIA ми збирали окремо: RTX 5090, 4090 і 3090 у локальних LLM.
Порівнянні 32-гігабайтні карти NVIDIA, за оцінкою ServeTheHome, коштують більш ніж удвічі дорожче за R9700 (видання їх не називає; за нашим тлумаченням ідеться про професійну лінійку RTX Pro Blackwell); точної ціни RTX Pro 4500 на дату ми не підтвердили. Про RTX 5090 ServeTheHome пише з посиланням на чутки, що карту знято з виробництва, — підтвердження немає, але зникнення з роздрібу США Tom’s Hardware зафіксував 14 вересня 2026 року.
Radeon R9700 проти RTX 3090, RX 7900 XTX і RX 9070 XT: що брати
Тут вибір інший: нова карта з 32 ГБ проти швидшої, але 24-гігабайтної (часто б/в) або 16-гігабайтної на тому самому чипі. Порівняння Radeon AI Pro R9700 з RTX 3090, RX 7900 XTX і RX 9070 XT зводиться до питання «чи потрібні вам зайві 8 ГБ» (а проти 9070 XT — зайві 16 ГБ).Карта Пам’ять Пропускна здатність Потужність Ціна (дата) $ за 1 ГБ Radeon AI Pro R9700 32 ГБ GDDR6 640 ГБ/с 300 Вт ~$1700 (26.10.2026) ~$53 RTX 3090, б/в 24 ГБ GDDR6X 936 ГБ/с 350 Вт ~$1380 — середнє нижніх лотів eBay за жовтень 2026 (GPU Poet) ~$57 RTX 4090 24 ГБ GDDR6X 1008 ГБ/с 450 Вт н/д на дату н/д RX 7900 XTX 24 ГБ GDDR6 960 ГБ/с 355 Вт н/д на дату (старт у 2022 році — $999) н/д RX 9070 XT 16 ГБ GDDR6 640 ГБ/с 304 Вт рекомендована $599 ~$37
- RTX 3090 б/в швидше читає пам’ять (936 проти 640 ГБ/с) і працює з CUDA, де майже будь-який софт запускається без налаштування. Але 24 ГБ вистачає на 27–32B у Q4 лише з коротким контекстом, а карта б/в — з невідомою історією навантаження. Один користувач в обговоренні llama.cpp #19890 пише, що на Qwen3-Coder-30B-A3B R9700 через Vulkan приблизно дорівнює 3090 з обмеженням потужності 250–300 Вт — близько 140 tok/s. Як зібрати дві такі карти в 48 ГБ — у нашому матеріалі збірка на двох RTX 3090.
- RX 7900 XTX — та сама логіка всередині AMD: більша пропускна здатність (960 ГБ/с) і менше пам’яті. Для моделей до 24 ГБ вона за формулою пропускної здатності має генерувати швидше за R9700; для 27–35B із довгим контекстом виграють зайві 8 ГБ. Розбір збірки — на AMD RX 7900 XTX для локального LLM.
- RX 9070 XT — той самий чип і та сама пропускна здатність, але 16 ГБ. Модель Qwen3-30B-A3B у Q4 (17,28 ГіБ) у неї вже повністю не влазить. Якщо вам вистачає моделей до 14B, 9070 XT дасть ту саму швидкість приблизно вдвічі дешевше за рекомендованими цінами ($599 проти $1299); якщо ні — переплата за R9700 купує саме пам’ять.
Дві й чотири R9700: 64 ГБ, vLLM і підводні камені
Дві карти дають 64 ГБ — достатньо для щільної 70B у Q4 або для 27B у FP8 з великим запасом. ServeTheHome зазначає, що в одну робочу станцію стають до чотирьох R9700: це 128 ГБ спільної відеопам’яті. Турбінне охолодження тут працює на користь — кожна карта видуває гаряче повітря через свою планку назовні, а не в сусідку.
Найповніші заміри пари карт опублікував Puget Systems (версія з виправленнями від 10 вересня 2026 року):Конфігурація (дві R9700, Qwen3.6-27B) 1 користувач 8 користувачів vLLM, FP8, тензорний паралелізм на 2 карти (TP=2) 15,88 tok/s 156,21 tok/s Те саме + MTP (спекулятивне декодування) 62,75 tok/s 320,23 tok/s llama.cpp, Q4_K_M, розбиття за шарами 23,40 tok/s —
Як читати ці цифри:
- Друга карта не подвоює швидкість одного потоку. 15,88 tok/s на 27B у FP8 — повільніше, ніж одна карта на порівнянній 27B у Q4. Пара карт масштабує обсяг і кількість користувачів, а не швидкість генерації.
- Швидкість одному користувачеві піднімає софт. MTP — режим, коли модель угадує кілька токенів наперед і перевіряє їх за один прохід. Він підняв одиночний потік із 15,88 до 62,75 tok/s, тобто майже вчетверо.
- Пару карт під навантаження Puget порахував проти хмари. За ціни пари $3283 (на 12.08.2026) і 8 одночасних користувачів вкладення окупається проти API GPT-5.6 Sol приблизно за 1,3 години навантаження на тиждень, проти дешевшої GPT-5.6 Luna — за 37 годин на тиждень. Для однієї людини цей розрахунок не підходить.
Заміряна потужність: одна карта на 8B-моделі — 205–283 Вт, дві карти на 27B — 310–505 Вт (пік 510 Вт). За рекомендацією AMD закладайте блок живлення від 750 Вт на одну карту; для двох карт орієнтир — 1000–1200 Вт із двома роз’ємами 12V-2×6 (наша оцінка за замірами Puget і запасом на процесор).
Покроково: дві карти у vLLM без зависань
- Запускайте на «голому залізі», а не у віртуальній машині. Ранній висновок Puget «стандартний vLLM на двох R9700 не працює» виявився помилкою стенда: віртуалізація KVM/VFIO ламала ініціалізацію RCCL (бібліотеки обміну даними між картами AMD). На bare metal TP=2 працює стабільно.
- Якщо ініціалізація зависає — увімкніть обхід
NCCL_PROTO=Simple. Так зависання лікується в issue #5480 репозиторію ROCm, відкритому 27 квітня 2026 року. 20 серпня 2026 року в RCCL запропонували патч (ROCm/rccl#2187), який вмикає той самий режим за замовчуванням; чи потрапив він у вашу версію ROCm, перевірте в нотатках до релізу. - Не вмикайте прискорені ядра AITER (
VLLM_ROCM_USE_AITER=1) без перевірки: у травні 2026 року з ними vLLM на R9700 не стартував (issue #3294), до вересня частина ядер запрацювала, але GEMM-ядра CK і BF16fused_moeна цьому чипі досі не працюють. - У llama.cpp починайте з розбиття за шарами — у цьому режимі Puget отримав на парі карт 23,40 tok/s. На нестандартних зв’язках збоїти можуть обидва режими: у коментарі до issue #5480 від 13 вересня 2026 року користувач зі зв’язкою R9700 + RX 9070 (OCuLink і Thunderbolt) отримував падіння і під час розбиття за шарами, і під час розбиття за рядками.
Ризики купівлі R9700: Linux, баги ROCm, відео і ціна
R9700 — молода карта на молодому програмному стеку. Ось що може зламатися, з датами, коли проблему було зафіксовано:
- Зависання RCCL на кількох картах (issue #5480, відкрито 27.04.2026). Лікується змінною
NCCL_PROTO=Simple; патч RCCL запропоновано 20.08.2026. У віртуальних машинах із прокиданням карт зависання, за даними Puget на 10.09.2026, відтворювалося. - AITER для vLLM підтримує чип лише частково (issue #3294 відкрито 21.05.2026, і на 26.10.2026 його не закрито). За звітом учасників від 5 вересня 2026 року частина ядер працює, а GEMM-ядра CK і BF16
fused_moe— ні; сам vLLM працює і без AITER. - Windows. За документацією ROCm 7.2 на Windows доступний лише PyTorch. llama.cpp через Vulkan на Windows працює, vLLM — ні.
- Відео. AMD сама веде в списку відомих проблем спотворення кольору під час генерації відео моделлю Wan 2.2 TI2V 5B у ComfyUI на R9700. HOSTKEY на Habr пише, що в генерації відео карти AMD програють, і суттєво.
- Ціна. Карта дорожчає разом із пам’яттю GDDR6, і зростання з липня 2026 року підтверджують і галузеві зведення, і трекери цін. Куплена сьогодні за $1700 карта може коштувати дорожче через квартал — але й дешевше, якщо ринок пам’яті розвернеться.
- Шум. Замірів шуму R9700 у відкритих джерелах немає. ServeTheHome зазначає, що за 300 Вт турбіну вдається охолодити «без шумового вибуху», але цифр у децибелах ніхто не публікував — якщо карта стоятиме в житловій кімнаті, пошукайте відгуки власників про шум.
- Швидкість софту змінюється швидко. Половина цифр цієї статті залежить від версії llama.cpp, vLLM і ROCm. Звіряйте заміри з датою і версією, а не із заголовком.
Сильні й слабкі сторони Radeon AI Pro R9700 за чужими тестами
Де карта сильна: пам’ять, живлення, MoE
- 32 ГБ відеопам’яті за ~$1700 (26.10.2026) — близько $53 за гігабайт проти $134 і вище в RTX 5090.
- 300 Вт, турбіна і стандартні два слоти: одна карта стає у звичайний ПК із БЖ від 750 Вт, до чотирьох — у робочу станцію.
- MoE-моделі 30–35B ідуть зі швидкістю 127–183 tok/s.
Де карта слабка: швидкість, софт, ціна
- 640 ГБ/с: щільні моделі 27–32B не швидші за ~30 tok/s, RTX 5090 швидша в 1,5–4 раза залежно від сценарію.
- Повний стек ROCm — лише Linux; AITER у vLLM і генерація відео працюють із застереженнями.
- Ціна зросла з $1299 до $1700–1900 за рік і досі залежить від ринку пам’яті.
Кому брати R9700, а кому краще інша карта
Рішення зручно ухвалювати від завдання:
- Чат, код, агенти для однієї людини на моделях до 35B — R9700 підходить найкраще, особливо на MoE-моделях. Це головний сценарій карти.
- Моделі 70B — дві R9700 (64 ГБ) обійдуться дешевше за одну RTX 5090 і дадуть більше пам’яті. Якщо не хочете морочитися з мульти-GPU і готові платити значно більше, дивіться на одну карту на 96 ГБ — розбір робочої станції на RTX PRO 6000.
- Сервіс на десятки користувачів або довгі документи — RTX 5090 чи професійні карти NVIDIA: обробка запиту в 2,6–3,4 раза швидша окуповує різницю.
- Генерація відео (Wan 2.2 і схожі моделі) — поки краще NVIDIA: в AMD це в списку відомих проблем.
- Лише Windows і не хочете Linux — R9700 через Vulkan працює, але ви втрачаєте vLLM і більшу частину екосистеми ROCm; б/в RTX 3090 буде простішою.
- Моделі до 14B — RX 9070 XT на тому самому чипі (рекомендована ціна $599) дасть ту саму швидкість; переплата за R9700 виправдана лише пам’яттю.
FAQ: часті запитання про Radeon AI Pro R9700
Чи вистачить однієї R9700 для моделі на 70 млрд параметрів?
Для нормальної якості — ні. Щільна 70B у квантизації Q4 важить близько 42 ГБ, а в карти 32 ГБ. Влізе лише стиснення нижче Q4, де відповіді помітно гірші, або часткове вивантаження в оперативну пам’ять, яке знижує швидкість у рази. Робочий варіант для 70B — дві R9700 із 64 ГБ сумарної пам’яті або одна карта на 48–96 ГБ.
Чи працює Radeon AI Pro R9700 на Windows для нейромереж?
Частково. За документацією ROCm 7.2 на Windows доступний лише PyTorch, а решта стека ROCm підтримується лише на Linux. llama.cpp і програми на його основі (наприклад, LM Studio) працюють на Windows через Vulkan без встановлення ROCm. vLLM і мульти-GPU з RCCL на Windows не запустити — для цих завдань потрібен Linux.
Чим Radeon AI Pro R9700 відрізняється від RX 9070 XT, якщо чип той самий?
Обидві карти побудовано на Navi 48 із пропускною здатністю пам’яті 640 ГБ/с, тому на моделях, які влазять у 16 ГБ, швидкість генерації в них близька. Різниця — у пам’яті: в R9700 32 ГБ проти 16 ГБ, є ECC під Linux, турбінне охолодження для встановлення кількох карт і професійний драйвер. Платите ви насамперед за подвоєний обсяг.
Скільки коштує R9700 і чому ціна вища за $1299?
$1299 — рекомендована ціна AMD на старті роздрібу 27 жовтня 2025 року. На 26 жовтня 2026 року ServeTheHome оцінює ринкову ціну приблизно в $1700, нижні лоти на eBay у жовтні коштували в середньому $1921. Причина — подорожчання пам’яті: GDDR6 з осені 2025 року подорожчала приблизно втричі, а AMD з липня 2026 року підняла ціни на набори «чип + пам’ять» приблизно на 10%.
Чи підійде блок живлення на 750 Вт для однієї R9700?
Так, це і є рекомендація AMD. Повна потужність карти — 300 Вт, Puget наміряв пікові 298 Вт під навантаженням. Потрібен блок із кабелем 12V-2×6 і запас під процесор. Якщо процесор ненажерливий, наприклад топовий Ryzen 9 або Core i9 з піднятими лімітами, за нашою оцінкою розумніше взяти 850 Вт.
Чи можна поставити дві R9700 у звичайний ПК?
Можна, якщо на платі два слоти PCIe x16 (хоча б електрично x8) на відстані, достатній для двох двослотових карт, а корпус уміщує карти завдовжки близько 27 см. Турбіни видувають повітря назовні, тому карти не гріють одна одну. Під дві карти, за нашою оцінкою, потрібен блок на 1000–1200 Вт із двома роз’ємами 12V-2×6, а для повноцінної роботи vLLM — Linux.