
Коротко: R9700 берут за 32 ГБ, а не за скорость
AMD Radeon AI Pro R9700 — профессиональная видеокарта AMD на чипе RDNA 4 с 32 ГБ видеопамяти. В магазинах её ищут как Radeon AI Pro R9700 32GB, и именно объём памяти — причина, по которой карту берут под локальные нейросети: в неё целиком помещаются языковые модели на 27–35 млрд параметров, которые на 16- и 24-гигабайтных картах не влезают или влезают впритык. Ниже — что эта память даёт на практике, во что упирается и кому карта подходит. Если вы только выбираете железо, начните с нашего общего разбора выбора видеокарты для локального ИИ, а сюда возвращайтесь, когда в списке осталась R9700.
- Коротко: R9700 берут за 32 ГБ, а не за скорость
- Характеристики R9700 для ИИ: что важно, а что нет
- Цена R9700 на 26 октября 2026: от $1300 по прайсу до $1900
- Какие модели влезают в 32 ГБ и с какой скоростью
- ROCm или Vulkan: какой бэкенд выбрать под вашу модель
- R9700 против RTX 5090: во сколько раз медленнее и дешевле
- Radeon R9700 против RTX 3090, RX 7900 XTX и RX 9070 XT: что брать
- Две и четыре R9700: 64 ГБ, vLLM и подводные камни
- Риски покупки R9700: Linux, баги ROCm, видео и цена
- Сильные и слабые стороны Radeon AI Pro R9700 по чужим тестам
- Кому брать R9700, а кому лучше другая карта
- FAQ: частые вопросы о Radeon AI Pro R9700
Этот обзор Radeon AI Pro R9700 собран по чужим замерам: своей карты на стенде у нас нет, поэтому каждая цифра скорости подписана — кто мерил, на какой модели и каким движком.
- Память: 32 ГБ GDDR6 и 640 ГБ/с пропускной способности. Объём — уровень RTX 5090, скорость чтения памяти — почти втрое ниже.
- Цена на 26 октября 2026 года: около $1700 по оценке ServeTheHome. Стартовая цена AMD была $1299, на eBay в октябре нижние лоты стоили в среднем $1921.
- Скорость: плотная модель на 27 млрд параметров в 4-битной квантизации — около 29 токенов в секунду (tok/s), модель-«смесь экспертов» 35B-A3B — 127–148 tok/s. RTX 5090 быстрее: в генерации примерно в 1,5 раза, в обработке запроса — в 2,6–3,4 раза.
- Софт: лучше всего работает на Linux. Через Vulkan карта запускается и на Windows, а стек ROCm на Windows ограничен одним PyTorch.
- Кому: одному человеку под чат, код и агентов на моделях до ~35B, а также тем, кто собирает 64–128 ГБ из двух-четырёх карт. Не подходит для видео-генерации и сервиса на десятки пользователей.
Характеристики R9700 для ИИ: что важно, а что нет
R9700 — это тот же чип Navi 48, что стоит в игровой RX 9070 XT, но с удвоенной памятью, профессиональным драйвером и турбинным охлаждением. Для нейросетей из длинного списка спецификаций важны три строки: объём памяти, её пропускная способность и питание. Остальное (терафлопсы, число ядер) на скорость домашней генерации текста влияет слабо.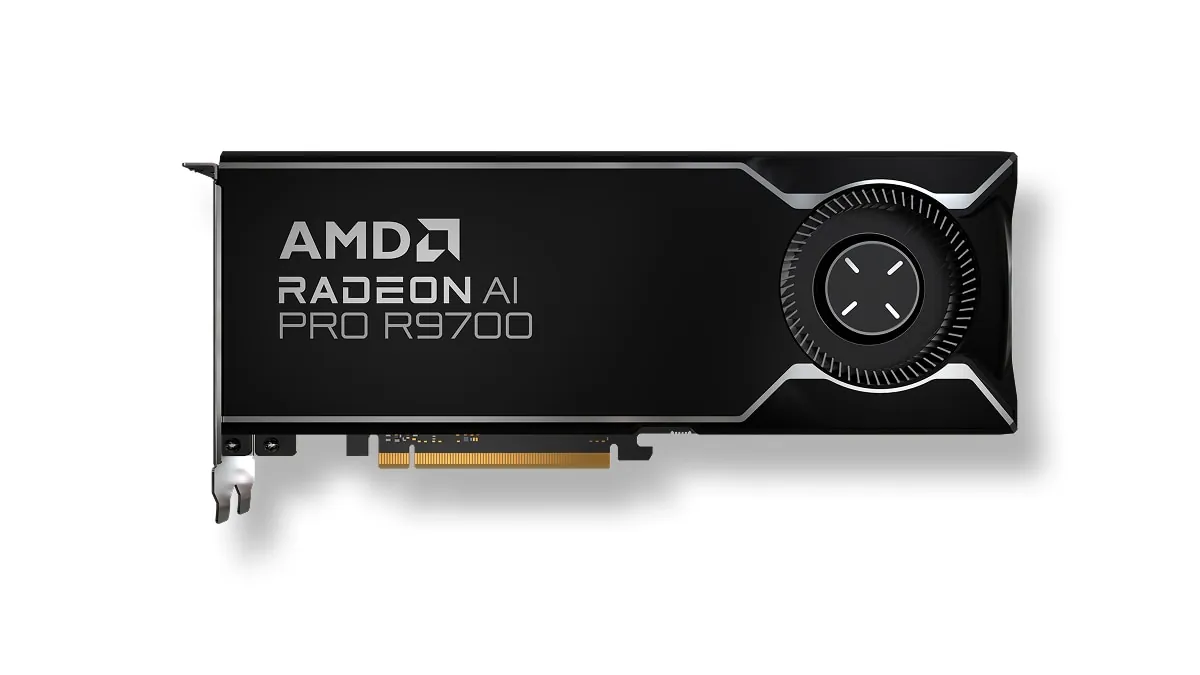
Фото: AMD. Иллюстрация со страницы продукта, а не наш стенд.
| Параметр | Radeon AI Pro R9700 | Что это значит для локального ИИ |
|---|---|---|
| Чип | Navi 48, RDNA 4, 64 вычислительных блока, 4096 потоковых процессоров, 128 ИИ-ускорителей | тот же кристалл, что у RX 9070 XT |
| Видеопамять | 32 ГБ GDDR6, шина 256 бит | влезают модели 27–35B в 4 битах с запасом под контекст |
| Пропускная способность | 640 ГБ/с | задаёт потолок скорости генерации (формула ниже) |
| Infinity Cache | 64 МБ | мал на фоне модели в 16–20 ГБ, потолок задаёт основная память |
| FP8 (матричные операции) | 383 TFLOPS, с разреженностью 766 | теоретический пик, ускоряет обработку запроса, а не генерацию |
| ECC | есть, только под Linux | защита памяти от сбоев, важна для долгих задач |
| Питание | TBP 300 Вт, разъём 12V-2×6, рекомендуемый БП от 750 Вт | влезает в обычный ПК |
| Интерфейс | PCIe 5.0 x16 | полноразмерный слот, как у игровых видеокарт |
| Охлаждение | турбина (blower), два слота; у ASRock длина 27,1 см | горячий воздух уходит наружу корпуса, карты можно ставить вплотную |
Источник спецификаций — страница AMD, данные сверены с таблицей ServeTheHome. Puget Systems в реальной работе намерил у одной карты пиковые 298 Вт, то есть в заявленные 300 Вт она укладывается.
Формула: сколько токенов в секунду даст 32GB-карта
Языковая модель на каждый новый токен (кусок слова) перечитывает из памяти все свои веса. Поэтому потолок скорости генерации считается просто: пропускная способность ÷ размер модели в памяти.
- Плотная модель на 27 млрд параметров в квантизации Q4_K_M весит 15,58 ГиБ, то есть около 16,7 ГБ. 640 ÷ 16,7 ≈ 38 tok/s в теории. Реальный замер в llama.cpp — около 29 tok/s, то есть карта работает примерно на 75% потолка.
- Модель на 8 млрд параметров без квантизации (FP16) весит 16 ГБ: потолок около 40 tok/s. Puget на DeepSeek-R1-Distill-Llama-8B намерил 34,5 tok/s.
- У модели-«смеси экспертов» (MoE) 35B-A3B на каждый токен работают только около 3 млрд параметров. Читать приходится в разы меньше, отсюда 127–148 tok/s.
Эта же формула ловит ошибки в чужих тестах. Puget Systems сначала опубликовал 61,7 tok/s на 8B-модели, а в сентябре 2026 года сам исправил цифру: для такой скорости понадобилось бы около 991 ГБ/с, а у карты 640. Верное значение — 34,5 tok/s. Если в пересказах вы видите «61,7» — это старая версия.
Цена R9700 на 26 октября 2026: от $1300 по прайсу до $1900
Цена Radeon AI Pro R9700 зависит от даты и канала продажи сильнее, чем у большинства карт. AMD выпустила её в рабочих станциях 23 июля 2025 года, в розницу карта поступила 27 октября 2025-го по рекомендованной цене $1299. Через год та же карта стоит на треть-половину дороже.Дата Канал Цена $ за 1 ГБ памяти 27.10.2025 рекомендованная цена AMD $1299 $40,6 июль 2026 Puget Systems, конфигуратор интегратора ~$1880 $58,8 начало августа 2026 Newegg, розница США (по данным localaimaster) $1350–1380 $42–43 октябрь 2026 eBay, среднее нижних лотов (GPU Poet) $1921, разброс $1683–2586 $60 26.10.2026 оценка рыночной цены ServeTheHome ~$1700 $53
Почему подорожало? Главная причина — память. По данным TrendForce со ссылкой на отраслевые каналы, AMD уведомила партнёров (Sapphire, ASUS, XFX и других) о росте цен на наборы «чип + память GDDR» примерно на 10% с июля 2026 года. Спотовая цена потребительской GDDR6 с осени 2025 года к июлю 2026-го выросла примерно с $2,5 до $7,5 за гигабайт (TrendForce, 3 июля 2026 года), а повышение AMD стало вторым за полгода. ServeTheHome называет ту же причину: цены выросли из-за подорожания комплектующих и памяти. У карты с 32 ГБ памяти это заметная часть себестоимости, поэтому R9700 дорожает быстрее игровых моделей с 16 ГБ.
Партнёрские версии (ASRock Creator, PowerColor, Sapphire, XFX) почти одинаковы: AMD держит партнёров в жёстких рамках дизайна, чтобы карты гарантированно вставали по несколько штук в рабочую станцию. Переплачивать за бренд смысла мало — сравнивайте цену и гарантию. Проверенных цен R9700 в украинской рознице на 26 октября 2026 года у нас нет, поэтому ориентируйтесь на долларовые цены США с поправкой на доставку и пошлины.
Что устареет первым: цены в этой таблице. Перед покупкой сверьте актуальную цену в магазине — тренд осени 2026 года направлен вверх.
Какие модели влезают в 32 ГБ и с какой скоростью
Для запуска языковых моделей на своём компьютере главный вопрос — какая модель поместится в память R9700 целиком. Если модель не влезает и часть слоёв уходит в оперативную память, скорость падает в разы. Размер весов считается так: параметры × биты на вес ÷ 8. Квантизация — это сжатие весов: Q4 хранит вес примерно в 4,8 бита вместо 16, и модель становится в три с лишним раза легче. Сколько качества при этом теряется — в нашем разборе квантования Q4 против Q8.
К весам добавьте 2–6 ГБ на кэш контекста (KV-кэш, память для уже прочитанного текста) и служебные буферы. Таблица — наш расчёт по этой формуле плюс опубликованные замеры на R9700.Модель (пример) Q4 (~4,8 бит) Q8 (~8,5 бит) FP16 Влезает в 32 ГБ? Замер на одной R9700 8B (Llama 3.1 8B, Qwen3 8B) ~5 ГБ ~8,5 ГБ ~16 ГБ да, даже без квантизации 27,7–34,5 tok/s в FP16, vLLM (Puget: Qwen3 8B — 27,7, Llama 3.1 8B — 29,1, DeepSeek-R1-Distill-Llama-8B — 34,5) 14B ~9 ГБ ~15 ГБ ~28 ГБ Q8 — свободно, FP16 — впритык н/д 27B плотная (Qwen3.5-27B) 15,58 ГиБ (~16,7 ГБ) ~29 ГБ ~54 ГБ Q4 — с запасом под длинный контекст, Q8 — на грани ~29 tok/s, Q4_K_M, Vulkan (llama.cpp #21043) 30B MoE (Qwen3-30B-A3B) 17,28 ГиБ (~18,5 ГБ) ~32 ГБ — Q4 — да, Q8 — нет 177 tok/s на контексте 2048, Vulkan (llama.cpp #19890) 35B MoE (Qwen3.5-35B-A3B) ~21 ГБ ~37 ГБ — Q4 — да 127,4–147,8 tok/s, Vulkan (#19890, #21043) 70B плотная ~42 ГБ ~75 ГБ ~140 ГБ нет; Q4 — только на двух картах н/д
Что видно из таблицы:
- Плотные 27–32B — потолок комфорта. ServeTheHome на Qwen3.8-27B в 4 битах получил 20–30 tok/s на одного пользователя — читать ответ в реальном времени можно, но это не мгновенно. Тест HOSTKEY на Habr в Ollama дал 26,3 tok/s на deepseek-r1:32b.
- MoE — естественная среда R9700. Модель с 35 млрд параметров, из которых на токен работают 3 млрд, идёт в 4–5 раз быстрее плотной 27B при похожем размере файла. Выбор модели здесь важнее выбора движка.
- Генерация картинок работает. Puget получил на Z-Image Turbo 1024×1024 за 3,6 секунды в установившемся режиме, около 18 ГБ видеопамяти. У HOSTKEY на той же модели вышло 6–7 секунд — другая сборка ПО и методика, цифры не усредняем.
- 70B на одной карте — только с агрессивным сжатием ниже Q4, где качество проседает заметно. Реальный путь — две карты (раздел ниже).
ROCm или Vulkan: какой бэкенд выбрать под вашу модель
У карт AMD два пути запуска нейросетей. ROCm — программная платформа AMD для вычислений на видеокарте, аналог CUDA у NVIDIA (подробно о разнице — в материале ROCm против CUDA). Vulkan — универсальный графический интерфейс, через который llama.cpp тоже умеет считать нейросети; ему не нужны отдельные драйверы ROCm.
Единой цифры «что быстрее» нет: источники мерили разные модели на разных сборках. Правило, которое из них складывается:Задача Что брать На чём основано llama.cpp, LM Studio, MoE-модели, одна карта Vulkan на Qwen3-30B-A3B ~183 tok/s через Vulkan против ~150 через ROCm (llama.cpp #19890); 147,8 tok/s на 35B-A3B (#21043) Плотные модели больше 20B в llama.cpp попробуйте ROCm участники обсуждения llama.cpp #21043 пишут, что ROCm быстрее на крупных плотных моделях, а Vulkan — на MoE; замеров в одинаковых условиях нет vLLM, несколько пользователей, две карты ROCm vLLM работает только поверх ROCm; Puget мерил официальный образ vllm-openai-rocm v0.20.2 PyTorch, ComfyUI, обучение LoRA ROCm Vulkan этих задач не покрывает Windows Vulkan или PyTorch на ROCm остальной стек ROCm для Radeon поддерживается только на Linux 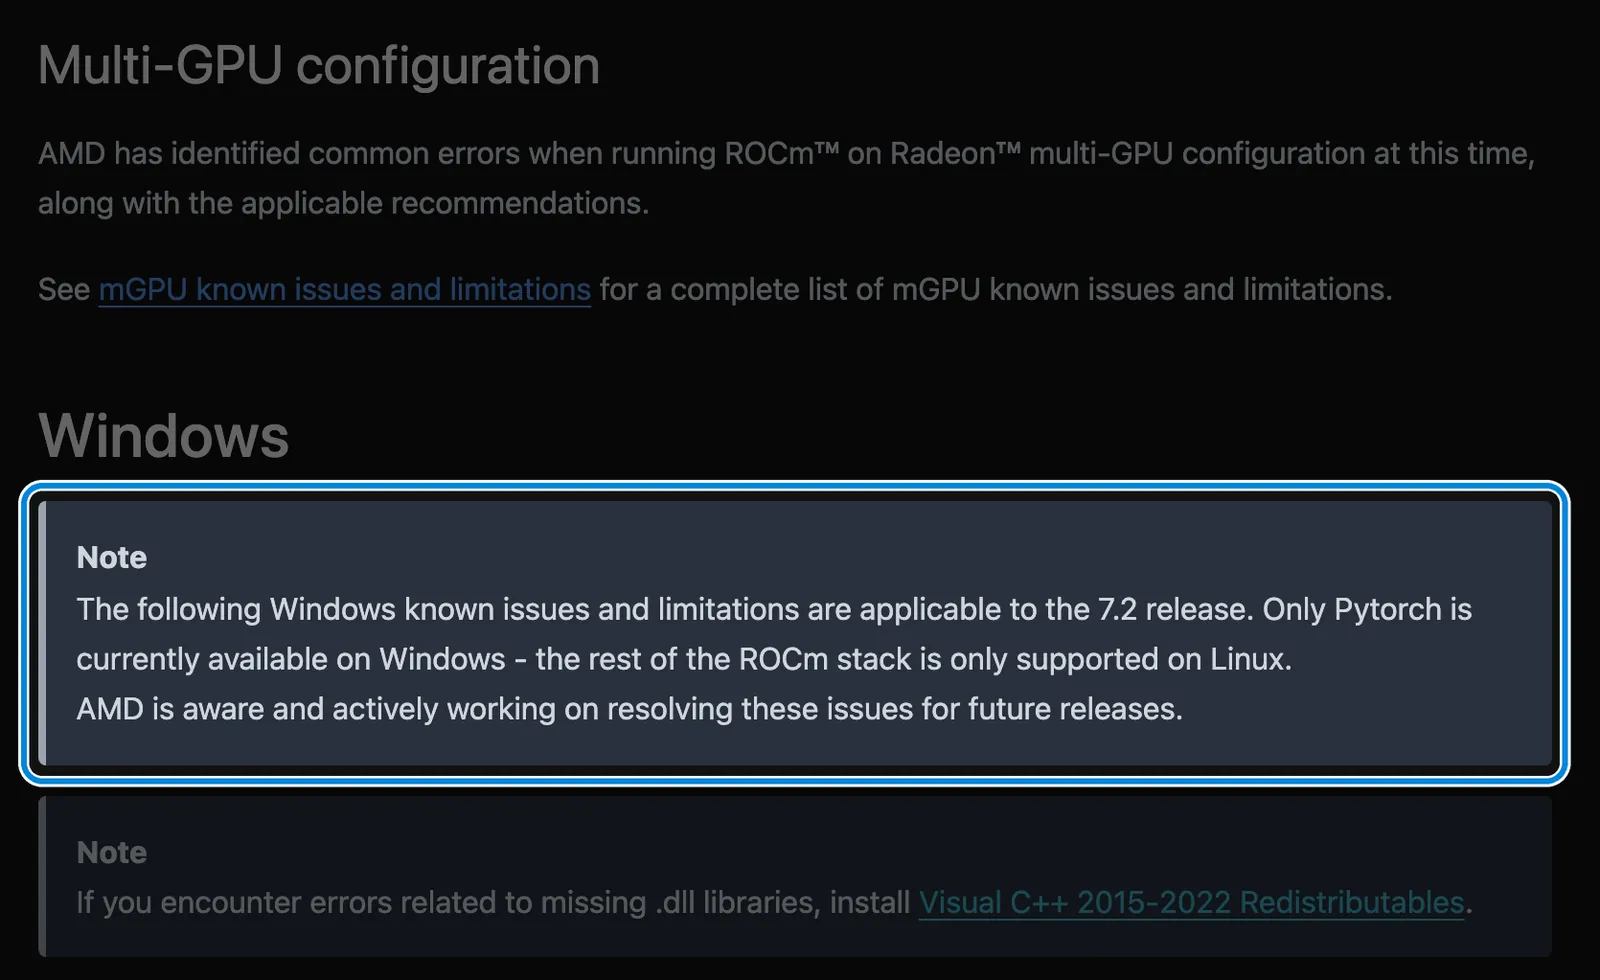
На скриншоте документации AMD ROCm 7.2 (снят 26 октября 2026 года) рамкой выделено ограничение: на Windows доступен только PyTorch, остальной стек ROCm поддерживается только на Linux.
Обновлять ROCm ради скорости в llama.cpp не обязательно: Phoronix 14 мая 2026 года не увидел изменений скорости llama.cpp при переходе с ROCm 7.0 на 7.2.3.
Запуск карты под llama.cpp: четыре шага
- Поставьте Linux из списка поддержки ROCm — проще всего Ubuntu 24.04 LTS. Для Vulkan-пути хватает свежего драйвера Mesa (RADV), для ROCm-пути поставьте ROCm 7.x по инструкции AMD.
- Соберите llama.cpp под нужный бэкенд:
cmake -B build -DGGML_VULKAN=ONдля Vulkan илиcmake -B build -DGGML_HIP=ON -DGPU_TARGETS=gfx1201для ROCm (gfx1201 — внутреннее имя чипа R9700). - Явно укажите карту. Если в процессоре есть встроенная графика, llama.cpp может по умолчанию выбрать её. Автор теста в обсуждении #19890 получил ~120 tok/s вместо ~180, пока не указал устройство флагом
-dev Vulkan1. - Проверьте, что все слои на карте (
-ngl 99) и что модель с контекстом укладывается в 32 ГБ — иначе скорость упадёт в разы.
R9700 против RTX 5090: во сколько раз медленнее и дешевле
Сравнение Radeon AI Pro R9700 и RTX 5090 напрашивается: у обеих по 32 ГБ видеопамяти, то есть влезают одни и те же модели. Разница — в скорости и цене, и она тянет в разные стороны.Radeon AI Pro R9700 GeForce RTX 5090 Видеопамять 32 ГБ GDDR6 32 ГБ GDDR7 Пропускная способность 640 ГБ/с 1792 ГБ/с (в 2,8 раза выше) Мощность 300 Вт 575 Вт Рекомендованная цена $1299 $1999 Цена осенью 2026 года ~$1700 (ServeTheHome, 26.10) $4299 в Micro Center и $6500–9500 у сторонних продавцов (Tom’s Hardware, 14.09); ~$6450 — среднее нижних лотов eBay за октябрь (GPU Poet) $ за 1 ГБ памяти ~$53 $134–297 Обработка запроса база в 2,6–3,4 раза быстрее (llama.cpp #19890) Генерация, один поток база примерно в 1,5 раза быстрее (llama.cpp #19890) Сервер под нагрузкой база почти в 4 раза быстрее на пике, плотная 27B (ServeTheHome)
Главное наблюдение из обзора ServeTheHome: на MoE-модели Qwen3.6-35B-A3B при малом числе пользователей разрыв сжимается до 2:1, при большом — около 3:1, а на плотной Qwen3.8-27B на пике пропускной способности RTX 5090 почти вчетверо быстрее. Тест HOSTKEY на Habr (компания сдаёт GPU в аренду, это стоит учитывать) показал похожую картину на deepseek-r1:32b в Ollama: 26,3 tok/s у R9700 против 65,4 tok/s у RTX 5090.
Отсюда вывод. Если вы один и пишете в чат или запускаете агента, R9700 медленнее в 1,5–2 раза, но стоит в 2,5–3,8 раза дешевле (на осенних ценах $1700 против $4299–6450). Если вы обслуживаете команду или гоняете длинные документы, где решает обработка промпта, RTX 5090 отрабатывает свою цену. Сводную таблицу замеров по NVIDIA мы собирали отдельно: RTX 5090, 4090 и 3090 в локальных LLM.
Сопоставимые 32-гигабайтные карты NVIDIA, по оценке ServeTheHome, стоят более чем вдвое дороже R9700 (издание их не называет; по нашей трактовке речь о профессиональной линейке RTX Pro Blackwell); точной цены RTX Pro 4500 на дату мы не подтвердили. О RTX 5090 ServeTheHome пишет со ссылкой на слухи, что карта снята с производства, — подтверждения нет, но пропажу из розницы США Tom’s Hardware зафиксировал 14 сентября 2026 года.
Radeon R9700 против RTX 3090, RX 7900 XTX и RX 9070 XT: что брать
Здесь выбор другой: новая карта с 32 ГБ против более быстрой, но 24-гигабайтной (часто б/у) или 16-гигабайтной на том же чипе. Сравнение Radeon AI Pro R9700 с RTX 3090 и RX 7900 XTX сводится к вопросу «нужны ли вам лишние 8 ГБ».Карта Память Пропускная способность Мощность Цена (дата) $ за 1 ГБ Radeon AI Pro R9700 32 ГБ GDDR6 640 ГБ/с 300 Вт ~$1700 (26.10.2026) ~$53 RTX 3090, б/у 24 ГБ GDDR6X 936 ГБ/с 350 Вт ~$1380 — среднее нижних лотов eBay за октябрь 2026 (GPU Poet) ~$57 RTX 4090 24 ГБ GDDR6X 1008 ГБ/с 450 Вт н/д на дату н/д RX 7900 XTX 24 ГБ GDDR6 960 ГБ/с 355 Вт н/д на дату (старт в 2022 году — $999) н/д RX 9070 XT 16 ГБ GDDR6 640 ГБ/с 304 Вт рекомендованная $599 ~$37
- RTX 3090 б/у быстрее читает память (936 против 640 ГБ/с) и работает с CUDA, где почти любой софт запускается без настройки. Но 24 ГБ хватает на 27–32B в Q4 только с коротким контекстом, а карта б/у — с неизвестной историей нагрузки. Один пользователь в обсуждении llama.cpp #19890 пишет, что на Qwen3-Coder-30B-A3B R9700 через Vulkan примерно равна 3090 с ограничением мощности 250–300 Вт — около 140 tok/s. Как собрать две такие карты в 48 ГБ — в нашем материале сборка на двух RTX 3090.
- RX 7900 XTX — та же логика внутри AMD: больше пропускная способность (960 ГБ/с) и меньше памяти. Для моделей до 24 ГБ она по формуле пропускной способности должна генерировать быстрее R9700; для 27–35B с длинным контекстом выигрывают лишние 8 ГБ. Разбор сборки — на AMD RX 7900 XTX для локального LLM.
- RX 9070 XT — тот же чип и та же пропускная способность, но 16 ГБ. Модель Qwen3-30B-A3B в Q4 (17,28 ГиБ) в неё уже не влезает целиком. Если вам хватает моделей до 14B, 9070 XT даст ту же скорость примерно вдвое дешевле по рекомендованным ценам ($599 против $1299); если нет — переплата за R9700 покупает именно память.
Две и четыре R9700: 64 ГБ, vLLM и подводные камни
Две карты дают 64 ГБ — достаточно для плотной 70B в Q4 или для 27B в FP8 с большим запасом. ServeTheHome отмечает, что в одну рабочую станцию встают до четырёх R9700: это 128 ГБ общей видеопамяти. Турбинное охлаждение здесь работает на пользу — каждая карта выдувает горячий воздух через свою планку наружу, а не в соседку.
Самые полные замеры пары карт опубликовал Puget Systems (версия с поправками от 10 сентября 2026 года):Конфигурация (две R9700, Qwen3.6-27B) 1 пользователь 8 пользователей vLLM, FP8, тензорный параллелизм на 2 карты (TP=2) 15,88 tok/s 156,21 tok/s То же + MTP (спекулятивное декодирование) 62,75 tok/s 320,23 tok/s llama.cpp, Q4_K_M, разбиение по слоям 23,40 tok/s —
Как читать эти цифры:
- Вторая карта не удваивает скорость одного потока. 15,88 tok/s на 27B в FP8 — медленнее, чем одна карта на сопоставимой 27B в Q4. Пара карт масштабирует объём и число пользователей, а не скорость генерации.
- Скорость одному пользователю поднимает софт. MTP — режим, когда модель угадывает несколько токенов вперёд и проверяет их за один проход. Он поднял одиночный поток с 15,88 до 62,75 tok/s, то есть почти вчетверо.
- Пару карт под нагрузку Puget посчитал против облака. При цене пары $3283 (на 12.08.2026) и 8 одновременных пользователях вложение окупается против API GPT-5.6 Sol примерно за 1,3 часа нагрузки в неделю, против более дешёвой GPT-5.6 Luna — за 37 часов в неделю. Для одного человека этот расчёт не подходит.
Замеренная мощность: одна карта на 8B-модели — 205–283 Вт, две карты на 27B — 310–505 Вт (пик 510 Вт). По рекомендации AMD закладывайте блок питания от 750 Вт на одну карту; для двух карт ориентир — 1000–1200 Вт с двумя разъёмами 12V-2×6 (наша оценка по замерам Puget и запасу на процессор).
Пошагово: две карты в vLLM без зависаний
- Запускайте на «голом железе», а не в виртуальной машине. Ранний вывод Puget «стандартный vLLM на двух R9700 не работает» оказался ошибкой стенда: виртуализация KVM/VFIO ломала инициализацию RCCL (библиотеки обмена данными между картами AMD). На bare metal TP=2 работает стабильно.
- Если инициализация зависает — включите обход
NCCL_PROTO=Simple. Так зависание лечится в issue #5480 репозитория ROCm, открытом 27 апреля 2026 года. 20 августа 2026 года в RCCL предложили патч (ROCm/rccl#2187), который включает тот же режим по умолчанию; попал ли он в вашу версию ROCm, проверьте в заметках к релизу. - Не включайте ускоренные ядра AITER (
VLLM_ROCM_USE_AITER=1) без проверки: в мае 2026 года с ними vLLM на R9700 не стартовал (issue #3294), к сентябрю часть ядер заработала, но GEMM-ядра CK и BF16fused_moeна этом чипе по-прежнему не работают. - В llama.cpp начинайте с разбиения по слоям — в этом режиме Puget получил на паре карт 23,40 tok/s. На нестандартных связках сбоить могут оба режима: в комментарии к issue #5480 от 13 сентября 2026 года пользователь со связкой R9700 + RX 9070 (OCuLink и Thunderbolt) получал падения и при разбиении по слоям, и при разбиении по строкам.
Риски покупки R9700: Linux, баги ROCm, видео и цена
R9700 — молодая карта на молодом программном стеке. Вот что может сломаться, с датами, когда проблема была зафиксирована:
- Зависание RCCL на нескольких картах (issue #5480, открыт 27.04.2026). Лечится переменной
NCCL_PROTO=Simple; патч RCCL предложен 20.08.2026. В виртуальных машинах с пробросом карт зависание, по данным Puget на 10.09.2026, воспроизводилось. - AITER для vLLM поддерживает чип лишь частично (issue #3294 открыт 21.05.2026 и на 26.10.2026 не закрыт). По отчёту участников от 5 сентября 2026 года часть ядер работает, а GEMM-ядра CK и BF16
fused_moe— нет; сам vLLM работает и без AITER. - Windows. По документации ROCm 7.2 на Windows доступен только PyTorch. llama.cpp через Vulkan на Windows работает, vLLM — нет.
- Видео. AMD сама ведёт в списке известных проблем искажения цвета при генерации видео моделью Wan 2.2 TI2V 5B в ComfyUI на R9700. HOSTKEY на Habr пишет, что в видео-генерации карты AMD «проигрывают и существенно».
- Цена. Карта дорожает вместе с памятью GDDR6, и рост с июля 2026 года подтверждают и отраслевые сводки, и трекеры цен. Купленная сегодня за $1700 карта может стоить дороже через квартал — но и дешевле, если рынок памяти развернётся.
- Шум. Замеров шума R9700 в открытых источниках нет. ServeTheHome отмечает, что при 300 Вт турбину удаётся охладить «без шумового взрыва», но цифр в децибелах никто не публиковал — если карта будет стоять в жилой комнате, поищите отзывы владельцев о шуме.
- Скорость софта меняется быстро. Половина цифр этой статьи зависит от версии llama.cpp, vLLM и ROCm. Сверяйте замеры с датой и версией, а не с заголовком.
Сильные и слабые стороны Radeon AI Pro R9700 по чужим тестам
Где карта сильна: память, питание, MoE
- 32 ГБ видеопамяти за ~$1700 (26.10.2026) — около $53 за гигабайт против $134 и выше у RTX 5090.
- 300 Вт, турбина и стандартные два слота: одна карта встаёт в обычный ПК с БП от 750 Вт, до четырёх — в рабочую станцию.
- MoE-модели 30–35B идут со скоростью 127–183 tok/s.
Где карта слаба: скорость, софт, цена
- 640 ГБ/с: плотные модели 27–32B не быстрее ~30 tok/s, RTX 5090 быстрее в 1,5–4 раза в зависимости от сценария.
- Полный стек ROCm — только Linux; AITER в vLLM и видео-генерация работают с оговорками.
- Цена выросла с $1299 до $1700–1900 за год и продолжает зависеть от рынка памяти.
Кому брать R9700, а кому лучше другая карта
Решение удобно принимать от задачи:
- Чат, код, агенты для одного человека на моделях до 35B — R9700 подходит лучше всего, особенно на MoE-моделях. Это главный сценарий карты.
- Модели 70B — две R9700 (64 ГБ) обойдутся дешевле одной RTX 5090 и дадут больше памяти. Если не хотите возиться с мульти-GPU и готовы платить сильно больше, смотрите на одну карту на 96 ГБ — разбор рабочей станции на RTX PRO 6000.
- Сервис на десятки пользователей или длинные документы — RTX 5090 или профессиональные карты NVIDIA: обработка запроса в 2,6–3,4 раза быстрее окупает разницу.
- Видео-генерация (Wan 2.2 и похожие модели) — пока лучше NVIDIA: у AMD это в списке известных проблем.
- Только Windows и не хотите Linux — R9700 через Vulkan работает, но вы теряете vLLM и большую часть экосистемы ROCm; б/у RTX 3090 будет проще.
- Модели до 14B — RX 9070 XT на том же чипе (рекомендованная цена $599) даст ту же скорость; переплата за R9700 оправдана только памятью.
FAQ: частые вопросы о Radeon AI Pro R9700
Хватит ли одной R9700 для модели на 70 млрд параметров?
Для нормального качества — нет. Плотная 70B в квантизации Q4 весит около 42 ГБ, а у карты 32 ГБ. Влезет только сжатие ниже Q4, где ответы заметно хуже, либо частичная выгрузка в оперативную память, которая роняет скорость в разы. Рабочий вариант для 70B — две R9700 с 64 ГБ суммарной памяти или одна карта на 48–96 ГБ.
Работает ли Radeon AI Pro R9700 на Windows для нейросетей?
Частично. По документации ROCm 7.2 на Windows доступен только PyTorch, а остальной стек ROCm поддерживается только на Linux. llama.cpp и программы на его основе (например, LM Studio) работают на Windows через Vulkan без установки ROCm. vLLM и мульти-GPU с RCCL на Windows не запустить — для этих задач нужен Linux.
Чем Radeon AI Pro R9700 отличается от RX 9070 XT, если чип тот же?
Обе карты построены на Navi 48 с пропускной способностью памяти 640 ГБ/с, поэтому на моделях, которые влезают в 16 ГБ, скорость генерации у них близкая. Разница — в памяти: у R9700 32 ГБ против 16 ГБ, есть ECC под Linux, турбинное охлаждение для установки нескольких карт и профессиональный драйвер. Платите вы в первую очередь за удвоенный объём.
Сколько стоит R9700 и почему цена выше $1299?
$1299 — рекомендованная цена AMD на старте розницы 27 октября 2025 года. На 26 октября 2026 года ServeTheHome оценивает рыночную цену около $1700, нижние лоты на eBay в октябре стоили в среднем $1921. Причина — подорожание памяти: GDDR6 с осени 2025 года выросла в цене примерно втрое, а AMD с июля 2026 года подняла цены на наборы «чип + память» примерно на 10%.
Подойдёт ли блок питания на 750 Вт для одной R9700?
Да, это и есть рекомендация AMD. Полная мощность карты — 300 Вт, Puget намерил пиковые 298 Вт под нагрузкой. Нужен блок с кабелем 12V-2×6 и запас под процессор. Если процессор прожорливый, например топовый Ryzen 9 или Core i9 с поднятыми лимитами, по нашей оценке разумнее взять 850 Вт.
Можно ли поставить две R9700 в обычный ПК?
Можно, если у платы два слота PCIe x16 (хотя бы электрически x8) на расстоянии, достаточном для двух двухслотовых карт, а корпус вмещает карты длиной около 27 см. Турбины выдувают воздух наружу, поэтому карты не греют друг друга. Под две карты, по нашей оценке, нужен блок на 1000–1200 Вт с двумя разъёмами 12V-2×6, а для полноценной работы vLLM — Linux.