
Коротко (TL;DR)
Бюджетная видеокарта для LLM в 2026 году — это не одна модель, а выбор, за что вы готовы платить: деньгами, софтом или шумом. Мы сравнили четыре карты, вокруг которых сейчас строят домашние ИИ-серверы: NVIDIA Tesla P100, AMD Radeon Pro V620, NVIDIA RTX 3060 12 ГБ и Intel Arc Pro B70.
- Коротко (TL;DR)
- Какая бюджетная GPU для ИИ-сервера: вердикт по четырём картам
- Цена за гигабайт VRAM: P100, V620, RTX 3060 и B70 на 26.10.2026
- Что влезает в 12, 16 и 32 ГБ: модели, кванты и ток/с по замерам
- Tesla P100: 16 ГБ за ~$200, но CUDA 12.x и пассивное охлаждение
- Radeon Pro V620: 32 ГБ за ~$350, но ROCm только под Linux
- RTX 3060 12 ГБ: медленнее, зато с рабочим CUDA-стеком
- Arc Pro B70: почему 32 ГБ за $949 стали $1 268 и что с софтом Intel
- Три сборки домашнего ИИ-сервера: карты, ватты и итог по цене
- Шум, охлаждение и питание пассивных серверных карт дома
- Как проверить б/у серверную карту перед покупкой на OLX
- Риски бюджетной сборки: мёртвый софт-стек, износ и цена-ловушка
- FAQ
- Самые дешёвые гигабайты — у серверных P100 (16 ГБ) и V620 (32 ГБ): около $11–13 за гигабайт видеопамяти на конец октября 2026 года. Платите за это стареющим софтом и пассивным охлаждением, которое придётся доделывать самому.
- RTX 3060 12 ГБ вдвое дороже за гигабайт (на OLX 26.10.2026 медиана 14 500 грн), зато это единственная карта четвёрки с полным и живым стеком CUDA: Ollama, llama.cpp и vLLM работают без обходных путей.
- Arc Pro B70 бюджетной уже не является: рекомендованные $949 за 32 ГБ превратились в $1 268 в августе и около $2 000 у перекупщиков в конце октября 2026 года. По цене гигабайта это худшая карта сравнения.
- 32–36 ГБ дома реально собрать тремя путями: 2×P100, 3×RTX 3060 или одна 32-гигабайтная карта. Ниже — цена каждого гигабайта в гривнах, что помещается в 12, 16 и 32 ГБ, три сборки с ваттами и чек-лист покупки б/у карты на OLX.
Какая бюджетная GPU для ИИ-сервера: вердикт по четырём картам
Если коротко отвечать на вопрос «из каких недорогих видеокарт собрать домашний ИИ-сервер», то для большинства это б/у RTX 3060 12 ГБ — одна для старта или две-три для объёма. Серверные P100 и V620 дешевле за гигабайт, но подходят тем, кто готов возиться с Linux, обдувом и старыми версиями библиотек. Arc Pro B70 имеет смысл только при цене около рекомендованной и только если вам нужны именно 32 ГБ в одной карте.
Главный ориентир при выборе — объём видеопамяти (VRAM, память на самой карте): именно он решает, поместится ли модель целиком. Подробно про выбор по объёму памяти мы писали в разборе выбора видеокарты для локального ИИ. Здесь фокус на нижней ценовой границе.Карта VRAM Цена на конец октября 2026 Охлаждение Кому подходит Tesla P100 16 ГБ HBM2 8 500–9 499 грн на OLX (26.10.2026) пассивное экспериментатору с Linux, кому важна цена Radeon Pro V620 32 ГБ GDDR6 ~$350 на eBay (июль 2026, по словам владельца) пассивное тем, кто гоняет MoE-модели и не боится Vulkan/ROCm RTX 3060 12 ГБ 12 ГБ GDDR6 9 899–16 000 грн на OLX (26.10.2026) свои вентиляторы новичку и всем, кому нужен рабочий CUDA Arc Pro B70 32 ГБ GDDR6 $949 MSRP, ~$1 268 в августе, ~$2 000 в октябре н/д тем, кому нужны 32 ГБ в одной новой карте
Цена за гигабайт VRAM: P100, V620, RTX 3060 и B70 на 26.10.2026
Цена за гигабайт — честная мера для ИИ-сервера, потому что платите вы в первую очередь за объём памяти. Считали так: цену объявлений на OLX переводим в доллары по официальному курсу 45,5382 грн/$, установленному НБУ на 27.10.2026, потом делим на объём VRAM. Пример для P100: 8 500 грн ÷ 45,5382 = $186,7; $186,7 ÷ 16 ГБ = $11,7 за гигабайт.
| Карта | VRAM | Цена (источник, дата) | В долларах | $ за 1 ГБ |
|---|---|---|---|---|
| Radeon Pro V620 | 32 ГБ | ~$350, eBay best-offer (июль 2026, владелец карты) | 350 | ~10,9 |
| Tesla P100 | 16 ГБ | 8 500–9 499 грн, OLX (26.10.2026) | 187–209 | 11,7–13,0 |
| RTX 3060 12 ГБ | 12 ГБ | 9 899–16 000 грн, медиана 14 500, OLX (26.10.2026, 15 объявлений) | 217–351, медиана 318 | 18,1–29,3, медиана 26,5 |
| Arc Pro B70 | 32 ГБ | $949 MSRP (25.03.2026) | 949 | 29,7 |
| Arc Pro B70 | 32 ГБ | ~$1 268, минимальная среднедневная по трекеру GPU Poet (август 2026) | 1 268 | 39,6 |
| Arc Pro B70 | 32 ГБ | ~$2 000, остатки у перекупщиков на Amazon (24.10.2026) | 2 000 | 62,5 |
Минимальная видеокарта для LLM, на которой есть смысл строить сервер, — карта с 12 ГБ: в неё помещаются модели до 14B в Q4 (подробнее — в следующем разделе). Дальше решает цена каждого гигабайта: по ней V620 и P100 в 2,3–2,7 раза дешевле B70 по рекомендованной цене и в 3–3,6 раза — по августовской. Но у V620 цена подтверждена только одним владельцем и площадкой в США: в украинских магазинах и на OLX мы её не нашли (н/д), и в комментариях к тому же посту писали уже про $440 и выше. У P100 на OLX 26.10.2026 было всего три предложения, поэтому вилка ориентировочная.
Для сравнения: б/у RTX 3090 на 24 ГБ стоила в среднем $1 264 по 366 объявлениям на 17.08.2026, то есть около $52,7 за гигабайт. На этом фоне даже B70 за $1 268 выглядит дешевле, но у 3090 быстрее память и зрелый CUDA — к этому вернёмся в разделе про B70.
Что влезает в 12, 16 и 32 ГБ: модели, кванты и ток/с по замерам
Видеокарта для локальной LLM упирается в два числа. Объём памяти решает, запустится ли модель вообще. Пропускная способность памяти (сколько гигабайт в секунду карта прокачивает) решает, насколько быстро модель будет отвечать: генерация текста почти целиком упирается в эту скорость. Так это формулирует и автор теста 19 видеокарт на vc.ru, и InsiderLLM.Карта VRAM и шина Пропускная способность Потребление Интерфейс Архитектура Tesla P100 PCIe 16 ГБ HBM2 732 ГБ/с 250 Вт PCIe Gen3 Pascal, CC 6.0 Radeon Pro V620 32 ГБ GDDR6, 256 бит 512 ГБ/с 300 Вт, 2×8-pin PCIe 4.0 x16 RDNA 2, gfx1030 RTX 3060 12 ГБ 12 ГБ GDDR6, 192 бит 360 ГБ/с 170 Вт PCIe 4.0 Ampere Arc Pro B70 32 ГБ GDDR6, 256 бит 608 ГБ/с 230 Вт, 1×8-pin PCIe 5.0 x16 Battlemage
Три термина, без которых таблица не читается:
- Квант (квантование) — сжатие весов модели. Q4 означает примерно 4 бита на параметр: модель на 14 млрд параметров в Q4 занимает около 9 ГБ вместо почти 30 ГБ в 16 битах. Сколько памяти нужно под конкретную модель и контекст, удобно посчитать по нашей таблице видеопамяти под LLM.
- Ток/с (токенов в секунду) — скорость генерации. Токен — кусочек слова. Наш ориентир: 20 ток/с читаются комфортно, 40+ ощущаются почти мгновенными.
- Обработка промпта (prefill) — как быстро карта «прочитывает» ваш запрос или документ перед ответом. Важна для длинных текстов и RAG.
| Модель и квант | Карта | Генерация / промпт, ток/с | Бэкенд | Источник и дата |
|---|---|---|---|---|
| Qwen3 8B Q4_K_XL | RTX 3060 12 ГБ | 41,97 / н/д | llama.cpp, CUDA 12.8 | Hardware Corner, 09.12.2025 |
| Qwen3 14B Q4_K_XL | RTX 3060 12 ГБ | 22,66 / н/д (у PromptQuorum 9–12) | llama.cpp, CUDA 12.8 | Hardware Corner, 09.12.2025 |
| Llama 3.1 8B Q4 | Tesla P100 | 32,99 / н/д | Ollama 0.5.11 | Database Mart (хостер, сдаёт P100 в аренду), 21.10.2026 |
| Qwen2.5 14B Q4 | Tesla P100 | 19,45 / н/д | Ollama 0.5.11 | Database Mart (хостер, сдаёт P100 в аренду), 21.10.2026 |
| GPT-OSS 20B (MoE) | Radeon Pro V620 | 104 / 1 262 | llama.cpp Vulkan | владелец карты, 03.07.2026 |
| Qwen3.6 35B-A3B Q4 (MoE) | Radeon Pro V620 | 59,5 / 1 049 | llama.cpp Vulkan | владелец карты, 03.07.2026 |
| Qwen3.6 27B Q4 (плотная) | Radeon Pro V620 | 22 / 245 | llama.cpp Vulkan | владелец карты, 03.07.2026 |
| Qwen3.6 35B-A3B Q4 (MoE) | Arc Pro B70 | 54,7 / 615 при ~114 Вт | llama.cpp SYCL | репозиторий PMZFX через RunAIHome, 18.08.2026 |
| Qwen3.5 27B Q4 (плотная) | Arc Pro B70 | 22,47 SYCL; 13,43 vLLM; 11,87 Vulkan | разные | RunAIHome, 18.08.2026 |
Как читать эту таблицу:
- 12 ГБ (RTX 3060) — уверенно модели 7–8B и плотные 13–14B в Q4. 32B сюда не помещается без выгрузки части слоёв в оперативную память, а выгрузка роняет скорость в разы.
- 16 ГБ (P100) — те же 14B, но с запасом под длинный контекст. По замеру хостера, у 14B в Q4 файл весит около 9 ГБ.
- 32 ГБ (V620, B70, 2×P100) — плотные 27B в Q4 (на V620 пик около 17 ГиБ) и MoE-модели класса 35B-A3B (пик 24,1 ГиБ). Это главный аргумент за 32-гигабайтные карты.
Отдельно про MoE (Mixture of Experts, «смесь экспертов»). В такой модели на каждый токен работает только малая часть параметров: у Qwen3.6 35B-A3B активны около 3 млрд из 35 млрд. Поэтому старая V620 на MoE выдаёт 59,5 ток/с, а на плотной 27B — всего 22. Если вы планируете работать с MoE-моделями, дешёвая 32-гигабайтная карта даёт непропорционально много.
Цифры из разных источников сравнивайте осторожно: бэкенд, квант и длина контекста у всех разные. Для RTX 3060 расхождение особенно заметно: Hardware Corner на llama-bench даёт 22,66 ток/с на Qwen3 14B, PromptQuorum без описания методики — 9–12. Лабораторный замер ближе к потолку, второй — к тому, что увидите в Ollama с длинным контекстом.
Tesla P100: 16 ГБ за ~$200, но CUDA 12.x и пассивное охлаждение
Tesla P100 — серверный ускоритель NVIDIA 2016 года на архитектуре Pascal. Из того, чего нет в таблице выше: по даташиту у карты есть ECC (исправление ошибок памяти), а вентилятора нет вообще — охлаждение пассивное. Быстрая HBM2 на 732 ГБ/с — причина, по которой карта 2016 года до сих пор прилично генерирует текст на моделях до 14B.
На OLX 26.10.2026 P100 продавали за 9 499 грн и 8 500 грн (второй вариант — комплект с охлаждением), это $187–209. Там же был готовый сервер на четырёх P100 за 80 000 грн (~$1 757) и переходник под вентилятор за 130 грн.
Главная проблема P100 — не скорость, а возраст софта. Compute capability (CC) — это номер «поколения возможностей» GPU у NVIDIA, по нему библиотеки решают, поддерживать карту или нет. У P100 CC 6.0. И вот что из этого следует на конец октября 2026 года:
- CUDA 13 Pascal больше не поддерживает. В релиз-нотах CUDA 13.0 NVIDIA отмечает удаление поддержки Maxwell, Pascal и Volta — всех GPU до Turing — в библиотеках cuFFT и cuSPARSE, а компилятор CUDA 13.0 больше не собирает код под Pascal. Для P100 остаётся CUDA 12.x.
- Драйвер R580 — последняя ветка. NVIDIA объявила, что серия 580 станет последней с поддержкой Maxwell, Pascal и Volta; в Linux-ветке 590 их уже нет (Notebookcheck, KitGuru). Новых функций и оптимизаций для P100 больше не будет; по данным KitGuru (04.12.2025), Pascal переведён в режим поддержки, где выходят только ежеквартальные патчи критических уязвимостей.
- vLLM не запустится. vLLM — сервер для быстрой многопользовательской генерации; по документации он требует CC 7.5 или выше, а P100 — это 6.0.
- llama.cpp работает при сборке на CUDA 12.x. Владелец соседней Pascal-карты P40 описал этот путь: CUDA 12.9 плюс патч заголовков, потому что на дистрибутивах с glibc 2.41 и новее CUDA 12.9 без правки не собирается.
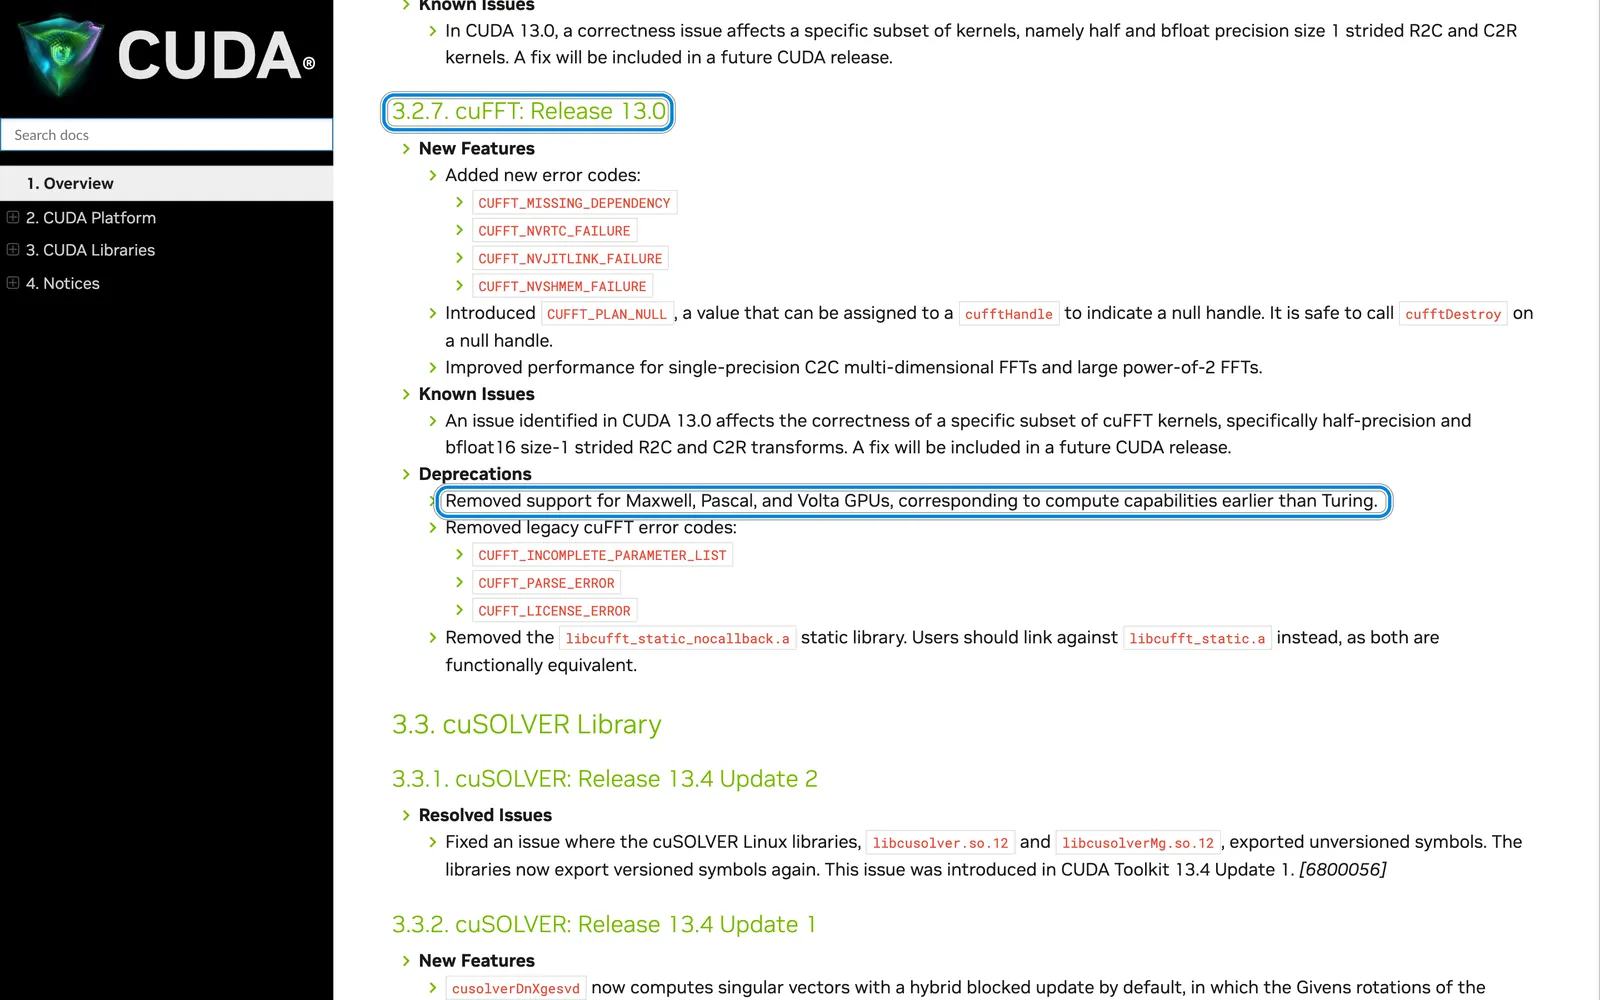
Скриншот релиз-нот CUDA Toolkit (снято 26.10.2026): в разделе cuFFT 13.0 рамкой выделена строка об удалении поддержки GPU до Turing — к ним относится и P100.
Ollama на P100 тоже работала: хостер Database Mart получил 32,99 ток/с на Llama 3.1 8B и 19,45 ток/с на Qwen2.5 14B. Две оговорки: компания сама сдаёт серверы с P100 в аренду (от $159 в месяц), то есть это замер заинтересованной стороны, и он сделан под Windows на Ollama 0.5.11 — версии начала 2025 года. Для новых версий проверяйте, на какой CUDA собран бинарник.
Стоит ли брать P100 в октябре 2026 года? Да, если вам нужен самый дешёвый вход в 16 ГБ, вы готовы сидеть на CUDA 12.x и llama.cpp и закрыть вопрос обдува. Нет, если хотите vLLM, свежие фреймворки или карту, которая просто работает в обычном корпусе.
Radeon Pro V620: 32 ГБ за ~$350, но ROCm только под Linux
Radeon Pro V620 — серверная карта AMD на архитектуре RDNA 2 для облачной графики. Основные цифры — в таблице выше; добавим, что по данным AMD у карты есть ECC, а охлаждение пассивное.
ROCm — открытый вычислительный стек AMD, аналог CUDA. Подробно о том, где Radeon догнал GeForce в нейросетях, мы разбирали в материале ROCm против CUDA. Для V620 важна одна деталь: в матрице совместимости ROCm версии 10.1.0 (страница от 26.08.2026) карта (gfx1030) поддерживается только под Linux — Ubuntu 22.04.5, 24.04.5 и 26.04.1; в селекторе ОС для неё есть ещё RHEL (таблица показывает RHEL 9.8 и 10.2), а вариантов Windows и WSL2 нет. В ветке ROCm 7.14 список был ещё уже: только Ubuntu 24.04.4 и 22.04.5.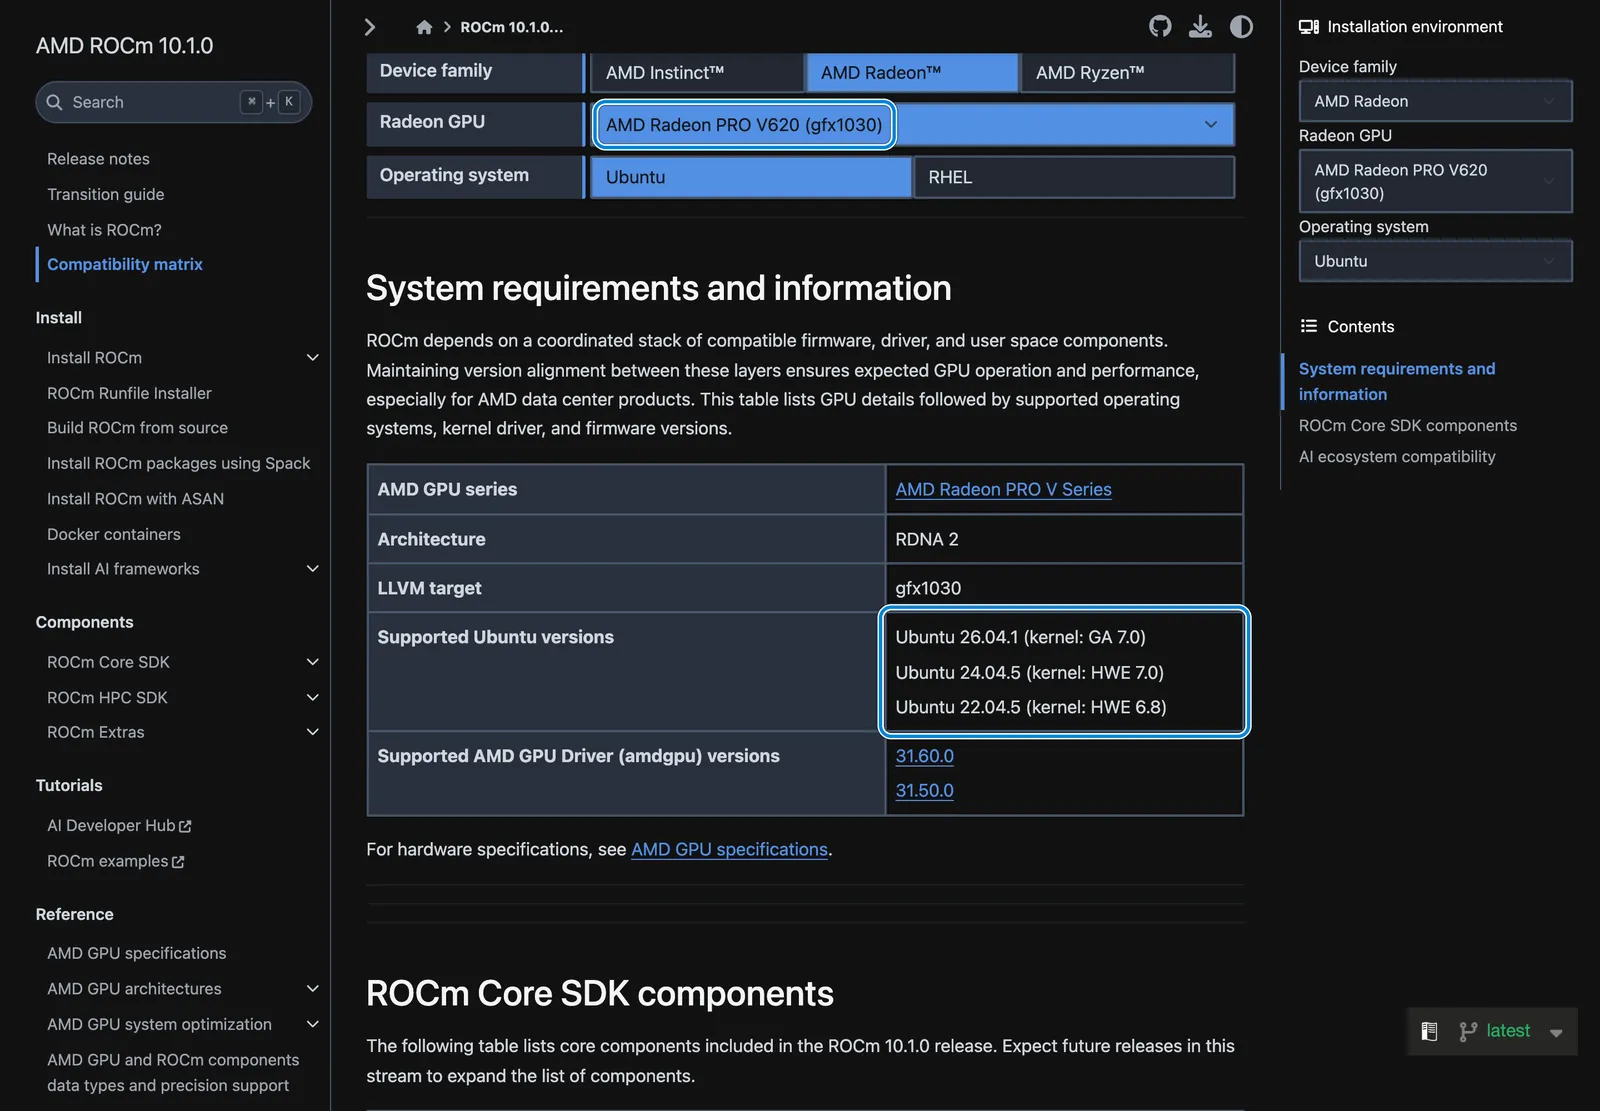
Скриншот матрицы ROCm 10.1.0 (снято 26.10.2026): выбрана Radeon PRO V620 (gfx1030), рамкой выделены поддерживаемые Ubuntu; в строке «Operating system» доступны только Ubuntu и RHEL.
ROCm при этом не обязателен. Владелец V620, опубликовавший замеры 03.07.2026, запускал llama.cpp через Vulkan — универсальный графический API, который работает и без ROCm. Его результаты: 104 ток/с на GPT-OSS 20B, 59,5 ток/с на MoE Qwen3.6 35B-A3B и 22 ток/с на плотной Qwen3.6 27B. Обработка промпта на плотной модели медленная — 245 ток/с, потому что старое ядро RDNA 2 слабее по вычислениям.
Что ещё знать по его опыту:
- под нагрузкой карта брала в среднем 197–233 Вт;
- в BIOS нужно включить Above 4G Decoding и Resizable BAR (режимы, позволяющие процессору видеть всю память карты), иначе она не заведётся;
- поддержку Windows он назвал ненадёжной;
- вентилятора нет, нужен шроуд — кожух-переходник под внешний вентилятор.
V620 — самый дешёвый способ получить 32 ГБ одной картой, если вы её найдёте. В Украине предложений мы не видели, а покупка на eBay добавляет доставку и растаможку.
RTX 3060 12 ГБ: медленнее, зато с рабочим CUDA-стеком
RTX 3060 для нейросетей берут не за скорость, а за то, что всё работает сразу. По данным NVIDIA у версии на 12 ГБ память GDDR6 на 192-битной шине и потребление 170 Вт. Пропускную способность NVIDIA не указывает; из частоты памяти и ширины шины выходит 360 ГБ/с — вдвое ниже, чем у P100; это обычная игровая карта с вентиляторами, она встаёт в любой корпус. Осторожно с версией на 8 ГБ и 128-битной шиной: для ИИ она заметно хуже, проверяйте объём в объявлении.
На OLX 26.10.2026 было 15 объявлений с ценой: от 9 899 до 16 000 грн, медиана 14 500 грн (~$318). В США б/у карту, по данным PromptQuorum на 01.09.2026, продают за $270–300 — порядок цен совпадает.
По замерам Hardware Corner на llama.cpp с CUDA 12.8 карта выдаёт 41,97 ток/с на Qwen3 8B и 22,66 ток/с на Qwen3 14B в 4-битном кванте при контексте 16 тыс. токенов. Этого хватает для чат-ассистента и помощника в коде на моделях до 14B. Если хотите выжать из одной карты больше, полезно сравнить оболочки: в нашем разборе Ollama, LM Studio и llama.cpp на одной модели по чужим замерам видно: при одинаковом кванте оболочки расходятся на 0,3–10%, а разрывы до трёх раз почти всегда дают разные кванты и настройки выгрузки.
Зачем три штуки? Чтобы получить 36 ГБ и запускать модели, которые в 12 ГБ не помещаются. llama.cpp умеет делить модель по слоям между картами: каждая хранит свою часть. Но есть оговорки:
- Память складывается не полностью. На каждой карте нужен свой буфер под вычисления и часть контекста, поэтому полезный объём меньше 36 ГБ.
- Скорость не утраивается. При делении по слоям карты обрабатывают токен по очереди, и генерация идёт примерно со скоростью одной карты на этом объёме. Сторонних замеров именно для трёх RTX 3060 мы не нашли (н/д), поэтому цифр не обещаем.
- Линии PCIe. На обычной материнской плате третья карта часто попадает на линии чипсета x4 или на райзер. Для генерации это терпимо, а загрузка модели идёт дольше. Например, автор обсуждаемой сборки 3×3060 на r/LocalAIServers поставил карты на серверный Xeon Platinum, где линий хватает.
Arc Pro B70: почему 32 ГБ за $949 стали $1 268 и что с софтом Intel
Arc Pro B70 — профессиональная карта Intel на архитектуре Battlemage, анонсированная 25.03.2026 по цене $949. Характеристики — в таблице выше, по данным InsiderLLM, ComputingForGeeks и RunAIHome; у партнёрских версий потребление разнится от 160 до 290 Вт.
Цена — главная причина, почему B70 не попадает в бюджетный класс. По трекеру GPU Poet, который цитирует RunAIHome, в августе 2026 года минимальная среднедневная цена была $1 268 при разбросе $1 048–1 471. ComputingForGeeks на 24.10.2026 пишет, что на Amazon остались только перекупщики примерно по $2 000. Это на 34–111% выше рекомендованной цены.
Arc Pro B70 для LLM хороша на MoE-моделях и экономна: 54,7 ток/с на Qwen3.6 35B-A3B при потреблении около 114 Вт. На плотных моделях картина хуже. На Qwen3.5 27B карта даёт 22,47 ток/с только после сборки llama.cpp с SYCL (вычислительный слой Intel на базе oneAPI) и тонкой настройки, 13,43 ток/с в vLLM и 11,87 ток/с через Vulkan в LM Studio.
Софт — вторая ловушка, и про неё стоит знать до покупки:
- Обычный Ollama на Arc считает на процессоре и не предупреждает об этом. Рабочие пути — llama.cpp с SYCL (основной) или сборка Ollama от Intel (IPEX-LLM Ollama Portable Zip). Учтите: репозиторий IPEX-LLM Intel перевела в архив 28.01.2026 и больше не развивает, так что свежие модели эта сборка может не поддерживать. Тот же нюанс мы подробно описывали в разборе бюджетной сборки на Intel Arc B580.
- Баг llama.cpp #21893. В апреле 2026 года на SYCL-сборках Battlemage некоторые модели выдавали бессвязный текст; обход — переменная
GGML_SYCL_DISABLE_OPT=1. 04.05.2026 автор закрыл баг, но если на старой сборке вместо ответа идёт мусор — начните с этой переменной. - vLLM работает через форк Intel LLM-Scaler, но ComputingForGeeks называет его уровнем беты.
- Документация llama.cpp SYCL в списке проверенных карт Arc B-Series называет только B580; B70 работает по отчётам сообщества.
При одинаковых деньгах выбор упирается в ваши модели. RunAIHome сформулировал это так: $1 264 за б/у RTX 3090 против $1 268 за новую B70 — берите 3090, если модели помещаются в 24 ГБ, и B70, если нет. Если смотрите в сторону 3090, у нас есть разбор сборки на двух RTX 3090 на 48 ГБ.
Три сборки домашнего ИИ-сервера: карты, ватты и итог по цене
Ниже три способа получить 32–36 ГБ видеопамяти — объём, в который помещаются плотные 27B и MoE класса 35B-A3B. Цены — только за видеокарты, на 26.10.2026 (OLX и курс НБУ) или на дату, указанную в ячейке. Платформу (процессор, плату, память) мы не считаем: б/у серверный Xeon и новая AM5 отличаются по цене в разы, а у многих базовый ПК уже есть.Параметр A: 2×Tesla P100 B: 3×RTX 3060 12 ГБ C1: 1×Radeon Pro V620 C2: 1×Arc Pro B70 VRAM 32 ГБ 36 ГБ 32 ГБ 32 ГБ Цена карт 17 000–19 000 грн (~$373–417) 29 700–48 000 грн (~$652–1 054), по медиане 43 500 грн (~$955) ~$350 (~15 900 грн), eBay, июль 2026; в Украине н/д $949 (~43 200 грн) MSRP; ~$1 268 (~57 700 грн) в августе 2026 TDP карт 500 Вт 510 Вт 300 Вт 230 Вт Блок питания (наша оценка) от 850 Вт 850–1 000 Вт от 650 Вт от 550 Вт Софт CUDA 12.x, llama.cpp; без vLLM CUDA, Ollama, llama.cpp, vLLM Vulkan или ROCm только Linux SYCL или Vulkan, vLLM — бета Охлаждение пассивное, нужен обдув свои вентиляторы пассивное, нужен шроуд н/д Главный минус софт заморожен на CUDA 12.x и R580 три карты, линии PCIe, скорость одной карты цену и наличие в Украине не подтвердить цена выше MSRP на 34–111%
Блок питания оценивали по простой формуле: сумма TDP карт плюс ~150 Вт на процессор и остальное, и сверху запас 30%. Для сборки A: (500 + 150) × 1,3 ≈ 845 Вт, значит, берём от 850 Вт. Для V620 учтите два 8-pin разъёма на карту, для B70 — один.
Если нужна видеокарта для домашней нейросети с минимумом возни, выбирайте сборку B: она дороже, зато каждый инструмент из инструкций в интернете запустится. Сборка A — самый дешёвый способ получить 32 ГБ с CUDA, но только для llama.cpp. Сборка C1 даёт 32 ГБ одной картой дешевле всех, если найдёте карту по $350. C2 оправдана только при цене около рекомендованной.
Апгрейд-путь у всех разный. У сборки B следующий шаг — замена 3060 на 24-гигабайтные карты. У A — переход на карты с CC 7.5+, чтобы открыть vLLM и CUDA 13. У C1 — вторая V620 на 64 ГБ, если плата и блок питания это выдержат.
Шум, охлаждение и питание пассивных серверных карт дома
Пассивная серверная карта — это радиатор без вентилятора. В сервере её продувает поток воздуха от мощных вентиляторов корпуса. В домашнем корпусе такого потока нет, и P100 на 250 Вт или V620 на 300 Вт без доработки быстро перегреется и сбросит частоты.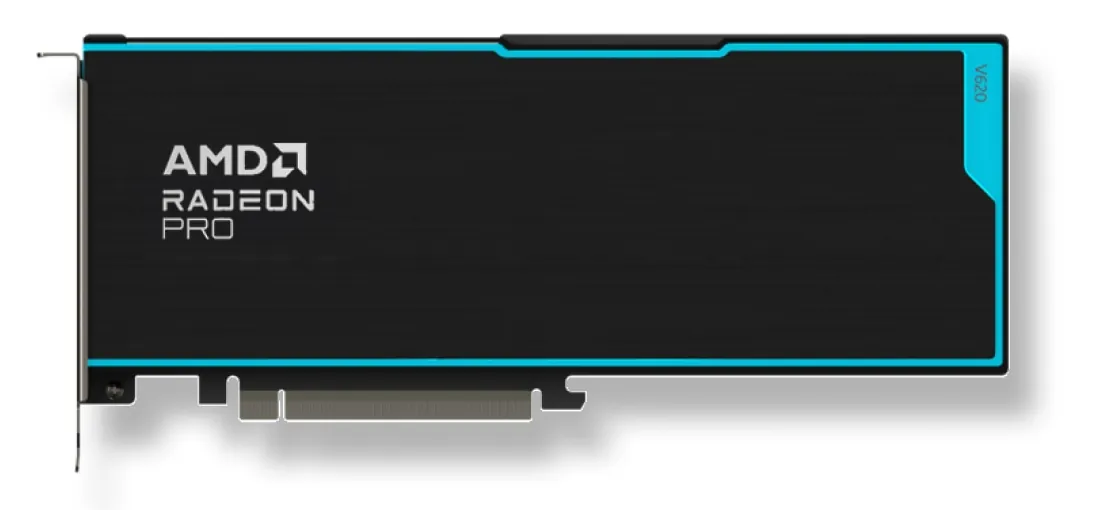
Фото: AMD. На карте нет вентилятора — только кожух радиатора, воздух должен идти через него снаружи.
Как это решают на практике:
- Шроуд с вентилятором. На торец карты ставят кожух-переходник (часто напечатанный на 3D-принтере) и вентилятор-улитку (блоуэр) или мощный 40–92 мм. На OLX такие переходники для P100 продают от 130 грн, встречаются и готовые комплекты «карта + охлаждение».
- Готовый сервер. Корпус с серверными вентиляторами решает вопрос охлаждения, но шумит заметно сильнее домашнего ПК. Для комнаты, где вы спите, это плохой вариант.
- Ограничение мощности. Один из комментаторов под постом про V620 держит карту на 160 Вт и оценивает потерю скорости примерно в 10%. Это мнение пользователя, а не замер, но способ снизить нагрев и шум рабочий.
- Расстояние между картами. Две-три карты вплотную греют друг друга; оставляйте хотя бы один свободный слот или ставьте райзеры.
Сколько децибел даёт каждая схема, сказать нельзя: сопоставимых замеров шума для этих карт в домашних условиях мы не нашли (н/д). Ориентир один — чем меньше вентилятор и чем выше его обороты, тем громче. Карта с собственными вентиляторами, как RTX 3060, в этом смысле проще всего.
С питанием главное — не экономить на блоке. Пиковое потребление серверных карт может кратковременно превышать среднее, а дешёвый блок на пределе — частая причина перезагрузок под нагрузкой.
Как проверить б/у серверную карту перед покупкой на OLX
Серверные карты часто приходят после нескольких лет работы в дата-центре или майнинге, поэтому проверка обязательна. Общий порядок для любой видеокарты расписан в нашем гайде как проверить б/у видеокарту перед покупкой. Для P100 и V620 добавьте несколько пунктов:
- Попросите скриншот под нагрузкой. Для NVIDIA —
nvidia-smiс моделью, объёмом памяти и температурой во время теста; для AMD —rocm-smiили аналог. Карта без кадра работы — повод для торга или отказа. - Проверьте всю память. Загрузите модель, которая занимает почти весь объём VRAM, и дайте ей поработать 15–30 минут. Артефакты, вылеты или бессвязный текст на заведомо рабочей модели — признак проблем с памятью.
- Посмотрите счётчики ECC. У P100 и V620 есть исправление ошибок памяти. У NVIDIA счётчики показывает
nvidia-smi -q -d ECC; растущее число исправленных ошибок — тревожный знак. - Осмотрите разъёмы. Контакты PCIe без потемнений и сколов, разъёмы питания не оплавлены, на месте планка крепления.
- Уточните комплект охлаждения. Пассивная карта без шроуда — это дополнительные траты и время; заложите их в цену сразу.
- Сделка с осмотром. Оплата при получении с проверкой на почте и тест в течение нескольких дней — разумный минимум для карты за 8–16 тыс. грн.
Риски бюджетной сборки: мёртвый софт-стек, износ и цена-ловушка
У каждой из четырёх карт свой главный риск, и он не всегда очевиден по цене:
- P100: софт больше не развивается. Сегодня llama.cpp на CUDA 12.x работает, но каждый следующий год новые модели и форматы будут чаще приходить без поддержки старых карт.
- V620: узкий круг ОС и ручная настройка. ROCm 10.1.0 поддерживает карту только на нескольких версиях Ubuntu и RHEL; Vulkan — запасной путь. Цена ~$350 подтверждена одним владельцем, а в Украине предложений нет.
- RTX 3060: износ и ограничение по объёму. Это массовая игровая карта, часть экземпляров прошла майнинг. 12 ГБ на одну карту — жёсткий потолок, а три карты дают объём, но не скорость.
- Arc Pro B70: цена-ловушка и молодой софт. В августе 2026 года карта стоила на 34% дороже рекомендованной цены, а на 24.10.2026 у перекупщиков на Amazon — на 111%. Ollama без сборки Intel не использует GPU, а сама эта сборка с января 2026 года в архиве; vLLM — в бете.
- Общий риск — гарантия. На б/у серверную карту с OLX её почти никогда нет, а у новой B70 по завышенной цене от перекупщика гарантия зависит от продавца.
Сводно по софту на 26.10.2026 — что запускается на каждой карте без обходных путей:Инструмент Tesla P100 Radeon Pro V620 RTX 3060 12 ГБ Arc Pro B70 CUDA только 12.x — да, включая 13 — ROCm — Linux: Ubuntu и RHEL — — SYCL (oneAPI) — — — да, нужна своя сборка Vulkan в llama.cpp н/д да (замеры владельца) да да, ~45% скорости SYCL llama.cpp да, на CUDA 12.x да, Vulkan или ROCm да да, SYCL или Vulkan Ollama старые версии (замер на 0.5.11) н/д да только архивная сборка Intel IPEX-LLM vLLM нет (нужна CC 7.5+) н/д да бета через LLM-Scaler
Первыми в этой статье устареют цены: B70 и б/у карт на OLX меняются за недели. Перед покупкой проверьте свежие объявления и курс НБУ, а совместимость V620 — по актуальной матрице ROCm.
Когда бюджетная сборка — неверный выбор? Если вам нужна скорость на плотных моделях 24–32B для ежедневной работы, разумнее одна б/у RTX 3090 на 24 ГБ или новая 32-гигабайтная карта класса Radeon AI Pro R9700. Они дороже, но избавляют от компромиссов, описанных выше.
FAQ
Стоит ли покупать Tesla P100 для нейросетей?
Стоит, если вы хотите самый дешёвый вход в 16 ГБ: на OLX 26.10.2026 карта стоила 8 500–9 499 грн. Но софт на ней заморожен: CUDA 13 Pascal уже не поддерживает, а драйвер R580 — последняя ветка. Работать придётся в llama.cpp на CUDA 12.x и решать вопрос обдува пассивного радиатора.
Какая самая дешёвая видеокарта для LLM?
По цене гигабайта на конец октября 2026 года дешевле всех Radeon Pro V620 (~$10,9 за ГБ при цене ~$350 на eBay) и Tesla P100 ($11,7–13,0 за ГБ на OLX). Из карт, которые просто работают в обычном ПК с полным CUDA, самая доступная — б/у RTX 3060 12 ГБ от 9 899 грн. Карты с 8 ГБ для LLM брать не стоит.
Можно ли собрать ИИ-сервер на трёх RTX 3060 и сложится ли память в 36 ГБ?
Собрать можно: llama.cpp делит модель по слоям между картами, и вместе они вмещают модели, которым мало 12 ГБ. Но полезный объём будет меньше 36 ГБ — каждой карте нужен свой буфер, — а скорость генерации останется примерно на уровне одной карты. Сторонних замеров для трёх 3060 мы не нашли, так что точную скорость заранее не предскажет никто.
Подойдёт ли Intel Arc Pro B70 для LLM и чем её запускать?
Подойдёт, особенно для MoE-моделей: 54,7 ток/с на Qwen3.6 35B-A3B при ~114 Вт по данным RunAIHome. Запускать лучше через llama.cpp с SYCL; сборка Ollama от Intel (IPEX-LLM) тоже работает, но с 28.01.2026 её репозиторий в архиве, а обычный Ollama считает на процессоре. Главный минус — цена: около $1 268 в августе и до $2 000 в октябре 2026 года вместо $949.
Работают ли vLLM и Ollama на P100?
vLLM — нет: по документации ему нужна compute capability 7.5 или выше, а у P100 6.0. Ollama на P100 работала в замере хостера Database Mart (19,45 ток/с на Qwen2.5 14B), но на версии 0.5.11. Новые сборки проверяйте отдельно: после перехода экосистемы на CUDA 13 поддержка Pascal может пропасть. Надёжный путь — llama.cpp на CUDA 12.x.
Можно ли поставить пассивную P100 или V620 в обычный ПК?
Можно, но только с доработкой охлаждения. У этих карт нет вентилятора, и в домашнем корпусе без направленного потока воздуха они быстро перегреваются. Нужен шроуд с вентилятором-улиткой на торце карты, блок питания с запасом и включённые в BIOS Above 4G Decoding и Resizable BAR. Для V620 добавьте два 8-pin разъёма питания и Linux.