
Коротко (TL;DR)
Бюджетна відеокарта для LLM у 2026 році — це не одна модель, а вибір, чим ви готові платити: грошима, софтом чи шумом. Ми порівняли чотири карти, довкола яких зараз будують домашні ШІ-сервери: NVIDIA Tesla P100, AMD Radeon Pro V620, NVIDIA RTX 3060 12 ГБ та Intel Arc Pro B70.
- Коротко (TL;DR)
- Яка бюджетна GPU для ШІ-сервера: вердикт щодо чотирьох карт
- Ціна за гігабайт VRAM: P100, V620, RTX 3060 і B70 на 26.10.2026
- Що вміщується у 12, 16 і 32 ГБ: моделі, кванти й ток/с за замірами
- Tesla P100: 16 ГБ за ~$200, але CUDA 12.x і пасивне охолодження
- Radeon Pro V620: 32 ГБ за ~$350, але ROCm лише під Linux
- RTX 3060 12 ГБ: повільніша, зате з робочим CUDA-стеком
- Arc Pro B70: чому 32 ГБ за $949 стали $1 268 і що із софтом Intel
- Три збірки домашнього ШІ-сервера: карти, вати й підсумок за ціною
- Шум, охолодження та живлення пасивних серверних карт удома
- Як перевірити вживану серверну карту перед купівлею на OLX
- Ризики бюджетної збірки: мертвий софт-стек, знос і ціна-пастка
- Часті запитання
- Найдешевші гігабайти — у серверних P100 (16 ГБ) і V620 (32 ГБ): близько $11–13 за гігабайт відеопам’яті наприкінці жовтня 2026 року. Платите за це застарілим софтом і пасивним охолодженням, яке доведеться допрацьовувати самому.
- RTX 3060 12 ГБ удвічі дорожча за гігабайт (на OLX 26.10.2026 медіана 14 500 грн), зате це єдина карта з четвірки з повним і живим стеком CUDA: Ollama, llama.cpp і vLLM працюють без обхідних шляхів.
- Arc Pro B70 уже не бюджетна: рекомендовані $949 за 32 ГБ перетворилися на $1 268 у серпні й близько $2 000 у перекупників наприкінці жовтня 2026 року. За ціною гігабайта це найгірша карта порівняння.
- 32–36 ГБ удома реально зібрати трьома шляхами: 2×P100, 3×RTX 3060 або одна 32-гігабайтна карта. Далі — ціна кожного гігабайта в гривнях, що вміщується у 12, 16 і 32 ГБ, три збірки з ватами й чек-лист купівлі вживаної карти на OLX.
Яка бюджетна GPU для ШІ-сервера: вердикт щодо чотирьох карт
Якщо коротко відповідати на питання «з яких недорогих відеокарт зібрати домашній ШІ-сервер», то для більшості це вживана RTX 3060 12 ГБ — одна для старту або дві-три для об’єму. Серверні P100 і V620 дешевші за гігабайт, але пасують тим, хто готовий морочитися з Linux, обдувом і старими версіями бібліотек. Arc Pro B70 має сенс лише за ціни, близької до рекомендованої, і лише якщо вам потрібні саме 32 ГБ в одній карті.
Головний орієнтир під час вибору — обсяг відеопам’яті (VRAM, пам’ять на самій карті): саме він вирішує, чи вміститься модель повністю. Докладно про вибір за обсягом пам’яті ми писали в розборі вибору відеокарти для локального ШІ. Тут фокус на нижній ціновій межі.Карта VRAM Ціна наприкінці жовтня 2026 Охолодження Кому пасує Tesla P100 16 ГБ HBM2 8 500–9 499 грн на OLX (26.10.2026) пасивне експериментатору з Linux, кому важлива ціна Radeon Pro V620 32 ГБ GDDR6 ~$350 на eBay (липень 2026, за словами власника) пасивне тим, хто запускає MoE-моделі й не боїться Vulkan/ROCm RTX 3060 12 ГБ 12 ГБ GDDR6 9 899–16 000 грн на OLX (26.10.2026) власні вентилятори новачкові та всім, кому потрібна робоча CUDA Arc Pro B70 32 ГБ GDDR6 $949 MSRP, ~$1 268 у серпні, ~$2 000 у жовтні н/д тим, кому потрібні 32 ГБ в одній новій карті
Ціна за гігабайт VRAM: P100, V620, RTX 3060 і B70 на 26.10.2026
Ціна за гігабайт — чесна міра для ШІ-сервера, бо платите ви насамперед за обсяг пам’яті. Рахували так: ціну оголошень на OLX переводимо в долари за офіційним курсом 45,5382 грн/$, встановленим НБУ на 27.10.2026, потім ділимо на обсяг VRAM. Приклад для P100: 8 500 грн ÷ 45,5382 = $186,7; $186,7 ÷ 16 ГБ = $11,7 за гігабайт.
| Карта | VRAM | Ціна (джерело, дата) | У доларах | $ за 1 ГБ |
|---|---|---|---|---|
| Radeon Pro V620 | 32 ГБ | ~$350, eBay best-offer (липень 2026, власник карти) | 350 | ~10,9 |
| Tesla P100 | 16 ГБ | 8 500–9 499 грн, OLX (26.10.2026) | 187–209 | 11,7–13,0 |
| RTX 3060 12 ГБ | 12 ГБ | 9 899–16 000 грн, медіана 14 500, OLX (26.10.2026, 15 оголошень) | 217–351, медіана 318 | 18,1–29,3, медіана 26,5 |
| Arc Pro B70 | 32 ГБ | $949 MSRP (25.03.2026) | 949 | 29,7 |
| Arc Pro B70 | 32 ГБ | ~$1 268, мінімальна середньоденна за трекером GPU Poet (серпень 2026) | 1 268 | 39,6 |
| Arc Pro B70 | 32 ГБ | ~$2 000, залишки в перекупників на Amazon (24.10.2026) | 2 000 | 62,5 |
Мінімальна відеокарта для LLM, на якій є сенс будувати сервер, — карта з 12 ГБ: у неї вміщуються моделі до 14B у Q4 (докладніше — у наступному розділі). Далі вирішує ціна кожного гігабайта: за нею V620 і P100 у 2,3–2,7 раза дешевші за B70 за рекомендованою ціною і в 3–3,6 раза — за серпневою. Але ціну V620 підтверджує лише один власник і майданчик у США: в українських магазинах і на OLX ми її не знайшли (н/д), а в коментарях до того самого допису писали вже про $440 і більше. P100 на OLX 26.10.2026 мала лише три пропозиції, тож діапазон орієнтовний.
Для порівняння: вживана RTX 3090 на 24 ГБ коштувала в середньому $1 264 за 366 оголошеннями на 17.08.2026, тобто близько $52,7 за гігабайт. На цьому тлі навіть B70 за $1 268 виглядає дешевшою, але в 3090 швидша пам’ять і зріла CUDA — до цього повернемося в розділі про B70.
Що вміщується у 12, 16 і 32 ГБ: моделі, кванти й ток/с за замірами
Відеокарта для локальної LLM упирається у два числа. Обсяг пам’яті вирішує, чи запуститься модель узагалі. Пропускна здатність пам’яті (скільки гігабайтів за секунду карта прокачує) вирішує, наскільки швидко модель відповідатиме: генерація тексту майже повністю впирається в цю швидкість. Так це формулюють і автор тесту 19 відеокарт на vc.ru, і InsiderLLM.Карта VRAM і шина Пропускна здатність Споживання Інтерфейс Архітектура Tesla P100 PCIe 16 ГБ HBM2 732 ГБ/с 250 Вт PCIe Gen3 Pascal, CC 6.0 Radeon Pro V620 32 ГБ GDDR6, 256 біт 512 ГБ/с 300 Вт, 2×8-pin PCIe 4.0 x16 RDNA 2, gfx1030 RTX 3060 12 ГБ 12 ГБ GDDR6, 192 біт 360 ГБ/с 170 Вт PCIe 4.0 Ampere Arc Pro B70 32 ГБ GDDR6, 256 біт 608 ГБ/с 230 Вт, 1×8-pin PCIe 5.0 x16 Battlemage
Три терміни, без яких таблицю не прочитати:
- Квант (квантування) — стиснення ваг моделі. Q4 означає приблизно 4 біти на параметр: модель на 14 млрд параметрів у Q4 займає близько 9 ГБ замість майже 30 ГБ у 16 бітах. Скільки пам’яті потрібно під конкретну модель і контекст, зручно порахувати за нашою таблицею відеопам’яті під LLM.
- Ток/с (токенів за секунду) — швидкість генерації. Токен — шматочок слова. Наш орієнтир: 20 ток/с читаються комфортно, 40+ сприймаються майже миттєвими.
- Обробка промпту (prefill) — як швидко карта «прочитує» ваш запит чи документ перед відповіддю. Важлива для довгих текстів і RAG.
| Модель і квант | Карта | Генерація / промпт, ток/с | Бекенд | Джерело й дата |
|---|---|---|---|---|
| Qwen3 8B Q4_K_XL | RTX 3060 12 ГБ | 41,97 / н/д | llama.cpp, CUDA 12.8 | Hardware Corner, 09.12.2025 |
| Qwen3 14B Q4_K_XL | RTX 3060 12 ГБ | 22,66 / н/д (у PromptQuorum 9–12) | llama.cpp, CUDA 12.8 | Hardware Corner, 09.12.2025 |
| Llama 3.1 8B Q4 | Tesla P100 | 32,99 / н/д | Ollama 0.5.11 | Database Mart (хостер, здає P100 в оренду), 21.10.2026 |
| Qwen2.5 14B Q4 | Tesla P100 | 19,45 / н/д | Ollama 0.5.11 | Database Mart (хостер, здає P100 в оренду), 21.10.2026 |
| GPT-OSS 20B (MoE) | Radeon Pro V620 | 104 / 1 262 | llama.cpp Vulkan | власник карти, 03.07.2026 |
| Qwen3.6 35B-A3B Q4 (MoE) | Radeon Pro V620 | 59,5 / 1 049 | llama.cpp Vulkan | власник карти, 03.07.2026 |
| Qwen3.6 27B Q4 (щільна) | Radeon Pro V620 | 22 / 245 | llama.cpp Vulkan | власник карти, 03.07.2026 |
| Qwen3.6 35B-A3B Q4 (MoE) | Arc Pro B70 | 54,7 / 615 за ~114 Вт | llama.cpp SYCL | репозиторій PMZFX через RunAIHome, 18.08.2026 |
| Qwen3.5 27B Q4 (щільна) | Arc Pro B70 | 22,47 SYCL; 13,43 vLLM; 11,87 Vulkan | різні | RunAIHome, 18.08.2026 |
Як читати цю таблицю:
- 12 ГБ (RTX 3060) — упевнено моделі 7–8B і щільні 13–14B у Q4. 32B сюди не вміщується без вивантаження частини шарів в оперативну пам’ять, а вивантаження знижує швидкість у рази.
- 16 ГБ (P100) — ті самі 14B, але із запасом під довгий контекст. За заміром хостера, файл 14B у Q4 важить близько 9 ГБ.
- 32 ГБ (V620, B70, 2×P100) — щільні 27B у Q4 (на V620 пік близько 17 ГіБ) і MoE-моделі класу 35B-A3B (пік 24,1 ГіБ). Це головний аргумент на користь 32-гігабайтних карт.
Окремо про MoE (Mixture of Experts, «суміш експертів»). У такій моделі на кожен токен працює лише мала частина параметрів: у Qwen3.6 35B-A3B активні близько 3 млрд із 35 млрд. Тому стара V620 на MoE видає 59,5 ток/с, а на щільній 27B — лише 22. Якщо ви плануєте працювати з MoE-моделями, дешева 32-гігабайтна карта дає непропорційно багато.
Цифри з різних джерел порівнюйте обережно: бекенд, квант і довжина контексту в усіх різні. Для RTX 3060 розбіжність особливо помітна: Hardware Corner на llama-bench дає 22,66 ток/с на Qwen3 14B, PromptQuorum без опису методики — 9–12. Лабораторний замір ближчий до стелі, другий — до того, що побачите в Ollama з довгим контекстом.
Tesla P100: 16 ГБ за ~$200, але CUDA 12.x і пасивне охолодження
Tesla P100 — серверний прискорювач NVIDIA 2016 року на архітектурі Pascal. Чого немає в таблиці вище: за специфікацією карта має ECC (виправлення помилок пам’яті), а вентилятора немає взагалі — охолодження пасивне. Швидка HBM2 на 732 ГБ/с — причина, з якої карта 2016 року досі пристойно генерує текст на моделях до 14B.
На OLX 26.10.2026 P100 продавали за 9 499 грн і 8 500 грн (другий варіант — комплект з охолодженням), це $187–209. Там само був готовий сервер на чотирьох P100 за 80 000 грн (~$1 757) і перехідник під вентилятор за 130 грн.
Головна проблема P100 — не швидкість, а вік софту. Compute capability (CC) — це номер «покоління можливостей» GPU в NVIDIA, за ним бібліотеки вирішують, підтримувати карту чи ні. У P100 CC 6.0. І ось що з цього випливає наприкінці жовтня 2026 року:
- CUDA 13 Pascal більше не підтримує. У примітках до випуску CUDA 13.0 NVIDIA зазначає вилучення підтримки Maxwell, Pascal і Volta — усіх GPU до Turing — у бібліотеках cuFFT і cuSPARSE, а компілятор CUDA 13.0 більше не збирає код під Pascal. Для P100 лишається CUDA 12.x.
- Драйвер R580 — остання гілка. NVIDIA оголосила, що серія 580 стане останньою з підтримкою Maxwell, Pascal і Volta; у Linux-гілці 590 їх уже немає (Notebookcheck, KitGuru). Нових функцій і оптимізацій для P100 більше не буде; за даними KitGuru (04.12.2025), Pascal переведено в режим підтримки, де виходять лише щоквартальні патчі критичних вразливостей.
- vLLM не запуститься. vLLM — сервер для швидкої генерації на багатьох користувачів; за документацією він вимагає CC 7.5 або вище, а P100 — це 6.0.
- llama.cpp працює зі збиранням на CUDA 12.x. Власник сусідньої Pascal-карти P40 описав цей шлях: CUDA 12.9 плюс патч заголовків, бо на дистрибутивах з glibc 2.41 і новіше CUDA 12.9 без правки не збирається.
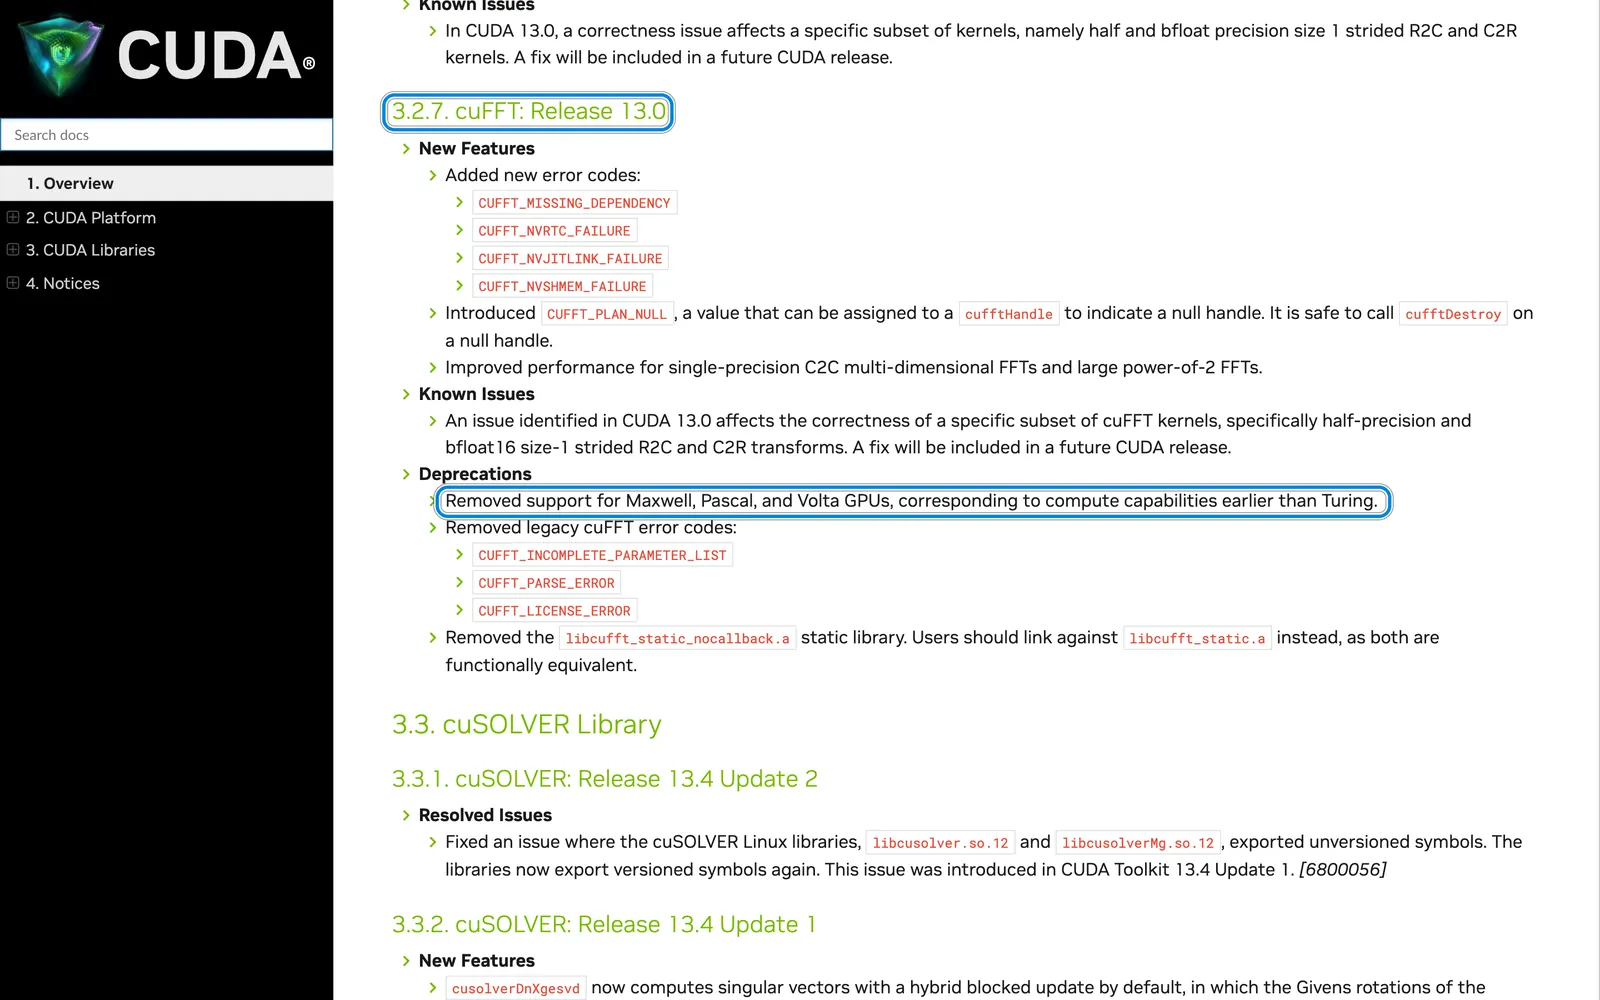
Скриншот приміток до випуску CUDA Toolkit (знято 26.10.2026): у розділі cuFFT 13.0 рамкою виділено рядок про вилучення підтримки GPU до Turing — до них належить і P100.
Ollama на P100 теж працювала: хостер Database Mart отримав 32,99 ток/с на Llama 3.1 8B і 19,45 ток/с на Qwen2.5 14B. Два застереження: компанія сама здає сервери з P100 в оренду (від $159 на місяць), тобто це замір зацікавленої сторони, і його зроблено під Windows на Ollama 0.5.11 — версії початку 2025 року. Для нових версій перевіряйте, на якій CUDA зібрано бінарник.
Чи брати P100 у жовтні 2026 року? Так, якщо вам потрібен найдешевший вхід у 16 ГБ, ви готові сидіти на CUDA 12.x і llama.cpp та розв’язати питання обдуву. Ні, якщо хочете vLLM, свіжі фреймворки чи карту, яка просто працює у звичайному корпусі.
Radeon Pro V620: 32 ГБ за ~$350, але ROCm лише під Linux
Radeon Pro V620 — серверна карта AMD на архітектурі RDNA 2 для хмарної графіки. Основні цифри — у таблиці вище; додамо, що за даними AMD карта має ECC, а охолодження пасивне.
ROCm — відкритий обчислювальний стек AMD, аналог CUDA. Докладно про те, де Radeon наздогнав GeForce у нейромережах, ми розбирали в матеріалі ROCm проти CUDA. Для V620 важлива одна деталь: у матриці сумісності ROCm версії 10.1.0 (сторінка від 26.08.2026) карта (gfx1030) підтримується лише під Linux — Ubuntu 22.04.5, 24.04.5 і 26.04.1; у селекторі ОС для неї є ще RHEL (таблиця показує RHEL 9.8 і 10.2), а варіантів Windows і WSL2 немає. У гілці ROCm 7.14 список був ще вужчим: лише Ubuntu 24.04.4 і 22.04.5.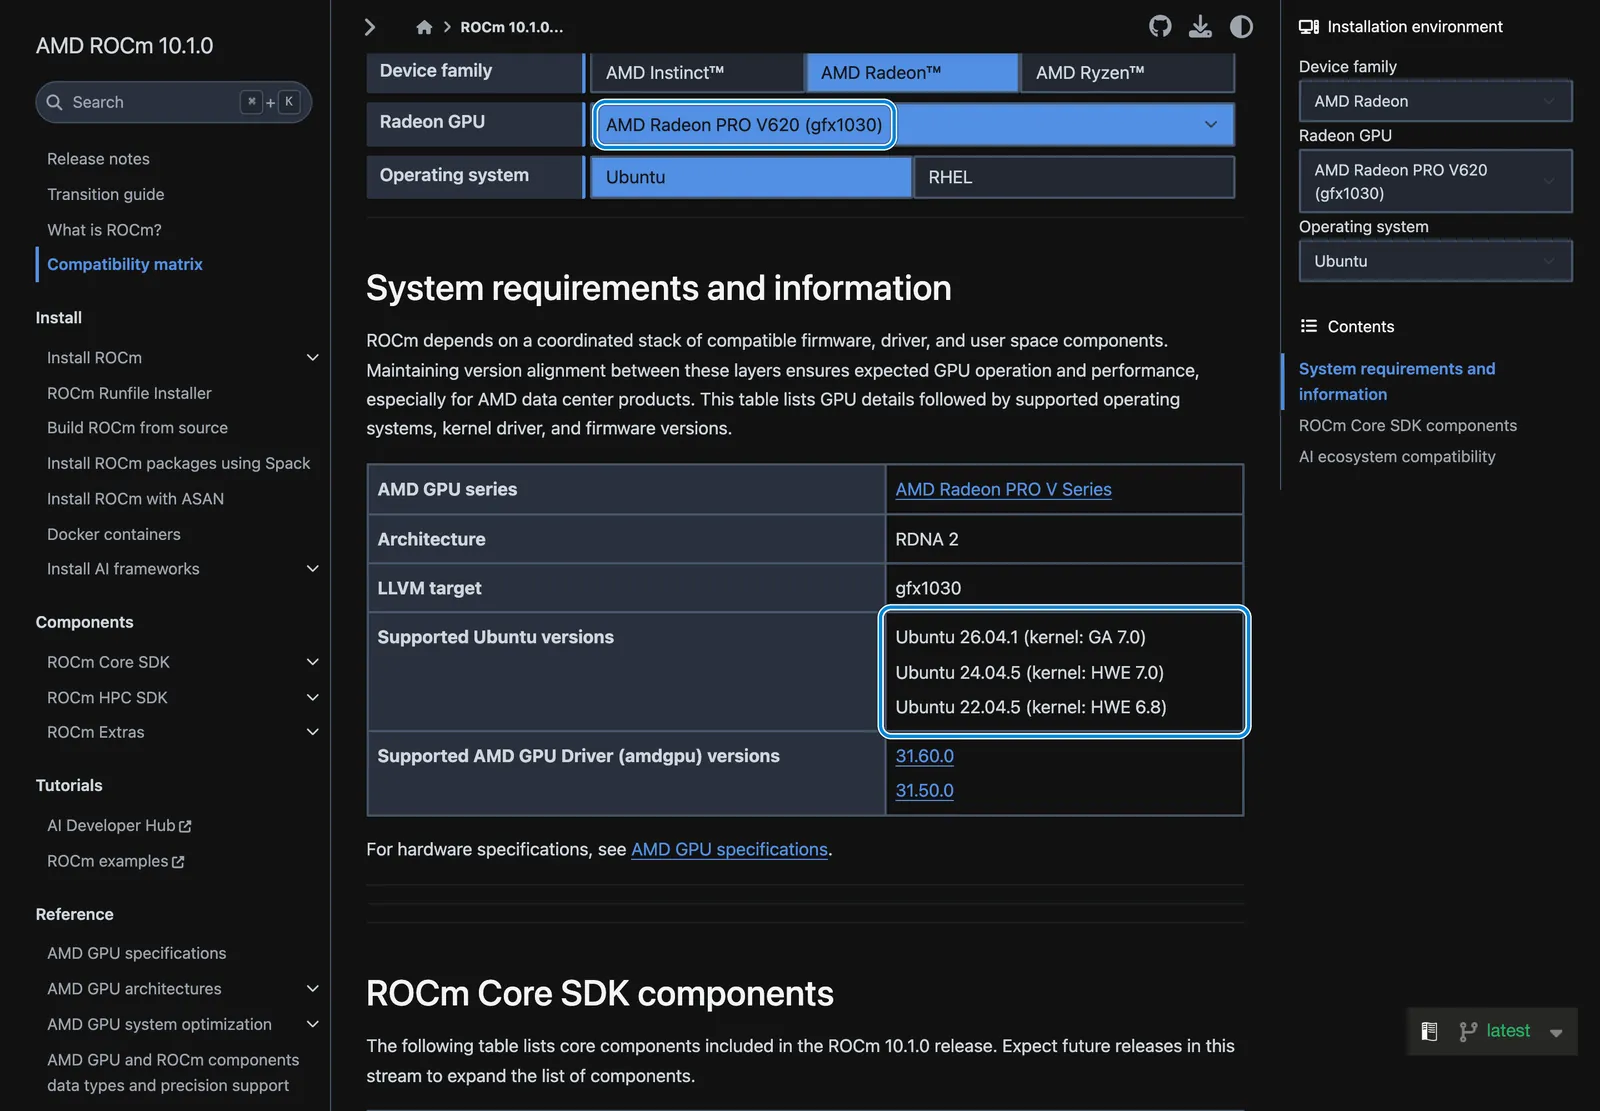
Скриншот матриці ROCm 10.1.0 (знято 26.10.2026): обрано Radeon PRO V620 (gfx1030), рамкою виділено підтримувані Ubuntu; у рядку «Operating system» доступні лише Ubuntu і RHEL.
ROCm при цьому не обов’язковий. Власник V620, який опублікував заміри 03.07.2026, запускав llama.cpp через Vulkan — універсальний графічний API, що працює й без ROCm. Його результати: 104 ток/с на GPT-OSS 20B, 59,5 ток/с на MoE Qwen3.6 35B-A3B і 22 ток/с на щільній Qwen3.6 27B. Обробка промпту на щільній моделі повільна — 245 ток/с, бо старе ядро RDNA 2 слабше в обчисленнях.
Що ще варто знати з його досвіду:
- під навантаженням карта споживала в середньому 197–233 Вт;
- у BIOS треба ввімкнути Above 4G Decoding і Resizable BAR (режими, що дають процесору бачити всю пам’ять карти), інакше вона не запуститься;
- підтримку Windows він назвав ненадійною;
- вентилятора немає, потрібен шрауд — кожух-перехідник під зовнішній вентилятор.
V620 — найдешевший спосіб отримати 32 ГБ однією картою, якщо ви її знайдете. В Україні пропозицій ми не бачили, а купівля на eBay додає доставку й розмитнення.
RTX 3060 12 ГБ: повільніша, зате з робочим CUDA-стеком
RTX 3060 для нейромереж беруть не за швидкість, а за те, що все працює одразу. За даними NVIDIA, версія на 12 ГБ має пам’ять GDDR6 на 192-бітній шині й споживання 170 Вт. Пропускну здатність NVIDIA не вказує; із частоти пам’яті й ширини шини виходить 360 ГБ/с — удвічі менше, ніж у P100; це звичайна ігрова карта з вентиляторами, вона стає в будь-який корпус. Обережно з версією на 8 ГБ і 128-бітною шиною: для ШІ вона помітно гірша, перевіряйте обсяг в оголошенні.
На OLX 26.10.2026 було 15 оголошень з ціною: від 9 899 до 16 000 грн, медіана 14 500 грн (~$318). У США вживану карту, за даними PromptQuorum на 01.09.2026, продають за $270–300 — порядок цін збігається.
За замірами Hardware Corner на llama.cpp з CUDA 12.8 карта видає 41,97 ток/с на Qwen3 8B і 22,66 ток/с на Qwen3 14B у 4-бітному кванті з контекстом 16 тис. токенів. Цього вистачає для чат-асистента й помічника в коді на моделях до 14B. Якщо хочете вичавити з однієї карти більше, корисно порівняти оболонки: у нашому розборі Ollama, LM Studio і llama.cpp на одній моделі за чужими замірами видно: з однаковим квантом оболонки розходяться на 0,3–10%, а розриви до трьох разів майже завжди дають різні кванти й налаштування вивантаження.
Навіщо три штуки? Щоб отримати 36 ГБ і запускати моделі, які у 12 ГБ не вміщуються. llama.cpp уміє ділити модель за шарами між картами: кожна зберігає свою частину. Але є застереження:
- Пам’ять додається не повністю. Кожній карті потрібен свій буфер під обчислення й частину контексту, тому корисний обсяг менший за 36 ГБ.
- Швидкість не потроюється. Коли модель поділено за шарами, карти обробляють токен по черзі, і генерація йде приблизно зі швидкістю однієї карти на цьому обсязі. Сторонніх замірів саме для трьох RTX 3060 ми не знайшли (н/д), тому цифр не обіцяємо.
- Лінії PCIe. На звичайній материнській платі третя карта часто потрапляє на лінії чипсета x4 або на райзер. Для генерації це терпимо, а завантаження моделі триває довше. Наприклад, автор обговорюваної збірки 3×3060 на r/LocalAIServers поставив карти на серверний Xeon Platinum, де ліній вистачає.
Arc Pro B70: чому 32 ГБ за $949 стали $1 268 і що із софтом Intel
Arc Pro B70 — професійна карта Intel на архітектурі Battlemage, анонсована 25.03.2026 за ціною $949. Характеристики — у таблиці вище, за даними InsiderLLM, ComputingForGeeks і RunAIHome; у партнерських версій споживання різниться від 160 до 290 Вт.
Ціна — головна причина, чому B70 не потрапляє в бюджетний клас. За трекером GPU Poet, який цитує RunAIHome, у серпні 2026 року мінімальна середньоденна ціна була $1 268 з розкидом $1 048–1 471. ComputingForGeeks на 24.10.2026 пише, що на Amazon лишилися тільки перекупники приблизно по $2 000. Це на 34–111% вище за рекомендовану ціну.
Arc Pro B70 для LLM добра на MoE-моделях і економна: 54,7 ток/с на Qwen3.6 35B-A3B зі споживанням близько 114 Вт. На щільних моделях картина гірша. На Qwen3.5 27B карта дає 22,47 ток/с лише після збирання llama.cpp із SYCL (обчислювальний шар Intel на базі oneAPI) і тонкого налаштування, 13,43 ток/с у vLLM і 11,87 ток/с через Vulkan у LM Studio.
Софт — друга пастка, і про неї варто знати до купівлі:
- Звичайна Ollama на Arc обчислює на процесорі й не попереджає про це. Робочі шляхи — llama.cpp із SYCL (основний) або збірка Ollama від Intel (IPEX-LLM Ollama Portable Zip). Зважте: репозиторій IPEX-LLM Intel перевела в архів 28.01.2026 і більше не розвиває, тож свіжих моделей ця збірка може не підтримувати. Той самий нюанс ми докладно описували в розборі бюджетної збірки на Intel Arc B580.
- Баг llama.cpp #21893. У квітні 2026 року на SYCL-збірках Battlemage деякі моделі видавали беззв’язний текст; обхід — змінна
GGML_SYCL_DISABLE_OPT=1. 04.05.2026 автор закрив баг, але якщо на старій збірці замість відповіді йде сміття — почніть із цієї змінної. - vLLM працює через форк Intel LLM-Scaler, але ComputingForGeeks називає його рівнем бети.
- Документація llama.cpp SYCL у списку перевірених карт Arc B-Series називає лише B580; B70 працює за звітами спільноти.
За однакових грошей вибір упирається у ваші моделі. RunAIHome сформулював це так: $1 264 за вживану RTX 3090 проти $1 268 за нову B70 — беріть 3090, якщо моделі вміщуються у 24 ГБ, і B70, якщо ні. Якщо дивитеся в бік 3090, у нас є розбір збірки на двох RTX 3090 на 48 ГБ.
Три збірки домашнього ШІ-сервера: карти, вати й підсумок за ціною
Нижче три способи отримати 32–36 ГБ відеопам’яті — обсяг, у який вміщуються щільні 27B і MoE класу 35B-A3B. Ціни — лише за відеокарти, на 26.10.2026 (OLX і курс НБУ) або на дату, вказану в клітинці. Платформу (процесор, плату, пам’ять) ми не рахуємо: вживаний серверний Xeon і нова AM5 відрізняються за ціною в рази, а в багатьох базовий ПК уже є.Параметр A: 2×Tesla P100 B: 3×RTX 3060 12 ГБ C1: 1×Radeon Pro V620 C2: 1×Arc Pro B70 VRAM 32 ГБ 36 ГБ 32 ГБ 32 ГБ Ціна карт 17 000–19 000 грн (~$373–417) 29 700–48 000 грн (~$652–1 054), за медіаною 43 500 грн (~$955) ~$350 (~15 900 грн), eBay, липень 2026; в Україні н/д $949 (~43 200 грн) MSRP; ~$1 268 (~57 700 грн) у серпні 2026 TDP карт 500 Вт 510 Вт 300 Вт 230 Вт Блок живлення (наша оцінка) від 850 Вт 850–1 000 Вт від 650 Вт від 550 Вт Софт CUDA 12.x, llama.cpp; без vLLM CUDA, Ollama, llama.cpp, vLLM Vulkan або ROCm лише Linux SYCL або Vulkan, vLLM — бета Охолодження пасивне, потрібен обдув власні вентилятори пасивне, потрібен шрауд н/д Головний мінус софт заморожено на CUDA 12.x і R580 три карти, лінії PCIe, швидкість однієї карти ціну й наявність в Україні не підтвердити ціна вища за MSRP на 34–111%
Блок живлення оцінювали за простою формулою: сума TDP карт плюс ~150 Вт на процесор та інше, і зверху запас 30%. Для збірки A: (500 + 150) × 1,3 ≈ 845 Вт, отже, беремо від 850 Вт. Для V620 врахуйте два 8-pin роз’єми на карту, для B70 — один.
Якщо потрібна відеокарта для домашньої нейромережі з мінімумом мороки, обирайте збірку B: вона дорожча, зате кожен інструмент з інструкцій в інтернеті запуститься. Збірка A — найдешевший спосіб отримати 32 ГБ з CUDA, але лише для llama.cpp. Збірка C1 дає 32 ГБ однією картою дешевше за всіх, якщо знайдете карту по $350. C2 виправдана тільки за ціни, близької до рекомендованої.
Шлях апгрейду в усіх різний. У збірки B наступний крок — заміна 3060 на 24-гігабайтні карти. В A — перехід на карти з CC 7.5+, щоб відкрити vLLM і CUDA 13. У C1 — друга V620 на 64 ГБ, якщо плата й блок живлення це витримають.
Шум, охолодження та живлення пасивних серверних карт удома
Пасивна серверна карта — це радіатор без вентилятора. У сервері її продуває потік повітря від потужних вентиляторів корпусу. У домашньому корпусі такого потоку немає, і P100 на 250 Вт чи V620 на 300 Вт без доопрацювання швидко перегріється й скине частоти.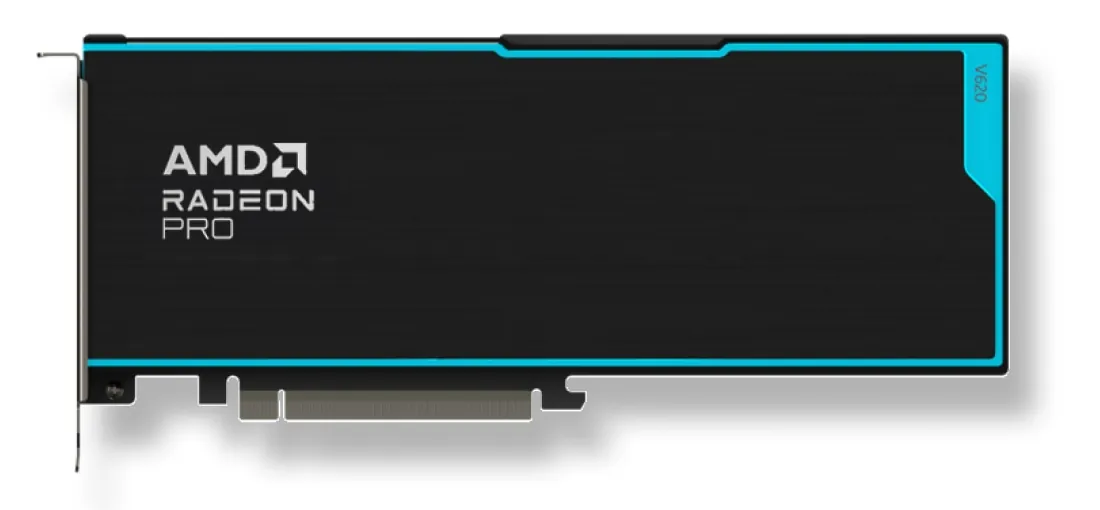
Фото: AMD. На карті немає вентилятора — лише кожух радіатора, повітря має йти крізь нього ззовні.
Як це розв’язують на практиці:
- Шрауд із вентилятором. На торець карти ставлять кожух-перехідник (часто надрукований на 3D-принтері) і вентилятор-равлик (блоуер) або потужний на 40–92 мм. На OLX такі перехідники для P100 продають від 130 грн, трапляються й готові комплекти «карта + охолодження».
- Готовий сервер. Корпус із серверними вентиляторами розв’язує питання охолодження, але шумить помітно сильніше за домашній ПК. Для кімнати, де ви спите, це поганий варіант.
- Обмеження потужності. Один із коментаторів під дописом про V620 тримає карту на 160 Вт і оцінює втрату швидкості приблизно в 10%. Це думка користувача, а не замір, але спосіб зменшити нагрів і шум робочий.
- Відстань між картами. Дві-три карти впритул гріють одна одну; залишайте хоча б один вільний слот або ставте райзери.
Скільки децибелів дає кожна схема, сказати не можна: порівнянних замірів шуму для цих карт у домашніх умовах ми не знайшли (н/д). Орієнтир один — що менший вентилятор і що вищі його оберти, то гучніше. Карта з власними вентиляторами, як RTX 3060, у цьому сенсі найпростіша.
Щодо живлення головне — не економити на блоці. Пікове споживання серверних карт може короткочасно перевищувати середнє, а дешевий блок на межі — часта причина перезавантажень під навантаженням.
Як перевірити вживану серверну карту перед купівлею на OLX
Серверні карти часто приходять після кількох років роботи в дата-центрі чи майнінгу, тому перевірка обов’язкова. Загальний порядок для будь-якої відеокарти розписано в нашому посібнику як перевірити б/в відеокарту перед купівлею. Для P100 і V620 додайте кілька пунктів:
- Попросіть скриншот під навантаженням. Для NVIDIA —
nvidia-smiз моделлю, обсягом пам’яті й температурою під час тесту; для AMD —rocm-smiабо аналог. Карта без кадру роботи — привід для торгу або відмови. - Перевірте всю пам’ять. Завантажте модель, яка займає майже весь обсяг VRAM, і дайте їй попрацювати 15–30 хвилин. Артефакти, вильоти чи беззв’язний текст на свідомо робочій моделі — ознака проблем із пам’яттю.
- Подивіться лічильники ECC. P100 і V620 мають виправлення помилок пам’яті. У NVIDIA лічильники показує
nvidia-smi -q -d ECC; зростання кількості виправлених помилок — тривожний знак. - Огляньте роз’єми. Контакти PCIe без потемнінь і сколів, роз’єми живлення не оплавлені, планка кріплення на місці.
- Уточніть комплект охолодження. Пасивна карта без шрауда — це додаткові витрати й час; закладіть їх у ціну одразу.
- Угода з оглядом. Оплата під час отримання з перевіркою на пошті й тест протягом кількох днів — розумний мінімум для карти за 8–16 тис. грн.
Ризики бюджетної збірки: мертвий софт-стек, знос і ціна-пастка
Кожна з чотирьох карт має свій головний ризик, і він не завжди очевидний за ціною:
- P100: софт більше не розвивається. Сьогодні llama.cpp на CUDA 12.x працює, але щороку нові моделі й формати дедалі частіше приходитимуть без підтримки старих карт.
- V620: вузьке коло ОС і ручне налаштування. ROCm 10.1.0 підтримує карту лише на кількох версіях Ubuntu і RHEL; Vulkan — запасний шлях. Ціну ~$350 підтверджує один власник, а в Україні пропозицій немає.
- RTX 3060: знос і обмеження за обсягом. Це масова ігрова карта, частина екземплярів пройшла майнінг. 12 ГБ на одну карту — жорстка стеля, а три карти дають обсяг, але не швидкість.
- Arc Pro B70: ціна-пастка й молодий софт. У серпні 2026 року карта коштувала на 34% дорожче за рекомендовану ціну, а на 24.10.2026 у перекупників на Amazon — на 111%. Ollama без збірки Intel не використовує GPU, а сама ця збірка із січня 2026 року в архіві; vLLM — у беті.
- Спільний ризик — гарантія. На вживану серверну карту з OLX її майже ніколи немає, а в нової B70 за завищеною ціною від перекупника гарантія залежить від продавця.
Зведено щодо софту на 26.10.2026 — що запускається на кожній карті без обхідних шляхів:Інструмент Tesla P100 Radeon Pro V620 RTX 3060 12 ГБ Arc Pro B70 CUDA лише 12.x — так, зокрема 13 — ROCm — Linux: Ubuntu і RHEL — — SYCL (oneAPI) — — — так, потрібна власна збірка Vulkan у llama.cpp н/д так (заміри власника) так так, ~45% швидкості SYCL llama.cpp так, на CUDA 12.x так, Vulkan або ROCm так так, SYCL або Vulkan Ollama старі версії (замір на 0.5.11) н/д так лише архівна збірка Intel IPEX-LLM vLLM ні (потрібна CC 7.5+) н/д так бета через LLM-Scaler
Першими в цій статті застаріють ціни: B70 і вживаних карт на OLX змінюються за тижні. Перед купівлею перевірте свіжі оголошення й курс НБУ, а сумісність V620 — за актуальною матрицею ROCm.
Коли бюджетна збірка — хибний вибір? Якщо вам потрібна швидкість на щільних моделях 24–32B для щоденної роботи, розумніше взяти одну вживану RTX 3090 на 24 ГБ або нову 32-гігабайтну карту класу Radeon AI Pro R9700. Вони дорожчі, але позбавляють компромісів, описаних вище.
Часті запитання
Чи варто брати Tesla P100 для нейромереж?
Варто, якщо ви хочете найдешевший вхід у 16 ГБ: на OLX 26.10.2026 карта коштувала 8 500–9 499 грн. Але софт на ній заморожено: CUDA 13 Pascal уже не підтримує, а драйвер R580 — остання гілка. Працювати доведеться в llama.cpp на CUDA 12.x і розв’язувати питання обдуву пасивного радіатора.
Яка найдешевша відеокарта для LLM?
За ціною гігабайта наприкінці жовтня 2026 року найдешевші Radeon Pro V620 (~$10,9 за ГБ за ціни ~$350 на eBay) і Tesla P100 ($11,7–13,0 за ГБ на OLX). З карт, які просто працюють у звичайному ПК з повною CUDA, найдоступніша — вживана RTX 3060 12 ГБ від 9 899 грн. Карти з 8 ГБ для LLM брати не варто.
Чи можна зібрати ШІ-сервер на трьох RTX 3060 і чи складеться пам’ять у 36 ГБ?
Зібрати можна: llama.cpp ділить модель за шарами між картами, і разом вони вміщують моделі, яким замало 12 ГБ. Але корисний обсяг буде меншим за 36 ГБ — кожній карті потрібен свій буфер, — а швидкість генерації лишиться приблизно на рівні однієї карти. Сторонніх замірів для трьох 3060 ми не знайшли, тож точну швидкість наперед не передбачить ніхто.
Чи підійде Intel Arc Pro B70 для LLM і чим її запускати?
Підійде, особливо для MoE-моделей: 54,7 ток/с на Qwen3.6 35B-A3B за ~114 Вт, за даними RunAIHome. Запускати краще через llama.cpp із SYCL; збірка Ollama від Intel (IPEX-LLM) теж працює, але з 28.01.2026 її репозиторій в архіві, а звичайна Ollama обчислює на процесорі. Головний мінус — ціна: близько $1 268 у серпні й до $2 000 у жовтні 2026 року замість $949.
Чи працюють vLLM і Ollama на P100?
vLLM — ні: за документацією йому потрібна compute capability 7.5 або вище, а в P100 — 6.0. Ollama на P100 працювала в замірі хостера Database Mart (19,45 ток/с на Qwen2.5 14B), але на версії 0.5.11. Нові збірки перевіряйте окремо: після переходу екосистеми на CUDA 13 підтримка Pascal може зникнути. Надійний шлях — llama.cpp на CUDA 12.x.
Чи можна поставити пасивну P100 або V620 у звичайний ПК?
Можна, але лише з доопрацюванням охолодження. Ці карти не мають вентилятора, і в домашньому корпусі без спрямованого потоку повітря вони швидко перегріваються. Потрібні шрауд із вентилятором-равликом на торці карти, блок живлення із запасом і ввімкнені в BIOS Above 4G Decoding та Resizable BAR. Для V620 додайте два 8-pin роз’єми живлення й Linux.