
Коротко (TL;DR)
Gemini 3.8 Flash — недорогая модель Google для API, агентов и массовых задач, вышла 2 сентября 2026 года. В этом обзоре Gemini 3.8 Flash мы сверили обещания Google с независимыми замерами и проверили два популярных тезиса: «Flash быстрее Pro» и «Flash дешёвая». Собственный прогон в этот материал не вошёл: все выводы опираются на данные Google, Artificial Analysis (AA), Vals, LMArena и BenchLM, и у каждой цифры указано, чья она.
- Коротко (TL;DR)
- Что за модель Gemini 3.8 Flash и чем она заменила 3.7 Flash
- Цена Gemini 3.8 Flash: $0,75 и $3,75 за 1M токенов до конца 2026
- Скорость вывода и ожидание: 131 токен/с, но 25 секунд до ответа
- Цена задачи на тесте AA: почему 3.8 Flash стоит почти как Argon
- Хватит ли Gemini 3.8 Flash вместо 3.1 Pro: сравнение по задачам
- Бенчмарки: что подтверждено независимо, а что самоотчёт Google
- Переходить ли с Gemini 3.7 Flash на 3.8 Flash
- Gemini 3.8 Flash против Haiku 5.5, GPT-6.1 Terra и MiniMax M3.1 Flash
- Риски 3.8 Flash: многословность, неанглийские языки и цена 2027
- Кому подойдёт Gemini 3.8 Flash, а кому лучше другая модель
- FAQ
- Цена токена низкая, но временно. $0,75 за миллион входных токенов и $3,75 за миллион выходных — вводный тариф до 31 декабря 2026 года. С 1 января 2027 года — $1,50 и $7,50.
- Задача теста AA — почти как у флагмана. По индексу AA v5.0 на 2 ноября 2026 года одна задача теста обходится Flash в $7,77, а Gemini 4 Argon — в $7,68. При этом индекс у Flash 31, у Argon — 50. Причина — многословность: 130 млн токенов на тесте против медианы 71 млн.
- «Быстрее Pro» не подтверждается. По AA Gemini 3.1 Pro Preview и печатает быстрее, и начинает отвечать раньше (подробности — в разделе о скорости).
- Где хватает вместо Pro: фоновый агентный код, работа в терминале, пакетная обработка документов. Где не хватает: сложное рассуждение и живой диалог, где человек ждёт ответа. Ответы на русском и украинском стоит проверять: Google сама фиксирует, что на неанглийских языках модель хуже соблюдает правила безопасности, чем 3.7 Flash.
- Это не новая модель, а дообучение Gemini 3.7 Flash. Старую 3.7 Google уже сняла: запросы к ней автоматически уходят на 3.8.
Что за модель Gemini 3.8 Flash и чем она заменила 3.7 Flash
Gemini 3.8 Flash — это самая новая модель класса Flash, недорогой ступени линейки Gemini (выше по линейке — Pro и флагман Gemini 4 Argon). Идентификатор в API — gemini-3.8-flash, в общий доступ (GA — generally available, то есть стабильная, а не тестовая версия) Google вывела её 2 сентября 2026 года. Модель умеет «думать» перед ответом, принимает текст, картинки, звук и видео, а отвечает текстом.
Главное, что стоит знать: это не новая база. В официальной карточке модели от Google DeepMind (model card) прямо написано: «Gemini 3.8 Flash is based on Gemini 3.7 Flash», то есть модель построена на 3.7 Flash и дообучена. Отсюда и та же цена, что у предшественницы, и темп выпуска: сама Google называет 3.8 «третьим релизом Flash всего за шесть недель» (3.6 → 3.7 → 3.8).
Ключевые параметры по документации Google на 2 ноября 2026 года:
| Параметр | Gemini 3.8 Flash |
|---|---|
| Идентификатор в API | gemini-3.8-flash |
| Дата выхода (GA) | 2 сентября 2026 года |
| Окно контекста (сколько текста модель видит за раз) | 1 048 576 токенов на вход |
| Максимальный ответ | 65 536 токенов |
| Уровни рассуждения (thinking) | low, medium (по умолчанию), high; minimal возвращает ошибку |
| Граница знаний | март 2026 года; Google предупреждает, что в части тем знания могут обрываться на январе 2025 года |
| Где доступна | Gemini API, Google AI Studio, Android Studio, Google Antigravity, Gemini Enterprise, приложение Gemini (подписки AI Pro и Ultra), AI Mode в поиске, Gemini в Google Sheets |
Токен — это кусок слова, в котором модель считает текст и деньги. Английское слово обычно занимает один-два токена, русское и украинское — больше, поэтому одна и та же мысль на кириллице стоит дороже.
Сводка против ближайших моделей Google на 2 ноября 2026 года (цены — тариф Standard за 1 млн токенов, скорость и индекс — Artificial Analysis):Gemini 3.8 Flash (high) Gemini 3.1 Pro Preview Gemini 4 Argon (high) Статус GA с 2.09.2026 preview с 19.02.2026 GA Цена вход / выход $0,75 / $3,75 до 31.12.2026 $2 / $12 (запрос до 200 тыс. токенов) $2 / $10 до 30.11.2026, затем $4 / $20 Индекс AA v5.0 31 не посчитан 50 Цена задачи индекса AA $7,77 н/д $7,68 Скорость вывода 130,7 ток/с 143,2 ток/с 83 ток/с Ожидание первого фрагмента 24,89 с 17,67 с 40,47 с
Вердикт: Flash — для фоновых задач, где важна цена за токен, а не скорость реакции. Экономию считайте по задаче, а не по прайсу.
Цена Gemini 3.8 Flash: $0,75 и $3,75 за 1M токенов до конца 2026
На 2 ноября 2026 года прайс Gemini API даёт для Gemini 3.8 Flash вводный тариф: $0,75 за миллион входных токенов и $3,75 за миллион выходных. В официальной таблице строки называются Input price и Output price (including thinking tokens) — и вторая оговорка важна: токены рассуждения, которые модель тратит «про себя» перед ответом, оплачиваются как выходные, по $3,75. В пересказах прайса легко увидеть только первую цифру и пропустить, что выход стоит в пять раз дороже входа.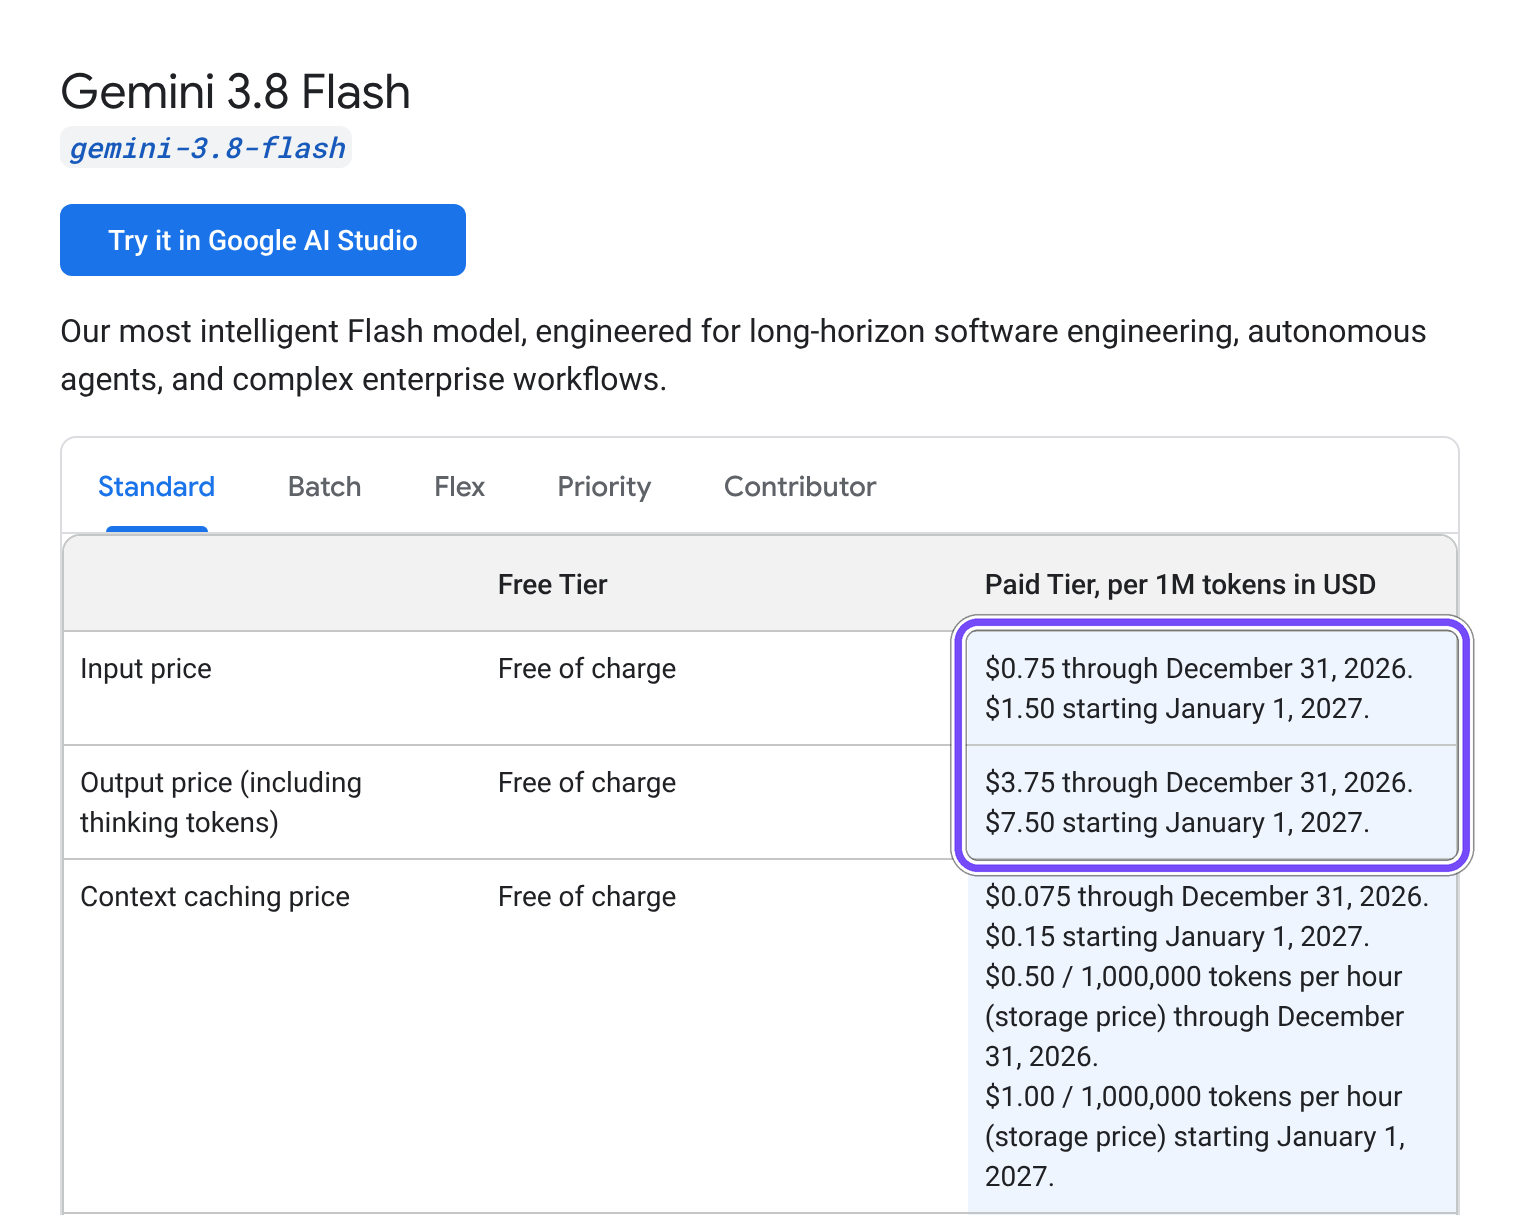
На скриншоте страницы цен Google (снят 2 ноября 2026 года) рамкой выделены обе платные цены и дата, с которой они удваиваются.Тариф (за 1 млн токенов) До 31.12.2026 С 01.01.2027 Standard — вход $0,75 $1,50 Standard — выход (вместе с рассуждением) $3,75 $7,50 Standard — кэш контекста $0,075 + хранение $0,50 в час $0,15 + хранение $1,00 в час Batch (пакетный режим) — вход $0,375 $0,75 Batch — выход $1,875 $3,75 Batch — кэш контекста $0,0375 $0,075 Бесплатный уровень (Free Tier) бесплатно, лимиты видны в AI Studio бесплатно, лимиты видны в AI Studio
Batch — режим, в котором запросы отправляются пачкой и обрабатываются без спешки: ответ приходит позже, зато вдвое дешевле. Кэш контекста — скидка на повторно отправляемый одинаковый текст (например, длинную инструкцию или базу знаний): по прайсу Google закэшированный токен в 10 раз дешевле обычного входного ($0,075 против $0,75), но за хранение кэша отдельно берут $0,50 за миллион токенов в час (с 1 января 2027 года — $1,00).
Наш расчёт: миллион токенов на вход плюс миллион на выход.



- Сейчас: $0,75 + $3,75 = $4,50.
- С 1 января 2027 года: $1,50 + $7,50 = $9,00.
- В пакетном режиме сейчас: $0,375 + $1,875 = $2,25.
- Для сравнения, Gemini 3.1 Pro Preview: $2 + $12 = $14 (при запросах до 200 тыс. токенов; длиннее — $4 за вход и $18 за выход).
Пример на типовой нагрузке: 1000 запросов по 20 тыс. входных и 3 тыс. выходных токенов — столько примерно выдаёт на ответ модель со «средней» разговорчивостью. Вход — 20 млн токенов × $0,75 = $15, выход — 3 млн × $3,75 = $11,25, итого $26,25 до конца 2026 года и $52,50 после. Если же Flash на ваших задачах окажется многословнее медианы так же, как на тесте AA (130 млн против 71 млн, примерно в 1,8 раза), выход вырастет до 5,5 млн токенов, а счёт — примерно до $35,60 по нынешнему тарифу. Это наша арифметика по прайсу Google, а не замер.
Бесплатный уровень Gemini API включает 3.8 Flash, но у него есть цена другого рода: в прайсе Google в строке «Used to improve our products» для бесплатного уровня стоит «Yes», для платного — «No». Проще говоря, то, что вы отправляете бесплатно, может использоваться для улучшения продуктов Google. Конкретных лимитов бесплатного уровня для 3.8 Flash Google в документации не приводит: на странице rate limits сказано, что действующие лимиты проекта видны в Google AI Studio (проверено 2 ноября 2026 года). Клиентские данные и рабочие документы через бесплатный ключ лучше не гонять.
Скорость вывода и ожидание: 131 токен/с, но 25 секунд до ответа
Скорость модели описывают две разные цифры. Первая — сколько токенов в секунду она печатает, когда уже начала отвечать. Вторая — сколько секунд вы ждёте первый фрагмент ответа. У «думающей» модели вторая цифра включает время рассуждения, и для человека у экрана она важнее первой.
По AA на 2 ноября 2026 года Gemini 3.8 Flash в режиме high печатает 130,7 токена в секунду, но первый фрагмент ответа приходит через 24,89 секунды, а полный ответ на тестовый запрос — через 28,71 секунды. Gemini 3.1 Pro Preview на той же площадке: 143,2 токена в секунду, 17,67 секунды до первого фрагмента и 21,16 секунды до полного ответа. Посылка «Flash быстрее Pro» на этих данных не подтверждается.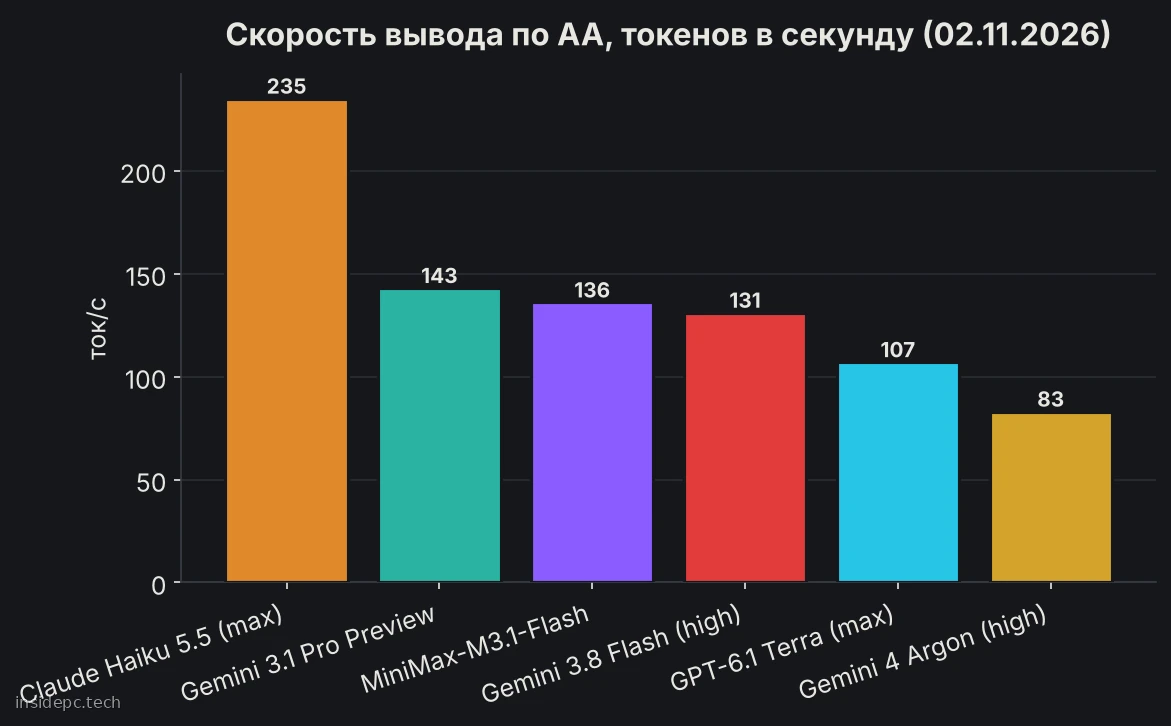
На графике Flash стоит в середине строки: заметно быстрее Gemini 4 Argon и GPT-6.1 Terra, но медленнее 3.1 Pro, MiniMax-M3.1-Flash и Claude Haiku 5.5.
Почему в обзорах встречаются совсем другие цифры — 305 и даже 824 токена в секунду? Это разные замеры в разных условиях:Источник Когда Скорость вывода Ожидание ответа Условия AA, Flash (high) 2 ноября 2026 130,7 ток/с 24,89 с до первого фрагмента независимый замер через API Google AA в пересказе eesel 8 сентября 2026 305,1 ток/с 13,30 с до первого токена замер первых дней после релиза OrcaRouter н/д 824 ток/с 8057 мс — медиана задержки собственный замер шлюза-посредника
Цифры расходятся из-за режима рассуждения, провайдера, дня замера и методики, поэтому мы опираемся на свежий независимый замер AA. Ещё в сентябре eesel обращал внимание: высокая скорость печати не означает быструю реакцию — медианная «думающая» модель того же ценового класса тогда начинала отвечать через 2,99 секунды против 13,30 у Flash.
На практике фоновому агенту, который ночью разбирает очередь задач, 25 секунд ожидания безразличны. Человеку в чате поддержки 25 секунд тишины перед каждым ответом — слишком долго.
Цена задачи на тесте AA: почему 3.8 Flash стоит почти как Argon
Цена за токен похожа на цену литра бензина, а цена задачи — на стоимость всей поездки. Дешёвый литр не поможет, если машина расходует вдвое больше. Google сама предупреждает в анонсе, что модель «иногда может использовать больше токенов, чтобы выжать максимум качества, особенно на высоких уровнях усилия».
Artificial Analysis это и измерил. На прогоне своего индекса v5.0 (девять тестов — от работы в терминале до экспертных вопросов) Gemini 3.8 Flash в режиме high сгенерировала 130 млн токенов при медиане 71 млн по сравнимым моделям. Входной токен у неё дешевле медианы ($0,75 против $2,00), выходной тоже ($3,75 против $10,00) — и всё равно одна задача индекса в среднем обошлась в $7,77.
На скриншоте страницы AA (2 ноября 2026 года) рамкой выделены карточки, на которых держится вывод: $7,77 за задачу при прайсе $0,75/$3,75 и 130 млн токенов расхода.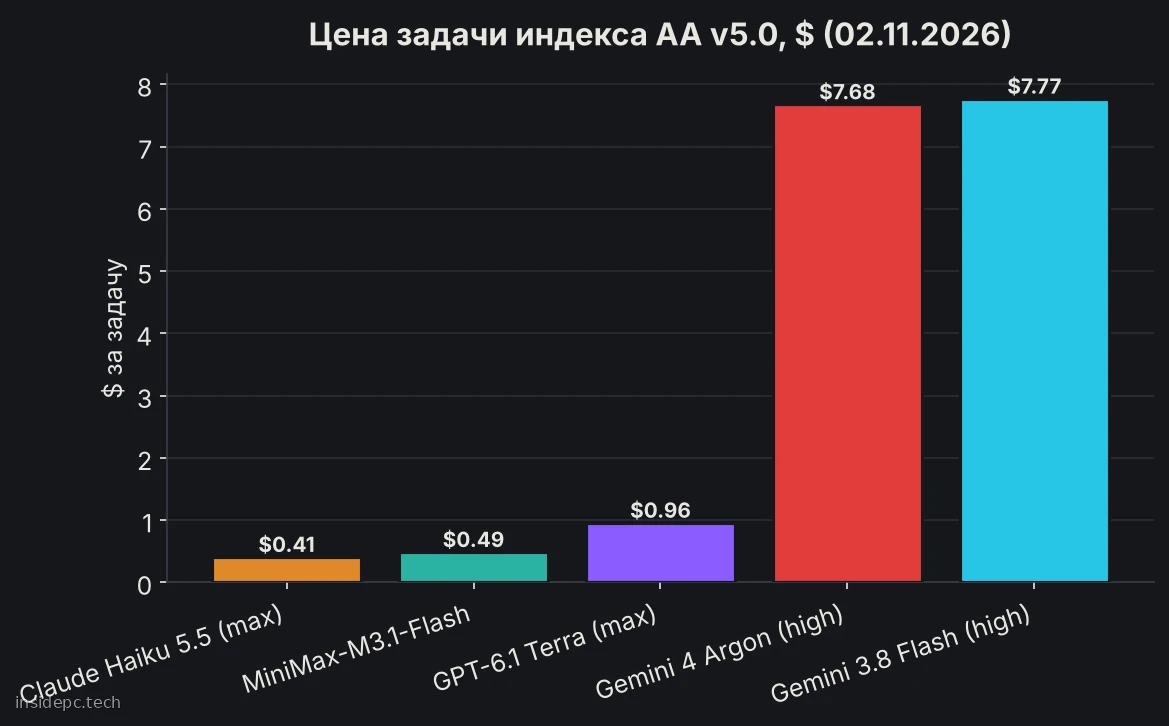
Вывод из графика: на задачах этого теста Gemini 3.8 Flash в режиме high стоит почти столько же, сколько флагман Gemini 4 Argon, а набирает 31 балл против 50. Claude Haiku 5.5, GPT-6.1 Terra и MiniMax M3.1 Flash решают задачу теста в 8–19 раз дешевле. Оговорка по MiniMax: в нашем отдельном обзоре этой модели стоят индекс 43 и $0,22 за задачу — это цифры предыдущей версии индекса AA, по версии v5.0 у неё 29 баллов и $0,49. Цифры разных версий смешивать нельзя.
Вторая оговорка: тест AA — сложные многошаговые задачи. На коротких запросах вроде классификации многословность проявляется меньше. Поэтому перед переносом нагрузки на 3.8 Flash прогоните сотню своих типовых запросов и посмотрите на расход токенов в отчёте биллинга.
Снизить расход помогает уровень рассуждения low или medium вместо high. По тому же AA индекс Flash в режиме Low — 22 против 31 в режиме high: качество падает заметно, но и токенов уходит меньше. На вопрос с Reddit от 31 октября «какой уровень брать» логика тарифа подсказывает: начинать с medium (он стоит по умолчанию), опускаться до low на простых массовых задачах и включать high там, где ошибка дороже лишних токенов. Это рекомендация, а не результат нашего теста.
Хватит ли Gemini 3.8 Flash вместо 3.1 Pro: сравнение по задачам
Коротко о паре Gemini 3.8 Flash vs 3.1 Pro: в агентном коде и работе в терминале Flash не уступает Pro и стоит в разы дешевле за токен, а в сложном рассуждении и в скорости реакции Pro по-прежнему впереди. Единого сравнения нет: Gemini 3.1 Pro с 19 февраля 2026 года остаётся в статусе preview, и индекс AA v5.0 для неё не посчитан.
Поэтому сравнение собрано из отдельных тестов, у каждой цифры — своя площадка и свой режим:Класс задач Цифры (Flash против 3.1 Pro) Источник и оговорки Хватает ли Flash Агентный код в терминале Terminal-Bench 2.1: 81,3% против 70,8% BenchLM по данным Vals, 29.10.2026 да Исправление багов в репозитории SWE-bench: 80,0% против 78,8% BenchLM по данным Vals, 29.10.2026 да Сложный терминал (новая версия теста) Terminal-Bench 4.0: 10% против 4% AA, Flash в режиме Low, 02.11.2026 да Автоматизация рабочих процессов AutomationBench-AA: 37% против 35% AA, Flash в режиме Low да, на равных Офисная работа со знаниями и документами AA-Briefcase v1.1: 1062 против 457 (рейтинг Elo от AA, больше — лучше); GDP.pdf: 19% против 18% AA, Flash в режиме Low да Экспертное рассуждение HLE-Diamond: 24% против 31% AA, Flash в режиме Low нет, лучше Pro или Argon Живой чат, где человек ждёт 24,89 с против 17,67 с до первого фрагмента AA, 02.11.2026 нет Цена 1 млн вход + 1 млн выход $4,50 против $14 прайс Google на 02.11.2026 да, пока действует вводный тариф
Общий балл агрегатора BenchLM на 29 октября 2026 года — 66,22 у Flash против 64,41 у Pro, но сам BenchLM предупреждает, что диапазоны оценок «не устанавливают уверенность в ранге». То есть разница в два пункта — не доказательство превосходства. В пользовательском рейтинге LMArena (людям показывают два анонимных ответа и просят выбрать лучший) на 2 ноября 2026 года gemini-3.8-flash-high стоит на 8-м месте в общем текстовом зачёте, gemini-3.1-pro-preview — на 15-м. В категории экспертных вопросов картина обратная: у Flash 28-е место, у Pro — 21-е.
Итог: для фонового агента, кода, документов и пакетной обработки Flash хватает, и за токен она дешевле Pro в 2,7–3,2 раза. Для глубокого рассуждения и быстрого первого ответа лучше Pro — или Argon, новый флагман Google, который в отличие от 3.1 Pro уже вышел в общий доступ.
Бенчмарки: что подтверждено независимо, а что самоотчёт Google
Бенчмарк (англ. benchmark) — стандартный набор задач, на котором модели вроде Gemini 3.8 Flash сравнивают между собой. Беда в том, что производитель сам выбирает, какие тесты показать. Поэтому цифры ниже разделены на две группы: что опубликовала Google и что измерили независимые площадки.Тест Результат 3.8 Flash Для сравнения Кто измерил HLE-Verified (экспертные вопросы) 54,9% Claude Opus 5 — 54,4%, 3.7 Flash — 53,6% Google (самоотчёт) DeepSWE v1.1 (долгая разработка) 73,7% Claude Opus 5 — 74,0%, 3.7 Flash — 65,3% Google (самоотчёт) Terminal-bench 4.0 (агент в терминале) 19,1% Claude Opus 5 — 51,8%, 3.7 Flash — 11,2% Google (самоотчёт) HLE-Diamond (экспертные вопросы) 24% в режиме Low 3.1 Pro Preview — 31% AA, 02.11.2026 Intelligence Index AA v5.0 31, #39 из 59 медиана сравнимых моделей — 38, Argon — 50 AA, 02.11.2026 Vals Index 55,95%, #18 из 32 $5,026 за прогон теста Vals AI, 02.11.2026 LMArena, текст, общий зачёт 8-е место 3.1 Pro Preview — 15-е LMArena, 02.11.2026
В таблице Google на экспертных вопросах HLE-Verified Flash даже чуть выше Claude Opus 5 (54,9% против 54,4%). Но на независимом экспертном тесте HLE-Diamond у AA та же модель в режиме Low уступает 3.1 Pro: 24% против 31%. Тесты и режимы разные, но контраст показательный. А на Terminal-bench 4.0 Flash даже в таблице Google отстаёт от Opus 5 более чем в два с половиной раза. Тезис «Flash догоняет флагманы» верен на выбранных тестах, а не в целом.
Независимые площадки ставят модель ниже середины: 39-е место из 59 в индексе AA (сам AA называет результат ниже среднего для сравнимых моделей) и 18-е из 32 в индексе Vals. Цены задачи у площадок ($7,77 у AA и $5,026 у Vals) считаются на разных наборах задач и между собой не сравниваются.
Ещё одна ловушка — версии шкалы. В сентябрьских обзорах (например, у eesel от 8 сентября 2026 года) встречается индекс AA 59. Это прежняя версия шкалы, а не «падение» модели: сейчас AA считает индекс v5.0 из девяти тестов.
Переходить ли с Gemini 3.7 Flash на 3.8 Flash
Сравнение Gemini 3.8 vs 3.7 Flash в API уже потеряло практический смысл. В changelog Gemini API в записи от 8 октября 2026 года Google пишет, что gemini-3.7-flash снята с поддержки: в AI Studio её больше нельзя выбрать, а запросы к ней через API автоматически уходят на gemini-3.8-flash.
На старте ситуация была другой. В самом анонсе 2 сентября Google советовала тем, для кого главное — экономия вычислений, «продолжать полагаться на Gemini 3.7 Flash», которая «остаётся полностью поддерживаемой» для таких задач. Через пять недель этот выбор исчез.Gemini 3.7 Flash Gemini 3.8 Flash Цена вход / выход $0,75 / $3,75 $0,75 / $3,75 до 31.12.2026 DeepSWE v1.1 (Google) 65,3% 73,7% Terminal-bench 4.0 (Google) 11,2% 19,1% Безопасность на неанглийских языках базовая линия хуже на 5,4 п.п. Расход токенов меньше (по словам Google) больше, особенно в режиме high Статус в API снята 8.10.2026, запросы уходят на 3.8 актуальная версия
Что сделать, если у вас в коде была 3.7 Flash:
- Явно пропишите
gemini-3.8-flash— чтобы понимать, какая модель отвечает, и не попасть под следующее тихое перенаправление. - Перемерьте расход токенов на своих запросах: при той же цене за токен счёт может вырасти из-за многословности.
- Проверьте уровень рассуждения: если в коде стоял
minimal, у 3.8 Flash он возвращает ошибку — допустимы толькоlow,mediumиhigh. - Перепроверьте ответы на русском и украинском — у 3.8 зафиксирован регресс безопасности на неанглийских языках (подробнее в разделе рисков).
Gemini 3.8 Flash против Haiku 5.5, GPT-6.1 Terra и MiniMax M3.1 Flash
В своём классе «быстрых и недорогих» Gemini 3.8 Flash не самая дешёвая и не самая умная. Вот как выглядят соседи по таблице AA на 2 ноября 2026 года (индекс v5.0, режимы рассуждения — в скобках):Модель Индекс AA v5.0 Цена задачи индекса Скорость вывода Ожидание первого фрагмента GPT-6.1 Terra (max) 51 $0,96 107 ток/с 264,33 с Gemini 4 Argon (high) 50 $7,68 83 ток/с 40,47 с Claude Haiku 5.5 (max) 36 $0,41 235 ток/с 370,08 с Gemini 3.8 Flash (high) 31 $7,77 131 ток/с 24,89 с MiniMax-M3.1-Flash 29 $0,49 136 ток/с 0,90 с 
По индексу Flash опережает только MiniMax-M3.1-Flash, а по цене задачи проигрывает всем, кроме Argon. Её козырь здесь — сравнительно короткое ожидание в режиме high: Haiku 5.5 и GPT-6.1 Terra на максимальном рассуждении думают минутами (на низких уровнях у них ожидание другое).
Flash разумнее соседей, если вы уже в экосистеме Google (AI Studio, Gemini Enterprise Agent Platform в Google Cloud, Sheets), нужен контекст на миллион токенов с картинками, звуком и видео на входе и важна цена токена в пакетном режиме.
Риски 3.8 Flash: многословность, неанглийские языки и цена 2027
Многословность и сбои. Расход токенов разобран в разделе о цене задачи. В model card Google также упоминает галлюцинации (уверенные ответы с выдуманными фактами) и «периодическую медлительность или тайм-ауты».
Регресс на неанглийских языках. В той же карточке модели Google публикует автоматические оценки безопасности относительно 3.7 Flash. Строка Multilingual Safety (соблюдение правил безопасности на разных языках) — +5,4 п.п., где «ниже — лучше», то есть стало хуже. Необоснованные отказы отвечать выросли на 1,1 п.п. Сама Google формулирует это так: безопасность на неанглийских языках «немного регрессировала».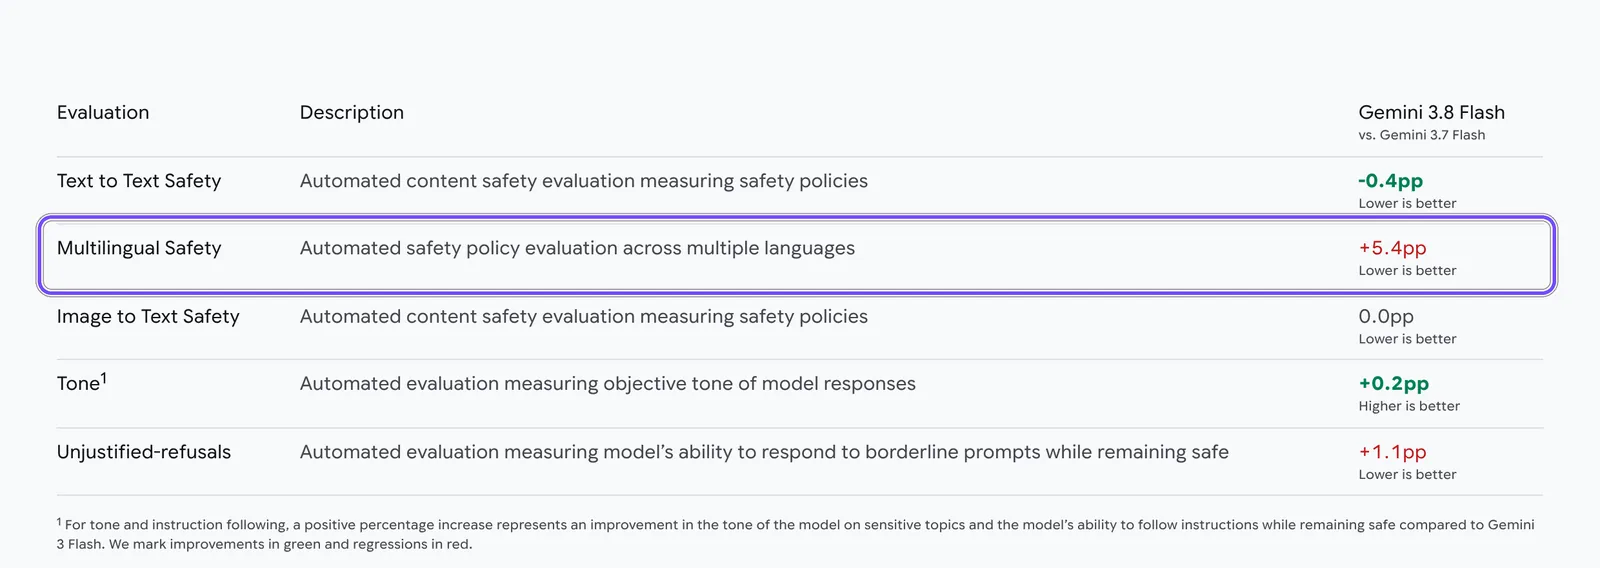
На скриншоте карточки модели (снят 2 ноября 2026 года) рамкой выделена строка Multilingual Safety — самый крупный регресс в таблице (второй — необоснованные отказы, +1,1 п.п.). Это оценка того, как модель соблюдает правила безопасности, а не качества текста на языке. Но для клиентских сценариев на русском и украинском это повод оставить проверку человеком: оценка автоматическая, а направление однозначное.
Цена 2027 года и данные бесплатного уровня. С 1 января 2027 года тариф удваивается, а бесплатный уровень отдаёт ваш контент на улучшение продуктов Google — оба пункта разобраны в разделе о цене. Удвоение тарифа — первое, что устареет в этом обзоре.
Тихие перенаправления. 3.7 Flash уже перенаправили на 3.8, а Flash выходят каждые несколько недель. Без явного идентификатора модели поведение и расход токенов могут поменяться без вашего ведома.
Жалобы пользователей за последний месяц. На Reddit 21 и 31 октября 2026 года в r/google_antigravity писали, что модель «регрессировала» и чаще галлюцинирует после обновления среды разработки; 26 октября пользователь SillyTavern жаловался, что она «долго думает и ничего не отвечает». Это отзывы без измерений, мы их не проверяли, но последняя жалоба совпадает с замером AA про долгое ожидание ответа.
Кому подойдёт Gemini 3.8 Flash, а кому лучше другая модель
Подойдёт:
- Фоновым кодовым агентам — терминал, правки в репозитории, ночные прогоны: по Terminal-Bench и SWE-bench Flash не хуже 3.1 Pro, а ожидание здесь не критично.
- Пакетной обработке — разбор документов, извлечение данных, разметка в Batch-режиме, который вдвое дешевле.
- Проверяющему «второму мнению» — недорогую Flash можно поставить аудитором, который перепроверяет работу большой модели. Такой сценарий описал один из участников Hacker News (его цитирует eesel): он проверял работу Opus ещё с помощью 3.7 Flash. Это единичный опыт, а не замер.
- Тем, кто уже в экосистеме Google — AI Studio, Antigravity, Gemini Enterprise Agent Platform в Google Cloud, Sheets, подписки AI Pro и Ultra.
Лучше другая модель:
- Чат с клиентом, где человек ждёт ответа, — 25 секунд до первого слова слишком долго.
- Сложное рассуждение и экспертные вопросы — 3.1 Pro или Gemini 4 Argon.
- Клиентские ответы на русском и украинском без модерации — на неанглийских языках модель соблюдает правила безопасности хуже, чем 3.7 Flash (+5,4 п.п. по автооценке Google).
- Максимальная экономия на сложных задачах — по цене задачи индекса AA Claude Haiku 5.5, MiniMax-M3.1-Flash и GPT-6.1 Terra в 8–19 раз дешевле.
FAQ
Сколько стоит Gemini 3.8 Flash и что будет с ценой в 2027 году?
На 2 ноября 2026 года — $0,75 за миллион входных токенов и $3,75 за миллион выходных, токены рассуждения оплачиваются как выходные. Это вводный тариф до 31 декабря 2026 года. С 1 января 2027 года цена удваивается: $1,50 и $7,50. Пакетный режим вдвое дешевле, а бесплатный уровень в API тоже есть, но с использованием данных для улучшения продуктов Google.
Правда ли, что Gemini 3.8 Flash быстрее Gemini 3.1 Pro?
По независимым замерам — нет. Artificial Analysis на 2 ноября 2026 года показывает, что 3.1 Pro Preview и печатает быстрее, и начинает отвечать примерно на семь секунд раньше, чем Flash в режиме high. Цифры 305 и 824 токена в секунду из других обзоров — это ранние или сторонние замеры в других условиях, с текущими данными AA их сравнивать нельзя.
Чем Gemini 3.8 Flash отличается от 3.7 Flash и надо ли переходить?
3.8 Flash — дообученная 3.7 Flash с той же ценой. По таблице Google она сильнее в агентных задачах: DeepSWE 73,7% против 65,3%, Terminal-bench 4.0 — 19,1% против 11,2%. Но она тратит больше токенов и хуже держит правила безопасности на неанглийских языках. Выбора в API почти нет: с 8 октября 2026 года запросы к 3.7 Flash перенаправляются на 3.8.
Есть ли у Gemini 3.8 Flash бесплатный доступ и что происходит с данными?
Да, модель входит в бесплатный уровень Gemini API и доступна в Google AI Studio, где видны и лимиты вашего проекта. Но на бесплатном уровне ваш контент может использоваться для улучшения продуктов Google, на платном — нет. Поэтому рабочие документы и данные клиентов разумнее отправлять через платный ключ.
Доступна ли Gemini 3.8 Flash из Украины?
Да. На 2 ноября 2026 года Украина есть в официальном списке регионов, где работают Google AI Studio и Gemini API: модель можно вызывать через API и пробовать в AI Studio. В приложении Gemini она открывается по подписке Google AI Pro или Ultra. Список регионов Google меняет, перед подключением сверьте страницу «Available regions».
Что такое Gemini 3.8 Flash Cyber и можно ли им пользоваться?
Gemini 3.8 Flash Cyber — отдельный вариант модели для задач кибербезопасности, который Google выпустила вместе с 3.8 Flash. Обычному пользователю он недоступен: Google открывает его только проверенным специалистам по защите через новую программу Fairwind. Это не то же самое, что gemini-3.8-flash в публичном API, и цифры из нашего обзора к нему не относятся.