Коротко (TL;DR)
Gemini 3.8 Flash — недорога модель Google для API, агентів і масових завдань, вийшла 2 вересня 2026 року. У цьому огляді ми звірили обіцянки Google з незалежними вимірами й перевірили дві популярні тези: «Flash швидша за Pro» і «Flash дешева». Власний прогін до цього матеріалу не ввійшов: усі висновки спираються на дані Google, Artificial Analysis (AA), Vals, LMArena і BenchLM, і біля кожної цифри вказано, чия вона.
- Коротко (TL;DR)
- Що за модель Gemini 3.8 Flash і чим вона замінила 3.7 Flash
- Ціна Gemini 3.8 Flash: $0,75 і $3,75 за 1M токенів до кінця 2026
- Швидкість і очікування: 131 токен/с, але 25 секунд до відповіді
- Ціна завдання на тесті AA: чому 3.8 Flash коштує майже як Argon
- Чи вистачить Gemini 3.8 Flash замість 3.1 Pro: тести за завданнями
- Бенчмарки: що підтверджено незалежно, а що самозвіт Google
- Чи переходити з Gemini 3.7 Flash на 3.8 Flash
- Gemini 3.8 Flash проти Haiku 5.5, GPT-6.1 Terra і MiniMax M3.1 Flash
- Ризики 3.8 Flash: багатослівність, неанглійські мови й ціна 2027
- Кому підійде Gemini 3.8 Flash, а кому краще інша модель
- Часті запитання
- Ціна токена низька, але тимчасово. $0,75 за мільйон вхідних токенів і $3,75 за мільйон вихідних — вступний тариф до 31 грудня 2026 року. З 1 січня 2027 року — $1,50 і $7,50.
- Завдання тесту AA — майже як у флагмана. За індексом AA v5.0 на 2 листопада 2026 року одне завдання тесту коштує Flash $7,77, а Gemini 4 Argon — $7,68. Водночас індекс у Flash 31, в Argon — 50. Причина — багатослівність: 130 млн токенів на тесті проти медіани 71 млн.
- «Швидша за Pro» не підтверджується. За AA Gemini 3.1 Pro Preview і друкує швидше, і починає відповідати раніше (подробиці — у розділі про швидкість).
- Де вистачає замість Pro: фоновий агентний код, робота в терміналі, пакетна обробка документів. Де не вистачає: складне міркування й живий діалог, де людина чекає на відповідь. Відповіді українською варто перевіряти: Google сама фіксує, що неанглійськими мовами модель гірше дотримується правил безпеки, ніж 3.7 Flash.
- Це не нова модель, а донавчена Gemini 3.7 Flash. Стару 3.7 Google уже зняла: запити до неї автоматично йдуть на 3.8.
Що за модель Gemini 3.8 Flash і чим вона замінила 3.7 Flash
Gemini 3.8 Flash — найновіша модель класу Flash, недорогого щабля лінійки Gemini (вище в лінійці — Pro і флагман Gemini 4 Argon). Ідентифікатор в API — gemini-3.8-flash, у загальний доступ (GA — generally available, тобто стабільна, а не тестова версія) Google вивела її 2 вересня 2026 року. Модель уміє «думати» перед відповіддю, приймає текст, зображення, звук і відео, а відповідає текстом.
Головне, що варто знати: це не нова база. В офіційній картці моделі від Google DeepMind (model card) прямо написано: «Gemini 3.8 Flash is based on Gemini 3.7 Flash», тобто модель побудована на 3.7 Flash і донавчена. Звідси й та сама ціна, що в попередниці, і темп випусків: сама Google називає 3.8 «третім релізом Flash лише за шість тижнів» (3.6 → 3.7 → 3.8).
Ключові параметри за документацією Google на 2 листопада 2026 року:

| Параметр | Gemini 3.8 Flash |
|---|---|
| Ідентифікатор в API | gemini-3.8-flash |
| Дата виходу (GA) | 2 вересня 2026 року |
| Вікно контексту (скільки тексту модель бачить за раз) | 1 048 576 токенів на вхід |
| Максимальна відповідь | 65 536 токенів |
| Рівні міркування (thinking) | low, medium (за замовчуванням), high; minimal повертає помилку |
| Межа знань | березень 2026 року; Google попереджає, що в частині тем знання можуть обриватися на січні 2025 року |
| Де доступна | Gemini API, Google AI Studio, Android Studio, Google Antigravity, Gemini Enterprise, застосунок Gemini (підписки AI Pro і Ultra), AI Mode у пошуку, Gemini в Google Sheets |
Токен — це шматок слова, у якому модель обчислює обсяг тексту й вартість. Англійське слово зазвичай займає один-два токени, українське — більше, тому та сама думка кирилицею коштує дорожче.
Зведення проти найближчих моделей Google на 2 листопада 2026 року (ціни — тариф Standard за 1 млн токенів, швидкість та індекс — Artificial Analysis):Gemini 3.8 Flash (high) Gemini 3.1 Pro Preview Gemini 4 Argon (high) Статус GA з 2.09.2026 preview з 19.02.2026 GA Ціна вхід / вихід $0,75 / $3,75 до 31.12.2026 $2 / $12 (запит до 200 тис. токенів) $2 / $10 до 30.11.2026, потім $4 / $20 Індекс AA v5.0 31 не пораховано 50 Ціна завдання індексу AA $7,77 н/д $7,68 Швидкість виведення 130,7 ток/с 143,2 ток/с 83 ток/с Очікування першого фрагмента 24,89 с 17,67 с 40,47 с
Вердикт: Flash — для фонових завдань, де важить ціна за токен, а не швидкість реакції. Економію оцінюйте за завданням, а не за прайсом.
Ціна Gemini 3.8 Flash: $0,75 і $3,75 за 1M токенів до кінця 2026
На 2 листопада 2026 року прайс Gemini API дає для Gemini 3.8 Flash вступний тариф: $0,75 за мільйон вхідних токенів і $3,75 за мільйон вихідних. На сторінці Gemini Developer API pricing рядки таблиці називаються Input price і Output price (including thinking tokens), і друге застереження важливе: токени міркування, які модель витрачає «про себе» перед відповіддю, оплачуються як вихідні, по $3,75. У переказах прайсу легко побачити тільки першу цифру й пропустити, що вихід коштує вп’ятеро дорожче за вхід.
На скриншоті сторінки цін Google (знято 2 листопада 2026 року) рамкою виділено обидві платні ціни й дату, з якої вони подвоюються.Тариф (за 1 млн токенів) До 31.12.2026 З 01.01.2027 Standard — вхід $0,75 $1,50 Standard — вихід (разом із міркуванням) $3,75 $7,50 Standard — кеш контексту $0,075 + зберігання $0,50 на годину $0,15 + зберігання $1,00 на годину Batch (пакетний режим) — вхід $0,375 $0,75 Batch — вихід $1,875 $3,75 Batch — кеш контексту $0,0375 $0,075 Безплатний рівень (Free Tier) безплатно, ліміти видно в AI Studio безплатно, ліміти видно в AI Studio
Batch — режим, у якому запити надсилають пачкою й обробляють без поспіху: відповідь приходить пізніше, зате вдвічі дешевше. Кеш контексту — знижка на повторно надісланий однаковий текст (наприклад, довгу інструкцію чи базу знань): за прайсом Google закешований токен у 10 разів дешевший за звичайний вхідний ($0,075 проти $0,75), але за зберігання кешу окремо беруть $0,50 за мільйон токенів на годину (з 1 січня 2027 року — $1,00).
Наш розрахунок: мільйон токенів на вхід плюс мільйон на вихід.



- Зараз: $0,75 + $3,75 = $4,50.
- З 1 січня 2027 року: $1,50 + $7,50 = $9,00.
- У пакетному режимі зараз: $0,375 + $1,875 = $2,25.
- Для порівняння, Gemini 3.1 Pro Preview: $2 + $12 = $14 (для запитів до 200 тис. токенів; довших — $4 за вхід і $18 за вихід).
Приклад на типовому навантаженні: 1000 запитів по 20 тис. вхідних і 3 тис. вихідних токенів — приблизно стільки видає на відповідь модель із «середньою» балакучістю. Вхід — 20 млн токенів × $0,75 = $15, вихід — 3 млн × $3,75 = $11,25, разом $26,25 до кінця 2026 року і $52,50 після. Якщо ж Flash на ваших завданнях виявиться багатослівнішою за медіану так само, як на тесті AA (130 млн проти 71 млн, приблизно в 1,8 раза), вихід зросте до 5,5 млн токенів, а рахунок — приблизно до $35,60 за нинішнім тарифом. Це наша арифметика за прайсом Google, а не вимір.
Безплатний рівень Gemini API включає 3.8 Flash, але має ціну іншого роду: у прайсі Google у рядку «Used to improve our products» для безплатного рівня стоїть «Yes», для платного — «No». Простіше кажучи, те, що ви надсилаєте безплатно, може використовуватися для вдосконалення продуктів Google. Конкретних лімітів безплатного рівня для 3.8 Flash Google у документації не наводить: на сторінці rate limits сказано, що чинні ліміти проєкту видно в Google AI Studio (перевірено 2 листопада 2026 року). Клієнтські дані й робочі документи через безплатний ключ краще не ганяти.
Швидкість і очікування: 131 токен/с, але 25 секунд до відповіді
Швидкість моделі описують дві різні цифри. Перша — скільки токенів за секунду вона друкує, коли вже почала відповідати. Друга — скільки секунд ви чекаєте на перший фрагмент відповіді. У «думаючої» моделі друга цифра включає час міркування, і для людини біля екрана вона важливіша за першу.
За AA на 2 листопада 2026 року Gemini 3.8 Flash у режимі high друкує 130,7 токена за секунду, але перший фрагмент відповіді приходить через 24,89 секунди, а повна відповідь на тестовий запит — через 28,71 секунди. Gemini 3.1 Pro Preview на тому самому майданчику: 143,2 токена за секунду, 17,67 секунди до першого фрагмента й 21,16 секунди до повної відповіді. Теза «Flash швидша за Pro» на цих даних не підтверджується.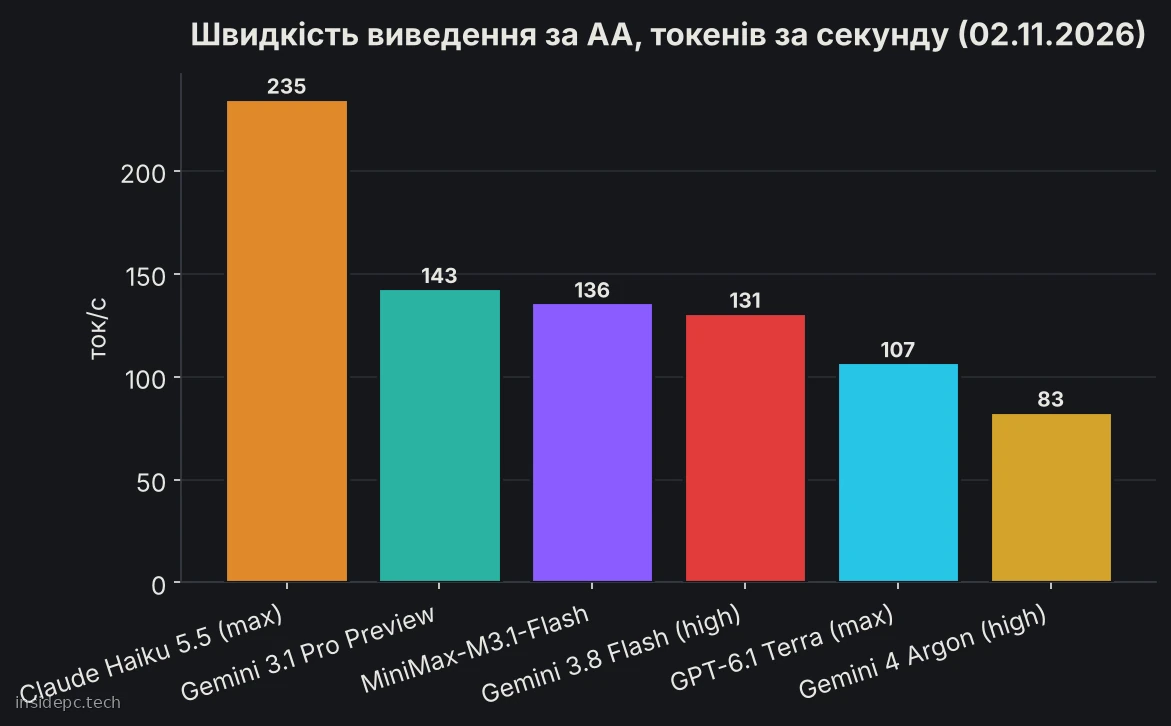
На графіку Flash стоїть у середині ряду: помітно швидша за Gemini 4 Argon і GPT-6.1 Terra, але повільніша за 3.1 Pro, MiniMax-M3.1-Flash і Claude Haiku 5.5.
Чому в оглядах трапляються зовсім інші цифри — 305 і навіть 824 токени за секунду? Це різні виміри в різних умовах:Джерело Коли Швидкість виведення Очікування відповіді Умови AA, Flash (high) 2 листопада 2026 130,7 ток/с 24,89 с до першого фрагмента незалежний вимір через API Google AA в переказі eesel 8 вересня 2026 305,1 ток/с 13,30 с до першого токена вимір перших днів після релізу OrcaRouter н/д 824 ток/с 8057 мс — медіана затримки власний вимір шлюзу-посередника
Цифри розходяться через режим міркування, провайдера, день виміру й методику, тому ми спираємося на свіжий незалежний вимір AA. Ще у вересні eesel звертав увагу: висока швидкість друку не означає швидкої реакції — медіанна «думаюча» модель того самого цінового класу тоді починала відповідати через 2,99 секунди проти 13,30 у Flash.
На практиці фоновому агенту, який уночі розбирає чергу завдань, 25 секунд очікування байдужі. Людині в чаті підтримки 25 секунд тиші перед кожною відповіддю — задовго.
Ціна завдання на тесті AA: чому 3.8 Flash коштує майже як Argon
Ціна за токен схожа на ціну літра бензину, а ціна завдання — на вартість усієї поїздки. Дешевий літр не допоможе, якщо машина витрачає вдвічі більше. Google сама попереджає в анонсі, що модель «іноді може використовувати більше токенів, щоб вичавити максимум якості, особливо на високих рівнях зусилля».
Artificial Analysis це й виміряв. На прогоні свого індексу v5.0 (дев’ять тестів — від роботи в терміналі до експертних запитань) Gemini 3.8 Flash у режимі high згенерувала 130 млн токенів за медіани 71 млн у порівнянних моделей. Вхідний токен у неї дешевший за медіану ($0,75 проти $2,00), вихідний теж ($3,75 проти $10,00) — і все одно одне завдання індексу в середньому коштувало $7,77.
На скриншоті сторінки AA (2 листопада 2026 року) рамкою виділено картки, на яких тримається висновок: $7,77 за завдання за прайсу $0,75/$3,75 і 130 млн токенів витрати.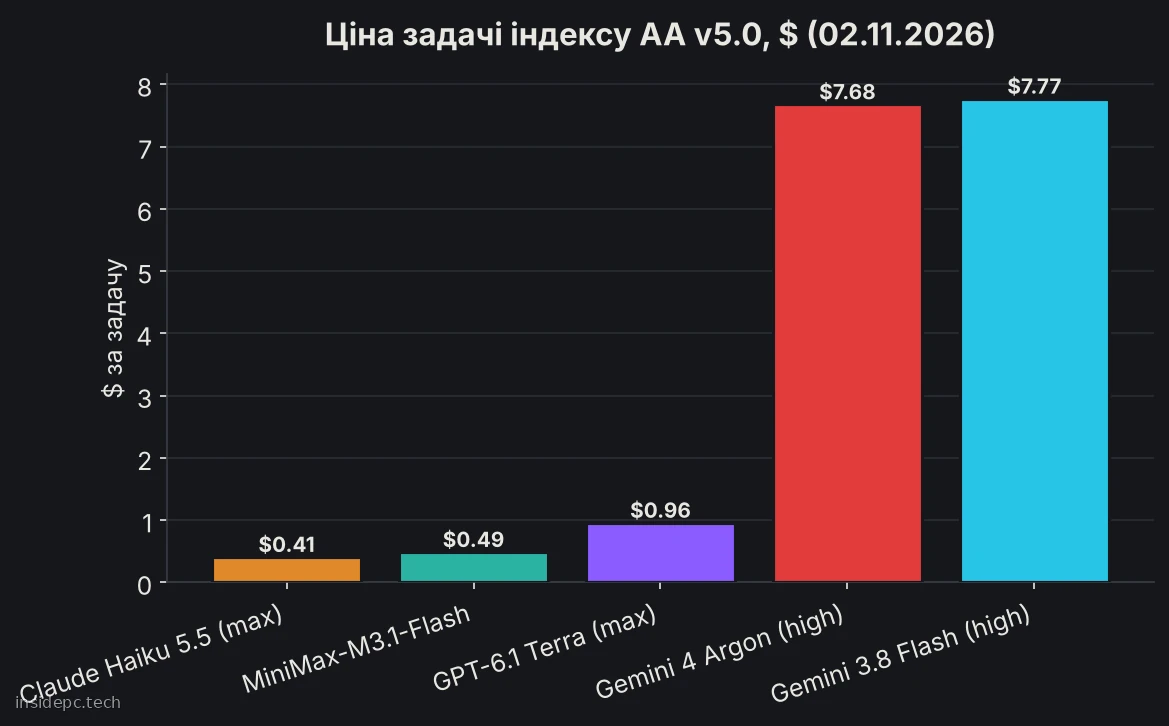
Висновок із графіка: на завданнях цього тесту Gemini 3.8 Flash у режимі high коштує майже стільки ж, скільки флагман Gemini 4 Argon, а набирає 31 бал проти 50. Claude Haiku 5.5, GPT-6.1 Terra і MiniMax M3.1 Flash виконують завдання тесту у 8–19 разів дешевше. Застереження щодо MiniMax: в окремому нашому огляді цієї моделі стоять індекс 43 і $0,22 за завдання — це цифри попередньої версії індексу AA, за версією v5.0 у неї 29 балів і $0,49. Цифри різних версій змішувати не можна.
Друге застереження: тест AA — складні багатокрокові завдання. На коротких запитах на кшталт класифікації багатослівність проявляється менше. Тому перед перенесенням навантаження на 3.8 Flash проженіть сотню своїх типових запитів і подивіться на витрату токенів у звіті білінгу.
Зменшити витрату допомагає рівень міркування low або medium замість high. За тим самим AA індекс Flash у режимі Low — 22 проти 31 у режимі high: якість помітно падає, але й токенів іде менше. На запитання з Reddit від 31 жовтня «який рівень брати» логіка тарифу підказує: починати з medium (він стоїть за замовчуванням), опускатися до low на простих масових завданнях і вмикати high там, де помилка дорожча за зайві токени. Це рекомендація, а не результат нашого тесту.
Чи вистачить Gemini 3.8 Flash замість 3.1 Pro: тести за завданнями
Коротко про пару Gemini 3.8 Flash vs 3.1 Pro: в агентному коді й роботі в терміналі Flash не поступається Pro і в рази дешевша за токен, а у складному міркуванні та швидкості реакції Pro досі попереду. Єдиного порівняння немає: Gemini 3.1 Pro з 19 лютого 2026 року залишається в статусі preview, і індекс AA v5.0 для неї не пораховано.
Тому порівняння Gemini 3.8 Flash vs Pro зібране з окремих тестів, і в кожної цифри — свій майданчик і свій режим:Клас завдань Цифри (Flash проти 3.1 Pro) Джерело й застереження Чи вистачає Flash Агентний код у терміналі Terminal-Bench 2.1: 81,3% проти 70,8% BenchLM за даними Vals, 29.10.2026 так Виправлення багів у репозиторії SWE-bench: 80,0% проти 78,8% BenchLM за даними Vals, 29.10.2026 так Складний термінал (нова версія тесту) Terminal-Bench 4.0: 10% проти 4% AA, Flash у режимі Low, 02.11.2026 так Автоматизація робочих процесів AutomationBench-AA: 37% проти 35% AA, Flash у режимі Low так, нарівні Офісна робота зі знаннями й документами AA-Briefcase v1.1: 1062 проти 457 (рейтинг Elo від AA, більше — краще); GDP.pdf: 19% проти 18% AA, Flash у режимі Low так Експертне міркування HLE-Diamond: 24% проти 31% AA, Flash у режимі Low ні, краще Pro або Argon Живий чат, де людина чекає 24,89 с проти 17,67 с до першого фрагмента AA, 02.11.2026 ні Ціна 1 млн вхід + 1 млн вихід $4,50 проти $14 прайс Google на 02.11.2026 так, поки діє вступний тариф
Загальний бал агрегатора BenchLM на 29 жовтня 2026 року — 66,22 у Flash проти 64,41 у Pro, але сам BenchLM попереджає, що діапазони оцінок «не встановлюють упевненості в ранзі». Тобто різниця у два пункти — не доказ переваги. У користувацькому рейтингу LMArena (людям показують дві анонімні відповіді й просять вибрати кращу) на 2 листопада 2026 року gemini-3.8-flash-high посідає 8-ме місце в загальному текстовому заліку, gemini-3.1-pro-preview — 15-те. У категорії експертних запитань картина протилежна: у Flash 28-ме місце, у Pro — 21-ше.
Підсумок: для фонового агента, коду, документів і пакетної обробки Flash вистачає, і за токен вона дешевша за Pro у 2,7–3,2 раза. Для глибокого міркування й швидкої першої відповіді краще Pro — або Argon, новий флагман Google, який на відміну від 3.1 Pro вже вийшов у загальний доступ.
Бенчмарки: що підтверджено незалежно, а що самозвіт Google
Бенчмарк (англ. benchmark) — стандартний набір завдань, на якому моделі на зразок Gemini 3.8 Flash порівнюють між собою. Проблема в тому, що виробник сам обирає, які тести показати. Тому цифри нижче поділено на дві групи: що опублікувала Google і що виміряли незалежні майданчики.Тест Результат 3.8 Flash Для порівняння Хто виміряв HLE-Verified (експертні запитання) 54,9% Claude Opus 5 — 54,4%, 3.7 Flash — 53,6% Google (самозвіт) DeepSWE v1.1 (довга розробка) 73,7% Claude Opus 5 — 74,0%, 3.7 Flash — 65,3% Google (самозвіт) Terminal-bench 4.0 (агент у терміналі) 19,1% Claude Opus 5 — 51,8%, 3.7 Flash — 11,2% Google (самозвіт) HLE-Diamond (експертні запитання) 24% у режимі Low 3.1 Pro Preview — 31% AA, 02.11.2026 Intelligence Index AA v5.0 31, #39 із 59 медіана порівнянних моделей — 38, Argon — 50 AA, 02.11.2026 Vals Index 55,95%, #18 із 32 $5,026 за прогін тесту Vals AI, 02.11.2026 LMArena, текст, загальний залік 8-ме місце 3.1 Pro Preview — 15-те LMArena, 02.11.2026
У таблиці Google на експертних запитаннях HLE-Verified Flash навіть трохи вища за Claude Opus 5 (54,9% проти 54,4%). Але на незалежному експертному тесті HLE-Diamond в AA та сама модель у режимі Low поступається 3.1 Pro: 24% проти 31%. Тести й режими різні, але контраст показовий. А на Terminal-bench 4.0 Flash навіть у таблиці Google відстає від Opus 5 більш ніж у два з половиною рази. Теза «Flash наздоганяє флагмани» правдива на вибраних тестах, а не загалом.
Незалежні майданчики ставлять модель нижче середини: 39-те місце з 59 в індексі AA (сам AA називає результат нижчим за середній для порівнянних моделей) і 18-те з 32 в індексі Vals. Ціни завдання на майданчиках ($7,77 в AA і $5,026 у Vals) обчислюються на різних наборах завдань і між собою не порівнюються.
Ще одна пастка — версії шкали. У вересневих оглядах (наприклад, в eesel від 8 вересня 2026 року) трапляється індекс AA 59. Це попередня версія шкали, а не «падіння» моделі: зараз AA обчислює індекс v5.0 з дев’яти тестів.
Чи переходити з Gemini 3.7 Flash на 3.8 Flash
Порівняння Gemini 3.8 vs 3.7 Flash в API вже втратило практичний сенс. У changelog Gemini API в записі від 8 жовтня 2026 року Google пише, що gemini-3.7-flash знято з підтримки: в AI Studio її більше не можна вибрати, а запити до неї через API автоматично йдуть на gemini-3.8-flash.
На старті ситуація була іншою. У самому анонсі 2 вересня Google радила тим, для кого головне — економія обчислень, «і далі покладатися на Gemini 3.7 Flash», яка «залишається повністю підтримуваною» для таких завдань. За п’ять тижнів цей вибір зник.Gemini 3.7 Flash Gemini 3.8 Flash Ціна вхід / вихід $0,75 / $3,75 $0,75 / $3,75 до 31.12.2026 DeepSWE v1.1 (Google) 65,3% 73,7% Terminal-bench 4.0 (Google) 11,2% 19,1% Безпека неанглійськими мовами базова лінія гірше на 5,4 в.п. Витрата токенів менша (за словами Google) більша, особливо в режимі high Статус в API знята 8.10.2026, запити йдуть на 3.8 актуальна версія
Що зробити, якщо у вашому коді була 3.7 Flash:
- Явно пропишіть
gemini-3.8-flash— щоб розуміти, яка модель відповідає, і не потрапити під наступне тихе перенаправлення. - Переміряйте витрату токенів на своїх запитах: за тієї самої ціни за токен рахунок може зрости через багатослівність.
- Перевірте рівень міркування: якщо в коді стояв
minimal, у 3.8 Flash він повертає помилку — допустимі лишеlow,mediumіhigh. - Перевіряйте відповіді українською — у 3.8 зафіксовано регрес безпеки неанглійськими мовами (докладніше в розділі ризиків).
Gemini 3.8 Flash проти Haiku 5.5, GPT-6.1 Terra і MiniMax M3.1 Flash
У своєму класі «швидких і недорогих» Gemini 3.8 Flash не найдешевша й не найрозумніша. Ось як виглядають сусіди за таблицею AA на 2 листопада 2026 року (індекс v5.0, режими міркування — у дужках):Модель Індекс AA v5.0 Ціна завдання індексу Швидкість виведення Очікування першого фрагмента GPT-6.1 Terra (max) 51 $0,96 107 ток/с 264,33 с Gemini 4 Argon (high) 50 $7,68 83 ток/с 40,47 с Claude Haiku 5.5 (max) 36 $0,41 235 ток/с 370,08 с Gemini 3.8 Flash (high) 31 $7,77 131 ток/с 24,89 с MiniMax-M3.1-Flash 29 $0,49 136 ток/с 0,90 с 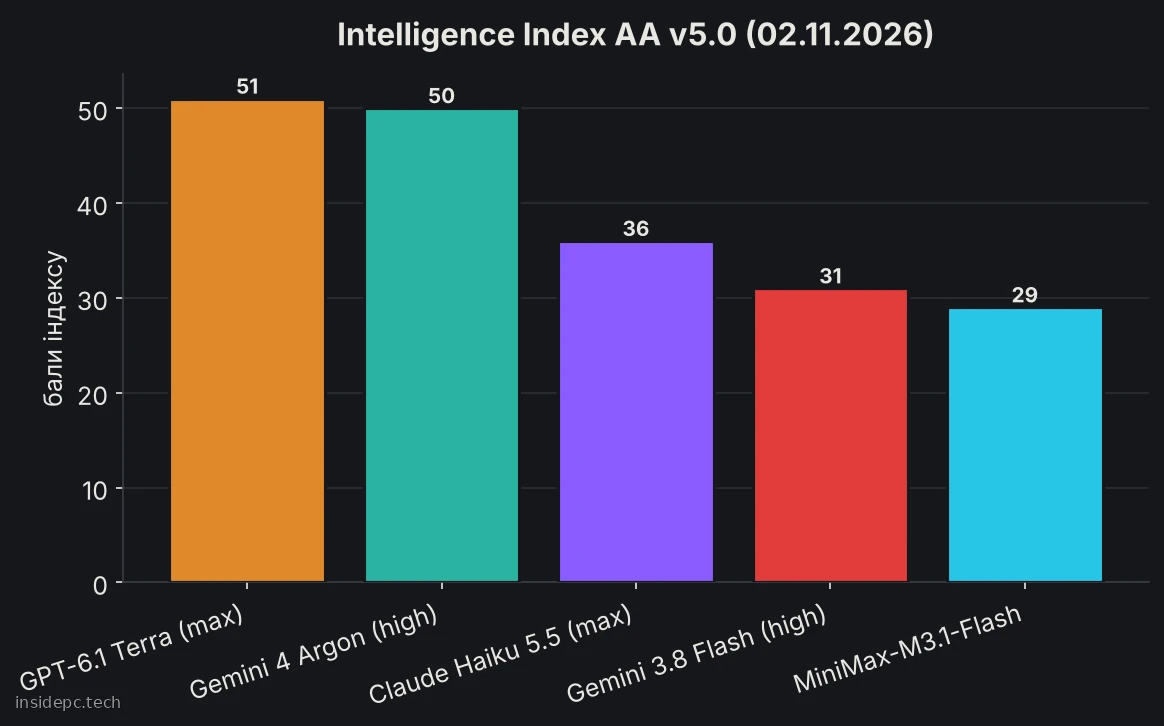
За індексом Flash випереджає лише MiniMax-M3.1-Flash, а за ціною завдання програє всім, крім Argon. Її козир тут — порівняно коротке очікування в режимі high: Haiku 5.5 і GPT-6.1 Terra на максимальному міркуванні думають хвилинами (на нижчих рівнях очікування в них інше).
Flash доречніша за сусідів, якщо ви вже в екосистемі Google (AI Studio, Gemini Enterprise Agent Platform у Google Cloud, Sheets), потрібен контекст на мільйон токенів із зображеннями, звуком і відео на вході й важить ціна токена в пакетному режимі.
Ризики 3.8 Flash: багатослівність, неанглійські мови й ціна 2027
Багатослівність і збої. Витрату токенів розібрано в розділі про ціну завдання. У model card Google також згадує галюцинації (упевнені відповіді з вигаданими фактами) і «періодичну повільність або тайм-аути».
Регрес неанглійськими мовами. У тій самій картці моделі Google публікує автоматичні оцінки безпеки відносно 3.7 Flash. Рядок Multilingual Safety (дотримання правил безпеки різними мовами) — +5,4 в.п., де «нижче — краще», тобто стало гірше. Необґрунтовані відмови відповідати зросли на 1,1 в.п. Сама Google формулює це так: безпека неанглійськими мовами «трохи регресувала».
На скриншоті картки моделі (знято 2 листопада 2026 року) рамкою виділено рядок Multilingual Safety — найбільший регрес у таблиці (другий — необґрунтовані відмови, +1,1 в.п.). Це оцінка того, як модель дотримується правил безпеки, а не якості тексту мовою. Але для клієнтських сценаріїв українською це привід залишити перевірку людиною: оцінка автоматична, а напрям однозначний.
Ціна 2027 року й дані безплатного рівня. З 1 січня 2027 року тариф подвоюється, а безплатний рівень віддає ваш контент на вдосконалення продуктів Google — обидва пункти розібрано в розділі про ціну. Подвоєння тарифу — перше, що застаріє в цьому огляді.
Тихі перенаправлення. 3.7 Flash уже перенаправили на 3.8, а Flash виходять що кілька тижнів. Без явного ідентифікатора моделі поведінка й витрата токенів можуть змінитися без вашого відома.
Скарги користувачів за останній місяць. На Reddit 21 і 31 жовтня 2026 року в r/google_antigravity писали, що модель «регресувала» й частіше галюцинує після оновлення середовища розробки; 26 жовтня користувач SillyTavern скаржився, що вона «довго думає і нічого не відповідає». Це відгуки без вимірів, ми їх не перевіряли, але остання скарга збігається з виміром AA про довге очікування відповіді.
Кому підійде Gemini 3.8 Flash, а кому краще інша модель
Підійде:
- Фоновим кодовим агентам — термінал, правки в репозиторії, нічні прогони: за Terminal-Bench і SWE-bench Flash не гірша за 3.1 Pro, а очікування тут не критичне.
- Пакетній обробці — розбір документів, видобування даних, розмітка в Batch-режимі, який удвічі дешевший.
- Для «другої думки» — недорогу Flash можна поставити аудитором, який перевіряє роботу великої моделі. Такий сценарій описав один з учасників Hacker News (його цитує eesel): він перевіряв роботу Opus ще за допомогою 3.7 Flash. Це поодинокий досвід, а не вимір.
- Тим, хто вже в екосистемі Google — AI Studio, Antigravity, Gemini Enterprise Agent Platform у Google Cloud, Sheets, підписки AI Pro і Ultra.
Краще інша модель:
- Чат із клієнтом, де людина чекає на відповідь, — 25 секунд до першого слова задовго.
- Складне міркування й експертні запитання — 3.1 Pro або Gemini 4 Argon.
- Клієнтські відповіді українською без модерації — неанглійськими мовами модель дотримується правил безпеки гірше, ніж 3.7 Flash (+5,4 в.п. за автооцінкою Google).
- Максимальна економія на складних завданнях — за ціною завдання індексу AA Claude Haiku 5.5, MiniMax-M3.1-Flash і GPT-6.1 Terra у 8–19 разів дешевші.
Часті запитання
Скільки коштує Gemini 3.8 Flash і що буде з ціною у 2027 році?
На 2 листопада 2026 року — $0,75 за мільйон вхідних токенів і $3,75 за мільйон вихідних, токени міркування оплачуються як вихідні. Це вступний тариф до 31 грудня 2026 року. З 1 січня 2027 року ціна подвоюється: $1,50 і $7,50. Пакетний режим удвічі дешевший, а безплатний рівень в API теж є, але з використанням даних для вдосконалення продуктів Google.
Чи правда, що Gemini 3.8 Flash швидша за Gemini 3.1 Pro?
За незалежними вимірами — ні. Artificial Analysis на 2 листопада 2026 року показує, що 3.1 Pro Preview і друкує швидше, і починає відповідати приблизно на сім секунд раніше, ніж Flash у режимі high. Цифри 305 і 824 токени за секунду з інших оглядів — це ранні або сторонні виміри в інших умовах, із поточними даними AA їх порівнювати не можна.
Чим Gemini 3.8 Flash відрізняється від 3.7 Flash і чи треба переходити?
3.8 Flash — донавчена 3.7 Flash із тією самою ціною. За таблицею Google вона сильніша в агентних завданнях: DeepSWE 73,7% проти 65,3%, Terminal-bench 4.0 — 19,1% проти 11,2%. Але вона витрачає більше токенів і гірше тримає правила безпеки неанглійськими мовами. Вибору в API майже немає: з 8 жовтня 2026 року запити до 3.7 Flash перенаправляються на 3.8.
Чи є в Gemini 3.8 Flash безплатний доступ і що відбувається з даними?
Так, модель входить до безплатного рівня Gemini API й доступна в Google AI Studio, де видно й ліміти вашого проєкту. Але на безплатному рівні ваш контент може використовуватися для вдосконалення продуктів Google, на платному — ні. Тому робочі документи й дані клієнтів розумніше надсилати через платний ключ.
Чи доступна Gemini 3.8 Flash з України?
Так. На 2 листопада 2026 року Україна є в офіційному списку регіонів, де працюють Google AI Studio і Gemini API: модель можна викликати через API й пробувати в AI Studio. У застосунку Gemini вона відкривається за підпискою Google AI Pro або Ultra. Список регіонів Google змінює, перед підключенням звірте сторінку «Available regions».
Що таке Gemini 3.8 Flash Cyber і чи можна ним користуватися?
Gemini 3.8 Flash Cyber — окремий варіант моделі для завдань кібербезпеки, який Google випустила разом із 3.8 Flash. Звичайному користувачеві він недоступний: Google відкриває його лише перевіреним фахівцям із захисту через нову програму Fairwind. Це не те саме, що gemini-3.8-flash у публічному API, і цифри з нашого огляду до нього не стосуються.