Коротко (TL;DR)
- Редагування голосу нейромережею — це три різні завдання: замінити слово в готовому записі, прибрати шум і змінити тембр. Їх розв’язують різні інструменти, а пошукова видача зазвичай зводить усе до однієї «зміни голосу».
- Відома заміна слів у Descript для української не працює. Функція Regenerate (раніше мала назву Overdub) підтримує лише англійську.
- Для української підтримку прямо заявляє лише ElevenLabs: Voice Changer — 29 мов, серед них українська. Незалежних вимірювань якості цими мовами ми не знайшли.
- Шумодав — найзріліша й найбезпечніша частина. Adobe Enhance Speech безкоштовно чистить до години запису на день, Auphonic — 2 години на місяць. Проте сильна обробка «перезбирає» голос, тож результат треба перевіряти на слух.
- Клон — найризикованіша частина. Професійно клонувати чужий голос ElevenLabs не дає навіть зі згодою, а в ЄС від 2 серпня 2026 року клон, який видає себе за живе мовлення, треба розкривати.
Як ШІ виправляє готовий голос: три завдання і три класи інструментів
Редагування голосу в готовому записі — це виправлення вже зробленого подкасту, відео чи озвучення без повторного походу в студію. Зручна аналогія — ретуш фотографії: прибрати пляму (шум), підправити деталь (слово) або змінити освітлення повністю (тембр). Кожне з трьох завдань має свій механізм, свої інструменти і свій рівень ризику. Тому універсальної програми для редагування голосу, яка однаково добре робить усе, немає.
- Коротко (TL;DR)
- Як ШІ виправляє готовий голос: три завдання і три класи інструментів
- Замінити слово в записі: клон голосу замість перезапису
- Descript Regenerate: лише англійська і лише власний голос
- ElevenLabs Studio і Voice Changer: що є для української мови
- Шумодав: Adobe Enhance Speech, Auphonic, Krisp, DeepFilterNet
- Коли шумодав псує голос: як перевірити обробку на слух
- Відкриті моделі: AuK, DeepFilterNet і Resemble Enhance на своєму ПК
- Скільки коштує хвилина правок: Descript, ElevenLabs, Auphonic, Adobe
- Ризики клону голосу: згода, дипфейк, AI Act, США і Данія
- Що ми перевірили, а чого ні: без власних аудіотестів українською
- Який інструмент обрати: таблиця рішень за завданням
- Часті запитання про редагування голосу за допомогою ШІ
- Заміна слів через текст. Запис перетворюється на транскрипт — текстову розшифровку мовлення. Ви редагуєте текст, а модель досинтезовує нові слова голосом клону. Приклади — Descript Regenerate, ElevenLabs Studio, Vrew Speech Editor.
- Шумодав. Нейромережа відокремлює голос від тла: гулу, вулиці, луни кімнати. Слова й тембр лишаються вашими, хоча за сильної обробки голос теж змінюється.
- Зміна тембру (voice changer, або speech-to-speech). Модель бере ваш запис і переозвучує його іншим голосом, зберігаючи інтонацію та паузи. Слова при цьому не змінюються.
| Завдання | Що змінюється в записі | Приклади інструментів | Українська | Ризик |
|---|---|---|---|---|
| Замінити слово | Окремі слова й фрази | Descript Regenerate, ElevenLabs Studio, Vrew | Descript — лише англійська; ElevenLabs — заявлено вендором; Vrew — н/д | Середній: потрібен клон голосу |
| Прибрати шум | Тло, луна, іноді тембр | Adobe Enhance Speech, Auphonic, Krisp, DeepFilterNet | Adobe називає інструмент незалежним від мови; вимірювань для української немає | Низький |
| Змінити тембр | Голос повністю | ElevenLabs Voice Changer | 29 мов, зокрема українська, заявлено вендором | Високий: близько до дипфейку |
Головний висновок таблиці: шумодав доступний майже кожному і, за заявою Adobe, майже будь-якою мовою, а от заміна слів і зміна тембру впираються в мову та в клон голосу. Далі розбираємо кожне завдання по черзі.
Замінити слово в записі: клон голосу замість перезапису
Заміна слова через текст влаштована як ланцюжок із чотирьох кроків. Сервісу потрібні і розпізнавач мовлення, і клон голосу — копія вашого тембру, навчена на зразку запису.
- Розпізнавання мовлення. Сервіс робить транскрипт і прив’язує кожне слово до відрізка аудіо.
- Редагування тексту. Ви закреслюєте невдале слово і вписуєте потрібне, як у текстовому редакторі.
- Синтез. Модель озвучує новий фрагмент вашим клоном з урахуванням сусідніх слів.
- Склеювання. Новий шматок вбудовується між старими так, щоб не було чутно шва: збігаються гучність, дихання і темп.
Клон нейромережа будує за зразком запису, і від його тривалості залежить якість. ElevenLabs для миттєвого клону (Instant Voice Cloning) потребує 1–2 хвилини чистого звуку, для професійного (Professional Voice Cloning) — від 30 до 180 хвилин.
Метод має природну межу довжини. Редакція Toolradar у своєму гайді пише, що такі функції добре працюють на окремих словах і коротких фразах, а довгі згенеровані шматки звучать помітно синтетично. Це думка редакції, а не вимірювання. Descript обмежує одну операцію 250 символами, тобто фразою-двома. Практичне правило: замінюйте обмовку, цифру чи ім’я, а абзац краще перезаписати.
Descript Regenerate: лише англійська і лише власний голос
Descript — відеоредактор, у якому запис редагують як документ. Функцію заміни слів у ньому довго знали як Overdub. Тепер вона має назву Regenerate, а в трекері побажань самої Descript пишуть «Regenerate (fka Overdub)», тобто «раніше Overdub». Чимало оглядів досі зводять Descript до схеми «клонував голос — міняєш слова». Для українського запису це не працює.
Довідка Descript говорить про обмеження прямо: Regenerate підтримує лише англійське аудіо та відео. Ми перевірили сторінку 2 листопада 2026 року, кадр нижче.
Рамкою виділено рядок «Regenerate currently supports English audio and video only» — саме він закриває питання про українську. Обмеження функції на 2 листопада 2026 року:Параметр Descript Regenerate Мова заміни слів Лише англійська Транскрипція української Немає в списках; Descript підтримує лише мови на латиниці Голос для редагування Лише власний клон, авторизований мовцем; стокові голоси не можна Довжина за одну операцію До 250 символів Тариф із клонами та Regenerate Hobbyist: $16 на місяць за річної оплати або $24 щомісяця, на 2 листопада 2026 року
Цікава деталь: синтез мовлення в самій Descript працює на трьох моделях ElevenLabs — Multilingual v2, v3 і v4. Тому, якщо вам потрібен клон голосу для виправлення українського запису, логічніше одразу дивитися на ElevenLabs, а не чекати нових мов у Descript. Запит користувачів на інші мови висить у трекері Descript зі статусом «на розгляді» (under consideration).
ElevenLabs Studio і Voice Changer: що є для української мови
ElevenLabs — сервіс синтезу і клонування мовлення. Це єдиний шлях, де вендор прямо називає українську в списку підтримуваних мов. Варто одразу застерегти: це заява вендора. Незалежних вимірювань якості цими мовами ми не знайшли, власних прогонів не робили.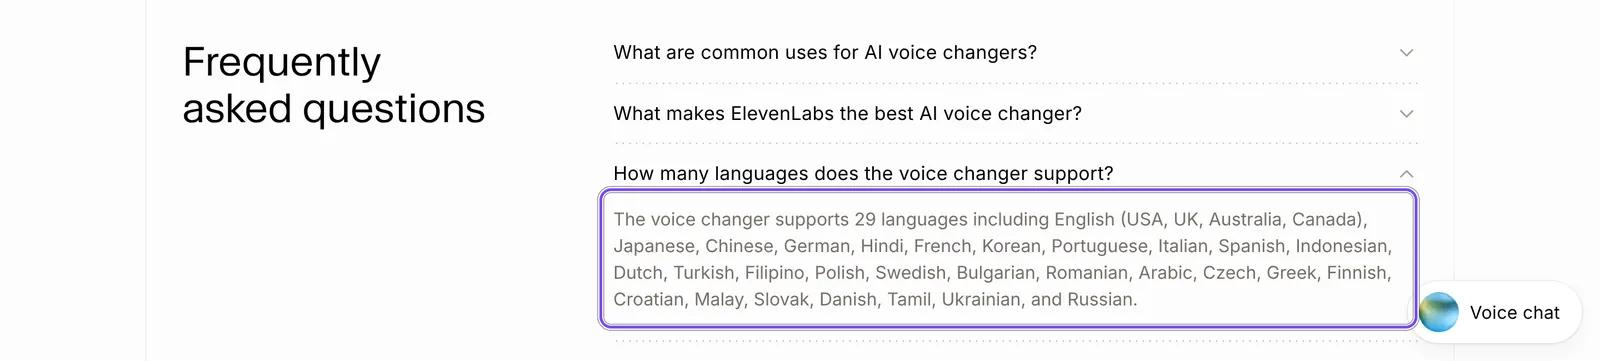
На кадрі зі сторінки Voice Changer (знято 2 листопада 2026 року) рамкою виділено відповідь із FAQ: інструмент підтримує 29 мов, останні в списку — Ukrainian і Russian. Для редагування голосу онлайн ElevenLabs має три інструменти, і розв’язують вони різні завдання:
- Studio — заміна слів через текст. Маркетингова сторінка Studio обіцяє: змінюєте сценарій — студія заново синтезує той самий голос. Довідка уточнює, що можна виділити одне чи кілька слів і згенерувати заново лише їх. Застереження: опція з’являється, коли для абзацу вже згенеровано аудіо. Тобто сценарій розрахований на озвучення, зроблене в Studio клоном, а не на будь-який живий запис.
- Voice Changer — зміна тембру. Ви завантажуєте запис, сервіс переозвучує його іншим голосом із вашою інтонацією. Ліміт — до 5 хвилин аудіо за одну конвертацію.
- Voice Isolator — шумодав. Відокремлює голос від тла і коштує стільки ж кредитів, скільки Voice Changer.
| Studio | Voice Changer | Voice Isolator | |
|---|---|---|---|
| Завдання | Замінити слова | Змінити тембр | Прибрати шум |
| Що потрібно | Клон голосу і текст | Запис і цільовий голос | Запис |
| Мови | Заявлено вендором; українську в довідці Studio окремо не названо | 29, зокрема українська | Н/д: вендор мов не перелічує |
| Обмеження | Повторна генерація слів в уже озвученому абзаці | До 5 хвилин за раз | Файл до 1 години і 500 МБ |
| Вартість | Кредити за символи синтезу | 1000 кредитів за хвилину | 1000 кредитів за хвилину |
Окрема тема — переклад відео іншою мовою тим самим голосом. Це вже не редагування, а дубляж, і влаштований він інакше: свої мови і свої ціни, їх ми розбирали в огляді ElevenLabs Dubbing v1 і v2.
Шумодав: Adobe Enhance Speech, Auphonic, Krisp, DeepFilterNet
Шумодав — нейромережа, яка відокремлює мовлення від усього іншого. Саме вона допомагає прибрати фоновий шум з аудіо: гул кондиціонера, вулицю, луну порожньої кімнати. Це найдоступніший із трьох класів інструментів: слів він не змінює, а голос лишається вашим.
Прибрати шум з аудіо онлайн можна просто в браузері: Adobe Enhance Speech і Auphonic не треба встановлювати на комп’ютер. Krisp — інший клас: він чистить звук у реальному часі, під час дзвінка чи запису, а не готовий файл. DeepFilterNet — відкрита модель для власного ПК, про неї нижче.Інструмент Тип Безкоштовно Мова Ліцензія і застереження Adobe Enhance Speech Онлайн, готовий файл Файл до 30 хвилин і 500 МБ, до 1 години на день Adobe: «language agnostic»; вимірювань для української немає Лише аудіо на безкоштовному плані Auphonic Онлайн, готовий файл 2 години обробки на місяць Н/д Безкоштовні файли йдуть із джинглом Auphonic Krisp Реальний час 7-денний пробний період Н/д Шумодав входить у кожен тариф ElevenLabs Voice Isolator Онлайн, готовий файл 10 хвилин на місяць (наш розрахунок) Н/д Кредити спільні з усіма функціями DeepFilterNet Відкрита модель Безкоштовно Н/д MIT або Apache 2.0; лише WAV 48 кГц
Ліміти вказано на 2 листопада 2026 року. Adobe попереджає, що вони змінюються, а старі огляди описують інші цифри.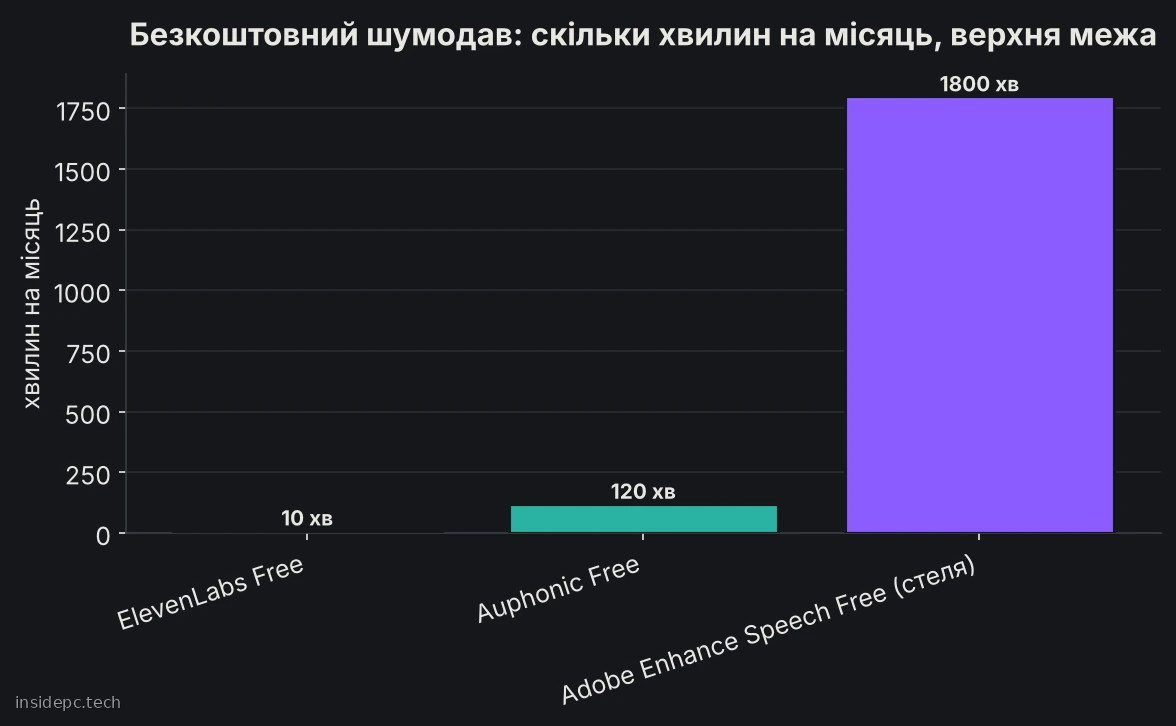
На графіку — верхня межа безкоштовної обробки на місяць, наш розрахунок за умовами на 2 листопада 2026 року. Одиниці обліку в сервісів різні. В Adobe добовий ліміт: 1 година на день × 30 днів = до 1800 хвилин, але лише якщо користуватися щодня. В Auphonic — 120 хвилин на місяць. В ElevenLabs спільний пул: 10 000 безкоштовних кредитів ÷ 1000 кредитів за хвилину = 10 хвилин. Висновок: для регулярного безкоштовного чищення подкасту Adobe щедріший за інших, а Auphonic зручний як друга думка.
На знімку сторінки тарифів Auphonic від 2 листопада 2026 року рамками виділено безкоштовну умову: 2 години обробленого аудіо на місяць, включно з ШІ-алгоритмами. Більше — через підписку або разові пакети годин, їх видно праворуч.
Незалежне порівняння є лише англійською. У тесті подкаст-редактора Джессі Маккьюна (червень 2024 року, 9 інструментів, 5 треків) Auphonic названо «темною конячкою» з природним звучанням. Проте він надто агресивно зрізає верхні частоти в жіночих голосах. Частина посилань в огляді приносить автору комісію, і він про це попереджає.
Коли шумодав псує голос: як перевірити обробку на слух
Сильний шумодав не віднімає шум, а заново збирає голос. Audo, конкурент Adobe, формулює це так: Enhance Speech «перебудовує голос, а не відфільтровує шум», тому результат може звучати інакше, ніж говорила людина. У тесті 2024 року зазначено, що за інтенсивності понад 50% голоси звучать помітно обробленими, а Adobe змінює характер голосу аж до «поганого клону». ProVideo Coalition, який тестував версію V2, пише, що вона помітно краща за першу, але іноді повертає зайвий бас.
Тож відповідь на питання, як прибрати шум з аудіо й не зіпсувати голос, проста: силу обробки виставляйте обережно, а результат перевіряйте на слух. Перевірка займе п’ять хвилин:
- Слухайте приголосні. Шиплячі й свистячі («С», «Ш», «Ц») і проривні на кшталт «Т» шумодав може змазати або зробити шепелявими.
- Знайдіть сміх і дихання. Якщо вони зникли або звучать металево, обробка надто сильна.
- Порівняйте тембр з оригіналом. Увімкніть 10 секунд до і після: голос має лишитися впізнаваним, без зайвого басу й «телефонного» звучання.
- Змішайте з оригіналом. Якщо сервіс має повзунок сили, почніть із 30–50%. Якщо ні — підмішайте трохи вихідної доріжки в монтажній програмі.
- Слухайте в навушниках і на динаміку телефона. Артефакти на різних пристроях чути по-різному.
Чому саме на слух, а не автоматично? Дослідження, представлене на Interspeech 2024 (порівнювали Denoiser, DeepFilterNet3 і FullSubNet+), показало три речі. Шумодави поводяться по-різному на різних даних. Об’єктивні метрики погано описують складні сцени з кількома джерелами шуму. А перевірка через розпізнавання мовлення може давати «галюцинації» — помилки, яких у звуці немає. Для українського мовлення незалежних тестів шумодавів ми не знайшли зовсім, тож вухо лишається головним суддею.
Відкриті моделі: AuK, DeepFilterNet і Resemble Enhance на своєму ПК
Відкрита модель — та, чиї ваги й код викладено публічно: її можна запустити в себе без підписки і без надсилання запису в хмару. Для редагування голосу помітних таких моделей три, і кожна має свої обмеження.Модель Що робить Ліцензія Формат і залізо Застереження AuK (Tencent Hunyuan) Генерація і редагування мовлення, 1,5 млрд параметрів MIT Пік 24,78 ГіБ відеопам’яті без offload, 16,75 ГіБ з offload Метрики лише від Tencent; демо китайською та англійською; маркування ШІ-аудіо немає DeepFilterNet Шумодав MIT або Apache 2.0 Лише WAV 48 кГц Останній реліз 0.5.6 — серпень 2023 року Resemble Enhance Шумодав і покращувач смуги частот MIT Н/д Репозиторій із листопада 2023 року
AuK — одна з нових відкритих моделей. Tencent Hunyuan анонсувала її 9 вересня 2026 року, технічний звіт вийшов на arXiv на день раніше. Модель уміє не лише озвучувати текст, а й редагувати готове мовлення. Обмеження суттєві. Усі опубліковані результати — власні тести Tencent, зовнішніх порівнянь немає. Демо-ролики китайською та англійською, про українську автори нічого не пишуть. Ні звіт, ні сторінка на Hugging Face не описують водяного знака, який позначав би звук як створений ШІ.
Порахуймо залізо. Автори виміряли пік відеопам’яті (VRAM) на серверній NVIDIA A800 з 80 ГБ: 24,78 ГіБ без offload і 16,75 ГіБ з offload. Offload — режим, за якого частина моделі зберігається у звичайній пам’яті комп’ютера, а не на відеокарті: заощаджує VRAM, але працює повільніше. Вимірювання зроблено на короткому тесті — півтори секунди вихідного звуку за текстом. Висновки:
- Без offload 24,78 ГіБ не вміщаються в споживчу відеокарту на 24 ГБ — це максимум масових ігрових моделей.
- З offload 16,75 ГіБ вміщаються в карту на 24 ГБ, але не в карту на 16 ГБ.
- Після оновлення 16 вересня 2026 року автори повідомили, що енкодер витрачає приблизно на 7,5 ГіБ менше, «щоб модель легше запускалася на споживчих відеокартах». Нового вимірювання піку вони не опублікували, а з README не видно, зроблено таблицю до оновлення чи після. Тому підсумок відніманням не рахуємо: робоча планка для власного ПК — карта на 24 ГБ.
- Від 13 вересня 2026 року автори також підтримують запуск через MLX на Mac з Apple Silicon.
Тож «безкоштовна» модель упирається в залізо. Як влаштований запуск відкритої моделі на власному ПК, ми показували на прикладі Qwen Coder — локальної заміни Copilot.
DeepFilterNet простіший: це шумодав, який можна безкоштовно використовувати й у комерційних проєктах. Проте він приймає лише WAV із частотою 48 кГц, а останній реліз вийшов у серпні 2023 року. Підтримувати його доведеться самостійно. Resemble Enhance поєднує шумодав і «покращувач», який намагається повернути звуку смугу частот, втрачену під час поганого запису.
Скільки коштує хвилина правок: Descript, ElevenLabs, Auphonic, Adobe
Ціни й ліміти нижче — на 2 листопада 2026 року, за офіційними сторінками тарифів. Виняток — Adobe Premium: окремої ціни Adobe не показує, дані взято зі стороннього огляду. Це місце статті застаріває найшвидше: перед покупкою звіряйтеся з першоджерелом.Сервіс Тариф Ціна на місяць Що входить Descript Hobbyist $16 за річної оплати, $24 щомісяця 10 годин медіа, 400 ШІ-кредитів, клони голосу і Regenerate (лише англійська) Descript Creator $24 за річної оплати, $35 щомісяця 30 годин медіа, 800 ШІ-кредитів ElevenLabs Free $0 10 000 кредитів ElevenLabs Starter $6 30 000 кредитів ElevenLabs Creator $22 (перший місяць $11) 121 000 кредитів ElevenLabs Pro $99 600 000 кредитів Auphonic Free $0 2 години обробки, із джинглом Auphonic S Н/д: ціна на сторінці підвантажується динамічно 9 годин обробки Adobe Enhance Speech Free $0 Файл до 30 хвилин, до 1 години на день Adobe Enhance Speech Premium Н/д: входить у платні плани Firefly; Audo, конкурент Adobe, у жовтні 2026 року називав $19,99 на місяць за Firefly Pro До 4 годин на день, файл до 1 ГБ 
Наш розрахунок вартості хвилини в ElevenLabs. Voice Changer і Voice Isolator коштують 1000 кредитів за хвилину, кредити спільні для всіх функцій сервісу. Виходить:
- Free: 10 000 ÷ 1000 = 10 хвилин на місяць.
- Starter: 30 хвилин за $6, тобто близько $0,20 за хвилину.
- Creator: близько 121 хвилини за $22, тобто близько $0,18 за хвилину. За річної оплати еквівалент $18,33 на місяць, і хвилина дешевшає приблизно до $0,15.
- Pro: 600 хвилин за $99, близько $0,17 за хвилину.
Важливе застереження: якщо того ж місяця ви озвучуєте текст або робите дубляж, кредити витрачаються і туди, тож хвилин на шумодав лишається менше. У Descript порахувати ціну хвилини Regenerate неможливо: скільки ШІ-кредитів списує одна операція, на сторінці тарифів не вказано. Для української це питання однаково не стоїть.
Ризики клону голосу: згода, дипфейк, AI Act, США і Данія
Дипфейк — синтетичний запис, який видає себе за реальну людину. Чищення шуму у власному подкасті до цього класу не належить. Із заміною слів клоном складніше: якщо синтезований фрагмент можна сприйняти за живе мовлення, юристи відносять його до дипфейків навіть за згоди власника голосу (докладніше — у блоці про ЄС нижче). Клон чужого голосу без згоди — дипфейк у чистому вигляді, і тут правила посилюються найшвидше.
Що дозволяють сервіси. ElevenLabs прямо пише: професійний клон можна зробити лише з власного голосу — навіть зі згодою іншої людини не можна. Власник голосу має створити й підтвердити клон сам, а потім поділитися ним. Правила використання ElevenLabs забороняють клонувати голос живої людини без її явної та поінформованої згоди. Descript вимагає явного дозволу від мовця, чий голос клонують. Тому виправити запис гостя подкасту його клоном можна лише з його явної згоди. Миттєвий клон в ElevenLabs ви створите самі, підтвердивши право і згоду власника голосу, а професійний клон створює лише сам гість.
Чому це не формальність. За даними McAfee (дослідження 2023 року, компанія продає антивіруси), трьох секунд аудіо вистачило для клону з 85-відсотковим збігом з оригіналом. Consumer Reports у березні 2025 року оцінив сервіси клонування голосу шести компаній, серед яких Descript і ElevenLabs. Чотири з шести не мали суттєвих бар’єрів проти клонування чужого голосу без згоди. ElevenLabs опинилася в цій четвірці: для клону вистачало позначити, що у вас є право на голос. Descript була серед двох компаній, де бар’єри були. Професійний клон ElevenLabs сьогодні створює лише сам власник голосу, а для миттєвого клону в документації й досі описано тільки підтвердження права і згоди. Як такі клони використовують шахраї і як від них захиститися, ми розбирали в матеріалі про голосові дипфейки телефоном.Юрисдикція Що діє Статус на 2 листопада 2026 року ЄС Стаття 50 AI Act: дипфейк-аудіо треба розкривати як створене або змінене ШІ Застосовується від 2 серпня 2026 року США FCC: автоматичні дзвінки з ШІ-голосами незаконні за законом про захист телефонних споживачів (TCPA) Рішення від 8 лютого 2024 року Данія Заборона поширювати реалістичні імітації обличчя і голосу без згоди Законопроєкт, внесено 8 жовтня 2026 року; не закон
ЄС. За роз’ясненням Єврокомісії, стаття 50 AI Act застосовується від 2 серпня 2026 року. Той, хто використовує ШІ для створення чи зміни аудіо, яке є дипфейком, зобов’язаний розкрити, що звук згенеровано або змінено. Зробити це потрібно не пізніше першого контакту зі слухачем, зрозуміло і без спеціальних інструментів — наприклад, звуковою чи видимою позначкою; машинозчитуваної мітки всередині файлу для цього недостатньо. Суто особисте використання під AI Act не підпадає, а регулярна робота з доходом — підпадає, навіть у приватної особи. Юридичний блог Praxikon, переказуючи настанови Комісії від 20 липня 2026 року, робить жорсткий висновок: клон голосу зі згодою власника однаково лишається дипфейком. Самих настанов ми не відкривали. Для провайдерів систем, випущених до 2 серпня 2026 року, технічне маркування контенту обов’язкове від 2 грудня 2026 року.
США. FCC ухвалила рішення після фейкового дзвінка з голосом «Байдена» виборцям Нью-Гемпширу.
Данія. Законопроєкт змінює закон про авторське право. Чи ухвалено його, на 2 листопада 2026 року ми не перевіряли.
Що це означає для автора з України: Україна не входить до ЄС, але якщо ваша аудиторія чи замовник у Євросоюзі, правило розкриття стосується і вас. Точне тлумачення для вашого випадку дасть лише юрист. Практичний мінімум — не клонувати чужий голос без письмової згоди і позначати помітно відредаговані ШІ фрагменти в описі випуску.
Що ми перевірили, а чого ні: без власних аудіотестів українською
Цей розбір зібрано за документацією вендорів, сторінками тарифів, вихідними репозиторіями та незалежними тестами англійською. Власних прогонів аудіо ми не робили. Ось що важливо знати:
- Перевірено за першоджерелами: мови й обмеження Descript Regenerate, мови Voice Changer, тарифи й кредити ElevenLabs, безкоштовні ліміти Adobe і Auphonic, ліцензії відкритих моделей, дати застосування AI Act і рішення FCC.
- Не перевірено зовсім: якість заміни слів і зміни тембру на українському мовленні — ні в ElevenLabs, ні в AuK. Незалежних вимірювань немає, є лише заяви вендорів.
- Перевірено лише англійською: поведінку шумодавів. Adobe називає Enhance Speech незалежним від мови, але ProVideo Coalition переказує скарги користувачів на неанглійське мовлення.
- Що застаріє першим: ціни й ліміти безкоштовних планів, список мов ElevenLabs і вимоги до відеопам’яті AuK. Останні вже змінювалися у вересні 2026 року.
Що зробити самому перед вибором: візьміть 30 секунд власного запису з обмовкою і шумом. Проженіть його через Adobe Enhance Speech і ElevenLabs Voice Isolator — обидва доступні безкоштовно. Для заміни слова знадобиться миттєвий клон голосу, а в ElevenLabs він є починаючи з тарифу Starter ($6 на місяць на 2 листопада 2026 року). Порівняйте за чек-листом із розділу про шумодав. Хвилина тесту заощадить місяць підписки.
Який інструмент обрати: таблиця рішень за завданням
Вибір залежить від завдання і мови. Для чищення шуму будь-якою мовою беріть безкоштовний Adobe Enhance Speech, для другої думки — Auphonic. Для заміни слова в англійському записі підійде Descript Regenerate. Для української підтримку з боку вендора заявляє лише ElevenLabs, і результат треба перевіряти на власному записі. Клонувати чужий голос без згоди власника не можна.Ваше завдання Мова Бюджет Що взяти Прибрати шум із подкасту Будь-яка $0 Adobe Enhance Speech, у разі сумніву — Auphonic Прибрати шум просто під час дзвінка Будь-яка Підписка Krisp Прибрати шум без хмари Будь-яка $0, власний ПК DeepFilterNet або Resemble Enhance Замінити слово Англійська Від $16 на місяць Descript Regenerate із власним клоном Замінити слово Українська Від $6 на місяць ElevenLabs: клон голосу і Studio; якість перевірити самому Змінити тембр Українська Від $6 на місяць ElevenLabs Voice Changer, до 5 хвилин за раз Експериментувати з відкритим редактором мовлення Китайська та англійська Відеокарта від 24 ГБ AuK Виправити голос гостя Будь-яка — Лише з його явної згоди; професійний клон ElevenLabs створює і підтверджує сам гість
Шлях від новачка до профі виглядає так. Почніть із шумодава: він безкоштовний і майже безпечний. Потім спробуйте заміну слова на власному голосі. Зміну тембру й відкриті моделі залиште на той випадок, коли розумієте, що саме хочете отримати і як це перевірити.
Часті запитання про редагування голосу за допомогою ШІ
Чи можна замінити слово в записі нейромережею українською?
Можна спробувати в ElevenLabs: Studio заново генерує виділені слова голосом клону, а вендор заявляє українську серед підтримуваних мов. Незалежних вимірювань якості цими мовами немає, тому результат треба перевіряти на власному записі. Descript Regenerate для цього не підходить: на 2 листопада 2026 року він працює лише з англійською.
Що таке Descript Overdub і чи працює він сьогодні?
Overdub — колишня назва функції заміни слів у Descript. Тепер вона має назву Regenerate, а сама Descript пише «Regenerate (fka Overdub)». Функція працює, але лише з англійським аудіо та відео, лише з власним авторизованим клоном голосу і не більше ніж 250 символів за одну операцію.
Чи можна клонувати чужий голос, щоб виправити його запис?
Лише з явної згоди власника голосу. В ElevenLabs миттєвий клон можна створити самому, підтвердивши право і згоду власника, а професійний клон чужого голосу не можна зробити навіть зі згодою: власник створює і підтверджує його сам, а потім ділиться. Descript вимагає явного дозволу мовця. У ЄС від 2 серпня 2026 року такий клон, виданий за живе мовлення, треба розкривати за статтею 50 AI Act.
Який нейромережевий шумодав можна використовувати безкоштовно?
Adobe Enhance Speech безкоштовно обробляє файли до 30 хвилин і до 1 години на день. Auphonic дає 2 години на місяць, але додає свій джингл. ElevenLabs Voice Isolator на безкоштовному плані — близько 10 хвилин на місяць. Без хмари підійдуть відкриті DeepFilterNet і Resemble Enhance. Ліміти вказано на 2 листопада 2026 року.
Чи треба позначати запис, якщо голос у ньому виправлено або клоновано ШІ?
Якщо запис можна сприйняти за живе мовлення реальної людини і його слухають у ЄС, то від 2 серпня 2026 року — так: стаття 50 AI Act вимагає розкривати дипфейк-аудіо. Прибраний шум зазвичай до цього не належить. Клон голосу, за тлумаченням юридичного блогу Praxikon з посиланням на настанови Єврокомісії, належить навіть зі згодою власника. Для точної оцінки вашого випадку потрібен юрист.
Скільки аудіо потрібно для клону голосу?
ElevenLabs для миттєвого клону потребує 1–2 хвилини чистого запису, для професійного — від 30 до 180 хвилин. Що чистіший зразок, то менше артефактів: без музики, луни й чужих голосів. Для шахраїв поріг нижчий: за даними McAfee, трьох секунд вистачило для клону з 85-відсотковим збігом.