Коротко (TL;DR)
Запустити LLM на Raspberry Pi 5 можна без жодних прискорювачів: процесор плати сам видає 8–11 токенів за секунду на моделях 1–1,5 млрд параметрів. Додаткова плата AI HAT+ 2 з нейропроцесором Hailo-10H цієї швидкості не піднімає, а на тих самих моделях навіть знижує. Її користь в іншому: вона економить вати, звільняє процесор і бере на себе камеру та голос.
- Коротко (TL;DR)
- Raspberry Pi 5 без прискорювача: які LLM тягне і з якою швидкістю
- AI HAT+ 2 на Hailo-10H: що всередині, скільки коштує і які моделі є
- AI HAT+ 2 проти процесора Pi 5: чому прискорювач повільніший
- Де AI HAT+ 2 виправданий: зір, VLM, голос і економія ват
- Старі AI HAT+ і AI Kit на Hailo-8: лише зір, без LLM
- Збірка Raspberry Pi 5 під LLM: комплектуючі та підсумкова ціна
- Pi 5, Jetson Orin Nano Super і міні-ПК на N150: ціна та швидкість
- Ризики AI HAT+ 2 і Pi 5: контекст, якість моделей, ціни
- Коли Raspberry Pi 5 для LLM замало і куди переходити далі
- FAQ
- Голий Pi 5 на 8 ГБ — робочий варіант для моделей 1–2B: близько 10 tok/s у Qwen2.5 1.5B, 4,6 tok/s у Llama 3.2 3B і менше ніж 2 tok/s у моделей на 7–8B (заміри 2026 року, подробиці нижче).
- AI HAT+ 2 (Hailo-10H, 8 ГБ власної пам’яті) у трьох незалежних тестах генерує текст повільніше за процесор Pi 5. Причина — однакова за швидкістю пам’ять у плати та в прискорювача.
- Де HAT виправданий: камера з розпізнаванням, моделі «картинка + текст» (VLM), голосові команди, живлення від акумулятора. Збірка з ним споживає 7–7,6 Вт проти 10–12 Вт у процесора.
- Гроші на 15 листопада 2026 року: Pi 5 8 ГБ коштує $175, AI HAT+ 2 — $200, разом із блоком живлення, кулером і карткою пам’яті виходить близько $440. Медіанна ціна міні-ПК на Intel N150 з 16 ГБ — $349, і він генерує приблизно вдвічі швидше.
- Коли Pi замало: потрібні моделі 7B і більше або довгі документи — дивіться міні-ПК, Jetson чи Mac.
Raspberry Pi 5 без прискорювача: які LLM тягне і з якою швидкістю
Raspberry Pi 5 — одноплатний комп’ютер на процесорі Broadcom BCM2712 з оперативною пам’яттю LPDDR4X-4267 обсягом від 1 до 16 ГБ. Для локальної нейромережі йому не потрібно нічого, крім Ollama або llama.cpp: це програми, які завантажують модель у форматі GGUF і запускають її на процесорі.
Швидкість генерації вимірюють у токенах за секунду (tok/s). Токен — шматок слова, зазвичай коротший за саме слово. За оцінкою японського блогу замірів ai-local-lab, 7–10 tok/s уже встигають за читанням про себе. Моделі майже завжди запускають у квантованому вигляді: Q4_K_M означає, що ваги стиснуті приблизно до 4 біт, і модель займає близько 0,6–0,7 ГБ на мільярд параметрів.Модель (квантування) Pi 5, процесор, tok/s Хто міряв, на чому, коли Gemma 3 1B (Q4_K_M) 10,84 ai-local-lab, Pi 5 8 ГБ, Ollama 0.24.0, 16.06.2026 Qwen2.5 1.5B (Q4_K_M) 10,62 ai-local-lab, Pi 5 8 ГБ, Ollama 0.24.0, 16.06.2026 Gemma 4 E2B 9 (LiteRT-LM) / 4 (llama.cpp, Q4_0) Google у блозі Raspberry Pi, Pi 5 8 ГБ, серпень 2026 Llama 3.2 1B (Q8_0) 7,77 ai-local-lab, Pi 5 8 ГБ, 23.06.2026 Qwen3 1.7B (Q4_K_M) 7,67 ai-local-lab, Pi 5 8 ГБ, 16.06.2026 Llama 3.2 3B 4,61 (8 ГБ) / 4,88 (16 ГБ) Джефф Ґірлінґ, ai-benchmarks, Ollama Gemma 3 4B (Q4_K_M) 3,59 ai-local-lab, Pi 5 8 ГБ, 23.06.2026 Ministral 3 8B (Q4_K_M) 1,96 ai-local-lab, Pi 5 8 ГБ, Ollama 0.31.1, 02.07.2026 DeepSeek R1 14B 1,20 (лише 16 ГБ) Джефф Ґірлінґ, ai-benchmarks Qwen3-30B-A3B (MoE, Q3_K_S-2.70bpw) 8,03 (лише 16 ГБ) заява ByteShape, 05.01.2026; запуск підтвердив Ґірлінґ
З таблиці видно головне правило: швидкість падає майже пропорційно розміру моделі. Звідси практичний вибір — яку LLM-модель ставити на Raspberry Pi під завдання:
- 0,2–1,5B — команди розумного дому, короткі відповіді, класифікація тексту. Швидкість 8–11 tok/s, у надмалої LFM2.5 на 230 млн параметрів — до 44 tok/s. Відповідь з’являється швидше, ніж ви її прочитаєте.
- 3–4B — помітно розумніші, але 2–5 tok/s. Підходять, коли відповідь коротка або її не чекають у реальному часі.
- 7–8B — менше ніж 2 tok/s. Модель запускається, але абзац тексту пишеться хвилину. Продавці готових комплектів іноді обіцяють «7B на Pi 5 8 ГБ» — це правда лише в сенсі «запускається».
Яку модель обрати за якістю, а не лише за швидкістю, ми розбирали в гіді яку локальну LLM обрати. Для Pi з нього підходять наймолодші моделі сімейств — наприклад, у Qwen3 є версії від 0,6B.
Перший запуск LLM на Raspberry Pi 5: три кроки
- Запишіть на картку пам’яті 64-бітну Raspberry Pi OS і оновіть систему.
- Встановіть Ollama офіційним скриптом:
curl -fsSL https://ollama.com/install.sh | sh. - Завантажте й запустіть модель однією командою:
ollama run qwen2.5:1.5b. Це та сама модель, що дала 10,62 tok/s у таблиці вище.
8 чи 16 ГБ: що дає зайва пам’ять
Обсяг пам’яті майже не впливає на швидкість: 4,61 tok/s на 8 ГБ проти 4,88 tok/s на 16 ГБ у Llama 3.2 3B за замірами Ґірлінґа. Швидкість визначає пропускна здатність пам’яті, а вона в усіх версій Pi 5 однакова. Натомість 16 ГБ відкривають моделі, які на 8 ГБ просто не вміщаються.
Найцікавіший випадок — MoE-моделі («суміш експертів»): параметрів у них багато, але на кожен токен працює лише мала частина. ByteShape стиснув Qwen3-30B-A3B приблизно до 10 ГБ і заявляє 8,03 tok/s на Pi 5 16 ГБ із 94,18% якості вихідної моделі. Ґірлінґ підтвердив запуск, але власної цифри швидкості не навів. Якщо заява правдива, це модель 30B-класу, швидша за 3B на тому самому Pi.
Рантайм і охолодження: безкоштовний приріст швидкості
Програма запуску впливає на швидкість не менше, ніж залізо. Google показав Gemma 4 E2B на Pi 5 8 ГБ: через власний LiteRT-LM — 9 tok/s і 1,4 ГБ пам’яті, через llama.cpp — 4 tok/s і 4,4 ГБ. В ai-local-lab просте оновлення Ollama з 0.24.0 до 0.31.1 прискорило маленьку модель LFM2.5 230M у 1,64 раза (з 26,73 до 43,84 tok/s). Тож перед купівлею прискорювача спершу спробуйте інший рантайм і свіжу версію. Наскільки розходяться Ollama, LM Studio і llama.cpp на одній моделі, ми розбирали окремо.
Під навантаженням процесор Pi 5 нагрівається до 71–73 °C навіть з офіційним кулером Active Cooler (ai-local-lab, червень 2026). Без активного охолодження плата почне скидати частоту, і всі цифри з таблиці виявляться завищеними.
AI HAT+ 2 на Hailo-10H: що всередині, скільки коштує і які моделі є
AI HAT+ 2 — офіційна плата розширення від Raspberry Pi для генеративного ШІ. Вона вийшла 15 січня 2026 року і встановлюється зверху на Pi 5. Усередині два головні чипи:
- Hailo-10H — нейропроцесор (NPU), тобто чип, спеціалізований на обчисленнях нейромереж. Виробник заявляє 40 TOPS (трильйонів операцій за секунду) у форматі INT4. Джефф Ґірлінґ в огляді пише про «40 TOPS INT8», але офіційні сторінки Raspberry Pi і Hailo вказують саме INT4.
- 8 ГБ пам’яті LPDDR4X просто на платі. Модель живе в ній, а не в пам’яті Raspberry Pi. Тому хостом може бути навіть Pi 5 на 2 ГБ: CNX Software провів усі тести саме на такій платі, і процесор під час генерації майже простоював.
AI HAT+ 2 для Raspberry Pi 5 і тільки для нього: у Pi 4, Pi 500 і Pi 500+ немає виведеного роз’єму PCIe. А на самому Pi 5 плата займає єдину лінію PCIe, тож NVMe-диск поруч із нею без розгалужувача не поставити.
З ціною є плутанина. На старті AI HAT+ 2 коштував $130. У квітні 2026 року The Register повідомив про подорожчання на $50, що дало б $180. На 15 листопада 2026 року офіційна сторінка показує $200, і звідки взялися ще $20, жодне знайдене джерело не пояснює. Загалом плата подорожчала на 54% за десять місяців.
Які LLM-моделі є для Hailo-10H
Hailo-10H не запускає довільні моделі з інтернету. Йому потрібен формат HEF — модель, заздалегідь скомпільована під цей чип інструментом Hailo Dataflow Compiler. Готові моделі лежать в офіційному каталозі Hailo Model Zoo GenAI. Нижче — список LLM-моделей для Hailo-10H з версії v5.5.0 від 1 листопада 2026 року. Цифри швидкості — заява Hailo, на якій платі їх зняли, каталог не вказує.Модель Розмір Контекст, токенів До першого токена, с Генерація, tok/s Llama3.2-1B-Instruct 1,79 ГБ 2048 0,35 9,82 Qwen2.5-Coder-1.5B 1,64 ГБ 2048 0,32 8,13 Qwen2-1.5B 1,56 ГБ 2048 0,32 8,02 DeepSeek-R1-Distill-Qwen-1.5B 2,37 ГБ 2048 1,45 7,59 Qwen2.5-1.5B 1,64 ГБ 2048 0,37 7,32 Gemma4-E2B 3,11 ГБ 2048 0,55 5,47 Qwen3-1.7B 1,79 ГБ 2048 0,62 4,72 Qwen3-4B-Instruct-2507 4,2 ГБ 2048 1,53 2,07 Qwen2-VL-2B / Qwen3-VL-2B (картинка + текст) 2,18 ГБ 2048 1,01 / 1,47 7,13 / 4,89 Qwen3-VL-4B (картинка + текст) 4,4 ГБ 2048 3,59 2,29 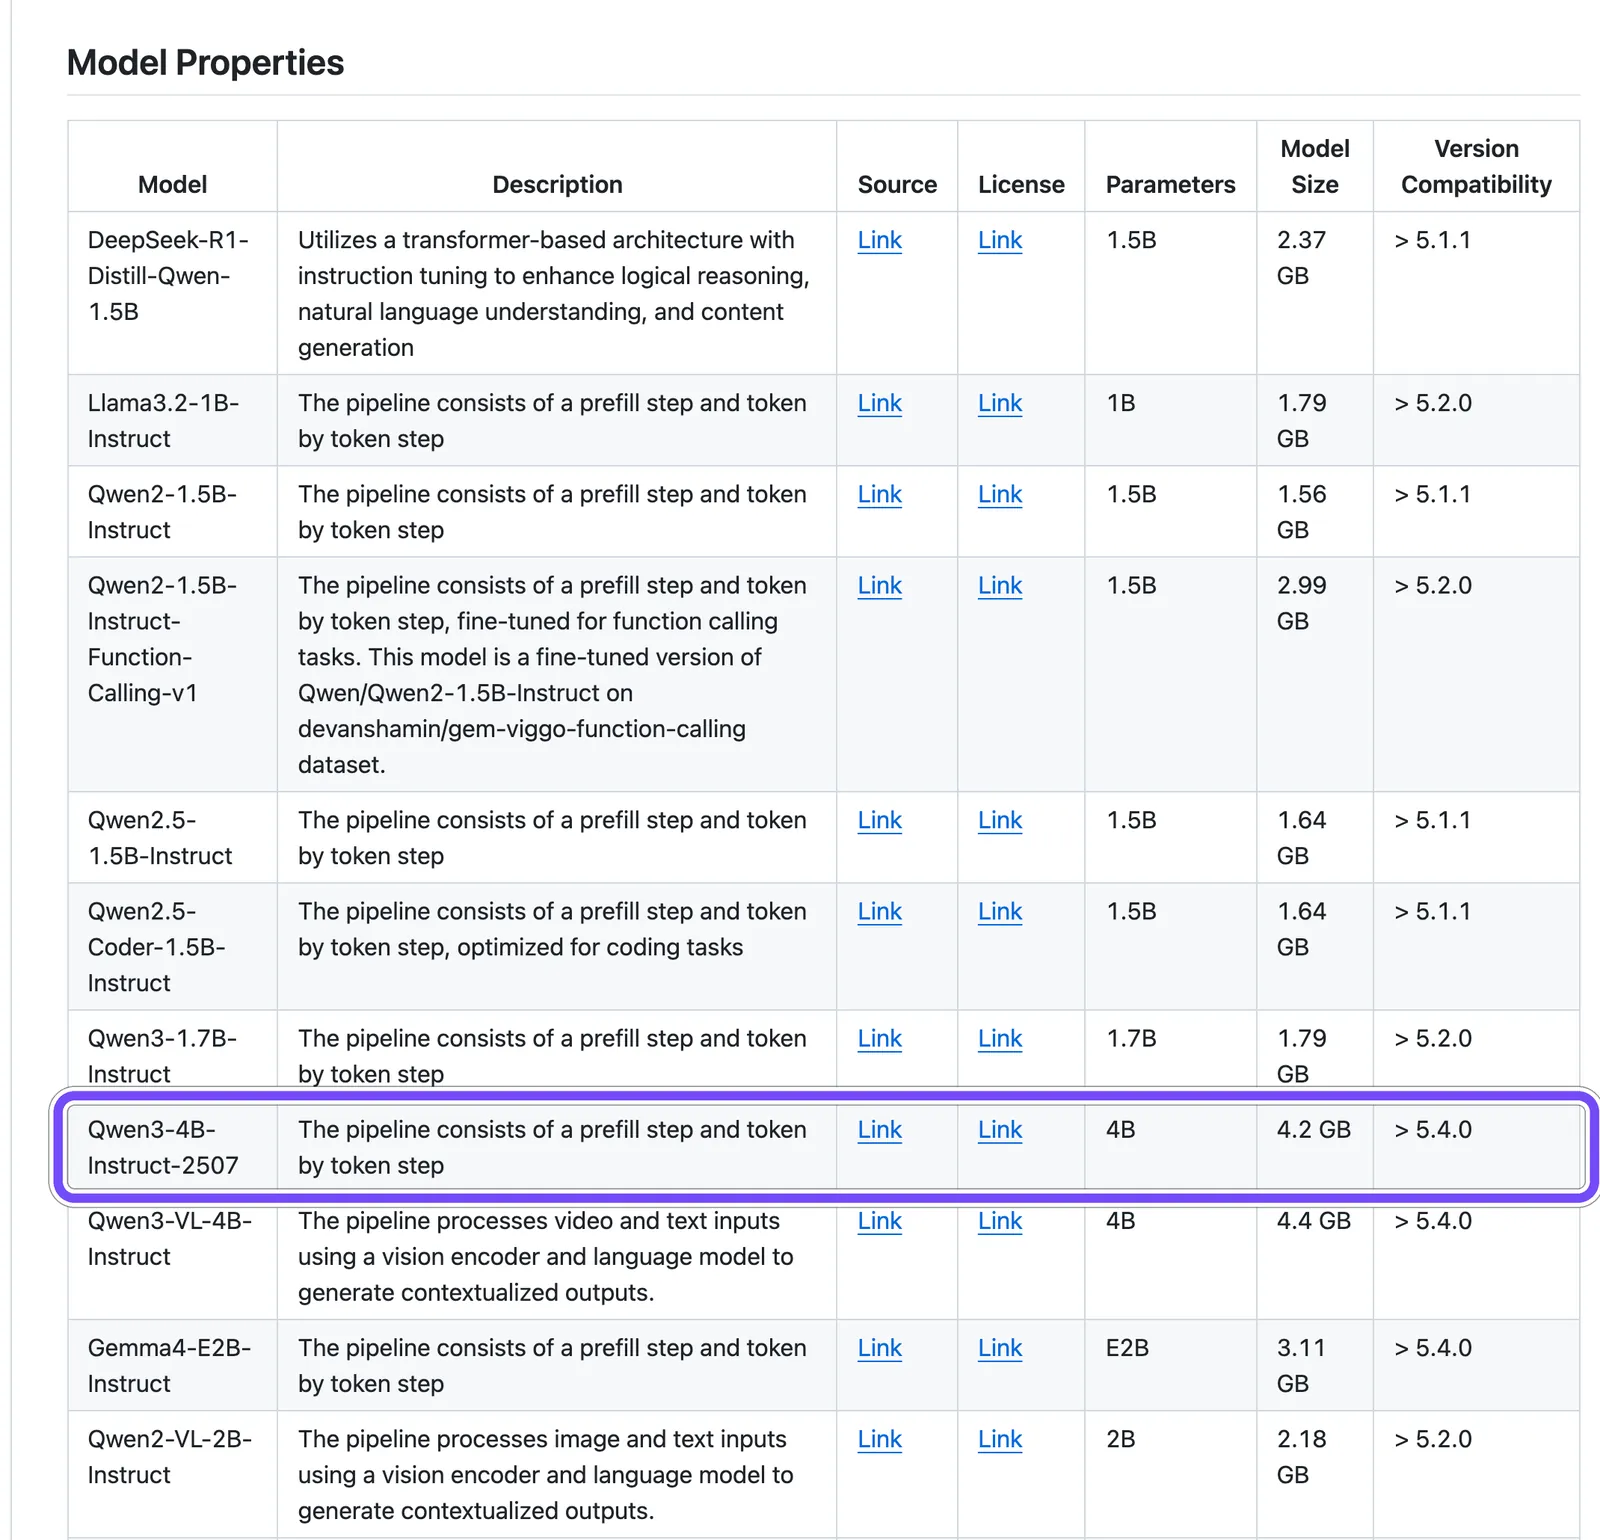
На скриншоті каталогу рамкою виділено Qwen3-4B-Instruct-2507 на 4,2 ГБ — найбільшу LLM, яка на 15 листопада 2026 року є для Hailo-10H. Огляд ComputingForGeeks від 19 жовтня 2026 року ще називав стелею Qwen3 1.7B, хоча 4B додали у версії v5.4.0 від 16 вересня. Крім мовних моделей, у каталозі є розпізнавання мовлення Whisper від Tiny до Medium.
Три обмеження помітні одразу. Перше: контекст 2048 токенів у всіх моделей. Це вікно пам’яті моделі, приблизно 3–4 сторінки тексту разом із вашим запитанням і відповіддю. Друге: стеля 4B, хоча 8 ГБ на платі формально вмістили б більше. Третє: власну модель із Hugging Face ви не завантажите — лише донавчите готову через адаптери LoRA і скомпілюєте їх у Dataflow Compiler.
AI HAT+ 2 проти процесора Pi 5: чому прискорювач повільніший
Зв’язку Hailo-10H і Raspberry Pi 5 незалежно перевірили три команди, і всі дійшли одного висновку: у генерації тексту прискорювач поступається процесору самої плати. CNX Software порівняв моделі 1,5–3B у січні 2026 року, Ґірлінґ опублікував свою таблицю того ж місяця, ai-local-lab повторив тест у липні.Модель Процесор Pi 5, tok/s AI HAT+ 2, tok/s Чий замір Qwen2 1.5B 11,29 / 12,47 5,89 / 8,25 CNX / Ґірлінґ Qwen2.5-Instruct 1.5B 11,73 / 11,41 6,74 / 6,86 CNX / Ґірлінґ DeepSeek-R1-Distill 1.5B 9,04 / 10,99 6,72 / 6,85 CNX / Ґірлінґ Qwen2.5-Coder 1.5B 10,26 / 9,77 8,06 / 8,13 CNX / Ґірлінґ Llama 3.2 3B 4,78 / 5,55 2,60 / 2,66 CNX / Ґірлінґ Qwen2.5 1.5B, однаковий промпт 9,72 7,05 ai-local-lab, 10.07.2026
Таблицю Ґірлінґа наведено в переказі ComputingForGeeks. Заміри мають застереження: CNX міряв процесор на девкіті CM5 з 4 ГБ (той самий чип BCM2712), а HAT — на Pi 5 з 2 ГБ, версії Ollama і квантування різні. Тому найчистіший тест — в ai-local-lab: одна плата, один промпт, різниця 38% на користь процесора. Найближче HAT підійшов на Qwen2.5-Coder, але й там не наздогнав.
Чому 40 TOPS не перетворюються на токени
Генерація тексту — це читання. На кожен новий токен модель знову зчитує з пам’яті всі свої ваги, а обчислює при цьому небагато. Тому швидкість упирається не в TOPS, а в пропускну здатність пам’яті. У Pi 5 і в Hailo-10H стоїть пам’ять одного класу, LPDDR4X-4267. Засновник Raspberry Pi Ебен Аптон підтвердив CNX Software, що схожий результат очікуваний саме з цієї причини.
TOPS працюють на іншій стадії — prefill, коли модель разом обробляє весь ваш запит. Там багато обчислень і мало читання пам’яті, тож NPU може виграти. Але на відповіді завдовжки в абзац основний час іде на генерацію.
Калькулятор: скільки токенів видасть ваше залізо
Формулу дає посібник Arm щодо генерації LLM: швидкість генерації дорівнює пропускній здатності пам’яті, поділеній на обсяг, прочитаний за один токен. На практиці до теоретичної стелі не доходить ніхто, тому результат множать на коефіцієнт ефективності.
- Візьміть розмір файлу моделі в гігабайтах. Якщо його немає — помножте кількість мільярдів параметрів на 0,7 (для квантування Q4_K_M).
- Поділіть пропускну здатність пам’яті на цей розмір. У Pi 5 вона близько 17 ГБ/с за паспортом, Arm у своїх тестах наміряв 13,8 ГБ/с у стабільному режимі.
- Помножте результат на 0,45–0,7. Це реальна ефективність: у замірах ai-local-lab на Pi 5 вона становила від 43 до 72%.
Перевірка на живих цифрах ai-local-lab:Модель Розмір (Q4_K_M) Стеля на Pi 5, tok/s Замір, tok/s Ефективність Gemma 3 1B ≈0,7 ГБ 24,3 10,84 45% Qwen2.5 1.5B ≈1,05 ГБ 16,2 10,62 66% Qwen3.5 4B ≈3,29 ГБ 5,2 2,24 43% Ministral 3 8B ≈6,23 ГБ 2,7 1,96 72%
Та сама формула пояснює, чому Jetson Orin Nano Super у рази швидший. Його пам’ять видає 102 ГБ/с — ушестеро більше, ніж у Pi. Для моделі на 3B (близько 2,2 ГБ) стеля близько 46 tok/s, і найкращий замір NVIDIA — 43,07 tok/s у Llama 3.2 3B — майже впирається в неї. Це наш розрахунок за формулою, а не вимірювання.
Затримка до першого токена в Hailo-10H: заява проти заміру
Hailo має сильний аргумент: час до першого токена (TTFT) — пауза перед тим, як модель почне відповідати. У статті Hailo в блозі Raspberry Pi наведено 320 мс на Hailo-10H проти 2039 мс на процесорі Pi 5 (Qwen2.5-1.5B, запит на 96 токенів, процесор через llama.cpp). Це в 6,4 раза швидше.
Незалежно цю цифру не підтвердив ніхто. CNX Software не знайшов в інструментах Hailo способу виміряти TTFT. ai-local-lab у липні 2026 року отримав протилежний результат: 738 мс на HAT проти 541 мс на процесорі (hailo-ollama 0.5.1). Можливо, виграш проявляється на довгих запитах або у власному SDK Hailo, але на 15 листопада 2026 року це лишається заявою виробника.
Де AI HAT+ 2 виправданий: зір, VLM, голос і економія ват
Сама Hailo формулює призначення плати прямо: не питайте в тостера уроків історії. AI HAT+ 2 найсильніший там, де багато вхідних даних і коротка відповідь. П’ять сценаріїв, у яких він дає реальну користь:
- Камера з розумінням сцени (VLM). Модель «картинка + текст» спершу проганяє кадр через важкий візуальний кодувальник — це робота саме для NPU. Qwen2-VL-2B за каталогом Hailo відповідає зі швидкістю 7,13 tok/s. CNX Software вважає такі камери, зокрема системи відеоспостереження на кшталт Frigate, найкращим застосуванням плати.
- Голос у дію. Ланцюжок «мовлення → текст → команда»: Whisper розпізнає фразу, маленька LLM розуміє намір і запускає дію. Відповідь коротка, тож повільна генерація майже не заважає.
- Розвантаження процесора. Поки модель працює на HAT, процесор і пам’ять Pi вільні для камери, бази даних або вебінтерфейсу.
- Дешевий хост. Модель живе у 8 ГБ на платі, тому вистачить Pi 5 на 2 ГБ за $77,50 замість 8-гігабайтної версії за $175.
- Живлення від акумулятора чи сонячної панелі. Під LLM-навантаженням уся система з HAT споживає 7,2–7,6 Вт проти 10,2–10,6 Вт на процесорі (CNX), у Ґірлінґа — 7,1 Вт проти 12,3 Вт.
У Hackster.io вийшло 5,2 Вт на всю систему, в ai-local-lab — 2,4 Вт проти 6,2 Вт: методики різні, напрям один. За розрахунком ai-local-lab, на 1000 згенерованих токенів HAT витрачає близько 0,095 Вт·год, процесор — 0,177 Вт·год. У простої картина зворотна: за даними Ґірлінґа, з HAT плата бере 4,2 Вт, без нього — 3,1 Вт.
Голосовий асистент на Pi 5: чи вистачить процесора
Для голосового помічника HAT не обов’язковий. На процесорі Pi 5 Whisper tiny розпізнає коротку команду менш ніж за секунду, base — за 1–2 секунди, small — за 3–6 секунд (оцінка посібника 1c3d, вересень 2026). Плюс 1–2 секунди на відповідь маленької LLM — і асистент вкладається в паузу звичайної розмови.
HAT дає змогу взяти точнішу модель розпізнавання: у каталозі Hailo є Whisper Medium, яку процесор Pi обробляв би надто довго. Наскільки важлива точність розпізнавання української, видно з нашого розбору Whisper large-v3 і turbo на ПК і Mac.
Старі AI HAT+ і AI Kit на Hailo-8: лише зір, без LLM
До AI HAT+ 2 у Raspberry Pi вже були ШІ-прискорювачі: AI Kit на чипі Hailo-8L (13 TOPS) і AI HAT+ на Hailo-8 або Hailo-8L (26 або 13 TOPS). Мовних моделей вони не запускають. Причина — у них немає власної пам’яті, і вони спираються на пам’ять Raspberry Pi. Для згорткових мереж розпізнавання образів цього достатньо, для LLM — ні.
На 15 листопада 2026 року AI Kit знято з виробництва, а AI HAT+ продається від $70 (на старті версії коштували $70 і $110). Якщо вам потрібен лише зір — детекція людей, авто, номерів, — старий HAT лишається робочим вибором:
- За зором AI HAT+ 2 і 26-TOPS AI HAT+ майже рівні. Так пише сама Raspberry Pi. Hailo заявляє до двох разів виграшу, але лише на великих моделях.
- Ґірлінґ сформулював жорсткіше: детекція на HAT+ 2 працює в 10 разів швидше, ніж на процесорі Pi, але те саме вміє старий HAT за $110 або камера AI Camera за $70.
- TOPS різних поколінь не порівнюють безпосередньо. У Hailo-8 цифра в INT8, у Hailo-10H — в INT4, а це різна точність обчислень.
- Нові плати 2026 року теж не про LLM. Sixfab AI HAT+ на чипі DEEPX (25 TOPS, 2 ГБ, близько $95) розрахований на зір, підтримки мовних моделей у нього немає.
Врахуйте й програмну несумісність: драйверний пакет hailo-h10-all для AI HAT+ 2 не уживається з hailo-all від старих плат.
Збірка Raspberry Pi 5 під LLM: комплектуючі та підсумкова ціна
Плата — лише частина витрат. Pi 5 під постійним навантаженням потрібні офіційний блок живлення на 27 Вт, активний кулер і картка пам’яті. За цінами збірок ComputingForGeeks (жовтень 2026) цей набір додає приблизно $65. Ціни нижче — рекомендовані в доларах США.Компонент Ціна На дату Навіщо Raspberry Pi 5 2 ГБ $77,50 з 01.10.2026 хост для AI HAT+ 2, модель живе на HAT Raspberry Pi 5 8 ГБ $175 квітень 2026 (старт — $80) базовий варіант для моделей 1–4B на процесорі Raspberry Pi 5 16 ГБ $385 з 02.11.2026 (старт у січні 2025 — $120) моделі 14B і MoE-модель 30B AI HAT+ 2 $200 15.11.2026 (старт — $130) NPU Hailo-10H і 8 ГБ пам’яті Блок живлення 27 Вт, Active Cooler, microSD 64 ГБ ≈$65 жовтень 2026, наш розрахунок за збірками ComputingForGeeks без них плата скидає частоту
Щодо 16-гігабайтної версії джерела розходяться: на 15 листопада 2026 року офіційна сторінка ще показує $305, а Tom’s Hardware, The Register і CNX Software повідомляють про $385 з 2 листопада. Ми рахуємо за новою ціною — це в 3,2 раза дорожче, ніж на старті.
Чотири готові збірки:Збірка Розрахунок Разом Що отримуєте Pi 5 8 ГБ, процесор $175 + $65 ≈$240 1–1,5B на 8–11 tok/s, 3B на 4,6 tok/s, будь-який GGUF Pi 5 2 ГБ + AI HAT+ 2 $77,50 + $200 + $65 ≈$340 моделі з каталогу Hailo, 7 Вт, вільний процесор Pi 5 8 ГБ + AI HAT+ 2 $175 + $200 + $65 ≈$440 те саме плюс запас пам’яті для інших завдань Pi 5 16 ГБ, процесор $385 + $65 ≈$450 усе з першого рядка плюс 14B і MoE-модель 30B
Висновок із таблиці: якщо мета — чат, а не камера, AI HAT+ 2 подвоює бюджет і нічого не додає до швидкості. Найрозумніша Pi-збірка під текст — 8 ГБ без прискорювача за ≈$240.
Pi 5, Jetson Orin Nano Super і міні-ПК на N150: ціна та швидкість
На бюджеті $350–450 одноплатний комп’ютер для ШІ конкурує не лише з іншими одноплатниками, а й з міні-ПК та платами NVIDIA. Порівняння на одній моделі — Llama 3.2 3B або найближчому аналогу:Платформа Ціна на листопад 2026 Модель 3B, tok/s Потужність під навантаженням Особливості Pi 5 8 ГБ, процесор $175 (≈$240 з усім) 4,61 пік 13,9 Вт (Ґірлінґ) будь-який GGUF, Ollama і llama.cpp Pi 5 16 ГБ, процесор $385 (≈$450) 4,88; MoE 30B ≈8 (заява) пік 11,9 Вт єдиний Pi під 14B і MoE Pi 5 8 ГБ + AI HAT+ 2 $375 (≈$440) 2,60–2,66 7,1–7,6 Вт лише моделі Hailo, контекст 2048 Jetson Orin Nano Super $399 (було $249) 22,6 (Ollama, Qwen2.5 3B) … 43,07 (NVIDIA, MLC) 7–25 Вт CUDA, 102 ГБ/с, наявність нестабільна Міні-ПК Intel N150, 16 ГБ медіана $349 9,06 пік 26,4 Вт готовий корпус і SSD M5Stack LLM-8850 + Pi 5 модуль $139, комплект $215 (січень 2026) 9,05 на 1,5B (заява M5Stack) до 7 Вт чип Axera AX8850, 24 TOPS INT8
Jetson подорожчав до $399 у липні 2026 року. Медіана N150 з 16 ГБ і SSD 500 ГБ — за зрізом Amazon US на 1 листопада 2026 року (розкид $281–550), швидкість — замір Ґірлінґа на GMKtec G3 Plus. Цифри LLM-8850 — від виробника, а одну версію модуля в магазині M5Stack уже знято з виробництва, тож актуальна ціна невідома.
Що випливає з порівняння:
- Міні-ПК на N150 удвічі швидший за Pi 5 на моделі 3B (9,06 проти 4,61 tok/s) і майже вдвічі — на 14B (2,13 проти 1,20 tok/s у DeepSeek R1 за замірами Ґірлінґа). Він дешевший за збірку Pi 5 8 ГБ з HAT і одразу має SSD. Платите ви ватами: пік 26,4 Вт проти 7–14 Вт у Pi.
- Jetson Orin Nano Super — у 5–9 разів швидший за Pi на моделях 3B завдяки пам’яті на 102 ГБ/с. За ціною він майже зрівнявся зі збіркою Pi + HAT: ComputingForGeeks оцінює Jetson з NVMe-диском у $440–480.
- Pi лишається найкращим там, де важливі 5–8 Вт, екосистема HAT-плат і GPIO для датчиків, камер і реле. За ціною переваги вже немає: Pi 5 16 ГБ у листопаді в 1,1 раза дорожчий за типовий міні-ПК на N150.
Детальніше про те, чому для домашнього ШІ важливіша пам’ять, а не NPU, — у розборі домашній ШІ-сервер: NAS, міні-ПК чи ПК.
Ризики AI HAT+ 2 і Pi 5: контекст, якість моделей, ціни
- Контекст 2048 токенів. Hackster.io попросив модель на HAT переказати огляд і отримав повідомлення про переповнення контексту. Документи, довге листування і RAG за власними файлами на HAT не працюють.
- Якість моделей 1–4B. Вони плутають факти й погано тримають довгу думку. У тесті CNX Software переклад короткої фрази французькою вийшов неточним. Для довідкових запитань такі моделі ненадійні.
- Лише формат HEF. Нова модель з’явиться на HAT, тільки коли її скомпілює Hailo. Завантажити свіжу модель із Hugging Face в день релізу, як в Ollama, не вийде.
- Холодний старт і сирі інструменти. Прискорювач вивантажує модель після простою, і перша відповідь чекає 25–40 секунд (Hackster.io). hailo-ollama дублює запити в термінал, версія 0.5.1 падала на запиті з переносом рядка (ai-local-lab), а Open WebUI з інструкції відкривається через HTTP на всіх мережевих інтерфейсах — у домашній мережі це варто закрити.
- Нерівний ритм оновлень. Релізи ПЗ для Hailo-10H виходять раз на квартал, але липневе оновлення 2026 року запізнилося: пакети 5.4.0 вийшли лише 9–16 вересня, і навіть тоді застосунки hailo-apps їх не приймали.
- Зміна власника Hailo. 24 липня 2026 року Microchip оголосив про підписання угоди про купівлю Hailo. Закриття очікували до кінця вересня, підтвердження завершення угоди ми не знайшли. Як це позначиться на підтримці Hailo-10H, поки невідомо.
- Ціни на пам’ять. За 2026 рік Raspberry Pi підвищував ціни чотири рази, востаннє — 2 листопада, і дефіцит пам’яті поки не закінчився.
Зв’язка має і сильні сторони: повна робота без інтернету, дані не йдуть у хмару, 7 Вт під навантаженням і роз’єм GPIO, до якого безпосередньо підключаються камери, датчики й реле.
Що застаріє першим. Ціни Raspberry Pi, список моделей у каталозі Hailo (нова версія виходить раз на квартал) і швидкість рантаймів: свіжа версія Ollama або LiteRT-LM може зсунути цифри з таблиць на десятки відсотків. Перед купівлею звірте ціну на сторінці продукту і версію в каталозі Hailo.
Коли Raspberry Pi 5 для LLM замало і куди переходити далі
Рішення зручно ухвалювати покроково — від завдання до заліза:
- Потрібна модель 7B і більше або швидкість вище 10 tok/s на 3B? Pi не підходить у жодному варіанті: на 7–8B він дає менше ніж 2 tok/s. Дивіться міні-ПК, Mac або ПК з відеокартою.
- Потрібні довгі документи, RAG або листування на десятки повідомлень? Відпадає AI HAT+ 2 з його 2048 токенами. Pi 5 на процесорі довгий контекст обробить, але повільно: на новому запиті в 1864 токени ai-local-lab чекав першого токена 29,7 секунди.
- Потрібен голосовий помічник або текстові команди розумного дому? Вистачить Pi 5 8 ГБ без прискорювача за ≈$240.
- Потрібна камера, яка описує подію словами, або живлення від батареї? Це сценарій для Pi 5 2 ГБ + AI HAT+ 2 за ≈$340.
- Хочете максимум якості на одноплатнику й готові чекати? Pi 5 16 ГБ з MoE-моделлю Qwen3-30B-A3B, але за ≈$450 міні-ПК уже швидший на звичайних моделях.
Чекати наступного покоління немає сенсу. Ебен Аптон на сесії запитань і відповідей 21 травня 2026 року сказав, що Pi 6 вийде не раніше початку 2028 року. Окремого NPU в ньому не чекають: майданчиком для ШІ-обчислень Аптон назвав сам процесор.
Наступний щабель після одноплатника — за нашим гідом як вибрати залізо для локального ШІ. Якщо бюджет дозволяє перескочити одразу через міні-ПК, подивіться Mac Mini M4 Pro для нейромереж: у нього швидка єдина пам’ять, а отже й інший порядок швидкості.
FAQ
Чи потягне Raspberry Pi 5 на 8 ГБ модель на 7B?
Запустить, але користуватися буде важко. У замірах ai-local-lab модель Ministral 3 8B у квантуванні Q4_K_M видала на Pi 5 8 ГБ 1,96 токена за секунду, тобто абзац відповіді пишеться близько хвилини. Пам’яті вистачає, усе впирається в пропускну здатність. Для моделі 7–8B розумніше взяти міні-ПК або Mac, а на Pi 5 краще ставити модель на 1,5–3B.
Чи потрібен AI HAT+ 2, якщо в мене Raspberry Pi 5 на 16 ГБ?
Для чату — ні. Ті самі відкриті моделі (Qwen2.5, Llama 3.2, Gemma) Pi 5 запускає на процесорі у форматі GGUF, і в незалежних замірах на однакових моделях процесор швидший за HAT. До того ж 16 ГБ тягнуть 14B і MoE-модель на 30B, яких у HAT немає. AI HAT+ 2 має сенс, лише якщо потрібні камера з VLM, розвантаження процесора або робота від акумулятора.
Чи працює AI HAT+ 2 з Raspberry Pi 4 або Pi 500?
Ні. AI HAT+ 2 підключається до роз’єму PCIe у форматі Raspberry Pi 5: у Pi 4, Pi 500 і Pi 500+ немає виведеного роз’єму PCIe під плату розширення. Офіційно підтримується лише Raspberry Pi 5, причому підійде будь-яка версія пам’яті, зокрема 2 ГБ: модель зберігається у власних 8 ГБ на платі прискорювача.
Чи можна запустити GGUF-модель з Hugging Face на Hailo-10H?
Ні. Hailo-10H розуміє лише моделі у форматі HEF, які Hailo заздалегідь компілює під свій чип і викладає в каталог Model Zoo GenAI. На 15 листопада 2026 року там близько десятка LLM і VLM до 4B. Власну модель можна лише донавчити адаптерами LoRA і зібрати через Hailo Dataflow Compiler, довільний GGUF не завантажується.
Чи можна поставити NVMe-диск разом з AI HAT+ 2?
Безпосередньо — ні. У Raspberry Pi 5 одна лінія PCIe, і AI HAT+ 2 займає її повністю, тому для NVMe-накопичувача знадобиться окрема плата-розгалужувач PCIe. Без неї система завантажується з картки microSD або USB-накопичувача. Якщо швидкий SSD для системи важливіший за прискорювач, обирайте збірку на процесорі: без HAT лінія PCIe вільна, і NVMe-накопичувач підключається через M.2-плату.