Коротко (TL;DR)
- Обсяг VRAM — це поріг. Він вирішує, чи влізе модель у пам’ять відеокарти. Не влізла — швидкість падає в рази: 70B-модель на RTX 4090, у якої половина ваг лежить у звичайній ОЗП, видає 2,32 токена за секунду.
- Пропускна здатність пам’яті — це швидкість. Для всього, що влізло, генерація упирається в те, скільки гігабайтів за секунду чип читає з пам’яті. Стелю обчислює одна формула: ГБ/с ÷ розмір моделі в ГБ.
- Однаковий обсяг не означає однакової швидкості. RTX 5060 Ti і RTX 5070 Ti мають по 16 ГБ. На одній і тій самій моделі вони дають 90,94 і 176,85 токена за секунду, бо смуга в другої вдвічі ширша (448 проти 896 ГБ/с).
- Реальність — 60–80% від стелі у відеокарт NVIDIA. У семи карт в одному тесті llama.cpp частка стелі — від 61,9% до 77,6%. У чипів Apple розкид ширший: від 40% в Ultra до 83% у M5 Pro.
- Формула не працює для обробки промпту, для кількох запитів одночасно й для зв’язки з двох відеокарт: друга карта додає обсяг, але не швидкість.
- Ми не запускали моделі самі: швидкості взято з відкритих вимірів llama.cpp із названою методикою, розрахунки наші.
Обсяг VRAM і пропускна здатність пам’яті: у кожного своя робота
Питання «що важливіше для локальної нейромережі — обсяг відеопам’яті чи її швидкість» поставлене не зовсім правильно. Це два різні обмеження, і вони не змагаються. Обсяг відповідає на питання «чи запуститься модель узагалі». Пропускна здатність пам’яті (англійською memory bandwidth) відповідає на питання «як швидко вона друкуватиме відповідь».
- Коротко (TL;DR)
- Обсяг VRAM і пропускна здатність пам’яті: у кожного своя робота
- Чому кожен токен — це читання всієї моделі з пам’яті
- Формула стелі: токенів за секунду = ГБ/с ÷ розмір моделі в ГБ
- Паспортна пропускна здатність: відеокарти, Mac, міні-ПК і ОЗП
- Стеля проти виміру: яку частку пропускної здатності отримуємо
- Однакові 16 ГБ, різна швидкість: RTX 5060 Ti проти RTX 5070 Ti
- Модель не влізла у VRAM: швидкість падає в рази, а не на відсотки
- Довгий контекст: KV-кеш додає читання на кожен токен
- MoE-моделі: обсяг рахують за всіма експертами, швидкість за активними
- Де формула не працює: промпт, батч, друга карта й бекенд
- Що брати під 8B, 14B, 32B і 70B: стелі за платформами
- Як перевірити свою карту через llama-bench: тест на 5 хвилин
- Слабкі місця розрахунку швидкості LLM: що не перевірено
- Часті запитання
Обсяг працює як сходинка. Поки ваги моделі й робочий кеш уміщаються у VRAM, він більше не впливає на швидкість: зайві 8 ГБ просто простоюють. Щойно модель перестала влазити, частина ваг переїжджає в оперативну пам’ять комп’ютера, а вона в десятки разів повільніша. Швидкість падає не на відсотки, а в рази.
Пропускна здатність працює як плавна шкала. Це скільки гігабайтів за секунду чип може прочитати зі своєї пам’яті. Що ширша смуга, то більше токенів за секунду на тій самій моделі. Тож коли питають про memory bandwidth LLM, насправді питають про швидкість відповіді, а не про те, які моделі вмістяться.Параметр Що вирішує Як поводиться Приклад із вимірів Обсяг VRAM, ГБ Чи влізе модель із контекстом Сходинка: влізла чи ні 70B Q4 на RTX 4090 24 ГБ: 2,32 ток/с, коли половина ваг в ОЗП Пропускна здатність, ГБ/с Скільки токенів за секунду Плавна шкала, майже лінійна Удвічі ширша смуга — майже вдвічі більше токенів (розбір нижче) Обчислення (TFLOPS) Швидкість обробки промпту Важливі для prefill, мало впливають на генерацію RTX 5090: промпт 14 073 ток/с, генерація 290 ток/с
Звідси просте правило вибору. Спершу перевіряємо обсяг: чи влазить потрібна модель із запасом під контекст. Потім серед варіантів, де вона влазить, дивимося на пропускну здатність. Скільки пам’яті треба під конкретну модель і квант, ми рахували окремо в розрахунку відеопам’яті під модель і KV-кеш. Ця стаття — про другу половину: швидкість.
Чому кожен токен — це читання всієї моделі з пам’яті
Мовна модель пише відповідь по одному токену. Токен — це шматочок тексту: слово, частина слова або знак. Щоб видати наступний токен, модель пропускає його через усі свої шари й для цього звертається до всіх своїх ваг. Ваги — це мільярди чисел, що лежать у пам’яті. Для щільної моделі розміром 5 ГБ це означає прочитати з пам’яті близько 5 ГБ на кожен токен.
Арифметики тут небагато, і сучасний чип дає їй раду швидко. Вузьке місце — доставка даних із пам’яті до обчислювальних блоків. Чип більшу частину часу чекає на пам’ять. Інженери називають таке завдання memory-bound — «упирається в пам’ять». NVIDIA в технічному блозі «Mastering LLM Techniques» прямо пише про фазу генерації: це операція, обмежена пам’яттю. До того самого висновку доходить огляд «LLM Inference Unveiled» (arXiv 2402.16363): обробка промпту упирається в обчислення, а генерація токенів — у пам’ять, навіть на професійній карті.
Зручна аналогія — кухар і склад. Кухар (обчислювальні блоки) ріже швидко. Але перед кожною стравою йому доводиться заново принести зі складу всі продукти. Скільки страв за годину він віддасть, вирішує не швидкість ножа, а ширина дверей складу. Ширина дверей і є пропускна здатність.
Звідси головний наслідок для локального запуску — те, що в англомовних гайдах обговорюють як memory bandwidth for local LLM: за одного запиту (так званий batch 1 — звичайний чат однієї людини) швидкість генерації зростає разом зі смугою пам’яті, а не з кількістю ядер. Так само рахують англомовні калькулятори швидкості, наприклад у Hardware Corner. Нижче ми перевіряємо формулу на реальних вимірах.
Формула стелі: токенів за секунду = ГБ/с ÷ розмір моделі в ГБ
Що таке токени за секунду? Це швидкість, з якою модель видає новий текст: скільки токенів вона генерує за одну секунду відповіді. Скорочено — ток/с, в англомовних тестах t/s або tok/s. У llama.cpp цю швидкість показує колонка tg (token generation, генерація токенів). Її не плутають із pp (prompt processing) — швидкістю читання вашого запиту.
Формула стелі випливає з механізму вище. Якщо на кожен токен треба прочитати всю модель, то за секунду її можна прочитати не більше ніж «смуга ÷ розмір» разів:
стеля ток/с = пропускна здатність (ГБ/с) ÷ розмір моделі в пам’яті (ГБ)
Стеля — це межа, швидше за яку фізично не буває. Реальна швидкість завжди нижча: частина часу йде на накладні витрати. Наскільки нижча — розберемо в наступних розділах.
Розрахунок крок за кроком на Llama 3.1 8B
- Беремо розмір файлу моделі. Llama 3.1 8B Instruct у кванті Q4_K_M (стиснений варіант, приблизно 4,5–5 біт на вагу) важить 4 920 739 232 байти, тобто 4,92 ГБ (розмір файлу за даними Hugging Face).
- Беремо паспортну пропускну здатність карти зі сторінки виробника: RTX 5090 — 1792 ГБ/с, RTX 4090 — 1008 ГБ/с, RTX 3090 — 936 ГБ/с (дані NVIDIA на 8 листопада 2026 року).
- Ділимо. RTX 5090: 1792 ÷ 4,92 = 364 ток/с. RTX 4090: 1008 ÷ 4,92 = 205 ток/с. RTX 3090: 936 ÷ 4,92 = 190 ток/с.
- Множимо на частку стелі, яку реально беруть карти (розділ нижче): приблизно 0,6–0,8. Для RTX 4090 очікуємо близько 120–165 ток/с. Незалежний вимір XiongjieDai (llama.cpp, травень 2024) для Llama 3 8B Q4_K_M на цій карті дав 127,74 ток/с.
Як порахувати пропускну здатність, якщо її немає в паспорті
Пропускна здатність відеопам’яті = ширина шини в бітах ÷ 8 × швидкість пам’яті на контакт. Приклад: у RTX 3090 шина 384 біти й GDDR6X на 19,5 Гбіт/с. Отримуємо 384 ÷ 8 × 19,5 = 936 ГБ/с — рівно те, що NVIDIA пише в whitepaper архітектури GA102. Зі звичайною оперативною пам’яттю так само: у Ryzen AI Max+ 395 шина 256 біт і LPDDR5x-8000, тобто 8000 МТ/с × 32 байти = 256 ГБ/с.
Чому квантування прискорює генерацію
Квант — це спосіб зберігати кожну вагу меншою кількістю біт. Менше байтів на модель — менше читати на кожен токен. Llama 3 8B у 16-бітному вигляді важить 16,06 ГБ, у Q4_K_M — близько 4,92 ГБ. Стеля RTX 4090 для них — 62,8 і 204,8 ток/с. Вимір XiongjieDai: 54,34 і 127,74 ток/с. Квантування прискорило генерацію у 2,4 раза без зміни заліза. Як квант позначається на якості відповідей — розібрано в матеріалі про квантування Q4 і Q8.
Паспортна пропускна здатність: відеокарти, Mac, міні-ПК і ОЗП
Нижче — пропускна здатність платформ, які найчастіше розглядають під локальні моделі. Цифри — паспортні зі сторінок виробників на 8 листопада 2026 року або пораховані за паспортними частотами пам’яті. Паспорт — це теоретичний пік. Реальна смуга нижча: автор розбору на Habr (12.08.2026) виміряв у RTX 5090 1671 ГБ/с послідовного читання, це 93% від паспортних 1792.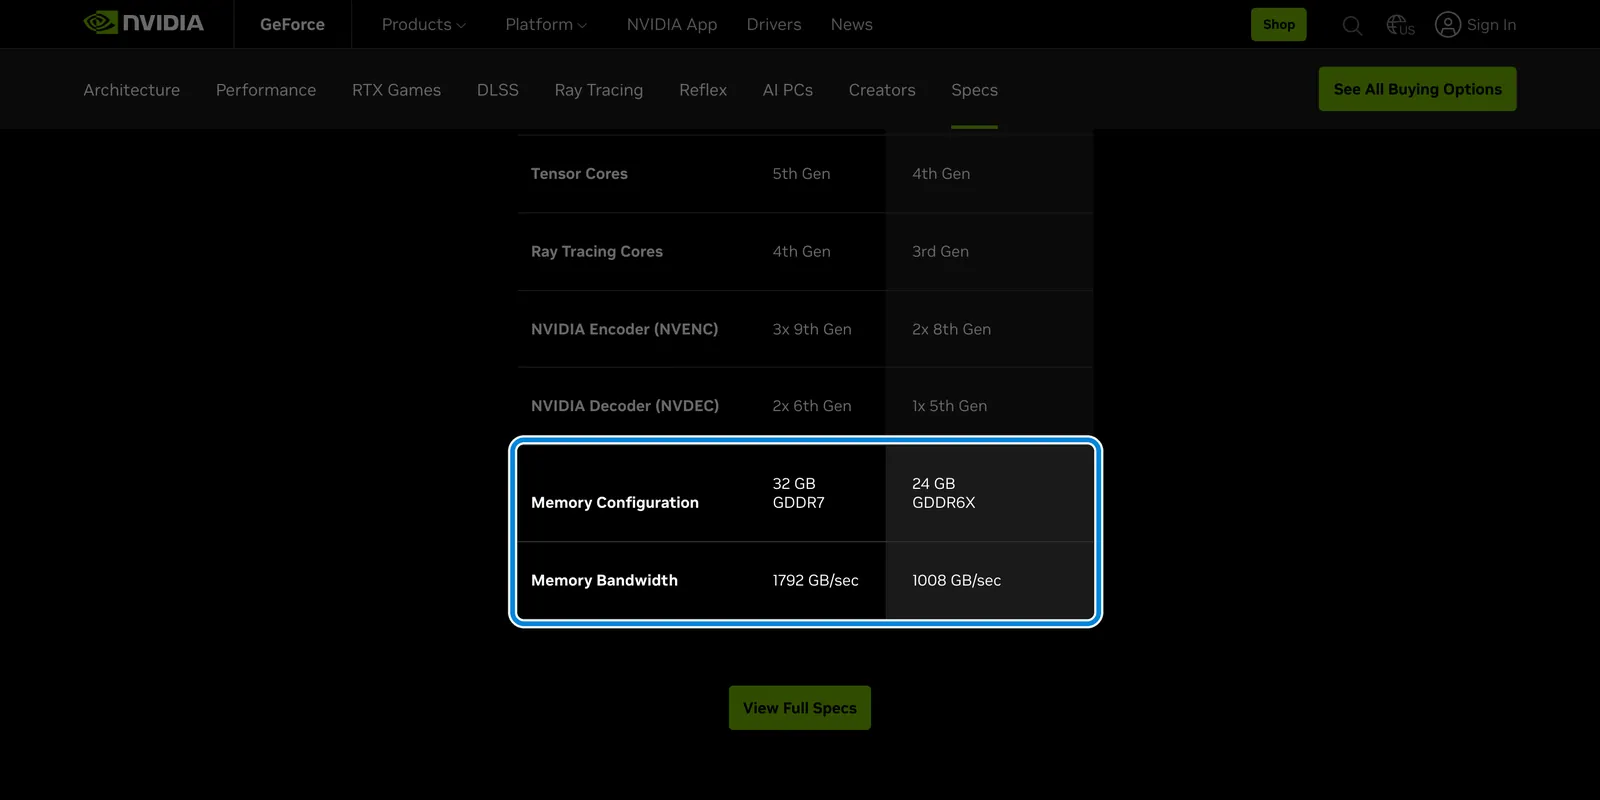
На кадрі — таблиця характеристик зі сторінки RTX 5090 у NVIDIA, знята 8 листопада 2026 року. Рамкою виділено два рядки, заради яких варто відкривати паспорт карти під LLM: Memory Configuration і Memory Bandwidth. Обсяг у 5090 більший, ніж у 4090, в 1,33 раза, а смуга — в 1,78 раза.Платформа Обсяг пам’яті Пропускна здатність, ГБ/с Звідки цифра RTX 5090 32 ГБ GDDR7 1792 NVIDIA, сторінка RTX 5090 RTX 4090 24 ГБ GDDR6X 1008 NVIDIA, сторінка RTX 5090 (колонка 4090) RTX 5080 16 ГБ GDDR7 960 NVIDIA, сторінка RTX 5080 RTX 3090 24 ГБ GDDR6X 936 NVIDIA, whitepaper GA102 RTX 5070 Ti 16 ГБ GDDR7 896 NVIDIA, сторінка RTX 5070 Family RTX 4080 16 ГБ GDDR6X 717 NVIDIA, сторінка RTX 5080 (колонка 4080) RTX 5070 12 ГБ GDDR7 672 NVIDIA, сторінка RTX 5070 Family RTX 5060 Ti 8 або 16 ГБ GDDR7 448 NVIDIA, сторінка RTX 5060 Family Mac Studio M5 Ultra до 512 ГБ єдиної пам’яті ≈1200 (1,2 ТБ/с) Apple, характеристики Mac Studio Mac Studio M5 Max, 40-ядерний GPU до 128 ГБ 614 Apple, характеристики Mac Studio Mac Studio M5 Max, 32-ядерний GPU 36 ГБ 460 Apple, характеристики Mac Studio NVIDIA DGX Spark 128 ГБ LPDDR5x 273 NVIDIA, сторінка DGX Spark Ryzen AI Max+ 395 (Strix Halo) до 128 ГБ LPDDR5x 256 AMD: 256 біт × LPDDR5x-8000 ПК, двоканальна DDR5-6000 скільки поставите 96 Hardware Corner: МТ/с × канали × 8 ÷ 1000
Таблиця показує головну суперечність ринку. Міні-ПК і Mac дають багато пам’яті, але вузьку смугу. Відеокарти — навпаки. Звичайна двоканальна DDR5-6000 у 10,5 раза повільніша за RTX 4090, тому модель, яка «не влізла» у відеокарту й лягла в ОЗП, гальмує так сильно. Докладна таблиця пропускної здатності й обсягів за всіма чипами M1–M6 є в розборі про єдину пам’ять Mac для ШІ, тут її не повторюємо.
Стеля проти виміру: яку частку пропускної здатності отримуємо
Формулу легко написати й важко перевірити: потрібні виміри різних карт на одній моделі, одній програмі й одним тестом. Такий набір є. В обговоренні llama.cpp #15013 учасники ганяють ту саму Llama 2 7B у кванті Q4_0 через llama-bench на відеокартах NVIDIA з бекендом CUDA (бекенд — прошарок, через який llama.cpp працює із залізом: CUDA в NVIDIA, Metal в Apple, Vulkan і ROCm в AMD). Файл моделі важить 3,56 ГіБ, це 3,82 ГБ. Ми поділили паспортну смугу кожної карти на 3,82 й порівняли стелю з виміром tg128 (генерація 128 токенів) без Flash Attention — оптимізації, що прискорює роботу з контекстом. Застереження: кожен рядок таблиці надіслав свій учасник зі своєю збіркою llama.cpp і драйвером, тому різниця у 2–3% між картами — у межах шуму.Карта VRAM, ГБ Смуга, ГБ/с Стеля, ток/с Вимір tg128, ток/с Частка стелі RTX 5090 32 1792 468,8 290,02 61,9% RTX 4090 24 1008 263,7 186,21 70,6% RTX 5080 16 960 251,1 181,99 72,5% RTX 5070 Ti 16 896 234,4 176,85 75,4% RTX 3090 24 936 244,9 158,16 64,6% RTX 5070 12 672 175,8 127,54 72,5% RTX 5060 Ti 16 448 117,2 90,94 77,6%
Частка стелі в семи карт — від 61,9% до 77,6%, медіана 72,5%. Швидкість іде за смугою майже лінійно: коефіцієнт кореляції між смугою й виміром — 0,989 (1,0 — ідеальна пряма). Зверніть увагу на виняток: найшвидша карта бере найменшу частку. У RTX 5090 на токен маленької моделі йде так мало часу, що помітнішими стають постійні накладні витрати — запуск обчислень, синхронізація, службові операції.
Це підтверджує й зворотний досвід. Коли модель велика й байтів на токен багато, накладні витрати тонуть у читанні. На Llama 3 8B у 16 бітах (16,06 ГБ) виміри XiongjieDai дають: RTX 4090 — 54,34 ток/с (86,6% стелі), RTX 3090 — 46,51 (79,8%), RTX 4080 — 40,29 (90,2%). Що важча модель, то ближча швидкість до паспорта.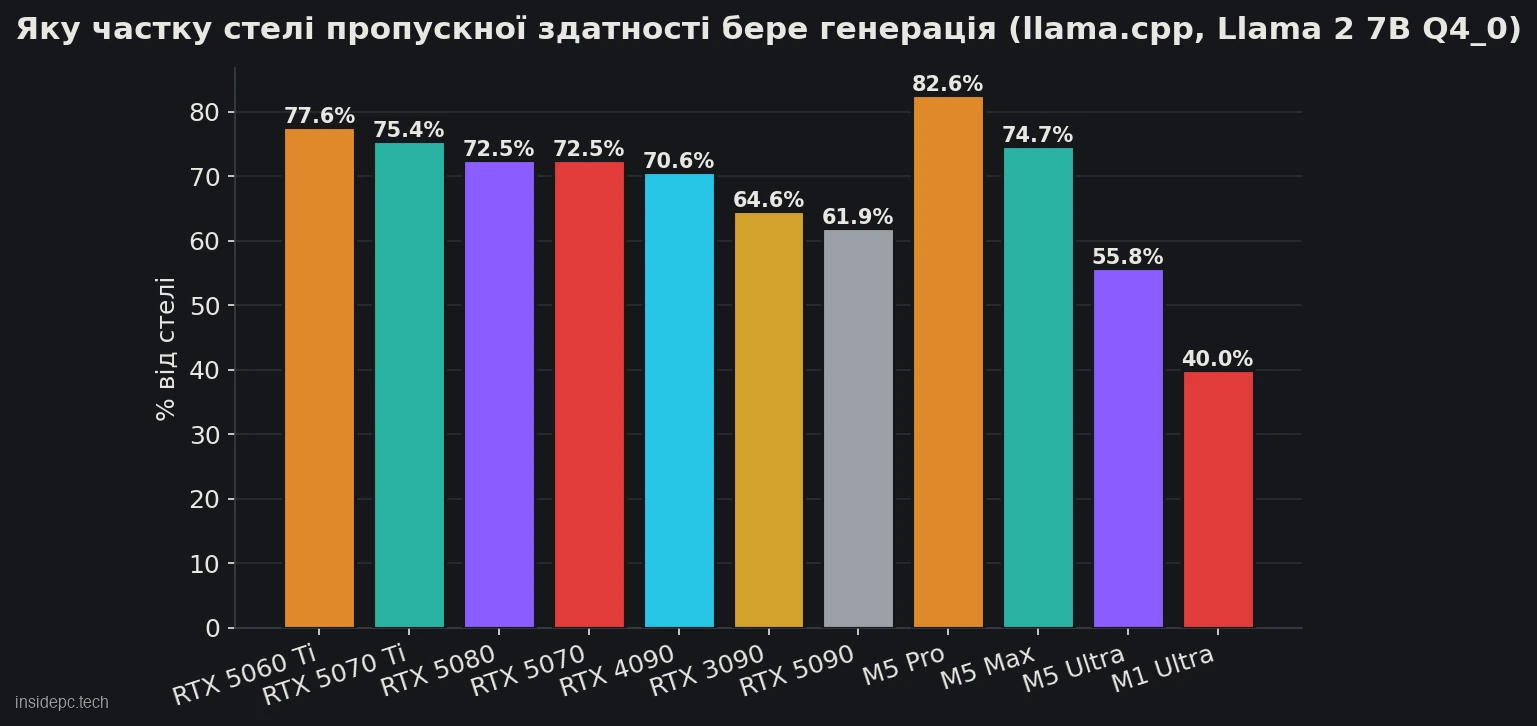
Чипи Apple: подвоєння смуги не подвоює швидкість
В Apple схожий набір — обговорення llama.cpp #4167 з тією самою моделлю Llama 7B Q4_0 на Metal. Там видно, що частка стелі залежить від класу чипа. Базові й Pro-чипи беруть 70–83%. Ultra-чипи, склеєні з двох кристалів, — 40–56%.Чип Смуга, ГБ/с Стеля, ток/с Вимір tg, ток/с Частка стелі M4 Pro, 20 ядер GPU 273 71,4 50,74 71,0% M5 Pro, 20 ядер GPU 307 80,3 66,33 82,6% M5 Max, 40 ядер GPU 614 160,6 119,92 74,7% M5 Ultra, 80 ядер GPU 1228 321,3 179,10 55,8%
Від M5 Max до M5 Ultra смуга зростає рівно у 2 рази, а швидкість — в 1,49 раза. У минулих поколінь Ultra ще нижче: M1 Ultra на 64 ядра — 83,73 ток/с за стелі 209,3 (40%), M2 Ultra і M3 Ultra — 94,27 і 92,14 ток/с (45% і 44%). Для Mac звідси практичне правило: на Ultra-чипі множте стелю не на 0,7, а на 0,4–0,6.
Що означають «токени за секунду» в чужому тесті: умови вирішують
Що означають «токени за секунду» в огляді конкретної карти, залежить від умов тесту. Число без моделі, кванта, бекенда й довжини контексту непорівнянне. 186 ток/с у RTX 4090 — це Llama 2 7B Q4_0 у CUDA на порожньому контексті. На 8B Q4_K_M та сама карта дає 127,74, на 16-бітній 8B — 54,34. Порівнюйте карти тільки в межах одного тесту. Саме тому в розділі нижче ми беремо пари з однієї таблиці.
Однакові 16 ГБ, різна швидкість: RTX 5060 Ti проти RTX 5070 Ti
Найкраща перевірка тези «швидкість вирішує смуга, а не обсяг» — знайти карти з однаковим обсягом і різною смугою в одному й тому самому тесті. У таблиці llama.cpp #15013 таких пар кілька.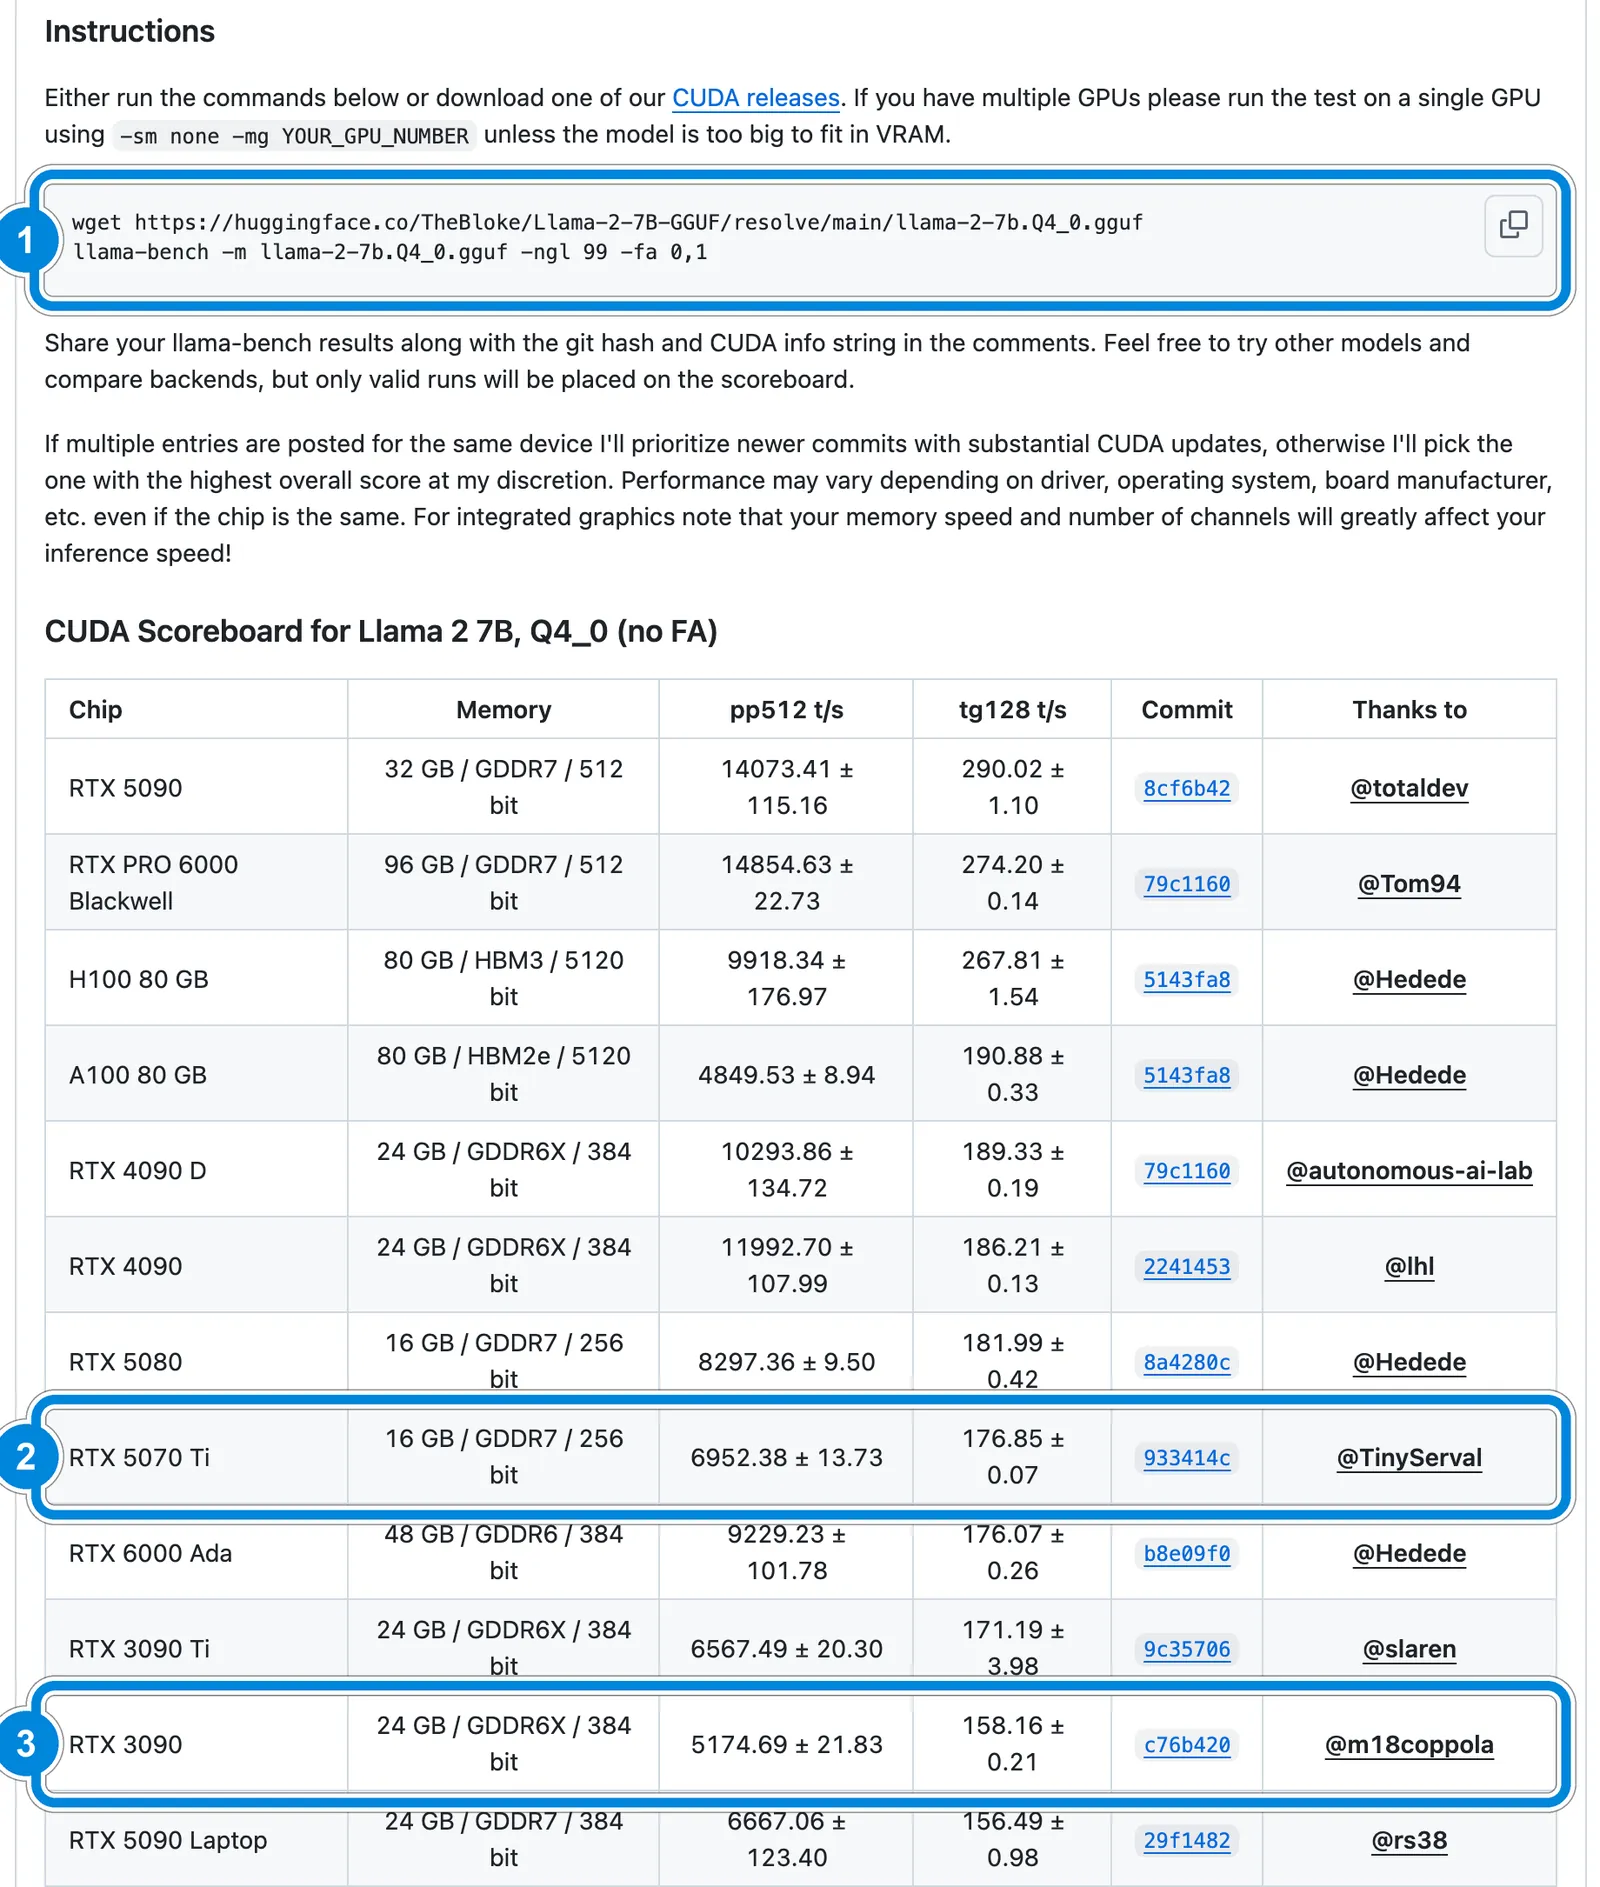
Кадр знято 8 листопада 2026 року. Номер 1 — команда, якою учасники отримують свої цифри (її ж використовуємо в розділі про самоперевірку). Номер 2 — RTX 5070 Ti на 16 ГБ: 176,85 ток/с. Номер 3 — RTX 3090 на 24 ГБ: 158,16 ток/с. Карта з меншим обсягом швидша на 12%.
- RTX 5060 Ti 16 ГБ проти RTX 5070 Ti 16 ГБ. Обсяг той самий. Шина — 128 проти 256 біт, смуга — 448 проти 896 ГБ/с (×2,0). Швидкість — 90,94 проти 176,85 ток/с (×1,94). Майже ідеальний збіг співвідношення смуги й співвідношення швидкості.
- RTX 3090 24 ГБ проти RTX 5070 Ti 16 ГБ. У старої карти на 8 ГБ більше пам’яті й трохи більша паспортна смуга (936 проти 896 ГБ/с). Але у вимірі вона повільніша: 158,16 проти 176,85 ток/с. Різниця — у частці стелі (64,6% проти 75,4%): новіша архітектура краще використовує свою смугу, а учасники ганяли тест на різних версіях llama.cpp (у кожного рядка таблиці свій коміт). Обсяг тут не допомагає взагалі.
- RTX 5080 проти RTX 5070 Ti. Обидві по 16 ГБ, у 5080 смуга ширша на 7,1% (960 проти 896 ГБ/с). Швидкість вища лише на 2,9% (181,99 проти 176,85). Поки обсяг однаковий, доплата за старшу модель майже не купує швидкості генерації.
- RTX 5060 Ti 8 ГБ і 16 ГБ. За даними NVIDIA, обидві версії мають одну смугу — 448 ГБ/с. Подвоєна пам’ять не прискорює ту саму модель. Вона відкриває моделі, які у 8 ГБ не вміщаються.
Висновок для вибору: 24 ГБ у RTX 3090 варто брати заради моделей 24–32B, які не влізуть у 16 ГБ, а не заради швидкості. Розбір конкретних карт під це завдання — у матеріалі про вибір відеокарти для локального ШІ.
Модель не влізла у VRAM: швидкість падає в рази, а не на відсотки
Тепер зворотний бік — обсяг. Найнаочніший вимір із відкритою методикою опублікував Максим Саплін на DEV Community 22 серпня 2024 року. Модель Llama 3.1 70B у кванті Q4 (близько 42,5 ГБ) він запускав на RTX 4090 із 24 ГБ і 96 ГБ DDR5-4800. Смугу ОЗП він виміряв в AIDA — близько 70 ГБ/с. Стенд — Windows і LM Studio на рушії llama.cpp.Де лежать ваги Вимір, ток/с Половина у VRAM, половина в ОЗП 2,32 Усе в ОЗП, обчислює процесор 1,42 «100% на GPU», але зайве переливається в Shared VRAM драйвера 0,69
Порахуймо, що передбачає формула. Якщо 21 ГБ лежить у VRAM, а 21,5 ГБ в ОЗП, на кожен токен карта читає свою частину за 21 ÷ 1008 = 0,021 с, а процесор свою — за 21,5 ÷ 70 = 0,307 с. Разом 0,328 с, тобто стеля близько 3,05 ток/с. Вимір — 2,32, це 76% стелі. Відеопам’ять у Сапліна розігнана (+1600 МГц), але на результат це майже не впливає: вузьке місце тут — ОЗП. Для варіанта «все в ОЗП» стеля 70 ÷ 42,5 = 1,65 ток/с, вимір 1,42 (86%). Формула працює й тут, просто враховує кожну пам’ять окремо.
А тепер порівняння, заради якого розділ і потрібен. Якби 42,5 ГБ влізли у VRAM карти зі смугою 1008 ГБ/с, стеля була б 23,7 ток/с — у 10 разів більше за вимір із половиною ваг в ОЗП. Та сама RTX 4090 на 8B-моделі, яка влазить повністю, видає 127,74 ток/с — у 55 разів швидше.
Формула корисна і як перевірка чужих обіцянок. Гайд CraftRigs (квітень 2026) пише про 8–12 ток/с для 70B Q4_K_M на RTX 3090 із 64 ГБ DDR5 за 40–45 шарів моделі на відеокарті. Перевірмо. За такого поділу в ОЗП лишається 18,6–21,3 ГБ. Стенд самого гайду — DDR5-5600, у двоканальної це 89,6 ГБ/с за паспортом. З урахуванням часу на частину у VRAM виходить не більше 3,8–4,3 ток/с. Цифра 8–12 ток/с за правилом «швидкість × вага ≤ смуга» в такій конфігурації недосяжна. Можливо, гайд мав на увазі іншу модель або інші умови, але з указаними параметрами вона не сходиться.
Довгий контекст: KV-кеш додає читання на кожен токен
KV-кеш — це пам’ять моделі про вже прочитаний текст. Щоб не перераховувати весь діалог для кожного нового токена, модель зберігає проміжні результати — ключі й значення (K і V) для кожного шару. Цей кеш теж читається на кожному кроці генерації. Отже, до ваг моделі додається ще один обсяг, що росте з довжиною діалогу.
Розмір рахують за файлом config.json моделі. У Llama 3.1 8B 32 шари, 8 KV-голів і розмір голови 128. У 16-бітному форматі на один токен іде 2 (K і V) × 32 × 8 × 128 × 2 байти = 128 КіБ. Далі просте множення на довжину контексту й ділення смуги на «ваги + кеш».Контекст, токенів KV-кеш, ГБ Стеля RTX 4090 без кешу Стеля RTX 4090 з кешем Падіння 1 024 0,13 204,8 199,4 −2,7% 8 192 1,07 204,8 168,2 −17,9% 32 768 4,29 204,8 109,4 −46,6% 131 072 17,18 204,8 45,6 −77,7%
Це стеля за формулою для повністю заповненого контексту, а не вимір. Реальне падіння залежить від архітектури. Виміряний контрприклад — той самий розбір на Habr (12.08.2026): на RTX 5090 гібридна MoE-модель, у якої лише 11 шарів уваги з 41, до контексту 32K втрачає 14,5% (317,45 → 271,53 ток/с). У звичайної щільної моделі кеш росте швидше, і падіння буде помітнішим. Квантований KV-кеш (8 біт замість 16) зменшує його обсяг удвічі — і вдвічі скорочує зайве читання.
MoE-моделі: обсяг рахують за всіма експертами, швидкість за активними
MoE (mixture of experts, «суміш експертів») — це модель, яка на кожному токені використовує лише частину своїх ваг. Решта «експертів» цієї миті лежать без діла. Для нашої формули це змінює все: обсяг пам’яті потрібен під усі ваги, а читати на кожен токен треба тільки активні.Модель (Q4_K_M) Файл, ГБ Активно на токен Читається за токен, ГБ Стеля RTX 4090 Qwen3-32B, щільна 19,76 усі 32 млрд 19,76 51 ток/с Qwen3-30B-A3B, MoE 18,56 3,3 з 30,5 млрд (10,8%) ≈2,0 (оцінка пропорцією) ≈502 ток/с
Обидві моделі займають пам’ять майже однаково — близько 19–20 ГБ, обидві влазять у 24 ГБ. Але стеля швидкості в MoE в 10 разів вища. Цифра 2,0 ГБ — наша оцінка за часткою активних параметрів: частина ваг (увага, ембединги) читається завжди, тому реальний обсяг читання трохи більший.
Вимір показує, що до стелі MoE добирається гірше за щільні моделі. У розборі на Habr (12.08.2026) автор виміряв реальну смугу RTX 5090 — 1671 ГБ/с — і порахував, скільки її використовує генерація. Щільна Qwen3.5-9B (5,0 ГБ на токен) вибирає 72% смуги: 239,62 ток/с. MoE Qwen3.5-35B-A3B (2,13 ГБ на токен) — лише 41%: 317,45 ток/с. MoE швидша в абсолюті, але лишає на столі більше. Це один розбір одного автора, але методика й команди в ньому наведені.
Практичний висновок: під MoE важливий обсяг (умістити всіх експертів), а швидкість буде високою навіть на середній смузі. Тому MoE-моделі — головний аргумент на користь міні-ПК і Mac із великою єдиною пам’яттю й помірною пропускною здатністю.
Де формула не працює: промпт, батч, друга карта й бекенд
Формула «смуга ÷ розмір» має чотири винятки. Кожен пояснює, чому чужі цифри іноді здаються «неможливими».
Обробка промпту упирається в обчислення
Перш ніж писати відповідь, модель читає ваш запит — це фаза prefill. Тут сотні токенів обробляються разом, і одне читання ваг ділиться на них усі. Вузьким місцем стають обчислення. RTX 5090 у тому самому тесті #15013 обробляє промпт зі швидкістю 14 073 ток/с, а генерує — 290 ток/с, у 48,5 раза повільніше. Якщо вас дратує довга пауза перед першим словом на довгому документі, справа не в смузі пам’яті, а в обчислювальній потужності.
Кілька запитів одночасно (батч)
Коли модель обслуговує кількох користувачів одночасно, ваги читаються один раз на всіх. У вимірах ggml-org на DGX Spark модель gpt-oss-20b (MXFP4) видає 80,13 ток/с одному користувачеві. За 32 одночасних потоків сумарно виходить 681,49 ток/с — у 8,5 раза більше. Кожному окремому потоку дістається 21,3 ток/с. Тому серверні цифри в тисячі токенів за секунду не можна порівнювати з домашнім чатом.
Друга відеокарта не прискорює генерацію
Коли модель ділять між картами за шарами, карти працюють по черзі: спершу перша читає свої шари, потім друга — свої. Обсяг додається, смуга — ні. Виміри XiongjieDai на Llama 3 70B Q4_K_M:Конфігурація Генерація, ток/с 2 × RTX 3090 16,29 4 × RTX 3090 16,89 6 × RTX 3090 16,93 2 × RTX 4090 19,06 4 × RTX 4090 18,83 8 × RTX 4090 18,76
Шість карт замість двох — плюс 4%. Стеля однієї RTX 3090 для такої моделі, якби вона влізла, — близько 22 ток/с; дві карти беруть 74% цього числа, але не більше. А на 8B-моделі, яка влазить в одну карту, друга RTX 3090 навіть сповільнює: 108,07 ток/с проти 111,74. Другу карту купують заради обсягу, а не швидкості. Паралельні режими (tensor parallel у серверних рушіях) уміють додавати смугу, але це вже окреме налаштування, а не звичайний llama.cpp.
Бекенд вирішує, яку частину смуги отримає чип
Пропускна здатність — умова необхідна, але не достатня. На тому самому Ryzen AI Max+ 395 (256 ГБ/с, стеля для Llama 7B Q4_0 — 67 ток/с) один учасник обговорення llama.cpp #10879 отримав 2 жовтня 2026 року: на процесорі 29,52 ток/с (44% стелі), через ROCm — 51,33 (77%), через Vulkan — 54,38 (81%). Пам’ять та сама, різниця майже вдвічі.
Відеокарти NVIDIA теж залежать від бекенда. У Vulkan-таблиці #10879 на тій самій моделі RTX 4090 дає 187,97 ток/с (майже як у CUDA), RTX 3090 — 164,05, а RTX 5070 Ti — 135,63 проти 176,85 у CUDA (на 23% менше). Чим відрізняються Ollama, LM Studio і чистий llama.cpp на одній моделі, ми розбирали в порівнянні Ollama, LM Studio і llama.cpp.
Що брати під 8B, 14B, 32B і 70B: стелі за платформами
Зведімо все в одну таблицю. Для кожної платформи рахуємо, чи влазить модель у Q4_K_M із запасом 10% на контекст і службові потреби, і яка в неї стеля швидкості. Прочерк — модель не влазить. Розміри файлів узято з Hugging Face: Llama 3.1 8B — 4,92 ГБ, Qwen3-14B — 9,0 ГБ, Qwen3-32B — 19,76 ГБ, Llama 3.1 70B — 42,52 ГБ.Платформа Обсяг, ГБ Смуга, ГБ/с 8B 14B 32B 70B RTX 5060 Ti 16 ГБ 16 448 91 50 — — RTX 5070 Ti 16 ГБ 16 896 182 100 — — RTX 3090 24 ГБ 24 936 190 104 47 — RTX 4090 24 ГБ 24 1008 205 112 51 — RTX 5090 32 ГБ 32 1792 364 199 91 — Ryzen AI Max+ 395, 128 ГБ 128 256 52 28 13 6 DGX Spark, 128 ГБ 128 273 56 30 14 6,4 Mac Studio M5 Max 40 ядер, 128 ГБ 128 614 125 68 31 14 Mac Studio M5 Ultra, 512 ГБ 512 1200 244 133 61 28
Усі числа — стеля в ток/с. Реальну швидкість отримуємо множенням на 0,6–0,8 для відеокарт і на 0,4–0,8 для чипів Apple (в Ultra — нижня межа). Для Strix Halo множник сильно залежить від бекенда: за виміром #10879 — від 0,44 на процесорі до 0,81 через Vulkan.
Як читати таблицю за сценаріями:
- 8B і 14B влазять усюди. Тут вирішує тільки смуга: будь-яка відеокарта зі списку в 1,6–7 разів швидша за міні-ПК на 128 ГБ (Strix Halo і DGX Spark).
- 32B уже не влазить у 16 ГБ. Карта на 24 ГБ дає стелю близько 50 ток/с, міні-ПК — 13–14. Це та межа, де обсяг починає вирішувати.
- 70B не влазить у жодну ігрову карту. Лишаються два шляхи: дві відеокарти (обсяг додасться, швидкість лишиться на рівні однієї — близько 16–19 ток/с за вимірами вище) або платформа з великою єдиною пам’яттю, де стеля — 6–28 ток/с залежно від смуги.
Порівняння трьох міні-платформ на 70B і 120B моделях докладно розібрано в матеріалі DGX Spark, Mac Studio і Strix Halo, а який обсяг відеопам’яті брати на виріст — у гайді про обсяг VRAM для локальних LLM.
Як перевірити свою карту через llama-bench: тест на 5 хвилин
Щоб порівняти свою карту з таблицею вище, повторіть тест обговорення #15013. Знадобиться зібраний llama.cpp із бекендом під вашу карту (CUDA для NVIDIA, Metal для Mac) і близько 4 ГБ вільного місця.
- Завантажте еталонну модель — llama-2-7b.Q4_0.gguf із репозиторію TheBloke/Llama-2-7B-GGUF на Hugging Face. Це та сама модель, що в усіх учасників тесту (3,56 ГіБ).
- Запустіть тест:
llama-bench -m llama-2-7b.Q4_0.gguf -ngl 99 -fa 0,1. Прапорець-ngl 99відправляє всі шари на відеокарту,-fa 0,1проганяє тест без Flash Attention і з нею. - Знайдіть рядок tg128. Це швидкість генерації 128 токенів. Рядок pp512 — швидкість читання промпту, для порівняння з формулою він не потрібен.
- Порахуйте свою стелю: паспортна смуга карти ÷ 3,82. Для RTX 4090 це 1008 ÷ 3,82 ≈ 264 ток/с.
- Порівняйте. Нормальна частка для відеокарти — 60–80% стелі. Якщо у вас помітно менше 60%, перевірте, чи всі шари справді на GPU (чи не переповнена пам’ять), який бекенд зібрано й чи не ввімкнено енергоощадний режим.
- Запишіть умови: версію llama.cpp (хеш коміту), бекенд, драйвер і операційну систему. Без них свою цифру нема з чим порівняти.
Якщо у вас кілька відеокарт, в обговоренні просять тестувати на одній: коли модель ділиться між картами, результат перестає відбивати смугу однієї карти.
Слабкі місця розрахунку швидкості LLM: що не перевірено
Ця стаття спирається на чужі виміри й наші розрахунки. Ось де цифри можуть розійтися з тим, що побачите ви.
- Власних вимірів немає. Методику кожного чужого виміру названо в тексті.
- Паспорт — не реальність. Стелю рахують за паспортною смугою. Реальна смуга нижча: у RTX 5090 виміряно 1671 ГБ/с проти 1792 (93%).
- Одна еталонна модель. Основні таблиці — Llama 2 7B Q4_0 на порожньому контексті. На нових архітектурах (MoE, гібриди) частка стелі інша: 41% проти 72% у розборі на Habr.
- Бекенд і збірка змінюють цифри. Vulkan і CUDA на одній карті розходяться до 23%, процесор і відеоядро на одному Strix Halo — майже вдвічі.
- Частина вимірів стара або поодинока. Саплін і XiongjieDai — 2024 рік, Strix Halo — звіт одного учасника від 2 жовтня 2026 року. Вони показують порядок величини, а не константу.
- Розмір Q4_K_M для Llama 3 8B узято за файлом Llama 3.1 8B (4,92 ГБ) — це наближення. Для 16-бітної версії розмір точний.
- Що застаріє першим: таблиця пропускної здатності з виходом нових карт і чипів та частка стелі в нових версіях llama.cpp. Свіжі виміри з’являються в обговореннях #15013 і #4167 на GitHub.
Часті запитання
Що важливіше для локальної нейромережі: обсяг VRAM чи пропускна здатність пам’яті?
Спершу обсяг, потім смуга. Обсяг вирішує, чи влізе модель: не влізла — швидкість падає в рази, у 70B-моделі на RTX 4090 приблизно в 10 разів. Якщо модель влазить на кількох варіантах заліза, вибирає вже пропускна здатність: за однакових 16 ГБ RTX 5070 Ti зі смугою 896 ГБ/с генерує майже вдвічі швидше за RTX 5060 Ti зі смугою 448 ГБ/с. Зайвий обсяг понад потрібний швидкості не додає.
Скільки токенів за секунду дасть моя відеокарта на моделі 8B?
Поділіть паспортну пропускну здатність карти на розмір файлу моделі й помножте на 0,6–0,8. Llama 3.1 8B у Q4_K_M важить 4,92 ГБ, тому в RTX 4090 зі смугою 1008 ГБ/с стеля — 205 токенів за секунду, а реально — близько 120–165. Вимір XiongjieDai на цій карті дав 127,74. Якщо модель не влізла у відеопам’ять повністю, формула враховує кожну пам’ять окремо, і швидкість падає в рази.
Чи прискорить друга відеокарта генерацію тексту?
Ні, у звичайному llama.cpp не прискорить. Карти читають свої шари моделі по черзі, тому обсяг додається, а пропускна здатність — ні. Виміри на Llama 3 70B: дві RTX 3090 дають 16,29 токена за секунду, шість — 16,93. Другу карту беруть, щоб велика модель узагалі вмістилася у відеопам’ять. Додавати смугу вміють режими tensor parallel — передусім у серверних рушіях.
Що означають «токени за секунду» в характеристиках і тестах?
Токени за секунду — це швидкість, з якою модель друкує відповідь. Токен — шматочок тексту: слово, частина слова або знак. У тестах llama.cpp це колонка tg (генерація), а pp — окрема швидкість читання вашого запиту; плутати їх не можна: у RTX 5090 на одній моделі pp — 14 073, а tg — 290 токенів за секунду. Порівнювати цифри можна тільки за однакових моделі, кванта й бекенда.
Чому міні-ПК або Mac зі 128 ГБ пам’яті повільніші за одну RTX 4090 на невеликій моделі?
Бо на невеликій моделі обсяг не потрібен, а смуга в них вужча. Ryzen AI Max+ 395 і DGX Spark дають 256–273 ГБ/с, Mac Studio на M5 Max — 614 ГБ/с, RTX 4090 — 1008 ГБ/с. Для 8B-моделі в Q4_K_M це стеля 52–56, 125 і 205 токенів за секунду відповідно. Виграють такі платформи там, де модель у відеокарту не вміщається.
Чому під час довгого діалогу модель відповідає повільніше?
На кожному токені модель читає не лише свої ваги, а й KV-кеш — збережені дані про попередній текст. Він росте з довжиною діалогу. У Llama 3.1 8B на 32 тисячах токенів контексту кеш займає близько 4,3 ГБ — майже як сама модель у Q4_K_M. За формулою стеля RTX 4090 падає з 205 до 109 токенів за секунду, майже вдвічі.