Коротко (TL;DR)
- Объём VRAM — это порог. Он решает, влезет ли модель в память видеокарты. Не влезла — скорость падает в разы: 70B-модель на RTX 4090 с половиной весов в обычной ОЗУ выдаёт 2,32 токена в секунду.
- Пропускная способность памяти — это скорость. Для всего, что влезло, генерация упирается в то, сколько гигабайт в секунду чип читает из памяти. Потолок считается одной формулой: ГБ/с ÷ размер модели в ГБ.
- Одинаковый объём не значит одинаковую скорость. RTX 5060 Ti и RTX 5070 Ti — обе по 16 ГБ. На одной и той же модели они дают 90,94 и 176,85 токена в секунду, потому что полоса у второй вдвое шире (448 против 896 ГБ/с).
- Реальность — 60–80% от потолка у видеокарт NVIDIA. У семи карт в одном тесте llama.cpp доля потолка — от 61,9% до 77,6%. У чипов Apple разброс шире: от 40% у Ultra до 83% у M5 Pro.
- Формула не работает для обработки промпта, для нескольких запросов сразу и для связки из двух видеокарт: вторая карта добавляет объём, но не скорость.
- Мы не запускали модели сами: скорости взяты из открытых замеров llama.cpp с названной методикой, расчёты наши.
Объём VRAM и пропускная способность памяти: у каждого своя работа
Вопрос «что важнее для локальной нейросети — объём видеопамяти или её скорость» поставлен не совсем правильно. Это два разных ограничения, и они не соревнуются. Объём отвечает на вопрос «запустится ли модель вообще». Пропускная способность памяти (ПСП, по-английски memory bandwidth) отвечает на вопрос «как быстро она будет печатать ответ».
- Коротко (TL;DR)
- Объём VRAM и пропускная способность памяти: у каждого своя работа
- Почему каждый токен — это чтение всей модели из памяти
- Формула потолка: токенов в секунду = ГБ/с ÷ размер модели в ГБ
- Паспортная пропускная способность: видеокарты, Mac, мини-ПК и ОЗУ
- Потолок против замера: какую долю пропускной способности получаем
- Одинаковые 16 ГБ, разная скорость: RTX 5060 Ti против RTX 5070 Ti
- Модель не влезла в VRAM: скорость падает в разы, а не на проценты
- Длинный контекст: KV-кэш добавляет чтение на каждый токен
- MoE-модели: объём считается по всем экспертам, скорость по активным
- Где формула не работает: промпт, батч, вторая карта и бекенд
- Что брать под 8B, 14B, 32B и 70B: потолки по платформам
- Как проверить свою карту через llama-bench: тест на 5 минут
- Слабые места расчёта скорости LLM: что не проверено
- FAQ
Объём работает как ступенька. Пока веса модели и рабочий кэш помещаются в VRAM, он больше не влияет на скорость: лишние 8 ГБ просто простаивают. Как только модель перестала влезать, часть весов уезжает в оперативную память компьютера, а она в десятки раз медленнее. Скорость падает не на проценты, а в разы.
ПСП работает как плавная шкала. Это сколько гигабайт в секунду чип может прочитать из своей памяти. Чем шире полоса, тем больше токенов в секунду при той же модели. Поэтому, когда спрашивают про memory bandwidth LLM, на самом деле спрашивают про скорость ответа, а не про то, какие модели поместятся.Параметр Что решает Как ведёт себя Пример из замеров Объём VRAM, ГБ Влезет ли модель с контекстом Ступенька: влезла или нет 70B Q4 на RTX 4090 24 ГБ: 2,32 ток/с с половиной весов в ОЗУ ПСП, ГБ/с Сколько токенов в секунду Плавная шкала, почти линейная Вдвое шире полоса — почти вдвое больше токенов (разбор ниже) Вычисления (TFLOPS) Скорость обработки промпта Важны для prefill, мало влияют на генерацию RTX 5090: промпт 14 073 ток/с, генерация 290 ток/с
Отсюда простое правило выбора. Сначала проверяем объём: влезает ли нужная модель с запасом под контекст. Потом среди вариантов, где она влезает, смотрим на ПСП. Сколько памяти нужно под конкретную модель и квант, мы считали отдельно в расчёте видеопамяти под модель и KV-кэш. Эта статья — про вторую половину: скорость.
Почему каждый токен — это чтение всей модели из памяти
Языковая модель пишет ответ по одному токену. Токен — это кусочек текста: слово, часть слова или знак. Чтобы выдать следующий токен, модель пропускает его через все свои слои и для этого обращается ко всем своим весам. Веса — это миллиарды чисел, которые лежат в памяти. Для плотной модели размером 5 ГБ это значит: прочитать из памяти около 5 ГБ на каждый токен.
Арифметики при этом немного, и современный чип справляется с ней быстро. Узкое место — доставка данных из памяти к вычислительным блокам. Чип большую часть времени ждёт память. Инженеры называют такую задачу memory-bound — «упирается в память». NVIDIA в техническом блоге «Mastering LLM Techniques» прямо пишет про фазу генерации: это операция, ограниченная памятью. К тому же выводу приходит обзор «LLM Inference Unveiled» (arXiv 2402.16363): обработка промпта упирается в вычисления, а генерация токенов — в память, даже на профессиональной карте.
Удобная аналогия — повар и склад. Повар (вычислительные блоки) режет быстро. Но перед каждым блюдом ему приходится заново принести со склада все продукты. Сколько блюд в час он отдаст, решает не скорость ножа, а ширина двери склада. Ширина двери и есть ПСП.
Отсюда главное следствие для локального запуска — то, что в англоязычных гидах обсуждают как memory bandwidth for local LLM: при одном запросе (так называемый batch 1 — обычный чат одного человека) скорость генерации растёт вместе с полосой памяти, а не с числом ядер. Так же считают англоязычные калькуляторы скорости, например у Hardware Corner. Ниже мы проверяем формулу на реальных замерах.
Формула потолка: токенов в секунду = ГБ/с ÷ размер модели в ГБ
Что такое токены в секунду? Это скорость, с которой модель выдаёт новый текст: сколько токенов она генерирует за одну секунду ответа. Сокращённо — ток/с, в английских тестах t/s или tok/s. В llama.cpp эту скорость показывает колонка tg (token generation, генерация токенов). Её не путают с pp (prompt processing) — скоростью чтения вашего запроса.
Формула потолка выводится из механизма выше. Если на каждый токен нужно прочитать всю модель, то за секунду можно прочитать её не больше, чем «ПСП ÷ размер» раз:
потолок ток/с = ПСП (ГБ/с) ÷ размер модели в памяти (ГБ)
Потолок — это предел, быстрее которого физически не бывает. Реальная скорость всегда ниже: часть времени уходит на накладные расходы. Насколько ниже — разберём в следующих разделах.
Расчёт по шагам на Llama 3.1 8B
- Берём размер файла модели. Llama 3.1 8B Instruct в кванте Q4_K_M (сжатый вариант, около 4,5–5 бит на вес) весит 4 920 739 232 байта, то есть 4,92 ГБ (размер файла по данным Hugging Face).
- Берём паспортную ПСП карты со страницы производителя: RTX 5090 — 1792 ГБ/с, RTX 4090 — 1008 ГБ/с, RTX 3090 — 936 ГБ/с (данные NVIDIA на 8 ноября 2026 года).
- Делим. RTX 5090: 1792 ÷ 4,92 = 364 ток/с. RTX 4090: 1008 ÷ 4,92 = 205 ток/с. RTX 3090: 936 ÷ 4,92 = 190 ток/с.
- Умножаем на долю потолка, которую реально берут карты (раздел ниже): примерно 0,6–0,8. Для RTX 4090 ожидаем порядка 120–165 ток/с. Независимый замер XiongjieDai (llama.cpp, май 2024) для Llama 3 8B Q4_K_M на этой карте дал 127,74 ток/с.
Как посчитать ПСП, если её нет в паспорте
ПСП видеопамяти = ширина шины в битах ÷ 8 × скорость памяти на контакт. Пример: у RTX 3090 шина 384 бита и GDDR6X на 19,5 Гбит/с. Получаем 384 ÷ 8 × 19,5 = 936 ГБ/с — ровно то, что NVIDIA пишет в whitepaper архитектуры GA102. С обычной оперативной памятью то же самое: у Ryzen AI Max+ 395 шина 256 бит и LPDDR5x-8000, то есть 8000 МТ/с × 32 байта = 256 ГБ/с.
Почему квантование ускоряет генерацию
Квант — это способ хранить каждый вес меньшим числом бит. Меньше байт на модель — меньше читать на каждый токен. Llama 3 8B в 16-битном виде весит 16,06 ГБ, в Q4_K_M — около 4,92 ГБ. Потолок RTX 4090 для них — 62,8 и 204,8 ток/с. Замер XiongjieDai: 54,34 и 127,74 ток/с. Квантование ускорило генерацию в 2,4 раза без смены железа. Чем платим за квант в качестве ответов — разобрано в материале про квантование Q4 и Q8.
Паспортная пропускная способность: видеокарты, Mac, мини-ПК и ОЗУ
Ниже — ПСП платформ, которые чаще всего рассматривают под локальные модели. Цифры — паспортные со страниц производителей на 8 ноября 2026 года или посчитаны по паспортным частотам памяти. Паспорт — это теоретический пик. Реальная полоса ниже: автор разбора на Habr (12.08.2026) измерил у RTX 5090 1671 ГБ/с последовательного чтения, это 93% от паспортных 1792.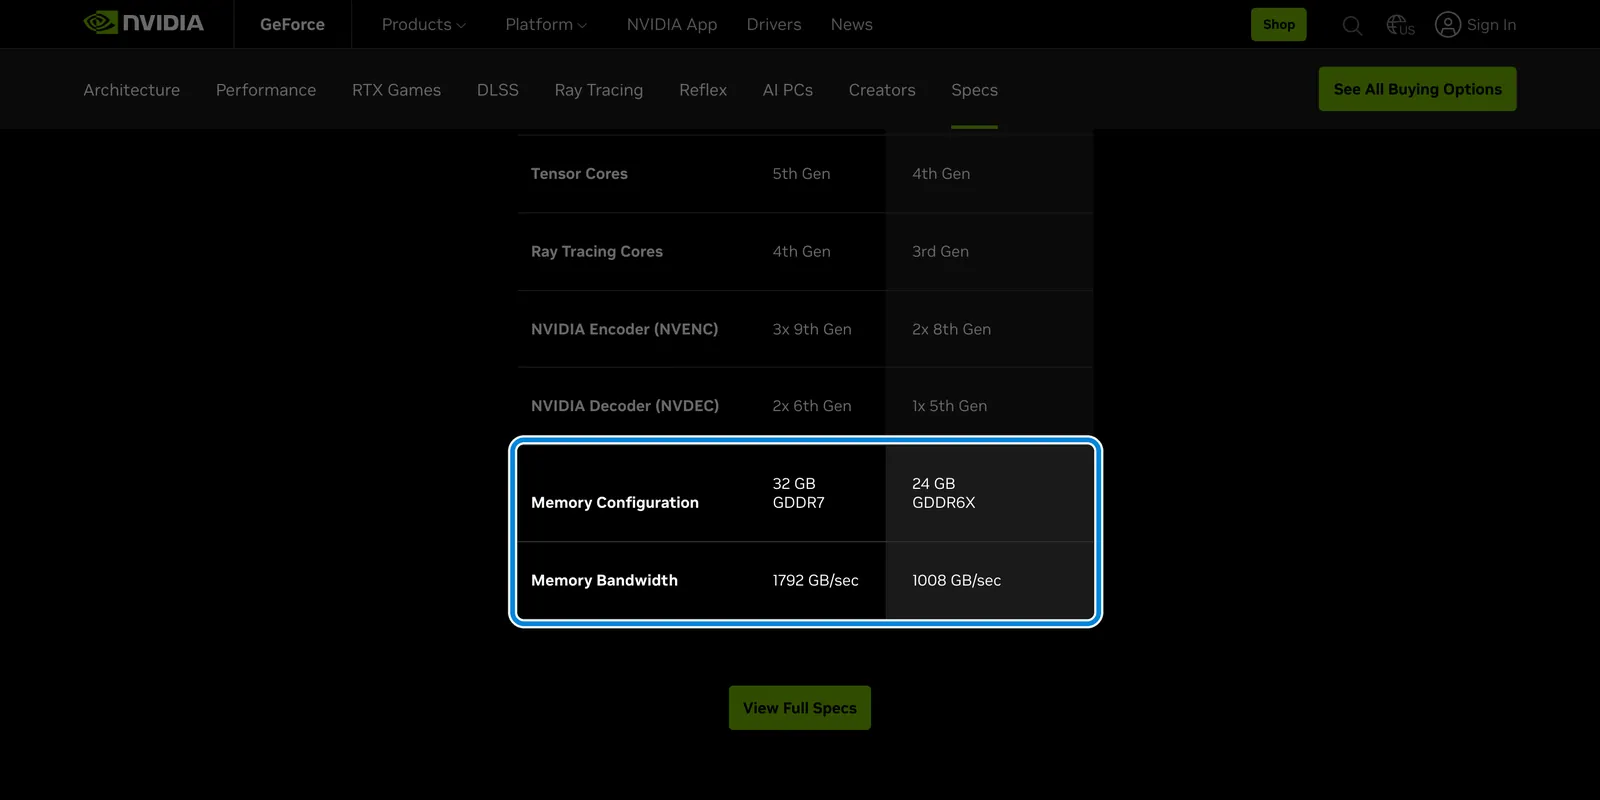
На кадре — таблица характеристик со страницы RTX 5090 у NVIDIA, снятая 8 ноября 2026 года. Рамкой выделены две строки, ради которых стоит открывать паспорт карты под LLM: Memory Configuration и Memory Bandwidth. Объём у 5090 больше, чем у 4090, в 1,33 раза, а полоса — в 1,78 раза.Платформа Объём памяти ПСП, ГБ/с Откуда цифра RTX 5090 32 ГБ GDDR7 1792 NVIDIA, страница RTX 5090 RTX 4090 24 ГБ GDDR6X 1008 NVIDIA, страница RTX 5090 (колонка 4090) RTX 5080 16 ГБ GDDR7 960 NVIDIA, страница RTX 5080 RTX 3090 24 ГБ GDDR6X 936 NVIDIA, whitepaper GA102 RTX 5070 Ti 16 ГБ GDDR7 896 NVIDIA, страница RTX 5070 Family RTX 4080 16 ГБ GDDR6X 717 NVIDIA, страница RTX 5080 (колонка 4080) RTX 5070 12 ГБ GDDR7 672 NVIDIA, страница RTX 5070 Family RTX 5060 Ti 8 или 16 ГБ GDDR7 448 NVIDIA, страница RTX 5060 Family Mac Studio M5 Ultra до 512 ГБ единой памяти ≈1200 (1,2 ТБ/с) Apple, спецификации Mac Studio Mac Studio M5 Max, 40-ядерный GPU до 128 ГБ 614 Apple, спецификации Mac Studio Mac Studio M5 Max, 32-ядерный GPU 36 ГБ 460 Apple, спецификации Mac Studio NVIDIA DGX Spark 128 ГБ LPDDR5x 273 NVIDIA, страница DGX Spark Ryzen AI Max+ 395 (Strix Halo) до 128 ГБ LPDDR5x 256 AMD: 256 бит × LPDDR5x-8000 ПК, двухканальная DDR5-6000 сколько поставите 96 Hardware Corner: МТ/с × каналы × 8 ÷ 1000
Из таблицы видно главное противоречие рынка. Мини-ПК и Mac дают много памяти, но узкую полосу. Видеокарты — наоборот. Обычная двухканальная DDR5-6000 в 10,5 раза медленнее RTX 4090, поэтому модель, которая «не влезла» в видеокарту и легла в ОЗУ, тормозит так сильно. Подробная таблица ПСП и объёмов по всем чипам M1–M6 есть в разборе про единую память Mac для ИИ, здесь её не повторяем.
Потолок против замера: какую долю пропускной способности получаем
Формулу легко написать и трудно проверить: нужны замеры разных карт на одной модели, одной программе и одним тестом. Такой набор есть. В обсуждении llama.cpp #15013 участники гоняют одну и ту же Llama 2 7B в кванте Q4_0 через llama-bench на видеокартах NVIDIA с бекендом CUDA (бекенд — прослойка, через которую llama.cpp работает с железом: CUDA у NVIDIA, Metal у Apple, Vulkan и ROCm у AMD). Файл модели весит 3,56 ГиБ, это 3,82 ГБ. Мы разделили паспортную ПСП каждой карты на 3,82 и сравнили потолок с замером tg128 (генерация 128 токенов) без Flash Attention — оптимизации, которая ускоряет работу с контекстом. Оговорка: каждую строку таблицы прислал свой участник со своей сборкой llama.cpp и драйвером, поэтому разница в 2–3% между картами — в пределах шума.Карта VRAM, ГБ ПСП, ГБ/с Потолок, ток/с Замер tg128, ток/с Доля потолка RTX 5090 32 1792 468,8 290,02 61,9% RTX 4090 24 1008 263,7 186,21 70,6% RTX 5080 16 960 251,1 181,99 72,5% RTX 5070 Ti 16 896 234,4 176,85 75,4% RTX 3090 24 936 244,9 158,16 64,6% RTX 5070 12 672 175,8 127,54 72,5% RTX 5060 Ti 16 448 117,2 90,94 77,6%
Доля потолка у семи карт — от 61,9% до 77,6%, медиана 72,5%. Скорость следует за ПСП почти линейно: коэффициент корреляции между полосой и замером — 0,989 (1,0 — идеальная прямая). Обратите внимание на исключение: самая быстрая карта берёт самую маленькую долю. У RTX 5090 на токен маленькой модели уходит так мало времени, что заметнее становятся постоянные накладные расходы — запуск вычислений, синхронизация, служебные операции.
Это подтверждает и обратный опыт. Когда модель большая и байт на токен много, накладные расходы тонут в чтении. На Llama 3 8B в 16 битах (16,06 ГБ) замеры XiongjieDai дают: RTX 4090 — 54,34 ток/с (86,6% потолка), RTX 3090 — 46,51 (79,8%), RTX 4080 — 40,29 (90,2%). Чем тяжелее модель, тем ближе скорость к паспорту.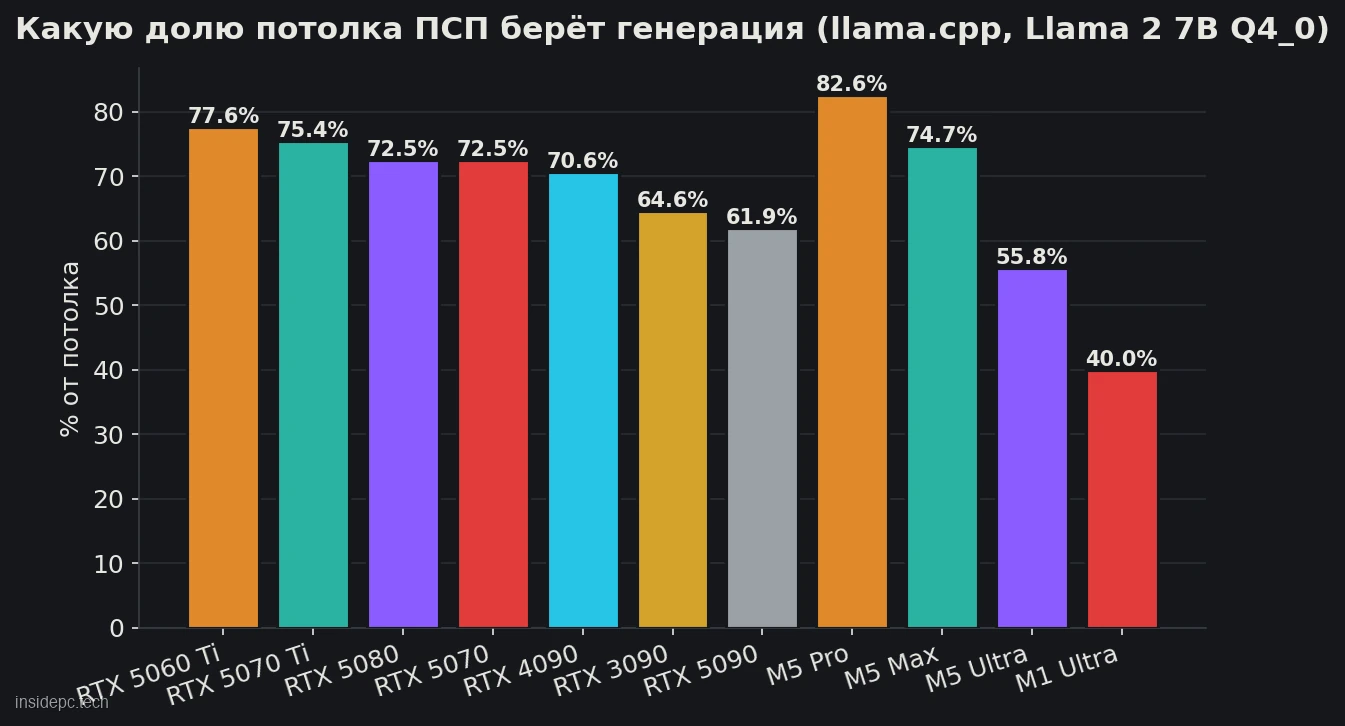
Чипы Apple: удвоение полосы не удваивает скорость
У Apple аналогичный набор — обсуждение llama.cpp #4167 с той же моделью Llama 7B Q4_0 на Metal. Там видно, что доля потолка зависит от класса чипа. Базовые и Pro-чипы берут 70–83%. Ultra-чипы, склеенные из двух кристаллов, — 40–56%.Чип ПСП, ГБ/с Потолок, ток/с Замер tg, ток/с Доля потолка M4 Pro, 20 ядер GPU 273 71,4 50,74 71,0% M5 Pro, 20 ядер GPU 307 80,3 66,33 82,6% M5 Max, 40 ядер GPU 614 160,6 119,92 74,7% M5 Ultra, 80 ядер GPU 1228 321,3 179,10 55,8%
От M5 Max к M5 Ultra полоса растёт ровно в 2 раза, а скорость — в 1,49 раза. У прошлых поколений Ultra ещё ниже: M1 Ultra на 64 ядра — 83,73 ток/с при потолке 209,3 (40%), M2 Ultra и M3 Ultra — 94,27 и 92,14 ток/с (45% и 44%). Для Mac из этого следует практичное правило: на Ultra-чипе умножайте потолок не на 0,7, а на 0,4–0,6.
Что значит «токены в секунду» в чужом тесте: условия решают
Что значат «токены в секунду» в обзоре конкретной карты, зависит от условий теста. Число без модели, кванта, бекенда и длины контекста несравнимо. 186 ток/с у RTX 4090 — это Llama 2 7B Q4_0 в CUDA на пустом контексте. На 8B Q4_K_M та же карта даёт 127,74, на 16-битной 8B — 54,34. Сравнивайте карты только внутри одного теста. Именно поэтому в разделе ниже мы берём пары из одной таблицы.
Одинаковые 16 ГБ, разная скорость: RTX 5060 Ti против RTX 5070 Ti
Лучшая проверка тезиса «скорость решает ПСП, а не объём» — найти карты с одинаковым объёмом и разной полосой в одном и том же тесте. В таблице llama.cpp #15013 таких пар несколько.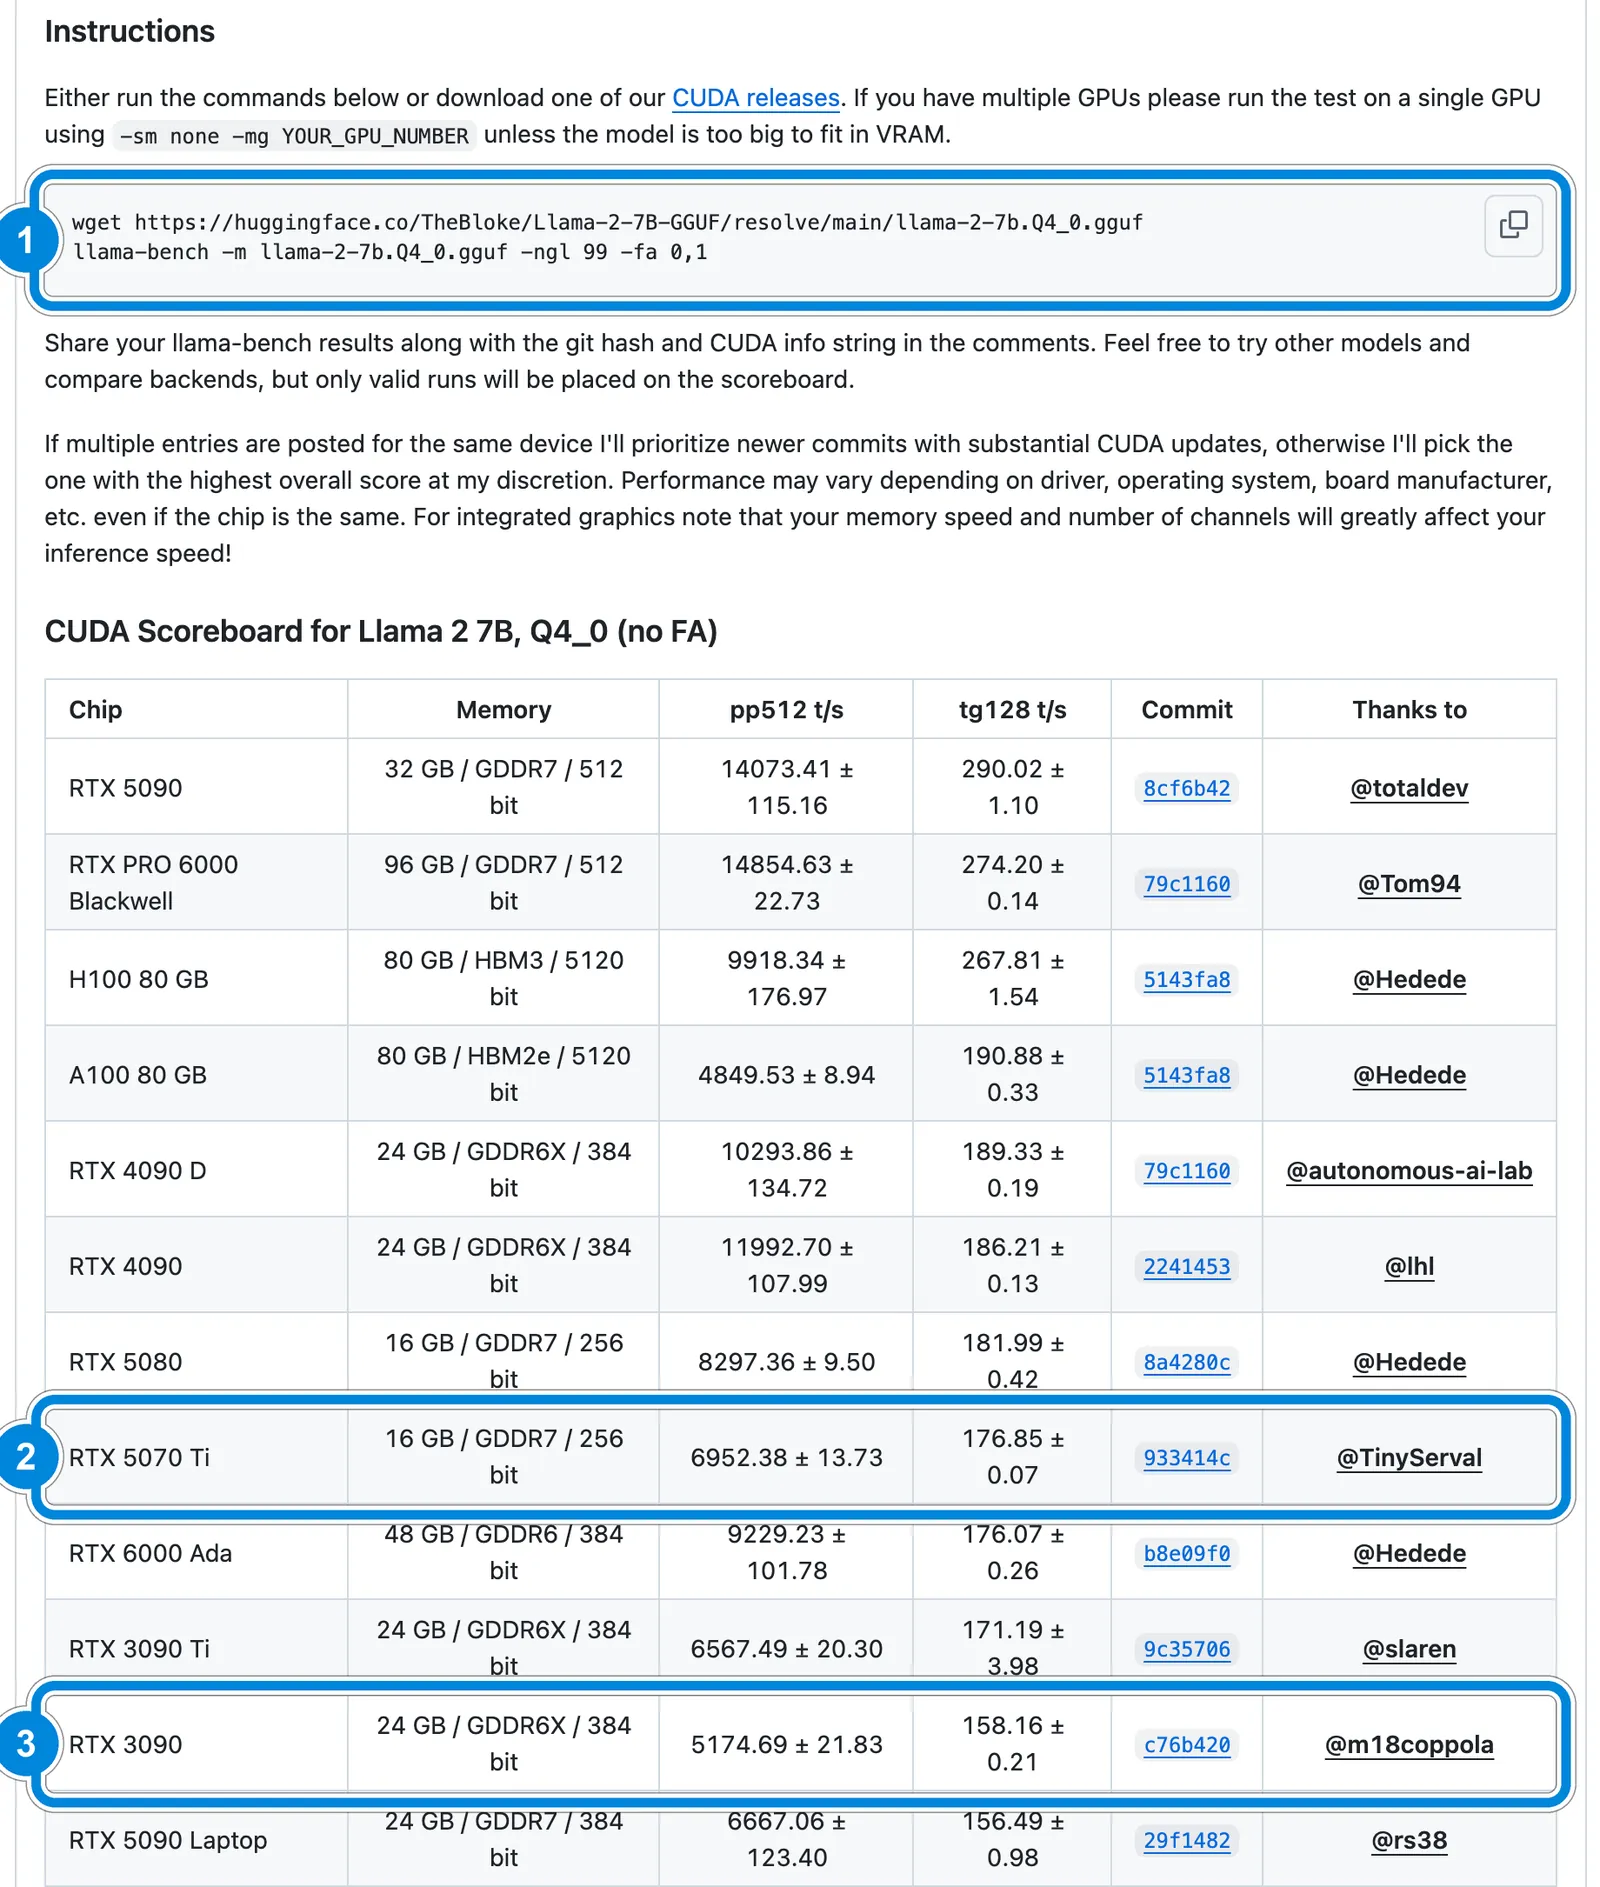
Кадр снят 8 ноября 2026 года. Номер 1 — команда, которой участники получают свои цифры (её же используем в разделе про самопроверку). Номер 2 — RTX 5070 Ti на 16 ГБ: 176,85 ток/с. Номер 3 — RTX 3090 на 24 ГБ: 158,16 ток/с. Карта с меньшим объёмом быстрее на 12%.
- RTX 5060 Ti 16 ГБ против RTX 5070 Ti 16 ГБ. Объём один и тот же. Шина — 128 против 256 бит, ПСП — 448 против 896 ГБ/с (×2,0). Скорость — 90,94 против 176,85 ток/с (×1,94). Почти идеальное совпадение отношения полосы и отношения скорости.
- RTX 3090 24 ГБ против RTX 5070 Ti 16 ГБ. У старой карты на 8 ГБ больше памяти и чуть больше паспортная ПСП (936 против 896 ГБ/с). Но в замере она медленнее: 158,16 против 176,85 ток/с. Разница — в доле потолка (64,6% против 75,4%): более новая архитектура лучше использует свою полосу, а участники гоняли тест на разных версиях llama.cpp (у каждой строки таблицы свой коммит). Объём здесь не помогает вообще.
- RTX 5080 против RTX 5070 Ti. Обе по 16 ГБ, у 5080 полоса шире на 7,1% (960 против 896 ГБ/с). Скорость выше всего на 2,9% (181,99 против 176,85). Пока объём одинаковый, доплата за старшую модель почти не покупает скорость генерации.
- RTX 5060 Ti 8 ГБ и 16 ГБ. По данным NVIDIA, у обеих версий одна полоса — 448 ГБ/с. Удвоенная память не ускоряет ту же модель. Она открывает модели, которые в 8 ГБ не помещаются.
Вывод для выбора: 24 ГБ у RTX 3090 стоит брать ради моделей 24–32B, которые не влезут в 16 ГБ, а не ради скорости. Разбор конкретных карт под эту задачу — в материале про выбор видеокарты для локального ИИ.
Модель не влезла в VRAM: скорость падает в разы, а не на проценты
Теперь обратная сторона — объём. Самый наглядный замер с открытой методикой опубликовал Максим Саплин на DEV Community 22 августа 2024 года. Модель Llama 3.1 70B в кванте Q4 (около 42,5 ГБ) он запускал на RTX 4090 с 24 ГБ и 96 ГБ DDR5-4800. Полосу ОЗУ он измерил в AIDA — около 70 ГБ/с. Стенд — Windows и LM Studio на движке llama.cpp.Где лежат веса Замер, ток/с Половина в VRAM, половина в ОЗУ 2,32 Всё в ОЗУ, считает процессор 1,42 «100% на GPU», но лишнее переливается в Shared VRAM драйвера 0,69
Посчитаем, что предсказывает формула. Если 21 ГБ лежит в VRAM, а 21,5 ГБ в ОЗУ, на каждый токен карта читает свою часть за 21 ÷ 1008 = 0,021 с, а процессор свою — за 21,5 ÷ 70 = 0,307 с. Вместе 0,328 с, то есть потолок около 3,05 ток/с. Замер — 2,32, это 76% потолка. Видеопамять у Саплина разогнана (+1600 МГц), но на результат это почти не влияет: узкое место здесь — ОЗУ. Для варианта «всё в ОЗУ» потолок 70 ÷ 42,5 = 1,65 ток/с, замер 1,42 (86%). Формула работает и здесь, просто считает каждую память отдельно.
А теперь сравнение, ради которого раздел и нужен. Если бы 42,5 ГБ влезли в VRAM карты с полосой 1008 ГБ/с, потолок был бы 23,7 ток/с — в 10 раз больше замера с половиной весов в ОЗУ. Та же RTX 4090 на 8B-модели, которая влезает целиком, выдаёт 127,74 ток/с — в 55 раз быстрее.
Формула полезна и как проверка чужих обещаний. Гид CraftRigs (апрель 2026) пишет про 8–12 ток/с для 70B Q4_K_M на RTX 3090 с 64 ГБ DDR5 при 40–45 слоях модели на видеокарте. Проверим. При таком делении в ОЗУ остаётся 18,6–21,3 ГБ. Стенд самого гида — DDR5-5600, у двухканальной это 89,6 ГБ/с по паспорту. С учётом времени на часть в VRAM получается не больше 3,8–4,3 ток/с. Цифра 8–12 ток/с по правилу «скорость × вес ≤ ПСП» в такой конфигурации недостижима. Возможно, гид имел в виду другую модель или другие условия, но с указанными параметрами она не сходится.
Длинный контекст: KV-кэш добавляет чтение на каждый токен
KV-кэш — это память модели об уже прочитанном тексте. Чтобы не пересчитывать весь диалог для каждого нового токена, модель хранит промежуточные результаты — ключи и значения (K и V) для каждого слоя. Этот кэш тоже читается на каждом шаге генерации. Значит, к весам модели добавляется ещё один объём, который растёт с длиной диалога.
Размер считается по файлу config.json модели. У Llama 3.1 8B 32 слоя, 8 KV-голов и размер головы 128. В 16-битном формате на один токен уходит 2 (K и V) × 32 × 8 × 128 × 2 байта = 128 КиБ. Дальше простое умножение на длину контекста и деление ПСП на «веса + кэш».Контекст, токенов KV-кэш, ГБ Потолок RTX 4090 без кэша Потолок RTX 4090 с кэшем Падение 1 024 0,13 204,8 199,4 −2,7% 8 192 1,07 204,8 168,2 −17,9% 32 768 4,29 204,8 109,4 −46,6% 131 072 17,18 204,8 45,6 −77,7%
Это потолок по формуле для полностью заполненного контекста, а не замер. Реальное падение зависит от архитектуры. Измеренный контрпример — тот же разбор на Habr (12.08.2026): на RTX 5090 гибридная MoE-модель, у которой лишь 11 слоёв внимания из 41, к контексту 32K теряет 14,5% (317,45 → 271,53 ток/с). У обычной плотной модели кэш растёт быстрее, и падение будет заметнее. Квантованный KV-кэш (8 бит вместо 16) режет его объём вдвое — и вдвое уменьшает лишнее чтение.
MoE-модели: объём считается по всем экспертам, скорость по активным
MoE (mixture of experts, «смесь экспертов») — это модель, которая на каждом токене использует только часть своих весов. Остальные «эксперты» в этот момент лежат без дела. Для нашей формулы это меняет всё: объём памяти нужен под все веса, а читать на каждый токен нужно только активные.Модель (Q4_K_M) Файл, ГБ Активно на токен Читается за токен, ГБ Потолок RTX 4090 Qwen3-32B, плотная 19,76 все 32 млрд 19,76 51 ток/с Qwen3-30B-A3B, MoE 18,56 3,3 из 30,5 млрд (10,8%) ≈2,0 (оценка пропорцией) ≈502 ток/с
Обе модели почти одинаково занимают память — около 19–20 ГБ, обе влезают в 24 ГБ. Но потолок скорости у MoE в 10 раз выше. Цифра 2,0 ГБ — наша оценка по доле активных параметров: часть весов (внимание, эмбеддинги) читается всегда, поэтому реальный объём чтения немного больше.
Измерение показывает, что до потолка MoE добирается хуже плотных моделей. В разборе на Habr (12.08.2026) автор измерил реальную полосу RTX 5090 — 1671 ГБ/с — и посчитал, сколько её использует генерация. Плотная Qwen3.5-9B (5,0 ГБ на токен) выбирает 72% полосы: 239,62 ток/с. MoE Qwen3.5-35B-A3B (2,13 ГБ на токен) — только 41%: 317,45 ток/с. MoE быстрее в абсолюте, но оставляет на столе больше. Это один разбор одного автора, но методика и команды в нём приведены.
Практический вывод: под MoE важен объём (вместить всех экспертов), а скорость будет высокой даже на средней полосе. Поэтому MoE-модели — главный аргумент в пользу мини-ПК и Mac с большой единой памятью и умеренной ПСП.
Где формула не работает: промпт, батч, вторая карта и бекенд
У формулы «ПСП ÷ размер» есть четыре исключения. Каждое объясняет, почему чужие цифры иногда выглядят «невозможными».
Обработка промпта упирается в вычисления
Прежде чем писать ответ, модель читает ваш запрос — это фаза prefill. Здесь сотни токенов обрабатываются разом, и одно чтение весов делится на них все. Узким местом становятся вычисления. RTX 5090 в том же тесте #15013 обрабатывает промпт со скоростью 14 073 ток/с, а генерирует — 290 ток/с, в 48,5 раза медленнее. Если вас раздражает долгая пауза перед первым словом на длинном документе, дело не в ПСП, а в вычислительной мощности.
Несколько запросов сразу (батч)
Когда модель обслуживает несколько пользователей одновременно, веса читаются один раз на всех. В замерах ggml-org на DGX Spark модель gpt-oss-20b (MXFP4) выдаёт 80,13 ток/с одному пользователю. При 32 одновременных потоках суммарно получается 681,49 ток/с — в 8,5 раза больше. Каждому отдельному потоку достаётся 21,3 ток/с. Поэтому серверные цифры в тысячи токенов в секунду нельзя сравнивать с домашним чатом.
Вторая видеокарта не ускоряет генерацию
Когда модель делят между картами по слоям, карты работают по очереди: сначала первая читает свои слои, потом вторая — свои. Объём складывается, ПСП — нет. Замеры XiongjieDai на Llama 3 70B Q4_K_M:Конфигурация Генерация, ток/с 2 × RTX 3090 16,29 4 × RTX 3090 16,89 6 × RTX 3090 16,93 2 × RTX 4090 19,06 4 × RTX 4090 18,83 8 × RTX 4090 18,76
Шесть карт вместо двух — плюс 4%. Потолок одной RTX 3090 для такой модели, если бы она влезла, — около 22 ток/с; две карты берут 74% этого числа, но не больше. А на 8B-модели, которая влезает в одну карту, вторая RTX 3090 даже замедляет: 108,07 ток/с против 111,74. Вторую карту покупают ради объёма, а не ради скорости. Параллельные режимы (tensor parallel в серверных движках) умеют складывать полосу, но это уже отдельная настройка, а не обычный llama.cpp.
Бекенд решает, какую часть полосы получит чип
ПСП — условие необходимое, но не достаточное. На одном и том же Ryzen AI Max+ 395 (256 ГБ/с, потолок для Llama 7B Q4_0 — 67 ток/с) один участник обсуждения llama.cpp #10879 получил 2 октября 2026 года: на процессоре 29,52 ток/с (44% потолка), через ROCm — 51,33 (77%), через Vulkan — 54,38 (81%). Память та же, разница почти вдвое.
Видеокарты NVIDIA тоже меняются от бекенда. В Vulkan-таблице #10879 на той же модели RTX 4090 даёт 187,97 ток/с (почти как в CUDA), RTX 3090 — 164,05, а RTX 5070 Ti — 135,63 против 176,85 в CUDA (на 23% меньше). Как отличаются Ollama, LM Studio и голый llama.cpp на одной модели, мы разбирали в сравнении Ollama, LM Studio и llama.cpp.
Что брать под 8B, 14B, 32B и 70B: потолки по платформам
Сведём всё в одну таблицу. Для каждой платформы считаем, влезает ли модель в Q4_K_M с запасом 10% на контекст и служебные нужды, и какой у неё потолок скорости. Прочерк — модель не влезает. Размеры файлов взяты с Hugging Face: Llama 3.1 8B — 4,92 ГБ, Qwen3-14B — 9,0 ГБ, Qwen3-32B — 19,76 ГБ, Llama 3.1 70B — 42,52 ГБ.Платформа Объём, ГБ ПСП, ГБ/с 8B 14B 32B 70B RTX 5060 Ti 16 ГБ 16 448 91 50 — — RTX 5070 Ti 16 ГБ 16 896 182 100 — — RTX 3090 24 ГБ 24 936 190 104 47 — RTX 4090 24 ГБ 24 1008 205 112 51 — RTX 5090 32 ГБ 32 1792 364 199 91 — Ryzen AI Max+ 395, 128 ГБ 128 256 52 28 13 6 DGX Spark, 128 ГБ 128 273 56 30 14 6,4 Mac Studio M5 Max 40 ядер, 128 ГБ 128 614 125 68 31 14 Mac Studio M5 Ultra, 512 ГБ 512 1200 244 133 61 28
Все числа — потолок в ток/с. Реальную скорость получаем умножением на 0,6–0,8 для видеокарт и на 0,4–0,8 для чипов Apple (у Ultra — нижняя граница). Для Strix Halo множитель сильно зависит от бекенда: по замеру #10879 — от 0,44 на процессоре до 0,81 через Vulkan.
Как читать таблицу по сценариям:
- 8B и 14B влезают везде. Здесь решает только полоса: любая видеокарта из списка в 1,6–7 раз быстрее мини-ПК на 128 ГБ (Strix Halo и DGX Spark).
- 32B уже не влезает в 16 ГБ. Карта на 24 ГБ даёт потолок около 50 ток/с, мини-ПК — 13–14. Это та граница, где объём начинает решать.
- 70B не влезает ни в одну игровую карту. Остаются две дороги: две видеокарты (объём сложится, скорость останется на уровне одной — около 16–19 ток/с по замерам выше) или платформа с большой единой памятью, где потолок — 6–28 ток/с в зависимости от полосы.
Сравнение трёх мини-платформ на 70B и 120B моделях подробно разобрано в материале DGX Spark, Mac Studio и Strix Halo, а какой объём видеопамяти брать на вырост — в гиде про объём VRAM для локальных LLM.
Как проверить свою карту через llama-bench: тест на 5 минут
Чтобы сравнить свою карту с таблицей выше, повторите тест обсуждения #15013. Понадобится собранный llama.cpp с бекендом под вашу карту (CUDA для NVIDIA, Metal для Mac) и около 4 ГБ свободного места.
- Скачайте эталонную модель — llama-2-7b.Q4_0.gguf из репозитория TheBloke/Llama-2-7B-GGUF на Hugging Face. Это та же модель, что у всех участников теста (3,56 ГиБ).
- Запустите тест:
llama-bench -m llama-2-7b.Q4_0.gguf -ngl 99 -fa 0,1. Флаг-ngl 99отправляет все слои на видеокарту,-fa 0,1прогоняет тест без Flash Attention и с ним. - Найдите строку tg128. Это скорость генерации 128 токенов. Строка pp512 — скорость чтения промпта, для сравнения с формулой она не нужна.
- Посчитайте свой потолок: паспортная ПСП карты ÷ 3,82. Для RTX 4090 это 1008 ÷ 3,82 ≈ 264 ток/с.
- Сравните. Нормальная доля для видеокарты — 60–80% потолка. Если у вас заметно меньше 60%, проверьте, что все слои действительно на GPU (не переполнена ли память), какой бекенд собран и не включён ли энергосберегающий режим.
- Запишите условия: версию llama.cpp (хеш коммита), бекенд, драйвер и операционную систему. Без них свою цифру не с чем сравнить.
Если у вас несколько видеокарт, в обсуждении просят тестировать на одной: при делении модели на карты результат перестаёт отражать полосу одной карты.
Слабые места расчёта скорости LLM: что не проверено
Эта статья опирается на чужие замеры и наши расчёты. Вот где цифры могут разойтись с тем, что увидите вы.
- Своих замеров нет. Методика каждого чужого замера названа в тексте.
- Паспорт — не реальность. Потолок считается по паспортной ПСП. Реальная полоса ниже: у RTX 5090 измерено 1671 ГБ/с против 1792 (93%).
- Одна эталонная модель. Основные таблицы — Llama 2 7B Q4_0 на пустом контексте. На новых архитектурах (MoE, гибриды) доля потолка другая: 41% против 72% в разборе на Habr.
- Бекенд и сборка меняют цифры. Vulkan и CUDA на одной карте расходятся до 23%, процессор и видеоядро на одном Strix Halo — почти вдвое.
- Часть замеров старая или единичная. Саплин и XiongjieDai — 2024 год, Strix Halo — отчёт одного участника от 2 октября 2026 года. Они показывают порядок величины, а не константу.
- Размер Q4_K_M для Llama 3 8B взят по файлу Llama 3.1 8B (4,92 ГБ) — это приближение. Для 16-битной версии размер точный.
- Что устареет первым: таблица ПСП с выходом новых карт и чипов и доля потолка у новых версий llama.cpp. Свежие замеры появляются в обсуждениях #15013 и #4167 на GitHub.
FAQ
Что важнее для локальной нейросети: объём VRAM или пропускная способность памяти?
Сначала объём, потом полоса. Объём решает, влезет ли модель: не влезла — скорость падает в разы, у 70B-модели на RTX 4090 примерно в 10 раз. Если модель влезает на нескольких вариантах железа, выбирает уже ПСП: при одинаковых 16 ГБ RTX 5070 Ti с полосой 896 ГБ/с генерирует почти вдвое быстрее RTX 5060 Ti с полосой 448 ГБ/с. Лишний объём сверх нужного скорость не добавляет.
Сколько токенов в секунду даст моя видеокарта на модели 8B?
Разделите паспортную пропускную способность карты на размер файла модели и умножьте на 0,6–0,8. Llama 3.1 8B в Q4_K_M весит 4,92 ГБ, поэтому у RTX 4090 с полосой 1008 ГБ/с потолок — 205 токенов в секунду, а реально — порядка 120–165. Замер XiongjieDai на этой карте дал 127,74. Если модель не влезла в видеопамять целиком, формула считает каждую память отдельно, и скорость падает в разы.
Ускорит ли вторая видеокарта генерацию текста?
Нет, в обычном llama.cpp — не ускорит. Карты читают свои слои модели по очереди, поэтому объём складывается, а пропускная способность — нет. Замеры на Llama 3 70B: две RTX 3090 дают 16,29 токена в секунду, шесть — 16,93. Вторую карту берут, чтобы большая модель вообще поместилась в видеопамять. Складывать полосу умеют режимы tensor parallel — в первую очередь в серверных движках.
Что значит «токены в секунду» в характеристиках и тестах?
Токены в секунду — это скорость, с которой модель печатает ответ. Токен — кусочек текста: слово, часть слова или знак. В тестах llama.cpp это колонка tg (генерация), а pp — отдельная скорость чтения вашего запроса; путать их нельзя: у RTX 5090 на одной модели pp — 14 073, а tg — 290 токенов в секунду. Сравнивать цифры можно только при одинаковых модели, кванте и бекенде.
Почему мини-ПК или Mac с 128 ГБ памяти медленнее одной RTX 4090 на небольшой модели?
Потому что на небольшой модели объём не нужен, а полоса у них уже. Ryzen AI Max+ 395 и DGX Spark дают 256–273 ГБ/с, Mac Studio на M5 Max — 614 ГБ/с, RTX 4090 — 1008 ГБ/с. Для 8B-модели в Q4_K_M это потолок 52–56, 125 и 205 токенов в секунду соответственно. Выигрывают такие платформы там, где модель в видеокарту не помещается.
Почему при длинном диалоге модель отвечает медленнее?
На каждом токене модель читает не только свои веса, но и KV-кэш — сохранённые данные о прошлом тексте. Он растёт с длиной диалога. У Llama 3.1 8B на 32 тысячах токенов контекста кэш занимает около 4,3 ГБ — почти как сама модель в Q4_K_M. По формуле потолок RTX 4090 падает с 205 до 109 токенов в секунду, почти вдвое.