
Коротко (TL;DR)
Если вы покупаете карту под локальные LLM сегодня, разумная база — 24 ГБ VRAM: в неё помещается главный «карточный» класс моделей 27–32B в 4-битном кванте, и за последние полтора года этот класс не вырос, а поумнел. 32 ГБ дают запас по длине контекста и 70B в сильно сжатом виде, 48 ГБ — нормальную 70B в 4 битах, 96 ГБ — 70B без компромиссов и средние MoE-модели. Вот короткий вердикт по деньгам на 29 октября 2026 года:
- Коротко (TL;DR)
- Какой объём VRAM брать под локальные LLM: ответ по ступеням 16–96 ГБ
- Что открывает каждая ступень: 16, 24, 32, 48 и 96 ГБ на моделях
- Цена гигабайта видеопамяти: Украина и США на 29 октября 2026
- Одна карта на 96 ГБ или несколько по 24: цена, скорость, питание
- Куда растут открытые модели: от 671B до 2,8T за полтора года
- Класс моделей 27–32B не растёт: почему 24 ГБ VRAM пока не устарели
- Что смягчает нехватку VRAM: кэш экспертов MoE, лёгкий KV и 4-бит
- Устареют ли 24 ГБ VRAM за год-два: прогноз с условиями и сроками
- Менять ли RTX 3090 на RTX 5070 Ti: 24 против 16 ГБ при близкой цене
- Генерация картинок: пороги VRAM у FLUX.2 не такие, как у LLM
- Риски покупки памяти впрок: б/у, цены, разводка и слепые зоны прогноза
- FAQ
- 24 ГБ (RTX 3090) — самый дешёвый гигабайт: около 2 480 ₴ за ГБ по единичному предложению Hotline (на вторичке ещё дешевле) и $65 за ГБ на вторичке в США. Брать, если основная задача — чат и код на моделях до 32B.
- 32 ГБ (RTX 5090) — гигабайт дороже всех: около 11 970 ₴. Платите не за объём, а за скорость и новую карту.
- 48 ГБ — дешевле всего набирается двумя RTX 3090; одна профкарта на 48 ГБ стоит в 3,9 раза дороже за гигабайт.
- 96 ГБ (RTX PRO 6000) — около 8 990 ₴ за ГБ, то есть гигабайт тут дешевле, чем у RTX 5090. Но 96 ГБ уже не «страховка навсегда»: новый класс MoE-моделей на 125–320B просит 100+ ГБ памяти суммарно, RAM + VRAM.
- Устареет ли 24 ГБ за год-два? Для класса 27–32B — по нашим данным нет. Устареет, если вам понадобится всё, что выше: плотные ~70B и крупные MoE. Это прогноз с условиями, а не гарантия, — триггеры пересмотра ниже.
Какой объём VRAM брать под локальные LLM: ответ по ступеням 16–96 ГБ
VRAM — это память самой видеокарты. Языковая модель работает быстро, только когда её веса и рабочий кэш целиком лежат в VRAM; всё, что не влезло, уходит в оперативную память компьютера, и скорость падает в разы. Поэтому вопрос «какую карту брать под ИИ» почти всегда сводится к вопросу «сколько гигабайт».
Чтобы дальше не спотыкаться, три термина:
- Квант (квантизация) — сжатие весов модели. В оригинале на каждый параметр уходит 16 бит (формат BF16), в 4-битном кванте — примерно четыре. Модель становится в 3–4 раза легче, а качество теряется умеренно; в 1–2 битах потери уже заметны.
- KV-кэш — «память о разговоре». Модель хранит промежуточные данные по каждому токену контекста, и чем длиннее диалог или загруженный документ, тем больше этот кэш. Токен — кусок слова, примерно 3–4 символа текста.
- MoE (Mixture of Experts) — модель из многих «экспертов», из которых на каждый токен работает лишь малая часть. Общий размер огромный, но считается быстро — если есть, где хранить всех экспертов.
Сколько точно займёт конкретная модель, мы уже посчитали в разборе формулы KV-кэша и таблицы квантов — здесь не повторяем. Эта статья про другое: какую ступень объёма покупать и как долго она прослужит.
| Ступень | Что открывает (модели и кванты) | Типовая карта | Цена 1 ГБ в Украине, 29.10.2026 |
|---|---|---|---|
| 16 ГБ | Чат-модели 8–14B; 27B — в 3 битах (12–14 ГБ) или впритык в 4-битном UD-IQ4_XS | RTX 5070 Ti | ≈3 670 ₴ |
| 24 ГБ | Qwen3.8-27B в 4 битах с контекстом до ~64K токенов (наш расчёт); 70B — нет | RTX 3090 (б/у), RTX 4090 | ≈2 480 ₴ |
| 32 ГБ | 27–32B с контекстом 32–128K; 70B в 3 битах целиком в памяти | RTX 5090, Radeon AI PRO R9700 | ≈11 970 ₴ / ≈3 730 ₴ |
| 48 ГБ | 70B в 4 битах (Q4_K_M, 42,5 ГБ); 27B в 8 битах | 2× RTX 3090, RTX PRO 5000 48 ГБ | ≈2 490 ₴ / ≈9 650 ₴ |
| 96 ГБ | 70B в 8 битах; 27B без сжатия; средние MoE (класс gpt-oss-120b); «Flash»-класс — на пределе | RTX PRO 6000 Blackwell | ≈8 990 ₴ |
Главная мысль таблицы: объём покупают под класс моделей, который вы будете держать каждый день, а не под рекорды флагманов. Флагманы открытых моделей давно ушли за пределы любой одиночной карты, а «рабочий» класс до 32B помещается в 24 ГБ.
Что открывает каждая ступень: 16, 24, 32, 48 и 96 ГБ на моделях
Ниже — что реально запускается на каждой ступени, с цифрами из карточек моделей и чужих замеров. Где цифра наша (расчёт), так и помечено.
16 ГБ: чат 8–14B и сжатая 27B
По данным Unsloth (команда, которая выпускает популярные сжатые версии моделей), Qwen3.8-27B в 4 битах занимает 16–19 ГБ, в 3 битах — 12–14 ГБ. Unsloth считает эти цифры как суммарную память, RAM + VRAM. На 16-гигабайтной карте 27B уверенно помещается в 3 битах; из 4-битных — только самый лёгкий UD-IQ4_XS (14,25 ГБ), впритык и с контекстом около 16 тыс. токенов, а ходовые 4-битные файлы весят от 16,5 ГБ. Модели 8–14B на 16 ГБ работают свободно.
24 ГБ: главный рабочий класс 27–32B
В англоязычных подборках 24 ГБ ищут отдельной ступенью — «24 GB VRAM GPU»: сюда входят RTX 3090, RTX 4090 и, например, Intel Arc Pro B60. В такую карту помещается Qwen3.8-27B в 4 битах (файл UD-Q4_K_XL — около 16,5–17,6 ГБ) плюс кэш контекста.
Сколько контекста влезает, мы посчитали по карточке модели: у Qwen3.8-27B полное внимание считают только 16 слоёв из 64, у них 4 KV-головы, поэтому кэш весит около 64 КиБ на токен в формате f16. Значит, 32K токенов — это 2 ГиБ, 64K — 4 ГиБ, 128K — 8 ГиБ. Итог для 24 ГБ: веса ~17,6 ГБ + 64K контекста ≈ 22 ГБ, плюс 1–1,5 ГиБ служебных буферов движка — помещается впритык; 128K (≈26 ГБ) уже нет, если не сжимать сам кэш.
Старый плотный стандарт этого класса, Qwen3-32B, держал 24 ГБ хуже: его кэш — 256 КиБ на токен, и 32K контекста добавляют 8 ГБ к 18,4 ГиБ весов. В замере ComputingForGeeks Qwen3 32B в Q4_K_M на RTX 3090 при контексте 32K падает с нехваткой памяти, а RTX 5090 на тех же 32K выдаёт 53,3 токена в секунду.
70B на одной 24-гигабайтной карте не живёт. Llama 3.3 70B в Q4_K_M — файл 42,5 ГБ, и на одиночную 3090 или 4090 он не грузится вовсе (RunAIHome). Даже агрессивно сжатая 70B в IQ3_XXS (25,58 ГиБ) на RTX 3090 выгружает 15 из 80 слоёв в оперативную память и выдаёт 3,4 токена в секунду — это уже не чат.

32 ГБ: длинный контекст и 70B в 3 битах
32 ГБ — это RTX 5090 и Radeon AI PRO R9700. Лишние 8 ГБ против 24 ГБ дают две вещи. Первая — контекст: по тому же расчёту Qwen3.8-27B в 4 битах с 128K токенов занимает ≈26 ГБ и помещается. Вторая — 70B в 3 битах: та же IQ3_XXS на RTX 5090 целиком в памяти идёт со скоростью 52,8 токена в секунду против 3,4 у RTX 3090 (ComputingForGeeks, арендованные карты). Сборку вокруг 32 ГБ мы разбирали в статье ПК на RTX 5090 для локального ИИ.
48 ГБ: нормальная 70B
48 ГБ видеопамяти — первая ступень, где 70B в 4 битах (42,5 ГБ) лежит целиком в VRAM с запасом под контекст. Набирают её двумя способами: двумя картами по 24 ГБ или одной профессиональной RTX PRO 5000 Blackwell на 48 ГБ. На двух RTX 3090 Llama 3.3 70B в Q4_K_M даёт 16,3–19,5 токена в секунду при разбиении по слоям и до 31,9 — при тензорном разбиении на корректно разведённой плате (данные RunAIHome и ComputingForGeeks). Детали такой сборки — в разборе двух RTX 3090 для локального ИИ.
Между 48 и 96 ГБ есть промежуточная ступень: NVIDIA выпустила RTX PRO 5000 Blackwell с 72 ГБ (Tom’s Hardware), но цену не публиковала, а в украинском Hotline на 29 октября 2026 года этой версии нет.
96 ГБ: без компромиссов до 70B и средние MoE
RTX PRO 6000 Blackwell несёт 96 ГБ памяти GDDR7 с коррекцией ошибок (ECC), пропускную способность 1792 ГБ/с и потребляет до 600 Вт (данные NVIDIA). В 96 ГБ помещаются Qwen3.8-27B без сжатия (BF16, 56 ГБ), 70B в 8 битах и прошлогодний средний класс MoE: gpt-oss-120b (117B параметров, 5,1B активных) рассчитан на одну 80-гигабайтную карту. Как это выглядит в рабочей станции — в разборе RTX PRO 6000 под 70B без мультикарты.
А вот новый «Flash»-класс 2026 года в 96 ГБ уже упирается — об этом в разделе про рост моделей.
Цена гигабайта видеопамяти: Украина и США на 29 октября 2026
Мы сняли цены 29 октября 2026 года: в Украине — по Hotline, Moyo и Allo, в США — по трекерам вторичного рынка и розницы. Гривны переведены в доллары по официальному курсу НБУ на ту же дату — 45,5923 ₴ за $1.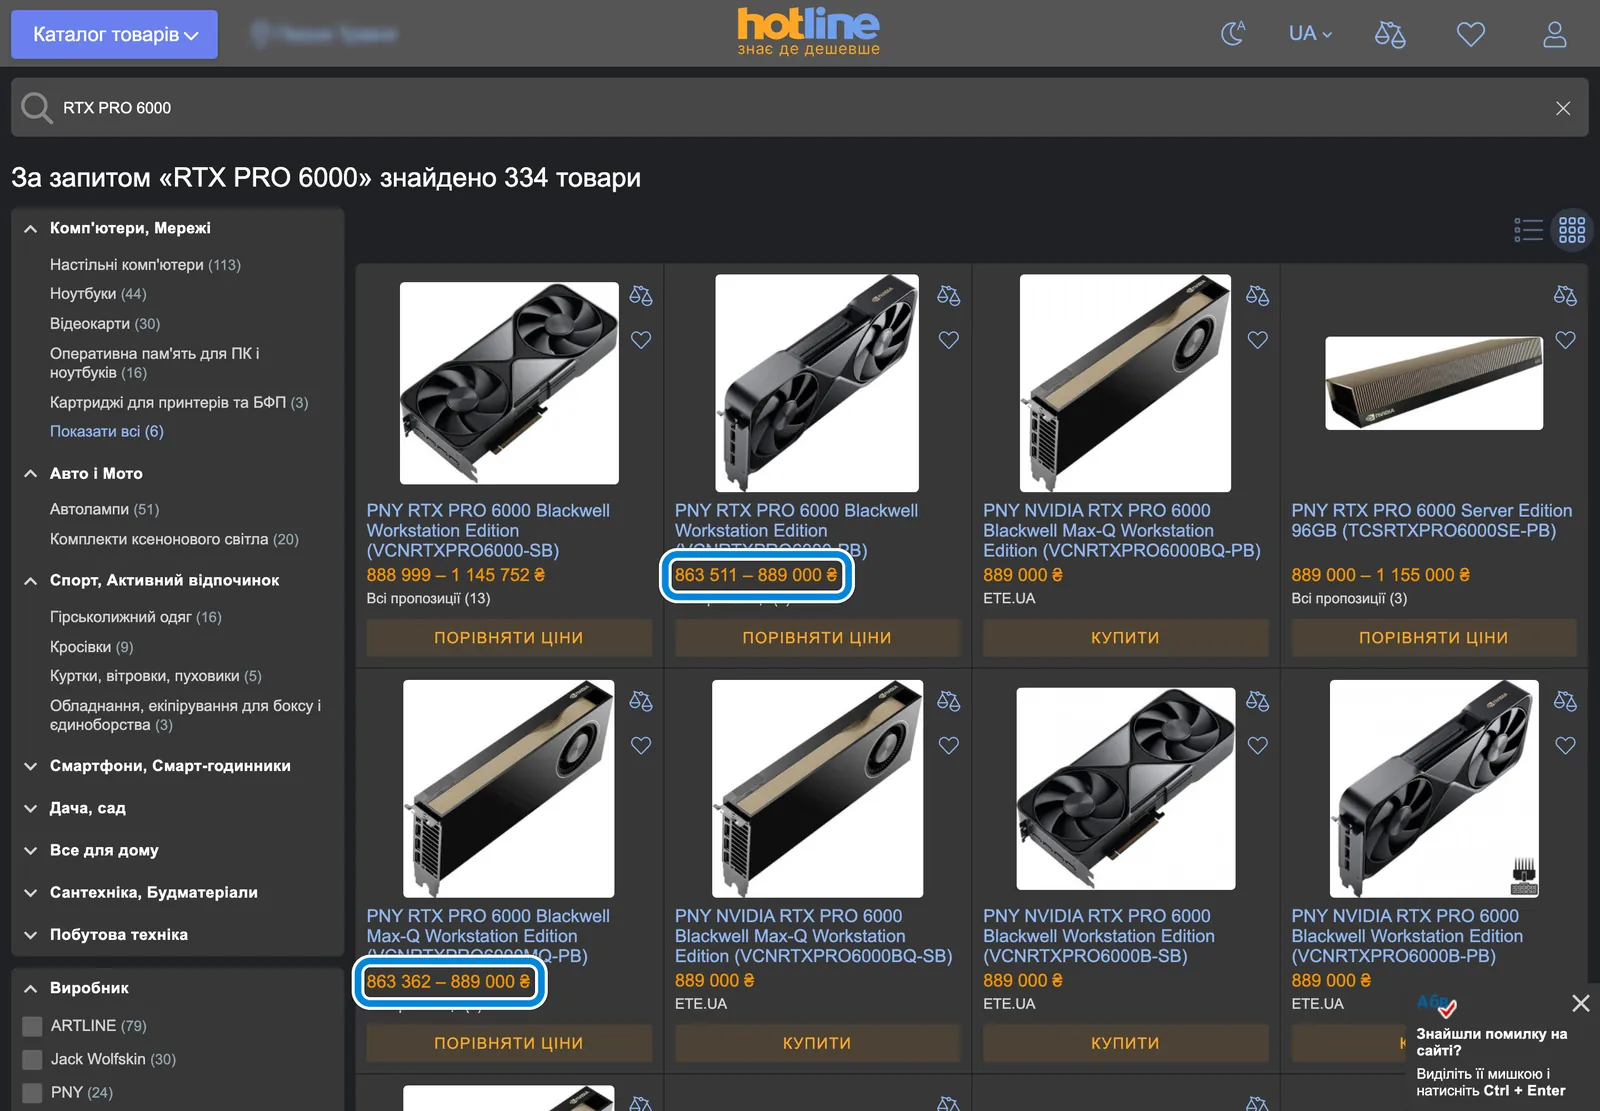
На скриншоте — выдача Hotline по RTX PRO 6000 на 29 октября 2026 года: рамками отмечены самые низкие диапазоны: 863 511 ₴ у Workstation Edition (600 Вт) и 863 362 ₴ у версии Max-Q (300 Вт). Hotline показывает не одну цену, а разброс по магазинам — «от» и «до».Карта Объём Украина, от (Hotline) ≈ в $ по НБУ ₴ за 1 ГБ США, 28–29.10.2026 $ за 1 ГБ RTX 5070 Ti 16 ГБ 58 693 ₴ $1 287 3 668 $1 300 (новая, минимум) 81 RTX 3090 24 ГБ 59 500 ₴ (одно предложение) $1 305 2 479 $1 561 (б/у, средняя) 65 Radeon AI PRO R9700 32 ГБ 119 338 ₴ $2 618 3 729 н/д н/д RTX 5090 32 ГБ 383 000 ₴ $8 401 11 969 $8 178 (новая, минимум в наличии) 256 RTX PRO 5000 Blackwell 48 ГБ 463 000 ₴ $10 155 9 646 н/д н/д RTX PRO 6000 Blackwell 96 ГБ 863 511 ₴ $18 940 8 995 $17 987 (новая, минимум) 187
Цифры США: б/у RTX 3090 — средняя $1 561 по 341 объявлению на eBay (ResalePrices, 29 октября 2026 года); RTX 5070 Ti и RTX PRO 6000 — текущий минимум по трекеру GPUPrix; RTX 5090 — самая дешёвая видеокарта в наличии по тому же трекеру (его «минимум» $7 699 — мини-ПК с мобильной RTX 5090); всё на 28 октября 2026 года. По RTX 5090 в Украине есть вторая точка сверки: в Moyo карта в наличии стоит 450 399 ₴.
Что из этого следует:
- Самый дешёвый гигабайт — 24 ГБ у RTX 3090. Даже по магазинной цене 3090 почти в полтора раза дешевле за гигабайт, чем 16-гигабайтная RTX 5070 Ti, при почти одинаковой цене самих карт; на вторичке разрыв ещё больше.
- RTX 5090 — самый дорогой гигабайт. В Украине 11 969 ₴ за ГБ — дороже, чем у профессиональных карт. При рекомендованной цене $1 999 карта продаётся в рознице США от $8 178: розница переоценила её на дефиците памяти сильнее, чем профкарты.
- 96 ГБ дешевле 32 ГБ за гигабайт. RTX PRO 6000 даёт гигабайт за ≈8 990 ₴ против ≈11 970 ₴ у RTX 5090 и ≈9 650 ₴ у RTX PRO 5000 на 48 ГБ. Если бюджет всё равно уходит в топовую карту, 96 ГБ выгоднее по объёму.
- Оговорка по RTX 3090 в Украине. На 29 октября 2026 года Hotline держит три модели 3090: MSI Gaming X Trio — одно предложение за 59 500 ₴, Gigabyte Vision OC — 59 999 ₴, Gainward Phoenix — 134 999–151 217 ₴ (девять предложений). Hotline не помечает, новая карта или б/у; у предложения MSI за 59 500 ₴ указана гарантия производителя, то есть это, скорее всего, остаток новых карт. На вторичке 3090 дешевле: на OLX рабочие карты на 25 октября 2026 года стоили чаще всего 28 000–44 000 ₴, типично около 40 000 ₴ (≈1 670 ₴ за ГБ); в таблицу такие объявления не вошли.
Цены карт растут, а не падают: б/у RTX 3090 в США подорожала на 24,9% за 90 дней (ResalePrices, 29 октября 2026 года), RTX PRO 6000 прошла путь от $8 565 на запуске в 2025 году до $16 000 в сентябре 2026-го и $17 987 минимума 28 октября.
Одна карта на 96 ГБ или несколько по 24: цена, скорость, питание
Четыре RTX 3090 дают те же 96 ГБ, что одна RTX PRO 6000. Разница — в цене, скорости, ваттах и хлопотах.Параметр 1× RTX PRO 6000 (96 ГБ) 4× RTX 3090 (4×24 ГБ) 2× RTX 3090 (48 ГБ) Цена в США, конец октября 2026 $17 987 (новая) ≈$6 244 (4× средняя б/у $1 561) $2 912–3 116 за пару (RunAIHome, 20.10.2026) Цена в Украине, конец октября 2026 от 863 511 ₴ ≈160 000 ₴ б/у на OLX (4×≈40 000 ₴) или ≈389 500 ₴ по Hotline: два единичных предложения + два Gainward по нижней цене 134 999 ₴ (наш расчёт) ≈80 000 ₴ б/у на OLX или ≈119 500 ₴ по двум единичным предложениям Hotline Питание видеокарт 600 Вт 4×350 = 1400 Вт 700 Вт Как работает память Одна память, 1792 ГБ/с Модель режется на четыре карты, обмен через PCIe Модель режется на две карты Главный риск Цена на пике Плата, блок питания, разводка линий PCIe Разводка линий PCIe
По деньгам четыре 3090 выигрывают: в США комплект стоит около 35% от одной RTX PRO 6000, в Украине — от 19% (б/у с OLX) до 45% (по Hotline). По остальному выигрывает одна карта. Модель в одной памяти не ждёт обмена между картами. Четыре 3090 забирают около 1,4 кВт только на видеокарты, плюс процессор и остальная система, и требуют серверной платы с достаточным числом полноценных слотов.
Отдельная ловушка — разводка. RunAIHome приводит случай, когда сборка на двух 3090 выдавала мусор на контексте длиннее 2K, потому что одна карта висела на слоте x4 от чипсета. Те 31,9 токена в секунду на 70B — потолок правильно разведённой сборки x8/x8, а не норма.
Новые режимы движков сокращают разрыв. Пользователь r/LocalLLaMA сообщал (в пересказе на dev.to), что llama.cpp сборки b9455 с тензорным разбиением -sm tensor и спекулятивным декодированием MTP выдаёт около 70 токенов в секунду на Qwen3.6-27B в 8 битах на двух 3090. Это отчёт пользователя, а не наш замер.
Есть и промежуточный вариант одной карты: RTX PRO 6000 в версии Max-Q даёт те же 96 ГБ при потреблении 300 Вт, и на Hotline 29 октября 2026 года она стоит почти столько же — от 863 362 ₴. Её стоит смотреть, если важны тишина и запас блока питания.
Выбор по смыслу: две 3090 — лучший путь к 48 ГБ за разумные деньги; четыре — компромисс для тех, кто готов к серверной сборке; одна RTX PRO 6000 — для тех, кому важны тишина, одна карта и предсказуемость. Если вы выбираете не только видеокарту, но и платформу целиком (ПК, Mac или мини-ПК), начните с нашего гида по железу для локального ИИ.
Куда растут открытые модели: от 671B до 2,8T за полтора года
Чтобы понять, устареет ли объём, посмотрим, как росли открытые модели. Буква B — миллиарды параметров, T — триллионы. У MoE-моделей в скобках — сколько параметров работает на каждый токен.Модель Дата Размер (активные) Помещается в 96 ГБ? DeepSeek-V3 декабрь 2024 671B (37B) нет Kimi K2 июль 2025 1T (32B) нет gpt-oss-120b август 2025 117B (5,1B) да, рассчитан на одну 80-ГБ карту DeepSeek-V4-Pro / V4-Flash апрель 2026 1,6T (49B) / 284B (13B) нет / в 4 битах — нет Kimi K3 июль 2026 2,8T (104B) нет Qwen3.8-2.4T-A95B август 2026 2,4T (95B) нет GLM-5.3-Flash август 2026 320B (18B) только 1-битный файл 93,09 ГБ, а всего нужно ≈102 ГБ Qwen3.8-Flash-Next август 2026 125B (≈6B) 4-битный файл — 93,7 ГиБ; нужно 96–114 ГБ памяти суммарно
За полтора с небольшим года флагманы выросли примерно вчетверо: с 671B у DeepSeek-V3 до 2,8T у Kimi K3. Ни одна из этих моделей не поместится ни в одну видеокарту, сколько бы она ни стоила. Значит, гнаться за флагманами объёмом VRAM бессмысленно — это задача серверов.
Важнее нижняя часть таблицы. В 2026 году появился класс «Flash» — MoE-модели на 125–320B, которые позиционируются как доступные для локального запуска. Именно они двигают планку вверх:
- GLM-5.3-Flash даже в 1-битном кванте весит 93,09 ГБ, а на запуск Unsloth рекомендует около 102 ГБ памяти суммарно; 3-битный вариант просит 128 ГБ. При этом 1-битная версия совпадает с полной моделью в выборе самого вероятного токена лишь в 71% случаев (метрика top-1 accuracy, замер Unsloth) — «влезло» не значит «то же качество».
- Qwen3.8-Flash-Next в 4 битах — 93,7 ГиБ (это около 100,6 ГБ в десятичных единицах), и Unsloth советует 96–114 ГБ памяти суммарно; самый маленький квант требует около 75 ГБ.
Обратите внимание на слово «суммарно». Unsloth считает требования как сумму оперативной памяти и видеопамяти: такие модели держат часть экспертов в обычной RAM. Поэтому для «Flash»-класса решает уже не только VRAM, но и сколько оперативной памяти стоит в компьютере. 96 ГБ видеопамяти этот класс в хорошем кванте целиком не вмещают — это не страховка «на вырост», а вход в самый край.
Класс моделей 27–32B не растёт: почему 24 ГБ VRAM пока не устарели
Пока флагманы раздувались, «карточный» класс шёл в обратную сторону — стал меньше и умнее.Параметр Qwen3-32B (апрель 2025) Qwen3.8-27B (август 2026) Параметров 32,8B 27B Вес в 4 битах ≈18,4 ГиБ 16–19 ГБ (Unsloth) KV-кэш на токен (f16) 256 КиБ ≈64 КиБ (наш расчёт по карточке) Контекст 32K токенов +8 ГБ +2 ГиБ Помещается в 24 ГБ с контекстом 32K нет (замер: нехватка памяти на RTX 3090) да, с запасом (расчёт)
Почему так вышло. В Qwen3.8-27B только 16 слоёв из 64 используют полное внимание и копят KV-кэш; остальные 48 — линейные слои Gated DeltaNet, у которых небольшое постоянное состояние, не растущее с длиной контекста. Это видно в карточке модели на Hugging Face. Кэш стал вчетверо легче, а значит, 24 ГБ хватает на контекст, на котором старая 32B падала.
Качество при этом выросло. По таблице в той же карточке Qwen3.8-27B набирает 61,7 в тесте агентного программирования SWE-bench Pro против 53,5 у Qwen3.6-27B того же размера. Это самоотчёт разработчика, но направление видно: класс растёт в качестве, а не в гигабайтах.
Тот же тренд у других разработчиков. DeepSeek заявляет, что V4-Pro на контексте в миллион токенов требует лишь 10% KV-кэша от DeepSeek-V3.2; Z.ai описывает гибридное разреженное и линейное внимание у GLM-5.3-Flash. Оба утверждения — заявления вендоров, но они указывают одно направление.
Вывод для покупки: 24 ГБ VRAM устаревают не потому, что модели растут, а когда вам становится мало класса до 32B. Пока главный открытый «рабочий» класс помещается в 16–19 ГБ, 24-гигабайтная карта держит его с контекстом. Сообщество эту ступень тоже признаёт: один из пользователей X назвал 24-гигабайтную ступень «средним классом» GPU для локальных моделей, а в r/LocalLLM обсуждают, не состарятся ли 24–32 ГБ неожиданно хорошо.
Что смягчает нехватку VRAM: кэш экспертов MoE, лёгкий KV и 4-бит
Раньше вопрос стоял жёстко: модель либо влезла в видеопамять, либо работает в разы медленнее. В 2026 году появились приёмы, которые размывают эту границу.
1. Кэш экспертов MoE в llama.cpp. llama.cpp — популярный движок для локального запуска моделей. В PR #29887, открытом 3 октября и влитом в основную ветку 7 октября 2026 года, появился кэш на видеокарте для экспертов, которые лежат в оперативной памяти: самые востребованные эксперты держатся в VRAM, остальные подгружаются по требованию. Включается флагом --moe-cache-mib, автор советует отдавать под кэш около 10% от общего объёма экспертов.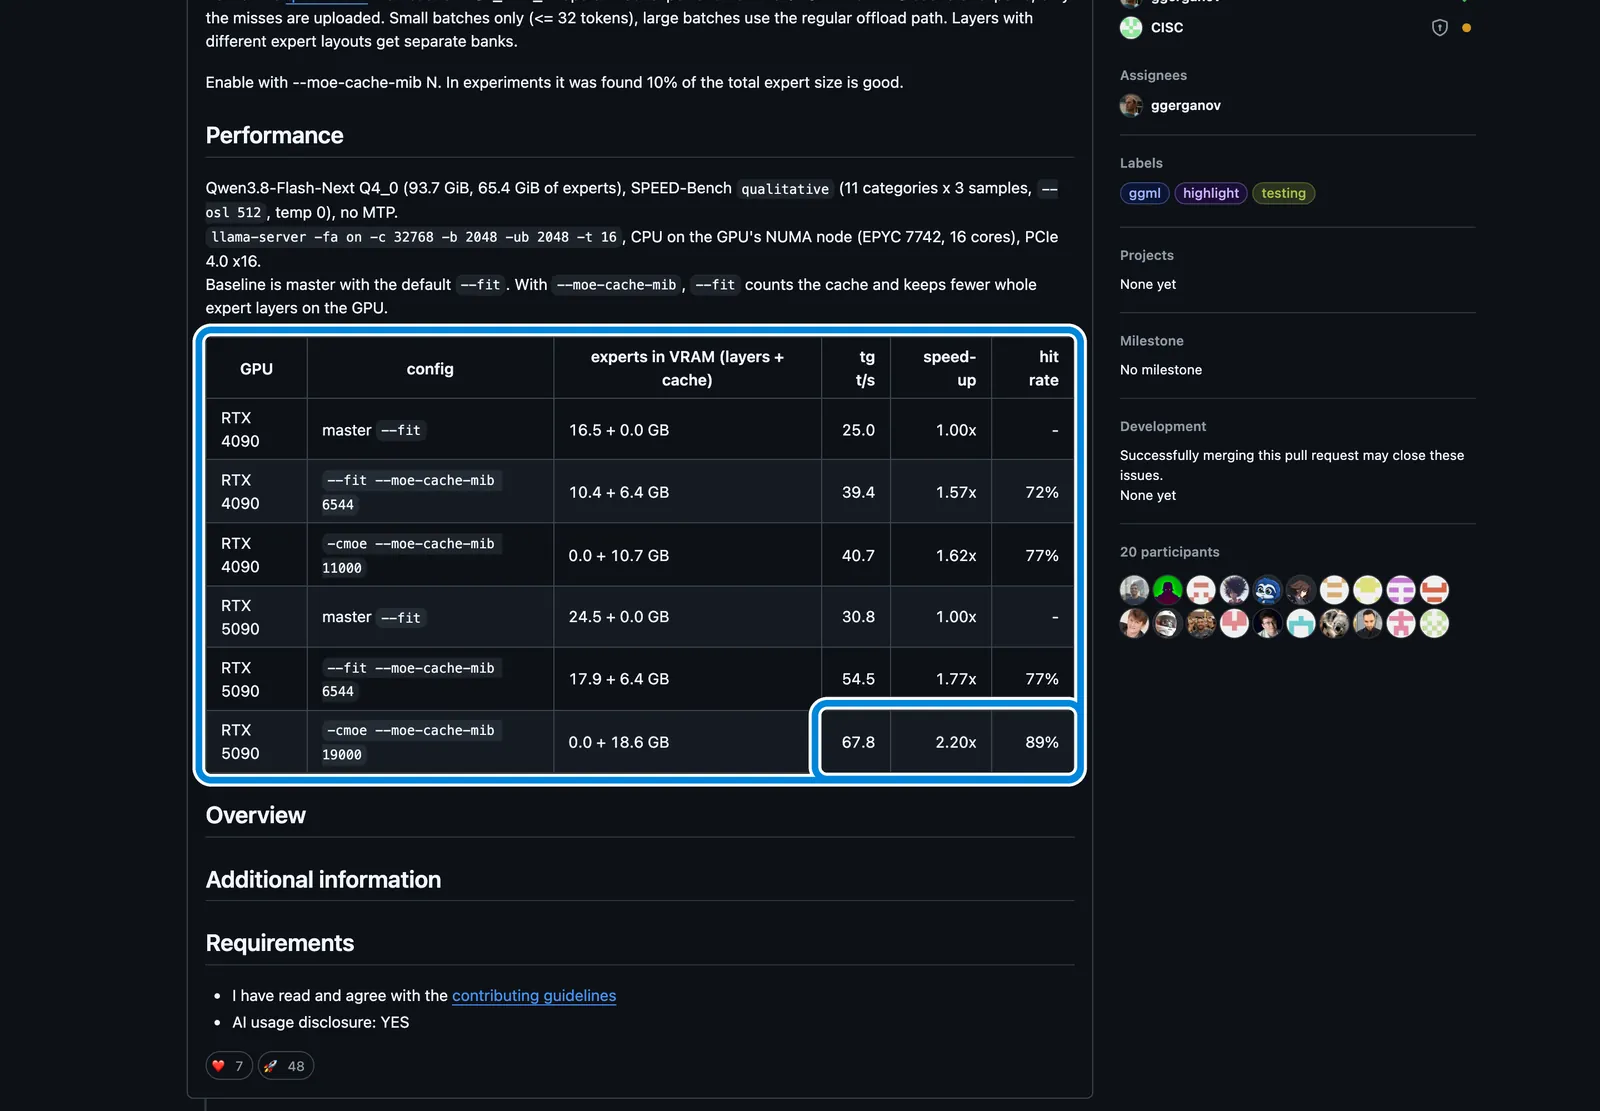
На скриншоте — таблица автора PR, снимок сделан 29 октября 2026 года. Модель Qwen3.8-Flash-Next в Q4_0 весит 93,7 ГиБ, то есть в 24 или 32 ГБ не помещается никак. Результаты:Карта Без кэша С кэшем экспертов Ускорение RTX 4090 (24 ГБ) 25,0 ток/с 39,4–40,7 ток/с 1,57–1,62× RTX 5090 (32 ГБ) 30,8 ток/с 54,5–67,8 ток/с 1,77–2,20×
Важные оговорки: это один замер автора PR на сервере с процессором EPYC 7742 и PCIe 4.0 x16, с контекстом 32K. Сам кэш уже в основной ветке llama.cpp (влит 7 октября 2026 года); появился ли он в Ollama и LM Studio, мы не проверяли. Но смысл ясен: карта на 24–32 ГБ в паре с большой оперативной памятью перестаёт быть «влезло или нет» и запускает модель на 93,7 ГиБ с рабочей скоростью.
Обратная сторона — без хорошей видеокарты такие модели почти неподъёмны. Один пользователь X сообщал, что GLM-5.3-Flash на 16-гигабайтной карте плюс 256 ГБ оперативной памяти выдаёт 2,11 токена в секунду: запустить можно, разговаривать — нет.
2. Лёгкий KV-кэш. Гибридное внимание, о котором шла речь выше, сокращает «стоимость» длинного контекста в разы. Чем легче кэш, тем меньше значит разница между 24 и 32 ГБ.
3. 4-битные форматы. Кванты становятся точнее при том же размере: 19 августа 2026 года Unsloth перевыпустил кванты Qwen3.8-27B и заявил о +10% точности при том же весе. Для видеокарт RTX 50 серии появились кванты в формате NVFP4 (например, Qwen3.8-27B-NVFP4 у Unsloth), рассчитанные на аппаратную поддержку FP4 у архитектуры Blackwell.
Предел у этих приёмов тоже есть: 1-битные кванты теряют заметную часть качества (71% у GLM-5.3-Flash), а подгрузка экспертов из RAM упирается в скорость шины и оперативной памяти.
Устареют ли 24 ГБ VRAM за год-два: прогноз с условиями и сроками
Короткий ответ: для чата и кода на моделях до 32B 24 ГБ VRAM, по нашей оценке, останутся рабочей ступенью в 2027 году. Для всего, что выше, 24 ГБ уже сейчас мало. Ниже — где кончаются факты и начинается прогноз.
Факты (проверено на 29 октября 2026 года):
- Флагманы выросли примерно вчетверо (671B → 2,8T) и вышли за пределы любой одиночной карты.
- Главный «карточный» класс уменьшился с 32,8B до 27B, а KV-кэш на токен — с 256 до ≈64 КиБ.
- В разобранных нами релизах 2026 года (Qwen3.8, GLM-5.3, DeepSeek V4, Kimi K3, MiniMax M3) нет плотной модели около 70B.
- Новый класс «Flash» (125–320B MoE) требует 75–128 ГБ памяти суммарно, RAM + VRAM.
- Цены памяти растут: ComputingForGeeks со ссылкой на TrendForce (30 сентября 2026 года) пишет о росте контрактных цен DRAM ещё на 10–15% в четвёртом квартале 2026 года после 13–18% в третьем; разрыв спроса и предложения, по этому прогнозу, расширится в 2027 году, а заметные новые мощности появятся не раньше второй половины 2027-го, существенно — в 2028-м. Первоисточник TrendForce мы не открывали, это пересказ.
Прогноз — три сценария (наша экстраполяция по двум-трём релизам, а не закон):Сценарий Что должно произойти Что это значит для 24 ГБ Что брать Базовый: класс до 32B остаётся главным Новые средние модели выходят на 27–32B и с лёгким KV 24 ГБ хватает на 4 бита и контекст 32–64K 24 ГБ; 32 ГБ — если нужен длинный контекст Сдвиг вверх: возвращается плотная ~70B Выходит открытая плотная ~70B, заметно лучше 27B 24 ГБ становятся второй лигой 48 ГБ (две 3090) Сдвиг в MoE: средний класс — «Flash» 100–300B Кэш экспертов из llama.cpp (влит 7 октября 2026 года) приходит в Ollama и LM Studio 24–32 ГБ живы, но нужны 128–256 ГБ оперативной памяти 24–32 ГБ + много RAM, а не 96 ГБ VRAM
Триггеры пересмотра — за чем следить:
- Релиз открытой плотной модели около 70B, которая на тестах заметно обходит Qwen3.8-27B.
- Появление кэша экспертов MoE в Ollama и LM Studio (в llama.cpp он уже влит 7 октября 2026 года).
- Потребительская карта на 48 ГБ. Пока её нет; про RTX 50 Super с памятью до 24 ГБ Igor’s Lab в ноябре 2025 года со ссылкой на инсайдера писал, что запуск отложен до третьего квартала 2026-го из-за дефицита памяти, но и к концу октября мы её запуска не нашли — это слух, а не план NVIDIA.
- Разворот цен DRAM вниз. По прогнозу TrendForce в пересказе — не раньше второй половины 2027 года.
Практический вывод: ждать удешевления, чтобы взять «больше и дешевле», — по текущим данным плохой план. Если задача уже есть и она укладывается в класс до 32B, 24 ГБ покупаются сейчас и не выглядят тупиком на горизонте года. Если вы уверены, что вам нужна 70B каждый день, сразу целитесь в 48 ГБ.
Менять ли RTX 3090 на RTX 5070 Ti: 24 против 16 ГБ при близкой цене
Этот вопрос активно обсуждают: тред «стоит ли менять RTX 3090 на RTX 5070 Ti» в r/buildapc собрал больше 500 голосов. Ответ упирается в арифметику на 29 октября 2026 года:
- США: б/у RTX 3090 продаётся в среднем за $1 561, новая RTX 5070 Ti стоит от $1 300. Денег от продажи 3090 хватает на новую 5070 Ti, и ещё остаётся небольшая сдача.
- Украина: б/у RTX 3090 на OLX продают примерно за 40 000 ₴ (типичная цена на 25 октября 2026 года), а новая RTX 5070 Ti стоит от 58 693 ₴ на Hotline и 73 799 ₴ в наличии в Allo. Доплата — около 19–34 тыс. ₴.
В США обмен идёт почти без доплаты, в Украине — с доплатой от 19 тыс. ₴, и в обоих случаях это обмен 24 ГБ на 16 ГБ. Что вы получаете: новую карту с гарантией, поколение Blackwell с аппаратной поддержкой FP4 и меньшее потребление — 300 Вт против 350 Вт у 3090 (данные NVIDIA). Что теряете: Qwen3.8-27B в 4 битах с нормальным контекстом. На 16 ГБ эта модель помещается в 3 битах или впритык в самом лёгком 4-битном UD-IQ4_XS.Кому имеет смысл обмен Кому нет Основная задача — генерация картинок с FP8/FP4-оптимизациями, а LLM нужны до 14B Основная задача — чат и код на моделях 27–32B Пугает возраст б/у карты и хочется гарантии Нужен длинный контекст (документы, кодовая база) Важны тишина и потребление Планируете вторую карту и ступень 48 ГБ
Для LLM мы бы не меняли: при близкой цене вы теряете треть памяти, а именно память решает, какой класс моделей вы держите. Подробное сравнение 3090, 5070 Ti и 5080 по скорости в токенах и цены на OLX — в нашем выборе видеокарты для локального ИИ.
Генерация картинок: пороги VRAM у FLUX.2 не такие, как у LLM
У моделей генерации изображений свои пороги, и они не совпадают с LLM. Пример — FLUX.2 [dev] от Black Forest Labs, вышедшая 25 ноября 2025 года:Режим Сколько VRAM Источник Полная загрузка модели на 32B параметров 90 ГБ NVIDIA Blog Режим lowVRAM (в память грузится только активная часть) 64 ГБ NVIDIA Blog Квант FP8 на 40% меньше при сопоставимом качестве NVIDIA Blog Рекомендация ComfyUI для высокого разрешения 24 ГБ и больше ComfyUI Blog
Чтобы FLUX.2 вообще пошла на домашних картах, NVIDIA и ComfyUI доработали выгрузку весов в оперативную память (weight streaming): часть модели лежит в RAM, и это работает, но с потерей скорости, потому что системная память медленнее видеопамяти. Поэтому ComfyUI называет 24 ГБ и больше рекомендуемым минимумом для высокого разрешения, а на 16 ГБ в RAM уходит ещё большая часть весов. Для LLM та же 24-гигабайтная карта держит модель 27B целиком, для FLUX.2 — уже нет: пороги у двух задач разные. По видеомоделям сверенных порогов на эту дату у нас нет. Какую версию FLUX брать под 8, 12 и 24 ГБ — в статье FLUX локально на ПК и Mac.
Риски покупки памяти впрок: б/у, цены, разводка и слепые зоны прогноза
Рынок и цены:
- Покупка на пике. Б/у RTX 3090 подорожала на 24,9% за 90 дней (ResalePrices, 29 октября 2026 года), RTX PRO 6000 — вдвое с запуска. Старые гайды с ценой 3090 в $650–850 устарели.
- Дефицит памяти. По пересказу прогноза TrendForce, DRAM продолжит дорожать и в 2027 году. Оперативная память для MoE-сценария тоже станет дороже.
- Hotline не различает новое и б/у. Самые дешёвые предложения RTX 3090 там единичные, а на OLX у б/у карт нет гарантии; перед покупкой проверяйте состояние карты и продавца.
Техника:
- Б/у карта после интенсивной работы. У 3090 бывают проблемы с термопрокладками памяти и вентиляторами; что проверять при покупке — в нашем выборе видеокарты для локального ИИ.
- Разводка PCIe у мультикарточных сборок. Слот x4 от чипсета может превратить вторую 3090 из ускорителя в тормоз.
- Питание. RTX 5090 потребляет до 575 Вт и требует блок питания от 1000 Вт, RTX PRO 6000 — до 600 Вт, каждая RTX 3090 — 350 Вт.
Слепые зоны прогноза:
- Вывод «класс до 32B не растёт» сделан по двум-трём релизам. Следующий релиз может его раздвинуть.
- Бенчмарки Qwen3.8-27B — самоотчёт разработчика; замеры ComputingForGeeks сделаны на арендованных картах; ускорение кэша экспертов — один замер автора PR.
- 1-битные кванты, на которых «Flash»-модели помещаются в 96 ГБ, теряют заметную часть качества.
Что устареет первым: цены (их стоит перепроверять на Hotline и в трекерах перед покупкой), поддержка кэша экспертов в Ollama и LM Studio и список актуальных моделей — следующий релиз Qwen, DeepSeek или GLM может сдвинуть таблицу ступеней.
FAQ
Хватит ли 24 ГБ видеопамяти для локальных LLM в 2027 году?
Для моделей до 32B — по нашей оценке, да. Qwen3.8-27B в 4 битах занимает 16–19 ГБ, а её KV-кэш вчетверо легче, чем у Qwen3-32B, так что 24 ГБ держат её с контекстом до ~64K токенов. Не хватит, если вам нужна плотная 70B или «Flash»-модели на 125–320B: им нужно 48 ГБ и больше или много оперативной памяти.
Чем 32 ГБ лучше 24 ГБ, если модель та же?
Длиной контекста и запасом под 70B в 3 битах. По нашему расчёту Qwen3.8-27B в 4 битах с контекстом 128K занимает около 26 ГБ и помещается в 32 ГБ, но не в 24 ГБ. В замере ComputingForGeeks Qwen3 32B на 32K контекста на RTX 3090 упирается в нехватку памяти, а RTX 5090 выдаёт 53,3 токена в секунду.
Что лучше для LLM: одна RTX PRO 6000 на 96 ГБ или четыре RTX 3090?
По цене выигрывают четыре 3090: в США комплект б/у стоит около $6 244 против $17 987 за RTX PRO 6000 (конец октября 2026 года). Одна карта выигрывает простотой: 600 Вт вместо 1400 Вт, одна память без обмена по PCIe, обычная плата. Для 48 ГБ разумный компромисс — две 3090.
Стоит ли ждать новых карт или падения цен, прежде чем брать видеокарту под LLM?
По данным на 29 октября 2026 года — скорее нет. TrendForce в пересказе ComputingForGeeks ждёт роста контрактных цен DRAM ещё на 10–15% в четвёртом квартале 2026 года, а заметных новых мощностей — не раньше второй половины 2027-го. RTX 50 Super с памятью до 24 ГБ так и не вышла. Если задача укладывается в модели до 32B, 24 ГБ разумно брать сейчас; если нужна 70B каждый день — сразу 48 ГБ.
Нужна ли видеокарта с запасом по VRAM, если можно добавить оперативной памяти?
Оперативная память помогает MoE-моделям: с кэшем экспертов llama.cpp RTX 4090 на 24 ГБ запускает модель в 93,7 ГиБ со скоростью около 40 токенов в секунду (замер автора PR #29887). Но для плотных моделей выгрузка в RAM убивает скорость: 70B на RTX 3090 с частью слоёв в оперативной памяти даёт 3,4 токена в секунду.
Что делать, если модель не влезает в видеопамять?
Есть четыре рычага по порядку: взять квант пониже (с 4 бит на 3), сократить контекст, сжать сам KV-кэш до 8 бит или выгрузить часть модели в оперативную память. Для MoE-моделей последний вариант работает неплохо, для плотных — заметно медленнее. Если не помогает ничего, значит, нужна следующая ступень объёма или вторая карта.