
Коротко: что NVIDIA ограничила в RTX 30 и 40 и чего это стоит
RTX 3090 BF16 считает по-настоящему, но вдвое медленнее, чем позволяет её кристалл: NVIDIA урезала у GeForce скорость тензорных ядер в режиме, где промежуточные суммы хранятся в 32-битном формате. В конце октября 2026 года энтузиасты нашли способ снять этот лимит на RTX 20, 30 и 40, и тема разошлась по Reddit, Hacker News и профильным изданиям. Главное за минуту:
- Коротко: что NVIDIA ограничила в RTX 30 и 40 и чего это стоит
- RTX 3090 и BF16: поддержка есть, но FP32-накопление вдвое медленнее
- Кто ограничил BF16 на GeForce: регистры прошивки, а не драйвер
- Какие видеокарты затронуты: RTX 20, 30 и 40 — да, RTX 50 — нет
- Сколько даёт разблокировка BF16: GEMM, ComfyUI и LLM в цифрах
- Почему RTX 4090 после разблокировки даёт +10–34%, а не вдвое
- Почему RTX 50 остаётся закрытой и что это говорит о стратегии NVIDIA
- Риски gpu-unlock: сбои запуска, гарантия, лицензия, «установщики»
- Ускорит ли разблокировка вашу задачу: пять вопросов до установки
- Легальная альтернатива без эксплойта: FP16-накопление в PyTorch
- Что это значит для покупателя б/у RTX 3090 и 4090
- Частые вопросы про FP32 accumulation и BF16 на RTX 30 и 40
- Что ограничено. Скорость матричной математики FP16 и BF16 с FP32-накоплением на всех GeForce RTX — ровно половина от режима с FP16-накоплением; TF32 урезан так же — вдвое против профессиональной карты, а у RTX 40 и 50 вдвое урезан и FP8 с FP32-накоплением. Это не секрет: цифры стоят в официальных документах NVIDIA об архитектуре, а у профессиональной RTX A6000 на том же кристалле такого урезания нет.
- Чем снимается. Открытым модулем ядра Linux gpu-unlock: он отрабатывает до загрузки драйвера NVIDIA, драйвер и BIOS видеокарты не трогает, эффект пропадает после полного обесточивания. Основной проект — только для Linux.
- Сколько даёт. Зависит от задачи и лимита мощности: синтетика умножения матриц — от +25% до +87%, генерация в ComfyUI в BF16 — от +17% до +60% на RTX 3090 Ti, у большинства моделей картинок +46…+59%, обработка промпта в LLM — +9…+36%, генерация токенов и 4-битные модели — около нуля.
- Что с RTX 50. Тот же лимит есть и на RTX 5090, но снять его нечем: на Blackwell нет той лазейки в прошивке, которой пользуются старые карты.
- Риски. Сбои запуска, экспериментальный статус для RTX 40 и 20, вопросы гарантии и лицензии драйвера, сторонние «установщики», которые автор проекта не признаёт.
Как это устроено и кому вообще стоит об этом думать — ниже. Пошаговую установку описывает сам проект, мы разбираем суть, цифры и риски.
Пять терминов, без которых дальше будет сложно:
- Тензорные ядра — блоки видеокарты, которые умножают матрицы. На них держатся нейросети: и генерация картинок, и языковые модели.
- BF16 и FP16 — 16-битные форматы чисел. В них хранят веса большинства современных моделей, если те не сжаты квантованием.
- FP32-накопление (FP32 accumulation) — режим, в котором тензорное ядро складывает тысячи произведений в 32-битную «копилку». Так сумма не теряет точность. Для BF16 других режимов у тензорных ядер нет.
- GEMM — умножение больших матриц, синтетический тест «чистой» математики. Это ещё не скорость программы.
- Prefill и decode — две фазы работы языковой модели: обработка вашего промпта целиком и выдача ответа по одному токену.
RTX 3090 и BF16: поддержка есть, но FP32-накопление вдвое медленнее
Да, RTX 3090 поддерживает BF16 аппаратно: формат появился в тензорных ядрах архитектуры Ampere. Но NVIDIA указывает для GeForce-версии половинную скорость BF16-математики с FP32-накоплением — поддержка есть, но с паспортным лимитом.
Чтобы понять, откуда лимит, разберём, как тензорное ядро считает. Оно перемножает пары 16-битных чисел и складывает результаты. Складывать можно в 16-битную сумму — это быстрее, но на длинных цепочках накапливается ошибка. Или в 32-битную — медленнее на GeForce, зато точно. Почти всё обучение и значительная часть «полноценного» вывода моделей используют второй вариант. У BF16 режима с 16-битной суммой нет вовсе, поэтому BF16 на GeForce всегда идёт по урезанному пути.
Единицы измерения: FLOPS — операции с плавающей запятой в секунду, TFLOPS — триллионы таких операций. Пиковая скорость RTX 3090 BF16 с FP32-накоплением — 71 TFLOPS при 142 TFLOPS у FP16 с FP16-накоплением, это таблица в официальном документе NVIDIA об архитектуре Blackwell, где RTX 5090 сравнивают с 4090 и 3090. Независимые замеры совпадают с паспортом: 71,9 TFLOPS в cuBLAS у автора блога на Substack (март 2025) и 76,6–77,0 TFLOPS в BF16 у владельца двух карт в отчёте на GitHub (октябрь 2026, лимит 420 Вт).
Плотные пиковые TFLOPS тензорных ядер по документам NVIDIA (без учёта разреженности):Карта FP16 с FP16-накоплением FP16/BF16 с FP32-накоплением Доля FP32-режима RTX 3090 (GeForce, GA102) 142,3 71,2 50% RTX A6000 (профессиональная, GA102) 154,8 154,8 100% RTX 4090 (GeForce) 330,3 165,2 50% RTX 5090 (GeForce) 419 209,5 50%
Таблица показывает главное: у трёх поколений GeForce FP32-режим стоит ровно на половине, а профессиональная A6000 на том же кристалле GA102 держит полную скорость в обоих режимах. Разница в 82 и 84 вычислительных блока (SM) у 3090 и A6000 такой пропасти не объясняет. Независимый замер airealist.ai (26 октября 2026 года, арендованные карты) подтвердил картину на практике: на каждый такт GeForce делает примерно вдвое меньше математики с 32-битными суммами, а профессиональные карты — поровну.
Кто ограничил BF16 на GeForce: регистры прошивки, а не драйвер
Популярные посты на Reddit назвали лимит «программным» (software capped). Это неточно. По документу автора проекта и разбору Tech Times (28 октября 2026 года), скорость тензорных операций задают специальные регистры-селекторы внутри вычислительных блоков. По умолчанию в них записано значение «половина скорости». Записать туда другое может только код, работающий в защищённом режиме видеокарты Heavy Secure. Драйвер NVIDIA таких прав не имеет, поэтому патчи драйвера и не помогали.
Как этот замок открыли, если упростить до сути:
- Ошибка в подписанной прошивке. В загрузчике прошивки, который видеокарта доверенно выполняет при старте, нашли переполнение буфера. Через него можно выполнить свой код в защищённом режиме и переписать селекторы скорости.
- Модуль до драйвера. Проект gpu-unlock — модуль ядра Linux. По README версии 2.0.0, он делает свою работу до того, как к карте подключится драйвер NVIDIA, и прямо пишет, что не является ни UEFI-приложением, ни изменённым драйвером.
- Ничего не сохраняется. BIOS видеокарты не перепрошивается. По данным TweakTown и ai.rs, после полного обесточивания карта возвращается в заводское состояние.
У приёма есть предыстория из мира майнинга. В июне 2026 года исследователь Jon Pry опубликовал на Zenodo работу о майнинговой карте CMP 170HX. Это тот же кристалл, что у ускорителя A100, но математика урезана до 1/32. Pry показал, что эти ограничения снимаются кодом в режиме Heavy Secure, без ключей подписи и физического доступа. Проект gpu-unlock перенёс идею на GeForce.
Факт урезания при этом известен давно. В декабре 2018 года на форуме fast.ai обсуждали «half-speed FP32 accumulate» у GeForce RTX 20 (Titan RTX ограничения не имел). В 2024 году разработчик на форуме NVIDIA ссылался на обновлённый документ, где это прямо подтверждено. Новое в октябре 2026 года — не сам лимит, а способ его снять.
Зачем NVIDIA это делает, компания не объясняла. Tech Times на 28 октября 2026 года пишет, что NVIDIA публично проекты не комментировала. Версия автора gpu-unlock — сегментация рынка: бизнес должен покупать профессиональные карты без ограничений по заметно более высокой цене. Это мнение разработчика, а не заявление производителя.
Какие видеокарты затронуты: RTX 20, 30 и 40 — да, RTX 50 — нет
Лимит стоит на всех GeForce RTX с тензорными ядрами, но снять его пока можно только у трёх поколений. Статус поддержки — оценка автора проекта, а не NVIDIA и не независимых лабораторий.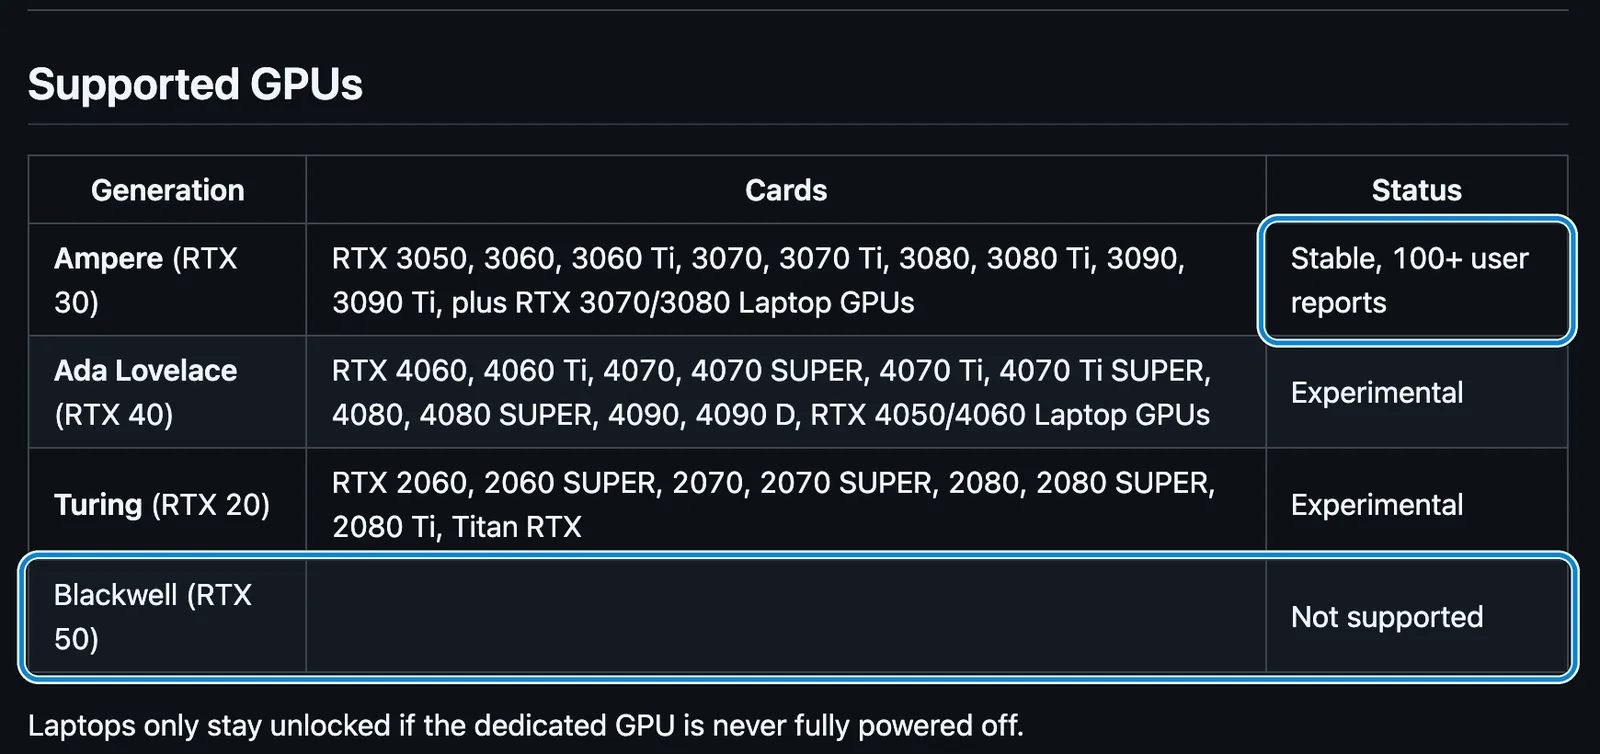
На скриншоте README проекта (снят 29 октября 2026 года) рамками выделены две строки: Ampere — «Stable, 100+ user reports», Blackwell — «Not supported».Поколение Карты Статус в README на 29.10.2026 Что подтверждено отчётами Ampere (RTX 30) 3050, 3060, 3060 Ti, 3070, 3070 Ti, 3080, 3080 Ti, 3090, 3090 Ti, ноутбучные 3070 и 3080 Stable, более 100 отчётов пользователей массово; исключение — OEM 3080 Ti 20 ГБ Ada (RTX 40) от 4060 до 4090 и 4090 D, ноутбучные 4050 и 4060 Experimental 4090, единичные 4090 D, 4070 Ti Super, 4060 Ti 16 ГБ Turing (RTX 20) от 2060 до 2080 Ti, Titan RTX Experimental одна RTX 2080 Ti 22 ГБ; только FP16; у Titan RTX по паспорту лимита нет Blackwell (RTX 50) вся линейка Not supported лимит есть, снятия нет
Оговорки, которые важны владельцу конкретной карты:
- Turing — только FP16. У RTX 20 нет аппаратного BF16, поэтому ускоряется лишь FP16-математика (Tom’s Hardware, 26 октября 2026 года).
- OEM RTX 3080 Ti 20 ГБ. Разблокировка проходит, но BF16 остаётся на половине скорости. Владелец в отчёте предполагает, что скорость этой модели ограничена на уровне кристалла. Подтверждения от NVIDIA нет.
- Ноутбуки. README предупреждает, что эффект сохраняется, только пока дискретная видеокарта ни разу не обесточена полностью. Режимы энергосбережения ноутбука это сводят на нет.
- Windows. Автор основного модуля прямо пишет, что Windows не использует и поддерживать не планирует. Есть сторонний экспериментальный порт через загрузочное UEFI-приложение. Tech Times (26 октября 2026 года) описывает его как версию только в исходном коде, которую нужно вручную выбирать в меню загрузки при каждом старте.
Сколько даёт разблокировка BF16: GEMM, ComfyUI и LLM в цифрах
Цифры из заголовков вроде «почти 2×» — это скорость выдачи инструкций, а не скорость программ. Между ними стоит лимит мощности, пропускная способность памяти и доля 16-битной математики в конкретной задаче. Поэтому замеры полезно сразу разделять на три уровня: синтетику, генерацию изображений и языковые модели.Задача Карта и условия До → после Прирост Источник BF16 GEMM RTX 3090, штатный лимит мощности 75 → 125 TFLOPS +65% README, 29.10.2026 BF16 GEMM RTX 3090, 420 Вт, N=8192 — +66,1% issue #85 BF16 GEMM RTX 3090 Ti, 450 Вт 88 → 157 TFLOPS +80% README, TweakTown BF16 GEMM RTX 3080 10 ГБ 65 → 113 TFLOPS +73% README BF16 GEMM RTX 4080 104 → 193 TFLOPS +87% README Генерация Z-Image Turbo, BF16 RTX 3090 Ti, ComfyUI 6,79 → 4,35 с +56,1% ComfyUI Wiki Генерация Qwen-Image 2.1 Turbo, BF16 RTX 3090 Ti, ComfyUI 8,51 → 5,41 с +57,2% ComfyUI Wiki Генерация Krea 2 Turbo, BF16 2× RTX 3090, 420 Вт 16,5 → 10,6 с ×1,57 issue #71 Видео LTX-2.5, BF16 RTX 3090 Ti, ComfyUI — +16,8% ComfyUI Wiki Генерация MOSS-Image, INT8 RTX 3090 Ti, ComfyUI 27,31 → 27,23 с +0,3% ComfyUI Wiki LLM prefill, vLLM, модель 27B BF16 RTX 3090, 350 Вт 12 346 → 16 165 ток/с +33% issue #25 LLM decode, та же модель RTX 3090, 350 Вт 112,98 → 114,24 ток/с +1,2% (шум) issue #25 LLM prefill 4× RTX 3090, 240 Вт 1 500 → 1 640 ток/с +9,3% issue #75 Модели INT8, FP8, INT4 (заявка README) любые — без изменений README FLUX.1 dev, чекпоинт FP8 RTX 3090 Ti, ComfyUI 31,96 → 20,66 с +54,6% ComfyUI Wiki MiniMax H3, INT8 ConvRot RTX 3090 Ti, ComfyUI 155,07 → 118,21 с +31,2% ComfyUI Wiki
Что видно из таблицы:
- Генерация изображений в BF16 — главный выигрыш. Замеры ComfyUI Wiki сняты на RTX 3090 Ti, у которой больше блоков и выше лимит мощности, чем у обычной 3090. На обычной 3090 сопоставимый результат даёт отчёт с двумя картами, у которых лимит поднят до 420 Вт (штатно — 350 Вт): Krea 2 Turbo ускорилась в 1,57 раза. По 150 прогонам ComfyUI Wiki картинки до и после совпали попиксельно.
- Самый большой прирост в замерах ComfyUI Wiki дала MiniMax H3 — +60,2% в BF16 на RTX 3090 Ti. Но если модель MiniMax H3 в ComfyUI на RTX 3090 упирается в оперативную память, время обмена с ОЗУ разблокировка не сокращает — ускоряется только часть, которую считает видеокарта.
- LLM ускоряются только на этапе промпта. Prefill — это сплошное умножение матриц, и он прибавляет 9–36% по разным отчётам. Decode упирается в скорость видеопамяти: у 3090 это 936 ГБ/с, и модуль её не меняет. Подробнее о том, как ведут себя эти карты в языковых моделях, — в разборе RTX 5090, 4090 и 3090 в локальных LLM.
- Квантованные модели ускоряются мало — но не всегда. Если математика модели действительно идёт в INT8 или INT4, лимит её не касается: MOSS-Image в INT8 прибавила 0,3%, а для llama.cpp и Ollama с файлами GGUF README даёт 0–15%, в основном на длинном контексте. Но у RTX 30 нет аппаратного FP8 (в документе NVIDIA — N/A), и FP8-чекпоинт на ней не идёт по 8-битному тракту: в ComfyUI FLUX.1 dev в FP8 ускорился на 54,6%, MiniMax H3 в INT8 ConvRot — на 31,2% (ComfyUI Wiki, RTX 3090 Ti).
Отдельно о заголовках. Notebookcheck вынес в заголовок «RTX 3090 performance nearly doubles», но речь там о BF16-умножении матриц (77,5 → 129,6 TFLOPS в отчёте пользователя), а не о скорости программ. Пост на Reddit с цифрой «+55% на RTX 3090» по цифрам совпадает с замерами ComfyUI Wiki, сделанными на RTX 3090 Ti. Заявленную в том же посте экономию энергии ни один открытый источник отдельно не измерял, поэтому на неё лучше не рассчитывать. Сам README обещает prefill +25–55%, а независимые отчёты дают +9…+36%.
Почему RTX 4090 после разблокировки даёт +10–34%, а не вдвое
У RTX 4090 разблокировка удваивает скорость выдачи инструкций, но реальные программы получают десятки процентов, а не удвоение. Причина — лимит питания 450 Вт: карта упирается в него раньше, чем в тензорные ядра. Цифры по независимому парному замеру из README форка для Ada (октябрь 2026 года, 450 Вт):
- Инструкции: FP16 с FP32-накоплением 160,4 → 320,4 TFLOPS, BF16 159,7 → 320,2 TFLOPS. Ровно вдвое.
- Реальное умножение матриц через cuBLAS (библиотеку NVIDIA, которую используют PyTorch и большинство программ): FP16 +12…+34% в зависимости от размера матриц, BF16 +16…+20% на двух размерах и без изменений на 4096×4096.
- Мощность: в другом прогоне того же форка разблокированная 4090 доходила до 346 Вт против 313 Вт в стоке и в обоих режимах работала под программным ограничением мощности.
Автор основного проекта формулирует это так: RTX 4090 «упирается в мощность раньше, чем в тензорные ядра». airealist.ai советует планировать 10–34%, а не 2×. Даже полноскоростной режим с 16-битными суммами у этой карты уже упирается в стену 450 Вт.
Тот же эффект виден на RTX 3090. В отчётах, собранных ComfyUI Wiki, прирост BF16-GEMM колеблется от +25% до +67% в зависимости от лимита мощности. В отчёте с четырьмя 3090 (issue #75) шаг дообучения LoRA при лимите 240 Вт ускорился на 20–24%, а одна карта, разблокированная и поднятая до 350 Вт, — на 49% относительно того же стока при 240 Вт: в эту цифру входит и прибавка мощности. Сколько вы получите, во многом определяется тем, сколько ватт готовы отдать карте и сможет ли охлаждение это отвести.
Почему RTX 50 остаётся закрытой и что это говорит о стратегии NVIDIA
На RTX 5090 тот же лимит есть, но снять его нечем. В документе NVIDIA у 5090 стоит 419 TFLOPS для FP16 с FP16-накоплением и ровно половина, 209,5, с FP32-накоплением. Замер ai.rs на собственной карте (25 октября 2026 года) дал 441,4 и 224,3 TFLOPS, то есть 51%. Исследовательский репозиторий phiraml намерил 0,68 от полной скорости в своей методике. Методики разные, но лимит видят все.
Почему лазейка не работает, ai.rs объясняет так: у кристалла GB202 нет того уязвимого загрузчика прошивки, через который снимают лимит у старых карт, а записи в регистры скорости карта молча отбрасывает. README gpu-unlock отвечает на вопрос о Blackwell коротко: не поддерживается, и поддержка маловероятна.
Отсюда контринтуитивный результат, на который обратил внимание ai.rs:Карта Состояние FP16/BF16 с FP32-накоплением, TFLOPS RTX 4090 разблокирована ≈331 RTX 5090 заводское 224,3 RTX 5090 теоретически без лимита около 440
На этом одном тракте старая карта после разблокировки быстрее новой в заводском виде. Это скорость инструкций, а не приложений, и у 5090 остаются 32 ГБ памяти и более быстрая шина. Но картина хорошо показывает, где проходит граница сегментации.
Что это говорит о стратегии. По данным airealist.ai, на Blackwell 4-битный формат FP4 NVIDIA считает на полной скорости даже у GeForce, а урезан по-прежнему 32-битный режим накопления, которым пользуются обучение и точный вывод. Профессиональные карты при этом упираются в свою стену — мощность: RTX 6000 Ada на кристалле 4090 ограничена 300 Вт и в замерах airealist.ai выдала 93–127 TFLOPS против 145–163 у GeForce 4090. Логика сегментации, по версии автора проекта и аналитиков, такая: обучение и дата-центр — на дорогих картах, потребительский вывод в 4 битах — на GeForce. Сама NVIDIA этого не подтверждала.
Риски gpu-unlock: сбои запуска, гарантия, лицензия, «установщики»
Модуль работает на уровне прошивки видеокарты через уязвимость. Это не настройка в панели драйвера, и риски у него соответствующие. Каждый пункт ниже — с датой и источником:
- Сбой запуска. В issue #23 (24 октября 2026 года) владелец двух RTX 3090 сообщил, что одна из версий модуля завершалась ошибкой и оставляла видеокарты недоступными драйверу до полного перезапуска. Ошибку исправили в тот же день. Для RTX 4090 README форка просит первый запуск делать только после полного выключения машины.
- Нагрузка на железо. Автор gpu-unlock считает повреждение карты маловероятным. Форк для RTX 20 предупреждает обратное: тензорные ядра на полной скорости потребляют очень много, и разблокировка «может повредить железо», использовать на свой риск. Самый длинный опубликованный отчёт о стабильности — 8 часов смешанной нагрузки на одной 3090 (issue #25). Долгих стресс-тестов нет.
- NVIDIA может закрыть лазейку. Метод держится на ошибке в подписанной прошивке. Планы NVIDIA неизвестны: на 28 октября 2026 года компания проекты не комментировала.
- Гарантия. TweakTown и Tech Times пишут, что любая такая модификация лишает гарантии. Условий конкретных производителей карт мы в источниках не нашли, поэтому для своей карты это стоит уточнить у продавца.
- Лицензия драйвера. Пункт 2.6 лицензии драйвера NVIDIA запрещает обходить технические ограничения программного обеспечения, а пункт 2.8 — использовать ПО для GeForce в дата-центрах. Применим ли запрет к модулю, который работает до загрузки драйвера, юридически не установлено.
- Сторонние сайты и «установщики». README проекта называет репозиторий единственным оригинальным источником: сайты, установщики и криптопроекты с этим названием к автору не относятся. К установщикам для Windows автор советует относиться очень осторожно. Программа, которая выполняет код на уровне ядра системы, из непроверенного источника — прямой риск для всего компьютера.
- Молодой проект. Репозиторий создан 18 октября 2026 года, к 29 октября у него версия 2.0.0, около 12,8 тыс. звёзд и 49 открытых обращений. Поддержка RTX 40 и 20 помечена как экспериментальная.
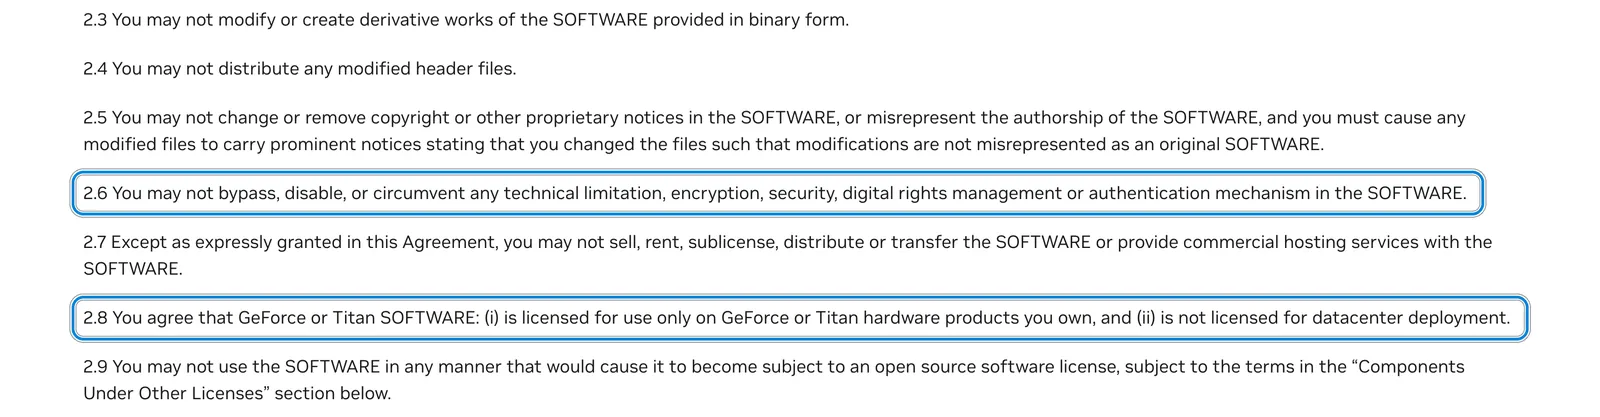
На скриншоте лицензии драйвера NVIDIA (снят 29 октября 2026 года) выделены два пункта, о которых шла речь выше.
У метода есть и сильные стороны, которые видны в отчётах. Результаты генерации совпадают с исходными до бита. Изменения обратимы обесточиванием. BIOS карты не перезаписывается.
Ускорит ли разблокировка вашу задачу: пять вопросов до установки
Прежде чем решать, нужно ли это вообще, ответьте на пять вопросов. Если на первые два ответ «нет», прироста не будет, и дальше можно не читать.
- Задача упирается в вычисления, а не в память? Генерация изображений и видео, обучение и дообучение, обработка длинных промптов — да. Чат с моделью, где ответ идёт токен за токеном, — нет.
- Модель работает в BF16 или FP16 с FP32-накоплением? Полные веса моделей диффузии и обучение в смешанной точности — да. GGUF в Q4 и модели, которые считают в INT8, — почти нет. FP8-чекпоинты в ComfyUI на RTX 30 — да: у этих карт нет аппаратного FP8.
- Чего больше в вашей работе: prefill или decode? Длинные документы и пакетная обработка выигрывают, короткие вопросы с длинными ответами — почти нет.
- Какой лимит мощности у карты? При урезанном до 225–240 Вт питании прирост падает примерно до +20–25%.
- Справится ли охлаждение? Разблокированная карта под той же нагрузкой может потреблять больше: у 4090 пик вырос с 313 до 346 Вт.
Пример расчёта для чата — наша оценка, а не замер. Возьмём скорости модели 27B в BF16 на одной RTX 3090 из issue #25 (там промпт был 2 904 токена) и перенесём их на промпт в 20 тыс. токенов; на длинном контексте реальная скорость prefill может быть ниже. Такой промпт обрабатывается за 1,62 с при 12 346 ток/с и за 1,24 с после разблокировки. Ответ на 500 токенов при 113 ток/с занимает 4,4 с в обоих случаях. Итого 6,0 с против 5,6 с — время ответа сокращается примерно на 6%, хотя prefill ускорился на треть.
Пример расчёта для генерации. Общий прирост программы можно оценить по закону Амдала: ускоряется только доля времени, которую занимает 16-битная математика. Если 70% времени генерации — BF16-GEMM, а он ускоряется в 1,65 раза, то общее время станет 0,3 + 0,7 ÷ 1,65 ≈ 0,72 от исходного, то есть около +38% к скорости. Это наша оценка по формуле, а не замер, но она объясняет, почему у разных моделей ComfyUI прирост колеблется от +17% до +60%.
Легальная альтернатива без эксплойта: FP16-накопление в PyTorch
Если ваша задача работает в FP16, а не в BF16, часть скорости можно получить без вмешательства в прошивку. В PyTorch есть официальный флаг torch.backends.cuda.matmul.allow_fp16_accumulation = True: он разрешает складывать произведения в 16-битную сумму, а этот режим у GeForce работает на полной скорости.
Цена — точность. В эксперименте автора блога на Substack (март 2025 года) на RTX 3090 такой режим в Triton дал 93–95 TFLOPS против 69–71 TFLOPS, то есть около +30%, со среднеквадратичной ошибкой 0,000185. Для вывода готовых моделей это часто приемлемо, для обучения — рискованно: ошибки накапливаются.
У BF16 такого обходного пути нет. Режим с 16-битной суммой для BF16 у тензорных ядер не предусмотрен, поэтому BF16-модели на GeForce в заводском виде всегда идут на половинной скорости.
Что это значит для покупателя б/у RTX 3090 и 4090
Главный аргумент за б/у RTX 3090 и 4090 для нейросетей — 24 ГБ видеопамяти. Разблокировка его не меняет, но для части задач делает эти карты заметно выгоднее. Подробно о выборе по объёму памяти — в материале Выбор видеокарты для локального ИИ.Кто вы Важен ли лимит Почему Генерируете изображения и видео в BF16 в ComfyUI да, сильно диффузия — почти чистая 16-битная математика, +46…+60% на 3090 Ti Дообучаете модели, LoRA, обучение в смешанной точности да обучение использует FP32-накопление Обрабатываете длинные документы в vLLM, пакетная обработка частично prefill +9…+36%, decode без изменений Общаетесь с моделью в Ollama, LM Studio, llama.cpp в Q4 нет 4-битные модели не урезаны Играете, в том числе с DLSS нет по Tech Times, игры не используют урезанный режим; проверенных замеров FPS нет
Цены на дату. По данным airealist.ai, средняя цена проданных на eBay б/у RTX 3090 по 24 октября 2026 года — $1 093, RTX 4090 — $2 271. Это рынок США, украинских цен в источниках нет. iXBT 27 октября предположил, что новость разогреет вторичный рынок и старые карты подорожают. Это прогноз, а не наблюдение.
Практические выводы для покупателя:
- Покупать 3090 ради разблокировки не стоит, покупать 3090 ради 24 ГБ — по-прежнему разумно. Прирост — бонус для конкретных задач, а не гарантированное свойство: NVIDIA может закрыть лазейку, а некоторые модели вроде OEM 3080 Ti 20 ГБ не ускоряются вовсе.
- Две 3090 вместо одной дорогой карты остаются популярным вариантом для локальных LLM. Как собрать такую систему, разобрано в материале сборка на двух RTX 3090 для локального ИИ.
- 4090 ради разблокировки — слабый аргумент. Реальный прирост 10–34% и упор в 450 Вт.
- RTX 50 лимит не снимет. Если важна именно 32-битная математика, это стоит учитывать при сравнении новой 5090 с б/у 4090. Общий расклад по рынку — в гайде какую видеокарту купить, пока RTX 5090 у перекупщиков.
- Проверяйте карту после майнинга и под нагрузкой. Разблокировка увеличивает тепловую нагрузку на тензорных задачах. Карта с изношенными вентиляторами и термопрокладками отработает её хуже.
Частые вопросы про FP32 accumulation и BF16 на RTX 30 и 40
Что такое FP32 accumulation на RTX 3090 и почему BF16 медленнее, чем на профессиональных картах?
FP32 accumulation — режим, в котором тензорное ядро складывает произведения 16-битных чисел в 32-битную сумму, чтобы не терять точность. На RTX 3090 BF16 работает только в этом режиме, а NVIDIA указала для GeForce половинную скорость: 71 TFLOPS против 142 у FP16 с 16-битной суммой. Профессиональная RTX A6000 на том же кристалле держит 154,8 TFLOPS в обоих режимах.
Работает ли разблокировка на RTX 50 и почему нет?
Нет. На RTX 5090 тот же лимит есть — замер ai.rs показал 51% от полной скорости. Но у кристалла Blackwell нет уязвимого загрузчика прошивки, через который лимит снимают у RTX 20, 30 и 40, а записи в регистры скорости карта отбрасывает. Автор gpu-unlock на 29 октября 2026 года называет поддержку RTX 50 маловероятной.
Безопасно ли ставить модуль ядра для ускорения видеокарты?
Полностью безопасным это назвать нельзя. Модуль использует уязвимость в прошивке, поддержка RTX 40 и 20 экспериментальная, есть отчёты о картах, недоступных драйверу до перезапуска. Форк для RTX 20 предупреждает о риске повреждения из-за высокой мощности. Плюс вопросы гарантии и лицензии драйвера. Сторонние установщики и сайты автор проекта не признаёт.
Правда ли, что RTX 3090 ускоряется на 55% в ComfyUI?
Цифра около +56% относится к RTX 3090 Ti и BF16-моделям: ComfyUI Wiki намерил 6,79 → 4,35 с на Z-Image Turbo. На обычной 3090 с лимитом, поднятым до 420 Вт, Krea 2 Turbo ускорилась в 1,57 раза (отчёт с двумя картами). Прирост сильно зависит от лимита мощности и модели: видео LTX-2.5 дало +16,8%, INT8-модель — +0,3%.
Ускорит ли это Ollama, llama.cpp и игры с DLSS?
Почти нет. Ollama и llama.cpp обычно запускают 4-битные модели в GGUF, а этот тракт не урезан — README проекта даёт 0–15%, в основном на длинном контексте. Генерация токенов упирается в скорость видеопамяти, которую модуль не меняет. По Tech Times, игры урезанный режим не используют, а Notebookcheck отмечает, что проверенных замеров FPS с разблокировкой нет.