
Коротко: какой SSD брать под локальный ИИ и сколько ТБ
SSD для ИИ на домашнем компьютере делает три вещи. Он хранит библиотеку моделей. Он решает, сколько секунд вы ждёте при первом запуске модели. И только если модель не поместилась в видеопамять и оперативную память, он ограничивает скорость ответа. Когда модель целиком в памяти, скорость генерации от диска не зависит: в независимом замере время до первого слова было 0,184 с с быстрого NVMe-диска и 0,178 с со старого SATA-диска, который читает примерно в 5 раз медленнее.
- Коротко: какой SSD брать под локальный ИИ и сколько ТБ
- Что SSD делает в локальном ИИ: хранит модель и грузит её в память
- Сколько места занимают модели: размеры файлов с Hugging Face
- Сколько ТБ нужно SSD: считаем библиотеку из 3, 9 и 13 моделей
- Влияет ли скорость SSD на токены в секунду: что показали замеры
- Сколько секунд занимает загрузка модели с SATA, Gen3, Gen4 и Gen5
- Gen5 или Gen4: окупается ли переплата при загрузке модели
- Когда SSD становится узким местом: модель не влезла в память
- Какой SSD выбрать: Samsung 990 PRO, SN850X и бюджетные NVMe
- Как разложить диски: система, быстрая библиотека и архив
- Износ SSD от локального ИИ: чтение модели ресурс не тратит
- Ошибки и риски при выборе SSD под локальный ИИ
- Частые вопросы про SSD для локального ИИ
Поэтому при выборе главное — объём, а не рекорд скорости. Ниже наш расчёт по реальным размерам файлов с Hugging Face на 7 ноября 2026 года: сколько места займёт библиотека моделей с запасом на версии и систему. Своих замеров скорости дисков у нас нет. Время загрузки мы посчитали по паспортным скоростям и сверили с двумя независимыми тестами, условия которых названы ниже.Сценарий Что держите на диске Объём SSD Тип диска Старт 2–3 модели 8B–27B в кванте Q4 1 ТБ (512 ГБ впритык) любой NVMe PCIe 4.0 Рабочий набор 6–9 моделей до 70B Q4 плюс FLUX и SDXL 2 ТБ (1 ТБ — минимум) NVMe PCIe 4.0 Большая библиотека 120B, 235B, 70B в Q8, несколько квантов одной модели 4 ТБ NVMe PCIe 4.0 или 5.0 — что дешевле
- Gen5 (диски PCIe 5.0, новейшее поколение) почти ничего не даёт на загрузке: на 70B в кванте Q4_K_M он экономит не больше 2,8 с за холодный запуск, и это верхняя граница по паспорту.
- На 2 ТБ Gen5 почти не дороже: на 7 ноября 2026 года Samsung 9100 PRO (PCIe 5.0) стоит на Hotline от 17 949 грн, 990 PRO (PCIe 4.0) — от 17 650 грн.
- Надпись «PCIe 4.0» не гарантирует скорость: самый дешёвый 1 ТБ «PCIe 4.0» в каталоге Hotline читает 3 500 МБ/с — это уровень прошлого поколения.
- Не хватает памяти — диск не спасёт: скорость падает обрывом, с десятков токенов в секунду до долей. Сначала видеопамять и ОЗУ, потом диск.
Что SSD делает в локальном ИИ: хранит модель и грузит её в память
SSD в локальном ИИ — это склад, а не рабочий стол. Модель лежит на диске файлом, обычно в формате GGUF (один файл с весами нейросети). При запуске программа читает его в видеопамять или оперативную память, и дальше модель работает оттуда. Диск в это время простаивает. Он снова нужен при смене модели или когда памяти не хватило.
В домашней системе у модели три яруса:

- Видеопамять (VRAM) — память видеокарты. Самая быстрая, но её меньше всего.
- Оперативная память (ОЗУ) — медленнее видеопамяти, зато её проще нарастить. Сюда уходит то, что не влезло в видеокарту.
- SSD — хранит файлы. В работе участвует при загрузке и как аварийный третий ярус, когда первых двух не хватило.
Как именно файл попадает в память, решает движок. llama.cpp — движок, на котором работают Ollama и LM Studio, — по умолчанию открывает модель через mmap. Это отображение файла в память: система подгружает куски файла с диска по мере обращения и держит их в кеше. В README сервера llama.cpp параметр --load-mode по умолчанию стоит в auto, то есть mmap, если устройство его поддерживает. Чем движки отличаются по скорости на одной модели, мы разбирали в сравнении Ollama, LM Studio и llama.cpp.
Второе правило — модель не выгружается сразу. Ollama по умолчанию держит её в памяти 5 минут после последнего запроса (официальный FAQ Ollama). Повторная загрузка поэтому почти бесплатна. В замере kimono-oyaji Llama 3.3 70B холодно грузилась 12 с, а повторно — 0,30 с.
Пример. Утром вы открыли чат с Llama 3.3 70B. Диск читает 42,5 ГБ — на стенде kimono-oyaji такая загрузка заняла 12 с, — и дальше вы переписываетесь без его участия. Ушли на обед дольше чем на 5 минут — Ollama выгрузила модель. Следующий запрос снова прочитает файл. Если ОЗУ хватает, часть файла система возьмёт из своего кеша, и загрузка пройдёт быстрее. Остальное железо под локальные модели — видеокарта, Mac или мини-ПК — подробно разобрано в гиде как выбрать железо для локального ИИ.
Сколько места занимают модели: размеры файлов с Hugging Face
Модель на 8 млрд параметров в популярном кванте Q4_K_M занимает около 5 ГБ, на 70 млрд — 42,5 ГБ, на 235 млрд — 142 ГБ. Квант — это сжатие весов. Q4 хранит примерно 4 бита на параметр, Q8 — около 8, поэтому одна модель в Q8 весит почти вдвое больше. Размеры ниже мы сняли запросом к API Hugging Face 7 ноября 2026 года.
Цифры взяты у популярных сборщиков GGUF (bartowski, unsloth, ggml-org), «ГБ» здесь — миллиард байт. Для примера — страница файлов Llama 3.3 70B на Hugging Face, где лежат десятки квантов одной модели.Модель и квант Размер на диске Llama 3.1 8B, Q4_K_M 4,92 ГБ Qwen3 14B, Q4_K_M 9,00 ГБ gpt-oss-20b, MXFP4 12,11 ГБ Qwen3.6-27B, Q4_K_M 16,82 ГБ Qwen3-32B, Q4_K_M 19,76 ГБ Qwen3.6-35B-A3B, Q4_K_M / Q8_0 22,13 / 36,90 ГБ Llama 3.3 70B, Q4_K_M / Q8_0 42,52 / 74,98 ГБ gpt-oss-120b, MXFP4 63,39 ГБ Qwen3-235B-A22B, Q4_K_M (три части) 142,15 ГБ DeepSeek-R1, Q4_K_M / Q8_0 404,43 / 713,29 ГБ FLUX.1 dev (картинки) 23,80 ГБ SDXL base (картинки) 6,94 ГБ 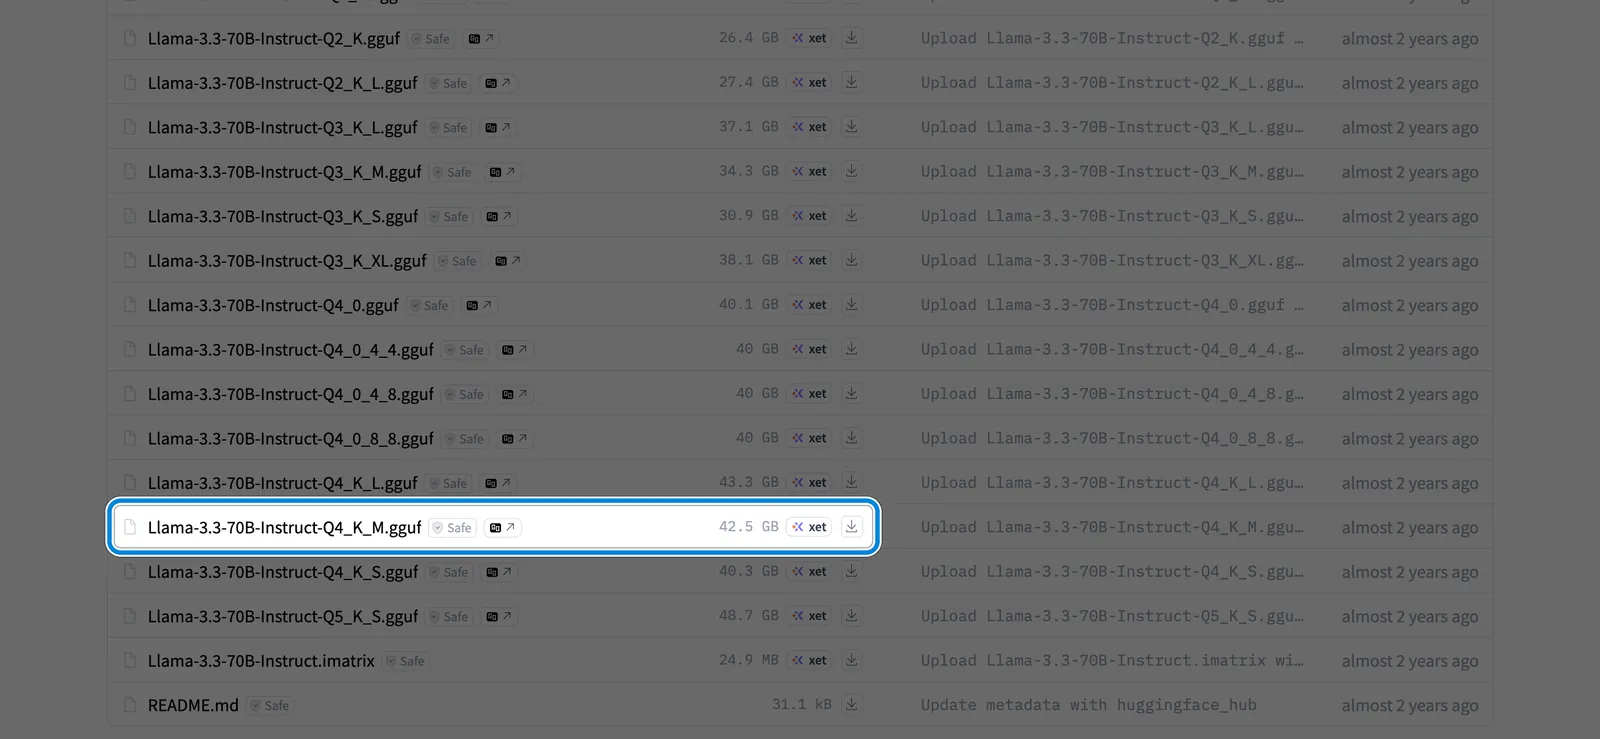
На снимке страницы файлов от 8 ноября 2026 года рамкой выделен файл Llama-3.3-70B-Instruct-Q4_K_M.gguf — 42,5 ГБ. Выше и ниже — другие кванты той же модели от 16,8 до 48,7 ГБ. Скачать два-три варианта «на пробу» — и одна модель уже занимает больше 100 ГБ.
Три оговорки к таблице:
- Это только веса. KV-кэш — память под контекст разговора — живёт в видеопамяти или ОЗУ, а не на диске. Сколько он занимает, считаем в разборе видеопамяти под LLM.
- MoE-модели весят как большие. MoE (mixture of experts) — модель из множества «экспертов», из которых на каждое слово работает только часть. У gpt-oss-120b 117 млрд параметров, активных — 5,1 млрд (по карточке модели OpenAI в пересказе Wombit). Считает она как маленькая, а на диске лежит весь файл — 63,39 ГБ. В реестре Ollama та же модель записана как 65 ГБ: упаковка другая.
- В Windows диск кажется меньше. Производитель считает 1 ТБ как триллион байт, а Windows подписывает такой диск «931 ГБ», хотя на деле это 931 гибибайт (ГиБ, по 1 073 741 824 байта).
Как выбор кванта влияет на качество ответов, а не только на место, — в разборе квантования Q4 против Q8.
Сколько ТБ нужно SSD: считаем библиотеку из 3, 9 и 13 моделей
Библиотека занимает не «число моделей × размер», а больше: люди держат по несколько квантов одной модели и старые версии. Поэтому мы посчитали объём с множителем копий. ×1 — один квант на модель. ×1,5 — иногда второй. ×3 — по три копии каждой модели. Порядок взят у OpenClawDC: там советуют закладывать на каждую модель, которую всерьёз пробуете, втрое больше объёма видеопамяти. Если держите Q4, Q6 и Q8 одной модели, множитель будет выше, около ×4,5: Q8 весит вдвое больше Q4.
Формула нашего расчёта: нужный объём = (сумма файлов × множитель + 150 ГБ на систему и программы) ÷ 0,8. Деление на 0,8 — запас: диск лучше не заполнять больше чем на 80%. Это практический совет SpecPicks (у потребительских SSD при заполнении падает скорость записи), а не норма производителя. Считали скриптом по размерам из таблицы выше.Профиль Что входит Сумма файлов ×1 ×1,5 ×3 Вывод Старт 8B, 14B, 27B 30,7 ГБ 226 ГБ 245 ГБ 303 ГБ 1 ТБ с запасом, 512 ГБ впритык Рабочий набор + 20B, 32B, 35B-A3B, 70B, SDXL, FLUX 158,0 ГБ 385 ГБ 484 ГБ 780 ГБ 1 ТБ минимум, 2 ТБ комфортно Большая библиотека + 120B, 70B Q8, 35B Q8, 235B 475,4 ГБ 782 ГБ 1 079 ГБ 1 970 ГБ 2 ТБ впритык, 4 ТБ с запасом
Что видно из расчёта:
- 1 ТБ закрывает старт и рабочий набор без лишних копий. На 1 ТБ помещается 15 файлов Llama 3.3 70B в Q4_K_M (с учётом системы и запаса 20%), на 2 ТБ — 34.
- 2 ТБ — разумный дефолт. Рабочий набор даже с тройным множителем требует 780 ГБ, и место остаётся на рост.
- 4 ТБ нужны тем, кто держит 120B и 235B. Большая библиотека с тройными копиями требует 1 970 ГБ: 2-терабайтный диск заполнится до тех самых 80%, и места на новые модели не останется.
- Гигантские модели живут отдельно. Один только DeepSeek-R1 в Q4_K_M занимает 404 ГБ — 20% диска на 2 ТБ, в Q8_0 — 713 ГБ, или 36%.
Влияет ли скорость SSD на токены в секунду: что показали замеры
Нет, если модель целиком помещается в видеопамять и ОЗУ. Диск читает файл один раз при запуске, а генерация идёт из памяти. В замере bestin-it время до первого слова после загрузки было 0,184 с на NVMe и 0,178 с на SATA — статистически одинаково. Скорость диска меняет только ожидание при загрузке.
Мы опираемся на два независимых теста с описанной методикой:Замер Стенд Холодная загрузка Повторная До первого слова bestin-it: Qwen3.6-35B-A3B Q4_K_S, 19,92 ГиБ HP Z6 G4, Radeon PRO W7900 48 ГБ, llama-server (Vulkan), 10 прогонов на диск NVMe 25,74 с / SATA 57,97 с — 0,184 / 0,178 с kimono-oyaji: Llama 3.3 70B, 42 ГБ RTX 3090 + RTX 3060, 62 ГБ ОЗУ, Ollama, медиана 5 прогонов 12 с 0,30 с — kimono-oyaji: Qwen3 8B, 5 ГБ тот же 3,2 с 0,25 с —
У bestin-it перед каждым прогоном сбрасывался кеш файлов, чтобы диск действительно читал модель. Важная деталь стенда: NVMe стоял на канале PCIe 3.0, так что это сравнение «NVMe прошлого поколения против SATA».
Сколько секунд занимает загрузка модели с SATA, Gen3, Gen4 и Gen5
Пара терминов. SATA — старый интерфейс дисков, его потолок 600 МБ/с. NVMe — SSD, подключённый к шине PCIe, той же, где стоит видеокарта. Gen3, Gen4 и Gen5 — поколения PCIe. M.2-диск подключён четырьмя линиями PCIe (x4), и через них эти поколения пропускают до 3,9, 7,9 и 15,8 ГБ/с.
Нижняя граница времени чтения — размер файла, делённый на паспортную скорость. Быстрее, чем по этой таблице, модель не загрузится:Накопитель (паспорт чтения) 8B Q4 (4,92 ГБ) 27B Q4 (16,82 ГБ) 70B Q4 (42,52 ГБ) 120B (63,39 ГБ) 235B Q4 (142,15 ГБ) HDD, 180 МБ/с 27 с 93 с 3,9 мин 5,9 мин 13,2 мин SATA SSD, 600 МБ/с 8,2 с 28 с 71 с 106 с 3,9 мин NVMe Gen3, ~3 500 МБ/с 1,4 с 4,8 с 12,1 с 18,1 с 40,6 с NVMe Gen4, 7 450 МБ/с (990 PRO) 0,7 с 2,3 с 5,7 с 8,5 с 19,1 с NVMe Gen5, 14 800 МБ/с (9100 PRO) 0,3 с 1,1 с 2,9 с 4,3 с 9,6 с
Паспортные скорости 990 PRO и 9100 PRO взяты со страниц Samsung, скорость жёсткого диска — паспорт Seagate IronWolf в пересказе Popular AI.
Реальная загрузка всегда дольше по двум причинам.
- Есть фиксированная часть. Движок разбирает файл, выделяет память, копирует веса в видеокарту. У kimono-oyaji эта часть — 1,6 с, у bestin-it — 14–17 с. От диска она не зависит.
- Паспортная скорость — максимум, а не норма. В тесте bestin-it диск Kingston KC3000 читал модель на 2 339,6 МБ/с, ниже паспорта.
Отсюда парадокс bestin-it. NVMe читал в 5,07 раза быстрее SATA, а загрузка ускорилась только в 2,25 раза: 14–17 с фиксированной работы съели разницу. Формула kimono-oyaji для его стенда — 1,6 с плюс размер, делённый примерно на 4 ГБ/с. Для 70B Q4_K_M она даёт 12,2 с, и измеренные 12 с с ней совпадают.
Gen5 или Gen4: окупается ли переплата при загрузке модели
По скорости — почти нет. На Llama 3.3 70B в Q4_K_M Gen5 экономит не больше 2,8 с за холодный запуск, и это паспортная верхняя граница: фиксированная часть загрузки съест часть выигрыша. По деньгам ответ зависит от объёма. На 2 ТБ на 7 ноября 2026 года Gen5 стоит почти как Gen4, на 4 ТБ у Samsung переплата уже заметная.
Цены — минимальные предложения на карточках Hotline на 7 ноября 2026 года. Доллары — по курсу НБУ 45,4432 грн на ту же дату.Диск Поколение 2 ТБ 4 ТБ Samsung 990 PRO PCIe 4.0 17 650 грн ($388) 33 339 грн ($734) WD_BLACK SN850X PCIe 4.0 17 280 грн ($380) 29 960 грн ($659) Kingston NV3 PCIe 4.0 13 999 грн ($308) 21 943 грн ($483) Samsung 9100 PRO PCIe 5.0 17 949 грн ($395) 42 699 грн ($940) Crucial T705 PCIe 5.0 17 620 грн ($388) 32 990 грн ($726)
Внутри линейки Samsung разница на 2 ТБ — 299 грн ($6,6), на 4 ТБ — 9 360 грн ($206), или 28%. Но у Crucial T705 на 4 ТБ цена Gen5 даже ниже, чем у 990 PRO: 32 990 против 33 339 грн. Паспорт T705 с официальной страницы Crucial мы не сняли — сайт отказал в доступе, поэтому скорость в таблицу не ставим.
Окупаемость считали так: секунды, сэкономленные на холодных запусках 70B, против переплаты за 4 ТБ Samsung 9100 PRO вместо 990 PRO.Холодных запусков 70B в день Gen5 экономит в день В год Цена часа ожидания при переплате $206 1 ≤3 с ≤0,3 ч от $717 5 ≤14 с ≤1,4 ч от $143 15 ≤43 с ≤4,3 ч от $48 40 ≤113 с ≤11,5 ч от $18
Для сравнения: переход с SATA на Gen4 при одном холодном запуске 70B в день экономит до 6,6 часа в год. Вот где ожидание реально уходит.
Что говорят другие:
- Производитель Micron пишет в белой книге о своём Gen5-диске 3610, что загрузка моделей стала быстрее «до 25%» против выбранных им Gen4-дисков. Это данные стороны, которая продаёт Gen5.
- Обзор на dev.to оценивает выигрыш Gen5 в 2–4 с на модели 40 ГБ — близко к нашей паспортной оценке.
Практические условия для Gen5. Нужен слот M.2 с PCIe 5.0: в слоте Gen4 диск упрётся в 7,9 ГБ/с и станет обычным Gen4. По обзору Compute Market, Gen5-диски заметно горячее, и большинству нужен массивный радиатор или обдув. А на потребительских платах слот Gen5 нередко делит линии PCIe со слотом видеокарты, и тогда видеокарте их достаётся меньше. Это проверяют в инструкции к плате до покупки.
Итог: на 2 ТБ можно брать то, что дешевле, если слот Gen5 свободен. На 4 ТБ переплачивать за Gen5 ради загрузки нет смысла. Почему SSD и память вообще подорожали и когда ждать снижения — в разборе цен на оперативную память и SSD.
Когда SSD становится узким местом: модель не влезла в память
Когда часть весов не помещается в видеопамять и ОЗУ, движок через mmap дочитывает недостающие куски с диска на каждом токене. Скорость падает обрывом, а не плавно. В замере bigiron.cc модель генерировала 32–34 токена в секунду, пока в памяти было не меньше 95% весов, 3,4 — при 79% и 0,8 — при 63%.Доля модели в памяти Скорость генерации 95–100% ~32–34 токена/с ~79% 3,4 токена/с ~63% 0,8 токена/с ~47% 0,8 токена/с
Условия этого теста: маленькая модель Qwen2.5-0.5B в F16 (1,27 ГБ), память урезана искусственно, облачная виртуальная машина, каждый режим прогнан один раз. Абсолютные цифры относятся к этому стенду, но форма — обрыв — общая.
Автор теста даёт формулу, которой удобно прикинуть свой случай: токены в секунду ≈ скорость чтения диска ÷ гигабайты весов, которые не влезли в память. Посчитали для разных случаев плотной модели:Не влезло в память SATA, 0,5 ГБ/с NVMe, 3 ГБ/с NVMe, 5 ГБ/с 5 ГБ 0,10 ток/с 0,60 ток/с 1,00 ток/с 10 ГБ 0,05 ток/с 0,30 ток/с 0,50 ток/с 20 ГБ 0,03 ток/с 0,15 ток/с 0,25 ток/с 40 ГБ 0,01 ток/с 0,07 ток/с 0,12 ток/с
Пример. Llama 3.3 70B в Q4_K_M весит 42,52 ГБ. Видеокарта на 24 ГБ плюс 8 ГБ свободной ОЗУ под веса — на диске остаётся 10,5 ГБ. NVMe на 3 ГБ/с даст не больше 0,29 токена в секунду, на 5 ГБ/с — 0,48, SATA — 0,05. Это верхняя граница: на практике хуже. Ответ длиной 300 токенов даже при 0,29 токена в секунду займёт больше 17 минут.
Загрузка тоже ломается. У kimono-oyaji десктоп с 62 ГБ ОЗУ грузил gpt-oss 120B (65 ГБ в сборке Ollama) 88 с вместо ~18 по его же формуле, а Qwen3 235B (86 ГБ) — 107 с вместо ~23. На мини-ПК со 122 ГБ памяти те же модели грузились за 22 и 27 с.
MoE-модели переносят нехватку памяти лучше: на каждый токен читаются только активные эксперты. Пользователь Hugging Face 29 января 2025 года запускал DeepSeek-R1 (квант UD-Q2_K_XL) на 96 ГБ ОЗУ и 24 ГБ видеопамяти. Его NVMe Gen5 с паспортом 12 400 МБ/с читал во время генерации лишь 2–5 ГБ/с, скорость — около 1,3 токена в секунду на контексте 8K. Это один пост, мы его не воспроизводили. Как такую схему настраивают для конкретной модели, где диск работает на каждом токене, — в инструкции по DeepSeek V4.1 Flash на домашнем ПК.
Вывод: деньги сначала в видеопамять и ОЗУ. Быстрый диск смягчает падение, но не лечит его.
Какой SSD выбрать: Samsung 990 PRO, SN850X и бюджетные NVMe
Выбор SSD под LLM сводится к объёму и настоящей скорости PCIe 4.0. Флагманы Samsung 990 PRO и WD_BLACK SN850X читают 7 450 и 7 300 МБ/с — для загрузки моделей это с запасом. Бюджетный NVMe на 6 000 МБ/с почти не уступает им в секундах, но ресурс и стабильность у дешёвых линеек стоит сверять отдельно.Диск Интерфейс Чтение (паспорт) Ресурс 2 ТБ (TBW) 1 ТБ Samsung 990 PRO PCIe 4.0 7 450 МБ/с — 10 229 грн WD_BLACK SN850X PCIe 4.0 7 300 МБ/с 1 200 ТБ — Samsung 9100 PRO PCIe 5.0 14 700–14 800 МБ/с 1 200 ТБ 10 619 грн Kingston NV3 PCIe 4.0 6 000 МБ/с (по каталогу) — 7 085 грн PATRIOT P400 Lite «PCIe 4.0» 3 500 МБ/с (по каталогу) — 6 450 грн
Цены — минимальные предложения на Hotline на 7 ноября 2026 года; цены на 2 и 4 ТБ — в таблице раздела про Gen5 и Gen4. Ресурс указан там, где мы сверили его по документу производителя: у SN850X — даташит SanDisk, у 9100 PRO — брошюра Samsung. По брошюре 9100 PRO на 1 и 2 ТБ читает до 14 700 МБ/с, на 4 и 8 ТБ — до 14 800.
Цены в таблицах — минимум на карточке товара. В списке каталога Hotline цифры бывают ниже: там самый дешёвый 2 ТБ с PCIe 4.0 на 7 ноября — ADATA Legend 860 за 12 648 грн (6 000 МБ/с по каталогу), а Kingston NV3 2 ТБ — 12 724 грн против 13 999 на карточке.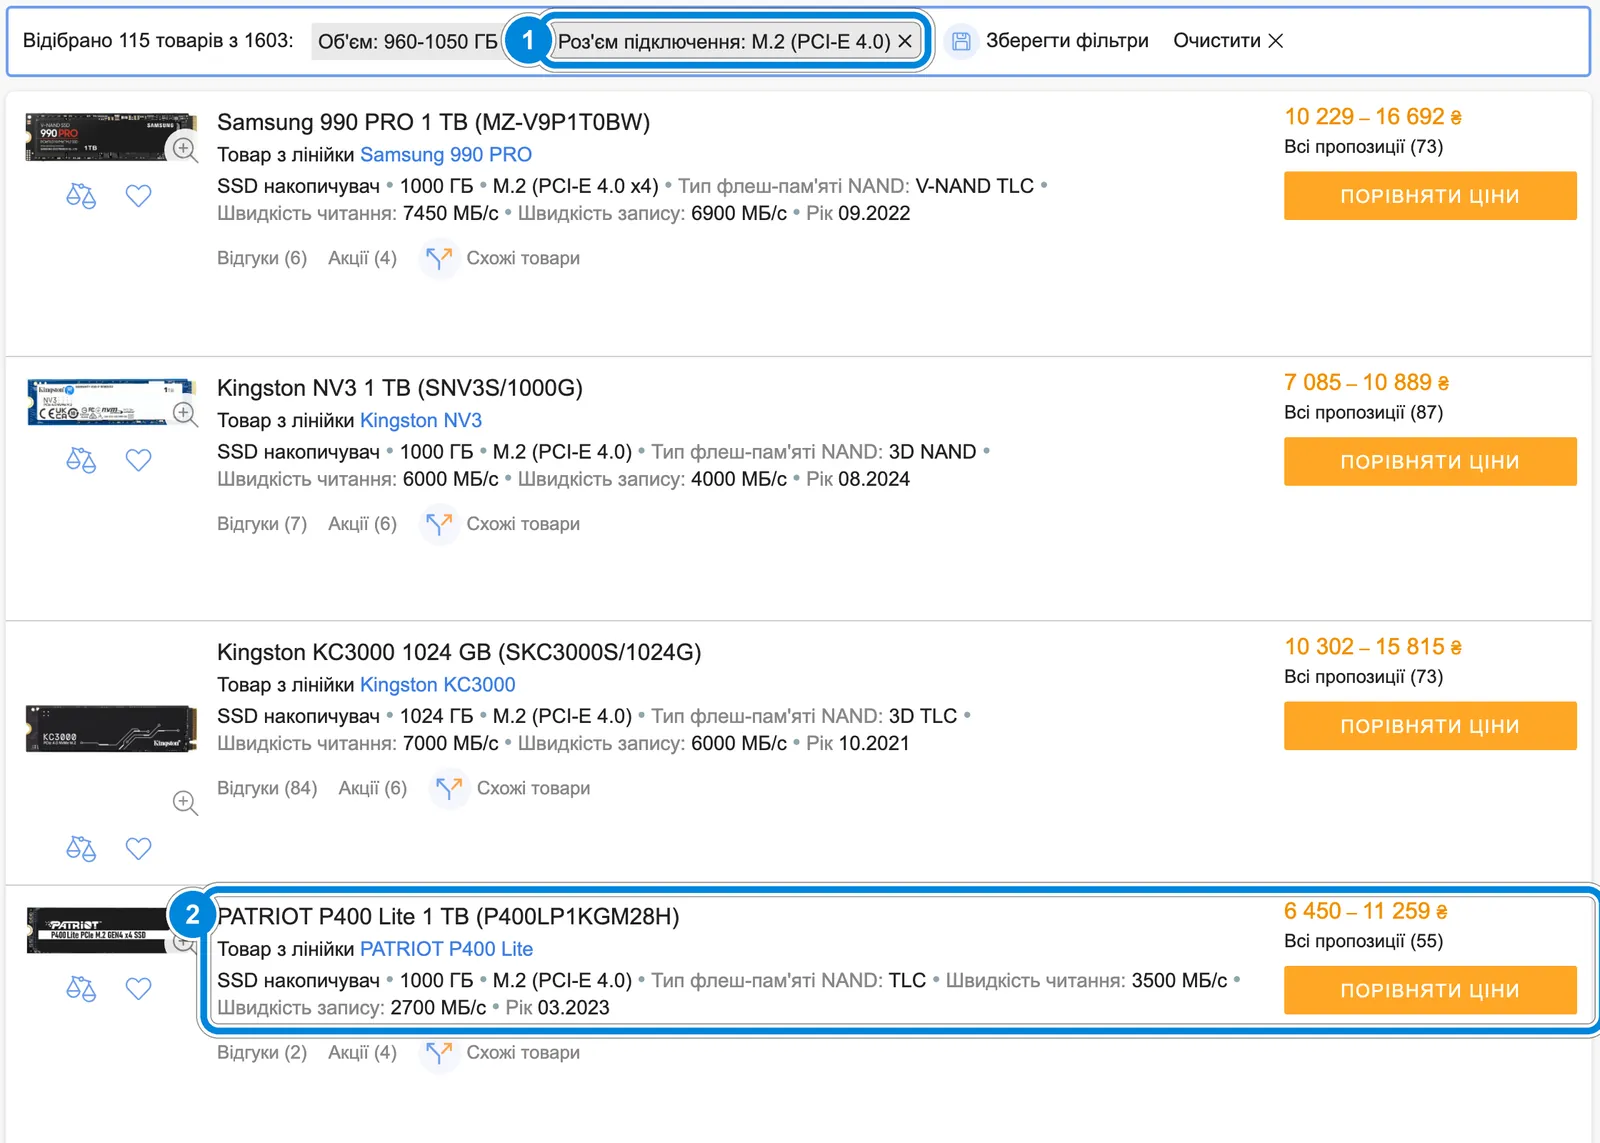
Ловушка «PCIe 4.0» на снимке каталога Hotline от 8 ноября 2026 года. Цифра 1 — фильтр «M.2 (PCI-E 4.0)» и объём 1 ТБ. Цифра 2 — PATRIOT P400 Lite от 6 450 грн с паспортным чтением 3 500 МБ/с. Это скорость диска прошлого поколения: интерфейс новый, контроллер и память — нет. Рядом Samsung 990 PRO от 10 229 грн с 7 450 МБ/с.
Как выбирать по шагам:
- Объём — по таблице сценариев из начала статьи.
- Паспорт чтения — от 6 000 МБ/с для Gen4. Ниже — переплата за надпись.
- Слот — сверить поколение слота M.2 в инструкции к плате. Gen5-диск в Gen4-слоте не даст своей скорости.
- Радиатор — если слот под видеокартой или диск Gen5.
- Цена за терабайт — у 990 PRO терабайт в версии на 4 ТБ дешевле, чем на 1 ТБ: 8 335 грн против 10 229. У 9100 PRO наоборот: 10 675 против 10 619 грн, поэтому цену за ТБ считайте по каждой модели отдельно.
Как разложить диски: система, быстрая библиотека и архив
Удобная схема — три яруса. Её советуют и обзоры SpecPicks и Popular AI: быстрый диск под то, что запускаете, медленный под то, что храните.
- Системный диск. Операционная система и программы. В расчёте выше на это заложено 150 ГБ.
- Быстрый NVMe под рабочие модели. Сюда переносят папку моделей. Ollama по умолчанию хранит их в
~/.ollama/modelsна macOS,/usr/share/ollama/.ollama/modelsна Linux иC:\Users\%username%\.ollama\modelsна Windows. Другую папку задают переменной окруженияOLLAMA_MODELS(официальный FAQ Ollama). - Архив на SATA SSD или жёстком диске. Модели, которые запускаете раз в месяц. Жёсткий диск на 180 МБ/с читает 70B Q4 не меньше 3,9 минуты, поэтому запускать с него модели неудобно — только хранить и копировать на быстрый диск перед работой.
Mac. Внутренний SSD у Mac выбирают при заказе. У Mac mini на M5 Pro объём настраивается до 8 ТБ, порты Thunderbolt 5 дают до 120 Гбит/с (страница Apple на 7 ноября 2026 года). Внешний NVMe-диск в корпусе Thunderbolt — рабочий запасной путь для библиотеки, но реальную скорость такого диска мы не мерили. Сколько моделей влезает в единую память разных Mac, мы считали в разборе единой памяти Mac для ИИ.
Износ SSD от локального ИИ: чтение модели ресурс не тратит
Ресурс SSD считают по записи, а не по чтению. Показатель TBW (terabytes written) — сколько терабайт можно записать на диск по гарантии. Запуск модели — это чтение файла, поэтому ресурс он не тратит. Расходуют его скачивание новых моделей, конвертация и дообучение.
По даташиту SanDisk, у WD_BLACK SN850X ресурс 600, 1 200, 2 400 и 4 800 ТБ для версий на 1, 2, 4 и 8 ТБ. У Samsung 9100 PRO на 2 ТБ по брошюре те же 1 200 ТБ. Мы посчитали, какую долю ресурса 2-терабайтного диска съест загрузка моделей:Записываете в месяц За год Доля ресурса 1 200 ТБ в год 100 ГБ новых моделей 1,2 ТБ 0,1% 300 ГБ новых моделей 3,6 ТБ 0,3% 1 ТБ новых моделей 12 ТБ 1% 5 ТБ (дообучение, конвертация) 60 ТБ 5% — до предела 20 лет
Даже активный энтузиаст, который каждый месяц скачивает по 300 ГБ, тратит 0,3% ресурса в год. Дообучение пишет больше: по оценке обзора Compute Market, один многодневный прогон — 1–5 ТБ записи. Но и тогда до паспортного предела далеко.
Ошибки и риски при выборе SSD под локальный ИИ
- Покупать Gen5 ради токенов в секунду. Он сокращает только холодную загрузку, а не время ответа.
- Брать 1 ТБ под рабочий набор с копиями. Рабочий набор с тремя копиями каждой модели требует 780 ГБ, а это почти весь 1 ТБ.
- Верить надписи «PCIe 4.0». Смотрите паспортную скорость чтения: 3 500 МБ/с — это уровень Gen3.
- Забивать диск под 90–100%. Совет держать заполнение ниже 80% — практическое правило обзорщиков. Но место под скачивание новой модели всё равно нужно: 70B Q8 — это 75 ГБ разом.
- Запускать модели с жёсткого диска. 70B Q4 с HDD грузится не меньше 3,9 минуты, а после выгрузки — снова.
- Ставить Gen5 в слот Gen4. Диск упрётся в 7,9 ГБ/с слота, переплата пропадает.
- Ждать, что быстрый SSD заменит нехватку памяти. При выгрузке весов на диск скорость падает до долей токена в секунду при любом NVMe.
- Считать цены постоянными. Цены SSD меняются быстрее всего в этой статье: всё выше — на 7 ноября 2026 года, свежие смотрите на Hotline. Размеры моделей стабильнее, но новые модели выходят каждую неделю — актуальный вес файла видно на странице модели на Hugging Face.
Частые вопросы про SSD для локального ИИ
Сколько места нужно для локальной нейросети на SSD?
Одна модель 8B в кванте Q4 занимает около 5 ГБ, 70B — 42,5 ГБ, 235B — 142 ГБ. Но обычно держат несколько моделей и квантов. По нашему расчёту 1 ТБ хватает для старта, 2 ТБ — разумный дефолт для рабочего набора до 70B с картиночными моделями, 4 ТБ нужны под 120B, 235B и копии в Q8.
Ускорит ли быстрый SSD ответы нейросети?
Нет, если модель целиком в видеопамяти и ОЗУ: в независимом замере время до первого слова было 0,184 с с NVMe и 0,178 с с SATA. Быстрый SSD сокращает холодную загрузку и смену модели. Если же память кончилась и веса дочитываются с диска, быстрый NVMe смягчает падение скорости, но вернуть нормальную скорость не может.
Нужен ли PCIe 5.0 SSD для локального ИИ?
Не обязателен. На Llama 3.3 70B в Q4_K_M Gen5 экономит не больше 2,8 с за холодный запуск по паспортным скоростям. Брать его имеет смысл, когда цена равна Gen4 — на 2 ТБ в ноябре 2026 года разница 299 грн — и на плате есть свободный слот PCIe 5.0 с радиатором.
Можно ли хранить модели на жёстком диске или внешнем SSD?
Хранить — да, запускать с жёсткого диска неудобно: при 180 МБ/с модель 70B Q4 грузится минимум 3,9 минуты. Жёсткий диск подходит под архив, откуда модель копируют на быстрый SSD. Внешний NVMe в корпусе USB4 или Thunderbolt работает как обычный быстрый диск для библиотеки, особенно у Mac, где внутренний объём выбирают при покупке.
Изнашивается ли SSD от запуска локальных моделей?
Почти нет. Ресурс SSD тратится на запись, а запуск модели — это чтение файла. Износ дают скачивание новых моделей и дообучение. По нашему расчёту 300 ГБ новых моделей в месяц — это 0,3% ресурса 2-терабайтного диска с паспортом 1 200 ТБ в год, а 5 ТБ записи в месяц — 5% в год.
Какой SSD нужен для Mac под локальные модели?
У Mac объём внутреннего SSD выбирают при заказе: у Mac mini на M5 Pro — до 8 ТБ. Под рабочий набор моделей разумно брать 2 ТБ, под 70B в нескольких квантах и 120B — 4 ТБ. Библиотеку можно вынести на внешний NVMe через Thunderbolt 5, но главным ограничением для моделей у Mac остаётся объём единой памяти, а не диск.