Коротко (TL;DR)
- Відеокарта не обов’язкова. LLM без GPU запускають рушій llama.cpp і програми на тій самій бібліотеці ggml (Ollama, LM Studio), якщо модель маленька: 1–4 млрд параметрів у кванті Q4_K_M.
- Три перевірки до завантаження: чи має процесор інструкції AVX2, чи працює пам’ять у два канали і скільки ОЗП вільно. Це важить більше, ніж кількість ядер.
- Швидкість визначає пам’ять, а не процесор. Стеля — пропускна здатність ОЗП, поділена на розмір файлу моделі. На старих ПК 3–4B-моделі в замірах видають 5–12 токенів за секунду, 7–9B — 3–4.
- Що брати: Qwen3.5 2B/4B, Llama 3.2 3B, Gemma 4 E2B, Phi-4 mini. На 8 ГБ ОЗП — до 4B, 9B і Nemotron-3.5-Bolt-E4B — уже на 16 ГБ.
- Новини листопада 2026: версія 1.0.0 у ggml і llama.cpp — стабільність програмного інтерфейсу, а не приріст швидкості. «4GB» у Nemotron-3.5-Bolt-E4B за замірами приблизно дорівнює робочій пам’яті, файл — 6,18 ГБ.
Чи можна запустити LLM без відеокарти і якої швидкості чекати
Так, LLM без відеокарти запускається на комп’ютері з процесором x86-64 і 8 ГБ ОЗП, але тільки маленька. За замірами на ПК і ноутбуках із Core i5 та i7 минулих років моделі на 3–4 млрд параметрів у форматі GGUF дають 5–12 токенів за секунду, на 1 млрд — 18–36. Для чату, переказу й чернеток цього вистачає, для довгих текстів і 9B-моделей — уже насилу.
- Коротко (TL;DR)
- Чи можна запустити LLM без відеокарти і якої швидкості чекати
- Три перевірки старого ПК: AVX2, канали пам’яті й вільна ОЗП
- Чому швидкість генерації на CPU впирається в пам’ять, а не в ядра
- Яка модель для слабкого ПК: Qwen3.5, Gemma 4, Llama 3.2, Phi-4 mini
- Скільки ОЗП потрібно: файл моделі, KV-кеш і запас під систему
- Що таке ggml, GGUF і v1.0.0 — і що вони змінюють для вашого ПК
- Nemotron-3.5-Bolt-E4B: чому «4GB» — це файл на 6,18 ГБ
- Запуск у LM Studio та Ollama на процесорі покроково
- Запуск через llama.cpp: готова збірка, потоки й контекст
- Якщо модель на CPU працює повільно: вісім кроків за спаданням ефекту
- Ризики LLM на старому ПК: своп, перегрів, помилки й чужі файли
- Коли процесора не вистачає: що змінювати і куди йти далі
- FAQ
Токен — шматочок тексту, часто коротший за слово. Microsoft у README проєкту bitnet.cpp називає 5–7 токенів за секунду швидкістю читання людини — для англійського тексту. Український текст розпадається на більше токенів, тож за такої швидкості відповідь ітиме приблизно зі швидкістю неквапливого читання або повільніше: зручно для короткого діалогу, довго для статті на три тисячі слів.
Нижче — опорні заміри з незалежних тестів 2026 року. Залізо й програми в авторів різні, тому це орієнтири, а не гарантія.Розмір моделі Швидкість генерації На чому виміряно 0,6–1B 18–36 ток/с It’s FOSS (ноутбук Intel i5, 12 ГБ, Ollama, 15.05.2026); InsiderLLM (i7-6700T, два канали DDR4) 3–4B 5–12 ток/с InsiderLLM (i7-6700T: 9,2–12,2); It’s FOSS (Phi-4 mini: 6,9); mustafa.net (Core i7-8559U, Qwen3.5 4B: 5,63) 7–9B 3–4 ток/с It’s FOSS (7B: 4,1–4,3; Ministral 3 8B: 3,16); mustafa.net (Qwen3.5 9B: 3,07)
Заміри It’s FOSS зроблено в Ollama на тегах за замовчуванням: файл моделі там міг бути важчим за Q4_K_M, отже, на легкому кванті швидкість буде не нижчою.
Приводи листопада 2026 року — реліз ggml і llama.cpp 1.0.0, допис на Hacker News про LLM на старих пристроях і модель Nemotron-3.5-Bolt-E4B — розберемо нижче, а почнемо з перевірки свого комп’ютера.
Три перевірки старого ПК: AVX2, канали пам’яті й вільна ОЗП
Запуск LLM на процесорі починається не із завантаження моделі, а з трьох перевірок на п’ять хвилин. Від них залежить, яка програма взагалі запуститься і якої швидкості чекати.
Перевірка 1. Чи має процесор AVX2
AVX2 — набір інструкцій процесора для паралельних обчислень над векторами. Без нього LM Studio під Windows не запуститься, а llama.cpp візьме повільніший варіант обчислень.
- Дізнайтеся модель процесора: у Windows — «Диспетчер завдань» → «Продуктивність» → «ЦП», у Linux — команда
lscpu. - Звіртеся з таблицею нижче або з карткою процесора в Intel ARK (поле «Розширення набору команд»). У Linux можна перевірити безпосередньо:
grep -o avx2 /proc/cpuinfo | head -1— якщо команда вивелаavx2, інструкції є.
| Процесор | AVX2 | LM Studio (Windows) | llama.cpp |
|---|---|---|---|
| Intel Core 4-го покоління (Haswell, з 2013) і новіші | є | працює | варіант haswell і вище |
| Intel Celeron і Pentium на архітектурі Tiger Lake і новіші | є | працює | варіант haswell і вище |
| Intel Celeron і Pentium старших поколінь, бюджетні серії N і J на ядрах Atom | немає | не запуститься | варіанти без AVX2 |
| Intel Core 2-го і 3-го поколінь (Sandy Bridge, Ivy Bridge) | немає, тільки AVX | не запуститься | варіанти sandybridge, ivybridge |
| AMD Excavator (з 2015), усі Ryzen | є | працює | варіант haswell і вище |
| AMD Piledriver (FX і APU 2012–2014) | немає, тільки AVX | не запуститься | варіант piledriver |
Покоління й роки — за Wikipedia (Advanced Vector Extensions), назви варіантів — за складом готової збірки llama.cpp b12521 від 18 листопада 2026 року. Рік випуску Celeron не гарантує AVX2: для Celeron N5105 2021 року (Jasper Lake) Intel ARK вказує тільки SSE4.2.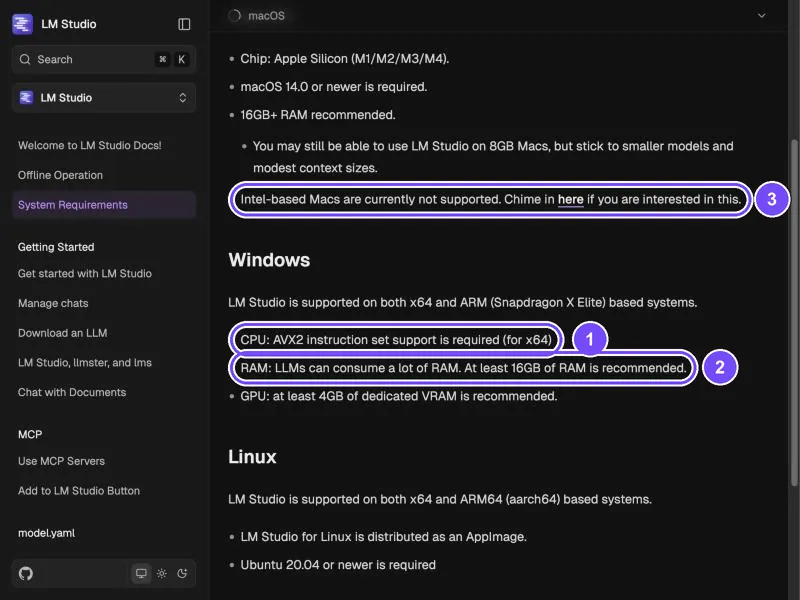
На кадрі — офіційна сторінка системних вимог LM Studio, знята 18 листопада 2026 року: AVX2 для Windows x64 (1), рекомендація від 16 ГБ ОЗП (2) і відмова від підтримки Mac на Intel (3). Рекомендація щодо пам’яті — порада, а не жорсткий поріг.
Перевірка 2. У скільки каналів працює пам’ять
Канал пам’яті — окрема «дорога» між процесором і ОЗП. Дві планки в правильних слотах зазвичай дають два канали й удвічі більшу пропускну здатність, одна планка — один канал.
- Windows: «Диспетчер завдань» → «Продуктивність» → «Пам’ять» показує кількість зайнятих гнізд і швидкість (наприклад, 2400 МГц). «Використано гнізд: 1 з 2» — майже напевно один канал. Але гнізда — не канали: «2 з 4» на платі з чотирма слотами теж може виявитися одним каналом, якщо планки стоять не в тих роз’ємах. Точно покаже безкоштовна CPU-Z, вкладка Memory, рядок «Channel #».
- Linux:
sudo dmidecode -t memoryпокаже кожну планку, її слот і частоту.
Для LLM це головне приховане гальмо. У замірі InsiderLLM (ThinkCentre M710q, i7-6700T, DDR4 на 2133 МГц, 11.08.2026) друга планка прискорила Llama 3.2 3B із 7,36 до 11,59 токена за секунду, а Gemma 3 4B — із 5,89 до 9,15. Це +52–58% без заміни процесора.
Перевірка 3. Скільки ОЗП вільно до запуску
Відкрийте браузер і звичні програми та подивіться в «Диспетчері завдань», скільки пам’яті зайнято. Модель із робочим буфером має вміститися в залишок, інакше система почне скидати дані на диск, і швидкість обвалиться.
Чому швидкість генерації на CPU впирається в пам’ять, а не в ядра
Щоб видати кожен наступний токен, модель заново читає з ОЗП усі свої ваги. Тому швидкість генерації обмежена тим, скільки гігабайтів за секунду пам’ять встигає віддати: стеля ≈ пропускна здатність ÷ розмір файлу моделі. Ядра процесора тим часом здебільшого чекають на дані.
Пропускна здатність одного каналу — частота в мегатрансферах × 8 байтів: DDR3-1600 дає 12,8 ГБ/с, DDR4-2400 — 19,2 ГБ/с, DDR4-3200 — 25,6 ГБ/с. Два канали — удвічі більше. Це теоретичний пік модуля за таблицями Wikipedia, реальна швидкість завжди нижча.
Наш розрахунок стелі для моделей Qwen3.5 у Q4_K_M (розміри файлів — із Hugging Face на 18 листопада 2026 року: 2B — 1,28 ГБ, 4B — 2,74 ГБ, 9B — 5,68 ГБ):Пам’ять ГБ/с Qwen3.5 2B Qwen3.5 4B Qwen3.5 9B DDR3-1600, один канал 12,8 10,0 4,7 2,3 DDR3-1600, два канали 25,6 20,0 9,3 4,5 DDR4-2133, один канал 17,1 13,3 6,2 3,0 DDR4-2400, два канали 38,4 30,0 14,0 6,8 DDR4-3200, два канали 51,2 40,0 18,7 9,0
Цифри в колонках моделей — максимум токенів за секунду, а не прогноз. Наскільки реальність нижча за стелю, ми звірили на замірі InsiderLLM. В i7-6700T із DDR4-2133 у двох каналах (34,1 ГБ/с) стеля для Llama 3.2 3B (2,02 ГБ) — 16,9 ток/с, а виміряно 11,59, тобто 69%. В одному каналі стеля 8,4, виміряно 7,36 — 87%. У нашому звірювальному замірі реальна швидкість — 69–87% від стелі, на інших машинах буває й нижча.
Із формули випливають три практичні висновки:
- Більше ядер майже не допомагає. InsiderLLM на одному процесорі отримав 5,37 ток/с із 6 потоками і 5,33 — із 12.
- Менший файл — прямо пропорційно швидше. Перехід із Q8 на Q4_K_M або з 9B на 4B прискорює генерацію приблизно в стільки разів, у скільки зменшився файл.
- Читання запиту залежить уже від ядер. Вставлений документ модель обробляє паралельно, і другий канал тут майже не допомагає: у тому самому замірі обробка промпту змінилася менш ніж на 2%. На Core i7-8559U Nemotron-3.5-Bolt-E4B читав промпт зі швидкістю 30 токенів за секунду (mustafa.net): документ на 3000 токенів — близько 100 секунд до початку відповіді.
Яка модель для слабкого ПК: Qwen3.5, Gemma 4, Llama 3.2, Phi-4 mini
Для слабкого комп’ютера підходять моделі на 1–4 млрд параметрів у кванті Q4_K_M. Квант — спосіб стиснути ваги моделі: Q4_K_M зберігає їх приблизно в 4,5–5 бітах замість 16 і майже не втрачає якості на чатових завданнях. З якого кванта якість обривається — у нашому розборі квантування Q4 проти Q8.
Розміри файлів — із Hugging Face на 18–19 листопада 2026 року, швидкості — з атрибутованих замірів на CPU, мови — із заяв розробників у картках моделей (якість українською ми не вимірювали).Модель Файл Q4_K_M Комфортно на ПК з Замір на CPU Мови за карткою Ліцензія Qwen3.5 0.8B 0,53 ГБ 4 ГБ н/д 201 мова й діалект Apache 2.0 Llama 3.2 1B 0,81 ГБ 4 ГБ трохи менше ніж 10 ток/с (Ryzen 5 2500U, батарея) 8 офіційно, української немає Llama 3.2 Qwen3.5 2B 1,28 ГБ 8 ГБ н/д 201 мова й діалект Apache 2.0 Llama 3.2 3B 2,02 ГБ 8 ГБ 7,36 / 11,59 ток/с (i7-6700T, 1 / 2 канали) 8 офіційно, української немає Llama 3.2 Phi-4 mini 2,49 ГБ 8 ГБ 6,9 ток/с (ноутбук i5) українська є в списку мов MIT Qwen3.5 4B 2,74 ГБ 8 ГБ 5,63 ток/с (Core i7-8559U) 201 мова й діалект Apache 2.0 Gemma 4 E2B 3,11 ГБ 8 ГБ 9,9 ток/с (ноутбук i5) 35+ з коробки, навчена на 140+ Apache 2.0 Gemma 4 E4B 4,98 ГБ 16 ГБ н/д 35+ з коробки, навчена на 140+ Apache 2.0 Qwen3.5 9B 5,68 ГБ 16 ГБ 3,07 ток/с (Core i7-8559U) 201 мова й діалект Apache 2.0 Nemotron-3.5-Bolt-E4B 6,18 ГБ 16 ГБ 5,03–10,9 ток/с (див. розділ нижче) en, es, fr, de, it, ja «та інші» OpenMDW-1.1
Колонка «Комфортно на ПК з» — наша оцінка: файл моделі плюс робочий буфер плюс 3–4 ГБ під Windows із браузером. Джерела замірів: It’s FOSS (ноутбук Intel i5, 12 ГБ), InsiderLLM, mustafa.net, Windows Central. Заміри It’s FOSS і Windows Central зроблено в Ollama на тегах за замовчуванням — файл там міг бути важчим за вказаний Q4_K_M (для Gemma 4 E2B It’s FOSS називає близько 7 ГБ на диску, llama3.2:1b в Ollama важить 1,3 ГБ).
Кому що брати:
- Ноутбук із 4 ГБ або дуже старий ПК — Qwen3.5 0.8B або Llama 3.2 1B. Відповіді прості, зате швидкі.
- Звичайний офісний ПК із 8 ГБ — Qwen3.5 2B або 4B для українського тексту, Gemma 4 E2B і Phi-4 mini як альтернативи. Llama 3.2 3B швидка, але українська офіційно не заявлена.
- 16 ГБ і два канали DDR4 — можна пробувати Qwen3.5 9B і Gemma 4 E4B, але готуйтеся до 3–6 токенів за секунду.
Літера E в Gemma 4 означає «effective»: файл більший, ніж підказує цифра, через таблиці Per-Layer Embeddings (про них — у розділі про Nemotron). Моделі під відеокарту й окремі завдання на кшталт програмування порівнюються в нашому гіді з 11 локальних моделей під завдання й залізо.
Скільки ОЗП потрібно: файл моделі, KV-кеш і запас під систему
ОЗП для LLM на CPU складається з трьох частин: файл моделі цілком, KV-кеш (пам’ять, де модель тримає вже прочитану розмову) і запас під систему з відкритими програмами. Для 3–4B-моделі в Q4_K_M із контекстом 4096 токенів на все це зазвичай вистачає 8 ГБ.
Як обчислюється KV-кеш, покажемо на Llama 3.2 3B. За її config.json на Hugging Face: 28 шарів, 8 голів уваги для ключів і значень, розмірність голови 128. У форматі f16 (за замовчуванням у llama.cpp) це 2 × 28 × 8 × 128 × 2 байти = 114 688 байтів на токен. Наш розрахунок:
- 4096 токенів контексту — близько 448 МіБ поверх файлу 2,02 ГБ, разом приблизно 2,5 ГБ на модель;
- 32 768 токенів — уже близько 3,5 ГіБ тільки на кеш, більше за саму модель;
- гібридні моделі на кшталт Qwen3.5 4B тримають повну увагу лише у 8 шарах із 32, тому їхній кеш помітно менший — за тією самою формулою безпосередньо його не порахувати.
Звідси головне правило для слабкого ПК: задайте контекст явно, 4096 токенів. Ollama і так бере 4096 за замовчуванням. А от llama.cpp за -c 0 бере довжину контексту з моделі, у Qwen3.5 це 262 144 токени. Увімкнене за замовчуванням автопідлаштування --fit підганяє незадані параметри під вільну пам’ять (контекст — не нижче 4096), але на машині без відеокарти ми його не перевіряли.
Формулу під моделі 8B–70B, відеокарту й довгий контекст докладно розібрано в нашому розрахунку ОЗП для локального ШІ під 8B–70B — тут не повторюємо, там же таблиця за розмірами.
Що таке ggml, GGUF і v1.0.0 — і що вони змінюють для вашого ПК
Ці три слова плутають найчастіше, хоча ролі в них різні:
- ggml — бібліотека тензорних обчислень на C/C++ без зовнішніх залежностей. Працює на x86, ARM і RISC-V, уміє квантування від 2 до 8 бітів і завдання для CPU, відеокарт і нейропроцесорів. Її почав писати Георгій Герганов наприкінці вересня 2022 року.
- llama.cpp — рушій, який запускає LLM поверх ggml. Від початку його метою була саме робота на комп’ютерах без відеокарти. LM Studio обчислює через llama.cpp, а Ollama з травня 2025 року частину моделей запускає на власному рушії, який працює безпосередньо з ggml.
- GGUF — формат файлу моделі для ggml: в одному файлі лежать ваги й усі налаштування. GGUF замінив старі формати GGML, GGMF і GGJT. Якщо на Hugging Face ви бачите файл
.gguf— це те, що потрібно для CPU.
13 листопада 2026 року ggml і llama.cpp одночасно отримали номер 1.0.0. За оголошенням команди в блозі Hugging Face, відтепер будь-яка несумісність програмного інтерфейсу відображатиметься зміною старшої цифри версії. У нотатках до релізу — чистка застарілих функцій і оптимізації під CUDA, Metal, Vulkan та інші прискорювачі, а прискорення саме для x86-процесорів там немає.
Для власника старого ПК 1.0.0 не змінює нічого: старі GGUF-файли працюють як раніше, швидкість на процесорі стрибком не зросла. Оновлюватися все одно варто — регулярні збірки приносять дрібні поліпшення.
Допис на Hacker News «I’m making LLMs work on small and old devices» — про проєкт smolmaxxing, патч поверх llama.cpp для ARM-пристроїв на кшталт ТВ-приставки з ~1 ГБ пам’яті. Частину його файлів відкриває тільки пропатчений рушій, тож для x86-ПК це набір ідей (маленькі моделі, 1-бітні ваги), а не готовий інструмент.
Nemotron-3.5-Bolt-E4B: чому «4GB» — це файл на 6,18 ГБ
NVIDIA випустила Nemotron-3.5-Bolt-E4B-4GB 23 жовтня 2026 року як маленьку модель для локальних асистентів. За карткою на Hugging Face: 8 млрд параметрів загалом і 4 млрд «ефективних», архітектура Gemma-4-E4B, контекст до 64 тисяч токенів, тільки текст, ліцензія OpenMDW-1.1.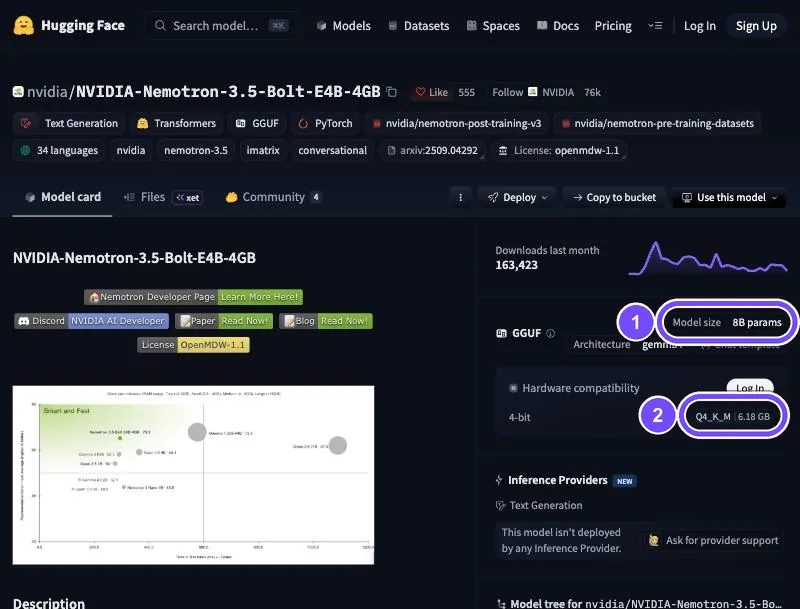
На кадрі — картка моделі на Hugging Face, знята 18 листопада 2026 року без входу в акаунт: розмір моделі (1) і єдиний файл GGUF у кванті Q4_K_M (2).
Ми звірили розмір файлу через API Hugging Face — 6 180 446 208 байтів, ту саму цифру до байта наводить mustafa.net. Звідки тоді «4GB»? Картка цього не пояснює, але розбір файлу автором Hackernoon показує:Що всередині GGUF Обсяг Таблиці Per-Layer Embeddings (здебільшого Q8_0) 3,05 ГБ Блоки трансформера (Q4_K і Q6_K) 2,40 ГБ Ембединги токенів 0,71 ГБ
Per-Layer Embeddings — таблиці, з яких на кожному токені модель читає лише кілька рядків. Google у документації Gemma 4 пояснює так само: таблиці великі, але потрібні тільки для швидких вибірок. Тому на CPU-сервері з контекстом 8K процес у Hackernoon зрештою займав близько 3,8 ГБ виділеної пам’яті та 4,1 ГБ RSS. Одразу після завантаження система показувала близько 9,6 ГБ — це сторінки файлу, щойно прочитані з диска, з часом цифра падає.
Наше спостереження із замірів mustafa.net: на Core i7-8559U Bolt видав 5,03 ток/с, а Qwen3.5 4B — 5,63. Файл у Bolt у 2,26 раза більший, а швидкість — 89% від 4B-моделі. Це і є ефект таблиць: на кожному токені доводиться читати не весь файл.Тест Залізо Програма Генерація Hackernoon, 28.10.2026 8 vCPU Intel Xeon (AVX-512), 16 ГБ llama.cpp b11913, llama-bench, 8 потоків 10,9 ± 2,8 ток/с mustafa.net, 12.11.2026 Intel NUC8, Core i7-8559U llama.cpp b11561, контекст 8K 5,03 ток/с
Що врахувати перед запуском Bolt на своєму ПК:
- Рецепт у картці — під відеокарту NVIDIA: Docker-образ із CUDA, прапорці
--gpus allі-ngl 999, у підтримуваному залізі — Ampere, Hopper і Blackwell. Те, що модель працює на CPU, показали незалежні тести, а не NVIDIA. - Потрібно 6,2 ГБ на диску і 16 ГБ ОЗП для спокійної роботи. На 8 ГБ із відкритим браузером ризикуєте впертися у своп.
- Режим міркувань на CPU дорогий. З вимкненим thinking відповідь у тесті Hackernoon займала 2,1–3,6 секунди, з увімкненим — 13,1 секунди. Але без міркувань модель у всіх трьох прогонах помилилася з відносною датою: замість найближчої п’ятниці поставила наступну. Для дат і розрахунків режим краще вмикати.
- Не плутайте з Bolt 74B-A9B-24GB. У NVIDIA в тій самій лінійці є модель на 74 млрд параметрів, розрахована на 24 ГБ пам’яті, — про неї наша новина про Nemotron 3.5 Super VL і Bolt на 24 ГБ. Це інший продукт і не для старого ПК.
Запуск у LM Studio та Ollama на процесорі покроково
Ollama і LM Studio — найпростіший спосіб запустити LLM на ПК без командного рядка або майже без нього. Обидві стоять на бібліотеці ggml: LM Studio — через llama.cpp, Ollama — частково через власний рушій на ggml. Різниця — у зручності та вимогах до заліза.Що важливо на старому ПК LM Studio Ollama llama.cpp Процесор без AVX2 Windows x64: не запуститься офіційно не підтверджено, перевіряйте є варіанти без AVX2 Інтерфейс вікно з чатом командний рядок і API командний рядок і вебсервер Вибір кванта будь-який GGUF із Hugging Face тег бібліотеки або hf.co/…:квантбудь-який GGUF Вимоги від 16 ГБ ОЗП рекомендовано Windows 10 22H2+, 4 ГБ на диску архів 25,6 МБ
Чим три програми відрізняються за швидкістю на одній моделі, ми розбирали окремо — у порівнянні Ollama, LM Studio і llama.cpp на одній моделі (заміри там на відеокартах і Mac).
LM Studio: п’ять кроків
- Перевірте AVX2 (розділ «Три перевірки старого ПК» вище). Без нього версія для Windows x64 не запуститься; у Linux програма постачається як AppImage для Ubuntu 20.04 і новіших.
- Завантажте інсталятор з офіційного сайту lmstudio.ai і встановіть.
- У вкладці пошуку моделей знайдіть, наприклад, Qwen3.5 4B і виберіть файл із позначкою Q4_K_M.
- Завантажте модель у чат. Відеокарти немає, тому вся модель опиниться в ОЗП — це нормально.
- Якщо модель уміє міркувати, для простих запитань вимкніть thinking у налаштуваннях чату.
Ollama: чотири кроки
- Встановіть Ollama: для Windows потрібна Windows 10 22H2 або новіша, права адміністратора не потрібні, під програму — від 4 ГБ на диску плюс місце під моделі.
- Запустіть модель. Майте на увазі, що теги бібліотеки за замовчуванням бувають важкими: на 18 листопада 2026 року
qwen3.5:2bважить 2,7 ГБ — сама модель у Q8_0 (2,0 ГБ) плюс проєктор для зображень (671 МБ). Легкий квант можна взяти безпосередньо з Hugging Face: за документацією HF команда має виглядollama run hf.co/{автор}/{репозиторій}:{квант}, а без кванта береться Q4_K_M, якщо він є в репозиторії. Для Qwen3.5 2B це виглядало б так (ми цю команду не запускали):
ollama run hf.co/unsloth/Qwen3.5-2B-GGUF:Q4_K_M
- Перевірте, де працює модель:
ollama ps
У колонці Processor має стояти 100% CPU — за документацією Ollama це означає, що модель цілком завантажена в оперативну пам’ять.
- Контекст за замовчуванням — 4096 токенів, його змінює змінна
OLLAMA_CONTEXT_LENGTH. На слабкому ПК збільшувати не варто.
Чому легкий квант важливий: на кожному токені читаються ваги моделі, а не проєктор, тому порівнювати треба 2,0 ГБ у Q8_0 з 1,28 ГБ у Q4_K_M — за формулою з розділу про пам’ять це прискорення приблизно в 1,5 раза. У gemma4:e2b (4,6 ГБ) близько гігабайта — теж проєктор.
Роботу Ollama на процесорі без AVX2 однозначно підтвердити не вдалося: стара документація описує варіанти бібліотек з AVX2, з AVX і без них, а код поточної версії — набір варіантів ggml. Перевірте на своїй машині; не пішло — переходьте до llama.cpp.
Запуск через llama.cpp: готова збірка, потоки й контекст
llama.cpp — найлегший і найгнучкіший варіант, особливо для старих процесорів без AVX2. Збирати з вихідного коду не потрібно: на GitHub у розділі Releases лежать готові архіви.
- Завантажте збірку під процесор. У релізі b12521 від 18 листопада 2026 року для Windows це
llama-b12521-bin-win-cpu-x64.zip(25,6 МБ), для Linux —llama-b12521-bin-ubuntu-x64.tar.gz(23,9 МБ), для Mac на Intel —llama-b12521-bin-macos-x64.tar.gz(13,1 МБ). В архіві для Windows лежатьllama-cli.exe,llama-server.exe,llama-bench.exeі бібліотеки під різні покоління процесорів, від базового x64 і SSE4.2 до haswell і новіших. За вихідним кодом програма сама бере найкращий сумісний варіант; на CPU без AVX2 ми це не перевіряли. - Завантажте модель. Візьміть файл
.ggufіз позначкою Q4_K_M зі сторінки моделі на Hugging Face. - Запустіть чат, указавши потоки й контекст:
llama-cli -m Qwen3.5-4B-Q4_K_M.gguf -t 4 -c 4096
Є коротший шлях: README llama.cpp 1.0.0 пропонує інсталяційний скрипт (curl -LsSf https://llama.app/install.sh | sh для Linux і macOS, irm https://llama.app/install.ps1 | iex для Windows PowerShell) і команду, яка сама завантажить модель із Hugging Face. Самі скрипти ми не запускали.
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF:Q4_0
Без кванта після двокрапки -hf бере Q4_K_M, якщо він є в репозиторії, а інакше — перший файл. У репозиторії ggml-org/Qwen3.5-0.8B-GGUF на 19 листопада 2026 року лежать тільки BF16 (1,56 ГБ), Q4_0 (0,56 ГБ) і Q8_0 (0,83 ГБ), тому квант краще вказувати явно. Якщо в репозиторії є проєктор для зображень (mmproj), -hf довантажить і його — для текстового чату це вимикає прапорець --no-mmproj.
Три прапорці, які вирішують на слабкому ПК:
-t— кількість потоків. Ставте за кількістю фізичних ядер, а не логічних — так радить документація llama.cpp. Автор блогу point.free на Xeon E5-2620 v4 (8 ядер, 16 потоків) ставив-t 8. Якщо генерація підозріло повільна, почніть із-t 1і подвоюйте.-c— контекст.-c 4096— розумний старт.-lm mlock— закріпити модель в ОЗП, щоб система не скидала її на диск. У нових версіях це режим--load-mode; старий прапорець--mlockзі статей минулих років може не спрацювати.
Свою швидкість вимірюйте вбудованим тестом, а не «на око»:
llama-bench -m Qwen3.5-4B-Q4_K_M.gguf -t 4
У виводі дві цифри: pp — обробка промпту, tg — генерація відповіді. Порівняйте tg зі стелею з таблиці про пам’ять: якщо отримали менше половини розрахункової, шукайте причину в наступному розділі.
Якщо модель на CPU працює повільно: вісім кроків за спаданням ефекту
Перевіряйте по черзі — перші кроки безкоштовні й дають найбільше.
- Підключіть ноутбук до мережі. У тесті Windows Central (ноутбук на Ryzen 5 2500U, 8 ГБ, Ollama) моделі на 1 млрд параметрів видавали трохи менше ніж 10 ток/с від батареї зі збалансованим планом живлення, а від мережі швидкість приблизно подвоїлася.
- Перевірте другий канал пам’яті (перевірка 2 вище). Одна планка в платі на два слоти — головне приховане гальмо.
- Візьміть легший квант. Q4_K_M замість Q8_0 — особливо в Ollama, де теги за замовчуванням бувають важчими.
- Візьміть меншу модель. 4B замість 9B прискорює генерацію приблизно вдвічі: файл 2,74 ГБ проти 5,68 ГБ.
- Поставте потоки за фізичними ядрами. Більше потоків генерацію не прискорює.
- Обмежте контекст 4096 токенами. Менший кеш, менший ризик свопу.
- Вимкніть режим міркувань для простих запитань. У Nemotron-Bolt це кілька секунд проти 13. Для дат і розрахунків — вмикайте: у тому тесті він виправив помилку з датою.
- Не допускайте свопу. Якщо модель вміщається в ОЗП, але система вивантажує її, коли ви відкриваєте інші програми, допомагає
-lm mlockу llama.cpp. Якщо не вміщається зовсім — тільки менша модель або легший квант: за спостереженням InsiderLLM, зі свопом швидкість падає нижче 2 токенів за секунду.
Ризики LLM на старому ПК: своп, перегрів, помилки й чужі файли
Сам запуск не надсилає ваші запити в інтернет, але ризики є:
- Своп замість ОЗП. Модель, яка не вміщається в пам’ять, система частково вивантажує на диск. Комп’ютер не зламається, але генерація сповільниться в рази. Тримайте запас пам’яті й не запускайте 9B на 8 ГБ.
- Нагрів і шум. Генерація тримає процесор під навантаженням хвилинами. У старих ноутбуків із забитою пилом системою охолодження це привід перевірити температури, перш ніж залишати модель працювати на годину.
- Помилки маленьких моделей. 4B-модель упевнено помиляється в датах, розрахунках і фактах — як Nemotron-Bolt із «п’ятницею» вище. Перевіряйте все, від чого залежать гроші, здоров’я або робота.
- Файли з неперевірених джерел. Беріть GGUF у розробника моделі або у відомих збирачів на Hugging Face, де файли проходять автоматичну перевірку (позначка Safe у списку файлів). Інсталяційні скрипти на кшталт
curl … | shвиконують чужий код із вашими правами — запускайте їх тільки з офіційної адреси проєкту. - Гучні обіцянки без застережень. У листопаді 2026 року соцмережами розійшлася цитата з README bitnet.cpp від Microsoft: модель на 100 млрд параметрів на одному процесорі й прискорення до 6,17 раза. Умова при цьому губиться: ідеться тільки про моделі, навчені в 1,58 біта, а прискорення 2,37–6,17 раза рахують відносно повноточних моделей, не відносно Q4_K_M. Доступна модель такого типу — BitNet b1.58 2B4T: за InsiderLLM, 30–45 ток/с на ноутбучних процесорах за 0,4 ГБ пам’яті. Звичайну Qwen чи Llama так не прискорити.
Коли процесора не вистачає: що змінювати і куди йти далі
LLM на CPU впирається у стелю, коли завдання потребують моделі від 9B і довгого контексту. Ознаки: відповідь іде повільніше за 3 токени за секунду, документ на кілька сторінок модель читає хвилинами, а якість 4B-моделі не влаштовує.
Варіанти за зростанням витрат:
- Змінити модель, а не залізо. Спробуйте іншу модель того самого розміру: якість українською в малих моделей різна, а картки говорять лише про заявлену підтримку мов.
- Докупити другу планку пам’яті тієї самої частоти, якщо зараз працює один канал. Це найдешевше прискорення для CPU.
- Відеокарта. Якщо без неї вже ніяк, рахуйте не модель відеокарти, а обсяг відеопам’яті — формула й таблиця за моделями в нашому матеріалі про те, скільки відеопам’яті потрібно під LLM. Порядок апгрейду з усіма підводними каменями, зокрема блоком живлення, розібрано в гіді про апгрейд старого ПК під локальний ШІ.
- Хмарна модель для важких завдань. Локальна 4B не замінить великі хмарні моделі в складних міркуваннях і програмуванні. Розумна схема — прості й приватні завдання локально, важкі — у хмарі.
FAQ
Яка модель підійде для слабкого комп’ютера з 8 ГБ ОЗП?
На 8 ГБ ОЗП комфортно працюють моделі до 4 млрд параметрів у кванті Q4_K_M: Qwen3.5 2B (1,28 ГБ) і 4B (2,74 ГБ), Llama 3.2 3B (2,02 ГБ), Phi-4 mini (2,49 ГБ), Gemma 4 E2B (3,11 ГБ). Для українського тексту розумно почати з Qwen3.5: за карткою вона підтримує 201 мову й діалект, а в Llama 3.2 українська офіційно не заявлена.
Чи запуститься LLM на старому Mac із процесором Intel?
Так, але не через LM Studio: за офіційними вимогами на 18 листопада 2026 року Mac на Intel програма не підтримує. Залишається llama.cpp — у релізі b12521 є готова збірка macos-x64 на 13,1 МБ. Далі все як на звичайному ПК: модель 1–4B у кванті Q4_K_M, контекст 4096 токенів і потоки за кількістю фізичних ядер.
Чи запуститься LM Studio на процесорі без AVX2?
Версія LM Studio для Windows x64 потребує підтримки AVX2 — так написано в офіційних системних вимогах на 18 листопада 2026 року. В Intel AVX2 є з четвертого покоління Core (Haswell, 2013), у Celeron і Pentium — тільки на архітектурі Tiger Lake і новіших, в AMD — з Excavator (2015). На процесорі без AVX2 використовуйте llama.cpp: за складом готової збірки в ній є варіанти для старіших наборів інструкцій.
Чи працює Ollama без відеокарти і як зрозуміти, що вона на CPU?
Так, Ollama працює без відеокарти й сама завантажує модель в оперативну пам’ять. Щоб переконатися, виконайте ollama ps: у колонці Processor має стояти «100% CPU». Майте на увазі, що теги бібліотеки за замовчуванням бувають важчими за Q4_K_M — qwen3.5:2b важить 2,7 ГБ проти 1,28 ГБ у того самого Qwen3.5 2B у Q4_K_M.
Чим ggml відрізняється від GGUF і llama.cpp?
ggml — бібліотека обчислень на C/C++, фундамент усієї системи. llama.cpp — рушій, який на ggml запускає мовні моделі, через нього працює LM Studio; Ollama частково використовує власний рушій на тій самій ggml. GGUF — формат файлу моделі, у якому лежать ваги й налаштування. Версія 1.0.0 від 13 листопада 2026 року означає стабільний програмний інтерфейс, а не нову швидкість.
Чи можна запустити LLM на ноутбуці з 4 ГБ ОЗП?
Можна, але тільки найменшу модель: Qwen3.5 0.8B (0,53 ГБ) або Llama 3.2 1B (0,81 ГБ) у кванті Q4_K_M. Система сама займе помітну частину пам’яті, тож закрийте браузер і використовуйте легкий llama.cpp — LM Studio рекомендує від 16 ГБ. Ноутбук тримайте підключеним до мережі: від батареї генерація буває вдвічі повільнішою.