Коротко (TL;DR)
- Видеокарта не обязательна. LLM на процессоре запускают движок llama.cpp и программы на той же библиотеке ggml (Ollama, LM Studio), если модель маленькая: 1–4 млрд параметров в кванте Q4_K_M.
- Три проверки до скачивания: есть ли в процессоре инструкции AVX2, работает ли память в два канала и сколько ОЗУ свободно. Это решает больше, чем число ядер.
- Скорость определяет память, а не процессор. Потолок — пропускная способность ОЗУ, делённая на размер файла модели. На старых ПК 3–4B-модели в замерах выдают 5–12 токенов в секунду, 7–9B — 3–4.
- Что брать: Qwen3.5 2B/4B, Llama 3.2 3B, Gemma 4 E2B, Phi-4 mini. На 8 ГБ ОЗУ — до 4B, 9B и Nemotron-3.5-Bolt-E4B — уже на 16 ГБ.
- Новости ноября 2026: версия 1.0.0 у ggml и llama.cpp — стабильность программного интерфейса, а не прирост скорости. «4GB» у Nemotron-3.5-Bolt-E4B по замерам примерно равно рабочей памяти, файл — 6,18 ГБ.
Можно ли запустить LLM без видеокарты и какой скорости ждать
Да, LLM без видеокарты запускается на компьютере с процессором x86-64 и 8 ГБ ОЗУ, но только маленькая. По замерам на ПК и ноутбуках с Core i5 и i7 прошлых лет модели на 3–4 млрд параметров в формате GGUF дают 5–12 токенов в секунду, на 1 млрд — 18–36. Для чата, пересказа и черновиков этого хватает, для длинных текстов и 9B-моделей — уже с трудом.
- Коротко (TL;DR)
- Можно ли запустить LLM без видеокарты и какой скорости ждать
- Три проверки старого ПК: AVX2, каналы памяти и свободная ОЗУ
- Почему скорость генерации на CPU упирается в память, а не в ядра
- Какая модель для слабого ПК: Qwen3.5, Gemma 4, Llama 3.2, Phi-4 mini
- Сколько ОЗУ нужно: файл модели, KV-кэш и запас под систему
- Что такое ggml, GGUF и v1.0.0 — и что они меняют для вашего ПК
- Nemotron-3.5-Bolt-E4B: почему «4GB» — это файл на 6,18 ГБ
- Запуск в LM Studio и Ollama на процессоре пошагово
- Запуск через llama.cpp: готовая сборка, потоки и контекст
- Если модель на CPU работает медленно: восемь шагов по убыванию эффекта
- Риски LLM на старом ПК: своп, перегрев, ошибки и чужие файлы
- Когда процессора не хватает: что менять и куда идти дальше
- FAQ
Токен — кусочек текста, часто короче слова. Microsoft в README проекта bitnet.cpp называет 5–7 токенов в секунду скоростью чтения человека — для английского текста. В русском слова длиннее в токенах, поэтому при такой скорости ответ пойдёт примерно со скоростью неторопливого чтения или медленнее: комфортно для короткого диалога, долго для статьи на три тысячи слов.
Ниже — опорные замеры из независимых тестов 2026 года. Железо и программы у авторов разные, поэтому это ориентиры, а не гарантия.Размер модели Скорость генерации На чём измерено 0,6–1B 18–36 ток/с It’s FOSS (ноутбук Intel i5, 12 ГБ, Ollama, 15.05.2026); InsiderLLM (i7-6700T, два канала DDR4) 3–4B 5–12 ток/с InsiderLLM (i7-6700T: 9,2–12,2); It’s FOSS (Phi-4 mini: 6,9); mustafa.net (Core i7-8559U, Qwen3.5 4B: 5,63) 7–9B 3–4 ток/с It’s FOSS (7B: 4,1–4,3; Ministral 3 8B: 3,16); mustafa.net (Qwen3.5 9B: 3,07)
Замеры It’s FOSS сняты в Ollama на тегах по умолчанию: файл модели там мог быть тяжелее Q4_K_M, а значит, на лёгком кванте скорость будет не ниже.
Поводы ноября 2026 года — релиз ggml и llama.cpp 1.0.0, пост на Hacker News про LLM на старых устройствах и модель Nemotron-3.5-Bolt-E4B — разберём ниже, а начнём с проверки своего компьютера.
Три проверки старого ПК: AVX2, каналы памяти и свободная ОЗУ
Запуск LLM на процессоре начинается не со скачивания модели, а с трёх проверок на пять минут. От них зависит, какая программа вообще запустится и какой скорости ждать.
Проверка 1. Есть ли в процессоре AVX2
AVX2 — набор инструкций процессора для параллельных вычислений над векторами. Без него LM Studio под Windows не запустится, а llama.cpp возьмёт более медленный вариант вычислений.
- Узнайте модель процессора: в Windows — «Диспетчер задач» → «Производительность» → «ЦП», в Linux — команда
lscpu. - Сверьтесь с таблицей ниже или с карточкой процессора в Intel ARK (поле «Расширения набора команд»). В Linux можно проверить напрямую:
grep -o avx2 /proc/cpuinfo | head -1— если команда вывелаavx2, инструкции есть.
| Процессор | AVX2 | LM Studio (Windows) | llama.cpp |
|---|---|---|---|
| Intel Core 4-го поколения (Haswell, с 2013) и новее | есть | работает | вариант haswell и выше |
| Intel Celeron и Pentium на архитектуре Tiger Lake и новее | есть | работает | вариант haswell и выше |
| Intel Celeron и Pentium старших поколений, бюджетные серии N и J на ядрах Atom | нет | не запустится | варианты без AVX2 |
| Intel Core 2-го и 3-го поколения (Sandy Bridge, Ivy Bridge) | нет, только AVX | не запустится | варианты sandybridge, ivybridge |
| AMD Excavator (с 2015), все Ryzen | есть | работает | вариант haswell и выше |
| AMD Piledriver (FX и APU 2012–2014) | нет, только AVX | не запустится | вариант piledriver |
Поколения и годы — по Wikipedia (Advanced Vector Extensions), названия вариантов — по составу готовой сборки llama.cpp b12521 от 18 ноября 2026 года. Год выпуска Celeron не гарантирует AVX2: у Celeron N5105 2021 года (Jasper Lake) Intel ARK указывает только SSE4.2.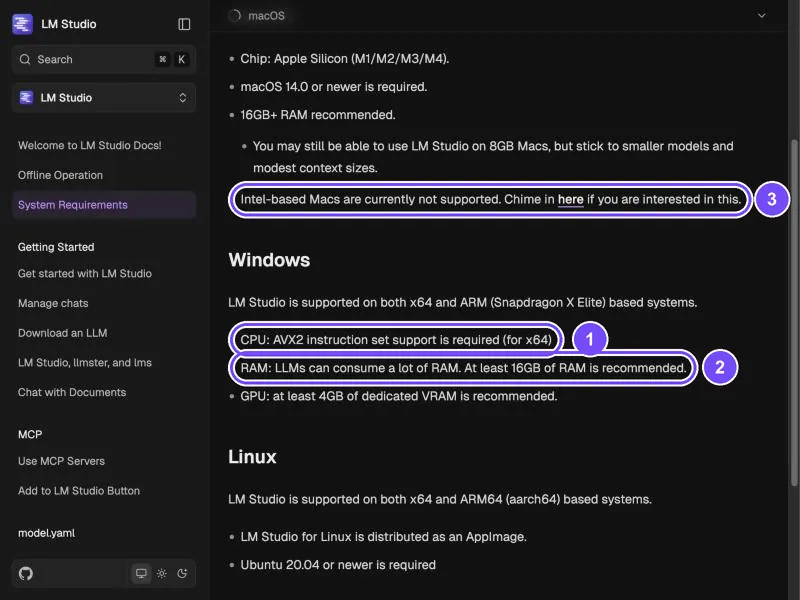
На кадре — официальная страница системных требований LM Studio, снятая 18 ноября 2026 года: AVX2 для Windows x64 (1), рекомендация от 16 ГБ ОЗУ (2) и отказ от поддержки Mac на Intel (3). Рекомендация по памяти — совет, а не жёсткий порог.
Проверка 2. В сколько каналов работает память
Канал памяти — отдельная «дорога» между процессором и ОЗУ. Две планки в правильных слотах обычно дают два канала и вдвое большую пропускную способность, одна планка — один канал.
- Windows: «Диспетчер задач» → «Производительность» → «Память» показывает число занятых гнёзд и скорость (например, 2400 МГц). «Использовано гнёзд: 1 из 2» — почти наверняка один канал. Но гнёзда — не каналы: «2 из 4» на плате с четырьмя слотами тоже может оказаться одним каналом, если планки стоят не в те разъёмы. Точно покажет бесплатная CPU-Z, вкладка Memory, строка «Channel #».
- Linux:
sudo dmidecode -t memoryпокажет каждую планку, её слот и частоту.
Для LLM это главный скрытый тормоз. В замере InsiderLLM (ThinkCentre M710q, i7-6700T, DDR4 на 2133 МГц, 11.08.2026) вторая планка ускорила Llama 3.2 3B с 7,36 до 11,59 токена в секунду, а Gemma 3 4B — с 5,89 до 9,15. Это +52–58% без замены процессора.
Проверка 3. Сколько ОЗУ свободно до запуска
Откройте браузер и привычные программы и посмотрите в «Диспетчере задач», сколько памяти занято. Модель с рабочим буфером должна поместиться в остаток, иначе система начнёт сбрасывать данные на диск, и скорость рухнет.
Почему скорость генерации на CPU упирается в память, а не в ядра
Чтобы выдать каждый следующий токен, модель заново читает из ОЗУ все свои веса. Поэтому скорость генерации ограничена тем, сколько гигабайт в секунду память успевает отдать: потолок ≈ пропускная способность ÷ размер файла модели. Ядра процессора при этом в основном ждут данные.
Пропускная способность одного канала — частота в мегатрансферах × 8 байт: DDR3-1600 даёт 12,8 ГБ/с, DDR4-2400 — 19,2 ГБ/с, DDR4-3200 — 25,6 ГБ/с. Два канала — вдвое больше. Это теоретический пик модуля по таблицам Wikipedia, реальная скорость всегда ниже.
Наш расчёт потолка для моделей Qwen3.5 в Q4_K_M (размеры файлов — с Hugging Face на 18 ноября 2026 года: 2B — 1,28 ГБ, 4B — 2,74 ГБ, 9B — 5,68 ГБ):Память ГБ/с Qwen3.5 2B Qwen3.5 4B Qwen3.5 9B DDR3-1600, один канал 12,8 10,0 4,7 2,3 DDR3-1600, два канала 25,6 20,0 9,3 4,5 DDR4-2133, один канал 17,1 13,3 6,2 3,0 DDR4-2400, два канала 38,4 30,0 14,0 6,8 DDR4-3200, два канала 51,2 40,0 18,7 9,0
Цифры в колонках моделей — максимум токенов в секунду, а не прогноз. Насколько реальность ниже потолка, мы сверили на замере InsiderLLM. У i7-6700T с DDR4-2133 в двух каналах (34,1 ГБ/с) потолок для Llama 3.2 3B (2,02 ГБ) — 16,9 ток/с, а измерено 11,59, то есть 69%. В одном канале потолок 8,4, измерено 7,36 — 87%. В нашем сверочном замере реальная скорость — 69–87% от потолка, на других машинах бывает и ниже.
Из формулы следуют три практических вывода:
- Больше ядер почти не помогает. InsiderLLM на одном процессоре получил 5,37 ток/с с 6 потоками и 5,33 — с 12.
- Меньший файл — прямо пропорционально быстрее. Переход с Q8 на Q4_K_M или с 9B на 4B ускоряет генерацию примерно во столько раз, во сколько уменьшился файл.
- Чтение запроса зависит уже от ядер. Вставленный документ модель обрабатывает параллельно, и второй канал тут почти не помогает: в том же замере обработка промпта изменилась меньше чем на 2%. На Core i7-8559U Nemotron-3.5-Bolt-E4B читал промпт со скоростью 30 токенов в секунду (mustafa.net): документ на 3000 токенов — около 100 секунд до начала ответа.
Какая модель для слабого ПК: Qwen3.5, Gemma 4, Llama 3.2, Phi-4 mini
Для слабого компьютера подходят модели на 1–4 млрд параметров в кванте Q4_K_M. Квант — способ сжать веса модели: Q4_K_M хранит их примерно в 4,5–5 битах вместо 16 и почти не теряет в качестве на чатовых задачах. Где у квантования начинается обрыв качества — в нашем разборе квантования Q4 против Q8.
Размеры файлов — из Hugging Face на 18–19 ноября 2026 года, скорости — из атрибутированных замеров на CPU, языки — из заявлений разработчиков в карточках моделей (качество на русском и украинском мы не измеряли).Модель Файл Q4_K_M Комфортно на ПК с Замер на CPU Языки по карточке Лицензия Qwen3.5 0.8B 0,53 ГБ 4 ГБ н/д 201 язык и диалект Apache 2.0 Llama 3.2 1B 0,81 ГБ 4 ГБ чуть меньше 10 ток/с (Ryzen 5 2500U, батарея) 8 официально, без русского и украинского Llama 3.2 Qwen3.5 2B 1,28 ГБ 8 ГБ н/д 201 язык и диалект Apache 2.0 Llama 3.2 3B 2,02 ГБ 8 ГБ 7,36 / 11,59 ток/с (i7-6700T, 1 / 2 канала) 8 официально, без русского и украинского Llama 3.2 Phi-4 mini 2,49 ГБ 8 ГБ 6,9 ток/с (ноутбук i5) русский и украинский в списке языков MIT Qwen3.5 4B 2,74 ГБ 8 ГБ 5,63 ток/с (Core i7-8559U) 201 язык и диалект Apache 2.0 Gemma 4 E2B 3,11 ГБ 8 ГБ 9,9 ток/с (ноутбук i5) 35+ из коробки, обучена на 140+ Apache 2.0 Gemma 4 E4B 4,98 ГБ 16 ГБ н/д 35+ из коробки, обучена на 140+ Apache 2.0 Qwen3.5 9B 5,68 ГБ 16 ГБ 3,07 ток/с (Core i7-8559U) 201 язык и диалект Apache 2.0 Nemotron-3.5-Bolt-E4B 6,18 ГБ 16 ГБ 5,03–10,9 ток/с (см. раздел ниже) en, es, fr, de, it, ja «и другие» OpenMDW-1.1
Колонка «Комфортно на ПК с» — наша оценка: файл модели плюс рабочий буфер плюс 3–4 ГБ под Windows с браузером. Источники замеров: It’s FOSS (ноутбук Intel i5, 12 ГБ), InsiderLLM, mustafa.net, Windows Central. Замеры It’s FOSS и Windows Central сняты в Ollama на тегах по умолчанию — файл там мог быть тяжелее указанного Q4_K_M (у Gemma 4 E2B It’s FOSS называет около 7 ГБ на диске, llama3.2:1b в Ollama весит 1,3 ГБ).
Кому что брать:
- Ноутбук с 4 ГБ или очень старый ПК — Qwen3.5 0.8B или Llama 3.2 1B. Ответы простые, зато быстрые.
- Обычный офисный ПК с 8 ГБ — Qwen3.5 2B или 4B для русского и украинского текста, Gemma 4 E2B и Phi-4 mini как альтернативы. Llama 3.2 3B быстрая, но русский и украинский официально не заявлены.
- 16 ГБ и два канала DDR4 — можно пробовать Qwen3.5 9B и Gemma 4 E4B, но готовьтесь к 3–6 токенам в секунду.
Буква E у Gemma 4 значит «effective»: файл больше, чем подсказывает цифра, из-за таблиц Per-Layer Embeddings (о них — в разделе про Nemotron). Модели под видеокарту и отдельные задачи вроде программирования сравниваются в нашем гиде по 11 локальным моделям под задачу и железо.
Сколько ОЗУ нужно: файл модели, KV-кэш и запас под систему
ОЗУ для LLM на CPU складывается из трёх частей: файл модели целиком, KV-кэш (память, где модель держит уже прочитанный разговор) и запас под систему с открытыми программами. Для 3–4B-модели в Q4_K_M с контекстом 4096 токенов на всё это обычно хватает 8 ГБ.
Как считается KV-кэш, покажем на Llama 3.2 3B. По её config.json на Hugging Face: 28 слоёв, 8 голов внимания для ключей и значений, размерность головы 128. В формате f16 (по умолчанию в llama.cpp) это 2 × 28 × 8 × 128 × 2 байта = 114 688 байт на токен. Наш расчёт:
- 4096 токенов контекста — около 448 МиБ поверх файла 2,02 ГБ, итого примерно 2,5 ГБ на модель;
- 32 768 токенов — уже около 3,5 ГиБ только на кэш, больше самой модели;
- гибридные модели вроде Qwen3.5 4B держат полное внимание лишь в 8 слоях из 32, поэтому их кэш заметно меньше — по той же формуле напрямую его не посчитать.
Отсюда главное правило для слабого ПК: задайте контекст явно, 4096 токенов. Ollama и так берёт 4096 по умолчанию. А вот llama.cpp при -c 0 берёт длину контекста из модели, у Qwen3.5 это 262 144 токена. Включённая по умолчанию автоподгонка --fit подстраивает незаданные параметры под свободную память (контекст — не ниже 4096), но на машине без видеокарты мы её не проверяли.
Формула под модели 8B–70B, видеокарту и длинный контекст подробно разобрана в нашем расчёте ОЗУ для локального ИИ под 8B–70B — здесь не повторяем, там же таблица по размерам.
Что такое ggml, GGUF и v1.0.0 — и что они меняют для вашего ПК
Эти три слова путают чаще всего, хотя роли у них разные:
- ggml — библиотека тензорных вычислений на C/C++ без внешних зависимостей. Работает на x86, ARM и RISC-V, умеет квантование от 2 до 8 бит и задачи для CPU, видеокарт и нейропроцессоров. Её начал писать Георгий Герганов в конце сентября 2022 года.
- llama.cpp — движок, который запускает LLM поверх ggml. Изначально его цель была именно работа на компьютерах без видеокарты. LM Studio считает через llama.cpp, а Ollama с мая 2025 года часть моделей запускает на собственном движке, который работает напрямую с ggml.
- GGUF — формат файла модели для ggml: в одном файле лежат веса и все настройки. GGUF сменил старые форматы GGML, GGMF и GGJT. Если на Hugging Face вы видите файл
.gguf— это то, что нужно для CPU.
13 ноября 2026 года ggml и llama.cpp одновременно получили номер 1.0.0. По объявлению команды в блоге Hugging Face, теперь любая несовместимость программного интерфейса будет отражаться сменой старшей цифры версии. В заметках к релизу — чистка устаревших функций и оптимизации под CUDA, Metal, Vulkan и другие ускорители, а ускорения именно для x86-процессоров там нет.
Для владельца старого ПК 1.0.0 не меняет ничего: старые GGUF-файлы работают как раньше, скорость на процессоре не выросла скачком. Обновляться всё равно стоит — регулярные сборки приносят мелкие улучшения.
Пост на Hacker News «I’m making LLMs work on small and old devices» — о проекте smolmaxxing, патче поверх llama.cpp для ARM-устройств вроде ТВ-приставки с ~1 ГБ памяти. Часть его файлов открывает только пропатченный движок, так что для x86-ПК это набор идей (маленькие модели, 1-битные веса), а не готовый инструмент.
Nemotron-3.5-Bolt-E4B: почему «4GB» — это файл на 6,18 ГБ
NVIDIA выпустила Nemotron-3.5-Bolt-E4B-4GB 23 октября 2026 года как маленькую модель для локальных ассистентов. По карточке на Hugging Face: 8 млрд параметров всего и 4 млрд «эффективных», архитектура Gemma-4-E4B, контекст до 64 тысяч токенов, только текст, лицензия OpenMDW-1.1.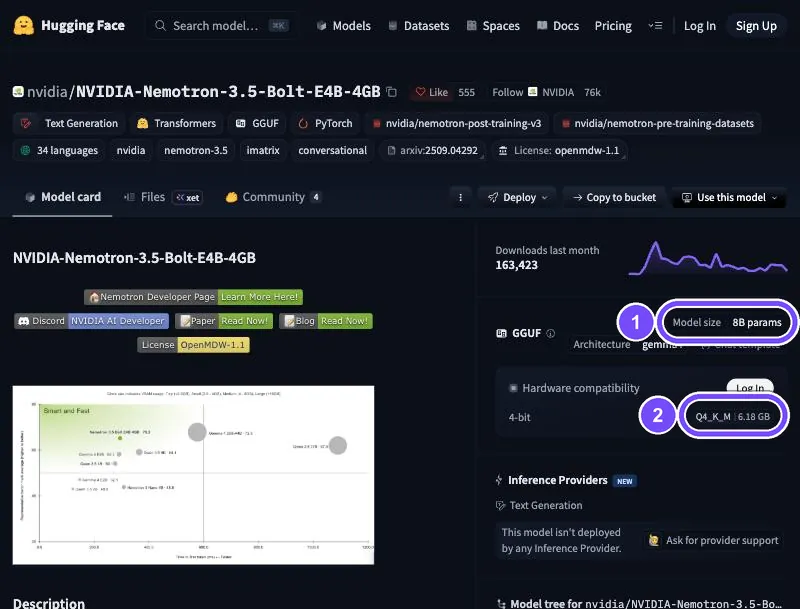
На кадре — карточка модели на Hugging Face, снятая 18 ноября 2026 года без входа в аккаунт: размер модели (1) и единственный файл GGUF в кванте Q4_K_M (2).
Мы сверили размер файла по API Hugging Face — 6 180 446 208 байт, ту же цифру до байта приводит mustafa.net. Откуда тогда «4GB»? Карточка этого не объясняет, но разбор файла автором Hackernoon показывает:Что внутри GGUF Объём Таблицы Per-Layer Embeddings (в основном Q8_0) 3,05 ГБ Блоки трансформера (Q4_K и Q6_K) 2,40 ГБ Эмбеддинги токенов 0,71 ГБ
Per-Layer Embeddings — таблицы, из которых на каждом токене модель читает всего несколько строк. Google в документации Gemma 4 объясняет так же: таблицы большие, но нужны только для быстрых выборок. Поэтому на CPU-сервере с контекстом 8K процесс у Hackernoon в итоге занимал около 3,8 ГБ выделенной памяти и 4,1 ГБ RSS. Сразу после загрузки система показывала около 9,6 ГБ — это страницы файла, только что прочитанные с диска, со временем цифра падает.
Наше наблюдение из замеров mustafa.net: на Core i7-8559U Bolt выдал 5,03 ток/с, а Qwen3.5 4B — 5,63. Файл у Bolt в 2,26 раза больше, а скорость — 89% от 4B-модели. Это и есть эффект таблиц: читать на каждом токене приходится не весь файл.Тест Железо Программа Генерация Hackernoon, 28.10.2026 8 vCPU Intel Xeon (AVX-512), 16 ГБ llama.cpp b11913, llama-bench, 8 потоков 10,9 ± 2,8 ток/с mustafa.net, 12.11.2026 Intel NUC8, Core i7-8559U llama.cpp b11561, контекст 8K 5,03 ток/с
Что учесть перед запуском Bolt на своём ПК:
- Рецепт в карточке — под видеокарту NVIDIA: Docker-образ с CUDA, флаги
--gpus allи-ngl 999, в поддерживаемом железе — Ampere, Hopper и Blackwell. То, что модель работает на CPU, показали независимые тесты, а не NVIDIA. - Нужно 6,2 ГБ на диске и 16 ГБ ОЗУ для спокойной работы. На 8 ГБ с открытым браузером рискуете упереться в своп.
- Режим размышлений на CPU дорогой. С выключенным thinking ответ в тесте Hackernoon занимал 2,1–3,6 секунды, с включённым — 13,1 секунды. Но без размышлений модель во всех трёх прогонах ошиблась с относительной датой: вместо ближайшей пятницы поставила следующую. Для дат и расчётов режим лучше включать.
- Не путайте с Bolt 74B-A9B-24GB. У NVIDIA в той же линейке есть модель на 74 млрд параметров, рассчитанная на 24 ГБ памяти, — о ней наша новость про Nemotron 3.5 Super VL и Bolt на 24 ГБ. Это другой продукт и не для старого ПК.
Запуск в LM Studio и Ollama на процессоре пошагово
Ollama и LM Studio — самый простой способ запустить LLM на ПК без командной строки или почти без неё. Обе стоят на библиотеке ggml: LM Studio — через llama.cpp, Ollama — частично через собственный движок на ggml. Разница — в удобстве и требованиях к железу.Что важно на старом ПК LM Studio Ollama llama.cpp Процессор без AVX2 Windows x64: не запустится официально не подтверждено, проверяйте есть варианты без AVX2 Интерфейс окно с чатом командная строка и API командная строка и веб-сервер Выбор кванта любой GGUF с Hugging Face тег библиотеки или hf.co/…:квантлюбой GGUF Требования от 16 ГБ ОЗУ рекомендовано Windows 10 22H2+, 4 ГБ на диске архив 25,6 МБ
Чем три программы отличаются по скорости на одной модели, мы разбирали отдельно — в сравнении Ollama, LM Studio и llama.cpp на одной модели (замеры там на видеокартах и Mac).
LM Studio: пять шагов
- Проверьте AVX2 (раздел «Три проверки старого ПК» выше). Без него версия для Windows x64 не запустится; в Linux программа идёт как AppImage для Ubuntu 20.04 и новее.
- Скачайте установщик с официального сайта lmstudio.ai и установите.
- Во вкладке поиска моделей найдите, например, Qwen3.5 4B и выберите файл с пометкой Q4_K_M.
- Загрузите модель в чат. Видеокарты нет, поэтому вся модель окажется в ОЗУ — это нормально.
- Если модель умеет размышлять, для простых вопросов выключите thinking в настройках чата.
Ollama: четыре шага
- Установите Ollama: для Windows нужна Windows 10 22H2 или новее, права администратора не требуются, под программу — от 4 ГБ на диске плюс место под модели.
- Запустите модель. Учтите, что теги библиотеки по умолчанию бывают тяжёлыми: на 18 ноября 2026 года
qwen3.5:2bвесит 2,7 ГБ — сама модель в Q8_0 (2,0 ГБ) плюс проектор для картинок (671 МБ). Лёгкий квант можно взять прямо с Hugging Face: по документации HF команда имеет видollama run hf.co/{автор}/{репозиторий}:{квант}, а без кванта берётся Q4_K_M, если он есть в репозитории. Для Qwen3.5 2B это выглядело бы так (мы эту команду не запускали):
ollama run hf.co/unsloth/Qwen3.5-2B-GGUF:Q4_K_M
- Проверьте, где работает модель:
ollama ps
В колонке Processor должно стоять 100% CPU — по документации Ollama это значит, что модель целиком загружена в оперативную память.
- Контекст по умолчанию — 4096 токенов, его меняет переменная
OLLAMA_CONTEXT_LENGTH. На слабом ПК увеличивать не стоит.
Почему лёгкий квант важен: на каждом токене читаются веса модели, а не проектор, поэтому сравнивать надо 2,0 ГБ в Q8_0 с 1,28 ГБ в Q4_K_M — по формуле из раздела про память это ускорение примерно в 1,5 раза. У gemma4:e2b (4,6 ГБ) около гигабайта — тоже проектор.
Работу Ollama на процессоре без AVX2 однозначно подтвердить не удалось: старая документация описывает варианты библиотек с AVX2, с AVX и без них, а код текущей версии — набор вариантов ggml. Проверьте на своей машине; не пошло — переходите к llama.cpp.
Запуск через llama.cpp: готовая сборка, потоки и контекст
llama.cpp — самый лёгкий и самый гибкий вариант, особенно для старых процессоров без AVX2. Собирать из исходников не нужно: на GitHub в разделе Releases лежат готовые архивы.
- Скачайте сборку под процессор. В релизе b12521 от 18 ноября 2026 года для Windows это
llama-b12521-bin-win-cpu-x64.zip(25,6 МБ), для Linux —llama-b12521-bin-ubuntu-x64.tar.gz(23,9 МБ), для Mac на Intel —llama-b12521-bin-macos-x64.tar.gz(13,1 МБ). В архиве для Windows лежатllama-cli.exe,llama-server.exe,llama-bench.exeи библиотеки под разные поколения процессоров, от базового x64 и SSE4.2 до haswell и новее. По исходному коду программа сама берёт лучший совместимый вариант; на CPU без AVX2 мы это не проверяли. - Скачайте модель. Возьмите файл
.ggufс пометкой Q4_K_M со страницы модели на Hugging Face. - Запустите чат, указав потоки и контекст:
llama-cli -m Qwen3.5-4B-Q4_K_M.gguf -t 4 -c 4096
Есть короткий путь: README llama.cpp 1.0.0 предлагает установочный скрипт (curl -LsSf https://llama.app/install.sh | sh для Linux и macOS, irm https://llama.app/install.ps1 | iex для Windows PowerShell) и команду, которая сама скачает модель с Hugging Face. Сами скрипты мы не запускали.
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF:Q4_0
Без кванта после двоеточия -hf берёт Q4_K_M, если он есть в репозитории, а иначе — первый файл. В репозитории ggml-org/Qwen3.5-0.8B-GGUF на 19 ноября 2026 года лежат только BF16 (1,56 ГБ), Q4_0 (0,56 ГБ) и Q8_0 (0,83 ГБ), поэтому квант лучше указывать явно. Если в репозитории есть проектор для картинок (mmproj), -hf докачает и его — для текстового чата это отключает флаг --no-mmproj.
Три флага, которые решают на слабом ПК:
-t— число потоков. Ставьте по числу физических ядер, а не логических — так советует документация llama.cpp. Автор блога point.free на Xeon E5-2620 v4 (8 ядер, 16 потоков) ставил-t 8. Если генерация подозрительно медленная, начните с-t 1и удваивайте.-c— контекст.-c 4096— разумный старт.-lm mlock— закрепить модель в ОЗУ, чтобы система не сбрасывала её на диск. В новых версиях это режим--load-mode; старый флаг--mlockиз статей прошлых лет может не сработать.
Свою скорость меряйте встроенным тестом, а не «на глаз»:
llama-bench -m Qwen3.5-4B-Q4_K_M.gguf -t 4
В выводе две цифры: pp — обработка промпта, tg — генерация ответа. Сравните tg с потолком из таблицы про память: если получили меньше половины расчётного, ищите причину в следующем разделе.
Если модель на CPU работает медленно: восемь шагов по убыванию эффекта
Проверяйте по порядку — первые шаги бесплатные и дают больше всего.
- Подключите ноутбук к сети. В тесте Windows Central (ноутбук на Ryzen 5 2500U, 8 ГБ, Ollama) модели на 1 млрд параметров выдавали чуть меньше 10 ток/с от батареи со сбалансированным планом питания, а от сети скорость примерно удвоилась.
- Проверьте второй канал памяти (проверка 2 выше). Одна планка в плате на два слота — главный скрытый тормоз.
- Возьмите квант легче. Q4_K_M вместо Q8_0 — особенно в Ollama, где теги по умолчанию бывают тяжелее.
- Возьмите модель меньше. 4B вместо 9B ускоряет генерацию примерно вдвое: файл 2,74 ГБ против 5,68 ГБ.
- Поставьте потоки по физическим ядрам. Больше потоков генерацию не ускоряет.
- Ограничьте контекст 4096 токенами. Меньше кэш, меньше риск свопа.
- Выключите режим размышлений для простых вопросов. У Nemotron-Bolt это несколько секунд против 13. Для дат и расчётов — включайте: в том тесте он исправил ошибку с датой.
- Не допускайте свопа. Если модель помещается в ОЗУ, но система выгружает её при открытии других программ, помогает
-lm mlockв llama.cpp. Если не помещается вовсе — только модель поменьше или квант легче: по наблюдению InsiderLLM, со свопом скорость падает ниже 2 токенов в секунду.
Риски LLM на старом ПК: своп, перегрев, ошибки и чужие файлы
Сам запуск не отправляет ваши запросы в интернет, но риски есть:
- Своп вместо ОЗУ. Модель, которая не помещается в память, система частично выгружает на диск. Компьютер не сломается, но генерация замедлится в разы. Держите запас памяти и не запускайте 9B на 8 ГБ.
- Нагрев и шум. Генерация держит процессор под нагрузкой минутами. У старых ноутбуков с забитой пылью системой охлаждения это повод проверить температуры, прежде чем оставлять модель работать на час.
- Ошибки маленьких моделей. 4B-модель уверенно ошибается в датах, расчётах и фактах — как Nemotron-Bolt с «пятницей» выше. Проверяйте всё, от чего зависят деньги, здоровье или работа.
- Файлы из непроверенных источников. Берите GGUF у разработчика модели или у известных сборщиков на Hugging Face, где файлы проходят автоматическую проверку (пометка Safe в списке файлов). Установочные скрипты вида
curl … | shвыполняют чужой код с вашими правами — запускайте их только с официального адреса проекта. - Громкие обещания без оговорок. В ноябре 2026 года в соцсетях разошлась цитата из README bitnet.cpp от Microsoft: модель на 100 млрд параметров на одном процессоре и ускорение до 6,17 раза. Условие при этом теряется: речь только о моделях, обученных в 1,58 бита, а ускорение 2,37–6,17 раза считается относительно полноточных моделей, не относительно Q4_K_M. Доступная модель такого типа — BitNet b1.58 2B4T: по InsiderLLM, 30–45 ток/с на ноутбучных процессорах при 0,4 ГБ памяти. Обычную Qwen или Llama так не ускорить.
Когда процессора не хватает: что менять и куда идти дальше
LLM на CPU упирается в потолок, когда задачи требуют модель от 9B и длинный контекст. Признаки: ответ идёт медленнее 3 токенов в секунду, документ на несколько страниц модель читает минутами, а качество 4B-модели не устраивает.
Варианты по нарастанию затрат:
- Сменить модель, а не железо. Попробуйте другую модель того же размера: качество на русском и украинском у малых моделей разное, а карточки говорят только о заявленной поддержке языков.
- Добить вторую планку памяти той же частоты, если сейчас работает один канал. Это самое дешёвое ускорение для CPU.
- Видеокарта. Если без неё уже никак, считайте не модель видеокарты, а объём видеопамяти — формула и таблица по моделям в нашем материале о том, сколько видеопамяти нужно под LLM. Порядок апгрейда со всеми подводными камнями, включая блок питания, разобран в гайде про апгрейд старого ПК под локальный ИИ.
- Облачная модель для тяжёлых задач. Локальная 4B не заменит большие облачные модели в сложных рассуждениях и программировании. Разумная схема — простые и приватные задачи локально, тяжёлые — в облаке.
FAQ
Какая модель подойдёт для слабого компьютера с 8 ГБ ОЗУ?
На 8 ГБ ОЗУ комфортно работают модели до 4 млрд параметров в кванте Q4_K_M: Qwen3.5 2B (1,28 ГБ) и 4B (2,74 ГБ), Llama 3.2 3B (2,02 ГБ), Phi-4 mini (2,49 ГБ), Gemma 4 E2B (3,11 ГБ). Для текста на русском и украинском разумно начать с Qwen3.5: по карточке она поддерживает 201 язык и диалект, а у Llama 3.2 эти языки официально не заявлены.
Запустится ли LLM на старом Mac с процессором Intel?
Да, но не через LM Studio: по официальным требованиям на 18 ноября 2026 года Mac на Intel программа не поддерживает. Остаётся llama.cpp — в релизе b12521 есть готовая сборка macos-x64 на 13,1 МБ. Дальше всё как на обычном ПК: модель 1–4B в кванте Q4_K_M, контекст 4096 токенов и потоки по числу физических ядер.
Запустится ли LM Studio на процессоре без AVX2?
Версия LM Studio для Windows x64 требует поддержку AVX2 — так написано в официальных системных требованиях на 18 ноября 2026 года. У Intel AVX2 есть с четвёртого поколения Core (Haswell, 2013), у Celeron и Pentium — только на архитектуре Tiger Lake и новее, у AMD — с Excavator (2015). На процессоре без AVX2 используйте llama.cpp: по составу готовой сборки в ней есть варианты для более старых наборов инструкций.
Работает ли Ollama без видеокарты и как понять, что она на CPU?
Да, Ollama работает без видеокарты и сама загружает модель в оперативную память. Чтобы убедиться, выполните ollama ps: в колонке Processor должно стоять «100% CPU». Учтите, что теги библиотеки по умолчанию бывают тяжелее Q4_K_M — qwen3.5:2b весит 2,7 ГБ против 1,28 ГБ у того же Qwen3.5 2B в Q4_K_M.
Чем ggml отличается от GGUF и llama.cpp?
ggml — библиотека вычислений на C/C++, фундамент всей системы. llama.cpp — движок, который на ggml запускает языковые модели, через него работает LM Studio; Ollama частично использует собственный движок на той же ggml. GGUF — формат файла модели, в котором лежат веса и настройки. Версия 1.0.0 от 13 ноября 2026 года означает стабильный программный интерфейс, а не новую скорость.
Можно ли запустить LLM на ноутбуке с 4 ГБ ОЗУ?
Можно, но только самую маленькую модель: Qwen3.5 0.8B (0,53 ГБ) или Llama 3.2 1B (0,81 ГБ) в кванте Q4_K_M. Система сама займёт заметную часть памяти, поэтому закройте браузер и используйте лёгкий llama.cpp — LM Studio рекомендует от 16 ГБ. Ноутбук держите подключённым к сети: от батареи генерация бывает вдвое медленнее.