Коротко: стоит ли брать RX 9070 XT под локальные LLM и картинки
Radeon RX 9070 XT — игровая видеокарта AMD на архитектуре RDNA 4 с 16 ГБ видеопамяти. Она вышла 6 марта 2025 года по рекомендованной цене $599, и с тех пор её всё чаще рассматривают как RX 9070 XT для нейросетей: локальных языковых моделей (LLM), генерации картинок и видео. Ниже разбираем, сколько токенов в секунду она даёт, какие модели помещаются в 16 ГБ, как с ней работает ROCm — программная платформа AMD для вычислений на видеокарте, аналог CUDA у NVIDIA, — и почему в ноябре 2026 вопрос «стоит ли» решает уже цена, а не софт.
- Коротко: стоит ли брать RX 9070 XT под локальные LLM и картинки
- Что RDNA4 даёт нейросетям: 128 AI-ускорителей, FP8 и 16 ГБ GDDR6
- Сколько tok/s даёт RX 9070 XT: замеры на 9B, 14B, 20B и 30B
- Потолок 16 ГБ у RX 9070 XT: какие модели влезают, а какие тормозят
- ROCm 10.1 для RX 9070 XT: что работает на Linux и Windows
- Stable Diffusion и ComfyUI на RX 9070 XT: скорость и подводные камни
- RX 9070 XT против RX 7900 XTX, R9700, RTX 5060 Ti и 5070 Ti
- Цена RX 9070 XT в ноябре 2026: США, Европа, Украина и б/у
- Проблемы RX 9070 XT в ИИ: ComfyUI, vLLM, LM Studio и драйверы
- Кому брать RX 9070 XT под ИИ, а кому — 7900 XTX, R9700 или RTX
- Частые вопросы про RX 9070 XT для локальных LLM
Своей карты на стенде у нас нет. Все цифры скорости в статье — чужие замеры, и у каждой подписано, кто мерил, на какой системе и когда.
- Языковые модели до 14–20 млрд параметров — да. gpt-oss:20b выдаёт 91,9 токена в секунду на Linux и около 73 на Windows 11, Qwen3 14B — 51–52 tok/s (стенды hirokuze и gadelog, сентябрь 2026).
- Плотные модели на 27B и больше — нет. В 4-битном кванте они весят от 17 ГБ, вылезают за 16 ГБ, и генерация падает до 6–7 tok/s.
- MoE-модели на 26–35B — с оговорками. Даже частично выгруженные в оперативную память, они держат около 35 tok/s.
- ROCm больше не преграда. В ROCm 10.1.0 от 5 октября 2026 года карта стоит в официальном списке и для Linux, и для Windows 11.
- Картинки и видео — слабое место. В ComfyUI по замерам 2025 года карта отстаёт от RTX 5070 Ti больше чем вдвое и упирается в нехватку памяти при декодировании.
- Цена съела преимущество. Около $920 в США на 9–11 ноября 2026 года против $770 у RTX 5060 Ti 16 ГБ и примерно $850 за б/у RX 7900 XTX с 24 ГБ.
Вердикт в одном абзаце: RX 9070 XT — быстрая карта «до 20B», особенно в обработке длинного промпта, но с жёстким потолком 16 ГБ и неровной диффузией. Если вы её уже купили для игр — она закроет большинство повседневных задач с локальными моделями. Если покупаете специально под ИИ, сравните её с б/у RX 7900 XTX и Radeon AI PRO R9700 в разделе про цены: при нынешнем рынке это решение считается в долларах за гигабайт и за токен.
Что RDNA4 даёт нейросетям: 128 AI-ускорителей, FP8 и 16 ГБ GDDR6
Чтобы понять, чего ждать от RX 9070 XT для нейросетей, нужно разделить работу языковой модели на две фазы. Первая — prefill, или обработка промпта: модель читает ваш запрос и документ целиком, и тут решают вычислительные блоки. Вторая — генерация: модель пишет ответ по одному токену (кусочку слова), и для каждого нового токена ей нужно заново прочитать из видеопамяти все свои веса. Поэтому генерацию ограничивает не мощность ядер, а скорость памяти.
У RDNA 4 сильная сторона — первая фаза. AMD добавила в карту 128 AI-ускорителей — матричных блоков, которые перемножают таблицы чисел, — и научила их формату FP8 (8-битные числа с плавающей точкой, варианты E4M3 и E5M2). По спецификации AMD пиковая производительность матричных блоков — 195 TFLOPs в FP16, 389 TFLOPs в FP8, 389 TOPs в INT8 и 779 TOPs в INT4. Это теоретические пики производителя: в токены в секунду они напрямую не переводятся.
Слабая сторона — память. 16 ГБ GDDR6 на 256-битной шине дают до 640 ГБ/с. Простой расчёт показывает, что это значит на практике. Qwen3 14B в кванте занимает около 9,3 ГБ. Делим 640 ГБ/с на 9,3 ГБ — получаем теоретический потолок около 69 токенов в секунду. Реальный замер на Linux дал 52,2 tok/s, то есть примерно 76% от потолка. Для сравнения, у RX 7900 XTX с её 960 ГБ/с тот же потолок был бы около 103 tok/s.Параметр RX 9070 XT RX 7900 XTX Radeon AI PRO R9700 RTX 5060 Ti 16 ГБ RTX 5070 Ti Видеопамять 16 ГБ GDDR6 24 ГБ GDDR6 32 ГБ GDDR6 16 ГБ GDDR7 16 ГБ GDDR7 Шина памяти 256 бит 384 бит 256 бит 128 бит 256 бит Пропускная способность 640 ГБ/с 960 ГБ/с 640 ГБ/с 448 ГБ/с 896 ГБ/с AI-/тензорные блоки 128 192 128 н/д 280 Потребление (TBP) 304 Вт 355 Вт 300 Вт н/д 300 Вт Рекомендуемый БП от 750 Вт от 800 Вт н/д н/д н/д Цена на старте $599 $999 $1 299 н/д $749
Спецификации AMD — по страницам производителя, данные RTX 5070 Ti и число блоков RX 7900 XTX — по таблице Tom’s Hardware, объём и шина RTX 5060 Ti — по scoreboard llama.cpp, её 448 ГБ/с — по спецификации NVIDIA в пересказе localaimaster. Из таблицы видно главное противоречие карты. По блокам для матриц RX 9070 XT новее и сильнее RX 7900 XTX, но по пропускной способности памяти уступает ей треть. А Radeon AI PRO R9700 — это тот же чип Navi 48 с той же скоростью памяти, но с вдвое большим объёмом.
Потребление 304 Вт и рекомендация AMD по блоку питания от 750 Вт важны, если вы ставите карту в старый корпус. Под долгой нагрузкой генерации карта работает часами, так что запас по питанию и охлаждению лучше заложить сразу.
Сколько tok/s даёт RX 9070 XT: замеры на 9B, 14B, 20B и 30B
Короткий ответ: на моделях, которые целиком помещаются в 16 ГБ, RX 9070 XT выдаёт от 50 до 90 токенов в секунду. Как только модель вылезает за 16 ГБ, всё зависит от её архитектуры: плотная модель падает до 6–7 tok/s, а MoE-модель удерживает около 35 tok/s.
Ниже — сводка двух независимых стендов. Первый — репозиторий hirokuze на GitHub: Linux, Ollama 0.18.2 в Docker с ROCm, температура 0,1, модель целиком в видеопамяти. Второй — японский блог gadelog: Windows 11, Ollama 0.30.10, ответ на 300 токенов, среднее из трёх прогонов. Оба замера опубликованы к сентябрю 2026 года.Модель Тип Объём в памяти Linux (hirokuze), tok/s Windows 11 (gadelog), tok/s Gemma 4 (класс 7,5B) плотная 9,6 ГБ н/д ~91 Qwen3.5 9B плотная н/д 57,8 н/д Qwen3 14B плотная 9,3 ГБ 52,2 ~51 gpt-oss:20b MoE ~13 ГБ 91,9 ~73 Gemma 4 26B MoE 17 ГБ (84% на GPU) н/д ~35 GLM-4.7-Flash 30B MoE 19,5 ГБ (81% на GPU) н/д ~35 Qwen 27B (Q4) плотная 17 ГБ 6,3 ~7
Отдельный стенд bhat-sahab на llama.cpp с Vulkan показывает, что даже MoE-модель Qwen3.6-35B-A3B в кванте IQ4_XS (18,2 ГБ) может давать 46–53 tok/s. Но это результат тонкой настройки: часть экспертов вынесена на процессор флагом --n-cpu-moe, контекст 32 тыс. токенов, включено предсказание нескольких токенов (MTP). Напрямую с цифрами Ollama его сравнивать нельзя.
gpt-oss:20b на Linux и Windows: почему верны и 91,9, и 73 tok/s
Разница в 26% между стендами — не ошибка одного из авторов. Это разные операционные системы, разные версии Ollama (0.18.2 против 0.30.10), разные промпты и, скорее всего, разный бэкенд: hirokuze запускал Ollama с ROCm в Docker, а на Windows Ollama для этой карты по документации идёт через Vulkan. Поэтому мы не усредняем, а даём обе цифры с подписью. И обобщать «Linux всегда быстрее» по одной паре стендов нельзя: на gpt-oss:20b Linux-стенд быстрее на 26%, а на Qwen3 14B разница в пределах 2% (52,2 против ~51 tok/s). Даже 73 tok/s для 20-миллиардной модели — комфортная скорость для чата и работы с кодом.
Prefill против генерации: почему RDNA 4 быстрее RX 7900 XTX в промпте
Самый воспроизводимый LLM benchmark для RX 9070 XT — llama-bench из llama.cpp на одной и той же модели Llama 2 7B Q4_0. Он меряет обе фазы отдельно: pp512 — обработку промпта из 512 токенов, tg128 — генерацию 128 токенов. На Vulkan RX 9070 XT обрабатывает промпт со скоростью 5202 токена в секунду против 3727 у RX 7900 XTX — на 40% быстрее. А генерирует 137 tok/s против 183 — на 25% медленнее. Это прямое следствие таблицы выше: матричные блоки RDNA 4 разгоняют чтение промпта, а 640 ГБ/с против 960 ГБ/с тормозят ответ.
Для вас это значит следующее. Если вы скармливаете модели длинные документы, логи или кодовую базу, RX 9070 XT начнёт отвечать быстрее старшей карты. Если ведёте короткий диалог, в котором важна скорость самого ответа, выигрывает RX 7900 XTX.
Есть и второе разделение — по бэкенду, то есть программной прослойке, через которую llama.cpp обращается к карте. В генерации на этой карте стабильно быстрее Vulkan: 136,6 против 101,3 t/s на Llama 2 7B и 220 против 179 tok/s на Llama 3.2 3B под Fedora 44. По обработке промпта ясного победителя нет: на Llama 2 7B оба бэкенда идут почти вровень (5202 против 5055 t/s), а на других моделях и сборках расклад меняется. Подробно сравнивать платформы здесь не будем — для выбора карты достаточно знать, что на RX 9070 XT работают обе.
Потолок 16 ГБ у RX 9070 XT: какие модели влезают, а какие тормозят
В 16 ГБ RX 9070 XT целиком помещаются плотные модели до 14 млрд параметров в 4-битном кванте и MoE-модели до 20 млрд вроде gpt-oss:20b. Плотная модель на 27 млрд в кванте Q4_K_M весит 17 ГБ — она уже не влезает и генерирует в 14,6 раза медленнее gpt-oss:20b. Граница проходит не по числу параметров, а по архитектуре.
Чтобы это увидеть, достаточно сравнить замеры hirokuze. gpt-oss:20b занимает около 13 ГБ и выдаёт 91,9 tok/s, Qwen 27B в Q4_K_M занимает 17 ГБ и выдаёт 6,3 tok/s: 91,9 / 6,3 ≈ 14,6. Но это сравнение плотной модели с MoE. Чистый эффект выгрузки виден на двух плотных моделях: Qwen3 14B целиком в памяти даёт 52,2 tok/s, а плотная 27B, вылезшая за 16 ГБ, — 6,3. Размер вырос меньше чем вдвое (17 против 9,3 ГБ), а скорость упала примерно в 8 раз. Причина — в механике генерации. Плотная модель на каждом токене читает все веса, и если 10% из них лежат в оперативной памяти компьютера, каждый токен ждёт медленную шину процессора. У gadelog именно так и вышло: 90% модели на GPU, 10% на CPU — и около 7 tok/s.
MoE-модель (Mixture of Experts, «смесь экспертов») устроена иначе. Она состоит из множества небольших подсетей, и на каждом токене работают только несколько из них. Если часть экспертов не поместилась в видеопамять, модель обращается к ним реже, поэтому потеря скорости намного меньше. Gemma 4 26B с 84% весов на GPU и GLM-4.7-Flash 30B с 81% держат около 35 tok/s — в пять раз больше, чем плотная модель сопоставимого размера (27B, те же 17 ГБ).Модель и квант Объём весов Помещается в 16 ГБ Что ожидать на RX 9070 XT Плотные 7–9B, Q4 ~10 ГБ да, с запасом под контекст 58–91 tok/s Qwen3 14B, Q4 9,3 ГБ да 51–52 tok/s gpt-oss:20b, MXFP4 (MoE) ~13 ГБ (14 ГБ на диске) да, впритык под длинный контекст 73–92 tok/s Gemma 4 26B (MoE) 17 ГБ нет, 84% на GPU ~35 tok/s GLM-4.7-Flash 30B (MoE) 19,5 ГБ нет, 81% на GPU ~35 tok/s Qwen3.6-35B-A3B, IQ4_XS (MoE) 18,2 ГБ нет, эксперты частично на CPU 46–53 tok/s после настройки Плотные 27B, Q4_K_M 17 ГБ нет, 90% на GPU 6–7 tok/s
Таблица собрана по замерам hirokuze, gadelog и bhat-sahab (сентябрь 2026). Размер gpt-oss:20b сверен с карточкой модели на Hugging Face: OpenAI пишет, что модель работает в пределах 16 ГБ памяти.
Помните, что 16 ГБ — это не 16 ГБ под веса. Часть памяти забирают драйвер и рабочий стол, а ещё часть — KV-кэш, то есть «черновик» модели, где она хранит уже прочитанный контекст. Чем длиннее контекст, тем больше этот кэш. Модель на 13 ГБ с коротким чатом поместится, а с документом на десятки тысяч токенов может начать вылезать в оперативную память. Посчитать кэш под свою модель и длину контекста можно по формуле из нашего разбора видеопамяти под LLM.
Практическое правило для владельца RX 9070 XT: выбирайте архитектуру модели, а не число параметров. MoE на 20–35B на этой карте полезнее плотной модели на 27B, хотя по названию вторая кажется скромнее.
ROCm 10.1 для RX 9070 XT: что работает на Linux и Windows
На 15 ноября 2026 года актуальная версия — ROCm Core SDK 10.1.0, её release notes AMD датированы 5 октября 2026 года. В списке поддерживаемых видеокарт есть Radeon RX 9070 XT, RX 9070 GRE и RX 9070 под общим кодом gfx1201 — и для Linux, и для Windows 11 25H2. Вопрос «поддерживает ли ROCm эту карту» формально закрыт.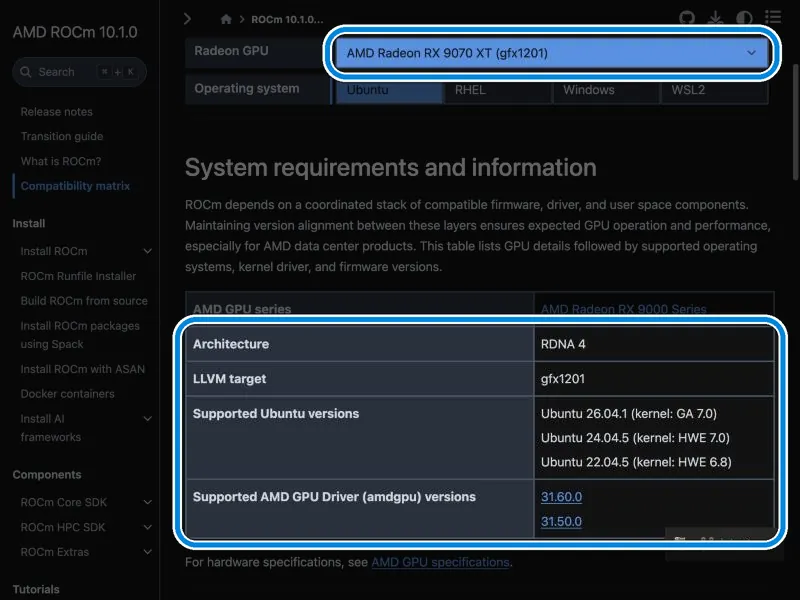
На скриншоте — официальная матрица совместимости ROCm 10.1.0, снятая 15 ноября 2026 года. Верхняя рамка показывает выбранную карту: AMD Radeon RX 9070 XT (gfx1201). Нижняя рамка — то, что нужно проверить перед установкой: архитектура RDNA 4, три поддерживаемые версии Ubuntu — 26.04.1 с ядром GA 7.0, 24.04.5 с HWE 7.0 и 22.04.5 с HWE 6.8 — и две версии драйвера amdgpu, 31.60.0 и 31.50.0.
В составе 10.1.0 — HIP 7.16.0 и сборки PyTorch 2.14.0, в том числе для Windows с Python от 3.11 до 3.14. Для vLLM, сервера для высоконагруженного запуска моделей, AMD указывает версию 0.29.0 на gfx1201 — только для Linux. По обзору технического блога Joho no Todai, в релиз вошло и техническое превью для WSL2 — подсистемы Linux внутри Windows.
Одна деталь, которая сбивает с толку многих: ComfyUI и другие приложения при установленном ROCm 10.1.0 пишут в консоли «ROCm 7.16». Это не старая версия и не ошибка. Приложение выводит версию HIP — низкоуровневого слоя ROCm, — а у ROCm 10.1.0 она как раз 7.16.0.
Если вы выбираете между Radeon и GeForce по зрелости софта в целом, это отдельная тема — мы разобрали её в материале ROCm против CUDA. Здесь — только то, что касается RX 9070 XT.
Linux: четыре шага до работающей карты на ROCm 10.1
- Поставьте поддерживаемую систему. По матрице AMD — Ubuntu 26.04.1, 24.04.5 или 22.04.5 с указанным ядром. На других дистрибутивах карта тоже работает у энтузиастов, но официальной гарантии нет.
- Установите драйвер amdgpu версии 31.60.0 или 31.50.0. Это те версии, которые матрица AMD связывает с ROCm 10.1.0. Если запускаете готовую сборку Ollama со встроенным ROCm, сверьтесь и с её документацией: там указано своё минимальное требование к драйверу.
- Установите ROCm 10.1.0 и проверьте, что система видит gfx1201. Для этого есть утилиты
rocminfoиamd-smi: если карта определяется под кодом gfx1201, всё собрано правильно. - Запустите движок под задачу. Ollama — для простого чата, llama.cpp — для тонкой настройки и замеров, vLLM — для сервера. В таблице поддержки Ollama RX 9070 XT указана как раз для Linux.
Windows: драйвер Adrenalin for ROCm, LM Studio и Vulkan
На Windows всё сложнее, потому что разные программы используют карту по-разному. У AMD есть отдельный драйвер Adrenalin Edition for ROCm 10.1 (версия 26.10.41.05), совместимый с серией RX 9000. Он нужен в первую очередь для PyTorch — а значит, для ComfyUI и других инструментов генерации картинок.
С языковыми моделями картина другая. В официальной таблице Ollama для Windows на ROCm перечислены только карты серии RX 7000 — RX 9070 XT там нет. На Windows Ollama по умолчанию включает Vulkan, и именно через него карта обычно и работает. LM Studio позволяет выбрать рантайм вручную — ROCm или Vulkan. Чем эти программы различаются на одной и той же модели, мы сравнили в разборе Ollama, LM Studio и llama.cpp.
Главная практическая ловушка на Windows — не выбор между ROCm и Vulkan. По наблюдению gadelog (сентябрь 2026, LM Studio runtime 2.37.0), LM Studio выбирает видеокарту по номеру, а номера меняются местами при смене рантайма. В системе со встроенной графикой модель может молча уехать на неё: скорость Gemma 4 E4B упала с 96 до 16,5 tok/s без единой ошибки. Проверить порядок можно командой lms runtime survey или в настройках Hardware. Самый надёжный способ — отключить встроенную графику совсем.
Stable Diffusion и ComfyUI на RX 9070 XT: скорость и подводные камни
RX 9070 XT генерирует картинки в Stable Diffusion и ComfyUI, но это её слабое место. В единственном подробном сравнении с RTX 5070 Ti карта AMD оказалась медленнее больше чем вдвое, а на тяжёлых сценариях вовсе не дошла до финиша. Важная оговорка: большинство замеров сделаны в 2025 году на ранних сборках ROCm, свежего независимого сравнения на ROCm 10.1 пока нет.Сценарий Стенд и дата Результат RX 9070 XT SDXL 832×1216, 10 картинок, ComfyUI chimolog, ROCm TheRock, сентябрь 2025 больше чем вдвое дольше RTX 5070 Ti (~44,1 с) Видео Wan2.2 416×416, 81 кадр chimolog, сентябрь 2025 ~200 с против ~77 с у RTX 5070 Ti; 720p — нехватка памяти Hires.Fix с ControlNet Tile chimolog, сентябрь 2025 RTX 5070 Ti ~в 4,8 раза быстрее; 4K не завершился из-за ошибок MIOpen SDXL 1024×1024, 20 шагов ComfyUI #7332, 2025 1,03 it/s, 32,25 с с тайловым VAE SDXL 1024×1024, 20 шагов ROCm TheRock #9134, обновлён 16.10.2026 ~28 с (1,5 it/s) только с тайловым VAE, без него — OOM Картинка и видео LTX 2.3 Level1Techs, Linux, Docker, ROCm 7.1, июль 2026 картинка меньше 30 с; 20 с видео за 5–8 минут «Обычный» SDXL, Forge Neo note.com/lpp, Windows, ROCm 10.1.0, 14.10.2026 ~3,3 с; шаги и разрешение автор не указал
Последняя строка выглядит как прорыв, но сравнивать её с остальными нельзя: автор не назвал ни разрешение, ни число шагов. Это скорее сигнал, что на ROCm 10.1 со встроенным Flash Attention ситуация могла улучшиться, чем замер, на который можно опереться при покупке.
Что важно знать до установки ComfyUI на RX 9070 XT:
- VAE-декодер съедает память. VAE превращает внутреннее представление картинки в пиксели, и на этой карте он часто упирается в 16 ГБ. Рабочий обход — тайловый VAE (декодирование кусками); ComfyUI иногда переключается на него сам после ошибки.
- Версии ROCm и PyTorch нужно подбирать. Автор с Level1Techs называет «золотой серединой» связку ROCm 7.1 и PyTorch 2.9.1 в Docker — новые версии не всегда были лучше на его задачах.
- На Windows 10.1.0 исправил старую ошибку. В ROCm 10.0.0 PyTorch 2.12.0 на gfx1201 падал после первого вызова внимания из-за несовпадения версий библиотеки AOTriton. В 10.1.0 это исправлено, а запасной обход — флаг
--use-quad-cross-attentionпри запуске ComfyUI. - Видео в 720p и выше — на грани. У chimolog Wan2.2 в 720p не поместился в память.
Если генерация картинок — ваша главная задача, а не дополнение к языковым моделям, RX 9070 XT сейчас не лучший выбор. Для чата с моделями и редких картинок её хватит.
RX 9070 XT против RX 7900 XTX, R9700, RTX 5060 Ti и 5070 Ti
На одном и том же тесте RX 9070 XT обгоняет RX 7900 XTX и RTX 5060 Ti в обработке промпта, но генерирует медленнее RX 7900 XTX и RTX 5070 Ti на CUDA. Radeon AI PRO R9700 по скорости почти не отличается от неё — за доплату вы получаете память, а не скорость.
Ниже — сводка из публичных таблиц llama.cpp на одной модели Llama 2 7B Q4_0, без Flash Attention. Строки присылают разные люди с разных сборок, поэтому разница в 5–10% — в пределах погрешности, а вот разница в 30–40% — реальная. Таблица собрана по scoreboard сообщества: Vulkan, ROCm и CUDA, срез на 15 ноября 2026 года.Карта Память Бэкенд Промпт pp512, t/s Генерация tg128, t/s RX 9070 XT 16 ГБ, 640 ГБ/с Vulkan 5202 136,6 RX 9070 XT 16 ГБ, 640 ГБ/с ROCm 5055 101,3 RX 7900 XTX 24 ГБ, 960 ГБ/с Vulkan 3727 182,6 Radeon AI PRO R9700 32 ГБ, 640 ГБ/с Vulkan 5610 145,7 Radeon AI PRO R9700 32 ГБ, 640 ГБ/с ROCm 4444 93,8 RTX 5060 Ti 16 ГБ 16 ГБ, 448 ГБ/с Vulkan 3461 93,5 RTX 5060 Ti 16 ГБ 16 ГБ, 448 ГБ/с CUDA 3737 90,9 RTX 5070 Ti 16 ГБ, 896 ГБ/с Vulkan 6214 135,6 RTX 5070 Ti 16 ГБ, 896 ГБ/с CUDA 6952 176,9
RX 7900 XTX vs RX 9070 XT в LLM: 24 ГБ против быстрого промпта
В языковых моделях эти две карты выигрывают в разном. Старшая RDNA 3 генерирует на треть быстрее (182,6 против 136,6 t/s) и даёт 24 ГБ — а значит, вмещает плотную модель на 27B, которая на RX 9070 XT обрывается до 6–7 tok/s. Новая RDNA 4 быстрее читает промпт: на Llama 2 7B — на 40%, а в тесте gamegpu на Gemma 4 11.9B (август 2026) — на 53% (3020 против 1971 t/s), при генерации 69,4 против 86,7 t/s в пользу RX 7900 XTX.
Подвох — в доступности. RX 7900 XTX снята с производства, и новые карты серии RX 7000 больше не попадают в недельный мониторинг розничных цен. Покупать её придётся на вторичном рынке. Как собрать вокруг неё систему под модели на 24 ГБ, мы разбирали в материале про RX 7900 XTX для локальных LLM.
RX 9070 XT vs RTX 5070 Ti в LLM: CUDA и 896 ГБ/с
При одинаковых 16 ГБ GeForce в языковых моделях быстрее. У неё 896 ГБ/с против 640 — в 1,4 раза больше, — и на CUDA она генерирует 176,9 t/s против 136,6 у Radeon на Vulkan. Тест chimolog (сентябрь 2025) показал ту же картину на реальных моделях: на 8B и 14B в LM Studio RTX 5070 Ti отвечала примерно в 1,3 раза быстрее. Плюс CUDA — это экосистема, под которую по умолчанию пишут большинство инструментов для диффузии и дообучения. Против — цена: в ноябре 2026 года RTX 5070 Ti стоит заметно дороже, об этом ниже.
Radeon AI PRO R9700: тот же чип Navi 48, но 32 ГБ
R9700 построена на том же чипе, с той же шиной и пропускной способностью 640 ГБ/с. В замерах llama.cpp она идёт вровень с RX 9070 XT: на ROCm даже чуть медленнее (4444 против 5055 t/s в промпте, 93,8 против 101,3 в генерации), на Vulkan — чуть быстрее. Различие одно — 32 ГБ памяти, в которые помещаются плотные модели на 27–35 млрд параметров. Подробно — в нашем обзоре Radeon AI PRO R9700.
RTX 5060 Ti 16 ГБ: тот же объём, медленнее память
RTX 5060 Ti 16 ГБ — главная альтернатива по цене. Объём памяти у неё такой же, но шина вдвое уже (128 бит), и пропускная способность — 448 ГБ/с. Отсюда и результат: 90,9 t/s в генерации на CUDA против 136,6 у RX 9070 XT на Vulkan, промпт — 3737 против 5202. По чистой скорости Radeon впереди на 40–50%, за GeForce — экосистема CUDA.
Цена RX 9070 XT в ноябре 2026: США, Европа, Украина и б/у
Рекомендованная цена RX 9070 XT на старте — $599. В ноябре 2026 года карта стоит около $920 в США, €933 в Германии и от 48 тысяч гривен в Украине. По данным TechSpot, в октябре 2026 года она продавалась в США на 45% дороже рекомендованной цены — дефицит видеокарт поднял цены на всё семейство. По нашему пересчёту от ~$920 на 9–11 ноября 2026 года наценка к рекомендованной цене — уже около +54%.Карта США Германия Украина (Hotline) Б/у RX 9070 XT ~$920–930 (минимум $919,99 на 9.11; ~$930 на 11.11) €932,90 (14.11) от 48 171 ₴; ASUS Prime 48 819–61 744 ₴ (15.11) ~$675 (медиана Jawa, 4.08–2.11) RTX 5060 Ti 16 ГБ $769,99 (9.11) €799,90 (14.11) н/д н/д RTX 5070 Ti ~$1 340 (начало ноября) €1 329,90 (14.11) н/д н/д RX 7900 XTX сняты с производства (EOL) н/д н/д ~$850 (медиана Jawa, 4.08–2.11); €899 — медиана проданных лотов eBay (3.11) Radeon AI PRO R9700 $1 699,99 (9.11) £1 599,95 в Великобритании (9.11) н/д н/д
По американскому рынку цифры расходятся по датам и магазинам. Минимум на агрегаторе PCPartPicker был $869,99 на 25 октября и $919,99 на 9 ноября, отдельные версии XFX Mercury доходили до $1599, а в крупных магазинах в целом — $900–1200 на 10 ноября. На Hotline 15 ноября 2026 года самое дешёвое предложение — ASRock Challenger от 48 171 ₴, у массовых моделей (ASUS Prime, ASRock Steel Legend, Sapphire Pulse) нижняя граница — 48–53 тыс. ₴, а весь диапазон страницы доходит до 86 409 ₴ у премиальной XFX Quicksilver. Это разброс цен магазинов по модели, а не гарантированная цена в наличии, и меняется он в течение дня. Данные по Украине и вторичному рынку — каждый из одного источника, поэтому их стоит перепроверить перед покупкой.
На вторичном рынке встречаются и карты после майнинга: RX 9070 XT добывает монеты, и это отдельная история, которую мы разобрали в материале про майнинг на RX 9070 XT. Перед покупкой б/у карты стоит проверить её температуру и стабильность под долгой нагрузкой.
Цена за 1 tok/s и за 1 ГБ видеопамяти у пяти видеокарт
Скорость в отрыве от цены мало что говорит, поэтому разделим ноябрьские цены США на генерацию из таблицы llama.cpp (лучший бэкенд для каждой карты) и на объём памяти.Карта Цена (США, ноябрь 2026) Генерация, t/s $ за 1 t/s $ за 1 ГБ памяти RX 9070 XT, новая ~$920 136,6 ~6,7 ~57,5 RX 9070 XT, б/у ~$675 136,6 ~4,9 ~42,2 RTX 5060 Ti 16 ГБ ~$770 93,5 ~8,2 ~48,1 RTX 5070 Ti ~$1 340 176,9 ~7,6 ~83,8 RX 7900 XTX, б/у ~$850 182,6 ~4,7 ~35,4 Radeon AI PRO R9700 ~$1 700 145,7 ~11,7 ~53,1
Расчёт показывает, что дефицит перевернул привычную логику «AMD дешевле». Новая RX 9070 XT по цене за токен лучше обеих GeForce, но по цене за гигабайт проигрывает RTX 5060 Ti. А б/у RX 7900 XTX при ~$850 выигрывает у всех и по скорости генерации, и по объёму памяти — ценой гарантии и риска покупки с рук. Новая R9700 почти вдвое дороже RX 9070 XT ($1700 / $920 ≈ 1,85) и оправдана только тогда, когда нужны именно 32 ГБ.
Проблемы RX 9070 XT в ИИ: ComfyUI, vLLM, LM Studio и драйверы
У RX 9070 XT под нейросети нет одной фатальной проблемы, но есть набор мелких, каждая из которых может стоить вечера настройки. Ниже — только подтверждённые случаи с источником и датой.
- ComfyUI падает с нехваткой памяти. В трекере AMD TheRock #9134 (открыт, обновлён 16 октября 2026 года) генерация SDXL на настройках по умолчанию завершается ошибкой OOM; работает только с тайловым VAE.
- vLLM пока не раскрывает FP8 на RDNA 4. Задача #28649 в трекере vLLM открыта, последнее обновление — 20 октября 2026 года. В марте 2026 года блог digtvbg сравнил на Qwen3.5-9B в кванте Q6_K vLLM на ROCm 7.2 и llama-server на Vulkan: 48 против 62 tok/s. Отдельно автор пишет, что FP8-модели vLLM на RDNA 4 молча деквантует в FP32, не задействуя AI-ускорители.
- LM Studio на Windows уезжает на встроенную графику. Скорость падает в шесть раз без ошибки (gadelog, сентябрь 2026).
- Ollama на Windows не использует ROCm для этой карты. По документации Ollama на 15 ноября 2026 года Windows-таблица ROCm заканчивается серией RX 7000.
- Регрессия обработки промпта на MoE в llama.cpp. После изменения от 29 июня 2026 года prefill на MoE-моделях в llama.cpp на Vulkan замедлился на 3–8% на картах RDNA 4 с 64 вычислительными блоками, как у RX 9070 XT (issue #26346). Тред закрыт 16 сентября 2026 года с меткой stale — по неактивности, а не с подтверждённым исправлением. В части англоязычных гайдов он до сих пор описан как открытый.
- Обновления ROCm ломают и чинят. Пример — ошибка AOTriton на Windows в ROCm 10.0.0, исправленная только в 10.1.0. Перед обновлением драйвера под рабочий проект стоит сохранить рабочую связку версий.
- Цена и вторичный рынок. По нашему пересчёту от ~$920 на 9–11 ноября 2026 года карта стоит примерно на 54% дороже рекомендованной цены, RX 7000 сняты с производства, а б/у рынок — это всегда риск состояния карты.
Сильные стороны RDNA 4 в ИИ, которые уравновешивают риски
Справедливо назвать и сильные стороны, подтверждённые теми же источниками. В обработке промпта RX 9070 XT быстрее RX 7900 XTX и RTX 5060 Ti, а из игровых карт в нашей сводке уступает только RTX 5070 Ti (и родственной R9700 на Vulkan: 5610 против 5202 t/s). Она официально поддерживается ROCm 10.1.0 на Linux и Windows. Она работает и через Vulkan, то есть без специального вычислительного драйвера. И на неё хорошо ложатся MoE-модели вроде gpt-oss:20b, GLM-4.7-Flash и Qwen3.6-35B-A3B.
Кому брать RX 9070 XT под ИИ, а кому — 7900 XTX, R9700 или RTX
Брать RX 9070 XT под ИИ стоит, если ваши задачи — языковые модели до 20 млрд параметров и MoE-модели, вы работаете с длинными документами и не привязаны к CUDA. Если нужны 24–32 ГБ, генерация картинок как основная задача или готовые CUDA-инструменты, выгоднее одна из альтернатив.Ваш сценарий Что брать Почему Чат и код на моделях до 14–20B, длинные документы RX 9070 XT промпт на 40% быстрее RX 7900 XTX, 52–92 tok/s на генерации Карта уже стоит в игровом ПК RX 9070 XT, без доплаты ROCm 10.1 и Vulkan закрывают повседневный локальный ИИ Плотные модели на 27–35B RX 7900 XTX б/у (24 ГБ) или R9700 (32 ГБ) на 16 ГБ скорость падает до 6–7 tok/s Максимум скорости генерации за свои деньги RX 7900 XTX б/у ~$4,7 за 1 t/s против ~$6,7 у новой RX 9070 XT Stable Diffusion, видео, дообучение RTX 5070 Ti CUDA, в 2+ раза быстрее в SDXL по замерам 2025 года Минимальный бюджет на 16 ГБ RTX 5060 Ti 16 ГБ или б/у RX 9070 XT ~$770 новая или ~$675 б/у; GeForce генерирует на треть медленнее Сервер на vLLM с FP8 подождать или взять CUDA FP8 на RDNA 4 в vLLM пока не доделан
Наш вывод: RX 9070 XT — хороший выбор для того, кто хочет локальные языковые модели среднего размера и не боится провести вечер с настройкой. Но это уже не «дешёвая альтернатива NVIDIA»: при ~$920 она конкурирует с RTX 5060 Ti и б/у RX 7900 XTX на равных, и выбор между ними решает задача, а не бренд. Если 16 ГБ для ваших моделей мало при любой видеокарте, посмотрите другие классы железа — Mac, мини-ПК с большой общей памятью и сборки на нескольких картах — в нашем гиде по железу для локального ИИ.
Частые вопросы про RX 9070 XT для локальных LLM
Хватит ли 16 ГБ RX 9070 XT для локального ИИ и какие модели в них влезают?
Хватит для плотных моделей до 14 млрд параметров в 4-битном кванте и MoE-моделей до 20 млрд — например, gpt-oss:20b (~13 ГБ в памяти, 73–92 tok/s). Плотная модель на 27B весит от 17 ГБ и замедляется до 6–7 tok/s. MoE на 26–30B с частичной выгрузкой в оперативную память держат около 35 tok/s.
Работает ли ROCm на RX 9070 XT в Windows или нужен Linux?
Работает: ROCm 10.1.0 от 5 октября 2026 года официально поддерживает RX 9070 XT (gfx1201) на Windows 11 25H2, есть драйвер Adrenalin for ROCm и PyTorch 2.14. Но Ollama на Windows использует для этой карты Vulkan, а не ROCm. Разница в скорости зависит от модели: на gpt-oss:20b Linux-стенд дал 91,9 против ~73 tok/s на Windows, а на Qwen3 14B — 52,2 против ~51.
Что быстрее для RX 9070 XT — ROCm или Vulkan в llama.cpp?
В генерации быстрее Vulkan: на Llama 2 7B он даёт 136,6 t/s против 101,3 на ROCm, на Llama 3.2 3B — 220 против 179. В обработке промпта бэкенды на Llama 2 7B идут почти вровень (5202 против 5055 t/s), а на других моделях расклад меняется. Для чата обычно выгоднее Vulkan; под длинные документы проверьте оба на своей модели.
RX 9070 XT или RX 7900 XTX для нейросетей: что брать при 16 и 24 ГБ?
Если ваши модели помещаются в 16 ГБ и вы работаете с длинными промптами — RX 9070 XT: она на 40% быстрее читает промпт, и это новая карта с гарантией. Если нужны плотные модели на 27B или максимум скорости ответа — б/у RX 7900 XTX: 24 ГБ, генерация на треть быстрее и около $850 на вторичном рынке.
Подходит ли RX 9070 XT для Stable Diffusion и ComfyUI?
Подходит для эпизодической генерации, но это не сильная сторона карты. По замерам 2025 года RTX 5070 Ti была быстрее больше чем вдвое в SDXL, а на настройках по умолчанию ComfyUI на RX 9070 XT ловит нехватку памяти при декодировании VAE. Помогает тайловый VAE и свежий ROCm 10.1.0, но независимых замеров на нём ещё нет.
Стоит ли покупать RX 9070 XT для ИИ по ценам ноября 2026?
Если она нужна и для игр, и для моделей до 20B — да, это быстрая карта с официальной поддержкой ROCm. Если покупаете только под ИИ, сравните её с б/у RX 7900 XTX за ~$850 и RTX 5060 Ti 16 ГБ за ~$770: при цене около $920 RX 9070 XT уже не самый дешёвый путь к локальным нейросетям.