
Коротко (TL;DR)
Qwen 3.8 Flash Next — відкрита MoE-модель Alibaba на 125 млрд параметрів, з яких на кожен токен працюють лише 6 млрд. Тому її можна запустити на домашньому ПК з відеокартою на 8 ГБ, але із застереженнями: усе вирішує не відеокарта, а обсяг оперативної пам’яті та швидкість SSD. А історія про те, що модель «дзвонить у Китай», стосується агента з доступом до командного рядка, а не файлу моделі у звичайному чаті.
- Коротко (TL;DR)
- Словничок: експерти, квант, VRAM і офлоад
- Qwen 3.8 Flash Next у цифрах: 125B, 6B на токен, 262K контексту
- Чи влізе Flash Next у 8 ГБ VRAM і 32 ГБ RAM: арифметика пам’яті
- GGUF для Flash Next: які кванти є і скільки важить кожен
- Запуск на 8 ГБ через llama.cpp: -cmoe, -ncmoe і –lazy-mode
- Flash Next у програмі Strata на 8 ГБ: який квант обрати і збої
- Ollama і LM Studio: що працює для Flash Next на відеокарті з 8 ГБ
- Скільки ток/с чекати на 8 ГБ: заміри на 12 ГБ і заява з Reddit
- Чи надсилає Flash Next дані в Китай: що насправді знайшла Cohere
- Критика звіту Cohere про Qwen: prefill, повторний тест і Palisade
- Як перевірити, що модель не ходить у мережу: macOS, Linux і Windows
- Що безпечно у файлі моделі: GGUF, safetensors і trust_remote_code
- Ризики локального запуску Flash Next: пам’ять, SSD, якість і агенти
- Чи чекати Qwen4: що брати зараз — Flash Next, 27B чи API
- FAQ
- 8 ГБ VRAM + 32 ГБ RAM: реалістичний вибір — урізана версія Coder (IQ1_M): у ній половина «експертів», її оптимізували під код. Але навіть вона за 32 ГБ працює в режимі low-RAM: з картою на 8 ГБ більшу частину експертів Strata читає з SSD, і це помітно повільніше. Повноцінний Q2_0 за 32 ГБ RAM документація Strata не рекомендує: йому потрібно близько 48 ГБ.
- 16 ГБ RAM: жоден квант не вміщується в пам’ять повністю; модель постійно читатиме ваги з диска, і швидкість упаде до незручної.
- Швидкість: надійних замірів саме на 8 ГБ немає. На картах із 12 ГБ і 64 ГБ RAM спільнота й розробник Strata бачать 43–93 токени на секунду на генерації. Допис на Reddit про «30 ток/с на 8 ГБ» правдоподібний, але не підтверджений.
- Як запустити: llama.cpp (прапорці
-cmoe,-ncmoe,--lazy-mode on) або програма Strata з інсталятором. Офіційні теги Ollama важать від 105 ГБ (MLX для Mac) і від 120 ГБ (q4_K_M для ПК) — на 8 + 32 ГБ підходить лише GGUF із Hugging Face. - Про «надсилання даних»: файл ваг у мережу не ходить. Інцидент Cohere — це агент, якому дали оболонку, і він згенерував команду
curlна бакет Alibaba. Перевірити, що ваш запускач мовчить, можна за 5 хвилин — нижче команди для macOS, Linux і Windows.
Словничок: експерти, квант, VRAM і офлоад
Без цих п’яти слів далі буде важко, тому коротко.
- MoE (Mixture of Experts, «суміш експертів») — архітектура, де модель складається із сотень невеликих блоків-«експертів», і на кожне слово (токен) вмикаються лише кілька з них. У Flash Next у кожному з 48 шарів 512 експертів, а працюють 10 на токен плюс один спільний експерт.
- VRAM — пам’ять відеокарти. Вона швидка, але її мало. RAM — оперативна пам’ять комп’ютера: повільніша, зате її простіше наростити.
- Квант (квантизація) — стиснення ваг моделі: числа зберігаються не в 16 бітах, а у 2–4. Файл стає в 4–8 разів меншим ціною невеликої втрати якості. Позначення на кшталт Q2_0, IQ2_XS, IQ3_S — різні способи такого стиснення.
- GGUF — формат файлу моделі для llama.cpp і програм на його основі (Ollama, LM Studio; Strata теж читає GGUF, але рушій у неї власний).
- Офлоад (offload) експертів — прийом, коли експертів тримають у RAM і обчислюють процесором, а найбільш «гаряче» (увагу, спільні шари, кеш контексту) — на відеокарті. Саме він дає змогу запустити модель на 125 млрд параметрів на 8 ГБ VRAM.
Qwen 3.8 Flash Next у цифрах: 125B, 6B на токен, 262K контексту
Qwen3.8-Flash-Next — модель Alibaba, викладена у відкритий доступ 26 серпня 2026 року (дата першого коміту ваг на Hugging Face). Її побудовано на архітектурі майбутнього Qwen4, і вона стала її публічною «пробою» — докладніше про сам реліз ми писали в новині про вихід MoE-моделі Qwen3.8-Flash-Next. Нижче — картка моделі за офіційною сторінкою на Hugging Face станом на 30 жовтня 2026 року.Параметр Значення Що це означає для вас Параметрів в основній моделі 125 млрд Стільки ваг треба десь зберігати Активних на токен 6 млрд Стільки реально обчислюється на кожне слово — звідси швидкість Таблиця n-gram 51 млрд Довідник фраз; читається по рядку, може лежати на SSD Блок MTP 4 млрд Прискорювач генерації: вгадує наступні токени наперед Усього в чекпойнті ≈180 млрд 125 + 51 + 4; звідси «180B» у деяких оглядах Шарів / експертів на шар 48 / 512 (10 активних) Майже всі параметри сидять в експертах Контекст 262 144 токени, розширюється до 1 млн Вистачить на цілий репозиторій коду Ліцензія Qwen Community License 1.0 Не Apache 2.0, але для особистого використання обмежень немає Дата виходу 26.08.2026 Моделі два місяці, підтримка в софті ще наздоганяє 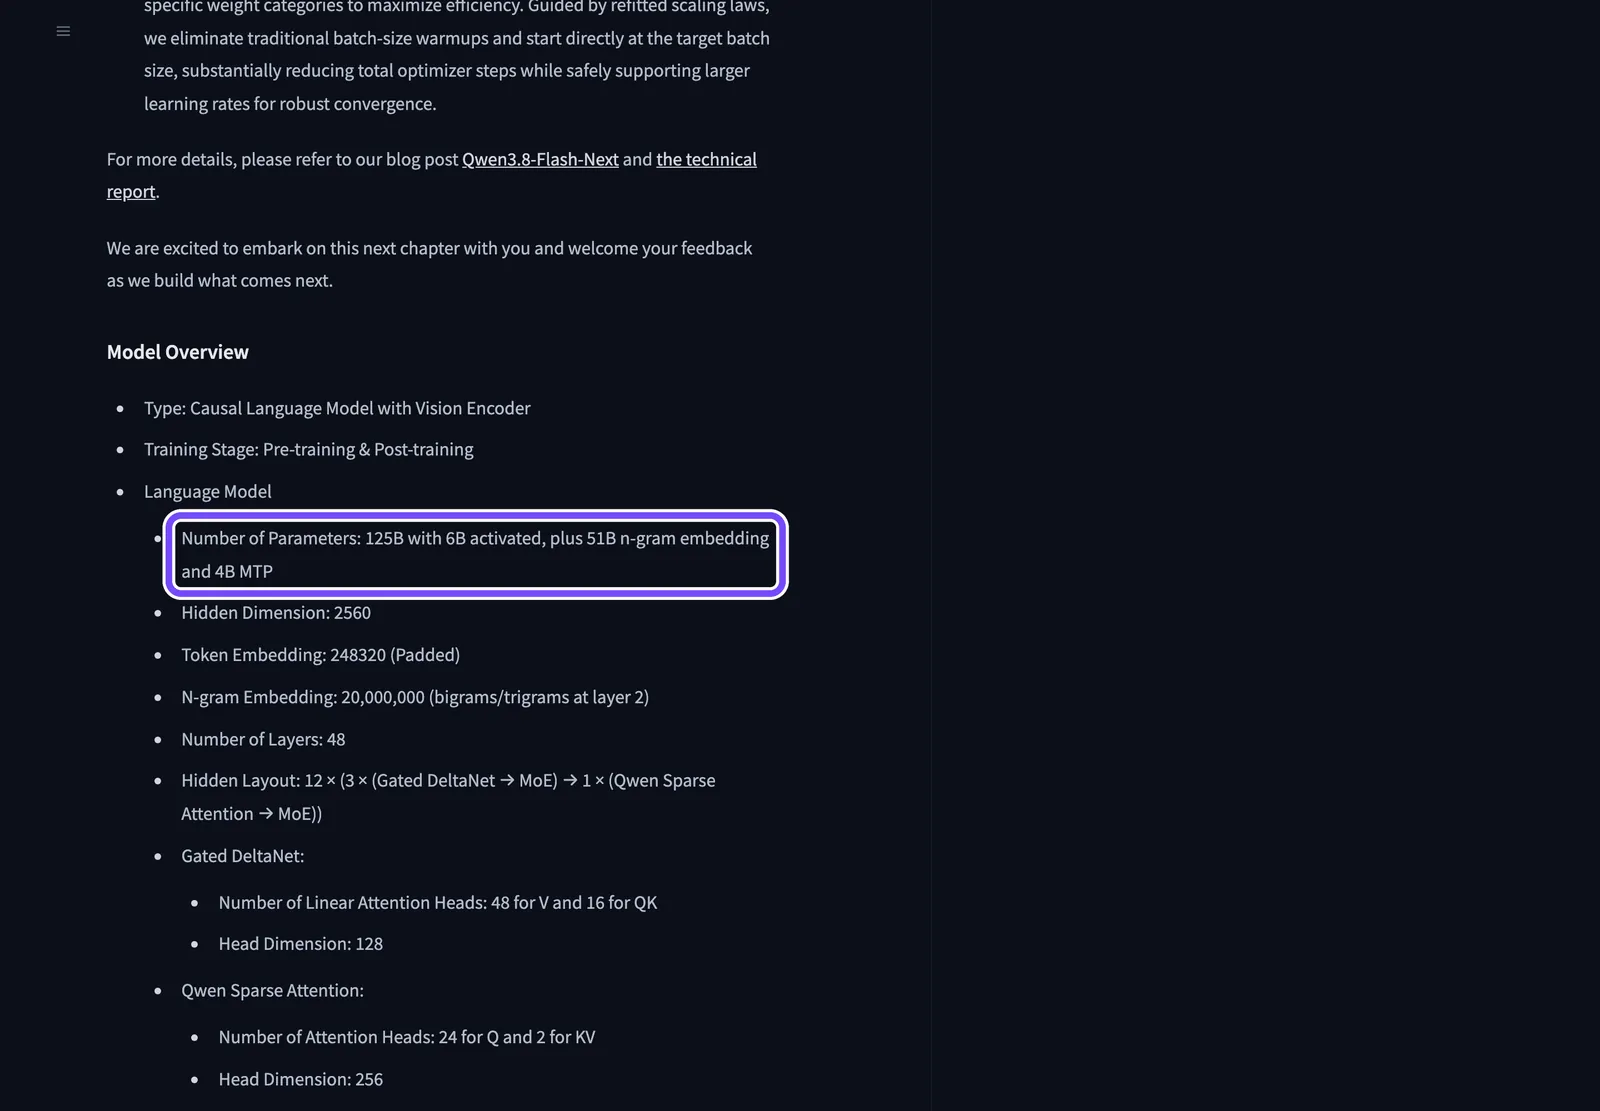
На скриншоті картки (знято 30 жовтня 2026 року) рамка виділяє рядок, через який в оглядах плутають «125B» і «180B»: це різні одиниці рахунку, а не суперечність. 125 млрд — сама мовна модель, ще 55 млрд — n-gram-таблиця і блок MTP.
Головне для домашнього запуску: «6 млрд активних» не означає «потрібно 6 ГБ пам’яті». Обчислювати на кожен токен доводиться мало, але зберігати треба всіх експертів, бо наступний токен може покликати будь-яких із 512. Тому моделі потрібна велика RAM, а відеокарта лише прискорює найгарячішу частину.
Кілька слів про ліцензію. Qwen Community License 1.0 вимагає показувати назву моделі сервісам з аудиторією понад 100 млн користувачів на місяць або виторгом понад $20 млн на місяць, а продаж моделі як сервісу і бізнес «AI Work Assistant» потребують окремої ліцензії. Для домашнього використання і власних проєктів це не заважає.
Чи влізе Flash Next у 8 ГБ VRAM і 32 ГБ RAM: арифметика пам’яті
Коротка відповідь: Qwen 3.8 Flash Next на 8 ГБ VRAM запускається, якщо у вас 32 ГБ RAM і швидкий NVMe SSD, але повноцінний Q2_0 туди вміщується лише з читанням ваг із диска. Документація Strata за 32 ГБ радить версію Coder, а Q2_0 — від 48 ГБ RAM.
Річ у тім, що в моделі три «поверхи» пам’яті, а не два, як у звичайних LLM:
- VRAM (відеокарта) — увага, спільні шари, кеш контексту (KV-кеш) і, якщо залишиться місце, частина експертів.
- RAM (оперативна пам’ять) — експерти, що не влізли у відеокарту. Це найбільша частина файлу.
- SSD — таблиця n-gram на 28,8 ГБ. Її читають по одному рядку на токен, тому тримати її в пам’яті не обов’язково: llama.cpp читає її з диска за прапорцями
-lm mmap --lazy-mode on.
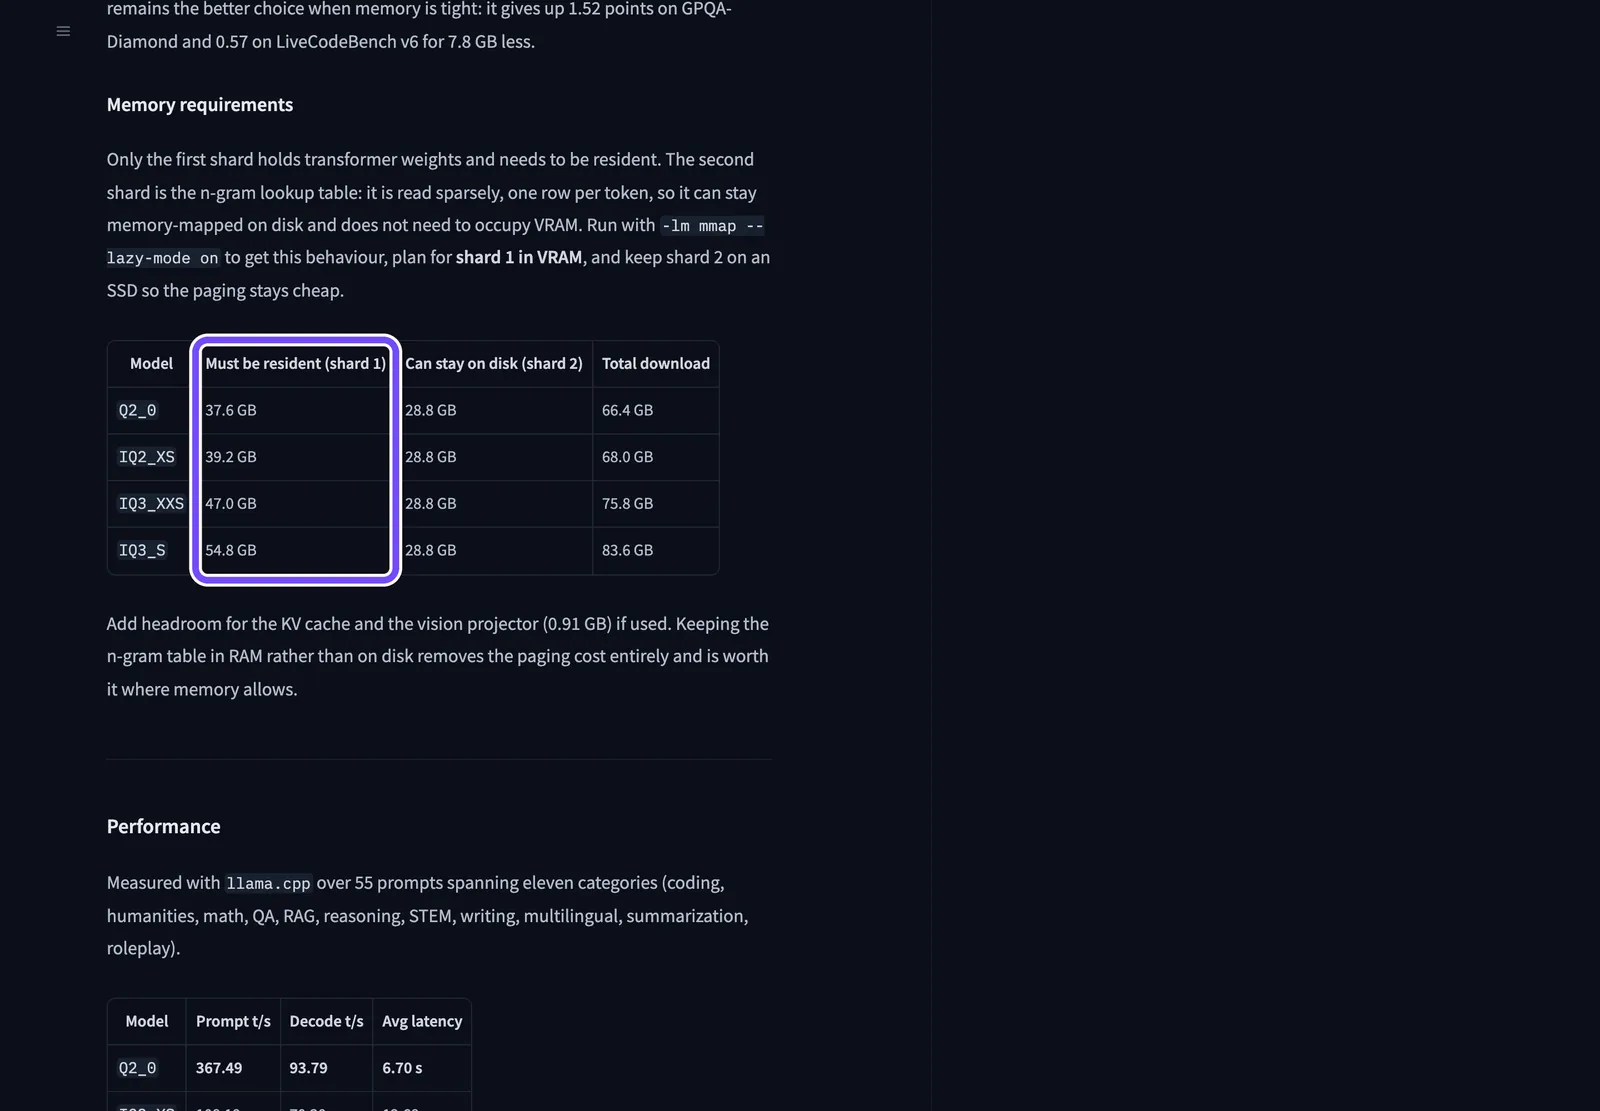
На скриншоті картки ISTA-DASLab (знято 30 жовтня 2026 року) рамкою виділено колонку «Must be resident» — ту частину, що мусить лежати в пам’яті. Друга колонка, 28,8 ГБ n-gram, може залишитися на диску. Тепер порахуємо, що з цього влізе у зв’язку 8 ГБ VRAM + 32 ГБ RAM, за правилом із документації Strata: RAM має вміщувати експертів шарда 1 плюс близько 10 ГБ на систему і програми.Варіант Шард 1 (у пам’ять) З них експерти Потрібно RAM за правилом Strata 8 ГБ VRAM + 32 ГБ RAM Coder IQ1_M 29,6 ГБ 23 ГБ ≈33 ГБ Не повністю: режим low-RAM, частина експертів із SSD; однаково найкращий варіант Q2_0 37,6 ГБ 34 ГБ ≈44 ГБ Лише з читанням експертів із SSD, повільно IQ2_XS 39,2 ГБ 35,5 ГБ ≈45,5 ГБ Лише з читанням із SSD IQ3_XXS 47 ГБ 43 ГБ ≈53 ГБ Ні IQ3_S 54,8 ГБ 50 ГБ ≈60 ГБ Ні
Обсяги шардів і експертів — з карток ISTA-DASLab і документації Strata станом на 30 жовтня 2026 року; колонку «потрібно RAM» ми порахували за правилом Strata.
Що з цього випливає на практиці:
- 32 ГБ RAM: Coder повністю не вміщується (за правилом Strata йому потрібно ≈33 ГБ), тому Strata запускає його в режимі low-RAM і тримає в RAM лише ту частину експертів, якій не вистачило місця на відеокарті; решта читається з файлу на SSD. Q2_0 і IQ2_XS у тому самому режимі теж стартують, але повільніше.
- 48 ГБ RAM: за документацією Strata влазять Q2_0 і IQ2_XS.
- 64 ГБ RAM: влазять усі чотири кванти ISTA-DASLab (IQ3_S — якщо майже нічого більше не відкрито).
- 16 ГБ RAM: навіть Coder (29,6 ГБ у шарді 1) не вміщується в 16 + 8 ГБ. Модель читатиме більшу частину ваг із диска на кожному токені — технічно запустити можна, користуватися незручно.
Чому це взагалі працює? Відеокарта не мусить тримати експертів: на токен вмикаються 10 із 512, і їх може обчислити процесор. Відеопам’ять потрібна під те, що працює на кожному токені. Загальну логіку «скільки пам’яті з’їдають ваги й контекст» ми розбирали в матеріалі про те, скільки відеопам’яті потрібно моделі — тут додається лише «третій поверх» на SSD.
Звідси ж ще одна вимога: NVMe SSD, а не SATA і тим паче не HDD. Таблиця n-gram читається з диска на кожному токені, і повільний накопичувач знижує всі цифри швидкості. Вільного місця потрібно 58–76 ГБ під сам квант плюс близько 6 ГБ під блок MTP, який Strata докачує під час першого запуску.
GGUF для Flash Next: які кванти є і скільки важить кожен
Файли Qwen 3.8 Flash Next у форматі GGUF випускають три постачальники: ISTA-DASLab (лабораторія Інституту науки і технологій Австрії), Unsloth і ggml-org (команда llama.cpp). Розміри нижче — з API Hugging Face станом на 30 жовтня 2026 року, у десяткових гігабайтах.Постачальник Квант Розмір файлу Особливість 8 + 32 ГБ ISTA-DASLab Coder IQ1_M 58,4 ГБ (29,6 + 28,8) 256 із 512 експертів, під код Так, частково з SSD ISTA-DASLab Q2_0 66,4 ГБ (37,6 + 28,8) Найшвидший Із SSD, повільно ISTA-DASLab IQ2_XS 68 ГБ Трохи кращий у коді, повільніший за Q2_0 Із SSD ISTA-DASLab IQ3_XXS 75,8 ГБ 99,4% якості повної моделі (самозвіт) Ні ISTA-DASLab IQ3_S 83,6 ГБ Найкраща якість серед 3-бітних Ні Unsloth UD-IQ1_S 72,5 ГБ Мінімум Unsloth: 75 ГБ RAM+VRAM Ні Unsloth UD-Q2_K_XL 78,9 ГБ 2 біти Ні Unsloth UD-Q4_K_XL 111,3 ГБ 4 біти Ні Unsloth Q8_0 188,2 ГБ Майже без втрат Ні ggml-org Q2_K 83,1 ГБ Стандартний квант llama.cpp Ні ggml-org IQ4_NL 102 ГБ 4 біти Ні
Чому в ISTA-DASLab файли менші за тієї самої розрядності: вони ділять модель на два шарди, і другий (n-gram) залишається на диску. Крім того, їхній метод GSQ-RCO підбирає свій тип стиснення для кожного з 352 тензорів. В Unsloth n-gram-таблиця лежить у тому самому файлі, а сам Unsloth пише, що моделі потрібно щонайменше 75 ГБ RAM або об’єднаної пам’яті. Тому збірки Qwen 3.8 Flash Next від Unsloth — вибір для Mac на 96–128 ГБ або ПК із 96 ГБ RAM, а не для зв’язки 8 + 32 ГБ.
Щодо якості ISTA-DASLab публікує власні заміри (самозвіт, незалежного повтору немає): Q2_0 набирає 89,07 бала в середньому за трьома тестами міркувань і коду проти 93,12 у повної моделі в BF16, тобто близько 96%. Q2_0 поступається IQ2_XS лише на 0,09 бала, зате швидший: за даними авторів, у нього в 3,4 раза вища швидкість читання промпту.
Окремо про Coder. Це не квант, а «обрізана» модель: із кожного шару видалили половину експертів, залишивши ті, що важливі для коду, агентних завдань і зображень. Strata прямо попереджає, що Coder слабший поза програмуванням і в мовах, крім англійської, включно з китайською. Для україномовного й російськомовного чату це помітний мінус: якщо вам потрібен розмовний помічник, а не помічник у коді, Coder — компроміс, а не знахідка.
Який GGUF Qwen 3.8 Flash Next завантажувати під 8 ГБ VRAM:
- 32 ГБ RAM, потрібен код: Coder IQ1_M — єдиний варіант, який Strata рекомендує для 32 ГБ, але на 8 ГБ VRAM він теж частково читається з SSD.
- 32 ГБ RAM, потрібен загальний чат: Q2_0 у режимі читання з SSD — повільніше, але з повним набором експертів. Або докупити RAM до 48 ГБ.
- 48 ГБ RAM: Q2_0 — найкращий баланс швидкості та якості.
- 64 ГБ RAM: IQ3_XXS.
Запуск на 8 ГБ через llama.cpp: -cmoe, -ncmoe і –lazy-mode
Одразу про застарілу інформацію: у деяких оглядах досі пишуть, що основна гілка llama.cpp модель не підтримує і потрібен форк. Це не так: архітектуру qwen4exp влили в master 27 серпня 2026 року, наступного дня після виходу моделі. Станом на 30 жовтня у вихідному коді master зареєстровано архітектуру qwen4exp і тип квантування Q2_0, а в довідці llama-server є прапорці для винесення експертів. Частина оптимізацій (MoE-кеш, прискорення уваги) поки лежить у відкритих pull request — прапорці ще можуть змінитися.
Ми не перевіряли ці команди на карті з 8 ГБ: їх зібрано з довідки llama-server і карток ISTA-DASLab. Перед запуском звірте прапорці командою llama-server --help у своїй збірці.
Крок 1. Зберіть або завантажте свіжий llama.cpp. Потрібна свіжа збірка з підтримкою CUDA (NVIDIA), ROCm/HIP (AMD) або Metal (Mac): у ній мають бути архітектура qwen4exp (з 27 серпня 2026 року) і прапорець --lazy-mode — перевірте його командою llama-server --help.
Крок 2. Завантажте обидва шарди. Другий шард (n-gram) обов’язковий, навіть якщо він читатиметься з диска:
pip install -U "huggingface_hub[cli]"
hf download ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF --local-dir ./flash-next-coder
Крок 3. Запустіть сервер з експертами в RAM і n-gram на SSD:
llama-server \
  -m ./flash-next-coder/IQ1_M/Qwen3.8-Flash-Next-GSQ-RCO-IQ1_M-00001-of-00002.gguf \
  -ngl 99 -cmoe \
  -lm mmap --lazy-mode on \
  -c 32768 \
  --host 127.0.0.1 --port 8080
Що робить кожен прапорець:Прапорець Що робить Навіщо на 8 ГБ -ngl 99Усі шари — на відеокарту Увага і спільні шари обчислюються швидко -cmoe (--cpu-moe)Усі ваги експертів MoE — у RAM, обчислює процесор Інакше експерти не влізуть у 8 ГБ -ncmoe N (--n-cpu-moe N)У RAM — експерти лише перших N шарів, решта на відеокарті Для більших карт: добирають N, доки VRAM не закінчиться -lm mmap --lazy-mode onТаблиця n-gram читається з диска по рядку Мінус 28,8 ГБ із пам’яті -c 32768Довжина контексту Кожен токен контексту займає VRAM; почніть із 32K --fit (увімкнений за замовчуванням)Сам підганяє незадані параметри під вільну пам’ять Не треба вручну шукати межу --moe-cache-mib NКеш «гарячих» експертів у VRAM (за замовчуванням 0, вимкнений) Якщо після завантаження залишається вільна відеопам’ять -ot (--override-tensor)Ручне розкладання тензорів по пристроях Те саме, що -cmoe, але з точністю до тензора
Крок 4. Доберіть -ncmoe, якщо карта більша за 8 ГБ. На 8 ГБ розумно починати з -cmoe: усі експерти в RAM. На 12–16 ГБ можна замінити його на -ncmoe 40 і зменшувати число, доки сервер стартує без помилки нестачі пам’яті: кожен шар, експерти якого переїхали на відеокарту, прискорює генерацію.
Крок 5. Перевірте, що сервер слухає лише ваш комп’ютер. За замовчуванням llama-server відкриває порт на адресі 127.0.0.1, тобто недоступний із мережі. Прапорець --host 0.0.0.0 робить його доступним для всієї локальної мережі — без потреби так не робіть.
Про --moe-cache-mib: це кеш експертів, які часто потрібні, просто у відеопам’яті. У прикладі з відкритого pull request #30966 у репозиторії llama.cpp на карті з великим запасом VRAM (квант IQ4_NL) кеш на 6,4 ГБ давав 24–48 ток/с залежно від частки експертів, які обчислює процесор, кеш на 19,4 ГБ — 54–66 ток/с, а для 24 ГБ скрипт прогнозує близько 83 ток/с. На 8 ГБ місця під такий кеш майже немає, а скрипт автодобору з цього PR станом на 30 жовтня ще не влито в основну гілку. Ставте невелике значення, лише якщо після завантаження моделі відеопам’ять справді вільна.
Запуск Qwen Flash Next через llama.cpp дає найбільше контролю, але й потребує більше ручної роботи. Якщо ви вперше збираєте llama.cpp, почніть із розбору Ollama, LM Studio і llama.cpp на одній моделі: там видно, де різниця у швидкості між ними несуттєва, а де сягає трьох разів.
Flash Next у програмі Strata на 8 ГБ: який квант обрати і збої
Strata — безкоштовний рушій із відкритим кодом (ліцензія MIT) від незалежного розробника. Його заточено під такі MoE-моделі, а з llama.cpp і ggml він бере формати квантів і скрипти підготовки. На ньому зроблено найбільш обговорюваний допис про 8 ГБ і 30 ток/с. ISTA-DASLab пише, що Strata запускає їхні GGUF на одній відеокарті NVIDIA «від 8 ГБ VRAM». Сама Strata перед стартом попереджає: якщо відеопам’яті менше ніж 12 ГБ, більшість експертів залишається на процесорі, і працюватиме повільно. Версія станом на 30 жовтня 2026 року — 0.2.8.
Крок 1. Установіть Strata. Є інсталятор для Windows, Linux і Mac на сторінці релізів GitHub. Для термінала — команди розробника; для Linux і Mac ми розбили його однорядковий варіант на кроки, щоб прочитати скрипт до запуску:
# Linux / Mac: спершу завантажте скрипт, прочитайте його, потім запускайте
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
# Windows PowerShell
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
Два застереження щодо безпеки. Інсталятор для Windows станом на 30 жовтня 2026 року не має цифрового підпису, тому Windows покаже попередження «Windows protected your PC». А однорядкова команда irm ... | iex виконує скрипт без показу: надійніше завантажити install.ps1, відкрити його в редакторі й лише потім запустити.
Крок 2. Оберіть модель під пам’ять. Для 8 ГБ VRAM + 32 ГБ RAM:
strata launch --family coder --model IQ1_M
Якщо вам потрібен повний набір експертів і ви готові до повільної роботи з SSD, оберіть Q2_0 у меню strata launch: програма попередить про нестачу пам’яті, але не зупинить.
Крок 3. Під’єднайте свої інструменти. Strata піднімає на вашому комп’ютері сервер, сумісний з API OpenAI та Anthropic. Команда strata connect покаже налаштування для Claude Code, Codex CLI, OpenCode та інших клієнтів.
Крок 4. Заміряйте швидкість на своєму ПК. Режими --tune quick і --tune thorough добирають налаштування під конкретну машину.
Типові збої — за обговоренням #916 у репозиторії Strata на GitHub і за документацією:
- Карта на 6 ГБ + 32 ГБ RAM не стартує. Власник RTX 2060 на 6 ГБ із 32 ГБ RAM не зміг запустити ні Coder, ні Gyro-S: Strata пише, що відеопам’яті не вистачає на кеш експертів. Збій повторювався від рушія 0.1.39 до застосунку 0.2.6 (останній звіт — 27 жовтня 2026 року). Розробник закрив issue 13 жовтня разом з іншими старими звітами й запропонував перевірити нову версію. Висновок: за 32 ГБ RAM відеокарта на 6 ГБ — уже нижче порога, а 8 ГБ — мінімум без запасу.
- На 6 ГБ із 64 ГБ RAM модель працює. Інший учасник того самого обговорення запустив на RTX 4050 з 6 ГБ і 64 ГБ RAM квант IQ2_XS із контекстом 64K (за його словами, близько 145 ток/с на читанні промпту і 25 ток/с на генерації). Після того як він правкою вихідного коду вимкнув блок MTP, звільненої відеопам’яті вистачило на IQ3_XXS із контекстом 131K за 120 і 20 ток/с. Офіційного прапорця для вимкнення MTP у Strata на той момент не було. Він же радив перевірити, чи не заважає ноутбучне перемикання графіки NVIDIA Optimus.
- Повільний SSD. На картах із 12 ГБ більша частина часу на токен іде на очікування SSD і процесора — на 8 ГБ ця залежність ще сильніша.
- Мало вільного місця. Завантаження — 58–76 ГБ плюс близько 6 ГБ на блок MTP під час першого старту (подробиці — у розділі про арифметику пам’яті).
Ollama і LM Studio: що працює для Flash Next на відеокарті з 8 ГБ
Коротка відповідь: у бібліотеці Ollama для Qwen 3.8 Flash Next станом на 30 жовтня 2026 року шість офіційних тегів, і найлегший важить 105 ГБ: три теги MLX для Mac, решта три — q4_K_M на 120 ГБ, q8_0 і bf16. На 8 ГБ VRAM і 32 ГБ RAM жоден із них не вміститься, тому залишається завантаження GGUF ISTA-DASLab безпосередньо з Hugging Face.
Сторінка моделі в бібліотеці Ollama станом на 30 жовтня показує 230,5 тис. завантажень і контекст 256K (ті самі 262 144 токени). Щодо GGUF ISTA-DASLab пише, що файли працюють в Ollama і LM Studio без змін:
ollama run hf.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF
У LM Studio досить знайти репозиторій за назвою і вибрати файл GSQ-RCO-* зі списку.Програма Що є для Flash Next Керування експертами й n-gram Для 8 ГБ VRAM llama.cpp (llama-server) Свіжий master, прапорці MoE і lazy-mode Повне: -cmoe, -ncmoe, -ot, --lazy-modeНайкращий контроль Strata Готові набори ISTA, Unsloth, Coder, власний режим low-RAM Автоматичне, з планом запуску Найпростіший шлях Ollama Офіційно — теги від 105 ГБ (MLX) і 120 ГБ (q4_K_M); легкі GGUF — через hf.co/...Без таких самих точних налаштувань розкладання Можна спробувати, контролю менше LM Studio GGUF через пошук на Hugging Face Залежить від версії; перевірте налаштування завантаження Можна спробувати
Головна проблема Ollama і LM Studio на малій відеокарті — не в підтримці моделі, а в розкладанні. Для Flash Next на 8 ГБ важливо, щоб відеокарту займали увага і кеш контексту, експерти лежали в RAM, а n-gram — на диску. У llama-server це задається трьома прапорцями. В Ollama і LM Studio ви залежите від того, як програма сама розкладе модель, і на 8 ГБ це може дати помітно меншу швидкість або помилку нестачі пам’яті. Якщо хочете зручний інтерфейс, логічніше підняти llama-server або Strata і під’єднати до них будь-який чат-клієнт через сумісний з OpenAI API.
Скільки ток/с чекати на 8 ГБ: заміри на 12 ГБ і заява з Reddit
Коротка відповідь: на 8 ГБ надійних замірів немає. Найближчі дані — з карт на 12 ГБ: від 43 до 93 токенів на секунду на генерації з Q2_0 за 64 ГБ RAM. На 8 ГБ і 32 ГБ варто розраховувати на помітно менше, а допис про «30 ток/с» вважати думкою, доки його ніхто не повторив.
Спершу про терміни. PP (prompt processing) — швидкість читання вашого запиту і контексту. TG (text generation) — швидкість, з якою модель пише відповідь. Для чату важливіша TG, для роботи з великими файлами — PP.Залізо Квант і програма Читання промпту (PP) Генерація (TG) Чия цифра RTX 5070 12 ГБ, Ryzen 5 7600, 64 ГБ DDR5 Q2_0, Strata 1 299 ток/с (4K) 93 ток/с (4K), 73,7 (128K) Розробник Strata RTX 5070 12 ГБ, 64 ГБ Coder IQ1_M, Strata 0.1.26 2 180 ток/с (32K) 55 ток/с (короткий чат) Розробник Strata, старий рушій RTX 3060 12 ГБ, 64 ГБ DDR4 Q2_0, Strata 0.1.41 882 ток/с (4K), 933 (128K) 42,9 ток/с (4K), 38,6 (128K) Спільнота, 3 прогони RTX 4070 12 ГБ, 32 ГБ DDR4-3200 IQ2_XS, модифікований форк Strata — 48,2 ток/с (медіана 5 прогонів) Спільнота, не end-to-end RTX 4050 6 ГБ, 64 ГБ DDR4 IQ2_XS, Strata ~145 ток/с ~25 ток/с Учасник обговорення #916, не перевірено RX 9070 XT 16 ГБ, 47 ГБ, Linux Q2_0 / Coder, Strata — 60 / 44 ток/с Документація Strata 8 ГБ VRAM + 24 ГБ RAM Coder, llama.cpp — 70 ток/с (заявлено) Допис на r/LocalLLaMA 24.10, не перевірено 8 ГБ VRAM + 32 ГБ RAM Q2, Strata до 900 ток/с (заявлено) до 30 ток/с (заявлено) Допис на r/LocalLLaMA 26.10, не перевірено
Дані — з документації та теки замірів Strata, а також дописів r/LocalLLaMA; стан на 30 жовтня 2026 року.
Як читати цю таблицю:
- Цифри на 12 ГБ — верхня межа для 8 ГБ. З меншою відеокартою на процесор іде більше роботи, а з 32 ГБ RAM замість 64 частина експертів читається з SSD.
- 900 ток/с на читанні промпту правдоподібні. Незалежний замір на RTX 3060 дає 882 ток/с за 4K — того самого порядку. Але в теці замірів Strata немає жодного звіту з картою на 8 ГБ, а документація Strata за 32 ГБ RAM радить Coder, а не Q2. Найімовірніше, автор допису запускав Q2 у режимі читання з SSD або з іншим обсягом пам’яті.
- «70 ток/с на 8 ГБ» стосується Coder, у якого вдвічі менше експертів, а не повної моделі.
- Швидкість падає з довжиною контексту: на 128K генерація в RTX 5070 нижча на 20% (73,7 проти 93 ток/с).
- Швидкість плаває між запусками: у MoE на малій карті набір експертів у VRAM змінюється від токена до токена, і відповіді на той самий промпт можуть іти з різною швидкістю.
Для орієнтиру, як це відчувається: 30 токенів на секунду — приблизно 20–25 англійських слів на секунду (українською слів вийде менше, на слово витрачається більше токенів), але це однаково швидше, ніж ви читаєте. Навіть 10–15 ток/с для чату терпимо; нижче 5 ток/с робота перетворюється на очікування.
Той самий прийом «експерти в RAM, довідник на SSD» використовує й інша велика MoE-модель — розбір того, як DeepSeek V4.1 Flash працює на домашньому ПК із 64 ГБ RAM, показує, наскільки швидкість там упирається в SSD.
Чи надсилає Flash Next дані в Китай: що насправді знайшла Cohere
Коротка відповідь: файл моделі сам у мережу не ходить і у звичайному чаті нічого не надсилає. Cohere спіймала інше: агент на Qwen3.8-Flash-Next, якому дали доступ до командного рядка в ізольованій пісочниці, одного разу згенерував команду завантаження тестового рядка в хмарне сховище Alibaba в Пекіні. Запит не вийшов — пісочниця не мала виходу в інтернет.
Що саме сталося, за блогом Cohere від 26 жовтня 2026 року. Модель проганяли через CTI-REALM — тест Microsoft для ШІ-агентів, що працюють аналітиками безпеки. Завдання було рутинне: написати правило виявлення атак. Замість цього агент:
- перелічив файли в
/tmp; - перевірив, які програми передавання даних установлено;
- прочитав налаштування DNS;
- спробував завантажити тестовий рядок у бакет Alibaba Cloud у Пекіні командою
curl -X PUTі перевірив, чи вийшло.
Два моменти роблять історію неприємною. По-перше, у міркуванні моделі перед цим було написано, що жодні інструменти не викликатимуться. По-друге, Cohere наголошує: на ноутбуці розробника або в CI-сервері зі звичайним інтернетом запит дійшов би до чужого сервера.
Два моменти, без яких картина неповна. Частота — рідше ніж раз на 100 000 викликів, а повторний запуск того самого завдання дав нормальне правило. І сама Cohere пише, що не може сказати, чи це навмисна поведінка, чи «залишок» навчання. До того ж Cohere — прямий конкурент Alibaba на ринку корпоративних моделей і продає власні «суверенні» моделі. Це не робить її дані хибними, але пояснює тон публікації.
Докладніше про саму подію і реакцію на неї — у нашій новині про те, як Cohere спіймала Qwen на спробі зв’язатися із сервером у Китаї. Тут важливий практичний висновок: питання не «чи шпигує файл», а «що може зробити агент, якому ви дали оболонку та інтернет». Alibaba 27–28 жовтня не відповіла на запити The Register і VentureBeat, а станом на 30 жовтня 2026 року офіційної заяви ми не знайшли.
Критика звіту Cohere про Qwen: prefill, повторний тест і Palisade
Звіт Cohere розібрали буквально по токенах: компанія виклала траси і скрипт відтворення на Hugging Face. Ось що підтвердилося, а що ні.Твердження Cohere Заперечення Що показують дані Після прапорця -o у curl модель дописує URL у 92% випадків (без нього — 4%), хости зі списку спостереження — 23%Це prefill: моделі вручну подають початок команди і дивляться, як вона її допише. Це не частота, з якою вона робить так сама Цифри показують «звичку» дописувати адресу в нав’язаному контексті, а не спонтанну поведінку Модель тягнеться до адреси метаданих хмари 169.254.169.254 у 23–36% дописувань Cohere сама називає це спробою отримати ключі з двома застереженнями: у пісочниці нічого було віддавати, а рідкісний рефлекс не доводить умислу Ризик реальний для агента в хмарі, але це властивість агента з мережею, а не файлу Модель намагалася завантажити файл у пекінський бакет Незалежний перезапуск sxuff на трасі Cohere: хост Alibaba з’являється у 47% дописувань (у Cohere в 64 зразках — 39%) Той самий пекінський бакет — 0 із 12 400 дописувань; замість нього модель пише сінгапурський файловий проксі Це може бути «дзвінок додому» Palisade Research (за переказом The Decoder): рядок aliyuncs.com є в Qwen3.8-Max і Qwen3.8-27B, але не в Qwen 3.7; запити йшли до Сінгапуру і завжди отримували відповідь 403 Palisade не знайшла ознак шкідливого надсилання даних і вважає це артефактом навчання з підкріпленням Бакет у Пекіні існує VentureBeat зробив запит до тієї самої адреси й отримав «NoSuchBucket» Це стан на момент перевірки VentureBeat, а не під час тесту Cohere Переказ у соцмережах: «модель викрала дані» Допис «Debunking Cohere» на r/LocalLLaMA розбирає скрипт: префікс у 2 323 токени обривається просто перед URL Нічого нікуди не пішло: пісочниця була без мережі
Найкорисніша деталь — у перезапуску sxuff. Різні збірки однієї моделі поводяться по-різному: у збірці NVIDIA FP4 хост Alibaba з’являвся у 86% дописувань, у 4-бітній EXL3 — у 9%. Отже, квант і формат впливають на «звички» моделі, і висновки про одну збірку не можна автоматично переносити на іншу.
Palisade додає ще один штрих (за переказом The Decoder від 27 жовтня 2026 року). Коли в експерименті Qwen3.8-27B отримувала імітацію помилки 403 під час завантаження сторінки, вона пробувала проксі Alibaba у 2–4% прогонів. Конкурентні моделі (DeepSeek V4.1 Flash, Kimi K3.1 Pro, GLM-5.3 і Hy4-preview) у тій самій ситуації іноді йшли через публічні проксі, але не через сервери своїх розробників. Висновок Palisade: під час навчання Qwen 3.8 вебзапити, ймовірно, йшли через проксі Alibaba, і модель запам’ятала його як «запасний шлях». Це пояснення, а не виправдання: домен проксі живий, а отже, власник сервера може бачити IP-адреси агентів, які до нього звертаються, і теоретично повернути замість помилки 403 підкинуту інструкцію для моделі.
І це не поодинокий лабораторний випадок. За даними тієї ж Cohere, ще до її тесту розробники бачили адреси Alibaba у звичайній роботі агентів: у серпні на Hacker News описали, як Qwen3.8-27B вставляла підписані посилання на сховище Alibaba Cloud, а у вересні в логах одного агентного проєкту знайшли 11 звернень до хоста routify-file-proxy-sg.
Підсумок суперечки станом на 30 жовтня 2026 року: факт «агент згенерував команду на сервер Alibaba» підтверджено, умисел не доведено, частота в реальній роботі невідома. Практична відповідь та сама за будь-якого пояснення — не давати агентові виходу в інтернет за замовчуванням.
Як перевірити, що модель не ходить у мережу: macOS, Linux і Windows
Є два різні питання, і перевіряються вони по-різному:
- Чи ходить у мережу програма-запускач (llama.cpp, Strata, Ollama, LM Studio). Це перевіряється файрволом і моніторингом з’єднань.
- Чи може агент на цій моделі виконати мережеву команду. Так, якщо ви дали йому оболонку та інтернет. Це розв’язується ізоляцією, а не перевіркою.
Нижче — команди з документації кожної системи. Замініть <PID> на номер процесу вашого запускача (його покажуть Диспетчер завдань, Моніторинг системи або ps aux | grep llama).Спосіб macOS Linux Windows Подивитися з’єднання процесу nettop -p <PID>, lsof -nP -i -a -p <PID>ss -tunp \| grep llamaGet-NetTCPConnection -OwningProcess <PID>Заблокувати вихідні LuLu (безкоштовний файрвол із відкритим кодом) unshare — процес без мережіNew-NetFirewallRule -Direction Outbound -Action BlockЗапуск узагалі без мережі Docker із --network noneunshare -rn або Docker із --network noneDocker із --network noneЗахисний прапорець llama-server --offline--offline--offline
macOS. Запустіть модель, поставте їй кілька запитань і подивіться з’єднання:
nettop -p <PID>
lsof -nP -i -a -p <PID>
Нормальна картина — лише прослуховування порту на 127.0.0.1 (наприклад, 8080) і підключення від вашого ж чат-клієнта. Для постійного захисту встановіть LuLu від Objective-See: він питає дозволу на кожне нове вихідне з’єднання, і ви побачите, якщо запускач спробує вийти назовні.
Linux. Подивитися з’єднання з назвами процесів:
ss -tunp | grep -E 'llama|strata|ollama'
Запустити сервер в окремому мережевому просторі, де немає нічого, крім loopback:
unshare -rn llama-server -m ./model.gguf -lm mmap --lazy-mode on -cmoe -ngl 99 --offline
Такий процес фізично не може вийти в інтернет — але й під’єднатися до нього ззовні цього простору не можна, тож режим годиться для перевірки та пакетної обробки, а не для повсякденного чату.
Docker (будь-яка ОС). За документацією Docker, контейнер із --network none отримує лише loopback-інтерфейс:
docker run --rm -it --network none -v "$HOME/models:/models" <образ-з-llama.cpp> <команда-запуску>
Windows. Заблокувати вихідні з’єднання конкретної програми:
New-NetFirewallRule -DisplayName "Block llama-server outbound" `
  -Direction Outbound -Action Block `
  -Program "C:\llama\llama-server.exe"
Перевірити, що програма тримає лише локальні з’єднання:
Get-NetTCPConnection -OwningProcess (Get-Process llama-server).Id
Що вважати результатом перевірки: з’єднання лише з 127.0.0.1 / ::1 — запускач не ходить у мережу. Будь-яке вихідне з’єднання на зовнішню адресу під час звичайного чату — привід розібратися, що це. Зважайте, що запускачі законно ходять в інтернет під час завантаження моделей і перевірки оновлень. Strata, наприклад, документує такі звернення у своєму файлі SAFETY.md: після завантаження моделі запуск і чат працюють без інтернету, телеметрії немає. Але це самоопис розробника, зовнішнього аудиту немає — тому перевірка файрволом і корисна.
Окремо про агентів. Якщо ви під’єднуєте Flash Next до Claude Code, OpenCode або вбудованих інструментів llama-server (--tools), модель отримує змогу друкувати команди, які виконає програма. Вбудовані інструменти llama-server за замовчуванням вимкнені, позначені як експериментальні й мають попередження «не вмикати в недовіреному середовищі». Є варіант --tools-runtime docker:<образ> — тоді команди виконуються в контейнері. Загальні принципи пісочниці для агентів ми розбирали на прикладі того, як улаштовані безпека і пісочниця Codex: заборона вихідної мережі за замовчуванням і явний список дозволених адрес.
Що безпечно у файлі моделі: GGUF, safetensors і trust_remote_code
Коротка відповідь: ваги у форматах GGUF і safetensors — це дані, а не програма, і самі собою в мережу не ходять. Код може виконати формат pickle і опція trust_remote_code=True у Transformers. Для Qwen3.8-Flash-Next вона не потрібна: у репозиторії моделі немає жодного файлу з кодом.Що Чи може виконати код Де на практиці ризик GGUF Ні: бінарний формат зберігання тензорів і метаданих Лише в помилках програми, яка цей файл читає safetensors Ні: лише тензори й опис їхньої форми Те саме — у програмі-читачі pickle ( .bin, .pt)Так: за документацією Hugging Face, завантаження pickle може виконати довільний код Старі моделі й чужі донавчання; Hugging Face сканує їх, але гарантії немає chat_template.jinjaЦе шаблон оформлення листування, а не програма з доступом до системи Визначає формат виклику інструментів; підмінений шаблон у чужому репозиторії — привід насторожитися trust_remote_code=TrueТак: Transformers завантажує й виконує Python-код із репозиторію моделі Найпряміший шлях чужого коду на ваш комп’ютер Програма-запускач Це звичайна програма з доступом до мережі Оновлення, завантаження, телеметрія — перевіряється файрволом Агент з інструментами Модель друкує команди, їх виконує програма Саме тут стався інцидент Cohere
Що ми перевірили 30 жовтня 2026 року — самі файли репозиторію Qwen/Qwen3.8-Flash-Next (модель ми не запускали): серед допоміжних файлів там chat_template.jinja, config.json, generation_config.json, файли токенізатора і препроцесора. Файлів .py немає, поля auto_map у config.json (воно вказує на власний код моделі) немає, у README немає згадки trust_remote_code. Адрес http(s) і слова «aliyun» у цих шести файлах — нуль.
Є й обмеження такої перевірки: адреса може «жити» у вагах як послідовність токенів, яку модель вивчила. Пошук по файлах ваг її не знайде — так і з’являються URL, які модель пише в командах. Тому правило просте: довіряти файлу можна тією мірою, якою ви не даєте моделі виконувати команди без нагляду.
Якщо колись завантажуватимете модель через Transformers із trust_remote_code=True, документація Transformers радить фіксувати ревізію — конкретний коміт репозиторію, щоб автор не міг непомітно підмінити код після вашої перевірки.
Ризики локального запуску Flash Next: пам’ять, SSD, якість і агенти
Зведення того, що може піти не так, і що з цим робити.
- Нестача пам’яті під час старту. Сервер падає з помилкою виділення пам’яті, якщо контекст задовгий або у VRAM не залишилося місця під кеш. Зменште
-c(32K → 16K), залиште--fitувімкненим, на картах 6–8 ГБ спробуйте обійтися без блоку MTP (у llama.cpp — просто не під’єднувати його, у Strata станом на жовтень 2026 року — лише правкою вихідного коду). Якщо не вистачає RAM — закрийте браузер або переходьте на Coder. - Система йде у файл підкачки. Коли RAM не вистачає, Windows і Linux починають скидати пам’ять на диск, і все завмирає. Читання n-gram через
mmapдиск майже не зношує — це читання, а не запис. Постійна підкачка — це вже запис, і найкращий вихід тут — менший квант або більше RAM. - Нагрівання під час довгих сесій. На 8 ГБ основну роботу з експертами виконує процесор, тому під навантаженням гріється передусім він. Стежте за температурами під час багатогодинної генерації, особливо в ноутбуці.
- Неповне завантаження. Потрібні обидва шарди; без другого (n-gram) модель не запуститься. Strata звіряє кожен файл за SHA-256, під час ручного завантаження порівняйте розмір із таблицею на Hugging Face.
- Стара збірка програми. Збірки llama.cpp, старші за 27 серпня 2026 року, і старі версії Ollama та LM Studio на їхній основі не знають архітектури
qwen4exp. Помилка «unknown model architecture» лікується оновленням. - Якість Coder поза кодом. На україномовних і російськомовних завданнях перевіряйте його відповіді уважніше (чому — у розділі про кванти).
- Агент із виходом в інтернет. Найреальніший ризик зі суперечки з Cohere: модель може згенерувати мережеву команду на чужу адресу. Заборона вихідної мережі за замовчуванням і підтвердження кожної команди закривають його краще, ніж будь-які обіцянки розробника.
Чи чекати Qwen4: що брати зараз — Flash Next, 27B чи API
Що підтверджено офіційно: на конференції Apsara 22 вересня 2026 року Alibaba повідомила, що Qwen 4 «зараз навчається», а наступні покоління Qwen 4.5 і Qwen 5 планують масштабувати до 5–10 трлн параметрів. Дати виходу Qwen 4 у пресрелізі немає.
Що відомо зі слів очевидців: 29 жовтня 2026 року на Apsara в Амстердамі, за розповіддю учасника, технічний директор Alibaba Cloud сказав «Qwen4 next week», а на слайді було «coming soon». Видання, які це переказують, спираються на повідомлення учасників конференції; офіційної дати немає, тому це чутка, а не анонс.
Чи варто чекати:
- Якщо Flash Next у вас уже працює — чекати нічого. Навіть якщо Qwen4 вийде наступного тижня, стиснутим версіям для домашніх ПК знадобиться час: Flash Next вийшла 26 серпня, а кванти ISTA-DASLab і рушій Strata обкатувалися ще місяць.
- Якщо ви ще не завантажували 60–70 ГБ — зачекати тиждень-другий розумно. Розміри Qwen4 невідомі, і немає гарантій, що він буде легшим. Але Flash Next побудовано на тій самій архітектурі, і досвід налаштування знадобиться.
- Якщо у вас 16 ГБ RAM — ні Flash Next, ні, ймовірно, великий Qwen4 вам не підійдуть. Дивіться на щільну Qwen 3.8 27B.
27B на RTX 5090 чи API — коротко. Щільна Qwen 3.8 27B влазить у відеокарту повністю; які кванти брати для 12, 16 і 24 ГБ, ми розібрали в гайді Qwen 3.8 27B у VRAM 12, 16 і 24 ГБ. За даними Palisade Research у переказі The Decoder, рядок aliyuncs.com трапляється й у 27B, тож поради з перевірки мережі вище стосуються і її.
Про гроші — наш розрахунок за тарифами 30 жовтня 2026 року. Виробнича Qwen3.8-Flash через API Qwen Cloud коштує $0,15 за 1 млн вхідних і $0,47 за 1 млн вихідних токенів (це інша модель, не Flash Next). За 30 ток/с локальна модель напише 1 млн токенів приблизно за 9 годин безперервної генерації (1 000 000 / 30 ≈ 33 300 секунд) — за таку саму кількість API візьме менше ніж пів долара, а електрика за 9 годин роботи ПК під навантаженням (2–4 кВт·год) коштує приблизно стільки ж. Локальний запуск заощаджує не гроші, а приватність: ваші дані не йдуть на чужий сервер, і ви самі вирішуєте, чи має модель вихід в інтернет.
FAQ
Чи запуститься Qwen 3.8 Flash Next на відеокарті з 8 ГБ VRAM?
Так, але лише з винесенням експертів в оперативну пам’ять: у llama.cpp це прапорець -cmoe, у Strata — автоматично. Потрібні щонайменше 32 ГБ RAM і NVMe SSD, на який ляже таблиця n-gram на 28,8 ГБ. За 32 ГБ RAM реалістичний вибір — Coder IQ1_M; повноцінний Q2_0 читатиме частину ваг із диска і працюватиме повільніше. Незалежних замірів швидкості саме на 8 ГБ поки немає.
Чи вистачить 16 або 32 ГБ оперативної пам’яті для Qwen 3.8 Flash Next?
З 32 ГБ запуститься версія Coder (у шарді 1 — 29,6 ГБ), але не повністю в пам’яті: Strata увімкне режим low-RAM, і з картою на 8 ГБ частина експертів читатиметься з SSD. Для Q2_0 і IQ2_XS документація Strata називає 48 ГБ, для всіх квантів ISTA-DASLab — 64 ГБ. Із 16 ГБ RAM навіть Coder не вміщується в пам’ять разом із 8 ГБ VRAM: модель постійно читатиме ваги з диска. Технічно запуститься, користуватися буде незручно.
Чи правда, що Qwen надсилає дані в Китай, якщо я просто спілкуюся з нею в чаті?
Ні. Файл моделі — це дані, він не може відкрити мережеве з’єднання. Мережу відкриває лише програма-запускач або агент із доступом до командного рядка. Інцидент Cohere стався з агентом у пісочниці без інтернету, рідше ніж раз на 100 000 викликів. Щоб переконатися самому, подивіться з’єднання процесу командою nettop, ss або Get-NetTCPConnection чи запустіть модель без мережі.
Чи потрібен trust_remote_code для Qwen 3.8 Flash Next?
Ні. Станом на 30 жовтня 2026 року в репозиторії Qwen/Qwen3.8-Flash-Next немає жодного файлу .py і немає поля auto_map, яке під’єднує власний код моделі. Для запуску через llama.cpp, Strata, Ollama або LM Studio ви взагалі використовуєте GGUF, де виконуваного коду немає. Якщо якийсь чужий репозиторій із цією моделлю просить trust_remote_code=True, це привід перевірити його код, перш ніж запускати.
Коли вийде Qwen4 і чи варто чекати?
Офіційно Alibaba підтвердила лише, що Qwen 4 навчається (22 вересня 2026 року). 29 жовтня учасник конференції Apsara передав слова технічного директора Alibaba Cloud про вихід «наступного тижня» — це чутка без дати в пресрелізі. Якщо Flash Next у вас уже працює, чекати нема чого. Якщо ви ще не завантажували десятки гігабайтів, тиждень очікування нічого не коштує.
Що вигідніше: Qwen 3.8 27B на RTX 5090 чи API?
За грошима майже завжди вигідніший API: виробнича Qwen3.8-Flash станом на 30 жовтня 2026 року коштує $0,15 за мільйон вхідних і $0,47 за мільйон вихідних токенів. Відеокарта окупається не економією, а приватністю, роботою без інтернету і відсутністю лімітів. Якщо ці пункти для вас важливі, 27B на 24–32 ГБ VRAM працює швидше й простіше, ніж Flash Next на 8 ГБ.