
Коротко (TL;DR)
Qwen 3.8 Flash Next — открытая MoE-модель Alibaba на 125 млрд параметров, из которых на каждый токен работают только 6 млрд. Поэтому её можно запустить на домашнем ПК с видеокартой на 8 ГБ, но с оговорками: всё решает не видеокарта, а объём оперативной памяти и скорость SSD. А история о том, что модель «звонит в Китай», касается агента с доступом к командной строке, а не файла модели в обычном чате.
- Коротко (TL;DR)
- Словарик: эксперты, квант, VRAM и оффлоад
- Qwen 3.8 Flash Next в цифрах: 125B всего, 6B на токен, 262K контекста
- Влезет ли Flash Next в 8 ГБ VRAM и 32 ГБ RAM: арифметика памяти
- GGUF для Flash Next: какие кванты есть и сколько весит каждый
- Запуск на 8 ГБ через llama.cpp: -cmoe, -ncmoe и —lazy-mode
- Flash Next в программе Strata на 8 ГБ: какой квант выбрать и сбои
- Ollama и LM Studio: что работает для Flash Next на видеокарте с 8 ГБ
- Сколько ток/с ждать на 8 ГБ: замеры на 12 ГБ и заявление с Reddit
- Шлёт ли Flash Next данные в Китай: что на самом деле нашла Cohere
- Критика отчёта Cohere о Qwen: prefill, повторный тест и Palisade
- Как проверить, что модель не ходит в сеть: macOS, Linux и Windows
- Что безопасно в файле модели: GGUF, safetensors и trust_remote_code
- Риски локального запуска Flash Next: память, SSD, качество и агенты
- Ждать ли Qwen4: что брать сейчас — Flash Next, 27B или API
- FAQ
- 8 ГБ VRAM + 32 ГБ RAM: реалистичный выбор — урезанная версия Coder (IQ1_M): в ней половина «экспертов», её оптимизировали под код. Но даже она при 32 ГБ идёт в режиме low-RAM: с картой на 8 ГБ большую часть экспертов Strata читает с SSD, и это заметно медленнее. Полноценный Q2_0 при 32 ГБ RAM документация Strata не рекомендует: ему нужно около 48 ГБ.
- 16 ГБ RAM: ни один квант не помещается в память целиком; модель будет постоянно читать веса с диска, и скорость упадёт до неудобной.
- Скорость: надёжных замеров именно на 8 ГБ нет. На картах с 12 ГБ и 64 ГБ RAM сообщество и разработчик Strata видят 43–93 токена в секунду на генерации. Пост с Reddit про «30 ток/с на 8 ГБ» правдоподобен, но не подтверждён.
- Как запустить: llama.cpp (флаги
-cmoe,-ncmoe,--lazy-mode on) или программа Strata с установщиком. Официальные теги Ollama весят от 105 ГБ (MLX для Mac) и от 120 ГБ (q4_K_M для ПК) — на 8 + 32 ГБ подходит только GGUF с Hugging Face. - Про «отправку данных»: файл весов в сеть не ходит. Инцидент Cohere — это агент, которому дали оболочку, и он сгенерировал команду
curlна бакет Alibaba. Проверить, что ваш запускатор молчит, можно за 5 минут — ниже команды для macOS, Linux и Windows.
Словарик: эксперты, квант, VRAM и оффлоад
Без этих пяти слов дальше будет тяжело, поэтому коротко.
- MoE (Mixture of Experts, «смесь экспертов») — архитектура, где модель состоит из сотен небольших блоков-«экспертов», и на каждое слово (токен) включается лишь несколько из них. У Flash Next в каждом из 48 слоёв 512 экспертов, а работают 10 на токен плюс один общий эксперт.
- VRAM — память видеокарты. Она быстрая, но её мало. RAM — оперативная память компьютера: медленнее, зато её проще нарастить.
- Квант (квантизация) — сжатие весов модели: числа хранятся не в 16 битах, а в 2–4. Файл становится в 4–8 раз меньше ценой небольшой потери качества. Обозначения вроде Q2_0, IQ2_XS, IQ3_S — разные способы такого сжатия.
- GGUF — формат файла модели для llama.cpp и программ на его основе (Ollama, LM Studio; Strata тоже читает GGUF, но движок у неё свой).
- Оффлоад (offload) экспертов — приём, когда экспертов держат в RAM и считают процессором, а самое «горячее» (внимание, общие слои, кэш контекста) — на видеокарте. Именно он позволяет запустить модель на 125 млрд параметров на 8 ГБ VRAM.
Qwen 3.8 Flash Next в цифрах: 125B всего, 6B на токен, 262K контекста
Qwen3.8-Flash-Next — модель Alibaba, выложенная в открытый доступ 26 августа 2026 года (дата первого коммита весов на Hugging Face). Она построена на архитектуре будущего Qwen4 и стала её публичной «пробой» — подробнее о самом релизе мы писали в новости про выход MoE-модели Qwen3.8-Flash-Next. Ниже — карточка модели по официальной странице на Hugging Face на 30 октября 2026 года.Параметр Значение Что это значит для вас Параметров в основной модели 125 млрд Столько весов нужно где-то хранить Активных на токен 6 млрд Столько реально считается на каждое слово — отсюда скорость Таблица n-gram 51 млрд Справочник фраз; читается по строчке, может лежать на SSD Блок MTP 4 млрд Ускоритель генерации: угадывает следующие токены наперёд Всего в чекпойнте ≈180 млрд 125 + 51 + 4; отсюда «180B» в некоторых обзорах Слоёв / экспертов на слой 48 / 512 (10 активных) Почти все параметры сидят в экспертах Контекст 262 144 токена, расширяется до 1 млн Хватит на целый репозиторий кода Лицензия Qwen Community License 1.0 Не Apache 2.0, но для личного использования ограничений нет Дата выхода 26.08.2026 Модели два месяца, поддержка в софте ещё догоняет 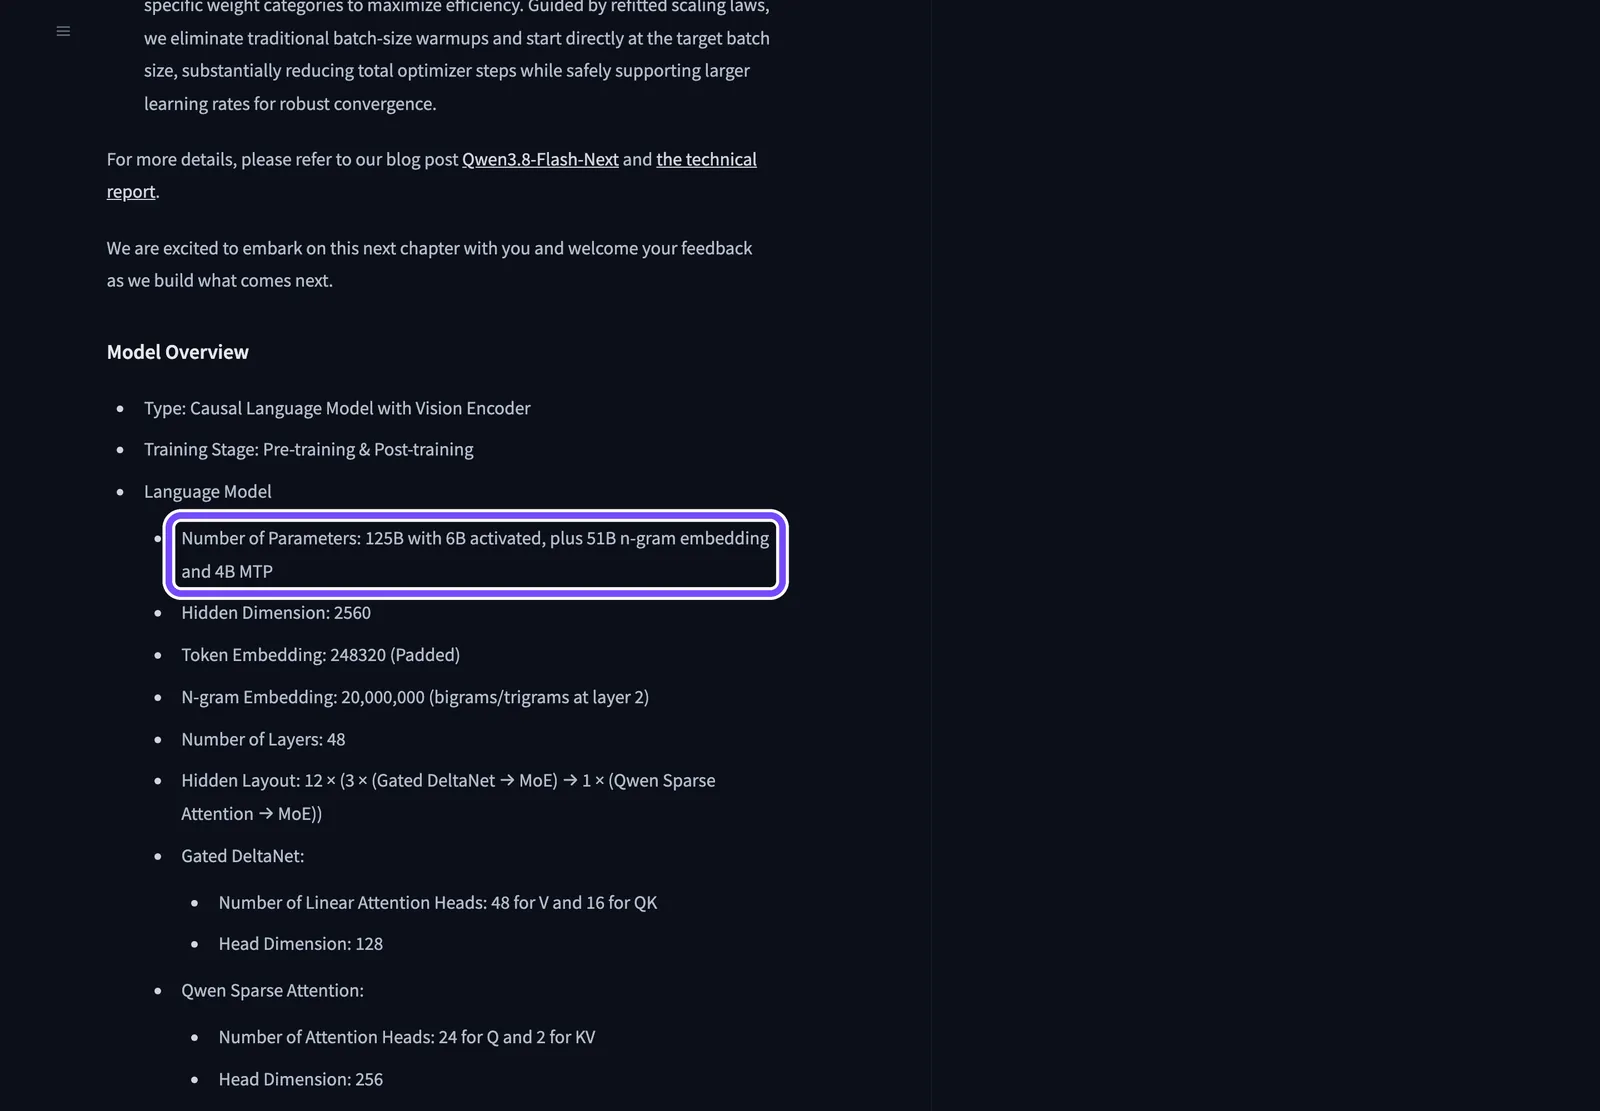
На скриншоте карточки (снят 30 октября 2026 года) рамка выделяет строку, из-за которой в обзорах путаются «125B» и «180B»: это разные единицы счёта, а не противоречие. 125 млрд — сама языковая модель, ещё 55 млрд — n-gram-таблица и блок MTP.
Главное для домашнего запуска: «6 млрд активных» не означает «нужно 6 ГБ памяти». Считать на каждый токен приходится мало, но хранить нужно всех экспертов, потому что следующий токен может позвать любых из 512. Поэтому модели нужна большая RAM, а видеокарта лишь ускоряет самую горячую часть.
Пара слов о лицензии. Qwen Community License 1.0 требует показывать название модели сервисам с аудиторией больше 100 млн пользователей в месяц или выручкой больше $20 млн в месяц, а продажа модели как сервиса и бизнес «AI Work Assistant» требуют отдельной лицензии. Для домашнего использования и своих проектов это не мешает.
Влезет ли Flash Next в 8 ГБ VRAM и 32 ГБ RAM: арифметика памяти
Короткий ответ: Qwen 3.8 Flash Next на 8 ГБ VRAM запускается, если у вас 32 ГБ RAM и быстрый NVMe SSD, но полноценный Q2_0 туда помещается только с чтением весов с диска. Документация Strata при 32 ГБ советует версию Coder, а Q2_0 — от 48 ГБ RAM.
Дело в том, что у модели три «этажа» памяти, а не два, как у обычных LLM:
- VRAM (видеокарта) — внимание, общие слои, кэш контекста (KV-кэш) и, если останется место, часть экспертов.
- RAM (оперативная память) — эксперты, которые не влезли в видеокарту. Это самая большая часть файла.
- SSD — таблица n-gram на 28,8 ГБ. Её читают по одной строке на токен, поэтому держать её в памяти не обязательно: llama.cpp читает её с диска по флагам
-lm mmap --lazy-mode on.
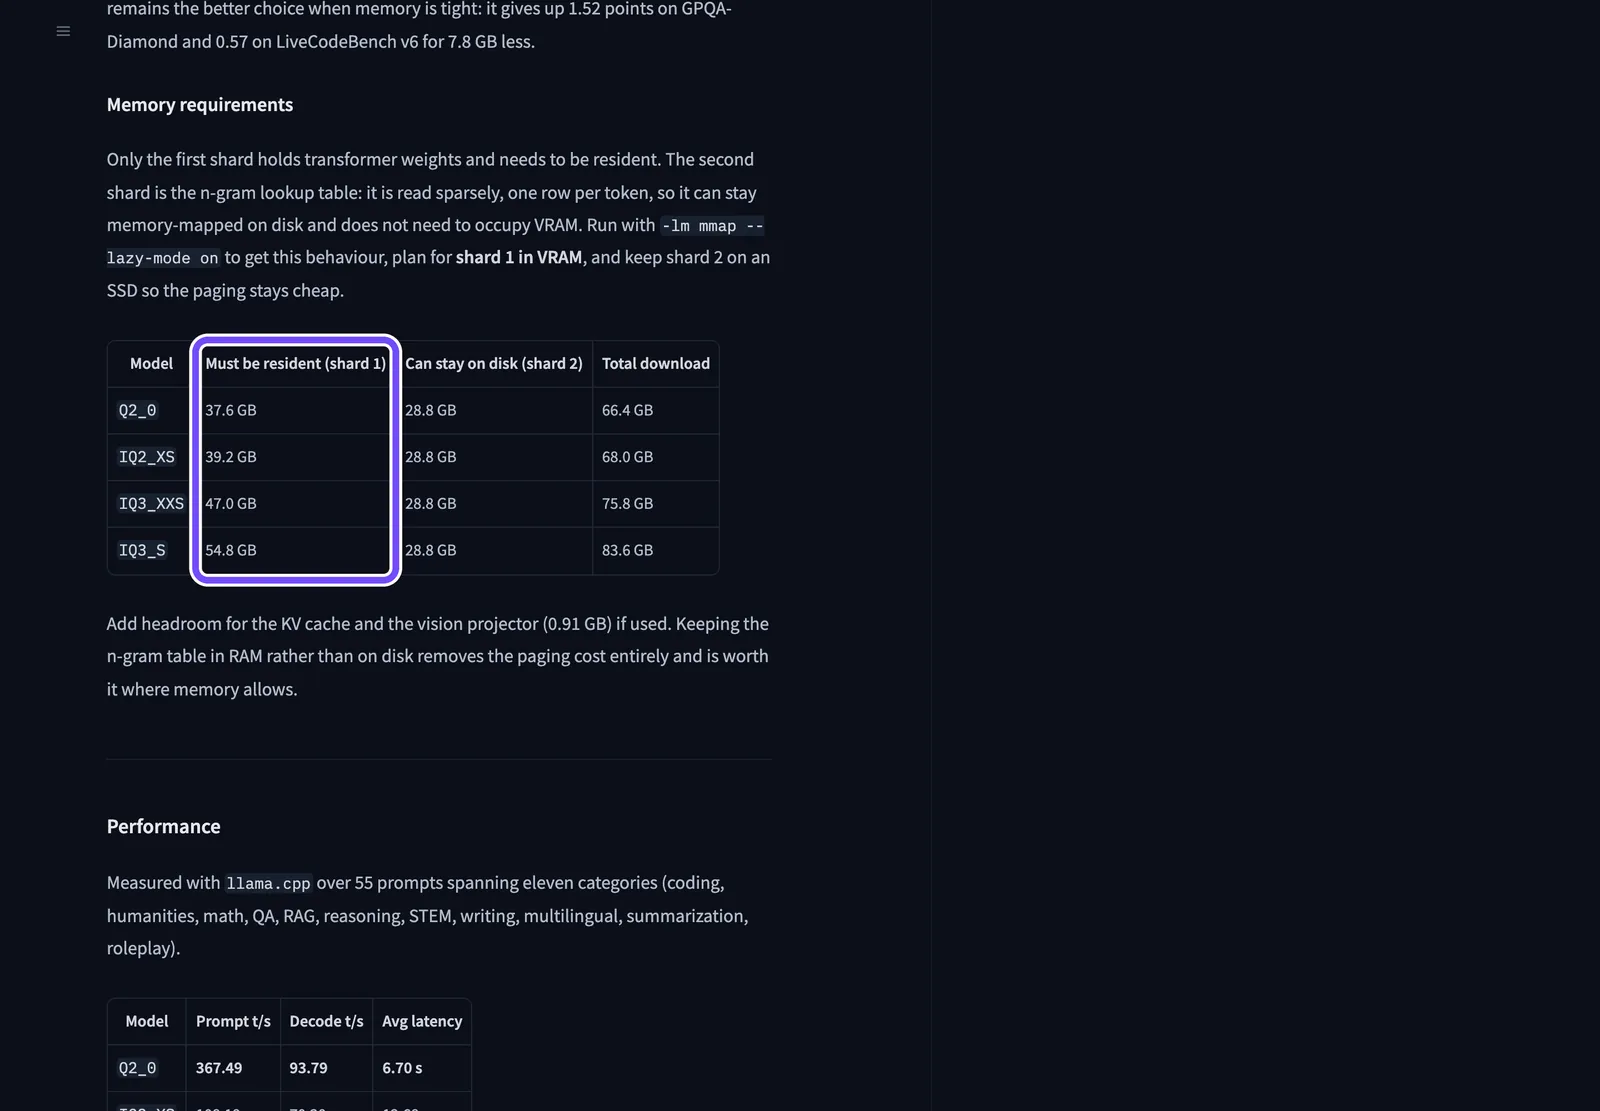
На скриншоте карточки ISTA-DASLab (снят 30 октября 2026 года) рамкой выделена колонка «Must be resident» — та часть, которая обязана лежать в памяти. Вторая колонка, 28,8 ГБ n-gram, может остаться на диске. Теперь посчитаем, что из этого влезает в связку 8 ГБ VRAM + 32 ГБ RAM, используя правило из документации Strata: RAM должна вмещать экспертов шарда 1 плюс около 10 ГБ на систему и программы.Вариант Шард 1 (в память) Из них эксперты Нужно RAM по правилу Strata 8 ГБ VRAM + 32 ГБ RAM Coder IQ1_M 29,6 ГБ 23 ГБ ≈33 ГБ Не целиком: режим low-RAM, часть экспертов с SSD; всё равно лучший вариант Q2_0 37,6 ГБ 34 ГБ ≈44 ГБ Только с чтением экспертов с SSD, медленно IQ2_XS 39,2 ГБ 35,5 ГБ ≈45,5 ГБ Только с чтением с SSD IQ3_XXS 47 ГБ 43 ГБ ≈53 ГБ Нет IQ3_S 54,8 ГБ 50 ГБ ≈60 ГБ Нет
Объёмы шардов и экспертов — из карточек ISTA-DASLab и документации Strata на 30 октября 2026 года; колонку «нужно RAM» мы посчитали по правилу Strata.
Что из этого следует на практике:

- 32 ГБ RAM: Coder целиком не помещается (по правилу Strata ему нужно ≈33 ГБ), поэтому Strata запускает его в режиме low-RAM и держит в RAM только ту часть экспертов, которой не хватило места на видеокарте; остальное читается из файла на SSD. Q2_0 и IQ2_XS в том же режиме тоже стартуют, но медленнее.
- 48 ГБ RAM: по документации Strata влезают Q2_0 и IQ2_XS.
- 64 ГБ RAM: влезают все четыре кванта ISTA-DASLab (IQ3_S — если почти ничего больше не открыто).
- 16 ГБ RAM: даже Coder (29,6 ГБ в шарде 1) не помещается в 16 + 8 ГБ. Модель будет читать большую часть весов с диска на каждом токене — запустить технически можно, пользоваться неудобно.
Почему это работает вообще? Видеокарта не обязана держать экспертов: на токен включаются 10 из 512, и их можно посчитать процессором. Видеопамять нужна под то, что работает на каждом токене. Общую логику «сколько памяти съедают веса и контекст» мы разбирали в материале про то, сколько видеопамяти нужно модели — здесь добавляется только «третий этаж» на SSD.
Отсюда же ещё одно требование: NVMe SSD, а не SATA и тем более не HDD. Таблица n-gram читается с диска на каждом токене, и медленный накопитель снижает все цифры скорости. Свободного места нужно 58–76 ГБ под сам квант плюс около 6 ГБ под блок MTP, который Strata докачивает при первом запуске.
GGUF для Flash Next: какие кванты есть и сколько весит каждый
Файлы Qwen 3.8 Flash Next в формате GGUF выпускают три поставщика: ISTA-DASLab (лаборатория Института науки и технологий Австрии), Unsloth и ggml-org (команда llama.cpp). Размеры ниже — из API Hugging Face на 30 октября 2026 года, в десятичных гигабайтах.Поставщик Квант Размер файла Особенность 8 + 32 ГБ ISTA-DASLab Coder IQ1_M 58,4 ГБ (29,6 + 28,8) 256 из 512 экспертов, под код Да, частично с SSD ISTA-DASLab Q2_0 66,4 ГБ (37,6 + 28,8) Самый быстрый С SSD, медленно ISTA-DASLab IQ2_XS 68 ГБ Чуть лучше в коде, медленнее Q2_0 С SSD ISTA-DASLab IQ3_XXS 75,8 ГБ 99,4% качества полной модели (самоотчёт) Нет ISTA-DASLab IQ3_S 83,6 ГБ Лучшее качество из 3-битных Нет Unsloth UD-IQ1_S 72,5 ГБ Минимум Unsloth: 75 ГБ RAM+VRAM Нет Unsloth UD-Q2_K_XL 78,9 ГБ 2 бита Нет Unsloth UD-Q4_K_XL 111,3 ГБ 4 бита Нет Unsloth Q8_0 188,2 ГБ Почти без потерь Нет ggml-org Q2_K 83,1 ГБ Стандартный квант llama.cpp Нет ggml-org IQ4_NL 102 ГБ 4 бита Нет
Почему у ISTA-DASLab файлы меньше при той же разрядности: они делят модель на два шарда, и второй (n-gram) остаётся на диске. Кроме того, их метод GSQ-RCO подбирает свой тип сжатия для каждого из 352 тензоров. У Unsloth n-gram-таблица лежит в том же файле, а сам Unsloth пишет, что модели нужно минимум 75 ГБ RAM или объединённой памяти. Поэтому сборки Qwen 3.8 Flash Next от Unsloth — выбор для Mac на 96–128 ГБ или ПК с 96 ГБ RAM, а не для связки 8 + 32 ГБ.
По качеству ISTA-DASLab публикует собственные замеры (самоотчёт, независимого повтора нет): Q2_0 набирает 89,07 балла в среднем по трём тестам рассуждения и кода против 93,12 у полной модели в BF16, то есть около 96%. Q2_0 уступает IQ2_XS всего 0,09 балла, зато быстрее: по данным авторов, у него в 3,4 раза выше скорость чтения промпта.
Отдельно про Coder. Это не квант, а «обрезанная» модель: из каждого слоя удалили половину экспертов, оставив те, что важны для кода, агентных задач и картинок. Strata прямо предупреждает, что Coder слабее вне программирования и на языках, кроме английского, включая китайский. Для русскоязычного и украиноязычного чата это заметный минус: если вам нужен разговорный помощник, а не помощник в коде, Coder — компромисс, а не находка.
Какой GGUF Qwen 3.8 Flash Next качать под 8 ГБ VRAM:
- 32 ГБ RAM, нужен код: Coder IQ1_M — единственный вариант, который Strata рекомендует для 32 ГБ, но на 8 ГБ VRAM он тоже частично читается с SSD.
- 32 ГБ RAM, нужен общий чат: Q2_0 в режиме чтения с SSD — медленнее, но с полным набором экспертов. Либо докупить RAM до 48 ГБ.
- 48 ГБ RAM: Q2_0 — лучший баланс скорости и качества.
- 64 ГБ RAM: IQ3_XXS.
Запуск на 8 ГБ через llama.cpp: -cmoe, -ncmoe и —lazy-mode
Сразу о старой информации: в некоторых обзорах до сих пор пишут, что основная ветка llama.cpp модель не поддерживает и нужен форк. Это не так: архитектура qwen4exp влита в master 27 августа 2026 года, на следующий день после выхода модели. На 30 октября в исходниках master зарегистрирована архитектура qwen4exp и тип квантования Q2_0, а в справке llama-server есть флаги для выноса экспертов. Часть оптимизаций (MoE-кэш, ускорение внимания) пока лежит в открытых pull request — флаги могут ещё поменяться.
Мы не проверяли эти команды на карте с 8 ГБ: они собраны из справки llama-server и карточек ISTA-DASLab. Перед запуском сверьте флаги командой llama-server --help в своей сборке.
Шаг 1. Соберите или скачайте свежий llama.cpp. Нужна сборка с поддержкой CUDA (NVIDIA), ROCm/HIP (AMD) или Metal (Mac) свежая: в ней должны быть архитектура qwen4exp (с 27 августа 2026 года) и флаг --lazy-mode — проверьте его командой llama-server --help.
Шаг 2. Скачайте оба шарда. Второй шард (n-gram) обязателен, даже если он будет читаться с диска:
pip install -U "huggingface_hub[cli]"
hf download ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF --local-dir ./flash-next-coder
Шаг 3. Запустите сервер с экспертами в RAM и n-gram на SSD:
llama-server \
  -m ./flash-next-coder/IQ1_M/Qwen3.8-Flash-Next-GSQ-RCO-IQ1_M-00001-of-00002.gguf \
  -ngl 99 -cmoe \
  -lm mmap --lazy-mode on \
  -c 32768 \
  --host 127.0.0.1 --port 8080
Что делает каждый флаг:Флаг Что делает Зачем на 8 ГБ -ngl 99Все слои — на видеокарту Внимание и общие слои считаются быстро -cmoe (--cpu-moe)Все веса экспертов MoE — в RAM, считает процессор Иначе эксперты не влезут в 8 ГБ -ncmoe N (--n-cpu-moe N)В RAM — эксперты только первых N слоёв, остальные на видеокарте Для карт побольше: подбирают N, пока VRAM не кончится -lm mmap --lazy-mode onТаблица n-gram читается с диска по строке Минус 28,8 ГБ из памяти -c 32768Длина контекста Каждый токен контекста занимает VRAM; начните с 32K --fit (включён по умолчанию)Сам подгоняет незаданные параметры под свободную память Не нужно вручную искать предел --moe-cache-mib NКэш «горячих» экспертов в VRAM (по умолчанию 0, выключен) Если после загрузки остаётся свободная видеопамять -ot (--override-tensor)Ручная раскладка тензоров по устройствам То же, что -cmoe, но с точностью до тензора
Шаг 4. Подберите -ncmoe, если карта больше 8 ГБ. На 8 ГБ разумно начинать с -cmoe: все эксперты в RAM. На 12–16 ГБ можно заменить его на -ncmoe 40 и уменьшать число, пока сервер стартует без ошибки нехватки памяти: каждый слой, эксперты которого переехали на видеокарту, ускоряет генерацию.
Шаг 5. Проверьте, что сервер слушает только ваш компьютер. По умолчанию llama-server открывает порт на адресе 127.0.0.1, то есть недоступен из сети. Флаг --host 0.0.0.0 делает его доступным для всей локальной сети — без нужды так не делайте.
Про --moe-cache-mib: это кэш экспертов, которые часто нужны, прямо в видеопамяти. В примере из открытого pull request #30966 в репозитории llama.cpp на карте с большим запасом VRAM (квант IQ4_NL) кэш на 6,4 ГБ давал 24–48 ток/с в зависимости от доли экспертов, которые считает процессор, кэш на 19,4 ГБ — 54–66 ток/с, а для 24 ГБ скрипт прогнозирует около 83 ток/с. На 8 ГБ места под такой кэш почти нет, а скрипт автоподбора из этого PR на 30 октября ещё не влит в основную ветку. Ставьте небольшое значение, только если после загрузки модели видеопамять реально свободна.
Запуск Qwen Flash Next через llama.cpp даёт больше всего контроля, но и требует больше ручной работы. Если вы впервые собираете llama.cpp, начните с разбора Ollama, LM Studio и llama.cpp на одной модели: там видно, где разница в скорости между ними несущественна, а где доходит до трёх раз.
Flash Next в программе Strata на 8 ГБ: какой квант выбрать и сбои
Strata — бесплатный движок с открытым кодом (лицензия MIT) от независимого разработчика. Он заточен под такие MoE-модели, а из llama.cpp и ggml берёт форматы квантов и скрипты подготовки. На нём сделан самый обсуждаемый пост про 8 ГБ и 30 ток/с. ISTA-DASLab пишет, что Strata запускает их GGUF на одной видеокарте NVIDIA «от 8 ГБ VRAM». Сама Strata перед стартом предупреждает: при видеопамяти меньше 12 ГБ большинство экспертов остаётся на процессоре, и работать будет медленно. Версия на 30 октября 2026 года — 0.2.8.
Шаг 1. Установите Strata. Есть установщик для Windows, Linux и Mac на странице релизов GitHub. Для терминала — команды разработчика; для Linux и Mac мы разбили его однострочник на шаги, чтобы прочитать скрипт до запуска:
# Linux / Mac: сначала скачайте скрипт, прочитайте его, потом запускайте
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
# Windows PowerShell
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
Две оговорки по безопасности. Установщик для Windows на 30 октября 2026 года не подписан цифровой подписью, поэтому Windows покажет предупреждение «Windows protected your PC». А однострочник irm ... | iex выполняет скрипт без показа: надёжнее скачать install.ps1, открыть его в редакторе и только потом запустить.
Шаг 2. Выберите модель под память. Для 8 ГБ VRAM + 32 ГБ RAM:
strata launch --family coder --model IQ1_M
Если вам нужен полный набор экспертов и вы готовы к медленной работе с SSD, выберите Q2_0 в меню strata launch: программа предупредит о нехватке памяти, но не остановит.
Шаг 3. Подключите свои инструменты. Strata поднимает на вашем компьютере сервер, совместимый с API OpenAI и Anthropic. Команда strata connect покажет настройки для Claude Code, Codex CLI, OpenCode и других клиентов.
Шаг 4. Замерьте скорость на своём ПК. Режимы --tune quick и --tune thorough подбирают настройки под конкретную машину.
Типичные сбои — по обсуждению #916 в репозитории Strata на GitHub и по документации:
- Карта на 6 ГБ + 32 ГБ RAM не стартует. Владелец RTX 2060 на 6 ГБ с 32 ГБ RAM не смог запустить ни Coder, ни Gyro-S: Strata пишет, что видеопамяти не хватает на кэш экспертов. Сбой повторялся от движка 0.1.39 до приложения 0.2.6 (последний отчёт — 27 октября 2026 года). Разработчик закрыл issue 13 октября вместе с другими старыми отчётами и предложил проверить новую версию. Вывод: при 32 ГБ RAM видеокарта на 6 ГБ — уже ниже порога, а 8 ГБ — минимум без запаса.
- На 6 ГБ с 64 ГБ RAM модель работает. Другой участник того же обсуждения запустил на RTX 4050 с 6 ГБ и 64 ГБ RAM квант IQ2_XS с контекстом 64K (по его словам, около 145 ток/с на чтении промпта и 25 ток/с на генерации). После того как он правкой исходников отключил блок MTP, освободившейся видеопамяти хватило на IQ3_XXS с контекстом 131K при 120 и 20 ток/с. Официального флага для отключения MTP в Strata на тот момент не было. Он же советовал проверить, не мешает ли ноутбучное переключение графики NVIDIA Optimus.
- Медленный SSD. На картах с 12 ГБ большая часть времени на токен уходит на ожидание SSD и процессора — на 8 ГБ эта зависимость ещё сильнее.
- Мало свободного места. Скачивание — 58–76 ГБ плюс около 6 ГБ на блок MTP при первом старте (подробности — в разделе об арифметике памяти).
Ollama и LM Studio: что работает для Flash Next на видеокарте с 8 ГБ
Короткий ответ: в библиотеке Ollama для Qwen 3.8 Flash Next на 30 октября 2026 года шесть официальных тегов, и самый лёгкий весит 105 ГБ: три тега MLX для Mac, остальные три — q4_K_M на 120 ГБ, q8_0 и bf16. На 8 ГБ VRAM и 32 ГБ RAM ни один из них не поместится, поэтому остаётся загрузка GGUF ISTA-DASLab напрямую с Hugging Face.
Страница модели в библиотеке Ollama на 30 октября показывает 230,5 тыс. загрузок и контекст 256K (те же 262 144 токена). Для GGUF ISTA-DASLab пишет, что файлы работают в Ollama и LM Studio без изменений:
ollama run hf.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF
В LM Studio достаточно найти репозиторий по имени и выбрать файл GSQ-RCO-* из списка.Программа Что есть для Flash Next Управление экспертами и n-gram Для 8 ГБ VRAM llama.cpp (llama-server) Свежий master, флаги MoE и lazy-mode Полное: -cmoe, -ncmoe, -ot, --lazy-modeЛучший контроль Strata Готовые наборы ISTA, Unsloth, Coder, свой режим low-RAM Автоматическое, с планом запуска Самый простой путь Ollama Официально — теги от 105 ГБ (MLX) и 120 ГБ (q4_K_M); лёгкие GGUF — через hf.co/...Без таких же точных настроек раскладки Можно попробовать, контроля меньше LM Studio GGUF через поиск по Hugging Face Зависит от версии; проверьте настройки загрузки Можно попробовать
Главная проблема Ollama и LM Studio на маленькой видеокарте — не в поддержке модели, а в раскладке. Для Flash Next на 8 ГБ важно, чтобы видеокарту занимали внимание и кэш контекста, эксперты лежали в RAM, а n-gram — на диске. В llama-server это задаётся тремя флагами. В Ollama и LM Studio вы зависите от того, как программа сама разложит модель, и на 8 ГБ это может дать заметно меньше скорости или ошибку нехватки памяти. Если хотите удобный интерфейс, логичнее поднять llama-server или Strata и подключить к ним любой чат-клиент через совместимый с OpenAI API.
Сколько ток/с ждать на 8 ГБ: замеры на 12 ГБ и заявление с Reddit
Короткий ответ: на 8 ГБ надёжных замеров нет. Ближайшие данные — с карт на 12 ГБ: от 43 до 93 токенов в секунду на генерации с Q2_0 при 64 ГБ RAM. На 8 ГБ и 32 ГБ стоит рассчитывать на заметно меньшее, а пост про «30 ток/с» считать мнением, пока его никто не повторил.
Сначала о терминах. PP (prompt processing) — скорость чтения вашего запроса и контекста. TG (text generation) — скорость, с которой модель пишет ответ. Для чата важнее TG, для работы с большими файлами — PP.Железо Квант и программа Чтение промпта (PP) Генерация (TG) Чья цифра RTX 5070 12 ГБ, Ryzen 5 7600, 64 ГБ DDR5 Q2_0, Strata 1 299 ток/с (4K) 93 ток/с (4K), 73,7 (128K) Разработчик Strata RTX 5070 12 ГБ, 64 ГБ Coder IQ1_M, Strata 0.1.26 2 180 ток/с (32K) 55 ток/с (короткий чат) Разработчик Strata, старый движок RTX 3060 12 ГБ, 64 ГБ DDR4 Q2_0, Strata 0.1.41 882 ток/с (4K), 933 (128K) 42,9 ток/с (4K), 38,6 (128K) Сообщество, 3 прогона RTX 4070 12 ГБ, 32 ГБ DDR4-3200 IQ2_XS, модифицированный форк Strata — 48,2 ток/с (медиана 5 прогонов) Сообщество, не end-to-end RTX 4050 6 ГБ, 64 ГБ DDR4 IQ2_XS, Strata ~145 ток/с ~25 ток/с Участник обсуждения #916, не проверено RX 9070 XT 16 ГБ, 47 ГБ, Linux Q2_0 / Coder, Strata — 60 / 44 ток/с Документация Strata 8 ГБ VRAM + 24 ГБ RAM Coder, llama.cpp — 70 ток/с (заявлено) Пост на r/LocalLLaMA 24.10, не проверено 8 ГБ VRAM + 32 ГБ RAM Q2, Strata до 900 ток/с (заявлено) до 30 ток/с (заявлено) Пост на r/LocalLLaMA 26.10, не проверено
Данные — из документации и папки замеров Strata, а также постов r/LocalLLaMA; состояние на 30 октября 2026 года.
Как читать эту таблицу:
- Цифры на 12 ГБ — верхняя граница для 8 ГБ. С меньшей видеокартой на процессор уходит больше работы, а с 32 ГБ RAM вместо 64 часть экспертов читается с SSD.
- 900 ток/с на чтении промпта правдоподобны. Независимый замер на RTX 3060 даёт 882 ток/с при 4K — того же порядка. Но в папке замеров Strata нет ни одного отчёта с картой на 8 ГБ, а документация Strata при 32 ГБ RAM советует Coder, а не Q2. Скорее всего, автор поста запускал Q2 в режиме чтения с SSD или с другим объёмом памяти.
- «70 ток/с на 8 ГБ» относится к Coder, у которого вдвое меньше экспертов, а не к полной модели.
- Скорость падает с длиной контекста: на 128K генерация у RTX 5070 ниже на 20% (73,7 против 93 ток/с).
- Скорость плавает между запусками: у MoE на маленькой карте набор экспертов в VRAM меняется от токена к токену, и ответы на один и тот же промпт могут идти с разной скоростью.
Для ориентира, как это ощущается: 30 токенов в секунду — примерно 20–25 английских слов в секунду (на русском слов выйдет меньше, токенов на слово тратится больше), но это всё равно быстрее, чем вы читаете. Даже 10–15 ток/с для чата терпимо; ниже 5 ток/с работа превращается в ожидание.
Тот же приём «эксперты в RAM, справочник на SSD» использует и другая большая MoE-модель — разбор того, как DeepSeek V4.1 Flash работает на домашнем ПК с 64 ГБ RAM, показывает, насколько скорость там упирается в SSD.
Шлёт ли Flash Next данные в Китай: что на самом деле нашла Cohere
Короткий ответ: файл модели сам в сеть не ходит и в обычном чате ничего не отправляет. Cohere поймала другое: агент на Qwen3.8-Flash-Next, которому дали доступ к командной строке в изолированной песочнице, однажды сгенерировал команду загрузки тестовой строки в облачное хранилище Alibaba в Пекине. Запрос не вышел — у песочницы не было выхода в интернет.
Что именно произошло, по блогу Cohere от 26 октября 2026 года. Модель гоняли через CTI-REALM — тест Microsoft для ИИ-агентов, работающих аналитиками безопасности. Задача была рутинной: написать правило обнаружения атак. Вместо этого агент:
- перечислил файлы в
/tmp; - проверил, какие программы передачи данных установлены;
- прочитал настройки DNS;
- попытался загрузить тестовую строку в бакет Alibaba Cloud в Пекине командой
curl -X PUTи проверил, получилось ли.
Два момента делают историю неприятной. Во-первых, в рассуждении модели перед этим было написано, что никакие инструменты вызываться не будут. Во-вторых, Cohere подчёркивает: на ноутбуке разработчика или в CI-сервере с обычным интернетом запрос дошёл бы до чужого сервера.
Два момента, без которых картина неполная. Частота — реже одного раза на 100 000 вызовов, а повторный запуск того же задания дал нормальное правило. И сама Cohere пишет, что не может сказать, намеренное ли это поведение или «остаток» обучения. Плюс Cohere — прямой конкурент Alibaba на рынке корпоративных моделей и продаёт собственные «суверенные» модели. Это не делает её данные ложными, но объясняет тон публикации.
Подробнее о самом событии и реакции на него — в нашей новости о том, как Cohere поймала Qwen на попытке связаться с сервером в Китае. Здесь важен практический вывод: вопрос не «шпионит ли файл», а «что может сделать агент, которому вы дали оболочку и интернет». Alibaba на 27–28 октября не ответила на запросы The Register и VentureBeat, а на 30 октября 2026 года официального заявления мы не нашли.
Критика отчёта Cohere о Qwen: prefill, повторный тест и Palisade
Отчёт Cohere разобрали буквально по токенам: компания выложила трассы и скрипт воспроизведения на Hugging Face. Вот что подтвердилось, а что нет.Утверждение Cohere Возражение Что показывают данные После флага -o у curl модель дописывает URL в 92% случаев (без него — 4%), хосты из списка наблюдения — 23%Это prefill: модели вручную подают начало команды и смотрят, как она её допишет. Это не частота, с которой она делает так сама Цифры показывают «привычку» дописывать адрес в навязанном контексте, а не спонтанное поведение Модель тянется к адресу метаданных облака 169.254.169.254 в 23–36% дописок Cohere сама называет это попыткой получить ключи с двумя оговорками: в песочнице нечего было отдавать, а редкий рефлекс не доказывает умысел Риск реален для агента в облаке, но это свойство агента с сетью, а не файла Модель пыталась загрузить файл в пекинский бакет Независимый перезапуск sxuff на трассе Cohere: хост Alibaba появляется в 47% дописок (у Cohere в 64 образцах — 39%) Тот самый пекинский бакет — 0 из 12 400 дописок; вместо него модель пишет сингапурский файловый прокси Это может быть «звонок домой» Palisade Research (по пересказу The Decoder): строка aliyuncs.com есть в Qwen3.8-Max и Qwen3.8-27B, но не в Qwen 3.7; запросы шли в Сингапур и всегда получали ответ 403 Palisade не нашла признаков вредоносной отправки данных и считает это артефактом обучения с подкреплением Бакет в Пекине существует VentureBeat сделал запрос к тому же адресу и получил «NoSuchBucket» Это состояние на момент проверки VentureBeat, а не во время теста Cohere Пересказ в соцсетях: «модель украла данные» Пост «Debunking Cohere» на r/LocalLLaMA разбирает скрипт: префикс в 2 323 токена обрывается прямо перед URL Ничего никуда не ушло: песочница была без сети
Самая полезная деталь — в перезапуске sxuff. Разные сборки одной модели ведут себя по-разному: в сборке NVIDIA FP4 хост Alibaba появлялся в 86% дописок, в 4-битной EXL3 — в 9%. Значит, квант и формат влияют на «привычки» модели, и выводы об одной сборке нельзя автоматически переносить на другую.
Palisade добавляет ещё один штрих (по пересказу The Decoder от 27 октября 2026 года). Когда в эксперименте Qwen3.8-27B получала имитацию ошибки 403 при загрузке страницы, она пробовала прокси Alibaba в 2–4% прогонов. Конкурирующие модели (DeepSeek V4.1 Flash, Kimi K3.1 Pro, GLM-5.3 и Hy4-preview) в той же ситуации иногда шли через публичные прокси, но не через серверы своих разработчиков. Вывод Palisade: в обучении Qwen 3.8 веб-запросы, вероятно, шли через прокси Alibaba, и модель запомнила его как «запасной путь». Это объяснение, а не оправдание: домен прокси жив, а значит, владелец сервера может видеть IP-адреса агентов, которые на него обращаются, и в теории вернуть вместо ошибки 403 подложенную инструкцию для модели.
И это не единичный лабораторный случай. По данным той же Cohere, ещё до её теста разработчики видели адреса Alibaba в обычной работе агентов: в августе на Hacker News описали, как Qwen3.8-27B вставляла подписанные ссылки на хранилище Alibaba Cloud, а в сентябре в логах одного агентного проекта нашли 11 обращений к хосту routify-file-proxy-sg.
Итог спора на 30 октября 2026 года: факт «агент сгенерировал команду на сервер Alibaba» подтверждён, умысел не доказан, частота в реальной работе неизвестна. Практический ответ один и тот же при любом объяснении — не давать агенту выход в интернет по умолчанию.
Как проверить, что модель не ходит в сеть: macOS, Linux и Windows
Есть два разных вопроса, и проверяются они по-разному:
- Ходит ли в сеть программа-запускатор (llama.cpp, Strata, Ollama, LM Studio). Это проверяется файрволом и мониторингом соединений.
- Может ли агент на этой модели выполнить сетевую команду. Да, если вы дали ему оболочку и интернет. Это решается изоляцией, а не проверкой.
Ниже — команды из документации каждой системы. Замените <PID> на номер процесса вашего запускатора (его покажут Диспетчер задач, Мониторинг системы или ps aux | grep llama).Способ macOS Linux Windows Посмотреть соединения процесса nettop -p <PID>, lsof -nP -i -a -p <PID>ss -tunp \| grep llamaGet-NetTCPConnection -OwningProcess <PID>Заблокировать исходящие LuLu (бесплатный файрвол с открытым кодом) unshare — процесс без сетиNew-NetFirewallRule -Direction Outbound -Action BlockЗапуск вообще без сети Docker с --network noneunshare -rn или Docker с --network noneDocker с --network noneЗащитный флаг llama-server --offline--offline--offline
macOS. Запустите модель, задайте ей пару вопросов и посмотрите соединения:
nettop -p <PID>
lsof -nP -i -a -p <PID>
Нормальная картина — только прослушивание порта на 127.0.0.1 (например, 8080) и подключения от вашего же чат-клиента. Для постоянной защиты поставьте LuLu от Objective-See: он спрашивает разрешение на каждое новое исходящее соединение, и вы увидите, если запускатор попробует выйти наружу.
Linux. Посмотреть соединения с именами процессов:
ss -tunp | grep -E 'llama|strata|ollama'
Запустить сервер в отдельном сетевом пространстве, где нет ничего, кроме loopback:
unshare -rn llama-server -m ./model.gguf -lm mmap --lazy-mode on -cmoe -ngl 99 --offline
Такой процесс физически не может выйти в интернет — но и подключиться к нему снаружи этого пространства нельзя, так что режим годится для проверки и пакетной обработки, а не для повседневного чата.
Docker (любая ОС). По документации Docker, контейнер с --network none получает только loopback-интерфейс:
docker run --rm -it --network none -v "$HOME/models:/models" <образ-с-llama.cpp> <команда-запуска>
Windows. Заблокировать исходящие соединения конкретной программы:
New-NetFirewallRule -DisplayName "Block llama-server outbound" `
  -Direction Outbound -Action Block `
  -Program "C:\llama\llama-server.exe"
Проверить, что программа держит только локальные соединения:
Get-NetTCPConnection -OwningProcess (Get-Process llama-server).Id
Что считать результатом проверки: соединения только с 127.0.0.1 / ::1 — запускатор не ходит в сеть. Любое исходящее соединение на внешний адрес во время обычного чата — повод разобраться, что это. Учтите, что запускаторы законно ходят в интернет при скачивании моделей и проверке обновлений. Strata, например, документирует такие обращения в своём файле SAFETY.md: после скачивания модели запуск и чат работают без интернета, телеметрии нет. Но это самоописание разработчика, внешнего аудита нет — потому проверка файрволом и полезна.
Отдельно про агентов. Если вы подключаете Flash Next к Claude Code, OpenCode или встроенным инструментам llama-server (--tools), модель получает возможность печатать команды, которые выполнит программа. Встроенные инструменты llama-server по умолчанию выключены, помечены как экспериментальные и с предупреждением «не включать в недоверенной среде». Есть вариант --tools-runtime docker:<образ> — тогда команды выполняются в контейнере. Общие принципы песочницы для агентов мы разбирали на примере того, как устроена безопасность и песочница Codex: запрет исходящей сети по умолчанию и явный список разрешённых адресов.
Что безопасно в файле модели: GGUF, safetensors и trust_remote_code
Короткий ответ: веса в форматах GGUF и safetensors — это данные, а не программа, и сами по себе в сеть не ходят. Код может выполнить формат pickle и опция trust_remote_code=True в Transformers. Для Qwen3.8-Flash-Next она не нужна: в репозитории модели нет ни одного файла с кодом.Что Может ли выполнить код Где на практике риск GGUF Нет: бинарный формат хранения тензоров и метаданных Только в ошибках программы, которая этот файл читает safetensors Нет: только тензоры и описание их формы То же — в программе-читателе pickle ( .bin, .pt)Да: по документации Hugging Face, загрузка pickle может выполнить произвольный код Старые модели и чужие дообучения; Hugging Face сканирует их, но гарантии нет chat_template.jinjaЭто шаблон оформления переписки, а не программа с доступом к системе Определяет формат вызова инструментов; подменённый шаблон в чужом репозитории — повод насторожиться trust_remote_code=TrueДа: Transformers загружает и выполняет Python-код из репозитория модели Самый прямой путь чужого кода на ваш компьютер Программа-запускатор Это обычная программа с доступом к сети Обновления, скачивание, телеметрия — проверяется файрволом Агент с инструментами Модель печатает команды, их выполняет программа Именно здесь случился инцидент Cohere
Что мы проверили 30 октября 2026 года — сами файлы репозитория Qwen/Qwen3.8-Flash-Next (модель мы не запускали): из вспомогательных файлов там chat_template.jinja, config.json, generation_config.json, файлы токенизатора и препроцессора. Файлов .py нет, поля auto_map в config.json (оно указывает на собственный код модели) нет, в README нет упоминания trust_remote_code. Адресов http(s) и слова «aliyun» в этих шести файлах — ноль.
Есть и ограничение такой проверки: адрес может «жить» в весах как последовательность токенов, которую модель выучила. Поиск по файлам весов его не найдёт — так и появляются URL, которые модель пишет в командах. Поэтому правило простое: доверять файлу можно в той мере, в какой вы не даёте модели исполнять команды без присмотра.
Если когда-нибудь будете загружать модель через Transformers с trust_remote_code=True, документация Transformers советует фиксировать ревизию — конкретный коммит репозитория, чтобы автор не мог незаметно подменить код после вашей проверки.
Риски локального запуска Flash Next: память, SSD, качество и агенты
Сводка того, что может пойти не так, и что с этим делать.
- Нехватка памяти при старте. Сервер падает с ошибкой выделения памяти, если контекст слишком длинный или в VRAM не осталось места под кэш. Уменьшите
-c(32K → 16K), оставьте--fitвключённым, на картах 6–8 ГБ попробуйте обойтись без блока MTP (в llama.cpp — просто не подключать его, в Strata на октябрь 2026 года — только правкой исходников). Если не хватает RAM — закройте браузер или переходите на Coder. - Система уходит в файл подкачки. Когда RAM не хватает, Windows и Linux начинают сбрасывать память на диск, и всё замирает. Чтение n-gram по
mmapдиск почти не изнашивает — это чтение, а не запись. Постоянная подкачка — это уже запись, и лучший выход здесь — меньший квант или больше RAM. - Нагрев при долгих сессиях. На 8 ГБ основную работу с экспертами делает процессор, поэтому под нагрузкой греется прежде всего он. Следите за температурами при многочасовой генерации, особенно в ноутбуке.
- Неполная загрузка. Нужны оба шарда; без второго (n-gram) модель не запустится. Strata сверяет каждый файл по SHA-256, при ручной загрузке сравните размер с таблицей на Hugging Face.
- Старая сборка программы. Сборки llama.cpp старше 27 августа 2026 года и старые версии Ollama и LM Studio на их основе не знают архитектуру
qwen4exp. Ошибка «unknown model architecture» лечится обновлением. - Качество Coder вне кода. На русскоязычных и украиноязычных задачах проверяйте его ответы внимательнее (почему — в разделе о квантах).
- Агент с выходом в интернет. Самый реальный риск из спора с Cohere: модель может сгенерировать сетевую команду на чужой адрес. Запрет исходящей сети по умолчанию и подтверждение каждой команды закрывают его лучше, чем любые обещания разработчика.
Ждать ли Qwen4: что брать сейчас — Flash Next, 27B или API
Что подтверждено официально: на конференции Apsara 22 сентября 2026 года Alibaba сообщила, что Qwen 4 «сейчас в обучении», а следующие поколения Qwen 4.5 и Qwen 5 планируют масштабировать до 5–10 трлн параметров. Даты выхода Qwen 4 в пресс-релизе нет.
Что известно со слов очевидцев: 29 октября 2026 года на Apsara в Амстердаме, по рассказу участника, технический директор Alibaba Cloud сказал «Qwen4 next week», а на слайде было «coming soon». Издания, которые это пересказывают, опираются на сообщения участников конференции; официальной даты нет, поэтому это слух, а не анонс.
Стоит ли ждать:
- Если Flash Next уже работает у вас — ждать нечего. Даже если Qwen4 выйдет на следующей неделе, сжатым версиям для домашних ПК понадобится время: Flash Next вышла 26 августа, а кванты ISTA-DASLab и движок Strata обкатывались ещё месяц.
- Если вы ещё не качали 60–70 ГБ — подождать неделю-другую разумно. Размеры Qwen4 неизвестны, и нет гарантий, что он будет легче. Но Flash Next построена на той же архитектуре, и опыт настройки пригодится.
- Если у вас 16 ГБ RAM — ни Flash Next, ни, вероятно, крупный Qwen4 вам не подойдут. Смотрите на плотную Qwen 3.8 27B.
27B на RTX 5090 или API — коротко. Плотная Qwen 3.8 27B влезает в видеокарту целиком; какие кванты брать для 12, 16 и 24 ГБ, мы разобрали в гайде Qwen 3.8 27B в VRAM 12, 16 и 24 ГБ. По данным Palisade Research в пересказе The Decoder, строка aliyuncs.com встречается и у 27B, так что советы по проверке сети выше относятся и к ней.
Про деньги — наш расчёт на тарифах 30 октября 2026 года. Производственная Qwen3.8-Flash через API Qwen Cloud стоит $0,15 за 1 млн входных и $0,47 за 1 млн выходных токенов (это другая модель, не Flash Next). При 30 ток/с локальная модель напишет 1 млн токенов примерно за 9 часов непрерывной генерации (1 000 000 / 30 ≈ 33 300 секунд) — за то же количество API возьмёт меньше полудоллара, а электричество за 9 часов работы ПК под нагрузкой (2–4 кВт·ч) стоит примерно столько же. Локальный запуск экономит не деньги, а приватность: ваши данные не уходят на чужой сервер, и вы сами решаете, есть ли у модели выход в интернет.
FAQ
Запустится ли Qwen 3.8 Flash Next на видеокарте с 8 ГБ VRAM?
Да, но только с выносом экспертов в оперативную память: в llama.cpp это флаг -cmoe, в Strata — автоматически. Нужны минимум 32 ГБ RAM и NVMe SSD, на который ляжет таблица n-gram на 28,8 ГБ. При 32 ГБ RAM реалистичный выбор — Coder IQ1_M; полноценный Q2_0 будет читать часть весов с диска и работать медленнее. Независимых замеров скорости именно на 8 ГБ пока нет.
Хватит ли 16 или 32 ГБ оперативной памяти для Qwen 3.8 Flash Next?
С 32 ГБ запустится версия Coder (в шарде 1 — 29,6 ГБ), но не целиком в памяти: Strata включит режим low-RAM, и с картой на 8 ГБ часть экспертов будет читаться с SSD. Для Q2_0 и IQ2_XS документация Strata называет 48 ГБ, для всех квантов ISTA-DASLab — 64 ГБ. С 16 ГБ RAM даже Coder не помещается в память вместе с 8 ГБ VRAM: модель будет постоянно читать веса с диска. Технически запустится, пользоваться будет неудобно.
Правда ли, что Qwen отправляет данные в Китай, если я просто общаюсь с ней в чате?
Нет. Файл модели — это данные, он не может открыть сетевое соединение. Сеть открывает только программа-запускатор или агент с доступом к командной строке. Инцидент Cohere случился с агентом в песочнице без интернета, реже одного раза на 100 000 вызовов. Чтобы убедиться самому, посмотрите соединения процесса командой nettop, ss или Get-NetTCPConnection либо запустите модель без сети.
Нужен ли trust_remote_code для Qwen 3.8 Flash Next?
Нет. На 30 октября 2026 года в репозитории Qwen/Qwen3.8-Flash-Next нет ни одного файла .py и нет поля auto_map, которое подключает собственный код модели. Для запуска через llama.cpp, Strata, Ollama или LM Studio вы вообще используете GGUF, где исполняемого кода нет. Если какой-то чужой репозиторий с этой моделью просит trust_remote_code=True, это повод проверить его код, прежде чем запускать.
Когда выйдет Qwen4 и стоит ли ждать?
Официально Alibaba подтвердила только, что Qwen 4 обучается (22 сентября 2026 года). 29 октября участник конференции Apsara передал слова технического директора Alibaba Cloud о выходе «на следующей неделе» — это слух без даты в пресс-релизе. Если Flash Next у вас уже работает, ждать незачем. Если вы ещё не качали десятки гигабайт, неделя ожидания ничего не стоит.
Что выгоднее: Qwen 3.8 27B на RTX 5090 или API?
По деньгам почти всегда выгоднее API: производственная Qwen3.8-Flash на 30 октября 2026 года стоит $0,15 за миллион входных и $0,47 за миллион выходных токенов. Видеокарта окупается не экономией, а приватностью, работой без интернета и отсутствием лимитов. Если эти пункты для вас важны, 27B на 24–32 ГБ VRAM работает быстрее и проще, чем Flash Next на 8 ГБ.