
У Claude Code з вересня 2026 року є вбудована команда /skill-doctor, і її легко сплутати з однойменними сторонніми скілами Skill Doctor — від Warp і незалежних авторів. Вбудований Skill Doctor відповідає на одне питання: скільки контексту з’їдає кожен скіл і чи викликали його взагалі. Застарілі й суперечливі правила в CLAUDE.md шукає інша команда — /doctor prompt-audit. Нижче — мапа всіх інструментів аудиту, наші прогони на Claude Code 2.1.316 від 2 листопада 2026 року і порядок чищення, після якого агент не стає дурнішим.
- Коротко (TL;DR)
- Skill Doctor, /doctor і prompt-audit: що перевіряє кожен
- Чому невикористаний скіл однаково коштує контексту
- Звіт /skill-doctor: як читати колонки і що з ним робити
- Аудит CLAUDE.md командою prompt-audit: розбір реального звіту
- Чищення CLAUDE.md і скілів за кроками: що вирізати, що винести в хук
- Перевірка самих скілів: plugin validate, eval і ручний тест
- Ризики аудиту: де він помиляється і чого не можна вирізати
- Сторонні skill-doctor і claude-md-improver: коли вони потрібні
- Як часто аудитувати скіли й CLAUDE.md: ритм і чек-лист
- FAQ
Коротко (TL;DR)
/skill-doctor— звіт «ціна і виклики»: скільки токенів кожен скіл займає в списку на кожному ході і скільки разів ним користувалися. Користі скіла і CLAUDE.md він не оцінює. Команда вийшла у версії 2.1.261 (4 вересня 2026), документація називає поріг 2.1.252./doctor prompt-audit— аудит тексту інструкцій: застарілі формулювання, шляхи й команди, яких немає, суперечності. З’явився у 2.1.283 (25 вересня 2026), файли сам не править.claude plugin validateловить зламаний frontmatter у SKILL.md,claude plugin evalпорівнює прогони з плагіном і без нього.- Наші прогони 02.11.2026: prompt-audit знайшов 8 проблем у пісочниці за 66 секунд і $0.89; validate завершився з кодом 1 на зламаному YAML;
/skill-doctorу свіжому середовищі показав у всіх скілів «0×, never» — це відсутність історії, а не вирок. - Головне «навіщо»: дослідження Databricks показало, що велика бібліотека скілів шкодить насамперед тим, що агент обирає не той скіл. Тому описи на перетин важливіші за економію токенів.
- Ритм: побіжний погляд на
/skill-doctorі/contextраз на місяць, повний prompt-audit — після зміни моделі, великого оновлення або пачки нових скілів.
П’ять термінів, на яких тримається текст. Контекст — усе, що модель бачить на поточному ході: системні інструкції, ваш CLAUDE.md, історію діалогу. Токен — одиниця рахунку тексту для моделі, приблизно 3–4 символи англійського тексту. Скіл — тека з файлом SKILL.md: короткий опис «коли мене кликати» плюс інструкція, яку Claude підвантажує на вимогу. Frontmatter — службовий блок на початку SKILL.md між лініями --- з полями name і description. CLAUDE.md — файл правил проєкту, який Claude Code читає на початку кожної сесії.
Skill Doctor, /doctor і prompt-audit: що перевіряє кожен
Вбудований Skill Doctor у Claude Code — не «лікар від усього». Кожен із п’яти інструментів закриває своє вузьке завдання, і жоден не відповідає на питання, чи корисний конкретний скіл. Плутанину посилюють дві обставини: сторонні скіли на GitHub і в каталогах мають те саме ім’я, а prompt-audit доступний через дві різні команди.Інструмент Що перевіряє Чого НЕ перевіряє Версія Ціна прогону за замірами /skill-doctorвагу кожного скіла в списку, кількість викликів, дату останнього виклику, давно не використані плагіни користь скіла, перетин описів, CLAUDE.md, синтаксис SKILL.md 2.1.261 (вийшла 04.09.2026); документація: від 2.1.252 н/д /doctor (чекап, аліас /checkup)встановлення, невикористані скіли, MCP-сервери й плагіни проти їхньої ваги, повільні хуки, дублікати CLAUDE.md і те, що Claude виведе з коду сам суперечності й застарілі формулювання н/д н/д /doctor prompt-auditзастарілі інструкції, зламані шляхи й команди, суперечності в CLAUDE.md, скілах, субагентах, командах частоту використання, вагу скілів 2.1.283 (25.09.2026) у нас $0.89 за 66 с; у bestagent.dev $0.41–0.75 claude plugin validateчи парситься YAML у frontmatter, чи є опис, чи коректний маніфест плагіна зміст опису і спрацьовування 2.1.233+ н/д claude plugin evalякість роботи плагіна: кожен кейс проганяється з плагіном і без, результат оцінюється CLAUDE.md; без набору кейсів в evals/ перевіряти нічого2.1.269 залежить від кількості кейсів
Окремо стоїть /claude-api prompt-audit: він з’явився раніше, у 2.1.221 (4 серпня 2026), і перевіряє промпти вашого застосунку, який звертається до Claude API, а не налаштування Claude Code. Методика в обох команд спільна — файл prompt-audit.md у репозиторії anthropics/skills.



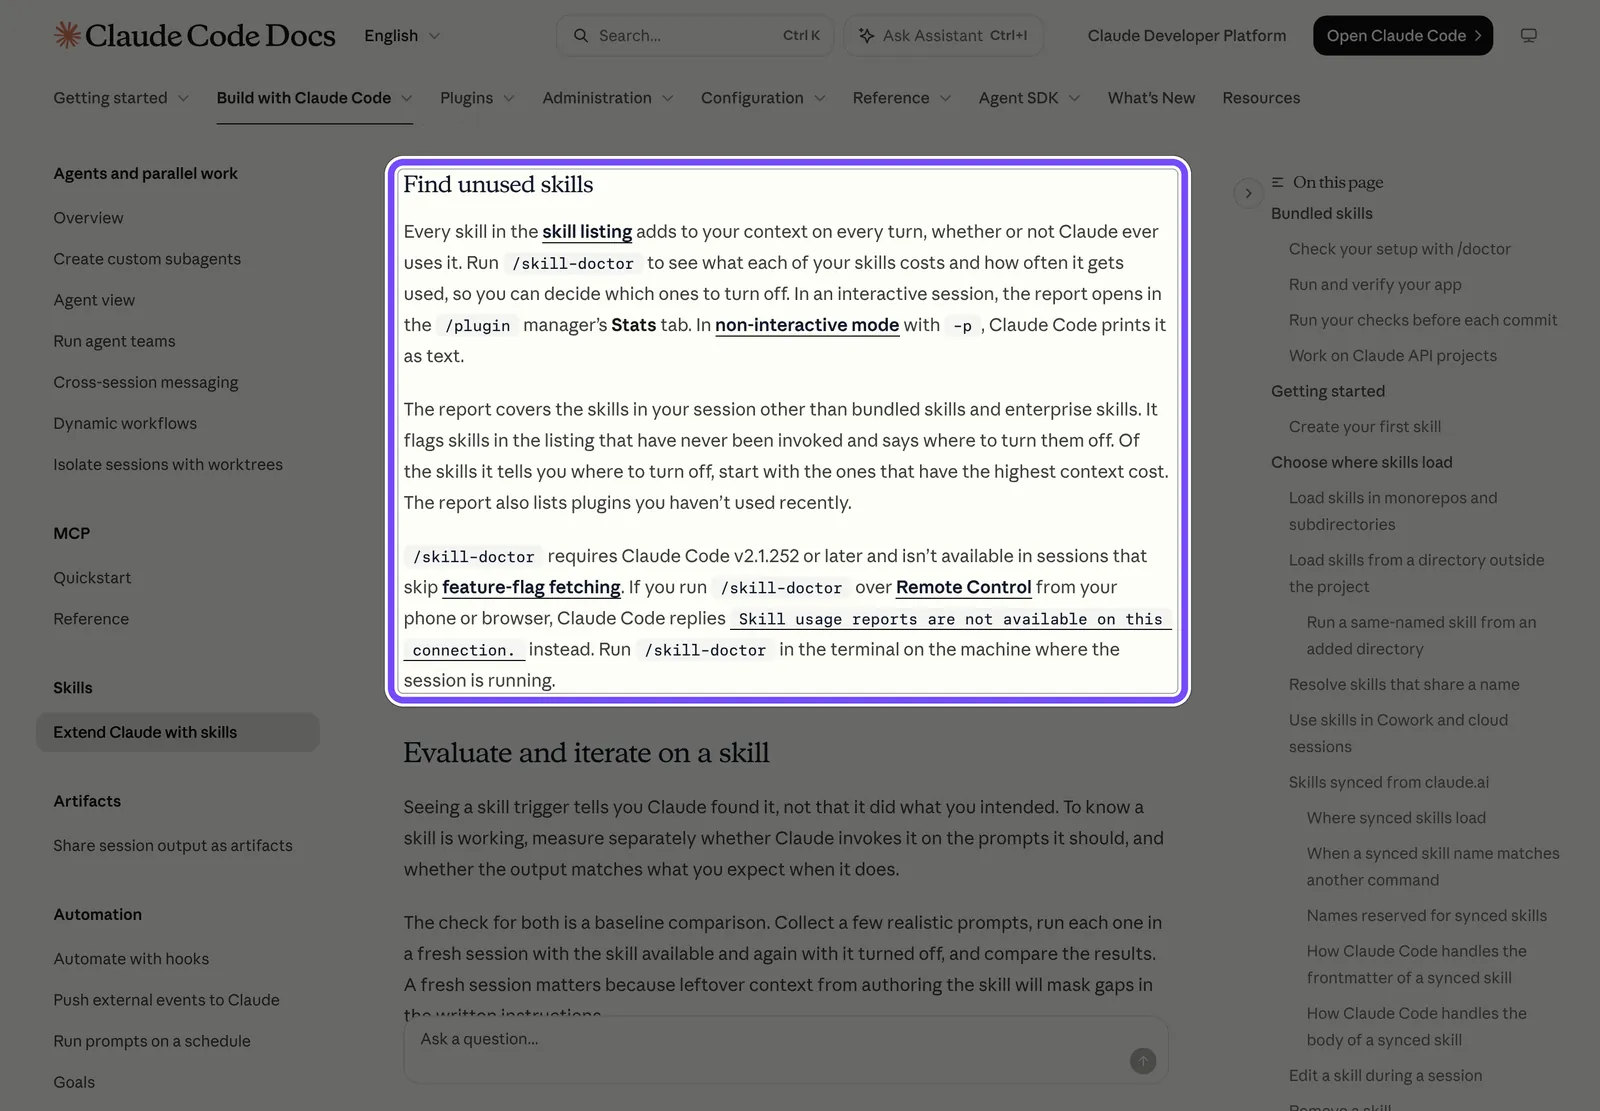
Кадр із документації Claude Code, знятий 2 листопада 2026 року: рамкою виділено розділ «Find unused skills». У ньому три речі, які варто знати заздалегідь. В інтерактивній сесії звіт відкривається на вкладці Stats менеджера /plugin, із прапорцем -p друкується текстом. Вбудовані (bundled) і корпоративні скіли до звіту не потрапляють. Через Remote Control із телефона чи з браузера команда не працює і відповідає рядком «Skill usage reports are not available on this connection.» — запускати її треба в терміналі тієї машини, де йде сесія.
Чому невикористаний скіл однаково коштує контексту
Claude Code завантажує скіли у два шари — це і є прогресивне завантаження, яке ми розбирали в матеріалі про Agent Skills у Claude Code. Перший шар — список імен і описів — іде моделі на кожному ході, щоб Claude знав, що в нього є. Другий шар — тіло SKILL.md — підвантажується лише під час виклику. Отже, скіл, який не викликали жодного разу, однаково платить своїм описом за кожне ваше повідомлення.Що Коли потрапляє в контекст Обмеження за документацією (02.11.2026) Ім’я скіла на кожному ході, завжди — Опис ( description + when_to_use)на кожному ході, поки вміщується в бюджет до 1 536 символів на скіл, налаштування skillListingMaxDescCharsУвесь список описів на кожному ході бюджет 1% вікна контексту, налаштування skillListingBudgetFractionТіло SKILL.md лише після виклику після компакції — перші 5 000 токенів скіла, на всі скіли разом 25 000
Коли список не вміщується в бюджет, Claude Code викидає описи скілів, які ви викликаєте найрідше. Ім’я лишається, а ключові слова, за якими Claude добирає скіл під запит, зникають. Компакція — це автоматичне стискання довгого діалогу, щоб звільнити вікно. Після неї Claude Code знову додає викликані скіли, але лише перші 5 000 токенів кожного і не більше 25 000 на всі разом, починаючи з останніх викликаних. Тому головне в SKILL.md варто тримати вгорі.
Усе це — постійний податок на кожен хід: той самий контекст, із якого складається витрата ваших лімітів Claude Code.
Скільки це в токенах, рахували троє авторів на своїх машинах. Методики різні, тому цифри нижче — ілюстрація, а не норма.Замір Скілів Токенів у списку Токенів на скіл (наш розрахунок) Як міряли Gekkode, 18.09.2026 117 (108 жодного разу не викликалися) ≈8 800 ≈75 звіт /skill-doctorMejba, 31.07.2026 226 ≈21 200 ≈94 символи ÷ 4, оцінка kenimo49 (dev.to), 04.06.2026 5 (3 не спрацювали жодного разу) ≈1 490 ≈298 замір за 7-годинну сесію 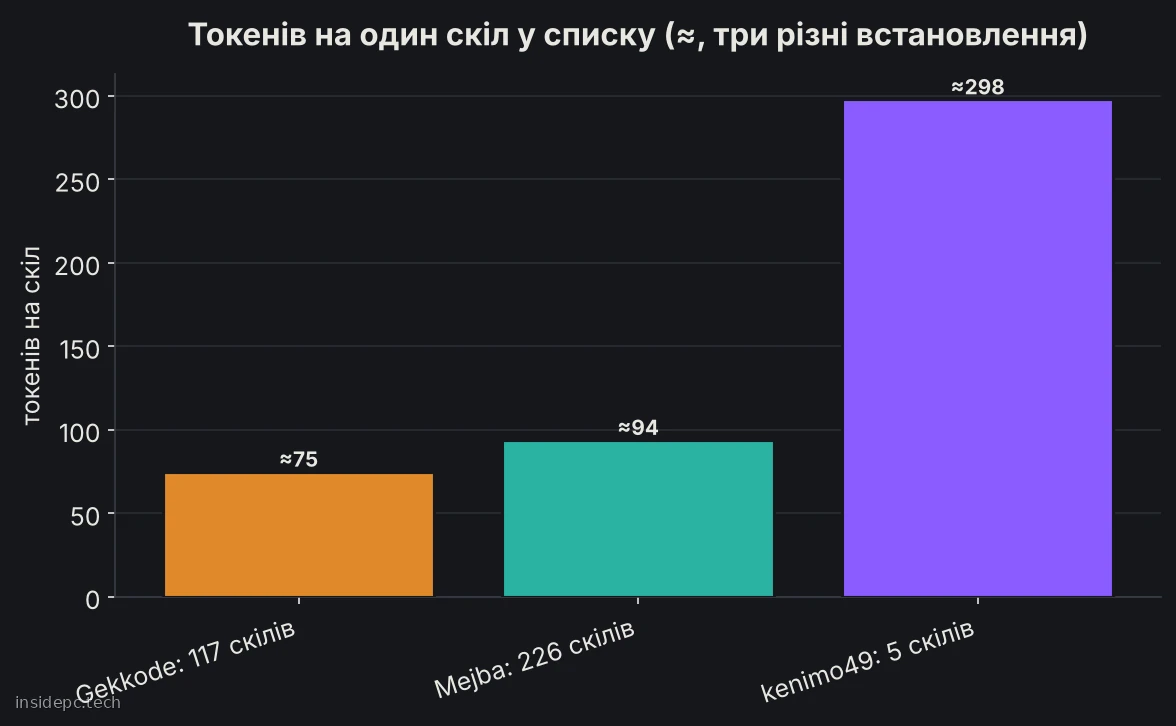
Висновок із графіка: що менше скілів, то «жирніші» в автора описи — у kenimo49 один опис важить учетверо більше, ніж у Gekkode. Абсолютні числа залежать від того, як ви пишете description, тому дивитися треба на власний звіт. Автор kenimo49 оцінив, що три скіли, які жодного разу не спрацювали, дали близько 11% токенів його робочого дня, але кешування промпта до розрахунку не ввійшло — тож це верхня оцінка.
Чому токени — не головна біда, показує робота дослідників Databricks «More Skills, Worse Agents?» (arXiv, травень 2026). На бенчмарку SkillsBench (88 завдань) частка розв’язаних завдань (pass rate) під час переходу від невеликого набору свідомо корисних скілів до бібліотеки з 202 скілів знижувалася на величину до 21%. Автори розклали падіння на дві частини. «Затінення» (skill shadowing) — агент обирає не той скіл — зростало з розміром бібліотеки. Внесок самого роздутого контексту виявився невідрізненним від нуля.
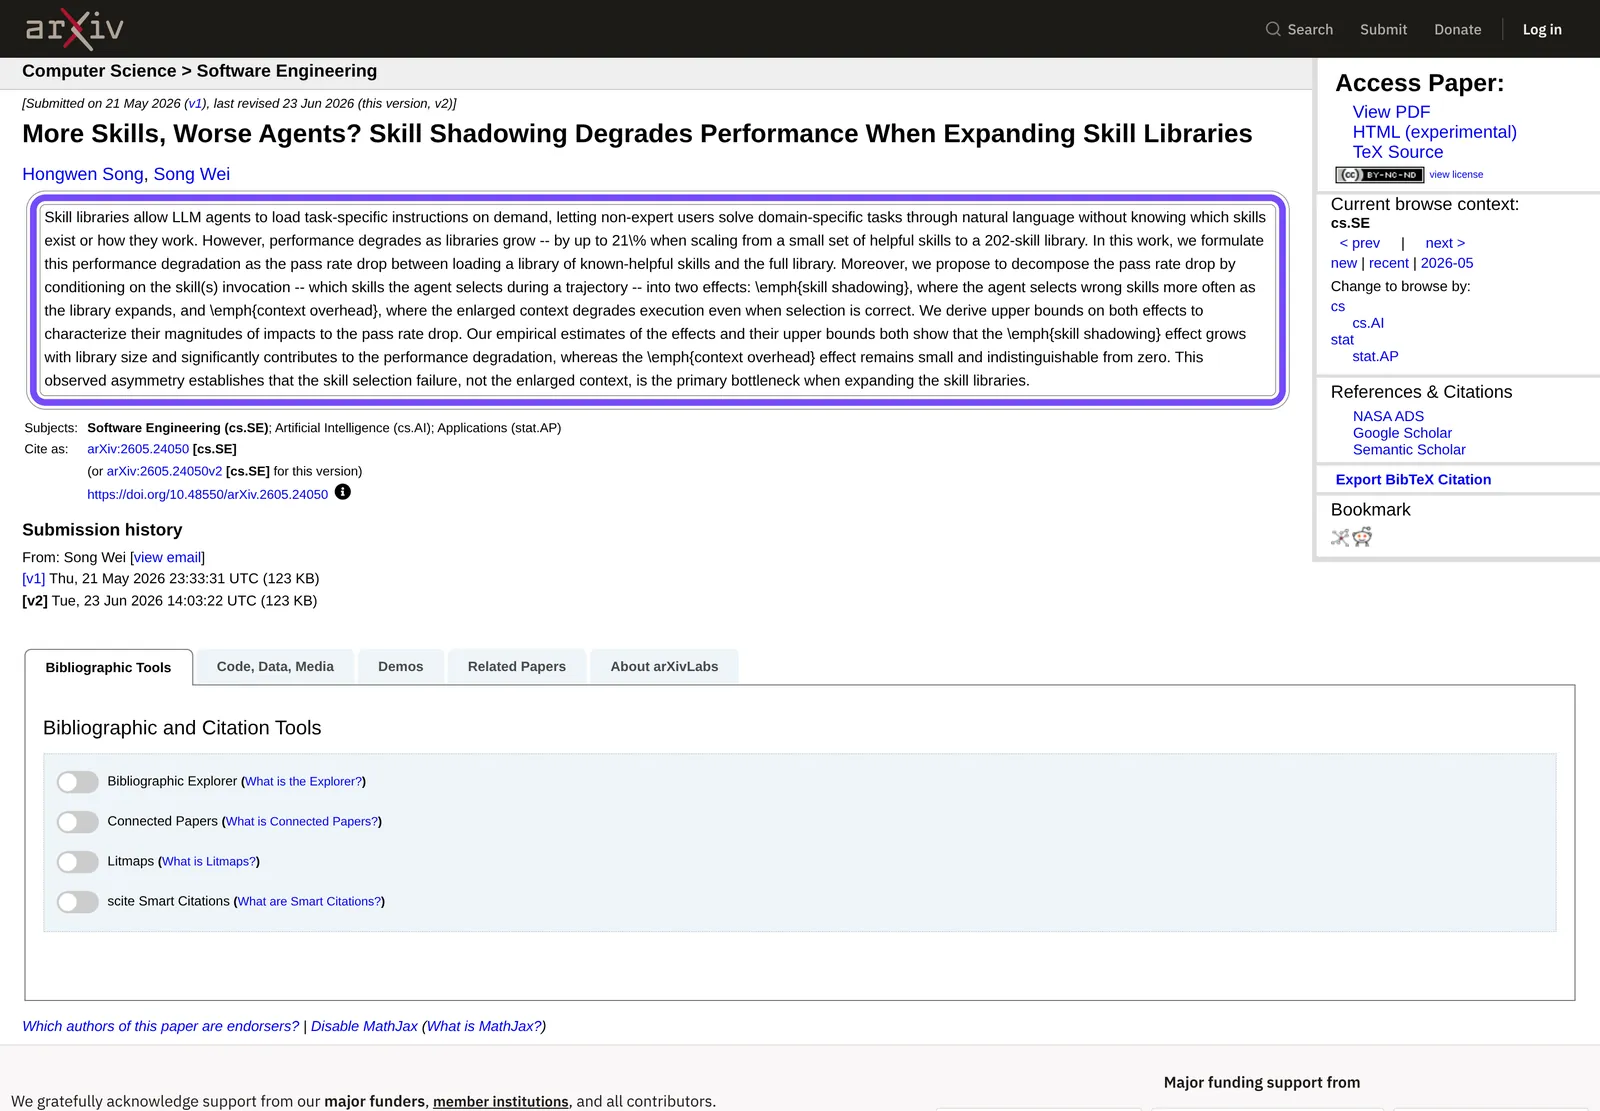
На кадрі зі сторінки arXiv (знятий 2 листопада 2026 року) рамкою виділено анотацію, де це сказано дослівно: вузьке місце — помилка вибору скіла, а не збільшений контекст. Застереження: це одна робота і дві моделі Anthropic (Haiku 4.5 і Sonnet 4.6), перевірені поза Claude Code. Але висновок для аудиту прямий — перевіряти треба, чи не перекривають описи один одного, а не лише скільки скілів встановлено. Схожу картину для інструкцій дав тест IFScale (arXiv, липень 2025): за 500 одночасних інструкцій найкращі моделі того часу виконували близько 68% із них. Завдання там інше, переносити цифру на CLAUDE.md безпосередньо не можна, але напрям той самий: що більше правил, то менша частка виконаних.
Звіт /skill-doctor: як читати колонки і що з ним робити
Ми запустили claude -p "/skill-doctor" 2 листопада 2026 року в хмарній сесії на Claude Code 2.1.316, у робочому проєкті редакції. Звіт перелічив 52 скіли: 28 особистих і проєктних (27 проєктних і один особистий), 10 із підключеного плагіна data і 14 синхронізованих із claude.ai. Фрагмент виводу — по рядку кожного походження і підсумкові підказки:
$ claude -p "/skill-doctor"
Skills loaded this session

  skill                                   source           context  7d tokens   uses  last used
  session-start-hook                      userSettings        ~100          -     0×  never
  system-check                            projectSettings     ~210          -     0×  never
  monthly-digest                          projectSettings     < 20          -     0×  never
  data:data-context-extractor             data                ~280          -     0×  never
  anthropic-skills:docs                   claude.ai sync      ~340          -     0×  never
  ...
28 skills loaded but never invoked. Each one adds to the system prompt every turn.
   Disable in /skills, or remove from .claude/skills.
14 skills synced from claude.ai loaded but never invoked. ... Disable in /skills, or turn them
   off on claude.ai — a deleted synced copy is re-downloaded on the next sync.
10 plugin skills loaded but never invoked, from data. ... Plugin skills can't be turned off
   individually — disable the plugin in /plugin.
| Колонка | Що означає | На що дивитися |
|---|---|---|
source | звідки скіл: userSettings — особистий, projectSettings — проєкту, ім’я плагіна (у нас data) або claude.ai sync | від джерела залежить, де його вимикати |
context | вага рядка скіла в списку, який іде на кожному ході | чищення починайте з найважчих |
7d tokens | токени, віднесені до скіла за останні 7 днів сесій на цій машині; прочерк — за тиждень до скіла не віднесено жодного токена | реальна робота скіла |
uses / last used | скільки разів викликали і коли востаннє | «0× never» — кандидат, а не вирок |
У нас усі 52 рядки показали «0×, never». Причина не в тому, що скіли мертві: хмарне середовище створюється з нуля, і історії викликів на цій машині просто немає. Той самий ефект буде на новому ноутбуці або після перевстановлення. Вага рядків — від «< 20» до приблизно 340 токенів. У 28 особистих і проєктних скілів у сумі виходить близько 2,6–2,7 тис. токенів, у всіх 52 — близько 7,3 тис.
Підсумкові рядки звіту корисніші за таблицю: вони кажуть, де вимикати кожну групу. Скіли проєкту — у /skills або видаленням із .claude/skills. Синхронізовані — у /skills або на claude.ai, бо видалена копія завантажиться знову під час наступної синхронізації. Скіли плагіна поодинці не вимикаються взагалі — лише весь плагін через /plugin.
Чому /context показує в рядку Skills 9,6 тис., а сума за /skill-doctor менша? Ми відкрили повну таблицю /context того самого дня. До рядка Skills там входять усі 68 скілів списку, зокрема 16 вбудованих (bundled) — як-от /claude-api і /code-review — на ≈2,4 тис. токенів. Вбудованих скілів /skill-doctor за документацією не охоплює; вимикають їх окремо — налаштуванням disableBundledSkills або поодинці через skillOverrides. Сума за групами з /context — ≈9,7 тис., що збігається з рядком Skills з точністю до округлення.
Як ухвалювати рішення за звітом:
- Накопичте історію. Запускайте звіт там, де ви справді працюєте, і не раніше ніж за кілька тижнів звичайної роботи — інакше всі рядки будуть «never».
- Відсортуйте за
context. Документація радить починати з найдорожчих за вагою скілів серед тих, які звіт пропонує вимкнути. - Перевірте кожного кандидата питанням «він рідкісний чи мертвий?». Скіл для щоквартального звіту покаже «0× за тиждень» і при цьому потрібен.
- Мертвий — в
off, рідкісний — уname-onlyабоuser-invocable-only. Як це зробити, розібрано в розділі про чищення нижче. - Скіли плагінів вимикайте через
/plugin. НалаштуванняskillOverridesна них не діє.
Межу звіту сформулював Implicator.ai: інструмент фіксує, чи запускався скіл і скільки місця зайняв, але не те, чи покращив він результат. Рідкісна, але цінна процедура у звіті виглядає так само, як мертвий вантаж.
Аудит CLAUDE.md командою prompt-audit: розбір реального звіту
/doctor prompt-audit — вбудований аудит інструкцій: Claude читає ваш CLAUDE.md, скіли, субагентів і команди та шукає застаріле й суперечливе. Правила, які застаріли саме з приходом нового покоління моделей, ми розбирали в матеріалі про context engineering для Claude 5 — там само обіцяли окремий розбір інструментів. Тут — сам процес на живому прикладі.
Для перевірки ми зібрали пісочницю: CLAUDE.md із семи правил із підкладеними помилками, package.json із двома скриптами (test і build) і скіл deploy. Ось файл повністю:
# Project notes
- Always use claude-3-opus for any model call. IMPORTANT: THINK STEP BY STEP before every answer or the output will be wrong!
- Run `npm run lintfix` before every commit.
- Follow the conventions in docs/STYLE_GUIDE.md.
- Indentation: use 4 spaces everywhere.
- Indentation: use 2 spaces everywhere.
- Never use semicolons in JS.
- Always end every JS statement with a semicolon.
Прогін claude -p "/doctor prompt-audit" 2 листопада 2026 року на Claude Code 2.1.316 з моделлю claude-opus-5-5 тривав 10 ходів, 66,5 секунди і коштував $0.89 за лічильником total_cost_usd. Область аудиту ми звузили налаштуванням claudeMdExcludes, інакше до перевірки потрапив би CLAUDE.md основного проєкту. Звіт знайшов 8 проблем і нічого не змінив — правки запропоновано у вигляді diff наприкінці.№ Де Що знайшов аудит Упевненість Запропонована дія 1 CLAUDE.md:2 ім’я моделі claude-3-opus — модель знято з підтримкивисока переписати на актуальну 2 CLAUDE.md:2 «THINK STEP BY STEP» великими літерами — у моделі мислення й так завжди увімкнене висока видалити 3 CLAUDE.md:3 npm run lintfix — такого скрипта в package.json немаєвисока видалити або замінити реальною командою 4 CLAUDE.md:4 docs/STYLE_GUIDE.md не існуєвисока видалити або повернути файл 5 skills/deploy:5 ./scripts/deploy.sh і npm run publish-all не існуютьвисока видалити скіл або виправити кроки 6 CLAUDE.md:5–6 4 пробіли проти 2 пробілів висока вирішуєте ви 7 CLAUDE.md:7–8 «ніколи крапку з комою» проти «завжди крапку з комою» висока вирішуєте ви 8 skills/deploy:3 опис «Does deployment stuff» надто розмитий середня переписати, якщо скіл лишається
Понад вісім пунктів аудит із низькою впевненістю запропонував додати скілу disable-model-invocation: деплой — дія назовні, його краще запускати лише вручну. Суперечності 6 і 7 до diff не потрапили: аудит прямо написав, що без історії git не може зрозуміти, яке правило новіше, і вибір залишив людині. Фрагмент запропонованої правки:
- - Always use claude-3-opus for any model call. IMPORTANT: THINK STEP BY STEP before every answer or the output will be wrong!
+ - Use `claude-opus-5-5` for model calls.
Ще одна корисна деталь — звіт прямо перелічує, чого він не перевірив. У нашій пісочниці доступ за межі теки був закритий, і аудит написав, що не дивився особистий ~/.claude, батьківські теки і скіли встановленого плагіна. За замовчуванням prompt-audit охоплює CLAUDE.md, CLAUDE.local.md і AGENTS.md, а також правила, скіли, команди, субагентів і стилі виводу в .claude/ і ~/.claude/. Щоб перевірити лише проєкт, передайте шлях: /doctor prompt-audit ..
Наскільки результат залежить від моделі, перевірив незалежний тест bestagent.dev (4–7 жовтня 2026, Claude Code 2.1.289): у репозиторій підклали 9 проблем і 6 контрольних рядків-«пасток» і проганяли аудит по три рази на кожній моделі.Модель Знайдено з 9 Ціна прогону за API Час Opus 5.5 9 в усіх прогонах ≈$0.75 62 с Sonnet 5.5 9 в усіх прогонах ≈$0.41 45 с Haiku 4.5 5, 7 і 6 (у середньому 6) ≈$0.20 69 с Haiku 5.5 (повтор 07.10.2026) 9 у трьох прогонах із трьох ≈$0.04 н/д 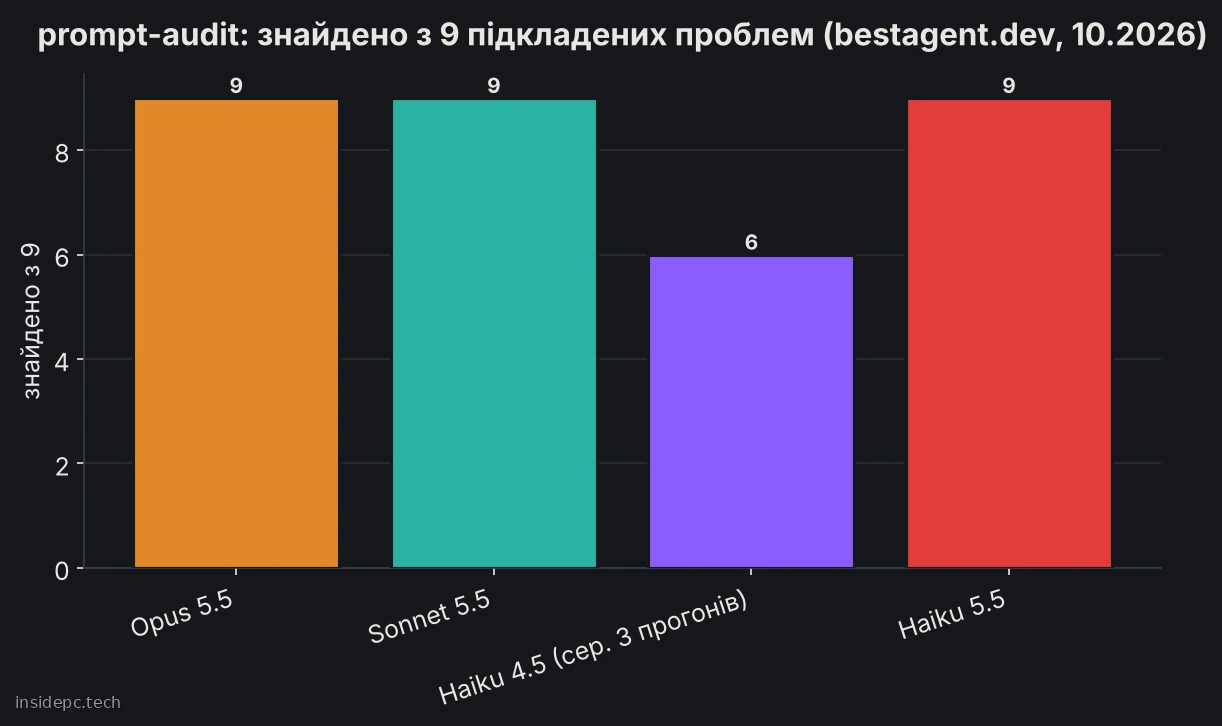
Висновок: Haiku 4.5 в усіх трьох прогонах пропустив вигаданий npm-скрипт і відсутній скрипт деплою — саме той клас помилок, заради якого аудит і запускають. Повтор 7 жовтня на тій самій моделі дав 3, 5 і 8 знахідок. Аудит працює на моделі вашої сесії, тому перед запуском перемкніться на Opus або Sonnet командою /model.
Чищення CLAUDE.md і скілів за кроками: що вирізати, що винести в хук
Спершу — що взагалі залишати. Документація Claude Code називає CLAUDE.md контекстом, а не примусовою конфігурацією: правило в ньому виконується в більшості випадків, але не в кожному. Кожен рядок цього файлу забирає трохи уваги моделі на кожному завданні, навіть якщо до завдання не стосується. Тому в ньому живе те, чого Claude не виведе з коду сам: підводні камені, причини рішень і домовленості, які розходяться з поведінкою інструментів за замовчуванням.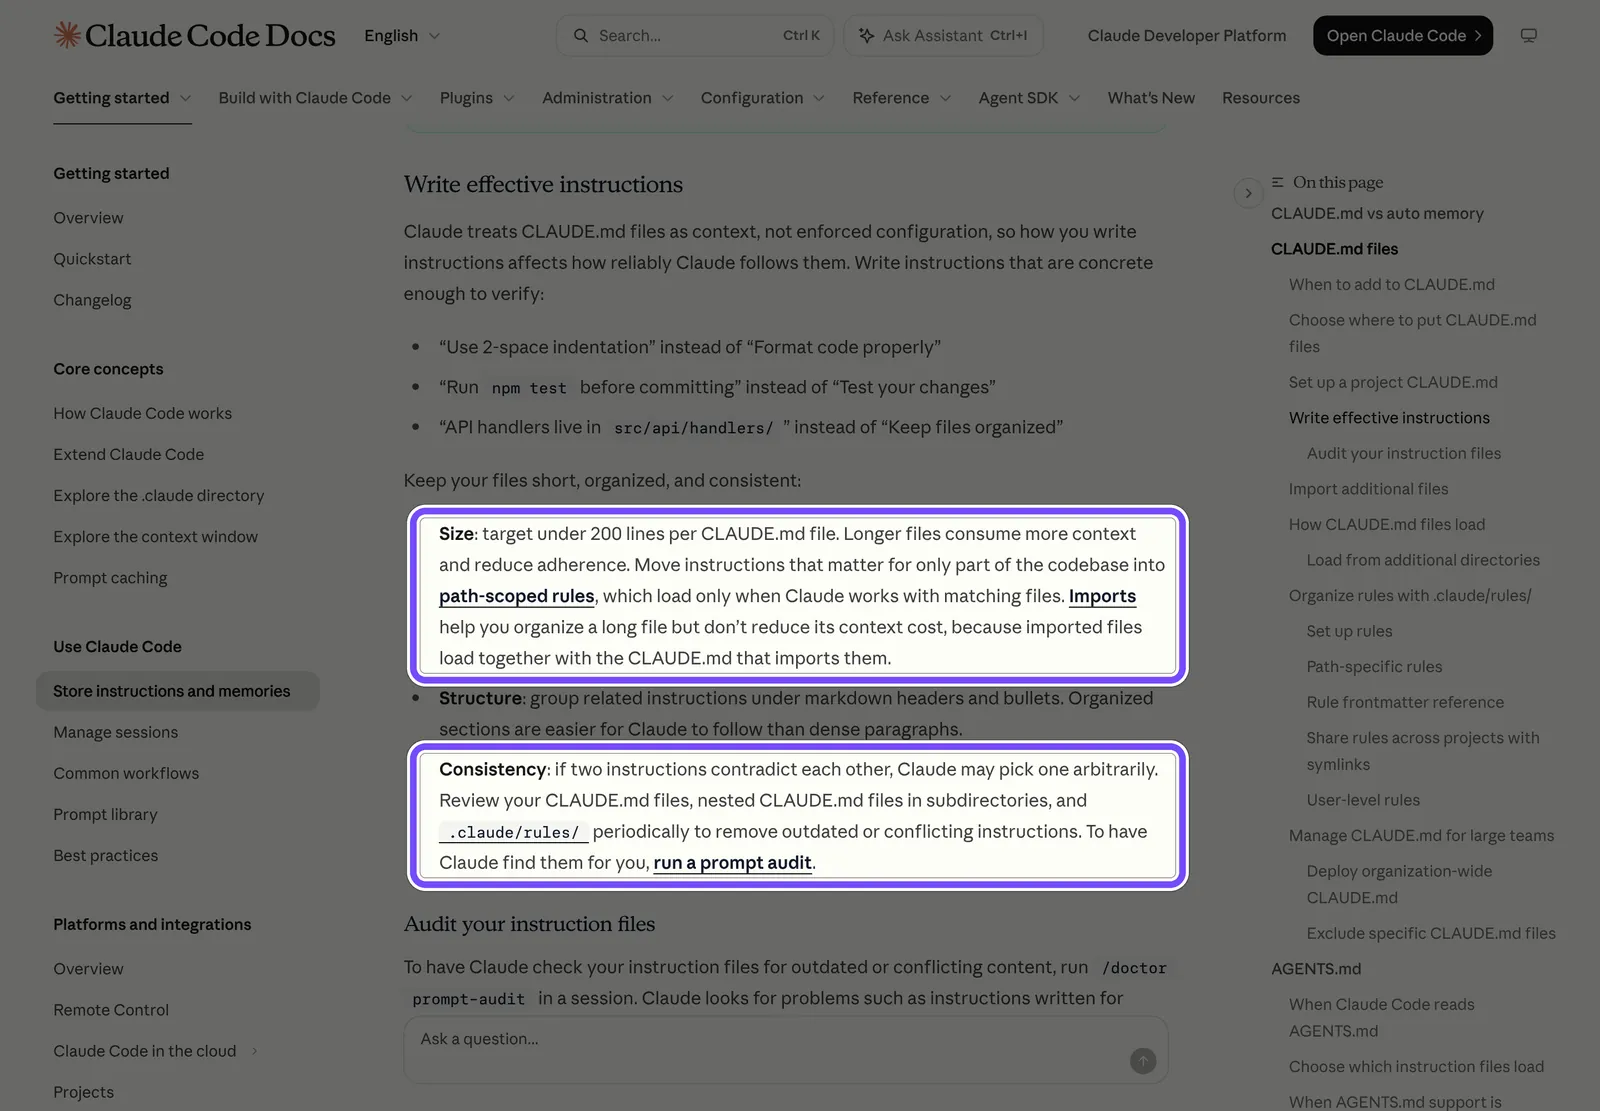
На кадрі з документації (2 листопада 2026 року) виділено два пункти. Перший — орієнтир «менше ніж 200 рядків на файл CLAUDE.md»; там само сказано, що імпорти через @ допомагають навести лад, але вартості в контексті не знижують — імпортований файл вантажиться разом з основним. Другий — якщо дві інструкції суперечать одна одній, Claude може обрати будь-яку з них довільно.
Орієнтир у рядках оманливий. CLAUDE.md робочого проєкту нашої редакції займає 99 рядків — удвічі менше за орієнтир, — але за /context важить 30,3 тис. токенів: рядки там завдовжки з абзац. Це 3% вікна в 1 млн токенів на кожному ході. Дивіться на токени в /context, а не на кількість рядків.
Повний чекап /doctor (він же /checkup) сам запропонує урізати CLAUDE.md: виріже те, що виводиться з коду, — дерево тек, список залежностей, огляд архітектури — і залишить граблі та домовленості. Далі — порядок, у якому ми чистимо самі:
- Зніміть базу. Запишіть цифри
/context(рядки Memory files і Skills) і збережіть вивід/skill-doctor— без них не зрозуміти, що дало чищення. - Приберіть те, що виводиться з коду. Структура проєкту, стек, версії бібліотек — Claude прочитає їх із репозиторію.
- Розв’яжіть суперечності. Аудит їх знаходить, але обрати правило має людина. Допомагає історія git: зазвичай новіший той рядок, який додали пізніше.
- Жорсткі правила — у хуки. Хук — скрипт, який Claude Code запускає сам на події, наприклад перед завершенням ходу. Документація best practices прямо пише: якщо ви дедалі сильніше виділяєте рядок у CLAUDE.md, а Claude однаково його пропускає, цьому рядку місце в хуку.
- Процедури — у скіли й правила за шляхами. Інструкція «як деплоїти» потрібна раз на тиждень — їй місце в скілі, який вантажиться під час виклику. Правило для однієї теки — у
.claude/rules/із прив’язкою до шляхів. Як зібрати сам скіл, ми розбирали в матеріалі SKILL.md без магії. - Скіли — за станами
skillOverrides. Таблиця нижче. - Один пункт за раз. Після кожної правки — звичайне завдання у свіжій сесії і порівняння з базою. Методика
prompt-audit.mdвід Anthropic формулює це так: аудит, який нічого не знайшов, нічого й не має змінювати.
Стан у skillOverrides | Модель бачить | У меню / | Коли ставити |
|---|---|---|---|
on (за замовчуванням) | ім’я та опис | так | робочий скіл, який Claude має добирати сам |
name-only | лише ім’я | так | потрібний, але другорядний — звільняє бюджет описів |
user-invocable-only | не бачить | так | рідкісний і цінний, запускаєте лише ви |
off | не бачить | ні | мертвий скіл або дублікат |
Задати skillOverrides можна в будь-якому файлі налаштувань, але найпростіше — через меню /skills: виділити скіл, пробілом перемкнути стан, Esc для збереження (меню записує в .claude/settings.local.json). Якщо готові правити сам SKILL.md, замість user-invocable-only можна поставити у frontmatter disable-model-invocation: true — так роблять зі скілами, що мають побічні ефекти на кшталт деплою чи надсилання повідомлень.Що знайшли Куди Чому опис структури проєкту, стек видалити Claude виведе з коду «завжди/ніколи» про тести, форматування, секрети хук правило в CLAUDE.md не гарантоване покрокова процедура на 20 рядків скіл вантажиться лише під час виклику правило для однієї теки .claude/rules/ зі шляхамивантажиться під час роботи з цими файлами граблі, причини рішень, нестандартні домовленості залишити з коду не виводяться
Перевірка самих скілів: plugin validate, eval і ручний тест
Зламаний YAML у frontmatter — найтихіша поломка скіла. За документацією, такий скіл завантажується з порожніми метаданими: за іменем /skill-name він запускається, але Claude не може дібрати його за описом. Помилки ви не побачите, скіл просто перестане спрацьовувати сам. Ловить це claude plugin validate, і попри назву — не лише для плагінів: команда приймає і звичайну теку зі скілами (з версії 2.1.233).
Ми прогнали її 2 листопада 2026 року на трьох тестових скілах: зі зламаним YAML, без опису і коректному.
$ claude plugin validate skills
Validating skill: .../skills/bad-yaml/SKILL.md
× Found 1 error:
  > frontmatter: YAML frontmatter failed to parse: YAML Parse error: Unexpected token.
    At runtime this skill loads with empty metadata (all frontmatter fields silently dropped).

Validating skill: .../skills/vague/SKILL.md
‼ Found 1 warning:
  > description: No description in frontmatter.

× Validation failed
exit=1
Коректний скіл пройшов без зауважень, підсумок — код виходу 1. Прапорець --json видає той самий звіт для скриптів із тими самими кодами виходу, а --strict за довідкою перетворює на помилки й попередження — так зручно ставити перевірку в CI (автоматичну перевірку перед злиттям коду). Для проєкту команда має вигляд claude plugin validate .claude/skills, для особистих скілів — claude plugin validate ~/.claude/skills.
Validate перевіряє форму, але не зміст. Документація формулює різницю точно: якщо скіл спрацював, це означає, що Claude його знайшов, а не що він зробив потрібне. Міряти треба дві речі окремо — чи викликається скіл на тих запитах, де має, і чи збігається результат з очікуванням.
Для плагінів це автоматизує claude plugin eval: кожен кейс із теки evals/ проганяється в ізольованій сесії двічі — з плагіном і без нього, результат оцінюють грейдери (перевірочні промпти), а за оцінки нижче порогу команда завершується з ненульовим кодом. Довідка версії 2.1.316 попереджає: прогін іде на вашій машині від вашого імені, тому оцінювати варто лише плагіни, яким ви довіряєте. Самі ми plugin eval на реальному плагіні не запускали — відповідного плагіна з набором кейсів під рукою не було.
Для окремого скіла вистачає ручного тесту:
- Зберіть 3–5 реальних запитів, на яких скіл має спрацювати, і 2–3, на яких не має.
- Проженіть кожен у свіжій сесії зі скілом і без нього (
offуskillOverrides). - Порівняйте, чи спрацював скіл і чий результат кращий. Свіжа сесія обов’язкова: залишки контексту від написання скіла маскують діри в інструкції.
Ризики аудиту: де він помиляється і чого не можна вирізати
| Ризик | Що відбувається | Як підстрахуватися | Джерело, дата |
|---|---|---|---|
| Рідкісний скіл схожий на мертвий | /skill-doctor бачить виклики й вагу, але не користь | name-only або user-invocable-only замість off | Implicator.ai, 07.09.2026 |
| Свіже середовище — порожня історія | у всіх скілів «0×, never» | судити лише за машиною з історією | наш прогін, 02.11.2026 |
| Аудит слабший на слабшій моделі | Haiku 4.5 знайшов 5–7 з 9 і пропустив зламані команди | запускати на Opus або Sonnet | bestagent.dev, 04–07.10.2026 |
| Хибні «зламані шляхи» | без контексту репозиторію аудит плутає шляхи | запускати з кореня проєкту, перевіряти кожну знахідку | Piekwerk (dev.to), 26.09.2026 |
| Особисті файли в області аудиту | за замовчуванням перевіряється і ~/.claude — правка зачепить усі проєкти | /doctor prompt-audit . | документація Claude Code, 02.11.2026 |
| Сліпе чищення заради короткого файлу | видаляються правила, які тримали поведінку | правка по одній, перевірка після кожної | anthropics/skills, prompt-audit.md |
Окремо про гучний аргумент «Anthropic сама обрізала промпт». 24 липня 2026 року співробітник Anthropic написав, що із системного промпта Claude Code для моделей рівня Opus 5 прибрали понад 80% тексту без вимірних втрат на внутрішніх тестах коду. Це заява вендора: оцінки не опубліковано, незалежного заміру немає. Привід перевірити свій CLAUDE.md — так, привід вирізати наосліп — ні.
Методика prompt-audit.md називає ще одну пастку — «пастку свіжості»: одна невдала сесія перетворюється на вічне правило. Агент одного разу запустив не той тест, у CLAUDE.md з’явився рядок великими літерами, через пів року причини ніхто не пам’ятає, а рядок висить у контексті кожного ходу. Зворотне теж шкодить: правило, яке запобігає реальній поломці, аудит може визнати зайвим, якщо не бачить історії. Тому останнє слово щодо кожної знахідки — за людиною, яка знає проєкт.
Сторонні skill-doctor і claude-md-improver: коли вони потрібні
Ім’я «Skill Doctor» має не лише вбудована команда: станом на 2 листопада 2026 року видача за ним — це здебільшого сторонні проєкти. Вони роблять інше, і плутати їх із вбудованою командою не варто.Інструмент Хто робить Звідки бере дані Що видає /skill-doctor (вбудований)Anthropic, Claude Code статистика сесій на машині вагу і виклики кожного скіла skill-doctor від Warp Warp, warpdotdev/common-skillsісторія ваших діалогів з агентом, локально оцінку скілів і чернетки правок, сторінку-звіт skill-doctor від незалежних авторів (ssamba1, amaljithkuttamath та ін.) спільнота, GitHub файли скілів і логи використання аудит перетинів, роздутості, застарілості — у кожного по-різному claude-md-improver + /revise-claude-mdAnthropic, офіційний плагін claude-md-managementCLAUDE.md і поточний код; підсумки сесії правки CLAUDE.md під зміни коду; нові правила за підсумками сесії
Сторонні інструменти закривають те, чого немає у вбудованого: наприклад, README проєкту ssamba1 прямо каже, що вбудовані засоби не ловлять колізій тригерів між скілами. Саме цю діру підсвічує дослідження про затінення. Але сторонній скіл — це код та інструкції, які виконуються з правами вашого Claude Code: читає файли, запускає команди, а варіант Warp ще й розбирає історію діалогів. Перед встановленням прочитайте його SKILL.md і скрипти повністю, ставте з репозиторію зі зрозумілим автором та історією комітів.
Коли що брати. Щоб зрозуміти, що витрачає контекст, вистачить вбудованого /skill-doctor. Для перевірки тексту інструкцій — /doctor prompt-audit. Якщо CLAUDE.md регулярно відстає від коду, знадобиться офіційний claude-md-improver. Сторонній skill-doctor має сенс, коли скілів десятки і ви підозрюєте, що вони перебивають один одного.
Як часто аудитувати скіли й CLAUDE.md: ритм і чек-лист
Єдиного стандарту частоти немає ні в Anthropic, ні в авторів тестів. Нижче — ритм, який ми пропонуємо самі, з огляду на те, що ламає інструкції.
Тригери для повного аудиту:
- зміна моделі — наприклад, перехід на нове покоління Opus або Sonnet: методика Anthropic прямо каже, що обхідний прийом, потрібний одному поколінню, на наступному стає мертвим вантажем;
- оновлення Claude Code зі змінами в скілах або CLAUDE.md у журналі змін;
- пачка нових скілів — умовно, плюс 10 до бібліотеки;
- зростання рядка Memory files або Skills у
/contextчи CLAUDE.md понад орієнтир у 200 рядків; - агент почав «не помічати» правило — сигнал перенести його в хук, а не додати ще одне «IMPORTANT».
Чек-лист одного проходу:
- Записати версію Claude Code, модель і цифри
/context. - Запустити
/skill-doctorна робочій машині з історією. - Розділити кандидатів на «мертві» й «рідкісні», виставити
off/name-only/user-invocable-only. - Скіли плагінів розібрати в
/plugin. - Запустити
/doctor prompt-audit .на Opus або Sonnet. - Перевірити кожну знахідку вручну: шлях існує? команда є в
package.json? - Суперечності розв’язати самому, жорсткі правила перенести в хуки.
- Прогнати
claude plugin validate .claude/skills. - Вносити правки по одній і перевіряти на звичайному завданні у свіжій сесії.
- Записати підсумок і знову зняти
/context.
Шаблон запису, щоб за три місяці було з чим порівняти:
Аудит <дата> · Claude Code <версія> · модель: <модель>
/context до: Memory <N>k · Skills <N>k → після: Memory <N>k · Skills <N>k
prompt-audit: знахідок <N> · прийнято <N> · відкладено <N> (суперечності — рішення за людиною)
skill-doctor: off — <N> · name-only — <N> · user-invocable-only — <N>
Що застаріє першим: номери версій, бюджети списку скілів і ціни прогонів. Перед аудитом звіряйтеся з розділами «Find unused skills» і «Write effective instructions» документації Claude Code та з її журналом змін.
FAQ
Що робить /skill-doctor у Claude Code і з якої версії він є? Команда показує, скільки контексту займає кожен завантажений скіл на кожному ході, скільки разів його викликали і коли востаннє, а також давно не використані плагіни. Вона з’явилася у версії 2.1.261, що вийшла 4 вересня 2026 року, а документація називає мінімальну версію 2.1.252. CLAUDE.md і користі скілів команда не оцінює.
Чим /doctor prompt-audit відрізняється від /skill-doctor?
/skill-doctor обчислює ціну й виклики скілів і не читає їхнього тексту. /doctor prompt-audit читає текст CLAUDE.md, скілів, субагентів і команд та шукає застарілі формулювання, шляхи й команди, яких немає в проєкті, суперечності. Перший відповідає на питання «що вимкнути», другий — «що переписати». Prompt-audit з’явився у версії 2.1.283 від 25 вересня 2026 року.
Скільки рядків має бути в CLAUDE.md?
Документація Claude Code радить тримати кожен файл CLAUDE.md коротшим за 200 рядків: довгий файл займає більше контексту і гірше дотримується. Але рядки — груба міра: файл із 99 рядків-абзаців може важити 30 тис. токенів. Дивіться рядок Memory files у /context і виносьте процедури в скіли, а правила для окремих тек — у .claude/rules/.
Як вимкнути невикористаний скіл, не видаляючи його?
Через налаштування skillOverrides або меню /skills: виділіть скіл і пробілом перемкніть стан. off приховує його повністю, name-only лишає в списку тільки ім’я, user-invocable-only ховає від моделі, але залишає запуск командою. Скілами плагінів це налаштування не керує — їх вмикають і вимикають у /plugin.
Чи змінює prompt-audit мої файли сам? Ні. Аудит видає звіт зі знахідками і запропонованим diff, а файли змінюються лише після вашої команди застосувати правки. У нашому прогоні 2 листопада 2026 року на початку звіту так і написано: «Nothing was edited». Суперечливих правил аудит до diff не включає взагалі й залишає вибір людині, бо не знає, яке з них актуальне.
Як часто запускати аудит скілів і CLAUDE.md?
Ми радимо раз на місяць дивитися /skill-doctor і /context, а повний /doctor prompt-audit запускати за подіями: зміна моделі, велике оновлення Claude Code, десяток нових скілів, помітне зростання CLAUDE.md. Частий аудит без змін нічого не дає: якщо знахідок немає, змінювати нічого не треба.