
Коротко (TL;DR)
- Скільки токенів в українському тексті порівняно з англійським: у 1,4–2,4 раза більше на сучасних токенізаторах. У нашому замірі того самого тексту словник o200k (GPT-4o і сімейство GPT-5) дав 924 токени проти 564, тобто в 1,64 раза.
- «У 17 разів дорожче» до української не стосується. Ця цифра — розрив між найдорожчою і найдешевшою з 200 мов в одній моделі; дорогі там бірманська, тибетська, кхмерська.
- Гроші: якщо всі запити українською, рахунок в API зростає приблизно на 64% (на 29 жовтня 2026 року — $18,04 проти $11,00 за 1000 типових запитів до GPT-6.1 Sol, якщо рахувати за словником o200k; для Claude множник не опубліковано).
- Головні важелі економії — не мова системного промпту. Сильніше працюють коротка відповідь (вихід уп’ятеро дорожчий за вхід), кеш промптів (читання — 5% ціни входу) і пакетний режим (−50%). Разом вони роблять українські запити дешевшими за звичайні англійські.
- Чого не робити: писати українську латиницею — на o200k, Llama і Gemma це додає 18–32% токенів, а не економить; виграш є тільки в словників, які ріжуть українську особливо сильно (старий cl100k, Qwen).
Кілька термінів, без яких далі буде складно. Токен — шматок тексту, яким модель читає і пише: ціле слово, склад або одна літера. В API і оплату, і ліміти вимірюють саме в токенах. Токенізатор — програма зі своїм словником, яка ріже текст на токени; у кожної моделі він свій. Системний промпт — постійна інструкція, що йде в модель із кожним запитом («ти — оператор підтримки, відповідай ввічливо…»).
- Коротко (TL;DR)
- Скільки токенів в українському тексті: замір на 9 токенізаторах
- Чому українська дорожча: кирилиця в словнику токенізатора
- «У 17 разів дорожче»: що насправді виміряло дослідження CLEAR
- Ціна української в API: 1000 запитів до GPT-6.1, Claude і Gemini
- Claude і Gemini: скільки токенів в української, якщо словник закритий
- Вікно контексту: скільки української вміщається в 128 тисяч токенів
- Писати промпт англійською чи українською: що відомо про якість
- Економія на українських запитах: кеш, коротка відповідь і batch
- Як порахувати токени свого тексту безкоштовно за п’ять хвилин
- Ризики економії на мові: якість відповіді, зміна токенізатора і ціни
- Часті запитання
Скільки токенів в українському тексті: замір на 9 токенізаторах
Скільки токенів у тексті, залежить і від мови, і від моделі. Щоб отримати відповідь на одному й тому самому матеріалі, ми написали нейтральний посібник «Як вибрати ноутбук для навчання» трьома мовами й порахували його дев’ятьма токенізаторами.
Методика заміру (29 жовтня 2026 року). Українська версія — 380 слів і 2768 знаків, англійська — 494 слова і 2867 знаків, російська — 390 слів і 2809 знаків. Рахували локально, словники взято з відкритих файлів: бібліотека tiktoken 0.14.0 (словники OpenAI o200k_base і cl100k_base) і tokenizers 0.23.3 з файлами моделей із Hugging Face. Окремо порахували короткий промпт-інструкцію приблизно на 360 знаків. Обмеження методики: це один текст одного жанру; на коді, таблицях і щільній термінології множник буде іншим. Повторити замір на своєму тексті можна за кроками з розділу про підрахунок токенів нижче.Токенізатор (моделі) Українська Англійська Російська UA до EN RU до EN o200k_base (GPT-4o, GPT-4.1, GPT-5) 924 564 691 1,64 1,23 cl100k_base (GPT-3.5, GPT-4) 1594 565 1261 2,82 2,23 Llama 4 810 564 602 1,44 1,07 Gemma 3 (словник Gemini 2.0) 852 568 666 1,50 1,17 Llama 3.1 886 565 819 1,57 1,45 Mistral Nemo 978 574 787 1,70 1,37 Mistral 7B v0.3 1226 606 1138 2,02 1,88 DeepSeek-V3 1153 567 776 2,03 1,37 Qwen2.5 і Qwen3 1360 565 862 2,41 1,53
Англійський текст майже скрізь укладається в 564–606 токенів: словники всіх моделей зібрано насамперед під нього. Українська розкидана від 810 до 1594 токенів. Короткий промпт дав ті самі пропорції: 122 токени проти 73 на o200k (1,67 раза), 110 проти 74 на Llama 4 (1,49 раза).
Порядок величин збігається з незалежними роботами. Рецензоване дослідження токенізації української в журналі Frontiers in Artificial Intelligence нарахувало на загальному корпусі 1,98 токена на слово в GPT-4o і 3,32 у GPT-3.5/4 проти 1,07–1,08 в англійської. Робота arXiv 2608.21384 (корпус із 8,37 млн словоформ п’ятьма мовами) дає українській +68–121% токенів на сучасних токенізаторах і +220% на старому cl100k.
Токени на слово і токени на зміст: чому це різні цифри
У дослідженнях зазвичай рахують токени на слово: у роботі arXiv 2605.24718 в української в середньому 2,66 токена на слово проти 1,23 в англійської — звідси й «у 2,2 раза дорожче». Але український текст коротший за кількістю слів: у нашому замірі той самий зміст зайняв 380 українських слів проти 494 англійських, на 23% менше. Тому на слово розрив 2,43 проти 1,14 (у 2,1 раза), а на весь текст — 1,64 раза. Для рахунку в API важить друга цифра: платите ви за зміст, який передали, а не за слова.
Ще одна деталь: окрема фраза може дати розрив, помітно більший за середній. У прикладі видання «Межа» англійська фраза із 47 знаків займає 7 токенів, а українська з 42 знаків — 17, тобто в 2,4 раза. Ми перевірили це на o200k і отримали ті самі 7 і 17. На цілому тексті розрив виходить 1,64, а на нашому промпті в 360 знаків — 1,67, тож за однією фразою про середнє судити не можна.
Чому українська дорожча: кирилиця в словнику токенізатора
Токенізатор навчається на величезному корпусі текстів і зберігає в словник найчастіші шматки. Англійської в інтернеті найбільше, тому «London» — один токен, а «artificial intelligence» — три. Українських текстів у навчальних даних менше, і частих українських шматків у словнику мало.
Що показав підрахунок словників:
- cl100k_base (GPT-3.5 і GPT-4): зі 100 277 токенів кирилицю містять 729, а українські літери і, ї, є або ґ — лише 2.
- o200k_base (GPT-4o і новіші): із 200 019 токенів кирилицю містять 14 209, українські літери — 502.
- Звідси стрибок між поколіннями: той самий текст у cl100k коштував 2,82 англійського, в o200k — уже 1,64.
Як це виглядає на словах (o200k_base):Слово Токенів Як розрізано London 1 London Київ 3 К · и · їв Україна 3 Укра · ї · на artificial intelligence 3 art · ificial · intelligence штучний інтелект 6 шт · уч · ний · ін · тел · ект
Літера «ї» в словах «Київ» і «Україна» майже завжди випадає в окремий шматок, бо сполучень із нею в словнику майже немає. Дослідження arXiv 2605.24718 на 25 європейських мовах називає це «українським штрафом»: українська платить на 15–18% більше за споріднені слов’янські мови, і автори пов’язують це з тим, що українських текстів у навчальних даних менше.
«У 17 разів дорожче»: що насправді виміряло дослідження CLEAR
Привід для обговорення — дописи в українському Telegram і переказ у медіа із заголовком у дусі «деякі промпти коштують у 17 разів дорожче залежно від мови». Джерело цифри — дослідження коаліції CLEAR (Coalition for Language Equity in AI Research), про яке 26 жовтня 2026 року написало видання Rest of World.
Що там сказано насправді:
- серед 20 найпоширеніших мов інтернету найдорожча потребує в 1,5–5 разів більше токенів, ніж найдешевша;
- коли вибірку розширили до 200 мов, розрив в одній із моделей зріс до 17 разів;
- найгірше доводиться мовам із писемностями, яких токенізатор майже не бачив: бірманській, тибетській, тифінагу, кхмерській, лаоській, ол-чікі.
Української в переказах дослідження не названо. Переносити на неї 17x — те саме, що взяти найгірший результат із 200 і видати його за середній. Rest of World посилається на публікацію CLEAR у блозі коаліції, але розбивку за мовами й моделями звідти ми отримати не змогли, тому спираємося на переказ Rest of World і на прямі заміри української.Звідки цифра Що порівнюють Значення для української CLEAR, «до 17 разів» найгірша з 200 мов проти найкращої, одна модель не виміряно CLEAR, «1,5–5 разів» найгірша з топ-20 мов проти найкращої не названо arXiv 2605.24718 токенів на слово, 10 моделей 2,7 проти 1,2 в англійської Frontiers, 2025 токенів на слово, GPT-4o 1,98 проти 1,07 arXiv 2608.21384 увесь корпус, сучасні токенізатори +68–121% Наш замір, 29.10.2026 той самий текст цілком, 9 токенізаторів у 1,44–2,82 раза
Висновок для практики: орієнтир для української — 1,4–2,4 раза на актуальних моделях і близько 2,8 раза на старих GPT-3.5 і GPT-4.
Ціна української в API: 1000 запитів до GPT-6.1, Claude і Gemini
Візьмімо типовий запит чат-бота: системний промпт на 1000 токенів, запитання користувача на 500 і відповідь на 800 (усе в англійському обчисленні). Порівняймо чотири варіанти мови з множником 1,64 — стільки дав словник o200k. Для GPT-6.1 OpenAI словника не називає, тому цифра — орієнтир, а для Claude і Gemini — припущення (чому — у розділі про Claude і Gemini нижче). Ціни — на 29 жовтня 2026 року за прайсами вендорів.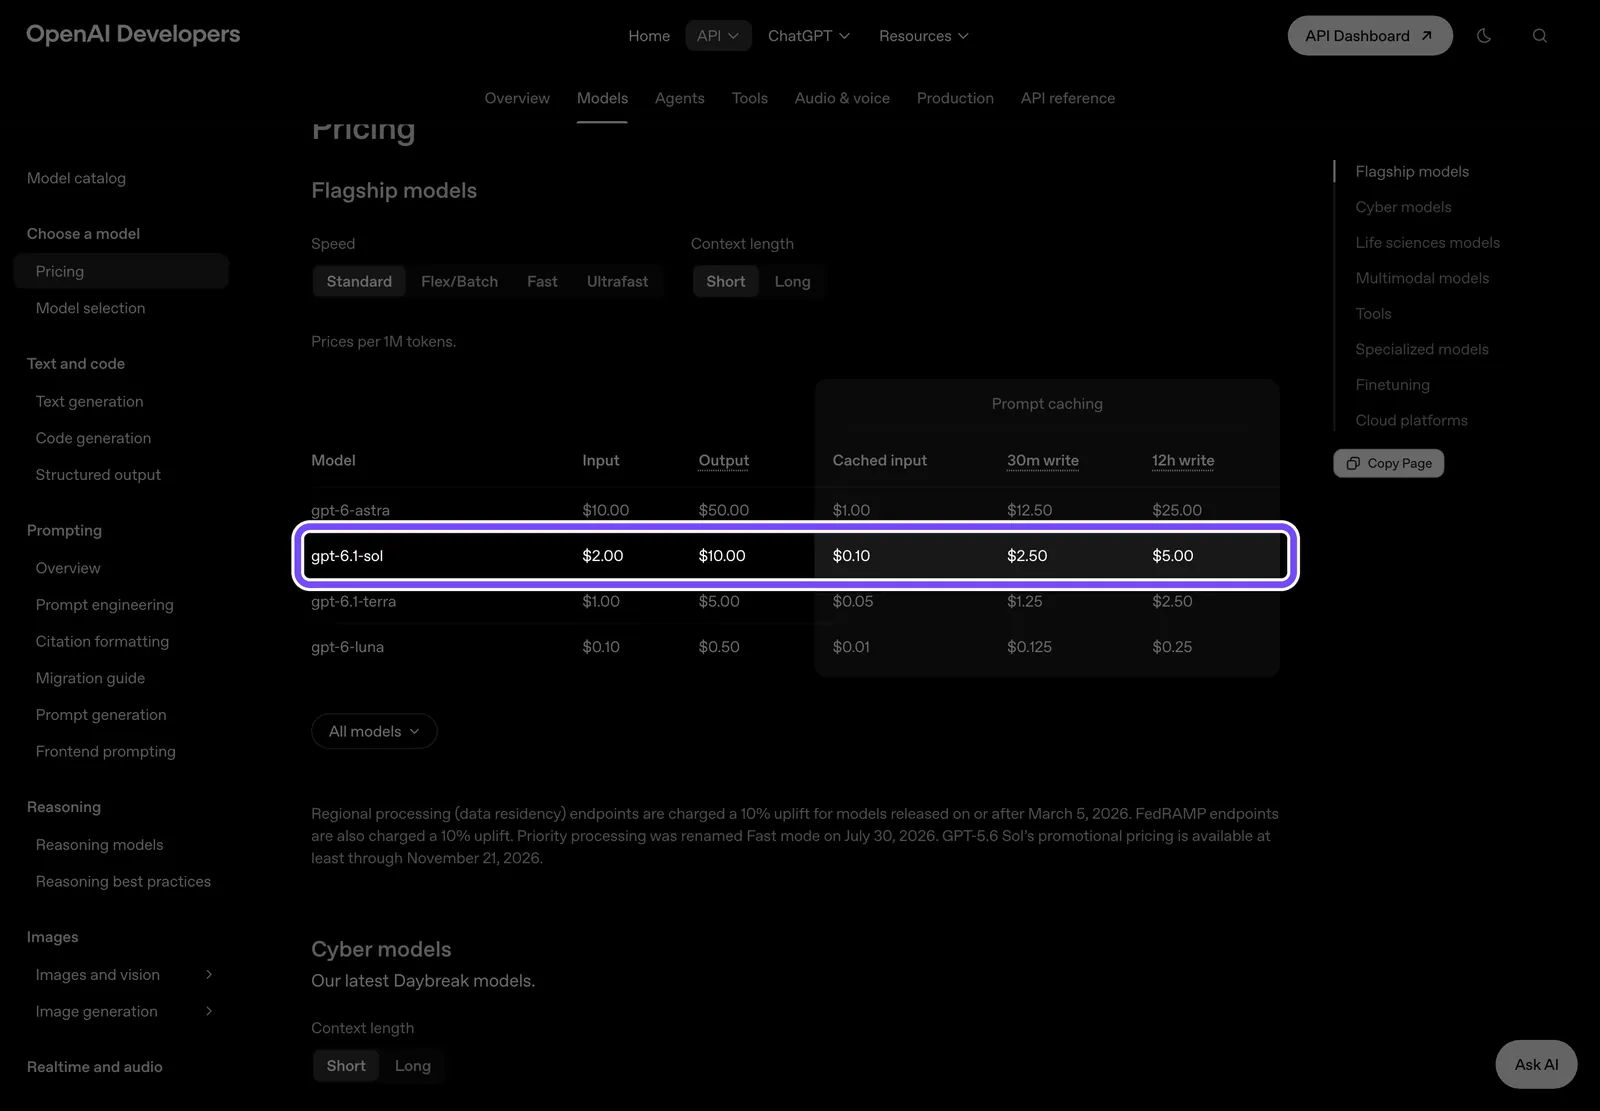
На скриншоті прайсу OpenAI (знято 29 жовтня 2026 року) рамкою виділено рядок GPT-6.1 Sol: $2 за мільйон вхідних токенів, $10 за мільйон вихідних і $0,10 за читання з кешу. Стільки ж за токен коштує Claude Sonnet 5.5, але токенізатор у Claude свій. Тому колонки Claude і Gemini пораховано з тим самим множником 1,64 — це порівняння цін, а не замір: у Claude українська, за непрямими даними, ріжеться сильніше, у Gemini 2.0 (за словником Gemma 3) — трохи м’якше, 1,50. У Gemini ціна виходу охоплює й токени міркувань моделі.Варіант (1000 запитів) GPT-6.1 Sol, Sonnet 5.5 ($2 / $10) Claude Opus 5.5 ($4 / $20) Gemini 3.8 Flash ($0,75 / $3,75) GPT-6.1 Terra ($1 / $5) Усе англійською $11,00 $22,00 $4,13 $5,50 Усе українською $18,04 (+64%) $36,08 $6,77 $9,02 Системний промпт англійською, решта українською $16,76 (+52%) $33,52 $6,29 $8,38 Системний промпт і відповідь англійською, запитання українською $11,64 (+6%) $23,28 $4,37 $5,82
Переклад системного промпту англійською заощаджує лише близько 7% рахунку ($18,04 → $16,76). Причина проста: вихідний токен уп’ятеро дорожчий за вхідний, і в українському варіанті відповідь — це 73% усієї суми. Відповідь англійською майже знімає переплату, але для українського користувача це зазвичай не варіант.
Якщо множник вищий (Qwen, DeepSeek або старі моделі), розрив зростає. З множником 2,4 «усе українською» коштує $26,40 замість $11,00, з 3,0 — $33,00.
Переплата за українську мову в гривнях: чат-бот на 30 000 запитів
Чат-бот підтримки на 1000 запитів на день — це близько 30 000 запитів на місяць. За курсом НБУ 45,59 грн за долар на 29 жовтня 2026 року на GPT-6.1 Sol з множником o200k виходить:
- усе англійською: $330 на місяць, близько 15 045 грн;
- усе українською без оптимізацій: $541,20 на місяць, близько 24 675 грн;
- переплата за мову: близько $211, або 9 630 грн на місяць.
Ціни, які застаріють першими: у Gemini 3.8 Flash ставка $0,75 / $3,75 діє до 31 грудня 2026 року, з 1 січня 2027-го — $1,50 / $7,50. У Gemini 4 Argon $2 / $10 діє до 30 листопада 2026 року, з 1 грудня — $4 / $20.
Claude і Gemini: скільки токенів в української, якщо словник закритий
Публічного токенізатора Claude немає: Anthropic не викладає словник, тому порахувати український текст локально, як для GPT чи Llama, не вийде. Порівняти Claude з GPT на одному українському тексті можна лише через API з ключем. Що відомо з відкритих джерел:Модель Що відомо Наскільки надійно Claude 4.7 і новіші (Sonnet 5.5, Opus 5.5, Fable 5.1) той самий текст дає приблизно на 30% більше токенів, ніж у моделей до 4.7 документація Anthropic, без розбивки за мовами Claude Opus 5 російською приблизно втричі більше токенів, ніж англійською один блог-замір Donseo в переказі, низька Claude 3 (наближений словник) 3,45 токена на українське слово проти 1,10 на англійське Frontiers, 2025; словник неофіційний Gemini 2.0 Gemma 3 використовує той самий словник; у нашому замірі 1,50 до англійської технічний звіт Gemma 3; проксі лише для Gemini 2.0 Gemini 3.x і 4 н/д словник не опубліковано 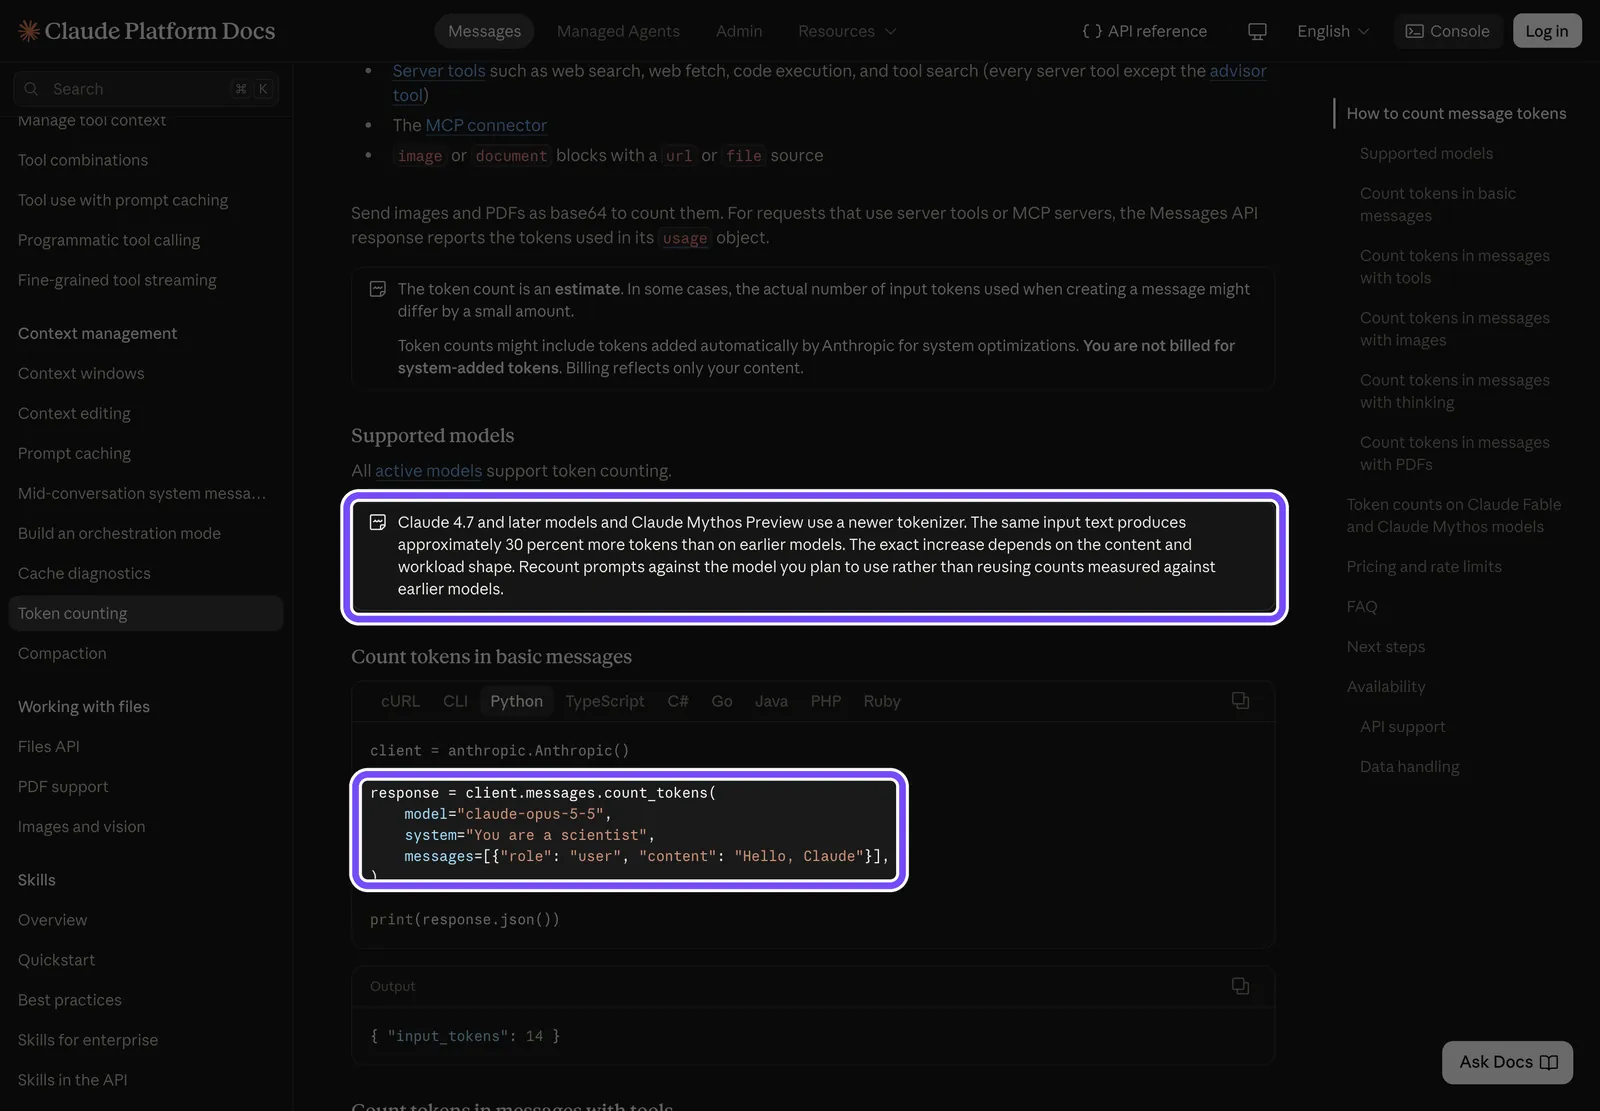
На скриншоті документації Anthropic про підрахунок токенів (знято 29 жовтня 2026 року) рамками виділено два місця: примітку про те, що Claude 4.7 і новіші рахують той самий текст приблизно на 30% довшим, і приклад виклику count_tokens. Той самий документ радить перераховувати промпти під модель, на яку ви переходите, а не брати старі цифри.
Відповіді на запитання «у скільки разів українська дорожча за англійську саме в Claude» у відкритих даних немає. Непрямі дані вказують, що кирилиця в Claude обходиться дорожче, ніж у GPT-4o і новіших, але цифри для української ми не наводимо: єдиний свіжий замір стосується російської і опублікований у переказі. Перевірка для свого завдання — у розділі про підрахунок токенів нижче.
Вікно контексту: скільки української вміщається в 128 тисяч токенів
Вікно контексту — це обсяг тексту, який модель тримає в голові за один раз: системний промпт, листування, вкладені документи й відповідь. Воно теж вимірюється в токенах, тому український текст заповнює його швидше.
Порахуймо, скільки машинописних сторінок по 1800 знаків вміщається у вікно 128 тисяч токенів — стільки в багатьох локальних моделей, зокрема в Gemma 3:Токенізатор Токенів на сторінку UA Токенів на сторінку EN Сторінок UA в 128K Сторінок EN в 128K o200k_base (GPT-4o, GPT-5) ≈600 ≈354 ≈213 ≈361 Llama 4 ≈527 ≈354 ≈243 ≈361 Gemma 3 ≈554 ≈357 ≈231 ≈359 Qwen2.5 і Qwen3 ≈884 ≈355 ≈145 ≈361 cl100k_base (GPT-4) ≈1037 ≈355 ≈123 ≈361
Якщо перерахувати на слова, на o200k у 128 тисяч токенів вміщається близько 112 тисяч англійських слів і близько 53 тисяч українських. Але, як розібрано вище, українських слів на той самий зміст потрібно менше, тому точніше міряти сторінками: українського змісту вміщається приблизно в 1,7 раза менше.
Практичні наслідки:
- Довгий діалог «забуває» початок раніше. У підписках ChatGPT і Claude ви не платите за кожен токен, але довге українське листування швидше впирається у вікно, і модель починає губити ранні деталі.
- Великий документ може не вміститися цілком. На Qwen договір на 200 сторінок англійською поміститься в 128K, а українською — ні.
- Вікно на 1 млн токенів знімає проблему для більшості завдань. У Claude Sonnet 5.5 і Opus 5.5 воно саме таке за документацією Anthropic; платите при цьому однаково за кожен токен.
Писати промпт англійською чи українською: що відомо про якість
Коротка відповідь: прямих досліджень «англійський промпт проти українського» із заміром якості відповіді українською ми не знайшли. Є роботи щодо інших мов і загальні спостереження, і вони дають обережний орієнтир, а не правило.
Що відомо:
- Роботи щодо інших мов схиляються до англійського промпту. На бенгальській, гінді та урду GPT-4, Llama 2 і Gemini краще впоралися з англійськими промптами (arXiv 2410.13153, 2024). У 197 експериментах на арабських даних найкращим у середньому був англійський промпт, далі змішаний, потім арабський (arXiv 2409.07054).
- Що сильніше мова ріжеться на токени, то нижча точність. На 16 африканських мовах кількість токенів на слово надійно передбачала падіння точності (arXiv 2509.05486). Українська ріжеться помітно м’якше, але механізм той самий.
- Приклади в промпті українською можуть шкодити. На 273 рішеннях українських судів додавання прикладів (few-shot) знижувало якість до 26 відсоткових пунктів, і надійнішим був запит без прикладів (arXiv 2605.14890).
- Транслітерація гірша за оригінал. Anthropic у документації радить подавати текст рідною писемністю, а не латиницею.
- Мову відповіді краще задавати явно. Та сама документація рекомендує прописувати мову відповіді в системному промпті, щоб вона трималася на всіх кроках діалогу.
Окремо від мови на якість сильніше впливає структура промпту: роль, контекст, формат і критерії результату.
Правило вибору за завданням:
- Розмова з людиною, тексти для української аудиторії — промпт українською, мову відповіді вказано явно. Переплата прийнятна, а ризик загубити реалії менший.
- Технічне завдання (код, видобування даних, класифікація) — системний промпт можна писати англійською, відповідь — потрібною мовою.
- Довга стабільна інструкція, яка йде з кожним запитом, — спершу кеш, а не переклад: це дешевше й не потребує переписувати промпт.
- Сумніваєтеся — проженіть 20–30 своїх реальних прикладів у двох варіантах і порівняйте відповіді. Це єдина перевірка, яка підходить саме вашому завданню.
Економія на українських запитах: кеш, коротка відповідь і batch
Найчастіша порада в обговореннях — «пишіть промпти англійською». Розрахунок вище показує, що вона заощаджує одиниці відсотків. Нижче — способи за реальним ефектом на 29 жовтня 2026 року; детальніше про кожен механізм — у нашому розборі витрат на токени LLM, тут лише те, що стосується української.Спосіб Ефект для українських запитів Статус Кеш промптів читання з кешу — $0,10 замість $2 за 1 млн (Sonnet 5.5, GPT-6.1 Sol), 5% ціни входу працює, перевірено за прайсами Обмеження довжини відповіді вихід уп’ятеро дорожчий за вхід; відповідь — близько 73% рахунку працює Пакетний режим (batch) −50% на вхід і вихід в Anthropic; в OpenAI для GPT-6.1 Sol $1 / $5 працює для нетермінових завдань Стиснення LLMLingua-2 −47–49% українського входу на тесті з пошуком по каталогу працює в дослідженні, треба перевірити в себе Системний промпт англійською близько −7% рахунку в нашому сценарії працює слабко Переклад усього запиту англійською локальною моделлю −34–47% входу на інших мовах для української не перевірено Українська латиницею +18% на o200k, +32% на Llama 4, +27% на Gemma 3; −12% тільки в Qwen не працює
Кеш промптів: довгий український системний промпт майже безкоштовний
Кеш промптів — це коли сервіс запам’ятовує незмінний початок запиту (системний промпт, інструкції, довідник) і під час повтору бере його за зниженою ціною. В Anthropic кеш за замовчуванням живе 5 хвилин і подовжується з кожним використанням, в OpenAI для GPT-5.6 і новіших — 30 хвилин. Мінімальна довжина кешованого початку — 512 токенів у Claude Sonnet 5.5 і Opus 5.5 та 1024 токени в OpenAI для GPT-5.6 і новіших.
Приклад: український системний промпт на 1640 токенів (наша тисяча англійських, помножена на 1,64). Без кешу 1000 запитів з’їдають за нього $3,28, з кешем — близько $0,16. Це дешевше, ніж той самий промпт англійською без кешу ($2,00). Перший запис у кеш коштує в 1,25 раза дорожче за звичайний вхід, але це разова плата.
Коротка відповідь разом із кешем: $10 за 1000 українських запитів
Порахуймо повний сценарій на GPT-6.1 Sol або Sonnet 5.5 для 1000 запитів, усе українською:
- Без оптимізацій — $18,04.
- З кешем системного промпту — $14,92.
- З кешем і відповіддю, скороченою до 500 токенів в англійському обчисленні (замість 800), — близько $10,00.
Третій варіант дешевший, ніж усе англійською без оптимізацій ($11,00). Коротку відповідь задають прямо в промпті: «відповідь — до 150 слів», «тільки список без вступу». Пакетний режим для того самого сценарію без кешу дає $9,02, але відповіді надходять із затримкою, тому він підходить для розмітки, перекладів і звітів, а не для чату.
Українська латиницею: чому транслітерація не економить токени
Ідея здається логічною: латиниця в словнику представлена краще, отже «Kyiv» дешевший за «Київ». На старому cl100k так і є — транслітерація заощаджує 25%. Але на більшості сучасних словників латинський запис української довший: у нашому замірі +18% на o200k, +32% на Llama 4 і Llama 3.1, +27% на Gemma 3. Винятки — Qwen2.5/Qwen3 (−12%) і DeepSeek-V3 (без змін): ці словники ріжуть українську кирилицю сильніше за всіх. Робота arXiv 2608.21384 дає +2–19% на більшості токенізаторів, дослідження у Frontiers дійшло того самого: транслітерація допомагає лише словникам, які ріжуть українську сильніше ніж на 2,5 токена на слово. До того ж модель гірше розуміє транслітерацію, а відповідь доведеться перекладати назад.
Як порахувати токени свого тексту безкоштовно за п’ять хвилин
Як дізнатися, скільки токенів у тексті, з яким ви працюватимете: найпростіше порахувати його самому, а не вірити середнім цифрам. П’ять способів від простого до точного.
- Токенізатор OpenAI у браузері. Сторінка Tokenizer у документації OpenAI (
platform.openai.com/tokenizer) показує кількість токенів і розфарбовує, як розрізано текст. Це найшвидший спосіб порахувати токени в браузері, без встановлення; виберіть у ньому найновішу модель зі списку. - tiktoken на своєму комп’ютері. Безкоштовна бібліотека OpenAI на Python підраховує токени в будь-яких обсягах тексту без інтернету. У версії 0.14.0 словник o200k_base прив’язано до GPT-4o, GPT-4.1 і сімейства GPT-5; для GPT-6.1 бібліотека словника не називає, тому цифра для неї — орієнтир.
- Токенізатори відкритих моделей. Бібліотека tokenizers і файл
tokenizer.jsonз Hugging Face дають точний підрахунок для Llama, Qwen, Gemma, Mistral і DeepSeek — корисно, якщо ви запускаєте модель локально. - count_tokens в Anthropic. Метод API безкоштовний (обмежений лише частотою запитів), але потрібен ключ. Це єдиний спосіб дізнатися, скільки токенів український текст займе саме в Claude; сама Anthropic називає результат оцінкою, яка може трохи відрізнятися від підсумкового рахунку.
- countTokens у Google. Метод Gemini API теж потребує ключа; у Gemini 3.8 Flash є безкоштовний рівень за прайсом Google на 29 жовтня 2026 року.
Мінімальний код для другого способу:
# pip install tiktoken
import tiktoken

enc = tiktoken.get_encoding("o200k_base")
for text in ["Штучний інтелект змінює те, як ми працюємо",
             "Artificial intelligence is changing how we work"]:
    print(len(enc.encode(text)), text)
# 17 Штучний інтелект змінює те, як ми працюємо
# 7 Artificial intelligence is changing how we work
Груба оцінка, якщо немає часу рахувати: англійський текст на o200k — близько 5 знаків на токен, український — близько 3, російський — близько 4. Сторінка українського тексту на 1800 знаків — приблизно 600 токенів.
Ризики економії на мові: якість відповіді, зміна токенізатора і ціни
Заощадити на токенах можна, але кожен спосіб має свою ціну.
- Відповідь англійською з подальшим перекладом. Рахунок падає майже до англійського рівня, але додається крок перекладу, а українські реалії — назви відомств, законів, банківських продуктів — можуть загубитися або спотворитися.
- Змішування мов. Англійський системний промпт і український діалог іноді призводять до відповідей англійською або з вкрапленнями англійських термінів. Це лікується явною вказівкою мови відповіді, але перевіряти треба на своїх прикладах.
- Зміна токенізатора у вендора. Перехід Anthropic на новий словник у Claude 4.7 одразу додав близько 30% токенів на той самий текст. Розрахунки, зроблені на старій моделі, після оновлення треба перерахувати.
- Акційні ціни. Ставки Gemini 3.8 Flash і Gemini 4 Argon тимчасові й подвояться з 1 січня 2027 року та 1 грудня 2026 року відповідно. Бюджет, порахований за акційною ціною, за кілька місяців виявиться вдвічі меншим за потрібний.
- Стиснення промптів. LLMLingua-2 у дослідженні не втратив даних на 80 перевірених випадках, але це вузький тест на каталозі товарів. На юридичних чи медичних текстах стиснення може викинути важливе застереження.
- Приватність. Переклад через сторонній сервіс або чужу модель — це передання тексту ще одній стороні; для персональних даних клієнтів це окремий ризик.
Часті запитання
У скільки разів український текст дорожчий за англійський у токенах?
На сучасних токенізаторах — у 1,4–2,4 раза. У нашому замірі одного тексту від 29 жовтня 2026 року o200k (GPT-4o і сімейство GPT-5) дав 1,64 раза, Llama 4 — 1,44, Gemma 3 — 1,50, Qwen — 2,41. На старих GPT-3.5 і GPT-4 розрив був близько 2,8 раза. Для Claude і найновіших Gemini відкритих замірів щодо української немає.
Скільки токенів в одній сторінці українського тексту?
Сторінка на 1800 знаків на словнику o200k (GPT-4o і новіші) займає близько 600 токенів, та сама сторінка англійською — близько 354. На інших моделях українська сторінка коштує від 527 токенів (Llama 4) до 884 (Qwen) і 1037 на старому словнику GPT-4. Точну цифру для свого тексту дає безкоштовний підрахунок у tiktoken або в токенізаторі OpenAI.
Писати промпт англійською чи українською, якщо потрібна відповідь українською?
Для економії це майже не важливо: англійський системний промпт знижує рахунок приблизно на 7%, бо основну суму дає відповідь. Щодо якості прямих досліджень для української немає; роботи щодо інших мов частіше показують перевагу англійського промпту. Практичний шлях — перевірити обидва варіанти на 20–30 своїх прикладах і явно вказати мову відповіді.
Чи однаково Claude і ChatGPT рахують українську?
Ні. У кожної моделі свій словник токенів. Для GPT-4o і новіших українська довша за англійську приблизно в 1,64 раза. Словник Claude закритий; за документацією Anthropic моделі Claude 4.7 і новіші рахують будь-який текст приблизно на 30% довшим за попередні, а єдиний свіжий сторонній замір щодо кирилиці стосується російської і дає близько 3 разів. Порівняти на своєму тексті можна через безкоштовний count_tokens із ключем API.
Чи правда, що мова може коштувати в 17 разів дорожче?
Так, але не українська. Цифра з дослідження CLEAR описує розрив між найдорожчою і найдешевшою з 200 мов в одній моделі; у невигідному становищі там бірманська, тибетська, кхмерська й лаоська. Серед 20 найпоширеніших мов розрив становить 1,5–5 разів. Української в переказах дослідження не названо, а прямі заміри дають їй 1,4–2,4 раза.
Чи допомагає написання української латиницею заощадити токени?
На більшості актуальних моделей — ні, текст стає довшим. У нашому замірі транслітерація додала 18% токенів на o200k, 32% на Llama 4 і 27% на Gemma 3; дослідження arXiv 2608.21384 дає +2–19% на більшості токенізаторів. Економію транслітерація дає лише словникам, які ріжуть українську найсильніше: старому GPT-4 (−25%) і Qwen (−12%); Anthropic же прямо радить подавати текст рідною писемністю.