Claude Sonnet 5.5 коротко: кому брати, ціна й головний суперник
Claude Sonnet 5.5 — модель середнього класу від Anthropic, що вийшла 28 вересня 2026 року. Вона коштує стільки ж, скільки Claude Sonnet 5: $2 за мільйон вхідних токенів і $10 за мільйон вихідних (ціни на 21 жовтня 2026 року). Ми звірили обіцянки Anthropic із незалежними замірами, прогнали нову модель і Sonnet 5 на трьох однакових завданнях і порахували, коли нова модель справді обходиться дешевше.
- Claude Sonnet 5.5 коротко: кому брати, ціна й головний суперник
- Що змінилося в Claude Sonnet 5.5 порівняно з Sonnet 5
- Ціна Claude Sonnet 5.5: API, кеш, Batch і підписки Claude
- Бенчмарки за даними Anthropic: де нова модель зросла найбільше
- Незалежні заміри: Artificial Analysis, Vals AI та Epoch AI
- Скільки Sonnet 5.5 витрачає на завдання: рахунок вирішує рівень effort
- Sonnet 5.5 проти GPT-6.1 Sol і Grok 4.7: ціни, індекси, швидкість
- Наша перевірка Sonnet 5.5 і Sonnet 5 на трьох однакових завданнях
- Відгуки розробників: CodeRabbit, ComputingForGeeks, партнери
- Коли брати Sonnet 5.5, а коли Opus 5.5, GPT-6.1 Sol чи Grok 4.7
- Перехід із Sonnet 5 на Sonnet 5.5: що зламається в коді
- Де модель підводить: кіберризики, факти без пошуку, рахунок на max
- Поширені запитання про Claude Sonnet 5.5
- Кому підходить: щоденному програмуванню та багфіксам, рев’ю кожного пул-реквесту, роботі з документами, таблицями й слайдами, агентам із довгим контекстом понад 272 тис. токенів.
- Головний суперник — GPT-6.1 Sol з тією самою ціною $2/$10. За індексом Artificial Analysis Sonnet 5.5 вища (56 проти 52 на максимальному рівні зусилля), але завдання індексу в Sol коштує $0,72, а в Sonnet 5.5 — $5,46.
- Головне застереження: обіцянка «до 30% дешевше за завдання» не працює на максимальному рівні зусилля: там Sonnet 5.5 обходиться дорожче за Sonnet 5 — $5,46 проти $5,09 за завдання індексу Artificial Analysis.
- Кому не підходить: тим, хто займається тестуванням на проникнення (ризиковані кіберзапити модель передає Sonnet 5), і тим, хто ставить довідкові запитання без вебпошуку — у фактах «з пам’яті» вона слабша за старші моделі.
- Коли потрібна старша модель: для складної відкритої роботи сама Anthropic радить Claude Opus 5.5 — вона вдвічі дорожча ($4/$20), але, за словами компанії, «залишається помітно сильнішою» в завданнях, де потрібне тривале самостійне судження.
Один термін знадобиться в усій статті. Рівень зусилля (effort) — налаштування, яке визначає, скільки модель міркує перед відповіддю. У Sonnet 5.5 їх п’ять: low, medium, high, xhigh і max. Що вищий рівень, то більше вихідних токенів і то більший рахунок. У Claude Code та застосунках Claude за замовчуванням стоїть medium, в API — high.
Що змінилося в Claude Sonnet 5.5 порівняно з Sonnet 5
Sonnet 5 вийшла 30 червня 2026 року, Claude Sonnet 5.5 — 28 вересня, через три місяці. Ціна токенів не змінилася: вступні $2/$10 у Sonnet 5 Anthropic зробила постійними, і Sonnet 5.5 їх успадкувала. Усе інше помітно зрушило. Порівняння Claude Sonnet 5 і 5.5 за опублікованими даними:Параметр Sonnet 5 Sonnet 5.5 Джерело Дата виходу 30.06.2026 28.09.2026 Anthropic Вхід / вихід, $ за 1 млн токенів 2 / 10 2 / 10 Anthropic Читання кешу, $ за 1 млн 0,20 0,10 Anthropic Контекст / максимум відповіді 1 млн / 128 тис. 1 млн / 128 тис. (300 тис. у Batch, бета) документація Межа знань — червень 2026 документація Швидкість виведення, max (Artificial Analysis) 81,6 токена/с 135,5 токена/с AA, 21.10.2026 Індекс Artificial Analysis, max 38 56 AA, 21.10.2026 Вартість завдання індексу, max $5,09 $5,46 AA, 21.10.2026 Terminal-Bench 4.0 (дані Anthropic) 10,3% 70,6% анонс SWE-Bench Pro (system card) 63,2 81,3 system card Global MMLU, 42 мови 89,2% 92,1% system card Режим міркувань можна вимкнути вимкнути не можна, мінімум — between_toolsдокументація Кіберобмеження без окремого відкату ризиковані запити відкочуються на Sonnet 5 анонс Термін підтримки залишається активною не раніше 28.09.2027 документація
Що з цього важливо на практиці. По-перше, читання кешу подешевшало вдвічі — з $0,20 до $0,10 за мільйон токенів. Кеш — це повторно надіслана частина контексту, яку модель уже опрацювала: системна інструкція, документ, історія діалогу. В агентній роботі на нього припадає більша частина входу, тому зниження тут відчутніше, ніж здається з прайсу. У частині оглядів досі трапляється цифра $0,20 — це ціна Sonnet 5, у Sonnet 5.5 офіційно $0,10.




По-друге, швидкість. Anthropic обіцяє «на 30% і більше швидше». Незалежний замір це підтверджує із запасом: Artificial Analysis на 21 жовтня 2026 року бачить 135,5 токена за секунду проти 81,6 у Sonnet 5 — приріст 66%.
По-третє, режим міркувань тепер не можна вимкнути зовсім. Найтихіше налаштування — between_tools: модель не думає перед відповіддю, але міркує між викликами інструментів. Для тих, хто тримав Sonnet 5 з вимкненим мисленням, це зміна, що ламає код, — подробиці в розділі про перехід.
Ціна Claude Sonnet 5.5: API, кеш, Batch і підписки Claude
В API платять за токени — шматочки тексту по 3–4 символи. Окремо тарифікуються вхід (ваш запит і контекст), вихід (відповідь разом із міркуваннями) і кеш. Повний прайс Claude Sonnet 5.5 — за сторінкою Pricing у документації Anthropic станом на 21 жовтня 2026 року:Стаття витрат Ціна за 1 млн токенів Вхід $2 Вихід $10 Читання кешу $0,10 Запис у кеш на 5 хвилин $2,50 Запис у кеш на 1 годину $4 Batch API (асинхронно) знижка 50%: $1 вхід / $5 вихід Обробка лише в США ( inference_geo)множник ×1,1 на всі статті Довгий контекст увесь 1 млн за однією ставкою
Останній рядок — структурна перевага. Документація прямо пише: запит на 900 тис. токенів тарифікується за тією самою ставкою, що й запит на 9 тис. У GPT-6.1 Sol і Grok 4.7 є пороги, після яких дорожчає весь запит, — про це в розділі порівняння.
Приклад місячного рахунку за API
Візьмімо застосунок, який за місяць надсилає 40 млн вхідних токенів, із них 75% — читання кешу, і отримує 8 млн вихідних:Рядок рахунку Sonnet 5.5 Sonnet 5 Звичайний вхід: 10 млн × $2 $20 $20 Читання кешу: 30 млн $3 (по $0,10) $6 (по $0,20) Вихід: 8 млн × $10 $80 $80 Разом за місяць $103 $106 Через Batch API (−50%) $51,50 — З обробкою лише в США (×1,1) $113,30 —
Висновок із таблиці: за однакового обсягу токенів економія на кеші скромна — 3%. Основні гроші — вихідні токени, а їхня кількість залежить від рівня зусилля. Тому головний важіль економії в Sonnet 5.5 — не прайс, а налаштування effort (наступні розділи).
Підписки Claude і безкоштовний доступ
Для роботи в чаті та Claude Code замість оплати токенів є підписки. На сторінці тарифів Anthropic на 21 жовтня 2026 року:
| Тариф | Ціна | Для кого |
|---|---|---|
| Free | $0 | спробувати модель |
| Pro | $17 на місяць за річної оплати ($200 одразу) або $20 помісячно | регулярна робота однієї людини |
| Max | від $100 на місяць | інтенсивна робота, великі ліміти |
PCWorld повідомляє, що Sonnet 5.5 стала моделлю за замовчуванням для безкоштовних користувачів Claude. На сторінці тарифів Anthropic цього прямо не зазначено, тож вважайте це даними видання, а не офіційною обіцянкою. Як влаштовані ліміти підписок у роботі з кодом і як їх розтягнути, ми розбирали в матеріалі про ліміти Claude Code.
Доступ з України. За офіційним списком Anthropic, Claude та API працюють в Україні, крім Криму, Донецької, Херсонської, Луганської та Запорізької областей.
Бенчмарки за даними Anthropic: де нова модель зросла найбільше
Бенчмарк (англ. benchmark) — стандартний набір завдань, на якому моделі порівнюють в однакових умовах. Нижче — бенчмарки Claude Sonnet 5.5 з анонсу та system card Anthropic від 28 вересня 2026 року. Усі цифри цієї таблиці — дані вендора, незалежні заміри йдуть окремим розділом.Тест і що він перевіряє Sonnet 5.5 Sonnet 5 Opus 5.5 GPT-6 Sol Terminal-Bench 4.0 — агент у терміналі 70,6% 10,3% 66,4% (xhigh) н/д FrontierCode 1.1 — складні завдання з коду 46,2% (max) / 52,1% (xhigh) 42,4% 54,4% 49,3% CursorBench 4.0 — робота в редакторі Cursor 55,5% 34,1% 57,8% н/д GDPval-AA v2.1 — офісна робота, рейтинг Elo 1844 1449 1846 1487 Humanity’s Last Exam — іспит з інструментами 64,5% 54,9% 67,7% н/д OSWorld 2.1 — керування комп’ютером 80,1% 57,0% 81,8% н/д Chartography — читання графіків без інструментів 61,6% 15,6% 64,4% 53,6% SWE-Bench Pro — реальні завдання з репозиторіїв 81,3 63,2 89,9 н/д Global MMLU — знання 42 мовами 92,1% 89,2% 94,3% н/д
Найбільше зросли агентні навички. Terminal-Bench 4.0 — з 10,3% до 70,6%, це вище навіть за Opus 5.5 за даними тієї ж Anthropic. Chartography (читання графіків) — з 15,6% до 61,6%. OSWorld, де модель керує комп’ютером через інтерфейс, — з 57,0% до 80,1%. В офісній роботі (GDPval-AA) Sonnet 5.5 майже наздогнала Opus 5.5: 1844 проти 1846 Elo.
Три застереження до таблиці, без яких її легко прочитати неправильно:
- На FrontierCode рівень max гірший за xhigh (46,2% проти 52,1%). Anthropic пояснює це тим, що на max модель частіше запускала субагентів-рецензентів, і у двох розібраних випадках це призвело до тайм-ауту або правок поза межами завдання. Більше зусилля — не завжди кращий результат.
- GPT-6 Sol у таблиці — попередня версія, а не GPT-6.1 Sol. Порівняння з актуальною моделлю OpenAI є лише в незалежних майданчиків.
- У парі Claude Sonnet 5.5 vs Opus 5.5 старша модель попереду майже скрізь, крім Terminal-Bench. Сама Anthropic пише, що Opus 5.5 «залишається помітно сильнішою у складній відкритій роботі, що потребує тривалого судження».
Незалежні заміри: Artificial Analysis, Vals AI та Epoch AI
Вендорські таблиці показують модель у найкращих умовах. Нижче — заміри трьох незалежних майданчиків, які проганяють усі моделі за однією методикою. Дати важливі: рейтинги оновлюються з кожною новою моделлю.
Картка моделі на Artificial Analysis на 21 жовтня 2026 року, режим max. У рамках — дві речі, які варто тримати в голові разом: ліворуч індекс інтелекту 56 і друге місце з 214 моделей, праворуч ціна завдання індексу $5,46 і багатослівність — 420 млн вихідних токенів на прогін індексу за медіани 82 млн. Модель сильна й швидка, але на максимальному зусиллі пише дуже багато.Майданчик і метрика Sonnet 5.5 Для порівняння Дата заміру Artificial Analysis, індекс інтелекту (max) 56, 2-ге місце з 214 Opus 5.5 — 58, GPT-6.1 Sol — 52, Grok 4.7 — 46, Sonnet 5 — 38 21.10.2026 Artificial Analysis, швидкість виведення (max) 135,5 токена/с Grok 4.7 — 89,7, Sonnet 5 — 81,6, GPT-6.1 Sol — 54,3 21.10.2026 Artificial Analysis, вихідні токени на індекс (max) 420 млн Sonnet 5 — 370 млн, Grok 4.7 — 240 млн, GPT-6.1 Sol — 67 млн 21.10.2026 Artificial Analysis, час до першого токена (max, з урахуванням міркувань) 406 с — 21.10.2026 Vals Index 70,85%, 1-ше місце з 23 GPT-6.1 Sol — 63,94% (7-ме), Grok 4.7 — 58,56% (11-те) 21.10.2026 Vals AI, Terminal-Bench 4.0 64,14% GPT-6.1 Sol — 55,05%, Grok 4.7 — 28,79% 21.10.2026 Vals AI, CyberBench v1.1 59,58%, 36-те місце з 47 — 21.10.2026 Epoch AI, індекс можливостей ECI 166, 6-те місце з 253 найкращий результат — 169 21.10.2026 Epoch AI, SimpleQA Verified (факти без пошуку) 47% Opus 5.5 — 72% 21.10.2026 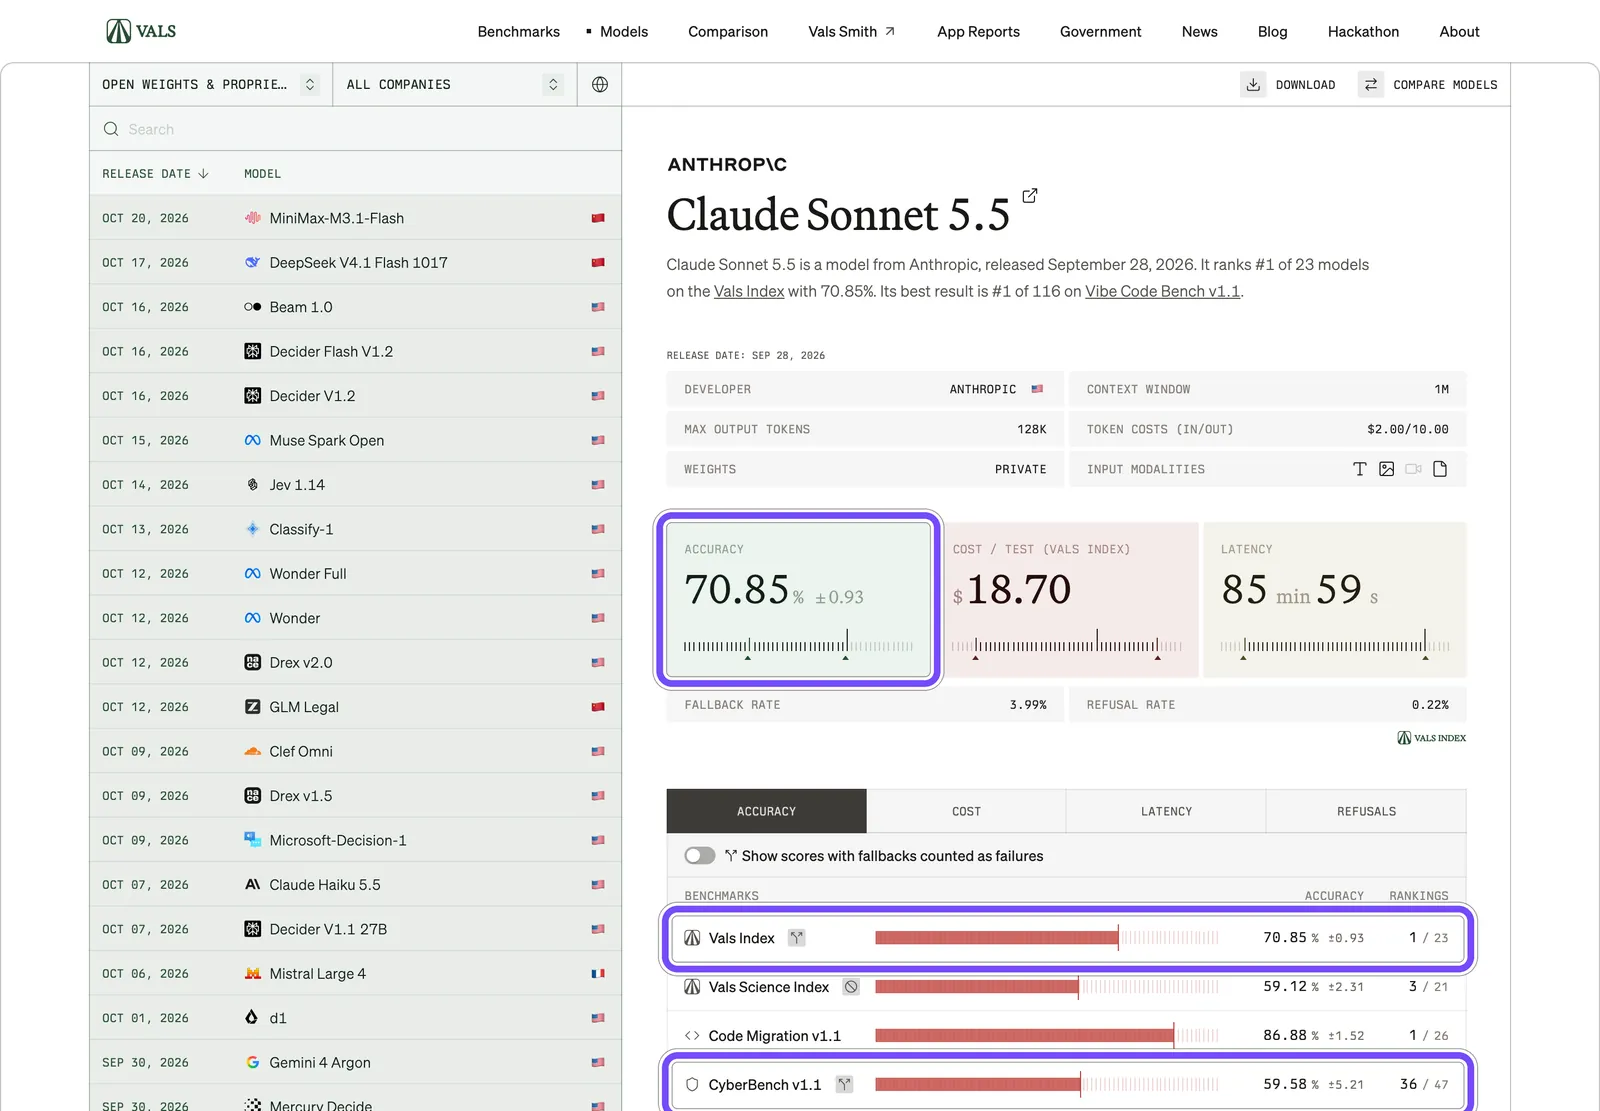
На Vals AI на 21 жовтня 2026 року Sonnet 5.5 — перша з 23 моделей у зведеному Vals Index з 70,85% (верхня й середня рамки на кадрі). Нижня рамка — CyberBench v1.1: 59,58% і лише 36-те місце з 47. Це слід кіберобмежень: Vals запускала модель із відкатом на Sonnet 5, і на CyberBench на відкат пішли 54 завдання з 116. Якщо вважати їх проваленими, результат падає з 59,58% до 41,97%. По всьому Vals Index частка відкатів — 3,99%. Середнє завдання Vals Index обходиться майданчику в $18,70 — проти $3,61 у GPT-6.1 Sol і $11,63 у Grok 4.7.
Що видно, якщо покласти незалежні цифри поруч із вендорськими:
- Terminal-Bench 4.0 нижчий за заявлений. Anthropic пише 70,6%, прогін Vals AI дав 64,14%. Різниця в 6,5 пункту — звична річ для різних обв’язок і налаштувань, але спиратися варто на незалежну цифру. Відрив від GPT-6.1 Sol (55,05%) при цьому зберігається.
- Лідерство в індексах підтверджується. І Artificial Analysis, і Vals AI ставлять Sonnet 5.5 на перше-друге місце, вище за GPT-6.1 Sol і Grok 4.7. Вище за неї в індексі AA лише Opus 5.5.
- Слабке місце — знання без пошуку. Epoch наміряла 47% на SimpleQA Verified проти 72% в Opus 5.5. System card Anthropic повідомляє те саме: за шкалою AA-Omniscience у Sonnet 5.5 підсумковий бал 0,35 — краще, ніж у Sonnet 5, але модель трохи частіше дає неправильну відповідь там, де варто було б сказати «не знаю».
Чого ми не знайшли. Свіжого місця в LMArena на 21 жовтня 2026 року немає: сторінка рейтингу недоступна для перевірки, а кешовані копії застаріли. Окремої оцінки державних інститутів безпеки ШІ (американського CAISI чи британського AISI) для Sonnet 5.5 теж немає — у system card згадано лише бенчмарк Gray Swan, створений разом із ними.
Скільки Sonnet 5.5 витрачає на завдання: рахунок вирішує рівень effort
Anthropic пише, що в її тестах Sonnet 5.5 обходиться «до 30% дешевше за завдання», ніж Sonnet 5. Ключове слово — «до». Ціна завдання — це прайс, помножений на кількість токенів, а кількість токенів визначає рівень зусилля. Artificial Analysis прогнала індекс на різних рівнях, і картина виходить така (на 21 жовтня 2026 року):Модель і рівень зусилля Індекс AA Вартість завдання індексу Центів за 1 бал індексу Sonnet 5.5, max 56 $5,46 9,8 Sonnet 5.5, xhigh 52 $2,01 3,9 Sonnet 5.5, high 47 $0,88 1,9 Sonnet 5, max 38 $5,09 13,4 GPT-6.1 Sol, max 52 $0,72 1,4 GPT-6.1 Sol, high 50 $0,32 0,6 Grok 4.7, xhigh 46 $3,74 8,1
Останній стовпець — наш розрахунок: вартість завдання, поділена на бал індексу. Він відповідає на запитання «скільки коштує одиниця якості» — в англомовних порівняннях це називають співвідношенням price-performance. Для Claude Sonnet 5.5 воно дуже залежить від обраного рівня зусилля.
Що з цього випливає:
- На max Sonnet 5.5 дорожча за Sonnet 5 за завдання — на 7% ($5,46 проти $5,09). Обіцяної економії тут немає.
- Але за одиницю якості вона дешевша на 27% (9,8 цента за бал проти 13,4). Тобто «−30%» майже справджується, якщо рахувати не завдання, а результат: за ті самі гроші ви отримуєте модель на 18 балів розумнішу.
- Перехід з max на xhigh зрізає рахунок у 2,7 раза ціною 4 балів індексу. З max на high — у 6,2 раза ціною 9 балів.
- GPT-6.1 Sol дешевша за близької якості. Sonnet 5.5 на xhigh набирає ті самі 52 бали, що Sol на max, але коштує $2,01 проти $0,72 — у 2,8 раза дорожче. Причина — багатослівність: на прогін індексу Sol витрачає 67 млн вихідних токенів, Sonnet 5.5 на max — 420 млн.
Незалежні тести на реальних завданнях показують ту саму залежність від рівня зусилля:
- CodeRabbit, рев’ю коду (28 вересня 2026 року): виклики моделі коштували $0,46 за рев’ю проти $1,16 у Sonnet 5 — на 60% дешевше, бо Sonnet 5.5 витрачає на рев’ю значно менше токенів.
- ComputingForGeeks, DevOps-завдання: дев’ять генерацій (маніфест Kubernetes, bash-скрипт і конфігурація OpenTofu, по три прогони) на рівні medium обійшлися в $0,0665, на max — у $1,3585, тобто у 20 разів дорожче за однакового результату. Автори радять тримати max лише для завдань, де він доведено окупається.
Практичний висновок: в API за замовчуванням стоїть high. Для рутини явно задайте medium, а xhigh і max вмикайте точково — на завданнях, де ви перевірили, що вони дають приріст.
Sonnet 5.5 проти GPT-6.1 Sol і Grok 4.7: ціни, індекси, швидкість
Порівняння Sonnet 5.5 з GPT-6.1 Sol і Grok 4.7 — головний вибір осені 2026 року в середньому ціновому класі. Усі три вийшли з різницею у вісім днів: Grok 4.7 — 21 вересня, Sonnet 5.5 — 28 вересня, GPT-6.1 Sol — 29 вересня 2026 року на DevDay OpenAI. Ціни й заміри на 21 жовтня 2026 року:Параметр Sonnet 5.5 GPT-6.1 Sol Grok 4.7 Дата виходу 28.09.2026 29.09.2026 21.09.2026 Вхід / вихід, $ за 1 млн 2 / 10 2 / 10 2 / 6 Читання кешу, $ за 1 млн 0,10 0,10 0,50 Контекст 1 млн, одна ставка 1,05 млн; запит понад 272 тис. — вхід і кеш ×2, вихід ×1,5 на весь запит 500 тис.; запит від 200 тис. — $4 / $1 кеш / $12 Максимум відповіді 128 тис. 128 тис. без ліміту (за документацією xAI) Межа знань червень 2026 30 квітня 2026 травень 2026 Індекс Artificial Analysis (верхній рівень) 56 (max) 52 (max) 46 (xhigh) Вартість завдання індексу AA $5,46 $0,72 $3,74 Швидкість виведення (AA) 135,5 токена/с 54,3 токена/с 89,7 токена/с Vals Index 70,85%, 1-ше місце 63,94%, 7-ме 58,56%, 11-те Terminal-Bench 4.0 (Vals AI) 64,14% 55,05% 28,79% (xAI заявляє 37,6%) Відкриті ваги ні ні ні
Ціни кешу й поріг довгого контексту в Grok 4.7 — за сторінкою цін у документації xAI: якщо промпт сягає 200 тис. токенів, увесь запит оплачується за підвищеною ставкою.
Claude Sonnet 5.5 vs GPT-6.1 Sol. Ціна токена однакова, якість у Sonnet 5.5 вища в обох незалежних індексах, швидкість — у 2,5 раза вища. Але Sol значно ощадливіше витрачає токени, тому дешевша за завдання в рази. Якщо ваше навантаження — тисячі коротких агентних прогонів, де вирішує ціна, Sol вигідніша. Попередницю цієї моделі ми докладно розбирали в огляді GPT-6 Sol і Luna.
Claude Sonnet 5.5 vs Grok 4.7. У Grok дешевший вихід ($6 проти $10), але за обома незалежними індексами він нижчий і за Sonnet 5.5, і за GPT-6.1 Sol, а на Terminal-Bench 4.0 у прогоні Vals AI відстає більш ніж удвічі. Заявлені xAI 37,6% на цьому тесті незалежний замір не підтвердив: у Vals AI вийшло 28,79%. Попередню версію ми докладно розбирали в огляді Grok 4.5.
Довгий контекст: де Sonnet 5.5 дешевша в рази
Пороги в GPT-6.1 Sol (272 тис.) і Grok 4.7 (200 тис.) вмикають підвищену ціну на ВЕСЬ запит. Агент, який завантажує в контекст великий репозиторій, переходить поріг на початку сесії й залишається за ним. Ми порахували один крок агента за однакової кількості токенів: 90% контексту з кешу, відповідь 4 тис. токенів, без запису в кеш.Крок агента Sonnet 5.5 GPT-6.1 Sol Grok 4.7 Контекст 150 тис. токенів (нижче за всі пороги) $0,084 $0,084 $0,122 Контекст 400 тис. токенів (вище за пороги) $0,156 $0,292 $0,568 Сесія зі 100 кроків по 400 тис. $15,60 $29,20 $56,80
Нижче за пороги Sonnet 5.5 і Sol коштують однаково. Вище — Sonnet 5.5 майже вдвічі дешевша за Sol і в 3,6 раза дешевша за Grok 4.7. Застереження те саме, що в розділі про effort: розрахунок виходить з однакової кількості токенів, а насправді GPT-6.1 Sol пише значно коротше. У коротких завданнях із великим виведенням Sol може виявитися дешевшою, у довгих сесіях із великим контекстом виграє Sonnet 5.5.
Наша перевірка Sonnet 5.5 і Sonnet 5 на трьох однакових завданнях
21 жовтня 2026 року ми прогнали три однакові завдання через Claude Code CLI версії 2.1.306 на чотирьох конфігураціях: Sonnet 5.5 на рівнях low, medium і high та Sonnet 5 з налаштуваннями за замовчуванням. Умови однакові: короткий нейтральний системний промпт, без інструментів, без збереження сесії. Це по одному прогону на конфігурацію — ілюстрація поведінки, а не бенчмарк: один прогін не усереднює випадковість. Рівні xhigh і max ми не проганяли — на простих завданнях вони дають лише зростання рахунку, це показали незалежні тести вище.Завдання і що перевіряли Sonnet 5.5 low Sonnet 5.5 medium Sonnet 5.5 high Sonnet 5 Код merge_intervals + тести: наш набір із 12 перевірок12 з 12 12 з 12 12 з 12 12 з 12 …власних тестів моделі (усі пройшли) 14 16 16 10 …вихідних токенів / час відповіді 1036 / 10,1 с 1142 / 10,2 с 1174 / 9,2 с 911 / 11,9 с Пояснення українською, ліміт 3–4 речення 4 — вклалася 5 — перевищила 5 — перевищила 4 — вклалася Розрахунок рахунку API (правильна відповідь — $103) правильно, 120 токенів правильно, 119 токенів правильно, 219 токенів правильно, 198 токенів
Завдання 1 — код. Написати на Python функцію об’єднання відрізків merge_intervals і тести pytest, вивести один блок коду. Усі чотири функції пройшли наш спільний набір із 12 випадків (порожній список, дотичні й вкладені відрізки, дублікати). Усі моделі виконали вимогу «лише код». Різниця — у старанності: Sonnet 5.5 написала 14–16 власних тестів, Sonnet 5 — 10. І Sonnet 5.5 відповіла трохи швидше на всіх рівнях.
Завдання 2 — пояснення українською. У 3–4 реченнях без списків пояснити новачкові, чим кешування промптів відрізняється від звичайного запиту. Усі відповіді написані грамотною українською без русизмів, суть передано правильно, у всіх є вдала побутова аналогія (закладка в книжці, конспект). Але на medium і high Sonnet 5.5 вийшла за ліміт — п’ять речень. На medium п’ятим стала практична порада ставити незмінну частину запиту на початок, на high модель розбила пояснення на два речення. Порада корисна, проте ліміт довжини порушено в обох випадках. Sonnet 5 і Sonnet 5.5 на low вклалися в чотири.
Завдання 3 — розрахунок. Порахувати місячний рахунок за API з розділу про ціни (40 млн вхідних токенів, 75% з кешу, 8 млн вихідних). Усі чотири конфігурації дали правильні $103. Sonnet 5.5 на medium вклалася в 119 вихідних токенів проти 198 у Sonnet 5 — на простому розрахунку нова модель помітно лаконічніша.
Вартість прогонів із CLI ми не порівнюємо: її спотворює разовий запис контексту самого Claude Code в кеш на першому виклику (близько 42 тис. токенів). Підсумок збігається з незалежними даними: на простих завданнях якість двох моделей однакова, Sonnet 5.5 старанніша в тестах і швидша, а строгий формат відповіді на medium і high варто перевіряти.
Відгуки розробників: CodeRabbit, ComputingForGeeks, партнери
Відгуки з відкритою методикою цінніші за цитати з пресрелізу: у них видно, на чому і як міряли. Знайшлося два такі розбори.
CodeRabbit — рев’ю коду (28 вересня 2026 року). Сервіс автоматичного рев’ю прогнав модель на 13 найскладніших відомих багах і на 44 реальних пул-реквестах відкритих проєктів:
- знайшла 6 багів із 13 проти 4 у Sonnet 5 за тієї самої точності зауважень — 41,2% проти 40,0%;
- середнє рев’ю тривало 6:33 проти 13:31 у Sonnet 5 — удвічі швидше;
- виклики моделі коштували близько $0,46 за рев’ю проти $1,16 — на 60% дешевше;
- Opus 5.5 на тих самих 13 випадках знайшла 8 багів на стандартному рівні та 10 на max.
Самі автори попереджають: 13 випадків — мала вибірка, а чотирьох із них не розв’язала жодна конфігурація Sonnet. Висновок CodeRabbit: це перший Sonnet, який вони розглядають для основного рев’ю кожного пул-реквесту, але заміною Opus 5.5 він не є. Якщо хочете налаштувати таке рев’ю в себе, у нас є розбір, як підключити Claude Code до GitHub з авторев’ю PR.
ComputingForGeeks — DevOps (28 вересня 2026 року). Автори генерували маніфести Kubernetes, bash-скрипти й конфігурації OpenTofu, по три прогони на конфігурацію. Усі файли пройшли лінтери, але реальне розгортання в кластері k3s показало різницю: у Sonnet 5 жодне з трьох розгортань не запрацювало, у Sonnet 5.5 на medium і вище — усі три. Рівень low виявився єдиним налаштуванням Sonnet 5.5, яке видало неробочі маніфести. А max дав той самий результат, що medium, за двадцятикратну ціну.
Відгуки партнерів з анонсу Anthropic. Це приклади, які відібрала сама компанія, — найкращі випадки, а не середнє:
- Balyasny Asset Management: на 2441 фінансовому завданні Sonnet 5.5 обійшла Sonnet 5 і витрачала близько 121 тис. токенів на відповідь проти 497 тис.;
- Base44: на 118 збірках застосунків — якість на рівні Opus 5 за 3,6 ітерації проти 7,7 в Opus 5;
- Zendesk: тікети обробляються на 20% швидше;
- Slack: приблизно на 14% менше вихідних токенів без правки промптів.
Коли брати Sonnet 5.5, а коли Opus 5.5, GPT-6.1 Sol чи Grok 4.7
Рішення за сценаріями на 21 жовтня 2026 року:Сценарій Що брати Чому Щоденний код, багфікси, Claude Code Sonnet 5.5 на medium якість вища, ніж у Sonnet 5, за тієї самої ціни токена, effort за замовчуванням у Claude Code — medium Рев’ю кожного пул-реквесту Sonnet 5.5 CodeRabbit: більше знайдених багів, рев’ю вдвічі швидше і на 60% дешевше Рев’ю високоризикових змін, архітектура Opus 5.5 8–10 багів із 13 проти 6; удвічі дорожча ($4/$20) Документи, таблиці, слайди Sonnet 5.5 GDPval-AA 1844 Elo — майже як Opus 5.5 Агенти з контекстом понад 272 тис. токенів Sonnet 5.5 одна ставка на весь 1 млн, у конкурентів націнка на весь запит Масові короткі агентні прогони GPT-6.1 Sol $0,72 за завдання індексу AA проти $2,01 у Sonnet 5.5 за рівного індексу Довідкові запитання без вебпошуку Opus 5.5 або Sonnet 5.5 з вебпошуком у Sonnet 5.5 слабші знання «з пам’яті»: SimpleQA Verified 47% проти 72% в Opus 5.5 Дешеве виведення великих текстів Grok 4.7 вихід $6 проти $10, але нижчий за незалежними індексами Тести на проникнення, дослідження вразливостей не Sonnet 5.5 ризиковані кіберзапити відкочуються на Sonnet 5
Коротка версія для вибору між Sonnet 5.5 і GPT-6.1 Sol: якщо потрібна найкраща модель класу та швидкість — Sonnet 5.5; якщо потрібна мінімальна ціна за виконане завдання за близької якості — GPT-6.1 Sol. Якщо ви вже на Sonnet 5, переходити варто: якість вища, а на рівні medium рахунок майже не зміниться (у ComputingForGeeks — $0,0665 проти $0,0650), а на рев’ю коду в CodeRabbit він упав на 60%. Але спершу перевірте свій код за списком нижче.
Перехід із Sonnet 5 на Sonnet 5.5: що зламається в коді
Через API Sonnet 5.5 підключається зміною ідентифікатора на claude-sonnet-5-5. Але документація Anthropic перелічує п’ять змін, що ламають код, який уже працює на Sonnet 5.
Список на кадрі знято зі сторінки моделі в документації Claude 21 жовтня 2026 року. Покроково, що перевірити:
- Вимкнене мислення більше не працює. Запит із
thinking: {type: "disabled"}повертає помилку. Мінімальне налаштування —between_tools: воно прибирає міркування перед відповіддю, але залишає їх між викликами інструментів. Працює воно на рівні зусилля high і нижче. - Примусовий виклик інструмента повертає помилку. Якщо ви змушували модель викликати конкретний інструмент через
tool_choice, перейдіть на structured outputs — структуровану відповідь за заданою схемою. - Блоки міркувань прив’язані до моделі та діалогу. Переносити їх із діалогів з іншою моделлю не можна.
- Старий інструмент керування комп’ютером
computer_20251124не приймається на Claude API та Google Cloud — оновіть інтеграції computer use. - Інструмент advisor більше не приймає Opus 4.8, Opus 4.7, Sonnet 5 і Haiku 5.5 у ролі радника.
Ще одна зміна запит не валить, але змінює форму відповіді: текст між викликами інструментів приходить у блоках міркувань. Застосунок, який транслює цей текст користувачеві, «замовкає» між викликами, доки не задано параметр display або не ввімкнено between_tools.
Дві речі не нові, але про них варто пам’ятати під час переїзду. Нестандартні temperature, top_p і top_k дають помилку 400 — так було й у Sonnet 5, тому робочий код їх уже не надсилає. І задайте рівень зусилля явно: в API за замовчуванням high, а для рутини, за даними ComputingForGeeks, medium дає той самий результат дешевше.
Sonnet 5 при цьому залишається доступною, а Sonnet 5.5 Anthropic обіцяє підтримувати не раніше ніж до 28 вересня 2027 року — час на перехід є.
Де модель підводить: кіберризики, факти без пошуку, рахунок на max
- Кібербезпека. Sonnet 5.5 — перша модель лінійки Sonnet із захистом рівня Opus: ризиковані кіберзапити помітно для користувача відкочуються на Sonnet 5. System card попереджає, що відмов стане більше навіть на безневинних завданнях із безпеки. На Vals AI CyberBench на 21 жовтня 2026 року модель на 36-му місці з 47. Пошуку й виправлення багів у власному коді це не стосується, але для пентесту модель незручна.
- Факти без пошуку. За SimpleQA Verified у Sonnet 5.5 47% проти 72% в Opus 5.5, а за system card вона трохи частіше, ніж Sonnet 5, дає неправильну відповідь замість «не знаю». Для довідкових запитань вмикайте вебпошук або перевіряйте відповідь.
- Багатослівність на максимумі. На max модель пише 420 млн вихідних токенів на прогін індексу AA, а час до першого токена на 21 жовтня 2026 року — 406 секунд. Max «за замовчуванням» обертається кратно більшим рахунком і довгим очікуванням.
- Формат відповіді. У нашому прогоні на medium і high модель порушила заданий ліміт довжини на одне речення. Якщо потрібен строгий формат — перевіряйте виведення.
- Зміни API, що ламають код. Код під Sonnet 5 може впасти на п’яти змінах зі списку вище.
- Вендорські цифри не дорівнюють незалежним. Terminal-Bench у Vals AI — 64,14% замість заявлених 70,6%. Орієнтуйтеся на незалежні заміри та на власний тест.
- Дані та акаунти. За анонсом Anthropic, Sonnet 5.5, як Opus 5.5 і Sonnet 5, доступна в режимі нульового зберігання даних (zero data retention). Міркування моделі тепер прив’язані до акаунта, в якому створені: якщо ви переносите діалоги між акаунтами або змінюєте акаунт посеред сесії Claude Code, звіртеся з документацією Anthropic.
- Доступ. Claude працює в Україні, крім Криму та Донецької, Херсонської, Луганської й Запорізької областей: у списку Anthropic ці області виключено повністю, без поділу на окуповані та підконтрольні частини.
- Що застаріє першим. Місця в рейтингах і ціни конкурентів: нові моделі виходять щокілька тижнів. Свіжі цифри — на сторінці тарифів Anthropic і в картках моделей Artificial Analysis та Vals AI.
Поширені запитання про Claude Sonnet 5.5
Чим Claude Sonnet 5.5 відрізняється від Sonnet 5?
За тієї самої ціни $2/$10 Sonnet 5.5 удвічі дешевша на читанні кешу ($0,10 проти $0,20), на 66% швидша за заміром Artificial Analysis і помітно сильніша: індекс AA 56 проти 38, Terminal-Bench 4.0 за даними Anthropic — 70,6% проти 10,3%. Мислення в ній не можна вимкнути зовсім, а для коду під Sonnet 5 є п’ять змін API, що ламають сумісність.
Скільки коштує Claude Sonnet 5.5 і чи можна користуватися безкоштовно?
В API — $2 за мільйон вхідних токенів, $10 за вихідні та $0,10 за читання кешу, через Batch API удвічі дешевше. Підписка Pro коштує $17 на місяць за річної оплати або $20 помісячно, Max — від $100. За даними PCWorld, Sonnet 5.5 — модель за замовчуванням і на безкоштовному тарифі, але Anthropic на сторінці тарифів цього прямо не пише.
Що краще для програмування: Claude Sonnet 5.5 чи GPT-6.1 Sol?
За якістю попереду Sonnet 5.5: на 21 жовтня 2026 року Terminal-Bench 4.0 у Vals AI — 64,14% проти 55,05%, індекс Artificial Analysis — 56 проти 52. Sonnet 5.5 ще й у 2,5 раза швидша. GPT-6.1 Sol виграє ціною завдання: вона пише значно менше токенів, тому для масових недорогих агентних прогонів вигідніша саме вона.
Чи правда, що Sonnet 5.5 на 30% дешевша за Sonnet 5?
Не на всіх рівнях зусилля. Anthropic пише «до 30% дешевше за завдання», CodeRabbit на рев’ю коду нарахувала навіть −60%. Але на рівні max завдання індексу Artificial Analysis коштує $5,46 проти $5,09 у Sonnet 5 — дорожче на 7%. У перерахунку на бал індексу Sonnet 5.5 однаково вигідніша на 27%.
Чи можна повністю вимкнути міркування в Sonnet 5.5?
Ні. Запит із вимкненим мисленням повертає помилку. Мінімальне налаштування — between_tools (на рівні зусилля high і нижче): модель не міркує перед відповіддю, але думає між викликами інструментів. Міркування оплачуються як вихідні токени, тому обсяг регулюйте рівнем зусилля: для рутини — medium, xhigh і max — лише там, де вони доведено дають приріст.
Чи працює Claude Sonnet 5.5 в Україні?
Так. За офіційним списком Anthropic, Claude та API доступні в Україні, крім Криму, Донецької, Херсонської, Луганської та Запорізької областей. Модель можна використовувати в застосунках Claude за підпискою або через API з оплатою за токени. Для роботи з кодом є Claude Code, де Sonnet 5.5 за замовчуванням працює на рівні зусилля medium.