Коротко: чи варто брати RX 9070 XT під локальні LLM і картинки
Radeon RX 9070 XT — ігрова відеокарта AMD на архітектурі RDNA 4 з 16 ГБ відеопамʼяті. Вона вийшла 6 березня 2025 року за рекомендованою ціною $599, і відтоді її дедалі частіше розглядають як RX 9070 XT для нейромереж: локальних мовних моделей (LLM), генерації картинок і відео. Далі розбираємо, скільки токенів за секунду вона дає, які моделі вміщуються в 16 ГБ, як із нею працює ROCm — програмна платформа AMD для обчислень на відеокарті, аналог CUDA в NVIDIA, — і чому в листопаді 2026 питання «чи варто» вирішує вже ціна, а не софт.
- Коротко: чи варто брати RX 9070 XT під локальні LLM і картинки
- Що RDNA4 дає нейромережам: 128 AI-прискорювачів, FP8 і 16 ГБ GDDR6
- Скільки tok/s дає RX 9070 XT: заміри на 9B, 14B, 20B і 30B
- Стеля 16 ГБ у RX 9070 XT: які моделі вміщуються, а які гальмують
- ROCm 10.1 для RX 9070 XT: що працює на Linux і Windows
- Stable Diffusion і ComfyUI на RX 9070 XT: швидкість і підводні камені
- RX 9070 XT проти RX 7900 XTX, R9700, RTX 5060 Ti і 5070 Ti
- Ціна RX 9070 XT у листопаді 2026: США, Європа, Україна і вживані
- Проблеми RX 9070 XT у ШІ: ComfyUI, vLLM, LM Studio і драйвери
- Кому брати RX 9070 XT під ШІ, а кому — 7900 XTX, R9700 чи RTX
- Часті запитання про RX 9070 XT для локальних LLM
Власної карти на стенді в нас немає. Усі цифри швидкості в статті — чужі заміри, і біля кожної підписано, хто міряв, на якій системі й коли.
- Мовні моделі до 14–20 млрд параметрів — так. gpt-oss:20b видає 91,9 токена за секунду на Linux і близько 73 на Windows 11, Qwen3 14B — 51–52 tok/s (стенди hirokuze і gadelog, вересень 2026).
- Щільні моделі на 27B і більше — ні. У 4-бітному кванті вони важать від 17 ГБ, виходять за межі 16 ГБ, і генерація падає до 6–7 tok/s.
- MoE-моделі на 26–35B — із застереженнями. Навіть частково вивантажені в оперативну памʼять, вони тримають близько 35 tok/s.
- ROCm більше не перешкода. У ROCm 10.1.0 від 5 жовтня 2026 року карта є в офіційному списку і для Linux, і для Windows 11.
- Картинки й відео — слабке місце. У ComfyUI за замірами 2025 року карта відстає від RTX 5070 Ti більш ніж удвічі й упирається в нестачу памʼяті під час декодування.
- Ціна зʼїла перевагу. Близько $920 у США на 9–11 листопада 2026 року проти $770 за RTX 5060 Ti 16 ГБ і приблизно $850 за вживану RX 7900 XTX із 24 ГБ.
Вердикт одним абзацом: RX 9070 XT — швидка карта «до 20B», особливо в обробці довгого промпту, але з жорсткою стелею 16 ГБ і нерівною дифузією. Якщо ви вже купили її для ігор — вона закриє більшість щоденних завдань із локальними моделями. Якщо купуєте саме під ШІ, порівняйте її з вживаною RX 7900 XTX і Radeon AI PRO R9700 у розділі про ціни: на нинішньому ринку це рішення рахують у доларах за гігабайт і за токен.
Що RDNA4 дає нейромережам: 128 AI-прискорювачів, FP8 і 16 ГБ GDDR6
Щоб зрозуміти, чого чекати від RX 9070 XT для нейромереж, треба розділити роботу мовної моделі на дві фази. Перша — prefill, або обробка промпту: модель читає ваш запит і документ цілком, і тут вирішують обчислювальні блоки. Друга — генерація: модель пише відповідь по одному токену (шматочку слова), і для кожного нового токена їй потрібно знову прочитати з відеопамʼяті всі свої ваги. Тому генерацію обмежує не потужність ядер, а швидкість памʼяті.
Сильна сторона RDNA 4 — перша фаза. AMD додала в карту 128 AI-прискорювачів — матричних блоків, які перемножують таблиці чисел, — і навчила їх формату FP8 (8-бітні числа з рухомою комою, варіанти E4M3 і E5M2). За специфікацією AMD пікова продуктивність матричних блоків — 195 TFLOPs у FP16, 389 TFLOPs у FP8, 389 TOPs в INT8 і 779 TOPs в INT4. Це теоретичні піки виробника: у токени за секунду вони безпосередньо не перекладаються.
Слабка сторона — памʼять. 16 ГБ GDDR6 на 256-бітній шині дають до 640 ГБ/с. Простий розрахунок показує, що це означає на практиці. Qwen3 14B у кванті займає близько 9,3 ГБ. Ділимо 640 ГБ/с на 9,3 ГБ — отримуємо теоретичну стелю близько 69 токенів за секунду. Реальний замір на Linux дав 52,2 tok/s, тобто приблизно 76% від стелі. Для порівняння, у RX 7900 XTX з її 960 ГБ/с та сама стеля була б близько 103 tok/s.Параметр RX 9070 XT RX 7900 XTX Radeon AI PRO R9700 RTX 5060 Ti 16 ГБ RTX 5070 Ti Відеопамʼять 16 ГБ GDDR6 24 ГБ GDDR6 32 ГБ GDDR6 16 ГБ GDDR7 16 ГБ GDDR7 Шина памʼяті 256 біт 384 біт 256 біт 128 біт 256 біт Пропускна здатність 640 ГБ/с 960 ГБ/с 640 ГБ/с 448 ГБ/с 896 ГБ/с AI-/тензорні блоки 128 192 128 н/д 280 Споживання (TBP) 304 Вт 355 Вт 300 Вт н/д 300 Вт Рекомендований БЖ від 750 Вт від 800 Вт н/д н/д н/д Ціна на старті $599 $999 $1 299 н/д $749
Специфікації AMD — за сторінками виробника, дані RTX 5070 Ti і кількість блоків RX 7900 XTX — за таблицею Tom’s Hardware, обсяг і шина RTX 5060 Ti — за таблицею результатів llama.cpp, її 448 ГБ/с — за специфікацією NVIDIA в переказі localaimaster. З таблиці видно головну суперечність карти. За матричними блоками RX 9070 XT новіша й сильніша за RX 7900 XTX, але за пропускною здатністю памʼяті поступається їй третиною. А Radeon AI PRO R9700 — це той самий чип Navi 48 з тією самою швидкістю памʼяті, але з удвічі більшим обсягом.
Споживання 304 Вт і рекомендація AMD щодо блока живлення від 750 Вт важливі, якщо ви ставите карту в старий корпус. Під тривалим навантаженням генерації карта працює годинами, тож запас за живленням і охолодженням краще закласти одразу.
Скільки tok/s дає RX 9070 XT: заміри на 9B, 14B, 20B і 30B
Коротка відповідь: на моделях, які цілком вміщуються в 16 ГБ, RX 9070 XT видає від 50 до 90 токенів за секунду. Щойно модель виходить за межі 16 ГБ, усе залежить від її архітектури: щільна модель падає до 6–7 tok/s, а MoE-модель утримує близько 35 tok/s.
Нижче — зведення двох незалежних стендів. Перший — репозиторій hirokuze на GitHub: Linux, Ollama 0.18.2 у Docker з ROCm, температура 0,1, модель цілком у відеопамʼяті. Другий — японський блог gadelog: Windows 11, Ollama 0.30.10, відповідь на 300 токенів, середнє з трьох прогонів. Обидва заміри опубліковано до вересня 2026 року.Модель Тип Обсяг у памʼяті Linux (hirokuze), tok/s Windows 11 (gadelog), tok/s Gemma 4 (клас 7,5B) щільна 9,6 ГБ н/д ~91 Qwen3.5 9B щільна н/д 57,8 н/д Qwen3 14B щільна 9,3 ГБ 52,2 ~51 gpt-oss:20b MoE ~13 ГБ 91,9 ~73 Gemma 4 26B MoE 17 ГБ (84% на GPU) н/д ~35 GLM-4.7-Flash 30B MoE 19,5 ГБ (81% на GPU) н/д ~35 Qwen 27B (Q4) щільна 17 ГБ 6,3 ~7
Окремий стенд bhat-sahab на llama.cpp з Vulkan показує, що навіть MoE-модель Qwen3.6-35B-A3B у кванті IQ4_XS (18,2 ГБ) може давати 46–53 tok/s. Але це результат тонкого налаштування: частину експертів винесено на процесор прапорцем --n-cpu-moe, контекст 32 тис. токенів, увімкнено передбачення кількох токенів (MTP). Безпосередньо порівнювати його з цифрами Ollama не можна.
gpt-oss:20b на Linux і Windows: чому правильні і 91,9, і 73 tok/s
Різниця в 26% між стендами — не помилка когось з авторів. Це різні операційні системи, різні версії Ollama (0.18.2 проти 0.30.10), різні промпти і, найімовірніше, різний бекенд: hirokuze запускав Ollama з ROCm у Docker, а на Windows Ollama для цієї карти за документацією йде через Vulkan. Тому ми не усереднюємо, а даємо обидві цифри з підписом. І узагальнювати «Linux завжди швидший» за однією парою стендів не можна: на gpt-oss:20b Linux-стенд швидший на 26%, а на Qwen3 14B різниця в межах 2% (52,2 проти ~51 tok/s). Навіть 73 tok/s для 20-мільярдної моделі — комфортна швидкість для чату й роботи з кодом.
Prefill проти генерації: чому RDNA 4 швидша за RX 7900 XTX у промпті
Найвідтворюваніший LLM benchmark для RX 9070 XT — llama-bench з llama.cpp на одній і тій самій моделі Llama 2 7B Q4_0. Він міряє обидві фази окремо: pp512 — обробку промпту з 512 токенів, tg128 — генерацію 128 токенів. На Vulkan RX 9070 XT обробляє промпт зі швидкістю 5202 токени за секунду проти 3727 у RX 7900 XTX — на 40% швидше. А генерує 137 tok/s проти 183 — на 25% повільніше. Це прямий наслідок таблиці вище: матричні блоки RDNA 4 розганяють читання промпту, а 640 ГБ/с проти 960 ГБ/с гальмують відповідь.
Для вас це означає таке. Якщо ви даєте моделі довгі документи, логи чи кодову базу, RX 9070 XT почне відповідати швидше за старшу карту. Якщо ведете короткий діалог, у якому важлива швидкість самої відповіді, виграє RX 7900 XTX.
Є й другий поділ — за бекендом, тобто програмним прошарком, через який llama.cpp звертається до карти. У генерації на цій карті стабільно швидший Vulkan: 136,6 проти 101,3 t/s на Llama 2 7B і 220 проти 179 tok/s на Llama 3.2 3B під Fedora 44. В обробці промпту явного переможця немає: на Llama 2 7B обидва бекенди йдуть майже врівень (5202 проти 5055 t/s), а на інших моделях і збірках розклад змінюється. Детально порівнювати платформи тут не будемо — для вибору карти досить знати, що на RX 9070 XT працюють обидві.
Стеля 16 ГБ у RX 9070 XT: які моделі вміщуються, а які гальмують
У 16 ГБ RX 9070 XT цілком вміщуються щільні моделі до 14 млрд параметрів у 4-бітному кванті та MoE-моделі до 20 млрд на кшталт gpt-oss:20b. Щільна модель на 27 млрд у кванті Q4_K_M важить 17 ГБ — вона вже не вміщується й генерує в 14,6 раза повільніше за gpt-oss:20b. Межа проходить не за кількістю параметрів, а за архітектурою.
Щоб це побачити, досить порівняти заміри hirokuze. gpt-oss:20b займає близько 13 ГБ і видає 91,9 tok/s, Qwen 27B у Q4_K_M займає 17 ГБ і видає 6,3 tok/s: 91,9 / 6,3 ≈ 14,6. Але це порівняння щільної моделі з MoE. Чистий ефект вивантаження видно на двох щільних моделях: Qwen3 14B цілком у памʼяті дає 52,2 tok/s, а щільна 27B, що вийшла за межі 16 ГБ, — 6,3. Розмір зріс менш ніж удвічі (17 проти 9,3 ГБ), а швидкість упала приблизно у 8 разів. Причина — в механіці генерації. Щільна модель на кожному токені читає всі ваги, і якщо 10% із них лежать в оперативній памʼяті компʼютера, кожен токен чекає повільну шину процесора. У gadelog саме так і вийшло: 90% моделі на GPU, 10% на CPU — і близько 7 tok/s.
MoE-модель (Mixture of Experts, «суміш експертів») влаштована інакше. Вона складається з багатьох невеликих підмереж, і на кожному токені працюють лише кілька з них. Якщо частина експертів не вмістилася у відеопамʼять, модель звертається до них рідше, тому втрата швидкості значно менша. Gemma 4 26B з 84% ваг на GPU і GLM-4.7-Flash 30B з 81% тримають близько 35 tok/s — упʼятеро більше, ніж щільна модель порівнянного розміру (27B, ті самі 17 ГБ).Модель і квант Обсяг ваг Вміщується в 16 ГБ Чого чекати на RX 9070 XT Щільні 7–9B, Q4 ~10 ГБ так, із запасом під контекст 58–91 tok/s Qwen3 14B, Q4 9,3 ГБ так 51–52 tok/s gpt-oss:20b, MXFP4 (MoE) ~13 ГБ (14 ГБ на диску) так, упритул під довгий контекст 73–92 tok/s Gemma 4 26B (MoE) 17 ГБ ні, 84% на GPU ~35 tok/s GLM-4.7-Flash 30B (MoE) 19,5 ГБ ні, 81% на GPU ~35 tok/s Qwen3.6-35B-A3B, IQ4_XS (MoE) 18,2 ГБ ні, експерти частково на CPU 46–53 tok/s після налаштування Щільні 27B, Q4_K_M 17 ГБ ні, 90% на GPU 6–7 tok/s
Таблицю зібрано за замірами hirokuze, gadelog і bhat-sahab (вересень 2026). Розмір gpt-oss:20b звірено з карткою моделі на Hugging Face: OpenAI пише, що модель працює в межах 16 ГБ памʼяті.
Памʼятайте, що 16 ГБ — це не 16 ГБ під ваги. Частину памʼяті забирають драйвер і робочий стіл, а ще частину — KV-кеш, тобто «чернетка» моделі, де вона зберігає вже прочитаний контекст. Що довший контекст, то більший цей кеш. Модель на 13 ГБ з коротким чатом вміститься, а з документом на десятки тисяч токенів може почати виходити в оперативну памʼять. Порахувати кеш під свою модель і довжину контексту можна за формулою з нашого розбору відеопамʼяті під LLM.
Практичне правило для власника RX 9070 XT: обирайте архітектуру моделі, а не кількість параметрів. MoE на 20–35B на цій карті корисніша за щільну модель на 27B, хоча за назвою друга здається скромнішою.
ROCm 10.1 для RX 9070 XT: що працює на Linux і Windows
Станом на 15 листопада 2026 року актуальна версія — ROCm Core SDK 10.1.0, її примітки до випуску AMD датовано 5 жовтня 2026 року. У списку підтримуваних відеокарт є Radeon RX 9070 XT, RX 9070 GRE і RX 9070 під спільним кодом gfx1201 — і для Linux, і для Windows 11 25H2. Питання «чи підтримує ROCm цю карту» формально закрите.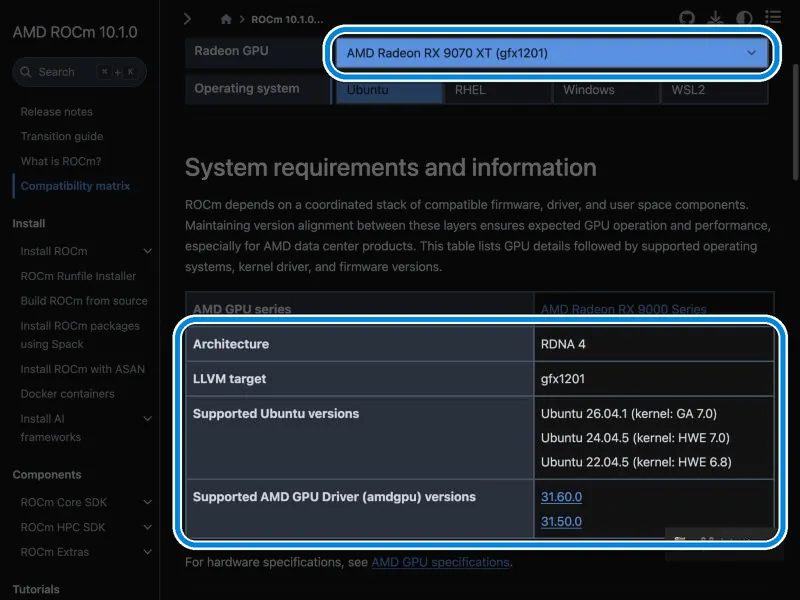
На скриншоті — офіційна матриця сумісності ROCm 10.1.0, знята 15 листопада 2026 року. Верхня рамка показує вибрану карту: AMD Radeon RX 9070 XT (gfx1201). Нижня рамка — те, що треба перевірити перед встановленням: архітектура RDNA 4, три підтримувані версії Ubuntu — 26.04.1 з ядром GA 7.0, 24.04.5 з HWE 7.0 і 22.04.5 з HWE 6.8 — і дві версії драйвера amdgpu, 31.60.0 і 31.50.0.
До складу 10.1.0 входять HIP 7.16.0 і збірки PyTorch 2.14.0, зокрема для Windows з Python від 3.11 до 3.14. Для vLLM, сервера для високонавантаженого запуску моделей, AMD вказує версію 0.29.0 на gfx1201 — лише для Linux. За оглядом технічного блогу Joho no Todai, до релізу увійшло й технічне превʼю для WSL2 — підсистеми Linux усередині Windows.
Одна деталь, яка збиває з пантелику багатьох: ComfyUI та інші застосунки з установленим ROCm 10.1.0 пишуть у консолі «ROCm 7.16». Це не стара версія і не помилка. Застосунок виводить версію HIP — низькорівневого шару ROCm, — а в ROCm 10.1.0 вона якраз 7.16.0.
Якщо ви обираєте між Radeon і GeForce за зрілістю софту загалом, це окрема тема — ми розібрали її в матеріалі ROCm проти CUDA. Тут — лише те, що стосується RX 9070 XT.
Linux: чотири кроки до робочої карти на ROCm 10.1
- Поставте підтримувану систему. За матрицею AMD — Ubuntu 26.04.1, 24.04.5 або 22.04.5 із зазначеним ядром. На інших дистрибутивах карта теж працює в ентузіастів, але офіційної гарантії немає.
- Встановіть драйвер amdgpu версії 31.60.0 або 31.50.0. Саме ці версії матриця AMD повʼязує з ROCm 10.1.0. Якщо запускаєте готову збірку Ollama з вбудованим ROCm, звіртеся і з її документацією: там зазначено власну мінімальну вимогу до драйвера.
- Встановіть ROCm 10.1.0 і перевірте, що система бачить gfx1201. Для цього є утиліти
rocminfoіamd-smi: якщо карта визначається під кодом gfx1201, усе зібрано правильно. - Запустіть рушій під завдання. Ollama — для простого чату, llama.cpp — для тонкого налаштування й замірів, vLLM — для сервера. У таблиці підтримки Ollama RX 9070 XT вказано якраз для Linux.
Windows: драйвер Adrenalin for ROCm, LM Studio і Vulkan
На Windows усе складніше, бо різні програми використовують карту по-різному. AMD має окремий драйвер Adrenalin Edition for ROCm 10.1 (версія 26.10.41.05), сумісний із серією RX 9000. Він потрібен насамперед для PyTorch — а отже, для ComfyUI та інших інструментів генерації картинок.
З мовними моделями картина інша. В офіційній таблиці Ollama для Windows на ROCm перелічено лише карти серії RX 7000 — RX 9070 XT там немає. На Windows Ollama за замовчуванням вмикає Vulkan, і саме через нього карта зазвичай і працює. LM Studio дає змогу вибрати рантайм вручну — ROCm або Vulkan. Чим ці програми відрізняються на одній і тій самій моделі, ми порівняли в розборі Ollama, LM Studio і llama.cpp.
Головна практична пастка на Windows — не вибір між ROCm і Vulkan. За спостереженням gadelog (вересень 2026, LM Studio runtime 2.37.0), LM Studio обирає відеокарту за номером, а номери міняються місцями під час зміни рантайму. У системі з вбудованою графікою модель може мовчки переїхати на неї: швидкість Gemma 4 E4B упала з 96 до 16,5 tok/s без жодної помилки. Перевірити порядок можна командою lms runtime survey або в налаштуваннях Hardware. Найнадійніший спосіб — вимкнути вбудовану графіку зовсім.
Stable Diffusion і ComfyUI на RX 9070 XT: швидкість і підводні камені
RX 9070 XT генерує картинки в Stable Diffusion і ComfyUI, але це її слабке місце. У єдиному детальному порівнянні з RTX 5070 Ti карта AMD виявилася повільнішою більш ніж удвічі, а на важких сценаріях узагалі не дійшла до фінішу. Важливе застереження: більшість замірів зроблено 2025 року на ранніх збірках ROCm, свіжого незалежного порівняння на ROCm 10.1 поки немає.Сценарій Стенд і дата Результат RX 9070 XT SDXL 832×1216, 10 картинок, ComfyUI chimolog, ROCm TheRock, вересень 2025 більш ніж удвічі довше за RTX 5070 Ti (~44,1 с) Відео Wan2.2 416×416, 81 кадр chimolog, вересень 2025 ~200 с проти ~77 с у RTX 5070 Ti; 720p — нестача памʼяті Hires.Fix з ControlNet Tile chimolog, вересень 2025 RTX 5070 Ti ~у 4,8 раза швидша; 4K не завершився через помилки MIOpen SDXL 1024×1024, 20 кроків ComfyUI #7332, 2025 1,03 it/s, 32,25 с із тайловим VAE SDXL 1024×1024, 20 кроків ROCm TheRock #9134, оновлено 16.10.2026 ~28 с (1,5 it/s) лише з тайловим VAE, без нього — OOM Картинка й відео LTX 2.3 Level1Techs, Linux, Docker, ROCm 7.1, липень 2026 картинка менш ніж за 30 с; 20 с відео за 5–8 хвилин «Звичайний» SDXL, Forge Neo note.com/lpp, Windows, ROCm 10.1.0, 14.10.2026 ~3,3 с; кроки й роздільну здатність автор не вказав
Останній рядок має вигляд прориву, але порівнювати його з іншими не можна: автор не назвав ні роздільну здатність, ні кількість кроків. Це радше сигнал, що на ROCm 10.1 з вбудованим Flash Attention ситуація могла покращитися, ніж замір, на який можна спертися під час купівлі.
Що важливо знати до встановлення ComfyUI на RX 9070 XT:
- VAE-декодер зʼїдає памʼять. VAE перетворює внутрішнє представлення картинки на пікселі, і на цій карті він часто впирається в 16 ГБ. Робочий обхід — тайловий VAE (декодування частинами); ComfyUI іноді перемикається на нього сам після помилки.
- Версії ROCm і PyTorch треба добирати. Автор із Level1Techs називає «золотою серединою» звʼязку ROCm 7.1 і PyTorch 2.9.1 у Docker — нові версії не завжди були кращими на його завданнях.
- На Windows 10.1.0 виправив стару помилку. У ROCm 10.0.0 PyTorch 2.12.0 на gfx1201 падав після першого виклику уваги через розбіжність версій бібліотеки AOTriton. У 10.1.0 це виправлено, а запасний обхід — прапорець
--use-quad-cross-attentionпід час запуску ComfyUI. - Відео в 720p і вище — на межі. У chimolog Wan2.2 у 720p не вмістився в памʼять.
Якщо генерація картинок — ваше головне завдання, а не доповнення до мовних моделей, RX 9070 XT зараз не найкращий вибір. Для чату з моделями й нечастих картинок її вистачить.
RX 9070 XT проти RX 7900 XTX, R9700, RTX 5060 Ti і 5070 Ti
На одному й тому самому тесті RX 9070 XT обганяє RX 7900 XTX і RTX 5060 Ti в обробці промпту, але генерує повільніше за RX 7900 XTX і RTX 5070 Ti на CUDA. Radeon AI PRO R9700 за швидкістю майже не відрізняється від неї — за доплату ви отримуєте памʼять, а не швидкість.
Нижче — зведення з публічних таблиць llama.cpp на одній моделі Llama 2 7B Q4_0, без Flash Attention. Рядки надсилають різні люди з різних збірок, тому різниця в 5–10% — у межах похибки, а от різниця в 30–40% — реальна. Таблицю зібрано за результатами спільноти: Vulkan, ROCm і CUDA, зріз на 15 листопада 2026 року.Карта Памʼять Бекенд Промпт pp512, t/s Генерація tg128, t/s RX 9070 XT 16 ГБ, 640 ГБ/с Vulkan 5202 136,6 RX 9070 XT 16 ГБ, 640 ГБ/с ROCm 5055 101,3 RX 7900 XTX 24 ГБ, 960 ГБ/с Vulkan 3727 182,6 Radeon AI PRO R9700 32 ГБ, 640 ГБ/с Vulkan 5610 145,7 Radeon AI PRO R9700 32 ГБ, 640 ГБ/с ROCm 4444 93,8 RTX 5060 Ti 16 ГБ 16 ГБ, 448 ГБ/с Vulkan 3461 93,5 RTX 5060 Ti 16 ГБ 16 ГБ, 448 ГБ/с CUDA 3737 90,9 RTX 5070 Ti 16 ГБ, 896 ГБ/с Vulkan 6214 135,6 RTX 5070 Ti 16 ГБ, 896 ГБ/с CUDA 6952 176,9
RX 7900 XTX vs RX 9070 XT у LLM: 24 ГБ проти швидкого промпту
У мовних моделях ці дві карти виграють у різному. Старша RDNA 3 генерує на третину швидше (182,6 проти 136,6 t/s) і дає 24 ГБ — а отже, вміщує щільну модель на 27B, яка на RX 9070 XT обривається до 6–7 tok/s. Нова RDNA 4 швидше читає промпт: на Llama 2 7B — на 40%, а в тесті gamegpu на Gemma 4 11.9B (серпень 2026) — на 53% (3020 проти 1971 t/s), за генерації 69,4 проти 86,7 t/s на користь RX 7900 XTX.
Підступ — у доступності. RX 7900 XTX знято з виробництва, і нові карти серії RX 7000 більше не потрапляють до щотижневого моніторингу роздрібних цін. Купувати її доведеться на вторинному ринку. Як зібрати навколо неї систему під моделі на 24 ГБ, ми розбирали в матеріалі про RX 7900 XTX для локальних LLM.
RX 9070 XT vs RTX 5070 Ti у LLM: CUDA і 896 ГБ/с
За однакових 16 ГБ GeForce у мовних моделях швидша. Вона має 896 ГБ/с проти 640 — у 1,4 раза більше, — і на CUDA генерує 176,9 t/s проти 136,6 у Radeon на Vulkan. Тест chimolog (вересень 2025) показав ту саму картину на реальних моделях: на 8B і 14B у LM Studio RTX 5070 Ti відповідала приблизно в 1,3 раза швидше. Плюс CUDA — це екосистема, під яку за замовчуванням пишуть більшість інструментів для дифузії й донавчання. Проти — ціна: у листопаді 2026 року RTX 5070 Ti коштує помітно дорожче, про це нижче.
Radeon AI PRO R9700: той самий чип Navi 48, але 32 ГБ
R9700 побудована на тому самому чипі, з тією самою шиною і пропускною здатністю 640 ГБ/с. У замірах llama.cpp вона йде врівень з RX 9070 XT: на ROCm навіть трохи повільніша (4444 проти 5055 t/s у промпті, 93,8 проти 101,3 у генерації), на Vulkan — трохи швидша. Відмінність одна — 32 ГБ памʼяті, у які вміщуються щільні моделі на 27–35 млрд параметрів. Детально — у нашому огляді Radeon AI PRO R9700.
RTX 5060 Ti 16 ГБ: той самий обсяг, повільніша памʼять
RTX 5060 Ti 16 ГБ — головна альтернатива за ціною. Обсяг памʼяті в неї такий самий, але шина вдвічі вужча (128 біт), а пропускна здатність — 448 ГБ/с. Звідси й результат: 90,9 t/s у генерації на CUDA проти 136,6 у RX 9070 XT на Vulkan, промпт — 3737 проти 5202. За чистою швидкістю Radeon попереду на 40–50%, на боці GeForce — екосистема CUDA.
Ціна RX 9070 XT у листопаді 2026: США, Європа, Україна і вживані
Рекомендована ціна RX 9070 XT на старті — $599. У листопаді 2026 року карта коштує близько $920 у США, €933 у Німеччині й від 48 тисяч гривень в Україні. За даними TechSpot, у жовтні 2026 року вона продавалася в США на 45% дорожче за рекомендовану ціну — дефіцит відеокарт підняв ціни на всю родину. За нашим перерахунком від ~$920 на 9–11 листопада 2026 року націнка до рекомендованої ціни — уже близько +54%.Карта США Німеччина Україна (Hotline) Вживані RX 9070 XT ~$920–930 (мінімум $919,99 на 9.11; ~$930 на 11.11) €932,90 (14.11) від 48 171 ₴; ASUS Prime 48 819–61 744 ₴ (15.11) ~$675 (медіана Jawa, 4.08–2.11) RTX 5060 Ti 16 ГБ $769,99 (9.11) €799,90 (14.11) н/д н/д RTX 5070 Ti ~$1 340 (початок листопада) €1 329,90 (14.11) н/д н/д RX 7900 XTX знято з виробництва (EOL) н/д н/д ~$850 (медіана Jawa, 4.08–2.11); €899 — медіана проданих лотів eBay (3.11) Radeon AI PRO R9700 $1 699,99 (9.11) £1 599,95 у Великій Британії (9.11) н/д н/д
На американському ринку цифри розходяться за датами й магазинами. Мінімум на агрегаторі PCPartPicker був $869,99 на 25 жовтня і $919,99 на 9 листопада, окремі версії XFX Mercury доходили до $1599, а у великих магазинах загалом — $900–1200 на 10 листопада. На Hotline 15 листопада 2026 року найдешевша пропозиція — ASRock Challenger від 48 171 ₴, у масових моделей (ASUS Prime, ASRock Steel Legend, Sapphire Pulse) нижня межа — 48–53 тис. ₴, а весь діапазон сторінки сягає 86 409 ₴ у преміальної XFX Quicksilver. Це розкид цін магазинів за моделлю, а не гарантована ціна в наявності, і змінюється він протягом дня. Дані щодо України та вторинного ринку — і ті, й інші з одного джерела, тому їх варто перевірити перед купівлею.
На вторинному ринку трапляються й карти після майнінгу: RX 9070 XT видобуває монети, і це окрема історія, яку ми розібрали в матеріалі про майнінг на RX 9070 XT. Перед купівлею вживаної карти варто перевірити її температуру й стабільність під тривалим навантаженням.
Ціна за 1 tok/s і за 1 ГБ відеопамʼяті в пʼяти відеокарт
Швидкість без ціни мало що каже, тому поділимо листопадові ціни США на генерацію з таблиці llama.cpp (найкращий бекенд для кожної карти) і на обсяг памʼяті.Карта Ціна (США, листопад 2026) Генерація, t/s $ за 1 t/s $ за 1 ГБ памʼяті RX 9070 XT, нова ~$920 136,6 ~6,7 ~57,5 RX 9070 XT, вживана ~$675 136,6 ~4,9 ~42,2 RTX 5060 Ti 16 ГБ ~$770 93,5 ~8,2 ~48,1 RTX 5070 Ti ~$1 340 176,9 ~7,6 ~83,8 RX 7900 XTX, вживана ~$850 182,6 ~4,7 ~35,4 Radeon AI PRO R9700 ~$1 700 145,7 ~11,7 ~53,1
Розрахунок показує, що дефіцит перевернув звичну логіку «AMD дешевша». Нова RX 9070 XT за ціною за токен краща за обидві GeForce, але за ціною за гігабайт програє RTX 5060 Ti. А вживана RX 7900 XTX за ~$850 виграє в усіх і за швидкістю генерації, і за обсягом памʼяті — ціною гарантії й ризику купівлі з рук. Нова R9700 майже вдвічі дорожча за RX 9070 XT ($1700 / $920 ≈ 1,85) і виправдана лише тоді, коли потрібні саме 32 ГБ.
Проблеми RX 9070 XT у ШІ: ComfyUI, vLLM, LM Studio і драйвери
RX 9070 XT під нейромережі не має однієї фатальної проблеми, але має набір дрібних, кожна з яких може коштувати вечора налаштування. Нижче — лише підтверджені випадки з джерелом і датою.
- ComfyUI падає через нестачу памʼяті. У трекері AMD TheRock #9134 (відкритий, оновлений 16 жовтня 2026 року) генерація SDXL на налаштуваннях за замовчуванням завершується помилкою OOM; працює лише з тайловим VAE.
- vLLM поки не розкриває FP8 на RDNA 4. Тікет #28649 у трекері vLLM відкритий, останнє оновлення — 20 жовтня 2026 року. У березні 2026 року блог digtvbg порівняв на Qwen3.5-9B у кванті Q6_K vLLM на ROCm 7.2 і llama-server на Vulkan: 48 проти 62 tok/s. Окремо автор пише, що FP8-моделі vLLM на RDNA 4 мовчки деквантує у FP32, не задіюючи AI-прискорювачі.
- LM Studio на Windows переїжджає на вбудовану графіку. Швидкість падає вшестеро без помилки (gadelog, вересень 2026).
- Ollama на Windows не використовує ROCm для цієї карти. За документацією Ollama станом на 15 листопада 2026 року Windows-таблиця ROCm закінчується серією RX 7000.
- Регресія обробки промпту на MoE в llama.cpp. Після зміни від 29 червня 2026 року prefill на MoE-моделях у llama.cpp на Vulkan сповільнився на 3–8% на картах RDNA 4 з 64 обчислювальними блоками, як у RX 9070 XT (issue #26346). Тред закрито 16 вересня 2026 року з міткою stale — через неактивність, а не з підтвердженим виправленням. У частині англомовних гайдів його досі описано як відкритий.
- Оновлення ROCm ламають і лагодять. Приклад — помилка AOTriton на Windows у ROCm 10.0.0, виправлена лише в 10.1.0. Перед оновленням драйвера під робочий проєкт варто зберегти робочу звʼязку версій.
- Ціна і вторинний ринок. За нашим перерахунком від ~$920 на 9–11 листопада 2026 року карта коштує приблизно на 54% дорожче за рекомендовану ціну, RX 7000 знято з виробництва, а вторинний ринок — це завжди ризик щодо стану карти.
Сильні сторони RDNA 4 у ШІ, які врівноважують ризики
Справедливо назвати й сильні сторони, підтверджені тими самими джерелами. В обробці промпту RX 9070 XT швидша за RX 7900 XTX і RTX 5060 Ti, а з ігрових карт у нашому зведенні поступається лише RTX 5070 Ti (і спорідненій R9700 на Vulkan: 5610 проти 5202 t/s). Вона офіційно підтримується ROCm 10.1.0 на Linux і Windows. Вона працює й через Vulkan, тобто без спеціального обчислювального драйвера. І на неї добре лягають MoE-моделі на кшталт gpt-oss:20b, GLM-4.7-Flash і Qwen3.6-35B-A3B.
Кому брати RX 9070 XT під ШІ, а кому — 7900 XTX, R9700 чи RTX
Брати RX 9070 XT під ШІ варто, якщо ваші завдання — мовні моделі до 20 млрд параметрів і MoE-моделі, ви працюєте з довгими документами й не привʼязані до CUDA. Якщо потрібні 24–32 ГБ, генерація картинок як основне завдання чи готові CUDA-інструменти, вигідніша одна з альтернатив.Ваш сценарій Що брати Чому Чат і код на моделях до 14–20B, довгі документи RX 9070 XT промпт на 40% швидше, ніж у RX 7900 XTX, 52–92 tok/s на генерації Карта вже стоїть в ігровому ПК RX 9070 XT, без доплати ROCm 10.1 і Vulkan закривають щоденний локальний ШІ Щільні моделі на 27–35B вживана RX 7900 XTX (24 ГБ) або R9700 (32 ГБ) на 16 ГБ швидкість падає до 6–7 tok/s Максимум швидкості генерації за свої гроші вживана RX 7900 XTX ~$4,7 за 1 t/s проти ~$6,7 у нової RX 9070 XT Stable Diffusion, відео, донавчання RTX 5070 Ti CUDA, у 2+ раза швидша в SDXL за замірами 2025 року Мінімальний бюджет на 16 ГБ RTX 5060 Ti 16 ГБ або вживана RX 9070 XT ~$770 нова або ~$675 вживана; GeForce генерує на третину повільніше Сервер на vLLM з FP8 зачекати або взяти CUDA FP8 на RDNA 4 у vLLM поки не доопрацьовано
Наш висновок: RX 9070 XT — добрий вибір для того, хто хоче локальні мовні моделі середнього розміру й не боїться провести вечір із налаштуванням. Але це вже не «дешева альтернатива NVIDIA»: за ~$920 вона конкурує з RTX 5060 Ti і вживаною RX 7900 XTX на рівних, і вибір між ними визначає завдання, а не бренд. Якщо 16 ГБ для ваших моделей замало з будь-якою відеокартою, подивіться інші класи заліза — Mac, міні-ПК з великою спільною памʼяттю і збірки на кількох картах — у нашому гіді із заліза для локального ШІ.
Часті запитання про RX 9070 XT для локальних LLM
Чи вистачить 16 ГБ RX 9070 XT для локального ШІ і які моделі в них вміщуються?
Вистачить для щільних моделей до 14 млрд параметрів у 4-бітному кванті та MoE-моделей до 20 млрд — наприклад, gpt-oss:20b (~13 ГБ у памʼяті, 73–92 tok/s). Щільна модель на 27B важить від 17 ГБ і сповільнюється до 6–7 tok/s. MoE на 26–30B з частковим вивантаженням в оперативну памʼять тримають близько 35 tok/s.
Чи працює ROCm на RX 9070 XT у Windows, чи потрібен Linux?
Працює: ROCm 10.1.0 від 5 жовтня 2026 року офіційно підтримує RX 9070 XT (gfx1201) на Windows 11 25H2, є драйвер Adrenalin for ROCm і PyTorch 2.14. Але Ollama на Windows використовує для цієї карти Vulkan, а не ROCm. Різниця у швидкості залежить від моделі: на gpt-oss:20b Linux-стенд дав 91,9 проти ~73 tok/s на Windows, а на Qwen3 14B — 52,2 проти ~51.
Що швидше для RX 9070 XT — ROCm чи Vulkan у llama.cpp?
У генерації швидший Vulkan: на Llama 2 7B він дає 136,6 t/s проти 101,3 на ROCm, на Llama 3.2 3B — 220 проти 179. В обробці промпту бекенди на Llama 2 7B ідуть майже врівень (5202 проти 5055 t/s), а на інших моделях розклад змінюється. Для чату зазвичай вигідніший Vulkan; під довгі документи перевірте обидва на своїй моделі.
RX 9070 XT чи RX 7900 XTX для нейромереж: що брати: 16 чи 24 ГБ?
Якщо ваші моделі вміщуються в 16 ГБ і ви працюєте з довгими промптами — RX 9070 XT: вона на 40% швидше читає промпт, і це нова карта з гарантією. Якщо потрібні щільні моделі на 27B або максимум швидкості відповіді — вживана RX 7900 XTX: 24 ГБ, генерація на третину швидша й близько $850 на вторинному ринку.
Чи підходить RX 9070 XT для Stable Diffusion і ComfyUI?
Підходить для епізодичної генерації, але це не сильна сторона карти. За замірами 2025 року RTX 5070 Ti була швидшою більш ніж удвічі в SDXL, а на налаштуваннях за замовчуванням ComfyUI на RX 9070 XT ловить нестачу памʼяті під час декодування VAE. Допомагають тайловий VAE і свіжий ROCm 10.1.0, але незалежних замірів на ньому ще немає.
Чи варто купувати RX 9070 XT для ШІ за цінами листопада 2026?
Якщо вона потрібна і для ігор, і для моделей до 20B — так, це швидка карта з офіційною підтримкою ROCm. Якщо купуєте лише під ШІ, порівняйте її з вживаною RX 7900 XTX за ~$850 і RTX 5060 Ti 16 ГБ за ~$770: за ціни близько $920 RX 9070 XT уже не найдешевший шлях до локальних нейромереж.