
Коротко (TL;DR)
- Сколько токенов в тексте на украинском по сравнению с английским: в 1,4–2,4 раза больше на современных токенизаторах. В нашем замере одного и того же текста словарь o200k (GPT-4o и семейство GPT-5) дал 924 токена против 564, то есть в 1,64 раза.
- «В 17 раз дороже» к украинскому не относится. Эта цифра — разрыв между самым дорогим и самым дешёвым из 200 языков в одной модели; дорогие там бирманский, тибетский, кхмерский.
- Деньги: при всех запросах на украинском счёт в API вырастает примерно на 64% (на 29 октября 2026 года — $18,04 против $11,00 за 1000 типичных запросов к GPT-6.1 Sol, если считать по словарю o200k; для Claude множитель не опубликован).
- Главные рычаги экономии — не язык системного промпта. Сильнее работают короткий ответ (выход в 5 раз дороже входа), кэш промптов (чтение — 5% цены входа) и пакетный режим (−50%). Вместе они делают украинские запросы дешевле обычных английских.
- Чего не делать: писать украинский латиницей — на o200k, Llama и Gemma это добавляет 18–32% токенов, а не экономит; выигрыш есть только у словарей, которые режут украинский особенно сильно (старый cl100k, Qwen).
Пара терминов, без которых дальше будет сложно. Токен — кусок текста, которым модель читает и пишет: целое слово, слог или одна буква. API считает деньги и лимиты именно в токенах. Токенизатор — программа со своим словарём, которая режет текст на токены; у каждой модели он свой. Системный промпт — постоянная инструкция, которая уходит в модель с каждым запросом («ты — оператор поддержки, отвечай вежливо…»).
- Коротко (TL;DR)
- Сколько токенов в украинском тексте: наш замер на девяти токенизаторах
- Почему украинский дороже: кириллица в словаре токенизатора
- «В 17 раз дороже»: что на самом деле измерило исследование CLEAR
- Цена украинского в API: 1000 запросов к GPT-6.1, Claude и Gemini
- Claude и Gemini: сколько токенов у украинского, если словарь закрыт
- Окно контекста: сколько украинского влезает в 128 тысяч токенов
- Писать промпт по-английски или по-украински: что известно о качестве
- Экономия на украинских запросах: кэш, короткий ответ и batch
- Как посчитать токены своего текста бесплатно за пять минут
- Риски экономии на языке: качество ответа, смена токенизатора и цены
- FAQ
Сколько токенов в украинском тексте: наш замер на девяти токенизаторах
Сколько токенов в тексте, зависит от языка и от модели сразу. Чтобы получить ответ на одном и том же материале, мы написали нейтральное руководство «Как выбрать ноутбук для учёбы» на трёх языках и посчитали его девятью токенизаторами.
Методика замера (29 октября 2026 года). Украинская версия — 380 слов и 2768 знаков, английская — 494 слова и 2867 знаков, русская — 390 слов и 2809 знаков. Счёт локальный, словари взяты из открытых файлов: библиотека tiktoken 0.14.0 (словари OpenAI o200k_base и cl100k_base) и tokenizers 0.23.3 с файлами моделей с Hugging Face. Отдельно посчитан короткий промпт-инструкция примерно на 360 знаков. Ограничение методики: это один текст одного жанра; на коде, таблицах и плотной терминологии множитель будет другим. Повторить замер на своём тексте можно по шагам из раздела о подсчёте токенов ниже.Токенизатор (модели) Украинский Английский Русский UA к EN RU к EN o200k_base (GPT-4o, GPT-4.1, GPT-5) 924 564 691 1,64 1,23 cl100k_base (GPT-3.5, GPT-4) 1594 565 1261 2,82 2,23 Llama 4 810 564 602 1,44 1,07 Gemma 3 (словарь Gemini 2.0) 852 568 666 1,50 1,17 Llama 3.1 886 565 819 1,57 1,45 Mistral Nemo 978 574 787 1,70 1,37 Mistral 7B v0.3 1226 606 1138 2,02 1,88 DeepSeek-V3 1153 567 776 2,03 1,37 Qwen2.5 и Qwen3 1360 565 862 2,41 1,53
Английский текст почти везде укладывается в 564–606 токенов: словари всех моделей собраны в первую очередь под него. Украинский разбегается от 810 до 1594 токенов. Короткий промпт дал те же пропорции: 122 токена против 73 на o200k (1,67 раза), 110 против 74 на Llama 4 (1,49 раза).

Порядок величин совпадает с независимыми работами. Рецензируемое исследование токенизации украинского в журнале Frontiers in Artificial Intelligence насчитало на общем корпусе 1,98 токена на слово у GPT-4o и 3,32 у GPT-3.5/4 против 1,07–1,08 у английского. Работа arXiv 2608.21384 (корпус в 8,37 млн словоформ на пяти языках) даёт украинскому +68–121% токенов на современных токенизаторах и +220% на старом cl100k.
Токены на слово и токены на смысл: почему это разные цифры
В исследованиях обычно считают токены на слово: в работе arXiv 2605.24718 у украинского в среднем 2,66 токена на слово против 1,23 у английского — отсюда и «в 2,2 раза дороже». Но украинский текст короче по словам: в нашем замере тот же смысл занял 380 украинских слов против 494 английских, на 23% меньше. Поэтому на слово разрыв 2,43 против 1,14 (в 2,1 раза), а на весь текст — 1,64 раза. Для счёта в API важна вторая цифра: платите вы за смысл, который передали, а не за слова.
Ещё одна деталь: отдельная фраза может дать разрыв заметно больше среднего. В примере издания «Межа» английская фраза из 47 знаков занимает 7 токенов, а украинская из 42 знаков — 17, то есть в 2,4 раза. Мы перепроверили это на o200k и получили те же 7 и 17. На целом тексте разрыв выходит 1,64, а на нашем промпте в 360 знаков — 1,67, так что по одной фразе о среднем судить нельзя.
Почему украинский дороже: кириллица в словаре токенизатора
Токенизатор учится на огромном корпусе текстов и сохраняет в словарь самые частые куски. Английского в интернете больше всего, поэтому «London» — один токен, а «artificial intelligence» — три. Украинских текстов в обучающих данных меньше, и частых украинских кусков в словаре мало.
Что показал подсчёт словарей:
- cl100k_base (GPT-3.5 и GPT-4): из 100 277 токенов кириллицу содержат 729, а украинские буквы і, ї, є или ґ — только 2.
- o200k_base (GPT-4o и новее): из 200 019 токенов кириллицу содержат 14 209, украинские буквы — 502.
- Отсюда скачок между поколениями: тот же текст в cl100k стоил 2,82 английского, в o200k — уже 1,64.
Как это выглядит на словах (o200k_base):Слово Токенов Как разрезано London 1 London Київ 3 К · и · їв Україна 3 Укра · ї · на artificial intelligence 3 art · ificial · intelligence штучний інтелект 6 шт · уч · ний · ін · тел · ект
Буква «ї» в «Київ» и «Україна» почти всегда выпадает в отдельный кусок, потому что сочетаний с ней в словаре почти нет. Исследование arXiv 2605.24718 по 25 европейским языкам называет это «украинским штрафом»: украинский платит на 15–18% больше родственных славянских языков, и авторы связывают это с тем, что украинских текстов в обучающих данных меньше.
«В 17 раз дороже»: что на самом деле измерило исследование CLEAR
Повод для обсуждения — посты в украинском Telegram и пересказы в медиа с заголовком в духе «некоторые промпты стоят в 17 раз дороже в зависимости от языка». Источник цифры — исследование коалиции CLEAR (Coalition for Language Equity in AI Research), о котором 26 октября 2026 года написало издание Rest of World.
Что там сказано на самом деле:
- среди 20 самых распространённых языков интернета самый «дорогой» требует в 1,5–5 раз больше токенов, чем самый дешёвый;
- когда выборку расширили до 200 языков, разрыв в одной из моделей вырос до 17 раз;
- хуже всего приходится языкам с письменностями, которые токенизатор почти не видел: бирманскому, тибетскому, тифинагу, кхмерскому, лаосскому, ол-чики.
Украинский в пересказах исследования не назван. Переносить на него 17x — то же, что взять худший результат из 200 и выдать его за средний. Rest of World ссылается на публикацию CLEAR в блоге коалиции, но разбивку по языкам и моделям оттуда мы получить не смогли, поэтому опираемся на пересказ Rest of World и на прямые замеры украинского.Откуда цифра Что сравнивают Значение для украинского CLEAR, «до 17 раз» худший из 200 языков против лучшего, одна модель не измерено CLEAR, «1,5–5 раз» худший из топ-20 языков против лучшего не названо arXiv 2605.24718 токенов на слово, 10 моделей 2,7 против 1,2 у английского Frontiers, 2025 токенов на слово, GPT-4o 1,98 против 1,07 arXiv 2608.21384 весь корпус, современные токенизаторы +68–121% Наш замер, 29.10.2026 тот же текст целиком, 9 токенизаторов в 1,44–2,82 раза
Вывод для практики: ориентир для украинского — 1,4–2,4 раза на актуальных моделях и около 2,8 раза на старых GPT-3.5 и GPT-4.
Цена украинского в API: 1000 запросов к GPT-6.1, Claude и Gemini
Возьмём типичный запрос чат-бота: системный промпт на 1000 токенов, вопрос пользователя на 500 и ответ на 800 (всё в английском исчислении). Сравним четыре варианта языка при множителе 1,64 — столько дал словарь o200k. Для GPT-6.1 OpenAI словарь не называет, поэтому цифра — ориентир, а для Claude и Gemini — допущение (почему — в разделе о Claude и Gemini ниже). Цены — на 29 октября 2026 года по прайсам вендоров.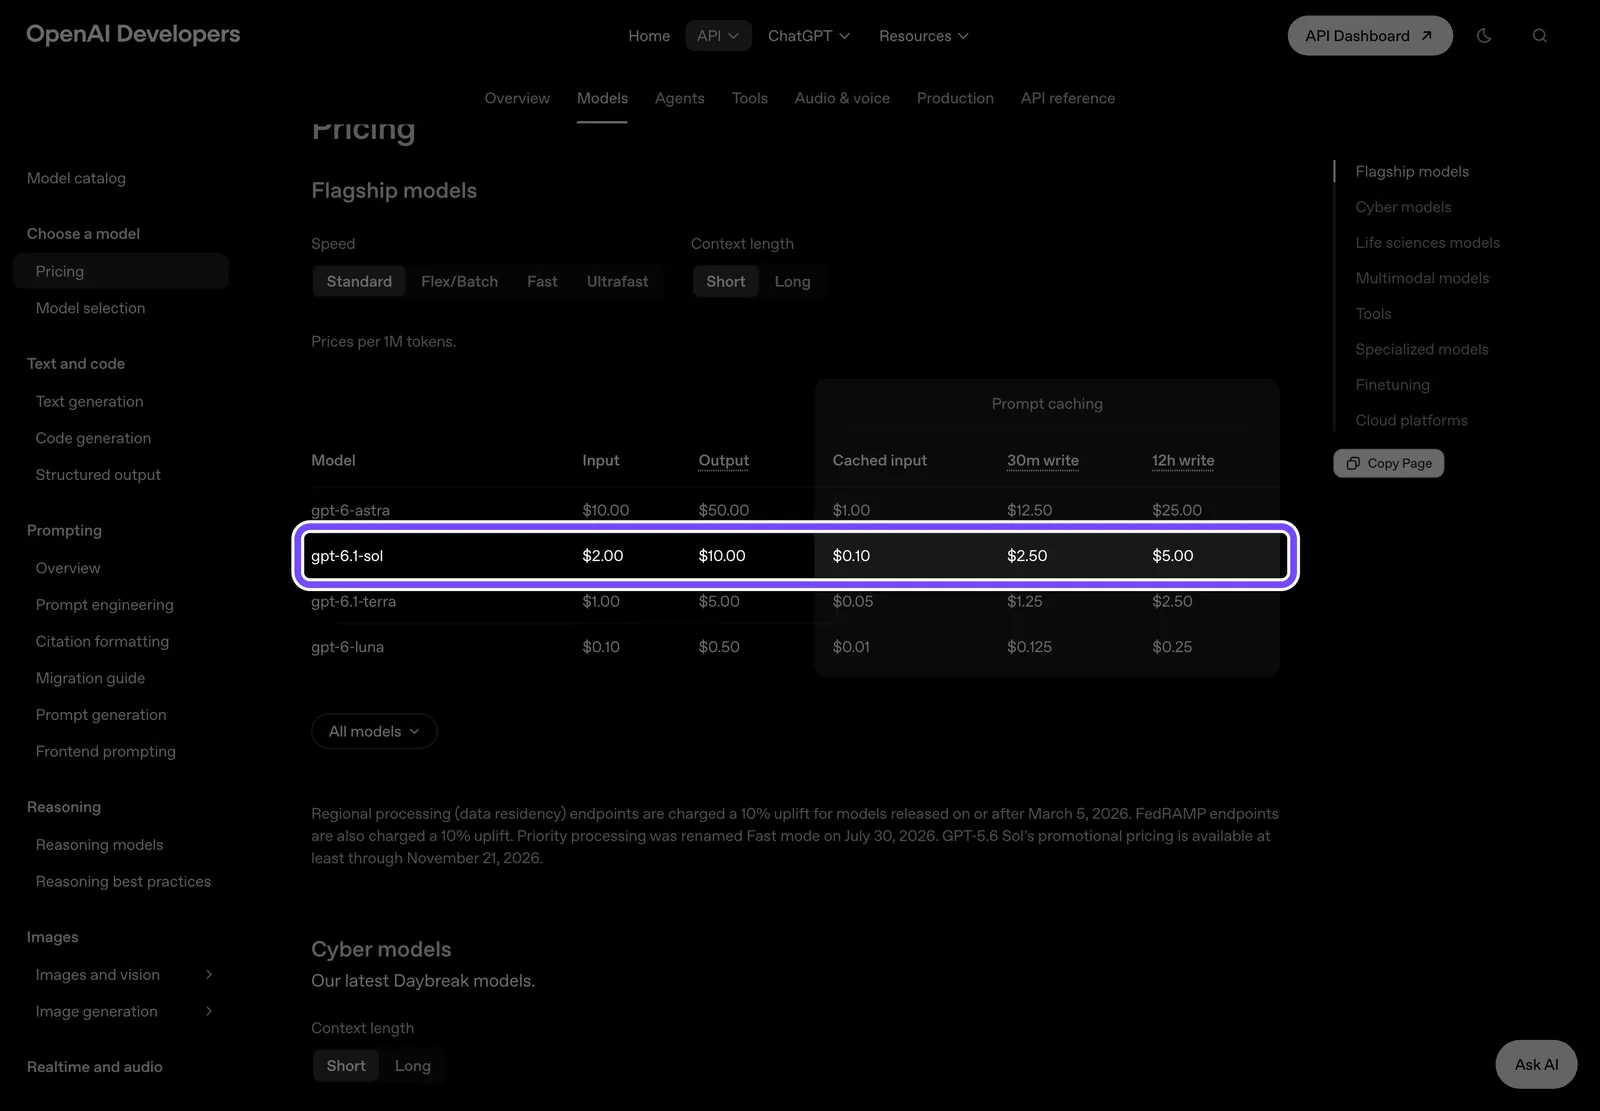
На скриншоте прайса OpenAI (снят 29 октября 2026 года) рамкой выделена строка GPT-6.1 Sol: $2 за миллион входных токенов, $10 за миллион выходных и $0,10 за чтение из кэша. Столько же за токен стоит Claude Sonnet 5.5, но токенизатор у Claude свой. Поэтому колонки Claude и Gemini посчитаны с тем же множителем 1,64 — это сравнение цен, а не замер: у Claude украинский, по косвенным данным, режется сильнее, у Gemini 2.0 (по словарю Gemma 3) — чуть мягче, 1,50. У Gemini цена выхода включает и токены размышлений модели.Вариант (1000 запросов) GPT-6.1 Sol, Sonnet 5.5 ($2 / $10) Claude Opus 5.5 ($4 / $20) Gemini 3.8 Flash ($0,75 / $3,75) GPT-6.1 Terra ($1 / $5) Всё на английском $11,00 $22,00 $4,13 $5,50 Всё на украинском $18,04 (+64%) $36,08 $6,77 $9,02 Системный промпт на английском, остальное на украинском $16,76 (+52%) $33,52 $6,29 $8,38 Системный промпт и ответ на английском, вопрос на украинском $11,64 (+6%) $23,28 $4,37 $5,82
Перевод системного промпта на английский экономит всего около 7% счёта ($18,04 → $16,76). Причина простая: выходной токен в пять раз дороже входного, и в украинском варианте ответ — это 73% всей суммы. Ответ на английском почти снимает переплату, но для украинского пользователя это обычно не вариант.
Если множитель выше (Qwen, DeepSeek или старые модели), разрыв растёт. При множителе 2,4 «всё на украинском» стоит $26,40 вместо $11,00, при 3,0 — $33,00.
Переплата за украинский язык в гривнах: чат-бот на 30 000 запросов
Чат-бот поддержки на 1000 запросов в день — это около 30 000 запросов в месяц. По курсу НБУ 45,59 грн за доллар на 29 октября 2026 года на GPT-6.1 Sol при множителе o200k выходит:
- всё на английском: $330 в месяц, около 15 045 грн;
- всё на украинском без оптимизаций: $541,20 в месяц, около 24 675 грн;
- переплата за язык: около $211, или 9 630 грн в месяц.
Цены, которые устареют первыми: у Gemini 3.8 Flash ставка $0,75 / $3,75 действует до 31 декабря 2026 года, с 1 января 2027-го — $1,50 / $7,50. У Gemini 4 Argon $2 / $10 действует до 30 ноября 2026 года, с 1 декабря — $4 / $20.
Claude и Gemini: сколько токенов у украинского, если словарь закрыт
Публичного токенизатора Claude нет: Anthropic не выкладывает словарь, поэтому посчитать украинский текст локально, как для GPT или Llama, нельзя. Сравнить Claude с GPT на одном украинском тексте можно только через API с ключом. Что известно из открытых источников:Модель Что известно Насколько надёжно Claude 4.7 и новее (Sonnet 5.5, Opus 5.5, Fable 5.1) тот же текст даёт примерно на 30% больше токенов, чем у моделей до 4.7 документация Anthropic, без разбивки по языкам Claude Opus 5 на русском примерно в 3 раза больше токенов, чем английский один блог-замер Donseo в пересказе, низкая Claude 3 (приближённый словарь) 3,45 токена на украинское слово против 1,10 на английское Frontiers, 2025; словарь неофициальный Gemini 2.0 Gemma 3 использует тот же словарь; в нашем замере 1,50 к английскому технический отчёт Gemma 3; прокси только для Gemini 2.0 Gemini 3.x и 4 н/д словарь не опубликован 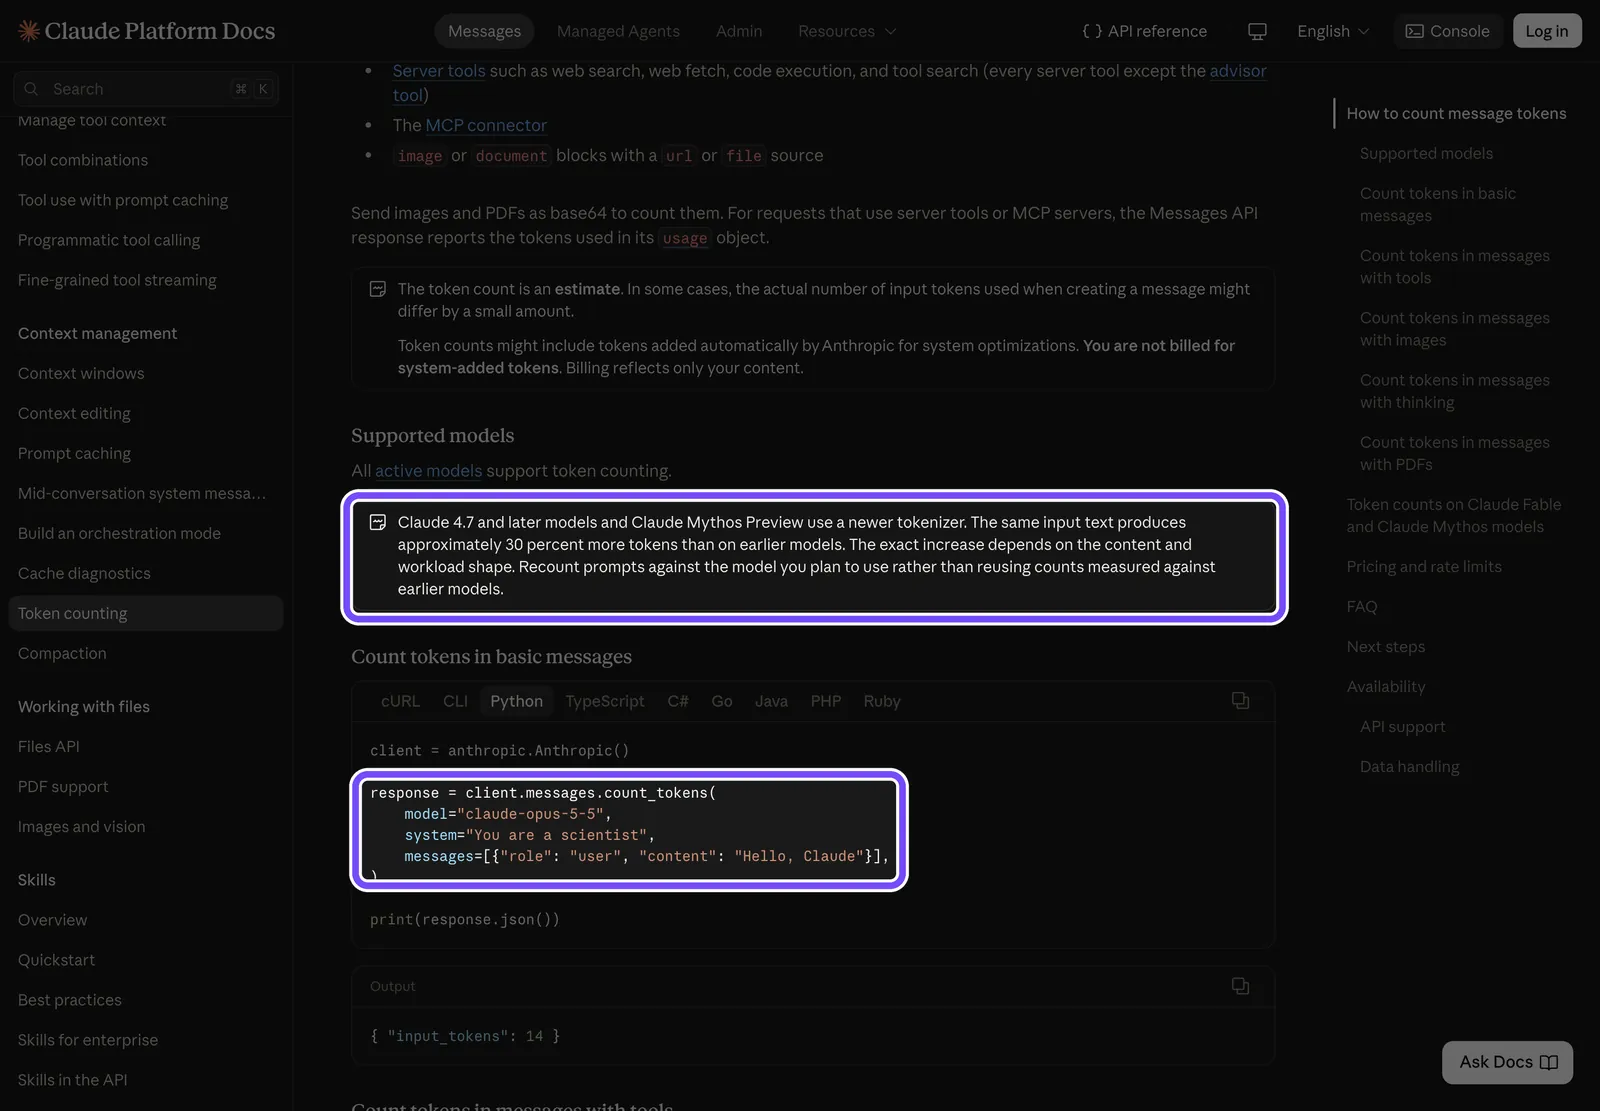
На скриншоте документации Anthropic по подсчёту токенов (снят 29 октября 2026 года) рамками выделены два места: примечание о том, что Claude 4.7 и новее считают тот же текст примерно на 30% длиннее, и пример вызова count_tokens. Тот же документ советует пересчитывать промпты под модель, на которую вы переходите, а не брать старые цифры.
Ответа на вопрос «во сколько раз украинский дороже английского именно в Claude» в открытых данных нет. Косвенные данные указывают, что кириллица в Claude обходится дороже, чем в GPT-4o и новее, но цифру для украинского мы не приводим: единственный свежий замер касается русского и опубликован в пересказе. Проверка для своей задачи — в разделе о подсчёте токенов ниже.
Окно контекста: сколько украинского влезает в 128 тысяч токенов
Окно контекста — это объём текста, который модель держит в голове за один раз: системный промпт, переписка, вложенные документы и ответ. Оно тоже измеряется в токенах, поэтому украинский текст заполняет его быстрее.
Посчитаем, сколько машинописных страниц по 1800 знаков помещается в окно 128 тысяч токенов — столько у многих локальных моделей, включая Gemma 3:Токенизатор Токенов на страницу UA Токенов на страницу EN Страниц UA в 128K Страниц EN в 128K o200k_base (GPT-4o, GPT-5) ≈600 ≈354 ≈213 ≈361 Llama 4 ≈527 ≈354 ≈243 ≈361 Gemma 3 ≈554 ≈357 ≈231 ≈359 Qwen2.5 и Qwen3 ≈884 ≈355 ≈145 ≈361 cl100k_base (GPT-4) ≈1037 ≈355 ≈123 ≈361
В пересчёте на слова на o200k в 128 тысяч токенов помещается около 112 тысяч английских слов и около 53 тысяч украинских. Но, как разобрано выше, украинских слов на тот же смысл нужно меньше, поэтому точнее мерить страницами: украинского содержания влезает примерно в 1,7 раза меньше.
Практические последствия:
- Долгий диалог «забывает» начало раньше. В подписках ChatGPT и Claude вы не платите за каждый токен, но длинная украинская переписка быстрее упирается в окно, и модель начинает терять ранние детали.
- Большой документ может не влезть целиком. На Qwen договор на 200 страниц по-английски поместится в 128K, а по-украински — нет.
- Окно в 1 млн токенов снимает проблему для большинства задач. У Claude Sonnet 5.5 и Opus 5.5 оно именно такое по документации Anthropic; плата при этом всё равно идёт за каждый токен.
Писать промпт по-английски или по-украински: что известно о качестве
Короткий ответ: прямых исследований «английский промпт против украинского» с замером качества ответа на украинском мы не нашли. Есть работы по другим языкам и общие наблюдения, и они дают осторожный ориентир, а не правило.
Что известно:
- Работы по другим языкам склоняются к английскому промпту. На бенгальском, хинди и урду GPT-4, Llama 2 и Gemini лучше справлялись с английскими промптами (arXiv 2410.13153, 2024). В 197 экспериментах на арабских данных лучшим в среднем был английский промпт, затем смешанный, затем арабский (arXiv 2409.07054).
- Чем сильнее язык режется на токены, тем ниже точность. На 16 африканских языках число токенов на слово надёжно предсказывало падение точности (arXiv 2509.05486). Украинский режется заметно мягче, но механизм тот же.
- Примеры в промпте на украинском могут вредить. На 273 решениях украинских судов добавление примеров (few-shot) снижало качество до 26 процентных пунктов, и надёжнее был запрос без примеров (arXiv 2605.14890).
- Транслит хуже оригинала. Anthropic в документации советует подавать текст в родной письменности, а не латиницей.
- Язык ответа лучше задавать явно. Та же документация рекомендует прописывать язык ответа в системном промпте, чтобы он держался на всех шагах диалога.
Отдельно от языка на качество сильнее влияет структура промпта: роль, контекст, формат и критерии результата.
Правило выбора по задаче:
- Разговор с человеком, тексты для украинской аудитории — промпт на украинском, язык ответа указан явно. Переплата терпима, а риск потерять реалии меньше.
- Техническая задача (код, извлечение данных, классификация) — системный промпт можно писать по-английски, ответ — на нужном языке.
- Длинная стабильная инструкция, которая уходит с каждым запросом, — сначала кэш, а не перевод: это дешевле и не требует переписывать промпт.
- Сомневаетесь — прогоните 20–30 своих реальных примеров в двух вариантах и сравните ответы. Это единственная проверка, которая подходит именно вашей задаче.
Экономия на украинских запросах: кэш, короткий ответ и batch
Самый частый совет в обсуждениях — «пишите промпты по-английски». Расчёт выше показывает, что он экономит единицы процентов. Ниже — приёмы по реальному эффекту на 29 октября 2026 года; подробнее про каждый механизм — в нашем разборе расходов на токены LLM, здесь только то, что касается украинского.Приём Эффект для украинских запросов Статус Кэш промптов чтение из кэша — $0,10 вместо $2 за 1 млн (Sonnet 5.5, GPT-6.1 Sol), 5% цены входа работает, проверено по прайсам Ограничение длины ответа выход в 5 раз дороже входа; ответ — около 73% счёта работает Пакетный режим (batch) −50% на вход и выход у Anthropic; у OpenAI для GPT-6.1 Sol $1 / $5 работает для несрочных задач Сжатие LLMLingua-2 −47–49% украинского входа на тесте с поиском по каталогу работает в исследовании, нужна проверка у себя Системный промпт на английском около −7% счёта в нашем сценарии работает слабо Перевод всего запроса на английский локальной моделью −34–47% входа на других языках для украинского не проверено Украинский латиницей +18% на o200k, +32% на Llama 4, +27% на Gemma 3; −12% только у Qwen не работает
Кэш промптов: длинный украинский системный промпт почти бесплатен
Кэш промптов — это когда сервис запоминает неизменное начало запроса (системный промпт, инструкции, справочник) и при повторе берёт его по сниженной цене. У Anthropic кэш по умолчанию живёт 5 минут и продлевается при каждом использовании, у OpenAI для GPT-5.6 и новее — 30 минут. Минимальная длина кэшируемого начала — 512 токенов у Claude Sonnet 5.5 и Opus 5.5 и 1024 токена у OpenAI для GPT-5.6 и новее.
Пример: украинский системный промпт на 1640 токенов (наша тысяча английских, умноженная на 1,64). Без кэша 1000 запросов съедают за него $3,28, с кэшем — около $0,16. Это дешевле, чем тот же промпт по-английски без кэша ($2,00). Первая запись в кэш стоит в 1,25 раза дороже обычного входа, но это разовая плата.
Короткий ответ вместе с кэшем: $10 за 1000 украинских запросов
Посчитаем полный сценарий на GPT-6.1 Sol или Sonnet 5.5 для 1000 запросов, всё на украинском:
- Без оптимизаций — $18,04.
- С кэшем системного промпта — $14,92.
- С кэшем и ответом, сокращённым до 500 токенов в английском исчислении (вместо 800), — около $10,00.
Третий вариант дешевле, чем всё на английском без оптимизаций ($11,00). Короткий ответ задаётся прямо в промпте: «ответ — до 150 слов», «только список без вступления». Пакетный режим для того же сценария без кэша даёт $9,02, но ответы приходят с задержкой, поэтому он подходит для разметки, переводов и отчётов, а не для чата.
Украинский латиницей: почему транслит не экономит токены
Идея кажется логичной: латиница в словаре представлена лучше, значит, «Kyiv» дешевле «Київ». На старом cl100k так и есть — транслит экономит 25%. Но на большинстве современных словарей латинская запись украинского длиннее: в нашем замере +18% на o200k, +32% на Llama 4 и Llama 3.1, +27% на Gemma 3. Исключения — Qwen2.5/Qwen3 (−12%) и DeepSeek-V3 (без изменений): эти словари режут украинскую кириллицу сильнее всех. Работа arXiv 2608.21384 даёт +2–19% на большинстве токенизаторов, исследование во Frontiers пришло к тому же: транслит помогает только словарям, которые режут украинский сильнее 2,5 токена на слово. К тому же модель хуже понимает транслит, а ответ придётся переводить обратно.
Как посчитать токены своего текста бесплатно за пять минут
Как узнать, сколько токенов в тексте, на котором вы будете работать: проще всего посчитать его самим, а не верить средним цифрам. Пять способов от простого к точному.
- Токенизатор OpenAI в браузере. Страница Tokenizer в документации OpenAI (
platform.openai.com/tokenizer) показывает число токенов и раскрашивает, как разрезан текст. Это самый быстрый способ посчитать токены в браузере, без установки; выберите в нём новейшую модель из списка. - tiktoken на своём компьютере. Бесплатная библиотека OpenAI на Python считает любые объёмы текста без интернета. В версии 0.14.0 словарь o200k_base привязан к GPT-4o, GPT-4.1 и семейству GPT-5; для GPT-6.1 библиотека словарь не называет, поэтому цифра для неё — ориентир.
- Токенизаторы открытых моделей. Библиотека tokenizers и файл
tokenizer.jsonс Hugging Face дают точный счёт для Llama, Qwen, Gemma, Mistral и DeepSeek — полезно, если вы запускаете модель локально. - count_tokens у Anthropic. Метод API бесплатный (ограничен только частотой запросов), но нужен ключ. Это единственный способ узнать, сколько токенов украинский текст займёт именно в Claude; сама Anthropic называет результат оценкой, которая может немного отличаться от итогового счёта.
- countTokens у Google. Метод Gemini API тоже требует ключ; у Gemini 3.8 Flash есть бесплатный уровень по прайсу Google на 29 октября 2026 года.
Минимальный код для второго способа:
# pip install tiktoken
import tiktoken

enc = tiktoken.get_encoding("o200k_base")
for text in ["Штучний інтелект змінює те, як ми працюємо",
             "Artificial intelligence is changing how we work"]:
    print(len(enc.encode(text)), text)
# 17 Штучний інтелект змінює те, як ми працюємо
# 7 Artificial intelligence is changing how we work
Грубая оценка, если считать некогда: английский текст на o200k — около 5 знаков на токен, украинский — около 3, русский — около 4. Страница украинского текста в 1800 знаков — примерно 600 токенов.
Риски экономии на языке: качество ответа, смена токенизатора и цены
Сэкономить на токенах можно, но у каждого приёма есть цена.
- Ответ на английском с последующим переводом. Счёт падает почти до английского уровня, но добавляется шаг перевода, а украинские реалии — названия ведомств, законов, банковских продуктов — могут потеряться или исказиться.
- Смешение языков. Английский системный промпт и украинский диалог иногда приводят к ответам на английском или с вкраплениями английских терминов. Лечится явным указанием языка ответа, но это надо проверять на своих примерах.
- Смена токенизатора у вендора. Переход Anthropic на новый словарь в Claude 4.7 сразу добавил около 30% токенов на тот же текст. Расчёты, сделанные на старой модели, после обновления надо пересчитать.
- Акционные цены. Ставки Gemini 3.8 Flash и Gemini 4 Argon временные и вдвое вырастут с 1 января 2027 года и 1 декабря 2026 года соответственно. Бюджет, посчитанный по акционной цене, через пару месяцев окажется вдвое меньше нужного.
- Сжатие промптов. LLMLingua-2 в исследовании не потерял данных на 80 проверенных случаях, но это узкий тест по каталогу товаров. На юридических или медицинских текстах сжатие может выбросить важную оговорку.
- Приватность. Перевод через сторонний сервис или чужую модель — это передача текста ещё одной стороне; для персональных данных клиентов это отдельный риск.
FAQ
Во сколько раз украинский текст дороже английского в токенах?
На современных токенизаторах — в 1,4–2,4 раза. В нашем замере одного текста от 29 октября 2026 года o200k (GPT-4o и семейство GPT-5) дал 1,64 раза, Llama 4 — 1,44, Gemma 3 — 1,50, Qwen — 2,41. На старых GPT-3.5 и GPT-4 разрыв был около 2,8 раза. Для Claude и новейших Gemini открытых замеров по украинскому нет.
Сколько токенов в одной странице украинского текста?
Страница в 1800 знаков на словаре o200k (GPT-4o и новее) занимает около 600 токенов, та же страница на английском — около 354. На других моделях украинская страница стоит от 527 токенов (Llama 4) до 884 (Qwen) и 1037 на старом словаре GPT-4. Точную цифру для своего текста даёт бесплатный подсчёт в tiktoken или в токенизаторе OpenAI.
Писать промпт по-английски или по-украински, если нужен ответ по-украински?
Для экономии это почти не важно: английский системный промпт снижает счёт примерно на 7%, потому что основную сумму даёт ответ. Для качества прямых исследований по украинскому нет; работы по другим языкам чаще показывают преимущество английского промпта. Практичный путь — проверить оба варианта на 20–30 своих примерах и явно указать язык ответа.
Одинаково ли Claude и ChatGPT считают украинский?
Нет. У каждой модели свой словарь токенов. Для GPT-4o и новее украинский длиннее английского примерно в 1,64 раза. Словарь Claude закрыт; по документации Anthropic модели Claude 4.7 и новее считают любой текст примерно на 30% длиннее прежних, а единственный свежий сторонний замер по кириллице касается русского и даёт около 3 раз. Сравнить на своём тексте можно через бесплатный count_tokens с ключом API.
Правда ли, что язык может стоить в 17 раз дороже?
Да, но не украинский. Цифра из исследования CLEAR описывает разрыв между самым дорогим и самым дешёвым из 200 языков в одной модели; в невыгодном положении там бирманский, тибетский, кхмерский и лаосский. Среди 20 самых распространённых языков разрыв составляет 1,5–5 раз. Украинский в пересказах исследования не назван, а прямые замеры дают ему 1,4–2,4 раза.
Помогает ли написание украинского латиницей сэкономить токены?
На большинстве актуальных моделей — нет, текст становится длиннее. В нашем замере транслит добавил 18% токенов на o200k, 32% на Llama 4 и 27% на Gemma 3; исследование arXiv 2608.21384 даёт +2–19% на большинстве токенизаторов. Экономию транслит даёт только словарям, которые режут украинский сильнее всего: старому GPT-4 (−25%) и Qwen (−12%); Anthropic же прямо советует подавать текст в родной письменности.