
Коротко (TL;DR)
Якщо ви купуєте карту під локальні LLM сьогодні, розумна база — 24 ГБ VRAM: у неї вміщається головний «картковий» клас моделей 27–32B у 4-бітному кванті, і за останні півтора року цей клас не виріс, а порозумнішав. 32 ГБ дають запас за довжиною контексту і 70B у сильно стиснутому вигляді, 48 ГБ — нормальну 70B у 4 бітах, 96 ГБ — 70B без компромісів і середні MoE-моделі. Ось короткий вердикт за грошима на 29 жовтня 2026 року:
- Коротко (TL;DR)
- Який обсяг VRAM брати під локальні LLM: ступені від 16 до 96 ГБ
- Що відкриває кожна ступінь: 16, 24, 32, 48 і 96 ГБ на моделях
- Ціна гігабайта відеопам’яті: Україна і США на 29 жовтня 2026
- Одна карта на 96 ГБ чи кілька по 24: ціна, швидкість, живлення
- Куди ростуть відкриті моделі: від 671B до 2,8T за півтора року
- Клас моделей 27–32B не росте: чому 24 ГБ VRAM поки не застаріли
- Що пом’якшує брак VRAM: кеш експертів MoE, легкий KV і 4 біти
- Чи застаріють 24 ГБ VRAM за рік-два: прогноз з умовами й термінами
- Чи міняти RTX 3090 на RTX 5070 Ti: 24 проти 16 ГБ за близької ціни
- Генерація зображень: пороги VRAM у FLUX.2 не такі, як у LLM
- Ризики купівлі пам’яті наперед: вживані карти, ціни й сліпі зони
- FAQ
- 24 ГБ (RTX 3090) — найдешевший гігабайт: близько 2 480 ₴ за ГБ за одиничною пропозицією Hotline (на вторинці ще дешевше) і $65 за ГБ на вторинному ринку США. Брати, якщо основне завдання — чат і код на моделях до 32B.
- 32 ГБ (RTX 5090) — гігабайт дорожчий за всі інші: близько 11 970 ₴. Ви платите не за обсяг, а за швидкість і нову карту.
- 48 ГБ — найдешевше набираються двома RTX 3090; одна профкарта на 48 ГБ коштує в 3,9 раза дорожче за гігабайт.
- 96 ГБ (RTX PRO 6000) — близько 8 990 ₴ за ГБ, тобто гігабайт тут дешевший, ніж у RTX 5090. Але 96 ГБ уже не «страховка назавжди»: новий клас MoE-моделей на 125–320B просить 100+ ГБ пам’яті сумарно, RAM + VRAM.
- Чи застаріють 24 ГБ за рік-два? Для класу 27–32B — за нашими даними, ні. Застаріють, якщо вам знадобиться все, що вище: щільні ~70B і великі MoE. Це прогноз з умовами, а не гарантія, — тригери перегляду нижче.
Який обсяг VRAM брати під локальні LLM: ступені від 16 до 96 ГБ
VRAM — це пам’ять самої відеокарти. Мовна модель працює швидко, лише коли її ваги й робочий кеш повністю лежать у VRAM; усе, що не вмістилося, іде в оперативну пам’ять комп’ютера, і швидкість падає в рази. Тому питання «яку карту брати під ШІ» майже завжди зводиться до питання «скільки гігабайтів».
Щоб далі не спотикатися, три терміни:
- Квант (квантування) — стиснення ваг моделі. В оригіналі на кожен параметр іде 16 біт (формат BF16), у 4-бітному кванті — приблизно чотири. Модель стає в 3–4 рази легшою, а якість втрачається помірно; в 1–2 бітах втрати вже помітні.
- KV-кеш — «пам’ять про розмову». Модель зберігає проміжні дані щодо кожного токена контексту, і що довший діалог або завантажений документ, то більший цей кеш. Токен — шматок слова, приблизно 3–4 символи тексту.
- MoE (Mixture of Experts) — модель із багатьох «експертів», з яких на кожен токен працює лише мала частина. Загальний розмір величезний, але працює швидко — якщо є де зберігати всіх експертів.
Скільки точно займе конкретна модель, ми вже порахували в розборі формули KV-кешу і таблиці квантів — тут не повторюємо. Ця стаття про інше: яку ступінь обсягу купувати і як довго вона прослужить.

| Ступінь | Що відкриває (моделі й кванти) | Типова карта | Ціна 1 ГБ в Україні, 29.10.2026 |
|---|---|---|---|
| 16 ГБ | Чат-моделі 8–14B; 27B — у 3 бітах (12–14 ГБ) або впритул у 4-бітному UD-IQ4_XS | RTX 5070 Ti | ≈3 670 ₴ |
| 24 ГБ | Qwen3.8-27B у 4 бітах з контекстом до ~64K токенів (наш розрахунок); 70B — ні | RTX 3090 (вживана), RTX 4090 | ≈2 480 ₴ |
| 32 ГБ | 27–32B з контекстом 32–128K; 70B у 3 бітах повністю в пам’яті | RTX 5090, Radeon AI PRO R9700 | ≈11 970 ₴ / ≈3 730 ₴ |
| 48 ГБ | 70B у 4 бітах (Q4_K_M, 42,5 ГБ); 27B у 8 бітах | 2× RTX 3090, RTX PRO 5000 48 ГБ | ≈2 490 ₴ / ≈9 650 ₴ |
| 96 ГБ | 70B у 8 бітах; 27B без стиснення; середні MoE (клас gpt-oss-120b); «Flash»-клас — на межі | RTX PRO 6000 Blackwell | ≈8 990 ₴ |
Головна думка таблиці: обсяг купують під клас моделей, який ви триматимете щодня, а не під рекорди флагманів. Флагмани відкритих моделей давно вийшли за межі будь-якої одиночної карти, а «робочий» клас до 32B вміщається в 24 ГБ.
Що відкриває кожна ступінь: 16, 24, 32, 48 і 96 ГБ на моделях
Нижче — що реально запускається на кожній ступені, з цифрами з карток моделей і чужих замірів. Де цифра наша (розрахунок), так і позначено.
16 ГБ: чат 8–14B і стиснута 27B
За даними Unsloth (команда, яка випускає популярні стиснуті версії моделей), Qwen3.8-27B у 4 бітах займає 16–19 ГБ, у 3 бітах — 12–14 ГБ. Unsloth наводить ці цифри як сумарну пам’ять, RAM + VRAM. На 16-гігабайтній карті 27B упевнено вміщається в 3 бітах; із 4-бітних — лише найлегший UD-IQ4_XS (14,25 ГБ), впритул і з контекстом близько 16 тис. токенів, а ходові 4-бітні файли важать від 16,5 ГБ. Моделі 8–14B на 16 ГБ працюють вільно.
24 ГБ: головний робочий клас 27–32B
В англомовних добірках 24 ГБ шукають окремою ступенню — «24 GB VRAM GPU»: сюди входять RTX 3090, RTX 4090 і, наприклад, Intel Arc Pro B60. У таку карту вміщається Qwen3.8-27B у 4 бітах (файл UD-Q4_K_XL — близько 16,5–17,6 ГБ) плюс кеш контексту.
Скільки контексту вміщається, ми порахували за карткою моделі: у Qwen3.8-27B повну увагу обчислюють лише 16 шарів із 64, у них 4 KV-голови, тому кеш важить близько 64 КіБ на токен у форматі f16. Отже, 32K токенів — це 2 ГіБ, 64K — 4 ГіБ, 128K — 8 ГіБ. Підсумок для 24 ГБ: ваги ~17,6 ГБ + 64K контексту ≈ 22 ГБ, плюс 1–1,5 ГіБ службових буферів рушія — вміщається впритул; 128K (≈26 ГБ) уже ні, якщо не стискати сам кеш.
Старий щільний стандарт цього класу, Qwen3-32B, тримав 24 ГБ гірше: його кеш — 256 КіБ на токен, і 32K контексту додають 8 ГБ до 18,4 ГіБ ваг. У замірі ComputingForGeeks Qwen3 32B у Q4_K_M на RTX 3090 за контексту 32K падає через брак пам’яті, а RTX 5090 на тих самих 32K видає 53,3 токена за секунду.
70B на одній 24-гігабайтній карті не живе. Llama 3.3 70B у Q4_K_M — файл 42,5 ГБ, і на одиночну 3090 чи 4090 він не вантажиться взагалі (RunAIHome). Навіть агресивно стиснута 70B в IQ3_XXS (25,58 ГіБ) на RTX 3090 вивантажує 15 із 80 шарів в оперативну пам’ять і видає 3,4 токена за секунду — це вже не чат.
32 ГБ: довгий контекст і 70B у 3 бітах
32 ГБ — це RTX 5090 і Radeon AI PRO R9700. Зайві 8 ГБ проти 24 ГБ дають дві речі. Перша — контекст: за тим самим розрахунком Qwen3.8-27B у 4 бітах із 128K токенів займає ≈26 ГБ і вміщається. Друга — 70B у 3 бітах: та сама IQ3_XXS на RTX 5090 повністю в пам’яті йде зі швидкістю 52,8 токена за секунду проти 3,4 у RTX 3090 (ComputingForGeeks, орендовані карти). Збірку навколо 32 ГБ ми розбирали в статті ПК на RTX 5090 для локального ШІ.
48 ГБ: нормальна 70B
48 ГБ відеопам’яті — перша ступінь, де 70B у 4 бітах (42,5 ГБ) лежить повністю у VRAM із запасом під контекст. Набирають її двома способами: двома картами по 24 ГБ або однією професійною RTX PRO 5000 Blackwell на 48 ГБ. На двох RTX 3090 Llama 3.3 70B у Q4_K_M дає 16,3–19,5 токена за секунду з розбиттям за шарами і до 31,9 — з тензорним розбиттям на коректно розведеній платі (дані RunAIHome і ComputingForGeeks). Деталі такої збірки — у розборі двох RTX 3090 для локального ШІ.
Між 48 і 96 ГБ є проміжна ступінь: NVIDIA випустила RTX PRO 5000 Blackwell із 72 ГБ (Tom’s Hardware), але ціну не публікувала, а в українському Hotline на 29 жовтня 2026 року цієї версії немає.
96 ГБ: без компромісів до 70B і середні MoE
RTX PRO 6000 Blackwell має 96 ГБ пам’яті GDDR7 з корекцією помилок (ECC), пропускну здатність 1792 ГБ/с і споживає до 600 Вт (дані NVIDIA). У 96 ГБ вміщаються Qwen3.8-27B без стиснення (BF16, 56 ГБ), 70B у 8 бітах і торішній середній клас MoE: gpt-oss-120b (117B параметрів, 5,1B активних) розрахована на одну 80-гігабайтну карту. Як це виглядає в робочій станції — у розборі RTX PRO 6000 під 70B без мультикарти.
А от новий «Flash»-клас 2026 року в 96 ГБ уже впирається — про це в розділі про зростання моделей.
Ціна гігабайта відеопам’яті: Україна і США на 29 жовтня 2026
Ми зняли ціни 29 жовтня 2026 року: в Україні — за Hotline, Moyo і Allo, у США — за трекерами вторинного ринку й роздрібу. Гривні переведено в долари за офіційним курсом НБУ на ту саму дату — 45,5923 ₴ за $1.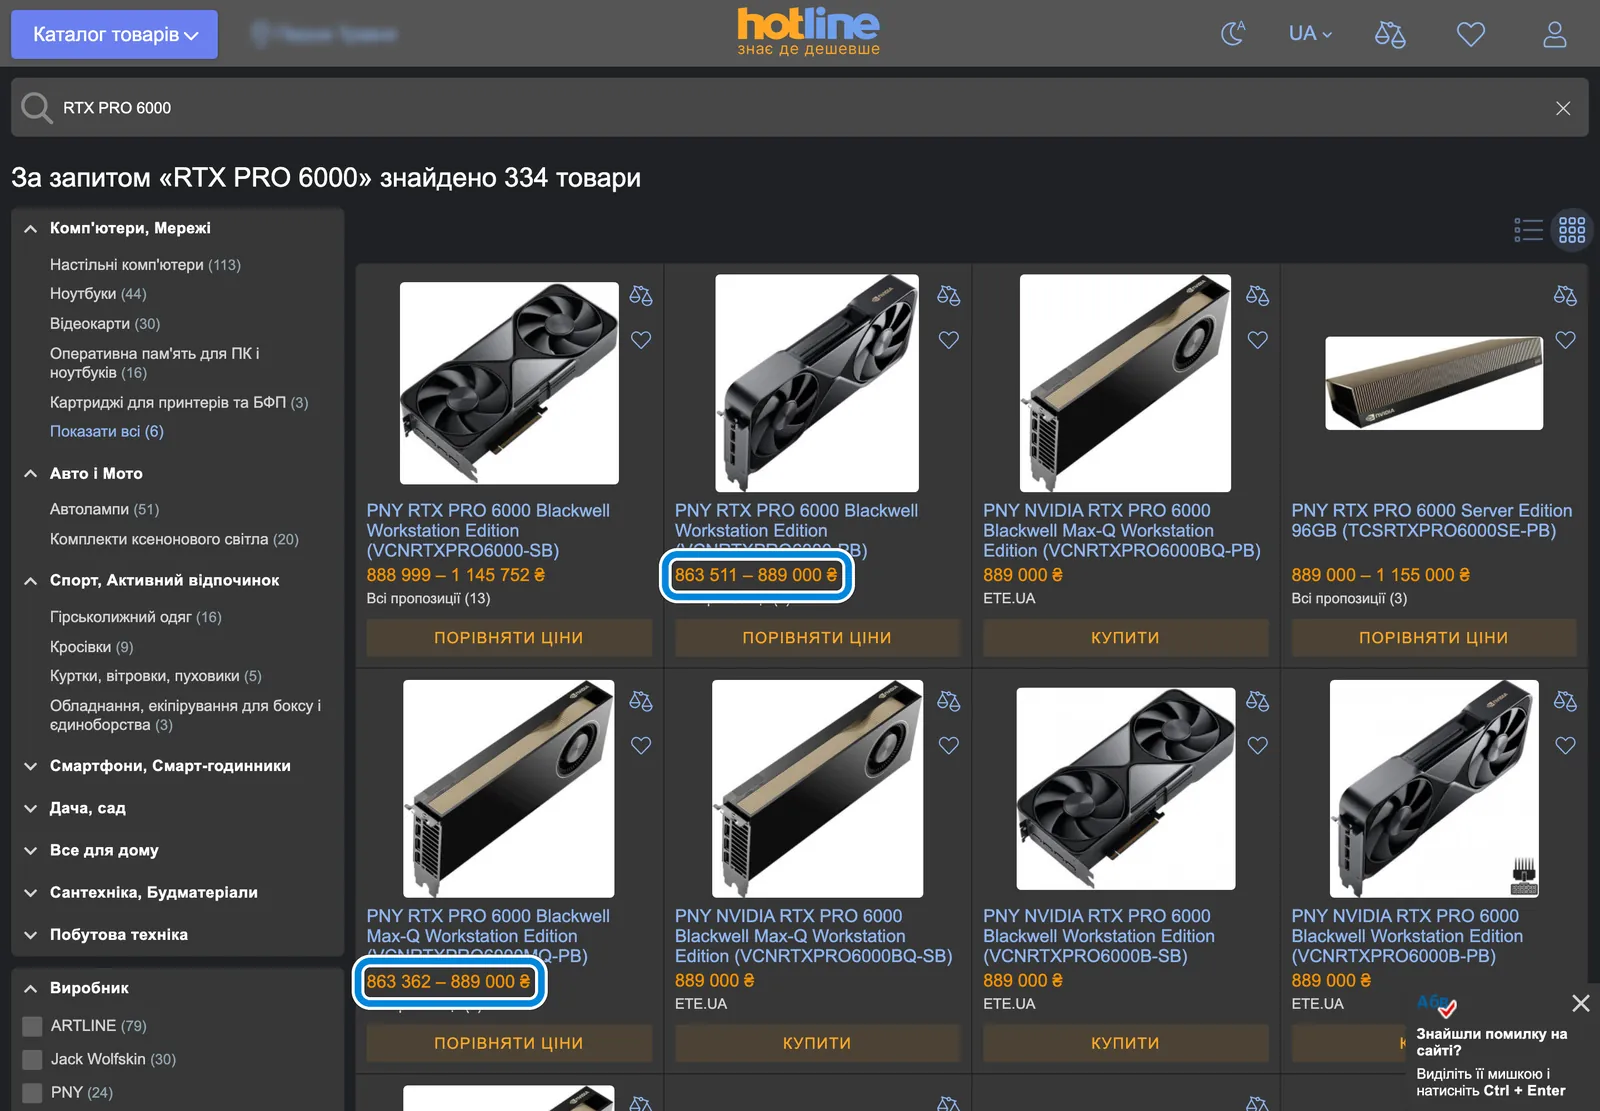
На скриншоті — видача Hotline за RTX PRO 6000 на 29 жовтня 2026 року: рамками позначено найнижчі діапазони: 863 511 ₴ у Workstation Edition (600 Вт) і 863 362 ₴ у версії Max-Q (300 Вт). Hotline показує не одну ціну, а розкид за магазинами — «від» і «до».Карта Обсяг Україна, від (Hotline) ≈ у $ за НБУ ₴ за 1 ГБ США, 28–29.10.2026 $ за 1 ГБ RTX 5070 Ti 16 ГБ 58 693 ₴ $1 287 3 668 $1 300 (нова, мінімум) 81 RTX 3090 24 ГБ 59 500 ₴ (одна пропозиція) $1 305 2 479 $1 561 (вживана, середня) 65 Radeon AI PRO R9700 32 ГБ 119 338 ₴ $2 618 3 729 н/д н/д RTX 5090 32 ГБ 383 000 ₴ $8 401 11 969 $8 178 (нова, мінімум у наявності) 256 RTX PRO 5000 Blackwell 48 ГБ 463 000 ₴ $10 155 9 646 н/д н/д RTX PRO 6000 Blackwell 96 ГБ 863 511 ₴ $18 940 8 995 $17 987 (нова, мінімум) 187
Цифри США: вживана RTX 3090 — середня $1 561 за 341 оголошенням на eBay (ResalePrices, 29 жовтня 2026 року); RTX 5070 Ti і RTX PRO 6000 — поточний мінімум за трекером GPUPrix; RTX 5090 — найдешевша відеокарта в наявності за тим самим трекером (його «мінімум» $7 699 — міні-ПК з мобільною RTX 5090); усе на 28 жовтня 2026 року. Щодо RTX 5090 в Україні є друга точка звірки: у Moyo карта в наявності коштує 450 399 ₴.
Що з цього випливає:
- Найдешевший гігабайт — 24 ГБ у RTX 3090. Навіть за магазинною ціною 3090 майже в півтора раза дешевша за гігабайт, ніж 16-гігабайтна RTX 5070 Ti, за майже однакової ціни самих карт; на вторинці розрив ще більший.
- RTX 5090 — найдорожчий гігабайт. В Україні 11 969 ₴ за ГБ — дорожче, ніж у професійних карт. За рекомендованої ціни $1 999 карта продається в роздробі США від $8 178: роздріб переоцінив її на дефіциті пам’яті сильніше, ніж профкарти.
- 96 ГБ дешевші за 32 ГБ у перерахунку на гігабайт. RTX PRO 6000 дає гігабайт за ≈8 990 ₴ проти ≈11 970 ₴ у RTX 5090 і ≈9 650 ₴ у RTX PRO 5000 на 48 ГБ. Якщо бюджет однаково йде в топову карту, 96 ГБ вигідніші за обсягом.
- Застереження щодо RTX 3090 в Україні. На 29 жовтня 2026 року Hotline тримає три моделі 3090: MSI Gaming X Trio — одна пропозиція за 59 500 ₴, Gigabyte Vision OC — 59 999 ₴, Gainward Phoenix — 134 999–151 217 ₴ (дев’ять пропозицій). Hotline не позначає, нова карта чи вживана; у пропозиції MSI за 59 500 ₴ вказано гарантію виробника, тобто це, найімовірніше, залишок нових карт. На вторинці 3090 дешевша: на OLX робочі карти на 25 жовтня 2026 року коштували найчастіше 28 000–44 000 ₴, типово близько 40 000 ₴ (≈1 670 ₴ за ГБ); у таблицю такі оголошення не потрапили.
Ціни карт ростуть, а не падають: вживана RTX 3090 у США подорожчала на 24,9% за 90 днів (ResalePrices, 29 жовтня 2026 року), RTX PRO 6000 пройшла шлях від $8 565 на запуску у 2025 році до $16 000 у вересні 2026-го і $17 987 мінімуму 28 жовтня.
Одна карта на 96 ГБ чи кілька по 24: ціна, швидкість, живлення
Чотири RTX 3090 дають ті самі 96 ГБ, що й одна RTX PRO 6000. Різниця — у ціні, швидкості, ватах і клопотах.Параметр 1× RTX PRO 6000 (96 ГБ) 4× RTX 3090 (4×24 ГБ) 2× RTX 3090 (48 ГБ) Ціна в США, кінець жовтня 2026 $17 987 (нова) ≈$6 244 (4× середня вживана $1 561) $2 912–3 116 за пару (RunAIHome, 20.10.2026) Ціна в Україні, кінець жовтня 2026 від 863 511 ₴ ≈160 000 ₴ вживані на OLX (4×≈40 000 ₴) або ≈389 500 ₴ за Hotline: дві одиничні пропозиції + дві Gainward за нижньою ціною 134 999 ₴ (наш розрахунок) ≈80 000 ₴ вживані на OLX або ≈119 500 ₴ за двома одиничними пропозиціями Hotline Живлення відеокарт 600 Вт 4×350 = 1400 Вт 700 Вт Як працює пам’ять Одна пам’ять, 1792 ГБ/с Модель ріжеться на чотири карти, обмін через PCIe Модель ріжеться на дві карти Головний ризик Ціна на піку Плата, блок живлення, розведення ліній PCIe Розведення ліній PCIe
За грошима чотири 3090 виграють: у США комплект коштує близько 35% від однієї RTX PRO 6000, в Україні — від 19% (вживані з OLX) до 45% (за Hotline). За рештою виграє одна карта. Модель в одній пам’яті не чекає обміну між картами. Чотири 3090 забирають близько 1,4 кВт тільки на відеокарти, плюс процесор і решта системи, і потребують серверної плати з достатньою кількістю повноцінних слотів.
Окрема пастка — розведення. RunAIHome наводить випадок, коли збірка на двох 3090 видавала сміття на контексті, довшому за 2K, бо одна карта висіла на слоті x4 від чипсета. Ті 31,9 токена за секунду на 70B — стеля правильно розведеної збірки x8/x8, а не норма.
Нові режими рушіїв скорочують розрив. Користувач r/LocalLLaMA повідомляв (у переказі на dev.to), що llama.cpp збірки b9455 з тензорним розбиттям -sm tensor і спекулятивним декодуванням MTP видає близько 70 токенів за секунду на Qwen3.6-27B у 8 бітах на двох 3090. Це звіт користувача, а не наш замір.
Є й проміжний варіант однієї карти: RTX PRO 6000 у версії Max-Q дає ті самі 96 ГБ за споживання 300 Вт, і на Hotline 29 жовтня 2026 року вона коштує майже стільки ж — від 863 362 ₴. Її варто розглянути, якщо важливі тиша й запас блока живлення.
Вибір за суттю: дві 3090 — найкращий шлях до 48 ГБ за розумні гроші; чотири — компроміс для тих, хто готовий до серверної збірки; одна RTX PRO 6000 — для тих, кому важливі тиша, одна карта і передбачуваність. Якщо ви обираєте не лише відеокарту, а й платформу загалом (ПК, Mac чи міні-ПК), почніть із нашого гіда з заліза для локального ШІ.
Куди ростуть відкриті моделі: від 671B до 2,8T за півтора року
Щоб зрозуміти, чи застаріє обсяг, подивимося, як росли відкриті моделі. Літера B — мільярди параметрів, T — трильйони. У MoE-моделей у дужках — скільки параметрів працює на кожен токен.Модель Дата Розмір (активні) Чи вміщається в 96 ГБ? DeepSeek-V3 грудень 2024 671B (37B) ні Kimi K2 липень 2025 1T (32B) ні gpt-oss-120b серпень 2025 117B (5,1B) так, розрахована на одну 80-ГБ карту DeepSeek-V4-Pro / V4-Flash квітень 2026 1,6T (49B) / 284B (13B) ні / у 4 бітах — ні Kimi K3 липень 2026 2,8T (104B) ні Qwen3.8-2.4T-A95B серпень 2026 2,4T (95B) ні GLM-5.3-Flash серпень 2026 320B (18B) тільки 1-бітний файл 93,09 ГБ, а загалом потрібно ≈102 ГБ Qwen3.8-Flash-Next серпень 2026 125B (≈6B) 4-бітний файл — 93,7 ГіБ; потрібно 96–114 ГБ пам’яті сумарно
За півтора з невеликим року флагмани виросли приблизно вчетверо: з 671B у DeepSeek-V3 до 2,8T у Kimi K3. Жодна з цих моделей не вміститься в жодну відеокарту, скільки б та не коштувала. Отже, ганятися за флагманами обсягом VRAM безглуздо — це завдання серверів.
Важливіша нижня частина таблиці. У 2026 році з’явився клас «Flash» — MoE-моделі на 125–320B, які позиціонують як доступні для локального запуску. Саме вони піднімають планку:
- GLM-5.3-Flash навіть в 1-бітному кванті важить 93,09 ГБ, а на запуск Unsloth радить близько 102 ГБ пам’яті сумарно; 3-бітний варіант просить 128 ГБ. До того ж 1-бітна версія збігається з повною моделлю у виборі найімовірнішого токена лише в 71% випадків (метрика top-1 accuracy, замір Unsloth) — «вмістилося» не означає «та сама якість».
- Qwen3.8-Flash-Next у 4 бітах — 93,7 ГіБ (це близько 100,6 ГБ у десяткових одиницях), і Unsloth радить 96–114 ГБ пам’яті сумарно; найменший квант потребує близько 75 ГБ.
Зверніть увагу на слово «сумарно». Unsloth наводить вимоги як суму оперативної пам’яті й відеопам’яті: такі моделі тримають частину експертів у звичайній RAM. Тому для «Flash»-класу вирішує вже не тільки VRAM, а й скільки оперативної пам’яті стоїть у комп’ютері. 96 ГБ відеопам’яті цей клас у доброму кванті повністю не вміщують — це не страховка «на виріст», а вхід на самий край.
Клас моделей 27–32B не росте: чому 24 ГБ VRAM поки не застаріли
Поки флагмани роздувалися, «картковий» клас ішов у протилежний бік — став меншим і розумнішим.Параметр Qwen3-32B (квітень 2025) Qwen3.8-27B (серпень 2026) Параметрів 32,8B 27B Вага в 4 бітах ≈18,4 ГіБ 16–19 ГБ (Unsloth) KV-кеш на токен (f16) 256 КіБ ≈64 КіБ (наш розрахунок за карткою) Контекст 32K токенів +8 ГБ +2 ГіБ Вміщається в 24 ГБ з контекстом 32K ні (замір: брак пам’яті на RTX 3090) так, із запасом (розрахунок)
Чому так вийшло. У Qwen3.8-27B лише 16 шарів із 64 використовують повну увагу й накопичують KV-кеш; решта 48 — лінійні шари Gated DeltaNet, у яких невеликий сталий стан, що не росте з довжиною контексту. Це видно в картці моделі на Hugging Face. Кеш став учетверо легшим, а отже, 24 ГБ вистачає на контекст, на якому стара 32B падала.
Якість при цьому зросла. За таблицею в тій самій картці Qwen3.8-27B набирає 61,7 у тесті агентного програмування SWE-bench Pro проти 53,5 у Qwen3.6-27B того самого розміру. Це самозвіт розробника, але напрям видно: клас росте якістю, а не гігабайтами.
Той самий тренд в інших розробників. DeepSeek заявляє, що V4-Pro на контексті в мільйон токенів потребує лише 10% KV-кешу від DeepSeek-V3.2; Z.ai описує гібридну розріджену й лінійну увагу в GLM-5.3-Flash. Обидва твердження — заяви вендорів, але вони вказують один напрям.
Висновок для покупки: 24 ГБ VRAM застарівають не тому, що моделі ростуть, а тоді, коли вам стає замало класу до 32B. Поки головний відкритий «робочий» клас вміщається в 16–19 ГБ, 24-гігабайтна карта тримає його з контекстом. Спільнота цю ступінь теж визнає: один із користувачів X назвав 24-гігабайтну ступінь «середнім класом» GPU для локальних моделей, а в r/LocalLLM обговорюють, чи не постаріють 24–32 ГБ несподівано добре.
Що пом’якшує брак VRAM: кеш експертів MoE, легкий KV і 4 біти
Раніше питання стояло жорстко: модель або вмістилася у відеопам’ять, або працює в рази повільніше. У 2026 році з’явилися прийоми, які розмивають цю межу.
1. Кеш експертів MoE у llama.cpp. llama.cpp — популярний рушій для локального запуску моделей. У PR #29887, відкритому 3 жовтня і влитому в основну гілку 7 жовтня 2026 року, з’явився кеш на відеокарті для експертів, які лежать в оперативній пам’яті: найзатребуваніші експерти тримаються у VRAM, решта довантажуються на вимогу. Вмикається прапорцем --moe-cache-mib, автор радить віддавати під кеш близько 10% від загального обсягу експертів.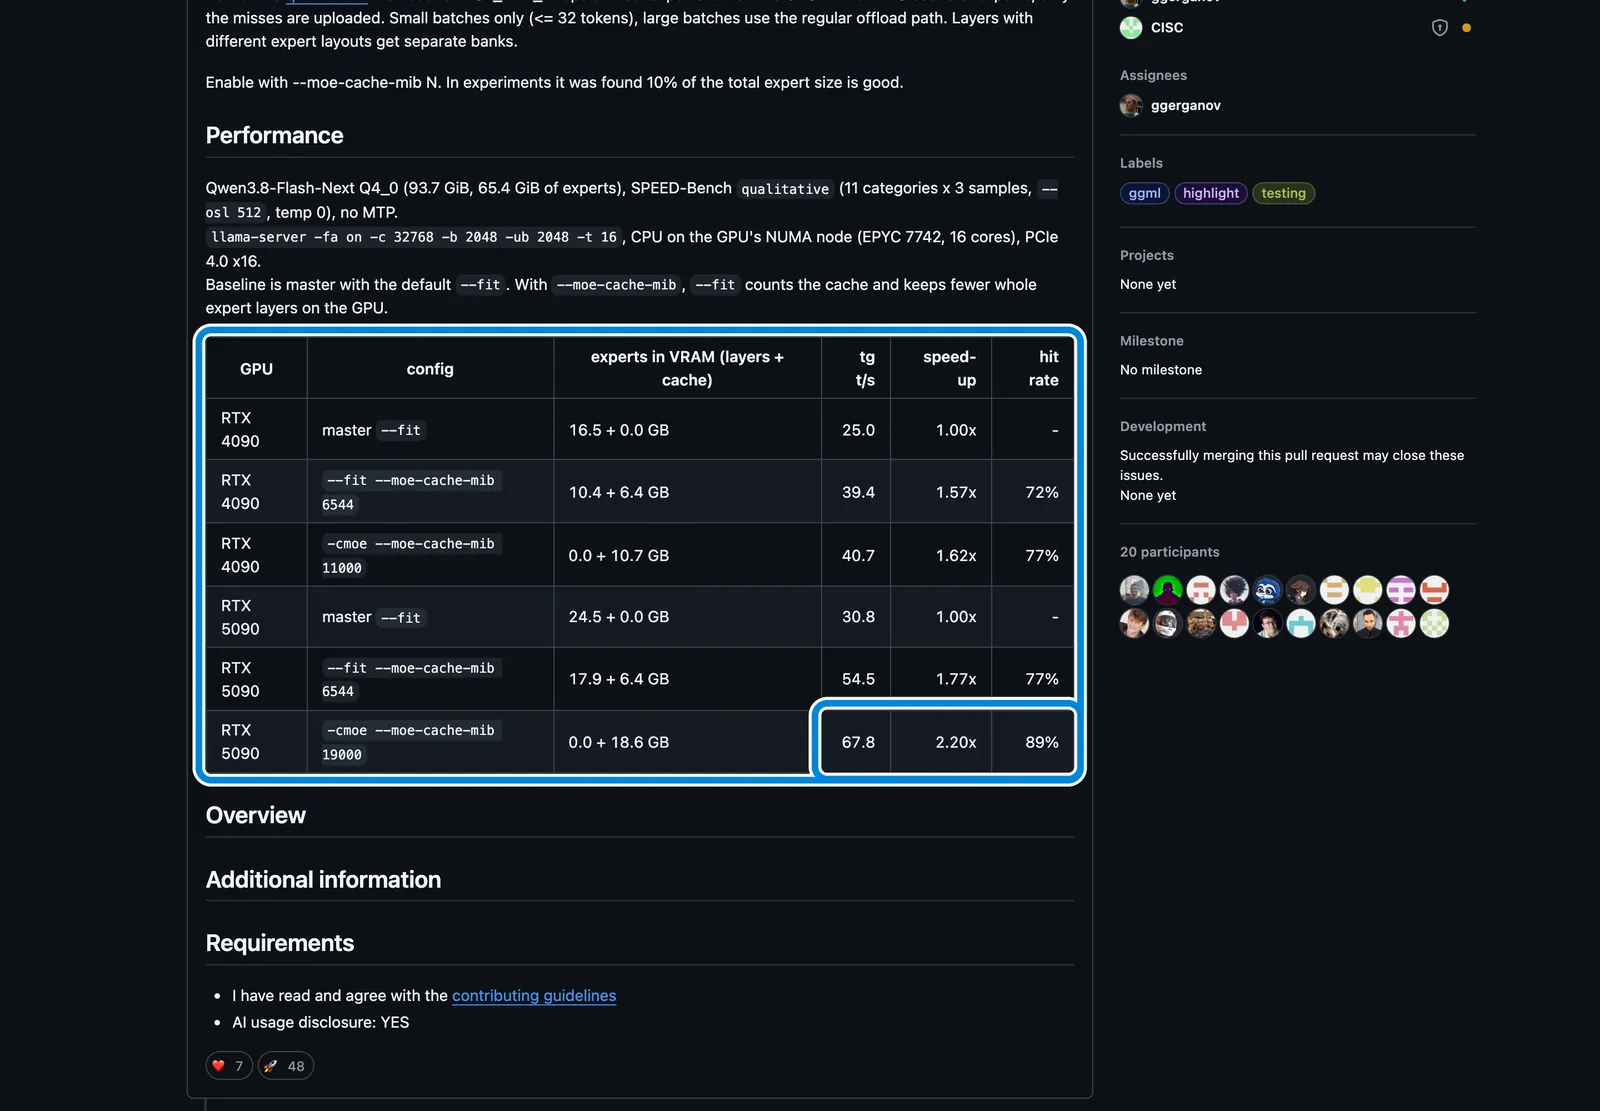
На скриншоті — таблиця автора PR, знімок зроблено 29 жовтня 2026 року. Модель Qwen3.8-Flash-Next у Q4_0 важить 93,7 ГіБ, тобто в 24 чи 32 ГБ не вміщається ніяк. Результати:Карта Без кешу З кешем експертів Прискорення RTX 4090 (24 ГБ) 25,0 ток/с 39,4–40,7 ток/с 1,57–1,62× RTX 5090 (32 ГБ) 30,8 ток/с 54,5–67,8 ток/с 1,77–2,20×
Важливі застереження: це один замір автора PR на сервері з процесором EPYC 7742 і PCIe 4.0 x16, з контекстом 32K. Сам кеш уже в основній гілці llama.cpp (влитий 7 жовтня 2026 року); чи з’явився він в Ollama і LM Studio, ми не перевіряли. Але суть зрозуміла: карта на 24–32 ГБ у парі з великою оперативною пам’яттю перестає бути «вмістилося чи ні» і запускає модель на 93,7 ГіБ із робочою швидкістю.
Зворотний бік — без доброї відеокарти такі моделі майже непідйомні. Один користувач X повідомляв, що GLM-5.3-Flash на 16-гігабайтній карті плюс 256 ГБ оперативної пам’яті видає 2,11 токена за секунду: запустити можна, розмовляти — ні.
2. Легкий KV-кеш. Гібридна увага, про яку йшлося вище, скорочує «вартість» довгого контексту в рази. Що легший кеш, то менше важить різниця між 24 і 32 ГБ.
3. 4-бітні формати. Кванти стають точнішими за того самого розміру: 19 серпня 2026 року Unsloth перевипустив кванти Qwen3.8-27B і заявив про +10% точності за тієї самої ваги. Для відеокарт серії RTX 50 з’явилися кванти у форматі NVFP4 (наприклад, Qwen3.8-27B-NVFP4 в Unsloth), розраховані на апаратну підтримку FP4 в архітектурі Blackwell.
Межа в цих прийомів теж є: 1-бітні кванти втрачають помітну частину якості (71% у GLM-5.3-Flash), а довантаження експертів із RAM упирається у швидкість шини й оперативної пам’яті.
Чи застаріють 24 ГБ VRAM за рік-два: прогноз з умовами й термінами
Коротка відповідь: для чату й коду на моделях до 32B 24 ГБ VRAM, за нашою оцінкою, залишаться робочою ступенню у 2027 році. Для всього, що вище, 24 ГБ уже зараз замало. Нижче — де закінчуються факти й починається прогноз.
Факти (перевірено на 29 жовтня 2026 року):
- Флагмани виросли приблизно вчетверо (671B → 2,8T) і вийшли за межі будь-якої одиночної карти.
- Головний «картковий» клас зменшився з 32,8B до 27B, а KV-кеш на токен — з 256 до ≈64 КіБ.
- У розібраних нами релізах 2026 року (Qwen3.8, GLM-5.3, DeepSeek V4, Kimi K3, MiniMax M3) немає щільної моделі близько 70B.
- Новий клас «Flash» (125–320B MoE) потребує 75–128 ГБ пам’яті сумарно, RAM + VRAM.
- Ціни пам’яті ростуть: ComputingForGeeks із посиланням на TrendForce (30 вересня 2026 року) пише про зростання контрактних цін DRAM ще на 10–15% у четвертому кварталі 2026 року після 13–18% у третьому; розрив попиту й пропозиції, за цим прогнозом, розшириться у 2027 році, а помітні нові потужності з’являться не раніше другої половини 2027-го, суттєво — у 2028-му. Першоджерело TrendForce ми не відкривали, це переказ.
Прогноз — три сценарії (наша екстраполяція за двома-трьома релізами, а не закон):Сценарій Що має статися Що це означає для 24 ГБ Що брати Базовий: клас до 32B лишається головним Нові середні моделі виходять на 27–32B і з легким KV 24 ГБ вистачає на 4 біти й контекст 32–64K 24 ГБ; 32 ГБ — якщо потрібен довгий контекст Зсув угору: повертається щільна ~70B Виходить відкрита щільна ~70B, помітно краща за 27B 24 ГБ стають другою лігою 48 ГБ (дві 3090) Зсув у MoE: середній клас — «Flash» 100–300B Кеш експертів з llama.cpp (влитий 7 жовтня 2026 року) приходить в Ollama і LM Studio 24–32 ГБ живі, але потрібні 128–256 ГБ оперативної пам’яті 24–32 ГБ + багато RAM, а не 96 ГБ VRAM
Тригери перегляду — за чим стежити:
- Реліз відкритої щільної моделі близько 70B, яка в тестах помітно обходить Qwen3.8-27B.
- Поява кешу експертів MoE в Ollama і LM Studio (у llama.cpp він уже влитий 7 жовтня 2026 року).
- Споживча карта на 48 ГБ. Поки її немає; про RTX 50 Super з пам’яттю до 24 ГБ Igor’s Lab у листопаді 2025 року з посиланням на інсайдера писав, що запуск відкладено до третього кварталу 2026-го через дефіцит пам’яті, але й до кінця жовтня ми її запуску не знайшли — це чутка, а не план NVIDIA.
- Розворот цін DRAM донизу. За прогнозом TrendForce у переказі — не раніше другої половини 2027 року.
Практичний висновок: чекати здешевлення, щоб узяти «більше й дешевше», — за поточними даними поганий план. Якщо завдання вже є і воно вкладається в клас до 32B, 24 ГБ купуються зараз і не виглядають глухим кутом на горизонті року. Якщо ви впевнені, що вам потрібна 70B щодня, одразу цільтеся в 48 ГБ.
Чи міняти RTX 3090 на RTX 5070 Ti: 24 проти 16 ГБ за близької ціни
Це питання активно обговорюють: тред «чи варто міняти RTX 3090 на RTX 5070 Ti» в r/buildapc зібрав понад 500 голосів. Відповідь упирається в арифметику на 29 жовтня 2026 року:
- США: вживана RTX 3090 продається в середньому за $1 561, нова RTX 5070 Ti коштує від $1 300. Грошей від продажу 3090 вистачає на нову 5070 Ti, і ще лишається невелика решта.
- Україна: вживану RTX 3090 на OLX продають приблизно за 40 000 ₴ (типова ціна на 25 жовтня 2026 року), а нова RTX 5070 Ti коштує від 58 693 ₴ на Hotline і 73 799 ₴ у наявності в Allo. Доплата — близько 19–34 тис. ₴.
У США обмін іде майже без доплати, в Україні — з доплатою від 19 тис. ₴, і в обох випадках це обмін 24 ГБ на 16 ГБ. Що ви отримуєте: нову карту з гарантією, покоління Blackwell з апаратною підтримкою FP4 і менше споживання — 300 Вт проти 350 Вт у 3090 (дані NVIDIA). Що втрачаєте: Qwen3.8-27B у 4 бітах із нормальним контекстом. На 16 ГБ ця модель вміщається в 3 бітах або впритул у найлегшому 4-бітному UD-IQ4_XS.Кому має сенс обмін Кому ні Основне завдання — генерація зображень з FP8/FP4-оптимізаціями, а LLM потрібні до 14B Основне завдання — чат і код на моделях 27–32B Лякає вік вживаної карти й хочеться гарантії Потрібен довгий контекст (документи, кодова база) Важливі тиша і споживання Плануєте другу карту і ступінь 48 ГБ
Для LLM ми б не міняли: за близької ціни ви втрачаєте третину пам’яті, а саме пам’ять вирішує, який клас моделей ви тримаєте. Докладне порівняння 3090, 5070 Ti і 5080 за швидкістю в токенах і ціни на OLX — у нашому виборі відеокарти для локального ШІ.
Генерація зображень: пороги VRAM у FLUX.2 не такі, як у LLM
У моделей генерації зображень свої пороги, і вони не збігаються з LLM. Приклад — FLUX.2 [dev] від Black Forest Labs, що вийшла 25 листопада 2025 року:Режим Скільки VRAM Джерело Повне завантаження моделі на 32B параметрів 90 ГБ NVIDIA Blog Режим lowVRAM (у пам’ять вантажиться лише активна частина) 64 ГБ NVIDIA Blog Квант FP8 на 40% менше за порівнянної якості NVIDIA Blog Рекомендація ComfyUI для високої роздільної здатності 24 ГБ і більше ComfyUI Blog
Щоб FLUX.2 взагалі запрацювала на домашніх картах, NVIDIA і ComfyUI доопрацювали вивантаження ваг в оперативну пам’ять (weight streaming): частина моделі лежить у RAM, і це працює, але зі втратою швидкості, бо системна пам’ять повільніша за відеопам’ять. Тому ComfyUI називає 24 ГБ і більше рекомендованим мінімумом для високої роздільної здатності, а на 16 ГБ у RAM іде ще більша частина ваг. Для LLM та сама 24-гігабайтна карта тримає модель 27B повністю, для FLUX.2 — уже ні: пороги у двох завдань різні. Щодо відеомоделей звірених порогів на цю дату в нас немає. Яку версію FLUX брати під 8, 12 і 24 ГБ — у статті FLUX локально на ПК і Mac.
Ризики купівлі пам’яті наперед: вживані карти, ціни й сліпі зони
Ринок і ціни:
- Купівля на піку. Вживана RTX 3090 подорожчала на 24,9% за 90 днів (ResalePrices, 29 жовтня 2026 року), RTX PRO 6000 — удвічі від запуску. Старі гайди з ціною 3090 у $650–850 застаріли.
- Дефіцит пам’яті. За переказом прогнозу TrendForce, DRAM і далі дорожчатиме у 2027 році. Оперативна пам’ять для MoE-сценарію теж подорожчає.
- Hotline не розрізняє нове й вживане. Найдешевші пропозиції RTX 3090 там одиничні, а на OLX у вживаних карт немає гарантії; перед купівлею перевіряйте стан карти й продавця.
Техніка:
- Вживана карта після інтенсивної роботи. У 3090 бувають проблеми з термопрокладками пам’яті й вентиляторами; що перевіряти під час купівлі — у нашому виборі відеокарти для локального ШІ.
- Розведення PCIe у багатокарткових збірках. Слот x4 від чипсета може перетворити другу 3090 з прискорювача на гальмо.
- Живлення. RTX 5090 споживає до 575 Вт і потребує блока живлення від 1000 Вт, RTX PRO 6000 — до 600 Вт, кожна RTX 3090 — 350 Вт.
Сліпі зони прогнозу:
- Висновок «клас до 32B не росте» зроблено за двома-трьома релізами. Наступний реліз може його розсунути.
- Бенчмарки Qwen3.8-27B — самозвіт розробника; заміри ComputingForGeeks зроблено на орендованих картах; прискорення кешу експертів — один замір автора PR.
- 1-бітні кванти, завдяки яким «Flash»-моделі вміщаються в 96 ГБ, втрачають помітну частину якості.
Що застаріє першим: ціни (їх варто перевіряти на Hotline і в трекерах перед купівлею), підтримка кешу експертів в Ollama і LM Studio та список актуальних моделей — наступний реліз Qwen, DeepSeek чи GLM може зсунути таблицю ступенів.
FAQ
Чи вистачить 24 ГБ відеопам’яті для локальних LLM у 2027 році?
Для моделей до 32B — за нашою оцінкою, так. Qwen3.8-27B у 4 бітах займає 16–19 ГБ, а її KV-кеш учетверо легший, ніж у Qwen3-32B, тож 24 ГБ тримають її з контекстом до ~64K токенів. Не вистачить, якщо вам потрібна щільна 70B або «Flash»-моделі на 125–320B: їм потрібно 48 ГБ і більше або багато оперативної пам’яті.
Чим 32 ГБ кращі за 24 ГБ, якщо модель та сама?
Довжиною контексту й запасом під 70B у 3 бітах. За нашим розрахунком Qwen3.8-27B у 4 бітах із контекстом 128K займає близько 26 ГБ і вміщається в 32 ГБ, але не в 24 ГБ. У замірі ComputingForGeeks Qwen3 32B на 32K контексту на RTX 3090 упирається в брак пам’яті, а RTX 5090 видає 53,3 токена за секунду.
Що краще для LLM: одна RTX PRO 6000 на 96 ГБ чи чотири RTX 3090?
За ціною виграють чотири 3090: у США комплект вживаних коштує близько $6 244 проти $17 987 за RTX PRO 6000 (кінець жовтня 2026 року). Одна карта виграє простотою: 600 Вт замість 1400 Вт, одна пам’ять без обміну через PCIe, звичайна плата. Для 48 ГБ розумний компроміс — дві 3090.
Чи варто чекати нових карт або падіння цін, перш ніж брати відеокарту під LLM?
За даними на 29 жовтня 2026 року — радше ні. TrendForce у переказі ComputingForGeeks очікує зростання контрактних цін DRAM ще на 10–15% у четвертому кварталі 2026 року, а помітних нових потужностей — не раніше другої половини 2027-го. RTX 50 Super з пам’яттю до 24 ГБ так і не вийшла. Якщо завдання вкладається в моделі до 32B, 24 ГБ розумно брати зараз; якщо потрібна 70B щодня — одразу 48 ГБ.
Чи потрібна відеокарта із запасом VRAM, якщо можна додати оперативної пам’яті?
Оперативна пам’ять допомагає MoE-моделям: із кешем експертів llama.cpp RTX 4090 на 24 ГБ запускає модель на 93,7 ГіБ зі швидкістю близько 40 токенів за секунду (замір автора PR #29887). Але для щільних моделей вивантаження в RAM убиває швидкість: 70B на RTX 3090 з частиною шарів в оперативній пам’яті дає 3,4 токена за секунду.
Що робити, якщо модель не вміщається у відеопам’ять?
Є чотири важелі по черзі: узяти квант нижчий (з 4 біт на 3), скоротити контекст, стиснути сам KV-кеш до 8 біт або вивантажити частину моделі в оперативну пам’ять. Для MoE-моделей останній варіант працює непогано, для щільних — помітно повільніше. Якщо не допомагає ніщо, отже, потрібна наступна ступінь обсягу або друга карта.